

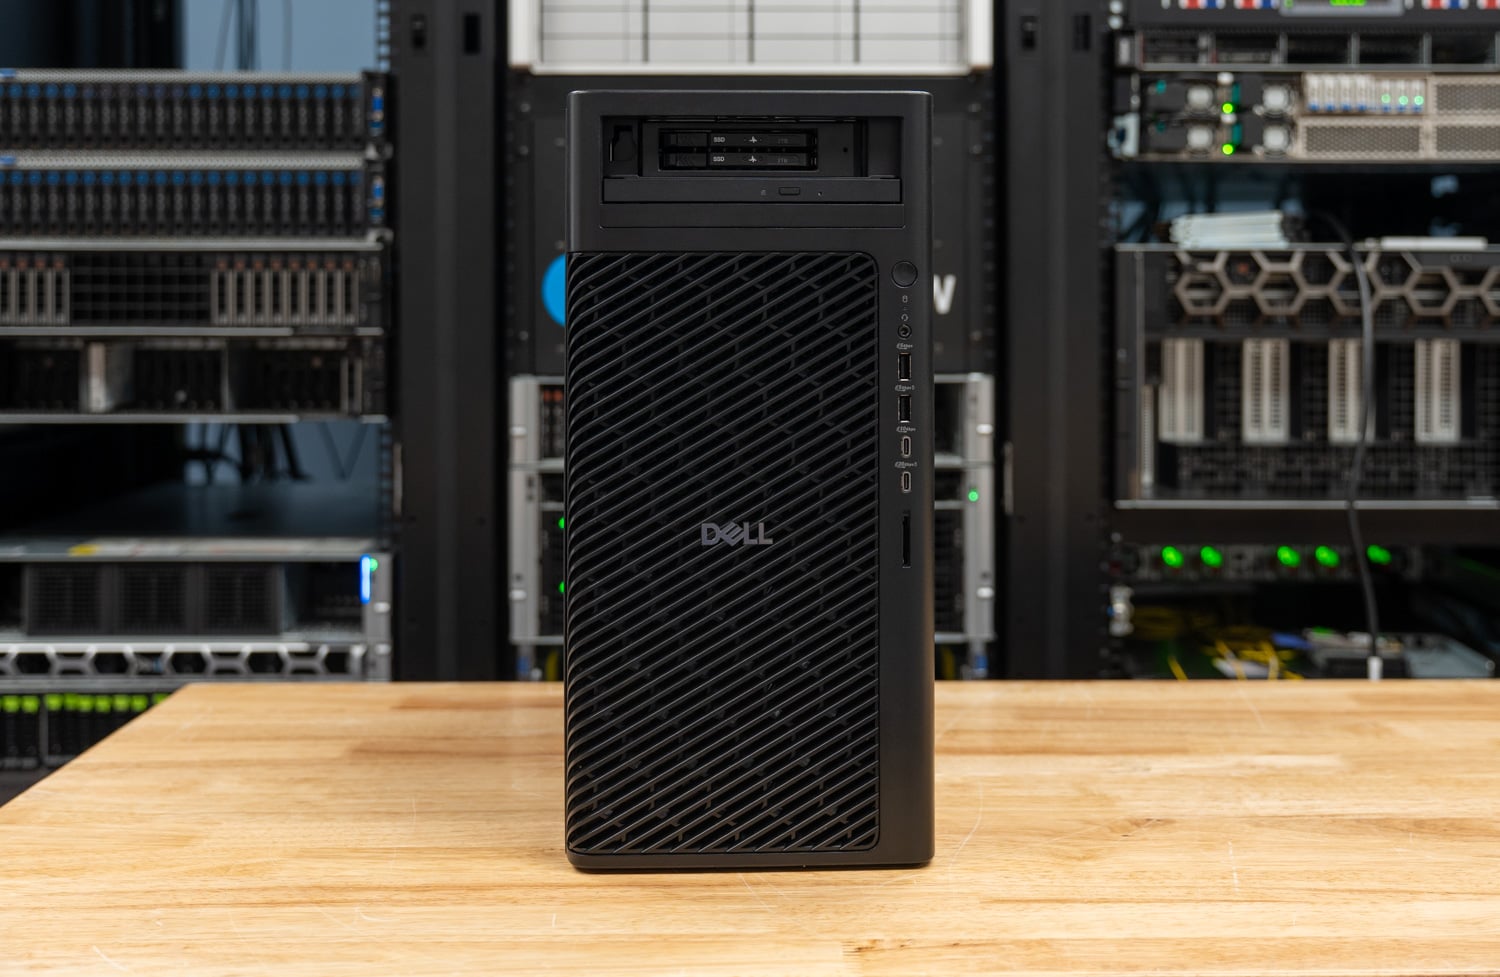
戴尔Pro Precision 9 T2是去年我们评测过的单GPU塔式机戴尔Pro Max Tower T2的Xeon版本,此次更新同时带来了两项变化:一是更名,戴尔将其工作站产品线重新归入Precision品牌;二是采用全新平台,在相同的32升机箱内,用英特尔Xeon 6处理器取代了之前的Core Ultra 9 285K处理器。我们评测的这台机器配备了24核Xeon 658X处理器、128GB DDR5-6400 RDIMM ECC内存、300W RTX PRO 6000 Blackwell Max-Q显卡,以及两块2TB E3.S Gen5硬盘,它们以条带化方式安装在前面板的FlexBay扩展槽中。在戴尔官网上,配置相同的机器售价约为28,300美元。
我们采用矩阵式测试方法:Pro Precision 9 T2 先用标配的 Max-Q 显卡运行完整测试套件,再用从 Pro Max Tower T2 中取出的 600W RTX PRO 6000 Blackwell 显卡运行,基于 Core 架构的 T2 也同时运行了这两张显卡。因此,以下所有结果均包含四列,每两列分别代表一个变量:CPU 平台或 GPU 的功耗限制。测试套件与上周RTX Spark 笔记本电脑的测试套件相同,只是在此基础上增加了一些新内容。
Xeon处理器提升了吞吐量,但增加了延迟。Pro Precision 9 T2在Cinebench 2026多核测试中得分12,322,而Core T2得分为8,856;LLVM构建耗时140.2秒,Core T2耗时182.5秒;STREAM Triad读取速度为122,233MB/s,Core T2读取速度为33,003MB/s;其单核Cinebench得分454.1,低于285K的564.4;Speedometer得分36.8,低于46.3。这款600W显卡在两种塔式机箱中,LLM解码性能提升约7%至20%,即时处理和扩散性能提升约20%至39%;而在Xeon塔式机箱中,它会使CPU全核性能降低4%至5%。
关键精华
- Xeon 6 是一款采用单路塔式设计的吞吐量平台: 在 Cinebench 2026 多核测试中得分为 12,322,比同机箱的 Core Ultra 9 285K 高出 39%;在 7-Zip 测试中达到 289.6 GIPS,而 Core Ultra 9 285K 为 174.8;DGEMM 性能为 1,638 GFLOPS,而 Core Ultra 9 为 768;四通道 DDR5-6400 内存带宽是 Core Ultra 9 285K 的 3.7 倍。
- 285K 仍然拥有单线程速度优势: Xeon 在 Cinebench 单核测试中落后 20%,在 Speedometer 测试中落后 21%,在单线程 Python 测试中落后 20% 到 31%,核心到核心的延迟为 56.2 ns,而后者为 38.1 ns。
- GPU决定AI的运行结果,而这张600W的显卡则通过接收指令来获取电量: MLPerf Llama 3.1 8B 使用 Max-Q 显卡每秒生成 230.9 个令牌,使用 600W 显卡每秒生成 252.8 个令牌,而首次生成令牌的时间从 0.082 秒降至 0.059 秒,Qwen-Image 20B 渲染 1024×1024 图像的时间为 19.7 秒,而 600W 显卡则为 26.1 秒。
- 600W显卡会使Xeon处理器的CPU工作负载增加4%到5%: Cinebench 多核性能从 12,322 下降到 11,705,30 分钟持续循环性能从 12,328 下降到 11,764,稳态时钟频率从 4,274MHz 下降到 4,178MHz;同样的交换对 Core T2 没有任何影响。
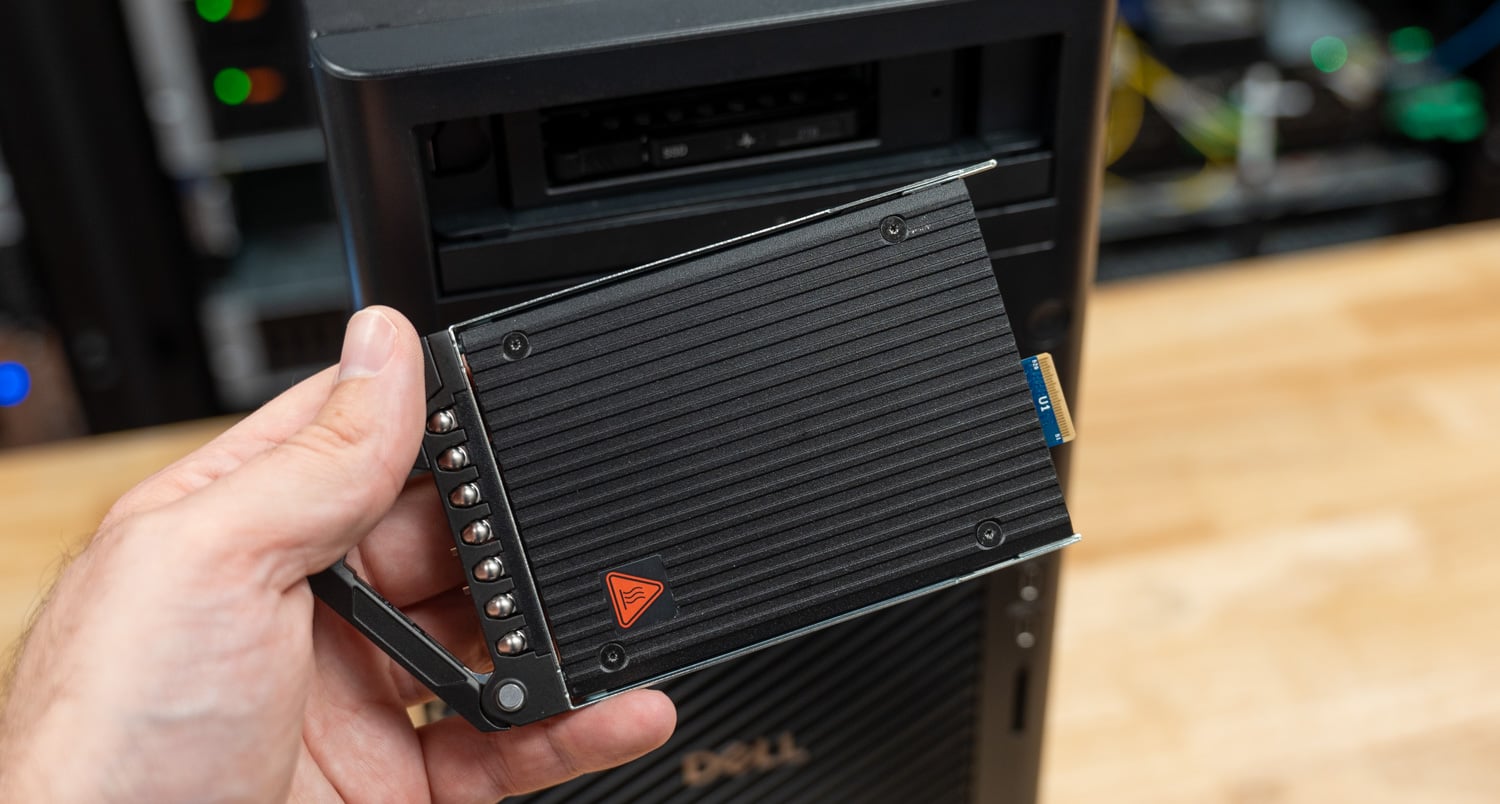
- E3.S 在 FlexBay 中,由 VROC by Graid 涂装: 前置硬盘位可容纳两块 E3.S Gen5 固态硬盘,这在我们实验室的塔式工作站中尚属首次。戴尔的 RAID 0 启动选项利用 Graid Technology 的 VROC 技术,将这两块硬盘组成一个 4,097GB 的卷。该卷的顺序读取速度为 9,332MB/s,4K 随机读取峰值 IOPS 为 840.1K,相比之下,Core T2 中单块 Gen5 M.2 固态硬盘的 IOPS 为 1.78 万。
从 Pro Max 到 Pro Precision
戴尔原计划在2025年初停用Precision系列名称,届时所有工作站都将更名为Dell Pro Max,但现在他们又重新启用了Precision。10月7日,戴尔将GB10和GB300桌面工作站的名称从Dell Pro Max改为Dell Pro Precision,戴尔官网(Dell.com)也将Pro Precision 9 T2与新款T4和T6塔式机一同列在同一品牌下。Pro Max系列仍然用于基于酷睿处理器的机型,因此我们去年评测的酷睿Ultra塔式机仍然以Dell Pro Max Tower T2的名称销售,而本文评测的至强塔式机则是Dell Pro Precision 9 T2,型号为PW9T2260。
T4 和 T6 机型在更名后也同样升级到了 Xeon 6 处理器,戴尔根据扩展性对这三款塔式机进行了定位。Pro Precision 9 T4 (PW9T4260) 搭载了与 T4 相同的处理器列表,最高可选配 86 核的 Xeon 698X,并增加了 16 个 DIMM 插槽,支持在所有八个内存通道上安装高达 4TB 的 DDR5-6400 内存。它可搭载一块 600W 的 RTX PRO 6000 显卡,或者在 1500W 电源下安装两块 Max-Q 显卡,也可选配 2400W 的机箱。
Pro Precision 9 T6 (PW9T6260) 是该系列的顶级产品,拥有六个插槽、2400W 电源,可容纳两张 600W RTX PRO 6000 系列显卡、三张 Max-Q 系列显卡,或最多五张 RTX PRO 5000 系列显卡。T2 则是该系列中单 GPU、四通道的入门级产品。
命名准确性至关重要,因为这两款塔式机箱外观完全相同,都采用相同的 32 升机箱(尺寸为 387 x 187.7 x 438 毫米)、相同的边框和前置 FlexBay 扩展槽,并且在戴尔配置器中也提供相同的 RTX PRO 6000 Blackwell 显卡选项,因此区别在于主板。Pro Max Tower T2 搭载 24 核 Core Ultra 9 285K 处理器,配备四个 DIMM 插槽的无缓冲 DDR5 内存;而 Pro Precision 9 T2 则采用英特尔面向工作站的 Xeon 6 处理器,即我们在六月份评测过的Granite Rapids-WS平台,该平台配备 ECC 注册内存、更多 PCIe 通道,并且在最高配置下搭载 250W 处理器。

戴尔Pro Precision 9 T2提供六款至强6处理器可选,从150W的12核至强634到我们评测的这款250W的24核至强658X,从634升级到658X需要额外支付1,560美元。至强658X拥有24个核心和48个线程,基础频率为3.0GHz,睿频可达4.9GHz,配备144MB L3缓存,是285K(36MB)的三倍,并且支持AVX-512和AMX指令集,而285K则不支持。该芯片支持8个DDR5-6400通道和128条Gen5内存通道;T2机型配备四个DIMM内存插槽和五个扩展插槽,而更大的T4和T6机型则提供剩余的插槽。
| 平台 | 戴尔专业版 Precision 9 T2(测试机型) | 戴尔 Pro Max Tower T2(测试机型) |
|---|---|---|
| 处理器 | 英特尔至强 658X 处理器,24 核/48 线程,主频 3.0 至 4.9GHz,144MB 三级缓存,250W | 英特尔酷睿Ultra 9 285K处理器,24核心/24线程(8个并行线程+16个并行线程),最高主频5.7GHz,36MB三级缓存,125W |
| 指令集 | AVX-512,AMX | AVX2(无 AVX-512)、英特尔 AI Boost NPU |
| 内存 | 4 x 32GB DDR5-6400 RDIMM ECC(四通道;最大支持 1TB) | 4 x 32GB DDR5-4400 ECC UDIMM |
| 扩展 | Gen5 x16、Gen5 x4、Gen4 x16、两个 Gen4 x8(其中一个 x4 为电气设备) | Gen5 x16,Gen4 x4 一台,Gen3 x4 两台 |
| 已测试的启动存储 | 前置 FlexBay 插槽配备 2 块 2TB E3.S Gen5 NVMe 固态硬盘,组建 RAID 0 阵列(采用 Graid Technology 的 VROC 技术),总容量 4,097GB | 2TB SK 海力士 PCB01 M.2 Gen5(单盘) |
| 内部 M.2 | 3 个 M.2 2280 Gen5 接口 | 1 个 Gen5 和 2 个 Gen4 M.2 接口 |
| 电源供应 | 标准功率750瓦;可选功率500瓦或1500瓦(测试功率为1500瓦) | 360瓦、500瓦或1500瓦(80 Plus白金认证) |
| 经测试的图形 | RTX PRO 6000 Blackwell Max-Q (300W) 出厂配置;也测试了 600W 的显卡。 | RTX PRO 6000 Blackwell (600W) 出厂配置;Max-Q 版本也进行了测试。 |
| 底座 | 尺寸:387 x 187.7 x 438毫米,重量:11.6至21.8公斤 | 尺寸:387 x 187.7 x 438毫米,重量:8.17至23公斤 |
Core T2 从单个 M.2 固态硬盘启动,而我们的 Pro Precision 9 T2 则配备了戴尔的 FlexBay NVMe 启动配置:前面板后方有两个支持热插拔的 E3.S Gen5 固态硬盘,通过 RAID 0 启动选项组成一个 4,097GB 的卷。E3.S 是我们一直向塔式机箱厂商提出的企业级规格,因为它将容量上限远远超过了 M.2,而且无需打开机箱即可从正面取出硬盘。RAID 层采用的是Graid Technology 的 VROC 技术,该技术源自英特尔的 VROC,Graid 去年接管了这项技术并在台北电脑展上重新发布。这是我们实验室首款搭载该技术的工作站。

600W显卡需要额外的空间,而Max-Q显卡则不需要。我们收到的这台机器出厂时,显卡旁边的插槽里插着一块Intel E810-XXV双端口25GbE网卡,要安装600W的RTX PRO 6000显卡,就必须先把网卡拆下来;因为显卡的散热器会占用相邻插槽的空间以及电源。如果买家想要购买全功率显卡和高速网卡,应该在下单前规划好插槽布局,而且1500W的电源是唯一合理的搭配;我们这台机器选配了1500W电源,比标配的750W电源贵了40美元。
建筑与设计
Pro Precision 9 T2 采用与 Pro Max 版本相同的免工具塔式机箱,配备全高网状前格栅用于进气,侧面板采用侧边卡扣和固定式手拧螺丝,FlexBay 扩展坞和可选的超薄光驱位于下部边框后方。戴尔官方标称机箱空重 11.6 公斤,配置后最大可达 21.8 公斤。我们评测的这台机器配备了 1500W 电源、658X 散热器和双槽显卡,重量接近上限。

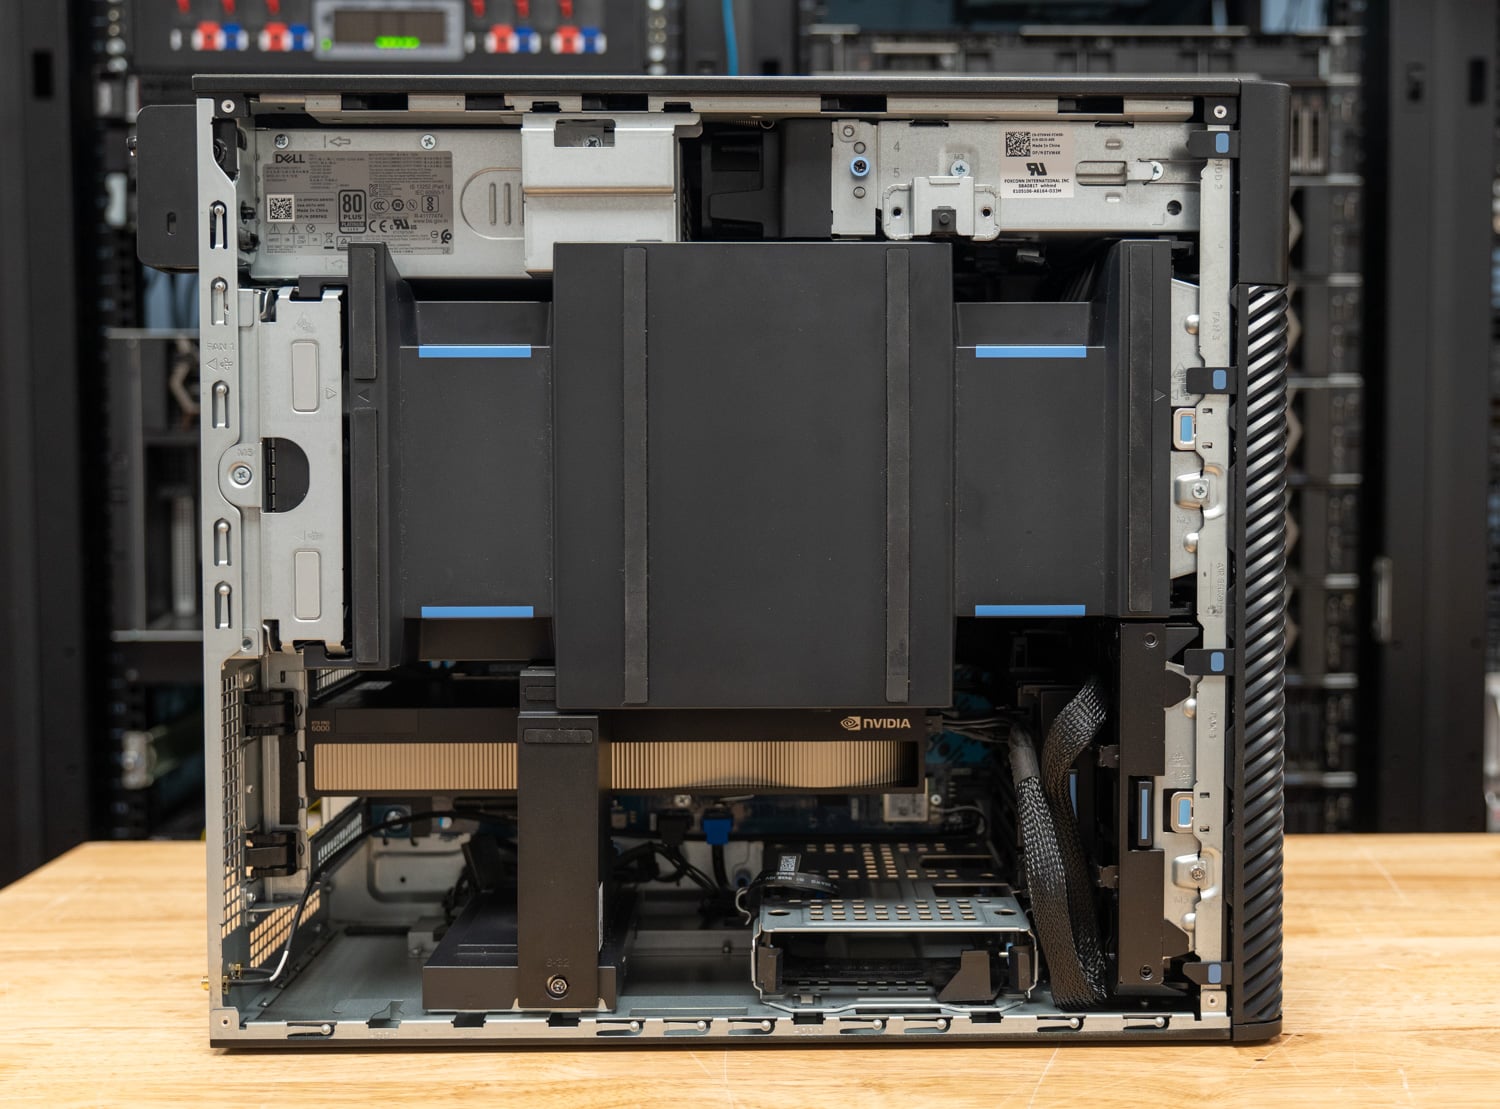
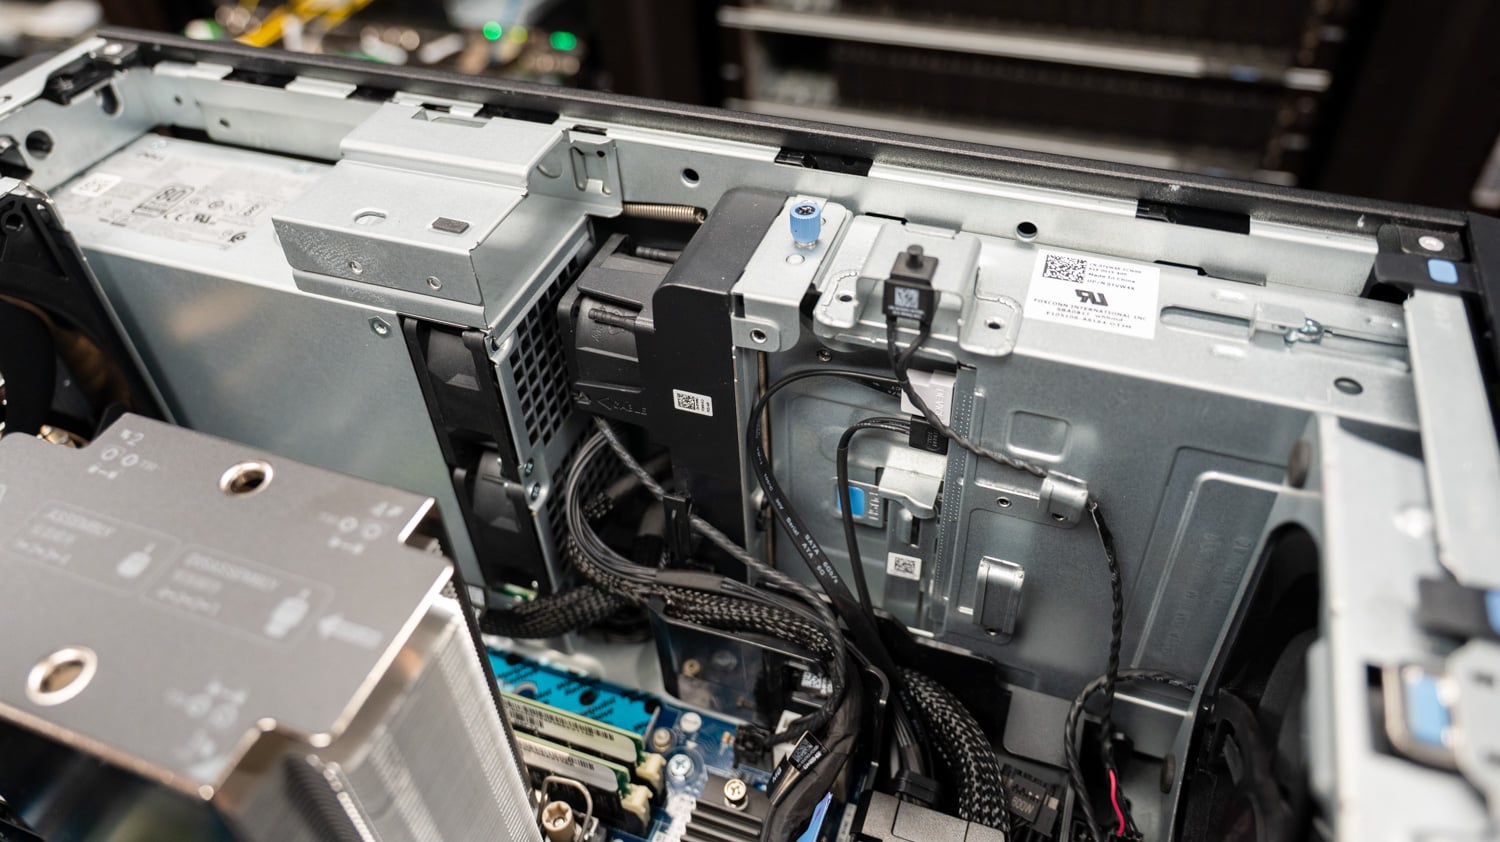
机箱内部设计以气流为核心,戴尔能够精准地引导气流流向所需之处。大型散热罩不仅能有效冷却内存条,还能将CPU产生的热空气直接排出机箱,其内部集成了一个风扇。打开机箱后,可以看到散热罩是如何融入机箱结构的:它的下边缘搁置在显卡支架上,并与侧盖紧密贴合。
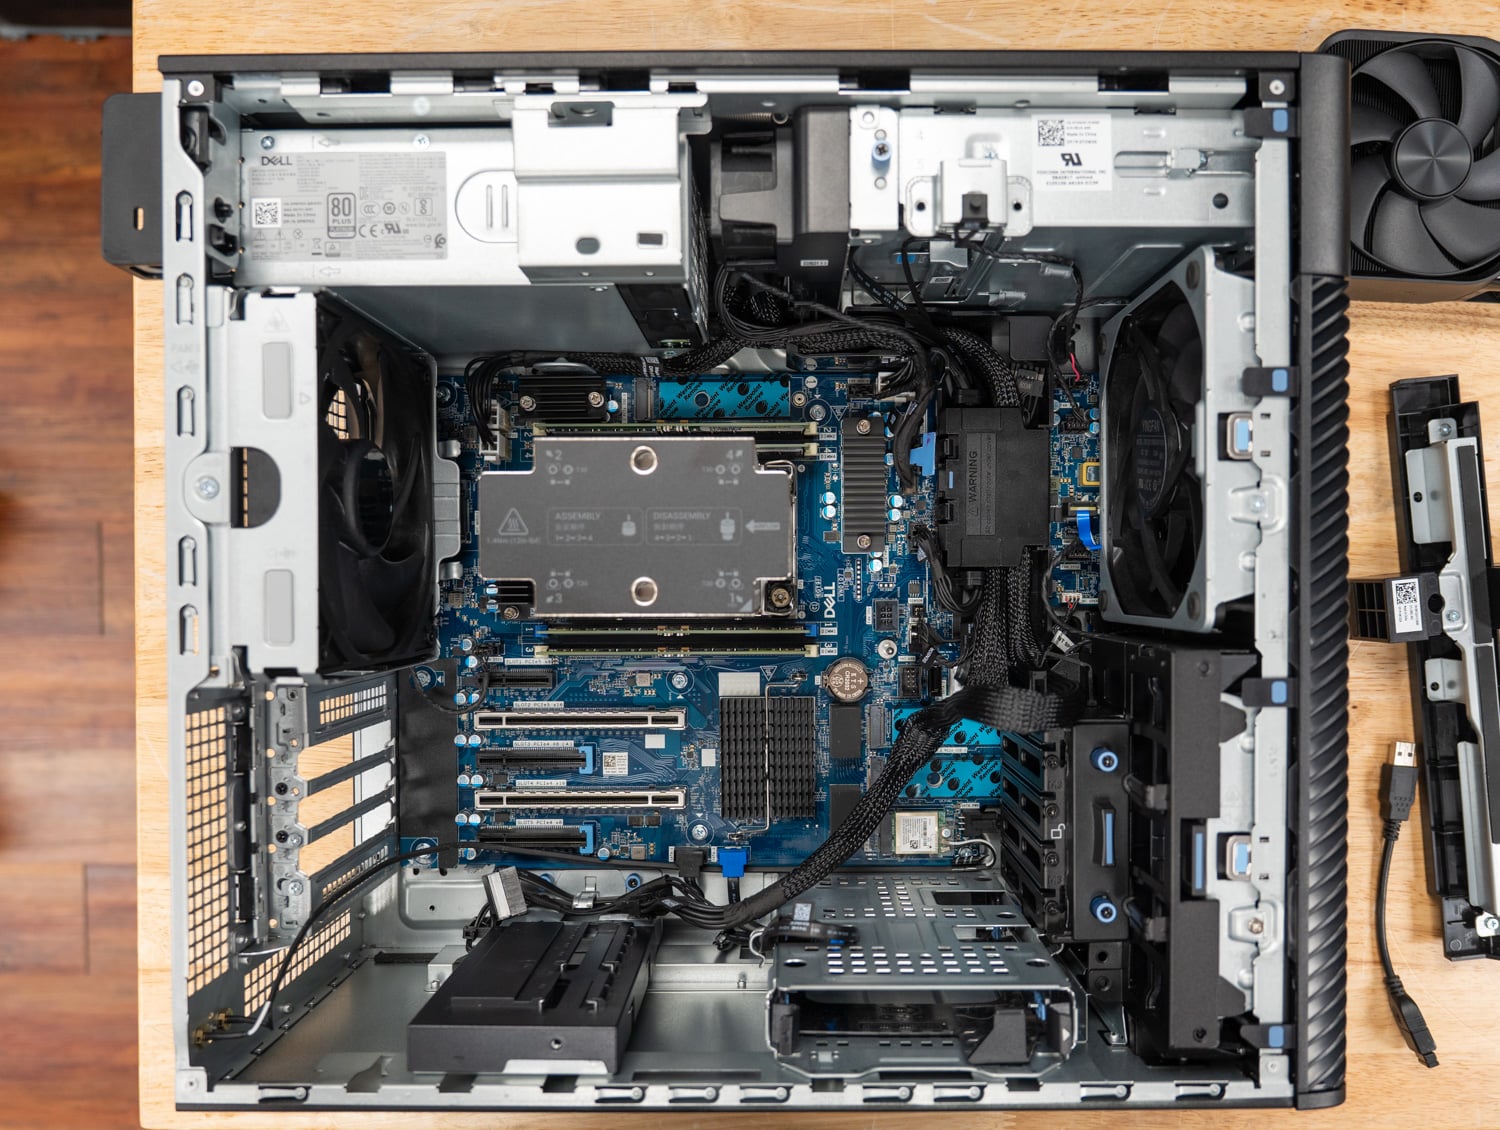
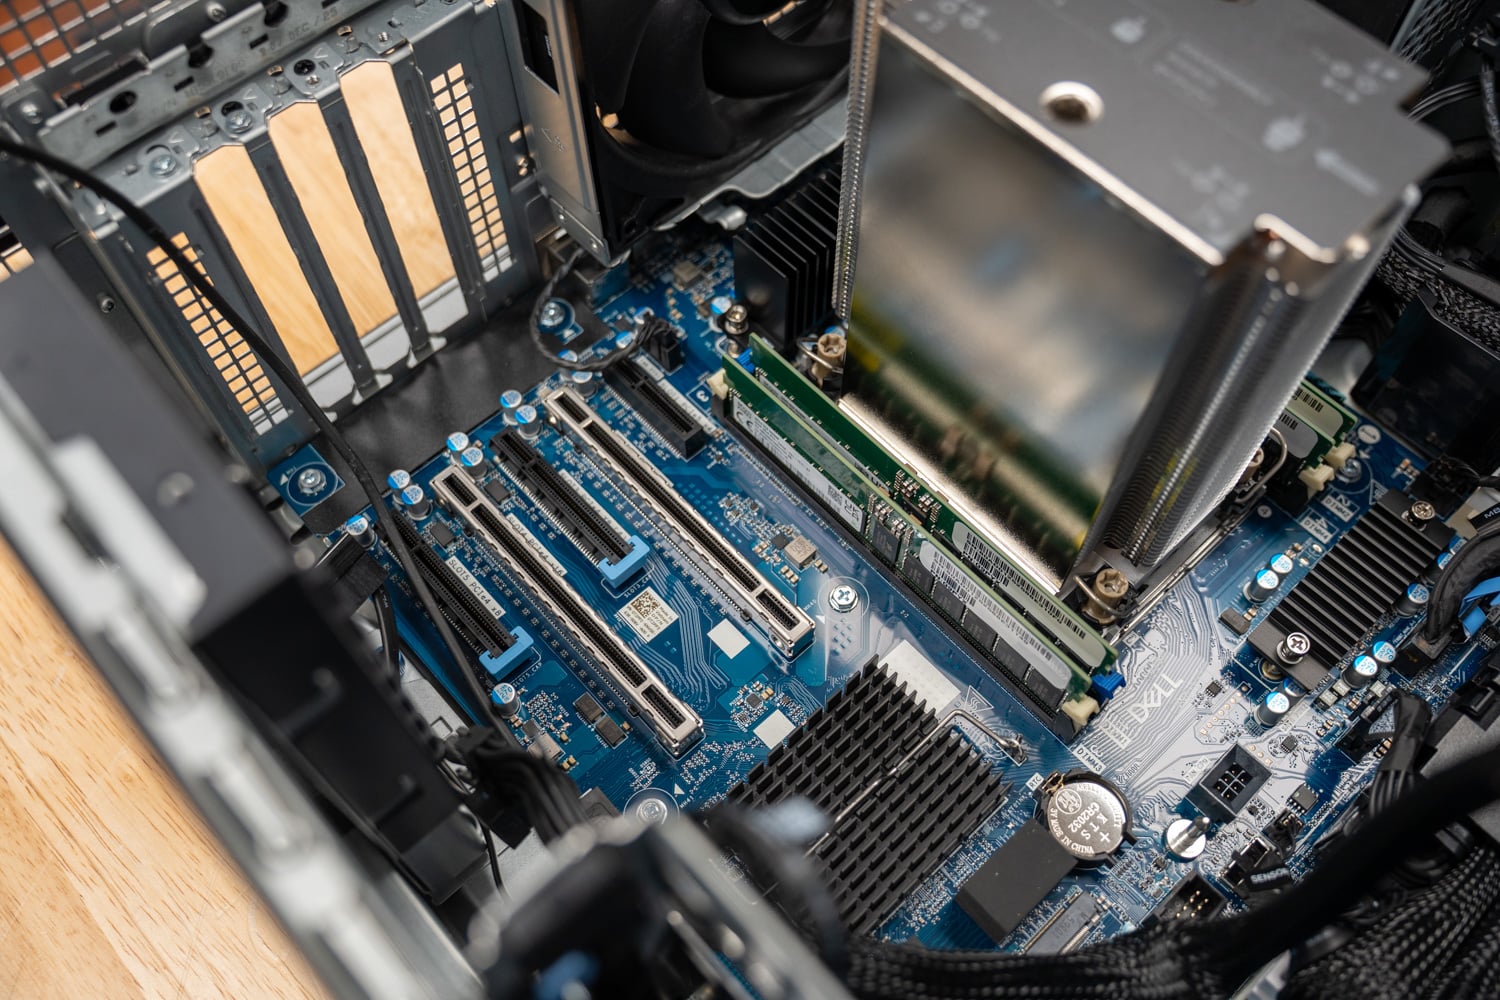
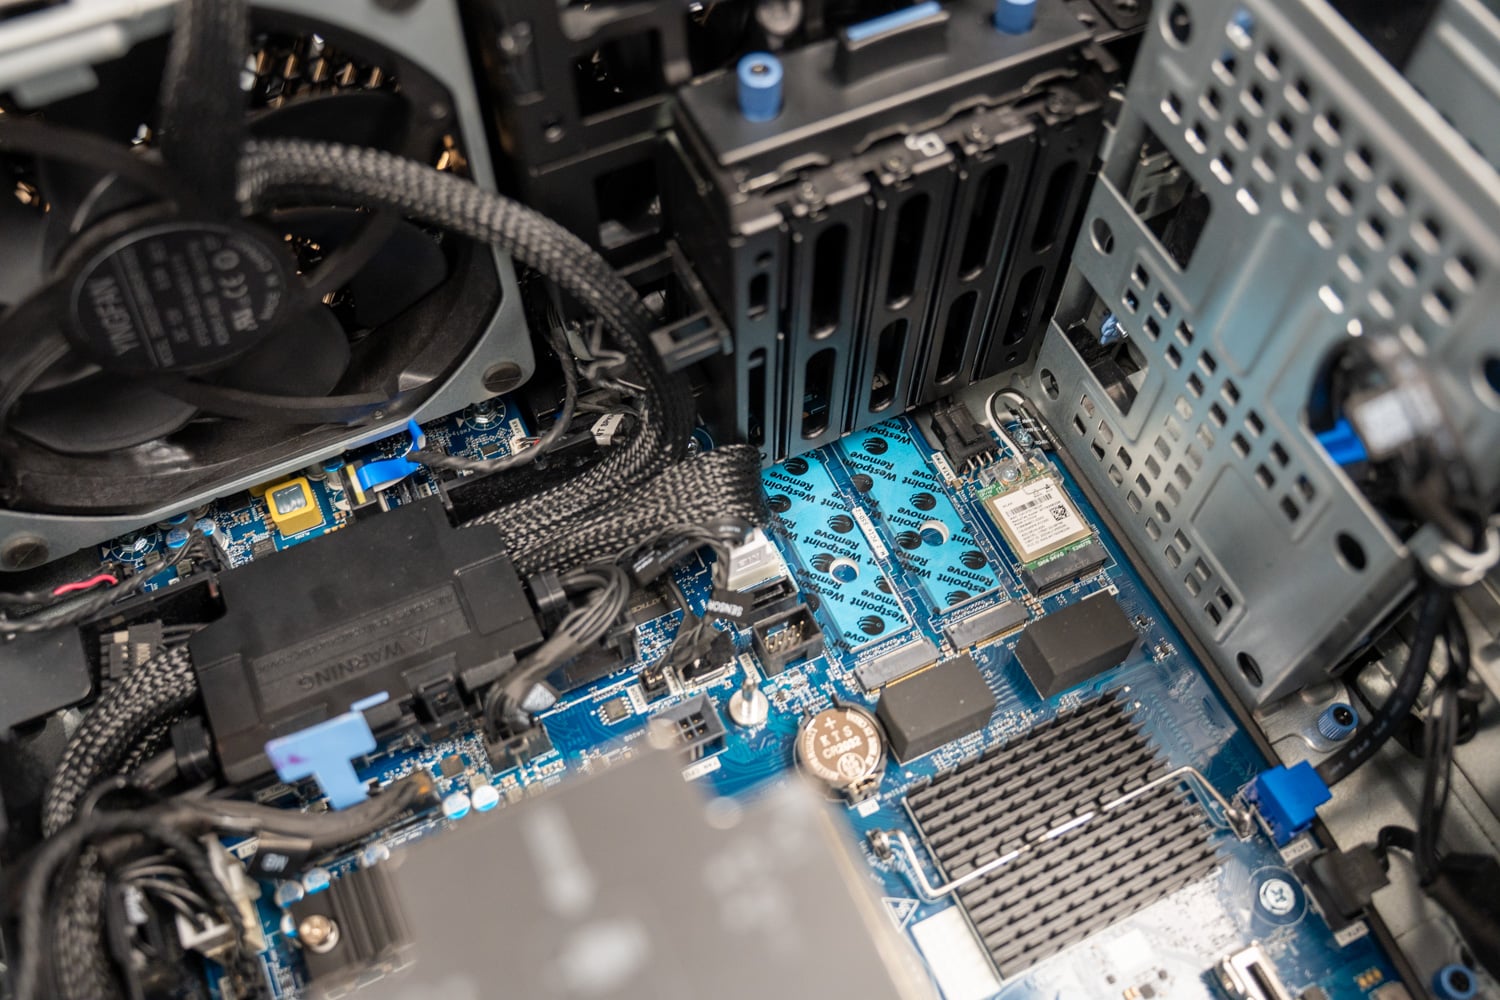
内部布局与Pro Max塔式机箱相同:处理器和四个DIMM内存插槽位于扩展区域上方,Gen5 x16插槽中的GPU由一个固定支架支撑,电源安装在机箱后部,并配有方便免工具拆卸的把手。所有五个插槽均为全高插槽:插槽2为Gen5 x16 GPU插槽,插槽1为Gen5 x4插槽,其余三个为Gen4插槽,其中一个为x16插槽,两个为开放式x8插槽,可用于安装网卡、存储卡或第二块GPU。三个内置M.2 2280 Gen5插槽和两个3.5英寸SATA硬盘位位于前置E3.S扩展槽的后方。
前置I/O接口包括一个耳机插孔、一个支持PowerShare的20Gbps USB-C接口、一个10Gbps USB-C接口、两个USB-A接口以及一个可选的SD卡槽。后置接口包括音频线路输出、一个20Gbps和一个10Gbps USB-C接口、两个支持SmartPower的USB 2.0接口、两个5Gbps USB-A接口、一个千兆以太网接口、一个可选的模块插槽(可安装5GbE网卡或两个额外的USB-A接口)以及一个可选的传统串口。我们评测的这台机器在内部M.2 2230插槽中加装了联发科MT7925 Wi-Fi 7网卡,并在其600W显卡上加装了英特尔E810-XXV 25GbE网卡。

戴尔 Pro Precision 9 T2 规格
| 规格 | 戴尔 Pro Precision 9 T2 (PW9T2260) |
|---|---|
| 平台概述 | |
| 处理器选项 | 英特尔至强 634(12 核,150W)、636(12 核,170W)、638(16 核,180W)、654(18 核,200W)、656(20 核,210W)、658X(24 核/48 线程,144MB L3 缓存,250W) 经测试的 Xeon 658X |
| 内存 | DDR5 RDIMM ECC,5600 或 6400 MT/s,四个插槽,最大支持 1TB (4 x 256GB) 经测试,内存容量为 128GB (4 x 32GB) DDR5-6400。 |
| 图形选项 | NVIDIA RTX A400、A1000、RTX PRO 2000/4000/4500/5000/6000 Blackwell (600W)/6000 Blackwell Max-Q (300W)、A800 Active;AMD Radeon Pro W7400;部分显卡支持双路和三路配置 测试显卡:RTX PRO 6000 Blackwell Max-Q 工作站版,96GB GDDR7 |
| 存放 | 前置 FlexBay:最多可安装两块 E3.S / NVMe 硬盘,外加一个可选的超薄光驱位,或一个 3.5 英寸 SATA 硬盘位 内部:3 个 M.2 2280 Gen5 NVMe 插槽,2 个 3.5 英寸 SATA 插槽 RAID:Intel VMD with VROC by Graid Technology(RAID 0 启动,内部 RAID 0) 测试结果:2块2TB E3.S Gen5 NVMe固态硬盘组建RAID 0阵列(4,097GB) |
| 扩展 | 插槽 1:Gen5 x4;插槽 2:Gen5 x16;插槽 3:Gen4 x8(x4 电气规格,开放式);插槽 4:Gen4 x16;插槽 5:Gen4 x8(开放式);M.2 2230 Wi-Fi 插槽 |
| I / O | |
| 前端口 | 1 个支持 PowerShare 的 20Gbps USB-C 接口、1 个 10Gbps USB-C 接口、1 个支持 PowerShare 的 5Gbps USB-A 接口、1 个 5Gbps USB-A 接口、耳机插孔、可选 SD 卡槽 |
| 后端口 | 1 个 USB-C 20Gbps 接口、1 个 USB-C 10Gbps 接口、2 个 USB 2.0(支持 SmartPower)、2 个 USB-A 5Gbps 接口、音频线路输出接口、1 个 RJ45 千兆以太网接口、可选 5GbE 或双 USB-A 模块、可选串口 |
| 网络测试 | 英特尔 E810-XXV DA2 双端口 25GbE SFP28(为 600W GPU 运行已移除);联发科 MT7925 Wi-Fi 7,蓝牙 5.4 |
| 力量和体能 | |
| 电源供应 | 标准功率750瓦;可选功率500瓦或1500瓦;测试功率为1500瓦。 |
| 尺寸 | 387 x 187.7 x 438毫米(15.23 x 7.38 x 17.24英寸) |
| 重量 | 最小重量 11.6 公斤(25.57 磅),最大重量 21.8 公斤(48.06 磅) |
| 操作系统 | Windows 11 专业工作站版(经测试)或 Ubuntu Linux 24.04 LTS |
| 管理和安全 | 英特尔博锐技术、TPM 2.0、机箱入侵开关、可锁定面板选项、Kensington 锁槽 |
| 价格筛选 | Dell.com 基本配置售价 3,978 美元(Xeon 634、16GB 内存、RTX A400 显卡、256GB 内存、750W 电源);测试配置售价约为 28,300 美元(Xeon 658X、128GB DDR5-6400 内存、RTX PRO 6000 Max-Q 显卡、两块 2TB Gen5 FlexBay 硬盘组建 RAID 0 阵列、1500W 电源、25GbE 以太网、Wi-Fi 7),以上价格为戴尔官网 2026 年 2 月 19 日公布的价格。 |
这个价格有两个需要注意的地方。戴尔官网的配置器将FlexBay硬盘列为2TB M.2 2280 Gen5模块,单价1,700美元,而我们测试的这台机器配备的是E3.S硬盘。我们已经询问戴尔,E3.S硬盘何时会在网上架。戴尔也坦言,很少有商用工作站会以网络价格出售,所以28,300美元的价格应该被视为上限,批量购买和合同价格通常会低于这个上限。内存和显卡加起来就占了19,090美元,而显卡的价格无论选择300W还是600W的显卡都一样。
戴尔将这款评测样机的测试价格定为 31,700 美元,该价格在我们定价的配置基础上增加了 E810-XXV 25GbE 适配器、Wi-Fi 7、光驱和三年 ProSupport 服务。
测试设置和方法
本次评测中的所有结果均来自我们编写的 Windows 客户端基准测试套件 sr-client 1.2,该套件使用戴尔出厂 Windows 镜像、戴尔驱动程序以及 NVIDIA 驱动程序 596.71,并运行完整配置。所有四种配置均采用相同的设置:Windows 电源模式设置为“最佳性能”,所有睡眠和显示器关闭定时器均已禁用,Windows 防火墙和 UAC 提示已关闭,VBS 和内存完整性功能保持出厂默认设置。每个结果均为多次运行的中位数,如果测试结果的偏差超过 2%,则该套件会重新运行测试才会接受该结果。
以下四种配置均为两台主机和两块GPU。Pro Precision 9 T2 使用其 Max-Q 显卡运行了全套测试,之后又使用我们 Pro Max Tower T2 中的 600W RTX PRO 6000 Blackwell 显卡再次运行测试。Pro Max Tower T2 则依次运行了这两块显卡,因此同一台主机内不同 GPU 列之间的区别仅在于显卡型号,而同一 GPU 下不同主机列之间的区别仅在于平台。Core T2 的硬盘是其标配的单块 2TB Gen5 M.2 固态硬盘,而 Xeon T2 的硬盘是其双硬盘 E3.S 条带,因此存储和模型加载行比较的是它们各自的配置。
| 配置 | 中央处理器 | 内存 | GPU | 启动盘 | 操作系统和电源模式 |
|---|---|---|---|---|---|
| 戴尔 Pro Precision 9 T2 (PW9T2260),Max-Q | 英特尔至强 658X,24 核/48 线程,250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q 工作站版,300W,96GB | 2 x 2TB E3.S Gen5 NVMe,VROC RAID0(4,097GB 启动卷) | Windows 11 专业工作站版 25H2,最佳性能 |
| 戴尔 Pro Precision 9 T2 (PW9T2260),600W | 英特尔至强 658X,24 核/48 线程,250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell 工作站版,600W,96GB | 2 x 2TB E3.S Gen5 NVMe,VROC RAID0(4,097GB 启动卷) | Windows 11 专业工作站版 25H2,最佳性能 |
| 戴尔 Pro Max Tower T2 (FCT2250),Max-Q | 英特尔酷睿Ultra 9 285K处理器,24核/24线程,125瓦 | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q 工作站版,300W,96GB | SK海力士PCB01 2TB,第五代 x4 | Windows 11 专业版 26H2,最佳性能 |
| 戴尔 Pro Max Tower T2 (FCT2250),600W | 英特尔酷睿Ultra 9 285K处理器,24核/24线程,125瓦 | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell 工作站版,600W,96GB | SK海力士PCB01 2TB,第五代 x4 | Windows 11 专业版 26H2,最佳性能 |
这里首次展示了多项测试,首先是LLM服务测试,它运行llama-server,使用四个模型,并逐步增加并发请求数,从单个请求到GPU内存所能容纳的最大请求数,并报告总吞吐量、单用户吞吐量、首令牌到达时间以及每个输出令牌的生成时间。图像生成测试使用FLUX.2 klein 4B、Z-Image Turbo 6B和Qwen-Image 20B三种模型,分别以Q4_0、Q8_0和BF16权重渲染1024×1024像素的图像,并使用PSNR和SSIM对量化后的输出结果进行评分(以BF16为基准),从而同时评估速度和保真度。编码代理测试现在运行在Crush平台上,而用户旁代理测试则采用了一种改进的方法,将浏览器基准测试限制在三个完整的运行周期内。
表格中反复出现三个标签,以“N/A”开头,表示该测试不适用于该硬件:例如,285K 的 SMT 单核测试(该处理器不具备 SMT 功能),以及 Xeon 的 OpenBLAS 顶级核心类别测试(该处理器拥有 24 个核心,属于同一类别)。“Partial”表示测试套件接受的结果,并附有说明,通常是指在编码代理层级中,三次运行中有一次测试失败。由于两台台式机均未将 CPU 或 GPU 温度暴露给测试套件的传感器,因此本次评测报告的是每次测试的平均 CPU 时钟频率,而非温度表。
本地人工智能性能
所有配置均配备 96GB GDDR7 显存,模型容量毋庸置疑,我们本地 AI 测试套件的每个层级都可以在所有四款显卡上运行。因此,测试结果会根据 GPU 功耗限制而出现差异:当测试受限于显存带宽时,Max-Q 显卡和 600W 显卡的性能相近;而当测试受限于计算能力时,600W 显卡则更胜一筹。CPU 平台的影响通常很小,但即便有影响,其影响方向也值得关注。
MLPerf 客户端 v2.0
MLPerf 客户端运行 Llama 3.1 8B 和 Phi-4-mini,涵盖五种提示类别,并报告首次令牌到达时间和之后的令牌生成率(以各类别几何平均值表示),所有配置均使用基于 CUDA 的 llama.cpp 作为引擎。代理场景运行 Llama 3.1 8B,分别作为数据分析代理和软件工程代理,在多个回合中调用工具。

| MLPerf 客户端 v2.0 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Llama 3.1 8B,首次到达令牌的时间,几何平均值(秒,越低越好) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B,令牌速率,几何平均值(令牌/秒) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini,首次令牌到达时间,几何平均值(秒,越低越好) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini,令牌率,几何平均值(令牌/秒) | 345.9 | 379.0 | 351.0 | 374.3 |
| 数据分析代理,端到端(s,数值越低越好) | 17.5 | 15.7 | 16.2 | 14.4 |
| 数据分析代理,代币速率(tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWE Agent,端到端(s,数值越低越好) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWE 代理,代币速率(tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
Max-Q显卡在Xeon塔式机上运行Llama 3.1 8B测试,每秒生成230.9个令牌,在Core塔式机上运行230.0个令牌;在Phi-4-mini测试中,每秒生成345.9个令牌,在Core塔式机上运行351.0个令牌,两者使用相同的GPU执行相同的任务。600W显卡在Xeon塔式机上将每秒生成令牌的数量分别提升至252.8个和379.0个,提升约9%;同时,Llama测试中第一个令牌的生成时间从0.082秒缩短至0.059秒,缩短了28%。由于快速处理受计算能力限制,解码受带宽限制,且两张显卡共享同一显存,因此功耗限制在第一个令牌的生成时间上比在后续令牌的生成时间上更为明显。
在代理场景中,CPU平台的优势得以体现。数据分析代理在配备Max-Q显卡的Core T2上耗时16.2秒,在Xeon T2上耗时17.5秒;软件工程师代理的耗时分别为14.6秒和16.2秒,其中Xeon的工具调用阶段分别比Core T2慢约1.5秒。两者的令牌生成率相差不到1%,因此差异在于模型调用之间CPU上运行的工具,285K的更快核心能够更快地完成这些任务。
模型加载
此测试使用 Ollama 对本地模型进行计时,从硬盘读取到生成第一个令牌,分别在冷态(文件缓存已清空)和热态(文件已在内存中)下进行。测试结果会报告冷态加载期间的硬盘读取速度、权重到达 GPU 内存的时间,以及负载效率指标,该指标将负载期间的读取速度与硬盘 1MB 的顺序读取上限进行比较。在 96GB 显存的情况下,所有三个层级的磁盘均运行:gpt-oss:20b 占用 12.8GB,Qwen3.6-35B-A3B 占用 21.1GB,gpt-oss:120b 占用 60.9GB。

| 模型加载(内存映射开启) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| gpt-oss:20b,冷加载到第一个标记(s,数值越小越好) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b,热加载到第一个标记(s,数值越小越好) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b,到达 GPU 内存,冷启动(s,数值越低越好) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B,冷加载到第一个令牌(s,数值越小越好) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B,热加载到第一个令牌(s,数值越小越好) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b,冷加载到第一个标记(s,数值越小越好) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b,热加载到第一个标记(s,数值越小越好) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b,冷加载期间的读取吞吐量(MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b,到达 GPU 内存,冷启动(s,数值越低越好) | 11.33 | 11.57 | 7.74 | 7.63 |
| 从 gpt-oss:20b 交换后加载 gpt-oss:120b(s,数值越低越好) | 14.30 | 13.97 | 11.89 | 11.93 |
| 驱动器容量上限,磁盘速度 1MB 顺序读取 (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
Core T2 在所有模型的加载速度上都更快,这主要归功于其硬盘。gpt-oss:120b 在 Core T2 上冷启动仅需 28.54 秒即可完成首次数据写入,而 Xeon T2 则需要 32.06 秒;61GB 的权重数据到达 GPU 内存也仅需 7.74 秒,而 Xeon T2 则需要 11.33 秒。单块 PCB01 的读写速度达到了 11,633MB/s,接近其 11,563MB/s 的 DiskSpd 上限;而 E3.S 条带的读写速度为 9,875MB/s,接近其自身 11,306MB/s 的上限。RAID 卷读取大块数据的速度几乎与单块硬盘一样快,但在 Ollama 的内存映射加载路径下无法保持如此高的速度。
热加载会将差距缩小到一两秒,因为文件已经加载到系统内存中,剩下的只是传输到显存以及 llama.cpp 的设置:在 Xeon T2 上,gpt-oss:120b 的加载时间为 27.18 秒,而 Xeon T2 为 25.58 秒;在 gpt-oss:20b 上,热加载时间为 7.52 秒,而 Xeon T2 为 6.60 秒。正如预期的那样,GPU 的功耗限制对加载时间没有明显影响。
编码代理
Crush 是一个终端编码代理,它驱动由 Ollama 服务的本地模型完成一个固定代码库中的编码任务,最多需要三轮才能通过代码库中的 11 个测试;我们报告了三次运行的平均耗时、成功次数以及生成率。耗时取决于模型决定使用的工具调用次数和令牌数量,而这些数量每次运行都会有所不同,因此生成率是更清晰的硬件比较指标。用户旁代理测试同时运行代理和 Speedometer,并报告它们彼此之间的速度影响。

| 粉碎编码代理 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| S 级,gpt-oss:20b,64K 上下文 | ||||
| 墙面停留时间,中位数(秒,数值越低越好) | 55.1 | 99.8 | 57.2 | 43.2 |
| 成功次数(共 3 次) | 3 | 2 | 3 | 2 |
| 生成速率(tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| M级,Qwen3.6-35B-A3B,64K上下文 | ||||
| 墙面停留时间,中位数(秒,数值越低越好) | 35.2 | 27.0 | 86.7 | 32.1 |
| 成功次数(共 3 次) | 3 | 3 | 3 | 3 |
| 生成速率(tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| L级,Qwen3.6-35B-A3B,128K上下文 | ||||
| 墙面停留时间,中位数(秒,数值越低越好) | 38.1 | 30.6 | 74.1 | 58.8 |
| 成功次数(共 3 次) | 3 | 3 | 3 | 3 |
| 生成速率(tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Tier W,gpt-oss:120b,128K 上下文 | ||||
| 墙面停留时间,中位数(秒,数值越低越好) | 49.1 | 37.9 | 56.6 | 30.8 |
| 成功次数(共 3 次) | 3 | 3 | 3 | 3 |
| 生成速率(tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| 用户旁边的代理(gpt-oss:20b 和 Speedometer 一起) | ||||
| 代理人旁边的速度表(分数) | 36.6 | 36.7 | 43.2 | 45.2 |
| 速度表减速(x,数值越低越好) | 1.005 | 1.011 | 1.053 | 1.044 |
| 除了速度表之外的代理生成速率(tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| 代理减速(x,数值越低越好) | 1.006 | 1.009 | 1.023 | 0.998 |
所有配置均使用 gpt-oss:120b(套件中最大的模型)完成了 W 层任务的全部三次运行,在 Xeon 塔式机上每秒生成 160.9 至 177.1 个令牌,在 Core 塔式机上每秒生成 158.5 至 174.4 个令牌,其中 600W 显卡在两种配置下均贡献了约 10% 的性能提升。Qwen3.6 任务在所有配置下也全部通过,每秒生成 223 至 253 个令牌。gpt-oss:20b 模型表现不佳:在四种配置中的两种配置下,其 S 层任务在三次运行中均失败一次,其 128K 上下文的 M 层任务(未显示)在所有配置下均至少失败一次,这种模型行为不受硬件影响。
在配备独立显卡和 24 个空闲核心的塔式机上同时运行代理程序和浏览器基准测试几乎不消耗任何资源。运行代理程序后,Xeon T2 的 Speedometer 速度降低了 1.005 倍,Core T2 降低了 1.053 倍,而代理程序的生成速率在所有情况下都变化不到 2%。Xeon T2 在运行代理程序的同时,其 Speedometer 得分为 36.6,低于 Core T2 的 43.2,原因与它单独运行代理程序时得分较低的原因相同:285K 的单核速度较低。
检索增强生成
我们的 RAG 测试使用 nomic-embed-text 嵌入了 20,963 段 SQuAD v1.1 文本,针对 2,000 个问题分别提取出前五段文本,并使用 Phi-4-mini 对其中 400 段文本进行解答,计算其与参考答案的完全匹配度和 F1 值。由于模型规模较小,因此该测试能够评估整个流程,包括 GPU 阶段之间的 CPU 端向量搜索。

| 鲁尔 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 摄入墙壁时间,20,963 次(秒,越低越好) | 128.5 | 125.5 | 108.1 | 103.0 |
| 嵌入率(tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| 检索查询时间,p50(毫秒,数值越低越好) | 30.6 | 27.2 | 23.4 | 18.7 |
| 答案,Phi-4-mini 首次令牌到达时间,p50(秒,越低越好) | 0.099 | 0.087 | 0.089 | 0.083 |
| 回答,快速处理(tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| 答案,生成速率(tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| 问题回答,p50(s,越低越好) | 0.152 | 0.133 | 0.130 | 0.120 |
| 召回率@5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| 答案 F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
在这一流程中,Core T2 的速度更快。它摄取语料库仅需 108.1 秒,而配备相同 Max-Q 显卡的 Xeon T2 则需要 128.5 秒;检索时间中位数为 23.4 毫秒,而 Xeon T2 为 30.6 毫秒;回答问题仅需 0.130 秒,而 Xeon T2 为 0.152 秒。嵌入和检索都存在 CPU 密集型阶段,而 285K 在这些阶段表现更佳。这款 600W 显卡使两个平台上的提示处理速度都提升了 25% 到 30%,Xeon T2 的提示处理速度从每秒 20,318 个词元提升至每秒 26,549 个词元。所有四种配置的准确率都相同,这与相同模型在 0 温度下的预期结果一致。
法学硕士在职
服务测试使用 llama-server 运行 Ministral 3 3B 和 8B(4,096 个提示符,1,024 个输出符)、Qwen3.8 27B 以及 gpt-oss 120B(8,192 个提示符),在权重计算后,分配尽可能多的槽位以适应 GPU 内存,然后逐步增加并发请求数直至达到该上限。我们报告总吞吐量(提示符和输出符的总和)、输出吞吐量、首次获取符的时间以及每个输出符的耗时(取中位数)。在 96GB 的显卡上,gpt-oss 120B 占用 64 个槽位,并配备 22.5GiB 的键值缓存;Qwen3.8 27B 占用 8 个槽位;而两个 Ministral 模型在其各自的上下文中占用 4 个槽位。

| llama-server,gpt-oss 120B,8,192 个令牌提示符,1,024 个令牌输出 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 1. 并发:输出吞吐量(tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 个并发用户:首次到达令牌的时间,中位数(毫秒,数值越低越好) | 1,241 | 918 | 1,238 | 923 |
| 1 个并发:每个输出令牌的耗时,中位数(毫秒,数值越低越好) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 个并发:总吞吐量(tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 个并发用户:每个用户的输出(tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 个并发用户:首次到达令牌的时间,中位数(毫秒,数值越低越好) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 个并发:总吞吐量(tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 个并发用户:每个用户的输出(tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 个并发用户:首次到达令牌的时间,中位数(毫秒,数值越低越好) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 个并发:每个输出令牌的耗时,中位数(毫秒,数值越低越好) | 163.0 | 141.3 | 152.7 | 126.3 |
单个用户在 Max-Q 卡上以每秒 160.6 个令牌的速度获取 gpt-oss 120B 数据,在 600W 卡上则为每秒 182.7 个令牌,第一个令牌在 8,192 个令牌的提示符后分别耗时 1,241 毫秒和 918 毫秒。在 Max-Q 卡上加载 64 个并发请求后,总吞吐量提升至每秒 3,296 个令牌,在 600W 卡上提升至每秒 3,805 个令牌,但代价是每个用户每秒分别损失 5.7 个令牌和 6.6 个令牌,第一个令牌的到达时间分别延长至 4.3 秒和 3.5 秒。并发请求数在 4 到 32 个之间趋于平缓,并在 64 个并发请求时再次跃升,此时批量处理最终抵消了较长的提示符时间。

| llama-server,在满足最高并发要求的情况下输出吞吐量(tok/s) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Ministral 3 3B 推理,4 并发 | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministral 3 8B 推理,4 并发 | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B,8 个并发 | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B,64 个并发进程 | 366.3 | 422.8 | 392.3 | 468.9 |
| 单次请求输出吞吐量(tok/s) | ||||
| 部长3 3B 推理 | 232.1 | 241.8 | 232.1 | 246.0 |
| 部长3 8B 推理 | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
在Max-Q平台上,对于单个用户而言,高密度Qwen3.8 27B模型速度最慢,每秒仅能处理54.0个令牌,因为每个令牌都会访问全部270亿个参数。而混合专家模型gpt-oss 120B虽然磁盘占用空间是前者的四倍,但运行速度却快了3倍。600W显卡的优势在高密度模型上最为显著,在8个并发请求的情况下领先24%,而在Ministral 3B模型上优势最小,约为7%。除了64个请求的gpt-oss场景外,两款显卡在其他所有场景下的性能差距都在3%左右。在gpt-oss场景下,无论使用哪款显卡,Core T2都领先7%到11%,因此服务器在该批处理大小下的CPU端工作更倾向于速度更快的核心。
影像产生
图像生成测试使用三种扩散模型和三种权重精度渲染 1024×1024 的图像,并报告每幅图像的渲染时间、去噪率以及权重占用的 GPU 内存。此外,该测试还使用相同的种子在 BF16 精度下渲染图像,并使用 PSNR 和 SSIM 对 Q4_0 和 Q8_0 的输出结果进行评分,从而量化量化对图像质量的影响。

| 图像生成,1024×1024 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| FLUX.2 klein 4B,4 步 | ||||
| Q8_0:每张图像的耗时(越低越好) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0:每分钟图像数 | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16:每张图像的耗时(越低越好) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B,8 步 | ||||
| Q8_0:每张图像的耗时(越低越好) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0:每分钟图像数 | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16:每张图像的耗时(越低越好) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B,20 步 | ||||
| Q4_0:每张图像的耗时(越低越好) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0:每张图像的耗时(越低越好) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16:每张图像的耗时(越低越好) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0:每分钟图像数 | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16:权重的GPU内存(GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
扩散运算受计算能力限制,600W 显卡充分证明了这一点:在 Max-Q 服务器上,Qwen-Image 20B 在 Q8_0 模式下每张图像的处理时间为 26.1 秒,而在 Xeon 塔式机上的 600W 显卡上则为 19.7 秒,每分钟图像处理速度提升了 33%;Z-Image Turbo 的速度提升了 32%,FLUX.2 klein 的速度提升了 21%。CPU 平台在这里无关紧要,除了服务器启动之外,两台塔式机在每一项的性能指标上都相差不到 1%;在服务器启动时,Xeon T2 的 RAID 卷加载权重需要几秒钟的时间。
| 与 BF16(相同种子)相比的量化保真度 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| PSNR(dB,越高越好)/ SSIM(越高越好) | ||||
| FLUX.2 klein 4B,Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 klein 4B,Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B,Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B,Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B,Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B,Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
由于输出取决于权重而非硬件,因此四种配置的保真度行完全相同。Q8_0 能够以 0.938 至 0.987 的 SSIM 值和 28 至 36 dB 的 PSNR 值重现 BF16 图像,而 Q4_0 的 SSIM 值降至 0.75 至 0.79,PSNR 值降至 18 至 22 dB,情况截然不同。在 96GB 的存储卡上,没有理由运行低于 Q8_0 的模型;Qwen-Image 的 BF16 权重大小为 45.3GiB,并且在所有三个模型上渲染 BF16 的速度都与 Q8_0 相当或略快,因为 Q8_0 路径需要花费时间进行反量化。
中央处理器性能
这两款处理器在我们的CPU测试套件中呈现出泾渭分明的分界线。在需要使用所有核心的测试中,Xeon 658X 在大多数测试中都领先27%到150%,而且向量范围越广、内存流量越大,其优势就越明显。而在仅使用一个或几个线程的测试中,Core Ultra 9 285K 凭借其5.7GHz的P核心,相对于拥有更高缓存和内存延迟的4.9GHz Xeon核心,领先13%到31%。600W GPU对Xeon全核性能的影响在每个表格中都有体现,并在时钟频率部分进行了总结。
Cinebench 2026 和持续负载
Cinebench 2026 使用 Maxon 的 Redshift 引擎在 CPU 上渲染场景,并分别测试单核、SMT 单核(一个物理核心上运行两个线程)和多核的吞吐量。随后,我们进行一个持续循环测试,重复多核运行约 30 分钟,并将稳定状态与第一次运行进行比较。

| Cinebench 2026(分数越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 单核 | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT单核 | 599.1 | 601.0 | 不适用(无SMT) | 不适用(无SMT) |
| 多核心 | 12,322 | 11,705 | 8,856 | 8,838 |
| 持续循环,第一次 | 12,201 | 11,731 | 8,717 | 8,788 |
| 持续循环,稳态 | 12,328 | 11,764 | 8,825 | 8,844 |
| 稳态/首次通过 | 1.010 | 1.003 | 1.012 | 1.006 |
| 持续循环,稳态 CPU 时钟频率(MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
安装 Max-Q 显卡后,658X 的多核跑分达到 12,322 分,比 285K 的 8,856 分高出 39%,并在 30 分钟的循环测试中保持 12,328 分的稳定成绩,比第一次测试高出 1%。单核跑分的情况则相反:285K 的得分为 564.4 分,而 Xeon 的得分为 454.1 分;Xeon 的单核双线程跑分达到 599.1 分,才超过了 285K 的单线程跑分。
换上 600W 显卡后,Xeon 的多核跑分降至 11,705,稳态跑分降至 11,764,下降了 5%,稳态频率也从 4,274MHz 降至 4,178MHz。Core T2 的跑分和稳态频率则没有变化,分别为 8,856 和 8,838。由于测试套件没有记录两台主机上的 CPU 或 GPU 温度,我们无法判断 250W 处理器的性能下降是由于 600W 显卡的散热问题,还是由于两者共享电源预算,我们只能确定,在机箱中使用更大功率的显卡后,其在所有全核测试中的性能都下降了 4% 到 5%。
7-ZIP
7-Zip 内置的基准测试报告 LZMA 压缩和解压缩的吞吐量,单位为每秒千兆指令数 (GSI/s),分别在每个线程上测试一次,以及在单个核心上测试一次。LZMA 依赖于整数吞吐量、分支预测以及缓存和内存延迟,因此它更看重核心数量和快速内存路径,而不是向量宽度。

| 7-Zip(GIPS 值,数值越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 所有帖子 | ||||
| 合计 | 289.6 | 288.9 | 174.8 | 175.7 |
| 压缩 | 276.4 | 273.5 | 151.5 | 151.9 |
| 解压缩 | 303.0 | 304.4 | 198.1 | 199.4 |
| 一条线 | ||||
| 合计 | 8.74 | 8.05 | 10.82 | 10.83 |
| 压缩 | 8.66 | 7.80 | 9.31 | 9.31 |
| 解压缩 | 8.83 | 8.30 | 12.33 | 12.34 |
在 48 个线程的情况下,Xeon 的 GIPS 为 289.6,而 285K 在 24 个线程的情况下为 174.8,领先 66%,压缩性能领先 82%,解压缩性能领先 53%。在单线程情况下,285K 的 GIPS 为 10.82,而 Xeon 为 8.74。当 Xeon 塔式机配备 600W 显卡时,差距进一步扩大到 8.05,这与该配置的较低时钟频率相符。
Blender、HandBrake 和 LLVM
Blender 4.5 使用 Cycles 渲染器在 CPU 上渲染 Monster、Junkshop 和 Classroom 场景。HandBrake 使用 x265(HEVC,中等预设,质量 22)和 SVT-AV1(预设 8,质量 30)对 60 秒的 4K60 视频片段进行软件编码。LLVM 测试使用 Clang 和 Ninja 编译完整的 LLVM 21.1.4 代码树,这是测试套件中最耗时的全核工作负载。

| 《测试》(Test) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Blender 4.5 Monster(采样/分钟,越高越好) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop(样本/分钟) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 课堂(样本/分钟) | 187.2 | 169.2 | 132.5 | 132.3 |
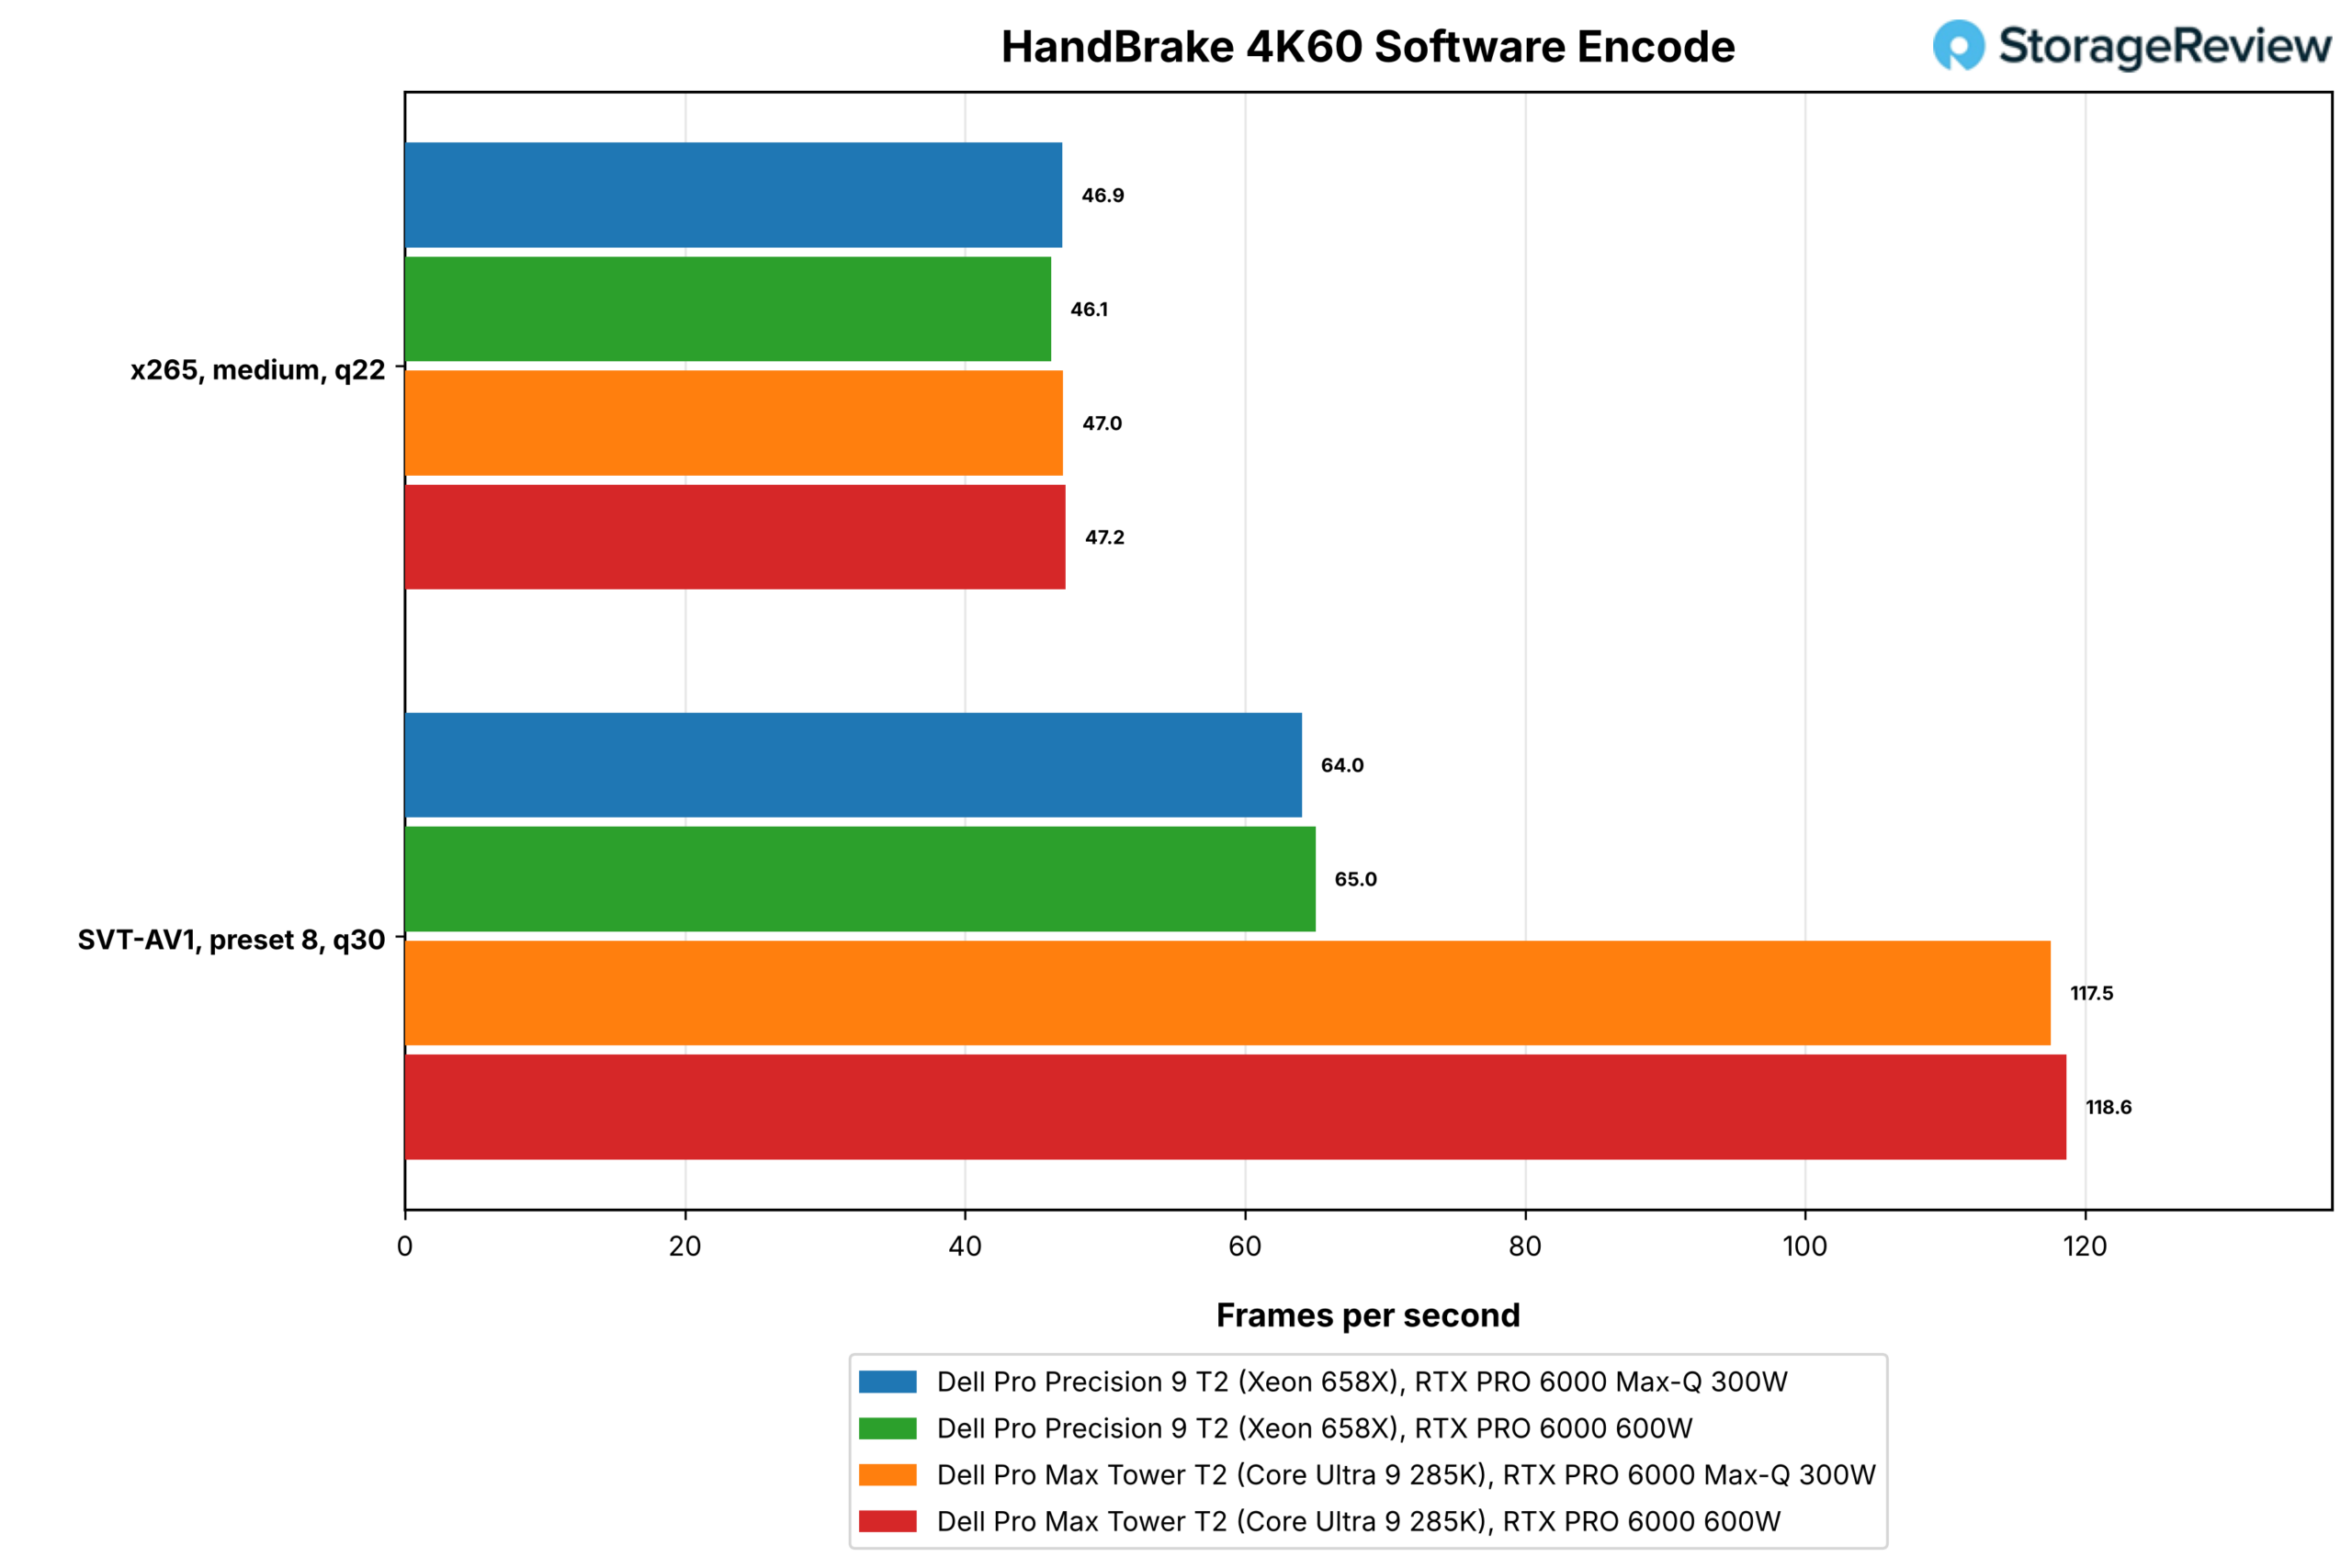
| HandBrake x265,中等画质,q22(帧率越高越好) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1,预设 8,q30(帧/秒) | 64.0 | 65.0 | 117.5 | 118.6 |
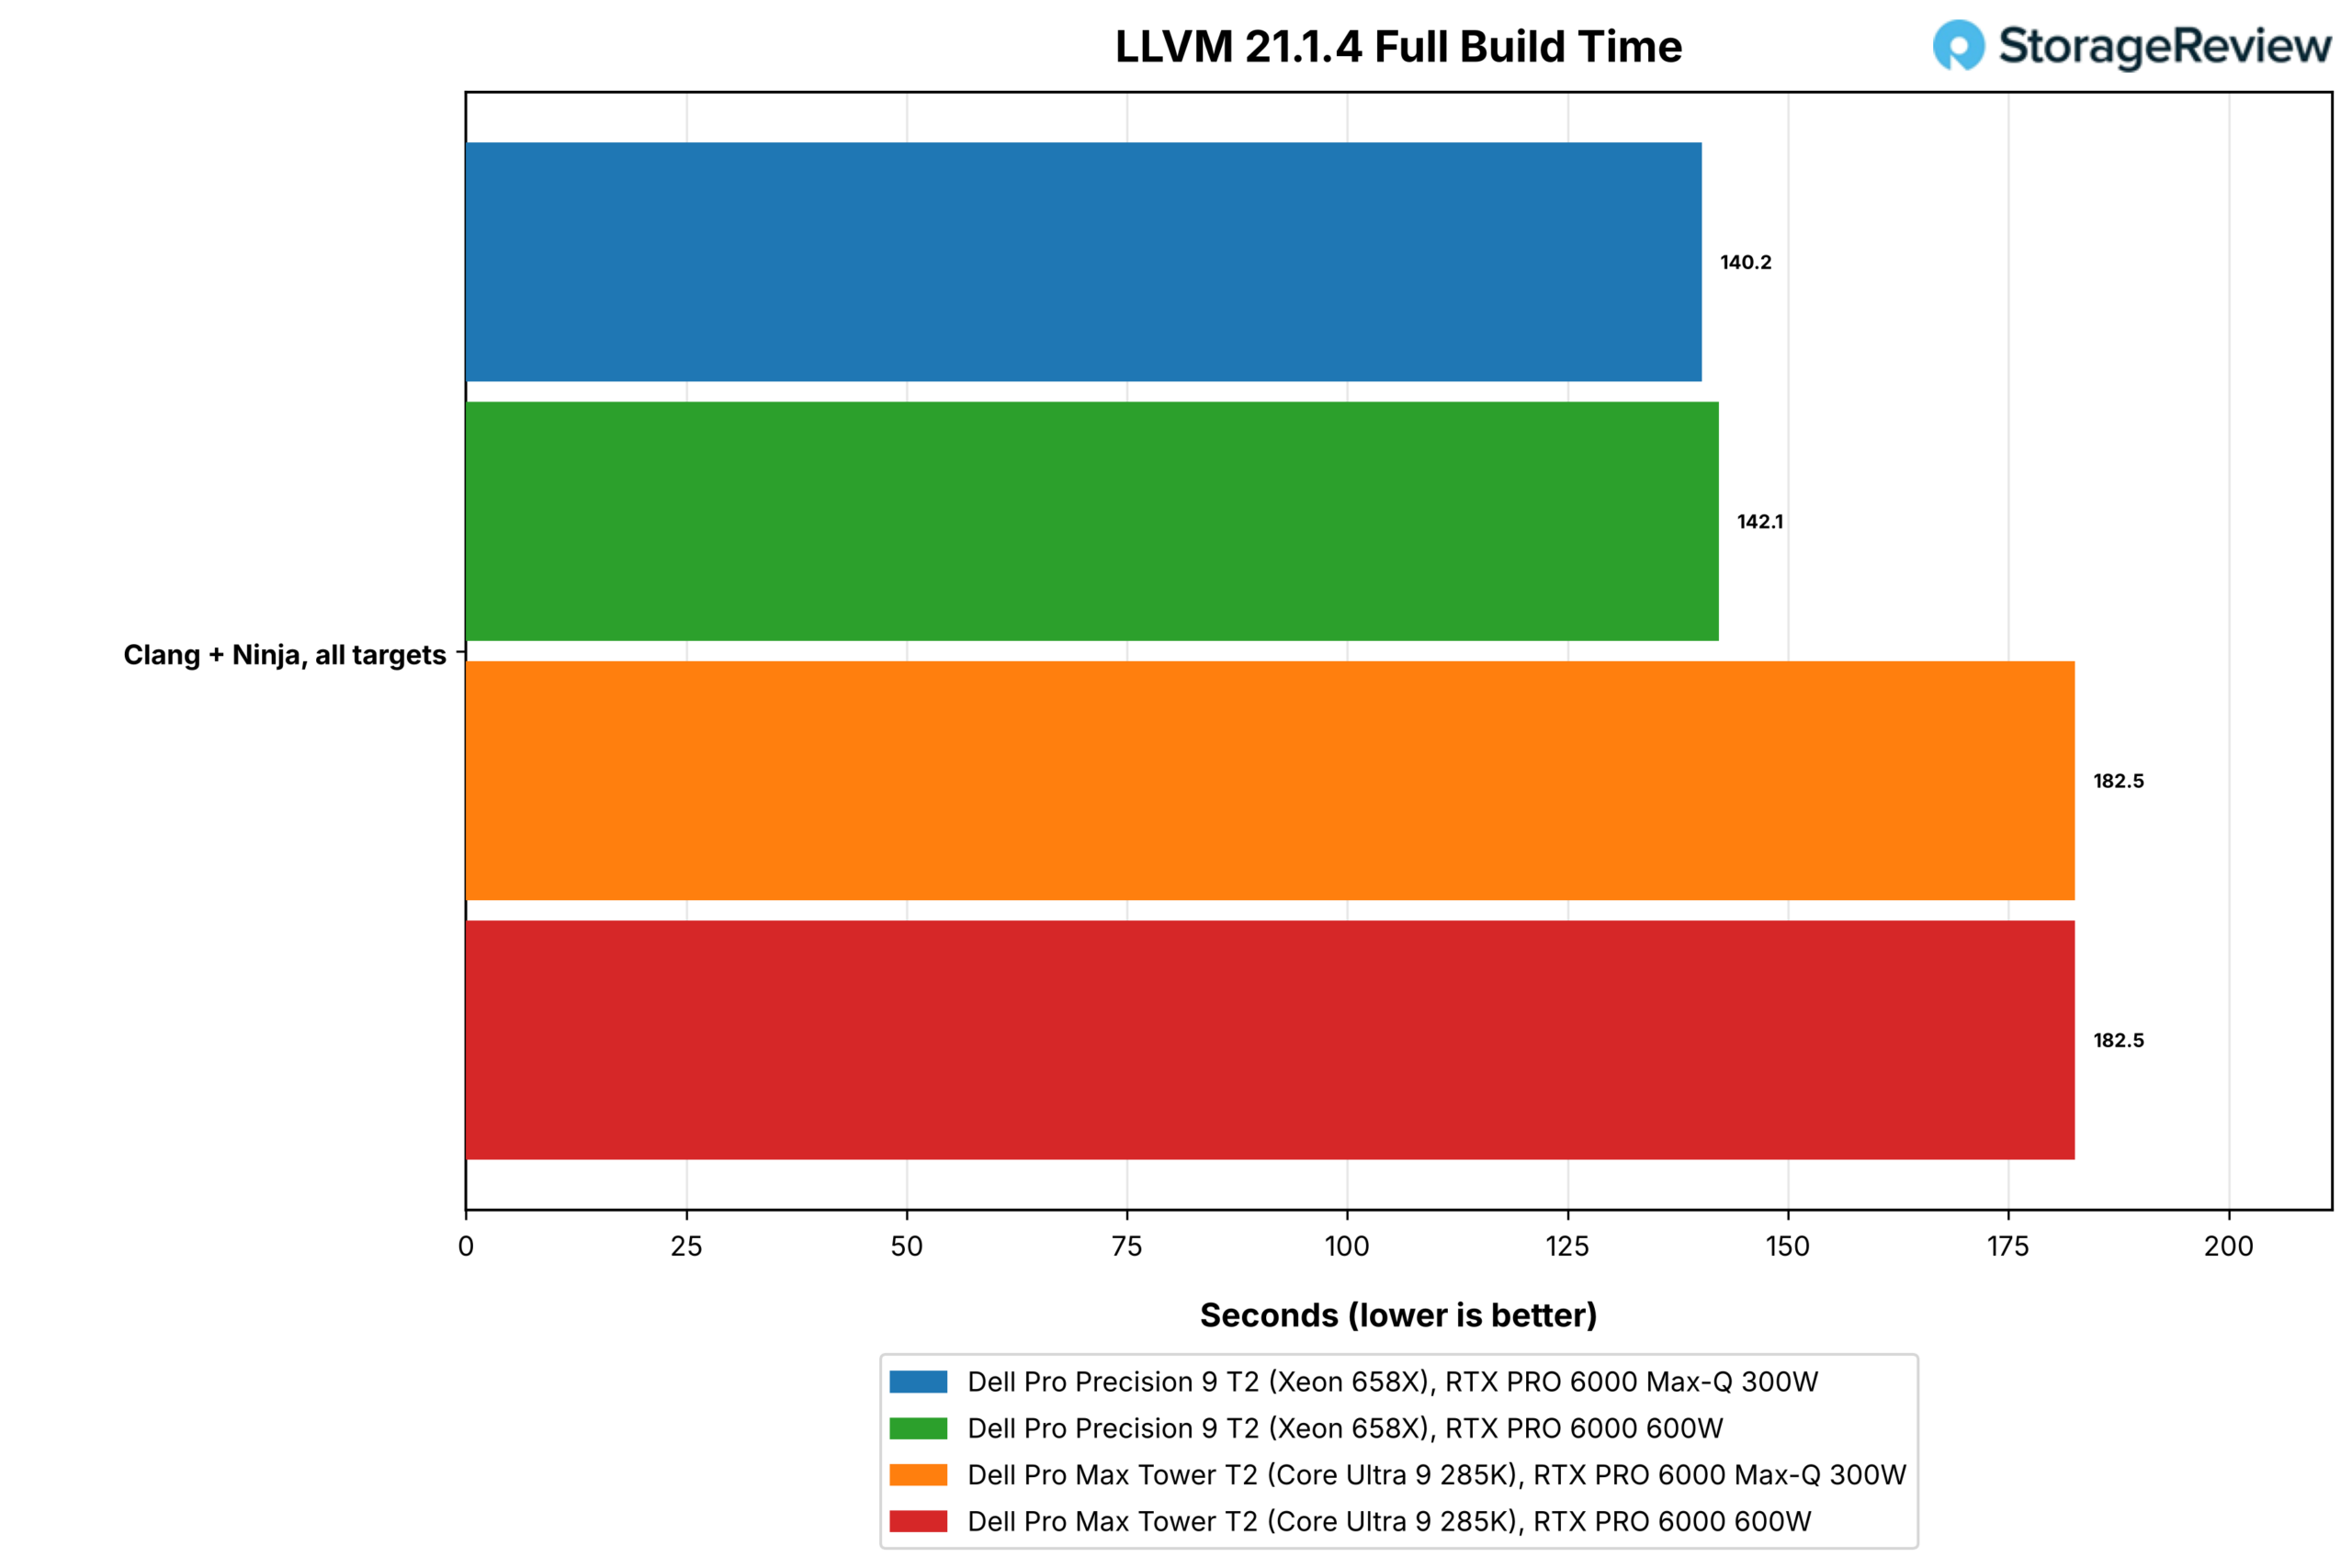
| LLVM 21.1.4 版本(版本号越低越好) | 140.2 | 142.1 | 182.5 | 182.5 |
在渲染 Monster 模型时,Xeon 处理器每分钟采样数达到 366.2,而 285K 处理器仅为 259.6,领先 41%,且在所有三个场景中差距均在两个百分点以内。此外,Xeon 处理器构建 LLVM 仅需 140.2 秒,而 285K 处理器则需要 182.5 秒,Xeon 处理器因此节省了 23% 的时间。然而,在安装 600W 显卡后,Xeon 处理器的 Blender 得分下降了 7% 到 10%,这是该显卡在所有 CPU 测试套件中造成的最高损失。
HandBrake 按编码器线路划分:x265 在中等预设下,Xeon 的运行帧率为 46.9 fps,285K 的运行帧率为 47.0 fps,两者持平;而 SVT-AV1 在预设 8 下,Xeon 的运行帧率为 64.0 fps,而 285K 的运行帧率为 117.5 fps。
我们花了一个下午研究这个问题,结果是逐线程计算得出的。在这个预设设置下,编码器的并行度最高达到 6 级,在 Xeon 处理器上大约占用了九个逻辑处理器的资源;强制使用 AVX2 内核代替 AVX-512 内核并没有改变帧率(帧率从 63.9 fps 提升到 63.8 fps),而将每个物理核心的线程数限制为 1 反而降低了 2%(帧率降至 62.6 fps),因此向量路径和 SMT 调度都不是问题所在。剩下的问题在于 Xeon 核心本身以及核心之间的网络拓扑结构,流水线编码器在每一帧中都会感受到这种拓扑结构的影响,因为它需要等待不同阶段之间的交接。
Stockfish、primesieve、Python 和浏览器
Stockfish 内置的基准测试工具以每秒百万个节点为单位报告国际象棋搜索速度。primesieve 统计所有线程上小于 10^12 的素数,以及单个线程上小于 10^11 的素数。PyPerformance 运行三个 CPython 基准测试(go、nbody 和 regex_compile),并绑定到一个高性能核心上。Speedometer 3.1 则用于测量 Microsoft Edge 浏览器中 Web 应用程序的响应速度。
| 《测试》(Test) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Stockfish 基准测试,所有线程(Mnps,数值越高越好) | 40.87 | 39.17 | 30.10 | 30.63 |
| Stockfish 工作台,单线程(Mnps,数值越高越好) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12,所有线程(s,越低越好) | 7.69 | 7.51 | 6.77 | 6.84 |
| primesieve 1e11,单线程(s,越低越好) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance 的值为(毫秒,数值越低越好) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody(毫秒,数值越低越好) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance 正则表达式编译(毫秒,数值越低越好) | 88.6 | 90.5 | 61.1 | 61.2 |
| Speedometer 3.1,Edge(评分,越高越好) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish 在 48 线程测试中,Xeon 处理器的 Mnps 为 40.87,而 285K 处理器为 30.10。单线程测试中,285K 处理器以 1.99 秒的成绩领先于 Xeon 处理器的 1.65 秒。在所有线程测试中,primesieve 是 285K 处理器唯一胜出的,耗时 6.77 秒,而 Xeon 处理器为 7.69 秒。这是因为 primesieve 的筛法可以放入缓存,并且其性能随时钟频率和核心数的增加而提升。所有单线程测试中,285K 处理器都领先 13% 到 31%:PyPerformance 测试耗时 64.8 毫秒,而 Xeon 处理器为 91.4 毫秒;regex_compile 测试耗时 61.1 毫秒,而 Xeon 处理器为 88.6 毫秒;Speedometer 测试耗时 46.3 毫秒,而 Xeon 处理器为 36.8 毫秒。
浏览器性能指标才是买家在桌面上实际感受到的。虽然36.8的Speedometer得分在绝对值上仍然很快,但它比同机箱的Core塔式机慢了五分之一,任何选择Xeon处理器是为了追求高吞吐量的用户都应该预料到,这台机器的交互性能会比Core Ultra台式机慢一些。
GROMACS、OpenBLAS 和内存
GROMACS 在 16 个核心上运行 benchMEM 分子动力学算例,采用四种不同的线程布局,并报告最佳布局下每天的模拟时间(以纳秒为单位)。我们的 OpenBLAS 测试在所有核心上运行 HPL 风格的双精度 LU 分解求解(三种问题规模)和 DGEMM 矩阵乘法运算,并在 285K 处理器上仅使用其八个 P 核心再次进行测试;Xeon 的 24 个核心属于同一类别,因此这些行不适用。STREAM 测量持续内存带宽,延迟行测量单次内存访问和核心间延迟。

| 测试(分数越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| GROMACS benchMEM,最佳布局(ns/天) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000,所有内核 (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000,所有内核 (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000,所有内核 (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000,仅限 P 核(GFLOPS) | 不适用(一门核心课程) | 不适用(一门核心课程) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000,所有核心(GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000,仅限 P 核(GFLOPS) | 不适用(一门核心课程) | 不适用(一门核心课程) | 565.3 | 566.5 |
AVX-512指令集、144MB三级缓存和四通道DDR5-6400内存的组合优势在此得以体现。DGEMM算法在Xeon处理器上达到了1,638 GFLOPS,而285K处理器仅为768 GFLOPS。在N=40000的LU求解任务中(该任务需要通过内存传输11.9GB的数据),Xeon处理器的运算速度达到了1,659 GFLOPS,而285K处理器仅为668 GFLOPS,是Core平台的2.5倍。3K处理器的性能在N=20000到N=40000的范围内几乎没有提升,因为此时其带宽已达到瓶颈,而Xeon处理器的性能则持续提升。在16核GROMACS测试中,Xeon处理器的性能比Core处理器高出27%,达到47.39 ns/day。

| 《测试》(Test) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 流式复制(MB/s,速度越高越好) | 106,698 | 106,512 | 39,477 | 39,426 |
| 流规模(MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| 流添加(MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM Triad (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| 内存延迟,1GiB 缓冲区,4KiB 页(纳秒,越低越好) | 148.3 | 147.8 | 135.2 | 135.4 |
| 核心间延迟,所有核心对的平均值(ns,数值越低越好) | 56.2 | 56.0 | 38.1 | 38.2 |
| 核心间延迟,最小值(纳秒) | 4.6 | 4.6 | 18.6 | 18.6 |
| 核心间延迟,最大值(纳秒) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad 测试在 Xeon T2 上的速度为 122,233MB/s,在 Core T2 上的速度为 33,003MB/s,带宽是后者的 3.7 倍。Xeon T2 使用四通道 DDR5-6400 RDIMM 内存,而 Core T2 使用的是四通道 DDR5-4400 UDIMM 内存,但该平台的内存容量无法满足其需求。代价是延迟:Xeon 的内存延迟为 148.3 ns,而 Core T2 为 135.2 ns;Xeon 的核心间平均延迟为 56.2 ns,而 Core T2 为 38.1 ns。Xeon 的最小延迟为 4.6 ns,对应于同一核心上两个 SMT 子线程之间的通信;最大延迟为 65.7 ns,对应于跨 SMT 网状结构的通信。
游戏娱乐
SuperTuxKart 1.5 在 1080p 全屏模式下,以最高预设设置关闭垂直同步运行其内置基准测试,并报告平均帧率和稳定帧率。在此分辨率下,GPU 性能绰绰有余,因此测试结果与 CPU 性能相符,并且该测试可以代表许多存在相同限制的专业视口。由于这些系统无法完成编码测试中的 NVENC 转换,因此省略了该测试结果。

| SuperTuxKart 1.5,1080p 超高画质,垂直同步关闭(帧数越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 一般 | 304.6 | 323.2 | 359.1 | 383.5 |
| Typical | 304 | 322 | 354 | 376 |
| 稳定 | 161 | 174 | 122 | 135 |
Core T2搭配Max-Q显卡时平均帧率为359.1 fps,而Xeon T2为304.6 fps,单线程性能差距再次显现。Xeon平台则拥有更高的稳定帧率,达到161 fps,而Core T2为122 fps,且帧率波动更少。600W显卡使两款平台的平均帧率均提升了约6%。
负载下的时钟
两台主机均未通过测试套件的传感器路径报告 CPU 或 GPU 温度,因此我们通常发布的温度表在此处被替换为每次测试期间的平均 CPU 频率,该数值可以解释 600W 显卡对 Xeon 处理器的影响。安装 Max-Q 显卡后,658X 在 30 分钟持续循环测试中保持 4,269MHz 的频率,在较短的全核测试中保持 4,040 至 4,480MHz 的频率。在机箱中安装 600W 显卡后,大多数测试的频率都降低了,最多降低了 300MHz,并且所有测试的得分也都降低了。
| 测试期间的平均 CPU 时钟频率(MHz) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| 持续循环 | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-ZIP | 4,414 | 4,307 | 4,854 | 4,837 |
| 鳕鱼干 | 4,291 | 3,995 | 4,749 | 4,741 |
| 混合器 | 4,258 | 4,253 | 4,582 | 4,552 |
| 手刹 | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVM 构建 | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| 开放式BLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| 流 | 4,321 | 4,326 | 4,687 | 4,676 |
| 初筛 | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerf 客户端 | 4,191 | 4,138 | 3,814 | 3,686 |
| 编码代理 | 4,134 | 4,100 | 4,239 | 4,213 |
| 法学硕士服务 | 4,261 | 4,169 | 4,229 | 4,209 |
| 图像生成 | 4,044 | 4,008 | 3,702 | 3,837 |
| 鲁尔 | 4,178 | 4,197 | 4,172 | 4,108 |
| 超级卡丁车 | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish 的频率从 4,291MHz 降至 3,995MHz,primesieve 的频率从 4,441MHz 降至 4,268MHz,7-Zip 的频率从 4,414MHz 降至 4,307MHz,持续循环的频率从 4,269MHz 降至 4,182MHz,而无论使用哪张显卡,285K 在所有全核测试中的运行频率都相差不到 20MHz。
平均时钟频率并不能完全解释这个问题。Cinebench 和 Blender 的平均频率与 Max-Q 配置下的频率相差不到 10MHz,但仍然损失了 5% 到 10% 的性能,这表明存在一些短时波动,而每次测试的平均值掩盖了这些波动。658X 的功耗最高可达 250W,600W 的显卡功耗也为 600W,两者的散热都通过同一个前置进气口排入 32 升的散热器;究竟是处理器的散热余量还是平台的功率上限限制了性能,这个问题需要我们下次使用外部电源和温度记录进行测试才能解答。目前,对于运行全核 CPU 任务的用户来说,应该知道 Max-Q 配置在 CPU 方面速度更快。
储存效能
我们的存储测试使用 fio 的四个角分别对启动盘进行 5GB 和 25GB 的读写测试,测试内容包括文件系统以及原始设备,此处报告的是 25GB 的测试结果。在 Core T2 上,启动盘是一块 2TB 的 SK 海力士 PCB01 Gen5 x4 硬盘;在 Pro Precision 9 T2 上,启动盘是 FlexBay 中的两块 E3.S Gen5 硬盘,通过 Graid Technology 的 VROC 技术条带化成 4,097GB 的 RAID 0 卷。所有四种配置的 BitLocker 均已关闭,因此文件系统行测量的是 NTFS 文件系统和 RAID 层,而非加密数据。


| fio,25GB 占用空间,QD32 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 顺序读取 128K,文件系统 (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| 顺序读取 128K,原始设备 (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| 顺序写入 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1MB 预填充读取,QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| 随机读取 4K,文件系统,峰值(IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| 随机读取 4K,原始设备,峰值(IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| 随机写入 4K,峰值(IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| 原始/文件系统随机读取 | 1.32x | 1.31x | 1.29x | 1.31x |
| 随机读取 4K,4 个任务,p99 延迟(微秒,越低越好) | 506 | 485 | 183 | 185 |
| 随机读取 4K,16 个任务,p99.99 延迟(微秒,越低越好) | 15,270 | 23,462 | 676 | 676 |
| 随机写入 4K,4 个任务,p99 延迟(微秒,越低越好) | 610 | 594 | 228 | 228 |
| 驱动器温度,最高(摄氏度) | 不适用(位于 RAID 之后) | 不适用(位于 RAID 之后) | 50 | 57 |
条带化的速度并不比单块硬盘快,在处理小块数据时更是远远落后。两块 E3.S 硬盘通过 NTFS 文件系统顺序读取速度为 9,332MB/s,从原始卷读取速度为 10,782MB/s,而 PCB01 的读取速度分别为 11,377MB/s 和 11,186MB/s;写入速度为 6,507MB/s,而 PCB01 的写入速度为 7,401MB/s。在 4K 随机读取测试中,条带化硬盘通过文件系统读取的峰值 IOPS 为 840.1K,原始卷读取的峰值 IOPS 为 1.11M,而单块硬盘的峰值 IOPS 分别为 1.78M 和 2.30M;随机写入速度为 557.5K,而单块硬盘的写入速度为 957.5K。两者的原始卷与文件系统的读写速度比约为 1.3 倍,因此 NTFS 文件系统在两者上的成本相同;区别在于两种路径下都存在 VROC 层。
尾延迟如下:在 16 个作业的情况下,最慢的 0.01% 随机读取操作在卷上耗时 15.3 毫秒,而单块硬盘仅需 0.68 毫秒;4 个作业的 p99 读取延迟分别为 506 微秒和 183 微秒。跨两块 NVMe 设备的软件 RAID 会为每次 I/O 操作增加一次 CPU 跳转,fio CPU 读数也证实了这一点,顺序执行时卷的 CPU 使用率达到 80%,而 Core T2 的 CPU 使用率仅为 40%。此外,该卷还隐藏了硬盘的 SMART 数据,因此测试套件无法记录其温度。
以上这些都不能说明FlexBay是个错误的选择。它为T2提供了前置可维护、支持热插拔的硬盘,其尺寸可扩展至M.2无法企及的容量,而且使用两块硬盘创建4TB启动卷也十分便捷。但这确实意味着,对于那些工作负载主要为小块随机I/O、本地数据库或大量缓存的模型目录的用户来说,他们应该考虑使用一块不带条带化的E3.S硬盘,或者使用内置的M.2插槽。Core T2的测试结果表明,在这种机箱下,一块Gen5硬盘在M.2插槽中的表现与E3.S硬盘相当。
结语
戴尔 Pro Precision 9 T2 实际上是搭载工作站处理器的 Pro Max Tower T2,评测数据显示,这正是买家所期待的。在同样的 32 升机箱内,Xeon 658X 处理器在 Cinebench 多核吞吐量方面提升了 39%,内存带宽提升了 3.7 倍,DGEMM 内存速率翻倍,并配备了 24 核 48 线程处理器,支持 AVX-512 和 AMX 指令集,以及 ECC 内存,最高可扩展至 1TB 内存。在单线程任务(从 PrimeSieve 到 Python)方面,性能提升了 13% 到 31%,对于那些整天在显示器或终端前工作的用户来说,这一点尤为明显。
本次评测旨在帮助买家了解GPU的选择。Max-Q版和600W版RTX PRO 6000显卡共享96GB显存,解码速度相差7%到20%。600W版显卡的优势在于处理速度更快,首帧响应时间缩短了三分之一甚至更多,以及图像扩散速度更快,图像渲染速度提升了20%到34%。
在至强塔式机中,600W 的显卡会使处理器在全核运行时的性能降低 4% 到 5%,并且需要占用旁边的插槽,在我们测试的这台机器上,这意味着需要移除 25GbE 网卡。对于一台主要运行 CPU 渲染、模拟以及本地模型的塔式机来说,戴尔提供的 Max-Q 显卡是一个较为均衡的选择;而对于一台需要为团队提供模型或全天渲染图像的塔式机来说,600W 的显卡则值得占用一个插槽并搭配 1500W 的电源。
FlexBay 中的 E3.S 硬盘是我们多年来一直梦寐以求的塔式机箱规格;Graid Technology 的 VROC 控制器是 RAID 阵列的理想搭档。在小随机 I/O 性能方面,它比 Core T2 中的单个 M.2 硬盘速度慢,4K 读写速度也慢了大约一半。如果用户不需要 RAID 启动卷,可以考虑使用单个 E3.S 硬盘或内部 M.2 插槽。
另一方面,随着 E3.S SSD 容量突破 60TB,拥有极端数据使用场景的用户得以进入一个全新的世界,而在此之前,这意味着需要使用外部机箱或安装共享存储卷,闪存价格是实际的限制因素。
在戴尔官网(Dell.com)上,Pro Precision 9 T2 的配置价格约为 28,300 美元,这还不包括大多数企业用户看到的批量折扣。相比之下,配置相同的 Pro Max Tower T2 价格高出约 4,500 美元:配备 285K 处理器、128GB DDR5-4400 ECC 内存、RTX PRO 6000 显卡、2TB Gen5 硬盘和 1500W 电源的 Pro Max Tower T2 售价约为 23,800 美元。两款塔式机箱的显卡和内存配置价格相差不到 900 美元。第二个 FlexBay 硬盘位的价格差为 1,700 美元,其余价格则取决于 Xeon 平台。
它买来的是一款单路塔式机,在全核负载下表现得像一台小型服务器,占地面积却与台式机相同,这就是 Precision 名称回归的原因。
排行榜:戴尔 Pro Precision 9 T2 在我们的最佳台式工作站排行榜上荣获最佳综合台式工作站称号,其 RTX PRO 6000 的性能也出现在我们的最佳企业级 GPU排行榜上。



 Amazon