

NVIDIA 和微软今天开启了 RTX Spark Windows 笔记本电脑的预售,预计将于 10 月 16 日上市;紧凑型台式机将于 11 月推出;NVIDIA 还发布了 DGX Station for Windows 的预览版,该产品将于第四季度发布。这些消息是在微软于旧金山举行的 Windows AI 和 Surface 大会上宣布的,黄仁勋与萨蒂亚·纳德拉一同登台亮相。微软还宣布其代理容器层 Microsoft Execution Containers 已在 Windows 11 上正式发布。
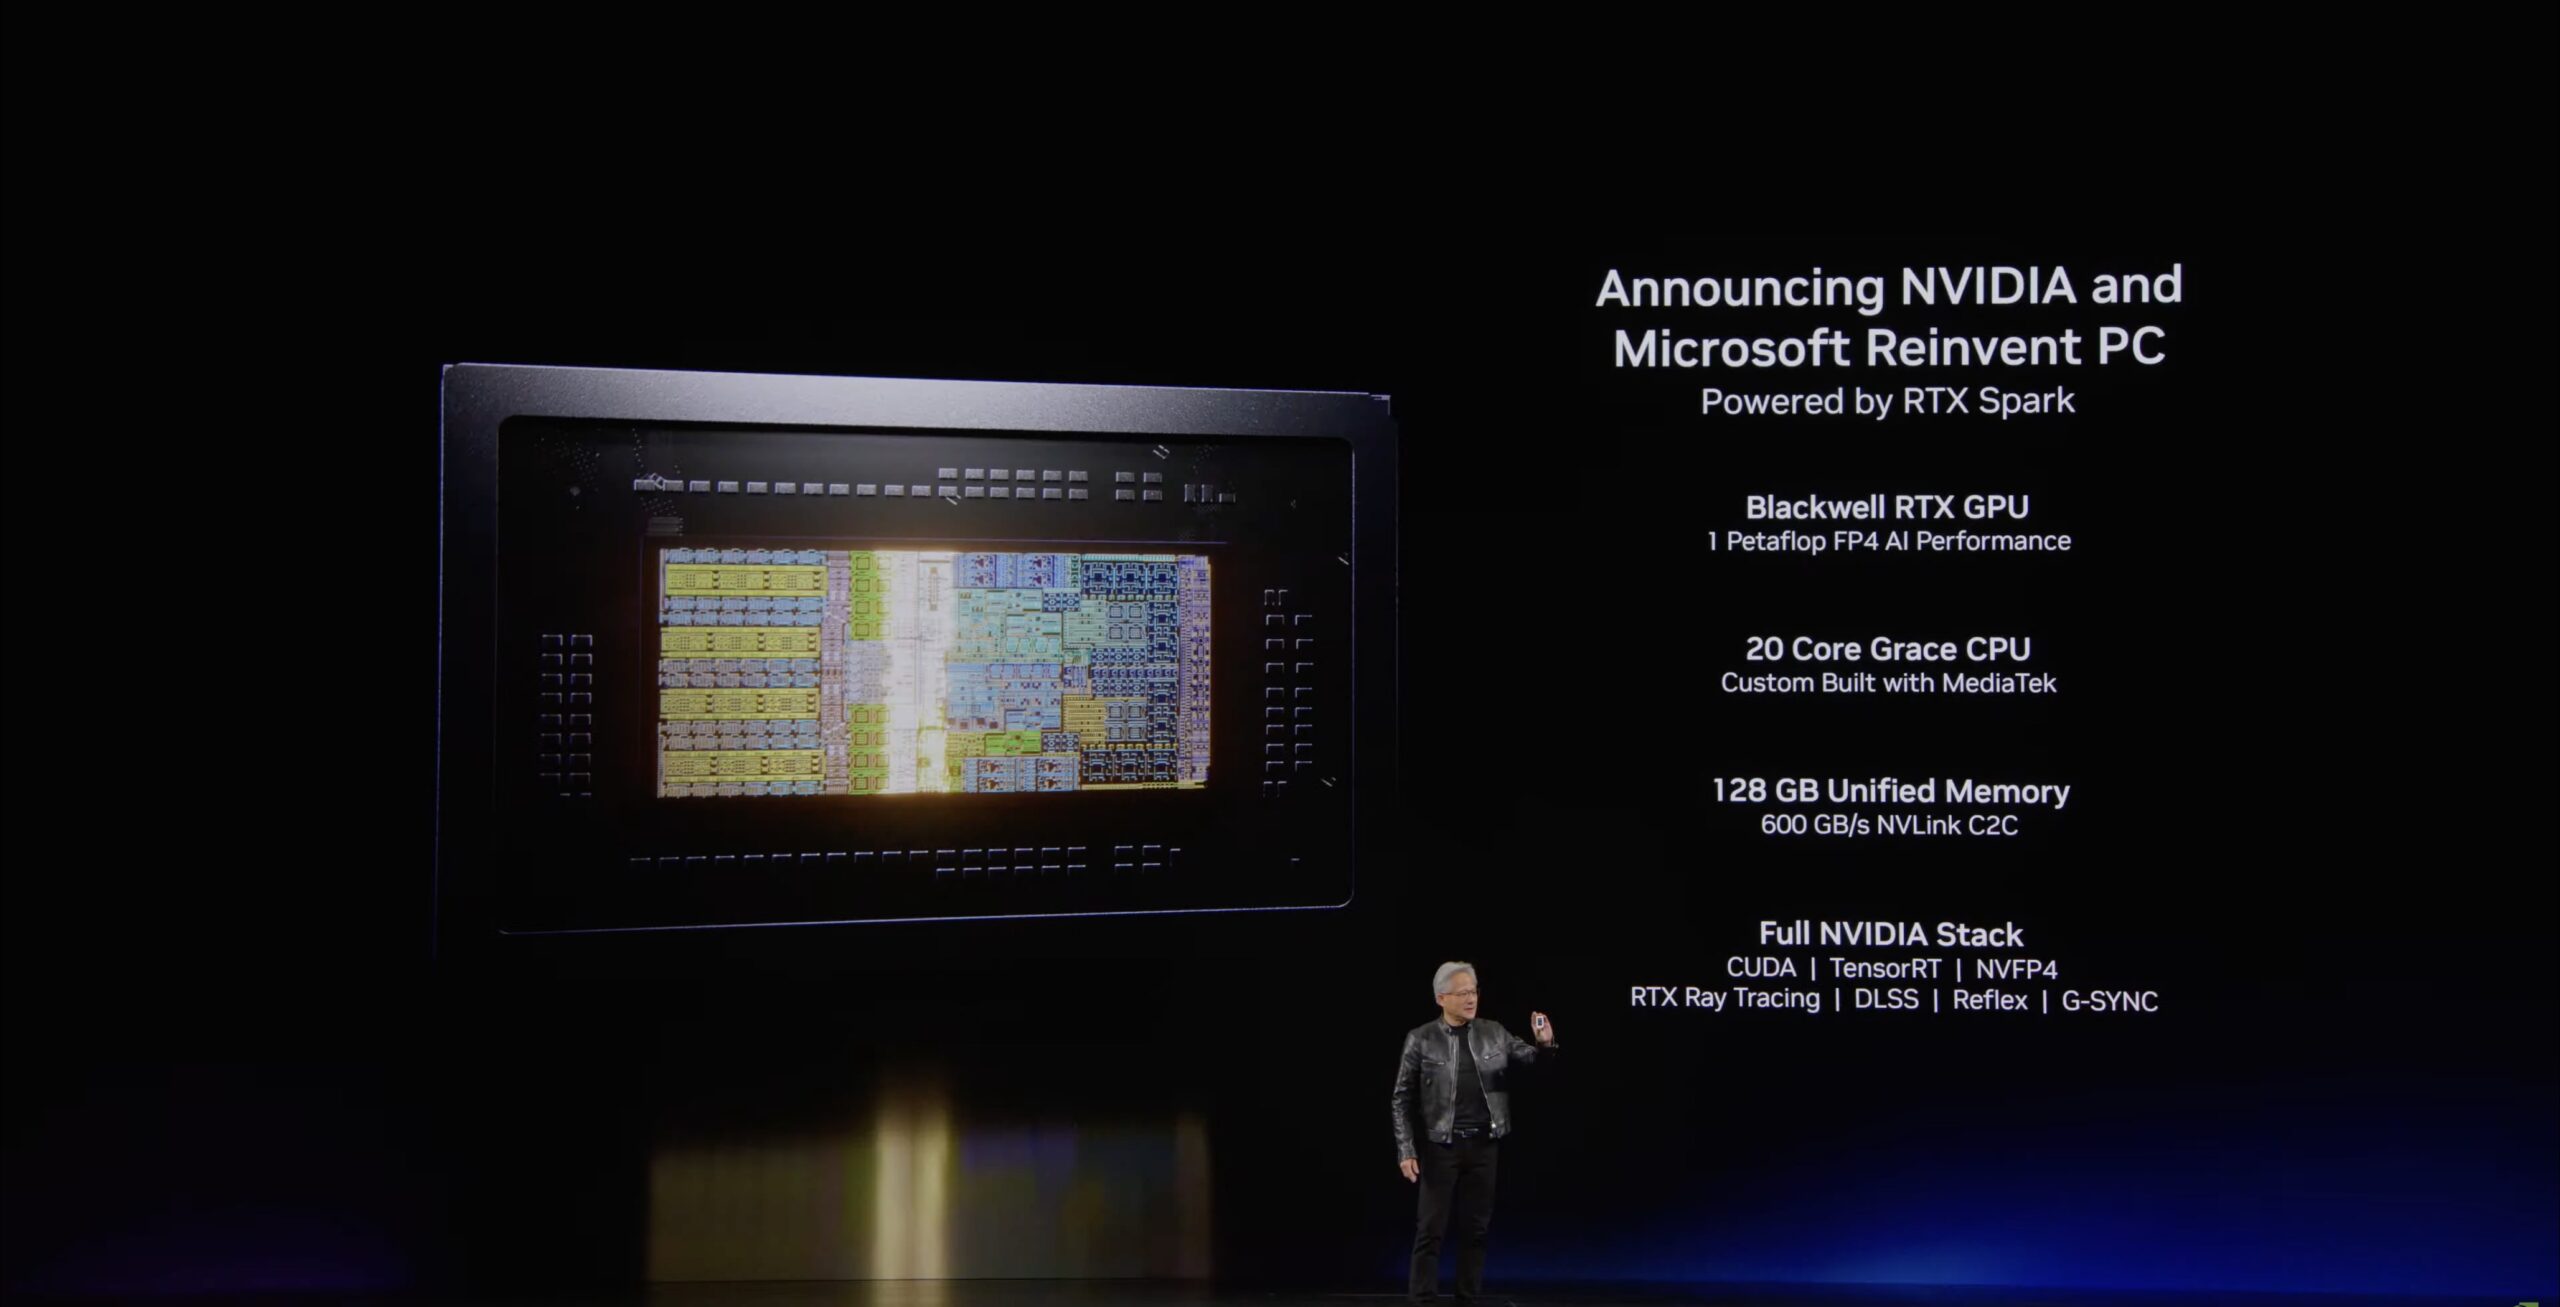
我们今天早些时候在戴尔 XPS 16 Creator Edition的评测文章中介绍了其中的第一款系统,并在六月份的台北国际电脑展 (Computex)上介绍了该平台本身。本文将重点介绍两家公司在展会期间发布的一些此前未知的信息:N1X 超级芯片的功耗范围、Windows 如何划分统一内存池、笔记本电脑上 137 亿参数编码模型的实测吞吐量、沙盒代理的运行机制,以及 Windows DGX Station 的完整规格表。
RTX Spark N1X:双芯片,三种功耗模式
NVIDIA 的 RTX Spark 规格表现在将笔记本电脑和台式机分开列出,这种区分比单纯的参数数字更能说明问题。笔记本电脑配备两种 N1X 版本:一种是拥有 6,144 个核心的 Blackwell RTX GPU,搭配 20 核 Grace CPU 和最高 128GB 的统一 LPDDR5X 内存;另一种是拥有 5,120 个核心的 GPU,搭配 18 核 CPU,最高内存可达 64GB;两者的 TDP 均为 45 至 80W。台式机仅提供 6,144 个核心、20 核 CPU 和最高 128GB 内存的版本,NVIDIA 标称其 TDP 为 140W。
这个140W的功耗与NVIDIA公布的DGX Spark中GB10芯片的TDP相同,涵盖了CPU和GPU的功耗,这与NVIDIA在6月份的说法一致,即这两款芯片是同一系统,只是针对不同的平台进行了优化。这也意味着笔记本电脑版N1X的功耗仅为桌面版N1X的32%到57%,而该系列所有系统都标配“最高1 petaflop”的FP4性能。微软Surface的脚注中将该数值描述为使用稀疏性计算的理论FP4性能。
| 规格 | RTX Spark N1X(笔记本电脑) | RTX Spark N1X(笔记本电脑) | RTX Spark N1X(桌面版) | GB10(DGX Spark) |
|---|---|---|---|---|
| GPU | 6,144 核 Blackwell RTX | 5,120 核 Blackwell RTX | 6,144 核 Blackwell RTX | Blackwell,第五代 Tensor Core,第四代 RT Core |
| 中央处理器 | 20 核 Grace | 18 核 Grace | 20 核 Grace | 20 个 Arm 内核(10 个 Cortex-X925,10 个 Cortex-A725) |
| TDP | 45至80W | 45至80W | 140W | 140W(240W电源) |
| 统一内存 | 最高128GB LPDDR5X | 最高64GB LPDDR5X | 最高128GB LPDDR5X | 64GB 或 128GB LPDDR5X,273GB/s |
| 媒体引擎 | 1 个第九代 NVENC 编码器,1 个第六代 NVDEC 编码器 | 1 个第九代 NVENC 编码器,1 个第六代 NVDEC 编码器 | 1 个第九代 NVENC 编码器,1 个第六代 NVDEC 编码器 | 1 个 NVENC 编码器,1 个 NVDEC 编码器 |
| 显示和 I/O | PCIe Gen5、HDMI 2.1b、DisplayPort 2.1b | PCIe Gen5、HDMI 2.1b、DisplayPort 2.1b | PCIe Gen5、HDMI 2.1b、DisplayPort 2.1b | HDMI 2.1a、ConnectX-7 200Gb/s、10GbE |
| 操作系统 | Windows 11 | Windows 11 | Windows 11 | NVIDIA DGX 操作系统 |
NVIDIA并未公布N1X的FP4密集功耗数据;在GB300上,NVIDIA同时公布了这两种功耗数据,其中密集功耗数据约为稀疏功耗数据的75%。我们预计OEM厂商的散热设计将使这些笔记本电脑的性能差异远超DGX Spark系列,而厂商调校前笔记本电脑TDP范围内35W的功耗差距便是首个有力证据。
微软在桌面端产品上又添新花样。其 Surface RTX Spark 开发盒页面显示,这款显卡采用铝制机箱,配备 1,000 个通风孔,散热能力为 100W,比英伟达 N1X 桌面显卡的 TDP 低 40W。两家公司可能衡量的是不同的指标——一个是芯片额定功率,另一个是机箱设计——但对于 11 月份正在比较紧凑型台式机的消费者来说,应该询问各厂商其产品持续功耗的具体数值。
内存速度是 XPS 与 GB10 的另一个平台区别。戴尔 XPS 的规格表显示,LPDDR5X 的读写速度为 9,400 MT/s,在与 GB10 类似的 256 位接口上,换算过来就是 300.8GB/s,与 NVIDIA 在 6 月份公布的 300GB/s 相符,比 DGX Spark 的 273GB/s 高出约 10%。CPU 和 GPU 通过 NVLink-C2C 连接,传输速度为 600GB/s。其余配置在所有三个组件中都是相同的:第五代 Tensor Core、第四代 RT Core、DLSS 5、支持帧扭曲的 Reflex 2 以及支持最高 4K 480Hz 或 8K 120Hz(带 DSC)的 HDMI 2.1b 接口。
NVIDIA 的商城目前提供 17 款笔记本电脑的预购配置,而我们仔细查看了其中 15 款,发现其中 7 款搭载了 5,120 核处理器,内存容量分别为 24GB、32GB、48GB 和 128GB,存储方面则同时配备了 PCIe Gen4 和 Gen5 接口的硬盘。
Windows 如何划分 128GB 的统一内存
内存会在 CPU 和 GPU 之间动态共享,GPU 可寻址的最大内存量取决于配置。微软和 GitHub 的工程帖子中提供了一张任务管理器截图,展示了搭载 6,144 核 N1X 处理器的 Surface Laptop Ultra 的内存分配情况。Windows 显示,GPU 专用内存为 74.9GB,共享内存为 35.5GB,GPU 总内存为 110GB,系统内存为 51.5GB。
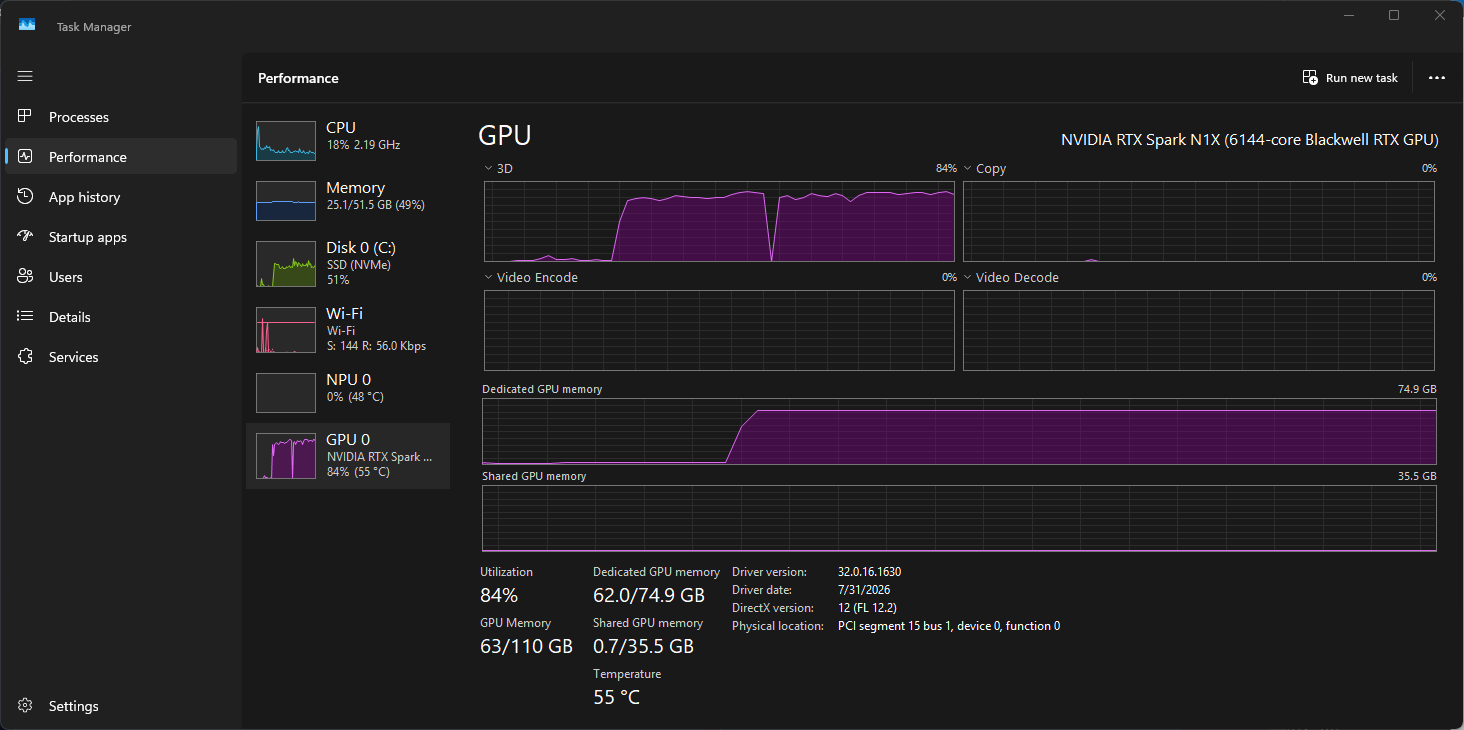
专用内存和系统内存加起来是 126.4GB,因此 Windows 将统一内存池呈现得就像呈现独立显卡一样:固定分配的专用内存,GPU 可以从系统内存中借用一定上限的内存。在这个单元中,GPU 的内存上限是 110GB,即已安装的 128GB 内存的 86%,权重、键值缓存和运行时开销都必须控制在这个范围内。同一张截图显示驱动程序版本为 32.0.16.1630,日期为 7 月 31 日,并且 NPU 被列为与 GPU 不同的独立设备。
该帖子明确指出,模型权重只是内存预算的一部分;操作系统、应用程序、推理运行时以及用于保存智能体不断增长的上下文注意力状态的键值缓存都共享同一内存池。对于预购清单中占比最大的 24GB 和 32GB 配置而言,这意味着 4 位及以上分辨率的 27B 级模型几乎没有剩余空间。发布材料中所有关于大型模型的描述均基于 128GB SKU。
适用范围:参数数量和每重量位数
同一芯片的参数上限数据似乎略有出入。NVIDIA 的产品页面称其模型最多可支持 120 亿个参数,每个参数对应 1 万个令牌上下文;其博客则以 Qwen 3.8 Flash Next 为例,指出其参数上限为 125 亿。微软则表示其模型支持超过 120 亿的参数,并列举了即将应用于 RTX Spark 的 MAI Code 1.1 Flash(137 亿)和 DeepSeek V4 Flash(284 亿)作为示例;戴尔则给出的参数上限为 200 亿。参数上限的差异主要在于每个权重占用的位数。
| 型号 | 参数 | 平台精度 | Footprint | 来源 |
|---|---|---|---|---|
| MAI 代码 1.1 闪存 | 总计137亿,活跃用户6.8亿(专家混合) | 混合精度,每重量约 3.3 位 | 53GB 权重;256K 上下文时峰值为 75.5GB | 微软、GitHub |
| NVIDIA Nemotron(即将推出) | 70B以上 | 2 bit | 略多于 20GB | Microsoft |
| DeepSeek V4 闪存 | 284B | 没有说明 | 没有说明 | Microsoft |
| Qwen 3.8 Flash Next | 125B | 没有说明 | 没有说明 | NVIDIA公司 |
| Qwen3.5 27B | 27B | 问题4 | 没有说明 | 微软基准测试脚注 |
微软提供的 MAI Code 1.1 Flash 数据最为完整。BF16 的云模型占用 274GB;设备端构建版本占用 53GB,微软称之为 80% 的容量缩减,每个权重大约需要 3.3 位(采用混合精度量化)。Nemotron 的数据也印证了这一点,因为 70 亿个权重每位需要 2 位,未加载额外开销时占用 17.5GB。DeepSeek V4 Flash 拥有 284 亿个参数,在加载任何上下文之前,为了满足 110GB GPU 的容量限制,每个权重大约需要 3.1 到 3.3 位或更少。
正是高质量的数据使得3位模型的有效性值得关注。微软报告称,量化后的设备端模型在SWE-Bench测试中得分为70.8%,与BF16云版本的72.6%进行了验证;而在Terminal-Bench 2.1测试中,其得分为66.29%,与BF16云版本的62.9%进行了比较。第二个测试结果显示,量化模型略胜一筹,但在包含89个任务的测试集中,这仅相差三个任务,在我们看来,这几乎可以忽略不计。作为对比的Unsloth GPT-OSS-120B GGUF模型在相同的两个测试中分别获得了32.0%和23.6%的分数。
吞吐量数据来自一台运行 Windows Arm64 架构 llama.cpp 的 Surface Laptop Ultra,该程序使用了 CUDA 后端和微软所谓的 DFlash2 滑动窗口推测解码技术,并使用合成代码生成工作负载进行了测试。微软的图表没有数据标签,因此以下是我们估算的结果:在 2K 提示符下约为每秒 63 个令牌,8K 提示符下约为每秒 61 个令牌,32K 提示符下约为每秒 57 个令牌,64K 提示符下约为每秒 52 个令牌,120K 提示符下约为每秒 55 个令牌,256K 提示符下约为每秒 39 个令牌。在 256K 提示符下,峰值内存使用量为 75.5GB,这与任务管理器捕获的独立 GPU 内存使用量完全一致。

提示处理速度是代理工作的关键指标。微软给出的数据是:在 64K 上下文中,每秒处理 923.5 个令牌;在 128K 上下文中,每秒处理 769.8 个令牌。一个 64K 的冷提示处理时间约为 71 秒,而一个 128K 的冷提示处理时间约为 170 秒,之后才会出现第一个输出令牌。博文还指出,保持模型加载并不能保证响应时间恒定,Copilot 在分配任务时会考虑缓存状态,因此预填充速度是我们首先在评测硬件上测量的指标。
MacBook 对比及其脚注
微软的对比测试将搭载 RTX Spark 显卡的 PC 与配备 M5 Pro 处理器和 64GB 内存的 16 英寸 MacBook Pro 进行了比较:RTX Spark PC 的首帧响应速度最高可提升 2.1 倍,图像生成速度最高可提升 4.3 倍,视频生成速度最高可提升 6.2 倍。首帧响应速度的提升来自微软委托 llama.cpp 进行的测试,测试使用了 Qwen3.5 27B 显卡(Q4_K_M 模式)和固定的 8,192 个字符的提示符。后两项提升则来自 NVIDIA 在 ComfyUI 中进行的测试,分别使用了 FLUX.2 Klein 4B 显卡(四步渲染,分辨率 1024 x 1024)和 LTX 2.3 22B 显卡(121 帧,八步渲染,分辨率 1280 x 720)。
脚注中包含多项限定条件,首先是硬件:所有测试均于 9 月份在配备 64GB 内存的 RTX Spark 预生产系统上进行,苹果系统为 M5 Pro,对比中不包含 M5 Max。ComfyUI 的两项测试均使用 NVFP4 精度的模型,脚注中也未描述 Mac 的软件配置。语言模型的结果是基于单一提示符长度的预填充测量;两家公司均未公布每秒解码标记数的对比数据,而这才是大多数本地语言模型用户所引用的数值。
在游戏方面,NVIDIA 表示 RTX Spark 显卡在 1440p 分辨率下,配合 DLSS 5、Reflex 和 G-SYNC 技术,能够以超过 100 帧/秒的帧率流畅运行 AAA 级游戏,但并未透露具体游戏名称或设置。微软则带来了《战争机器:E-Day》,该版本支持 DirectX 光线追踪、可变速率着色、DirectStorage 和高级着色器交付技术。微软称,这些技术可以将首次启动时的着色器编译时间从几分钟缩短到几秒钟,并承诺《使命召唤》将于 2027 年登陆 RTX Spark 平台。关于 Prism 和反作弊系统的详细信息,请参阅我们关于戴尔的报道。
微软执行容器:代理沙箱的工作原理
MXC 是此次发布会中影响范围最广的部分,因为它适用于任何 Windows 11 PC,并以开源库和多语言 SDK 的形式提供,同时还支持 macOS 和 Linux 后端。开发者可以通过 JSON 策略声明工作负载的需求:它可以修改的文件、只能读取的文件、入站和出站网络访问权限,以及是否可以访问桌面。MXC 会将该策略映射到隔离后端并在运行时强制执行,并且该策略位于工作负载之外,因此生成的代码无法授予自身额外的访问权限。
| MXC 后端 | 交易平台 | 机制 | 预期用途 |
|---|---|---|---|
| 进程容器 | Windows 11、macOS、Linux | Windows 上的 AppContainer、macOS 上的 Seatbelt、Linux 上的 Bubblewrap | 针对模型生成的代码和工具执行的低延迟隔离 |
| 会话容器 | 仅限 Windows 11 | 独立的 Windows 帐户和会话,拥有独立的桌面、剪贴板、用户界面和输入方式 | 需要桌面的长时间运行代理和自动化 |
| WSL容器(WSLc) | 仅限 Windows 11 | 通过 WSL 运行 Linux 环境 | Linux优先的代理工具链 |
| 微型虚拟机 | Windows 11 和 Linux(实验性) | 硬件强制虚拟化边界 | 高风险工作负载和不受信任的代码 |
策略编写周期包含三种运行模式:强制模式会阻止策略之外的任何操作;学习模式会阻止这些操作并将其记录到 JSON 活动报告中;宽容模式允许操作并记录原本会被拒绝的操作,以便团队可以运行代理执行实际任务,并根据这些证据构建最小权限策略。活动报告仅适用于 Windows 上的进程容器。组织可以通过管理工具对开发人员的策略添加自定义约束,微软表示 Intune 对 MXC 进程容器的管理功能即将推出。
明确哪些功能已普遍可用至关重要,而10月7日发布的正是隔离功能。代理身份识别(Microsoft Entra 可区分代理和已登录用户的操作)以及将 Agent 365 控制扩展到本地代理的功能,目前均处于即将推出的状态。在这些功能推出之前,MXC 容器会限制代理的访问权限,但安全工具仍然会以用户身份查看其活动,而微软所描述的集群级治理尚未实现;微软的脚注还指出,大规模治理可能需要额外的服务。
GitHub 对其自身集成的描述清晰地展现了二者之间的界限。Copilot 在 Windows 系统上使用进程容器的基础层,默认情况下,shell 命令以及本地模型上下文协议 (MCP) 服务器和语言服务器都在该层内运行。Copilot 的内置文件工具则运行在代理框架中,请求会根据策略进行检查,但不会被操作系统隔离,而远程 MCP 服务器则完全位于本地沙箱之外。本地推理不会改变这一切,因为无论哪个模型请求,shell 命令都会继承相同的访问权限。
目前支持 MXC 的代理包括 GitHub Copilot、OpenAI Codex、OpenClaw、Replit、LM Studio 和 Unsloth AI,而 Claude Code、Perplexity、Manus 和 Hermes Agent 等代理也即将加入支持行列。NVIDIA 已将 OpenShell 集成到 MXC 中,微软表示,OpenShell 为代理访问文件和推理服务增加了策略控制、高级网络控制、凭证管理以及面向企业的 OCSF 审计功能。
黄将此次发布会的重点放在容器层:“正如 Windows 和 DirectX 彻底改变了应用程序的构建方式一样,MXC 也将彻底改变代理的构建和部署方式。” 我们的观点则更为狭隘:策略模型本身是合理的,跨平台 SDK 也降低了采用成本,但目前为止详细描述的唯一集成方案使用的是最轻量级的后端,代理的隔离程度完全取决于开发者选择的后端。
混合路由:HydraFusion、Windows ML 和 llama.cpp
本地模型通过 GitHub Copilot 提供给开发者。GitHub 今年早些时候推出的 HydraFusion 可以将每个任务路由到合适的云端模型,现在它将扩展到设备端模型,并于 10 月下旬在 Copilot 应用、Copilot CLI 和 Visual Studio Code 中推出实验性预览版。开发者可以将模型放置设置为“自动”,也可以显式选择本地模型,可以是 Windows ML 提供程序提供的 MAI Code 1.1 Flash 模型,也可以是任何位于 OpenAI 兼容本地端点之后的模型。
微软还为 Windows ML 添加了对 llama.cpp 的支持,而上述 MAI 代码正是基于 Windows ML 运行时生成的。这为开放模型生态系统提供了一条通往该平台的受支持路径;我们的“最佳本地 LLM 工具”页面追踪了基于此构建的运行时和前端。不过,微软自身对这一功能的描述较为保守。其“开发者工具”页面称,智能路由可以将高达 20% 的 Copilot 工作负载卸载到本地模型,这表明本地推理是一种节省令牌预算的方式,而大部分工作仍然由云端完成。
系统、价格和日期
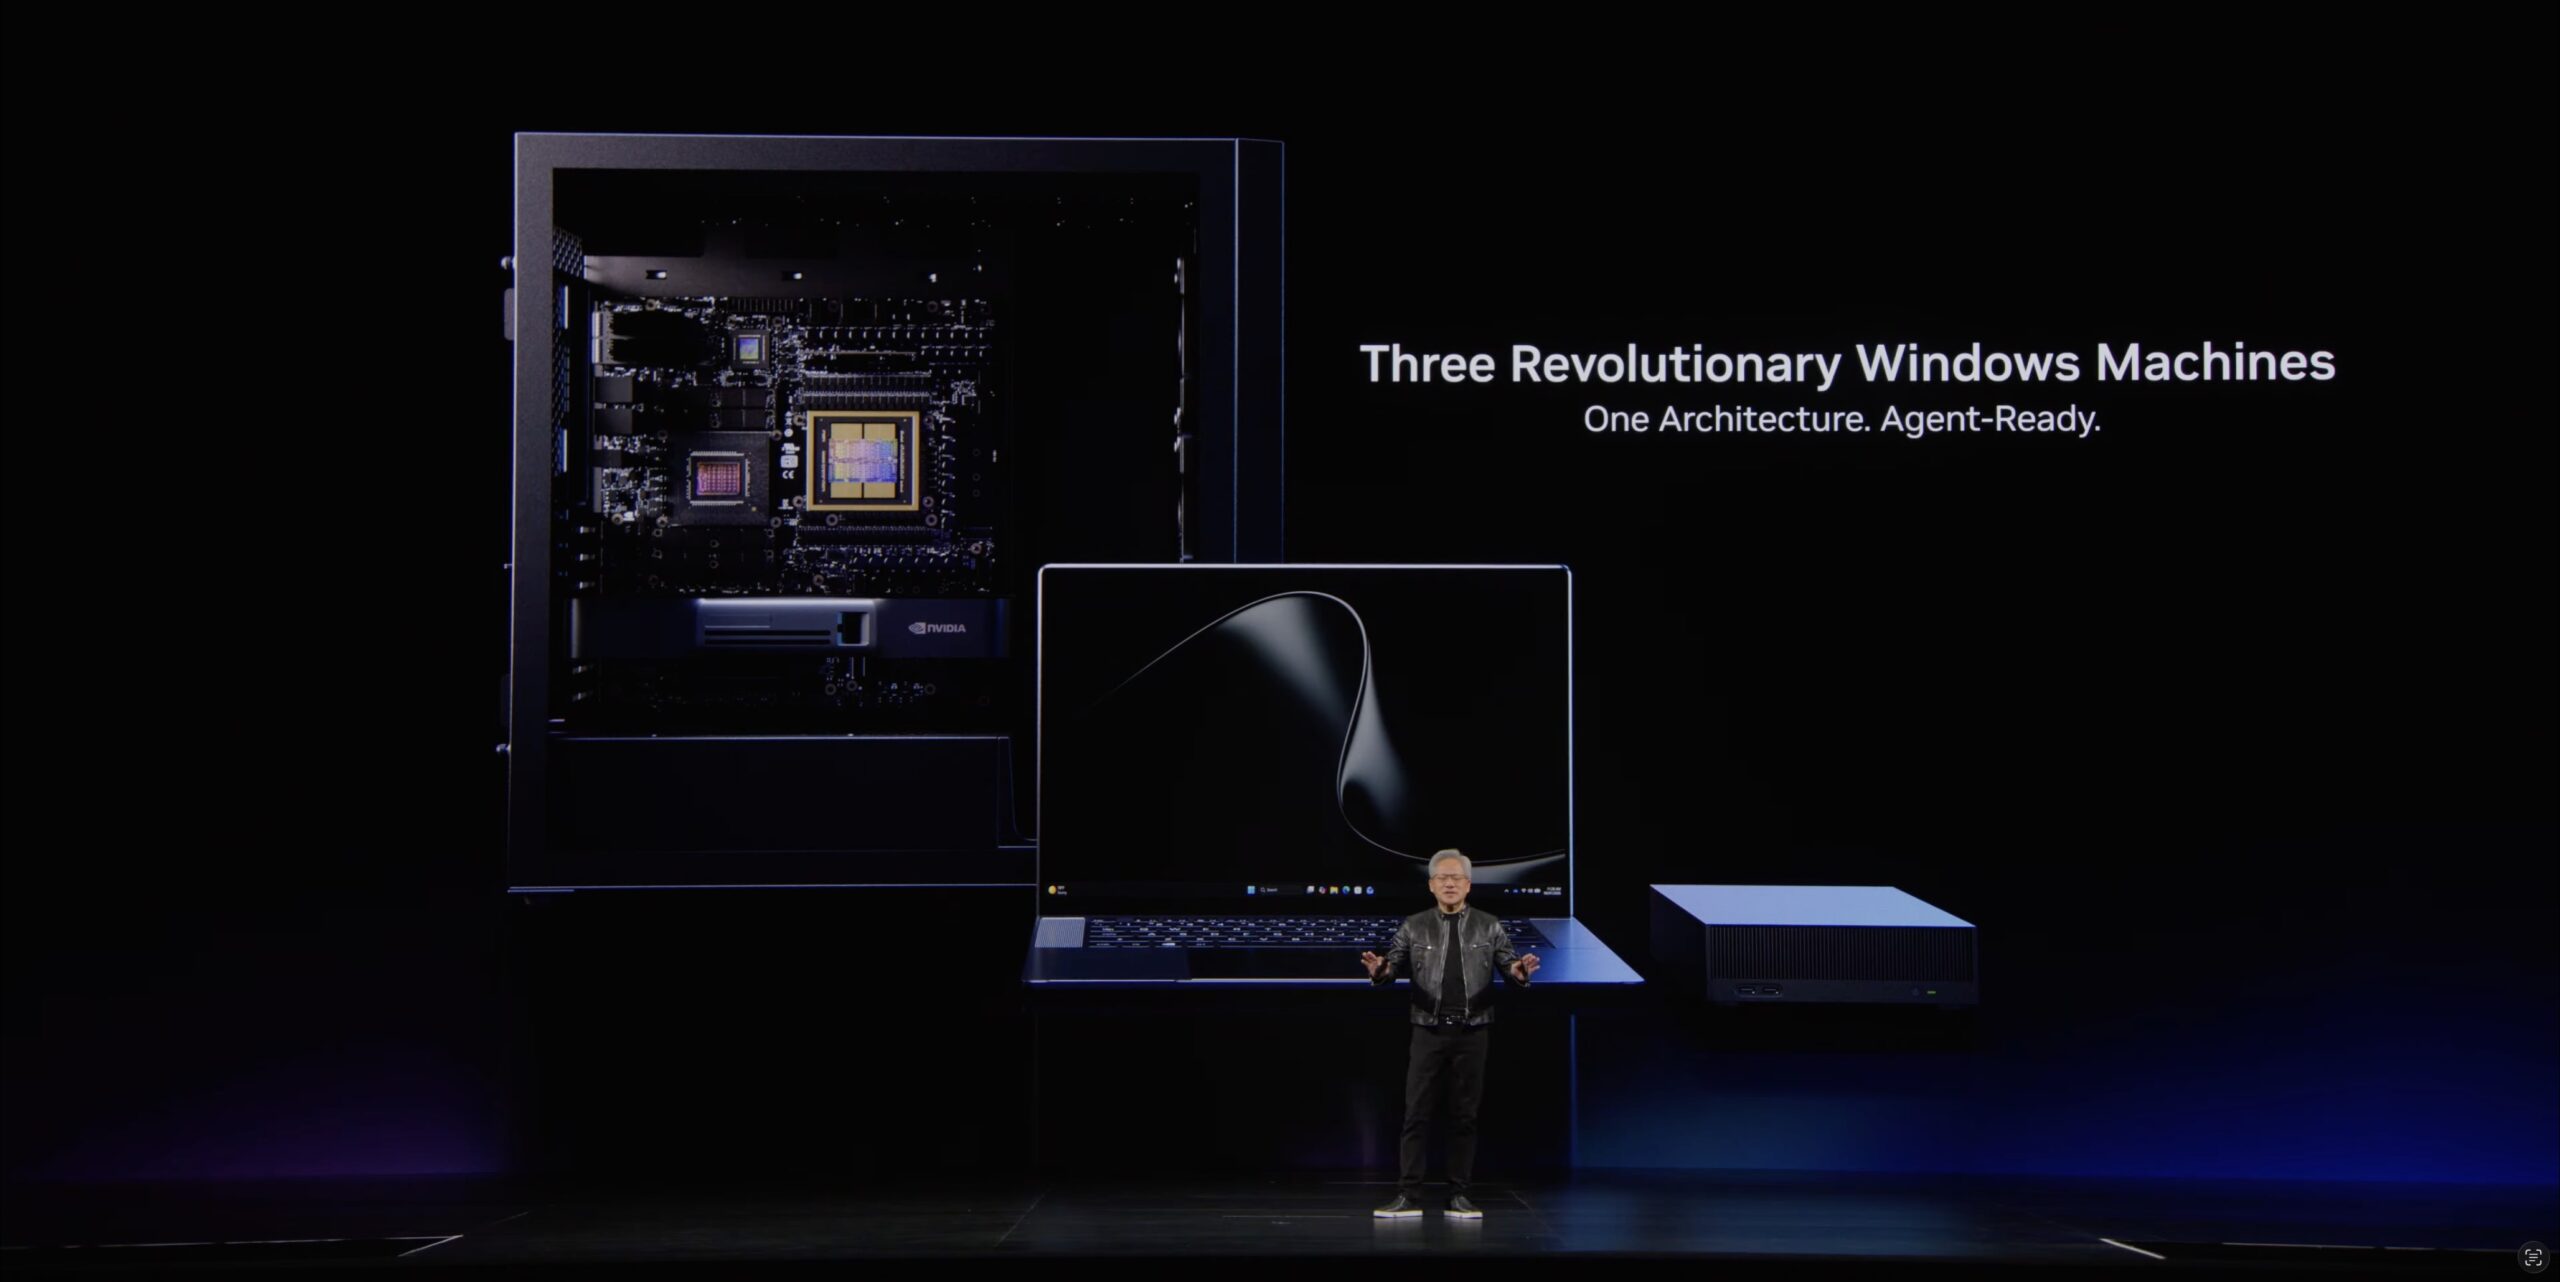
六家OEM厂商的笔记本电脑将于10月16日开启预售:华硕ProArt P16和P14、戴尔XPS 16 Creator Edition、惠普OmniBook Ultra 16、联想Yoga 9n二合一笔记本电脑、微星Prestige N16 Flip AI+以及微软Surface Laptop Ultra。NVIDIA的商城也列出了惠普OmniBook X 14。微星的这款笔记本电脑配备16英寸UHD+双屏OLED显示屏和99.9Wh电池。此外,NVIDIA还列出了宏碁和技嘉等厂商,它们也将推出RTX Spark系统。
Surface Laptop Ultra 起售价为 2,599 美元,这是我们见过的搭载 RTX Spark 显卡的最低价格。微软宣称其机身厚度不足 18 毫米,重量不足 4.5 磅。微软表示,这款笔记本电脑的散热能力是现有 Surface Laptop 的 2.5 倍,配备 15 英寸 120Hz 触控屏,分辨率为 3270 x 2180,在 10% 窗口范围内测得的峰值 HDR 亮度为 2,000 尼特,支持用户拆卸存储,并配备磁吸式 USB-C 充电接口,该接口仍可用于视频和数据传输。部分配置还配备 140W 电源适配器。NVIDIA 商城上的最低配置为搭载 5,120 核处理器、24GB 内存和 512GB 第四代固态硬盘。
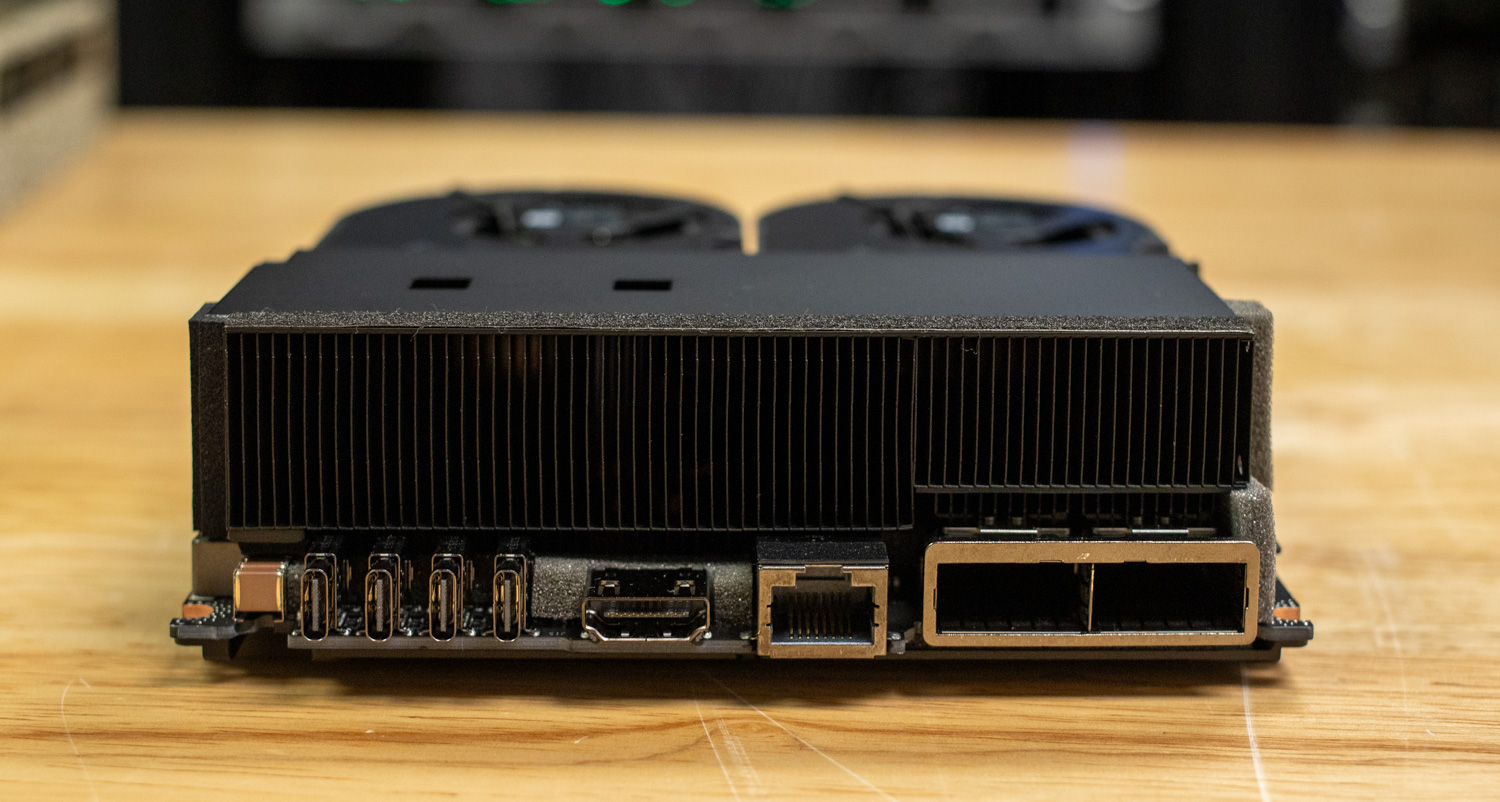
Surface RTX Spark Dev Box 是首款定价的紧凑型台式机,售价 5,999 美元(128GB 版本),仅在美国通过 Microsoft.com 销售,将于 11 月发货,预装 Visual Studio Code、Git、GitHub Copilot、WSL、Python 和 Node。它比售价 4,999 美元、内存翻倍的64GB DGX Spark高出 1,000 美元。微软列出了两个 USB-C 接口、一个 USB-A 接口、一个 HDMI 接口、一个以太网接口和一个耳机插孔,但并未提及 DGX Spark 集群所需的 ConnectX-7 接口,而这正是我们六月份提出的桌面网络问题的答案之一。
DGX Station for Windows:第四季度,附完整规格表
NVIDIA 的 DGX Station for Windows 页面现在显示“将于第四季度发布”,微软表示该系统将于今年晚些时候上市,并首先提及搭载 GB300 芯片的戴尔 Pro Precision 和惠普 ZGX Fury AI Station。NVIDIA 的合作伙伴名单新增了华硕、技嘉、微星和超微。硬件方面,我们曾在微星 XpertStation WS300、华硕 ExpertCenter Pro ET900N G3以及双塔集群上测试过搭载 GB300 Grace Blackwell Ultra Desktop Superchip 芯片的 Ubuntu 系统。
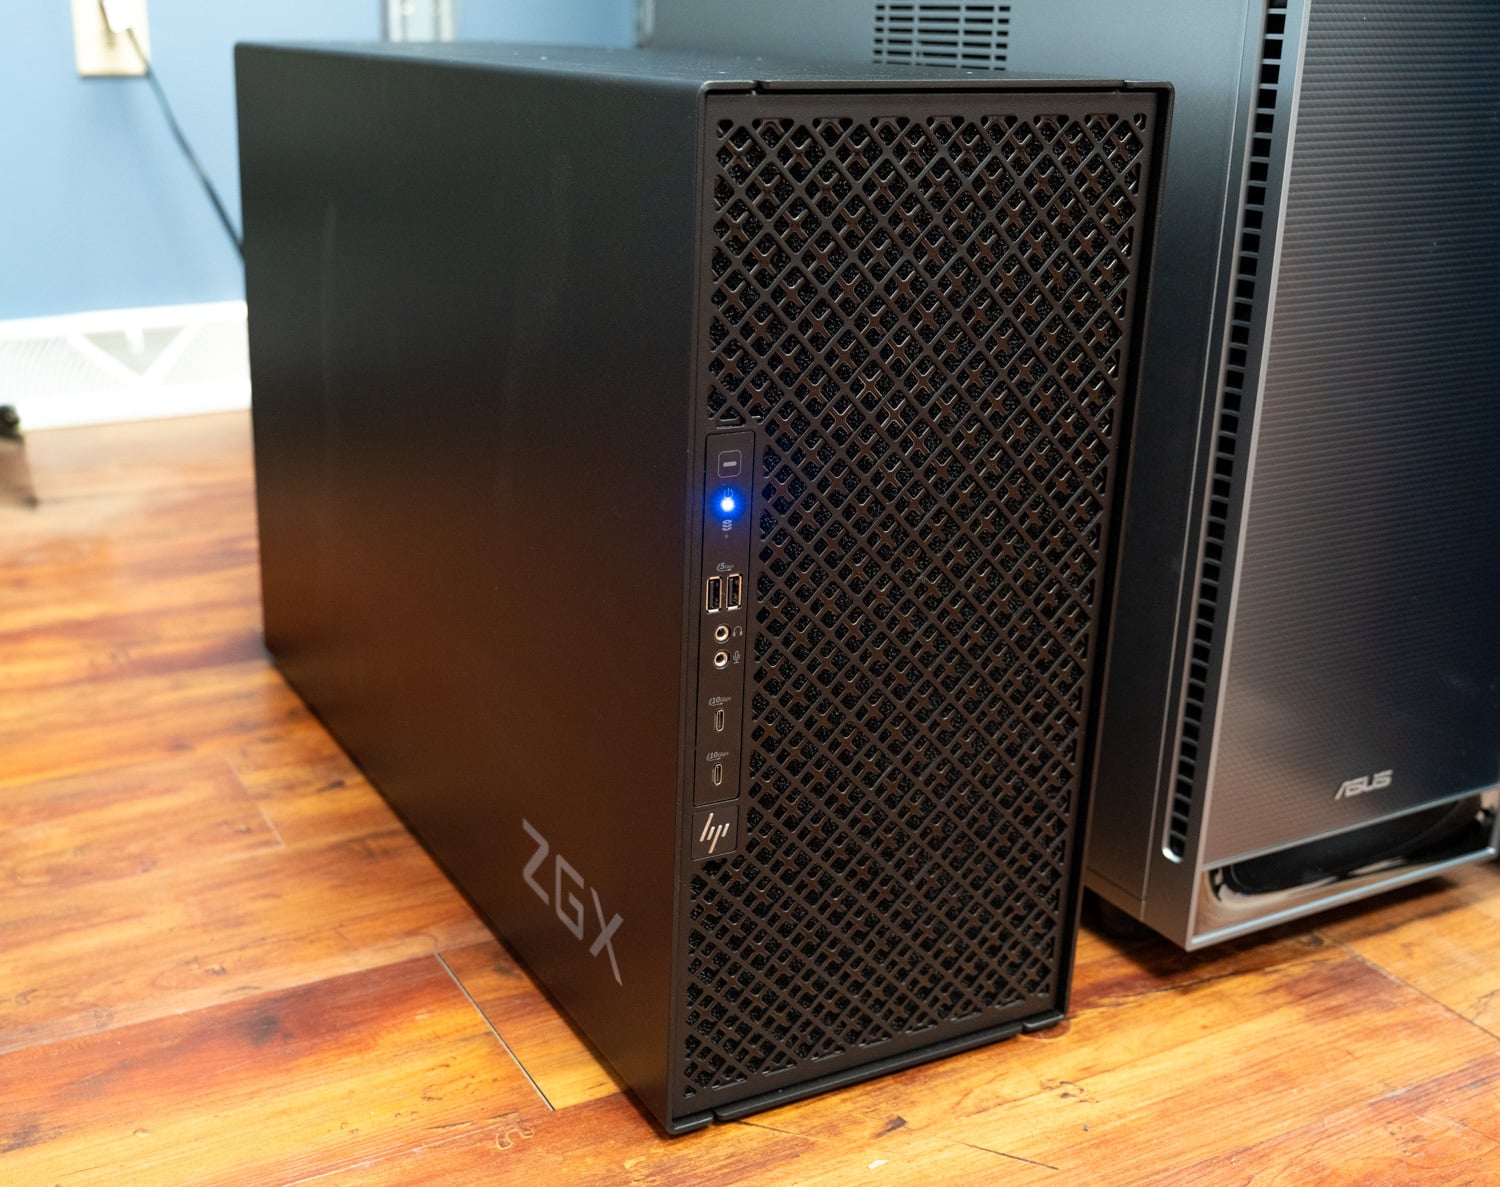
| 规格 | NVIDIA DGX Station for Windows |
|---|---|
| GPU | 1块NVIDIA Blackwell Ultra显卡,252GB HBM3e显存,读写速度7.1TB/s。 |
| 中央处理器 | 1 个 Grace 处理器,72 个 Neoverse V2 核心,496GB LPDDR5X 内存,读写速度 396GB/s。 |
| 连贯记忆 | 最高支持 748GB;NVLink-C2C 传输速度高达 900GB/s |
| FP4 张量核心 | 启用稀疏性时性能为 20 PFLOPS;禁用稀疏性时性能为 15 PFLOPS。 |
| FP8 和 FP6 张量核心 | 10 浮点数 |
| FP16 和 BF16 张量核心 | 5 浮点数 |
| TF32 张量核心 | 2.5 浮点数 |
| FP32 / FP64 | 80 TFLOPS / 1.3 TFLOPS |
| 社交 | ConnectX-8 超级网卡,最高传输速度可达 800Gb/s:2 个 QSFP112 端口,每个端口传输速度为 400Gb/s 1 个 10GbE RJ-45 接口,1 个 1GbE RJ-45 接口(BMC) |
| 存放 | 4 个 M.2 PCIe Gen5 插槽 |
| PCIe插槽 | 1 个 PCIe Gen5 x16 插槽;2 个 PCIe Gen5 x16 插槽(电气规格为 x8) |
| 支持的 RTX PRO GPU | RTX PRO 6000 工作站版、RTX PRO 6000 Blackwell Max-Q 工作站版、RTX PRO 4000 Blackwell SFF 版、RTX PRO 2000 Blackwell(支持情况可能因系统而异) |
| 解码器 | 7 个 NVDEC,7 个 nvJPEG |
| 系统电源 | 功率1,600瓦;需要20安培电路。 |
| 操作系统 | Microsoft Windows;通过 WSL 提供的 Linux 工具链 |
微软描述了 Windows DGX Station 的两种用途。一种是作为个人 AI 超级计算机,用于工程和研究工作,运行 Llama 4 Maverick、Kimi K2.6 和 DeepSeek V4 Pro 等模型,其硬件支持高达 1 万亿个参数的模型(微软在脚注中如此描述)。另一种用途是作为所谓的 Windows 令牌工厂,这是一个共享系统,支持团队同时运行 32 个或更多代理,以减少云令牌的消耗。微软表示,IT 部门可以使用与管理其 Windows 系统相同的工具来管理这些系统。
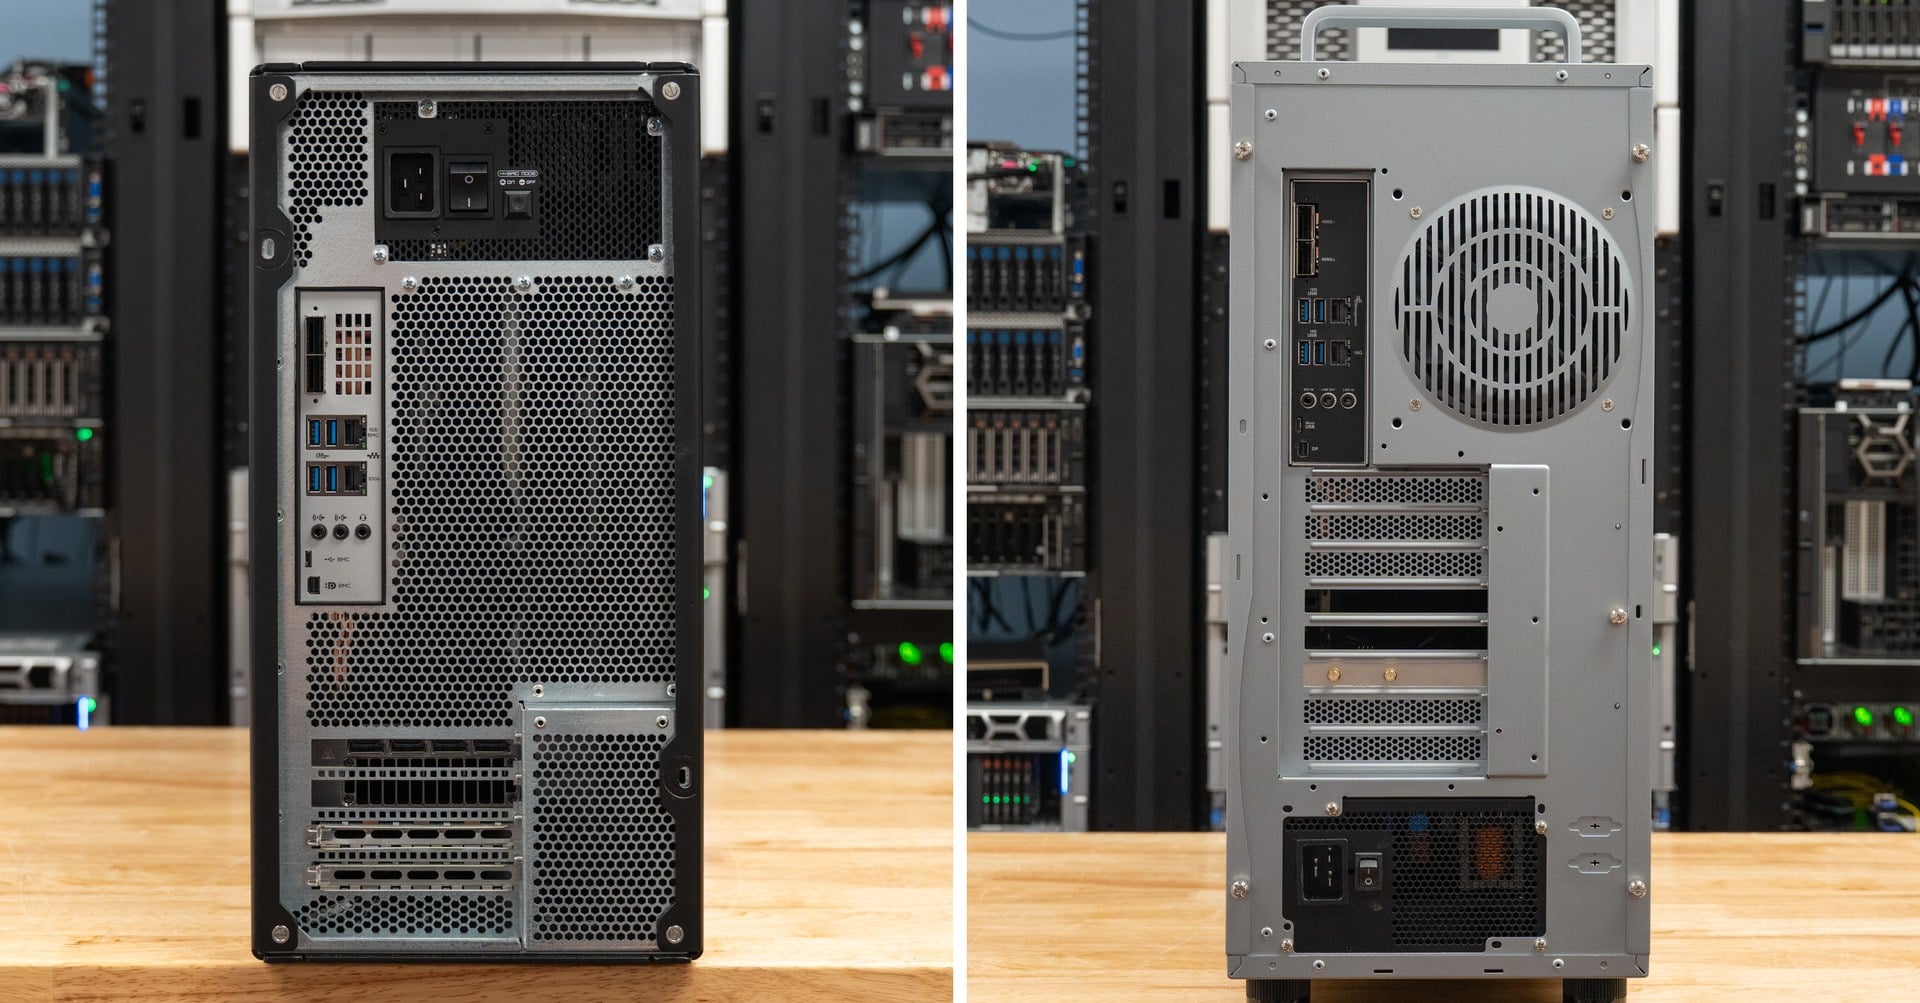
可选的 RTX PRO 显卡在 Windows 系统上比在 Linux 系统上更为重要。正如我们在 Computex 展会上指出的,GB300 中的 Blackwell Ultra GPU 没有 RT 核心,因此 Windows 设计和工程应用程序中的光线追踪可视化由独立显卡运行,而超级芯片则负责 AI 处理。NVIDIA 列出了四款支持的 RTX PRO Blackwell 显卡,从 RTX PRO 2000 到 6000,并指出不同系统的兼容性可能有所不同。
六月份提出的那个悬而未决的问题依然存在。我们之前在 Ubuntu 系统上使用 vLLM 和 NVIDIA 容器技术栈进行 GB300 测试,但两家公司都没有说明哪些服务栈可以在这台硬件上的 Windows 系统下原生运行,哪些需要在 WSL 环境下运行,也没有说明在配备两个 400Gb/s 端口的 72 核 Grace 主机上使用 WSL 会造成多少吞吐量损失。这些是我们拿到 Windows 测试机后首先要测试的内容。
总而言之
发布资料解答了我们在台北电脑展上留下的一些疑问。笔记本电脑运行该芯片的功耗为 45 至 80 瓦,台式机为 140 瓦;128GB 内存选项与两款芯片中较大的那款绑定;Windows 将 GPU 可寻址内存限制在已安装的总内存以下;微软的首款紧凑型台式机没有配备高速网络。微软 Windows 和设备执行副总裁 Pavan Davuluri 表示“你可以在这台笔记本电脑上运行传统机器根本无法运行的模型”,这句话同样适用于 128GB 配置,而微软每秒约 60 个令牌的 137 字节编码模型正是对这一说法的有力证明。
目前仍缺少一些依赖于特定机箱的测试数据:长时间代理会话下的持续供电、与苹果 M5 Max 和 AMD Strix Halo 系统相比的解码吞吐量、推理任务下的电池续航时间,以及大多数 128GB 笔记本电脑的定价。我们也不知道 Windows 何时会登陆基于 GB10 芯片的 DGX Spark,该芯片上个月已在固件中获得了Windows 启动证书。评测样机将按照我们“最佳本地 AI 笔记本电脑”和“最佳本地 AI 台式机”排行榜的测试流程进行测试。



 Amazon