

Nous avons déjà testé plusieurs stations GB300 DGX et avons récemment eu l'occasion d'en utiliser deux simultanément dans notre laboratoire : l' ASUS ExpertCenter Pro ET900N G3 et la station HP ZGX Fury AI . Les deux tours étant placées côte à côte, nous avons souhaité les connecter afin d'évaluer l'apport d'un second GB300 aux performances d'une machine unique, pour des charges de travail d'IA de bureau plus coordonnées.
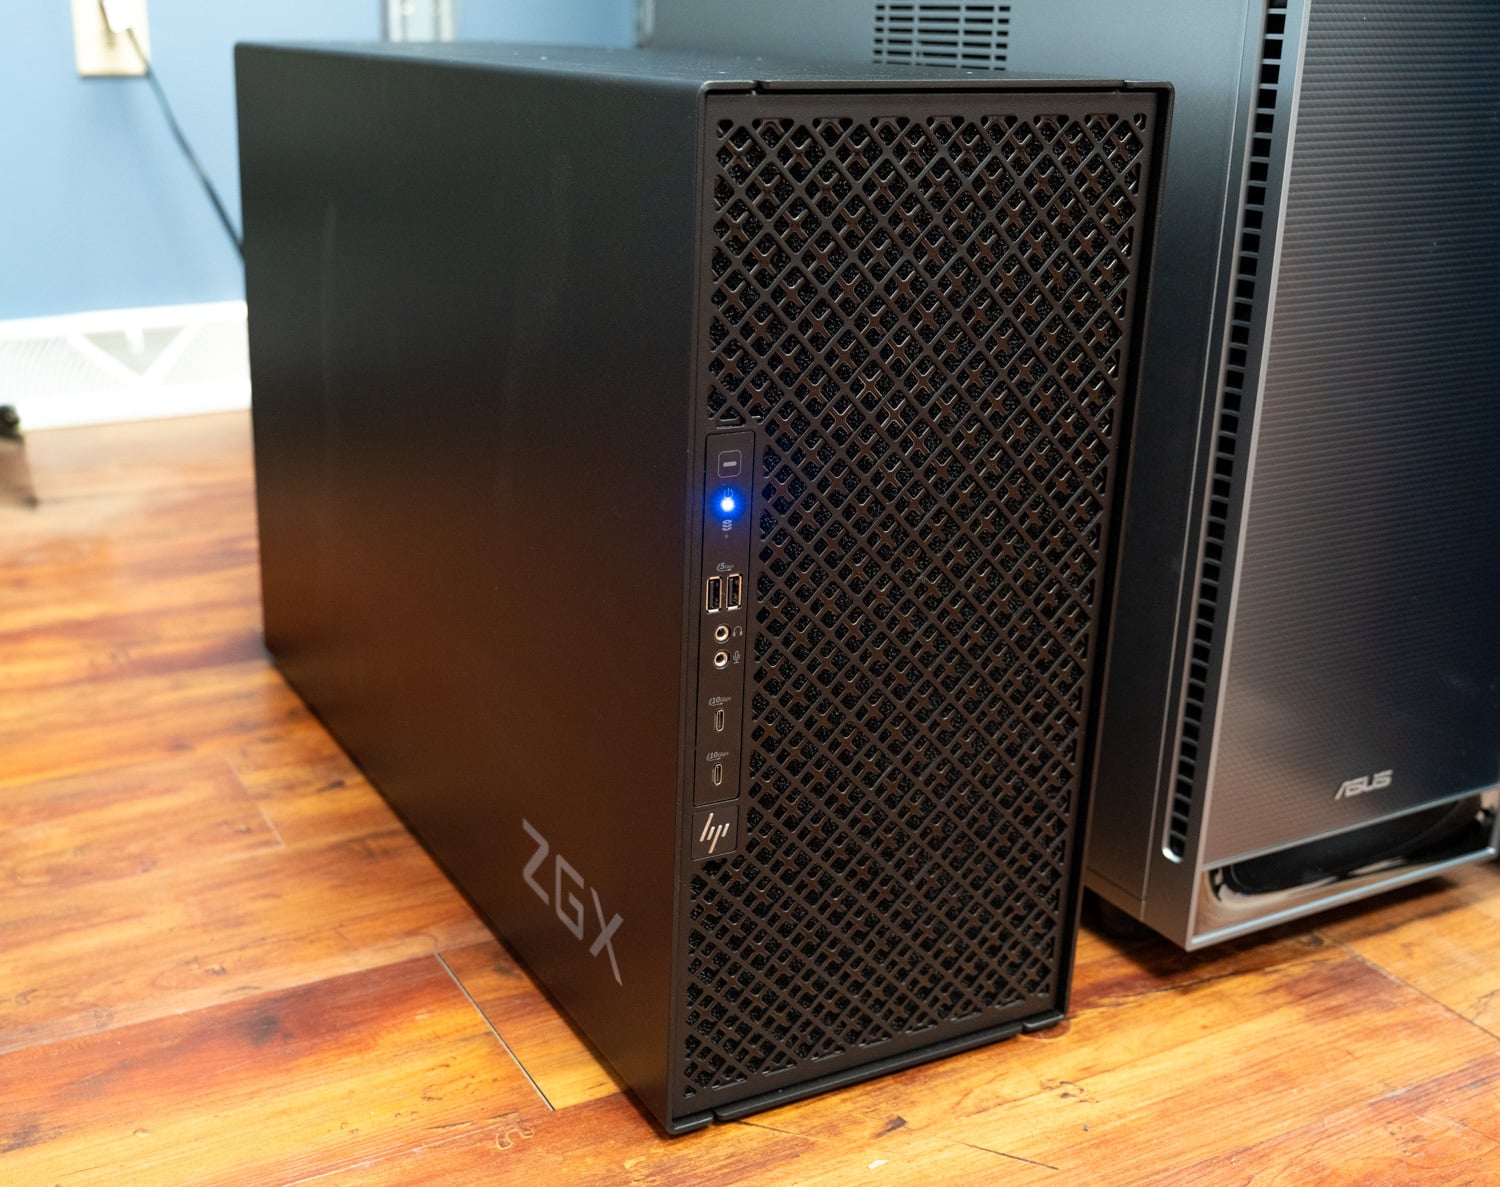
L'idée d'étendre progressivement une configuration de bureau, boîtier par boîtier, n'est pas nouvelle ; NVIDIA l'a explicitement proposée avec la plateforme GB10. L'un des atouts majeurs du DGX Spark résidait dans la possibilité de démarrer avec un seul système et d'en connecter d'autres au fur et à mesure de l'augmentation de la charge de travail. Le GB300 offre des performances initiales nettement supérieures, mais l'exécution de modèles plus complexes ou la prise en charge d'un plus grand nombre d'utilisateurs peuvent mettre à rude épreuve même les ordinateurs de bureau les plus rapides que nous ayons testés. C'est ce que nous soulignions dans notre test initial du MSI : si votre charge de travail justifie l'utilisation d'une de ces stations, il est facile d'imaginer qu'elle puisse, à terme, en justifier plusieurs.
Pour de nombreux acheteurs, le coût déterminera le moment où cette extension deviendra envisageable. Comprendre dès maintenant la compatibilité de deux stations permet à une personne qui n'en possède qu'une de mieux appréhender les avantages d'une extension ultérieure.
Points clés à retenir
- Deux câbles, 98 % du débit de ligne : Deux convertisseurs numérique-analogique (DAC) de 400 Gbit/s connectés aux ports ConnectX-8 des cartes mères ASUS ET900N G3 et HP ZGX Fury ont permis d'atteindre un débit de 98 Go/s en NCCL pour la diffusion, la réduction et l'envoi/réception, contre 100 Go/s pour la capacité maximale de la paire. Le protocole RDMA GPUDirect a atteint 392 Gbit/s sur chaque voie, et une écriture RDMA de 8 octets a affiché un temps moyen de 1.46 µs. La configuration a été gérée par le système NVIDIA.
- GLM-5.2 obtient un gain de 11x à concurrence égale : Le point de contrôle NVFP4 de 433 Go déverse environ 215 Go de poids d'experts dans la mémoire Grace sur une station, qui a servi 139 jetons de sortie par seconde sur 32 flux ; répartis sur deux B300 en parallèle tensoriel, il a atteint 1 525 sur 32 flux et 3 141 sur 256.
- GLM-5.3 passe de 188 à 5 018 jetons par seconde : Le gain le plus important de l'ensemble, 27x, est venu de l'autre modèle qui déborde de 252 Go de HBM3e, la paire grimpant toujours à 256 flux sur la même charge de travail et maintenant près de 600 jetons de sortie par seconde sur des invites de 8 192 jetons, environ cinq fois la tour unique.
- Les invites longues MiniMax-M3 s'arrêtent à huit flux sur une seule station : La tour unique est tombée à 103 jetons de sortie par seconde à huit flux lorsque le cache KV s'est épuisé ; la paire a servi 736 au même point, 7.1x, et a continué jusqu'à 1 801 à 256 flux.
- Les modèles compatibles reçoivent une deuxième copie et une séparation pré-remplissage/décodage : Avec une station en pré-remplissage et l'autre en décodage, GLM-5.3 Flash a triplé le débit d'invite courte à 32 flux (de 828 à 2 721) et doublé le débit d'invite longue (de 1 219 à 2 448), et DeepSeek V4.1 Flash a affiché le débit de sortie le plus élevé de tous les modèles testés, soit 5 248 jetons par seconde à 256 flux.
Réseautage sur la station DGX
Avant d'aborder le cluster, récapitulons les fonctionnalités réseau présentées dans notre test du MSI. La carte réseau ConnectX-8 SuperNIC ne se contente pas d'assurer la connexion réseau. Son commutateur PCIe intégré gère également une partie des E/S internes de la station, en se connectant à la carte Grace ainsi qu'aux deux emplacements de stockage PCIe Gen 6 x4.
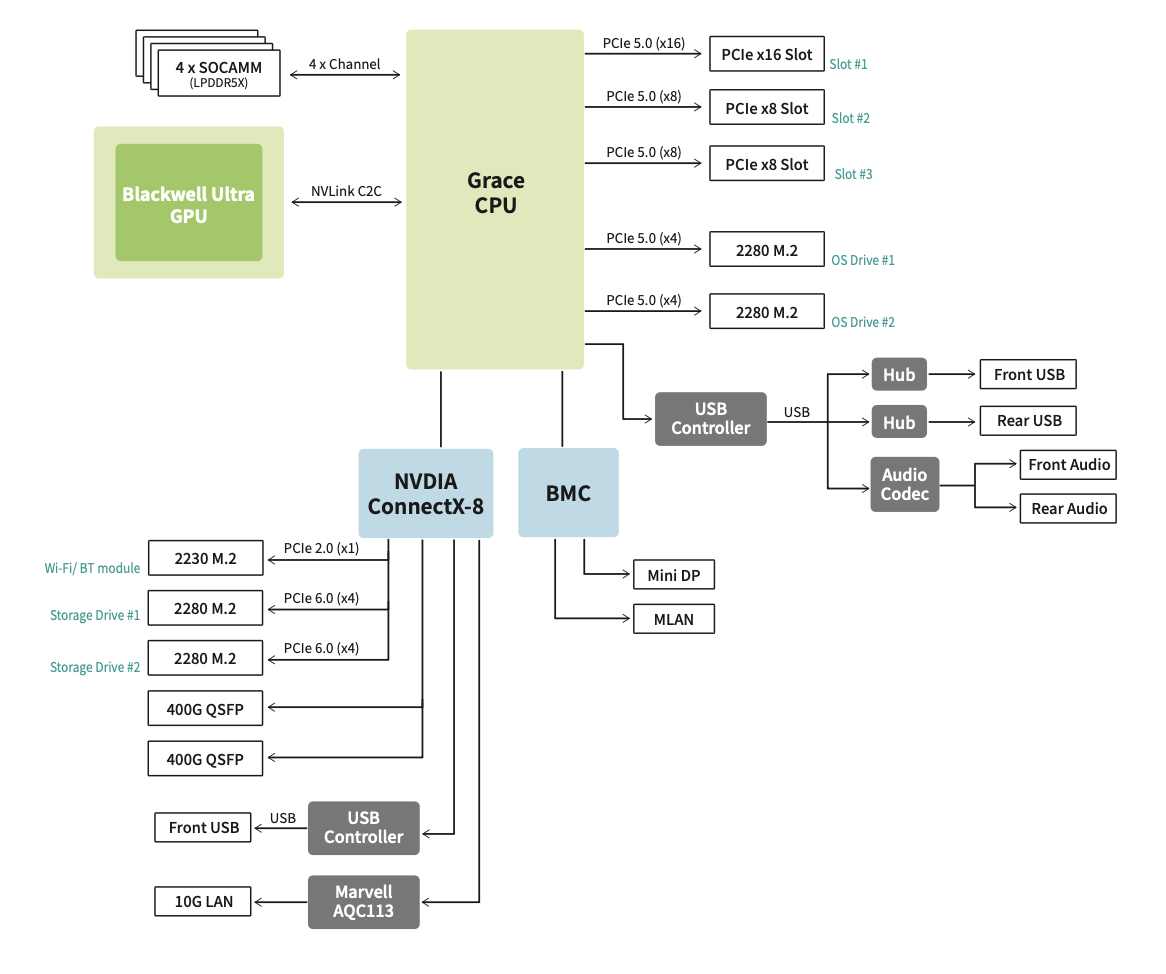
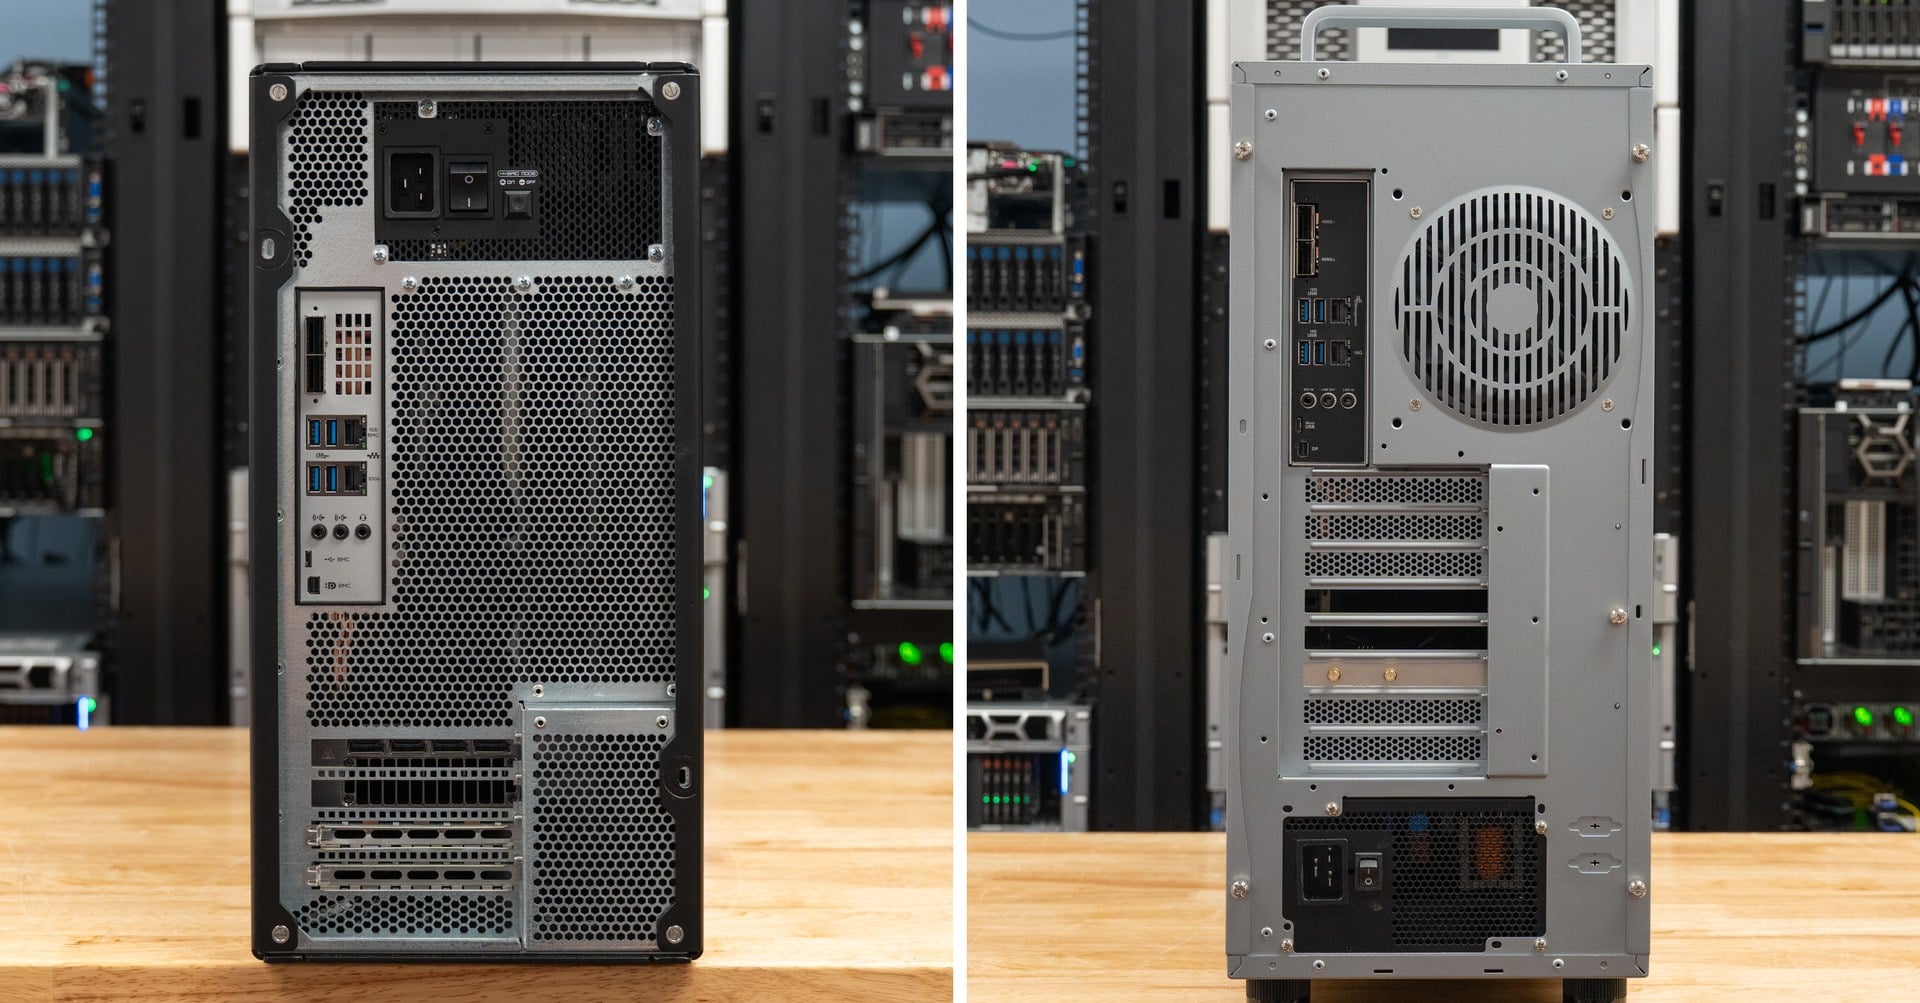
Pour la mise en réseau proprement dite, le système expose deux ports QSFP112 d'une capacité de 400 Gb/s chacun, fournissant une bande passante agrégée de 800 Gb/s pour connecter les stations entre elles ou les connecter à un réseau plus vaste.
Comparativement à l'implémentation du DGX Spark, que nous avons présentée dans notre test initial , l'interface ConnectX-7 400 Gb/s du Spark offrait des performances supérieures aux capacités de la connectivité PCIe du GB10. Le contrôleur était situé derrière deux liaisons PCIe 5.0 x4 distinctes, limitant le débit réseau agrégé utile à environ 200 Gb/s. Ses deux ports physiques apparaissaient également comme quatre interfaces Ethernet logiques sous Linux. Pour bénéficier de la bande passante maximale, il était nécessaire de mapper ces interfaces sur le châssis connecté, de configurer les deux interfaces logiques en aval et de s'assurer que le trafic RDMA pouvait utiliser les deux chemins PCIe.
La Station nous offre une configuration plus simple, avec deux ports 400 Gb/s pouvant chacun servir de réseau ferroviaire indépendant.
Quadrupler la bande passante utilisable du Spark via deux cages QSFP augmente également la charge de refroidissement, et lors de nos tests, chaque unité a parfaitement géré cette charge. Le ConnectX-8 est refroidi par liquide, et certains fabricants, comme MSI, étendent ce refroidissement aux cages QSFP, tandis que d'autres systèmes utilisent des dissipateurs thermiques et des ventilateurs dédiés au-dessus des cages, comme nous l'avons constaté lors de notre test d'ASUS. Ce refroidissement est particulièrement utile pour les modules optiques, qui génèrent plus de chaleur que les convertisseurs N/A passifs. Les deux approches ont donné de bons résultats lors de nos tests, et nous n'avons rencontré aucun problème de refroidissement au niveau du réseau.
Relier deux gares
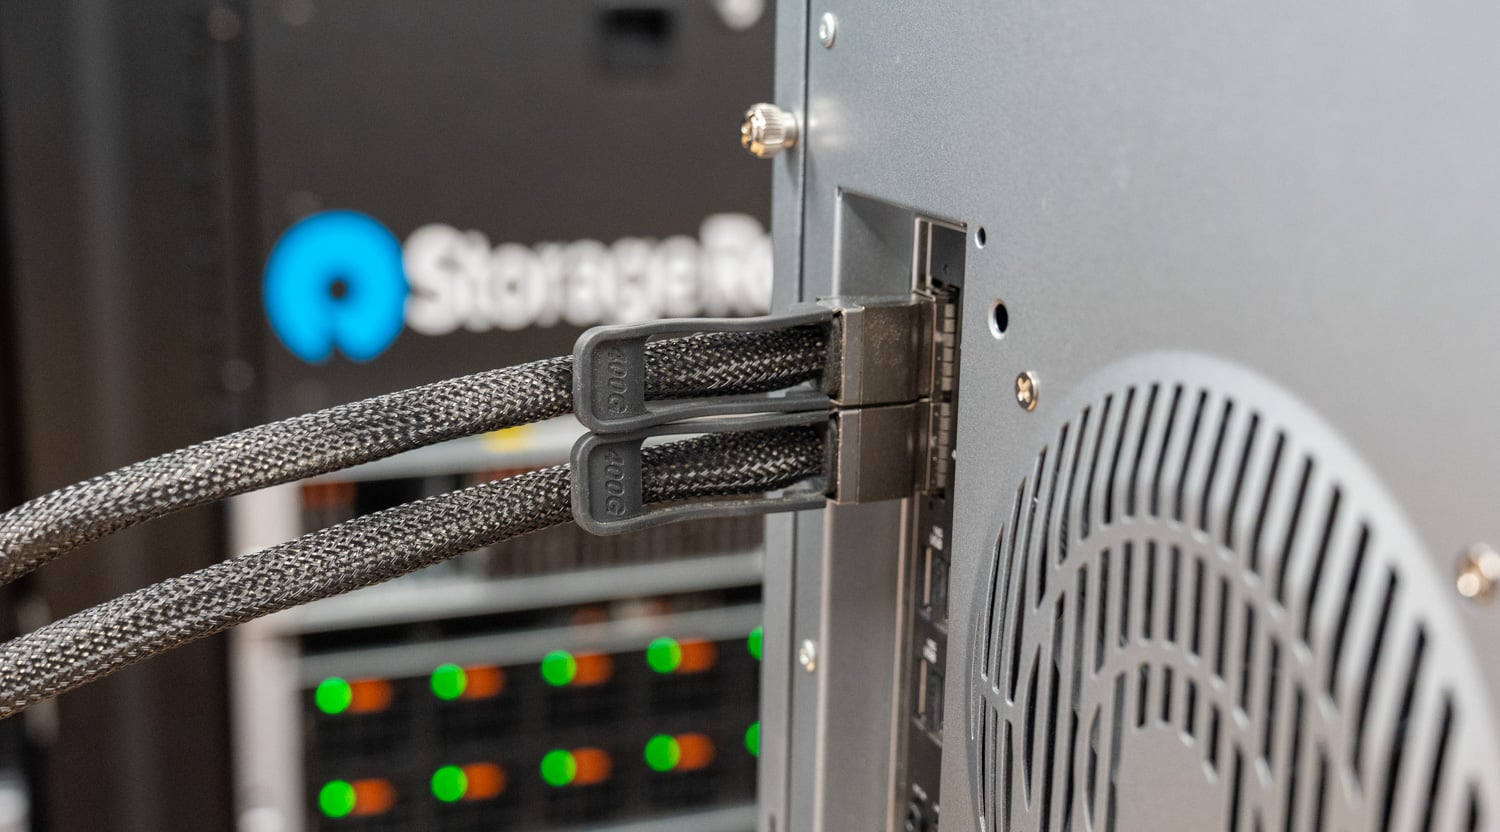
Le regroupement de deux stations DGX était simple : nous avons connecté l'ASUS et le HP directement à l'aide de deux câbles cuivre à connexion directe (DAC) 400G entre leurs ports QSFP112 correspondants, ce qui nous a donné deux connexions indépendantes de 400 Gb/s.
Côté logiciel, NVIDIA fournit un guide pas à pas pour la mise en cluster des systèmes. Les instructions étaient suffisamment claires pour que nous ayons simplement fourni le lien vers Claude Code et l'ayons laissé gérer la configuration. Il a configuré le réseau entre les deux stations, effectué des tests de bande passante NCCL et nous a fourni un rapport des résultats.
Le guide est un playbook numéroté exécuté depuis une troisième machine qui accède aux deux stations via SSH. Les ports sont câblés en liaisons appariées, QSFP0 à QSFP0 et QSFP1 à QSFP1, chaque liaison devenant un lien RoCEv2 point à point : les scripts activent les deux interfaces ConnectX-8 avec une MTU de 9 000 octets, attribuent à chaque liaison un /24 privé et appliquent les paramètres d’exécution RoCE et GPUDirect.
Une étape de validation confirme ensuite que les deux liaisons sont configurées à 400 Gbit/s, que les requêtes ping jumbo transitent par chaque liaison et que les deux périphériques RDMA, mlx5_0 et mlx5_1, sont actifs. Une exécution de la commande ib_write_bw sur chaque liaison prouve que le réseau gère le trafic RDMA et pas seulement les requêtes ping. NCCL est ensuite configuré pour utiliser les deux liaisons avec la variable d'environnement NCCL_IB_HCA=mlx5_0,mlx5_1, et la tâche est lancée comme pour toute autre exécution sur deux nœuds. Les résultats ci-dessous sont issus de cette séquence.
Le premier tableau provient de nccl-tests et présente les résultats de tâches collectives d'inférence distribuée ou d'entraînement, exécutées sur deux B300 avec les deux liaisons utilisées. Avec un GPU par station, chaque tâche collective consiste en un échange de données entre les deux GPU via les deux liaisons 400G. La colonne « Bande passante du bus » correspond donc directement aux 100 Go/s (800 Gb/s) fournis par les deux câbles. La valeur « Pic » représente le meilleur résultat obtenu pour différentes tailles de messages ; la colonne « 16 Gio » correspond au message le plus volumineux testé, pour lequel la bande passante s'est stabilisée.
| Opération | taille maximale | Bande passante maximale du bus | Bande passante du bus à 16 Gio |
|---|---|---|---|
| Tout réduit | 1 GiB | 92.242 GB / s | 91.346 GB / s |
| Rassemblement général | 16 GiB | 87.893 GB / s | 87.893 GB / s |
| Réduction de la dispersion | 2 GiB | 93.930 GB / s | 92.905 GB / s |
| Diffusez | 16 GiB | 97.975 GB / s | 97.975 GB / s |
| Réduire | 16 GiB | 97.978 GB / s | 97.978 GB / s |
| Tous à tous | 8 GiB | 80.522 GB / s | 80.512 GB / s |
| Envoi/réception unidirectionnelle | 16 GiB | 97.953 GB / s | 97.953 GB / s |
| Émission/réception bidirectionnelle | 16 GiB | 83.748 Go/s par direction | 167.496 Go/s (débit cumulé) |
Les modes de diffusion, de réduction et d'envoi/réception unidirectionnels ont tous atteint 98 Go/s, soit 98 % de la capacité des deux câbles. Les tests avec transmission bidirectionnelle simultanée ont affiché des débits inférieurs : 92 Go/s pour la réduction et 80 Go/s pour la transmission bidirectionnelle. Le résultat de l'envoi/réception bidirectionnel sert de référence : avec les deux GPU transmettant simultanément, chaque direction a atteint 84 Go/s, soit un total de 167 Go/s sur la liaison.
Le deuxième tableau descend en dessous de NCCL pour atteindre le chemin RDMA brut, en utilisant ib_write_bw rail par rail. Les lignes GPUDirect correspondent à des transferts d'écriture de 1 Mio de la mémoire HBM d'un B300 vers celle de l'autre, la carte réseau lisant et écrivant directement dans la mémoire GPU ; les deux rails atteignent 392 Gb/s, soit 98 % du débit maximal. Les lignes relatives à la mémoire hôte constituent le test de base du guide : une seule paire de files d'attente alimentée par la mémoire Grace, dont le playbook NVIDIA indique un débit de 220 à 230 Gb/s sur un rail à 400 Gb/s ; nous avons mesuré 228 Gb/s. La ligne relative à la latence correspond à une écriture de 8 octets : 1.46 µs en moyenne.
| Test | Bande passante | Utilisation des liens |
|---|---|---|
| GPUDirect RDMA, mémoire GPU, ib_write_bw, transferts de 1 Mio | ||
| Rail 0 | 392.15 Gb / s | 98.04 % |
| Rail 1 | 392.15 Gb / s | 98.04 % |
| RDMA en mémoire hôte, les deux rails | ||
| Écriture RDMA, unidirectionnelle | 228.15 Gb / s | |
| Lecture RDMA, unidirectionnelle | 228.23 Gb / s | |
| envoi RDMA, unidirectionnel | 228.16 Gb / s | |
| Écriture RDMA, bidirectionnelle | agrégat de 447.10 Gb/s | |
| Latence d'écriture RDMA, 8 octets | 1.46 µs en moyenne ; 1.63 et 1.66 µs au 99e percentile par voie ferroviaire | |
Comment nous avons testé le cluster
Le temps passé avec cette paire de machines étant limité, nous nous sommes concentrés sur l'inférence, la charge de travail d'IA la plus courante aujourd'hui. Nous prévoyons d'étendre ces travaux à des clusters plus importants. Dans cet article, nous avons privilégié les modèles de grande taille et comparé une seule station à deux stations en utilisant le parallélisme tensoriel (TP) et la désagrégation pré-remplissage/décodage (PD).
Le parallélisme tensoriel répartit les tenseurs de poids et les calculs du modèle sur plusieurs GPU. Dans notre configuration à deux stations (TP2), chaque B300 gère une partie du modèle et les deux traitent chaque requête. Cela nous offre davantage de mémoire à large bande passante (HBM) pour stocker les poids, ainsi qu'une puissance de calcul accrue. En revanche, les GPU doivent échanger les résultats intermédiaires et se synchroniser via NCCL tout au long de l'inférence ; les coûts de communication sont donc inclus dans le coût d'exécution du modèle.
L'inférence désagrégée répartit les étapes de préremplissage et de décodage d'une requête sur des nœuds de calcul distincts. Le préremplissage traite l'invite d'entrée et construit le cache clé/valeur (KV), l'état d'attention que le modèle réutilise lors de la génération. Le décodage utilise ensuite cet état pour générer les jetons de sortie un par un. Ces deux étapes ont des exigences de traitement différentes : le préremplissage est gourmand en ressources de calcul, tandis que le décodage nécessite une bande passante mémoire importante. Dans les configurations plus importantes, cette désagrégation de l'inférence permet à l'opérateur d'adapter indépendamment le nombre de nœuds de calcul à la demande, comme l'a démontré notre article sur le déchargement du cache KV.
Dans une configuration à nœud unique, lorsque les deux phases partagent un nœud de calcul, vLLM peut entrelacer le préremplissage des requêtes entrantes avec le décodage des requêtes en cours. Ce traitement des requêtes peut augmenter le délai entre les jetons de sortie. Dans notre configuration PD, une station gère le préremplissage et transfère le cache KV de la requête à l'autre station, qui gère le décodage. Chaque nœud de calcul a accès à sa propre copie du modèle, y compris aux données placées dans la mémoire Grace. Le nœud de calcul de décodage n'a plus besoin de planifier le traitement des nouvelles requêtes en même temps que la génération des jetons, ce qui accélère le débit d'inférence.
Pour nos tests, les besoins en mémoire du modèle ont déterminé l'approche utilisée. Pour les points de contrôle les plus volumineux, où une seule station devait décharger une quantité importante de poids du modèle vers la mémoire Grace, le traitement par lots (TP) a offert les meilleures performances. La répartition des poids sur deux GPU a permis de maintenir une plus grande partie du modèle en mémoire HBM et de réduire la pénalité de déchargement. Pour les modèles pouvant tenir correctement sur une seule station, soit entièrement en HBM, soit avec un déchargement limité vers Grace, nous avons utilisé la désagrégation PD. Cela incluait DeepSeek V4.1 Flash, avec ses tables de consultation d'engrammes placées dans la DRAM Grace.
Afin de garantir la comparabilité avec nos données précédentes, nous avons conservé notre méthodologie initiale, avec des longueurs de séquence d'entrée (ISL) et de sortie (OSL) fixes. La charge de travail équivalente utilise 512 jetons d'entrée et 512 jetons de sortie, tandis que la charge de travail avec préremplissage important utilise 8 192 jetons d'entrée et 1 024 jetons de sortie. Nous faisons varier le nombre de requêtes simultanées tout en maintenant ces longueurs de séquence constantes.
La configuration de référence à une seule station dans chaque graphique est l'ASUS ET900N G3 de notre test, balayée jusqu'à 32 flux ; les tests à deux stations vont jusqu'à 256. Chaque point correspond à un seul passage, donc une baisse à un niveau de concurrence donné est signalée telle que collectée.
Configuration d'inférence
| Modèle | Mode cluster | Logiciels | Décodage spéculatif | Souvenir de Grace |
|---|---|---|---|---|
| Flash DeepSeek V4.1 (FP8) | Désagrégation préremplissage/décodage, copie complète par station | vllm/vllm-openai:deepseekv41-flash-0909 | Dessinateur du modèle, a corrigé 5 jetons | Deux tables d'engrammes FP8 (188.84 Gio) épinglées dans la mémoire Grace, plus 131.97 Go de poids d'experts déchargés, sur chaque station |
| GLM-5.3 NVFP4 | Parallélisme tensoriel (TP2) | Conteneur NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | MTP, brouillon fixe à 5 jetons | Aucun sur le cluster ; 215 Go de poids d'experts déchargés sur une seule station |
| Flash NVFP4 GLM-5.3 | Désagrégation préremplissage/décodage, préremplissage ASUS, décodage HP | vLLM 0.28.1 RC1 | MTP, brouillon fixe à 5 jetons | Aucun |
| GLM-5.2 NVFP4 | Parallélisme tensoriel (TP2) | Conteneur NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | MTP, brouillon fixe à 3 jetons | Aucun sur le cluster ; environ 215 Go de poids d'experts déchargés sur une seule station |
| MiniMax-M3 NVFP4 | Parallélisme tensoriel (TP2) | Conteneur NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | EAGLE3, brouillon fixe à 3 jetons | Aucun sur le cluster ; une poignée d'experts répartis sur une seule station |
Performances d'inférence
Flash DeepSeek V4.1
DeepSeek V4.1 Flash fonctionnait de manière désagrégée : une station gérait le préremplissage et l’autre le décodage, chaque station contenant une copie complète du modèle. Les deux tables d’engrammes FP8, soit 188.84 Gio au total, étaient stockées dans la mémoire Grace, ainsi que 131.97 Go de poids d’experts déchargés dans cette même mémoire. Il s’agit donc de la seule configuration de l’ensemble où la mémoire Grace est utilisée sur les deux machines. C’est également le seul modèle ici sans ligne à station unique, car le test ASUS a utilisé la version V4 Flash précédente, et les deux ne sont pas directement comparables.
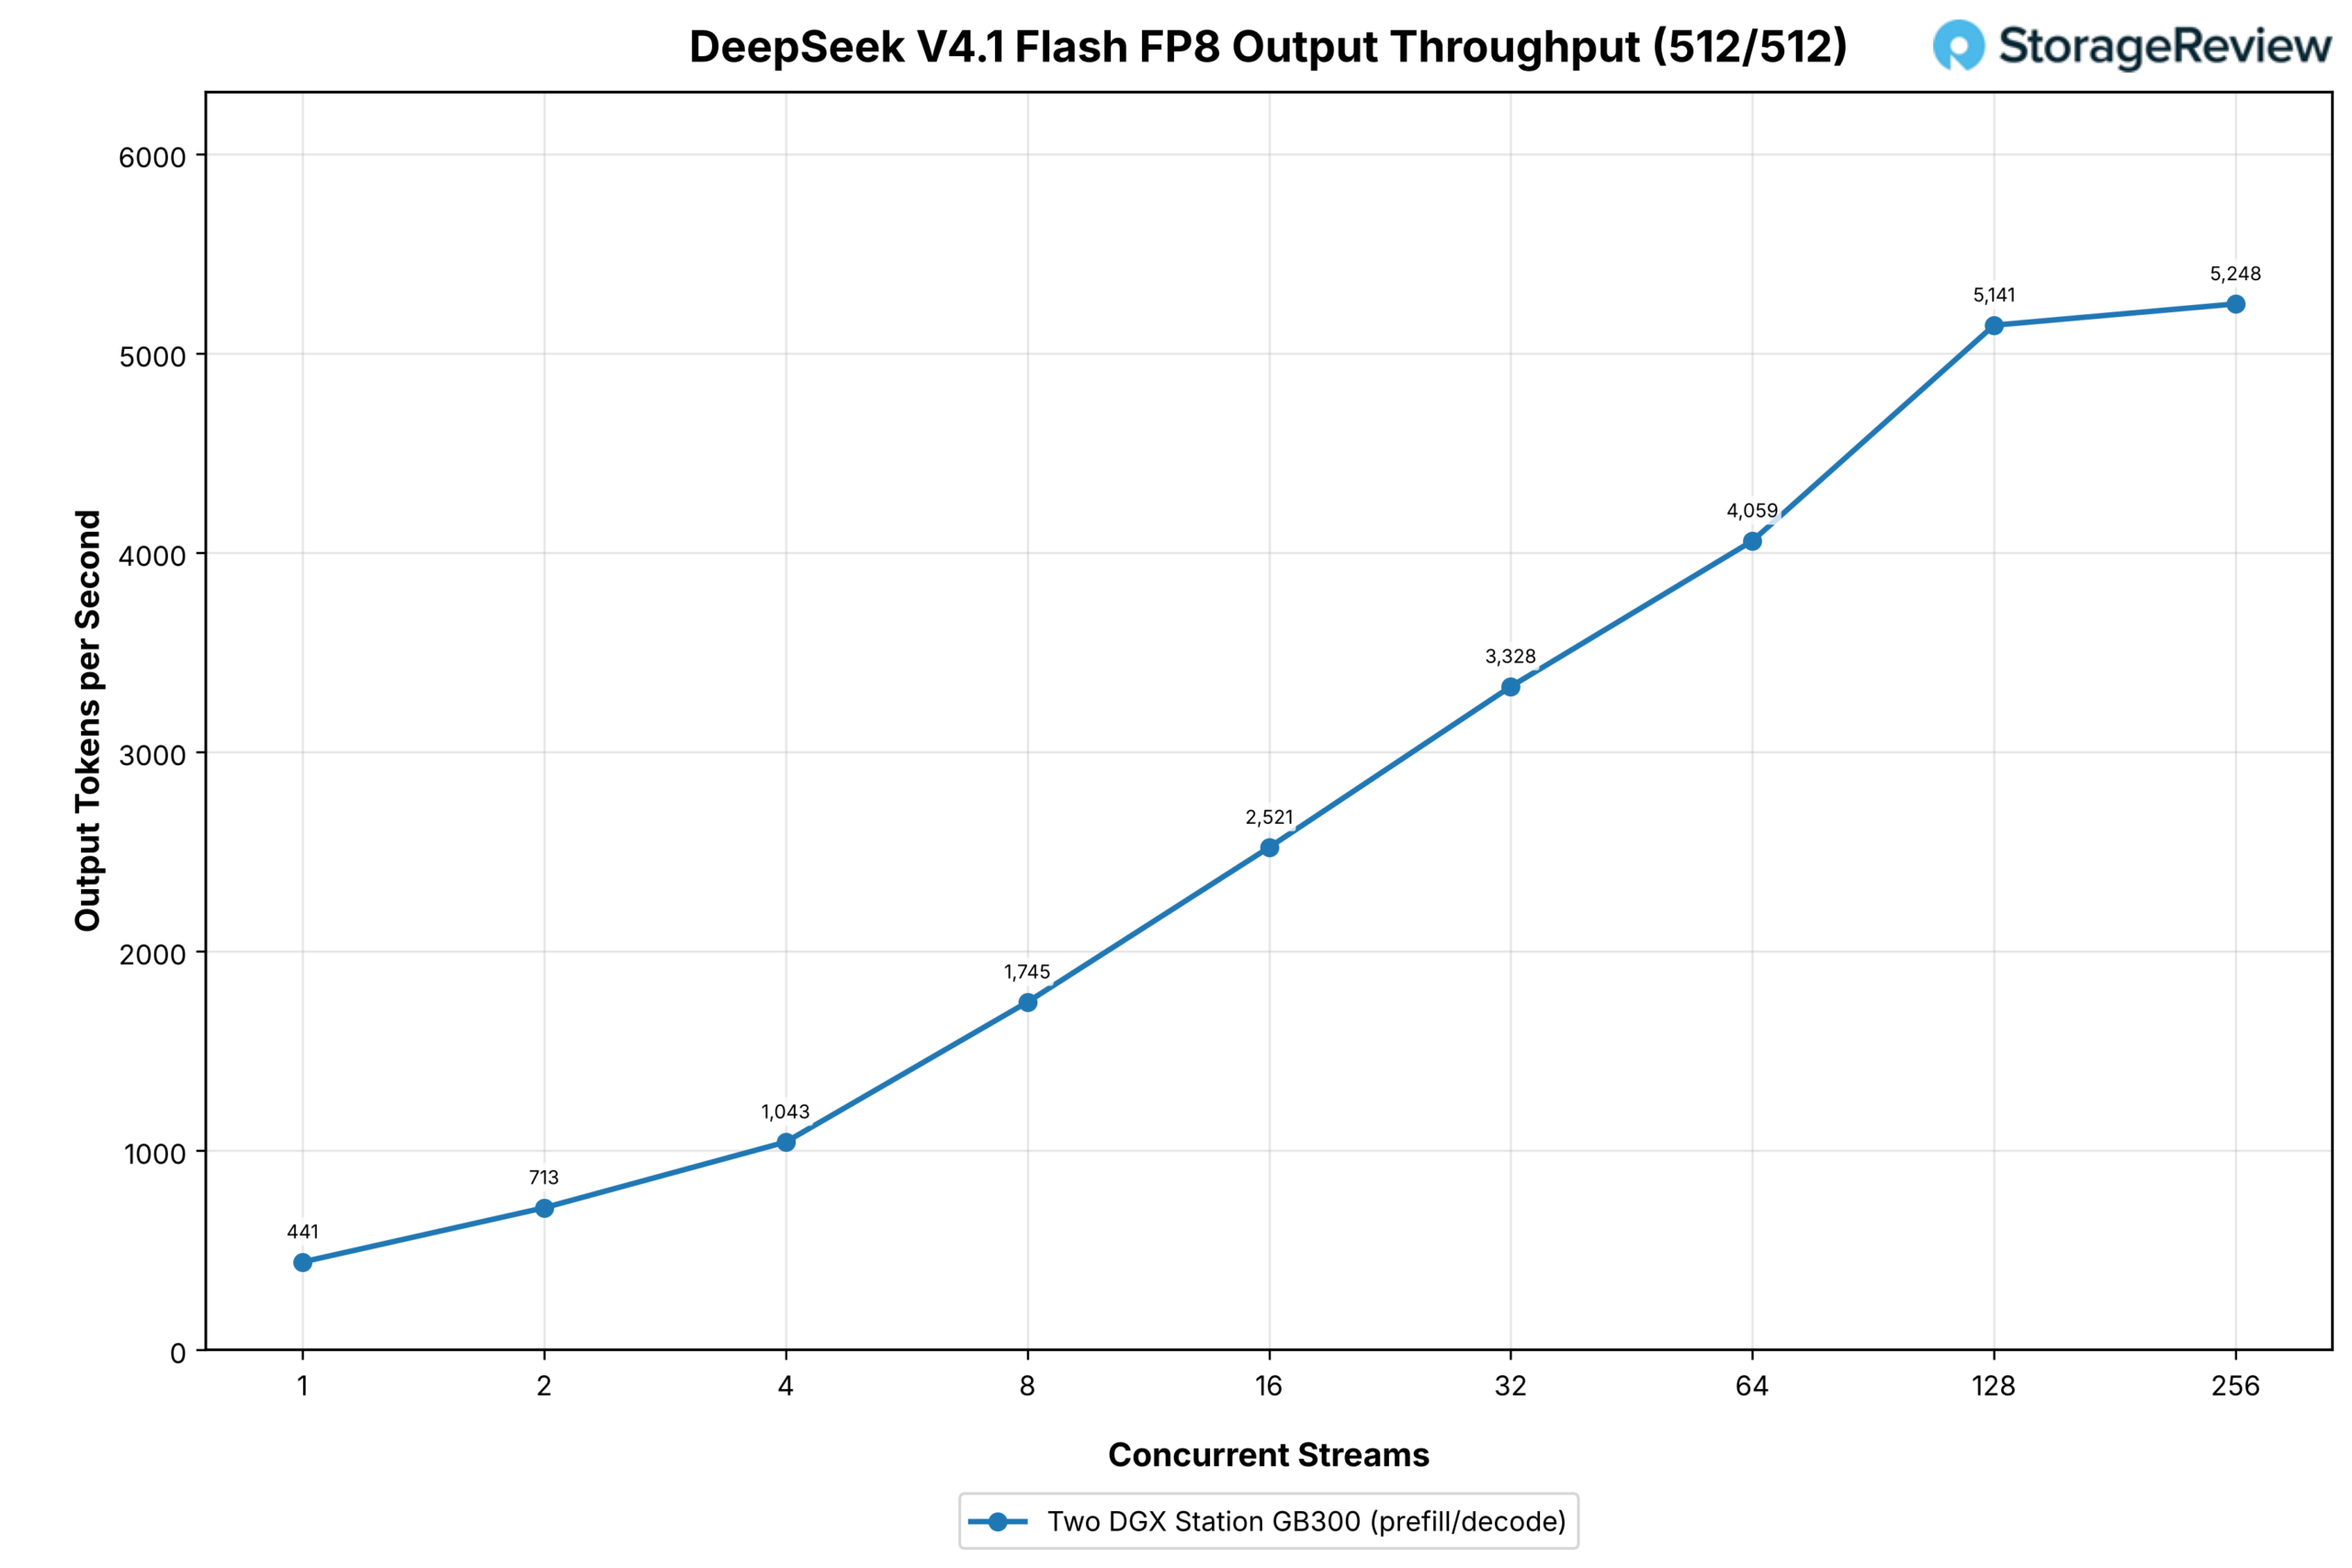
Sur le cluster à deux stations, le modèle FP8 natif a atteint un débit de sortie de 441 jetons par seconde avec un flux, 3 328 avec 32 flux, 5 141 avec 128 flux et 5 248 avec 256 flux, soit le débit de sortie le plus élevé de tous les modèles testés. La courbe ne s'aplatit qu'en haut de la plage de débit. À titre de comparaison, la station ASUS unique a géré du Flash V4 à 1 766 jetons par seconde avec 32 flux lors de notre test.
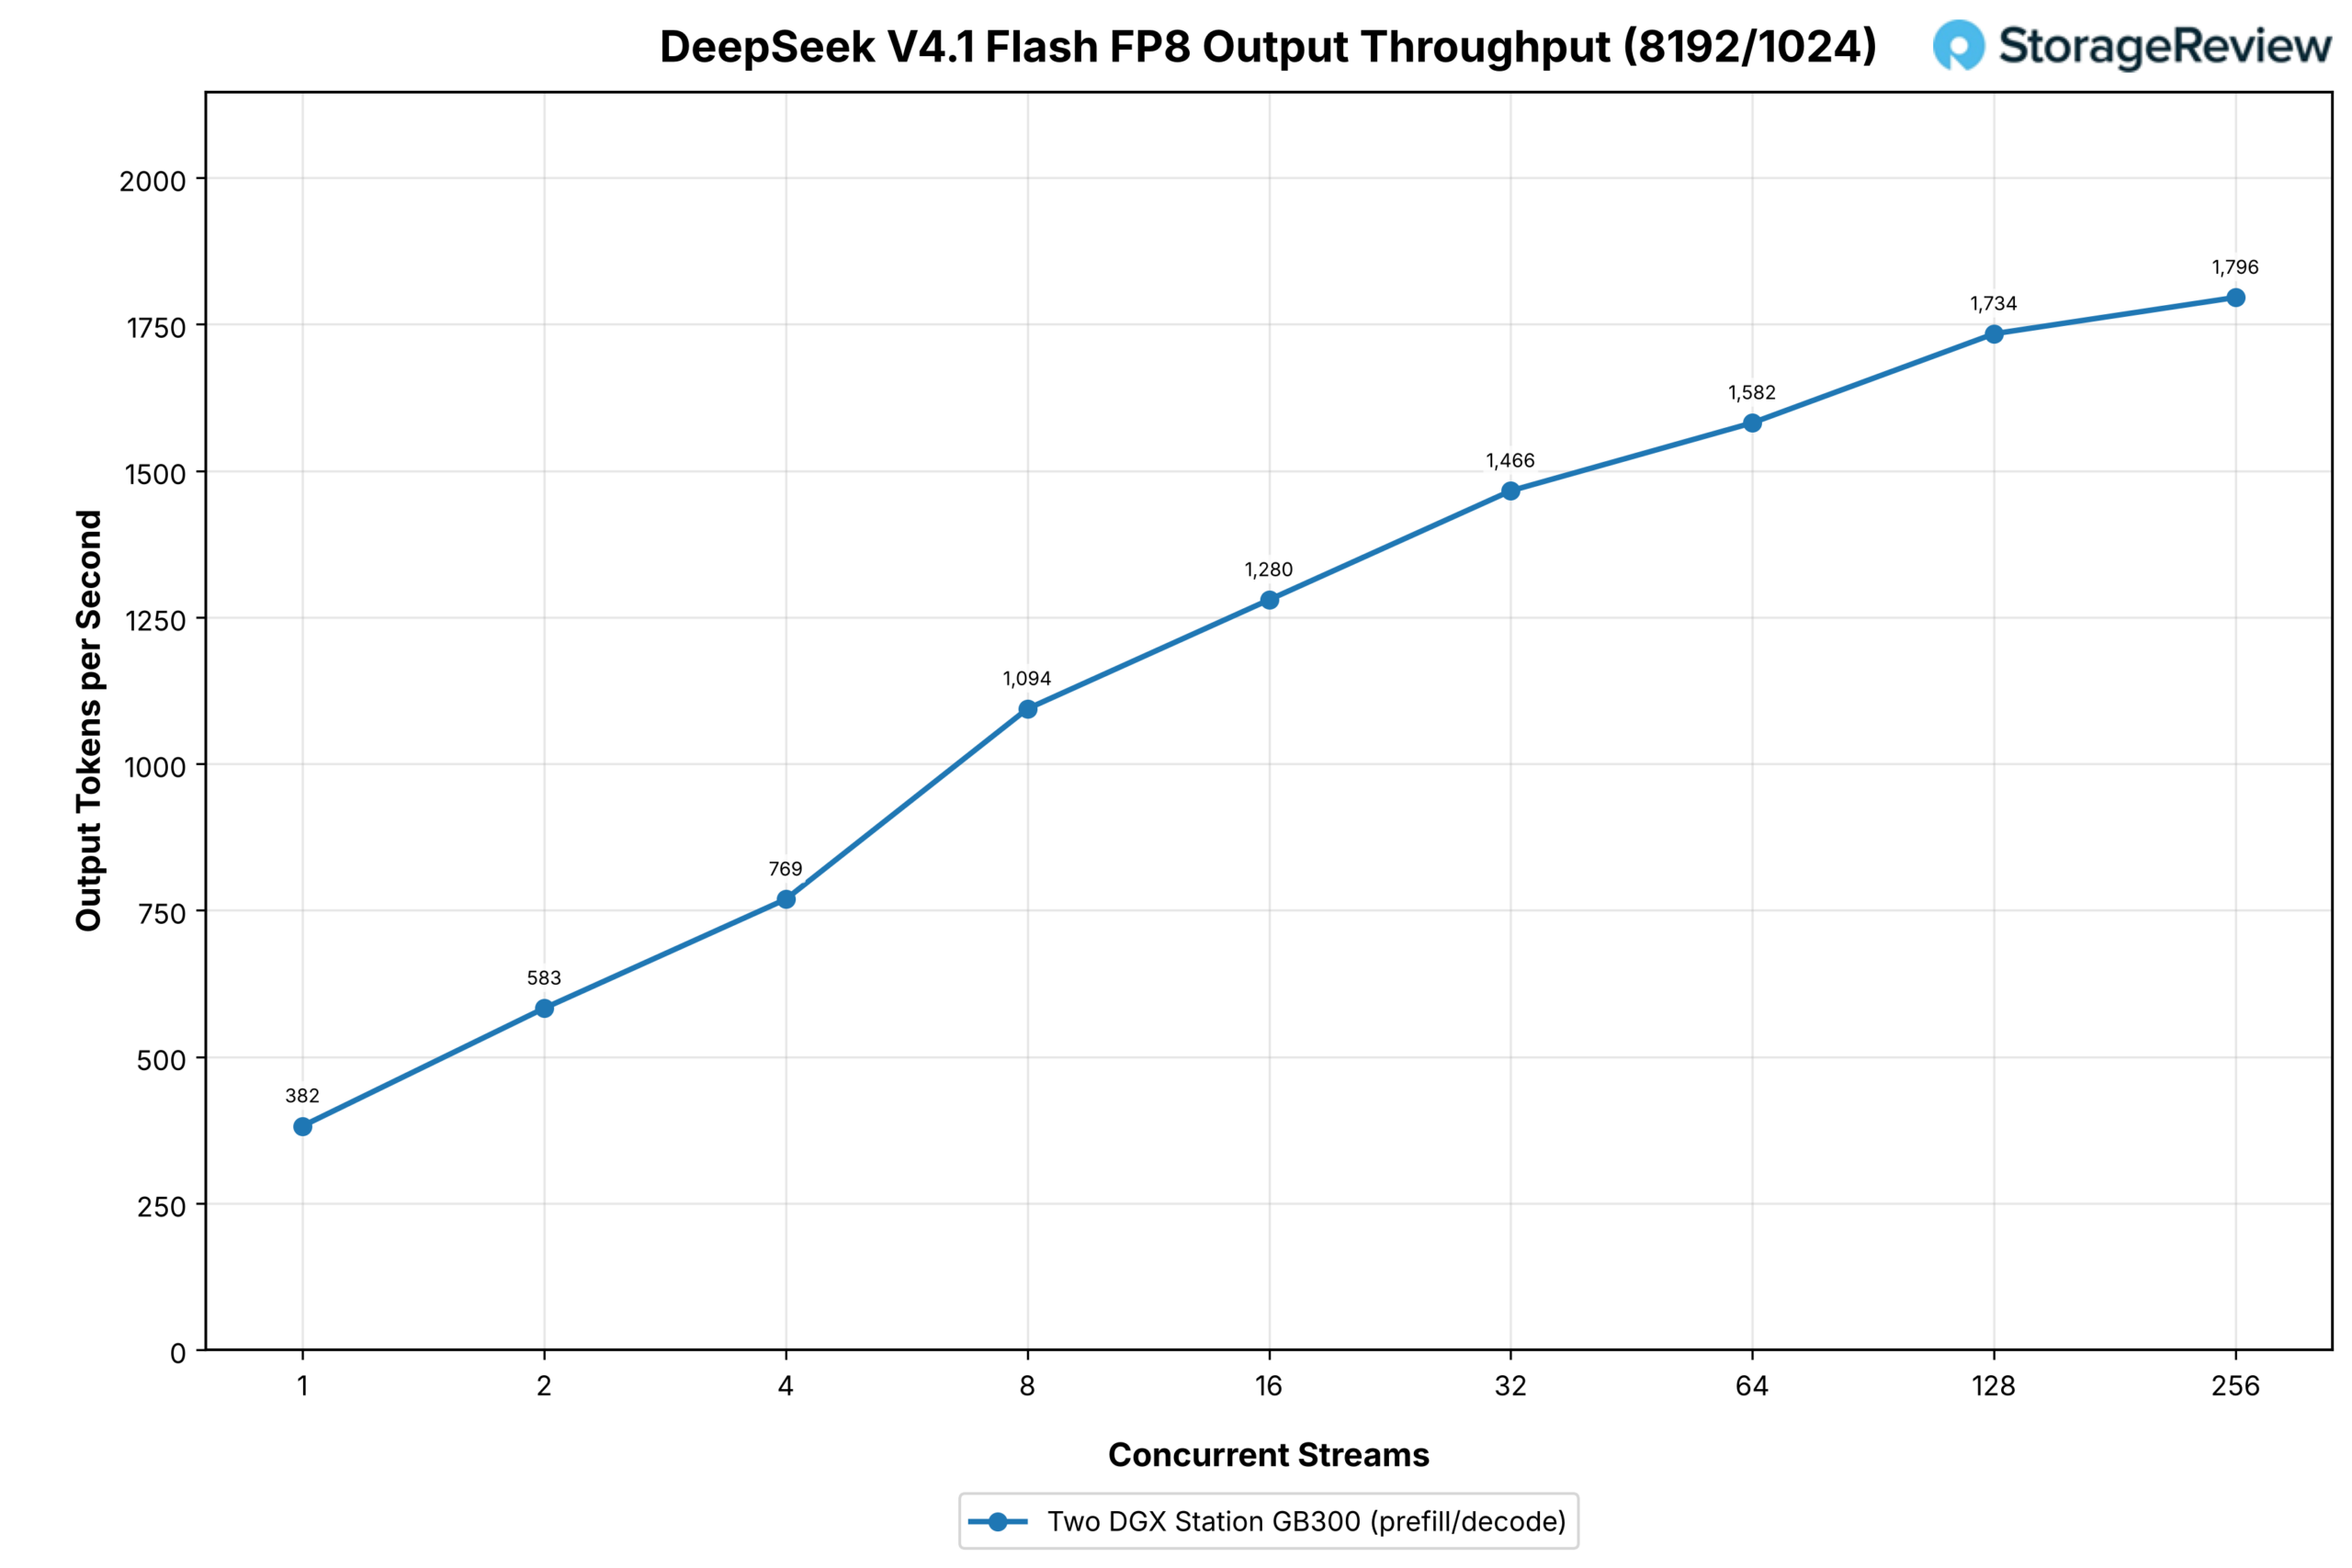
Avec un profil de préremplissage intensif, le cluster a traité 382 jetons par seconde en sortie pour un flux, 1 466 pour 32 flux et 1 796 pour 256 flux. Chaque requête transportant 8 192 jetons en entrée, le débit total a atteint 16 163 jetons par seconde en fin de cycle. Grâce aux tables d'engrammes et aux 131.97 Go de pondérations d'experts stockés dans la mémoire Grace de chaque station, les courbes restent régulières tout au long du cycle.
GLM-5.3
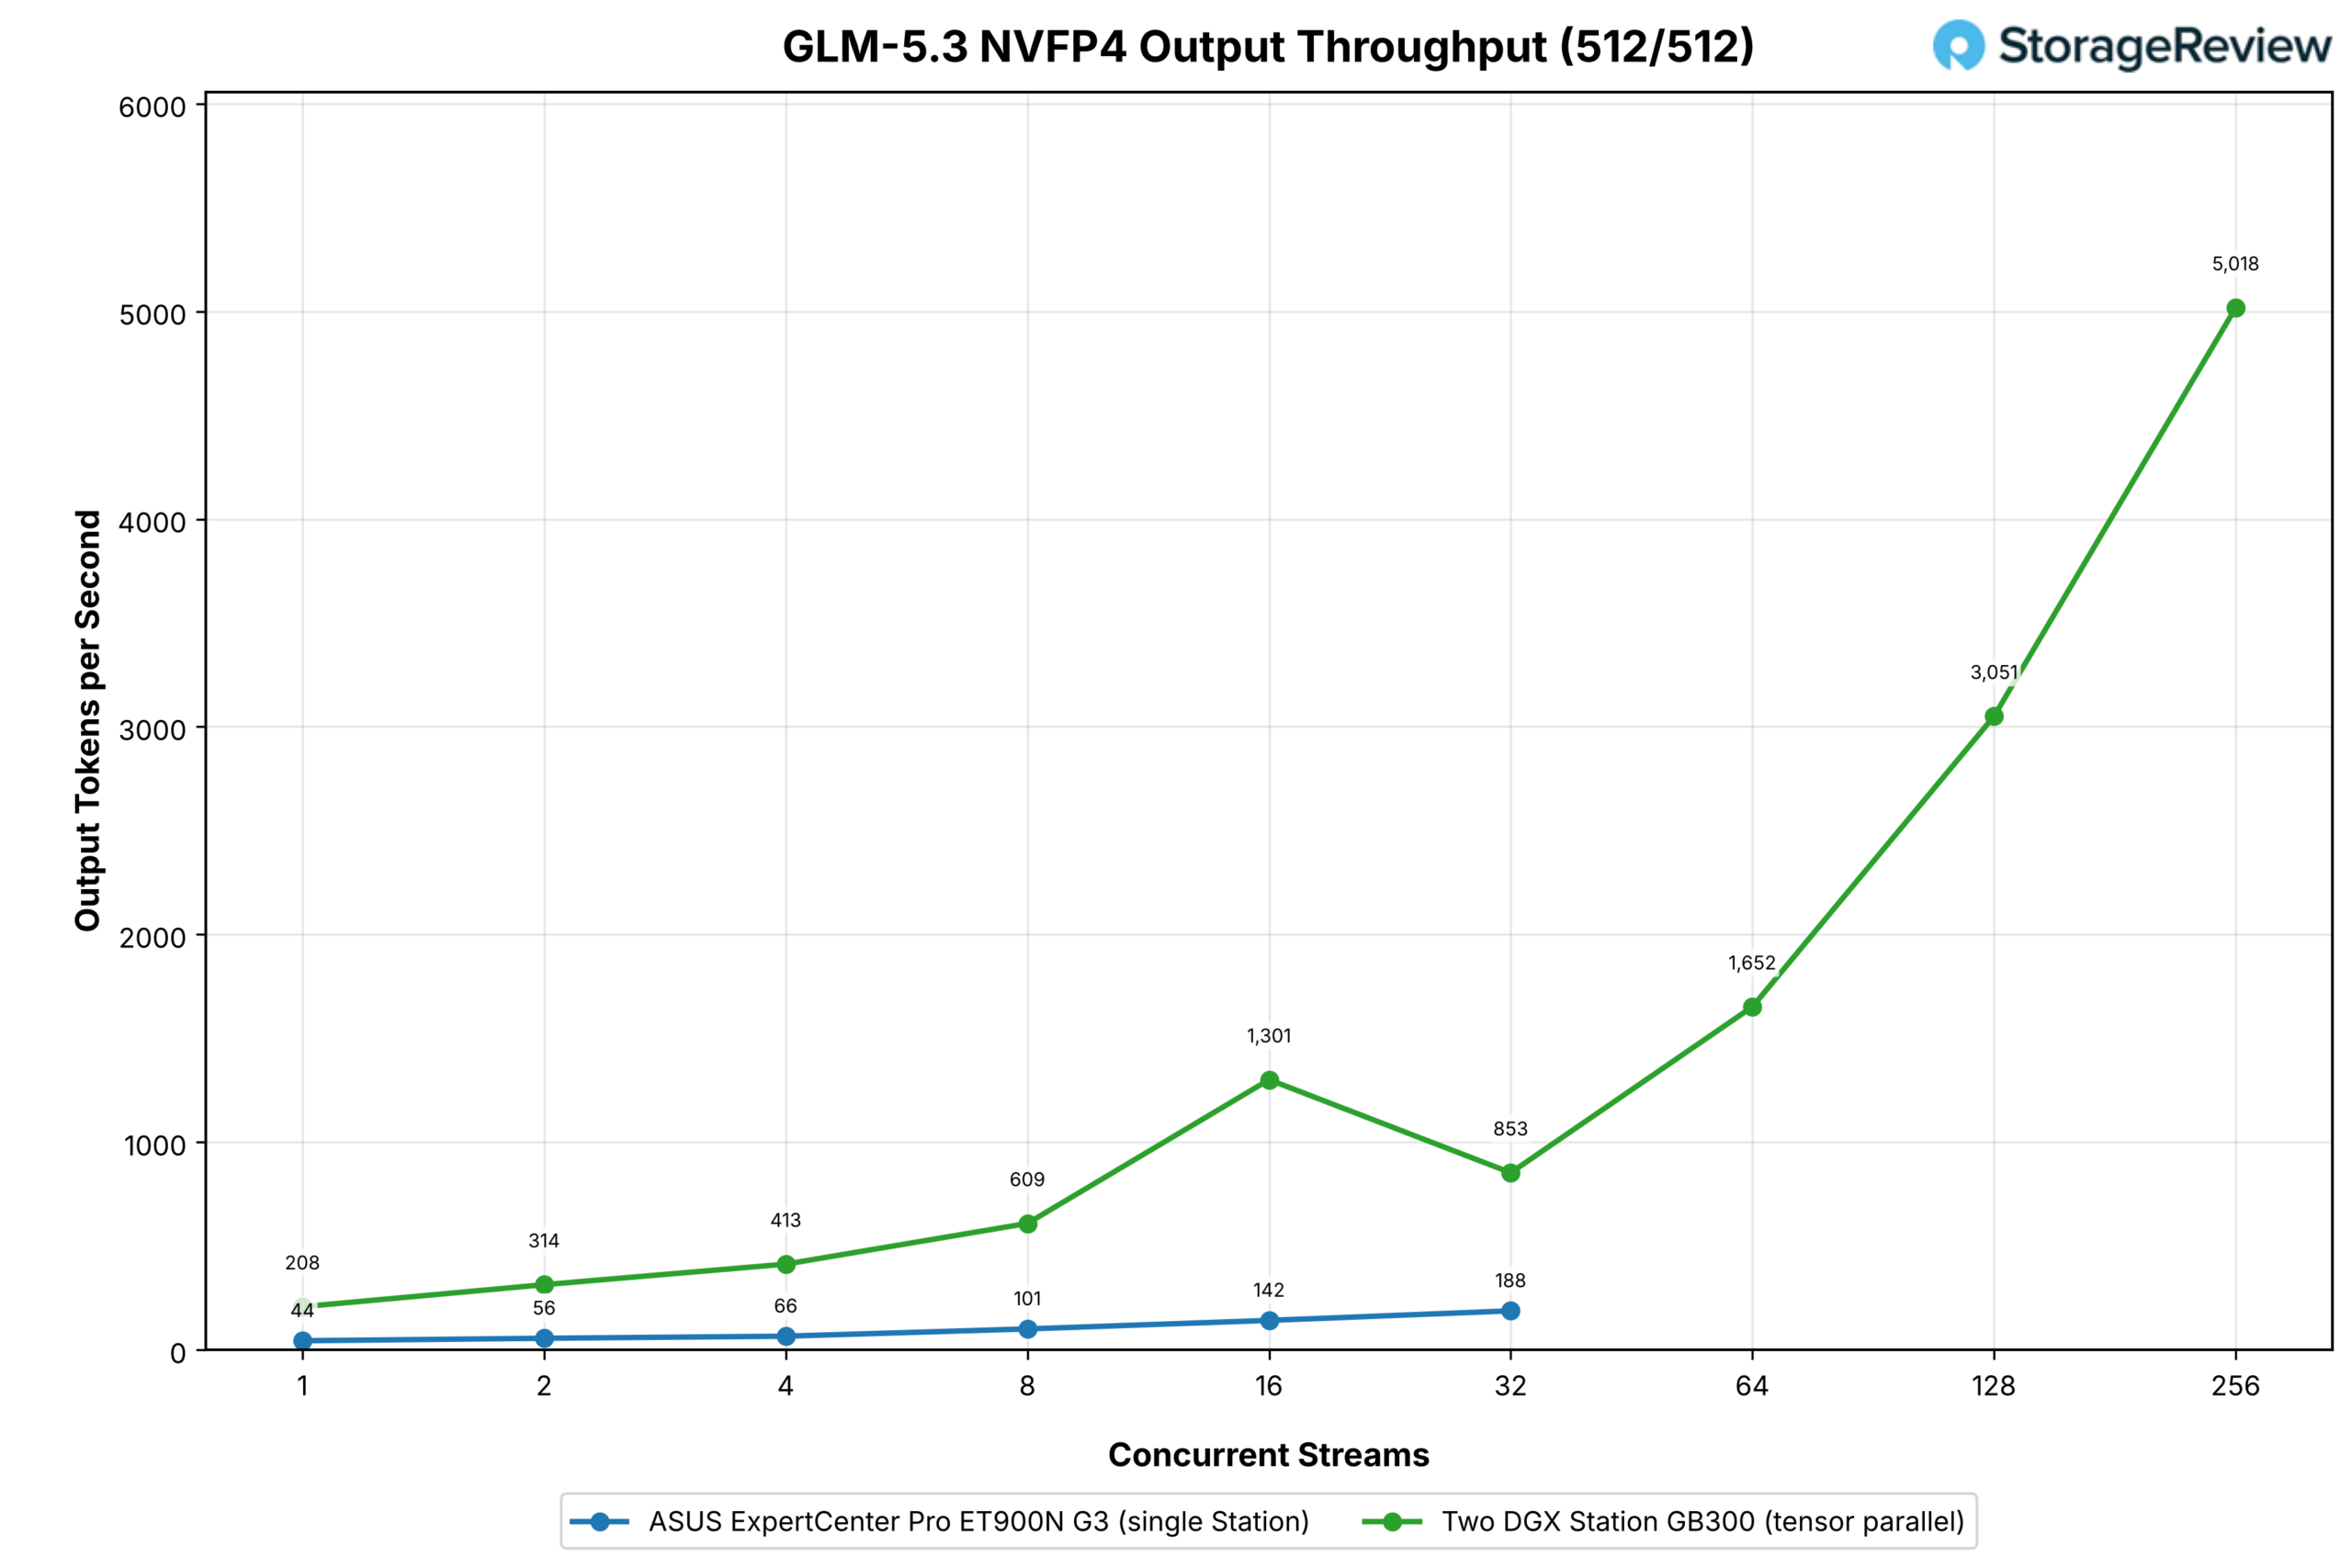
GLM-5.3 a été exécuté en TP2 sans déchargement Grace. Sur une seule station, 215 Go de poids d'experts sont déchargés dans la mémoire Grace, et les résultats du cluster suivent ceux de GLM-5.2 pendant la majeure partie du balayage avant de présenter des écarts. Une station a généré entre 44 jetons de sortie par seconde sur un flux et 188 sur 32 flux avec une charge de travail équivalente.
Le cluster à deux stations est passé de 208 à 1 301 flux (soit entre 4.7 et 9.2 fois plus qu'une seule tour), avant de chuter à 853 à 32 flux, puis de reprendre sa progression jusqu'à 1 652 à 64 flux, 3 051 à 128 et 5 018 à 256 flux. Le point à 32 flux correspond aux données collectées ; les décisions de traitement par lots et la sélection du noyau évoluent avec l'augmentation de la concurrence, et un déploiement parallèle par tenseurs ajoute un calcul collectif à chaque couche, qui doit être terminé avant l'étape suivante. La courbe n'est donc pas linéaire, mais le plafond à 256 flux est 27 fois supérieur à celui atteint par une seule station à 32 flux.
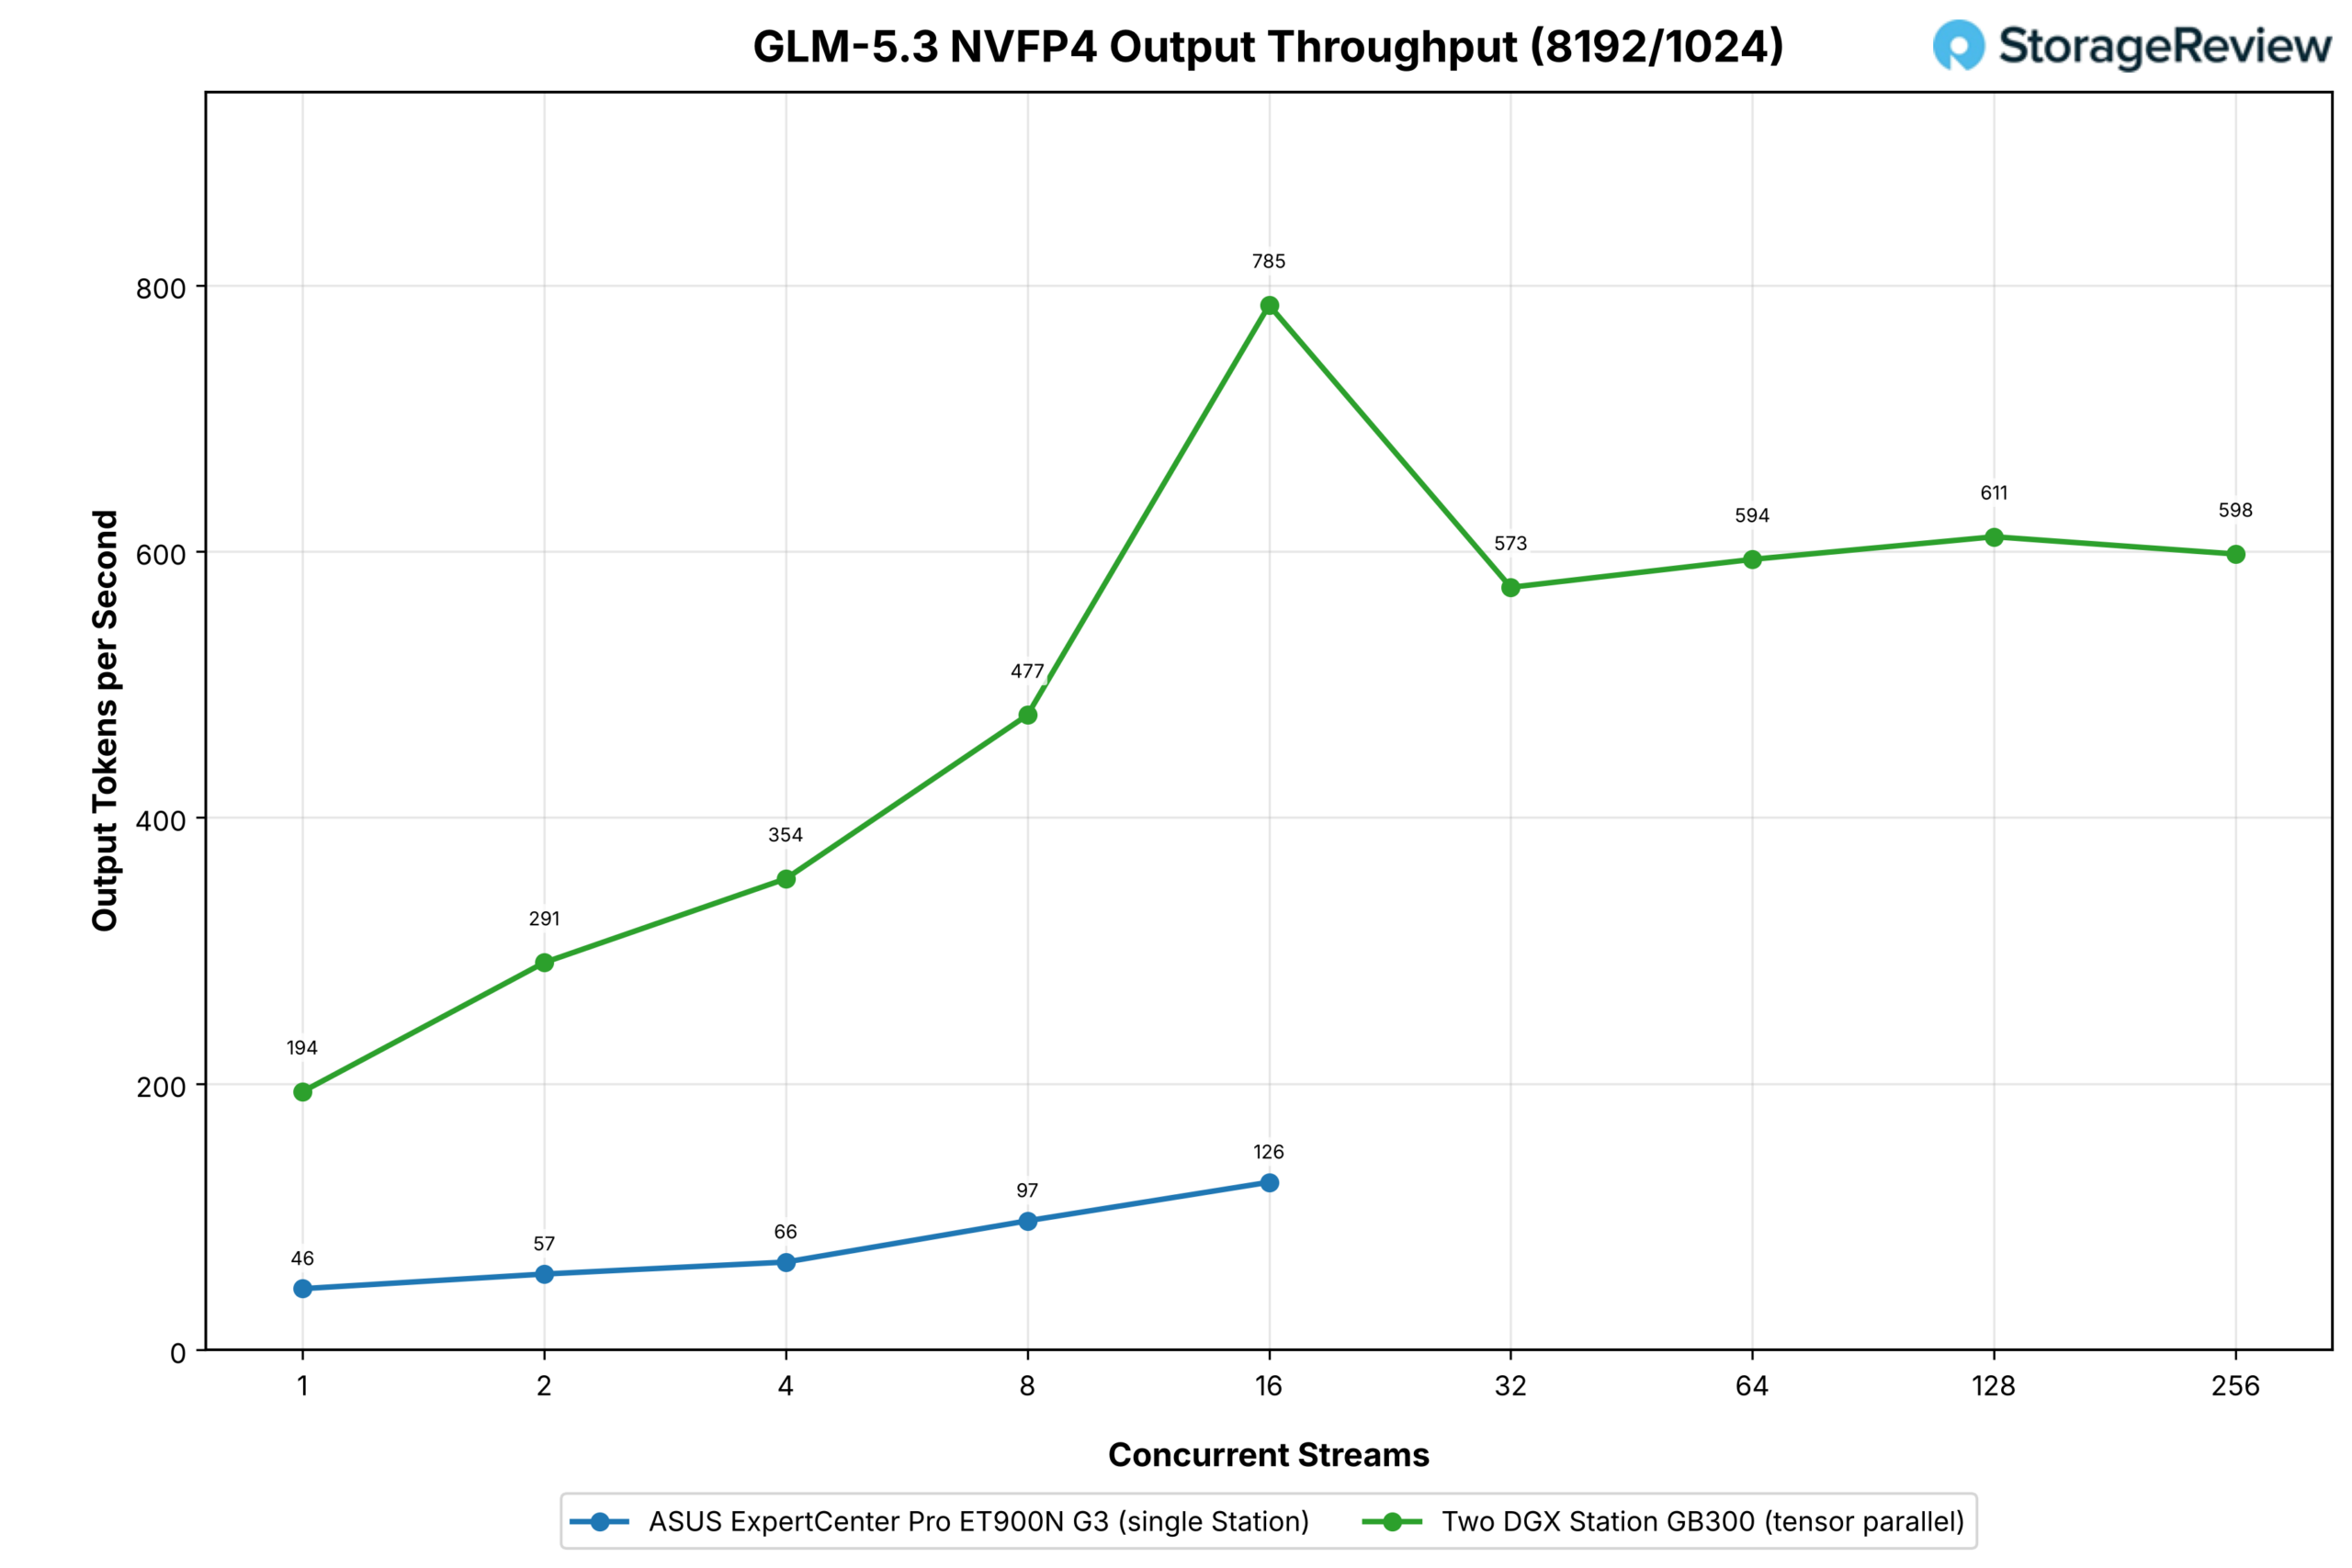
Avec un profil de préremplissage important, la station unique s'est arrêtée à 16 flux, intentionnellement : un modèle déchargé atteint rapidement sa limite et augmenter la concurrence n'apporte que peu d'avantages. Elle est passée de 46 jetons de sortie par seconde avec un seul flux à 126 avec 16 flux. Le cluster, quant à lui, est passé de 194 à 785 sur la même plage, soit une multiplication par 6.2 au maximum, puis s'est stabilisé entre 573 et 611 de 32 à 256 flux, un plafond de près de 600 jetons de sortie par seconde pour les longues invites, ce qui représente encore environ cinq fois la meilleure performance de la station unique.
Flash GLM-5.3
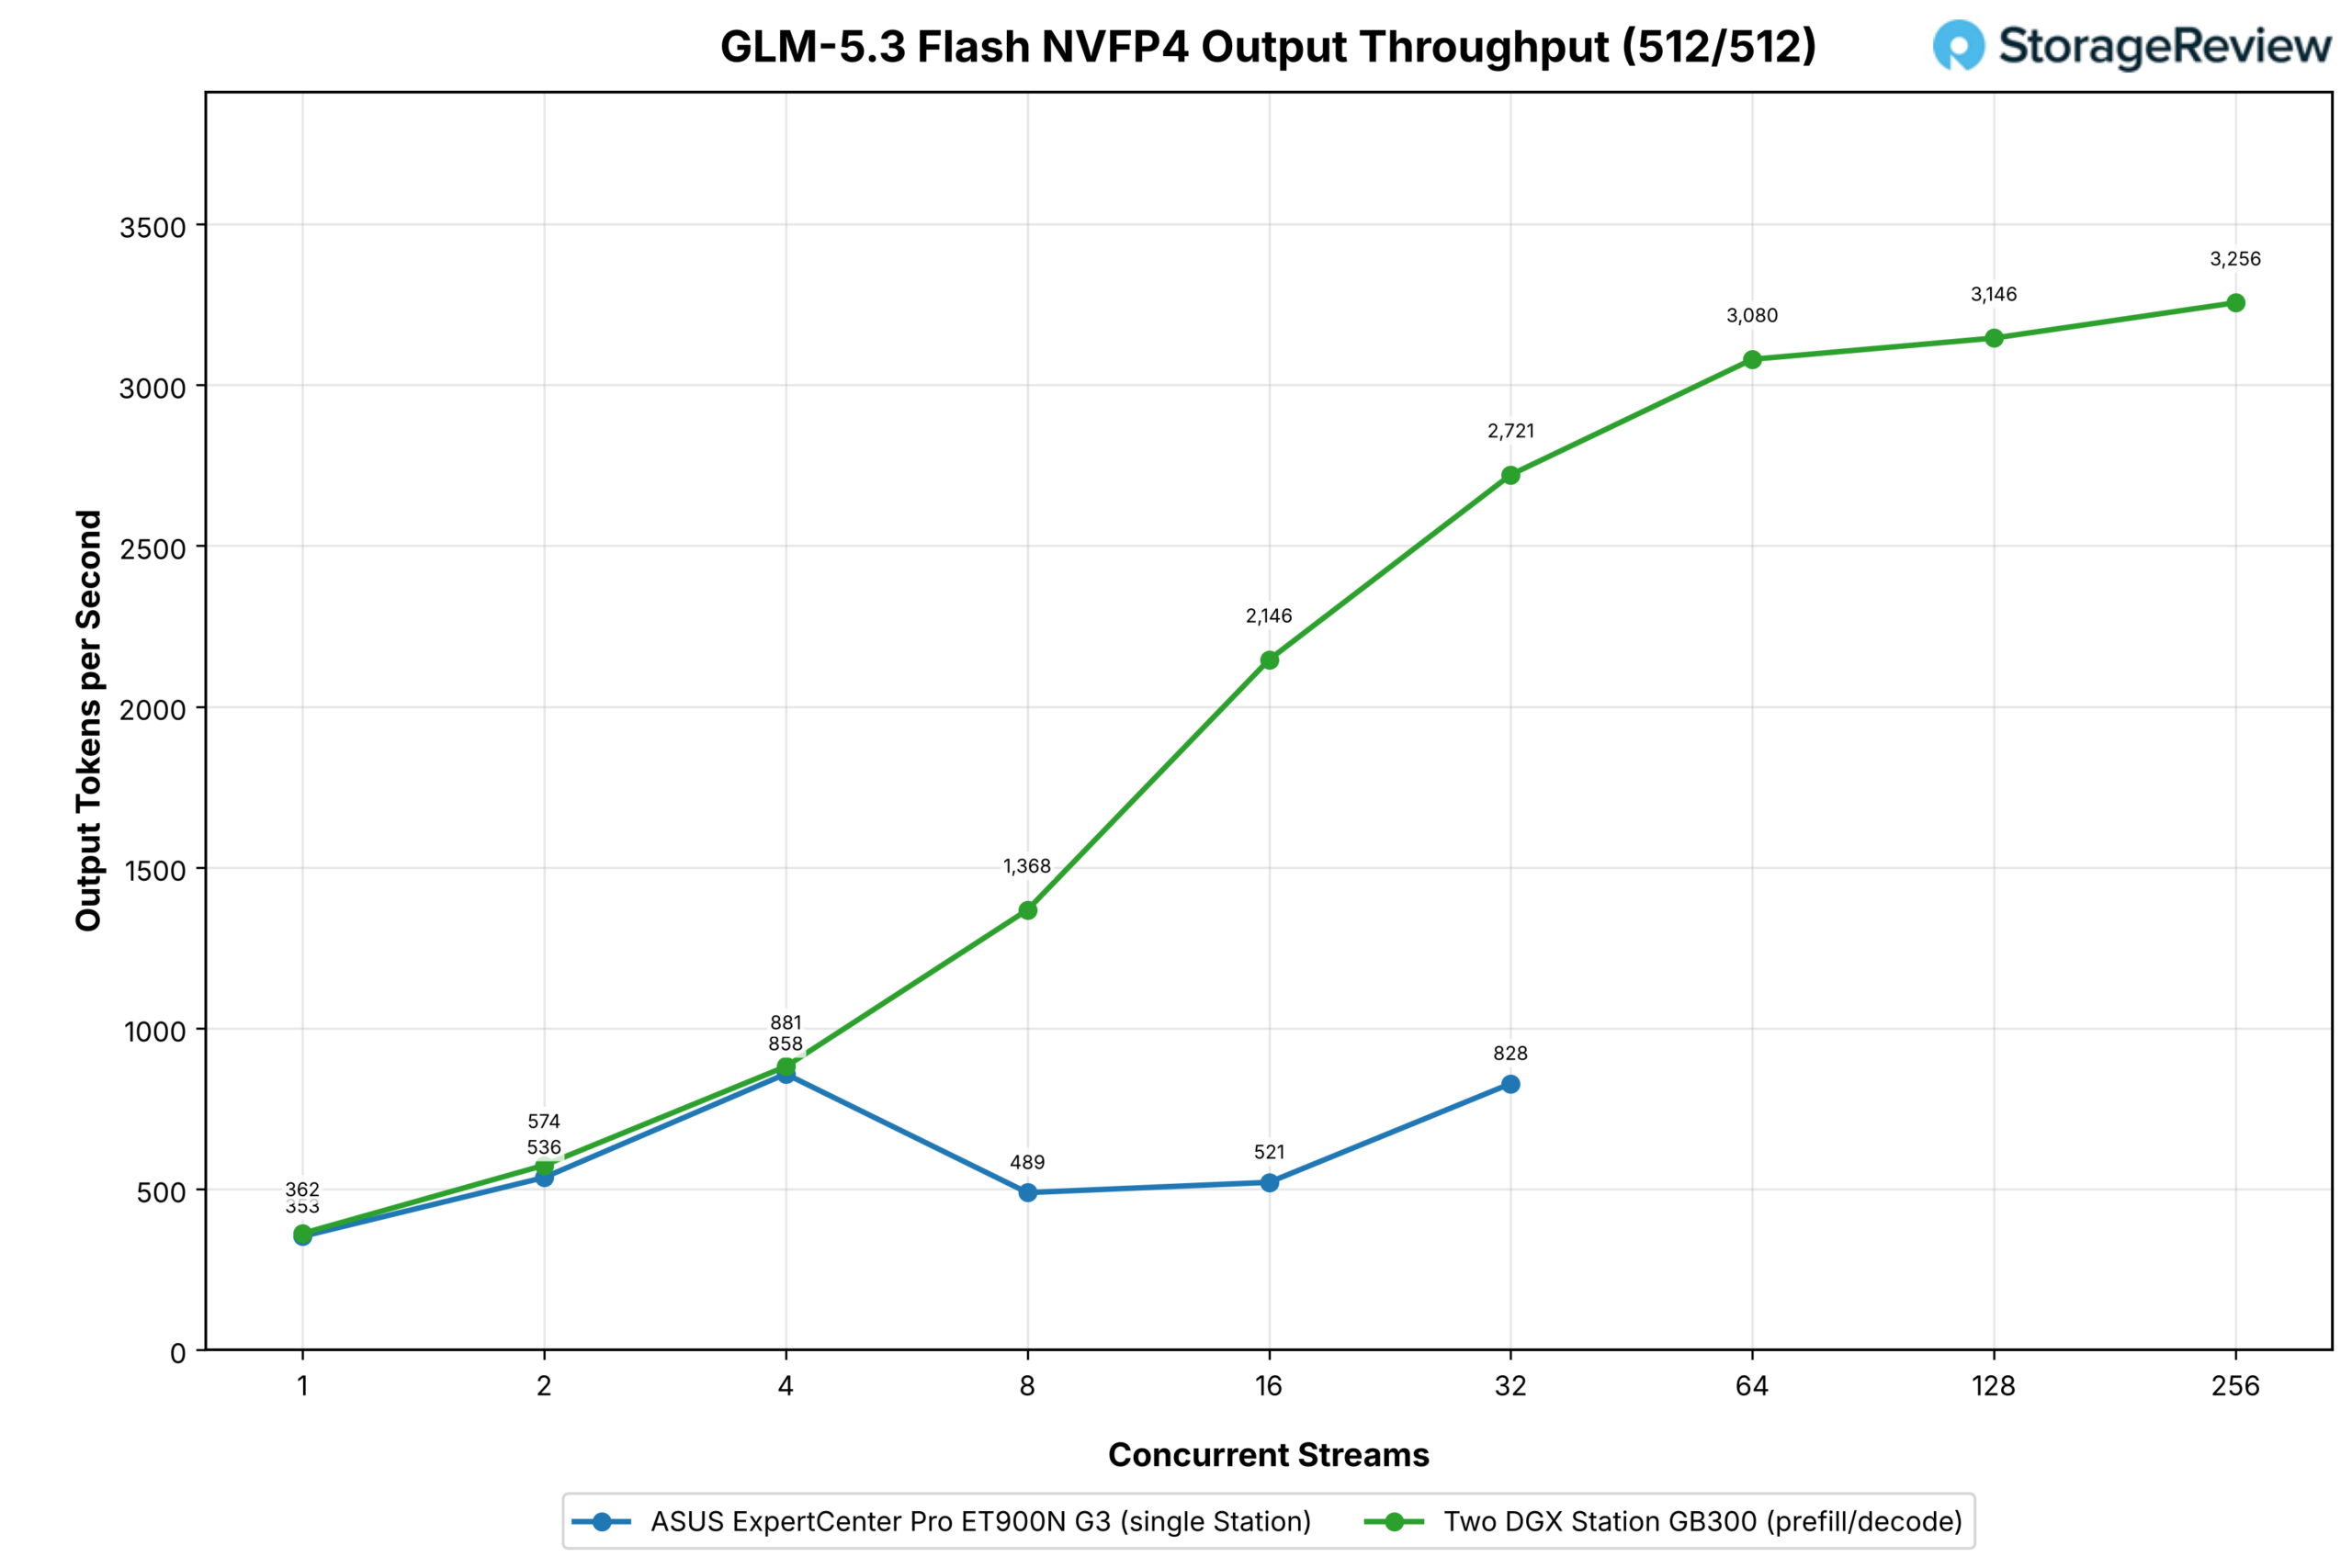
La mémoire Flash GLM-5.3 étant suffisamment petite pour que chaque station puisse contenir une copie complète, elle a fonctionné de manière désagrégée : la station ASUS gérait le préremplissage et la station HP le décodage. La mémoire Flash ayant un faible nombre de paramètres actifs, elle fonctionne déjà rapidement sur une seule station : 353 jetons de sortie par seconde avec un flux et 828 avec 32 flux à charge de travail égale, avec une valeur intermédiaire inégale (858 avec quatre flux, 489 avec huit) que nous rapportons telle que collectée.
Sur la paire désagrégée, la charge de travail égale est passée de 362 jetons de sortie par seconde sur un flux à 2 721 sur 32, soit 3.3 fois la tour unique, et jusqu'à 3 256 sur 256 flux.
Avec un ou deux flux, la paire correspond presque exactement à une seule station, ce qui est normal lorsque la station de décodage effectue le même travail seule ; le gain survient lorsqu’il y a suffisamment de requêtes en cours pour que la station de préremplissage reste occupée et que la station de décodage bénéficie de ne jamais s’interrompre pour préremplir.
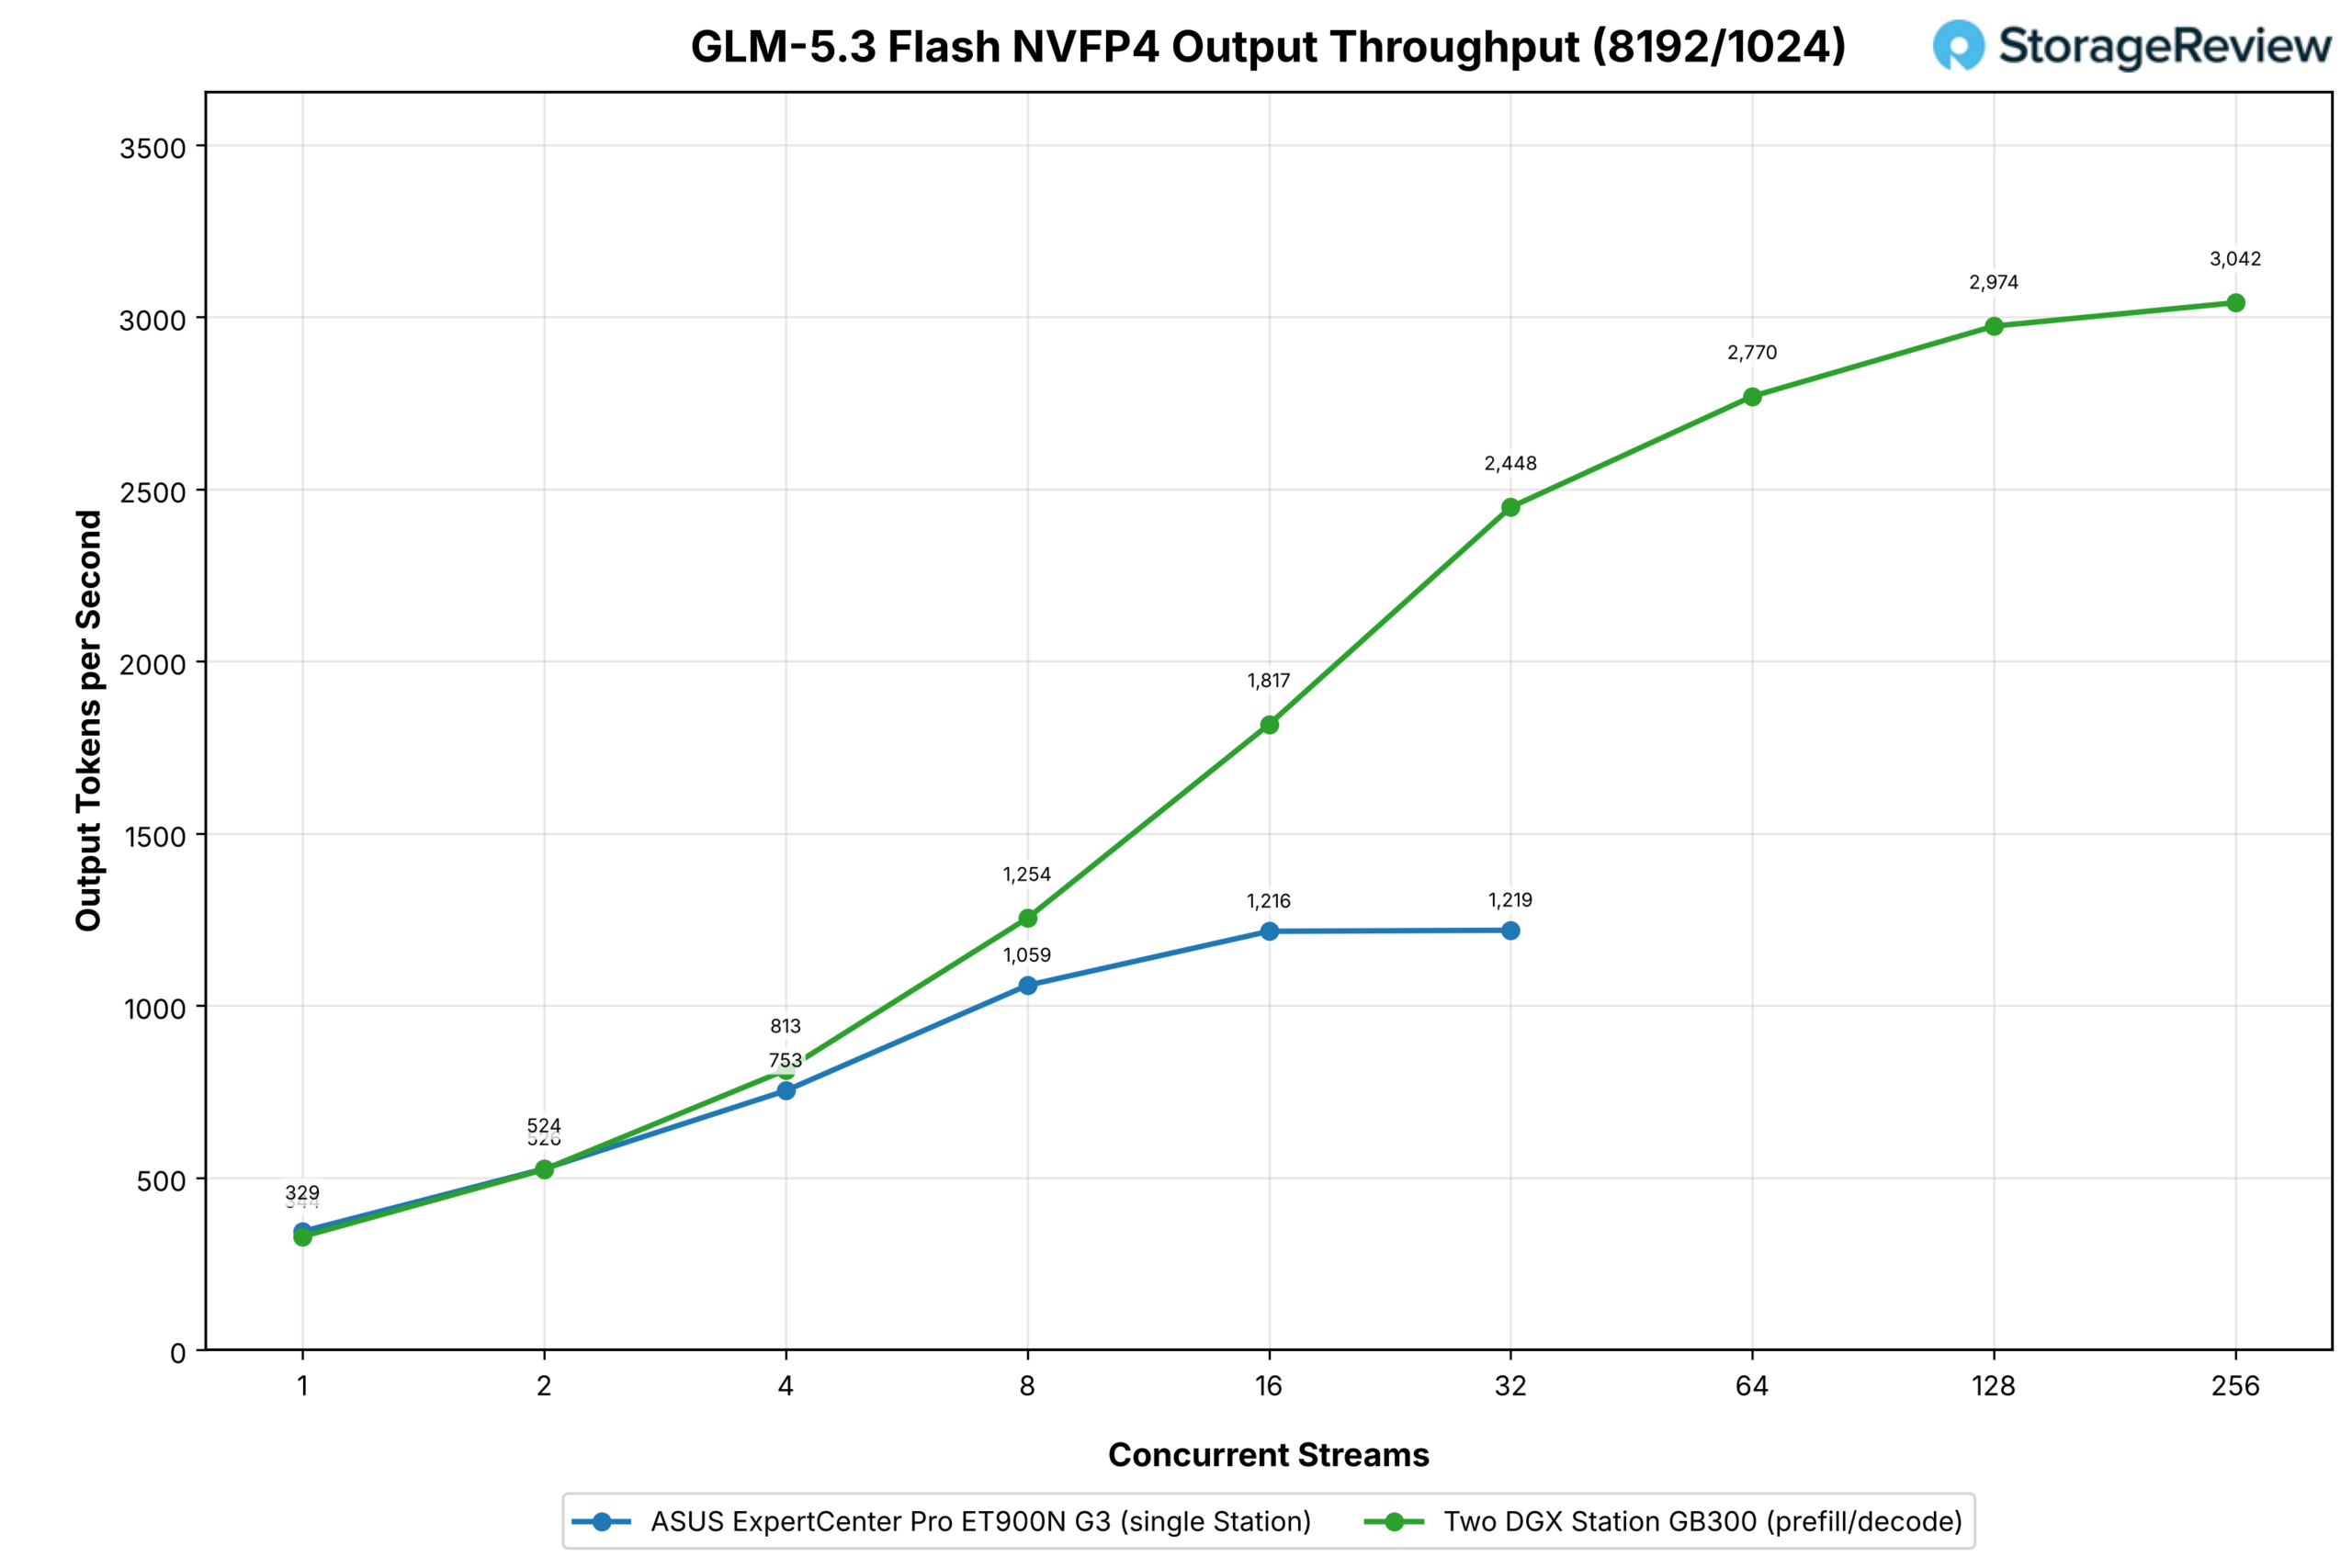
Avec un profil de préremplissage important, la station unique a vu son débit de jetons de sortie passer de 344 jetons par seconde à 1 216 jetons à 16 flux, puis s'est stabilisé à 1 219 jetons à 32 flux, restant constant à partir de 16 flux. La paire préremplissage/décodage a continué d'augmenter, passant de 329 jetons à 1 flux à 2 448 jetons à 32 flux (soit le double du débit de la station unique où il s'était stabilisé), puis à 3 042 jetons à 256 flux. Ce système est conçu pour les longues invites, car la station de préremplissage absorbe les invites de 8 192 jetons tandis que le cache KV et les ressources de calcul de la station de décodage restent dédiés à la génération.
GLM-5.2
Le modèle GLM-5.2 a été exécuté sous TP2 sans déchargement Grace sur le cluster et constitue l'argument le plus convaincant en faveur d'une seconde station. Le point de contrôle NVFP4 pèse environ 433 Go ; ainsi, sur une GB300, environ 215 Go de poids experts résident dans la mémoire Grace, et chaque étape de décodage les concernant transite par NVLink-C2C vers LPDDR5X à 396 Go/s. Répartis sur deux stations, chaque GB300 contient environ la moitié du modèle en HBM3e.
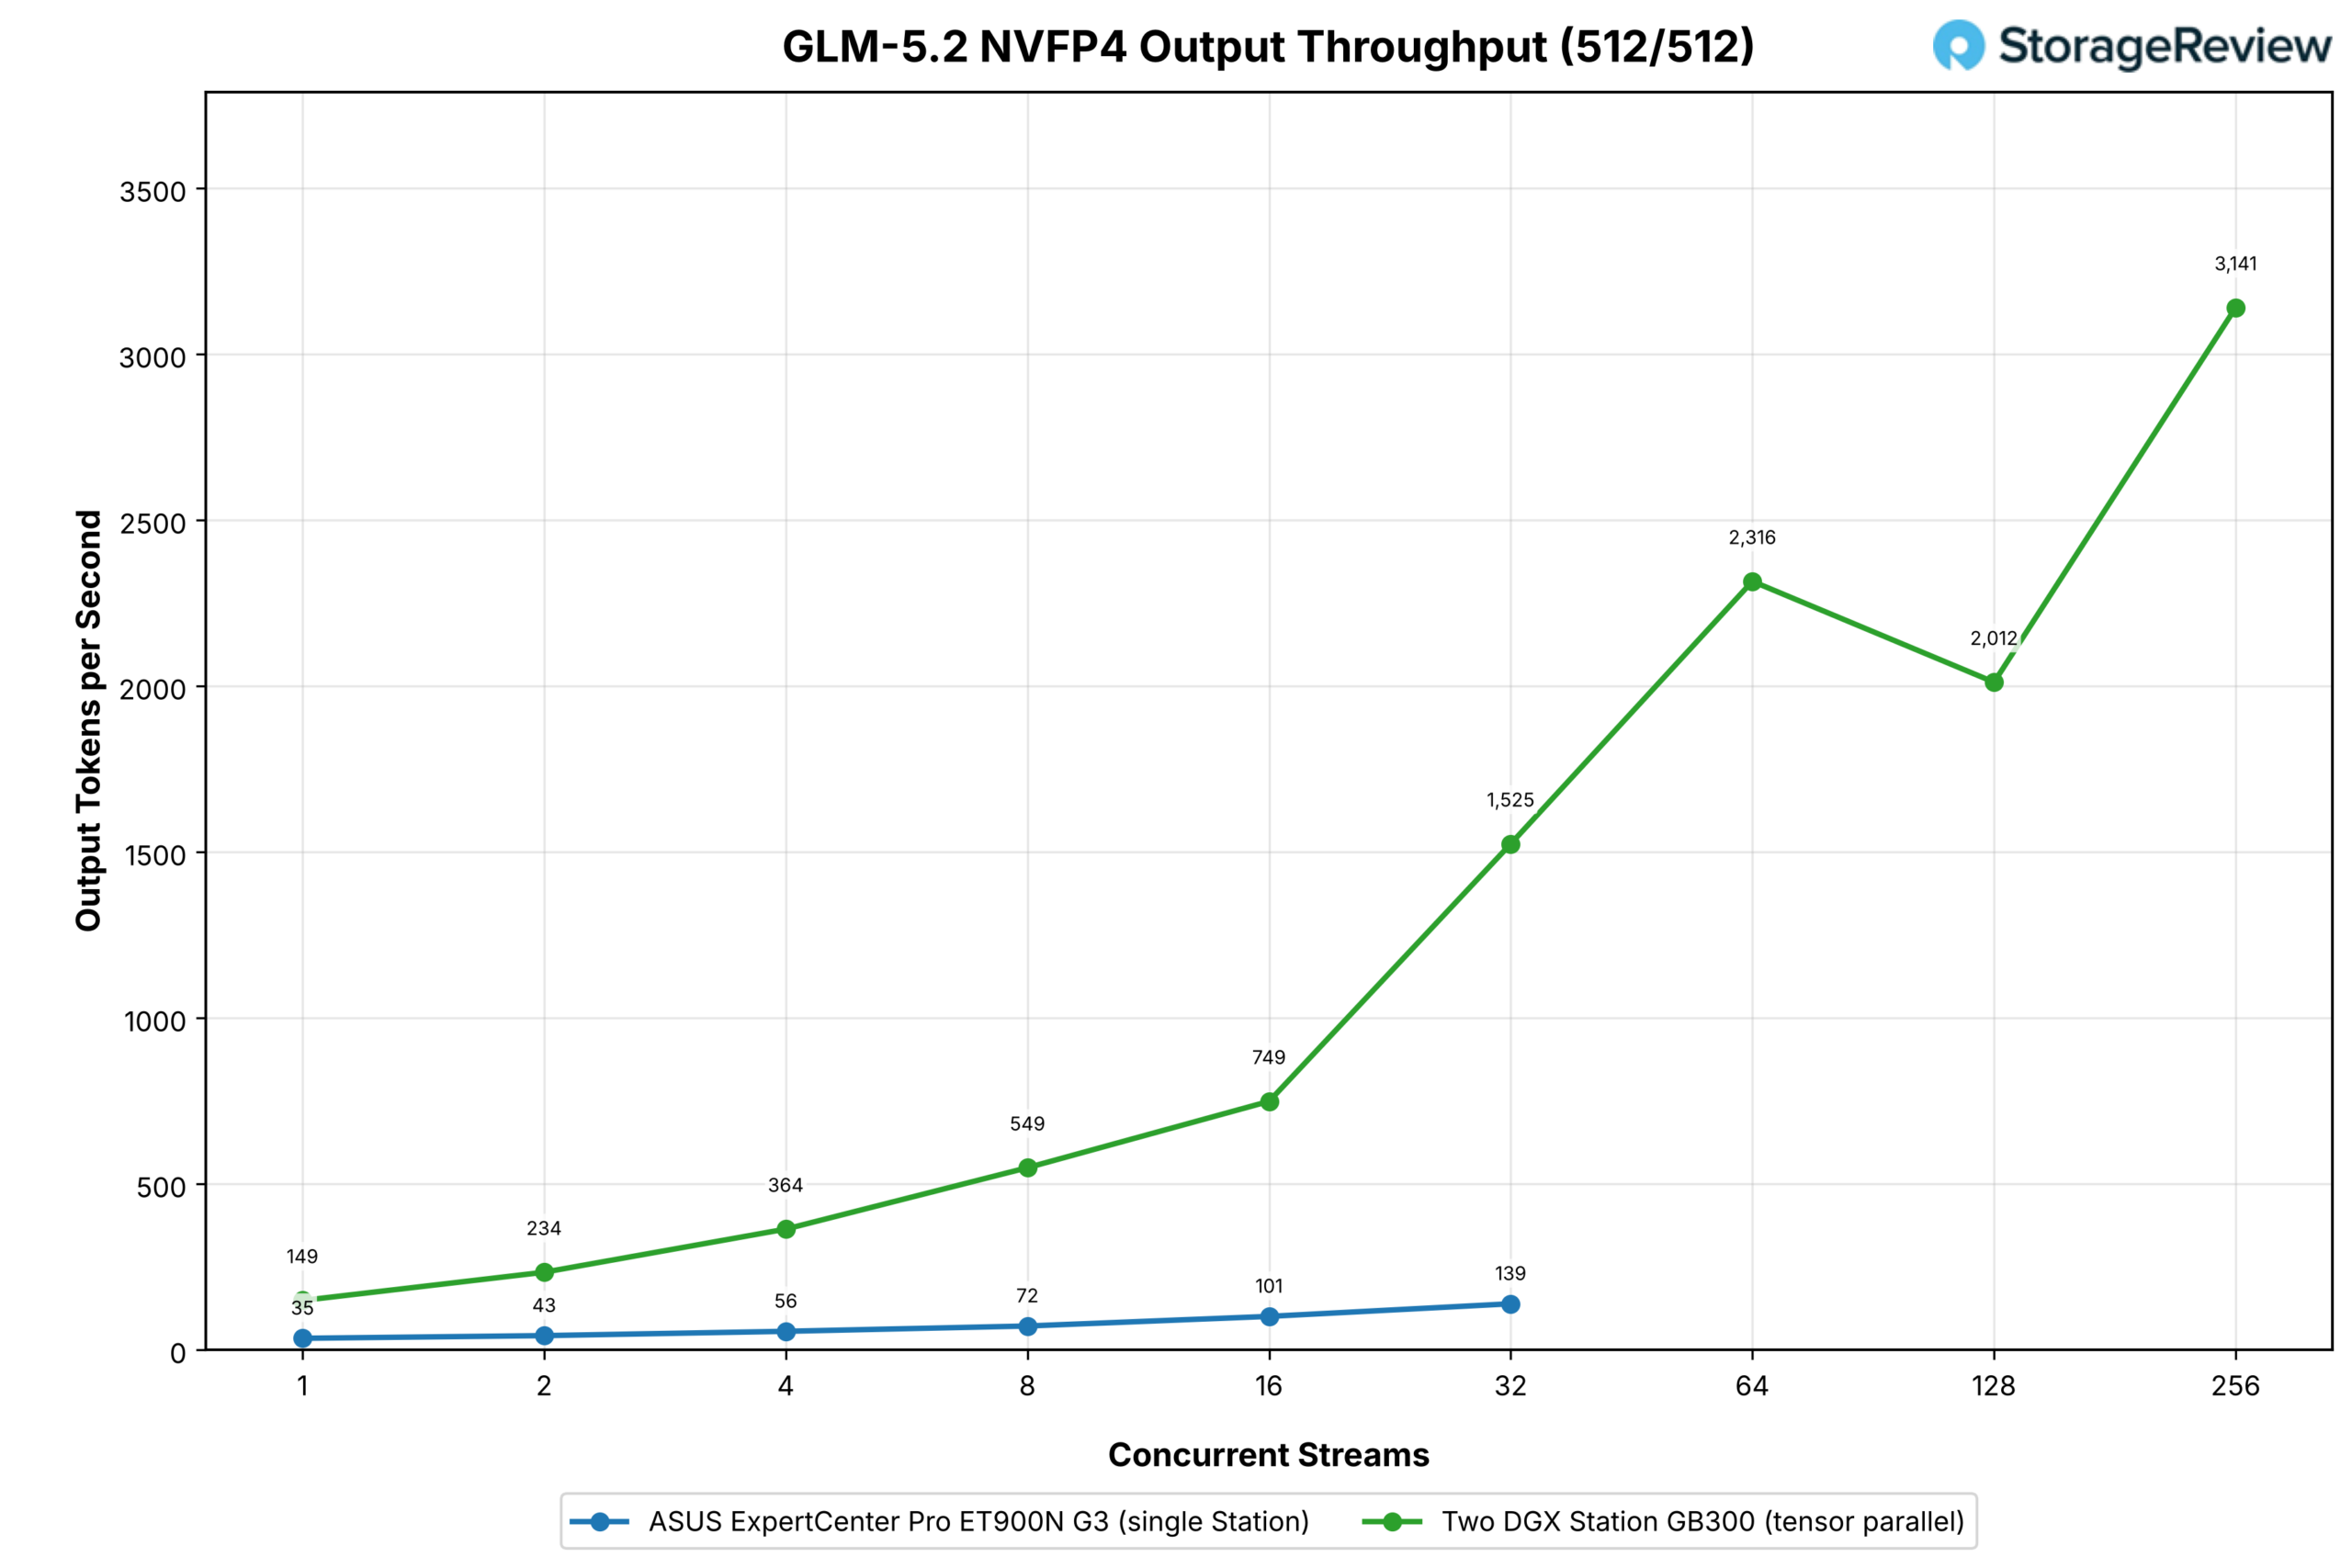
À charge de travail égale, le seul ET900N G3 a fourni 35 jetons de sortie par seconde sur un flux et 139 sur 32. Le cluster à deux stations a démarré à 149 jetons par seconde sur un flux, soit 4.3 fois plus que la station unique, a atteint 1 525 sur 32 flux, soit 11 fois plus, et a continué à dépasser les performances de la station unique pour atteindre 2 316 sur 64 et 3 141 sur 256, avec une baisse à 2 012 sur 128. Un modèle permettant à une seule station de gérer une conversation à un petit nombre d'utilisateurs devient un modèle que deux stations peuvent gérer pour un département.
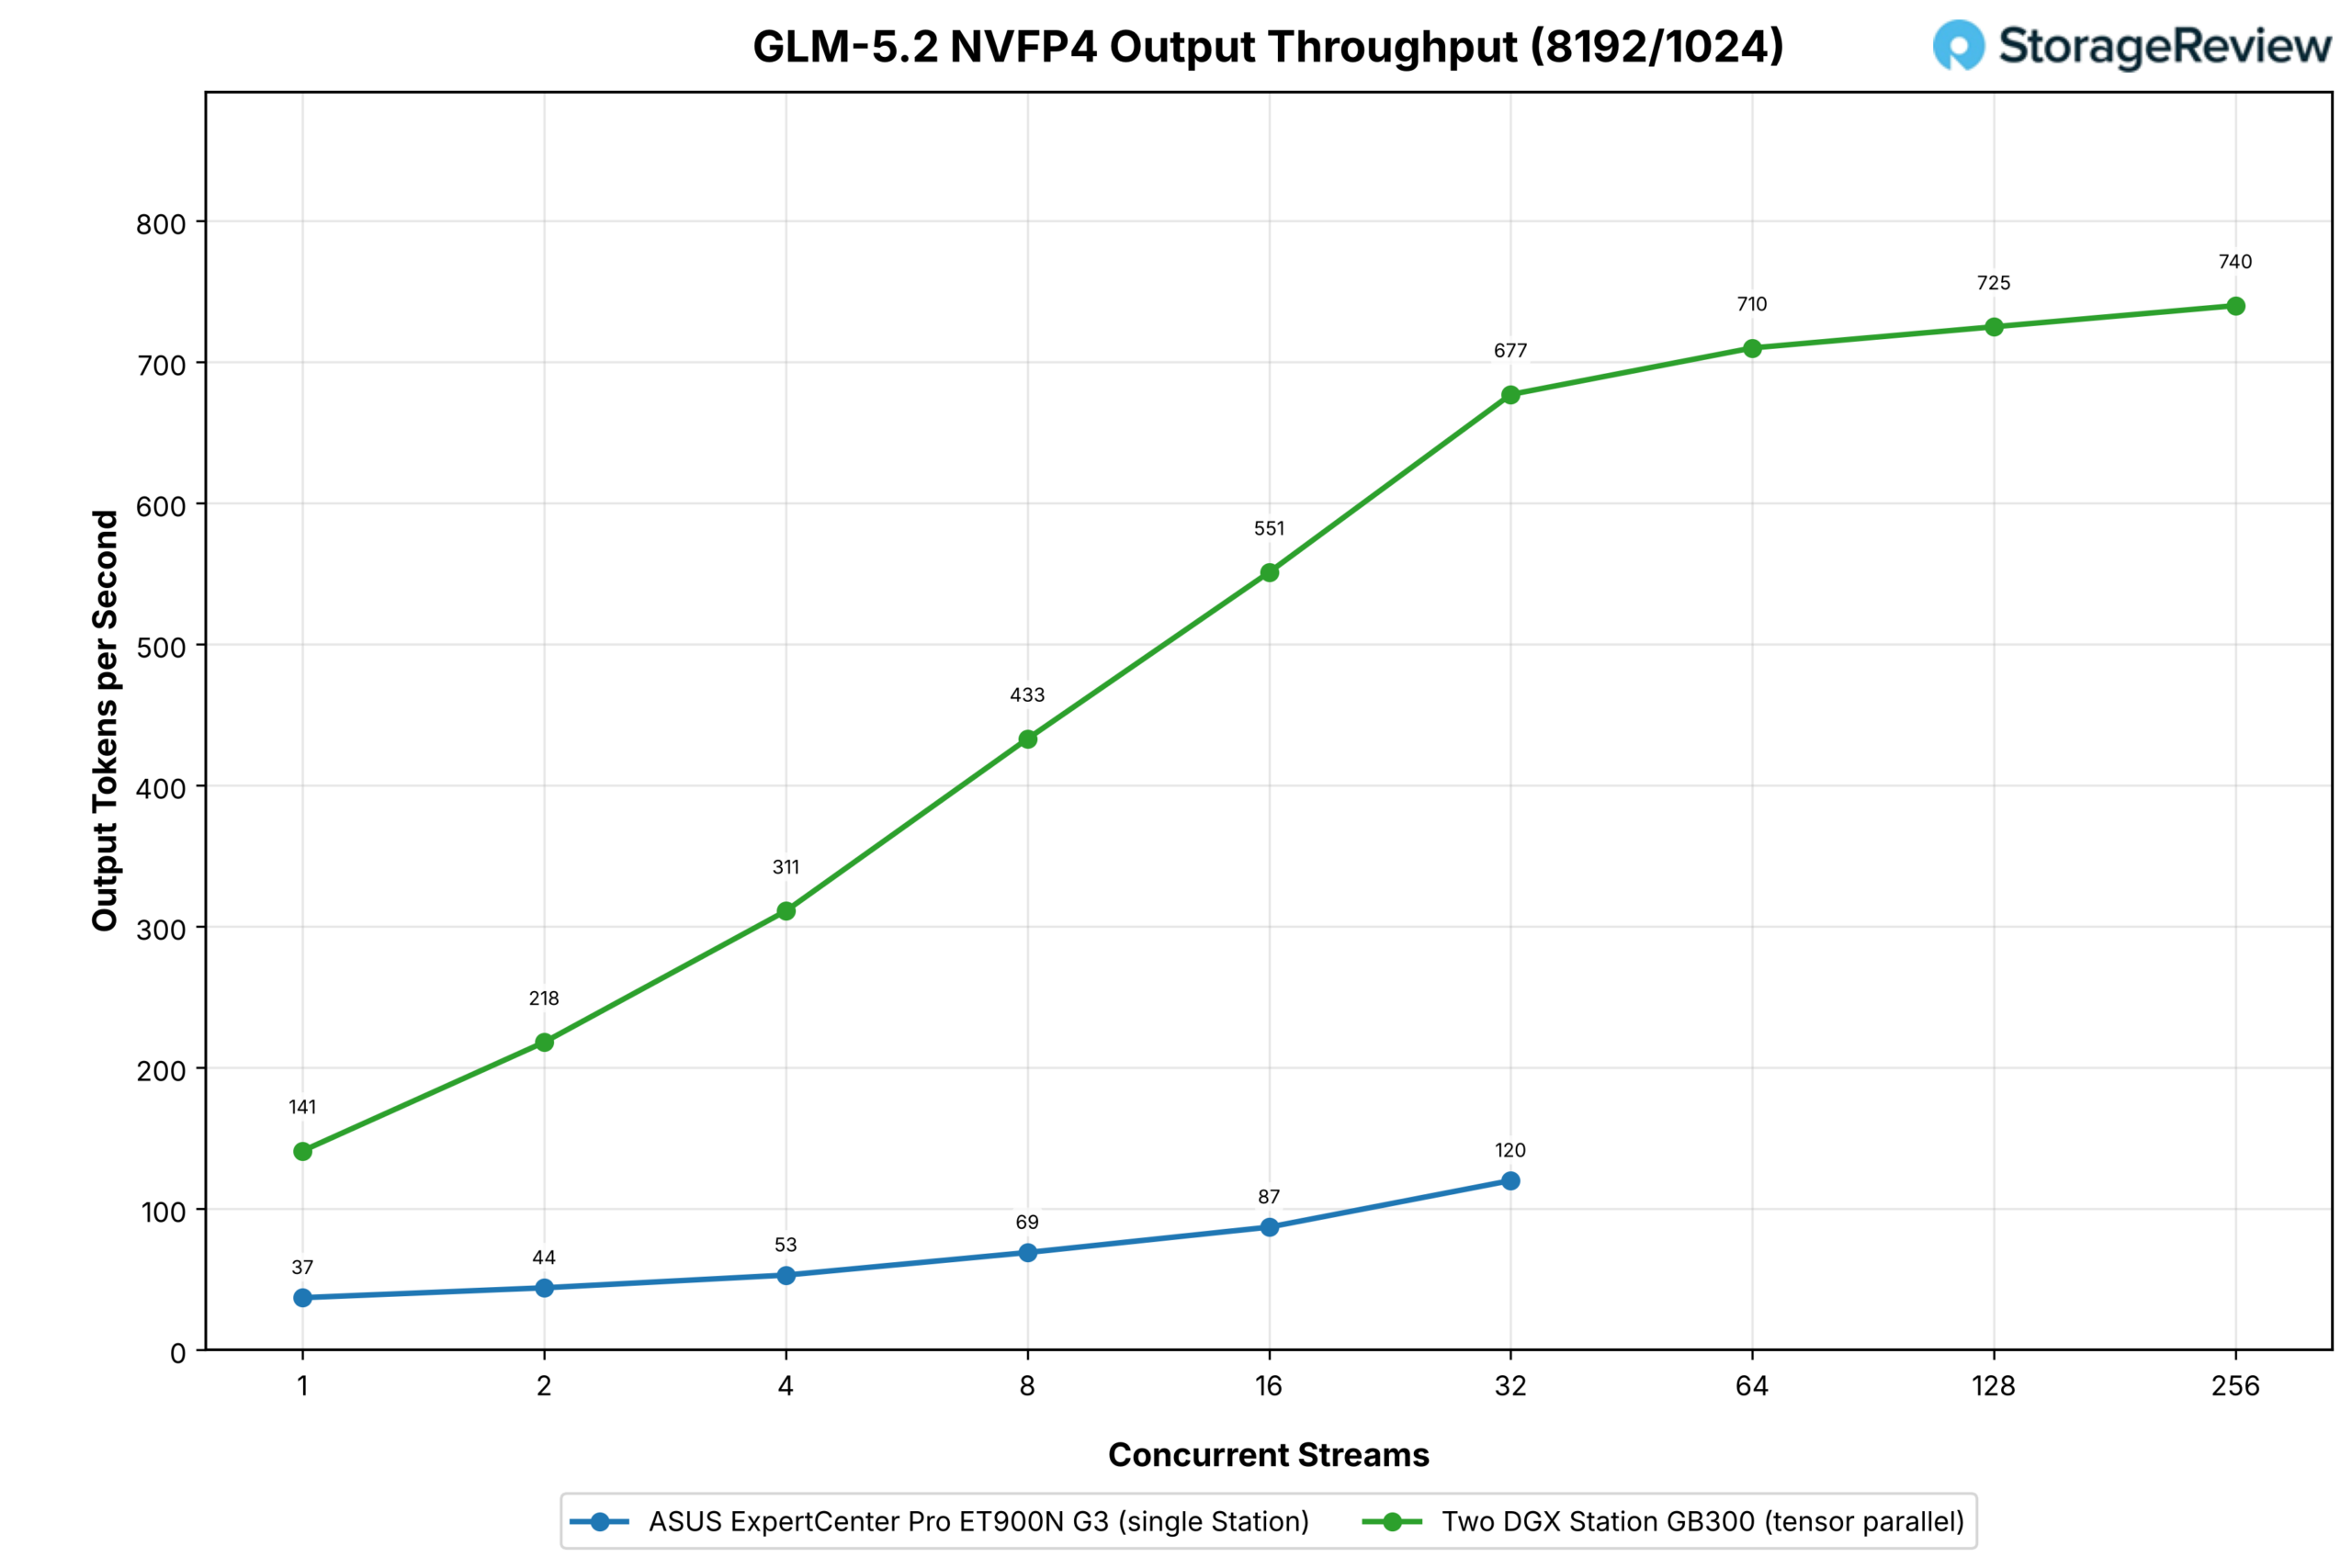
Le profil à forte pré-remplissage raconte la même histoire à une hauteur inférieure, avec une station passant de 37 jetons de sortie par seconde sur un flux à 120 sur 32, et le cluster passant de 141 à 677 sur la même plage, 3.8x au bas du balayage et 5.6x au haut, puis se stabilisant à 710, 725 et 740 sur 256 flux.
Les invites longues sollicitent davantage le préremplissage, et comme les deux configurations sont limitées par la puissance de calcul, le gain de performance lié au déchargement apporté par la seconde station représente une part plus faible du total que pour les invites courtes. Le gain dépasse largement le double sur les deux profils, car la seconde station utilise un modèle de 433 Go en LPDDR5X et le place intégralement en HBM, ce qui est plus déterminant ici que la puissance de calcul de la seconde carte B300.
MiniMax-M3
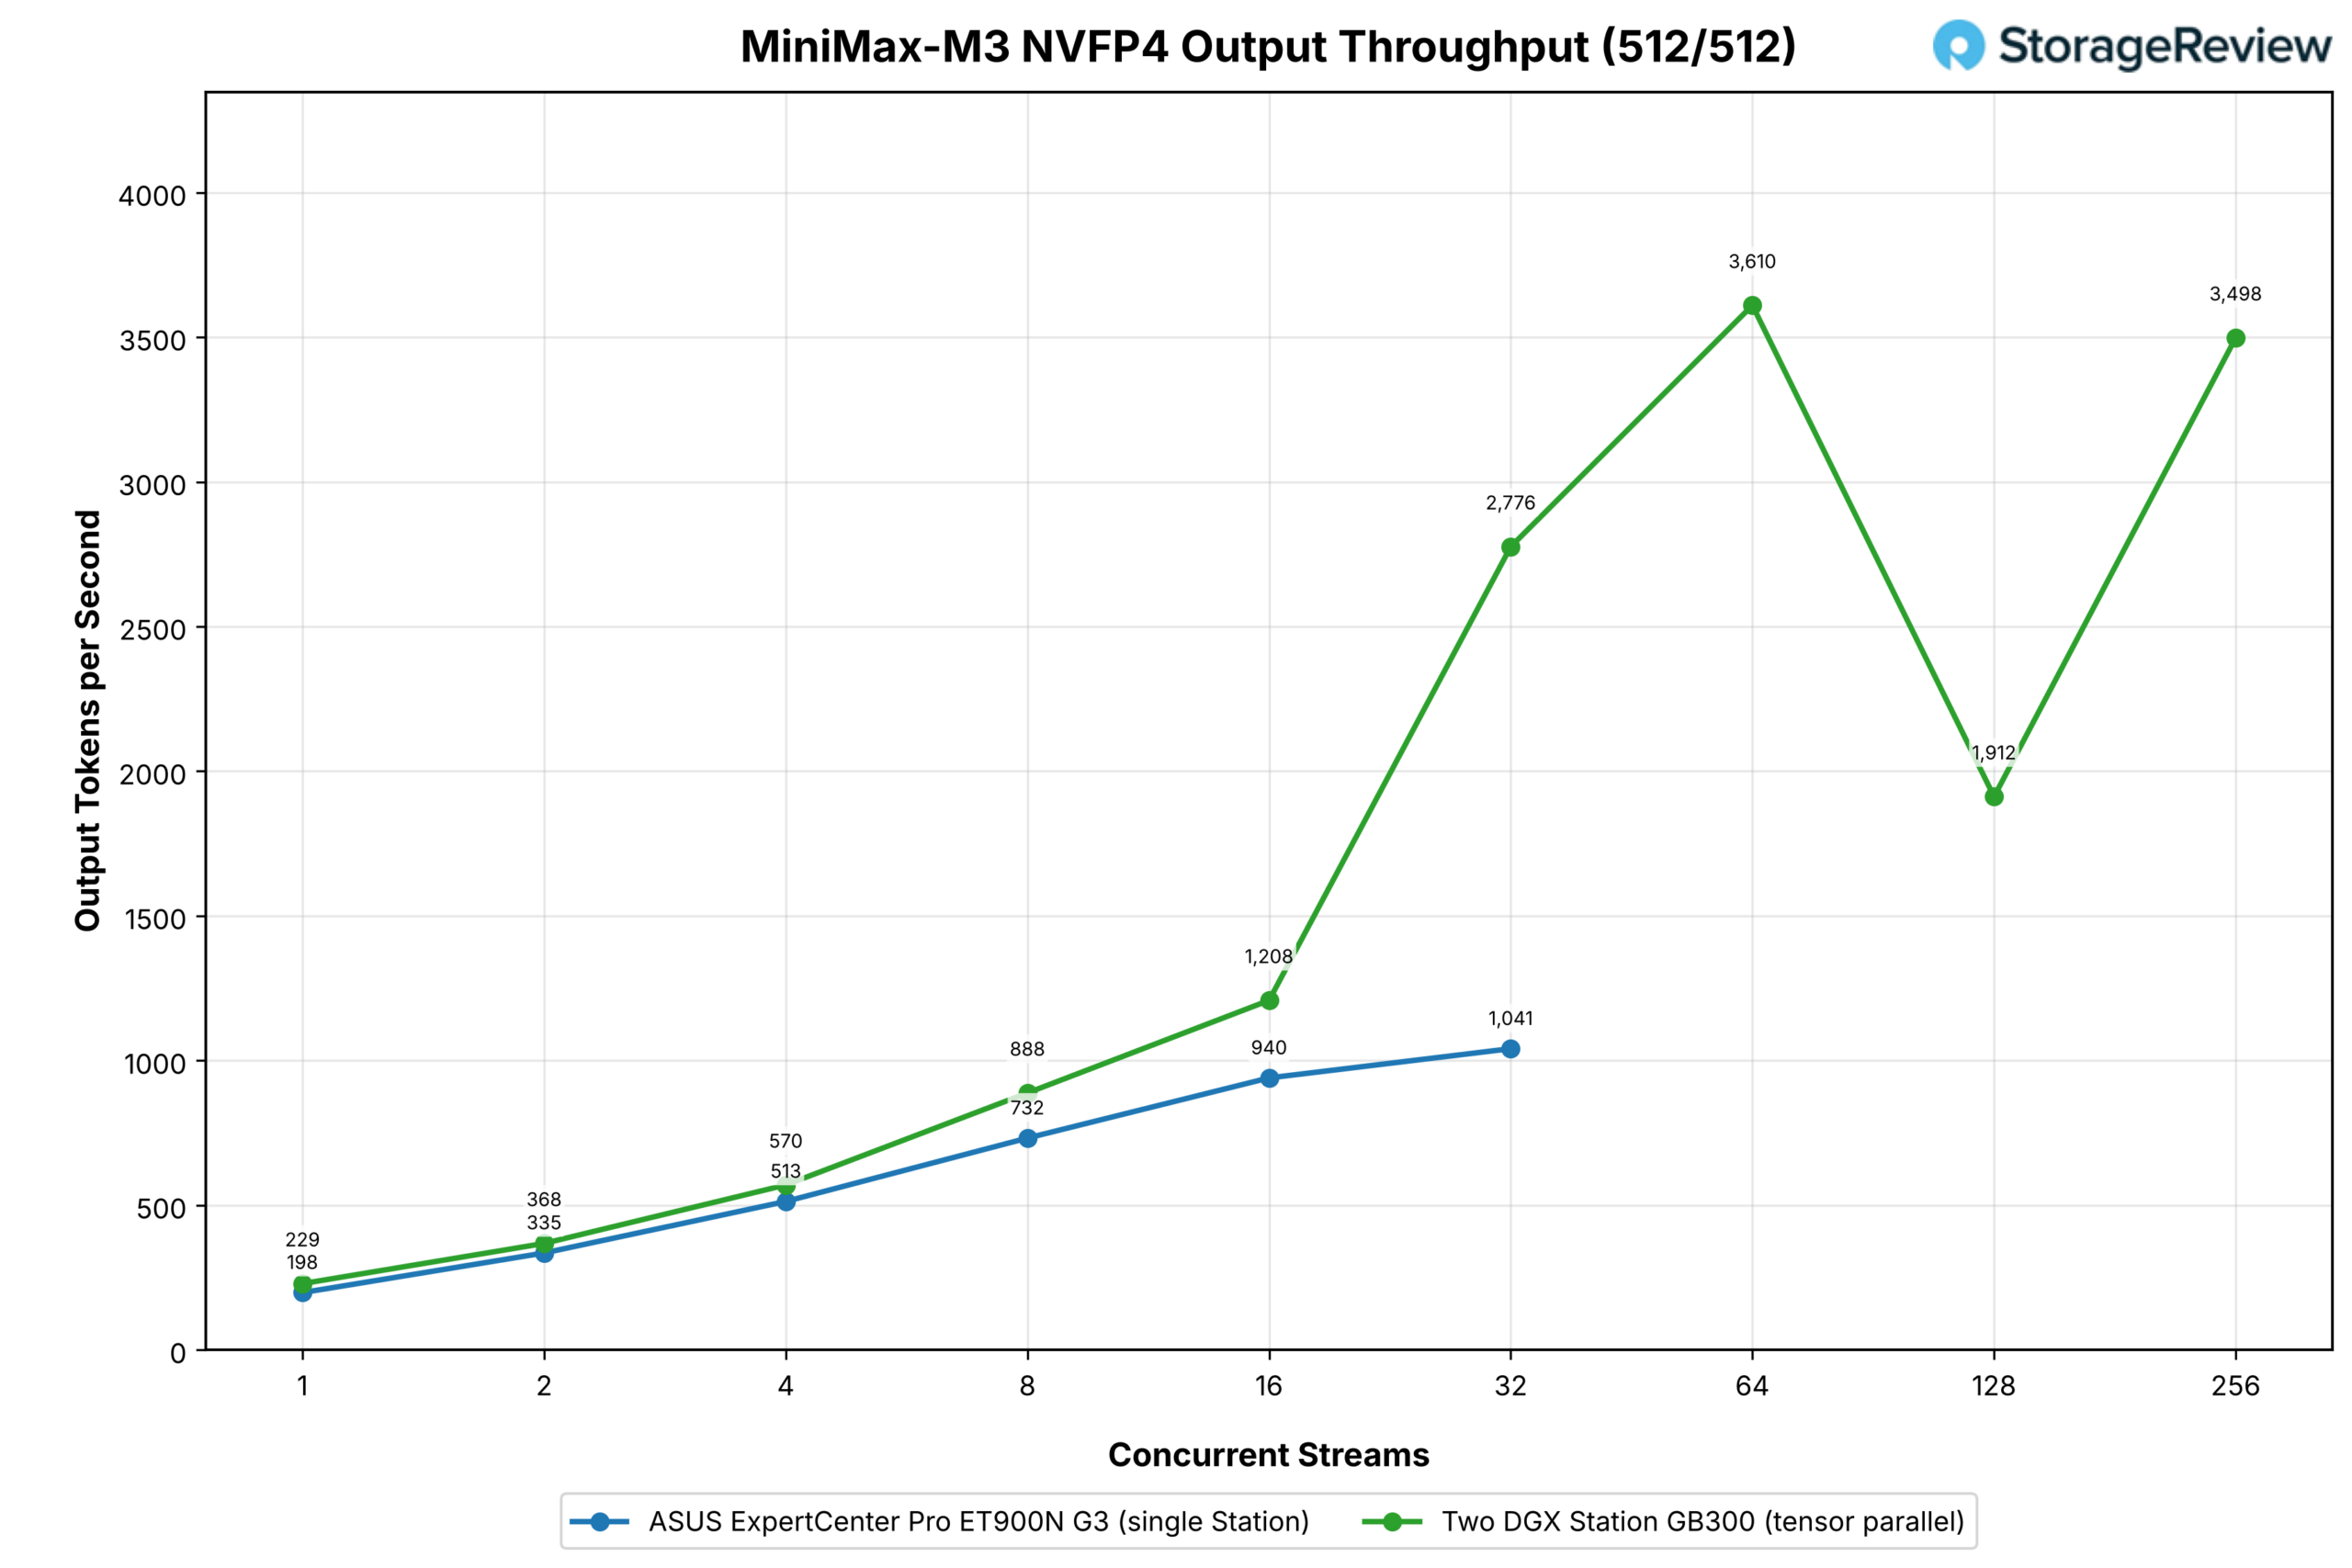
Le MiniMax-M3 a fonctionné sous TP2 sans déchargement Grace. Sur une station, il se situe à la limite des performances de la mémoire HBM, avec une partie de ses performances optimisées pour la mémoire Grace. Lors du test d'ASUS, il a atteint 1 041 jetons de sortie par seconde à 32 flux, sur une charge de travail équivalente à celle de l'EAGLE3.
Le cluster suit de près la station unique sur 16 flux (1 208 contre 940) puis prend de l'avance : 2 776 à 32 (2.7 fois la tour unique), 3 610 à 64, une baisse à 1 912 à 128 et 3 498 à 256. Deux stations apportent moins ici que sur GLM-5.2 car une station conserve déjà la majeure partie de ce modèle dans la mémoire HBM ; la contribution du second GPU se rapproche donc davantage d'une simple mise à l'échelle du calcul, avec une marge de sécurité supplémentaire grâce au cache KV.
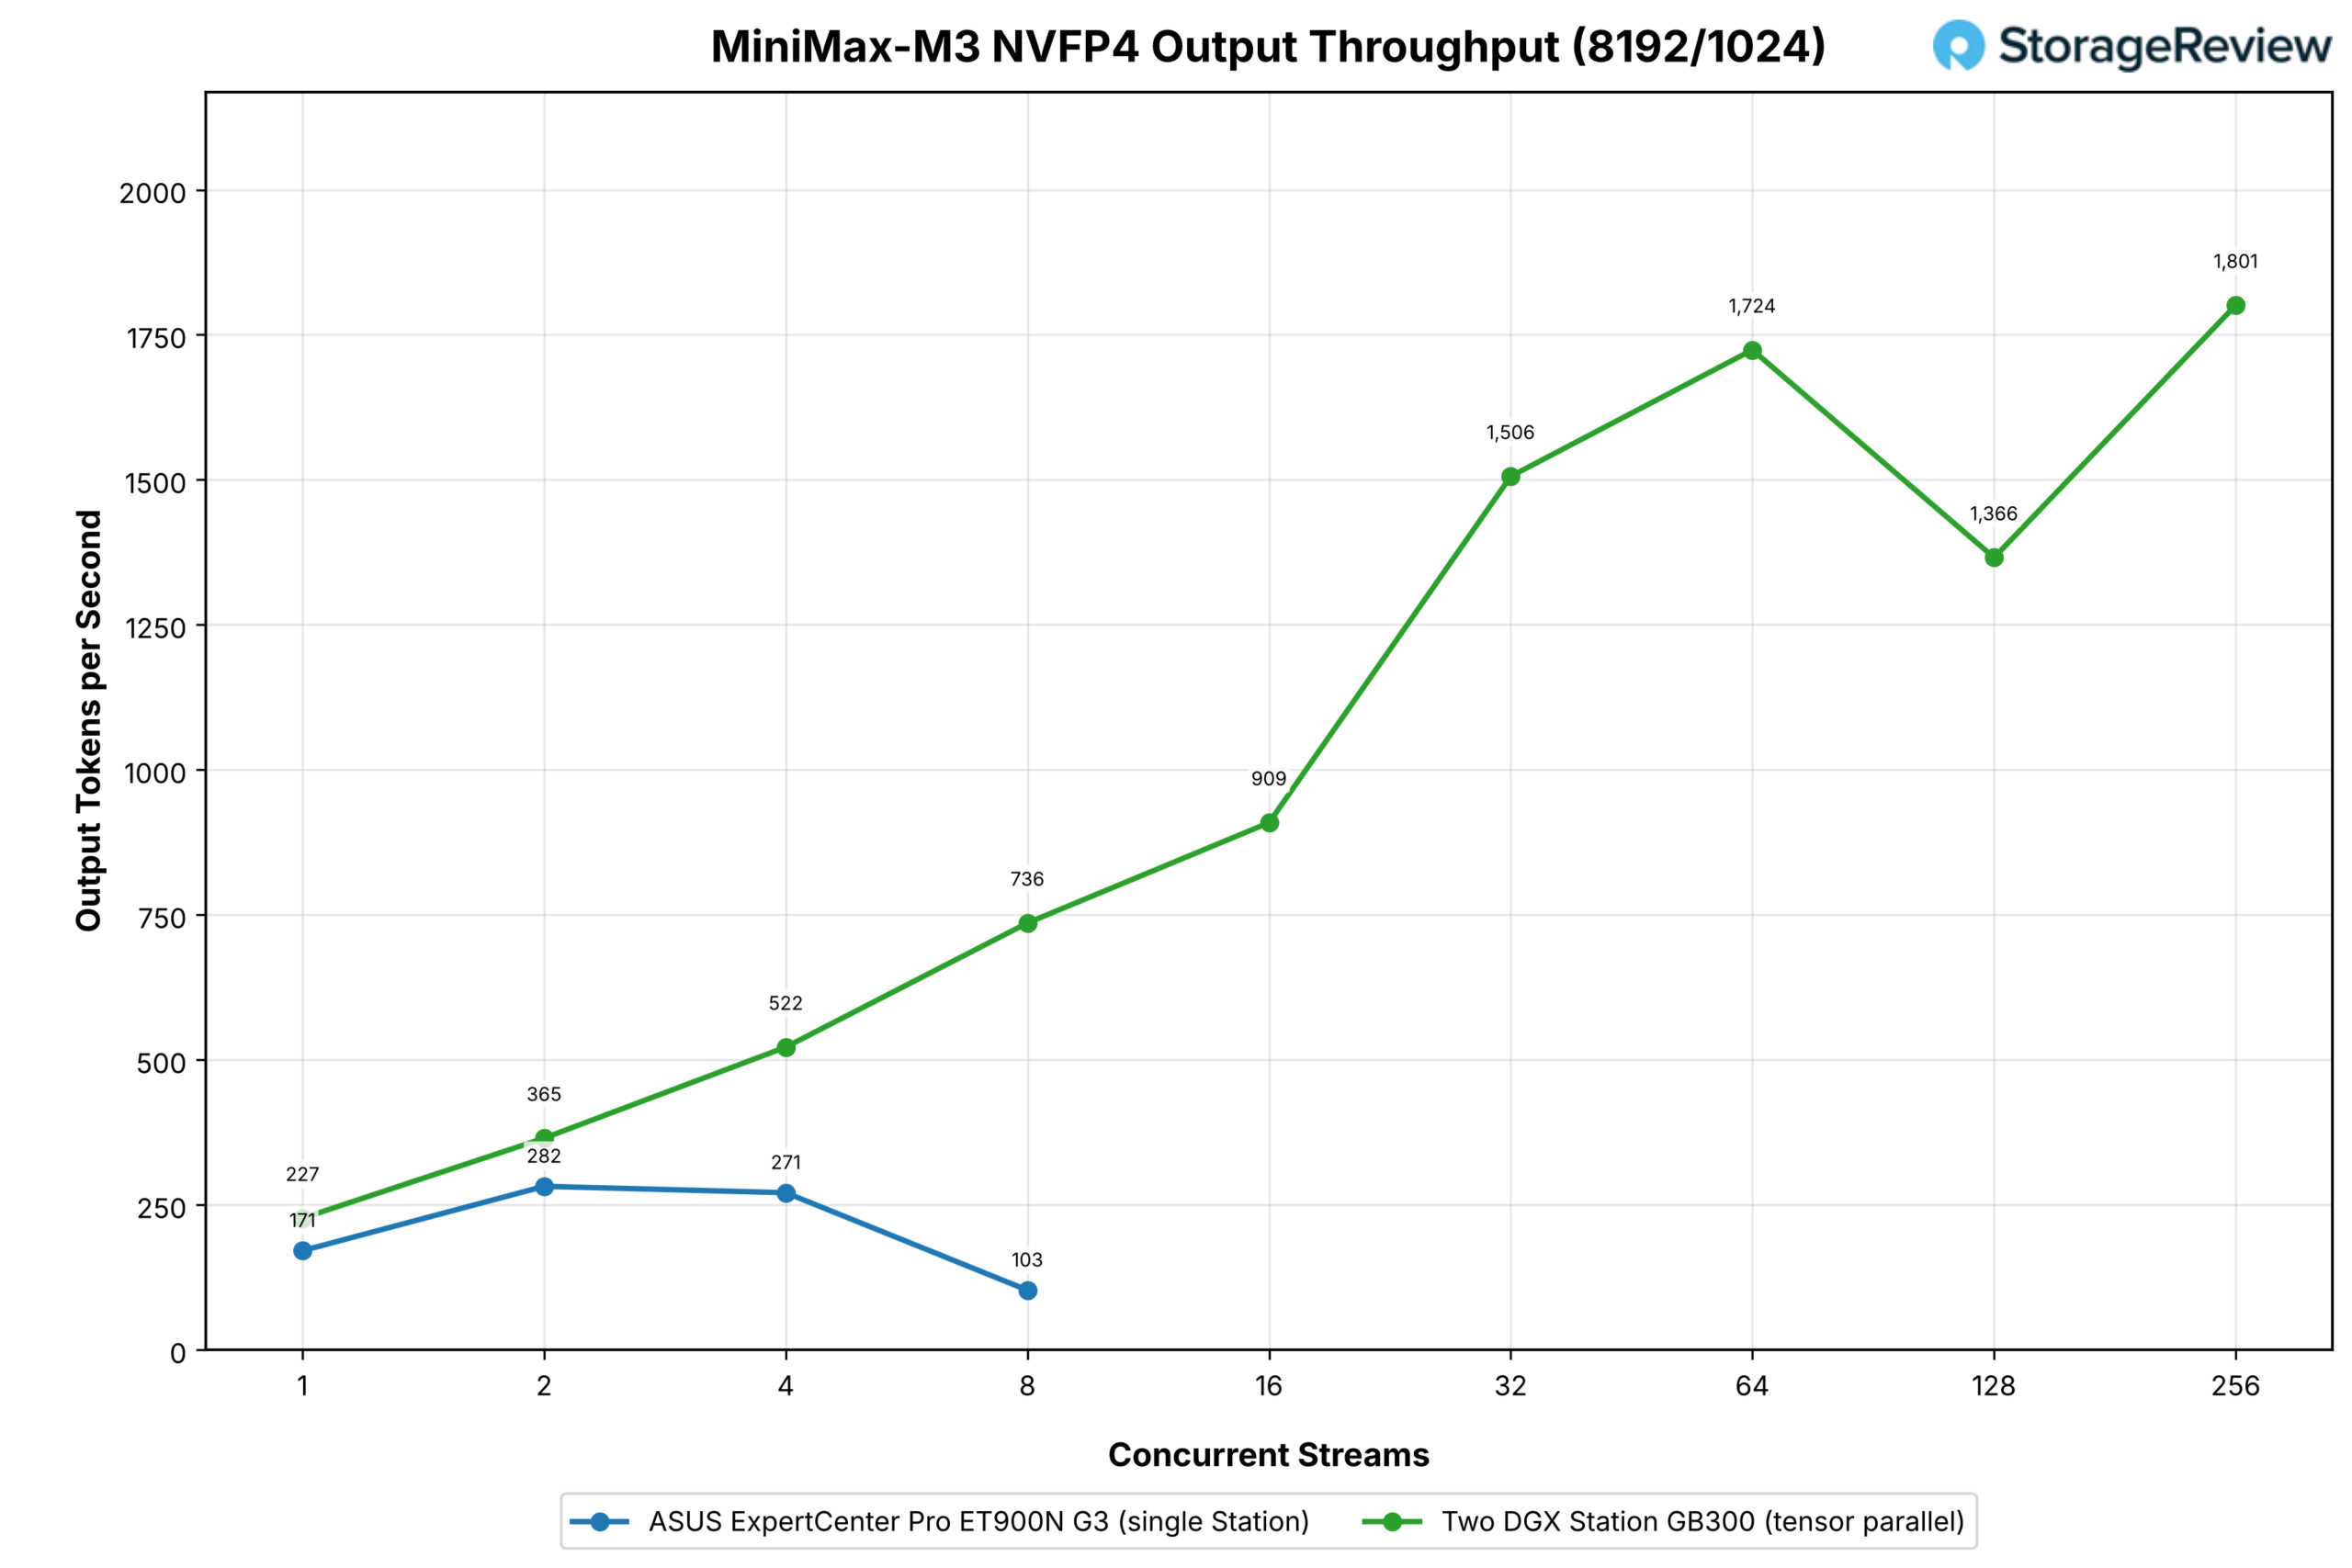
C'est dans le profil à forte pré-remplissage que MiniMax-M3 a manqué d'espace sur une station : les invites de 8 192 jetons consomment rapidement le cache KV restant, de sorte que la tour unique a atteint un pic de 282 jetons de sortie par seconde à deux flux, s'est maintenue à 271 à quatre et est tombée à 103 à huit, où le balayage s'est terminé car il n'y avait plus rien à mesurer.
Avec le modèle réparti sur deux stations, les mêmes points affichaient 365, 522 et 736, soit un gain de 30 % sur deux flux où les deux configurations disposaient de mémoire cache suffisante, et de 7.1 fois sur huit, où l'un des flux était saturé. Le cluster a ensuite atteint 909 sur 16, 1 506 sur 32, 1 724 sur 64, 1 366 sur 128 et 1 801 sur 256, une plage de valeurs qu'une seule station ne peut absolument pas atteindre avec ce profil.
Conclusion
Deux stations GB300 DGX reliées par câble via leurs ports ConnectX-8 respectifs fonctionnent comme prévu selon la documentation NVIDIA ; l’installation s’est déroulée sans problème et ce sont les premières données de débit que nous observons pour la configuration à double système.
La seconde station tire pleinement parti des modèles qui dépassent les 252 Go de HBM3e : le GLM-5.2 passe de 139 jetons de sortie par seconde à 32 flux sur une station à 1 525 sur deux, puis à 3 141 à 256 flux, car la division utilise un modèle de 433 Go de LPDDR5X ; le GLM-5.3 atteint 5 018 à 256 flux à partir d’un plafond de 188 sur une seule station ; le MiniMax-M3 sur les longues invites passe d’une tour qui ralentit à huit flux à une paire qui continue de grimper à 256.
Sur les deux modèles qui tiennent dans une seule station, GLM-5.3 Flash et DeepSeek V4.1 Flash, la meilleure façon d'utiliser le deuxième boîtier est de donner à chaque station une copie complète, de séparer le préremplissage du décodage et de laisser le processus de décodage générer sans pause ; sur GLM-5.3 Flash, cela a doublé le débit des invites longues à 32 flux et triplé le débit des invites courtes, et DeepSeek V4.1 Flash a affiché le débit de sortie le plus élevé de l'ensemble à 5 248 jetons par seconde.
Notre avis sur le produit n'a pas changé depuis le test du MSI XpertStation WS300 : c'est une machine intéressante pour un marché spécifique, et si vous en avez besoin, vous pourriez en avoir besoin d'une autre.
La meilleure façon de les gérer est de les considérer comme une infrastructure fongible : un pool sur lequel une équipe planifie ses tâches et qu'elle restructure au gré des projets. NVIDIA possède les composants nécessaires à cette gestion. L'entreprise a acquis Run:ai pour la planification, Brev pour les environnements de développement et Lepton pour une plateforme de calcul. L'association de l'une de ces trois solutions avec un rack de Stations rendrait le produit bien plus attractif si vous y avez accès.
La configuration à deux boîtiers a démontré une excellente évolutivité ; le gain le plus important que nous ayons mesuré a été obtenu avec GLM-5.3, passant de 188 jetons de sortie par seconde sur une seule station à 5,018 2 sur les deux (soit un gain de 27x). À concurrence égale, GLM-5.2 a atteint un gain de 11x avec 32 flux, dans les deux cas pour des modèles qu'une seule station ne peut gérer qu'en répartissant les poids dans la mémoire Grace. Ce résultat est comparable à celui de GB300 sur deux systèmes de 400 Go, et nous sommes impatients de découvrir à quoi ressemblera une station Vera Rubin lorsque NVIDIA la commercialisera, avec la prochaine génération de mémoire HBM et NVLink-C2C.
L'utilisation de ces stations reste inchangée : deux stations sur un bureau, sans rack ni centre de données, prennent désormais en charge les modèles qui justifiaient auparavant un serveur GPU et les infrastructures associées. Ainsi, une équipe qui ne peut obtenir d'emplacement dans un centre de données, ou qui ne souhaite pas attendre, dispose d'une solution d'inférence de pointe à proximité immédiate. NVIDIA a placé la barre très haut dans cette catégorie, indépendamment du prix. La gamme GB300 figure dans notre classement des meilleurs ordinateurs de bureau pour l'IA locale , et ces données de cluster confirment ce choix.



 Amazon