

NVIDIA a annoncé un nouveau GPU pour le calcul scientifique lors de la conférence SC26. Le Rubin HPC fait partie de la plateforme Vera Rubin, qui intègre plus de 50 000 cœurs CUDA sur un seul GPU. NVIDIA prévoit sa disponibilité en 2028. Le reste des annonces de l'entreprise à SC26 comprend un rack Vera de 192 processeurs pour la simulation, attendu début 2027, le logiciel de modélisation ouvert Nemotron for Science, de nouvelles bibliothèques CUDA-X, une plateforme de co-conception quantique avec IBM et Fermilab, et le déploiement par Lambda de commutateurs optiques intégrés.
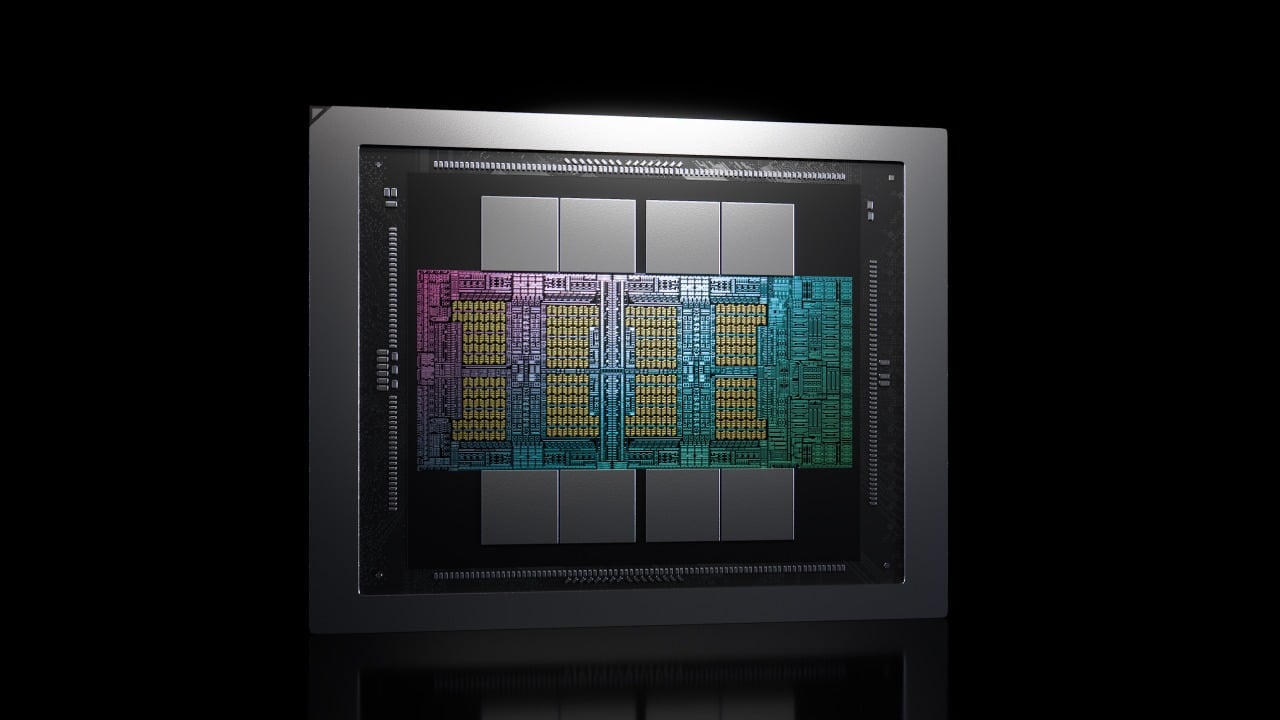
GPU Rubin HPC
NVIDIA décrit Rubin HPC comme un GPU dédié à la simulation et au traitement des données en sciences, ingénierie et analyse, conçu pour optimiser simultanément le transfert de données et la puissance de calcul. Outre le nombre de cœurs, qualifié de record par NVIDIA, l'entreprise met en avant une capacité d'accélération des données éparses qui alimente ces cœurs en données et assure des liaisons GPU-à-GPU via NVLink de septième génération. Les charges de travail cibles comprennent les opérations sur matrices creuses, les calculs de stencil, le tri et la réduction de matrices, les modèles climatiques, la simulation en ingénierie, l'analyse génomique et l'évaluation des risques financiers.

Lors du salon SC26, NVIDIA a annoncé que Rubin HPC triple les performances de simulation et d'analyse, et prend en charge toutes les précisions, de FP64 à FP4. L'entreprise n'a pas précisé la configuration de référence pour ce triplement, ni communiqué les informations relatives à la capacité mémoire, au débit FP64, à la consommation énergétique ou aux configurations système. Ian Buck, vice-président du calcul haute performance et à très grande échelle chez NVIDIA, a souligné l'importance de ce composant pour la recherche en informatique automatisée, affirmant qu'« une simulation plus rapide signifie une découverte plus rapide » pour les agents travaillant sur des problèmes scientifiques et d'ingénierie. Intel présente également son GPU D270 compatible FP64 pour les mêmes charges de travail de simulation.
Baies CPU Vera pour HPC
La plateforme Vera pour le calcul haute performance (HPC) est un rack NVIDIA MGX à refroidissement liquide, intégrant 192 processeurs Vera connectés par InfiniBand Quantum-X800. Elle offre environ 300 To de mémoire, 1 Po de stockage et une bande passante mémoire maximale agrégée supérieure à 200 To/s. Chaque plateau 1U accueille huit processeurs, ainsi que le stockage et la gestion NVMe. Le rack réutilise le châssis, la distribution d'alimentation et le système de refroidissement des systèmes NVL72. Chaque processeur dispose de 88 cœurs Olympus, 176 threads et d'une mémoire SOCAM M2 LPDDR5X cadencée jusqu'à 1.2 To/s.

Cette configuration diffère de celle des racks Vera à 256 processeurs annoncés par Dell et Supermicro pour les environnements de test d'agents lors de la GTC Berlin. Ces racks intègrent les technologies InfiniBand et SHARP pour une simulation à couplage étroit. NVIDIA indique que Dell Technologies, HPE, Lenovo et Supermicro proposeront ces racks HPC dès début 2027. Le DKRZ, Centre allemand de calcul climatique, a choisi les processeurs Vera pour son supercalculateur HLRE-5, construit sur une plateforme Bull et comprenant également des systèmes GB200 et la technologie Quantum-2 InfiniBand. Sa mise en service est prévue début 2028.
NVIDIA affirme que Vera offre une efficacité énergétique deux fois supérieure à celle des processeurs x86. Lors de ses tests, Vera a affiché des performances 1.9 fois supérieures et une efficacité énergétique 2.4 fois supérieure à celle des systèmes x86 sur le cas OpenFOAM motorBike Large. NVIDIA prévoit également des performances 1.6 fois supérieures et une efficacité énergétique deux fois supérieure sur le modèle de recherche et de prévision météorologique (WRF). Ces résultats proviennent du constructeur et n'ont pas été vérifiés par nos soins. NVIDIA n'a pas non plus communiqué les noms des processeurs x86 utilisés. Dans notre test du processeur Vera , un système Vera à deux sockets a terminé un calcul OpenFOAM de grande taille 1.44 fois plus rapidement qu'un système EPYC 9965 à 384 cœurs et 1.20 fois plus rapidement qu'un système Xeon 6978P à 240 cœurs.
Côté logiciel, le kit de développement logiciel (SDK) NVIDIA HPC 26.11 est disponible dès maintenant avec des compilateurs et des bibliothèques optimisés pour Vera. Un compilateur Fortran de nouvelle génération, développé en collaboration avec des centres de calcul haute performance et des laboratoires nationaux, est actuellement en version bêta publique. NVIDIA affirme que ce compilateur permet d'exécuter plus rapidement les programmes Fortran existants sur ses plateformes, sans réécriture de code.
Nemotron pour la science et les bibliothèques CUDA-X
Nemotron for Science intègre le modèle ouvert Nemotron 3.5 Super VL, des évaluations scientifiques, des recettes post-entraînement et LitmusBench v0.2, un jeu de données ouvert de près de 50 000 questions de raisonnement chimique. Le modèle et le jeu de données sont disponibles dès maintenant sur Hugging Face. NVIDIA indique que le modèle a été optimisé pour une exécution locale sur un DGX Spark de 128 Go. Le Laboratoire national d'Argonne l'intègre à son système multi-agents StructBioReasoner pour les thérapies à base de protéines, et RIKEN l'a rendu disponible sur sa plateforme de supercalcul d'IA RIKYU.
Parmi les clients ayant post-entraîné le modèle, Lila Sciences a quasiment doublé la précision de la synthèse de points quantiques, atteignant 61 %, un résultat supérieur aux 54 % de GPT-6 Astra selon NVIDIA, pour un coût d'inférence 10 à 20 fois inférieur. Terray Therapeutics a récupéré environ 76 % des réactions annotées lors du test RxnScribe de lecture de schémas de réactions chimiques. Un agent du KTH Royal Institute of Technology a réparé 81 % des configurations de dynamique moléculaire GROMACS défectueuses en une seule exécution nocturne sur un unique DGX Spark.
Parmi les nouveautés de CUDA-X, la boîte à outils cuPhoton corrèle les observations de l'Event Horizon Telescope en huit minutes, là où l'analyse prenait auparavant plus d'un mois. cuPotential accélère jusqu'à trois fois les logiciels de simulation moléculaire existants, et Daviator, un ensemble de noyaux GPU par lots pour le Vienna Ab initio Simulation Package, exécute des calculs de mécanique quantique jusqu'à 22 fois plus rapidement, pour un coût jusqu'à 75 % inférieur. NVIDIA n'a pas précisé les performances de référence de cuPotential et de Daviator.
cuSpa et une bibliothèque HMMER accélérée par GPU sont désormais open source. Au Memorial Sloan Kettering Cancer Center, cuSpa a permis d'obtenir une accélération de 900x par rapport aux CPU pour les calculs de polygones cellulaires, tandis qu'à Basecamp Research, la bibliothèque HMMER a exécuté des recherches de référence jusqu'à 84 fois plus rapidement que la version standard de HMMER. La bibliothèque rapids-singlecell, co-développée avec scverse, est maintenant distribuée dans un conteneur unique conçu pour les agents, et 10x Genomics l'a intégrée à sa plateforme Sentira.
Conception conjointe quantique avec IBM et Fermilab
Dans le domaine quantique, NVIDIA et IBM mettent en commun des systèmes NVIDIA DGX B200 avec des ordinateurs quantiques IBM, notamment des systèmes équipés du processeur IBM Quantum Nighthawk, afin de soutenir une plateforme de co-conception quantique modulaire développée avec Fermilab. Les chercheurs l'utiliseront pour évaluer des codes correcteurs d'erreurs, des algorithmes de décodage et des applications quantiques-classiques pour la physique nucléaire et des hautes énergies. IBM a mis en place un dispositif similaire avec AMD et le Laboratoire national d'Oak Ridge , associant Nighthawk à un cluster Instinct MI355X. NVIDIA n'a communiqué ni le nombre de systèmes, ni leur emplacement, ni le calendrier de déploiement.
Par ailleurs, NVIDIA a publié TCBP-JOBS, un algorithme de décodage intégré à la bibliothèque CUDA-Q QEC 0.9.0. Selon l'entreprise, cet algorithme décode jusqu'à 13 000 fois plus vite que les principaux algorithmes existants et réduit le temps de calcul nécessaire à la conception de nouveaux ordinateurs quantiques de 12 semaines à 45 minutes. La plateforme CUDA-Q s'enrichit également d'un serveur de décodage, d'un ensemble étendu de primitives tolérantes aux pannes, d'une bibliothèque d'algorithmes CUDA-Q contenant des composants d'application réutilisables, et de CUDA-Q Pulse, un outil permettant de moduler les impulsions de contrôle qui pilotent les qubits.
NVIDIA indique que le déploiement de processeurs quantiques dans les centres de supercalcul a été multiplié par sept en cinq ans, près de 30 centres déployant désormais plus de 50 processeurs. Slurm 26.11, attendu fin novembre, intègre une interface quantique permettant aux concepteurs de QPU de décrire leur matériel une seule fois, dans un fichier unique, et de réutiliser cette intégration dans tous les centres. Compatible avec les interfaces HPC quantiques QRMI et QDMI, et grâce à la contribution d'IBM via son interface de gestion des ressources quantiques (Quantum Resource Management Interface), cette interface permet aux centres de planifier des processeurs quantiques parallèlement aux CPU et GPU. Alice & Bob, IBM, IQM, Pasqal, Quantinuum et MQSC l'adoptent déjà, et NVIDIA a fait l'acquisition de SchedMD, développeur de Slurm , fin 2025.
NVIDIA a également mis en avant les travaux de chimie quantique-classique menés par IBM et RIKEN, finalistes du prix Gordon Bell de l'ACM 2026, qui ont permis de calculer les énergies de liaison de complexes protéine-ligand comportant jusqu'à 12 635 atomes. Cela représente plus de 40 fois le précédent test de chimie quantique-classique portant sur 303 atomes. Les calculs classiques ont été effectués sur le supercalculateur ROQUO de RIKEN, basé sur des systèmes NVIDIA GB200 et une interface InfiniBand Quantum-X800.
Parmi les projets de l'écosystème sur la plateforme, Altera et Oxford Quantum Circuits ont développé un contrôleur quantique sur FPGA qui connecte le contrôle et la lecture des qubits aux GPU via NVQLink, et Quantum Motion a intégré son framework de chimie QUICHE à CUDA-Q. QunaSys a utilisé cuQuantum et 1 024 GPU NVIDIA de génération Hopper sur ABCI-Q pour simuler plus de 300 millions d'opérations quantiques, atteignant une précision chimique pour un modèle à quatre atomes d'hydrogène. Les chercheurs de NVIDIA ont utilisé le supercalculateur JUPITER pour simuler 10⁴ qubits avec un bruit réaliste.
Lambda déploie des solutions optiques co-emballées
Lambda utilise des commutateurs optiques co-packagés (CPO) NVIDIA Photonics pour connecter des racks GB300 NVL72 dans un déploiement de plus de 10 000 GPU. Chaque commutateur dispose de 144 ports à 800 Gb/s et de 18 sources lumineuses externes remplaçables sur site par les techniciens. En effet, la défaillance d'un laser dans une optique enfichable implique le remplacement du module entier. Les tests cités par NVIDIA ont démontré une latence réseau inférieure d'environ 4 % à l'échelle du rack et jusqu'à 10 % inférieure à l'échelle du module, avec un débit équivalent à celui des optiques enfichables.

La température médiane des composants optiques déployés était de 36 °C, contre 51 °C pour les systèmes optiques enfichables classiques. NVIDIA affirme que ses commutateurs photoniques offrent une efficacité énergétique jusqu'à 5 fois supérieure, une fiabilité jusqu'à 15 fois plus élevée et nécessitent 4 fois moins de lasers que les solutions enfichables. NVIDIA a également profité de cet événement pour célébrer les 20 ans de CUDA, qui compte aujourd'hui plus de 11 millions de développeurs et plus de 1 000 bibliothèques CUDA-X.


 Amazon