

WEKA a annoncé l'intégration de sa plateforme NeuralMesh à l'architecture de référence NVIDIA STX, positionnant ainsi son réseau de mémoire augmentée comme un composant essentiel des infrastructures d'IA de nouvelle génération. La solution combinée cible l'une des principales contraintes des environnements d'inférence à grande échelle : les limitations de mémoire qui impactent les performances, le coût et l'évolutivité.
S'appuyant sur NeuralMesh, la grille de mémoire augmentée de WEKA étend la mémoire GPU en externalisant et en persistant le cache clé-valeur. Dans les déploiements NVIDIA STX, cette architecture prend en charge le stockage de mémoire contextuelle à haut débit pour les charges de travail d'IA agentielle, permettant un raisonnement contextuel étendu à travers les sessions, les outils et les flux de travail. L'entreprise indique que les configurations tirant parti des systèmes NVIDIA Vera Rubin NVL72 , des DPU BlueField-4 et de l'Ethernet Spectrum-X peuvent multiplier par 4 à 10 le débit des jetons de mémoire contextuelle. La plateforme devrait également offrir un débit de lecture d'au moins 320 Go/s et un débit d'écriture d'au moins 150 Go/s, soit plus du double des performances des systèmes de stockage IA classiques.

L'infrastructure mémoire devient le goulot d'étranglement de l'inférence
WEKA conçoit l'intégration autour d'une contrainte croissante des déploiements d'IA : la saturation de la mémoire. Dans les pipelines d'inférence modernes, la mémoire à large bande passante limitée des GPU entraîne des évictions fréquentes du cache clé-valeur, provoquant des recalculs et une baisse d'efficacité. Avec l'augmentation de la concurrence, ces inefficacités s'accumulent, engendrant des coûts d'infrastructure plus élevés et une prévisibilité réduite du système.
L'entreprise préconise une infrastructure de cache KV partagée comme solution. En conservant un contexte persistant entre les utilisateurs et les sessions, le cache partagé élimine les calculs redondants et stabilise le débit des jetons. NVIDIA STX fournit une architecture de référence pour la mise en œuvre de ce modèle, WEKA assurant la couche d'extension de stockage et de mémoire.
Architecture NeuralMesh et grille de mémoire augmentée
NeuralMesh sert de plateforme de stockage distribuée à WEKA, conçue pour fonctionner sur l'ensemble de la pile NVIDIA STX. Le système fournit des services de données haute performance adaptés aux charges de travail d'IA, tandis que la grille de mémoire augmentée (Augmented Memory Grid) fonctionne comme une couche d'extension de mémoire dédiée qui met en commun le cache KV en dehors de la mémoire GPU.
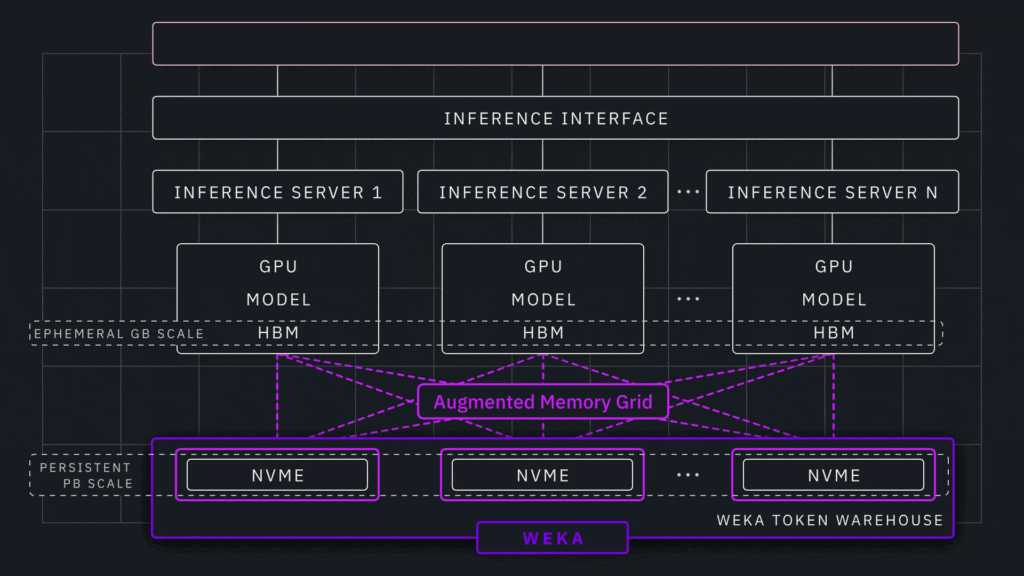
Cette approche permet aux environnements d'inférence de maintenir des sessions à long contexte sans saturer les ressources du GPU. En préservant l'état du cache et en permettant sa réutilisation entre les charges de travail, la plateforme vise à garantir une utilisation élevée et des performances constantes, même à grande échelle.
WEKA annonce que la technologie Augmented Memory Grid, initialement présentée lors de la GTC 2025 et désormais disponible, a été validée sur les plateformes NVIDIA Grace équipées de processeurs DPU BlueField. Cette architecture offre des gains significatifs en termes d'efficacité d'inférence, notamment un temps d'obtention du premier jeton considérablement réduit, un débit de jetons par GPU plus élevé et des performances stables malgré l'augmentation de la concurrence. Le déchargement du chemin de données de stockage vers BlueField-4 réduit davantage la charge du processeur et minimise les goulots d'étranglement d'E/S.
Gains de performance et d'efficacité
Dans les environnements de production, la plateforme est conçue pour améliorer la réactivité et l'efficacité de l'infrastructure. WEKA indique qu'Augmented Memory Grid peut réduire le temps d'obtention du premier jeton de 4 à 20 fois, tout en augmentant le nombre de jetons produits par GPU jusqu'à 6.5 fois. Ces gains sont dus à des taux d'accès au cache KV plus élevés et à une réduction des recalculs, permettant ainsi aux systèmes de maintenir leurs performances malgré l'augmentation du nombre de fenêtres de contexte et d'utilisateurs.
Firmus, fournisseur d'infrastructures d'IA, est cité comme l'un des premiers utilisateurs de NeuralMesh avec une infrastructure alignée sur NVIDIA. L'entreprise fait état d'un débit de jetons amélioré et d'une latence réduite à grande échelle, gains qu'elle attribue à une utilisation plus efficace des ressources GPU existantes plutôt qu'à une augmentation de l'empreinte matérielle.
Implications pour la conception de l'infrastructure d'IA
Cette intégration souligne une évolution de l'architecture des systèmes d'IA, où la conception de la mémoire et du stockage détermine de plus en plus les performances globales et la rentabilité. À mesure que les charges de travail d'IA agentielle augmentent et que les fenêtres de contexte s'étendent, les approches basées uniquement sur la DRAM deviennent moins viables en raison de la surcharge croissante liée aux recalculs et de la sous-utilisation des GPU.
WEKA considère le cache KV persistant et partagé comme une capacité fondamentale pour les usines d'IA. Les organisations qui adoptent ce modèle peuvent maintenir une utilisation plus élevée du GPU, réduire la consommation d'énergie par tâche d'inférence et obtenir des caractéristiques de mise à l'échelle plus prévisibles. À l'inverse, les environnements qui continuent de s'appuyer uniquement sur la mémoire GPU locale risquent de faire face à une augmentation des coûts opérationnels et à une diminution des rendements à mesure que les charges de travail augmentent.
Disponibilité
La grille de mémoire augmentée de WEKA est généralement disponible dans le cadre de la plateforme NeuralMesh.


 Amazon