

La Intel Arc Pro B70 è la scheda AI desktop più performante e promettente che Intel abbia mai lanciato, ma a volte è anche la più frustrante. Intel ha fissato il prezzo di listino a 949 dollari per 32 GB di GDDR6 al momento del lancio, a marzo di quest'anno. Tuttavia, la crisi di disponibilità di memoria che sta mettendo a dura prova l'intero mercato ha spinto i prezzi di vendita al dettaglio oltre i 1,100 dollari al momento di questa recensione. Anche così, la B70 ha un prezzo inferiore rispetto alla NVIDIA RTX Pro 4000, che ha un prezzo di listino più alto e ha superato i 2,000 dollari nonostante offra 24 GB, un terzo in meno di VRAM rispetto alla B70. Quattro B70 possono essere installate in una singola workstation o server per un totale di 128 GB di VRAM condivisa, sufficienti per gestire modelli di apprendimento automatico con 120 miliardi di parametri, con una concorrenza che in passato richiedeva una spesa ben maggiore. L'hardware è impressionante; il prezzo lo è ancora di più. Ciò che ne frena il successo è lo stesso problema che ha ostacolato il B60 che abbiamo presentato in anteprima lo scorso dicembre: il software non è ancora pronto, e ci chiediamo: Intel riuscirà mai a raggiungere questo obiettivo?
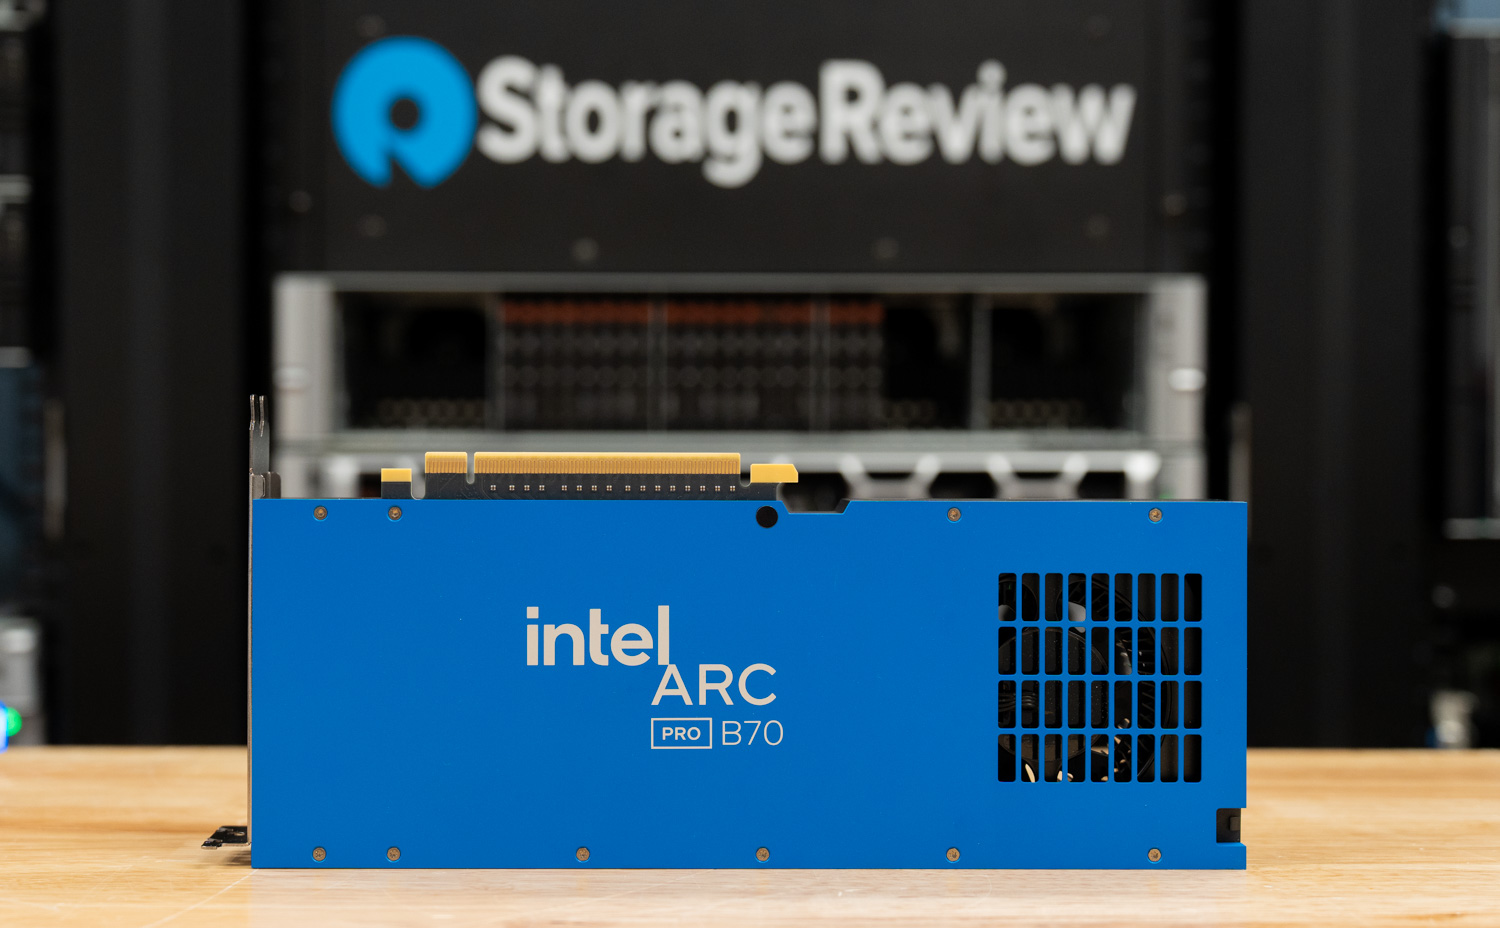
Abbiamo già avuto esperienze simili con Intel. Quando abbiamo analizzato la Arc Pro B60 Battlematrix , il punto di forza era un ottimo silicio in attesa di essere rilasciato, e la B70 eredita entrambe le caratteristiche. La scheda è basata sul die BMG-G31 più grande con 32 core Xe2, 256 motori XMX e 367 INT8 TOPS. È alimentata da un bus a 256 bit a 608 GB/s ed è configurabile da 160W a 290W. Rispetto alla B60, Intel stima un aumento delle prestazioni generazionali del 44% in media nei carichi di lavoro workstation e fino al 69% nelle applicazioni professionali. Un aspetto da tenere presente fin da subito è che, mentre la B60 era disponibile come scheda dual-GPU che condivideva uno slot x8/x8, la B70 ha una GPU per scheda e richiede una corsia PCIe 5.0 x16 completa, il che modifica la configurazione di un case a quattro schede.
Il marketing di Intel si basa interamente su deduzioni locali e il confronto scelto è con la NVIDIA RTX Pro 4000 da 24 GB. Secondo i dati di Intel relativi a Linux, la B70 da 32 GB può contenere circa 93.000 token KV-cache contro i 42.000 della RTX Pro 4000 prima di esaurire la memoria, offre un throughput dei token superiore fino all'85% all'aumentare degli utenti simultanei, risponde fino a 6.2 volte più velocemente in termini di tempo di risposta al primo token sotto carico e offre fino al doppio dei token per dollaro. Questi sono i dati di Intel, relativi a una singola scheda, su un piccolo Llama 3.1 8B al Black Friday 2016; metteremo alla prova le B70 in modo più approfondito. L'affermazione sui token per dollaro si basa sui prezzi di lancio; ai prezzi attuali, il divario si mantiene o si amplia a favore di Intel.
Prima di passare ai benchmark, è importante sottolineare questo compromesso, perché determina chi dovrebbe acquistare questa scheda oggi. L'LLM Scaler di Intel, il ramo di sviluppo di vLLM abilitato per Battlemage, a nostro avviso è ancora, nella migliore delle ipotesi, una versione beta. La copertura dei modelli è limitata; diversi percorsi di quantizzazione che dovrebbero funzionare non lo fanno ancora e lo stack limita le capacità dell'hardware. Abbiamo riscontrato lo stesso problema con Intel Gaudi 3 nel Dell PowerEdge XE7740 , dove i risultati FP8 non erano dovuti al silicio, bensì a percorsi di codice immaturi nella versione di vLLM di Intel. La B70 si trova nella stessa situazione. È qui che Intel deve prendere una decisione e attenersi ad essa con maggiore determinazione rispetto a quanto fatto finora.
Il vantaggio competitivo di NVIDIA non si limita a CUDA. Sono gli aspetti più banali, ma fondamentali per la corretta implementazione di un modello, come la documentazione, gli esempi, i container funzionanti, le risposte sui forum e una solida base di utenti che ha già risolto la maggior parte dei problemi. AMD ha chiaramente spinto ROCm nella stessa direzione. Intel ha bisogno dello stesso livello di impegno nei confronti di Arc Pro, altrimenti la B70 rischia di diventare una scheda che gli appassionati desiderano, ma che i team faticano ad adottare.
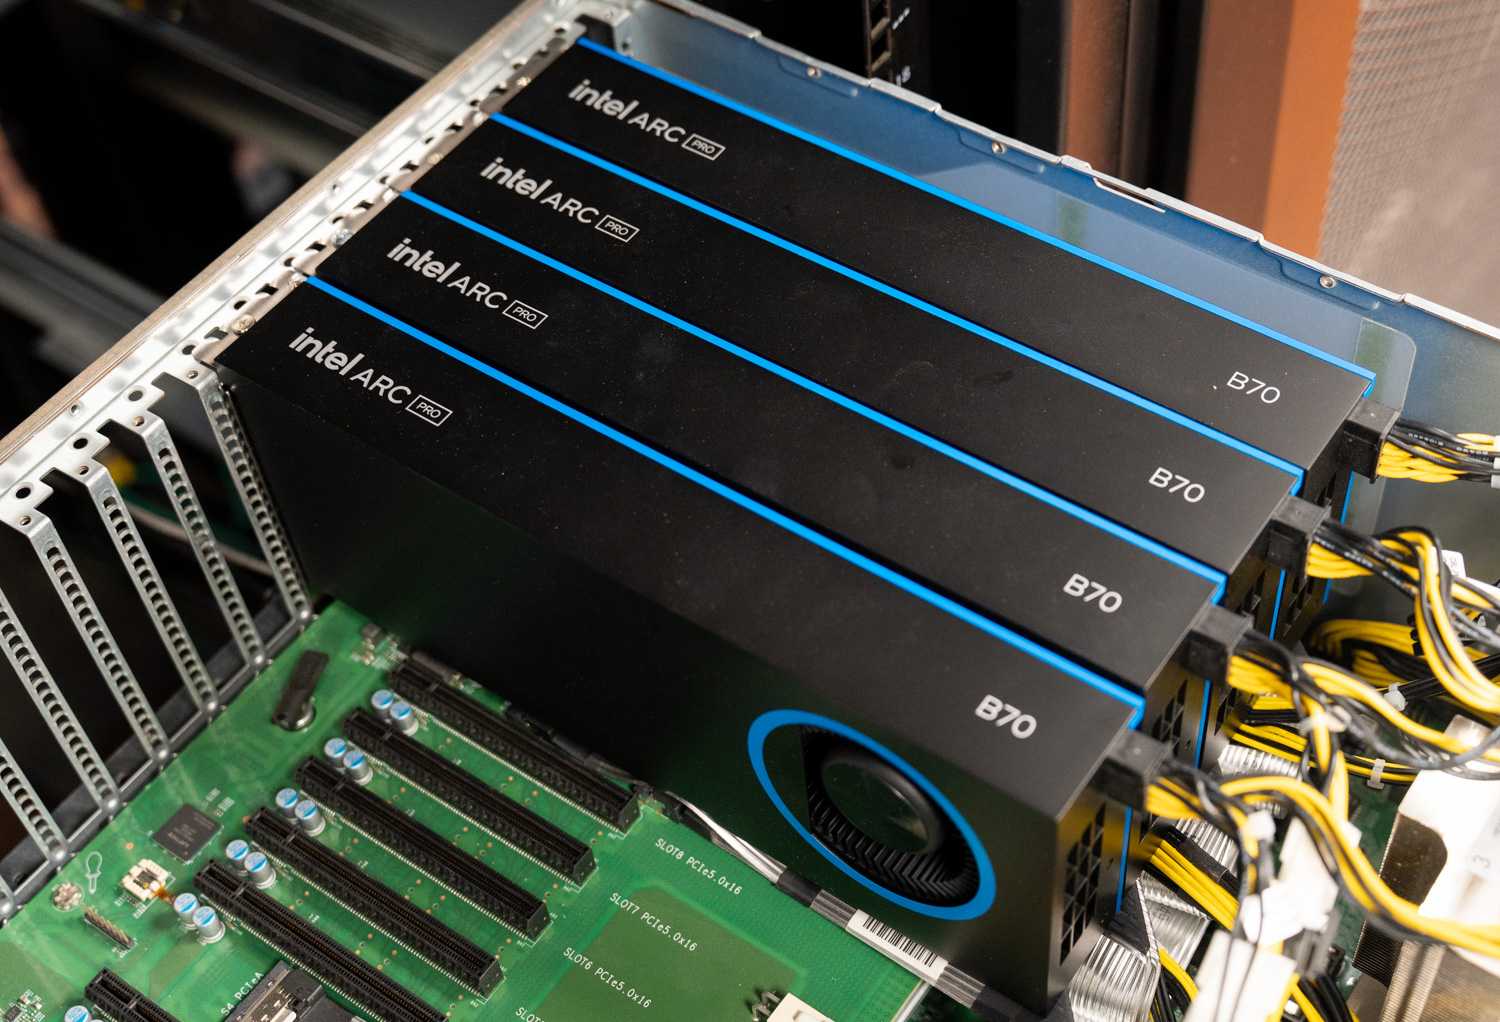
Per questa recensione, abbiamo mantenuto la stessa piattaforma utilizzata per il test B60, al fine di garantire un confronto equo: un Supermicro AS-4125GS-TNRT con processori AMD EPYC 9374F e 512 GB di DDR5, con quattro schede B70 (128 GB) e quattro B60 (96 GB) in modalità vLLM. Come per il test B60, non si tratta del benchmark Battlematrix interamente basato su processori Intel, che abbina le schede a un host Xeon 6. I sistemi di produzione con processori Intel potrebbero comportarsi in modo diverso. Quanto segue va considerato come un test comparativo generazionale e di rapporto qualità-prezzo a parità di configurazione, tenendo conto che la maturità del software influisce su ogni risultato.
Specifiche Intel Arc Pro B70
| Specificazione | Intel Arc Pro B70 |
|---|---|
| General | |
| Famiglia di prodotti | Grafica Intel Arc Pro serie B |
| Modello | Intel Arc Pro B70 |
| Nome codice | Battlemage |
| microarchitettura | Xe2 |
| Tecnologia di processo | TSMC N5 |
| Ora Di Pranzo | Q1 2026 |
| Garanzia | 3 anni |
| Specifiche della GPU | |
| Xe-Core | 32 |
| Renderizza le sezioni | 8 |
| Unità di ray tracing | 32 |
| Motori Intel XMX | 256 |
| Motori vettoriali Xe | 256 |
| Orologio grafico | 2280 MHz |
| Orologio dinamico massimo | 2800 MHz |
| Prestazioni FP32 | 22.94 TFLOPS |
| Prestazioni AI INT8 | 367 TOP |
| Potenza totale della scheda (TBP) | 230 W (configurabile: 160–290 W) |
| Interfaccia PCI Express | PCIe 5.0 x16 |
| Memorie | |
| Capacità di memoria | 32GB GDDR6 |
| Memory Bus | 256-bit |
| Banda di memoria | 608 GB / s |
| Memoria ECC | Supporto |
| Display e I/O | |
| Visualizza le uscite | DisplayPort 2.1 |
| Display massimi | 4 |
| Risoluzione massima | 7680 × 4320 a 120Hz (HDMI / DisplayPort) |
| Frequenza di aggiornamento variabile | HDMI VRR, VESA Adaptive Sync |
| Funzionalità e software | |
| Codifica/decodifica video | H.264, H.265 (HEVC), AV1 |
| Ray tracing | Supporto |
| Quadri di intelligenza artificiale | oneAPI, OpenVINO, estensione Intel per PyTorch (IPEX) |
| API grafiche | DirectX 12 Ultimate, Vulkan 1.3, OpenGL 4.6, OpenCL 3.0 |
| Intel XESS | Supporto |
| Supporto HDR | HDR10, HDR10+ Gaming, Dolby Vision |
| Motori codec multiformato | 2 |
| Specifiche fisiche | |
| Dimensioni | 10.5 × 3.9 pollici |
| Larghezza della scanalatura | Doppio slot |
| Peso | 1020 g |
| Connettore di alimentazione | 1 × 8 pin (ATX 2×4) |
Assemblaggio e progettazione della scheda madre Intel Arc Pro B70
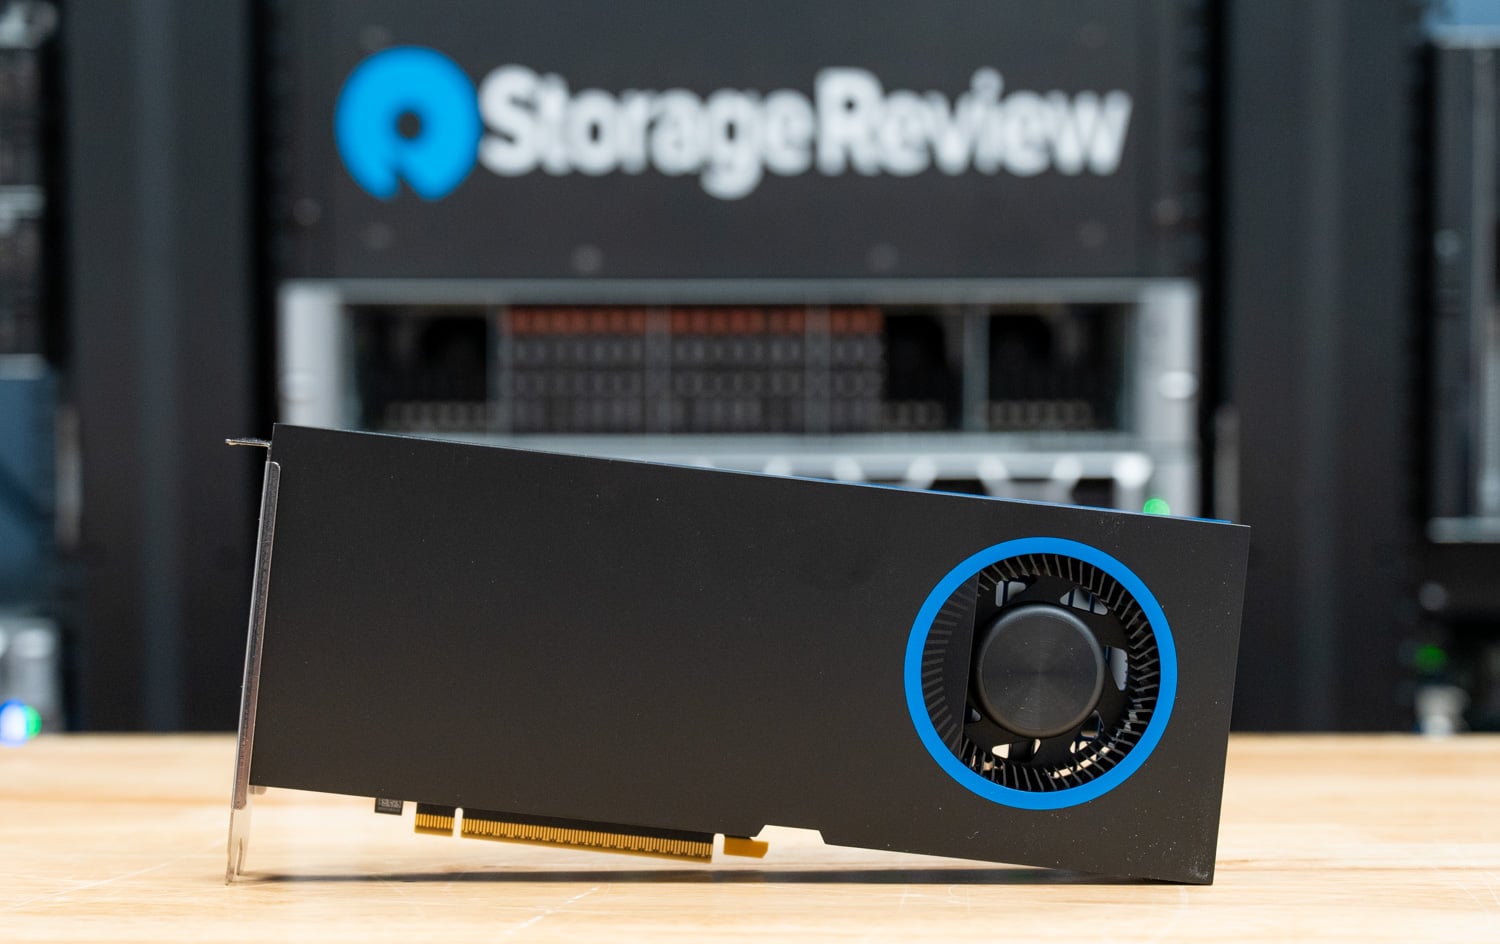
Con dimensioni di 267 × 99 mm (10.5 × 3.9 pollici) e un peso di 1 kg (2.25 libbre), la Intel Arc Pro B70 presenta un design compatto a doppio slot con un aspetto pulito e sobrio. La scheda è rifinita in nero opaco con i caratteristici dettagli blu di Intel. Include una piastra posteriore in alluminio anodizzato a tutta lunghezza che aggiunge rigidità e si abbina al marchio Intel.
È dotata di una singola ventola di tipo blower che aspira l'aria attraverso il dissipatore e la espelle direttamente dalla staffa I/O posteriore. Questo design di raffreddamento chiuso mantiene le dimensioni della scheda compatte e garantisce un flusso d'aria pulito all'interno del sistema.
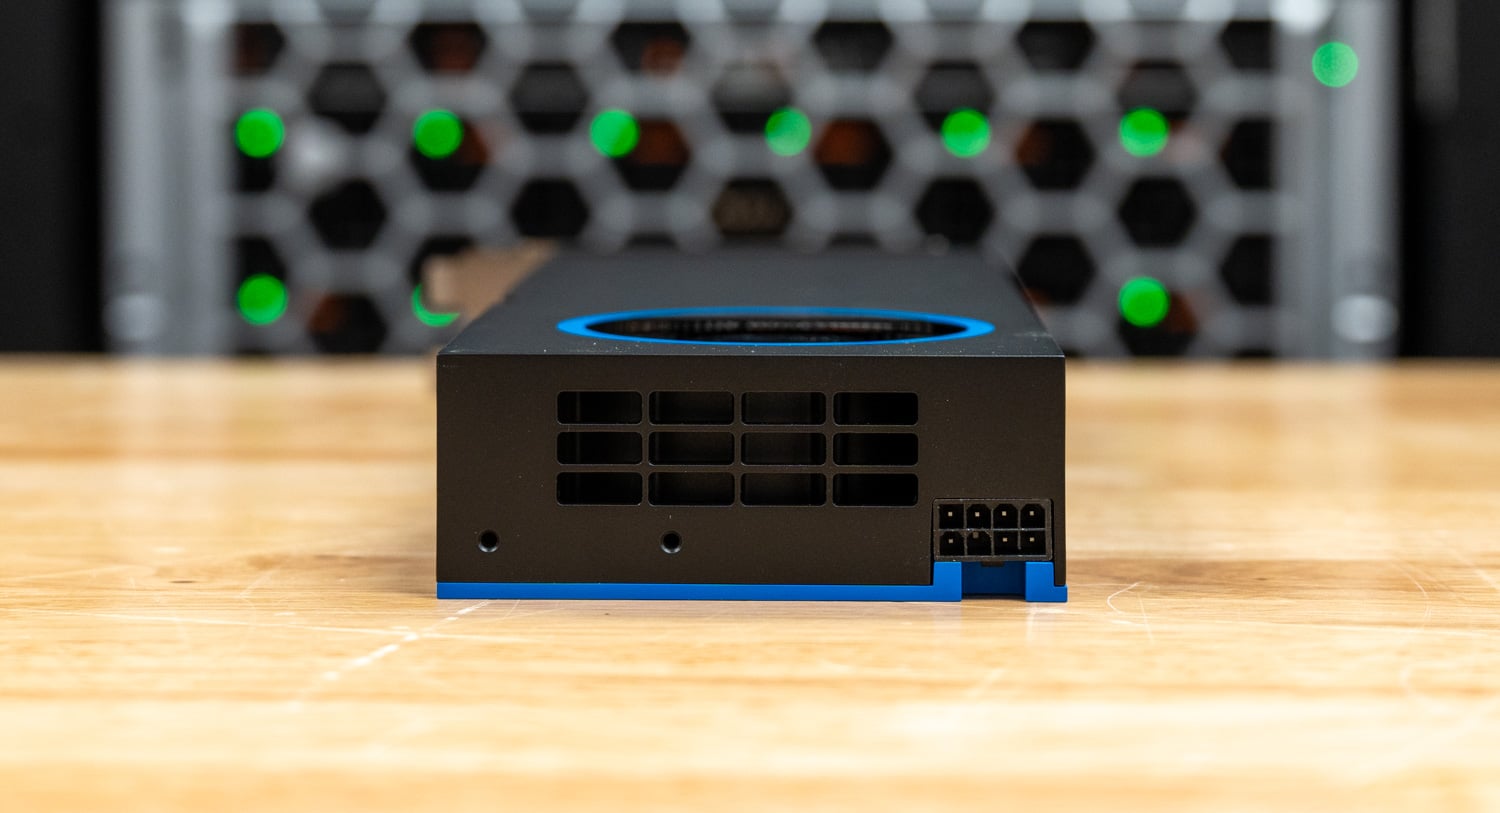
Sul retro della scheda, in posizione opposta alla staffa PCIe, Intel ha incluso un singolo connettore di alimentazione PCIe a 8 pin (2×4) per fornire alimentazione esterna. Questa estremità del dissipatore presenta anche ulteriori aperture di aspirazione che convogliano aria fresca alla ventola di raffreddamento, insieme a punti di montaggio filettati per il fissaggio di una staffa di supporto GPU opzionale, utile per migliorare la stabilità nelle installazioni in workstation.
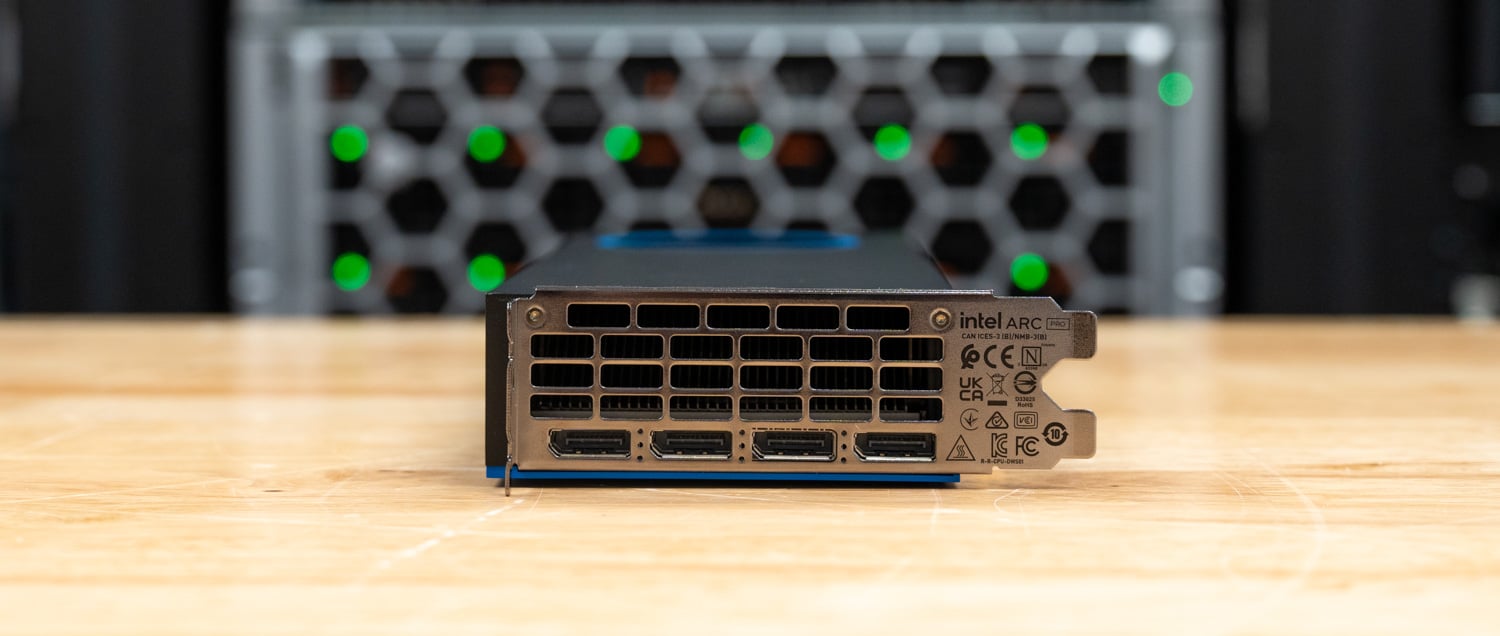
Lungo il bordo inferiore, la Arc Pro B70 utilizza un'interfaccia PCIe 5.0 x16 standard per la connettività con l'host. Questa angolazione evidenzia anche il fattore di forma a doppio slot della scheda. Offre spazio sufficiente per la soluzione di raffreddamento a ventola integrata, pur rimanendo abbastanza compatta per installazioni dense in workstation e server.
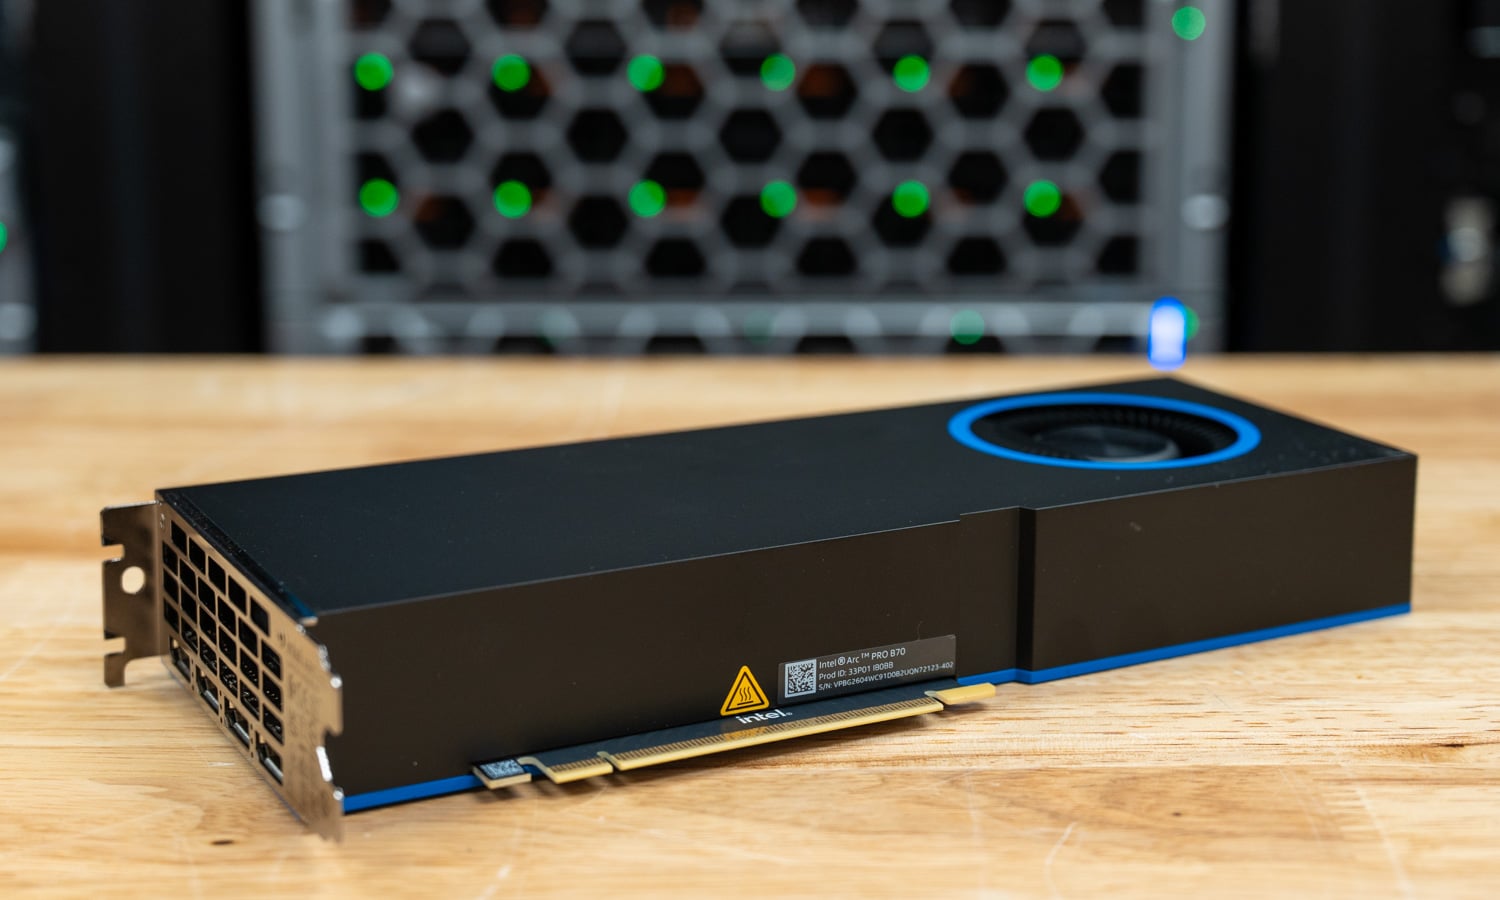
La staffa I/O è dotata di un'ampia griglia di ventilazione che permette alla ventola di espellere l'aria calda direttamente fuori dallo chassis. Sotto la griglia di ventilazione si trovano quattro uscite DisplayPort 2.1, ciascuna in grado di gestire display fino a 7680 × 4320 (8K) a 120Hz, offrendo un'ampia larghezza di banda per ambienti workstation multi-monitor ad alta risoluzione.
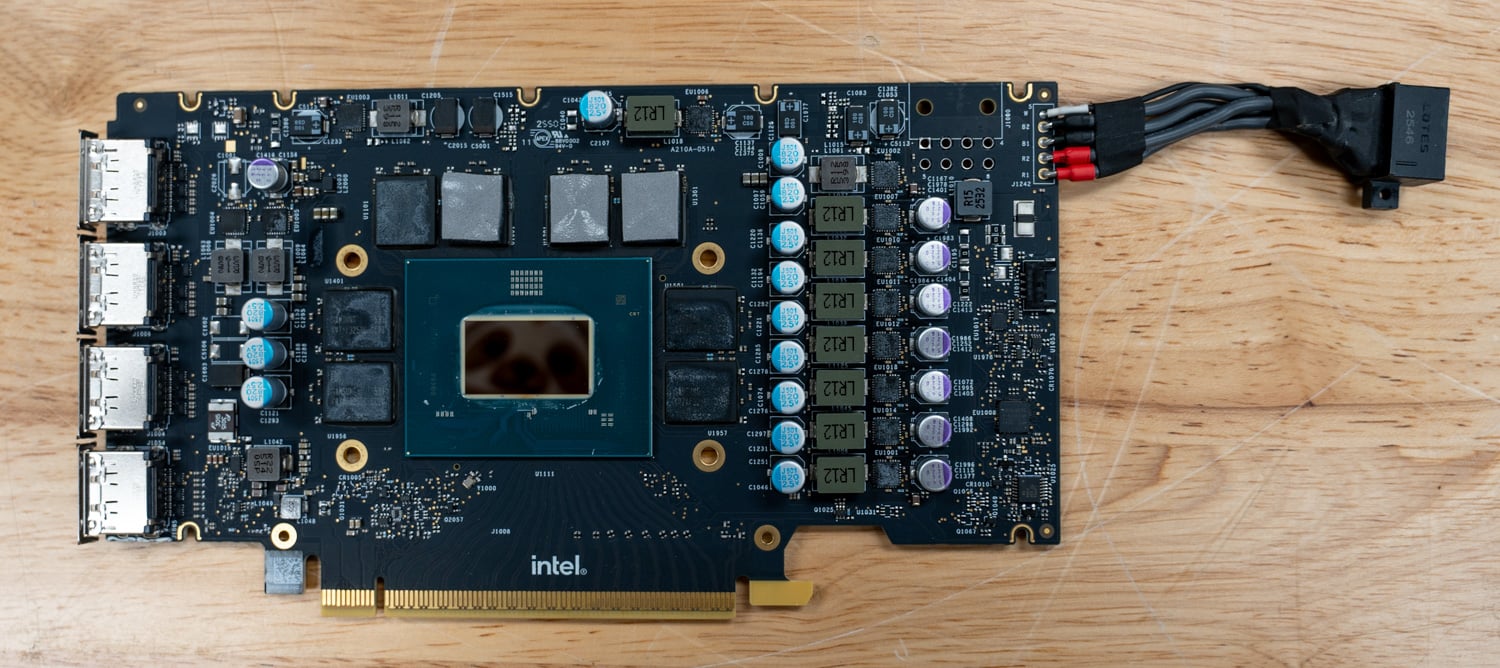
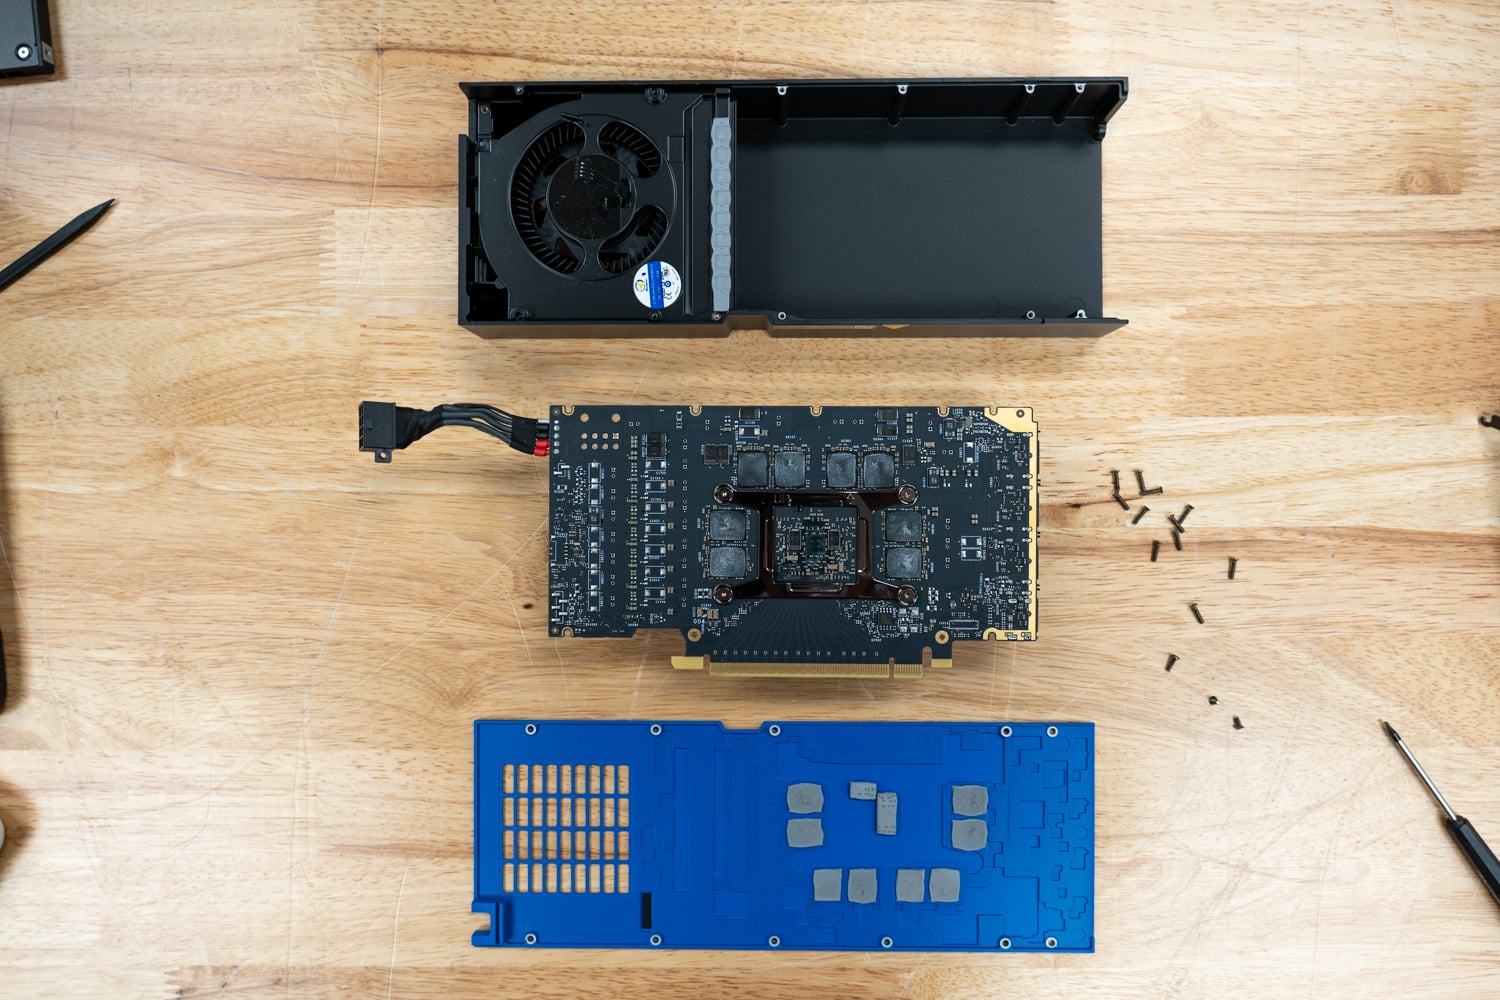
Una volta rimosso il dissipatore, il PCB della Arc Pro B70 rivela i componenti principali che alimentano la scheda. Al centro si trova la GPU Intel Xe2-HPG a 32 core, circondata da 32 GB di memoria GDDR6 dedicata, collegata tramite un'interfaccia di memoria a 256 bit che offre una larghezza di banda fino a 608 GB/s. La GPU integra anche 256 motori XMX AI che offrono fino a 367 INT8 TOPS di prestazioni di calcolo AI, insieme a 32 unità Ray Tracing dedicate per i carichi di lavoro di ray tracing accelerati dall'hardware. Attorno alla GPU si trovano le fasi di alimentazione, i circuiti di memoria e i componenti di output video che supportano il design della scheda.
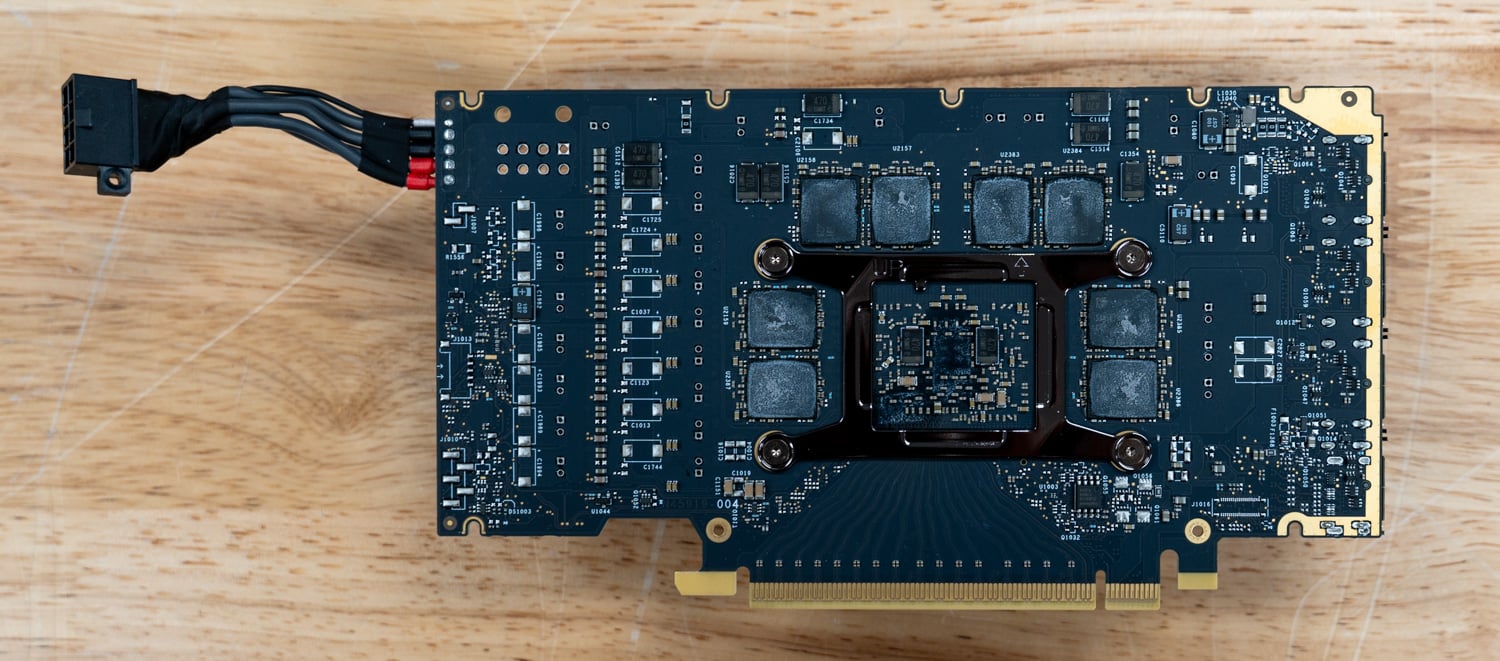
La parte posteriore del PCB espone ulteriori moduli di memoria GDDR6 e parte del circuito di alimentazione della scheda. L'ampia staffa di fissaggio che circonda la GPU contribuisce a distribuire uniformemente la pressione di montaggio del dissipatore. Il connettore di alimentazione PCIe a 8 pin fornisce l'alimentazione esterna alla scheda. Con l'alimentazione fornita tramite lo slot PCIe, la Arc Pro B70 è in grado di gestire un consumo energetico totale fino a 230 W.
Test delle prestazioni della scheda madre Intel Arc Pro B70
Test su Windows – Piattaforma di test AMD Threadripper di StorageReview
Ecco la piattaforma di test che utilizzeremo per i nostri test su singola scheda madre Intel Arc Pro B70:
- Scheda madre: ASUS Pro WS TRX50-SAGE WIFI
- CPU: AMD Ryzen Threadripper 7980X 64-core
- RAM: 128 GB DDR5 4800 MT/s
- Memoria su disco: Samsung 2Pro da 980TB
- OS: Windows 11 Pro per workstation
GPU comparabili testate
- Intel Arc Pro B50
- Intel Arc Pro B70
- AMD Radeon RX 9060 XT
- AMD Radeon RX 9070
- AMD Radeon RX 9070 XT
- NVIDIA GeForce RTX 5060 Ti
- NVIDIA GeForce RTX 5070 FE
UL Procyon: generazione di testo AI
Il benchmark Procyon AI Text Generation semplifica i test delle prestazioni dei modelli LLM basati sull'IA con un metodo di valutazione conciso e coerente. Consente di ripetere i test su più modelli LLM, riducendo al minimo la complessità dei modelli di grandi dimensioni e l'impatto di fattori variabili. Sviluppato in collaborazione con i leader nel settore dell'hardware per l'IA, ottimizza l'utilizzo degli acceleratori AI locali per fornire valutazioni delle prestazioni più affidabili ed efficienti. I seguenti risultati sono stati misurati utilizzando TensorRT su modelli NVIDIA e ONNX su modelli AMD.
La Arc Pro B70 offre uno dei maggiori miglioramenti generazionali nel confronto, aumentando i punteggi complessivi del 60% rispetto alla B50 sui modelli Phi, Mistral e Llama 3, riducendo al contempo il tempo di esecuzione del primo token del 40-45%. Rispetto ad AMD, la B70 ottiene un punteggio superiore del 224% rispetto alla Radeon RX 9060 XT su Phi (4,152 contro 1,281), del 220% su Mistral (4,082 contro 1,274) e del 250% su Llama 3 (4,029 contro 1,150). Rispetto alla Radeon RX 9070 XT, Intel mantiene ancora un vantaggio rispettivamente del 100%, dell'83% e del 95%. NVIDIA riduce il divario, con la RTX 5060 Ti in ritardo del 45% rispetto alla B70 in Phi e del 45% in Mistral, mentre la RTX 5070 rimane indietro del 15-20% negli stessi modelli. Il risultato più eclatante è Llama 2, dove la B70 ottiene il punteggio più alto dell'intero confronto con 5,769, superando la RTX 5070 dell'85% e la RX 9070 XT del 151%.
| UL Procyon: generazione di testo AI | Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| Punteggio complessivo Phi | 2,593 | 4,152 | 1,281 | 1,933 | 2,080 | 2,870 | 3,453 |
| Tempo di output Phi per il primo token | 0.275 s | 0.155 s | 1.473 s | 0.954 s | 0.855 s | 0.375 s | 0.323 s |
| Token di output Phi al secondo | 72.128 token/s | 104.121 token/s | 94.453 token/s | 139.187 token/s | 144.471 token/s | 120.773 token/s | 150.435 token/s |
| Durata complessiva Phi | 39.179 s | 37.924 s | 39.365 s | 26.989 s | 25.587 s | 25.216 s | 20.302 s |
| Punteggio complessivo Mistral | 2,483 | 4,082 | 1,274 | 2,040 | 2,231 | 2,807 | 3,562 |
| Tempo di output di Mistral per il primo token | 0.346 s | 0.180 s | 1.827 s | 1.109 s | 0.946 s | 0.526 s | 0.433 s |
| Gettoni di output Mistral al secondo | 46.799 token/s | 65.834 token/s | 65.115 token/s | 101.300 token/s | 103.348 token/s | 91.057 token/s | 120.507 token/s |
| Durata complessiva del Mistral | 59.907 s | 58.976 s | 54.516 s | 34.960 s | 33.350 s | 33.377 s | 25.496 s |
| Punteggio complessivo di Llama3 | 2,427 | 4,029 | 1,150 | 1,904 | 2,070 | 2,599 | 3,125 |
| Tempo di output di Llama3 per il primo token | 0.311 s | 0.166 s | 1.632 s | 0.981 s | 0.845 s | 0.449 s | 0.379 s |
| Token di output Llama3 al secondo | 45.031 token/s | 66.340 token/s | 53.167 token/s | 87.594 token/s | 89.102 token/s | 74.709 token/s | 100.388 token/s |
| Llama3 Durata complessiva | 61.926 s | 53.687 s | 62.563 s | 38.273 s | 36.742 s | 39.489 s | 29.720 s |
| Punteggio complessivo di Llama2 | - | 5,769 | 1,252 | 2,047 | 2,298 | 2,576 | 3,125 |
| Tempo di output di Llama2 per il primo token | - | 0.259 s | 2.992 s | 1.926 s | 1.565 s | 0.844 s | 0.785 s |
| Token di output Llama2 al secondo | - | 63.666 token/s | 34.654 token/s | 59.673 token/s | 61.127 token/s | 41.386 token/s | 56.647 token/s |
| Llama2 Durata complessiva | - | 44.131 s | 99.027 s | 59.100 s | 55.520 s | 71.302 s | 53.234 s |
Procione UL: Generazione di immagini AI
Il benchmark Procyon AI Image Generation misura in modo coerente e accurato le prestazioni di inferenza AI su una vasta gamma di hardware, dalle NPU a basso consumo alle GPU di fascia alta. Include tre test: Stable Diffusion XL (FP16) per GPU di fascia alta, Stable Diffusion 1.5 (FP16) per GPU di potenza media e Stable Diffusion 1.5 (INT8) per dispositivi a basso consumo. Il benchmark utilizza il motore di inferenza ottimale per ciascun sistema, garantendo risultati equi e comparabili.
La generazione di immagini è un altro ambito in cui la Arc Pro B70 mostra un netto miglioramento rispetto alla sorella minore, ottenendo un punteggio Stable Diffusion 1.5 FP16 superiore del 179% (2,101 contro 754) e riducendo il tempo di generazione da 132.6 secondi a 47.6 secondi, con una riduzione del 64%. La B70 si posiziona sostanzialmente alla pari con la RTX 5060 Ti (2,101 contro 2,110, con una differenza inferiore all'1%), mentre è inferiore del 19% rispetto alla RX 9070 XT e del 29% rispetto alla RTX 5070. In Stable Diffusion XL FP16, Intel triplica nuovamente le prestazioni della B50 (181% in più) e si posiziona appena l'8% davanti alla RTX 5060 Ti, mentre è inferiore di circa il 18% rispetto alla RTX 5070 FE. Il carico di lavoro INT8 favorisce l'implementazione TensorRT di NVIDIA, sebbene la B70 migliori comunque la B50 del 265% e riduca il tempo di generazione delle immagini di oltre il 72%.
| UL Procyon: generazione di immagini AI (punteggio complessivo: più alto è, meglio è) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| Diffusione stabile 1.5 (FP16) — Punteggio complessivo | 754 | 2,101 | 1,436 | 2,110 | 2,280 | 2,598 | 2,937 |
| Diffusione stabile 1.5 (FP16) — Tempo complessivo | 132.585 s | 47.585 s | 69.633 s | 47.590 s | 43.858 s | 38.481 s | 34.038 s |
| Diffusione stabile 1.5 (FP16) — Velocità di generazione delle immagini | 8.287 s/immagine | 2.974 s/immagine | 4.352 s/immagine | 2.974 s/immagine | 2.741 s/immagine | 2.405 s/immagine | 2.127 s/immagine |
| Diffusione stabile 1.5 (INT8) — Punteggio complessivo | 5,020 | 18,344 | N/A | 27,705 | N/A | N/A | 36,320 |
| Diffusione stabile 1.5 (INT8) — Tempo complessivo | 49.795 s | 13.628 s | N/A | 9.024 s | N/A | N/A | 6.883 s |
| Diffusione stabile 1.5 (INT8) — Velocità di generazione delle immagini | 6.224 s/immagine | 1.703 s/immagine | N/A | 1.128 s/immagine | N/A | N/A | 0.860 s/immagine |
| Diffusione stabile XL (FP16) — Punteggio complessivo | 748 | 2,102 | 1,124 | 1,940 | 1,805 | 2,010 | 2,473 |
| Diffusione stabile XL (FP16) — Tempo complessivo | 790.774 s | 285.344 s | 533.736 s | 326.550 s | 332.400 s | 298.499 s | 242.606 s |
| Stable Diffusion XL (FP16) — Velocità di generazione delle immagini | 49.423 s/immagine | 17.834 s/immagine | 33.359 s/immagine | 20.409 s/immagine | 20.775 s/immagine | 18.656 s/immagine | 15.163 s/immagine |
Luxmark
Luxmark è un benchmark GPU che utilizza LuxRender, un motore di rendering ray-tracing open source, per valutare le prestazioni di un sistema con scene 3D altamente dettagliate. Questo benchmark è particolarmente rilevante per valutare le capacità di rendering grafico di server e workstation, soprattutto nelle applicazioni di effetti visivi e visualizzazione architettonica, dove una simulazione accurata della luce è fondamentale.
LuxMark dimostra un'eccellente scalabilità per Battlemage. L'Arc Pro B70 supera la B50 del 128% nella scena del cibo e del 137% in quella della sala. Supera inoltre la Radeon RX 9060 XT del 33% nella scena del cibo e del 53% in quella della sala. La RX 9070 XT, orientata al gaming, mantiene un vantaggio di circa il 54% nella scena del cibo e del 37% in quella della sala, mentre la NVIDIA RTX 5070 FE è in testa rispettivamente del 62% e dell'81%. Nel complesso, la B70 si afferma saldamente come un potente acceleratore di rendering OpenCL per carichi di lavoro workstation.
| Luxmark (Più alto è meglio) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| Punteggio cibo | 2,456 | 5,609 | 4,220 | 6,590 | 8,233 | 8,610 | 9,061 |
| Punteggio Hall | 5,158 | 12,220 | 8,007 | 15,348 | 16,566 | 16,758 | 22,062 |
Geekbench 6
Geekbench 6 è un benchmark multipiattaforma che misura le prestazioni complessive del sistema. Il Geekbench Browser consente di confrontare qualsiasi sistema con i risultati ottenuti.
La Arc Pro B70 ottiene un punteggio di 140,165, che rappresenta un miglioramento del 100% rispetto alla Arc Pro B50. Supera la Radeon RX 9070 di circa l'1%, surclassa la RX 9060 XT del 36% e si posiziona appena dietro alla RTX 5060 Ti, con un distacco di appena il 7%. La RTX 5070 FE di NVIDIA amplia il vantaggio a circa il 24%, mentre la RX 9070 XT di AMD si piazza circa il 35% avanti, collocando la B70 esattamente a metà della fascia alta delle schede grafiche di fascia media.
| Geekbench 6 OpenCL (Più alto è meglio) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | AMD Radeon RX 9070 | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| Punteggio GPU OpenCL | 70,038 | 140,165 | 102,750 | 138,463 | 150,743 | 173,255 | 188,892 |
3DMark
3DMark Port Royal, Speed Way e Steel Nomad sono benchmark GPU che testano le prestazioni in diversi scenari. Port Royal si concentra sul ray tracing, Speed Way valuta le prestazioni nelle simulazioni di corse e Steel Nomad sfida le GPU con una grafica realistica e ad alta intensità. Valutano le capacità della GPU in termini di rendering, illuminazione e scene dinamiche.
Le prestazioni grafiche sintetiche scalano bene con la nuova architettura. La Arc Pro B70 ottiene un punteggio superiore del 154% rispetto alla B50 in Port Royal, del 136% in Speed Way e del 149% in Steel Nomad. Rispetto alla RX 9060 XT, la B70 è in vantaggio del 9% in Port Royal, del 7% in Speed Way e del 9% in Steel Nomad. Rispetto alla RTX 5060 Ti, la B70 ha prestazioni entro il 2% in Port Royal, è indietro del 23% in Speed Way e ha un vantaggio del 13% in Steel Nomad. Le schede di fascia alta RTX 5070 FE e RX 9070 XT continuano a detenere un vantaggio del 31-83% a seconda del carico di lavoro, a conferma del loro posizionamento come GPU da gioco ad alte prestazioni.
| 3DMark (Più alto è meglio) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| Port Royal | 4,197 | 10,668 | 9,751 | 10,432 | 14,026 | 15,760 | 17,989 |
| Via della velocità | 1,355 | 3,202 | 3,004 | 4,184 | 5,869 | 5,791 | 6,237 |
| Steel Nomad (DX12) | 1,644 | 4,089 | 3,767 | 3,611 | 5,019 | 5,992 | 6,977 |
Topazio Video AI
Topaz Video AI è un'applicazione professionale per il miglioramento e il restauro di video tramite modelli di intelligenza artificiale avanzati. Supporta diverse attività, tra cui l'upscaling di filmati a 4K o 8K, la nitidezza di contenuti sfocati, la riduzione del rumore, il miglioramento dei dettagli del viso, la colorazione di filmati in bianco e nero e l'interpolazione dei fotogrammi per un movimento più fluido. La suite include un benchmark integrato che misura le prestazioni del sistema sui vari algoritmi di miglioramento video, fornendo una chiara visione di come le piattaforme hardware gestiscono carichi di lavoro impegnativi di elaborazione video basata sull'IA.
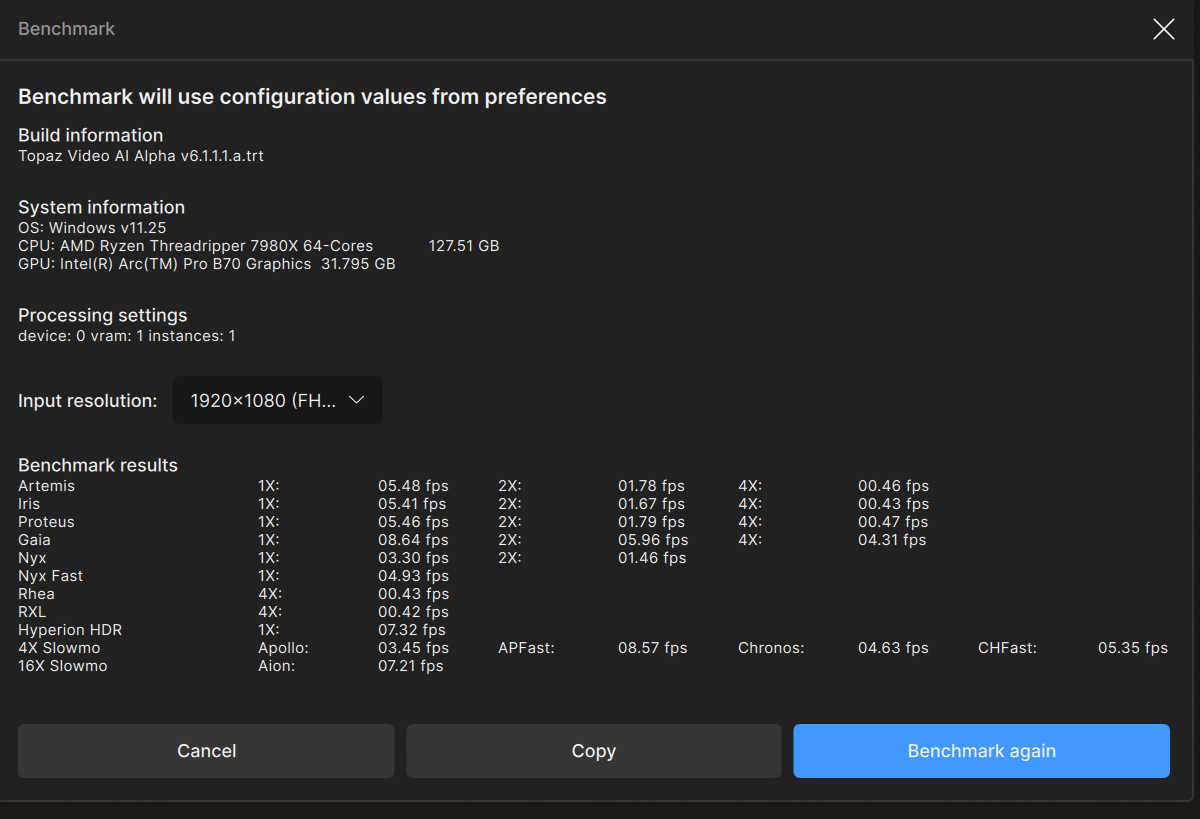
La Arc Pro B70 offre un miglioramento sostanziale rispetto alla precedente generazione di schede professionali Intel, con i maggiori incrementi riscontrabili nei carichi di lavoro di upscaling AI. La scheda raggiunge 5.48 FPS in Artemis, 5.41 FPS in Iris e 5.46 FPS in Proteus con un miglioramento 1×, mentre Gaia arriva a 8.64 FPS, il risultato più veloce tra i modelli di miglioramento standard. I modelli di restauro più intensivi dal punto di vista computazionale risultano naturalmente più lenti, con Nyx a 3.30 FPS e Nyx Fast a 4.93 FPS, mentre Hyperion HDR elabora i filmati a 7.32 FPS. Anche la generazione di slow-motion offre buone prestazioni, con 3.45 FPS con Apollo, 8.57 FPS con APFast, 4.63 FPS con Chronos, 5.35 FPS con CHFast e 7.21 FPS con Aion. Nel complesso, questi risultati dimostrano che la Arc Pro B70 è in grado di gestire l'intera gamma di flussi di lavoro di Topaz AI, dal miglioramento e dalla riduzione del rumore video alla conversione HDR e all'interpolazione dei fotogrammi, rappresentando quindi un'ottima opzione per i creatori che desiderano sfruttare l'accelerazione AI XMX di Intel.
Blender 4.5
Blender è un'applicazione open-source per la modellazione 3D. Questo benchmark è stato eseguito utilizzando l'utility Blender Benchmark su tutte le GPU. Il punteggio è misurato in campioni al minuto, con valori più alti che indicano prestazioni migliori.
La Arc Pro B70 raggiunge 1,524.6 campioni/minuto in Monster, 846.9 campioni/minuto in Junkshop e 912.2 campioni/minuto in Classroom. Sebbene questi valori non siano paragonabili a quelli di GPU di fascia alta per appassionati come la RX 9070 XT o la RTX 5070, dimostrano che Battlemage offre prestazioni di rendering sufficienti per carichi di lavoro professionali di visualizzazione e creazione di contenuti. Grazie al framebuffer da 32 GB e ai driver certificati per workstation, la B70 trova un equilibrio ideale tra capacità di rendering, accelerazione AI e affidabilità professionale.
| Blender 4.5.0 (campioni al minuto, un valore più alto è migliore) | Intel Arc Pro B70 |
|---|---|
| Mostro - Monster | 1,524.60 |
| Rigattiere | 846.87 |
| Aula | 912.24 |
Consumo energetico: Intel B70
Il consumo energetico è una componente significativa di qualsiasi piattaforma di calcolo. Ogni nuova generazione di GPU consuma più energia sotto carico, richiedendo alimentatori più potenti e un flusso d'aria adeguato per il raffreddamento. Tuttavia, le GPU più veloci possono raggiungere valori di picco più elevati, ma la durata di ciascun carico di lavoro si riduce. Utilizzando l' analizzatore di rete Quarch presente nel nostro laboratorio di test, abbiamo misurato il consumo energetico totale del sistema durante il test Procyon AI Image Generator Stable Diffusion XL FP16. Questo carico di lavoro ha spinto ciascuna GPU al limite delle sue capacità, con punti di inizio e fine ben definiti per ogni immagine generata, chiaramente visibili.
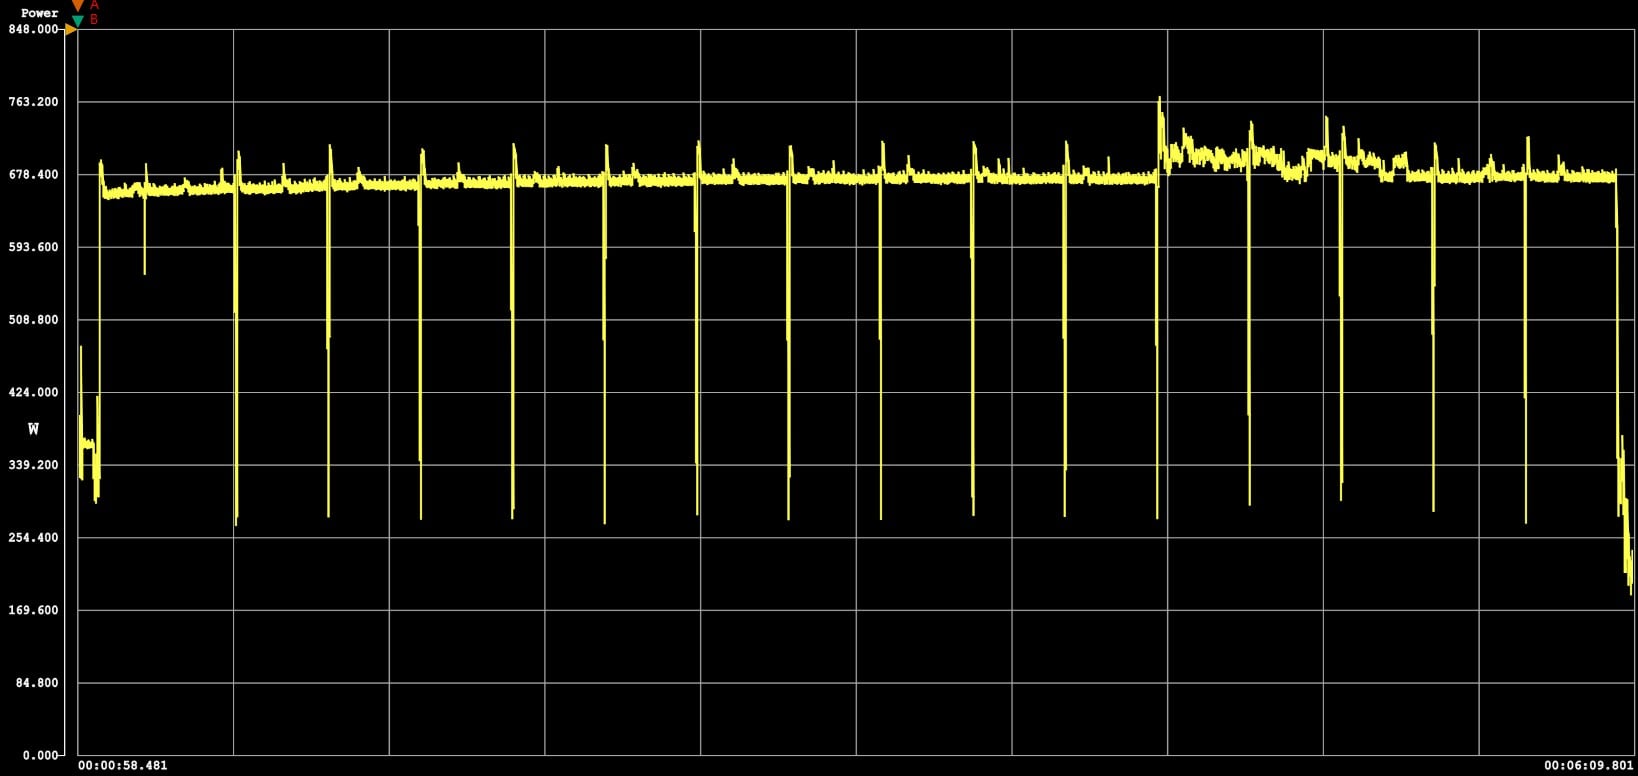
Durante i nostri test sulla Intel Arc Pro B70, abbiamo misurato un consumo energetico del sistema inattivo di 207 W, un consumo di picco di 705.6 W durante il carico di lavoro e un consumo medio durante il carico di lavoro di 638.6 W.
| Efficienza energetica di Stable Diffusion XL FP16 (è meglio più basso) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | PNY NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|
| Consumo di energia | 5.32 Wh | 3.45 Wh | 4.00 Wh | 3.41 Wh | 2.13 Wh | 2.46 Wh |
| Durata del test | 49.9 s | 18.46 s | 33.0 s | 17.4 s | 20.2 s | 19.2 s |
Prestazioni di riferimento del servizio online vLLM
vLLM è il motore di inferenza e di erogazione ad alta velocità più diffuso per i LLM. Il benchmark di erogazione online di vLLM è uno strumento di valutazione delle prestazioni che misura le prestazioni di erogazione in condizioni reali con richieste simultanee. Simula carichi di lavoro di produzione inviando richieste a un server vLLM in esecuzione con parametri configurabili, tra cui la frequenza delle richieste, le lunghezze di input/output e il numero di client simultanei. Il benchmark misura metriche chiave, tra cui il throughput (token al secondo), il tempo al primo token (TTFT) e il tempo per token di output (TPOT), aiutando gli utenti a comprendere le prestazioni di vLLM in diverse condizioni di carico.
Piattaforma di prova:
- Server: Supermicro AS-4125GS-TNRT
- processori: AMD EPYC 9374F
- Memoria: 512 GB Samsung 4800 MT/s DDR5
- ISL 2k/ OSL 256
Test comparativo delle GPU
- Intel Arc Pro B60
- Intel Arc Pro B70
- NVIDIA RTX Pro 6000
- Scheda grafica NVIDIA DGX Spark
Abbiamo testato quattro B70 (128 GB) e quattro B60 (96 GB) nell'host Supermicro confrontandole con una singola RTX Pro 6000 e una singola DGX Spark. La disomogeneità nel numero di GPU è voluta: con un prezzo di listino di 949 dollari, un set di quattro B70 ha un prezzo simile a quello di una singola Spark e ben inferiore a quello di una singola RTX Pro 6000, quindi questo confronto allinea le piattaforme in base all'investimento approssimativo in dollari piuttosto che al numero di schede.
Mistral Piccolo 24B
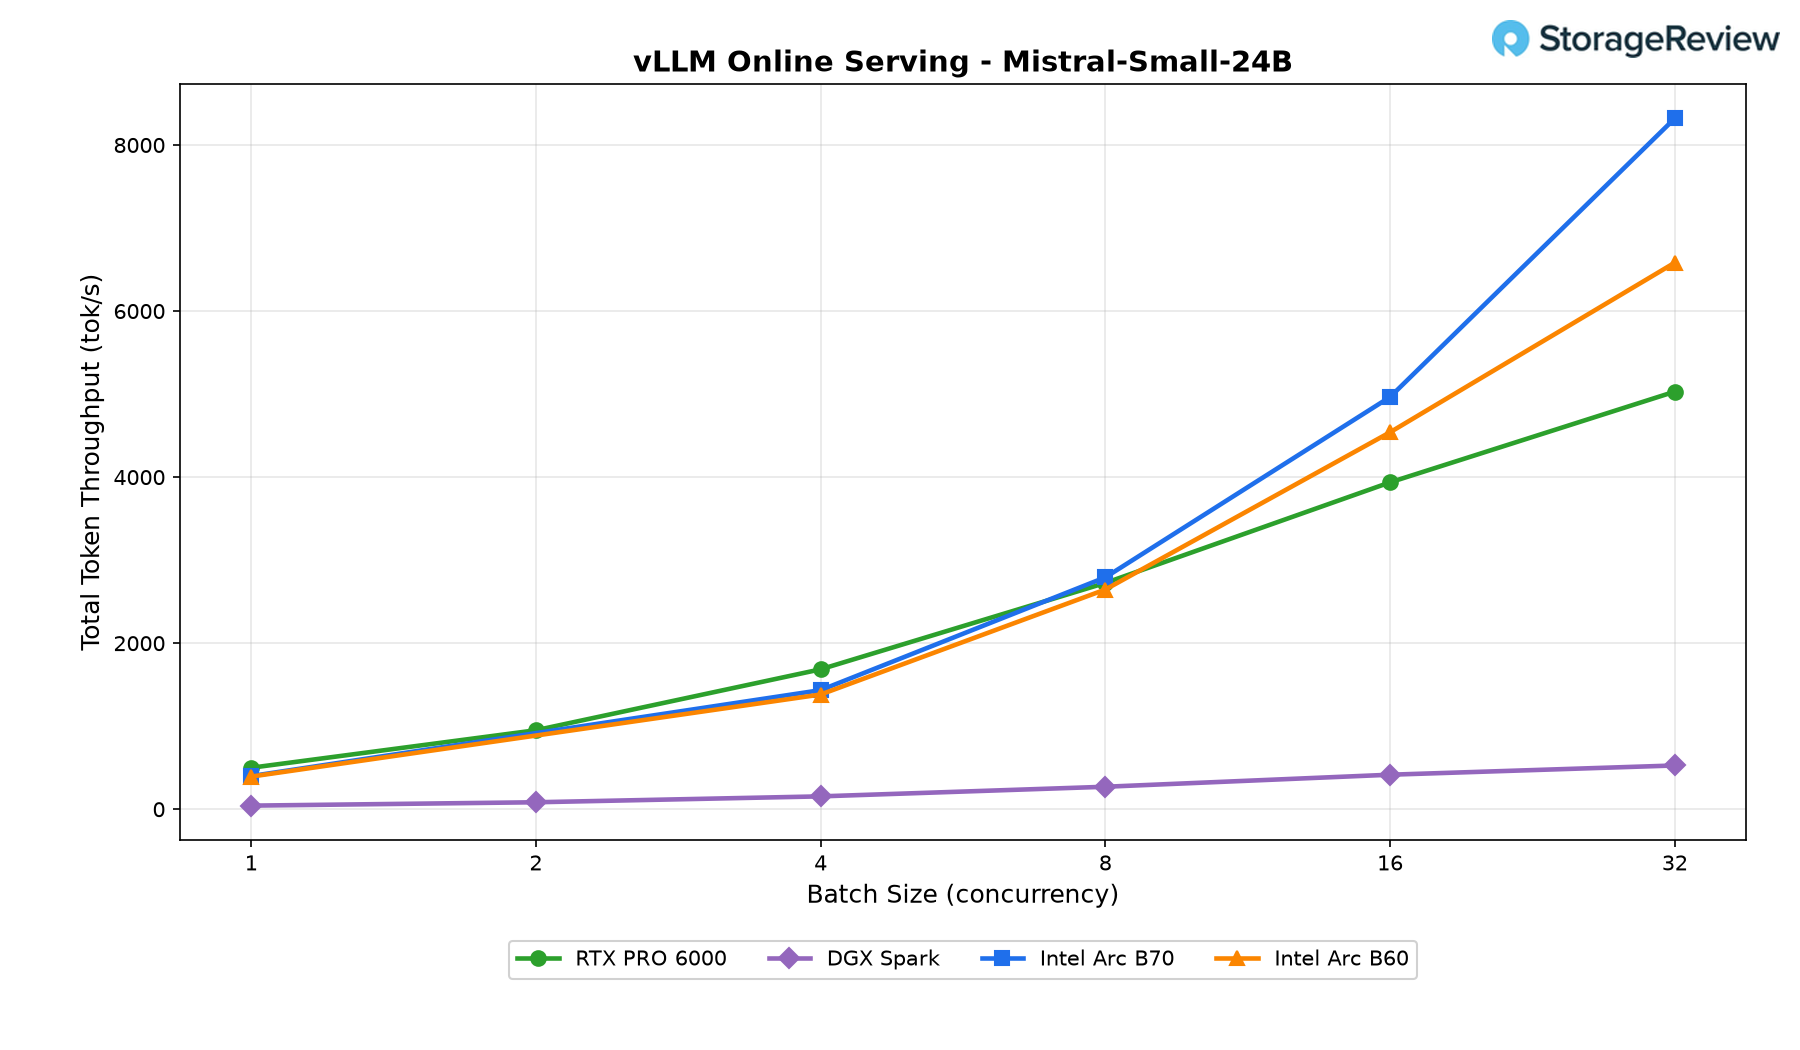
La Intel Arc Pro B70 ha dato il meglio di sé nel workload Mistral-Small-24B, passando da 450 tok/s con batch size 1 a 8,321 tok/s con batch size 32. Mentre la RTX PRO 6000 manteneva un leggero vantaggio fino a batch size 4, la B70 l'ha superata a batch size 8 e ha costantemente ampliato il divario, terminando con un vantaggio di circa il 65% al massimo livello di concorrenza. Rispetto alla sorella minore, la Arc Pro B60, la B70 ha mantenuto un modesto vantaggio iniziale, estendendolo a circa il 26% con batch size 32. La DGX Spark è rimasta nettamente indietro per tutta la durata del test, raggiungendo un picco di soli 527 tok/s, lasciando la B70 quasi 16 volte più veloce sotto carico massimo.
Qwen3 Coder 30B
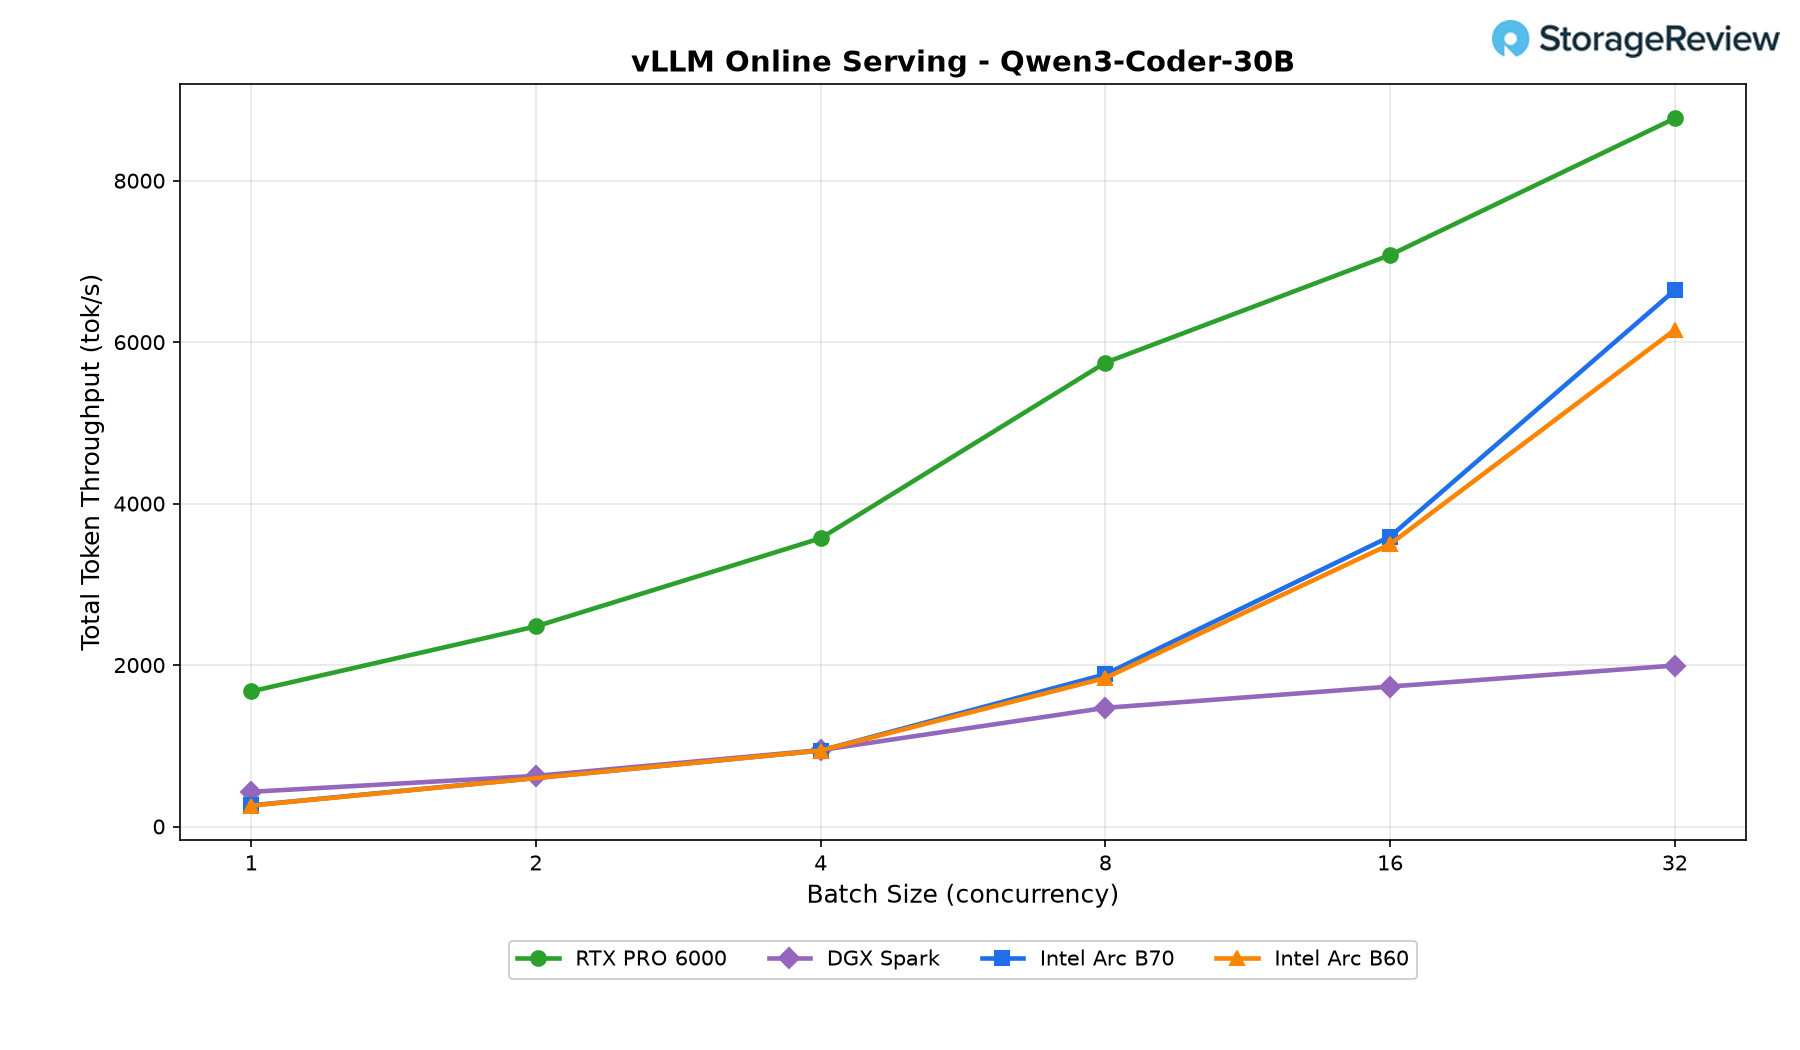
Il test Qwen3-Coder-30B ha favorito la RTX PRO 6000, che ha mantenuto il throughput più elevato a tutti i livelli di concorrenza, raggiungendo 8,772 token/s. La Intel Arc Pro B70 ha comunque mostrato una buona scalabilità, arrivando a 6,643 token/s con una dimensione del batch di 32, mantenendo un piccolo ma costante vantaggio rispetto alla Arc Pro B60, risultando circa l'8% più veloce. Sebbene non sia riuscita a eguagliare la RTX PRO 6000 in questo carico di lavoro orientato agli sviluppatori, la B70 ha comunque offerto un throughput più che triplo rispetto alla DGX Spark alla massima concorrenza, evidenziando la sua capacità di gestire in modo efficiente un numero maggiore di richieste di inferenza simultanee.
Lama 3.1 8B
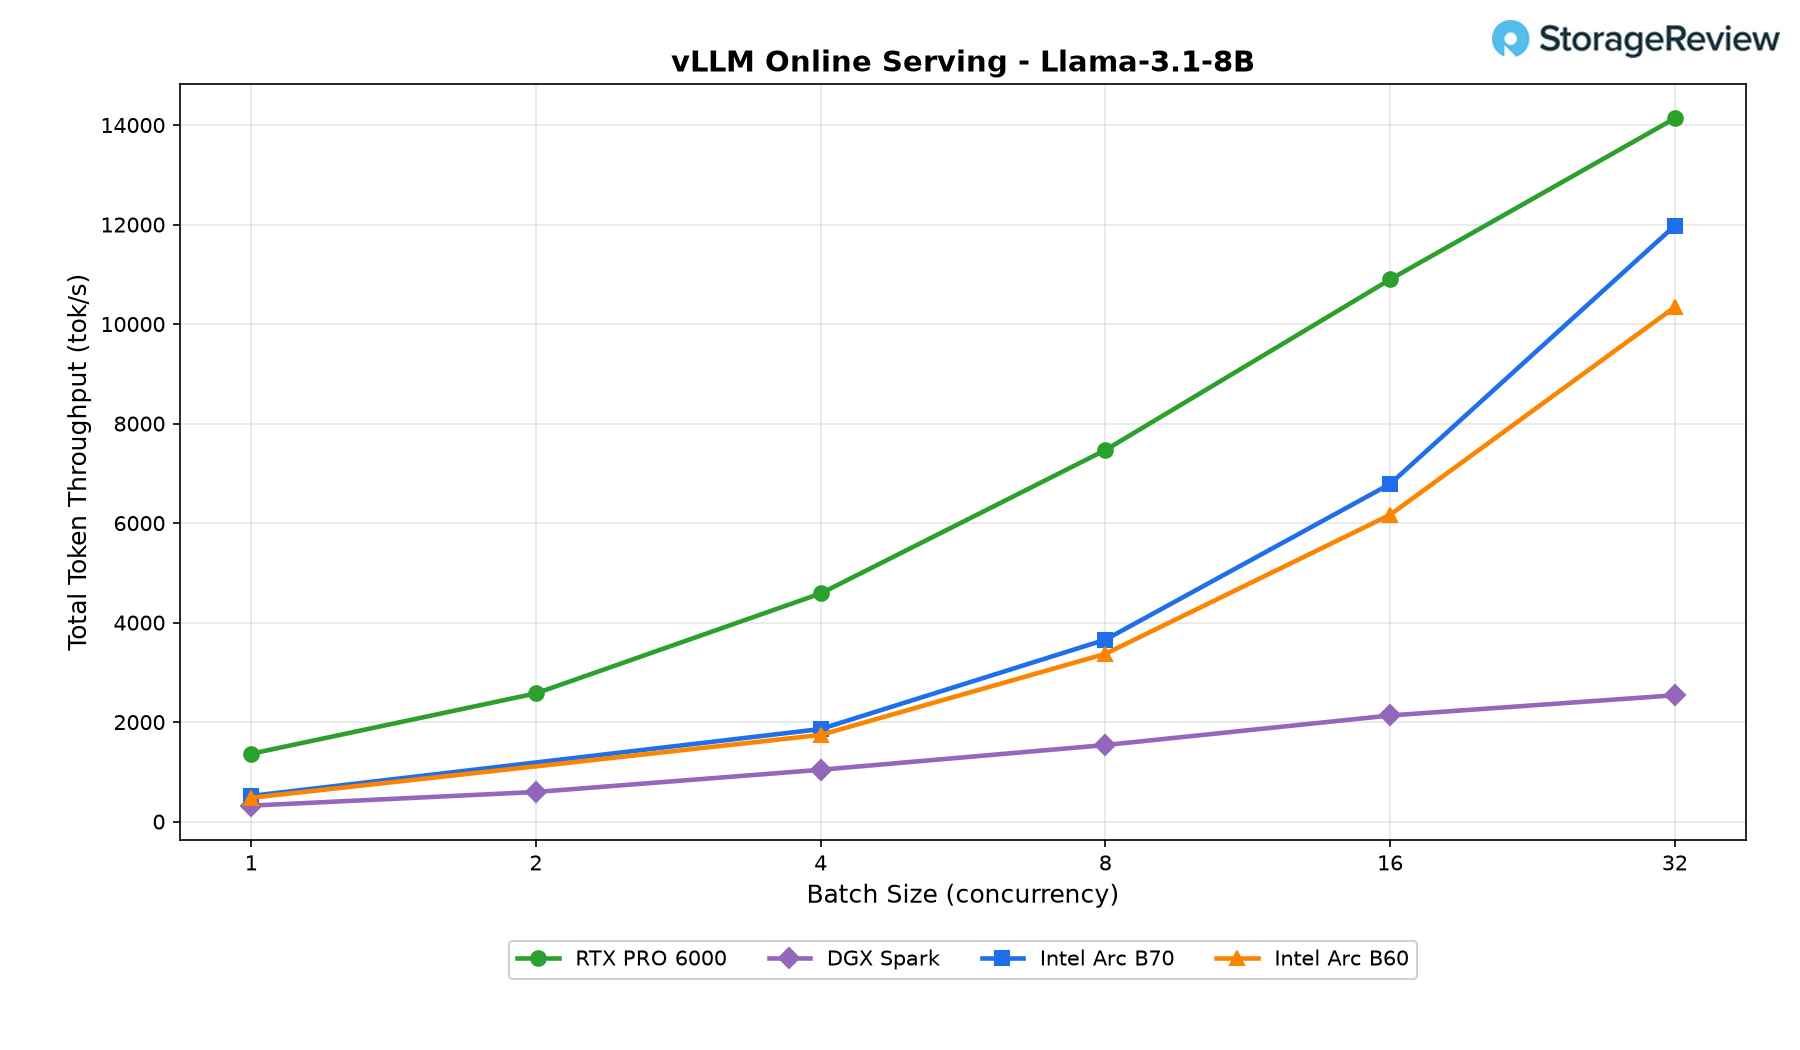
Con il modello più piccolo Llama-3.1-8B, tutte le GPU discrete hanno scalato in modo aggressivo all'aumentare della concorrenza, sebbene la RTX PRO 6000 sia rimasta chiaramente leader in termini di prestazioni. L'Intel Arc Pro B70 ha raggiunto quasi 12,000 token/s con una dimensione del batch pari a 32, posizionandosi circa il 16% avanti rispetto all'Arc Pro B60 e raggiungendo circa l'85% del throughput della RTX PRO 6000. Il divario rispetto alla DGX Spark ha continuato ad ampliarsi con l'aumentare della concorrenza, con la B70 che ha prodotto un throughput circa 4.7 volte superiore alla dimensione del batch più elevata. I risultati dimostrano inoltre che la B70 beneficia notevolmente di code di richieste più grandi, consentendole di sfruttare al meglio le risorse GPU disponibili.
GPT OSS 20B
Il benchmark GPT-OSS-20B ha nuovamente posizionato la RTX PRO 6000 in cima alla classifica, con un valore di quasi 16,900 token/s. La Intel Arc Pro B70 ha raggiunto poco più di 10,000 token/s, mantenendo un vantaggio, seppur minimo, rispetto alla Arc Pro B60 lungo tutta la curva di scalabilità, risultando circa il 7% più veloce con una dimensione del batch pari a 32. Pur essendo inferiore di circa il 40% rispetto alla GPU di punta per workstation di NVIDIA, ha comunque offerto una velocità di elaborazione quasi tre volte superiore a quella della DGX Spark. La scalabilità quasi lineare oltre la dimensione del batch pari a 8 suggerisce inoltre che la B70 rimane ben sfruttata all'aumentare delle richieste simultanee.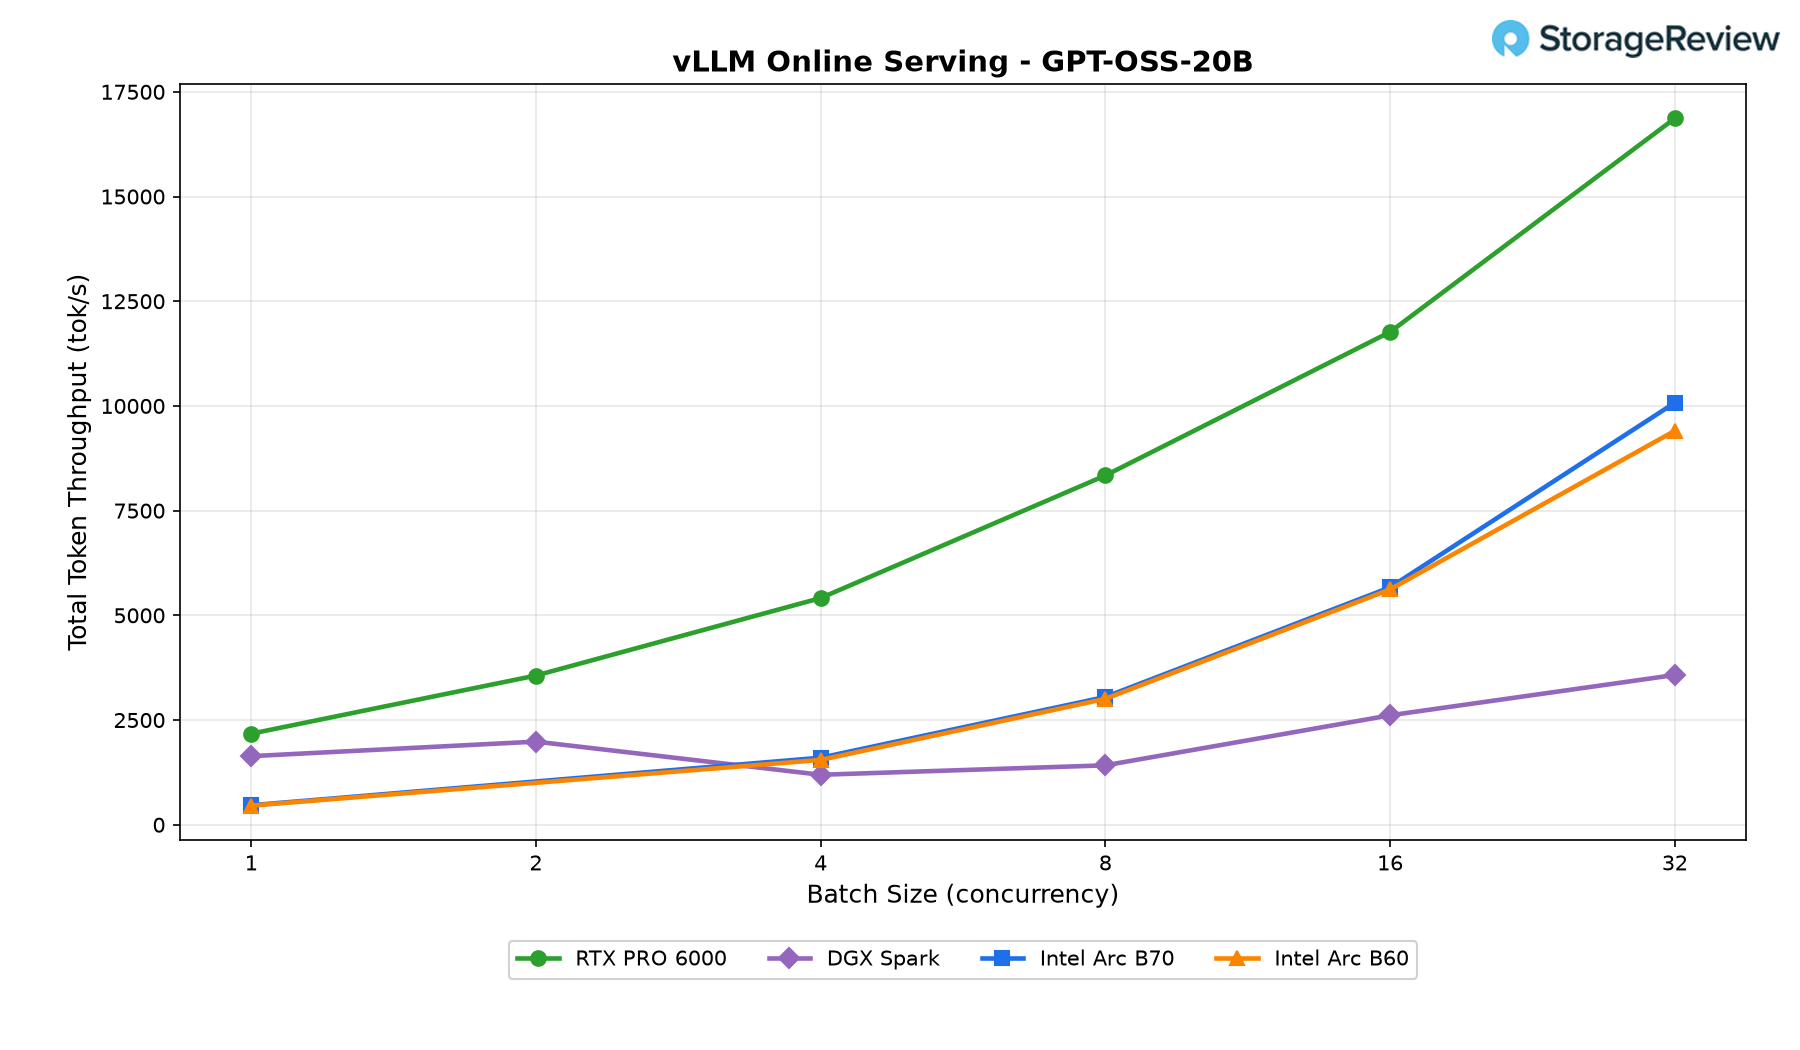
GPT OSS 120B
Il modello più grande del gruppo si è dimostrato più esigente su tutte le piattaforme, eppure l'Intel Arc Pro B70 ha continuato a scalare in modo efficiente. Ha raggiunto 6,870 token/s, circa il 7% in più rispetto all'Arc Pro B60, ottenendo circa tre quarti del throughput della RTX PRO 6000. La DGX Spark ha raggiunto 2,175 token/s allo stesso livello di concorrenza, conferendo alla B70 un vantaggio di circa 3.2 volte. Sebbene la RTX PRO 6000 abbia mantenuto il suo vantaggio complessivo, la B70 ha dimostrato di rimanere altamente competitiva nella gestione di modelli linguistici più grandi, in particolare quando un'elevata concorrenza mantiene l'hardware completamente occupato.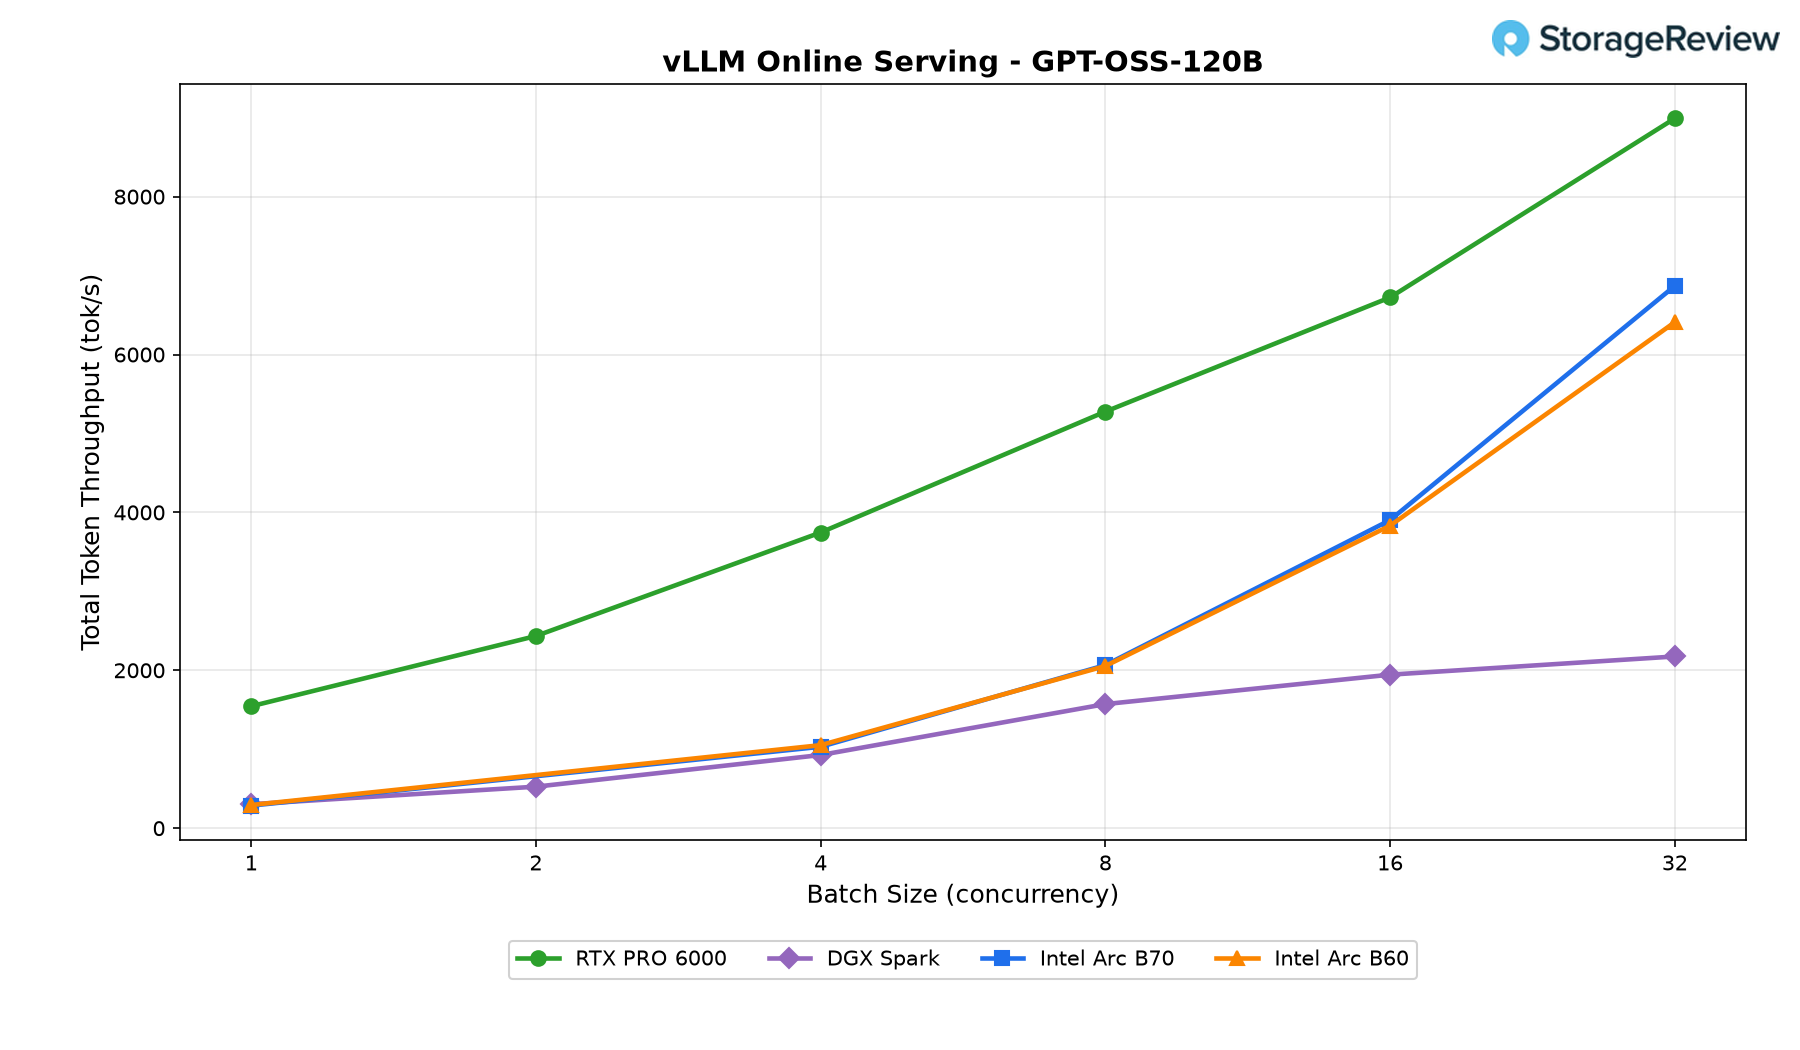
Conclusione
La Intel Arc Pro B70 è una delle GPU per workstation dedicate all'intelligenza artificiale più interessanti che Intel abbia mai rilasciato. Al suo prezzo di lancio di 949 dollari, si è ritagliata una posizione unica combinando 32 GB di memoria ECC GDDR6 con prestazioni che, in molti carichi di lavoro professionali e di intelligenza artificiale, superavano le GPU consumer di prezzo simile, risultando al contempo significativamente più economiche rispetto alle alternative NVIDIA di classe workstation. Anche con i prezzi di mercato attuali che spingono la scheda oltre i 1,100 dollari, il rapporto qualità-prezzo rimane interessante rispetto a prodotti come la RTX Pro 4000, soprattutto per gli utenti che necessitano di grandi quantità di memoria locale o di configurazioni multi-GPU, dove la capacità di memoria è il fattore limitante piuttosto che la pura potenza di calcolo.
Dal punto di vista hardware, la Intel Arc Pro B70 si è dimostrata all'altezza: ha eguagliato le prestazioni della RTX 5060 Ti nella generazione di immagini Stable Diffusion 1.5, ha ottenuto risultati di rendering rispettabili e ha gestito modelli linguistici moderni a velocità tali da renderla una valida opzione per infrastrutture AI locali, raggiungendo quasi 12,000 token/s in Llama 3.1 8B e, con quattro schede, superando del 65% la nostra singola RTX Pro 6000 di riferimento in Mistral Small 24B a piena concorrenza. Quattro B70 in una singola workstation offrono 128 GB di VRAM a un prezzo di listino di circa 3,800 dollari, ben al di sotto del costo di una singola GPU per workstation di fascia alta.
La sfida più grande per la Arc Pro B70 non è il silicio, bensì l'ecosistema software che la circonda. La qualità dei driver e il supporto dei framework continuano a essere inferiori sia all'ecosistema CUDA di NVIDIA che allo stack ROCm di AMD, sempre più maturo. Sebbene Intel abbia fatto progressi significativi con oneAPI, OpenVINO e il suo lavoro di sviluppo vLLM abilitato per Battlemage, gli utenti devono comunque aspettarsi occasionali problemi di compatibilità, un supporto limitato per i modelli e una maggiore disponibilità a fornire assistenza rispetto alle piattaforme concorrenti. Chi cerca una GPU "chiavi in mano" che "funzioni e basta" con praticamente tutti i framework e le applicazioni di intelligenza artificiale troverà ancora in NVIDIA e AMD le scelte più sicure.
In definitiva, la Arc Pro B70 è facile da consigliare agli acquirenti che apprezzano la capacità VRAM, le funzionalità da workstation e le prestazioni AI in rapporto al prezzo, a patto che comprendano cosa stanno acquistando. Si tratta di un hardware eccezionale supportato da un prezzo competitivo, ma il suo successo a lungo termine dipende quasi interamente dall'impegno di Intel nel continuare a sviluppare software e ad ampliare il supporto dell'ecosistema. Se Intel riuscirà a mantenere questo investimento, la B70 avrà le basi hardware per diventare una delle soluzioni con il miglior rapporto qualità-prezzo nell'accelerazione AI per utenti consumer e professionali. In caso contrario, rischia di rimanere una scheda con un enorme potenziale che non raggiunge mai la semplicità d'uso delle sue concorrenti NVIDIA e AMD.


 Amazon