

AMD silicon က ဒီကို ပထမဆုံးရောက်လာတယ်လို့ ငြင်းခုံနိုင်ပါတယ်။ NVIDIA မဝင်ခင်ကတည်းက Strix Halo mini PC တွေနဲ့ laptop တွေကို 128GB unified memory နဲ့ တင်ပို့ရောင်းချခဲ့တာပါ။ ဒါပေမယ့် local-AI desktop အမျိုးအစားကတော့ NVIDIA က Grace Blackwell superchip ကို တစ်လီတာဘူးထဲမှာထည့်ပြီး DGX Spark လို့ အမည်ပေးတဲ့အခါ ထိရောက်စွာ ဖန်တီးထားတဲ့ အမျိုးအစား ပါ။ အဓိကအချက်က ရိုးရှင်းပါတယ်။ cloud မှာ metered မလုပ်ဘဲ စားပွဲပေါ်မှာတင်ပြီး စွမ်းဆောင်ရည်မြင့် မော်ဒယ်တွေကို သိမ်းဆည်းထားနိုင်တဲ့ unified memory လုံလောက်တဲ့ developer-class စက်တစ်လုံးပါ။ AMD Ryzen AI Halo ဟာ AMD ရဲ့ အဖြေပါ။ AMD က ၂၀၂၆ ခုနှစ် မေလမှာ Ryzen AI Max PRO 400 Series နဲ့အတူ ကြေငြာခဲ့ပါတယ်။ ဇွန်လမှာ Micro Center ကနေတစ်ဆင့် ကြိုတင်မှာယူမှုတွေကို သီးသန့်ဖွင့်လှစ်ခဲ့ပြီး ဇူလိုင်လ ၁၀ ရက်နေ့မှာ ဆိုင်မှာ ဝယ်ယူနိုင်ပါတယ်။ Ryzen AI Halo ကလည်း အလားတူ footprint၊ 128GB unified memory၊ ဒေါ်လာ ၃,၉၉၉ ဈေးနှုန်းနဲ့ Spark နဲ့ သိသိသာသာ ကွဲပြားတဲ့ အဆိုပြုချက်တစ်ခု ဖြစ်စေတဲ့ ဆုံးဖြတ်ချက်စာရင်းတိုတိုနဲ့ ရောက်ရှိလာပါတယ်။
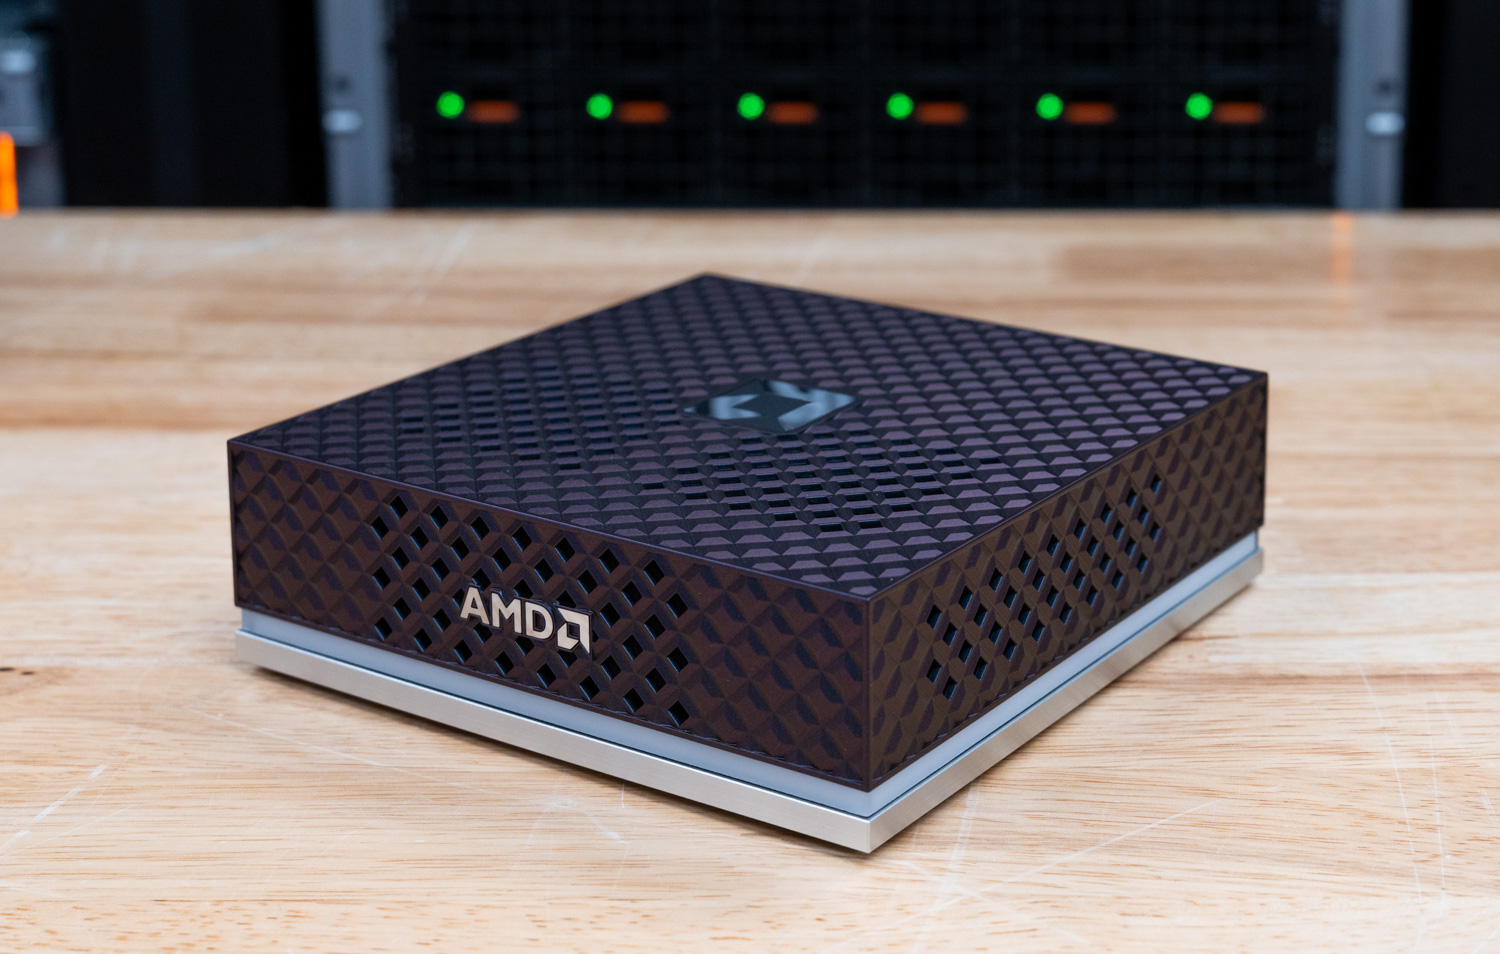
AMD က Halo ကို သူ့ရဲ့ ပထမဆုံး AI developer platform အဖြစ် သတ်မှတ်ပြီး developer တွေအနေနဲ့ AI ကို ဒေသတွင်းမှာ တည်ဆောက်ပြီး လည်ပတ်နိုင်ဖို့ မြန်ဆန်ပြီး ပွတ်တိုက်မှုနည်းတဲ့ လမ်းကြောင်းကို ပေးစွမ်းပါတယ်။ အတွင်းပိုင်းမှာ Radeon 8060S integrated graphics (RDNA 3.5 compute units ၄၀) ပါဝင်တဲ့ 16-core, 32-thread “Zen 5” အစိတ်အပိုင်းနဲ့ XDNA 2 NPU ပါဝင်တဲ့ Ryzen AI Max+ 395 ပါဝင်ပြီး အားလုံးက platform တစ်ခုအတွင်းမှာပဲ ဖြစ်ပြီး AMD ဟာ AI throughput ပေါင်းစပ်မှု 126 TOPS အထိ ဈေးကွက်တင်ထားပါတယ်။ 128GB LPDDR5x ဟာ 8000 MT/s မှာ လည်ပတ်ပြီး bandwidth 256 GB/s ပေးစွမ်းနိုင်ပြီး platform တစ်ခုလုံးဟာ 120W မှာ ရှိတဲ့ USB-C input တစ်ခုတည်းကနေ ပါဝါကို ရယူပါတယ်။ AMD က memory pool ဟာ device memory မှာ parameter ၂၀၀ ဘီလီယံအထိ ရှိတဲ့ မော်ဒယ်တွေကို သိမ်းဆည်းထားဖို့ လုံလောက်တယ်လို့ ပြောပါတယ်။ ဒါဟာ x86 mini-workstation တစ်ခုလုံးဖြစ်ပြီး အရေးအကြီးဆုံး ကွာခြားချက်ရဲ့ အရင်းအမြစ်ပါပဲ။
အဲဒီကွာခြားချက်ကတော့ Windows ပါပဲ။ Spark မှာ NVIDIA ရဲ့ Linux-based DGX OS ပဲ ပါဝင်ပြီး တခြားဘာမှ မပါဝင်ပါဘူး။ Halo ကတော့ Windows 11 ဒါမှမဟုတ် AMD ရဲ့ Linux developer image ကို hardware တစ်ခုတည်းမှာ boot လုပ်ပါတယ်။ Native Windows support က Spark ကို စိတ်ဝင်စားနေတဲ့သူတွေဆီက အများဆုံးကြားရတဲ့ တောင်းဆိုမှုတစ်ခုဖြစ်ပြီး ဒီ box က ဘယ်သူ့အတွက်လဲဆိုတာကို ပြန်လည်ပုံဖော်ပေးပါတယ်။ AMD ရဲ့ ကိုယ်ပိုင်ရပ်တည်ချက်ကလည်း အဲဒီအချက်ကို ထောက်ပြထားပါတယ်။ Windows နဲ့ Linux နဲ့ Spark ရဲ့ Linux သီးသန့် ( ဘယ်လိုပဲဖြစ်ဖြစ် ဒီနေ့အထိပေါ့ )။
Halo နဲ့ Spark ကို နောက်ထပ် ဆုံးဖြတ်ချက်သုံးခုနဲ့ ခွဲခြားထားပြီး၊ တစ်ခုချင်းစီမှာ လက်ရှိကုမ္ပဏီအကြောင်း ကျွန်တော်တို့ ကြားသိခဲ့ရတဲ့ တိုင်ကြားချက်တွေကို ဖြေရှင်းပေးထားပါတယ်။ Halo မှာ Spark မှာ အသုံးနည်းတဲ့ 2242 drive အစား standard M.2 2280 SSD ကို အသုံးပြုထားပြီး drive ကို အစားထိုးလိုသူတိုင်းအတွက် 8TB capacities အပါအဝင် aftermarket option အများအပြားကို ဖွင့်ပေးပါတယ်။ ၎င်းမှာ operating system နှစ်ခုလုံးမှာ အမြင့်ဆုံးခွဲဝေမှုအထိ Variable Graphics Memory preset ပါရှိတာကြောင့် မော်ဒယ်ကြီးတွေဟာ manual tuning မလိုအပ်ဘဲ load လုပ်နိုင်ပါတယ်။ ဒါ့အပြင် chassis ကို lit status ring နဲ့ ထုပ်ပိုးထားပြီး၊ OEM ပေါ်မူတည်ပြီး ဝယ်သူတချို့ ရရှိတဲ့ မှောင်မိုက်ပြီး အလင်းရောင်မရှိတဲ့ Spark unit တွေအတွက် အနည်းငယ်ပြင်ဆင်မှုတစ်ခုပါ။ AMD ရဲ့ ချဉ်းကပ်မှုရဲ့ ကုန်ကျစရိတ်ကို box ရဲ့နောက်ကျောမှာ ပြသထားပြီး၊ အဲဒီမှာ high-speed fabric မရှိဘဲ 10GbE သာရှိပြီး multi-node clustering နဲ့ ဘာတွေလုပ်နိုင်လဲဆိုတာကို ကန့်သတ်ထားပါတယ်။ ဒါတွေက အပေးအယူတွေဖြစ်ပြီး benchmark run ခြင်းမပြုမီ ဒီစက်ကို တည်ဆောက်ထားတဲ့ workload တွေကို သတ်မှတ်ပေးပါတယ်။
ဈေးနှုန်းအရဆိုရင် သိမ်မွေ့တဲ့ အချက်တွေ အရေးကြီးပါတယ်။ Halo ရဲ့ 2TB SSD ပါဝင်တဲ့ ဈေးနှုန်းက $3,999 ဖြစ်ပြီး Spark-class စနစ်အတွက် လက်ရှိဈေးနှုန်းနဲ့ ကိုက်ညီပါတယ်။ နှိုင်းယှဉ်ချက်က ဘယ် Spark ကို ဆိုလိုတာလဲဆိုတဲ့အပေါ် မူတည်ပါတယ်။ NVIDIA ရဲ့ DGX Spark drive ပိုကြီးတဲ့ စနစ်က အခုဆိုရင် $4,700 နီးပါးနဲ့ လည်ပတ်နေပြီး LPDDR5X နဲ့ NAND ထောက်ပံ့မှု အကျပ်အတည်းနဲ့ ဆက်စပ်နေပါတယ်။ ASUS နဲ့ တခြားကုမ္ပဏီတွေရဲ့ Base Grace Blackwell စနစ်တွေကို $4,000 ဝန်းကျင်နဲ့ ရောင်းချနေဆဲဖြစ်ပြီး Amazon မှာ ဒီနေ့ပဲ စာရင်းဝင်နေပါပြီ (affiliate link)။ အမျိုးအစားအလိုက် တိုင်းတာမယ်ဆိုရင် Halo က တန်းတူဖြစ်ပြီး ဈေးကွက်ကို လျှော့ချမယ့်အစား အထက်က ဆုံးဖြတ်ချက်တွေပေါ်မှာ မူတည်ပါတယ်။
ကျွန်ုပ်တို့သည် Halo ကို Windows နှင့် Linux နှစ်ခုလုံးတွင် StorageReview ၏ local AI suite မှတစ်ဆင့် လုပ်ဆောင်ခဲ့ပြီး ရလဒ်များကို ဤသုံးသပ်ချက်တစ်လျှောက်လုံးတွင် ဒီဇိုင်းနှင့် software ခွဲခြမ်းစိတ်ဖြာမှုနှင့်အတူ တင်ပြထားပါသည်။
Key ကို Takeaways
- dual-OS x86 အစားထိုးရွေးချယ်စရာ- Ryzen AI Halo ဟာ Spark အမျိုးအစားမှာ Windows 11 ဒါမှမဟုတ် Linux ကို x86 platform အပြည့်နဲ့ boot လုပ်နိုင်တဲ့ တစ်ခုတည်းသော box ဖြစ်ပြီး 2TB SSD ပါဝင်တဲ့ $3,999 နဲ့ DGX Spark Founders Edition ရဲ့ $4,699 နဲ့ ယှဉ်ရင် သက်သာပါတယ်။
- မော်ဒယ်ကြီးများကို သိမ်းဆည်းရန် မှတ်ဉာဏ်- 128GB LPDDR5x-8000 ပေါင်းစည်းမှတ်ဉာဏ် 256GB/s သည် မော်ဒယ်များကို ဒေသတွင်းတွင် ကန့်သတ်ချက်ပေါင်း 200 ဘီလီယံအထိ ပံ့ပိုးပေးပြီး Variable Graphics Memory ကို ကြိုတင်ချိန်ညှိထားသောကြောင့် မော်ဒယ်ကြီးများသည် ကိုယ်တိုင်ပြင်ဆင်သတ်မှတ်စရာမလိုဘဲ load လုပ်နိုင်ပါသည်။
- ကျွန်ုပ်တို့စမ်းသပ်ဖူးသမျှထဲမှာ အားအကောင်းဆုံး Ryzen AI Max+ 395: Halo သည် Cinebench R23 multi-core တွင် 37,316 မှတ်၊ 7-Zip တွင် 184.2 GIPS မှတ်နှင့် Procyon AI text generation (Phi 1,192) နှင့် image generation (SD 1.5 FP16 937) မှတ်များအပါအဝင် Windows workload အားလုံးနီးပါးတွင် HP Z2 Mini G1a နှင့် ZBook Ultra G1a ထက် သာလွန်ခဲ့သည်။
- Spark နှင့် နှိုင်းယှဉ်လျှင် CPU အနိုင်ရမှု၊ ကောက်ချက်ဆုံးရှုံးမှုများ- Linux မှာ Halo ဟာ CPU လုပ်ဆောင်ချက်မှာ DGX Spark ထက် ပြတ်ပြတ်သားသား သာလွန်ခဲ့ပြီး 7-Zip မှာ compression ၁၁% ပိုမြန်ပြီး decompress ၃၈% ပိုမြန်ကာ LLVM compile ကို ၁၄% ပိုမြန်အောင် ပြီးမြောက်ခဲ့ပေမယ့် vLLM serving scenarios အများစုမှာ concurrency မြင့်တဲ့အခါ ၂ ဆ ကနေ ၄ ဆ အထိ နောက်ကျကျန်ခဲ့ပြီး prefill-heavy GPT OSS 120B လုပ်ဆောင်ချက်မှာ ၈.၈ ဆ အထိ မြင့်တက်ခဲ့ပါတယ်။
- ဝန်ဆောင်မှုပေးနိုင်သော သိုလှောင်မှု၊ အသင့်အတင့် ကွန်ရက်ချိတ်ဆက်မှု- စံ M.2 2280 bay သည် aftermarket အဆင့်မြှင့်တင်မှုများကို 8TB အထိ ဖွင့်ပေးသော်လည်း၊ platform သည် ပါ၀င်သော Gen5 Micron 4600 ကို ဒီဇိုင်းအားဖြင့် Gen4 အထိ လျှော့ချပေးထားပြီး မြန်နှုန်းမြင့် fabric မပါဝင်သော 10GbE port တစ်ခုတည်းသည် Spark ၏ 200G ConnectX-7 မှ ဖွင့်ပေးသည့် multi-node clustering ကို ဖယ်ထုတ်ထားသည်။
အသေးစိတ်ဖော်ပြချက်
| specification | AMD Ryzen AI Halo စနစ် |
|---|---|
| processor ကို | |
| စီပီယူ | AMD Ryzen™ AI Max+ 395 ပရိုဆက်ဆာ 16 Cores / 32 Threads (Zen 5 ဗိသုကာ) |
| GPU ကို | AMD Radeon™ 8060S ပေါင်းစပ်ဂရပ်ဖစ် တွက်ချက်ယူနစ် ၄၀ (RDNA™ 3.5 ဗိသုကာ) |
| NPU | AMD XDNA™ 2 NPU |
| မှတ်ဉာဏ် | |
| memory အမျိုးအစား | LPDDR5x |
| မှတ်ဉာဏ်စွမ်းဆောင်ရည် | 128GB |
| Memory Speed | 8000MT/s |
| မှတ်ဉာဏ် Bandwidth | 256GB / s နဲ့ |
| သိုလှောင်ခြင်း | |
| သိုလှောင်ခြင်း | 2TB M.2 NVMe SSD (SED) |
| ကွန်ရက်ချိတ်ဆက်မှုနှင့် ချိတ်ဆက်မှု | |
| Ethernet | ၁ × ၁၀GbE |
| ဝိုင်ဖိုင် | Wi-Fi ကို 7 |
| ဘလူးတုသ် | ဘလူးတုသ် ၅.၀ |
| I / O | |
| ယူအက်စ်ဘီ | ၃ × USB-C၊ ၁ × USB-C (ပါဝါအဝင်) |
| display Output | 1× HDMI 2.1b |
| စံနစ် | |
| TDP | 120W |
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | Linux သို့မဟုတ် Windows 11 |
| ရှုထောင့် | 150 × 150 × 45.4 မီလီမီတာ (5.9 × 5.9 × 1.79 in) |
| အလေးချိန် | ၁.၂ ကီလိုဂရမ် (၂.၆၅ ပေါင်) အောက် |
AMD Ryzen AI Halo တည်ဆောက်မှုနှင့် ဒီဇိုင်း
AMD Ryzen AI Halo စနစ်သည် ကျစ်လစ်သိပ်သည်းသော “NVIDIA Spark” ပုံစံကို အသုံးပြုထားပြီး 150 × 150 × 45.4mm သာရှိပြီး အလေးချိန် 1.2kg (2.65lbs) အောက်သာရှိသည်။ အလူမီနီယမ်ကိုယ်ထည်တွင် အပေါ်နှင့်ရှေ့တစ်လျှောက်တွင် ဂျီသြမေတြီလေဝင်လေထွက်ပုံစံပါရှိသောကြောင့် အအေးပေးစနစ်ထဲသို့ လေစီးဆင်းမှုကို အများဆုံးဖြစ်စေပြီး စနစ်ကို ထူးခြားသောအသွင်အပြင်ကို ပေးစွမ်းသည်။ ၎င်း၏ အရွယ်အစားသေးငယ်သော်လည်း၊ ပလက်ဖောင်းကို workstation application များ၊ local LLM inference နှင့် AI development workloads များကို ကိုင်တွယ်နိုင်သော full desktop AI workstation အဖြစ် ဒီဇိုင်းထုတ်ထားသည်။
ရှေ့
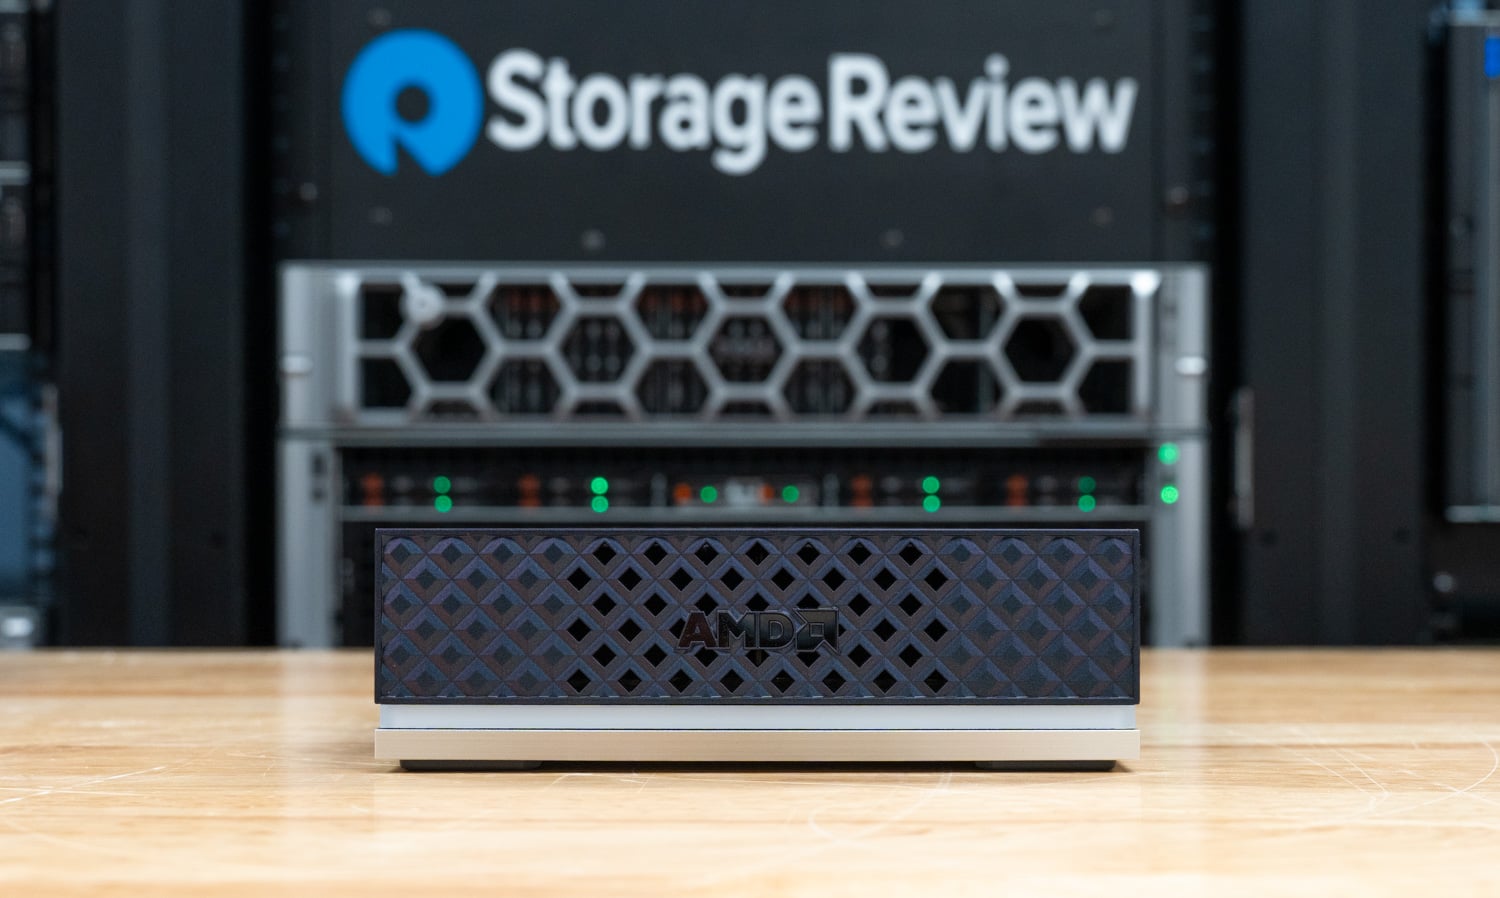
စနစ်ရဲ့ ရှေ့ပိုင်းဟာ ရည်ရွယ်ချက်ရှိရှိ သန့်ရှင်းပြီး ကိုယ်ထည်အကျယ်ကို ဖုံးလွှမ်းထားတဲ့ ကြီးမားတဲ့ mesh ventilation grille နီးပါး ပါဝင်ပါတယ်။ ရှေ့ပိုင်းမှာ port တွေ ထားမယ့်အစား AMD ဟာ ဒီနေရာကို လေစီးဆင်းမှုအတွက် ရည်ရွယ်ထားပြီး အေးမြတဲ့လေကို ကြီးမားတဲ့ ပုံစံ intake ကနေတစ်ဆင့် စနစ်ထဲကို ဝင်ရောက်စေပြီး ရှေ့ပိုင်းကို သပ်ရပ်စွာ ထားရှိပေးပါတယ်။ ကိုယ်ထည်ရဲ့ အောက်ခြေတစ်လျှောက်မှာ ငွေရောင် အသားပေးမှုက မှိန်ဖျော့တဲ့ အနက်ရောင် enclosure နဲ့ သိမ်မွေ့တဲ့ အမြင်အာရုံ ဆန့်ကျင်ဘက်ကို ပေးစွမ်းပါတယ်။
နောက်ဘက် အဝင်/အထွက်
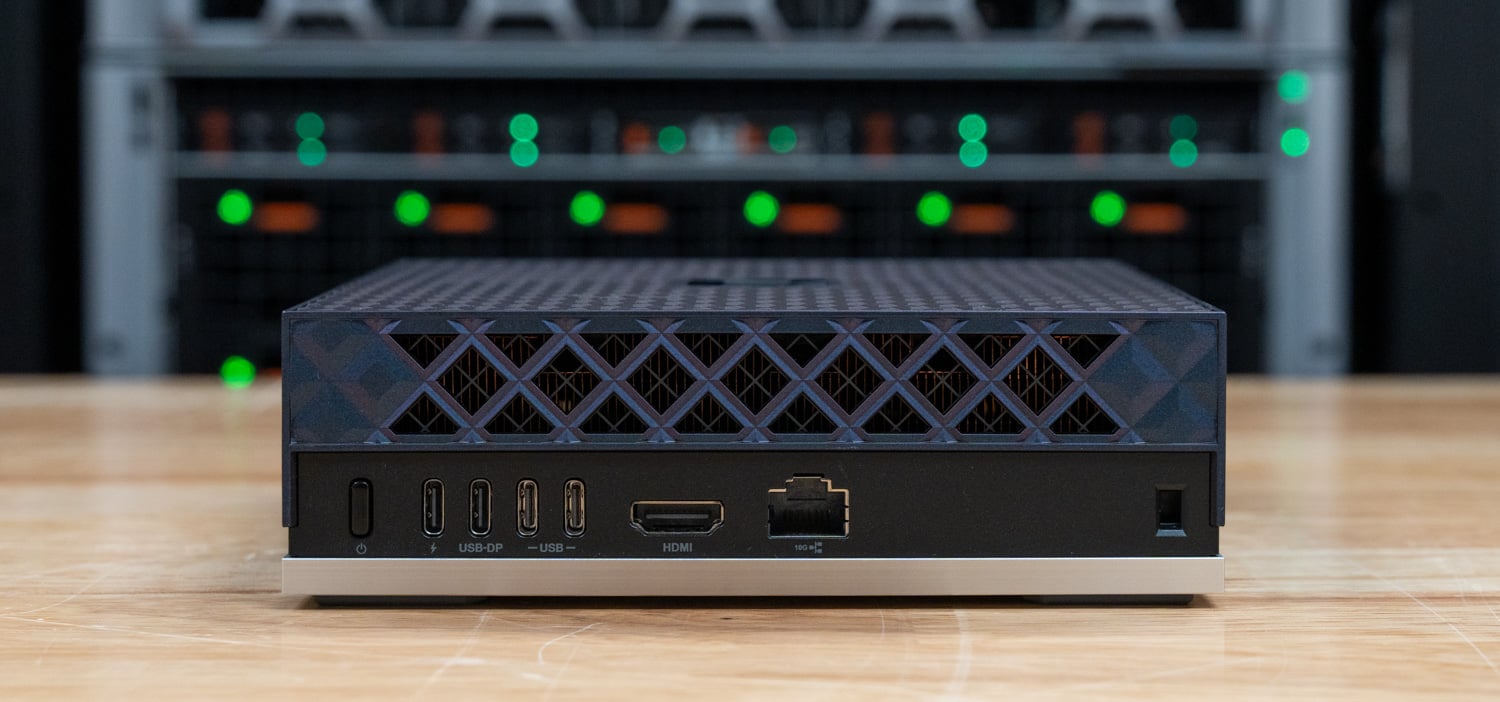
ပြင်ပချိတ်ဆက်မှုအားလုံးကို စနစ်၏နောက်ဘက်တွင် တည်ရှိသည်။ ဘယ်ဘက်မှညာဘက်သို့၊ နောက်ဘက်အကန့်တွင် အောက်ပါတို့ပါဝင်သည်-
- USB-C ပါဝါထည့်သွင်းမှု
- DisplayPort Alt Mode ပါရှိသော USB-C port
- USB-C port နှစ်ခု ထပ်တိုး
- HDMI 2.1b အထွက်
- 10GbE RJ45 အီသာနက်
- Kensington လုံခြုံရေးသော့ပေါက်
စနစ်တွင် USB-C data port သုံးခုနှင့်အတူ dedicated USB-C power connector တစ်ခု ပါရှိသောကြောင့် မြန်နှုန်းမြင့် peripheral များနှင့် display များကို တစ်ပြိုင်နက် ချိတ်ဆက်နိုင်စေပါသည်။ HDMI 2.1b သည် native display output ကို ပံ့ပိုးပေးပြီး integrated 10GbE Ethernet interface သည် မြန်နှုန်းမြင့် NAS ချိတ်ဆက်မှု၊ AI dataset transfer များနှင့် local development environments များအတွက် platform ကို သင့်လျော်စေပါသည်။
အတွင်းပိုင်းဒီဇိုင်း
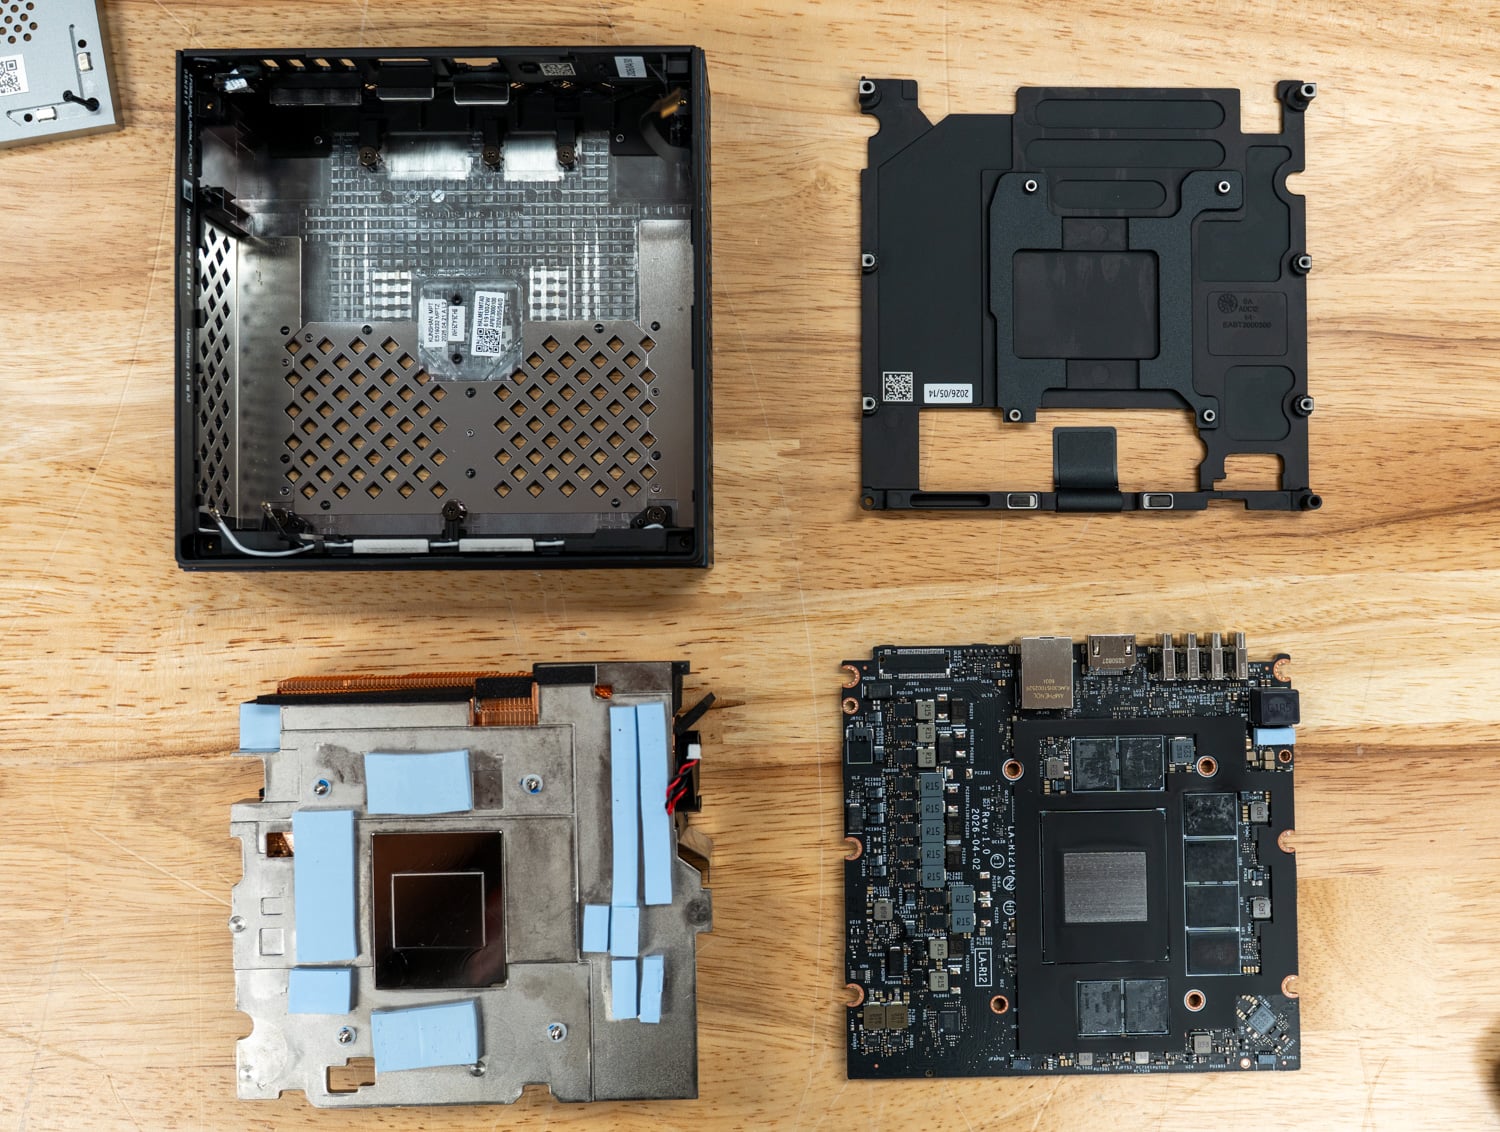
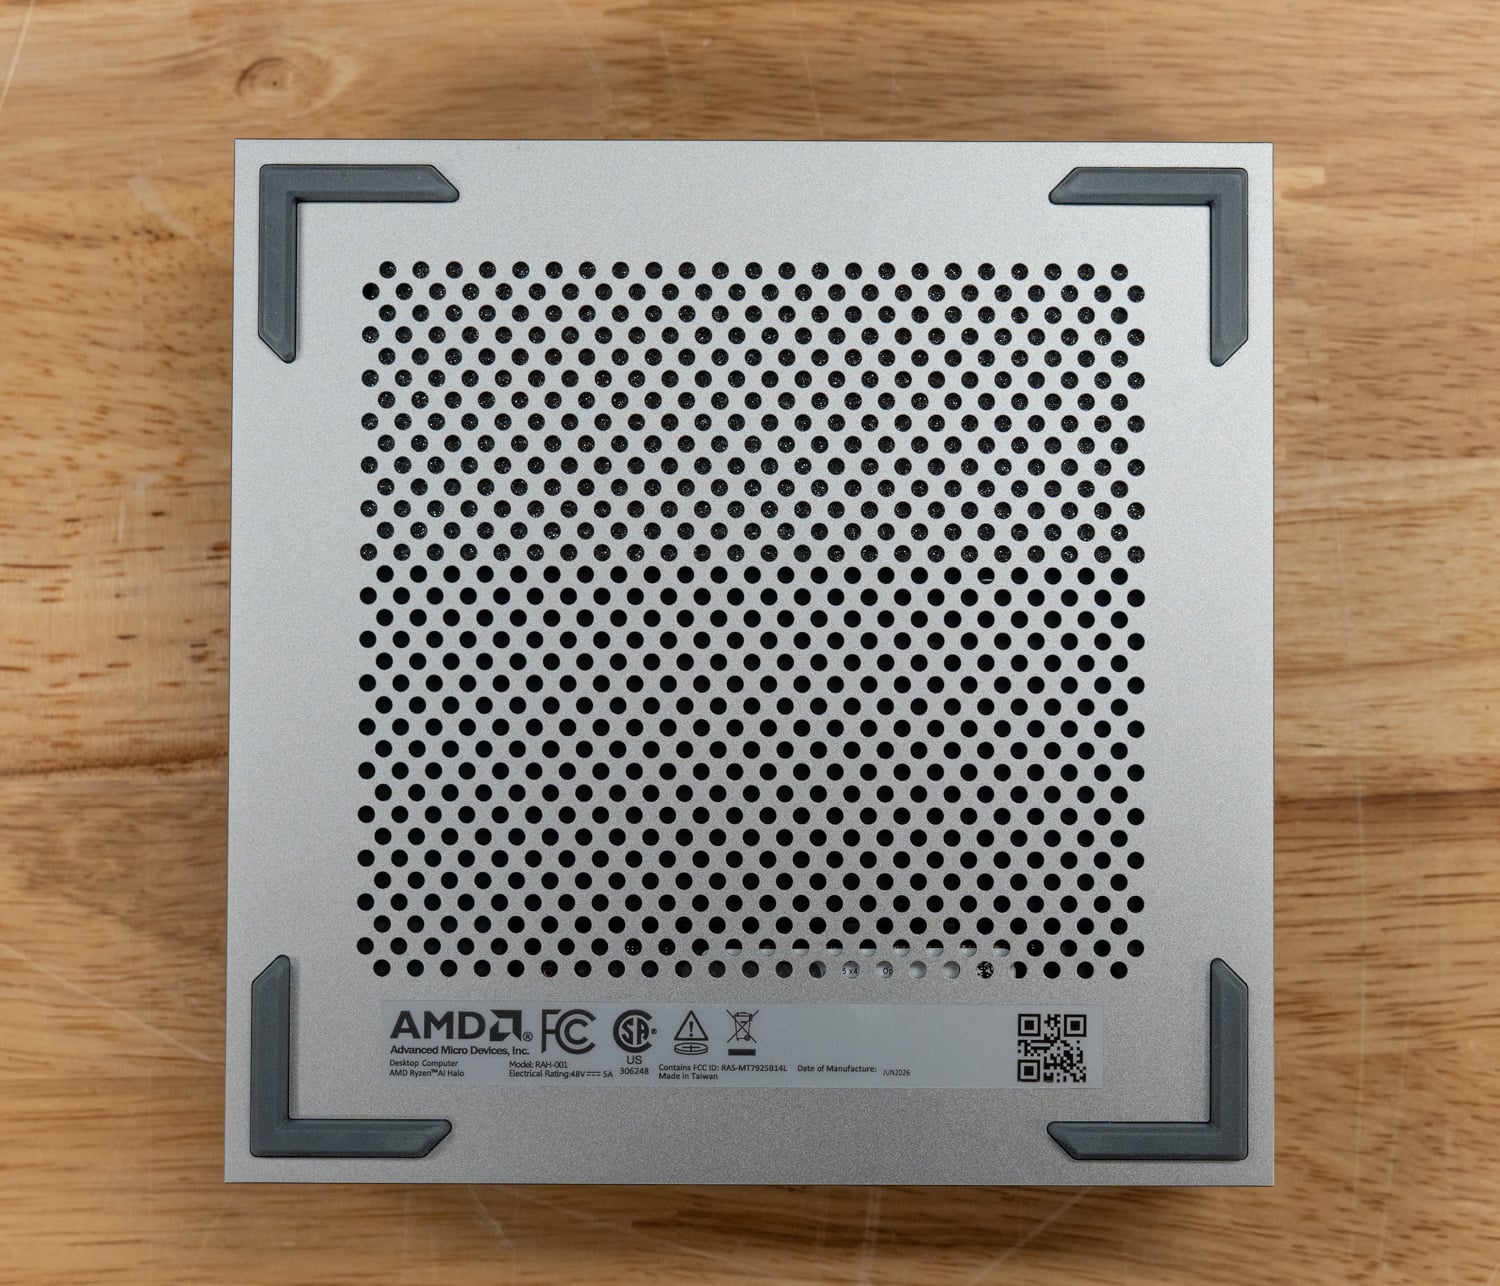
Ryzen AI Halo ရဲ့ အောက်ခြေမှာ ဘုတ်ရဲ့ အောက်ခြေတစ်လျှောက်မှာ တပ်ဆင်ထားတဲ့ အစိတ်အပိုင်းတွေကို အအေးခံဖို့ လေကို စုပ်ယူပေးတဲ့ အပေါက်ကြီးတစ်ခု ပါရှိပြီး ထောင့်တွေမှာ ရော်ဘာခြေထောက်လေးချောင်းက ယူနစ်ကို စားပွဲ ဒါမှမဟုတ် စင်ပေါ်မှာ တည်ငြိမ်နေစေပါတယ်။
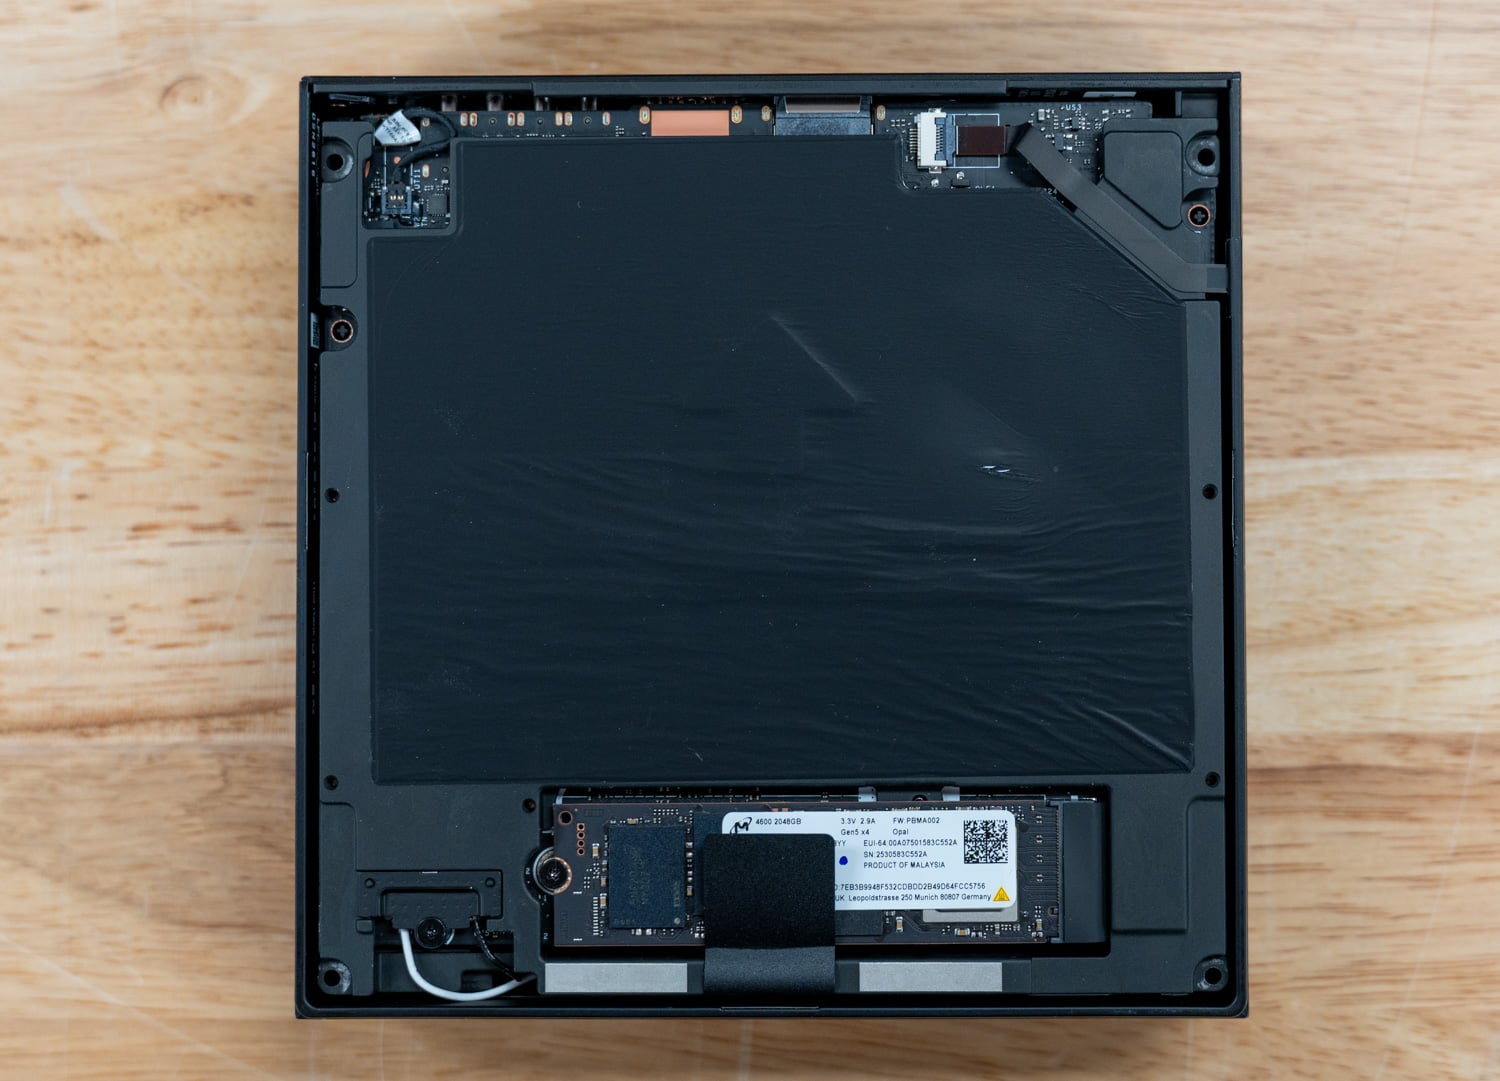
အောက်ခြေ panel ကို ချိတ်ထားတဲ့ screw လေးခုကို ဖြုတ်လိုက်ရင် M.2 SSD bay နဲ့ Wi-Fi card connector အပါအဝင် system ရဲ့ lower-board အစိတ်အပိုင်းအနည်းငယ်ကို တွေ့ရပါလိမ့်မယ်။ ကျွန်တော်တို့ရဲ့ review unit မှာ အဲဒီ slot မှာ Micron 4600 2TB Gen5 x4 SSD ပါဝင်ပြီး board ရဲ့ ကျန်တဲ့အပိုင်းကို ပေါ်နေတဲ့ အောက်ခြေကနေ အနက်ရောင် adhesive sheet က ကာကွယ်ပေးထားပါတယ်။
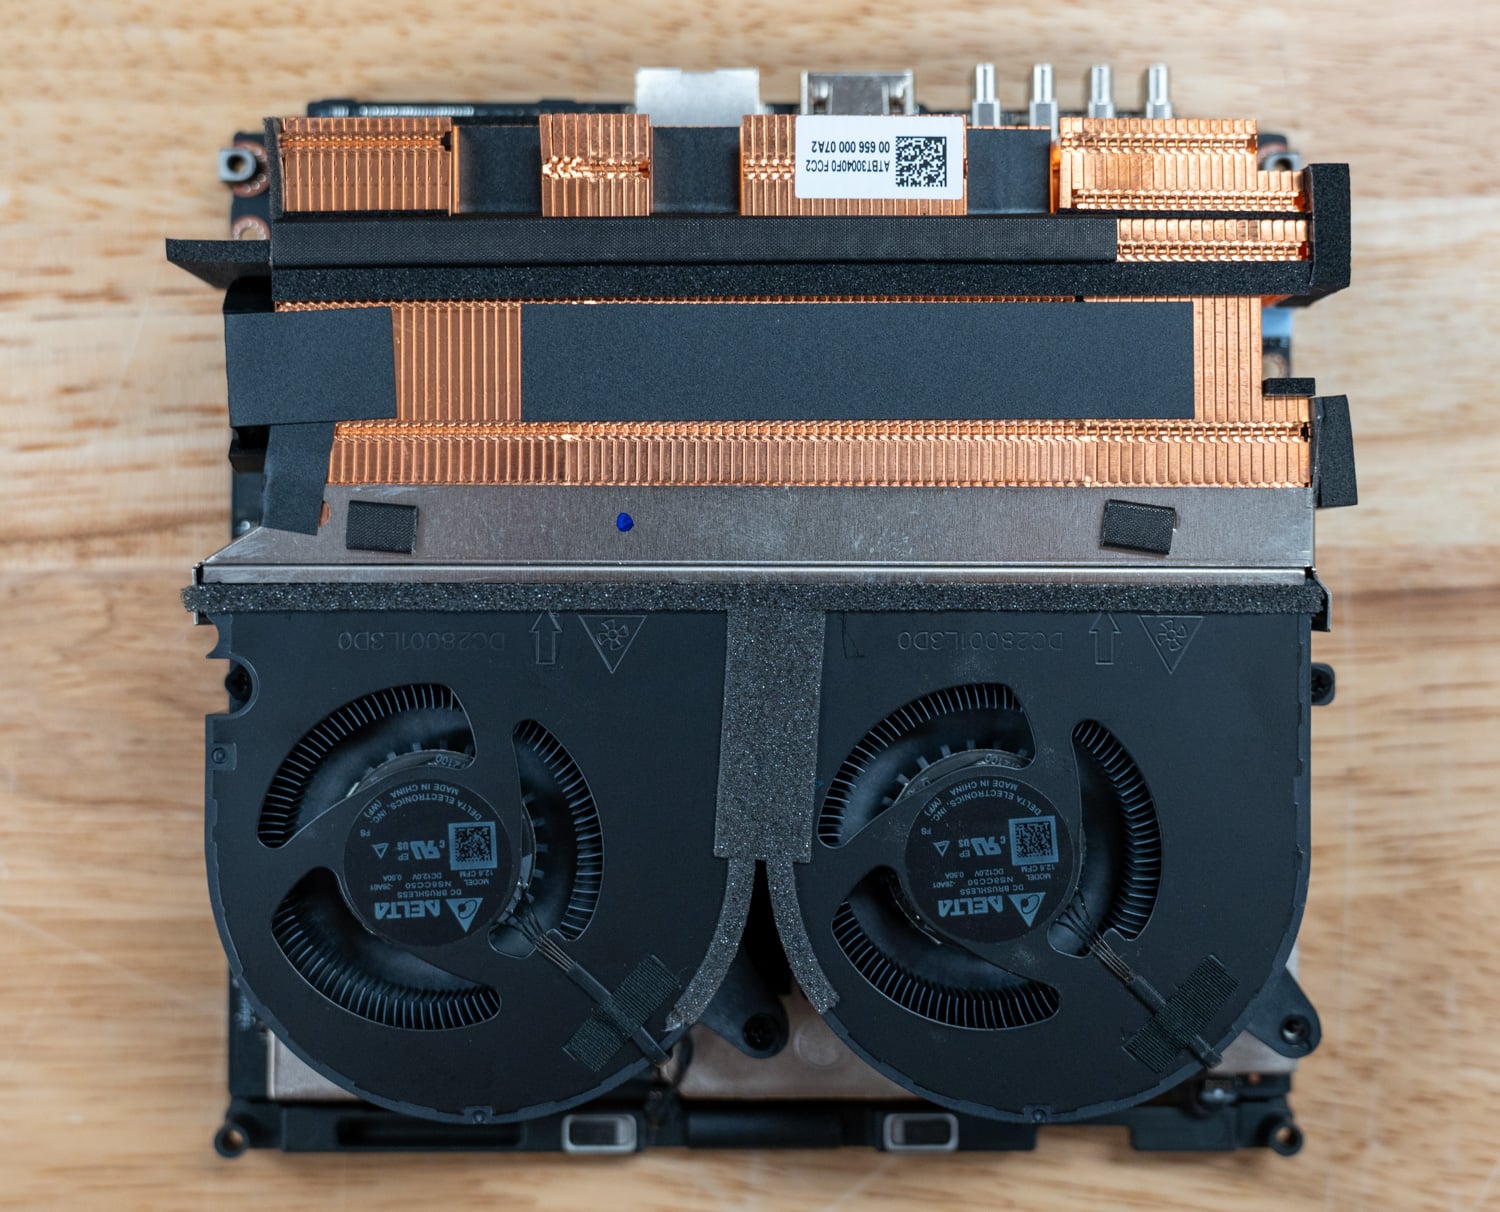
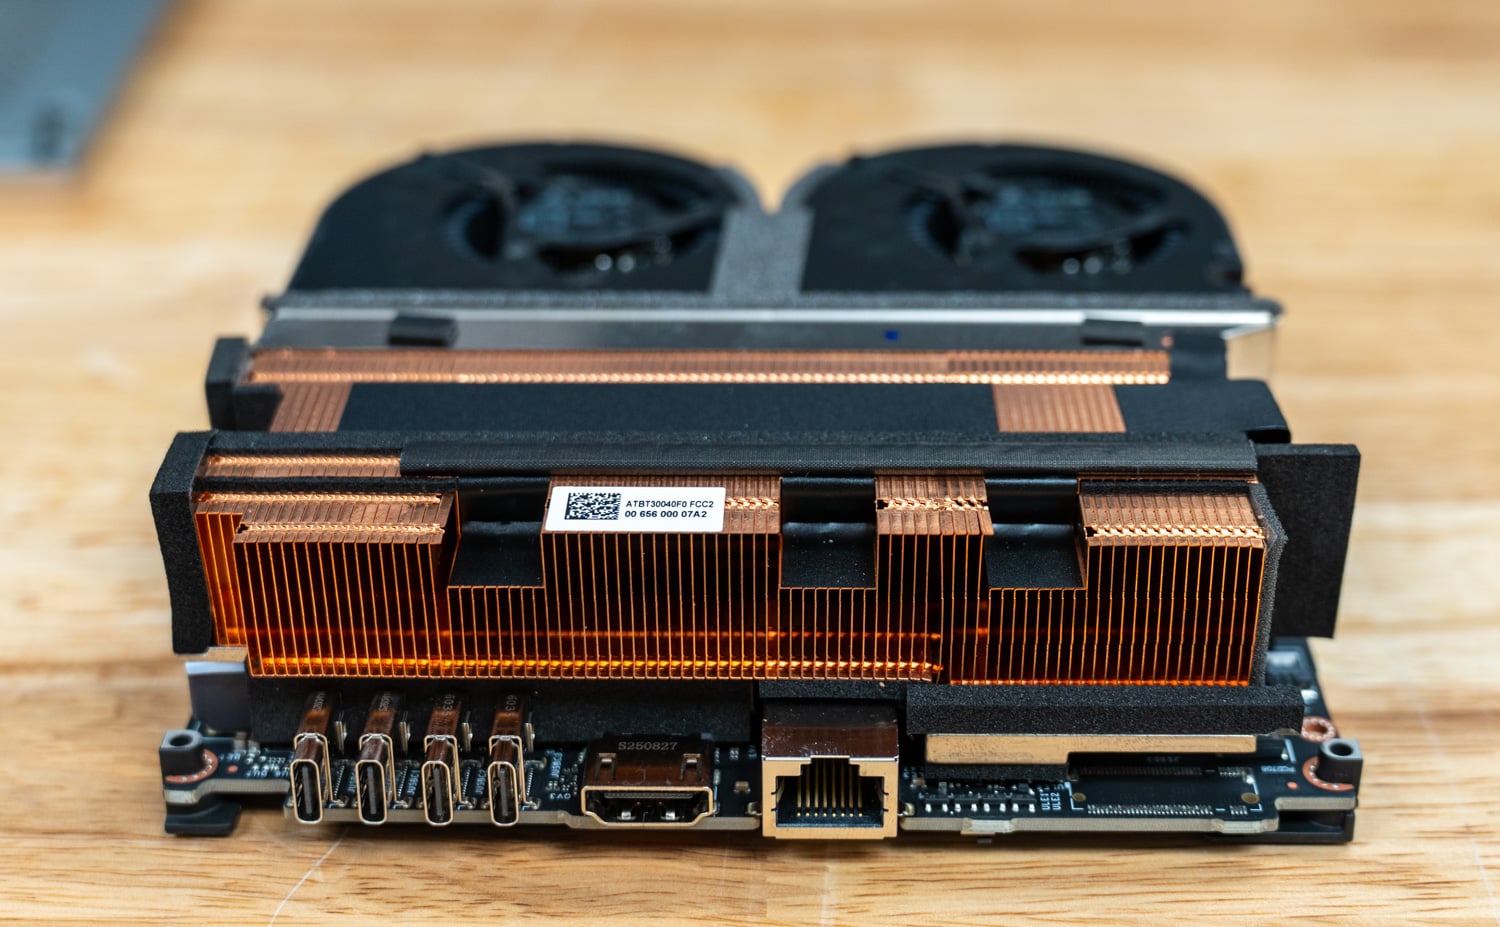
အအေးပေးရန်အတွက် AMD သည် NVIDIA ၏ DGX Spark နှင့် အလားတူချဉ်းကပ်မှုကို လုပ်ဆောင်ခဲ့ပြီး finned heatsink မှတစ်ဆင့် လေကိုဆွဲယူကာ chassis ၏နောက်ဘက်မှ စွန့်ထုတ်သည့် dual fan များကို အသုံးပြုခဲ့သည်။
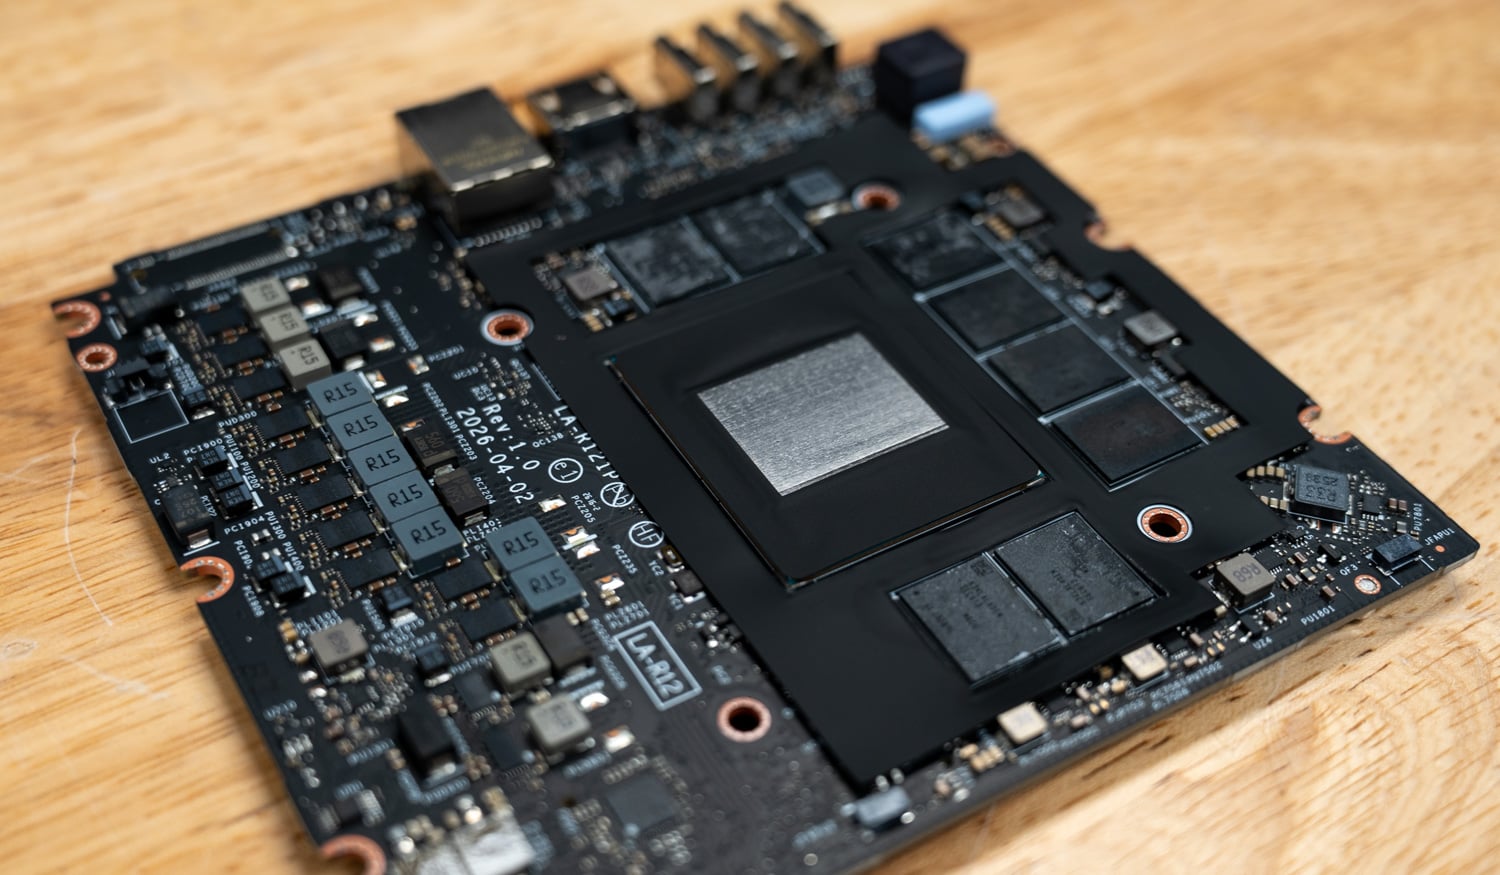
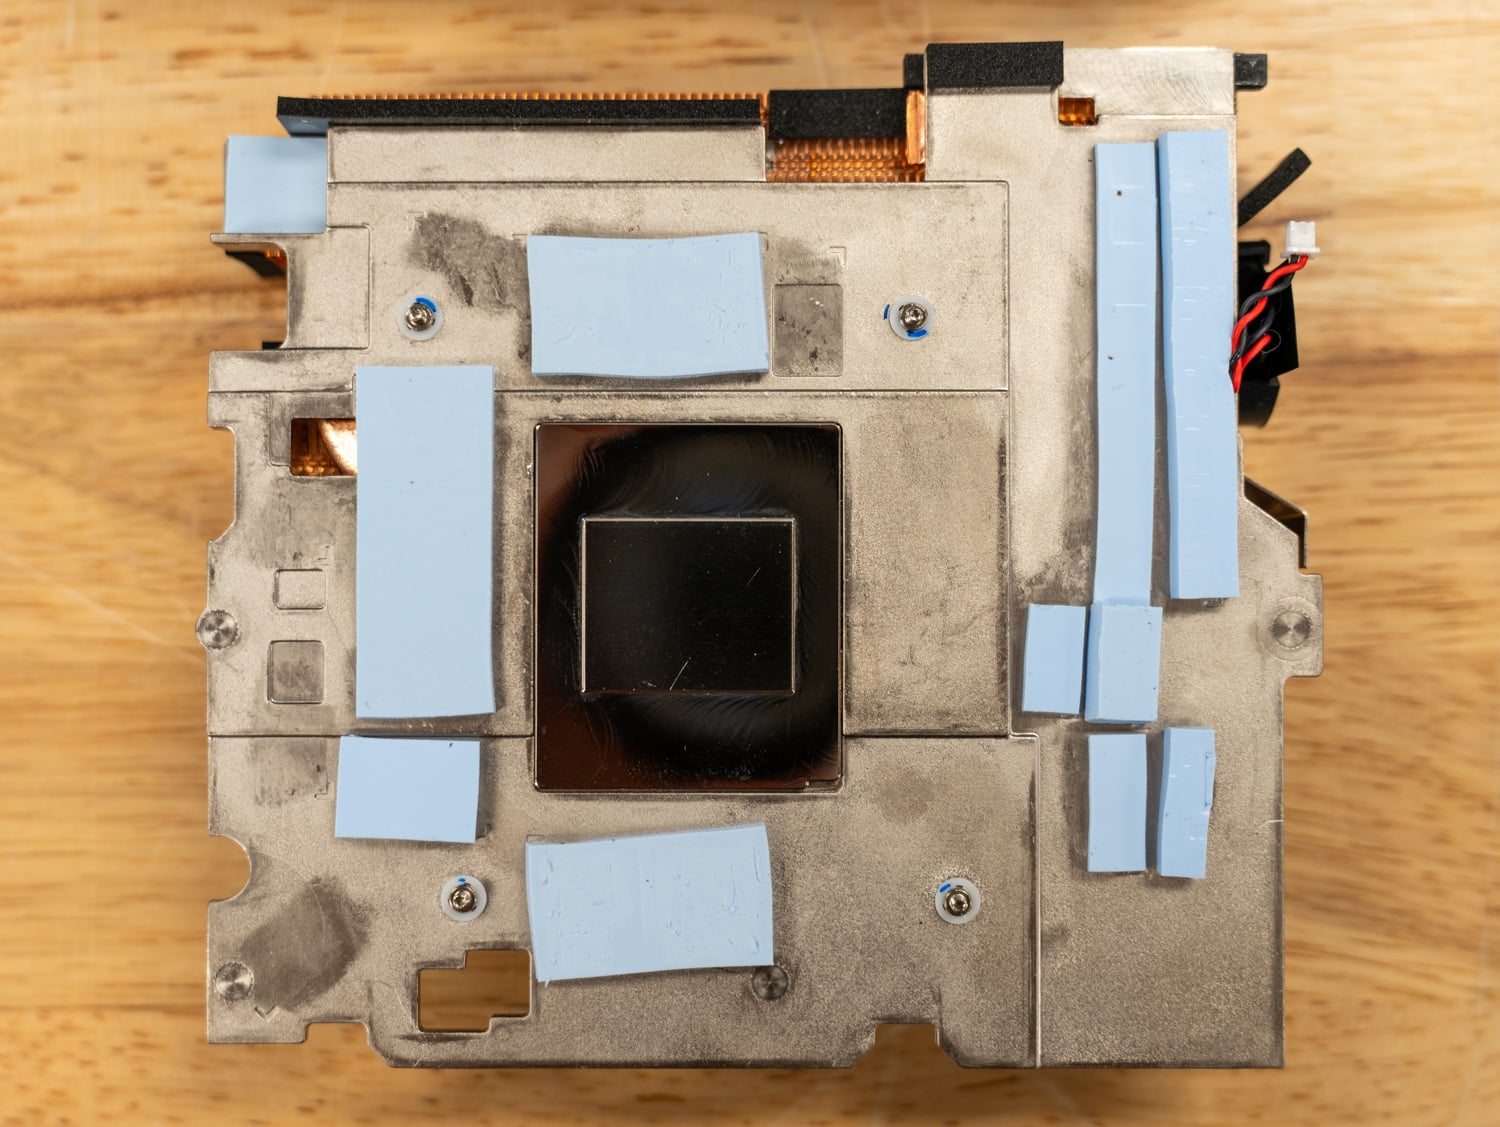
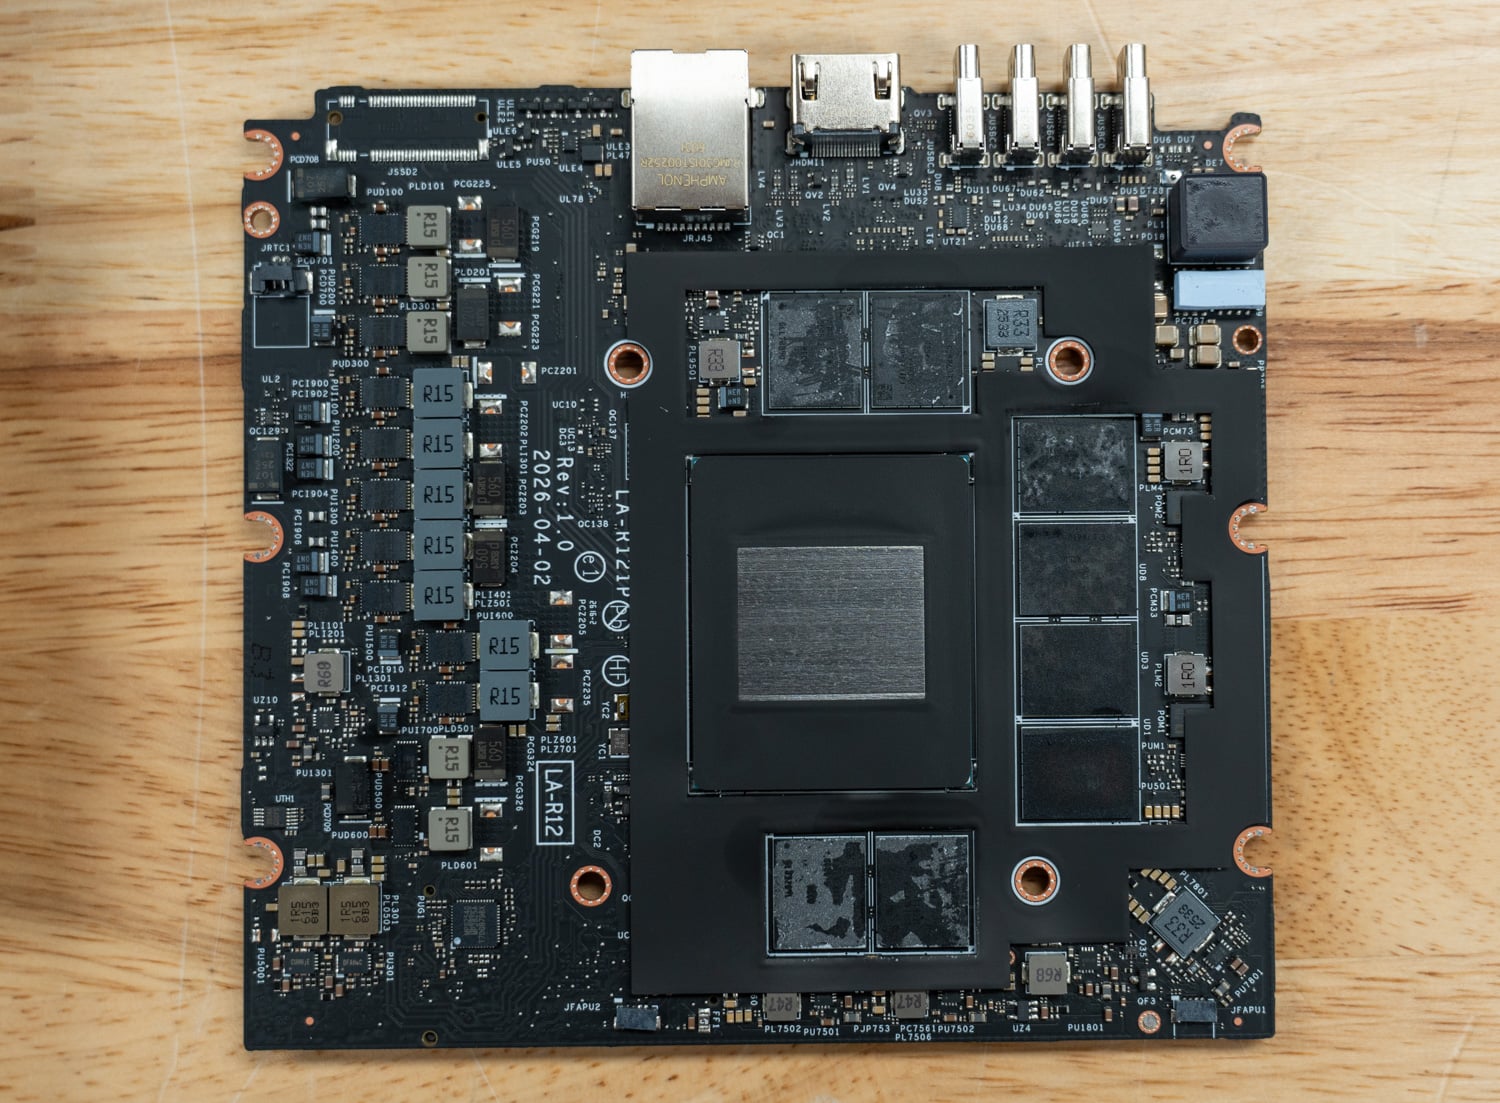
အအေးပေးစက်ကို မြှောက်လိုက်တဲ့အခါ main board ပေါ်လာပြီး အလယ်မှာ APU die ကို မြင်ရပြီး ဘေးနှစ်ဖက်မှာ memory package တွေနဲ့ ဘယ်ဘက်အစွန်းတစ်လျှောက် VRM circuitry တွေ ရှိနေပါတယ်။ die ပေါ်မှာ မြင်ရတဲ့ ငွေရောင်စတုရန်းက အရည်သတ္တု ဒါမှမဟုတ် paste-based compound မဟုတ်ဘဲ AMD က die-to-heatsink interface အဖြစ် လိမ်းထားတဲ့ အစိုင်အခဲ thermal pad ဒါမှမဟုတ် coating ရဲ့ အကြွင်းအကျန်ဖြစ်ပြီး စိုစွတ်ပြီး ပေကျံနေတဲ့ paste ဒါမှမဟုတ် အရည်သတ္တုတွေ ချန်ထားလေ့ရှိတာထက် သူ့ရဲ့ တသမတ်တည်း၊ ခြောက်သွေ့တဲ့ အသွင်အပြင်ကို ရှင်းပြပါတယ်။
heatsink ကို လှန်လိုက်တဲ့အခါ cold plate ရဲ့ အောက်ခြေကို မြင်ရပြီး အဲဒီမှာ မှန်နဲ့ ඔප දැමීම အပိုင်းက die နဲ့ တိုက်ရိုက်ထိတွေ့နေပါတယ်။ တစ်ချိန်တည်းမှာပဲ၊ memory နဲ့ power-delivery zone တွေကို အထူအမျိုးမျိုးရှိတဲ့ ကြိုတင်လိမ်းထားတဲ့ thermal pad တွေနဲ့ ဖုံးအုပ်ထားပါတယ်။
AMD Ryzen AI Halo စွမ်းဆောင်ရည်စမ်းသပ်ခြင်း
ကျွန်ုပ်တို့သည် Windows နှင့် Linux ပေါ်ရှိ AMD Ryzen AI Halo platform ကို workstation application များနှင့် AI-focused workloads များတွင် ၎င်း၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန် အကဲဖြတ်ခဲ့ပါသည်။ Windows စမ်းသပ်မှုအတွက် AMD Ryzen AI Halo system ကို Ryzen AI Max+ PRO 395 မှ ပါဝါပေးထားသော စီးပွားဖြစ်ရရှိနိုင်သော system နှစ်ခုဖြစ်သည့် compact desktop workstation တစ်ခုဖြစ်သည့် HP Z2 Mini G1a နှင့် mobile workstation တစ်ခုဖြစ်သည့် HP ZBook Ultra G1a 14-inch တို့နှင့် နှိုင်းယှဉ်ခဲ့ပါသည်။ system သုံးခုစလုံးတွင် underlying processor architecture နှင့် Radeon 8060S integrated graphics များ အတူတူပင်ဖြစ်သောကြောင့်၊ ဤနှိုင်းယှဉ်မှုများသည် Halo platform သည် မတူညီသော thermal envelopes များနှင့် system designs များတွင် မည်သို့စွမ်းဆောင်ရည်ကို မီးမောင်းထိုးပြနေပါသည်။
Linux စမ်းသပ်မှုအတွက်၊ Ryzen AI Halo စနစ်ကို NVIDIA DGX Spark နှင့် နှိုင်းယှဉ်ကာ AI ဖွံ့ဖြိုးတိုးတက်မှုနှင့် သိုလှောင်မှု workloads များသို့ ကျွန်ုပ်တို့ ပြောင်းလဲခဲ့သည်။ ဤစမ်းသပ်မှုများသည် FIO storage benchmarking နှင့် vLLM inference စွမ်းဆောင်ရည်ကို အာရုံစိုက်ခဲ့ပြီး၊ AMD ၏ Ryzen AI Halo-based developer platform နှင့် NVIDIA ၏ local large-language-model inference အတွက် ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော AI ဖွံ့ဖြိုးတိုးတက်မှုစနစ်တို့ကို နှိုင်းယှဉ်ခဲ့သည်။
စမ်းသပ်ပြီးသော ယူနစ်များ
UL Procyon: AI ကွန်ပျူတာအမြင်
Procyon AI Computer Vision Benchmark သည် AI inference engine များ ပရော်ဖက်ရှင်နယ်အဆင့်တွင် မည်သို့လုပ်ဆောင်သည်ကို အသေးစိတ်ထိုးထွင်းသိမြင်စေပါသည်။ ရောင်းချသူများစွာထံမှ engine များကို ပေါင်းစပ်အသုံးပြုခြင်းဖြင့် စက်ပစ္စည်း၏စွမ်းရည်များကို တိကျစွာထင်ဟပ်စေသော စွမ်းဆောင်ရည်ရမှတ်များကို ပေးပါသည်။ benchmark သည် CPU၊ GPU နှင့် NPU အပါအဝင် hardware အမျိုးအစားများတစ်လျှောက် ၎င်းတို့၏ AI acceleration စွမ်းဆောင်ရည်ကို နှိုင်းယှဉ်ခြင်းဖြင့် အဆင့်မြင့် neural network မော်ဒယ်များကို အကဲဖြတ်ပြီး အသုံးပြုသူများအား workloads နှင့် conditions အမျိုးမျိုးတွင် နှိုင်းရထိရောက်မှုကို အကဲဖြတ်နိုင်စေပါသည်။
လက်တွေ့ကမ္ဘာ AI workloads များကို ထင်ဟပ်စေရန်အတွက်၊ benchmark သည် ခေတ်မီကွန်ပျူတာအမြင်တာဝန်များနှင့် သက်ဆိုင်မှုရှိသောကြောင့် ရွေးချယ်ထားသော ကွဲပြားသော neural network မော်ဒယ်ခြောက်ခုကို အသုံးပြုထားသည်။ MobileNet V3 သည် ရုပ်ပုံများတွင် ဘာသာရပ်ခွဲခြားသတ်မှတ်ရန်အတွက် ဒီဇိုင်းထုတ်ထားသော ကျစ်လစ်ပြီး မိုဘိုင်းကို အဓိကထားသော မော်ဒယ်တစ်ခုဖြစ်ပြီး Inception V4 သည် ပိုမိုနက်ရှိုင်းပြီး ရှုပ်ထွေးသော ဗိသုကာဖြင့် တူညီသောလုပ်ငန်းကို လုပ်ဆောင်သည်။
YOLO V3 (သင်တစ်ကြိမ်သာကြည့်သည်) သည် အရာဝတ္ထုဖြစ်နိုင်ခြေများကို ခန့်မှန်းခြင်းဖြင့် အချိန်နှင့်တပြေးညီ အရာဝတ္ထုရှာဖွေခြင်းတွင် အထူးပြုသည်။ MobileNet V2 ပေါ်တွင်တည်ဆောက်ထားသော DeepLab V3 သည် semantic image segmentation နှင့် pixel clustering ကို အာရုံစိုက်သည်။ တွက်ချက်မှုအရ အလိုအပ်ဆုံးစမ်းသပ်မှုဖြစ်သော Real-ESRGAN သည် ရုပ်ပုံများကို 250×250 မှ 1,000×1,000 resolution အထိ မြှင့်တင်ပေးသည်။ နောက်ဆုံးအနေဖြင့် ResNet 50 သည် deep neural network များကို ပိုမိုထိရောက်စွာ လေ့ကျင့်နိုင်စေသည့် ခိုင်မာသော classification model တစ်ခုဖြစ်သည်။
Ryzen AI Halo ပလက်ဖောင်းသည် CPU နှင့် GPU workloads များတွင် စဉ်ဆက်မပြတ် ခိုင်မာသော AI inference စွမ်းဆောင်ရည်ကို ပေးဆောင်ခဲ့သည်။ CPU စမ်းသပ်မှုများတွင်၊ ၎င်းသည် ಒಟ್ಟಾರೆရမှတ် ၂၁၆ ရရှိခဲ့ပြီး HP Z2 Mini ၏ ၂၂၇ ထက် အနည်းငယ်နောက်ကျပြီး HP ZBook Ultra ၏ ၁၈၆ ထက် သက်တောင့်သက်သာသာ ပိုမိုကောင်းမွန်ခဲ့သည်။ GPU inference သည် ပို၍ပင် အထင်ကြီးစရာကောင်းပြီး Halo စနစ်သည် ZBook Ultra (528) နှင့် Z2 Mini (528) ထက် ಒಟ್ಟಾರೆရမှတ် ၅၅၃ ဖြင့် အမြင့်ဆုံးရရှိခဲ့သည်။ ၎င်းသည် အမြန်ဆုံး MobileNet V3 inference ကို 0.38ms ဖြင့် မှတ်တမ်းတင်ခဲ့ပြီး Z2 Mini တွင် 211.76ms နှင့် ZBook Ultra တွင် 200.40ms တို့နှင့် နှိုင်းယှဉ်ပါက တောင်းဆိုမှုများသော REAL-ESRGAN workload ကို 185.08ms ဖြင့် ပြီးမြောက်ခဲ့သည်။
| UL Procyon: AI ကွန်ပျူတာအမြင် ကောက်ချက်ချခြင်း (နိမ့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU အချိန်များ | |||
| AI ကွန်ပျူတာအမြင် ಒಟ್ಟಾರೆရမှတ် (မြင့်လေ ပိုကောင်းလေ) | 216 | 227 | 186 |
| မိုဘိုင်းကွန်ရက် V3 | 0.73 ms | 0.75 ms | 1.09 ms |
| ResNet 50 | 6.02 ms | 5.99 ms | 6.84 ms |
| စတင်ခြင်း V4 | 17.18 ms | 17.12 ms | 19.80 ms |
| DeepLab V3 | 29.21 ms | 21.20 ms | 28.27 ms |
| ယိုလို V3 | 35.60 ms | 36.58 ms | 41.64 ms |
| REAL-ESRGAN | 1,931.13 ms | 1,892.10 ms | 2,138.97 ms |
| GPU အချိန်များ | |||
| AI ကွန်ပျူတာအမြင် ಒಟ್ಟಾರೆရမှတ် (မြင့်လေ ပိုကောင်းလေ) | 553 | 528 | 583 |
| မိုဘိုင်းကွန်ရက် V3 | 0.38 ms | 0.42 ms | 0.46 ms |
| ResNet 50 | 4.04 ms | 3.85 ms | 3.27 ms |
| စတင်ခြင်း V4 | 13.26 ms | 15.15 ms | 11.62 ms |
| DeepLab V3 | 12.72 ms | 10.98 ms | 10.72 ms |
| ယိုလို V3 | 11.17 ms | 12.64 ms | 10.57 ms |
| REAL-ESRGAN | 185.08 ms | 211.76 ms | 200.40 ms |
UL Procyon: AI စာသားထုတ်လုပ်ခြင်း
Procyon AI Text Generation Benchmark သည် တိကျပြီး တသမတ်တည်းရှိသော အကဲဖြတ်နည်းလမ်းကို ပံ့ပိုးပေးခြင်းဖြင့် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ပိုမိုကောင်းမွန်စေသည်။ ၎င်းသည် မော်ဒယ်အရွယ်အစားကြီးများနှင့် variable factor များ၏ ရှုပ်ထွေးမှုကို လျှော့ချနေစဉ် LLM မော်ဒယ်များစွာတွင် ထပ်ခါတလဲလဲ စမ်းသပ်နိုင်စေပါသည်။ AI hardware ဦးဆောင်သူများနှင့်အတူ တီထွင်ထားသောကြောင့် ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်သော စွမ်းဆောင်ရည်အကဲဖြတ်မှုများအတွက် ဒေသတွင်း AI accelerator များအသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးပါသည်။ အောက်ပါရလဒ်များကို TensorRT ကို အသုံးပြု၍ တိုင်းတာခဲ့သည်။
Ryzen AI Halo reference platform သည် Procyon AI Text Generation တွင် စမ်းသပ်ထားသော ဘာသာစကားမော်ဒယ်အားလုံးတွင် ဦးဆောင်ခဲ့သည်။ ၎င်းသည် HP Z2 Mini အတွက် ၉၆၅ နှင့် HP ZBook Ultra အတွက် ၉၂၂ တို့နှင့် နှိုင်းယှဉ်ပါက အမြင့်ဆုံး Phi ရမှတ် ၁,၁၉၂ ဖြင့် ရရှိခဲ့သည်။ Mistral သည် အလားတူလမ်းကြောင်းကို လိုက်ခဲ့ပြီး ၈၅၀ နှင့် ၈၂၉ ထက် ၉၉၈ ရမှတ်ဖြင့် လိုက်ခဲ့ပြီး Llama3 သည် ပြိုင်ဘက်စနစ်များထက် အသီးသီး ၇၆၆ နှင့် ၇၅၆ ဖြင့် ပိုမိုကောင်းမွန်စွာ စွမ်းဆောင်နိုင်ခဲ့ပြီး ၈၄၇ ဖြင့် ပြီးဆုံးခဲ့သည်။ Halo platform သည် မော်ဒယ်တိုင်းတွင် ပထမဆုံး token ကို ၀.၉၉၆ စက္ကန့်အတွင်း ထုတ်လုပ်ခဲ့ပြီး ပထမဆုံး Phi token ကို ထုတ်လုပ်ခဲ့ပြီး HP စနစ်များ၏ latency ၏ ထက်ဝက်နီးပါးဖြစ်သည်။ token generation throughput သည် Z2 Mini ကို တစ်ခါတစ်ရံတွင် ဦးစားပေးသော်လည်း Halo platform ၏ သိသိသာသာ နိမ့်ကျသော startup latency သည် အကောင်းဆုံး benchmark ရမှတ်များကို ရရှိစေခဲ့သည်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Phi ၏ စုစုပေါင်းရမှတ် | 1,192 | 965 | 922 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.996 စက္ကန့် | 1.898 စက္ကန့် | 1.956 စက္ကန့် |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | 55.271 တိုကင်/s | 68.967 တိုကင်/s | 64.986 တိုကင်/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 56.237 စက္ကန့် | 52.666 စက္ကန့် | 55.501 စက္ကန့် |
| Mistral ၏ စုစုပေါင်းရမှတ် | 998 | 850 | 829 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 1.603 စက္ကန့် | 2.734 စက္ကန့် | 2.783 စက္ကန့် |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | 35.027 တိုကင်/s | 43.358 တိုကင်/s | 41.992 တိုကင်/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 88.582 စက္ကန့် | 81.716 စက္ကန့် | 84.065 စက္ကန့် |
| Llama3 အလုံးစုံရမှတ် | 847 | 766 | 756 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 1.963 စက္ကန့် | 2.545 စက္ကန့် | 2.578 စက္ကန့် |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | 34.630 တိုကင်/s | 36.752 တိုကင်/s | 36.243 တိုကင်/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 92.026 စက္ကန့် | 91.987 စက္ကန့် | 93.200 စက္ကန့် |
| Llama2 အလုံးစုံရမှတ် | N / A | 936 | 929 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | စက္ကန့် မရှိပါ။ | 3.813 စက္ကန့် | 3.860 စက္ကန့် |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | တိုကင်/များ မရှိပါ | 24.685 တိုကင်/s | 24.619 တိုကင်/s |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | စက္ကန့် မရှိပါ။ | 136.077 စက္ကန့် | 136.720 စက္ကန့် |
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ ဟာ့ဒ်ဝဲတစ်လျှောက် AI inference စွမ်းဆောင်ရည်ကို တိုင်းတာရန် တသမတ်တည်းနှင့် တိကျသောနည်းလမ်းကို ပေးဆောင်သည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခုပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ်ပါဝါရှိသော GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်းစက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သောရလဒ်များကို သေချာစေသည်။
ရုပ်ပုံထုတ်လုပ်မှုသည် Ryzen AI Halo ၏ အားအကောင်းဆုံး workloads များထဲမှ တစ်ခုဖြစ်သည်ကို သက်သေပြခဲ့သည်။ Stable Diffusion 1.5 FP16 တွင် Halo platform သည် ಒಟ್ಟಾರೆရမှတ် ၉၃၇ ရရှိခဲ့ပြီး Z2 Mini အတွက် ၇၂၅ နှင့် ZBook Ultra အတွက် ၆၄၈ ဖြင့် နှိုင်းယှဉ်ပါက ပိုမိုကောင်းမွန်လာခဲ့ပြီး ထုတ်လုပ်မှုအချိန်ကို ၁၃၇.၈ နှင့် ၁၅၄.၂ စက္ကန့် အသီးသီးဖြင့် ၁၀၆.၇ စက္ကန့်အထိ လျှော့ချနိုင်ခဲ့သည်။ Stable Diffusion XL သည်လည်း အလားတူ အားကောင်းသည့် ဦးဆောင်မှုကို ပြသခဲ့ပြီး Halo စနစ်သည် ၈၇၈.၅ စက္ကန့်ဖြင့် ပြီးဆုံးခဲ့ပြီး Z2 Mini ထက် ၁၇၄ စက္ကန့်ခန့် ပိုမိုမြန်ဆန်ပြီး ZBook Ultra ထက် ၄၅၀ စက္ကန့်ကျော် ပိုမိုမြန်ဆန်ခဲ့သည်။ ထို့အပြင် platform သည် Stable Diffusion 1.5 INT8 benchmark ကိုလည်း ಒಟ್ಟಾರೆရမှတ် ၉၁၅၈ ဖြင့် အပြီးသတ်နိုင်ခဲ့ပြီး HP နှိုင်းယှဉ်စနစ်နှစ်ခုလုံးတွင် မရရှိနိုင်သော workload တစ်ခုဖြစ်သည်။
| UL Procyon: AI ပုံရိပ်ထုတ်လုပ်ခြင်း | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – အလုံးစုံရမှတ် | 937 | 725 | 648 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – ಒಟ್ಟಾರೆအချိန် | 106.7 စက္ကန့် | 137.815 စက္ကန့် | 154.203 စက္ကန့် |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) – အလုံးစုံရမှတ် | 9,158 | N / A | N / A |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) – ಒಟ್ಟಾರೆအချိန် | 27.298 စက္ကန့် | N / A | N / A |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | N / A | N / A |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – အလုံးစုံရမှတ် | 682 | 570 | 451 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – ಒಟ್ಟಾರೆအချိန် | 878.493 စက္ကန့် | 1,052.468 စက္ကန့် | 1,329.592 စက္ကန့် |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
SPEC workstation ၄
SPECworkstation 4.0 benchmark သည် workstation စွမ်းဆောင်ရည်၏ အဓိကရှုထောင့်အားလုံးကို အကဲဖြတ်ရန်အတွက် ပြီးပြည့်စုံသောကိရိယာတစ်ခုဖြစ်သည်။ ၎င်းသည် CPU၊ ဂရပ်ဖစ်၊ accelerator နှင့် disk စွမ်းဆောင်ရည်တို့၏ လက်တွေ့ကမ္ဘာတိုင်းတာမှုကို ပေးစွမ်းပြီး ကျွမ်းကျင်ပညာရှင်များအား ၎င်းတို့၏ hardware ရင်းနှီးမြှုပ်နှံမှုများနှင့်ပတ်သက်၍ အသိပေးဆုံးဖြတ်ချက်များချရန် လိုအပ်သောဒေတာကို ပေးသည်။ benchmark တွင် data science tasks နှင့် ONNX Runtime-based inference tests များကဲ့သို့သော AI နှင့် ML workloads များကို အာရုံစိုက်သည့် သီးသန့်စမ်းသပ်မှုအစုံတစ်ခု ပါဝင်ပြီး workstation ပတ်ဝန်းကျင်တွင် AI/ML ၏ တိုးပွားလာသော အရေးပါမှုကို ထင်ဟပ်စေသည်။ ၎င်းသည် စက်မှုလုပ်ငန်း verticals ခုနစ်ခုနှင့် hardware subsystems လေးခုကို လွှမ်းခြုံထားပြီး ယနေ့ခေတ် workstations များ၏ စွမ်းဆောင်ရည်ကို အသေးစိတ်နှင့် သက်ဆိုင်ရာတိုင်းတာမှုကို ပေးစွမ်းသည်။
SPECworkstation 4 သည် Ryzen AI Halo ပလက်ဖောင်း၏ ဟန်ချက်ညီသော workstation စွမ်းရည်များကို မီးမောင်းထိုးပြခဲ့သည်။ ၎င်းသည် Financial Services (2.92)၊ Media & Entertainment (2.97)၊ Product Design (2.22) နှင့် Productivity & Development (1.27) တို့တွင် အမြင့်ဆုံးရမှတ်များ ရရှိခဲ့ပြီး ထိုကဏ္ဍများတွင် HP Z2 Mini နှင့် HP ZBook Ultra နှစ်ခုလုံးထက် သာလွန်ခဲ့သည်။ Z2 Mini သည် Energy (2.50 vs. 2.35) နှင့် Life Sciences (2.60 vs. 2.33) တို့တွင် အနည်းငယ် ဦးဆောင်နေခဲ့သည်။ အလုံးစုံပြောရလျှင် Halo reference platform သည် benchmark ၏ professional workloads များတွင် ခိုင်မာသောစွမ်းဆောင်ရည်ကို ပြသခဲ့ပြီး စမ်းသပ်ထားသော အမျိုးအစားတိုင်းတွင် ယှဉ်ပြိုင်နိုင်စွမ်းရှိနေဆဲဖြစ်သည်။
| SPECworkstation 4.0.0 (မြင့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| စွမ်းအင်ဝန်ကြီးဌာန | 2.35 | 2.50 | 2.20 |
| ဘဏ္ဍာရေးဝန်ဆောင်မှု | 2.92 | 2.35 | 1.60 |
| ဘဝကသိပ္ပံ | 2.33 | 2.60 | 2.20 |
| မီဒီယာနှင့်ဖျော်ဖြေရေး | 2.97 | 2.22 | 1.90 |
| ကုန်ပစ္စည်းဒီဇိုင်း | 2.22 | 2.00 | 1.74 |
| ထုတ်လုပ်မှုနှင့် ဖွံ့ဖြိုးတိုးတက်မှု | 1.27 | 1.00 | 1.03 |
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray-tracing renderer ဖြစ်သော LuxRender ကိုအသုံးပြု၍ အလွန်အသေးစိတ်ကျသော 3D မြင်ကွင်းများဖြင့် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ graphical rendering စွမ်းရည်များကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များအတွက် အသုံးဝင်ပြီး တိကျသောအလင်း simulation သည် အရေးကြီးပါသည်။
Luxmark ရလဒ်များအရ Ryzen AI Max+ 395 ပလက်ဖောင်းသုံးခုတွင် အနည်းဆုံးကွာဟချက်ကို ပြသခဲ့သည်။ Halo reference system သည် အမြင့်ဆုံး Food ရမှတ် ၄,၁၅၈ ဖြင့် Z2 Mini (3,943) နှင့် ZBook Ultra (3,915) တို့ကို ကျော်ဖြတ်ခဲ့သည်။ Hallbench workload တွင် ၎င်းသည် ၈၀၁၄ မှတ်ရရှိခဲ့ပြီး Z2 Mini ၏ ၈,၄၇၇ ထက် အနည်းငယ်နောက်ကျသော်လည်း ZBook Ultra ၏ ၇,၈၃၃ ထက် သာလွန်သည်။ အလုံးစုံပြောရလျှင် Radeon 8060S ကို အခြေခံ၍ တည်ဆောက်ထားသော စနစ်များသည် ပုံစံမည်သို့ပင်ရှိစေကာမူ အလွန်ဆင်တူသော ray-tracing စွမ်းဆောင်ရည်ကို ပေးစွမ်းကြောင်း ရလဒ်များက ညွှန်ပြနေသည်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| ဟောလ်ဘန်ချ် | 8,014 | 8,477 | 7,833 |
| အစားအသောက်များ | 4,158 | 3,943 | 3,915 |
7-Zip ချုံ့ခြင်း
7-Zip Compression Benchmark သည် compression နှင့် decompression လုပ်နေစဉ်အတွင်း CPU စွမ်းဆောင်ရည်ကို အကဲဖြတ်ပြီး GIPS (Giga Instructions Per Second) နှင့် CPU အသုံးပြုမှုတို့တွင် စွမ်းဆောင်ရည်ကို တိုင်းတာသည်။ GIPS မြင့်မားခြင်းနှင့် ထိရောက်သော CPU အသုံးပြုမှုသည် သာလွန်ကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြသည်။
Ryzen AI Halo ပလက်ဖောင်းသည် 7-Zip benchmark တွင် အဓိက အမျိုးအစားတိုင်းတွင် ဦးဆောင်နေသည်။ ၎င်းသည် compression rating 176.7 GIPS ရရှိခဲ့ပြီး HP Z2 Mini တွင် 139.3 GIPS နှင့် ZBook Ultra တွင် 139.6 GIPS တို့နှင့် နှိုင်းယှဉ်ပါက မြင့်မားနေဆဲဖြစ်သည်။ Decompression စွမ်းဆောင်ရည်သည် 191.6 GIPS တွင် တူညီစွာ အားကောင်းနေဆဲဖြစ်ပြီး Z2 Mini ၏ 164.0 GIPS နှင့် ZBook Ultra ၏ 174.0 GIPS တို့ကို ကျော်လွန်ခဲ့သည်။ ပေါင်းစပ်လိုက်သောအခါ Halo ပလက်ဖောင်းသည် အမြင့်ဆုံး overall rating 184.2 GIPS ကို ရရှိခဲ့ပြီး ပြိုင်ဘက်စနစ်များထက် ၂၀% ခန့် ပိုမိုကောင်းမွန်ခဲ့ပြီး archive creation နှင့် extraction workloads များအတွက် အလွန်ကောင်းမွန်သော integer throughput ကို ပြသခဲ့သည်။
| 7-Zip ဖိသိပ်မှု စံနှုန်း (မြင့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| ချုံ့ | ||||||
| လက်ရှိ CPU အသုံးပြုမှု | 2,741% | 2,734% | 2,868% | |||
| လက်ရှိ အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| လက်ရှိခဲ့သည် Rating | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| ရလဒ်အနေဖြင့် CPU အသုံးပြုမှု | 2,751% | 2,718% | 2,855% | |||
| ရလဒ်အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| ရလဒ်အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| ဖိသိပ်ခြင်း | ||||||
| လက်ရှိ CPU အသုံးပြုမှု | 2,568% | 2,343% | 2,904% | |||
| လက်ရှိ အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| လက်ရှိခဲ့သည် Rating | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| ရလဒ်အနေဖြင့် CPU အသုံးပြုမှု | 2,469% | 2,414% | 2,887% | |||
| ရလဒ်အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| ရလဒ်အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| စုစုပေါင်း အဆင့်သတ်မှတ်ချက် | ||||||
| စုစုပေါင်း CPU အသုံးပြုမှု | 2,610% | 2,566% | 2,871% | |||
| စုစုပေါင်း အဆင့်သတ်မှတ်ချက်/အသုံးပြုမှု | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
| စုစုပေါင်း အဆင့်သတ်မှတ်ချက် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | ၁၀၇.၂၂၉ ဂျီပီအက်စ် | |||
Blender Benchmark
Blender သည် open-source 3D modeling application တစ်ခုဖြစ်သည်။ ဤ benchmark ကို Blender Benchmark utility ဖြင့် လုပ်ဆောင်ခဲ့သည်။ ရမှတ်ကို တစ်မိနစ်လျှင် နမူနာများဖြင့် တိုင်းတာပြီး မြင့်မားသောတန်ဖိုးများသည် ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြသည်။
CPU rendering ဟာလည်း Ryzen AI Halo သာလွန်ကောင်းမွန်တဲ့ နောက်ထပ်နယ်ပယ်တစ်ခုပါပဲ။ Monster မြင်ကွင်းမှာ HP Z2 Mini (224.3) နဲ့ HP ZBook Ultra (189.3) တို့ထက် တစ်မိနစ်ကို sample ၂၄၄.၇ ခု ရရှိခဲ့ပါတယ်။ Junkshop ကတော့ တစ်မိနစ်ကို sample ၁၄၉.၅ နဲ့ ၁၂၉.၄ ခုနဲ့ နှိုင်းယှဉ်ရင် ၁၅၉.၄ ခု ရရှိခဲ့ပြီး Classroom ကတော့ တစ်မိနစ်ကို sample ၁၃၁.၆ ခု ရရှိခဲ့ပြီး Z2 Mini (116.3) ထက် ၁၃% ခန့်နဲ့ ZBook Ultra (94.1) ထက် ၄၀% နီးပါး သာလွန်ခဲ့ပါတယ်။ ဒီရလဒ်တွေက Ryzen AI Max+ 395 ဟာ workstation အရွယ်အစားသေးငယ်ပေမယ့် multithreaded rendering စွမ်းဆောင်ရည်ကို အလွန်ကောင်းမွန်စွာ ပေးစွမ်းနိုင်တယ်ဆိုတာကို ပြသနေပါတယ်။
| Blender Benchmark CPU (တစ်မိနစ်လျှင် နမူနာများ၊ မြင့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| ဧရာမသတ္တဝါကြီး | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ |
| အမှိုက်ဆိုင် | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ |
| စာသင်ခန်း | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ |
GPU rendering ရလဒ်များသည် စနစ်အားလုံးတွင် အတော်လေး နီးစပ်ပါသည်။ Halo reference platform သည် Monster scene ကို တစ်မိနစ်လျှင် samples 704.2 ဖြင့် render လုပ်ခဲ့ပြီး Z2 Mini (745.6) ထက် နောက်ကျနေသော်လည်း ZBook Ultra (661.5) ထက် သာလွန်နေပါသည်။ Junkshop သည် Halo platform (366.6) နှင့် Z2 Mini (366.5) အကြားတွင် ထိရောက်စွာ တူညီနေပါသည်။ တစ်ချိန်တည်းမှာပင်၊ Halo system သည် တစ်မိနစ်လျှင် samples 361.5 ဖြင့် အမြင့်ဆုံး Classroom score ကို ရရှိခဲ့ပြီး Z2 Mini (359.0) နှင့် ZBook Ultra (333.3) ထက် အနည်းငယ်သာ ကျော်လွန်နေပါသည်။ ရလဒ်များအရ Radeon 8060S သည် အကောင်အထည်ဖော်မှုများတွင် အံ့သြဖွယ်ကောင်းလောက်အောင် တသမတ်တည်းရှိသော GPU rendering စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ကြောင်း ညွှန်ပြနေပါသည်။
| Blender Benchmark GPU (တစ်မိနစ်လျှင် နမူနာများ၊ များလေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| ဧရာမသတ္တဝါကြီး | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ |
| အမှိုက်ဆိုင် | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ |
| စာသင်ခန်း | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ | ၃၃၃.၂၆ နမူနာ/မီတာ |
y-cruncher
y-cruncher သည် Pi နှင့် အခြားသင်္ချာကိန်းသေများကို ထရီလီယံဂဏန်းအထိ တွက်ချက်နိုင်သော multithreaded၊ scalable program တစ်ခုဖြစ်သည်။ ၂၀၀၉ ခုနှစ်တွင် စတင်မိတ်ဆက်ချိန်မှစ၍ ၎င်းသည် overclocker များနှင့် hardware ဝါသနာရှင်များအတွက် ရေပန်းစားသော benchmarking နှင့် stress-testing tool တစ်ခု ဖြစ်လာခဲ့သည်။
y-cruncher ရလဒ်များသည် တွက်ချက်မှုအရွယ်အစားအလိုက် ကွဲပြားသည်။ ၁ ဘီလီယံဂဏန်းနှင့် ၂.၅ ဘီလီယံဂဏန်း လည်ပတ်မှုများတွင် စနစ်သုံးခုစလုံးသည် တစ်ခုနှင့်တစ်ခု စက္ကန့်၏ ဆယ်ပုံတစ်ပုံအနည်းငယ်အတွင်း ပြီးမြောက်ခဲ့ပြီး HP စနစ်များသည် အနည်းငယ်သာ ရှေ့ရောက်နေခဲ့သည်။ workload တိုးချဲ့လာသည်နှင့်အမျှ Halo သည် 5 ဘီလီယံဂဏန်း တွက်ချက်မှုကို ၇၁.၉၄၈ စက္ကန့်အတွင်း ပြီးမြောက်ခဲ့ပြီး Z2 Mini အတွက် ၇၅.၀၂၁ စက္ကန့်နှင့် ZBook Ultra အတွက် ၇၈.၁၉ စက္ကန့်နှင့် နှိုင်းယှဉ်ပါက ကျော်လွန်သွားခဲ့သည်။ ၁၀ ဘီလီယံဂဏန်းတွင် Halo သည် ၁၅၁.၄၀၉ စက္ကန့်ဖြင့် ပြီးမြောက်ခဲ့ပြီး Z2 Mini ထက် ၆% ခန့် သာလွန်ပြီး ZBook Ultra ထက် ၁၂% သာလွန်သောကြောင့် desktop chassis သည် လည်ပတ်ချိန်များ တိုးချဲ့လာသည်နှင့်အမျှ လေးလံသော multithreaded load ကို ပိုမိုကောင်းမွန်စွာ ခံနိုင်ရည်ရှိကြောင်း ညွှန်ပြနေသည်။
| Y-Cruncher (စုစုပေါင်း တွက်ချက်ချိန်) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 ဘီလီယံ | 13.193 စက္ကန့် | 12.965 စက္ကန့် | 12.93 စက္ကန့် |
| 2.5 ဘီလီယံ | 34.578 စက္ကန့် | 34.533 စက္ကန့် | 34.91 စက္ကန့် |
| 5 ဘီလီယံ | 71.948 စက္ကန့် | 75.021 စက္ကန့် | 78.19 စက္ကန့် |
| 10 ဘီလီယံ | 151.409 စက္ကန့် | 160.252 စက္ကန့် | 171.72 စက္ကန့် |
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။
Geekbench 6 သည် Halo platform ၏ ဟန်ချက်ညီသော စွမ်းဆောင်ရည်ပရိုဖိုင်ကို အားဖြည့်ပေးခဲ့သည်။ ၎င်းသည် HP Z2 Mini (2,862) နှင့် ZBook Ultra (2,825) တို့ထက် အမြင့်ဆုံး single-core ရမှတ် 2,986 ရရှိခဲ့သည်။ Multi-core စွမ်းဆောင်ရည်သည်လည်း 18,068 ဖြင့် ဦးဆောင်နေသည်။ Radeon 8060S သည် OpenCL GPU ရမှတ် 92,883 ဖြင့် အမြင့်ဆုံးစံချိန်တင်ခဲ့ပြီး Z2 Mini (91,591) ထက် အနည်းငယ်သာလွန်ပြီး ZBook Ultra (85,337) ထက် သက်တောင့်သက်သာသာ စွမ်းဆောင်ရည်သာလွန်ခဲ့သည်။ CPU နှင့် GPU စမ်းသပ်မှုတစ်လျှောက်တွင် တသမတ်တည်း ဦးဆောင်မှုများက Ryzen AI Max+ 395 platform ၏ ပြည့်စုံသော စွမ်းဆောင်ရည်ကို ဖော်ပြသည်။
| Geekbench 6 (မြင့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU Single-Core | 2,986 | 2,862 | 2,825 |
| CPU Multi-Core | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 သည် 3D rendering workloads များတွင် CPU စွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန်အတွက် ကျယ်ကျယ်ပြန့်ပြန့် အသိအမှတ်ပြုထားသော benchmark တစ်ခုဖြစ်သည်။ Cinema 4D engine မှ စွမ်းအားပေးထားသော ၎င်းသည် processor သည် single-threaded နှင့် multithreaded task များကို မည်မျှကောင်းမွန်စွာ ကိုင်တွယ်နိုင်သည်ကို တိုင်းတာပေးပြီး အလုံးစုံ responsiveness နှင့် parallel processing စွမ်းရည်များအကြောင်း ထိုးထွင်းသိမြင်မှုကို ပေးစွမ်းသည်။
Cinebench R23 မှာ Ryzen AI Max+ 395 desktop အကောင်အထည်ဖော်မှုနှစ်ခုကြား အလွန်နီးကပ်တဲ့ ယှဉ်ပြိုင်မှုကို ပြသခဲ့ပါတယ်။ Halo reference platform ဟာ multi-core ရမှတ် ၃၇,၃၁၆ ရရှိခဲ့ပြီး HP Z2 Mini ရဲ့ ၃၇,၁၅၆ ထက် အသာရခဲ့ပြီး နှစ်ခုစလုံးဟာ HP ZBook Ultra ရဲ့ ၂၉,၁၁၂ ထက် သာလွန်ခဲ့ပါတယ်။ Single-core စွမ်းဆောင်ရည်ကလည်း အလားတူပုံစံအတိုင်း လိုက်လံခဲ့ပြီး Halo platform က ၂၀၄၇ ရမှတ် ရရှိခဲ့ပြီး Z2 Mini မှာ ၂၀၂၀ နဲ့ ZBook Ultra မှာ ၁၉၈၄ ရမှတ် ရရှိခဲ့ပါတယ်။ Z2 Mini ထက် ကွာခြားချက် နည်းပေမယ့် Halo system ကတော့ benchmark ရဲ့ ထိပ်ဆုံးမှာ အမြဲရပ်တည်ခဲ့ပါတယ်။
| Cinebench R23 (မြင့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core ပါ | 37,316 | 37,156 | 29,112 |
| Single-Core ဖြစ်သည် | 2,047 | 2,020 | 1,984 |
Cinebench ၂
Cinebench 2024 သည် CPU စွမ်းဆောင်ရည်ကို အာရုံစိုက်ထားစဉ် GPU-based rendering စမ်းသပ်မှုများကို မိတ်ဆက်ပေးခြင်းဖြင့် R23 ၏ အခြေခံပေါ်တွင် တည်ဆောက်ထားသည်။ ဤအပိုင်းအတွက်၊ ကျွန်ုပ်တို့သည် CPU ရမှတ်များကိုသာ စစ်ဆေးပြီး စနစ်တစ်ခုစီသည် ခေတ်မီ 3D rendering လုပ်ငန်းများကို မည်မျှကောင်းမွန်စွာ ကိုင်တွယ်နိုင်သည်ကို အပ်ဒိတ်လုပ်ထားသော ထိုးထွင်းသိမြင်မှုကို ပေးဆောင်ပါသည်။
Cinebench 2024 benchmark အသစ်သည် R23 ရလဒ်များနှင့် တူညီနေပါသည်။ Ryzen AI Halo သည် အမြင့်ဆုံး multi-core ရမှတ် 1,916 ဖြင့် မှတ်တမ်းတင်ခဲ့ပြီး HP Z2 Mini (1,906) ထက် အနည်းငယ်သာ သာလွန်ခဲ့ပြီး HP ZBook Ultra (1,579) ထက် များစွာ ဦးဆောင်နေဆဲဖြစ်သည်။ Single-core စွမ်းဆောင်ရည်သည်လည်း Halo platform ကို မျက်နှာသာပေးခဲ့ပြီး Z2 Mini တွင် 112 မှတ်နှင့် ZBook Ultra တွင် 111 မှတ် ရရှိခဲ့သည်။ desktop system များအကြား ကွာခြားချက်များမှာ သေးငယ်နေသော်လည်း ရလဒ်များသည် Ryzen AI Max+ 395 ၏ ထိပ်တန်း CPU rendering စွမ်းဆောင်ရည်ကို တသမတ်တည်း ပေးစွမ်းနိုင်စွမ်းကို အားကောင်းစေသည်။
| Cinebench 2024 (မြင့်လေ ပိုကောင်းလေ) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a ၁၄ လက်မ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core ပါ | 1,916 | 1,906 | 1,579 |
| Single-Core ဖြစ်သည် | 116 | 112 | 111 |
Phoronix စံနှုန်းများ
Phoronix Test Suite သည် OpenBenchmarking.org မှတစ်ဆင့် စမ်းသပ်မှုပရိုဖိုင် ၄၅၀ ကျော်နှင့် စမ်းသပ်မှုအစုံ ၁၀၀ ကျော်ကို ပံ့ပိုးပေးသည့် open-source၊ အလိုအလျောက် benchmarking platform တစ်ခုဖြစ်သည်။ ၎င်းသည် dependencies များထည့်သွင်းခြင်းမှသည် စမ်းသပ်မှုများကို လုပ်ဆောင်ခြင်းနှင့် ရလဒ်များစုဆောင်းခြင်းအထိ အရာအားလုံးကို ကိုင်တွယ်ဆောင်ရွက်ပေးပြီး စွမ်းဆောင်ရည်နှိုင်းယှဉ်ခြင်း၊ hardware validation နှင့် continuous integration တို့အတွက် အသင့်တော်ဆုံးဖြစ်စေသည်။ Stream၊ 7-Zip နှင့် LLVM စမ်းသပ်မှုများတွင် စွမ်းဆောင်ရည်ကို ကျွန်ုပ်တို့ လေ့လာကြည့်ပါမည်။
Phoronix benchmark suite ကိုကြည့်မယ်ဆိုရင် AMD Ryzen AI Halo platform နဲ့ NVIDIA DGX Spark ကြားမှာ အတော်လေး ညီမျှတဲ့ ကွာဟချက်ကို ကျွန်တော်တို့ တွေ့ရှိခဲ့ပါတယ်။ Ryzen AI Halo system ဟာ CPU-centric workloads တွေကို အဆက်မပြတ် ဦးဆောင်နေပြီး 7-Zip compression မှာ DGX Spark ထက် ၁၁%၊ 7-Zip decompression မှာ ၃၈% နဲ့ LLVM compile test မှာ ၁၄% ပိုမြန်ပြီး ပြီးမြောက်ခဲ့ပါတယ်။ တစ်ဖက်မှာတော့ DGX Spark ဟာ memory bandwidth ပိုမိုအားကောင်းပြီး STREAM Scale, Triad နဲ့ Add test တွေမှာ ၁၇%၊ ၁၃% နဲ့ ၁၅% အသီးသီး ဦးဆောင်နေပါတယ်။ Halo ဟာ STREAM Copy benchmark မှာ ၁၈% အားသာချက် ရရှိထားတာကြောင့် system နှစ်ခုစလုံးဟာ စွမ်းဆောင်ရည်မြင့်မားပေမယ့် Ryzen AI Halo platform က general-purpose compute performance ကို ဦးစားပေးပြီး DGX Spark ကတော့ memory-bandwidth-focused workloads တွေမှာ throughput ပိုမိုမြင့်မားတာကို ပြသနေပါတယ်။
| စမ်းသပ် | AMD Ryzen AI Halo | NVIDIA DGX Spark | အောင်သူ |
|---|---|---|---|
| 7-Zip ဖိသိပ်မှု (MIPS) | 186,921 | 169,052 | ဟေလို (+၁၈%) |
| 7-Zip ဖြည်ချခြင်း (MIPS) | 146,109 | 106,084 | ဟေလို (+၁၈%) |
| တိုက်ရိုက်ကြည့်ရှုမှု မိတ္တူ (MB/s) | 145,363 | 123,730 | ဟေလို (+၁၈%) |
| STREAM စကေး (MB/s) | 110,611 | 128,970 | မီးပွား (+၁၅%) |
| STREAM Triad (MB/s) | 107,105 | 121,433 | မီးပွား (+၁၅%) |
| ထုတ်လွှင့်မှု ထပ်ထည့်ခြင်း (MB/s) | 107,022 | 122,815 | မီးပွား (+၁၅%) |
| LLVM စုစည်းမှု (ဖန်တီးခြင်း၊ စက္ကန့်များ) | 431.8 | 504.3 | ဟေလို (၁၄% ပိုမြန်) |
FIO စွမ်းဆောင်ရည် စံနှုန်း
အသုံးများသော စက်မှုလုပ်ငန်း မက်ထရစ်များတွင် သိုလှောင်မှုစွမ်းဆောင်ရည်ကို တိုင်းတာရန်အတွက် fio ကို အသုံးပြုပါသည်။ ကျွန်ုပ်တို့၏ ရိုးရာ SSD စမ်းသပ်မှုသည် drive တစ်ခုစီကို drive နှစ်ခုအပြည့်ဖြည့်ခြင်းဖြင့် secondary drive အဖြစ် ကြိုတင်သတ်မှတ်ထားသည်။ ဤနေရာတွင်၊ ကျွန်ုပ်တို့သည် filesystem မှတစ်ဆင့် drive တစ်ခုစီကို in-system တွင် စမ်းသပ်ခဲ့သည်။ NVIDIA စနစ်များကို GDSIO ဖြင့် ယခင်က စမ်းသပ်ခဲ့သော်လည်း AMD သည် နှိုင်းယှဉ်နိုင်သော GPU-direct storage စမ်းသပ်မှုကို မပေးဆောင်သောကြောင့် platform နှစ်ခုလုံးတွင် filesystem-level fio ကို အသုံးပြုခြင်းဖြင့် ၎င်းတို့အား တန်းတူညီမျှသော ယှဉ်ပြိုင်မှုနယ်ပယ်တွင် ထားရှိပေးပြီး ၎င်းသည် drive များကို ခွဲခြားသိမြင်စွာ benchmarking လုပ်ခြင်းထက် ပိုအရေးကြီးပါသည်။
NVIDIA DGX Spark (Founders Edition) နှင့် AMD Ryzen AI Halo နှစ်ခုစလုံးသည် PCIe Gen5 drive ပါရှိသောကြောင့် စာရွက်ပေါ်တွင် platform နှစ်ခုလုံးတွင် raw drive bandwidth အတွက် တူညီသော ceilings များရှိသည်။ သို့သော် လက်တွေ့တွင် Halo ၏ drive သည် ဤစနစ်တွင် PCIe Gen4 link speeds များဖြင့် လည်ပတ်ပြီး drive ကိုယ်တိုင်လုပ်ဆောင်နိုင်သည်ထက် များစွာနိမ့်သော ရရှိနိုင်သော bandwidth ကို ကန့်သတ်ထားသည်။ ထို link-speed ကန့်သတ်ချက်သည် platform နှစ်ခုကြားရှိ bandwidth gap ၏ အဓိပ္ပာယ်ရှိသော အစိတ်အပိုင်းတစ်ခုကို ထည့်သွင်းစဉ်းစားသောကြောင့် ဤအပိုင်းတစ်လျှောက်လုံးတွင် သတိပြုသင့်သည်။
ဤအပိုင်းတွင်၊ ကျွန်ုပ်တို့သည် အောက်ပါ FIO စံနှုန်းများကို အာရုံစိုက်ပါသည်။
- ၁၂၈K အစီအစဉ်အတိုင်း
- 64K ကျပန်း
- ၁၂၈K အစီအစဉ်အတိုင်း
- 16K ကျပန်း
- 4K ကျပန်း
၁၆K အစဉ်လိုက်ဖတ်ရှုခြင်း
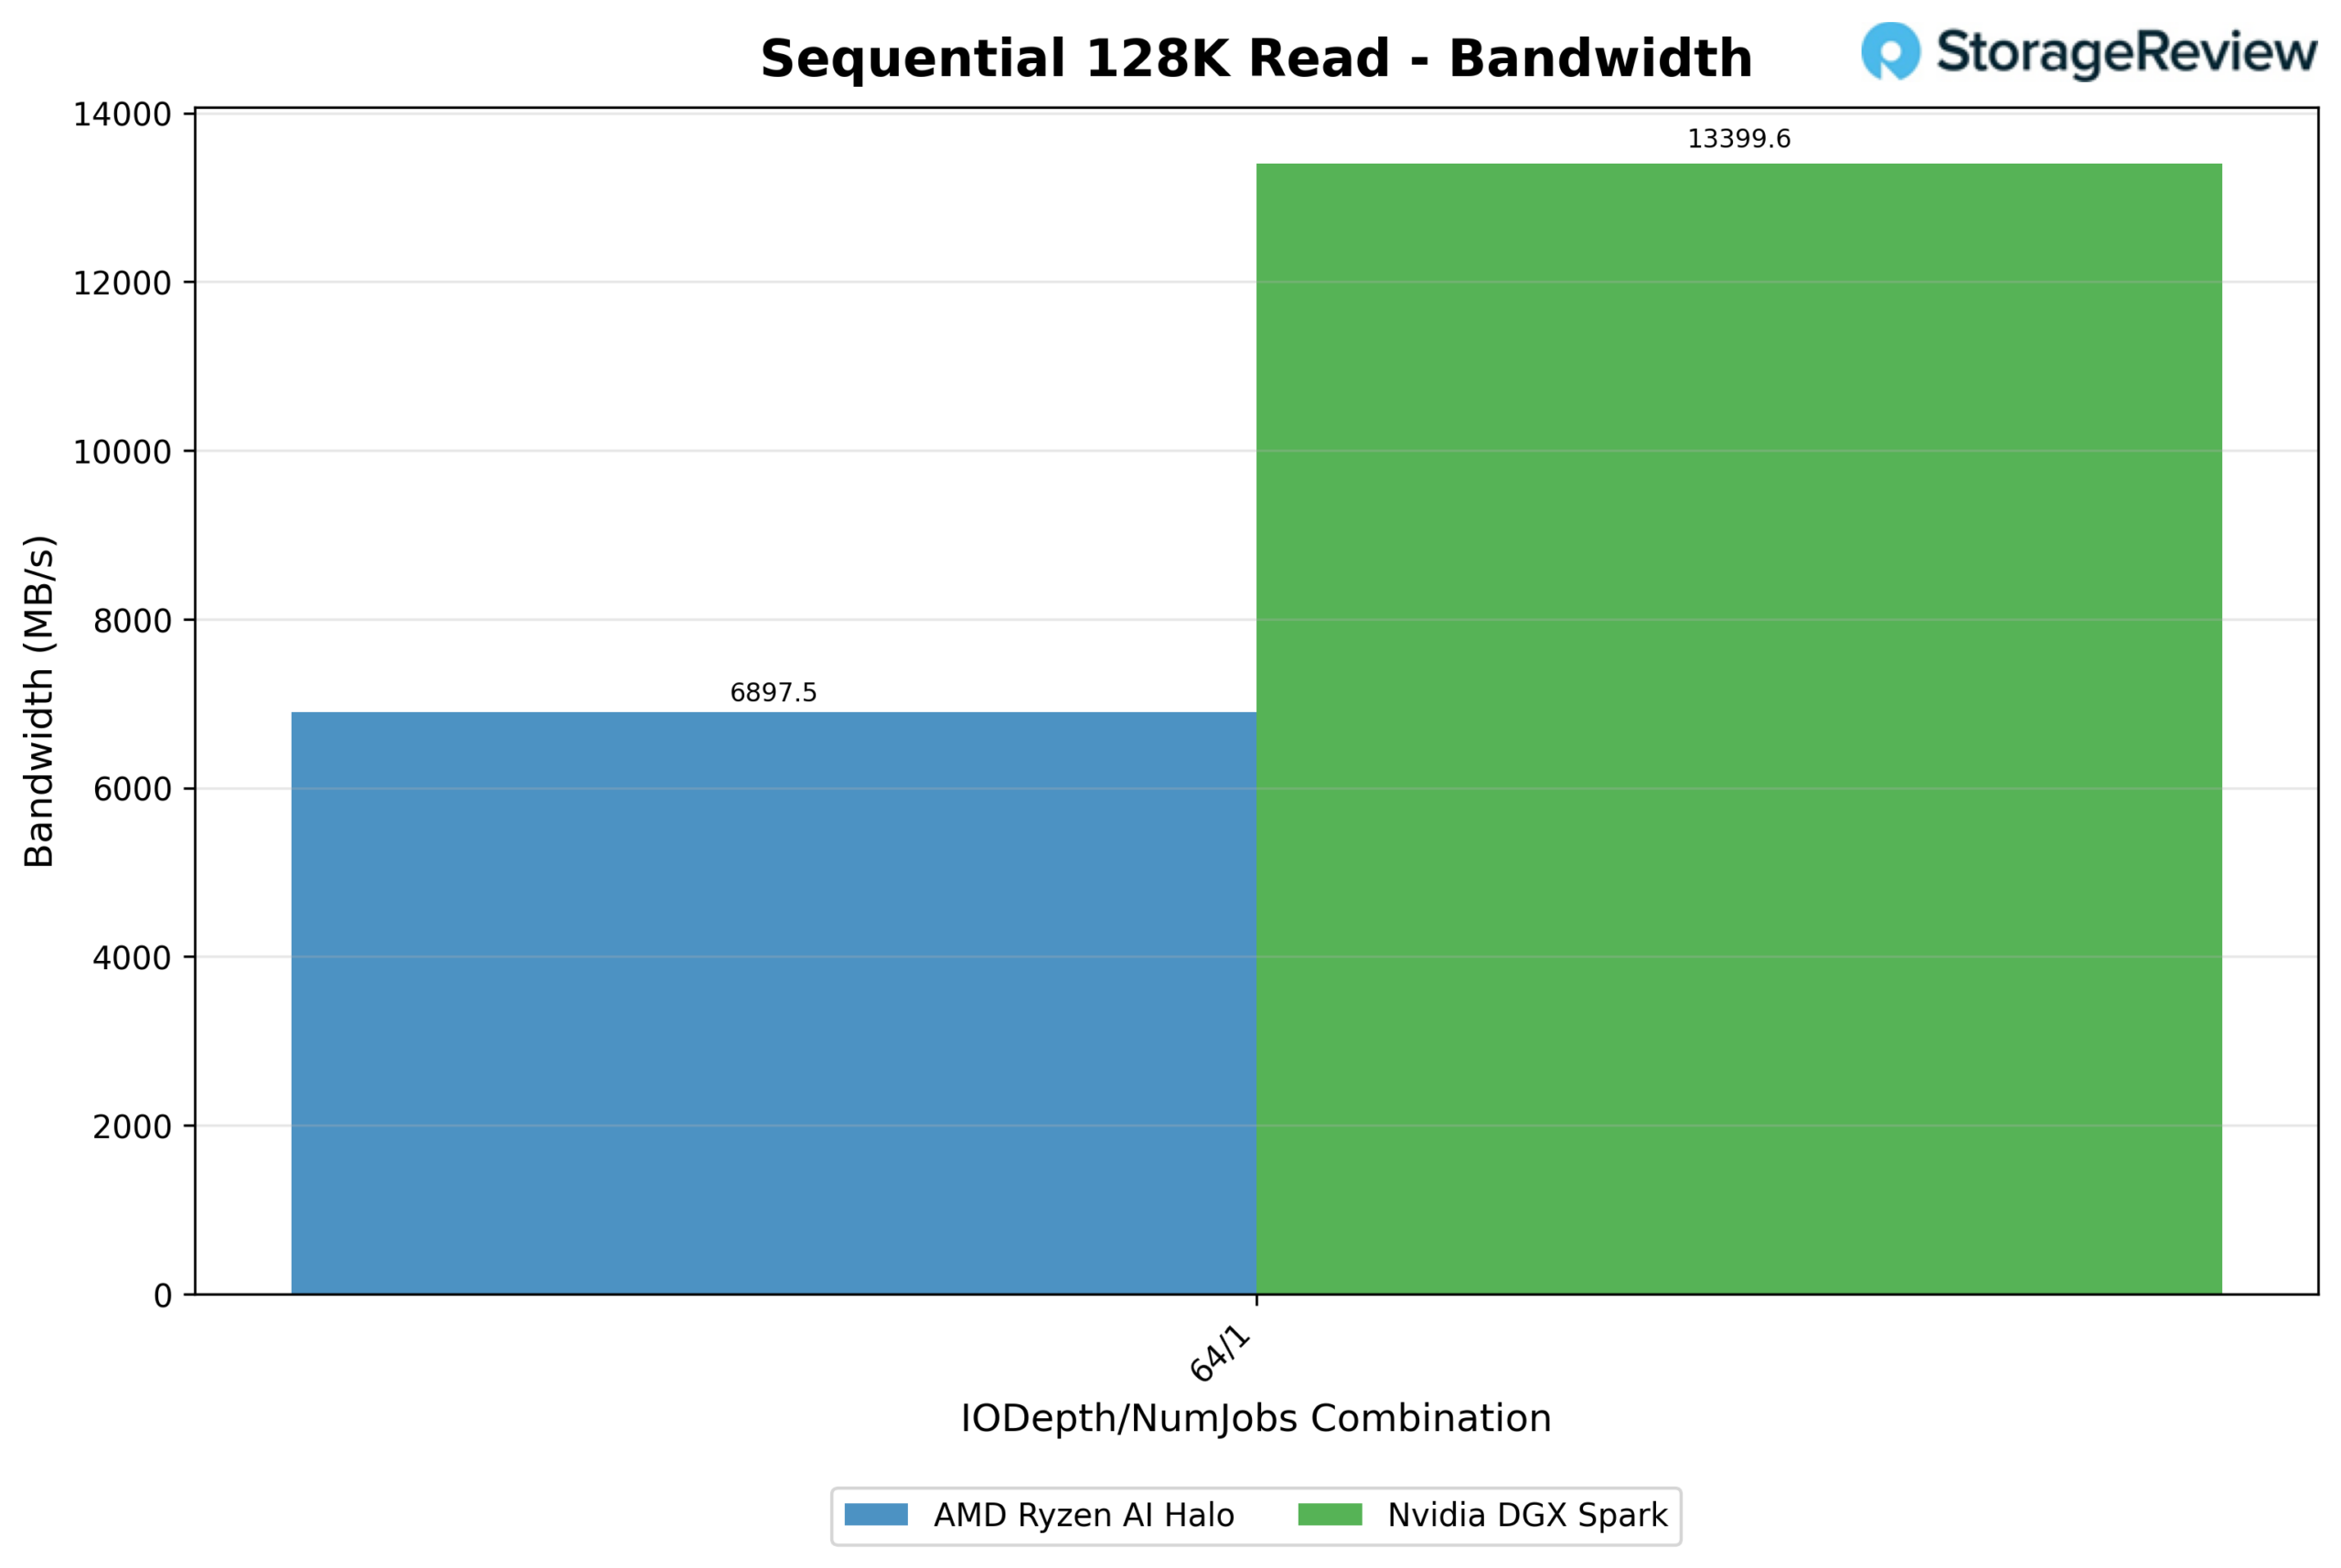
single-threaded, deep-queue 128K sequential read (64/1) မှာ NVIDIA DGX Spark ဟာ 13,399.6 MB/s ရရှိခဲ့ပြီး AMD Ryzen AI Halo ရဲ့ 6,897.5 MB/s ထက် နှစ်ဆနီးပါး မြန်ဆန်ခဲ့ပါတယ်။ Latency ကလည်း အဲဒီပုံစံအတိုင်းပါပဲ- Spark ရဲ့ ဒီ depth မှာ ပျမ်းမျှ latency က 0.597 ms ရှိပြီး Halo ကတော့ 1.159 ms သာ နှေးကွေးခဲ့ပြီး data ရဲ့ ထက်ဝက်ကို ရွှေ့နေပေမယ့် request တစ်ခုစီအတွက် နှစ်ဆနီးပါး နှေးကွေးခဲ့ပါတယ်။ ဒါက sweep တစ်ခုလုံးမှာ အရှင်းလင်းဆုံး ကွာဟချက်ဖြစ်ပြီး Spark ရဲ့ storage stack ကို ဒီ block size မှာ sequential throughput မြင့်မားစေဖို့ တည်ဆောက်ထားတာကို ညွှန်ပြနေပါတယ်။
128K အစဉ်လိုက်ရေးသားခြင်း
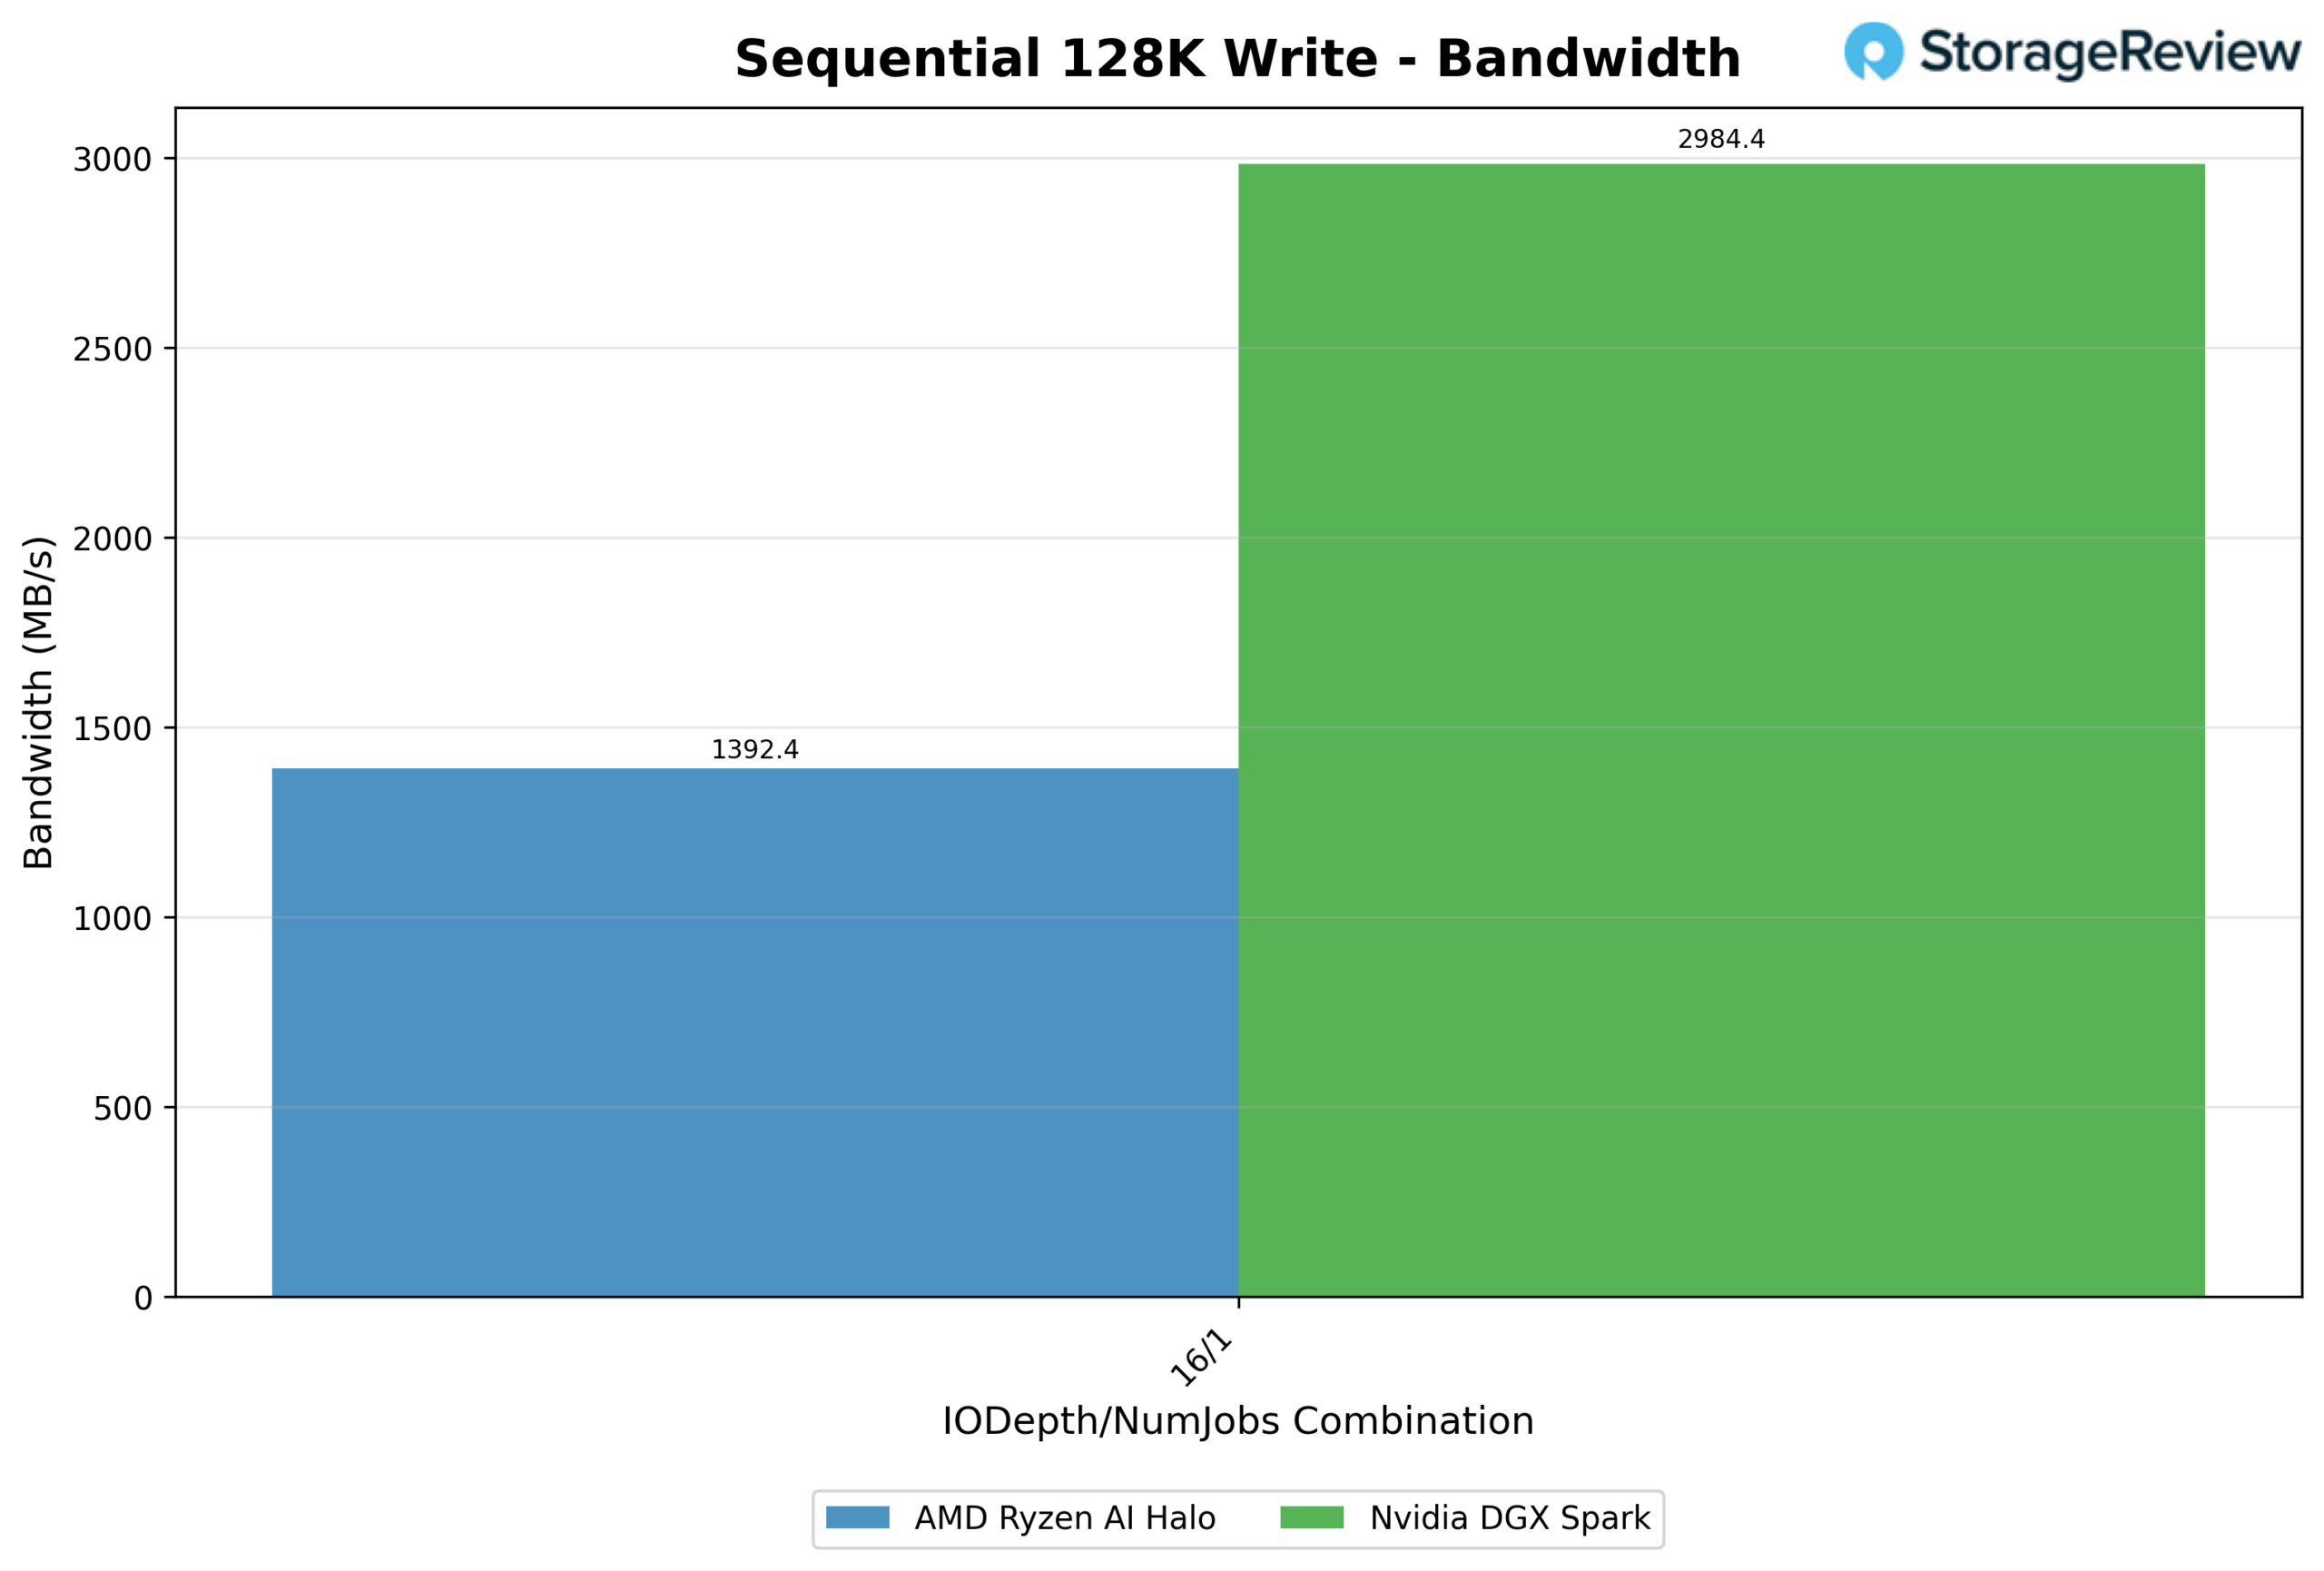
ရေးသားမှုဘက်ခြမ်းကလည်း အလားတူဇာတ်လမ်းတစ်ပုဒ်ကို ပြောပြပါတယ်။ IODepth 16/1 မှာ Spark ဟာ Halo ရဲ့ 1,392.4 MB/s နဲ့ နှိုင်းယှဉ်ရင် 2,984.4 MB/s အထိ ရောက်ရှိခဲ့ပြီး NVIDIA အတွက် 114% အားသာချက်ရှိခဲ့ပါတယ်။ Latency က Spark ကို 0.67 ms နဲ့ နှိုင်းယှဉ်ရင် Halo ရဲ့ 1.436 ms နဲ့ နှိုင်းယှဉ်ရင် ပိုမိုကောင်းမွန်လာခဲ့ပါတယ်။ ဖတ်ရှုမှုရလဒ်တွေနဲ့ ပေါင်းစပ်လိုက်တဲ့အခါ 128K sequential ဟာ Halo နဲ့ နှိုင်းယှဉ်ရင် Spark ရဲ့ အားအကောင်းဆုံး ပြသမှုပဲ ဖြစ်ပါတယ်။
64K ကျပန်းဖတ်ပါ။
Halo ရဲ့ low-queue-depth latency အားသာချက်က ဒီမှာတကယ်ကိုပြသနေပါတယ်။ 1/1 မှာ Halo က 0.051 ms နဲ့ပဲ ဖြေကြားခဲ့ပြီး Spark ရဲ့ 0.275 ms ထက်စာရင် ကျန်ရှိနေတဲ့ request တစ်ခုအတွက် 5 ဆကျော်ပိုမြန်ပါတယ်။ အဲဒီကွာဟချက်က low-to-mid queue depths တွေမှာ ရှိနေပြီး Halo က 0.2 ms အောက်မှာ အတော်လေးကို track လုပ်နေချိန်မှာ Spark ကတော့ sweep အများစုအတွက် 0.2–0.45 ms အတွင်းမှာပဲ ရှိနေတာပါ။
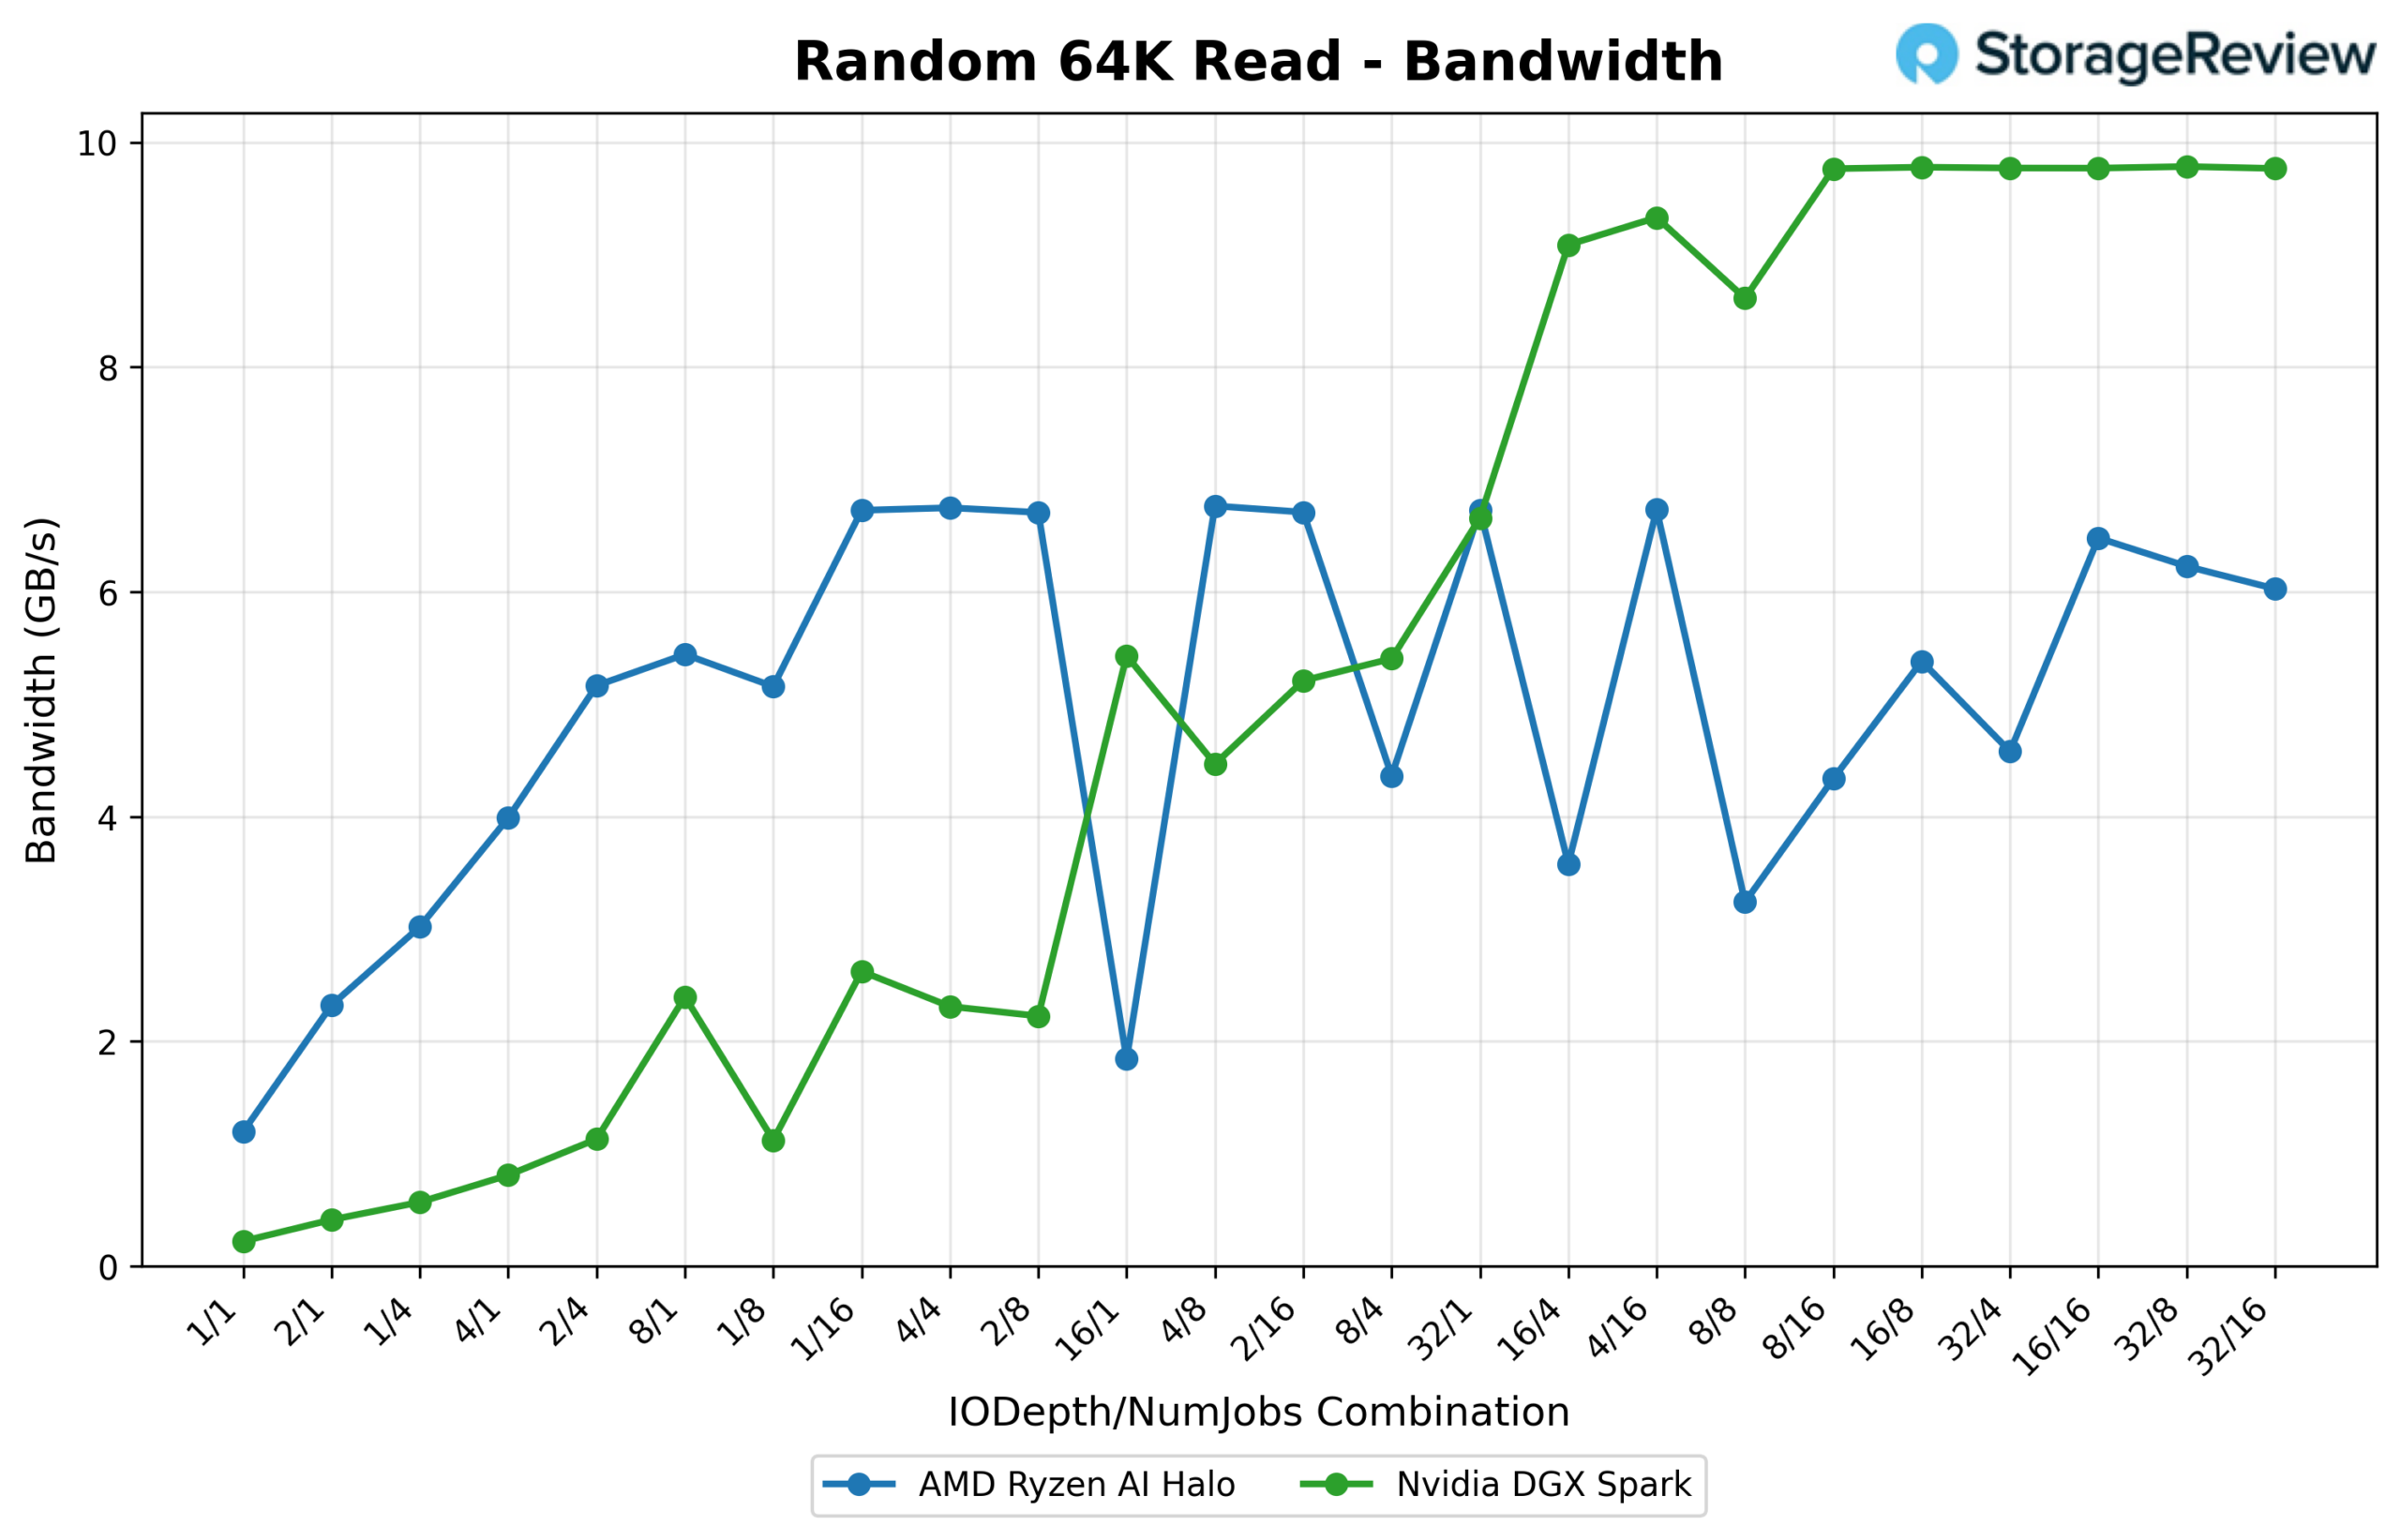
ဇာတ်လမ်းကတော့ စကေးပြောင်းပြန်ပါပဲ။ queue depth နဲ့ thread count က 16/4 လောက်ကို ကျော်လွန်လာတာနဲ့အမျှ Spark ရဲ့ bandwidth က ပြိုကွဲသွားပြီး 8/16 ကနေစပြီး 9.8 GB/s လောက်မှာ ရပ်တန့်သွားပြီး 32/8 မှာ 10,019.1 MB/s (160.3K IOPS) အထိ ရောက်ရှိသွားပါတယ်။ Halo ကတော့ အဲဒီ အမြင့်ဆုံးအဆင့်ကို မရောက်ပါဘူး။ 6.0–6.9 GB/s အတိုင်းအတာအတွင်းမှာပဲ ရှိနေပြီး 4/8 မှာ 6,926.5 MB/s (110.8K IOPS) အထိ အမြင့်ဆုံး ရောက်ရှိသွားပါတယ်။ သူ့ရဲ့ bandwidth curve က သိသိသာသာ ပိုပြီး မတည်ငြိမ်ဘဲ depth/thread ပေါင်းစပ်မှုပေါ်မူတည်ပြီး ချောမွေ့စွာ မြင့်တက်မယ့်အစား 2 ကနေ 6.8 GB/s အကြားမှာပဲ ရှိပါတယ်။
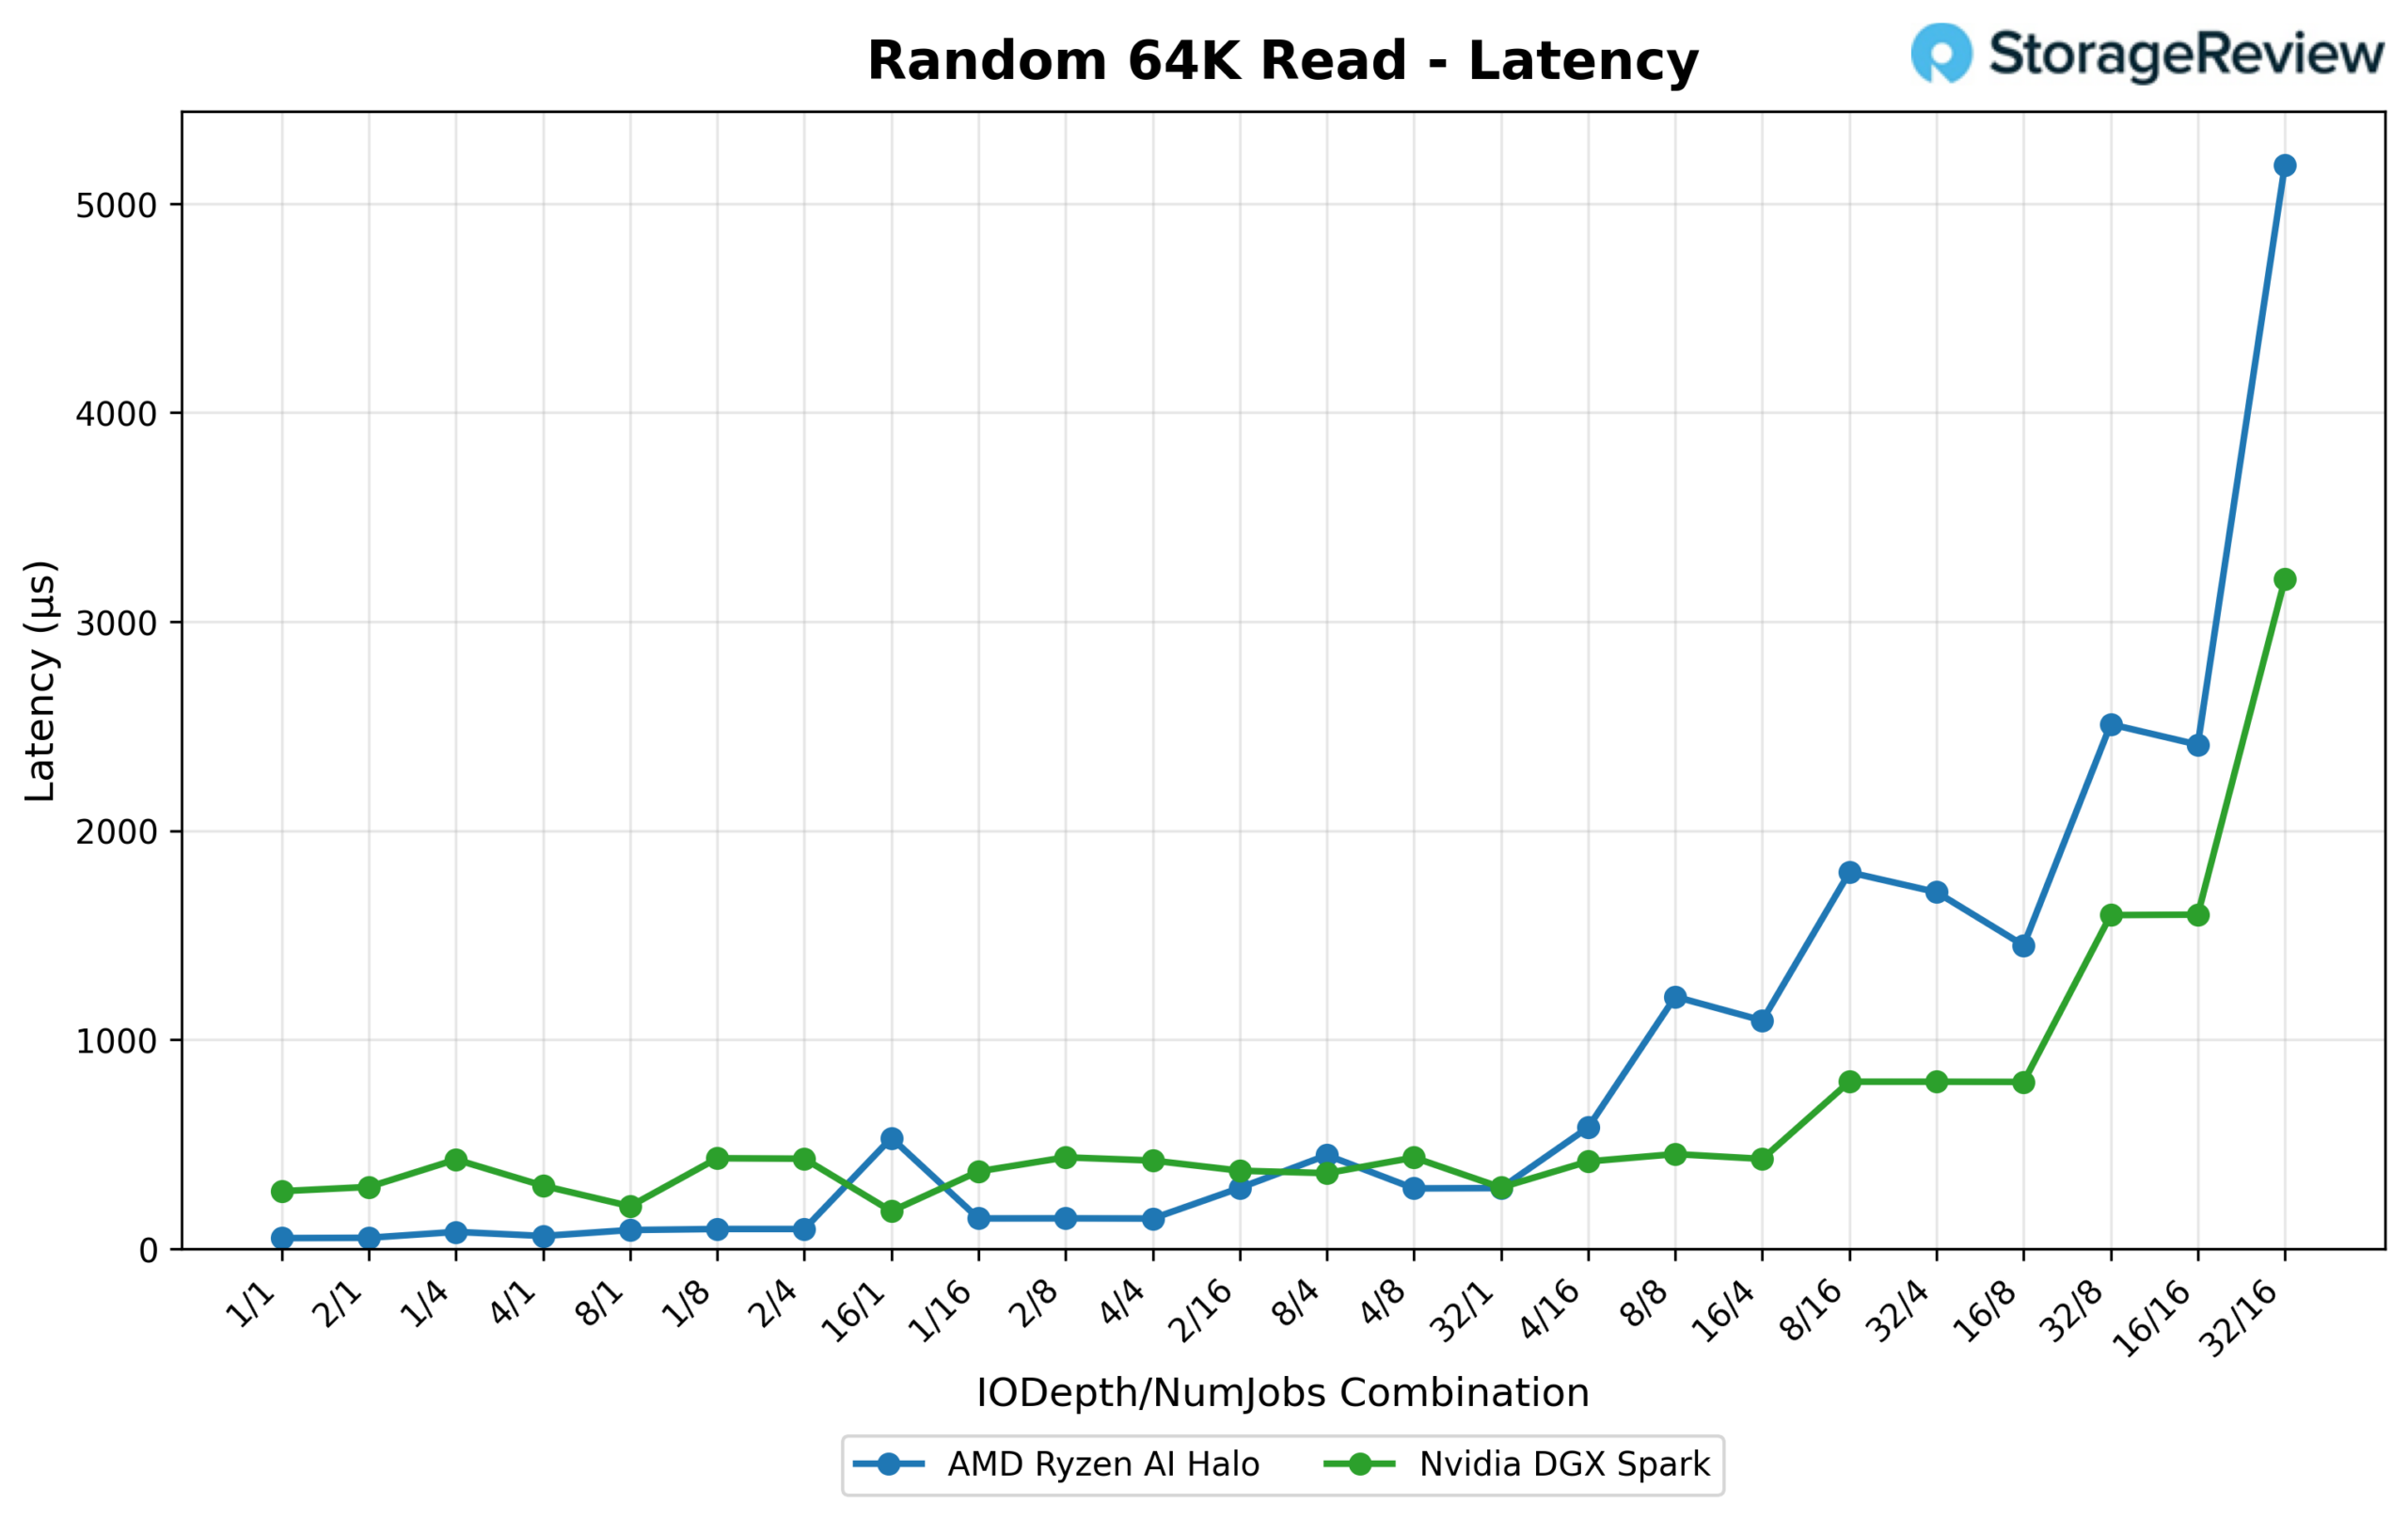
အပြည့်အဝ saturation မှာ latency ကလည်း Spark အတွက် အကျိုးရှိပါတယ်- 32/16 မှာ Halo ရဲ့ ပျမ်းမျှ latency က 5.185 ms အထိ မြင့်တက်လာပြီး Spark ရဲ့ 3.204 ms နဲ့ နှိုင်းယှဉ်ရင် Halo ဟာ queue အပြည့်အဝ load လုပ်လိုက်တာနဲ့ tail အပြုအမူ ပိုဆိုးသွားပြီး low-queue-depth responsiveness အတွက် အကျိုးရှိစေပါတယ်။
64K ကျပန်းရေးပါ။
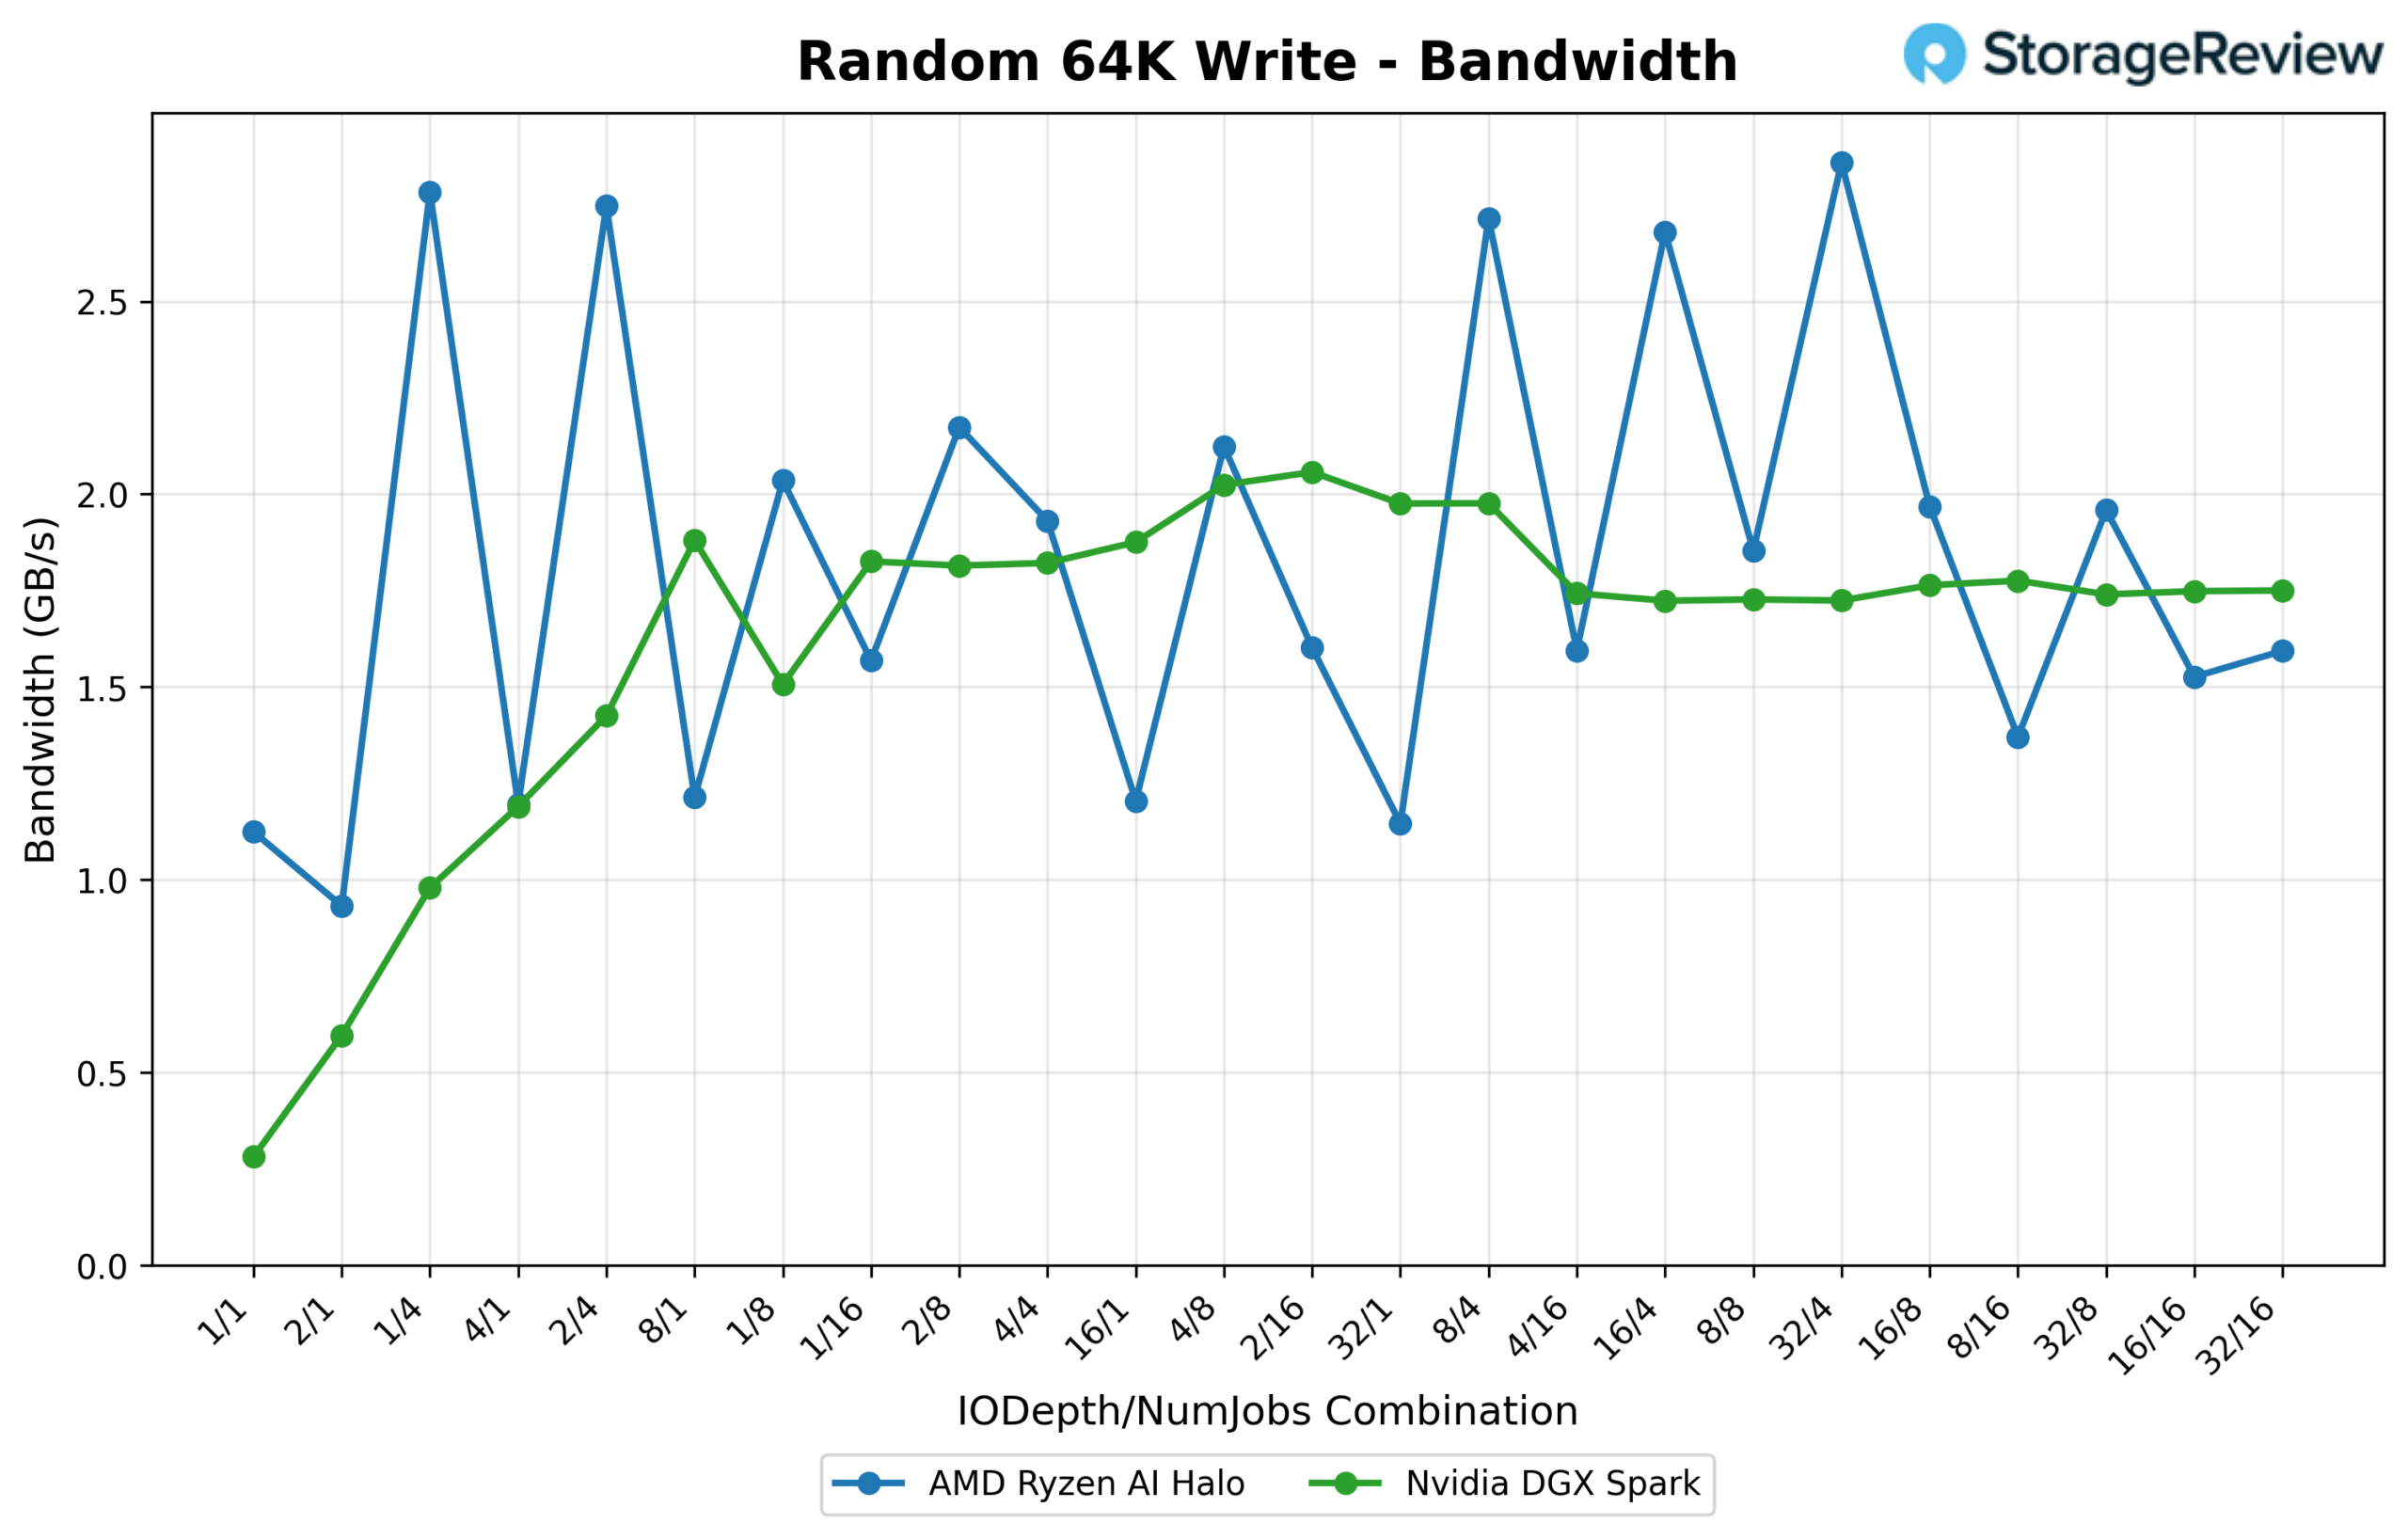
ပလက်ဖောင်းနှစ်ခုကြားတွင် read bandwidth ထက် Random 64K write bandwidth သည် ပိုမိုနီးကပ်သော်လည်း curves ပုံသဏ္ဍာန်များမှာ အလွန်ကွာခြားပါသည်။ Halo ၏ bandwidth သည် ပိုမိုစူးရှသည်- ၎င်းသည် 2.5 GB/s အထက်သို့ အကြိမ်ကြိမ်ခုန်တက်ပြီးနောက် (32/4 တွင် 2,929.1 MB/s / 46.9K IOPS တွင် အမြင့်ဆုံးရောက်ရှိသည်) နှင့် ဆက်စပ်ပေါင်းစပ်မှုများတွင် 1.1–1.5 GB/s အပိုင်းအခြားသို့ ပြန်လည်ကျဆင်းသွားသည်။ Spark သည် နှိုင်းယှဉ်လျှင် တည်ငြိမ်ပြီး အများစုအတွက် 1.7–2.0 GB/s band တွင် အခြေချပြီး 2/16 တွင် 2,106.6 MB/s (33.7K IOPS) တွင် အမြင့်ဆုံးရောက်ရှိသည်။
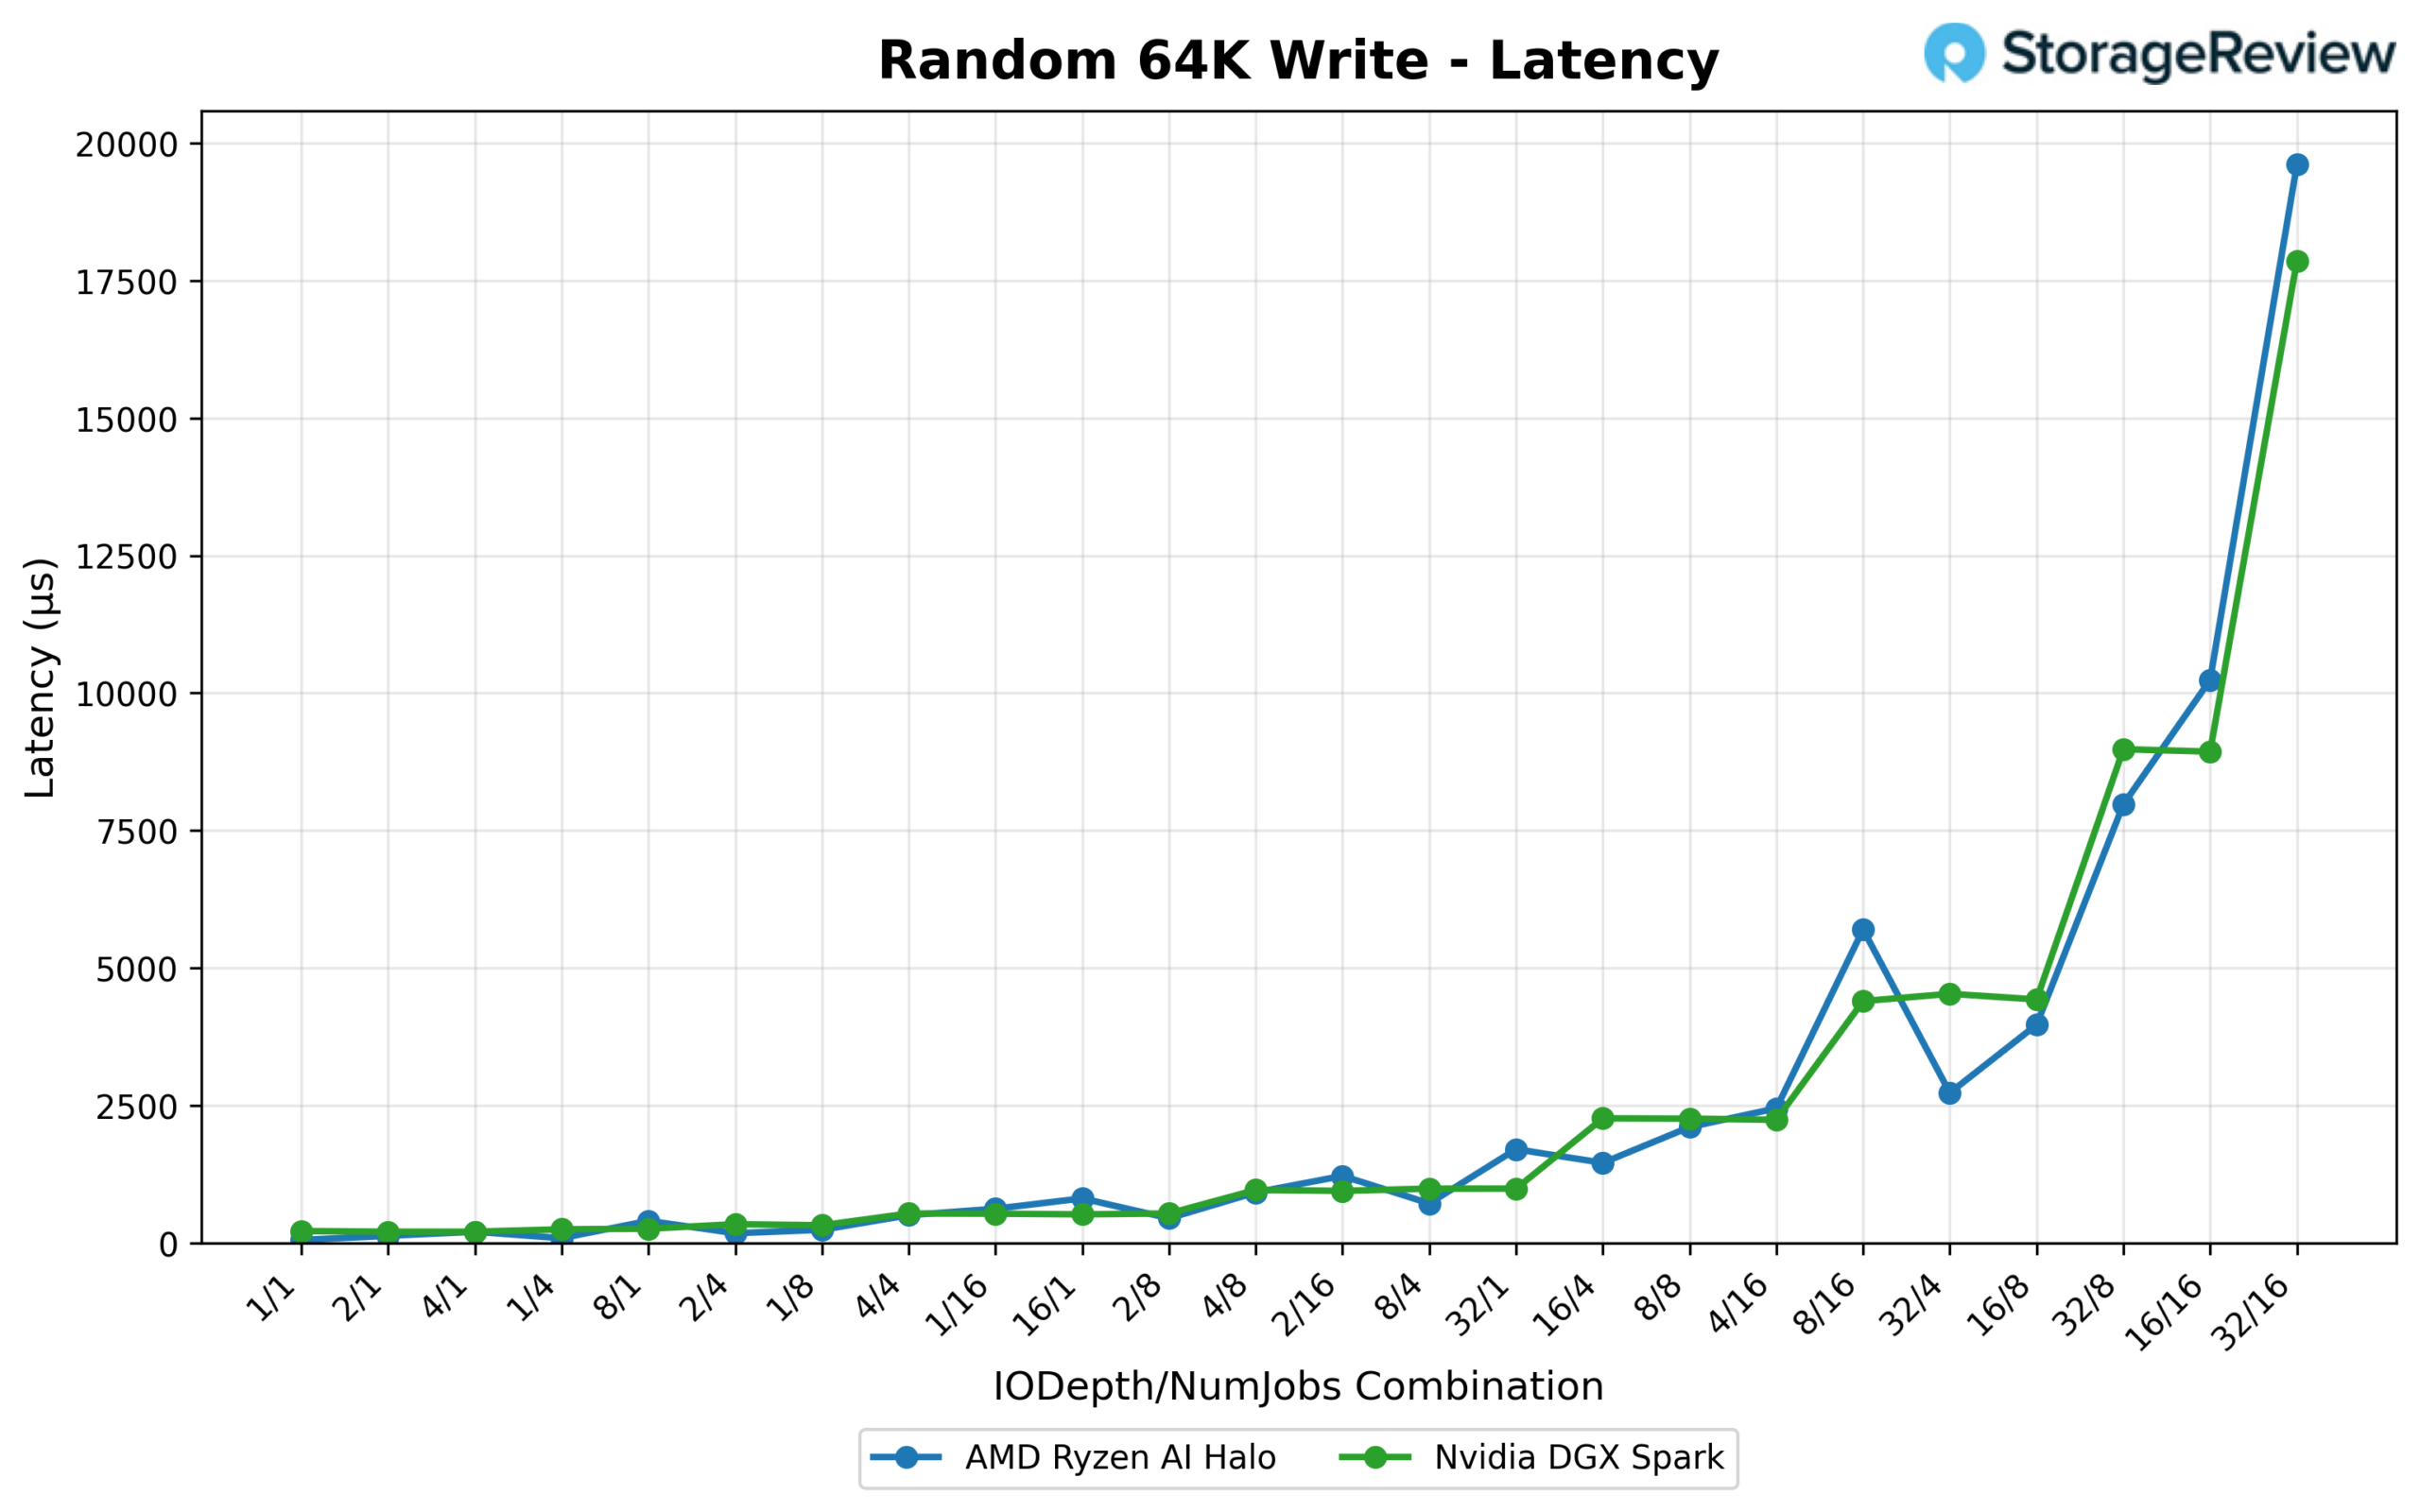
Latency သည် 64K read pattern ကို ထင်ဟပ်စေသည်- Halo သည် queue depth နည်းသောအခါတွင် သိသိသာသာ ပိုမြန်သည် (1/1 တွင် 0.054 ms vs. Spark အတွက် 0.217 ms)၊ queue depth နှင့် thread count သည် double digits အထိ မြင့်တက်လာသည်နှင့်အမျှ drive နှစ်ခုစလုံးသည် သိသိသာသာ ယိုယွင်းပျက်စီးသွားသည်။ full saturation (32/16) တွင် Halo ၏ latency သည် Spark ၏ 17.857 ms နှင့် နှိုင်းယှဉ်ပါက 19.611 ms သို့ ရောက်ရှိသည်။ drive နှစ်ခုစလုံးသည် ဤအချိန်တွင် write-amplification stress မြင့်မားနေပြီး Halo သည် curve ၏ထိပ်ဆုံးတွင် အနည်းငယ်ပိုဆိုးသည်။
၁၆K အစဉ်လိုက်ဖတ်ရှုခြင်း
bandwidth ဟာ အများစုမှာ မြင့်မားနေဆဲဖြစ်ပြီး depth/thread ပေါင်းစပ်မှုပေါ်မူတည်ပြီး drive နှစ်ခုစလုံးဟာ 1–8 GB/s အကြား မြန်ဆန်ပါတယ်။ Spark က 32/1 မှာ 8,069.3 MB/s (516.4K IOPS) အထိ ရောက်ရှိပြီး Halo က 8/4 မှာ 6,715.8 MB/s (429.8K IOPS) အထိ ရောက်ရှိပါတယ်။
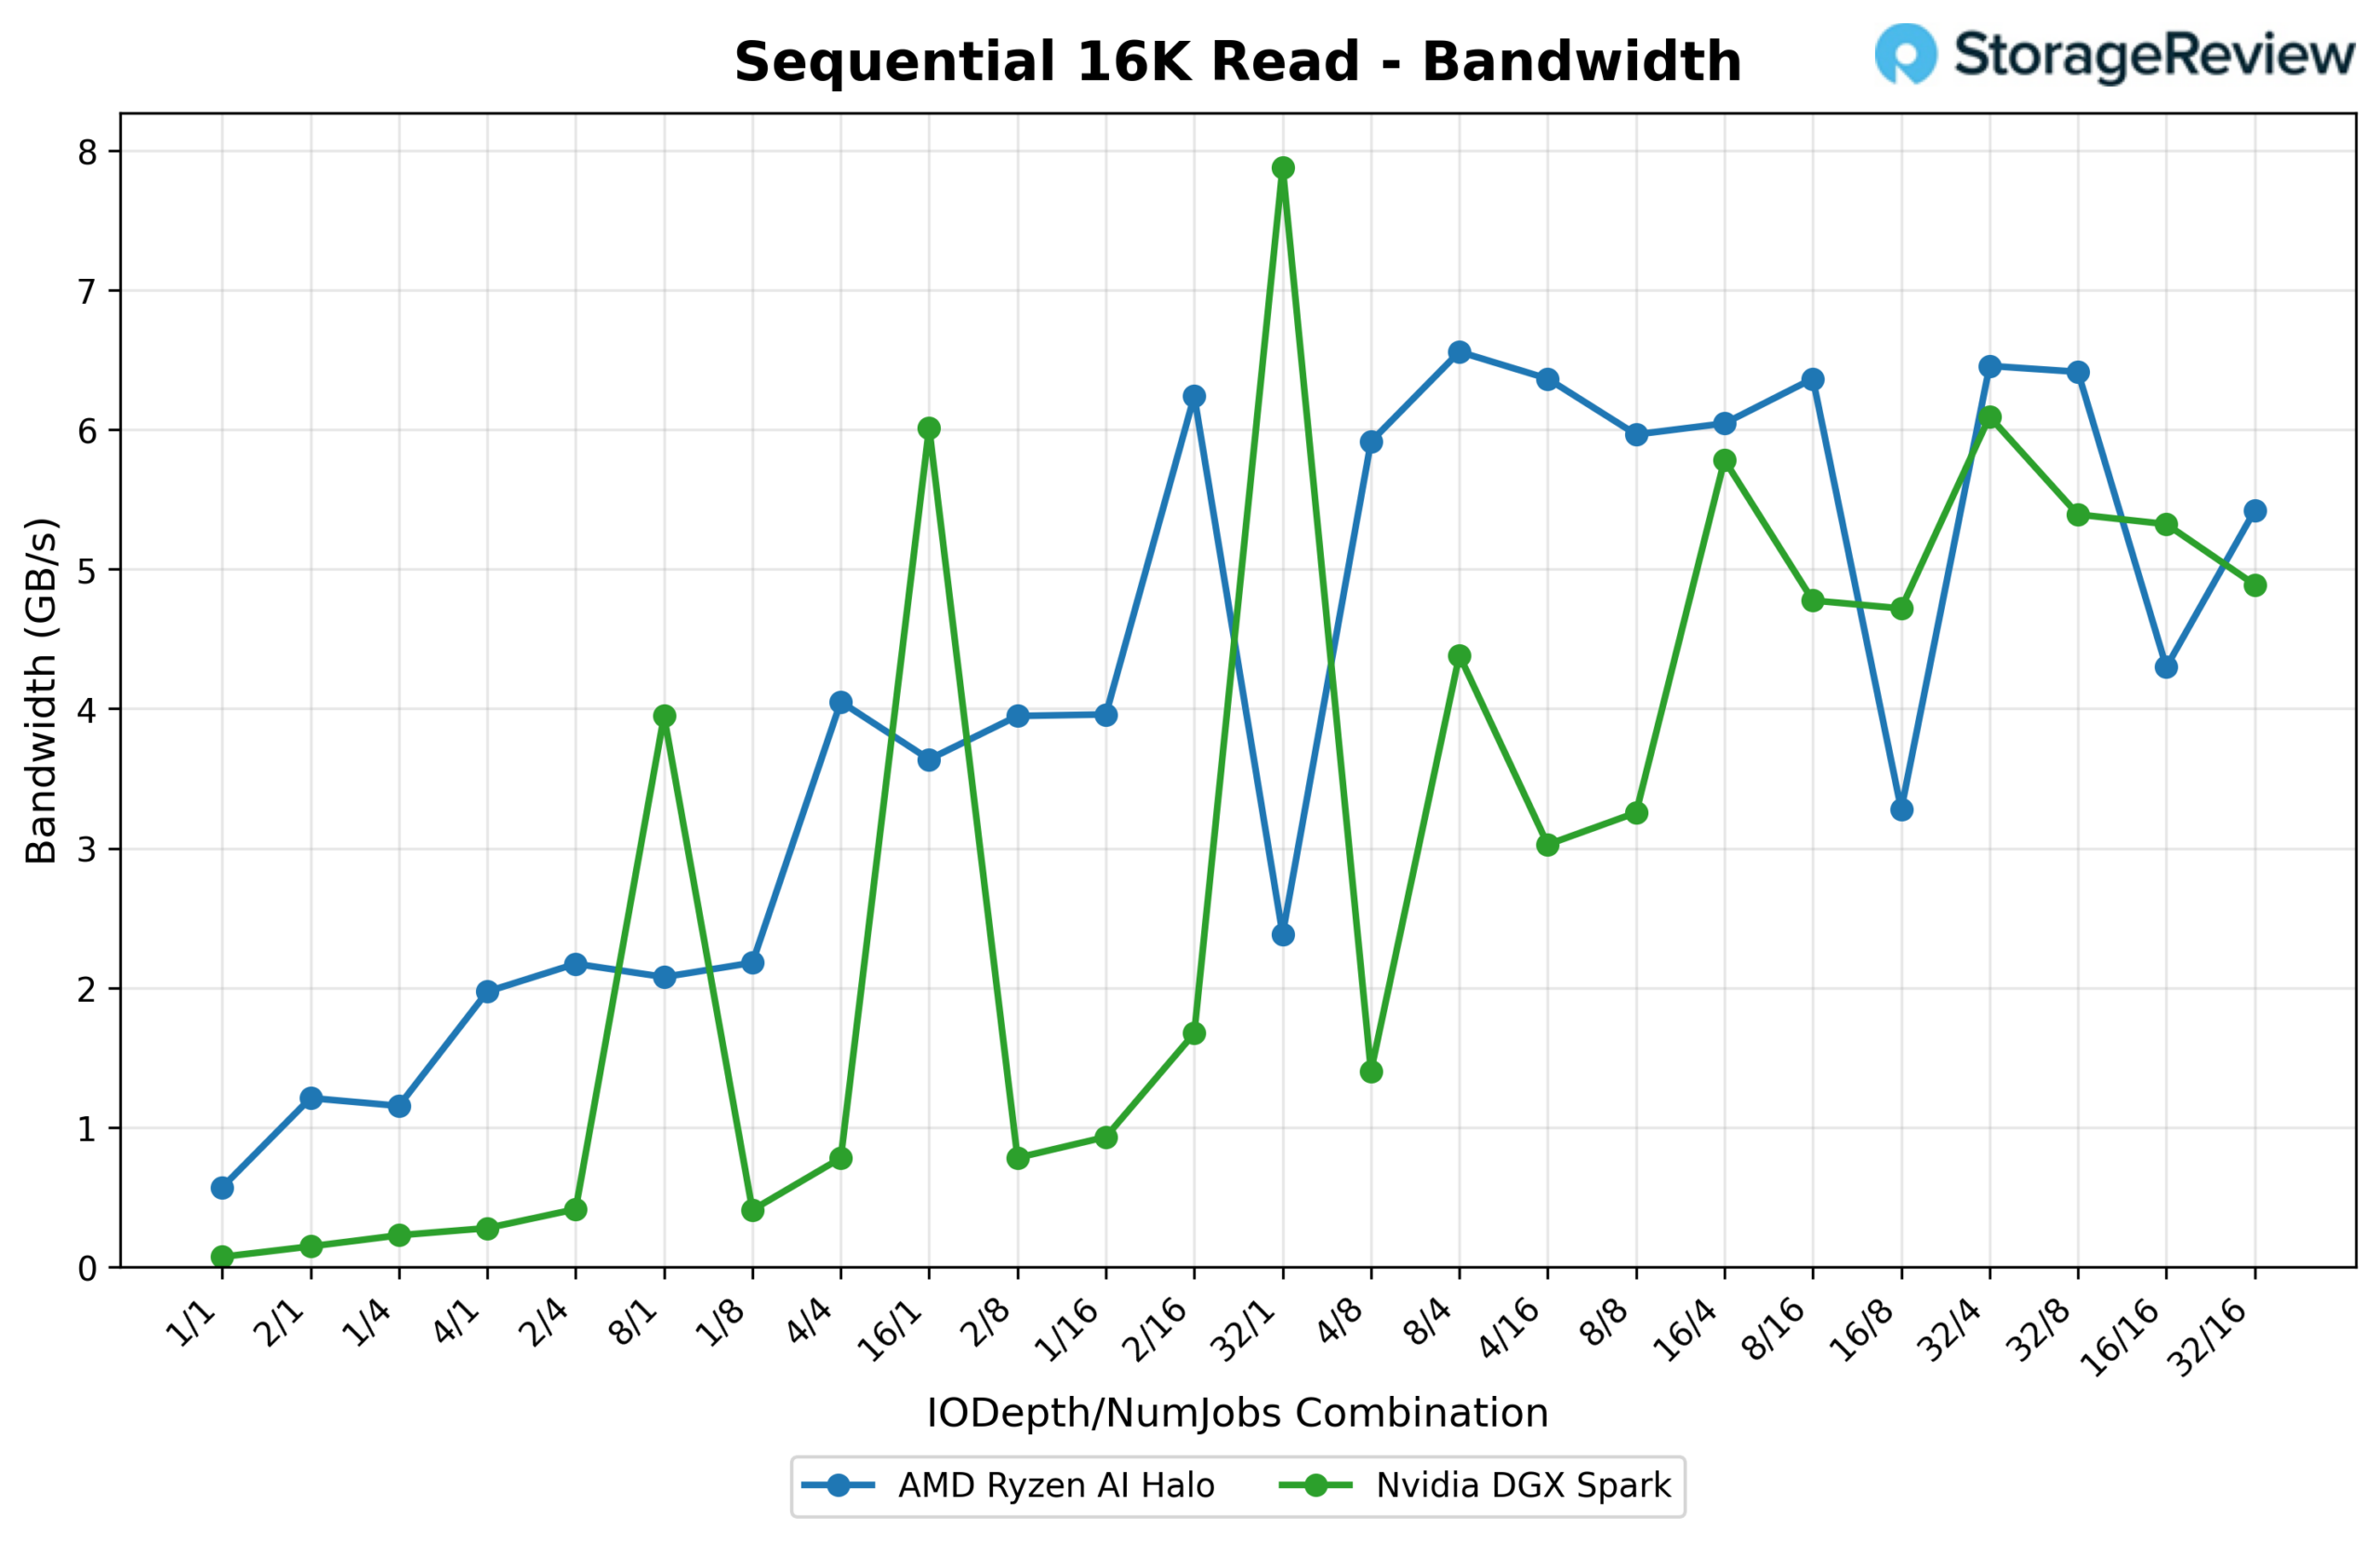
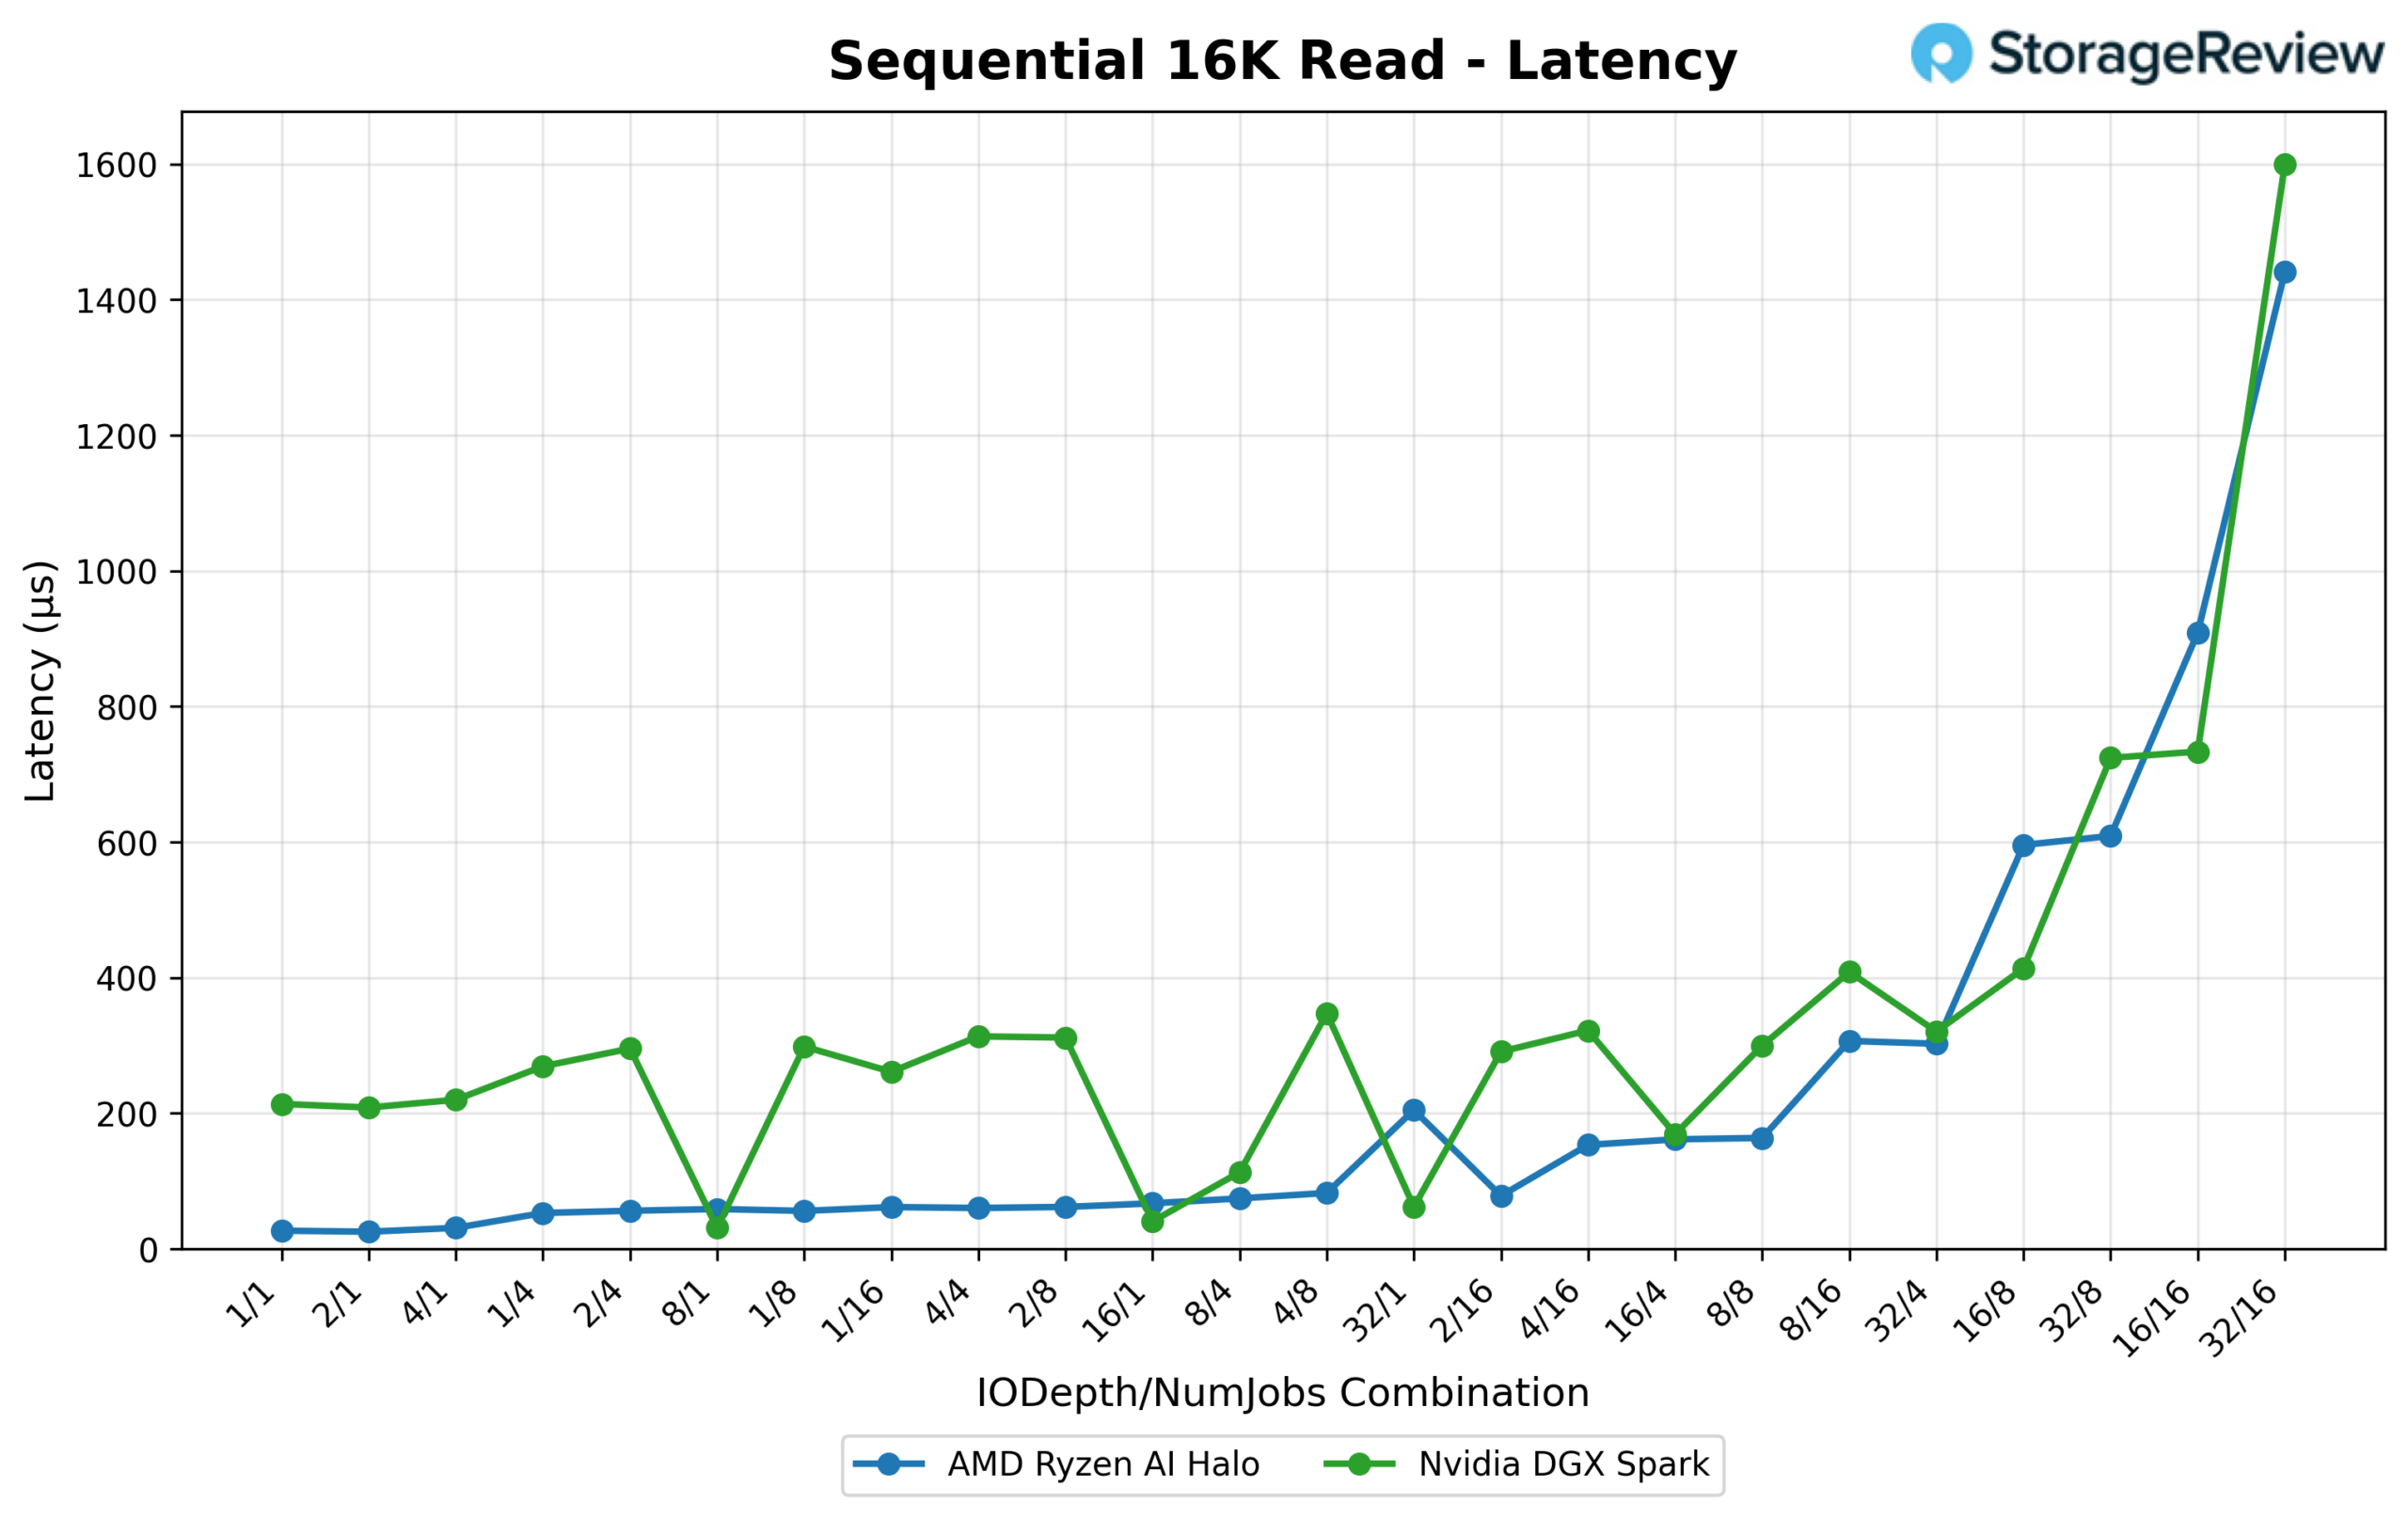
Latency က Halo ကို queue ရဲ့ထိပ်ဆုံးကလွဲရင် နေရာတိုင်းမှာ အကျိုးပြုပါတယ်။ 1/1 မှာ Halo က 0.027 ms နဲ့ တုံ့ပြန်ပြီး Spark ရဲ့ 0.214 ms နဲ့ ယှဉ်ရင် ပိုကောင်းပြီး Halo က အများစုမှာ latency နိမ့်ကျနေပါတယ်။ အနက်ရှိုင်းဆုံးပေါင်းစပ်မှုတွေမှာသာ gap ပိတ်သွားပါတယ်။ 32/16 မှာ Halo ရဲ့ ပျမ်းမျှ latency 1.441 ms ဟာ Spark ရဲ့ 1.599 ms အောက်ကို ရောက်သွားတာကြောင့် Halo ရဲ့ latency curve က saturation မှာ Spark ကို မကျော်နိုင်တဲ့ ရှားရှားပါးပါးအမှတ်တွေထဲက တစ်ခုပါ။
16K အစဉ်လိုက်ရေးသားခြင်း
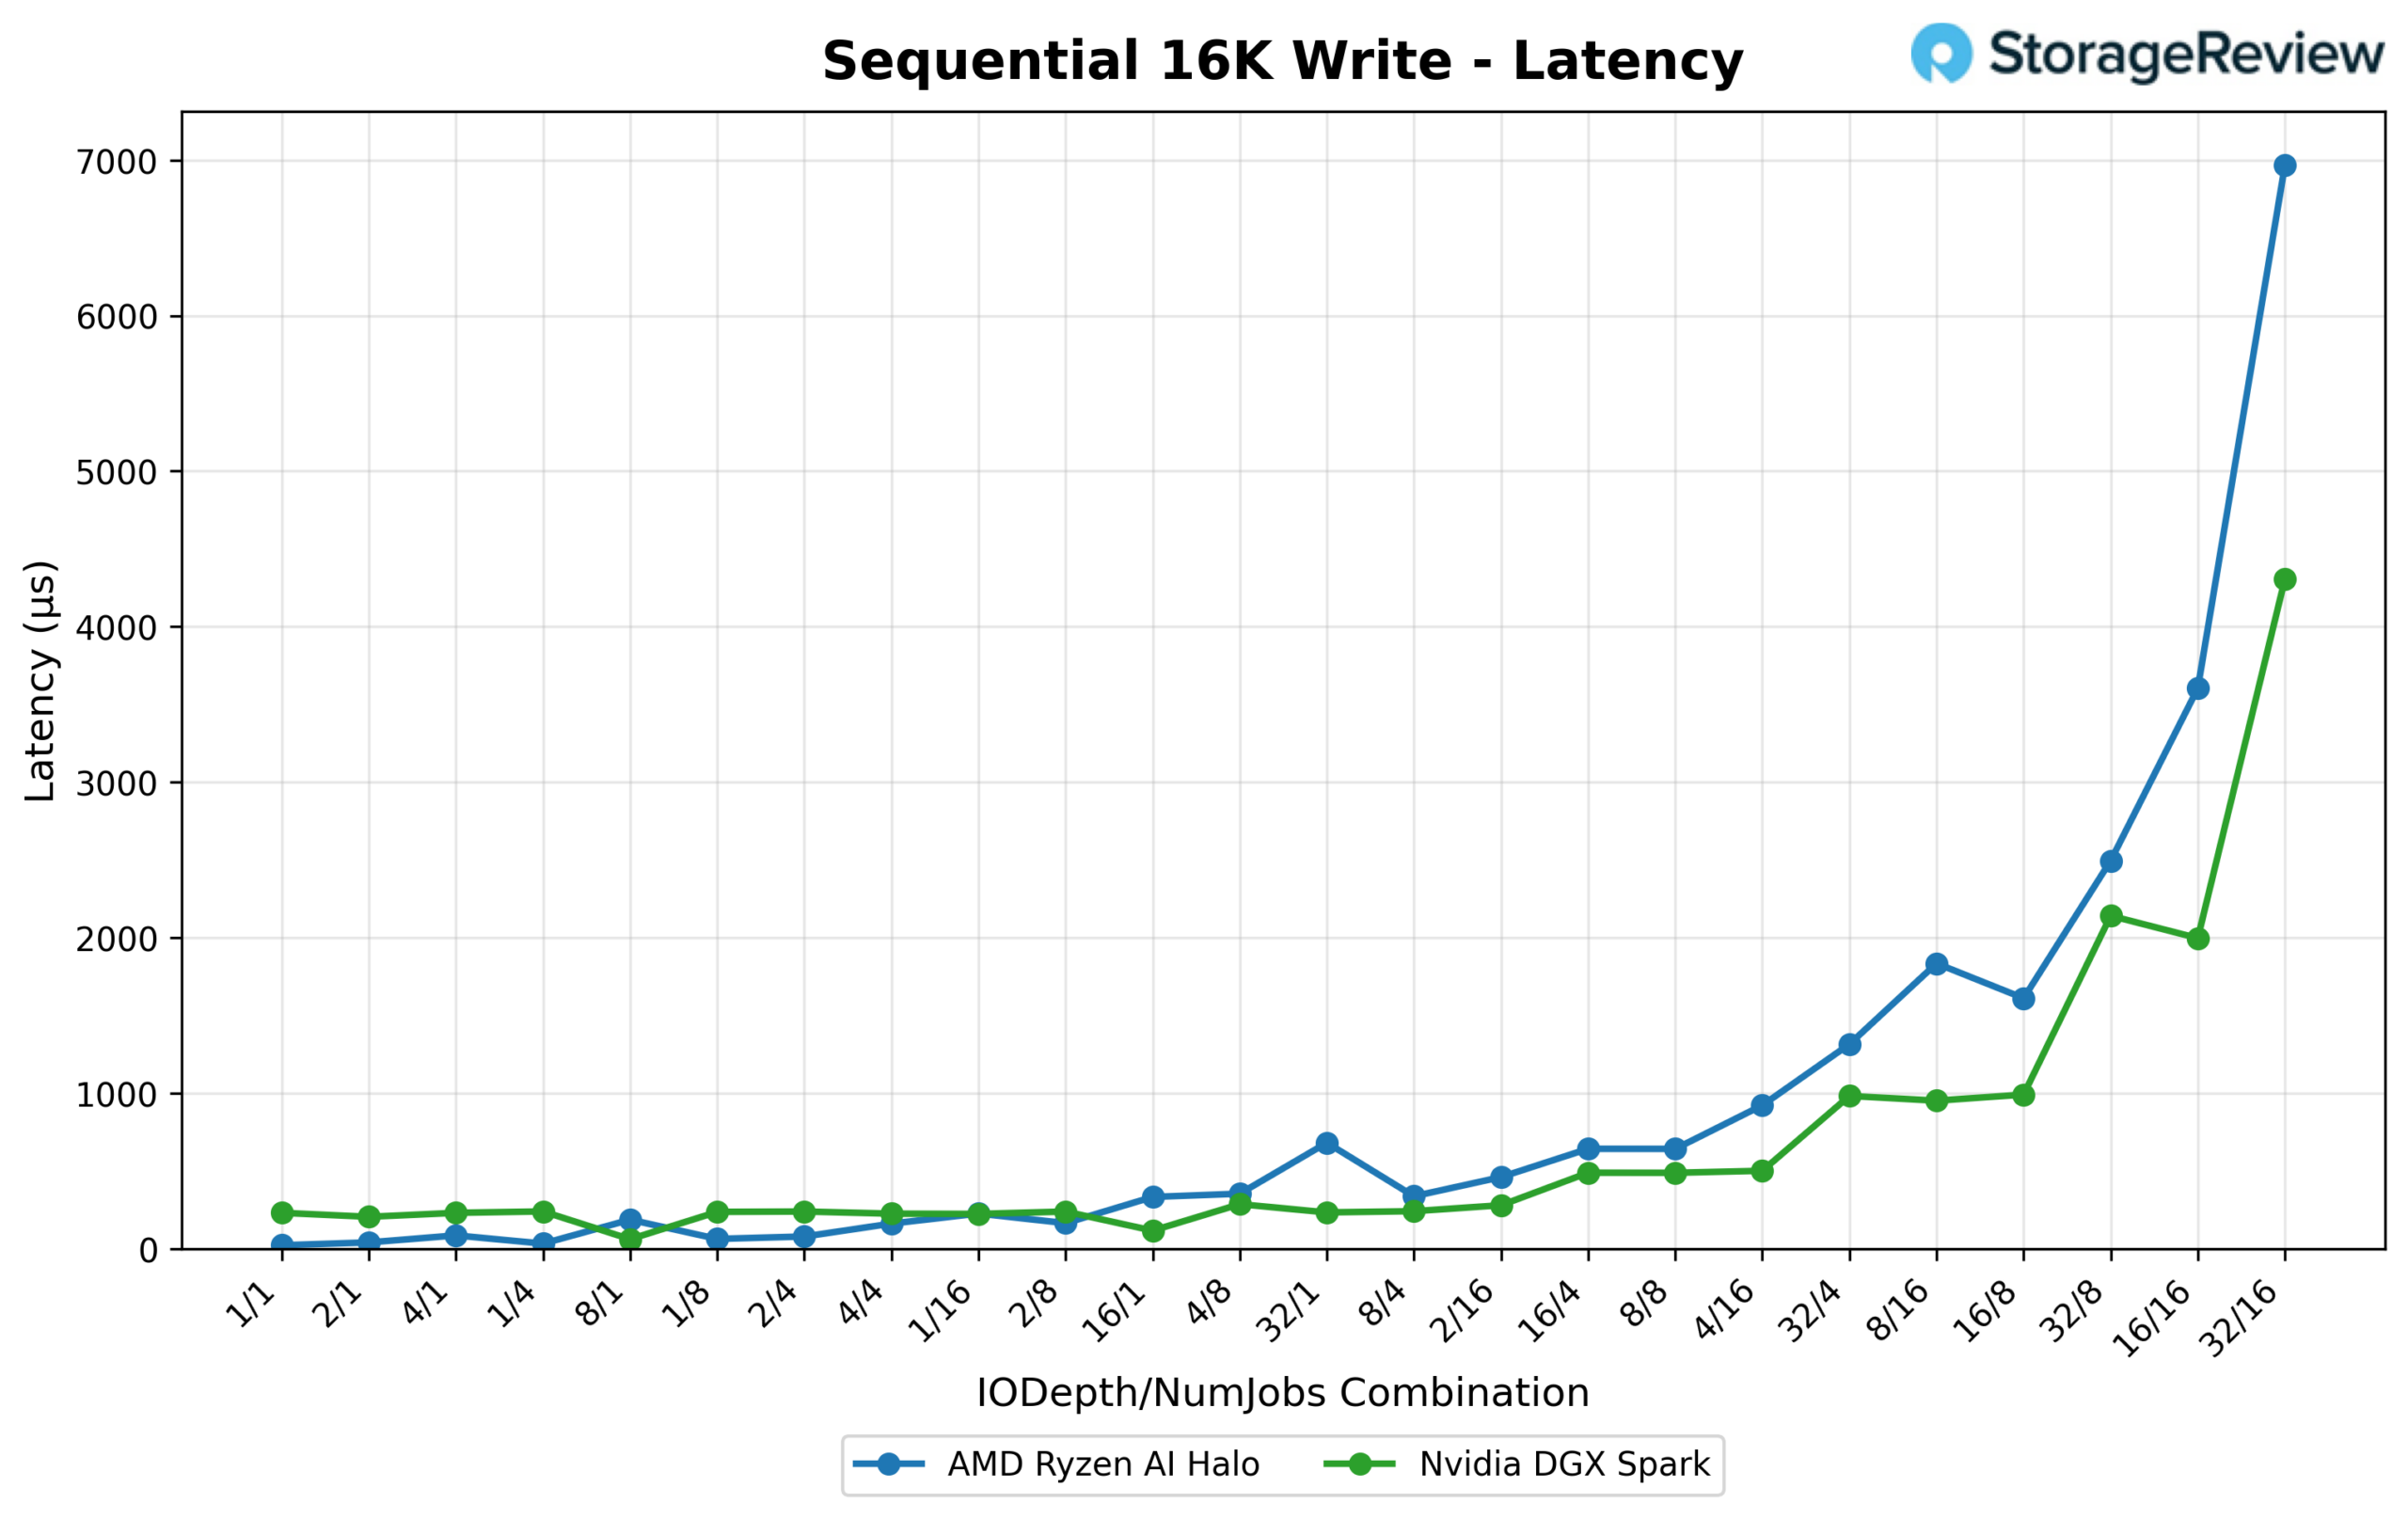
Bandwidth ကလည်း ဒီမှာ နီးစပ်ပါတယ်။ Spark က 16/1 မှာ 2,141.6 MB/s (137.1K IOPS) အမြင့်ဆုံးရောက်ပြီး Halo ကတော့ 1,970.9 MB/s (126.1K IOPS) 1/8 မှာ နောက်ကျမကျန်ပါဘူး။
Latency က နှစ်ခု သိသိသာသာ ကွာခြားတဲ့နေရာပါ။ Halo က queue အနက်နည်းတဲ့နေရာမှာ (1/1 မှာ 0.022 ms နဲ့ Spark ရဲ့ 0.231 ms ) မှာ အရမ်းစောပြီး စတင်ပေမယ့် queue ပြည့်သွားတာနဲ့အမျှ latency curve က ပြင်းထန်စွာ မြင့်တက်လာပါတယ်။ 32/16 မှာတော့ Halo ရဲ့ ပျမ်းမျှ latency က 6.967 ms အထိ မြင့်တက်လာပြီး Spark ရဲ့ 4.306 ms ထက် အများကြီး ကျော်လွန်သွားပါတယ်။ Halo ရဲ့ curve ကလည်း ခန့်မှန်းရခက်ပြီး Spark က အလယ်အလတ်တန်းစား ပေါင်းစပ်မှုတွေမှာ သိသိသာသာ မြင့်တက်လာပါတယ်။
16K ကျပန်းဖတ်ပါ။
ဒါက Halo ရဲ့ ပိုမိုကောင်းမွန်တဲ့ ပြသမှုတွေထဲက တစ်ခုပါ။ တကယ်တမ်းမှာ 32/16 မှာ 6,609.4 MB/s (423.0K IOPS) မြင့်မားတဲ့ peak bandwidth ကို ပေးစွမ်းနိုင်ပြီး Spark ရဲ့ 6,082.6 MB/s (389.3K IOPS) ကတော့ အတူတူပါပဲ။
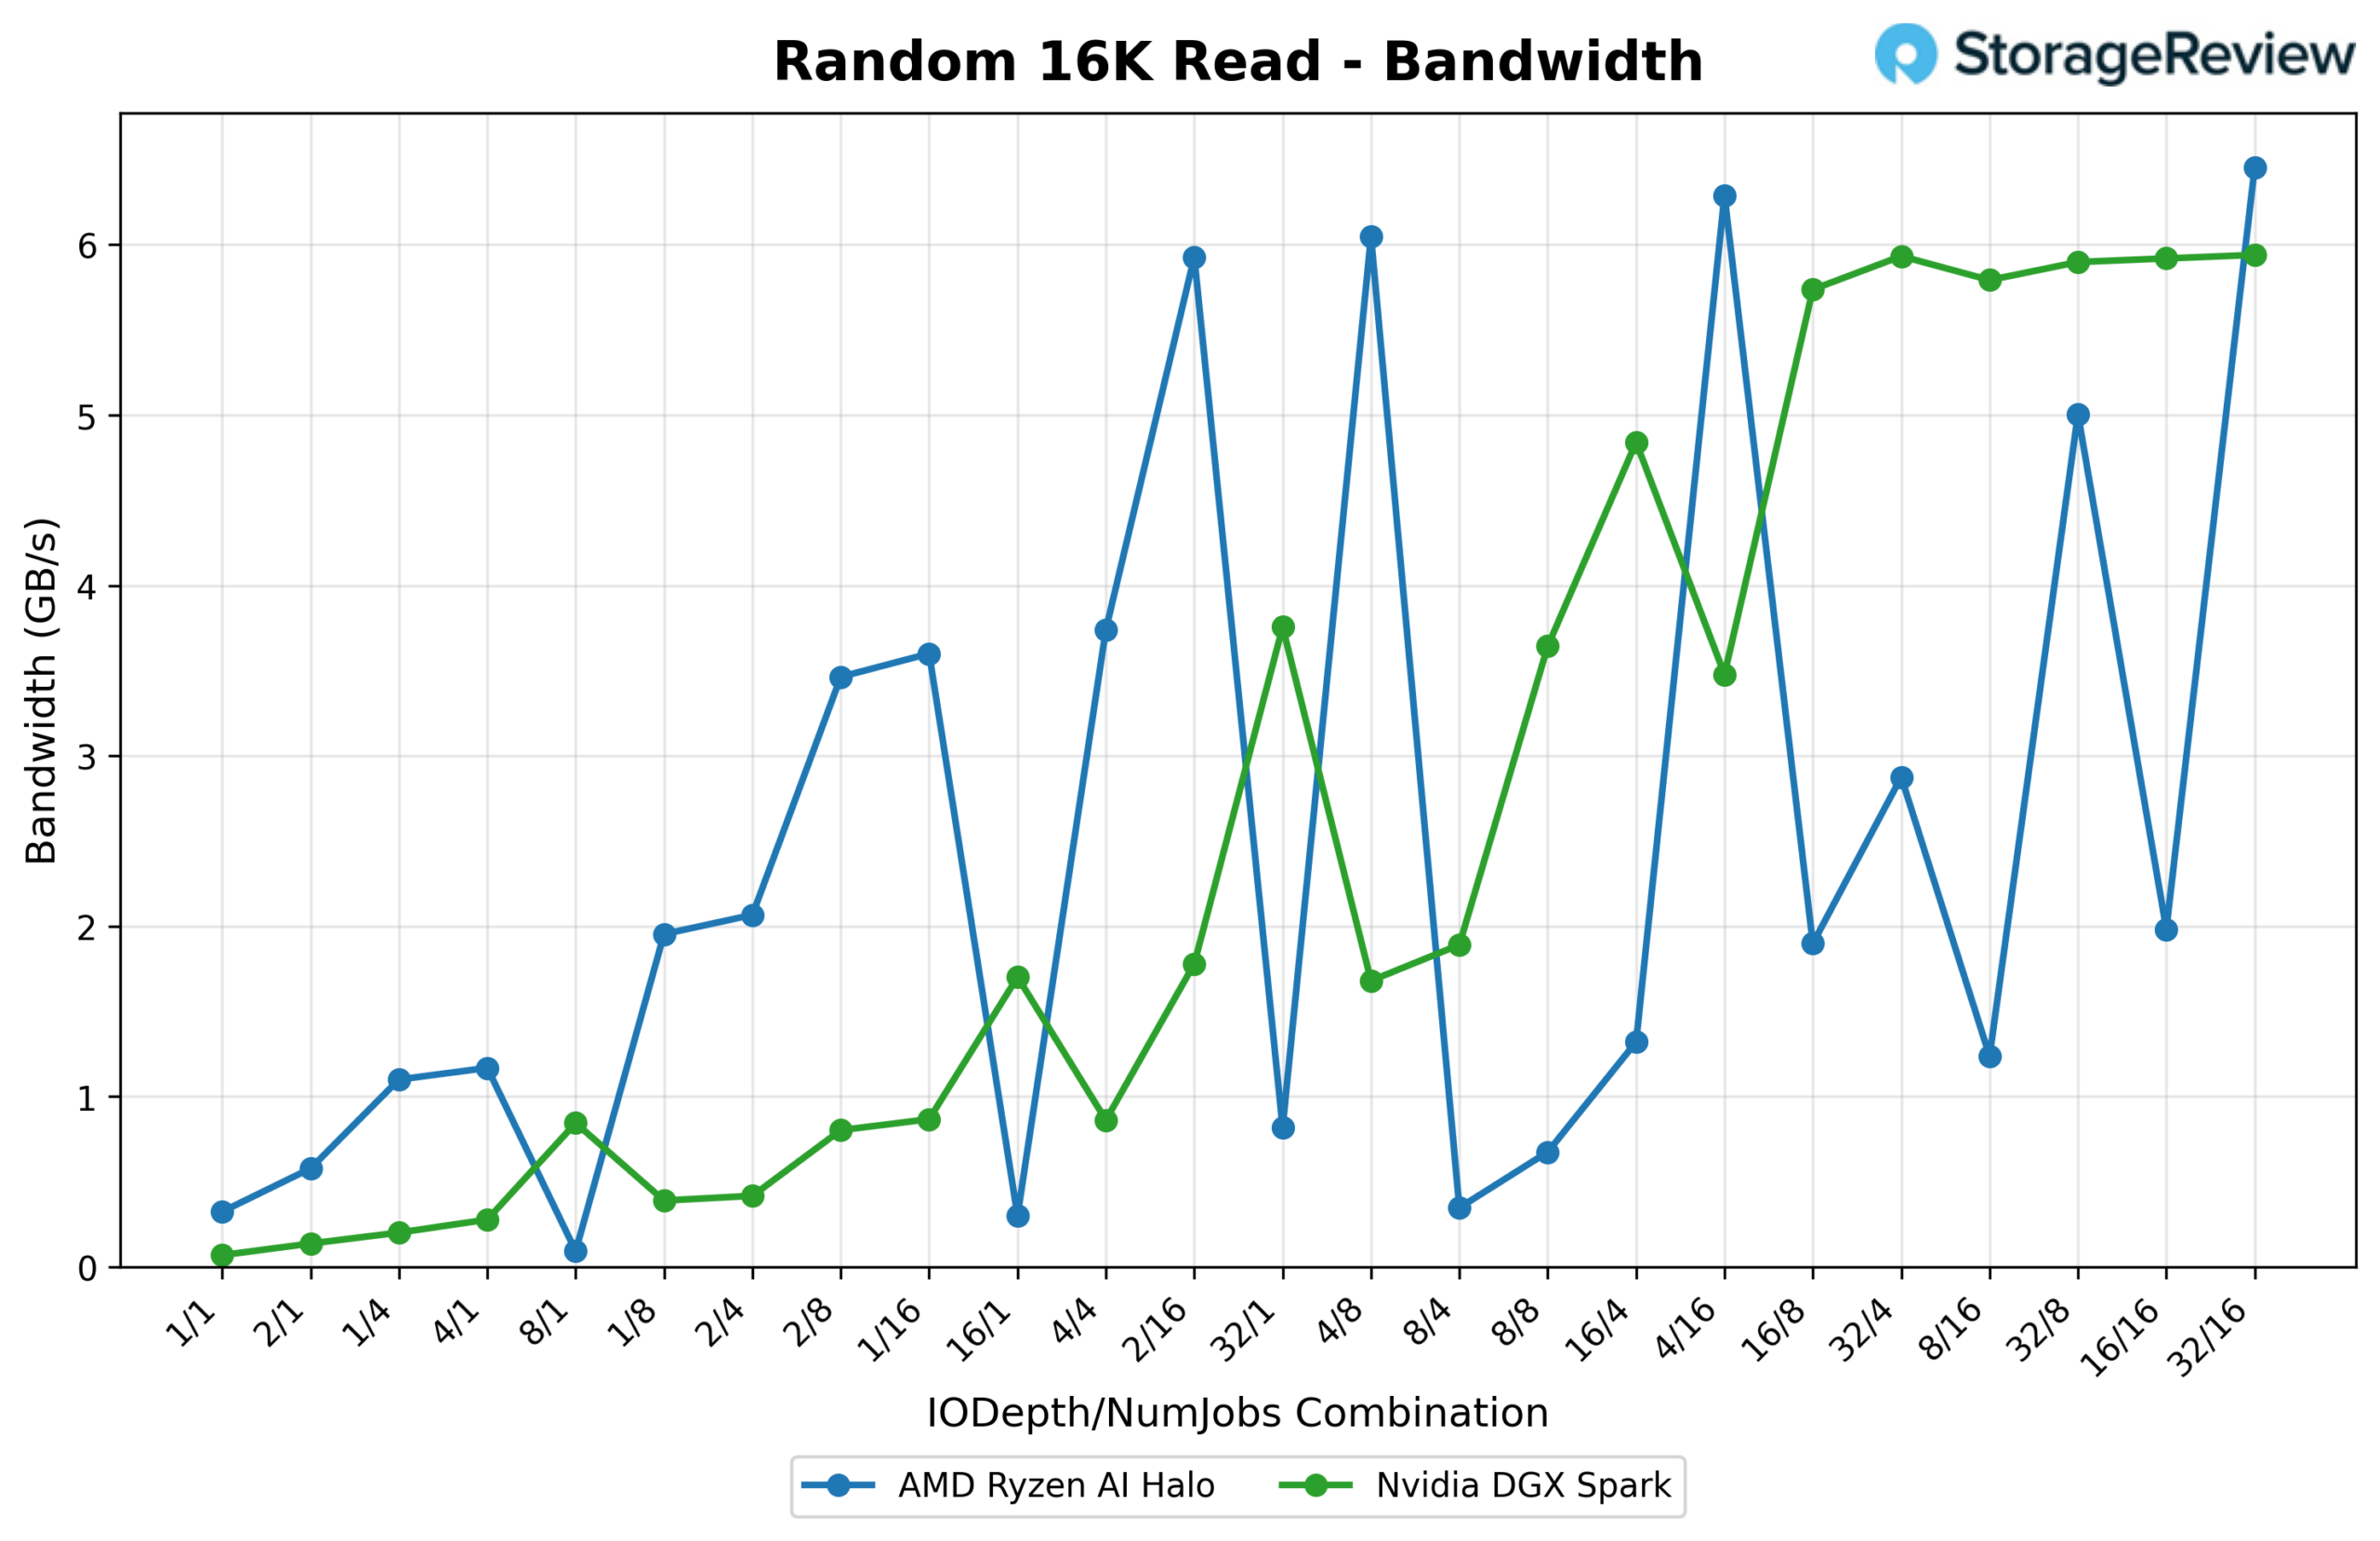
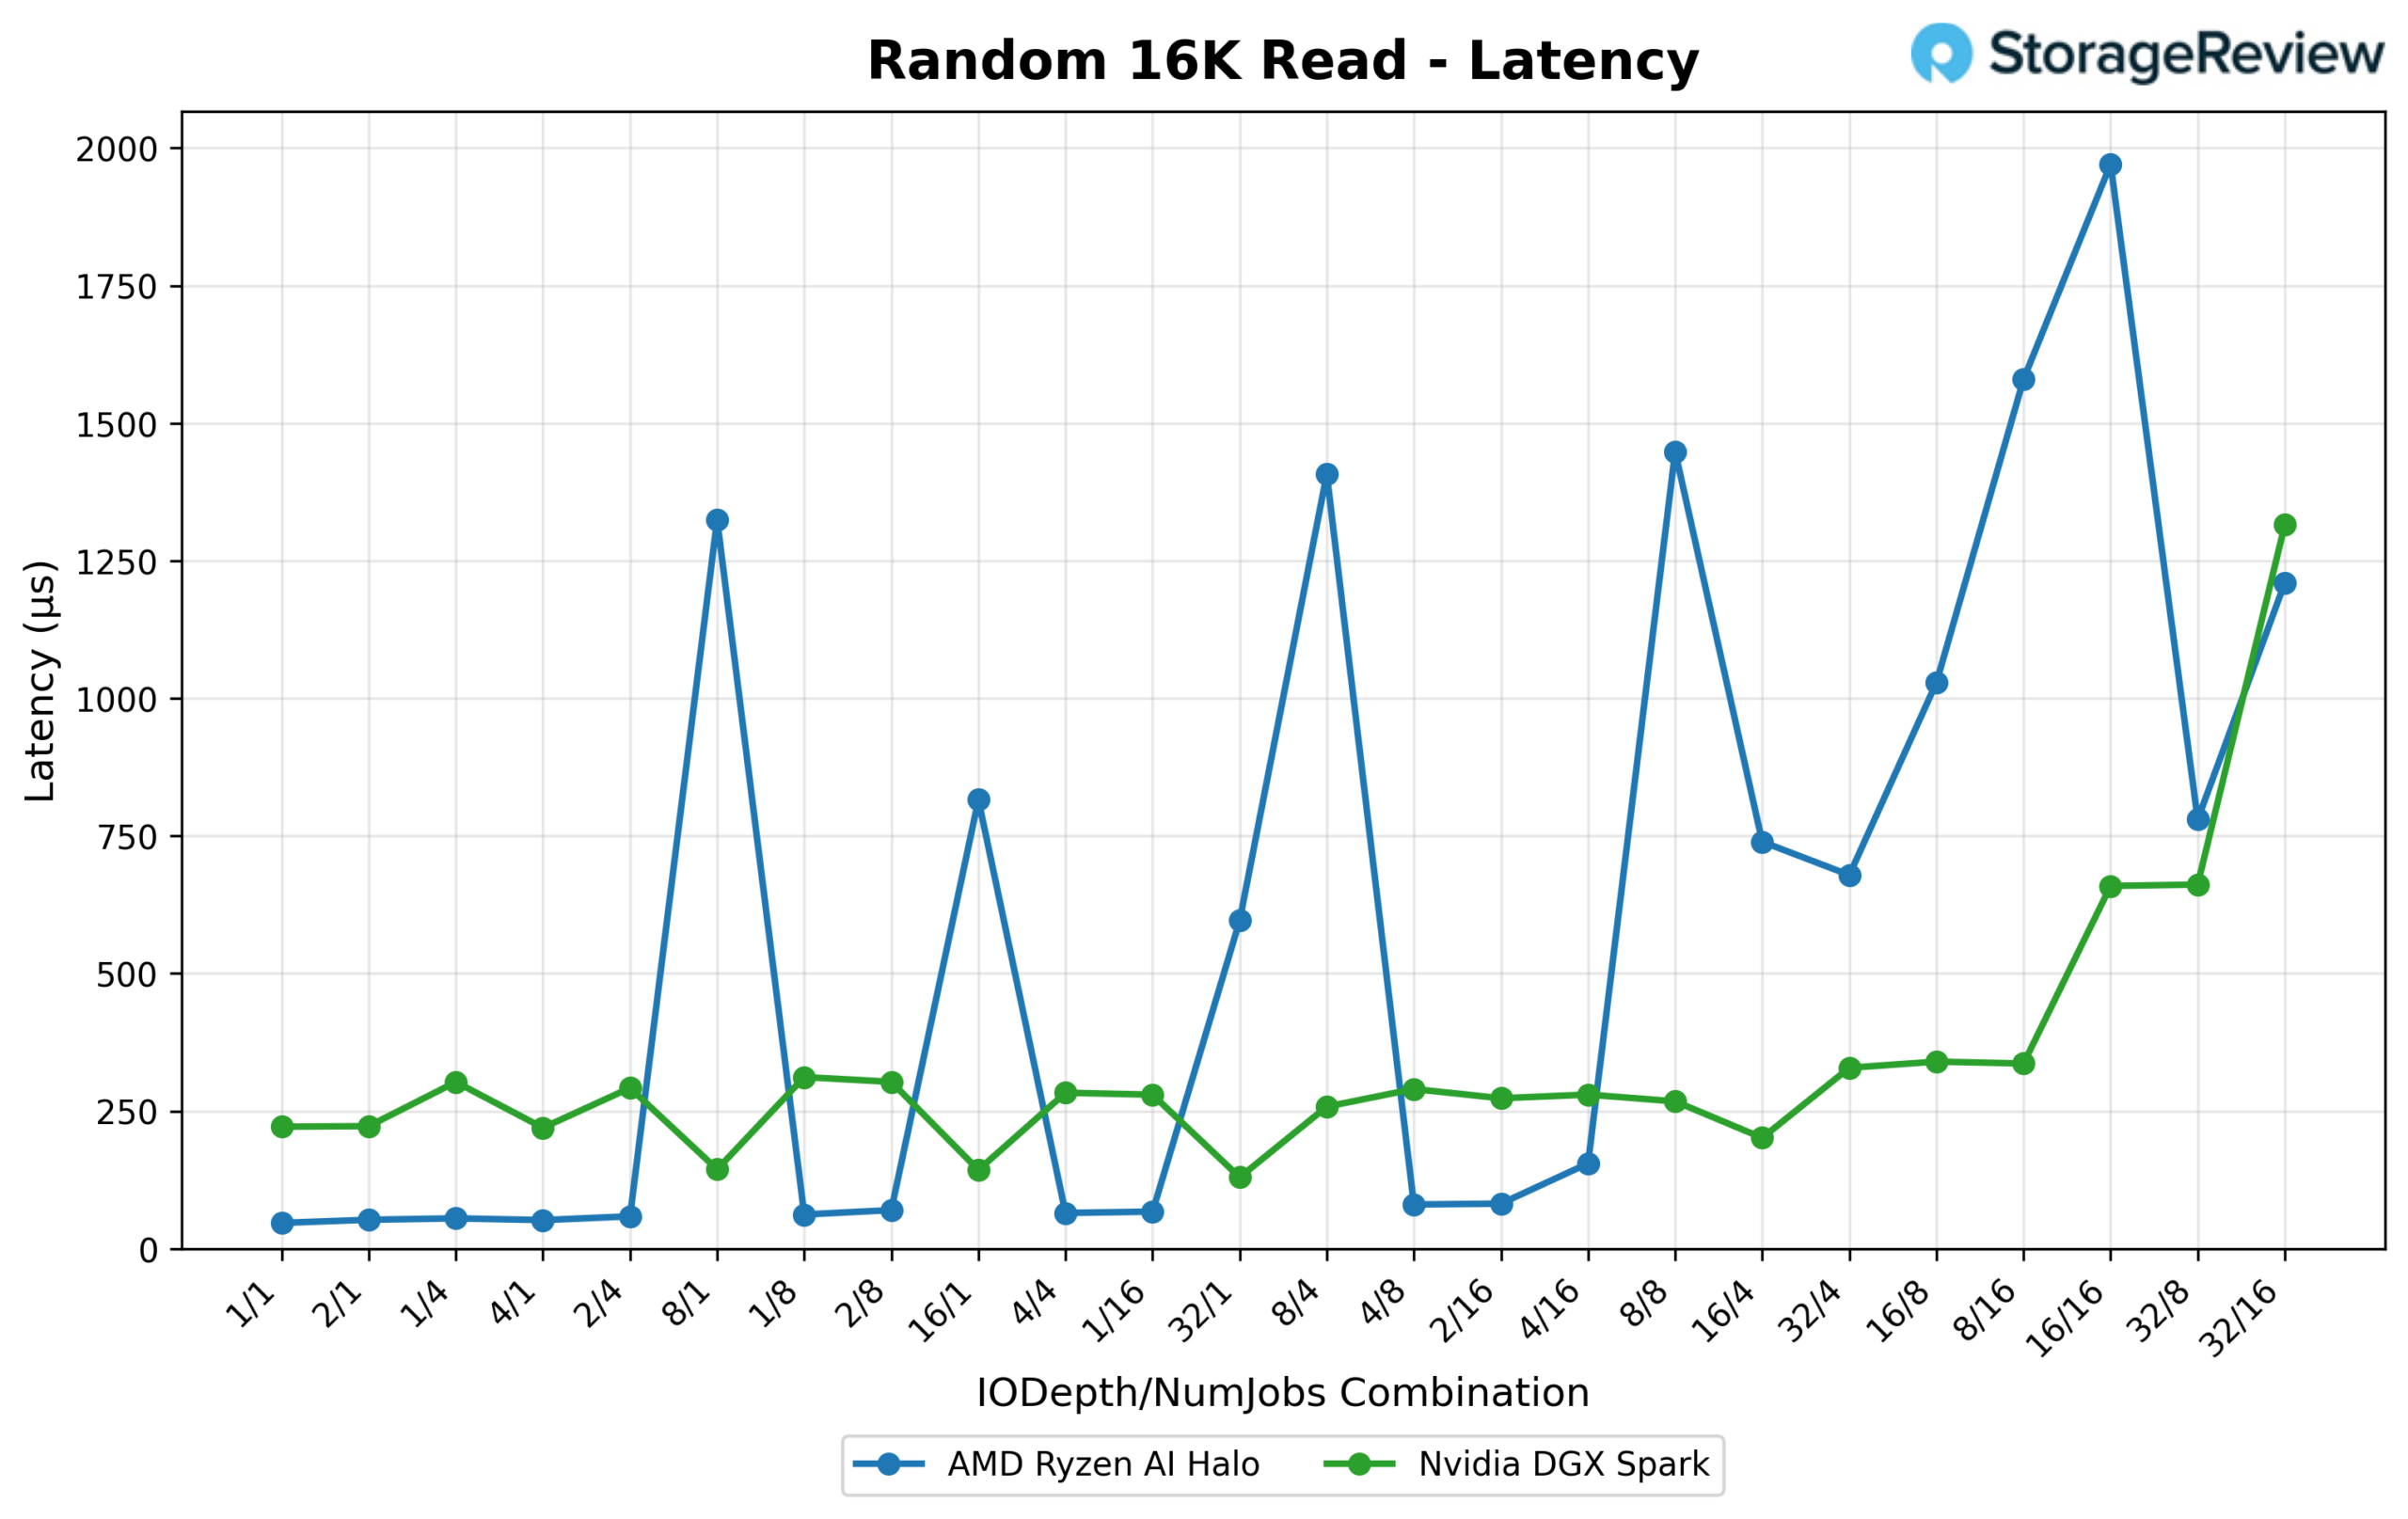
Latency က Halo ရဲ့ အားသာချက်ကို ပြန်ရပြန်ပြီ (1/1 မှာ 0.047 ms နဲ့ Spark မှာ 0.222 ms)။ ဒါပေမယ့် Halo ရဲ့ latency curve က 8/1, 16/1, 8/4 နဲ့ 8/8 မှာ သိသိသာသာ မြင့်တက်လာပြီး Spark ရဲ့ ချောမွေ့တဲ့ (baseline မြင့်ရင်) curve ထက် အများကြီး ပိုများပါတယ်။ Queue ရဲ့ ထိပ်ဆုံးမှာ Halo ရဲ့ 1.971 ms (16/16 မှာ) peak latency က Spark ရဲ့ 1.315 ms (32/16 မှာ) peak ထက် ကျော်လွန်နေတာမို့ Halo က queue နိမ့်တဲ့ မြန်နှုန်းအတွက် consistency ကို လဲလှယ်ပါတယ်။
16K ကျပန်းရေးပါ။
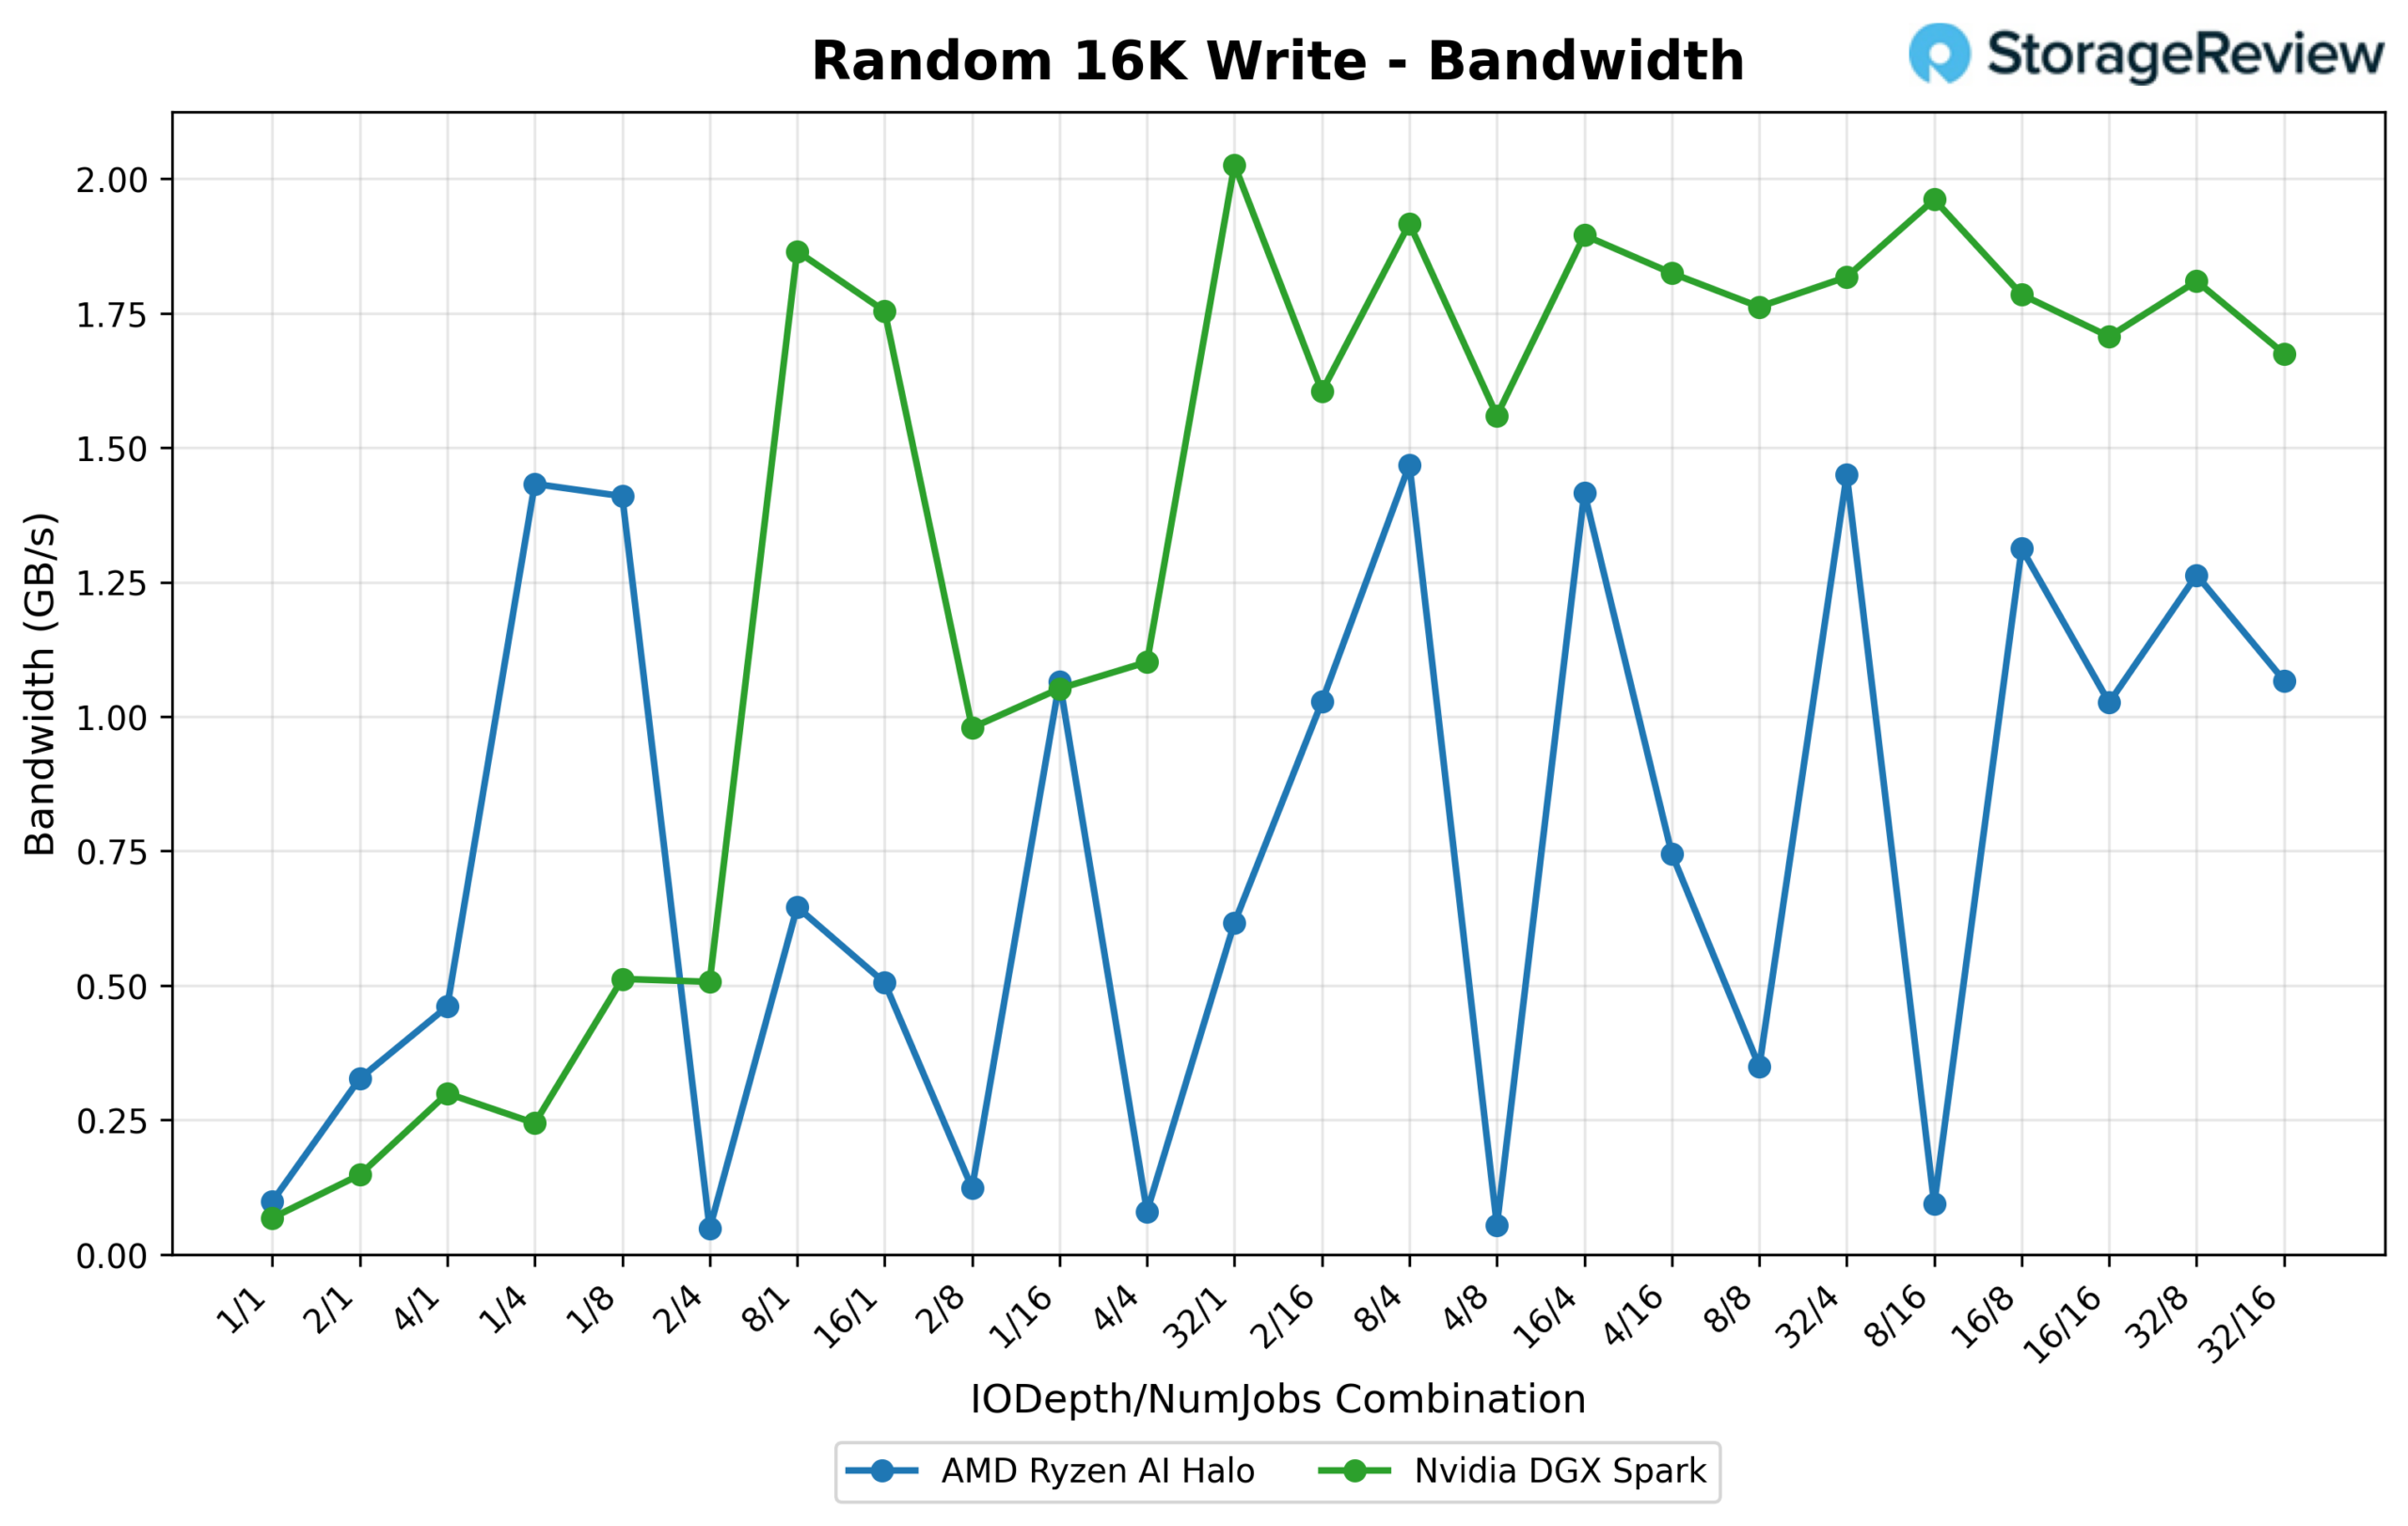
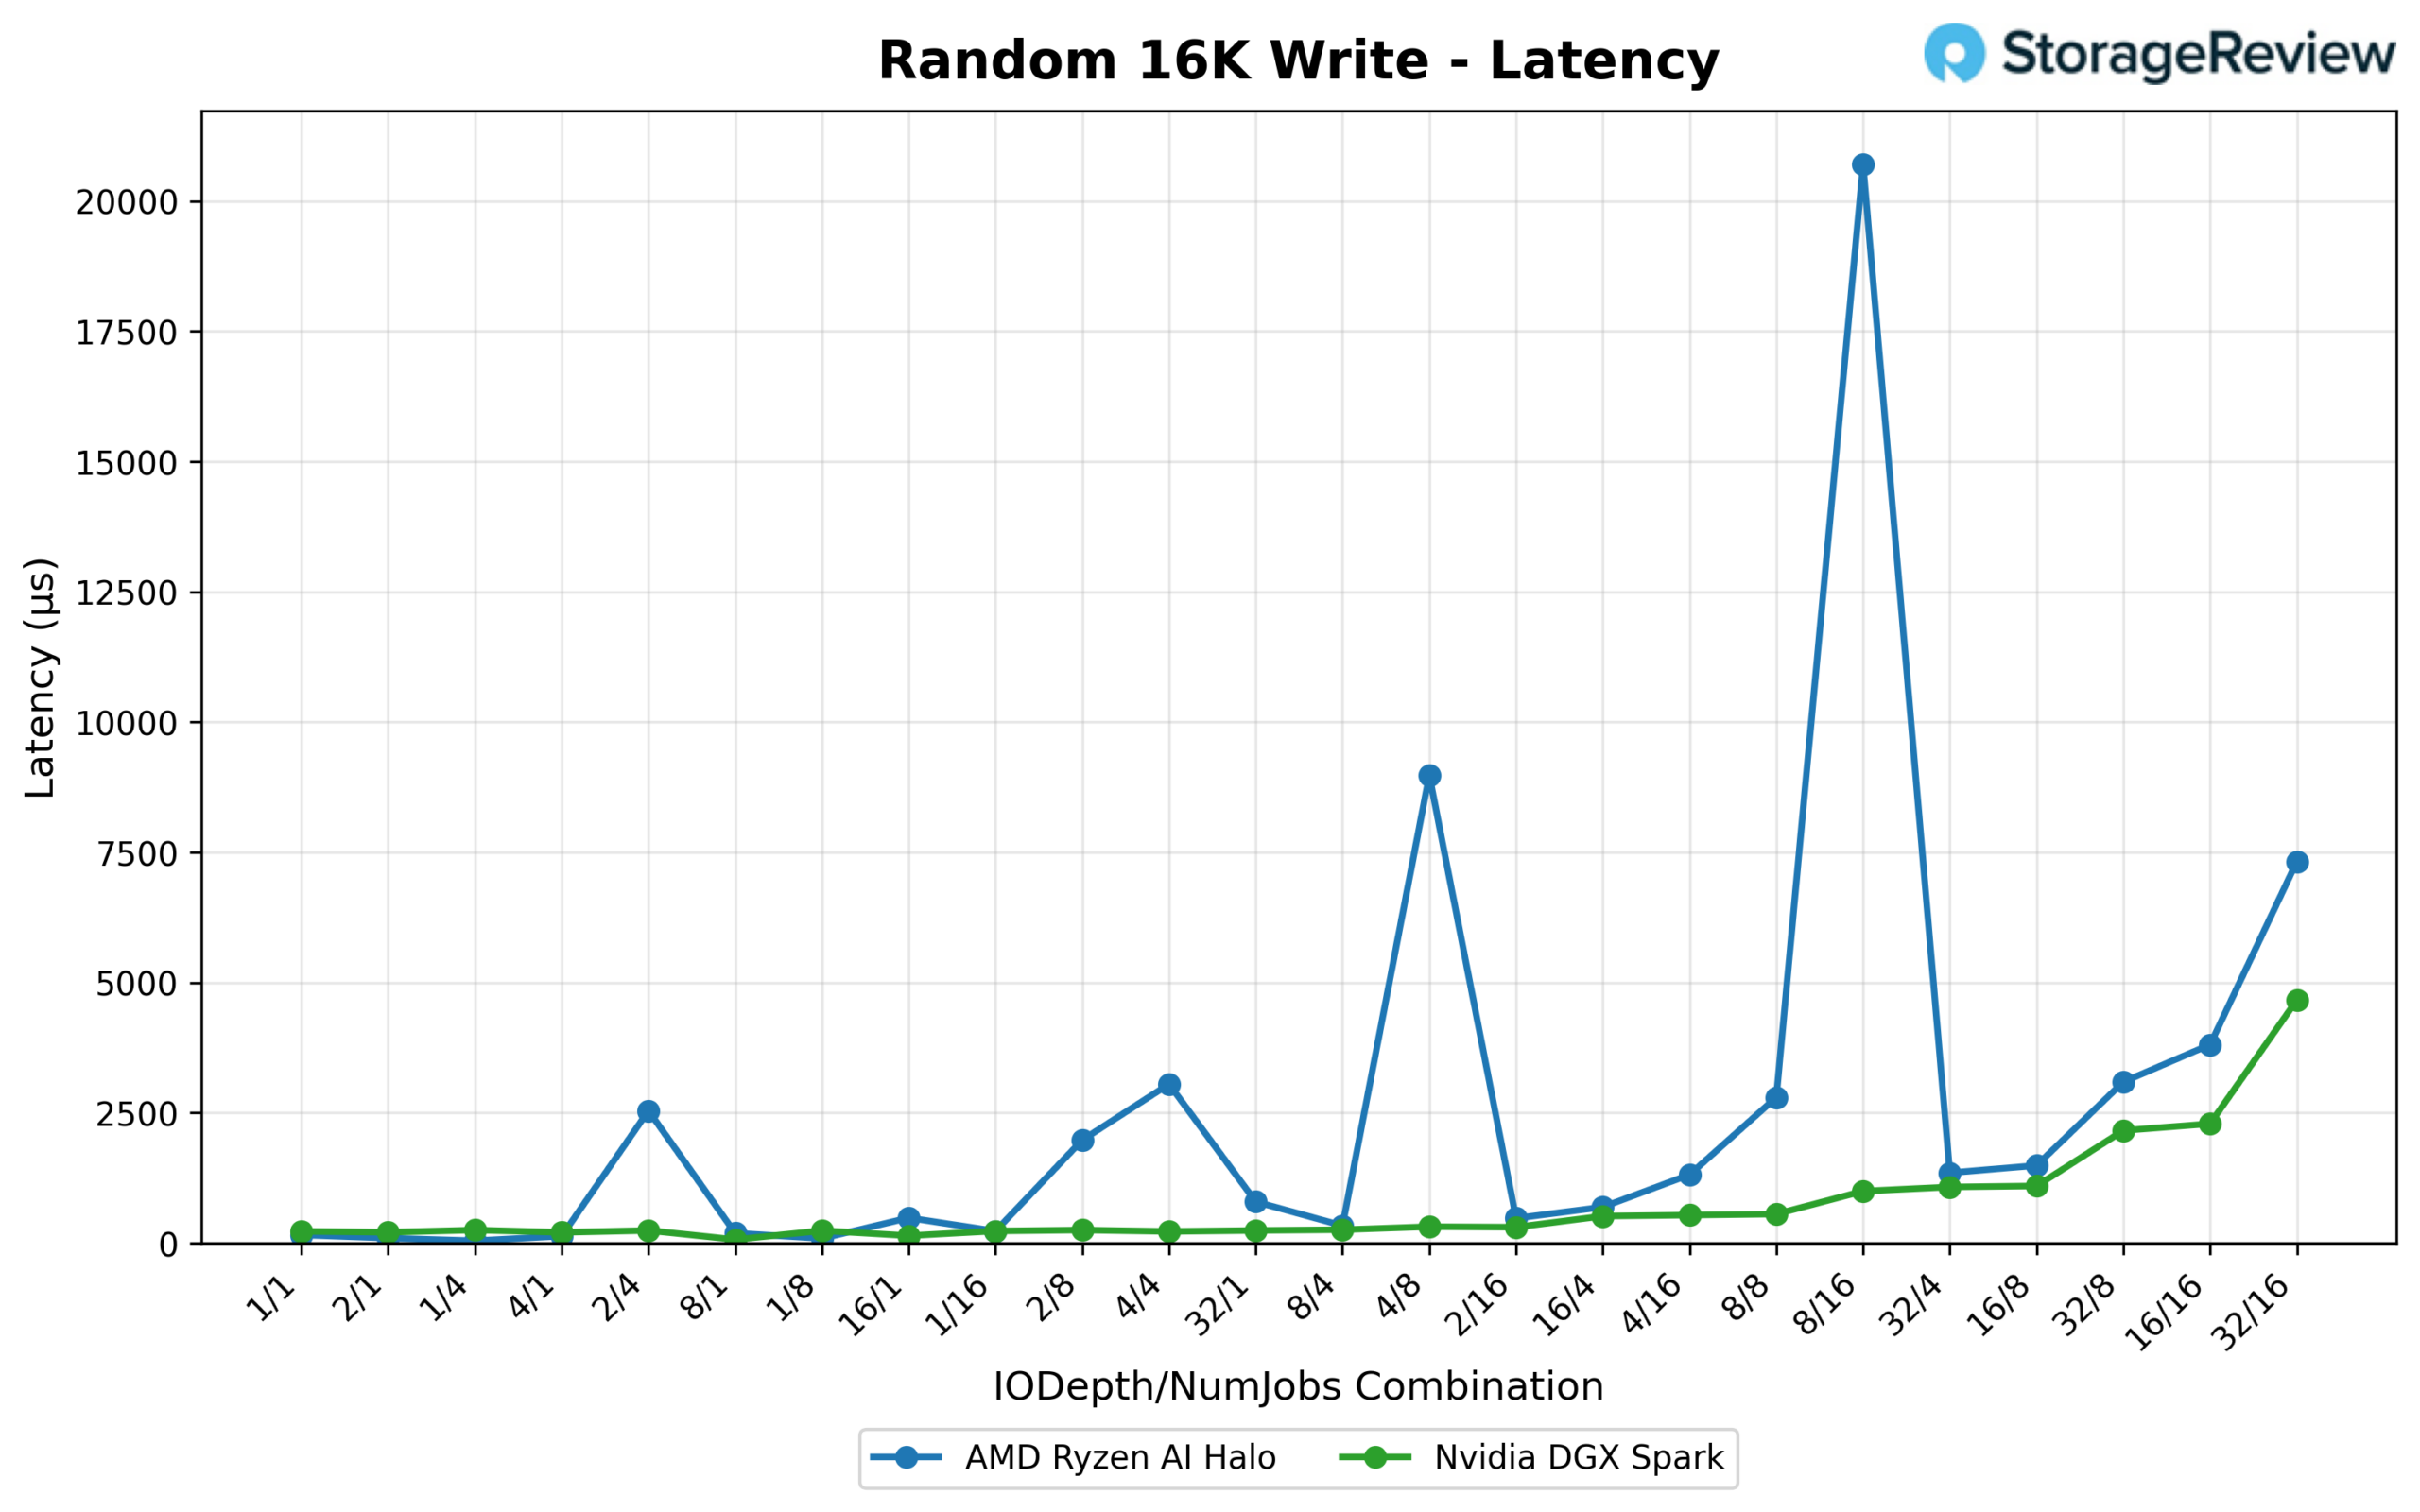
Bandwidth က Spark ကို အကျိုးပြုပြီး Halo ရဲ့ 1,503.5 MB/s (96.2K IOPS) 8/4 မှာ 2,074.1 MB/s (132.7K IOPS) 32/1 မှာ ရောက်ရှိပါတယ်။ Spark ရဲ့ bandwidth curve ကလည်း သိသိသာသာ ပိုတည်ငြိမ်ပြီး အစပိုင်း ramp ပြီးနောက် sweep အများစုအတွက် 1.6–2.0 GB/s အတိုင်းအတာအတွင်းမှာပဲ ရှိပါတယ်။ နှိုင်းယှဉ်ကြည့်မယ်ဆိုရင် Halo က ပေါင်းစပ်မှုတစ်ခုကနေ နောက်တစ်ခုကို 0.1 နဲ့ 1.5 GB/s အကြား သိသိသာသာ ပြောင်းလဲသွားတာကို တွေ့ရပါတယ်။
ဒီစမ်းသပ်မှုမှာ latency က ထင်ရှားပါတယ်- Halo က 1/1 (0.154 ms vs. 0.224 ms) မှာ ပိုနိမ့်တဲ့အဆင့်ကနေ စတင်ပေမယ့် 8/16 မှာတော့ ပျမ်းမျှ latency က 20.698 ms အထိ မြင့်တက်သွားပြီး Spark ရဲ့ အဆိုးဆုံးအခြေအနေ 4.664 ms ထက် ၄.၅ ဆ နီးပါး ပိုများပါတယ်။ အဲဒီတစ်ချက်တည်း မြင့်တက်သွားတာကလွဲရင် Halo ရဲ့ latency က သင့်တင့်ပေမယ့် အဲဒီ depth/thread ပေါင်းစပ်မှုမှာ ကျရောက်နိုင်တဲ့ workload တိုင်းအတွက် မှတ်သားထားသင့်တဲ့ သိသိသာသာ outlier တစ်ခုပါ။
4K ကျပန်းဖတ်ပါ။
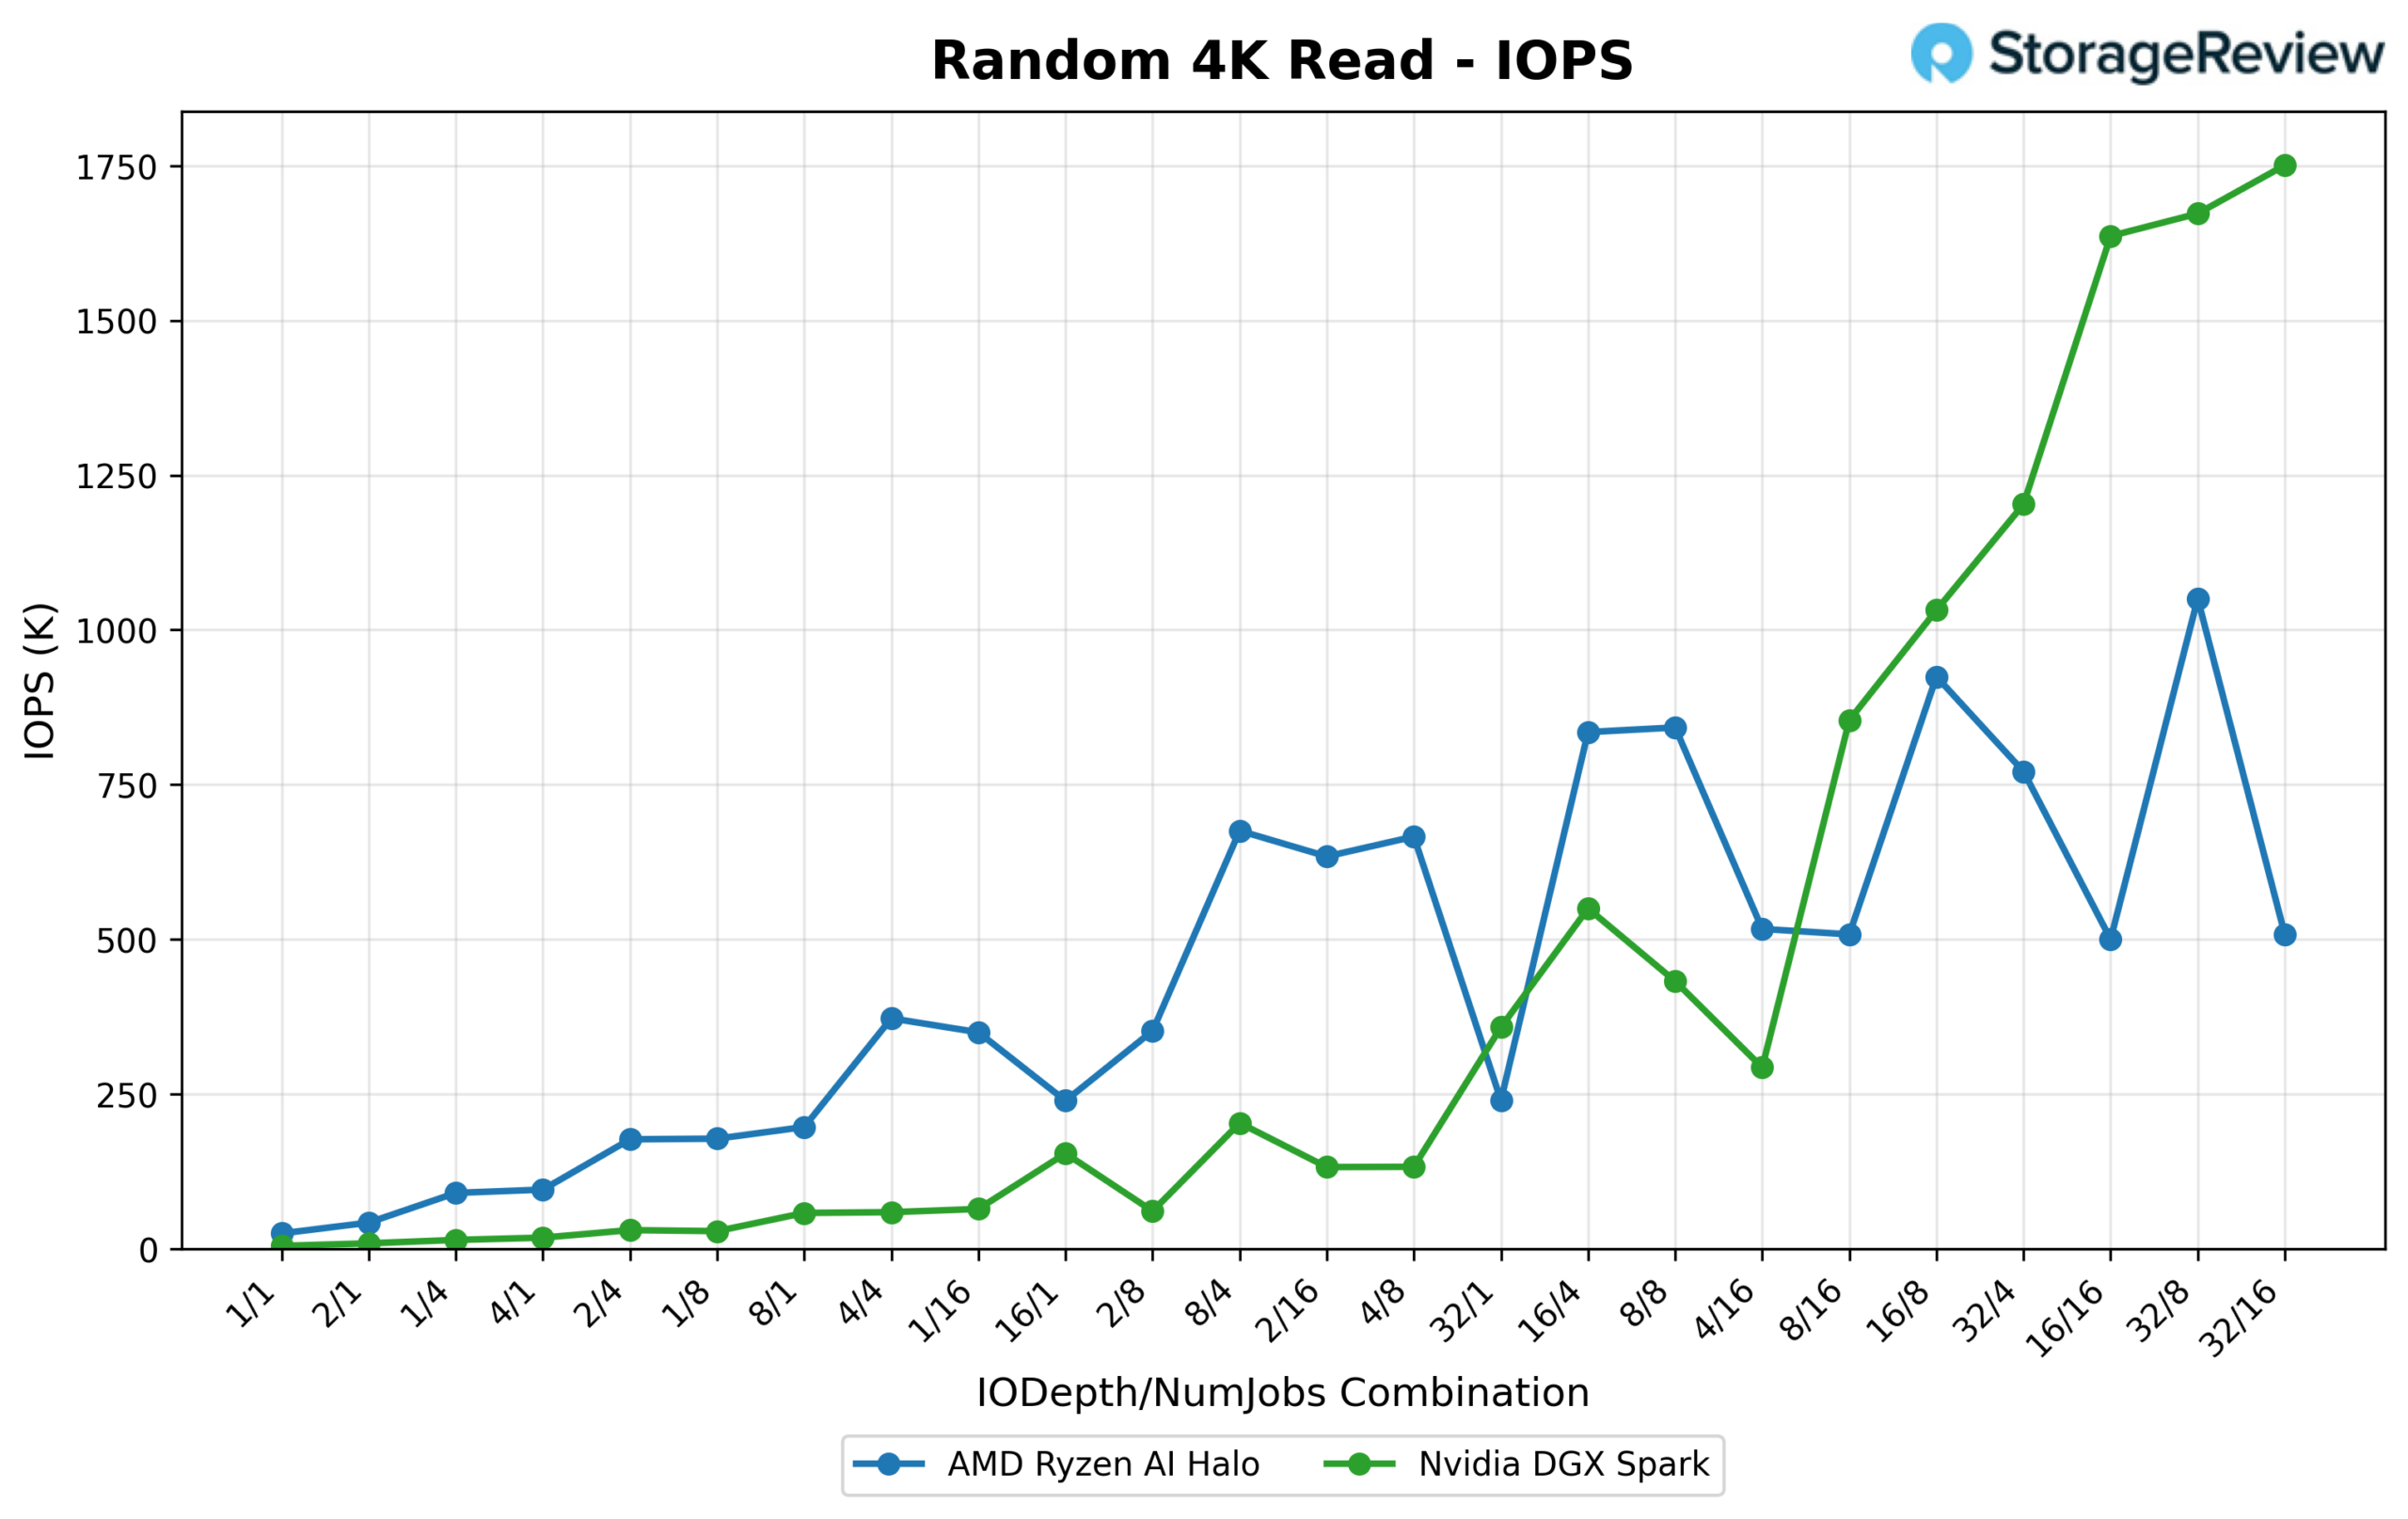
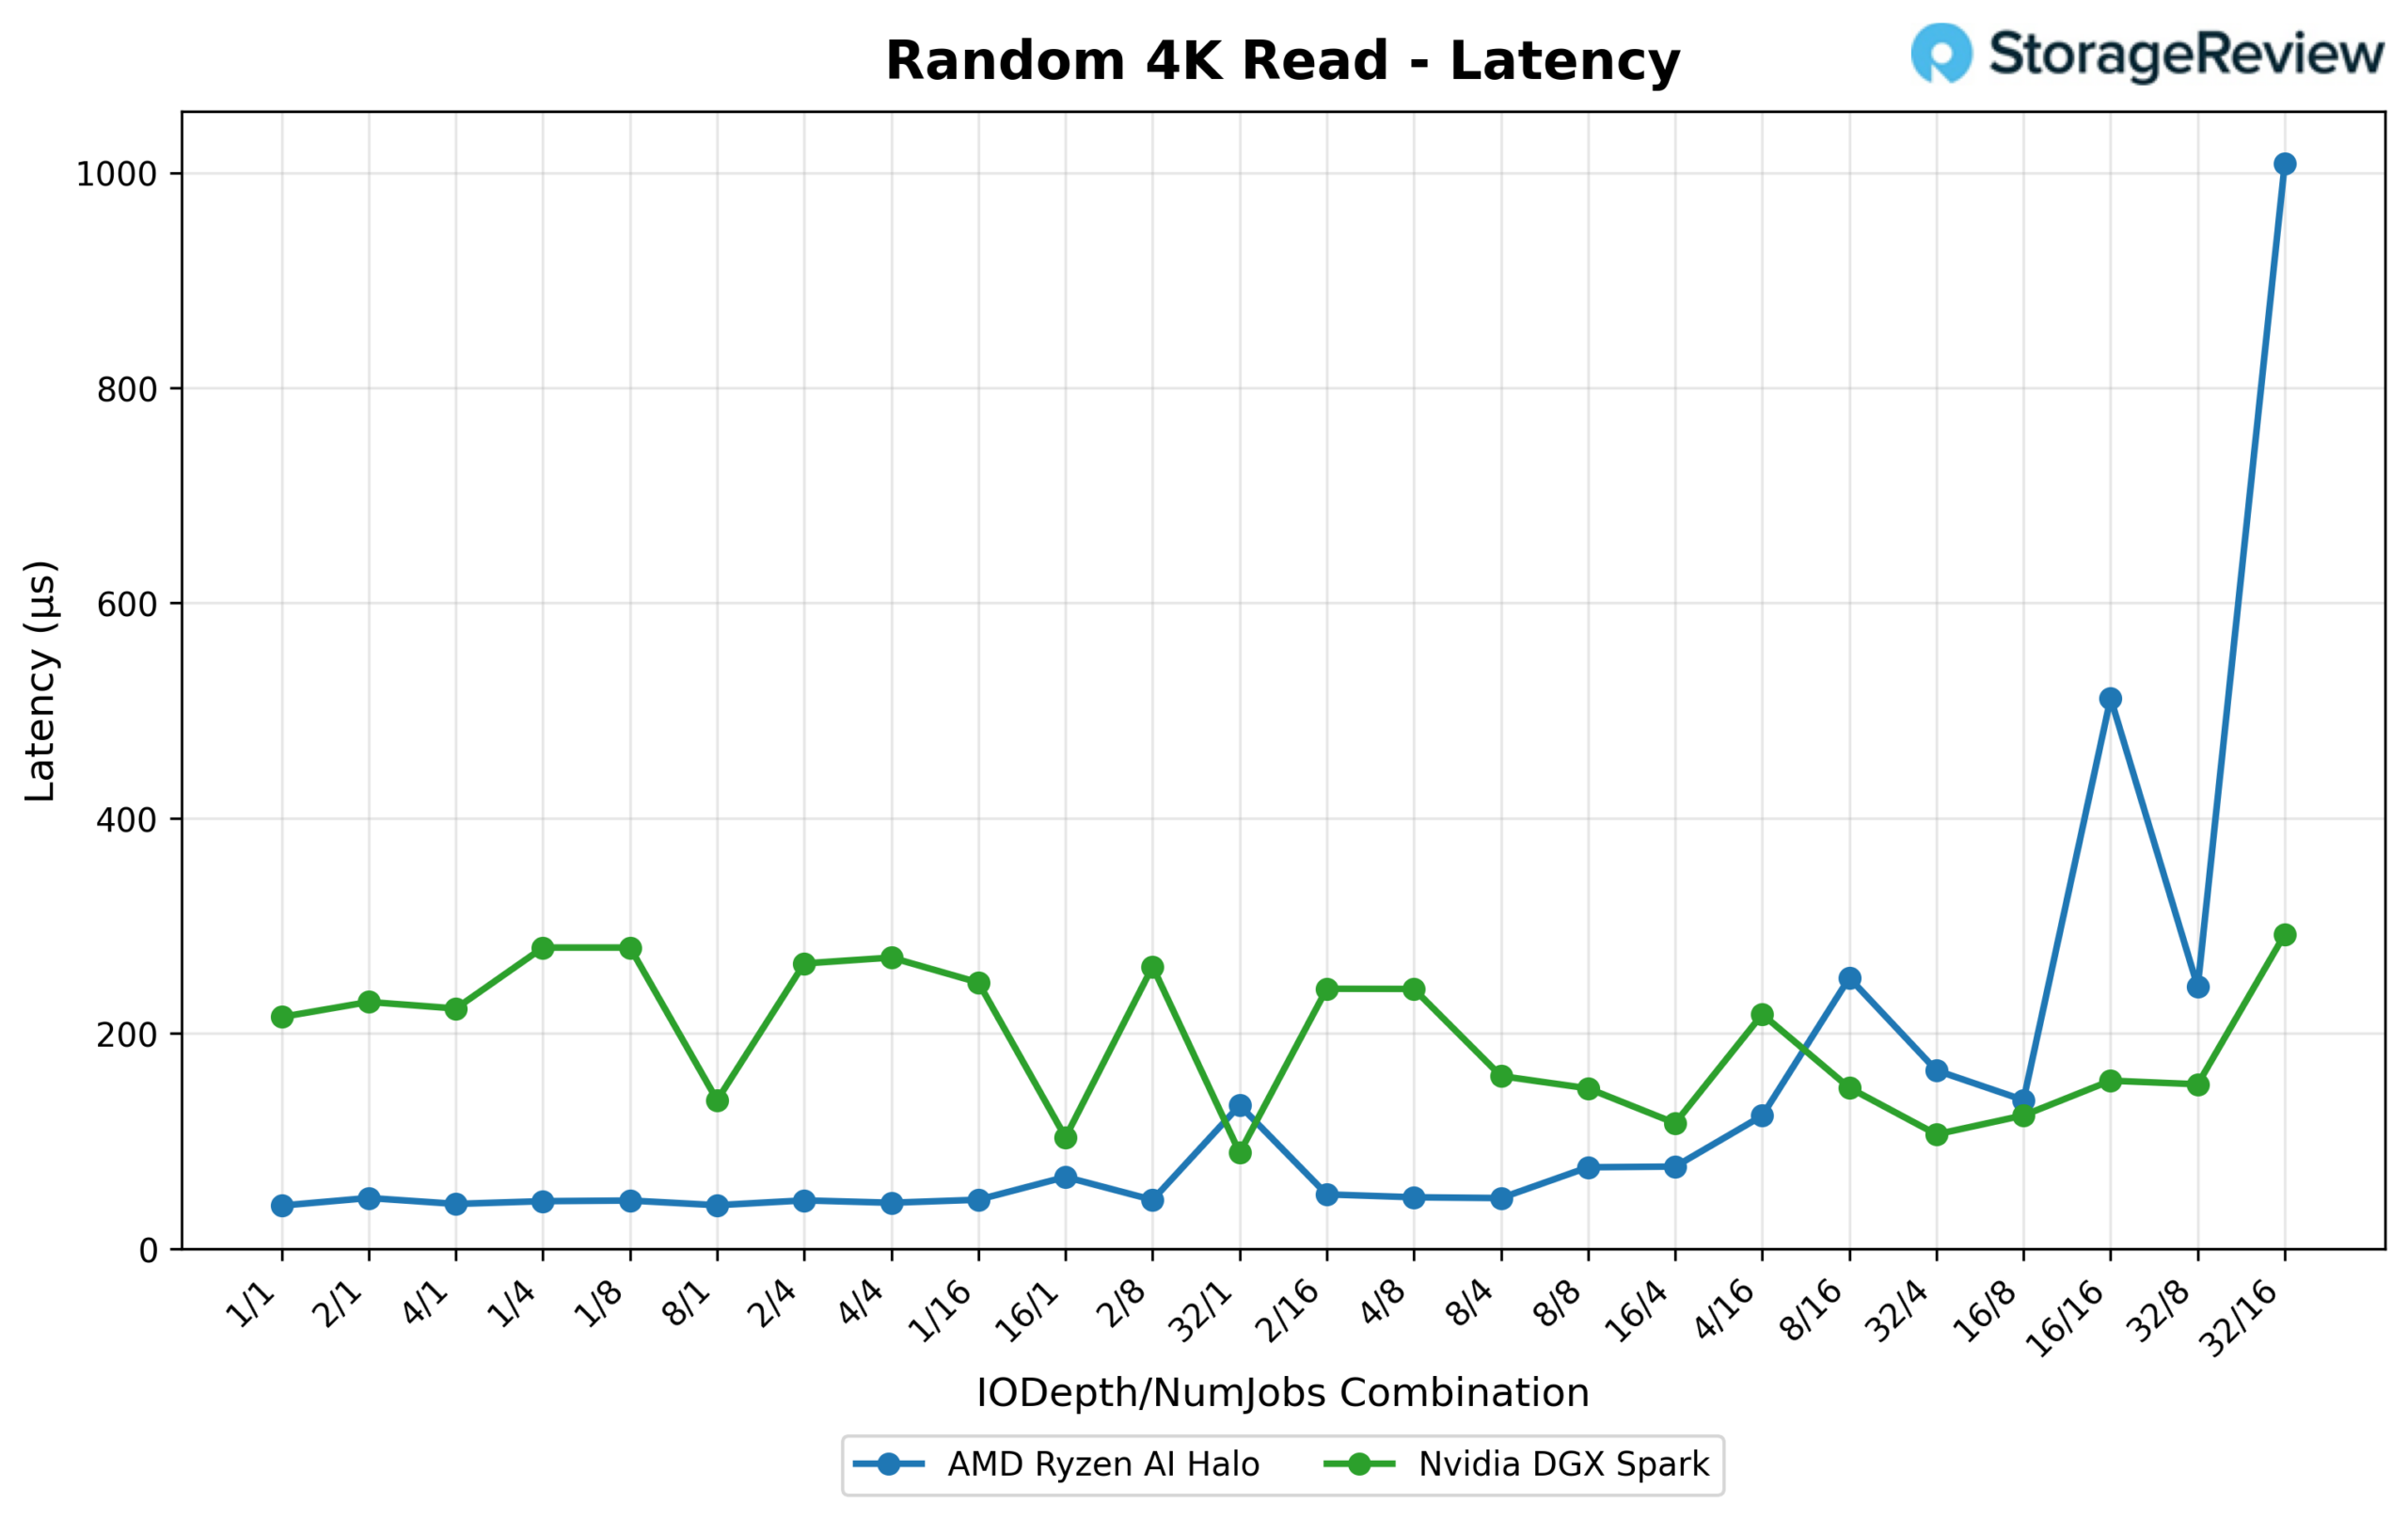
queue depth နည်းတဲ့အခါမှာ Halo ဟာ သိသိသာသာ ပိုမြန်ပါတယ် (Spark ရဲ့ 0.215 ms နဲ့ ယှဉ်ရင် 1/1 မှာ 0.04 ms)၊ ပြီးတော့ sweep ရဲ့ low-to-mid range အများစုမှာ latency အားသာချက်ကို ထိန်းသိမ်းထားနိုင်ပါတယ်။ ဒါပေမယ့် Spark ဟာ throughput ပိုင်းမှာတော့ ပြတ်ပြတ်သားသား ဦးဆောင်နေပါတယ်- 32/16 မှာ အမြင့်ဆုံး IOPS က 1,750.7K (6,838.8 MB/s) အထိ ရောက်ရှိပြီး Halo ရဲ့ အမြင့်ဆုံး IOPS (32/8) မှာ 1,050.4K IOPS (4,103.2 MB/s) ထက် အများကြီး သာလွန်ပါတယ်။
စိတ်ဝင်စားစရာကောင်းတာက latency image ဟာ queue depth မြင့်မားတဲ့အခါ ပြောင်းပြန်ဖြစ်သွားပါတယ်။ Spark ရဲ့ latency curve ဟာ depth နဲ့ thread တွေ မြင့်တက်လာတဲ့အချိန်မှာတောင် အတော်လေး ထိန်းထားနိုင်ပြီး 0.292 ms မှာပဲ အမြင့်ဆုံးရောက်ပါတယ်။ ဆန့်ကျင်ဘက်အနေနဲ့ Halo ကတော့ 16/16 (0.513 ms) မှာ သိသိသာသာ မြင့်တက်လာပြီး 32/16 (1.009 ms) မှာ ထပ်မံမြင့်တက်လာကာ steady-state baseline ကို 3 ဆကျော် ကျော်လွန်သွားပြီး ၎င်းရဲ့ အလွန်ကောင်းမွန်တဲ့ low-queue-depth responsiveness ဟာ full saturation အထိ မရောက်ရှိနိုင်ပါဘူး။
4K ကျပန်းရေးပါ။
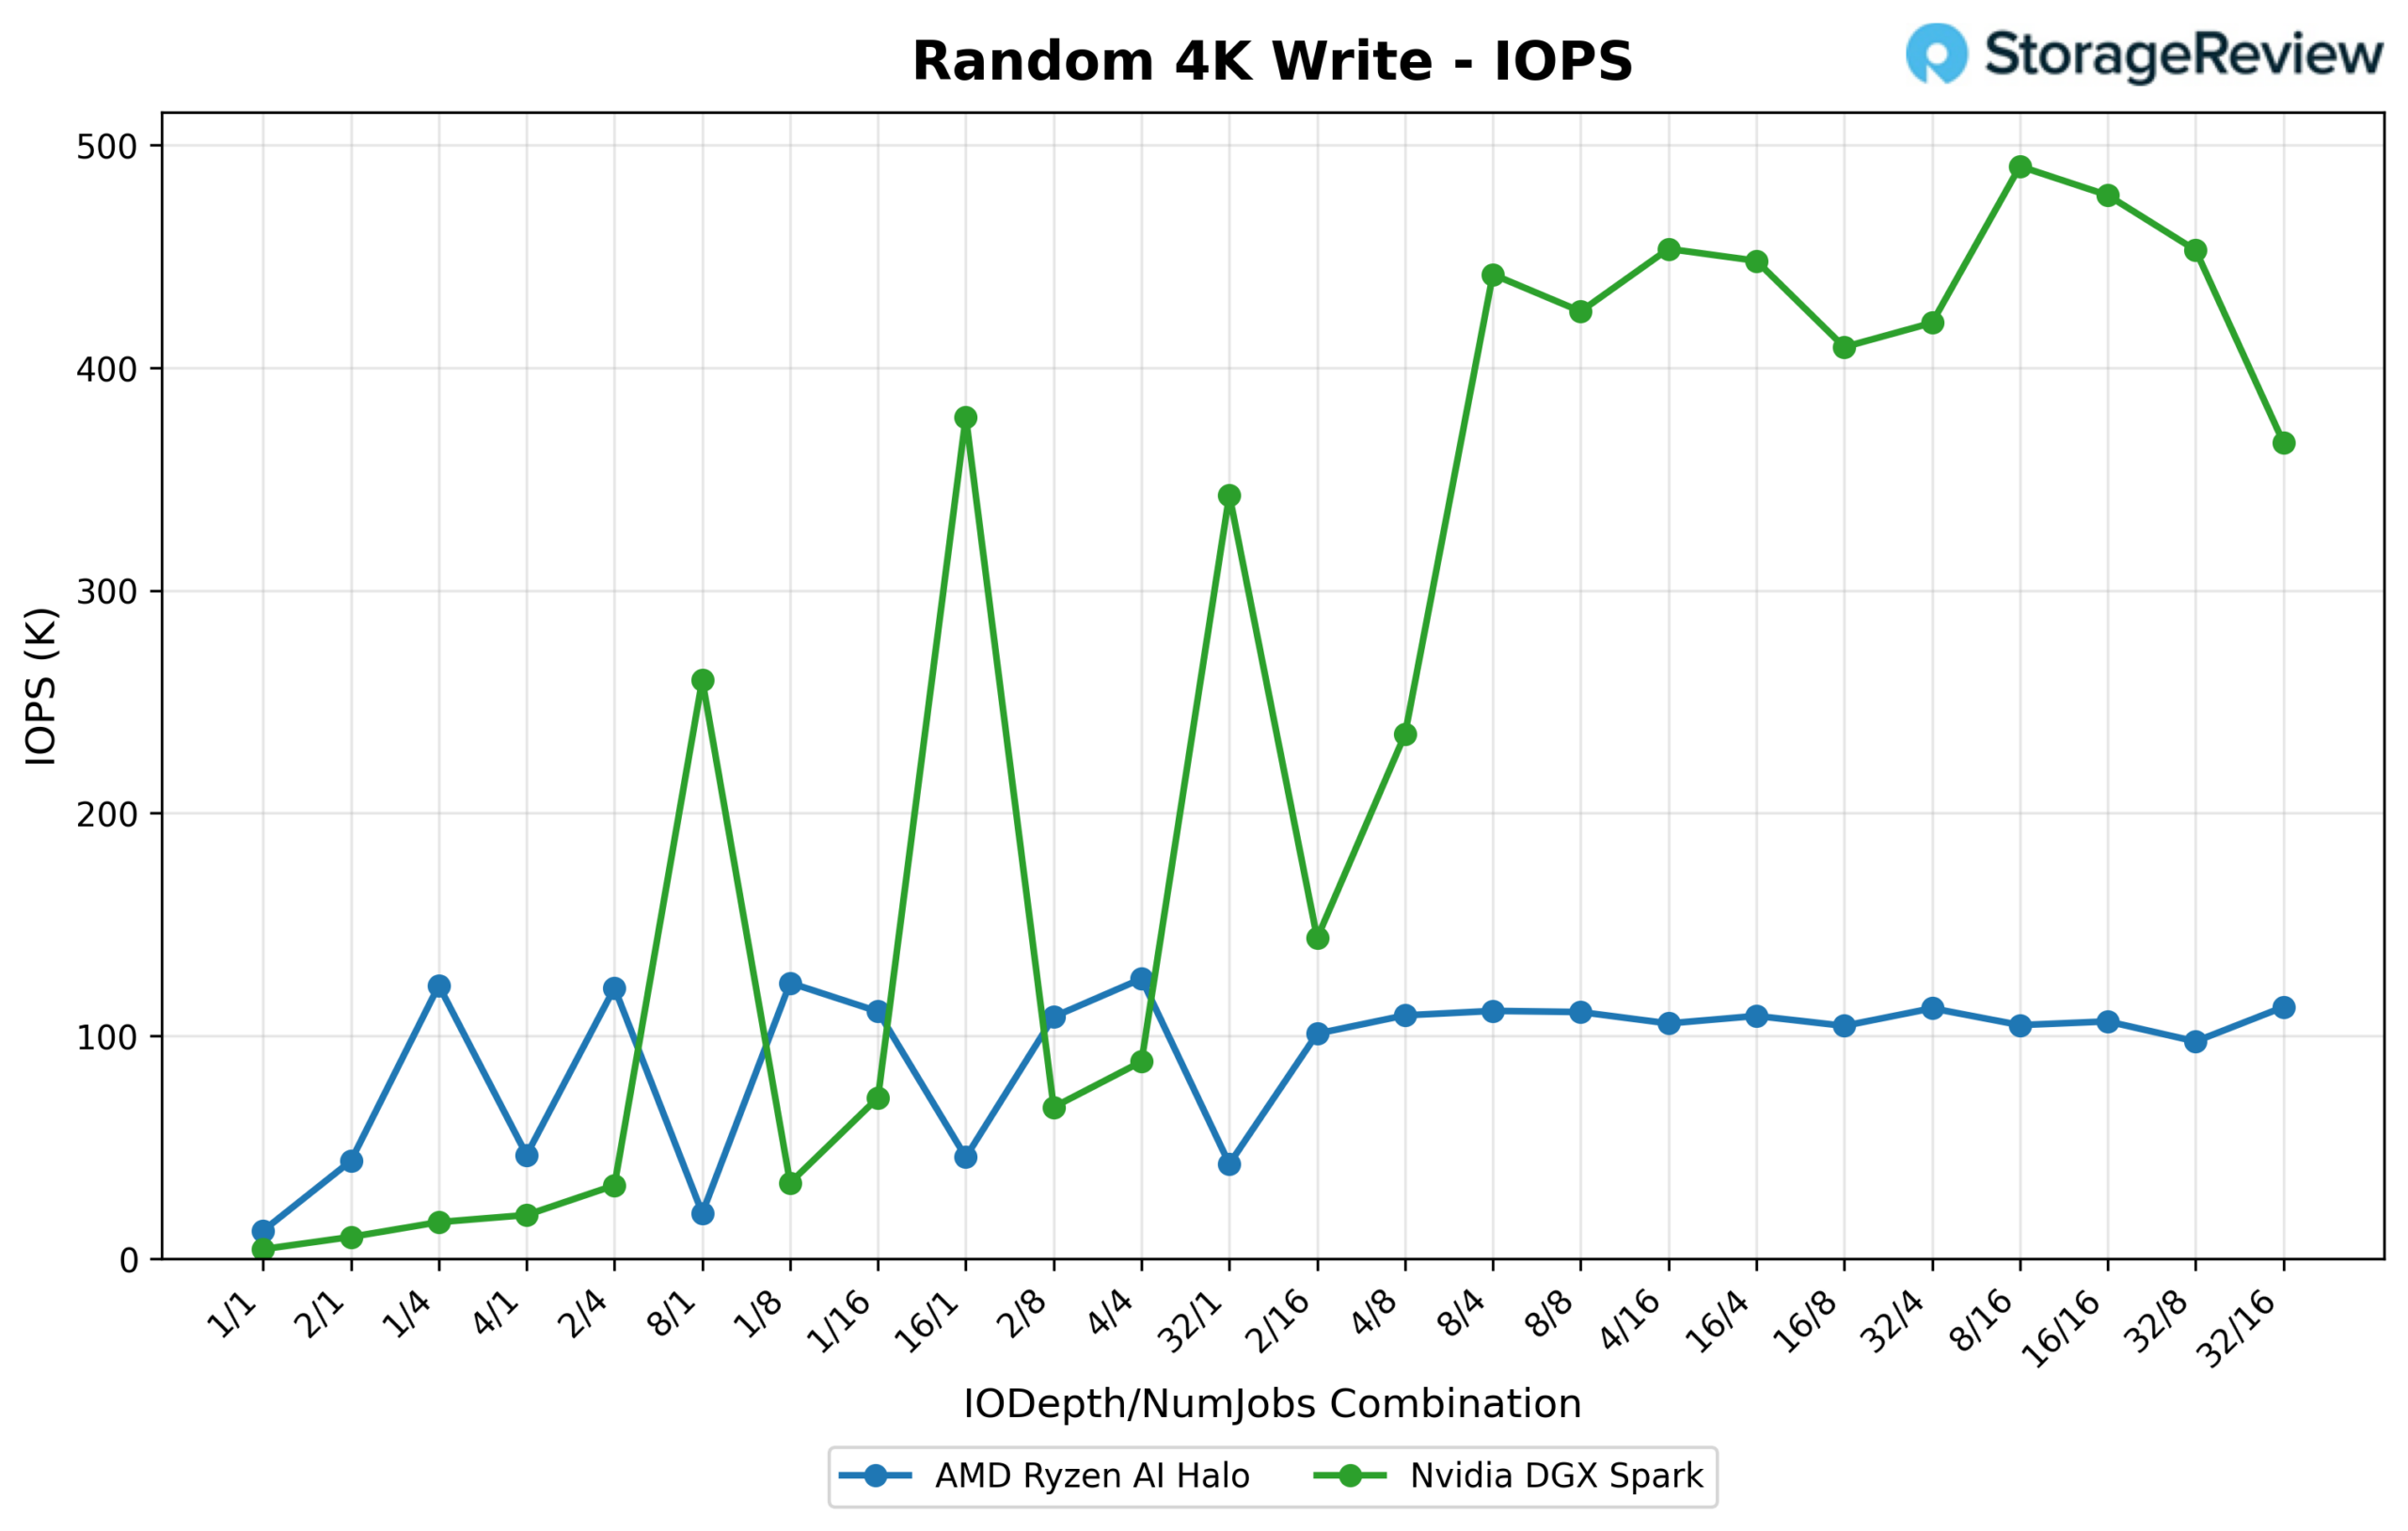
ဒါက sweep မှာ အကျယ်ဆုံး IOPS gap ပါ။ Spark ရဲ့ random 4K write performance ဟာ queue depth နဲ့ thread count တွေ များလာတာနဲ့အမျှ သိသိသာသာ မြင့်တက်လာပြီး 8/16 မှာ 490.4K IOPS (1,915.6 MB/s) အထိ ရောက်ရှိခဲ့ပါတယ်။ တစ်ချိန်တည်းမှာပဲ Halo ကတော့ အစောပိုင်းမှာရော နိမ့်တဲ့အဆင့်မှာပါ ရပ်တန့်သွားပြီး 4/4 မှာ 125.6K IOPS (490.7 MB/s) မှာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး sweep ကျန်အချိန်တွေမှာ 110–115K IOPS လောက် မကျော်လွန်ခဲ့ပါဘူး။ Spark က Halo ရဲ့ ceiling ထက် 4 ဆ နီးပါး မြန်ပါတယ်။
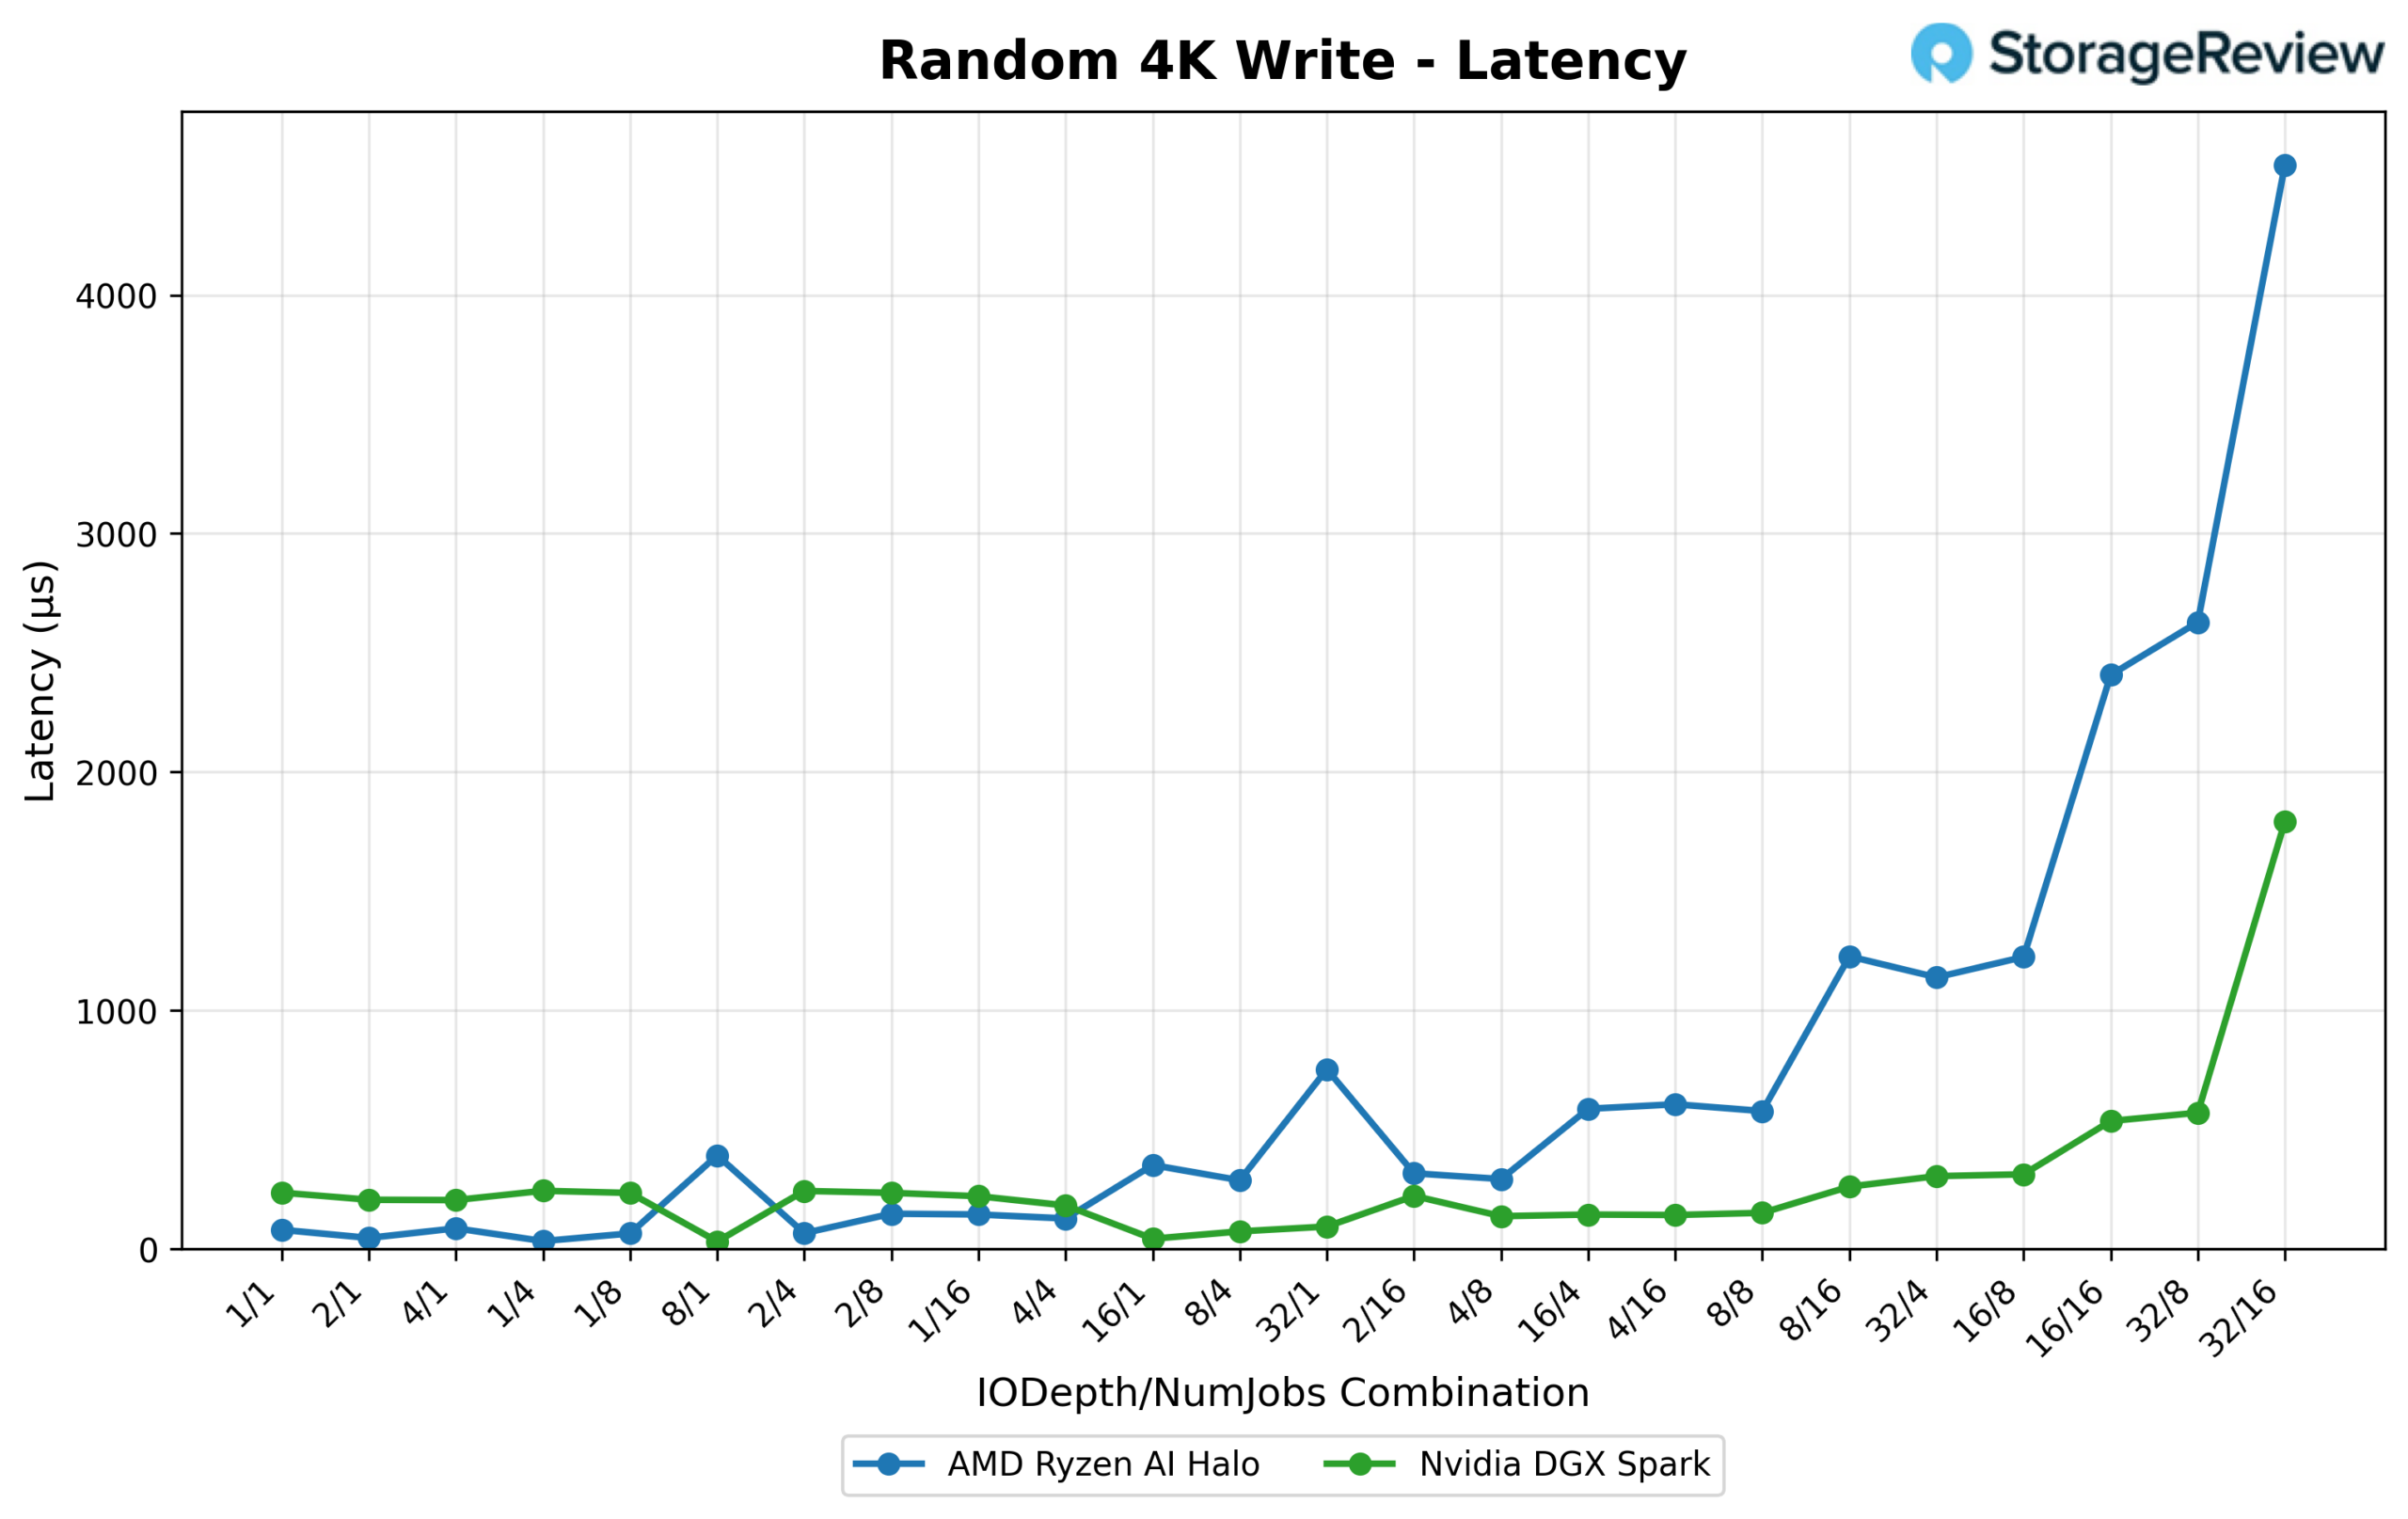
Latency ဟာ queue depth နိမ့်တဲ့အခါမှာ Halo ရဲ့ အကျိုးပြန်ရလာပြန်ပါတယ် (0.079 ms vs. 0.235 ms at 1/1)။ ၃၂/၁၆ မှာတော့ Halo ရဲ့ ပျမ်းမျှ latency ဟာ 4.546 ms အထိ မြင့်တက်လာပြီး Spark ရဲ့ latency ကတော့ 1.792 ms မှာ နှိုင်းယှဉ်ရင် ထိန်းချုပ်ထားဆဲပါ။ IOPS gap နဲ့ ပေါင်းစပ်လိုက်ရင် ဒါက depth/thread sweep တစ်ခုလုံးမှာ Spark ရဲ့ အားသာချက် အထင်ရှားဆုံးနဲ့ အတည်ငြိမ်ဆုံး စမ်းသပ်မှုပါ။
vLLM အွန်လိုင်းဝန်ဆောင်မှု – LLM ကောက်ချက်ချမှုစွမ်းဆောင်ရည်
vLLM သည် LLM များအတွက် အလွန်ရေပန်းစားသော high-throughput inference နှင့် serving engine များထဲမှ တစ်ခုဖြစ်သည်။ vLLM အွန်လိုင်း serving benchmark သည် concurrent request များအောက်တွင် ဤ inference engine ၏ လက်တွေ့ကမ္ဘာ serving စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည်။ ၎င်းသည် request rate၊ input နှင့် output length များနှင့် concurrent client အရေအတွက်ကဲ့သို့သော configure လုပ်နိုင်သော parameter များဖြင့် လည်ပတ်နေသော vLLM server သို့ request များပေးပို့ခြင်းဖြင့် production workload များကို simulate လုပ်သည်။ benchmark သည် throughput (တစ်စက္ကန့်လျှင် token များ)၊ ပထမဆုံး token မှအချိန်နှင့် output token တစ်ခုလျှင်အချိန် (TPOT) အပါအဝင် အဓိက metric များကို တိုင်းတာပြီး အသုံးပြုသူများ vLLM ၏ load condition အမျိုးမျိုးအောက်တွင် မည်သို့လုပ်ဆောင်သည်ကို နားလည်ရန် ကူညီပေးသည်။
ကျွန်ုပ်တို့သည် မတူညီသော concurrency profiles များတစ်လျှောက် throughput ကို အကဲဖြတ်ရန်အတွက် မတူညီသော architectures၊ parameter scales နှင့် quantization strategies များကို လွှမ်းခြုံထားသော မော်ဒယ်အစုံတစ်လျှောက် inference performance ကို စမ်းသပ်ခဲ့ပါသည်။
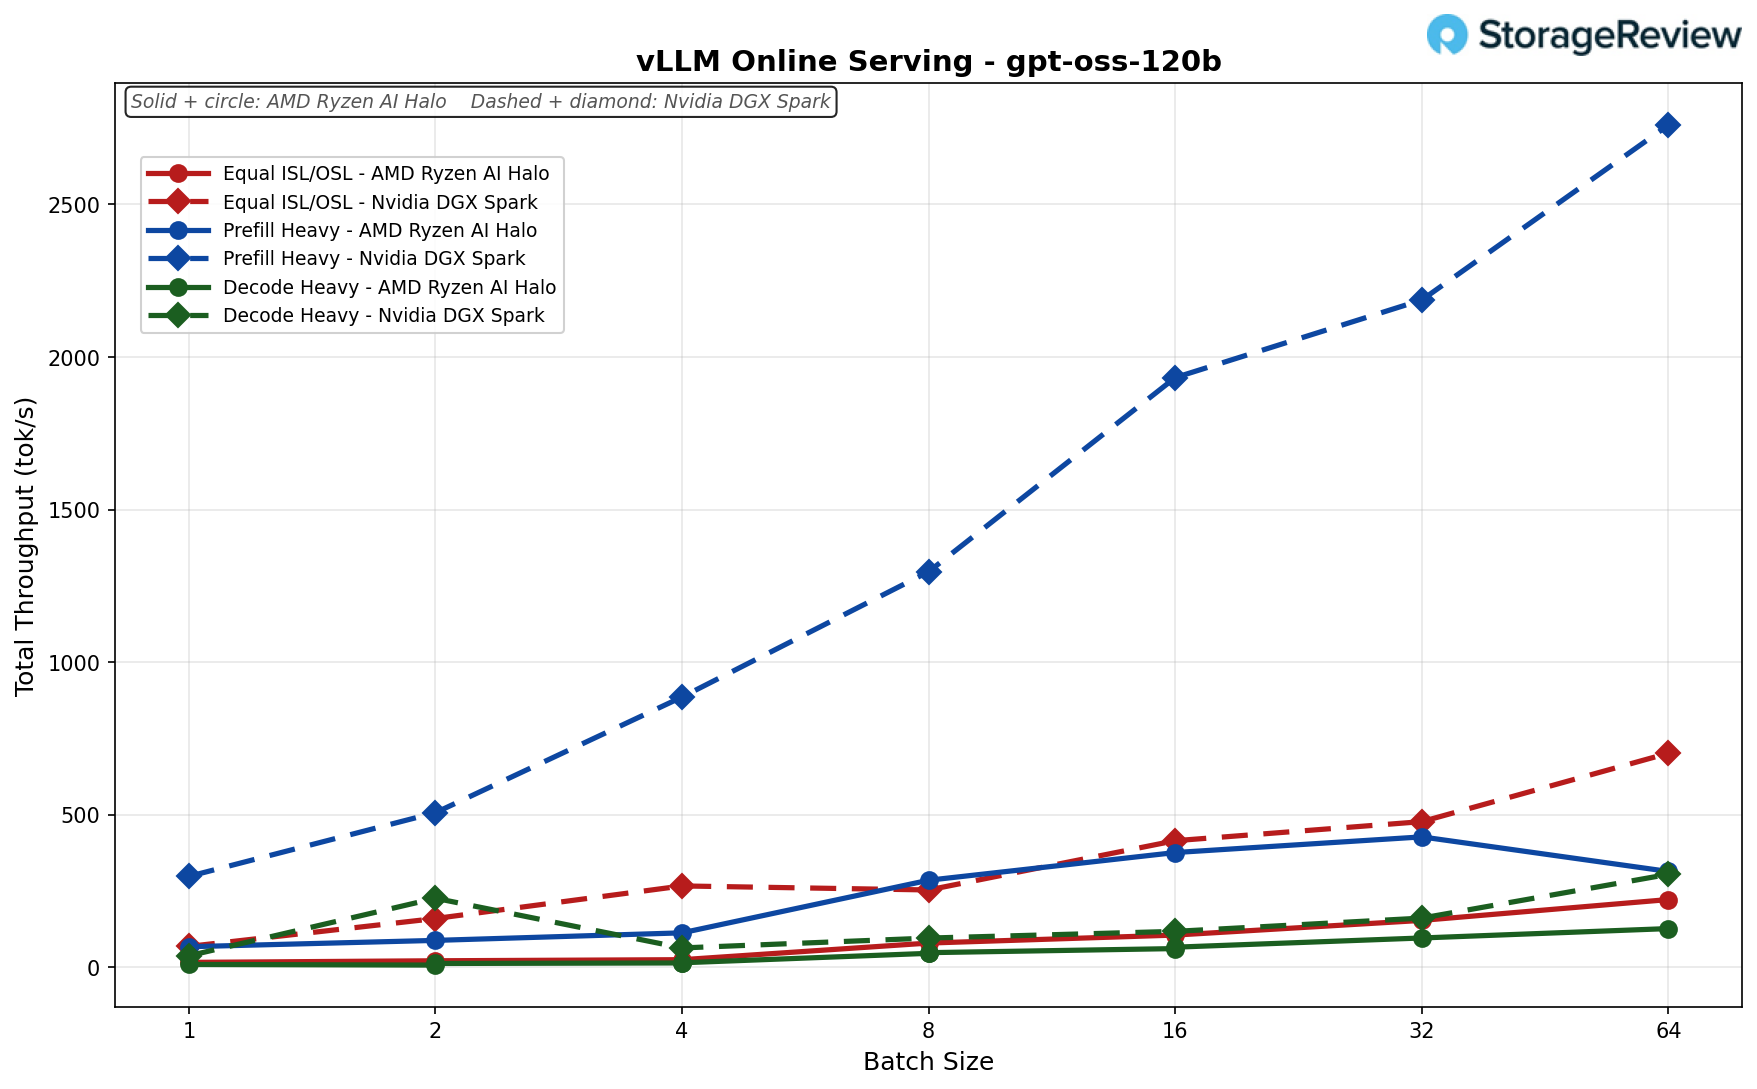
GPT OSS 120B
Equal ISL/OSL (၂၅၆/၂၅၆): Halo သည် batch size ၆၄ တွင် ၂၂၂ tok/s အထိ တိုးမြှင့်ခဲ့ပြီး Spark သည် ၇၀၁ (၃.၂ ဆခန့် နောက်ကျ) သို့ ရောက်ရှိခဲ့သည်။
Prefill Heavy (8k/1k): Halo ရဲ့ throughput ဟာ batch 32 (427 tok/s) မှာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး batch 64 မှာ 314 အထိ ကျဆင်းသွားခဲ့ပြီး Spark ကတော့ 2,760 (8.8x ခန့်) အထိ မြင့်တက်လာခဲ့ပါတယ် — set ထဲမှာ အကျယ်ဆုံးကွာဟချက်ပါ။
Decode Heavy (1k/8k): Halo သည် 127 tok/s အထိ ရောက်ရှိခဲ့ပြီး၊ batch size 64 (2.4x ခန့်) တွင် Spark ၏ 305 နှင့် နှိုင်းယှဉ်ပါက ဖြစ်သည်။
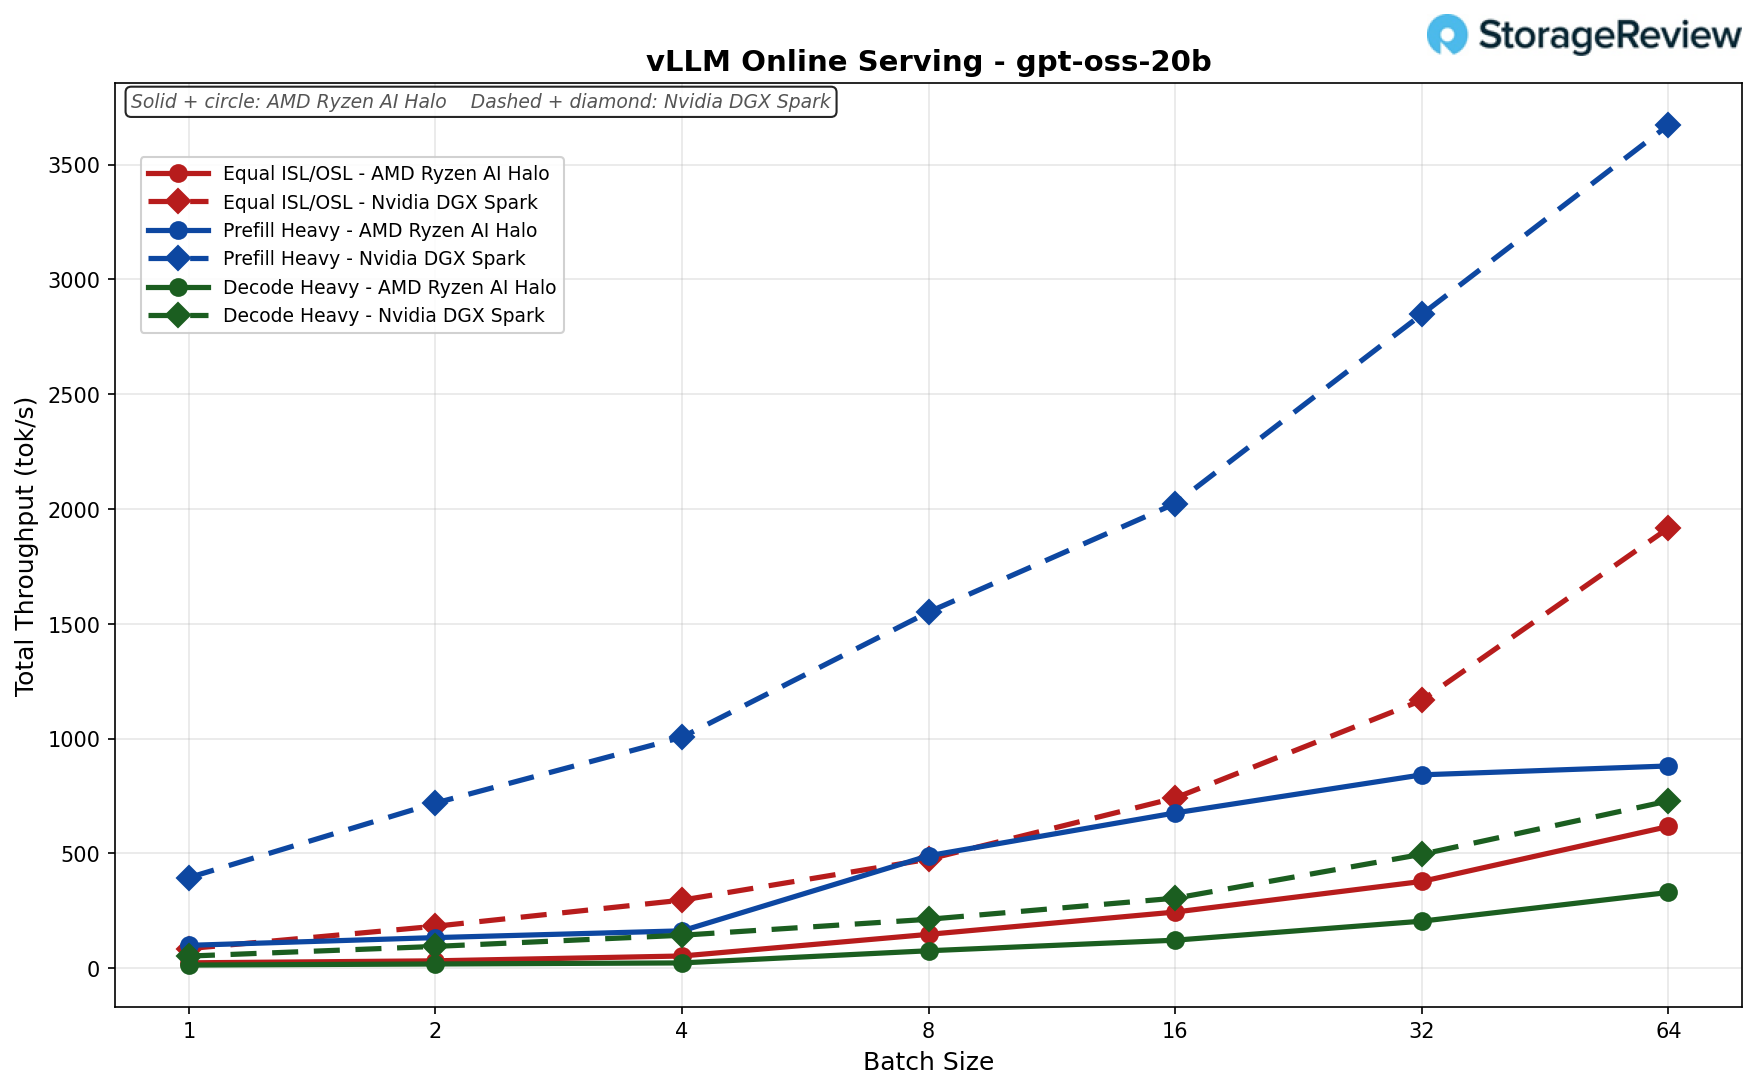
GPT OSS 20B
Equal ISL/OSL (၂၅၆/၂၅၆): Spark သည် အသုတ်တိုင်းတွင် ဦးဆောင်ခဲ့ပြီး အသုတ် ၆၄ တွင် ၆၁၇ tok/s ရှိပြီး 1,917 အထိ မြင့်တက်လာသည် (Spark သည် ၃.၁ ဆခန့် သာလွန်သည်)။
Prefill Heavy (8k/1k): Spark ၏ အားအကောင်းဆုံး ဦးဆောင်မှုဖြစ်ပြီး batch size 64 တွင် 881 tok/s ထက် 3,672 အထိ မြင့်တက်လာသည် (Spark သည် 4.2 ဆခန့် ရှေ့ရောက်နေသည်)။
Decode Heavy (1k/8k): Spark သည် batch 64 တွင် 330 tok/s တွင် 728 ရောက်ရှိခဲ့ပြီး (Spark သည် 2.2 ဆခန့် ရှေ့ရောက်နေသည်) တစ်လျှောက်လုံးတွင် ဦးဆောင်နေသည်။
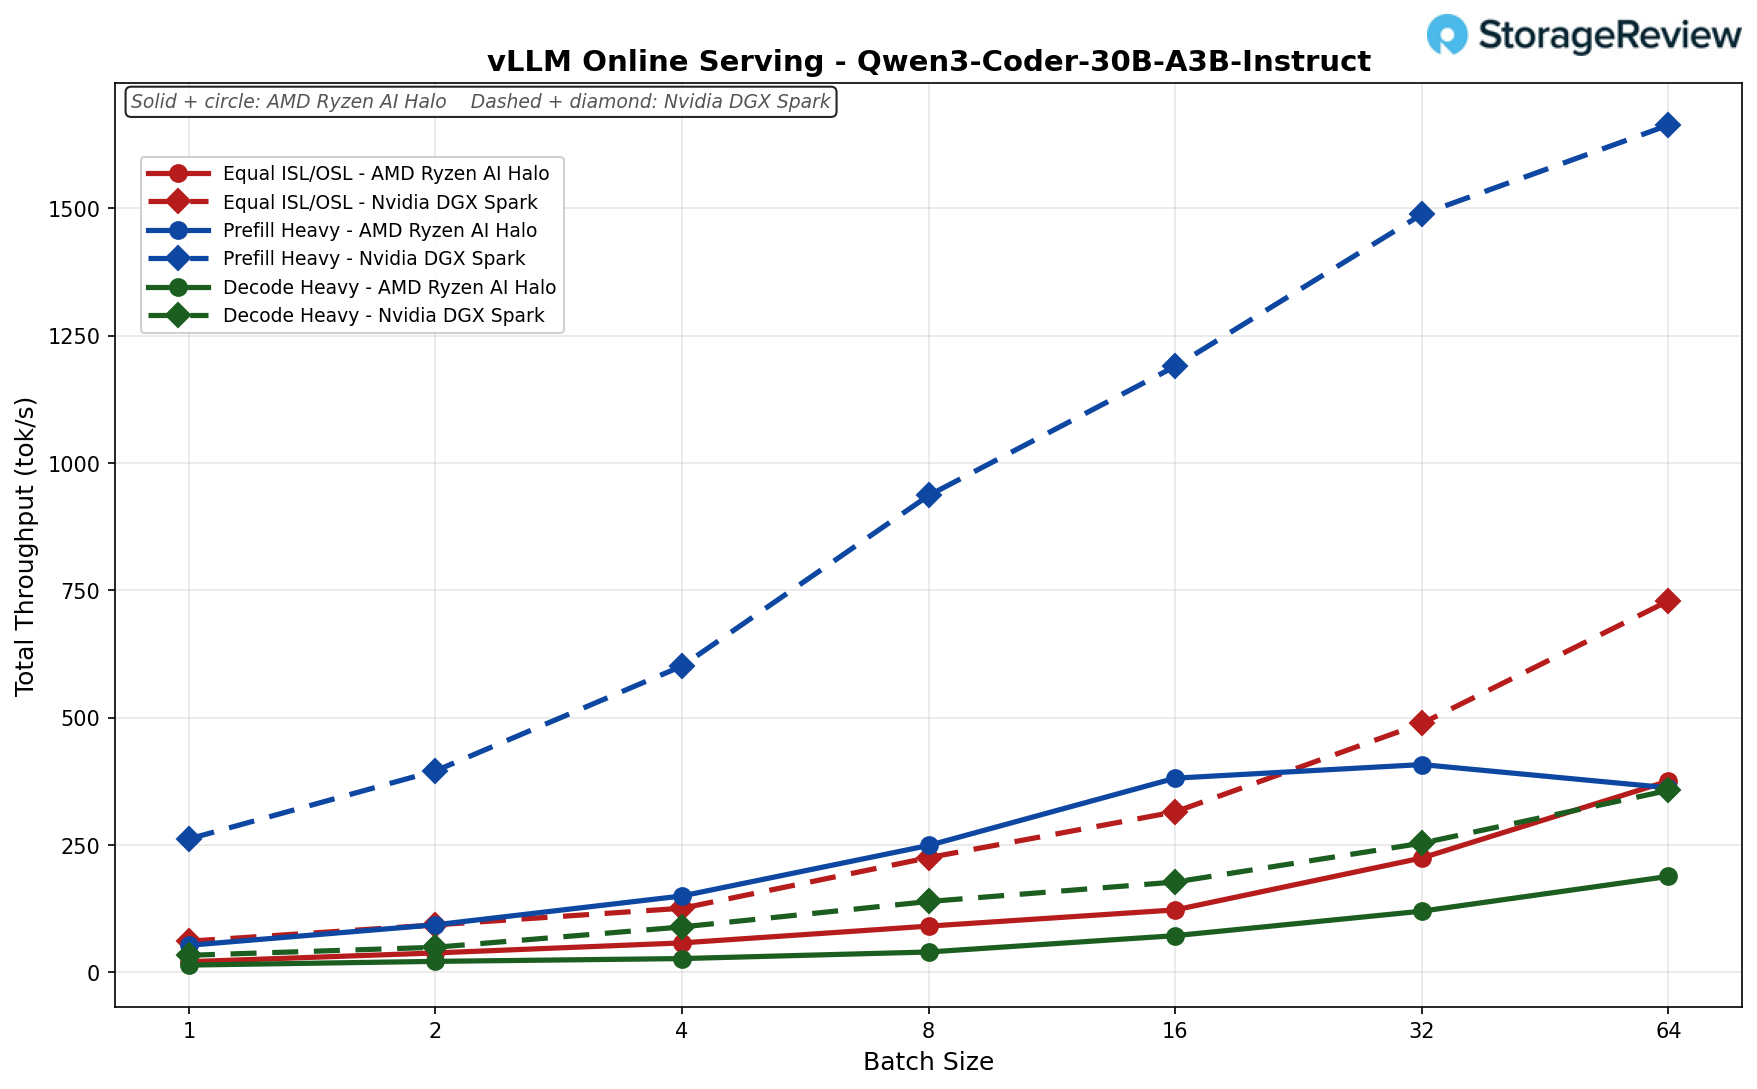
Qwen3 Coder 30B A3B ညွှန်ကြားချက်
Equal ISL/OSL (၂၅၆/၂၅၆): Halo သည် အသုတ်အရွယ်အစား ၆၄ တွင် ၃၇၆ tok/s အထိ တိုးလာပြီး Spark ၏ ၇၂၉ ၏ ထက်ဝက်ခန့် (၁.၉x ခန့်) ဖြစ်ပြီး ပိုမိုတင်းကျပ်သော Equal ISL/OSL ရလဒ်များထဲမှ တစ်ခုဖြစ်သည်။
Prefill Heavy (8k/1k): Halo သည် batch 32 (408 tok/s) တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး၊ batch 64 တွင် 362 သို့ ကျဆင်းသွားကာ Spark ၏ 1,663 (4.6x ခန့်) ထက် နောက်ကျကျန်နေခဲ့သည်။
Decode Heavy (1k/8k): Halo သည် 188 tok/s အထိ ရောက်ရှိခဲ့ပြီး၊ batch size 64 (1.9x ခန့်) တွင် Spark ၏ 357 နှင့် နှိုင်းယှဉ်ပါက ဖြစ်သည်။
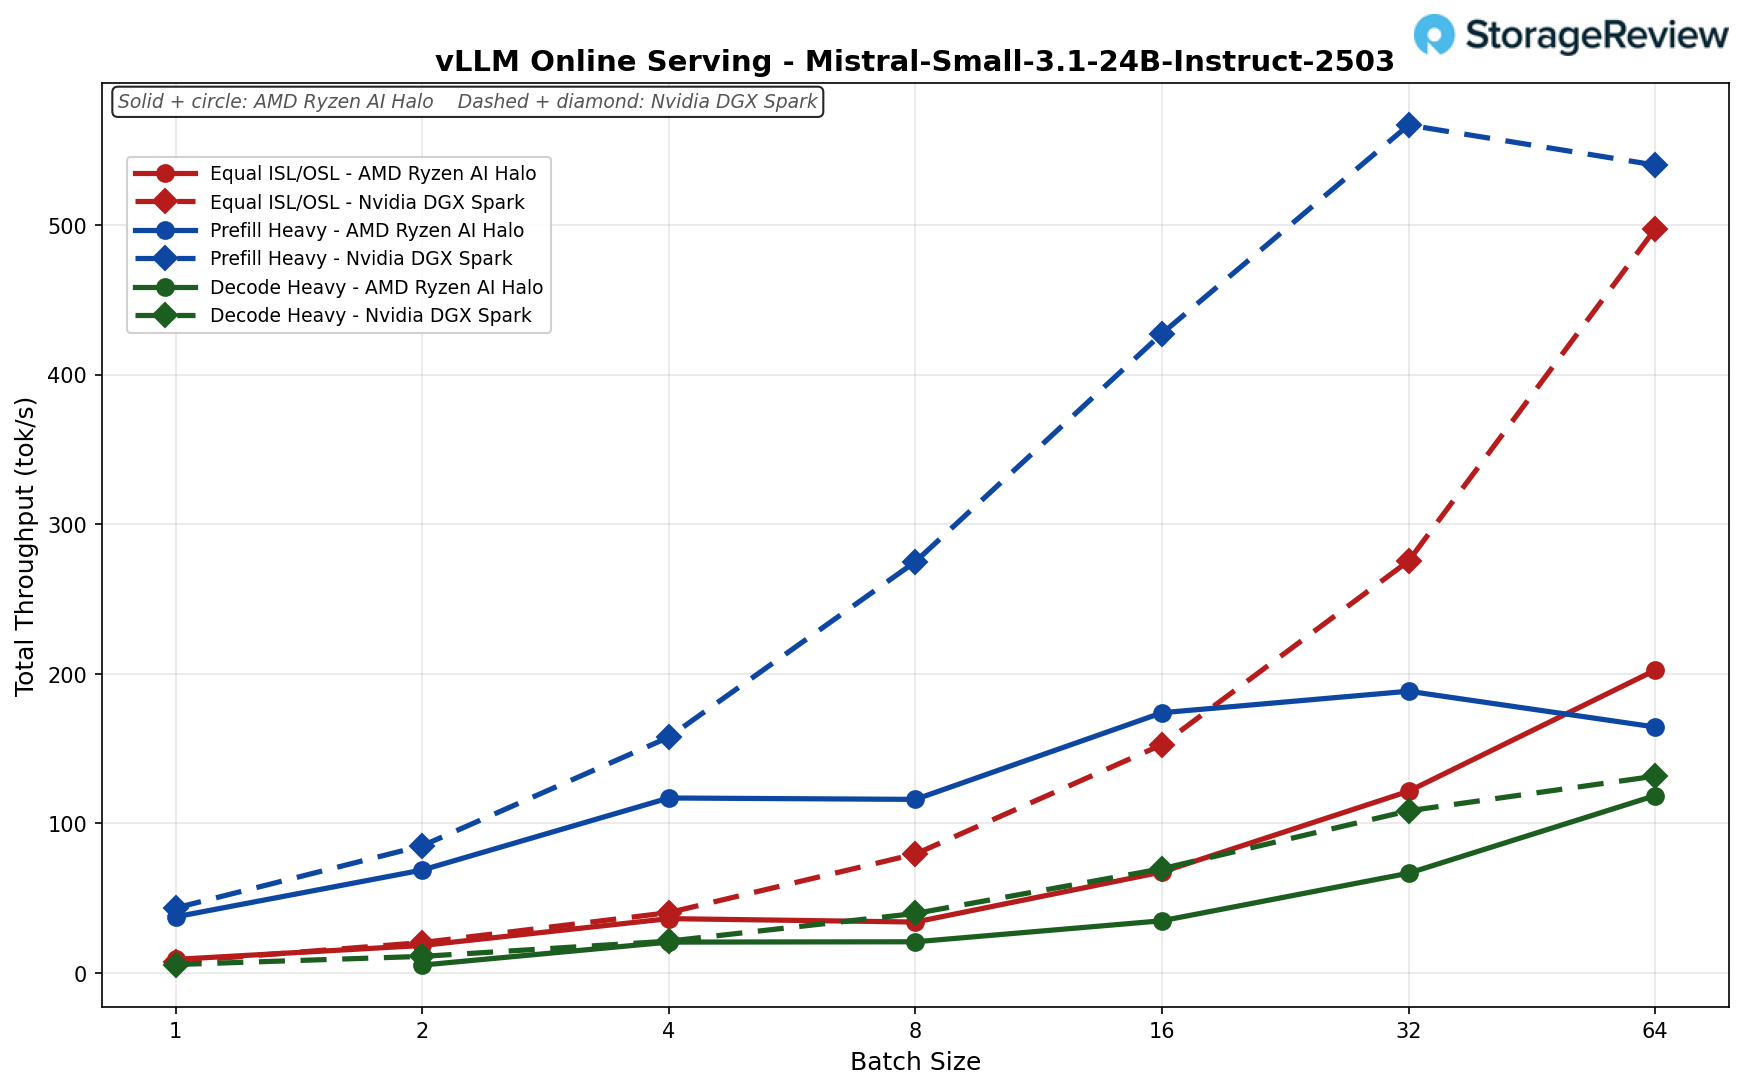
Mistral Small 3.1 24B ညွှန်ကြားချက်
Equal ISL/OSL (၂၅၆/၂၅၆): Halo ဟာ batch 1 (၉ vs ၈ tok/s) မှာ အမှန်တကယ် ဦးဆောင်ခဲ့ပြီး batch 64 မှာ ၂၀၂ tok/s အထိ ရောက်ရှိခဲ့ပြီး Spark ကတော့ ၄၉၈ (၂.၅ ဆ နောက်ကျ) မှာ ရှိခဲ့ပါတယ်။
Prefill Heavy (8k/1k): Halo သည် အသုတ် 32 (188 tok/s) တွင် အထွတ်အထိပ်သို့ ရောက်ရှိခဲ့ပြီး အသုတ် 64 တွင် 164 သို့ အနည်းငယ် ကျဆင်းသွားကာ Spark ၏ 540 (3.3x ခန့်) ထက် နောက်ကျကျန်နေခဲ့သည်။
Decode Heavy (1k/8k): တစ်လျှောက်လုံးနီးပါး တူညီနေတဲ့ Halo ဟာ batch 64 မှာ Spark ရဲ့ 132 tok/s နဲ့ ယှဉ်ရင် 119 tok/s ရောက်ခဲ့ပါတယ် (၁၁% လောက်အတွင်း)။
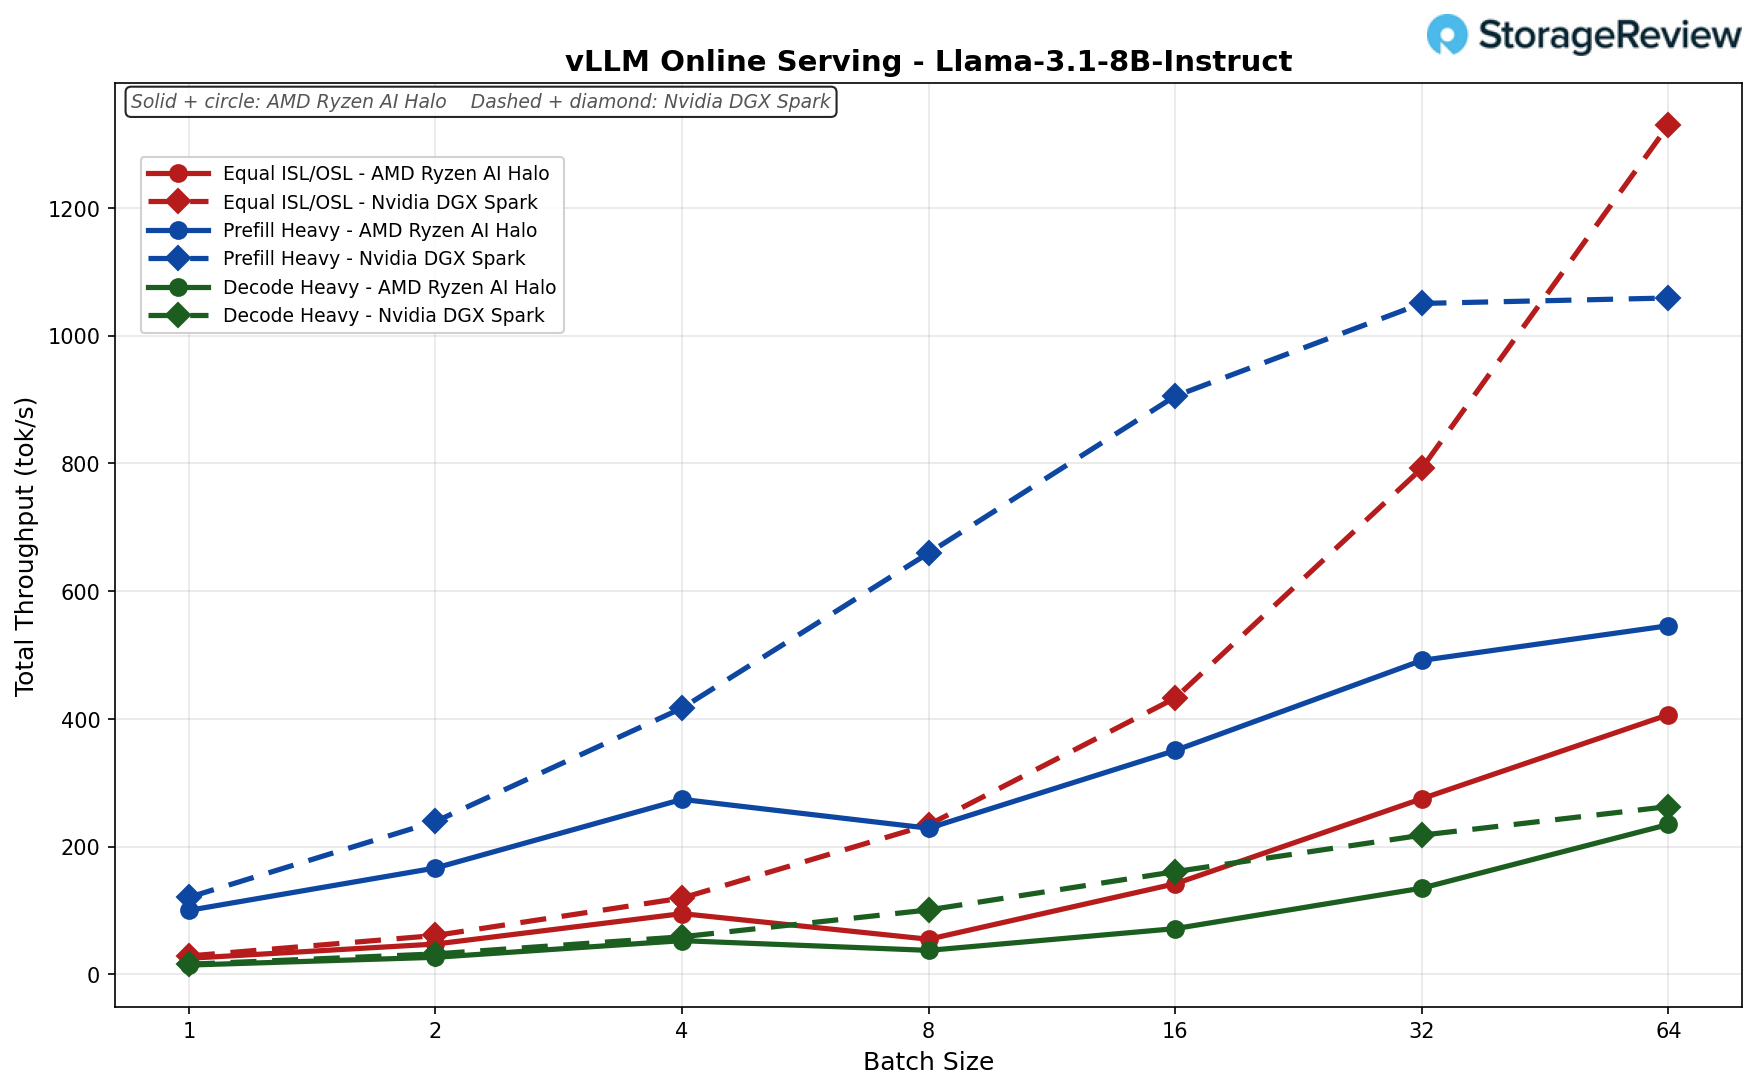
Llama 3.1 8B ညွှန်ကြားချက်
Equal ISL/OSL (၂၅၆/၂၅၆): Halo သည် အသုတ် ၁ တွင် ၂၅ tok/s မှ အသုတ် ၆၄ တွင် ၄၀၇ tok/s အထိ ရှင်းလင်းစွာ တိုးချဲ့ခဲ့ပြီး အသုတ် ၄ တွင် Spark ကို အနီးကပ် ခြေရာခံခဲ့ပြီးနောက် Spark သည် ၁၃၃၀ အထိ ဦးဆောင်ခဲ့သည် (Halo သည် အမြင့်ဆုံးတွင် ၃.၃ ဆခန့် နောက်ကျကျန်နေခဲ့သည်)။
Prefill Heavy (8k/1k): Halo သည် အသုတ်အရွယ်အစား 64 တွင် 546 tok/s ရောက်ရှိခဲ့ပြီး Spark ၏ 1,059 tok/s ၏ ထက်ဝက်ခန့်ကို ထိန်းထားနိုင်သည်။
Decode Heavy (1k/8k): Halo ရဲ့ အပြိုင်အဆိုင်အရှိဆုံး အခြေအနေဖြစ်ပြီး၊ Spark ရဲ့ 263 နဲ့ ယှဉ်ရင် 235 tok/s အထိ ရောက်ရှိပြီး batch size 64 (12% ခန့်အတွင်း) ရှိပါတယ်။
လာမာ ၃.၁ ၈ဘီ ညွှန်ကြားချက် FP၄
Equal ISL/OSL (၂၅၆/၂၅၆): Halo သည် batch size 64 တွင် 267 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး Spark ၏ 3,573 ထက် များစွာနောက်ကျကျန်နေ — FP4 သည် အကျယ်ဆုံးကွာဟချက်ကို ပြသသည် (13.4x ခန့်)။
Prefill Heavy (8k/1k): Halo သည် batch size 64 တွင် 457 tok/s ရောက်ရှိခဲ့ပြီး Spark ၏ 2,713 (5.9x ခန့်) ရှိသည်။
Decode Heavy (1k/8k): Halo သည် 146 tok/s အထိ မြှင့်တင်ထားပြီး၊ Spark ၏ 588 tok/s သည် batch size 64 (4x ခန့်) တွင် ရှိသည်။
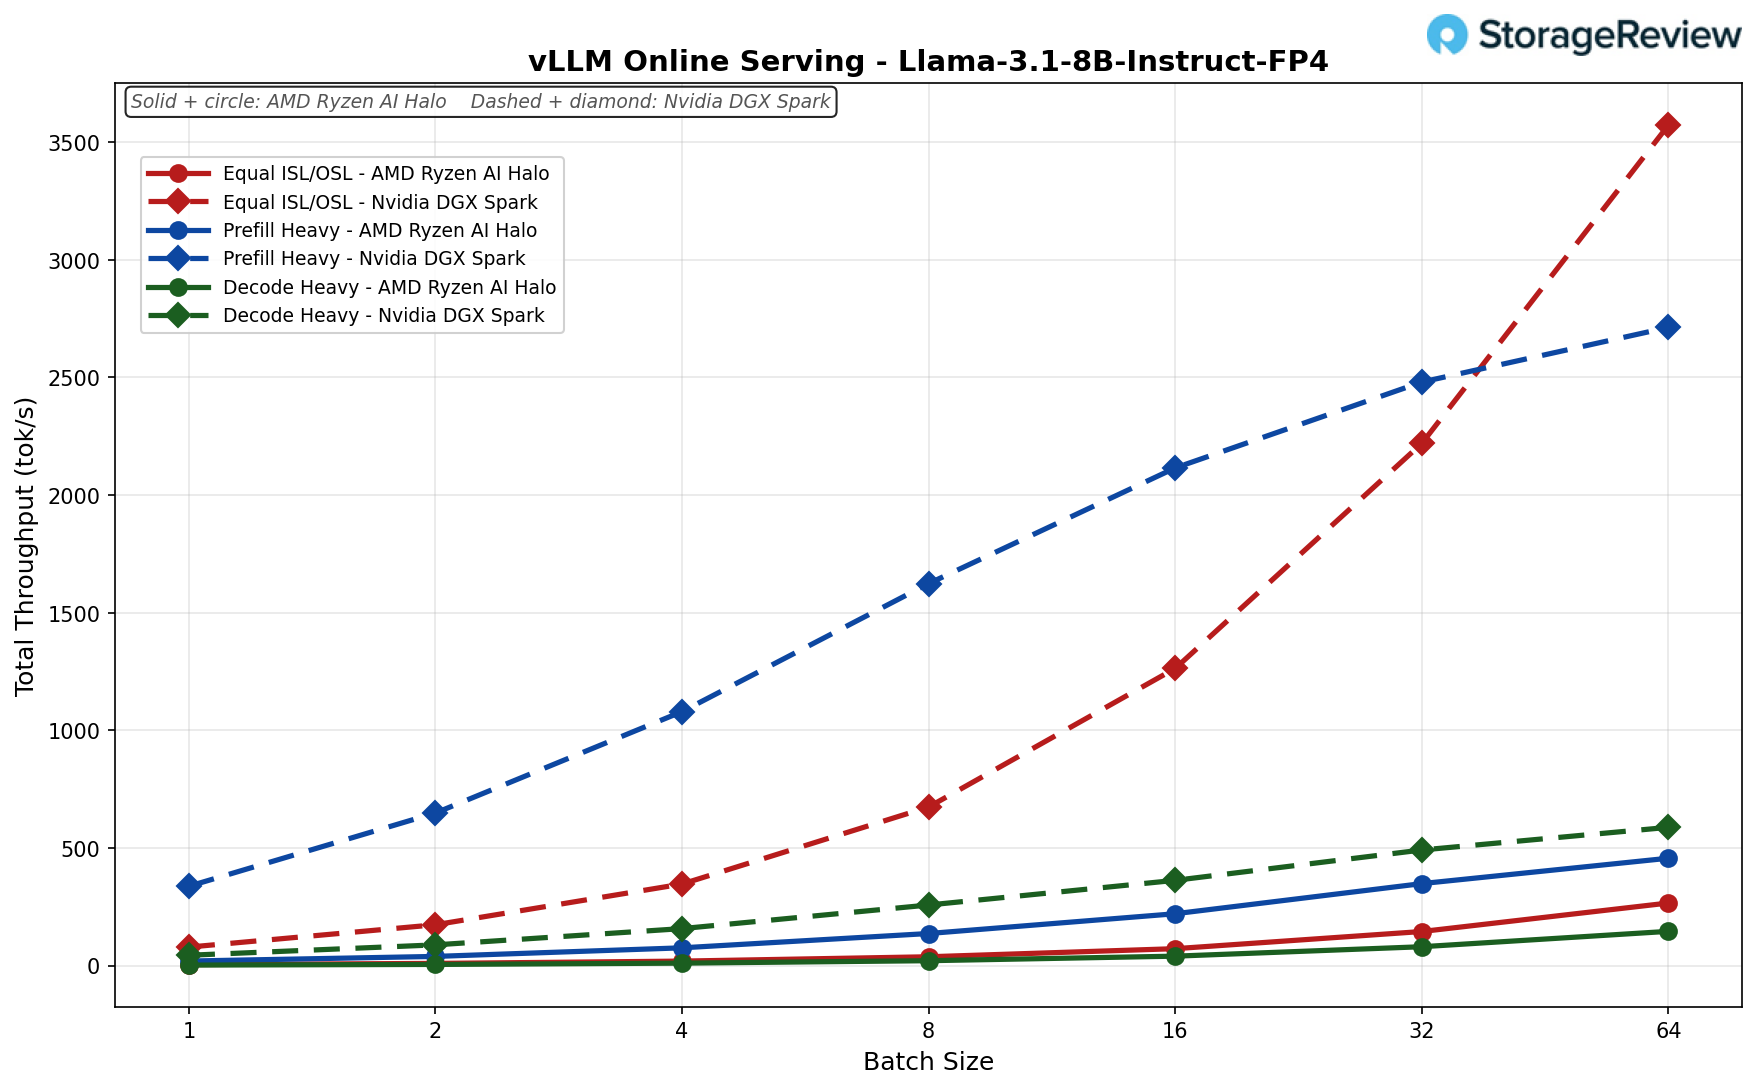
ကောက်ချက်
AMD Ryzen AI Halo သည် NVIDIA မှ DGX Spark ဖြင့် ထိထိရောက်ရောက် ဖန်တီးထားသော အမျိုးအစားတွင် ပါဝင်ပြီး၊ ၎င်း၏ကိုယ်ပိုင်ဂိမ်းတွင် Spark ကို အနိုင်ယူရန် မကြိုးစားပါ။ ကျွန်ုပ်တို့၏ vLLM sweeps များတွင်၊ Spark သည် မြင့်မားသော concurrency တွင် အခြေအနေအများစုတွင် 2x မှ 4x throughput အားသာချက်ကို ထိန်းသိမ်းထားနိုင်ပြီး prefill-heavy GPT OSS 120B အလုပ်တွင် 8.8x အထိ ကျယ်ပြန့်ပြီး decode-heavy runs နှစ်ခုတွင်သာ 10% ခန့်အထိ ကျဉ်းမြောင်းသွားပြီး ၎င်း၏ storage subsystem သည် saturation တွင် fio စမ်းသပ်မှုတိုင်းနီးပါးကို အနိုင်ရခဲ့သည်။ ယင်းအစား Halo မှ ပေးဆောင်သည်မှာ အလားတူ footprint တွင် တူညီသော unified memory 128GB နှင့် 200-billion-parameter ceiling ဖြစ်ပြီး Spark Founders Edition ၏ $4,699 (OEM အချို့တွင် ၎င်းတို့ကို $4,000 အောက်ဖြင့် ရောင်းချသော်လည်း) ဖြင့် အလားတူ footprint တွင် $3,999 ဖြင့် ရရှိနိုင်ပြီး DGX OS တစ်ခုတည်းအစား Windows 11 သို့မဟုတ် Linux ကို boot လုပ်သည့် full x86 စက်တွင် ရှိပါသည်။
Spark ကို ခဏထားလိုက်ပါ၊ Halo က ကျွန်တော်တို့ စမ်းသပ်ဖူးသမျှထဲမှာ အားအကောင်းဆုံး Ryzen AI Max+ 395 implementation ပါ။ ကျွန်တော်တို့ စမ်းသပ်ခဲ့တဲ့ Windows workload တိုင်းလိုလိုမှာ HP Z2 Mini G1a နဲ့ ZBook Ultra G1a တို့ကို ယှဉ်ပြီး အမှတ်အများဆုံး ရခဲ့ပါတယ်- Cinebench R23 multi-core မှာ 37,316၊ 7-Zip မှာ GIPS 184.2 နဲ့ HP တွေအတွက် 151.6 နဲ့ 156.8၊ Procyon AI text and image generation score အမြင့်ဆုံးနဲ့ y-cruncher times 5 နဲ့ 10 billion digits မှာ အမြန်ဆုံးပါ။ Linux မှာတော့ Spark နဲ့ ယှဉ်ရင် CPU-bound Phoronix စမ်းသပ်မှုတွေကို ပြတ်ပြတ်သားသား အနိုင်ရခဲ့ပြီး 7-Zip မှာ 11% ပိုမြန်တဲ့ compression နဲ့ LLVM compile ကို 14% ပိုစောပြီး အပြီးသတ်နိုင်ခဲ့ပါတယ်။ ဒါက သေးငယ်တဲ့ workstation တစ်ခုဖြစ်ပြီး၊ AI developer role ကို အစားထိုးမယ့်အစား အပေါ်ကနေ layer လုပ်ထားပါတယ်။
တစ်စက္ကန့်လျှင် အများဆုံး ဒေသတွင်းတိုကင်များ လိုအပ်သော သို့မဟုတ် မြန်နှုန်းမြင့် fabric ပေါ်တွင် node များကို cluster လုပ်ရန် စီစဉ်ထားသော developer များသည် Spark ကို ဝယ်ယူသင့်ပါသည်။ Halo ၏ 10GbE နှင့် ၎င်း၏ vLLM အမြင့်ဆုံးပမာဏသည် မနီးစပ်ပါ။ ROCm ကို ဆန့်ကျင်၍ တည်ဆောက်နေသော developer များအတွက်၊ Windows လိုအပ်သော အဖွဲ့များ သို့မဟုတ် ပရော်ဖက်ရှင်နယ် workload များနှင့် ဒေသတွင်းမော်ဒယ်လုပ်ငန်းကို ဖြည့်ဆည်းရန် box တစ်ခု လိုချင်သူတိုင်းအတွက် Halo သည် ပိုမိုသင့်လျော်ပြီး standard M.2 2280 bay နှင့် pre-tuned Variable Graphics Memory သည် Spark ပိုင်ရှင်များ ထောက်ပြသော အဖြစ်အများဆုံး တိုင်ကြားချက်နှစ်ခုကို ဖယ်ရှားပေးပါသည်။ AMD သည် တတိယသုံးလပတ်တွင် Ryzen AI Max PRO 400 Series silicon ကို 192GB အထိ unified memory ဖြင့် ရယူမည်ဟုလည်း ပြောကြားခဲ့ပြီး ပိုမိုကြီးမားသော မော်ဒယ်များကို လိုက်စားသော ဝယ်ယူသူများသည် platform များကို မပြောင်းလဲဘဲ ရှေ့ဆက်ရန် ရှင်းလင်းသော လမ်းကြောင်းတစ်ခု ရှိပါသည်။
ထုတ်ကုန်စာမျက်နှာ – AMD Ryzen AI Halo

ဦးဆောင်သူစာရင်း- AMD Ryzen AI Halo သည် ကျွန်ုပ်တို့၏ Best Desktops for Local AI ဦးဆောင်သူစာရင်းတွင် Best x86 Alternative နေရာကို ရယူထားသည်။



 အမေဇုံ