

Lenovo ThinkPad P1 Gen 9 သည် Lenovo ၏ ပါးလွှာသော flagship မိုဘိုင်း workstation တစ်ခုဖြစ်သည်။ ဤ ၁၆ လက်မ စက်တွင် ThinkPad P လိုင်း၏ ကျန်အပိုင်းများ၏ ပရီမီယံအင်္ဂါရပ်များကို အလေးချိန်နှင့် ဈေးနှုန်းပစ်မှတ်များနှင့် ကိုက်ညီစေရန် တပ်ဆင်ထားသည်။ ၎င်းသည် ရှေ့အနားတွင် ၉.၈၇ မီလီမီတာရှိပြီး ၁.၈ ကီလိုဂရမ်အောက်ရှိသော အလူမီနီယမ်ကိုယ်ထည်၊ 140W အားသွင်းစနစ်ပါရှိသော 90Wh ဘက်ထရီ၊ Thunderbolt 5 port နှစ်ခု၊ Gen5 x4 bay ပါရှိသော dual M.2 slot များနှင့် 800-nit 3840×2400 IPS panel သို့မဟုတ် 120Hz Tandem OLED တို့ကို ရွေးချယ်နိုင်သည်။
ကျွန်ုပ်တို့ရဲ့ သုံးသပ်ချက်ယူနစ်မှာ Core Ultra 9 386H ကို LPCAMM2 မော်ဂျူးတစ်ခုပေါ်မှာ 64GB LPDDR5X-8533 နဲ့ တွဲဖက်ထားပြီး 2TB SK hynix Gen5 SSD၊ RTX PRO 2000 Blackwell နဲ့ 4K IPS မျက်နှာပြင်တို့ ပါဝင်ပါတယ်။ Lenovo.com က ၂၀၂၆ ခုနှစ် အောက်တိုဘာလ ၂၄ ရက်နေ့အထိ OLED panel ပါဝင်တဲ့ build တစ်ခုတည်းကို ဒေါ်လာ ၇,၇၁၉ နဲ့ စာရင်းသွင်းထားပြီး နှစ်ရက်အလိုမှာ ဒေါ်လာ ၅,၃၉၉ နဲ့ ရောင်းချခဲ့ပါတယ်။ Lenovo က P line ကို မကြာခဏ လျှော့တွက်လေ့ရှိတာကြောင့် ရောင်းချမယ့်ဈေးနှုန်းက ပိုကောင်းတဲ့ အခြေခံဖြစ်ပြီး ကျွန်ုပ်တို့က နိဂုံးချုပ်အနေနဲ့ အသုံးပြုပါတယ်။
ဒီဆိုက်မှာ ဒီ processor နဲ့ GPU ပါတဲ့ 4K IPS panel ကို မဖော်ပြထားပါဘူး။ အနီးစပ်ဆုံး IPS build ဖြစ်တဲ့ RTX PRO 2000, 32GB, နဲ့ 1TB ပါတဲ့ Core Ultra 7 356H ရဲ့ ဈေးနှုန်းက အောက်တိုဘာ ၂၂ ရက်နေ့မှာ ဒေါ်လာ ၃၄၄၉ နဲ့ ရောင်းချပြီးနောက် ဒေါ်လာ ၅၀၉၉ ဖြစ်ပါတယ်။ build-your-own configurations တွေကတော့ 16GB နဲ့ 512GB ပါတဲ့ ဒေါ်လာ ၃၇၃၄ ကနေ စတင်ရောင်းချသွားမှာပါ။
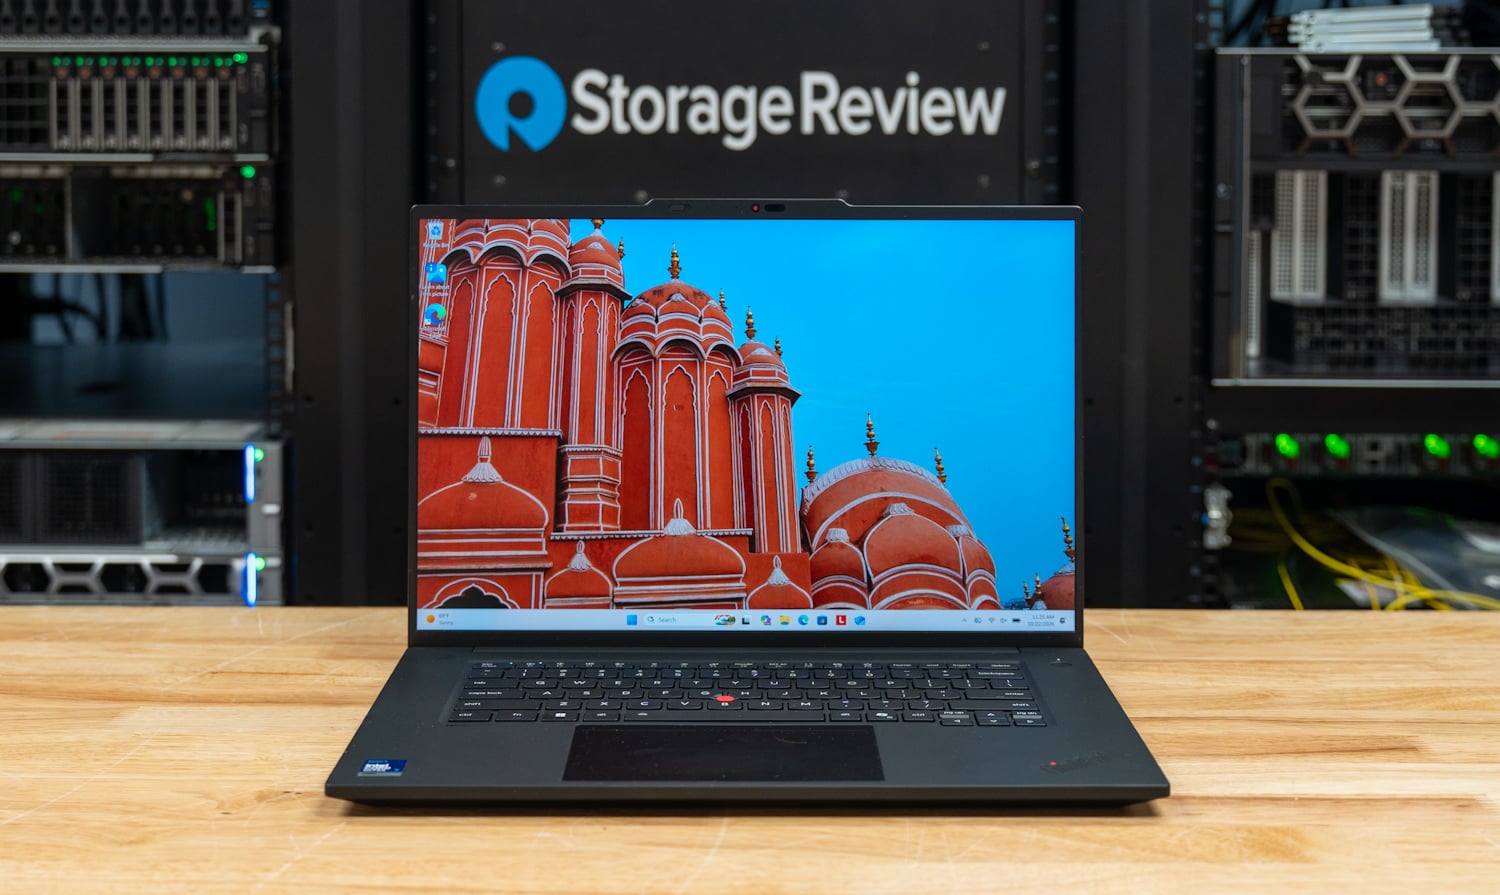
Lenovo သည် P16-class chassis မပါဘဲ ISV-certified graphics ကို လိုချင်သော ဖန်တီးမှုဆိုင်ရာ ပရော်ဖက်ရှင်နယ်များ၊ အင်ဂျင်နီယာများနှင့် AI developer များကို ပစ်မှတ်ထားသည်။ Gen 9 သည် Gen 8 ကဲ့သို့ပင် ကိုယ်ထည်တွင် silicon update တစ်ခုဖြစ်ပြီး 50 TOPS NPU ပါရှိသော Intel ၏ Core Ultra Series 3 သည် Series 2 ကို အစားထိုးထားပြီး LPCAMM2 မှတ်ဉာဏ်သည် 64GB မှ 96GB အထိ မြင့်တက်လာကာ GPU အမြင့်ဆုံးမှာ 8GB GDDR7 ပါရှိသော RTX PRO 2000 Blackwell တွင်သာ ရှိနေသည်။
Dell Pro Precision 9 T2 နှင့် RTX Spark notebook များအတွက် အသုံးပြုသည့် scripted suite ဖြင့် ကျွန်ုပ်တို့ စမ်းသပ်ခဲ့ပါသည်။ ထို့နောက် ၎င်း၏ရလဒ်များကို ယခင်မျိုးဆက် Core Ultra 9 285H နှင့် RTX PRO 2000 တပ်ဆင်ထားသော Dell Pro Max 14 Premium၊ Core Ultra X9 388H ပါဝင်ပြီး discrete GPU မပါဝင်သော Dell Pro Precision 5 16S နှင့် NVIDIA ၏ RTX Spark N1X မှ ပါဝါပေးသည့် HP OmniBook Ultra 16 တို့နှင့် နှိုင်းယှဉ်ခဲ့ပါသည်။
Panther Lake ဟာ multi-threaded work မှာ နေရာတစ်နေရာ ရရှိထားပါတယ်။ P1 ဟာ Cinebench 2026 multi-core မှာ 5,083 မှတ် ရရှိခဲ့ပြီး 285H မှာ 4,292 မှတ် ရရှိခဲ့ပါတယ်။ LLVM ကို 309.1 စက္ကန့်နဲ့ build လုပ်ခဲ့ပြီး 393.9 စက္ကန့်နဲ့ STREAM Triad မှာ 81,712MB/s read လုပ်ခဲ့ပါတယ်။ single-core Cinebench မှာ 519.9 မှတ် ရရှိခဲ့ပြီး 7 ရာခိုင်နှုန်း သာလွန်နေပြီး Speedometer ကတော့ 40.6 ရာခိုင်နှုန်းနဲ့ 41.5 ရာခိုင်နှုန်း သာလွန်နေပါတယ်။ GPU မှာတော့ P1 ရဲ့ 50W RTX PRO 2000 ဟာ MLPerf Client token rates မှာရှိတဲ့ Dell ရဲ့ 47W card ထက် 19 ရာခိုင်နှုန်းကနေ 27 ရာခိုင်နှုန်းအထိ ပိုမြန်ပါတယ်။ GDDR7 8GB က 20B နဲ့အထက် model tier တွေနဲ့ 3B အထက် serving tier တိုင်းကို လက်လှမ်းမမီအောင် ထိန်းထားပေးပါတယ်။
Key ကို Takeaways
- Multi-threaded CPU လုပ်ဆောင်ချက်သည် မျိုးဆက်တစ်ခု ရှေ့သို့ ရွေ့လျားနေပါသည်။ Cinebench 2026 multi-core မှာ 5,083 မှတ်၊ တူညီတဲ့ GPU ရှိတဲ့ Core Ultra 9 285H ထက် 18 ရာခိုင်နှုန်း သာလွန်၊ 7-Zip မှာ 93.4 မှတ်နဲ့ ယှဉ်ရင် 109.2 GIPS၊ Blender ဟာ scene သုံးခုမှာ 18 ရာခိုင်နှုန်းကနေ 23 ရာခိုင်နှုန်း မြင့်တက်ပြီး 309.1 စက္ကန့်မှာ 22 ရာခိုင်နှုန်း လျော့နည်းတဲ့ LLVM build ရရှိထားပါတယ်။
- Single-thread နှင့် browser လုပ်ဆောင်ချက်များ မပြောင်းလဲပါ- Cinebench single-core မှာ ၄၈၆.၀ နဲ့ ယှဉ်ရင် ၅၁၉.၉ မှတ်၊ Speedometer မှာ ၄၀.၆ မှတ်၊ ၄၁.၅ နဲ့ ယှဉ်ရင် ၁ threaded Python မှာ ဘယ်လမ်းမဆို ၂၈၅H ရဲ့ ၂ ရာခိုင်နှုန်းကနေ ၅ ရာခိုင်နှုန်းအတွင်း ရှိနေပါတယ်။ ၃၈၆H ကတော့ single-core မှာ Dell Pro Precision 5 16S ရဲ့ 5.1GHz Core Ultra X9 388H ထက် ၃ ရာခိုင်နှုန်း သာပါတယ်။
- မှတ်ဉာဏ်စနစ်က တိတ်ဆိတ်ငြိမ်သက်တဲ့ အဆင့်မြှင့်တင်မှုပါ။ STREAM Triad သည် LPDDR5X-8533 မှ 81,712MB/s ကို 285H တွင် 62,255 နှင့် နှိုင်းယှဉ်ပြီး ဖတ်ရှုကာ မှတ်ဉာဏ် latency သည် 173.1 မှ 116.1 ns သို့ ကျဆင်းသွားပြီး DGEMM သည် 391 မှ 519 GFLOPS အထိ မြင့်တက်သွားသည်။
- 8GB GDDR7 သည် AI အမြင့်ဆုံးအဆင့်ကို သတ်မှတ်ပေးသည်- MLPerf Client သည် Llama 3.1 8B ကို တစ်စက္ကန့်လျှင် 64.8 tokens ဖြင့် နှင့် Phi-4-mini ကို 111.9 ဖြင့် ထုတ်ပေးပြီး မော်ဒယ်ငယ်များတွင် Dell ၏ 47W RTX PRO 2000 နှင့် RTX Spark N1X နှစ်ခုလုံးထက် သာလွန်သော်လည်း ကျွန်ုပ်တို့၏ model-load နှင့် coding-agent စမ်းသပ်မှုများတွင် 20B နှင့် ပိုကြီးသော tiers များနှင့် 3B အထက် serving tiers များသည် အရည်အချင်းမပြည့်မီခဲ့ပါ။ 128GB N1X notebook နှင့် 64GB Arc Pro B390 Dell သည် model-load နှင့် coding-agent tier တိုင်းကို လုပ်ဆောင်ခဲ့သည်။
- ဈေးနှုန်းက ဈေးကွက်ကို ရှုပ်ထွေးစေပါတယ်- ဒေါ်လာ ၇,၇၁၉ စာရင်းအရ ကျွန်ုပ်တို့ရဲ့ OLED ဗားရှင်းဟာ ဒေါ်လာ ၆,၂၂၉.၉၉ တန် 128GB HP OmniBook Ultra 16 ထက် ပိုဈေးကြီးပါတယ်။ အောက်တိုဘာ ၂၂ ရက်နေ့မှာ Lenovo က ရောင်းချခဲ့တဲ့ ဒေါ်လာ ၅,၃၉၉ နဲ့ ရောင်းချတဲ့ ဈေးနှုန်းအရဆိုရင် အဲဒီစက်နဲ့ ဒေါ်လာ ၄,၉၉၉.၉၉ တန် 64GB OmniBook ကြားမှာ ရှိပါတယ်။ 128GB ယူနစ်ဟာ P1 မလုပ်ဆောင်နိုင်တဲ့ ဒေသတွင်း AI အဆင့်တိုင်းကို လည်ပတ်နိုင်ပြီး Ryzen AI Max unified-memory workstation တွေကလည်း အတူတူပါပဲ။ P1 ရဲ့ case မှာ ISV အသိအမှတ်ပြုလက်မှတ်၊ Thunderbolt 5 နဲ့ အဖွဲ့ထဲမှာ အမြန်ဆုံး မော်ဒယ်ငယ် GPU ပါဝင်ပြီး ဒေသတွင်း AI စွမ်းရည် မဟုတ်ပါဘူး။
- ၎င်း၏ရမှတ်ကို ထိန်းထားနိုင်လောက်အောင် အေးမြသည်- မိနစ် ၃၀ ကြာ Cinebench loop သည် ၎င်း၏ပထမဆုံးအကြိမ် pass ၏ 4,811, 0.983 တွင် 3,505MHz ပျမ်းမျှနာရီတွင် ရပ်တန့်သွားပြီး CPU ကို 94.1C တွင် pin လုပ်ထားသည်။ 2TB PCB01 သည် 10,012MB/s ကို အစဉ်လိုက်ဖတ်ရှုပြီး 4K ကျပန်းဖတ်ရှုမှုများတွင် 756.5K IOPS တွင် အမြင့်ဆုံးရောက်ရှိသည်။
P1 Gen 9 ရဲ့ တည်နေရာ
Lenovo ဟာ မတ်လမှာ ThinkPad P14s Gen 7 နဲ့ P16s Gen 5 တို့နဲ့အတူ P1 Gen 9 ကို ကြေညာခဲ့ပြီး ဇွန်လမှာ ရရှိနိုင်မယ့် ထုတ်ကုန်ဖြစ်ပြီး ၎င်းရဲ့ တည်ဆောက်ဖူးသမျှထဲမှာ စွမ်းဆောင်ရည်အမြင့်ဆုံး ThinkPad လို့ ခေါ်ဆိုပါတယ်။ P16s Gen 5 မှာ Core Ultra Series 3 processors တွေ၊ 96GB LPCAMM2 ceiling နဲ့ RTX PRO 2000 option တွေ ပါဝင်တာကြောင့် GPU က ဒီနှစ်ခုကို ခွဲခြားထားတာမျိုး မဟုတ်တော့ပါဘူး။ P1 ဟာ ကိုယ်ထည်နဲ့ Lenovo ရဲ့ စွမ်းဆောင်ရည်တွေကြောင့် သူ့ရဲ့ အားသာချက်ကို ရရှိခဲ့ပါတယ်။
P16s နဲ့ယှဉ်ရင် 60Wh အစား 90Wh ဘက်ထရီ၊ 100W အစား 140W adapter၊ Thunderbolt 5 port နှစ်ခုနဲ့ Thunderbolt 4 နှစ်ခုအစား Thunderbolt 4 တစ်ခု၊ တစ်ခုအစား M.2 slot နှစ်ခု၊ SD Express 7.0 reader တစ်ခု၊ optional 5G၊ all-aluminum shell နဲ့ premium panel နှစ်ခုပါဝင်ပြီး P16s ကတော့ 1.79kg ပဲရှိပါတယ်။ အားလုံးက 1.77kg ပဲရှိပါတယ်။
၎င်းအထက်တွင် ThinkPad P16 Gen 3 သည် HX silicon ပါသည့် 16-လက်မ အပြည့်ပါဝါအဖြစ် ဆက်လက်တည်ရှိနေပြီး RTX PRO 5000 အထိ ရှိသည်။ ThinkPad P16v Gen 3 သည် 285H နှင့် 2.1kg အလေးချိန်ရှိသော 16 ရှိပြီး RTX PRO 2000 နှင့် အတူတူပင်ဖြစ်သည်။ နှစ်ခုစလုံးသည် Series 3 သို့ မပြောင်းရသေးပါ။
P1 ရဲ့ ထိပ်တန်း GPU က RTX PRO 2000 ဖြစ်ပြီး အောက်ဆုံးမှာ RTX PRO 1000 ရှိပြီး Gen 8 ကနေ မပြောင်းလဲပါဘူး။ discrete GPU က processor ကို ဆုံးဖြတ်ပေးပါတယ်။ Lenovo က dGPU ကို Arc Pro B390 integrated graphics နဲ့ မတွဲဖက်ထားတာကြောင့် RTX PRO 2000 configuration တွေကို Core Ultra 7 356H ဒါမှမဟုတ် Core Ultra 9 386H နဲ့ တွဲဖက်ပေးထားပါတယ်။ အဲဒီ configuration တွေမှာ four-Xe-core integrated GPU နဲ့ top out 4.9GHz ရှိပြီး Core Ultra X7 368H နဲ့ X9 388H တွေကတော့ 12-Xe-core B390 နဲ့ 5.1GHz ပါဝင်တဲ့ integrated-only build တွေ ဖြစ်ပါတယ်။
ဒါကြောင့် X9 388H နဲ့ B390 ပါတဲ့ Dell Pro Precision 5 16S ဟာ ဒီနှိုင်းယှဉ်ချက်မှာ ပါဝင်နေတာပါ။ Panther Lake workstation ကို configure လုပ်ဖို့ တခြားနည်းလမ်းတစ်ခုဖြစ်ပြီး RTX PRO 2000 က ဘာတွေဝယ်လဲ၊ ပိုမြန်တဲ့ CPU က ဘာတွေပြန်ပေးလဲဆိုတာကို သူတို့အတူတကွ ပြသပေးပါတယ်။
မျိုးဆက်တစ်ခုပြီးတစ်ခု Gen 9 သည် ဆီလီကွန်အသစ်ပါရှိသော Gen 8 ကိုယ်ထည်ဖြစ်သည်။ အရွယ်အစားမှာ 354.3 x 241.0 နှင့် နှိုင်းယှဉ်ပါက 354.4 x 241.2mm ဖြစ်သည်။ port အစုံ၊ display option သုံးခုနှင့် GPU option နှစ်ခုမှာ မပြောင်းလဲဘဲ အလေးချိန်မှာ 1.84 မှ 1.77kg အထိ ကျဆင်းသွားသည်။ ပြောင်းလဲမှုမှာ 13 TOPS NPU နှင့် LPDDR5X-7467 64GB အထိရှိသော Series 2 Arrow Lake-H မှ 50 TOPS NPU နှင့် LPCAMM2 96GB အထိရှိသော Series 3 Panther Lake သို့ဖြစ်သည်။ Lenovo သည် memory ကို 8533 MT/s ဖြင့် စာရင်းပြုစုထားပြီး ကျွန်ုပ်တို့၏ unit သည် 8533 တွင် လည်ပတ်နေသော 9600-rated module ကိုအသုံးပြုသည်။
တည်ဆောက်ခြင်းနှင့်ဒီဇိုင်းဆွဲခြင်း
P1 Gen 9 ဟာ အလူမီနီယမ် clamshell ဖြစ်ပြီး အရွယ်အစားက 354.4 x 241.2mm ရှိပြီး ရှေ့အနားက 9.87mm၊ နောက်ဘက်မှာ 15.8mm နဲ့ ခြေထောက်မှာ အများဆုံး 20.6mm ရှိပါတယ်။ Lenovo က 1.77kg အလေးချိန်ရှိတယ်လို့ ဖော်ပြထားပါတယ်။ အဖုံးနဲ့ အောက်ခံနှစ်ခုစလုံးက အလူမီနီယမ်ဖြစ်ပြီး Lenovo က အပေါ်အဖုံးက ပြန်လည်အသုံးပြုထားတဲ့ အလူမီနီယမ် ၇၅ ရာခိုင်နှုန်းနဲ့ အောက်ခြေက ၅၅ ရာခိုင်နှုန်းဖြစ်တယ်လို့ ဖော်ပြထားပြီး စက်ကလည်း P လိုင်းရဲ့ ကျန်တဲ့ဖုန်းတွေလိုပဲ MIL-STD-810H စမ်းသပ်မှုကို ခံယူထားပါတယ်။ ကျွန်တော်တို့ရဲ့ ယူနစ်က အနက်ရောင်ဖြစ်ပြီး တစ်ခုတည်းသော အရောင်ဖြစ်ပါတယ်။

မျက်နှာပြင်က ၁၆ လက်မ 3840×2400 IPS panel ဖြစ်ပြီး 800 nits ပေးစွမ်းနိုင်ပြီး 16:10 anti-glare screen ပါဝင်ကာ DCI-P3 coverage 100 ရာခိုင်နှုန်း၊ DisplayHDR 400၊ Dolby Vision နဲ့ X-Rite factory calibration at 60Hz တို့ ပါဝင်ပါတယ်။ Lenovo က entry build တွေမှာ 1920×1200 500-nit IPS panel နဲ့ pen support ပါဝင်တဲ့ 3200×2000 Tandem OLED touch panel ပါဝင်ပြီး 600 nits SDR နဲ့ 1,500 nits HDR peak ပါဝင်ပြီး 40 ကနေ 120Hz variable refresh rate ပါဝင်ပါတယ်။ ဒီ panel မှာ ဝယ်သူအများစုက color work အတွက် ရွေးချယ်ကြပါတယ်။ ဒီ resolution မှာ Windows က 250 ရာခိုင်နှုန်း scaling ကို default အနေနဲ့ ပေးထားပါတယ်။

ကီးဘုတ်သည် Copilot key၊ backlighting နှင့် spill resistance ပါရှိသော six-row ThinkPad layout ဖြစ်ပြီး TrackPoint နှင့် အောက်တွင် glass haptic touchpad (85 x 135mm) ပါရှိသည်။ power ခလုတ်တွင် match-on-chip fingerprint reader ပါရှိပြီး display အပေါ်ရှိ 5MP ကင်မရာတွင် Windows Hello အတွက် IR sensor နှင့် physical privacy shutter နှင့် computer-vision presence detection တို့ တွဲဖက်ထားသည်။ Wi-Fi မော်ဒယ်တွင် Dolby Atmos ပါရှိသော 2W speakers တစ်စုံပါဝင်ပြီး WWAN မော်ဒယ်တွင် 1W drivers တစ်စုံ ထပ်မံထည့်သွင်းထားသည်။

port များကို ဘေးနှစ်ဖက်စလုံးတွင် တပ်ဆင်ထားပြီး DisplayPort 2.1 နှင့် 140W power input ပါရှိသော Thunderbolt 5 port နှစ်ခု၊ HDMI 2.1 port တစ်ခုနှင့် ဘယ်ဘက်တွင် audio jack တစ်ခု ပါဝင်သည်။ ညာဘက်တွင် Lenovo မှ အစားထိုး module အဖြစ် တည်ဆောက်ထားသော Thunderbolt 4 port၊ အမြဲတမ်းဖွင့်ထားသော အားသွင်းစနစ်ပါရှိသော 10Gbps USB-A port၊ SD Express 7.0 reader၊ Kensington Nano slot နှင့် 5G မော်ဒယ်များတွင် Nano-SIM tray တို့ ပါဝင်သည်။ onboard Ethernet မပါဝင်ပါ။ Lenovo သည် အချို့သော configuration များတွင် USB-C မှ 2.5GbE adapter ကို ပေါင်းစပ်ထားပြီး အချို့သော configuration များတွင် option အဖြစ် စာရင်းသွင်းထားသည်။ USB-C port သုံးခုသည် external display သုံးခုကို 5120×3200 resolution အထိ သို့မဟုတ် 8K60 panel တစ်ခုတည်းဖြင့် မောင်းနှင်နိုင်သည်။


အောက်ခြေအဖုံးကို ဝန်ဆောင်မှုအတွက် ဖြုတ်ပြီး BIOS တွင် tamper detection ပါရှိသည်။ LPCAMM2 မှတ်ဉာဏ်မော်ဂျူးကို 96GB အထိ ဖောက်သည်များ အစားထိုးနိုင်ပြီး M.2 2280 slot နှစ်ခုမှာ Gen5 x4 တစ်ခုနှင့် RAID 0 နှင့် 1 ပံ့ပိုးမှုပါရှိသော Gen4 x4 တစ်ခုဖြစ်ပြီး 90Wh ဘက်ထရီကို 140W USB-C GaN adapter မှ တစ်နာရီအတွင်း 80 ရာခိုင်နှုန်းအထိ အမြန်အားသွင်းခြင်းဖြင့် ဖောက်သည်များ အစားထိုးနိုင်သည်။ 5G မော်ဂျူးသည် WWAN builds များရှိ Gen4 slot တွင် နေရာယူထားသောကြောင့် two-drive configuration နှင့် 5G သည် သီးသန့်ဖြစ်သည်။

Lenovo ThinkPad P1 Gen 9 သတ်မှတ်ချက်များ
| specification | Lenovo ThinkPad P1 Gen 9 (စမ်းသပ်ပြီး 21UE000XUS) |
|---|---|
| ပလက်ဖောင်း | |
| processor ကို | Intel Core Ultra 9 386H (စီးရီး ၃)၊ 16 cores / 16 threads (4P + 8E + 4LPE)၊ P-core 2.1 မှ 4.9GHz၊ 18MB Intel Smart Cache၊ Intel vPro Enterprise ရွေးချယ်စရာများ- Core Ultra 7 356H၊ Core Ultra 7 366H၊ Core Ultra X7 368H၊ Core Ultra X9 388H (Arc Pro B390 ပါဝင်သော X-series၊ integrated graphics သာ) |
| NPU | Intel NPU၊ TOPS ၅၀ အထိ |
| မှတ်ဉာဏ် | LPCAMM2 မော်ဂျူးတစ်ခုတွင် 64GB LPDDR5X-8533 (dual-channel) ပါဝင်ပြီး ဖောက်သည်မှ အစားထိုးအသုံးပြုနိုင်သည်။ 16GB၊ 32GB၊ 64GB သို့မဟုတ် 96GB |
| ဂရပ်ဖစ် | NVIDIA RTX PRO 2000 Blackwell Generation Laptop GPU၊ 8GB GDDR7၊ 50W TGP ကို ပြင်ဆင်သတ်မှတ်ထားသည် ရွေးချယ်စရာများ- RTX PRO 1000 Blackwell 8GB; Intel Arc Pro B390 ပေါင်းစပ်ထားသော (X-series CPU များ) |
| သိုလှောင်ခြင်း | 2TB SK hynix PCB01 (HFS002TFM9X179N)၊ M.2 2280 PCIe 5.0 x4၊ Opal 2.0 slot များ: M.2 2280 PCIe 5.0 x4 တစ်ခု၊ M.2 2280 PCIe 4.0 x4 တစ်ခု၊ 8TB (2 x 4TB) အထိ၊ RAID 0/1 |
| မျက်နှာပြင် | |
| စမ်းသပ်ထားတဲ့ Panel အတိုင်း | ၁၆ လက်မ WQUXGA (3840×2400) IPS၊ 800 nits၊ 100% DCI-P3၊ 60Hz၊ 1500:1၊ အလင်းပြန်မှု ဆန့်ကျင်ပေးသည့်စနစ်၊ DisplayHDR 400၊ Dolby Vision၊ X-Rite စက်ရုံချိန်ညှိမှု |
| ပန်နယ်ရွေးချယ်စရာများ | ၁၆ လက်မ WUXGA (1920×1200) IPS၊ 500 nits၊ 100% sRGB၊ 60Hz ၁၆ လက်မ 3.2K (3200×2000) Tandem OLED touch၊ 600 nits SDR / 1,500 nits HDR၊ 100% DCI-P3၊ 40 မှ 120Hz VRR၊ ဘောပင်ပံ့ပိုးမှု |
| connectivity | |
| ဆိပ်ကမ်းများ | Thunderbolt 5 ၂ ခု (USB PD 3.1၊ DisplayPort 2.1၊ 140W အဝင် / 15W အထွက်) ၁ x Thunderbolt 4 (မော်ဂျူလာ) USB-A 10Gbps ၁ ခု၊ အမြဲတမ်းဖွင့်ထားသည် HDMI 2.1 (8K60) ၁ ခု ၁ x SD Express 7.0 ၁ x ၃.၅ မီလီမီတာ နားကြပ်/မိုက်ခရိုဖုန်း Kensington Nano slot |
| ကြိုးမဲ့ | Intel Wi-Fi 7 BE211 2×2 ပါ၀င်သည့် Bluetooth 5.4 (6.0 hardware အသင့်ဖြစ်ပြီ)၊ vPro eSIM ပါဝင်သော ရွေးချယ်နိုင်သော Snapdragon X61 5G sub-6 (Gen4 M.2 slot ကိုအသုံးပြုသည်)၊ ရွေးချယ်နိုင်သော NFC |
| Ethernet | မပါရှိပါ။ Lenovo USB-C မှ 2.5GbE အဒက်တာ |
| ကင်မရာနှင့် အသံ | privacy shutter နှင့် presence detection ပါရှိသော 5MP RGB + IR၊ dual far-field မိုက်ခရိုဖုန်းများ၊ Dolby Voice၊ 2 x 2W စပီကာများ၊ Dolby Atmos (WWAN မော်ဒယ်များတွင် quad စပီကာများ) |
| ရုပ်ပိုင်းဆိုင်ရာ | |
| ဘက်ထရီနှင့်ပါဝါ | 90Wh၊ ဖောက်သည်အစားထိုးနိုင်သည်၊ တစ်နာရီအတွင်း 80% အထိ အမြန်အားသွင်းနိုင်၊ 140W USB-C GaN အဒက်တာ၊ PD 3.1 |
| ရှုထောင့် | ၃၅၄.၄ x ၂၄၁.၂ x ၉.၈၇ / ၁၅.၈ မီလီမီတာ (ရှေ့/နောက်)၊ အများဆုံး ၂၀.၆ မီလီမီတာ |
| အလေးချိန် | ၁.၇၇ ကီလိုဂရမ် (၃.၉၀ ပေါင်) မှစတင်၍ |
| လုံခွုံရေး | သီးခြား TPM 2.0၊ ပါဝါခလုတ်ရှိ ချစ်ပ်ပေါ်တွင် ကိုက်ညီသော လက်ဗွေဖတ်စက်၊ အလိုအလျောက် ကုသနိုင်သော BIOS၊ အောက်ခြေအဖုံးကို ခိုးယူမှုရှာဖွေခြင်း၊ Windows Hello အတွက် IR ကင်မရာ |
| လက်မှတ် | MIL-STD-810H; Altair၊ AVID၊ Autodesk၊ ANSYS၊ Barco၊ Bentley၊ Dassault၊ Esri၊ Nemetschek၊ PTC၊ Siemens အတွက် ISV အသိအမှတ်ပြုလက်မှတ်; EPEAT Gold၊ ENERGY STAR 9.0၊ TCO 10 |
| operating system | Windows 11 Pro (စမ်းသပ်ပြီး); Windows 11 Home၊ Ubuntu၊ Fedora၊ Red Hat Enterprise Linux 10.2 အသိအမှတ်ပြုလက်မှတ် ရရှိပြီး |
| စျေးနှုန်း | ၂၀၂၆ ခုနှစ် အောက်တိုဘာလ ၂၄ ရက်နေ့အထိ Tandem OLED panel (21UE0014US) နှင့် ကိုက်ညီသော configuration အတွက် lenovo.com တွင် $7,719 ဖြင့် ရောင်းချခဲ့ပြီး၊ ထိုအပတ်အစောပိုင်းတွင် $5,399 ဖြင့် ရောင်းချခဲ့ပြီး၊ RTX PRO 2000၊ 16GB၊ 512GB နှင့် WUXGA panel ပါဝင်သော build-your-own Core Ultra 7 356H အတွက် $3,734 မှစတင်၍ |
စမ်းသပ်ခြင်း Setup နှင့်နည်းစနစ်
ကျွန်ုပ်တို့ရဲ့ review unit မှာ Core Ultra 9 386H ကို RTX PRO 2000 Blackwell၊ 64GB LPDDR5X-8533 memory နဲ့ Windows 11 Pro 25H2 ကိုအသုံးပြုထားတဲ့ 2TB Gen5 SSD တို့နဲ့ တွဲဖက်အသုံးပြုထားပါတယ်။ ပလပ်ထိုးထားစဉ်မှာ Windows ကို Best performance မှာထားပြီး Lenovo ရဲ့ Ultra Performance mode ကိုဖွင့်ထားကာ benchmark တွေကို စမ်းသပ်ခဲ့ပါတယ်။ ဘက်ထရီသက်တမ်းကို နောက်ပိုင်း update မှာ ဖော်ပြပေးသွားပါမယ်။
ရလဒ်များသည် ကျွန်ုပ်တို့၏ scripted client benchmark suite ဖြစ်သော sr-client ၏ full နှင့် Peak-profile run များမှ ထွက်ပေါ်လာပါသည်။ ကျွန်ုပ်တို့သည် P1 နှင့် Dell Pro Max 14 တွင် version 1.3 နှင့် Pro Precision 5 16S နှင့် OmniBook တွင် version 1.2 ကို အသုံးပြုခဲ့သည်။ Version 1.3 သည် မည်သည့်စမ်းသပ်မှုကိုမျှ မပြောင်းလဲဘဲ run မှုအခြေအနေများကို ပြုပြင်ပေးသည့် maintenance release တစ်ခုဖြစ်သည်။ စနစ်တစ်ခုစီသည် OEM ၏ drivers များနှင့် utilities များဖြင့် ၎င်း၏ factory Windows image ကို run ပြီး P1 တွင် NVIDIA driver 597.16 ကို run သည်။
ဒီ suite က နေရာတိုင်းမှာ အတူတူပဲ setting တွေကို အသုံးပြုပါတယ်- Windows power mode ကို Best performance မှာထား၊ display ကို 50 percent brightness မှာထား၊ sleep နဲ့ display timer အားလုံးကိုပိတ်ထား၊ Windows Firewall နဲ့ UAC prompts တွေကိုပိတ်ထား၊ VBS နဲ့ Memory Integrity ကို shipped လုပ်ထားတဲ့အတိုင်းထား။ ရလဒ်တစ်ခုစီဟာ ထပ်ခါတလဲလဲ pass လုပ်ခြင်းရဲ့ median ဖြစ်ပြီး၊ suite က လက်ခံခြင်းမပြုမီ ၎င်းရဲ့ spread ဟာ 2 percent ထက်ကျော်လွန်သွားရင် စမ်းသပ်မှုကို ပြန်လည်လုပ်ဆောင်ပါတယ်။
Dell Pro Max 14 Premium သည် ယခင် Intel မျိုးဆက်ဖြစ်ပြီး RTX PRO 2000 တူညီသောကြောင့် နှစ်ခုစလုံးသည် CPU platform ကို သီးခြားခွဲထုတ်ထားသည်။ Dell သည် ၎င်း၏ကတ်ကို 47W ဖြင့် လည်ပတ်ပြီး Lenovo ၏ 50W သည် GPU ဘက်တွင် တစ်ခုတည်းသော hardware ကွာခြားချက်ဖြစ်သည်။ Dell Pro Precision 5 16S သည် Core Ultra X9 388H နှင့် Arc Pro B390 integrated graphics ပါရှိသော ၁၆ လက်မ workstation တွင် တူညီသော Panther Lake မျိုးဆက်ဖြစ်ပြီး discrete GPU မပါဝင်ပါ။ HP OmniBook Ultra 16 သည် NVIDIA ၏ RTX Spark N1X ဖြစ်ပြီး လက်ရှိတွင် ကျွန်ုပ်တို့၏ ဒေသတွင်း AI စမ်းသပ်မှုများကို ဦးဆောင်နေသည့် unified memory 128GB ပါရှိသည်။
| configuration | စီပီယူ | မှတ်ဉာဏ် | GPU ကို | boot drive | OS နှင့် ပါဝါမုဒ် |
|---|---|---|---|---|---|
| Lenovo ThinkPad P1 Gen 9 (21UE000XUS) | Intel Core Ultra 9 386H, 16C / 16T (4P + 8E + 4LPE) | 64GB LPDDR5X-8533 LPCAMM2 | NVIDIA RTX PRO 2000 Blackwell လက်ပ်တော့ GPU၊ 8GB GDDR7၊ 50W | SK hynix PCB01 2TB (HFS002TFM9X179N), Gen5 x4 | Windows 11 Pro 25H2 (x64)၊ Lenovo Ultra Performance၊ အကောင်းဆုံးစွမ်းဆောင်ရည် |
| Dell Pro Max 14 Premium (MA14250) | Intel Core Ultra 9 285H, 16C / 16T (6P + 8E + 2LPE) | 64GB LPDDR5X-8400 | NVIDIA RTX PRO 2000 Blackwell လက်ပ်တော့ GPU၊ 8GB GDDR7၊ 47W | SK hynix PC811 2TB | Windows 11 Pro 25H2 (x64)၊ Dell Optimizer Ultra Performance |
| Dell Pro Precision 5 16S (PW516260) | Intel Core Ultra X9 388H, 16C / 16T (4P + 8E + 4LPE) | 64GB LPDDR5X-8533 LPCAMM2 | Intel Arc Pro B390 (ပေါင်းစပ်ထားသော၊ 12 Xe cores) | SK hynix PCB01 1TB၊ Gen5 x4 | Windows 11 Pro 25H2 (x64)၊ Dell Optimizer Ultra Performance |
| HP OmniBook Ultra 16 (16-bk0xxx) | NVIDIA RTX Spark N1X, 20C / 20T (လက်မ) | 128GB LPDDR5X-9400 (64/64 ခွဲခြမ်းစိတ်ဖြာမှု) | ၆,၁၄၄-core Blackwell RTX (ပေါင်းစပ်ထားပြီး၊ အသုံးပြုနိုင်သော 62.5GB) | Sandisk PC SN8050S 2TB၊ Gen5 x4 | Windows 11 Pro 26H1 (Arm64)၊ HP စွမ်းဆောင်ရည် |
ဇယားများတွင် အညွှန်းနှစ်ခု ထပ်ခါတလဲလဲပေါ်လာသည်- N/A ဆိုသည်မှာ SMT မပါဝင်သော ချစ်ပ်များပေါ်တွင် Cinebench SMT single-core စမ်းသပ်မှုကဲ့သို့ ဟာ့ဒ်ဝဲနှင့် စမ်းသပ်မှု မသက်ဆိုင်ကြောင်း ဆိုလိုပြီး Not run ဆိုသည်မှာ ဟာ့ဒ်ဝဲသည် အရည်အချင်းမပြည့်မီသောကြောင့် (ကျွန်ုပ်တို့၏ မော်ဒယ်-တင်ခြင်း၊ coding-agent နှင့် ပိုမိုကြီးမားသော serving နှင့် image tiers များသည် အနည်းဆုံး GPU-usable memory 16GB လိုအပ်ပြီး RTX PRO 2000 စက်နှစ်ခုစလုံးသည် 7.7GB ရှိသည်) သို့မဟုတ် RTX PRO 2000 စနစ်နှစ်ခုရှိ NVENC encode အတွက် driver က ၎င်းကိုစတင်ရန် ငြင်းဆိုသောကြောင့်ဖြစ်သည်။ fio ဆဲလ်အနည်းငယ်သည် ပြန်လည်လည်ပတ်ပြီးနောက် spread ကို ၂ ရာခိုင်နှုန်းအထက်တွင် ထိန်းသိမ်းထားနိုင်ပြီး တိုင်းတာပြီးအဖြစ် အစီရင်ခံထားသည်။
P1 က CPU အပူချိန်တွေကို suite ကို ထုတ်ဖော်ပြသခဲ့ပြီး Dell နှစ်ယောက်စလုံးက မထုတ်ဖော်ပြသခဲ့တာကြောင့် thermal section က P1 နဲ့ OmniBook တို့ကို လေးခုစလုံးရဲ့ ပျမ်းမျှနာရီတွေနဲ့ အစီရင်ခံပါတယ်။ P1 ရဲ့ အဓိက run ကို Smart App Control ဖွင့်ထားခြင်းဖြင့် ပြီးမြောက်ခဲ့ပြီး၊ အဲဒီ binary နှစ်ခုကို block လုပ်ပြီးနောက်မှာ GROMACS နဲ့ LLM serving tests တွေကို ပိတ်ထားပြီး ပြန်လည် run ခဲ့ပါတယ်။ နှိုင်းယှဉ်စနစ်တွေက ပိတ်ထားပြီး run ခဲ့ပါတယ်။
ဒေသတွင်း AI စွမ်းဆောင်ရည်
RTX PRO 2000 ရဲ့ 8GB GDDR7 က ဒီအပိုင်းမှာ အဓိကအချက်ပါ။ သင့်တော်တဲ့ မော်ဒယ်ငယ်လေးတွေမှာ P1 က အုပ်စုထဲမှာ အမြန်ဆုံးစနစ်ဖြစ်ပြီး Dell မှာ 47W မှာ တူညီတဲ့ GPU ထက် အရင်ရှိပြီး RTX Spark N1X ထက်လည်း သာပါတယ်။ ပိုကြီးတဲ့ မည်သည့်အရာမှာမဆို 128GB N1X notebook နဲ့ 64GB system memory ရဲ့ integrated GPU အများစုကို ပေးစွမ်းနိုင်တဲ့ Arc Pro B390 Dell တို့ဟာ P1 စတင်လို့မရတဲ့ အဆင့်တွေကို အသုံးပြုပါတယ်။ 7B parameters အထက် ဒေသတွင်းမော်ဒယ်တွေအတွက် မိုဘိုင်း workstation ကို လိုချင်တဲ့ ဝယ်ယူသူတွေဟာ ဒီစက်နဲ့ ဈေးကွက်ရဲ့ တခြားနေရာမှာ ဝယ်ယူနေကြပါတယ်။
MLPerf ကလိုင်းယင့် v2.0
MLPerf Client သည် Llama 3.1 8B နှင့် Phi-4-mini တို့ကို prompt အမျိုးအစားငါးခုမှတစ်ဆင့် လုပ်ဆောင်ပြီး ပထမတိုကင်နှင့် ၎င်းနောက်ရှိ တိုကင်နှုန်းသို့ အချိန်ကို အမျိုးအစားများတစ်လျှောက် geometric mean အဖြစ် အစီရင်ခံသည်။ အင်ဂျင်သည် NVIDIA GPU သုံးခုပေါ်ရှိ CUDA ပေါ်ရှိ llama.cpp နှင့် Arc Pro B390 ပေါ်ရှိ Intel ၏ native OpenVINO path ဖြစ်သောကြောင့် Dell Pro Precision 5 16S column သည် မတူညီသော silicon ပေါ်ရှိ runtime ကွဲပြားပြီး ထို configuration သည် မည်သည့်အရာကို ပေးစွမ်းသည်အဖြစ် ဖတ်ပြီး အင်ဂျင်နှိုင်းယှဉ်မှုကဲ့သို့ မဟုတ်ပါ။ agentic scenarios များသည် Llama 3.1 8B ကို data analyst agent နှင့် software engineering agent အဖြစ် လုပ်ဆောင်ပြီး tools များကို အလှည့်များစွာတွင် ခေါ်ယူသည်။


| MLPerf ကလိုင်းယင့် v2.0 | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| လာမာ ၃.၁ ၈ဘီ၊ ပထမဆုံးတိုကင်သို့ရောက်ရှိချိန်၊ ဂျီဩမေတြီ (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 0.345 | 0.441 | 0.214 | 0.274 |
| လာမာ ၃.၁ ၈ဘီ၊ တိုကင်နှုန်း၊ ဂျီဩမေတြီပျမ်းမျှ (tok/s) | 64.8 | 54.7 | 26.9 | 56.5 |
| Phi-4-mini၊ ပထမဆုံးတိုကင်အတွက်အချိန်၊ geomean (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 0.161 | 0.214 | 0.181 | 0.130 |
| Phi-4-mini၊ တိုကင်နှုန်း၊ ဂျီအိုမီယန် (tok/s) | 111.9 | 88.0 | 41.4 | 96.8 |
| ဒေတာ ခွဲခြမ်းစိတ်ဖြာသူ အေးဂျင့်၊ အဆုံးမှအဆုံး (များသော၊ နိမ့်လေ ပိုကောင်းလေ) | 49.7 | 61.0 | 84.7 | 53.0 |
| ဒေတာ ခွဲခြမ်းစိတ်ဖြာသူ အေးဂျင့်၊ တိုကင်နှုန်း (tok/s) | 58.0 | 45.9 | 25.6 | 48.5 |
| SWE အေးဂျင့်၊ အဆုံးမှအဆုံး (များလေ၊ နိမ့်လေ ပိုကောင်းလေ) | 43.4 | 52.7 | 65.6 | 45.3 |
| SWE အေးဂျင့်၊ တိုကင်နှုန်း (tok/s) | 54.0 | 42.5 | 25.0 | 46.6 |
| အင်ဂျင်နှင့် ကိရိယာ | llama.cpp၊ CUDA၊ NVIDIA RTX PRO 2000 | llama.cpp၊ CUDA၊ NVIDIA RTX PRO 2000 | OpenVINO၊ Intel Arc Pro B390 GPU | llama.cpp၊ CUDA၊ NVIDIA RTX Spark N1X |
Dell's 47W RTX PRO 2000 မှာ 54.7 နဲ့ 88.0 တွေနဲ့ နှိုင်းယှဉ်ရင် P1 ဟာ Llama 3.1 8B ကို တစ်စက္ကန့်ကို 64.8 tokens နဲ့ Phi-4-mini ကို 111.9 နဲ့ ထုတ်ပေးခဲ့ပြီး token rate တွေက 19% နဲ့ 27% ပိုများပြီး ပထမဆုံး token ထုတ်ဖို့ အချိန်ကလည်း 22% ကနေ 25% အထိ လျော့နည်းသွားပါတယ်။
TGP ရဲ့ 3W က အဲဒီရဲ့ တစ်စိတ်တစ်ပိုင်းဖြစ်ပြီး ကျန်တာတွေကတော့ ကိုယ်ထည်ပါ။ Dell က တူညီတဲ့ ကတ်ကို အအေးပေးမယ့် ၁၄ လက်မ စက်တစ်လုံးဖြစ်ပြီး CPU အမျိုးအစားတူကို အသံအတိုးအကျယ်နည်းနည်းနဲ့ အအေးပေးပါတယ်။ ဒီ suite က GPU ရဲ့ clock ဒါမှမဟုတ် အပူချိန်ကို မဖတ်နိုင်တာကြောင့် thermal gap ဘယ်လောက်ရှိလဲဆိုတာ မပြောနိုင်ပါဘူး။ OmniBook မှာရှိတဲ့ N1X က RTX PRO 2000 စနစ်နှစ်ခုကြားမှာ token rate 56.5 နဲ့ 96.8 ရှိပြီး NVIDIA အုပ်စုထဲမှာ ပထမဆုံး token ကို အမြန်ဆုံးရောက်တဲ့ အချိန်ပါ။
Dell Pro Precision 5 16S ရှိ Arc Pro B390 ကို OpenVINO မှတစ်ဆင့် တစ်စက္ကန့်လျှင် တိုကင် ၂၆.၉ နှင့် ၄၁.၄ ဖြင့် ထုတ်လုပ်ပြီး P1 ၏နှုန်းထား၏ ထက်ဝက်နီးပါးအောက်တွင် ရှိပြီး နှစ်မျိုးလုံးလည်ပတ်နိုင်သော မော်ဒယ်ငယ်များတွင် ပေါင်းစပ်ထားသော ဖွဲ့စည်းပုံ၏ ကုန်ကျစရိတ်ဖြစ်သည်။ Llama တွင် ပထမဆုံးတိုကင်ထိုးရန် အချိန် ၀.၂၁၄ စက္ကန့်သည် ဇယားတွင် အကောင်းဆုံးဖြစ်သောကြောင့် OpenVINO လမ်းကြောင်း၏ prompt ဘက်ခြမ်းသည် decode မလုပ်သည့်နေရာတွင်ပင် ယှဉ်ပြိုင်နိုင်သည်။
agent run များသည် token rate များကို ခြေရာခံသည်- P1 သည် data analyst agent ကို ၄၉.၇ စက္ကန့်ဖြင့် အပြီးသတ်ခဲ့ပြီး SWE agent ကို ၄၃.၄ စက္ကန့်ဖြင့် အပြီးသတ်ခဲ့ပြီး Dell Pro Max 14 တွင် ၆၁.၀ နှင့် ၅၂.၇၊ OmniBook တွင် ၅၃.၀ နှင့် ၄၅.၃ ဖြင့် အပြီးသတ်ခဲ့ပြီး tool phases လေးခုတွင် တစ်ခုနှင့်တစ်ခု နှစ်စက္ကန့်ခန့်သာ ကွာခြားသည်။
မော်ဒယ်တင်ခြင်းနှင့် ကုဒ်သွင်းခြင်းအေးဂျင့်
ကျွန်ုပ်တို့ရဲ့ model-load နဲ့ coding-agent စမ်းသပ်မှုတွေဟာ gpt-oss:20b မှာ စတင်ပါတယ်။ 12.8GB download တစ်ခုဖြစ်ပြီး GPU-usable memory 16GB လောက် လိုအပ်ပြီး ၎င်းရဲ့ context နဲ့အတူ suite က ဘယ် tiers တွေကို run ရမလဲဆိုတာကို မဆုံးဖြတ်ခင်မှာ system တစ်ခုချင်းစီရဲ့ GPU-usable memory ကို တိုင်းတာပါတယ်။ RTX PRO 2000 က 7.7GB လို့ ဖော်ပြတဲ့အတွက် P1 နဲ့ Dell Pro Max 14 နှစ်ခုစလုံးဟာ tier တစ်ခုအတွက် အရည်အချင်းမပြည့်မီပါဘူး။ အောက်မှာ Not run အဖြစ် ပြသထားပါတယ်။ သူတို့ကို run လုပ်ခဲ့တဲ့ နှိုင်းယှဉ်စနစ်နှစ်ခုကို scale အတွက် ဖော်ပြပေးထားပါတယ်။ Arc Pro B390 က Dell ရဲ့ 64GB system memory အများစုကို ကိုင်တွယ်ဖြေရှင်းနိုင်ပြီး N1X က OmniBook ရဲ့ 128GB ရဲ့ 62.5GB ကို ကိုင်တွယ်ဖြေရှင်းပေးပါတယ်။
| မော်ဒယ်ဝန်နှင့် ကုဒ်ရေးအေးဂျင့် | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| မော်ဒယ်ကို ပထမဆုံးတိုကင်သို့ တင်ပါ (တိုကင်များ များလေ၊ တိုကင်နည်းလေ ပိုကောင်းလေ) | ||||
| gpt-oss:20b, 12.8GB, အေးခဲနေသည် | မပြေးပါ | မပြေးပါ | 5.98 | 6.23 |
| gpt-oss:၂၀ခ၊ နွေးသည် | မပြေးပါ | မပြေးပါ | 4.14 | 3.59 |
| Qwen3.6-35B-A3B၊ 21.1GB၊ အေးသည် | မပြေးပါ | မပြေးပါ | 9.41 | 9.04 |
| Qwen3.6-35B-A3B၊ နွေး | မပြေးပါ | မပြေးပါ | 6.60 | 4.23 |
| မော်ဒယ်များလဲလှယ်ပြီးနောက် Qwen3.6-35B-A3B | မပြေးပါ | မပြေးပါ | 13.38 | 4.77 |
| Crush coding agent | ||||
| gpt-oss:20b၊ 64K အခြေအနေ၊ နံရံအချိန် (s၊ ပိုနည်းလေ ပိုကောင်းလေ) | မပြေးပါ | မပြေးပါ | 584.2 | 115.3 |
| gpt-oss:20b၊ 64K အခြေအနေ၊ ထုတ်လုပ်မှုနှုန်း (tok/s) | မပြေးပါ | မပြေးပါ | 17.9 | 58.0 |
| Qwen3.6-35B-A3B၊ 64K အခြေအနေ၊ နံရံအချိန် (s၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | မပြေးပါ | မပြေးပါ | 351.7 | 72.0 |
| Qwen3.6-35B-A3B၊ 64K အခြေအနေ၊ ထုတ်လုပ်မှုနှုန်း (tok/s) | မပြေးပါ | မပြေးပါ | 38.9 | 89.5 |
| Speedometer ဘေးရှိ အေးဂျင့်၊ အေးဂျင့်ထုတ်လုပ်နှုန်း (tok/s) | မပြေးပါ | မပြေးပါ | 17.9 | 55.8 |
| Speedometer ဘေးရှိ Agent၊ Speedometer နှေးကွေးခြင်း (x) | မပြေးပါ | မပြေးပါ | 1.60 | 1.73 |
OmniBook က gpt-oss:20b coding task ကို တစ်စက္ကန့်လျှင် 58.0 tokens ဖြင့် စက္ကန့် ၁၁၅.၃ စက္ကန့်အတွင်း လုပ်ဆောင်ခဲ့ပြီး Dell Pro Precision 5 16S ကတော့ တစ်စက္ကန့်လျှင် 584.2 စက္ကန့်ဖြင့် စက္ကန့် ၁၇.၉ စက္ကန့်ကြာ လုပ်ဆောင်ခဲ့ပြီး ယင်းမှာ ဝယ်သူတစ်ဦးက ကြီးမားသော unified pool တစ်ခုထက် 8GB discrete GPU ကို ရွေးချယ်ခြင်းဖြင့် စွန့်လွှတ်လိုက်သည့် အတိုင်းအတာဖြစ်သည်။ ထို workload အတွက် P1 ၏ အဖြေမှာ cloud သို့မဟုတ် သေးငယ်သော မော်ဒယ်ဖြစ်သည်- အောက်ဖော်ပြပါ 3B serving tier သည် ကျွန်ုပ်တို့၏ suite တွင် ထည့်သွင်းနိုင်သည့် အကြီးဆုံးဖြစ်ပြီး Q4_0 ရှိ MLPerf ၏ 8B မော်ဒယ်များသည် MLPerf သည် ၎င်း၏ context ကို ကတ်သို့ အရွယ်အစားသတ်မှတ်သောကြောင့် လုပ်ဆောင်သည်။
Retrieval-augmented မျိုးဆက်
RAG စမ်းသပ်မှုသည် Ollama မှတစ်ဆင့် nomic-embed-text ဖြင့် SQuAD အပိုင်း ၂၀,၉၆၃ ပိုင်းကို ထည့်သွင်းပြီး မေးခွန်း ၂၀၀၀ အတွက် ထိပ်ဆုံးငါးခုကို ပြန်လည်ရယူကာ 4,096-token context တွင် Phi-4-mini ဖြင့် ဖြေဆိုကာ ingest throughput၊ retrieval latency နှင့် recall၊ အဖြေအရည်အသွေးနှင့် အမြန်နှုန်းတို့ကို အစီရင်ခံပါသည်။ 3.8B အဖြေမော်ဒယ်သည် ဤနေရာတွင် GPU တိုင်းနှင့် ကိုက်ညီသောကြောင့် ဤသည်မှာ အဖွဲ့တစ်ခုလုံး အဆုံးမှအဆုံး လုပ်ဆောင်သော ဒေသတွင်း AI စမ်းသပ်မှုတစ်ခုဖြစ်သည်။

| RAG (အိုလာမာ ၀.၄၀.၃) | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| စားသုံးရန် | ||||
| တစ်စက္ကန့်လျှင် ဖြတ်သန်းမှုအရေအတွက် | 165.1 | 151.6 | 80.2 | 119.5 |
| ထည့်သွင်းမှုနှုန်း (tok/s) | 26,740 | 24,554 | 12,992 | 19,352 |
| နံရံကို စုပ်ယူချိန် (စက္ကန့်၊ နည်းလေ ပိုကောင်းလေ) | 138.8 | 152.2 | 271.7 | 187.0 |
| ပြန်. ရယူ | ||||
| ပြန်လည်သိမ်းဆည်းခြင်း @၅ (%) | 82.8 | 82.8 | 82.7 | 82.8 |
| မေးမြန်းချိန် p50 (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 19.33 | 22.13 | 22.20 | 23.33 |
| မေးမြန်းချိန် p95 (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 22.10 | 25.59 | 23.91 | 26.12 |
| အဖြေ (Phi-4-mini, ctx 4096) | ||||
| တိကျသော ကိုက်ညီမှု (%) | 63.25 | 63.25 | 63.00 | 62.75 |
| F1 (%) | 74.4 | 74.4 | 74.2 | 74.0 |
| ပထမဆုံး တိုကင် p50 အတွက် အချိန် (s၊ နိမ့်လေ ပိုကောင်းလေ) | 0.214 | 0.261 | 0.855 | 0.155 |
| လျင်မြန်စွာ လုပ်ဆောင်ခြင်း (tok/s) | 4,953 | 4,011 | 2,151 | 7,142 |
| ထုတ်လုပ်မှုနှုန်း (tok/s) | 103.5 | 92.6 | 48.3 | 104.4 |
| မေးခွန်းအတွက် အဖြေ p50 (s၊ ပိုနည်းလေ ပိုကောင်းလေ) | 0.287 | 0.342 | 0.997 | 0.227 |
P1 သည် တစ်စက္ကန့်လျှင် 165.1 passages များကို ထည့်သွင်းပြီး 138.8 စက္ကန့်အတွင်း abstract လုပ်ပြီးစီးခဲ့ပြီး အုပ်စုတွင် အမြန်ဆုံးဖြစ်ပြီး Dell Pro Max 14 သည် 151.6 နှင့် OmniBook သည် 119.5 ဖြင့် ရှေ့တွင် ရှိနေသည်။ Arc Pro B390 သည် 271.7 စက္ကန့် ကြာမြင့်ခဲ့သည်။ အဖြေအရည်အသွေးသည် လေးခုလုံးတွင် အတူတူပင်ဖြစ်ပြီး တိကျသော 63.25 ရာခိုင်နှုန်းနှင့် ဆယ်ပုံတစ်ပုံအတွင်း 74.4 F1 ရှိသည်၊ အဘယ်ကြောင့်ဆိုသော် မော်ဒယ်နှင့် ရယူထားသော passages များသည် အတူတူပင်ဖြစ်သည်။ ကွာခြားချက်မှာ မြန်နှုန်းဖြစ်သည်။
P1 သည် မေးခွန်းတစ်ခုကို အလယ်အလတ်အဆင့်တွင် ၀.၂၈၇ စက္ကန့်ဖြင့် ဖြေဆိုခဲ့ပြီး၊ တစ်စက္ကန့်လျှင် တိုကင် ၄,၉၅၃ ခုဖြင့် prompt processing နှင့် တစ်စက္ကန့်လျှင် တိုကင် ၁၀၃.၅ ခုဖြင့် ဖြေဆိုခဲ့ပြီး၊ Dell Pro Max 14 တွင် ၀.၃၄၂ စက္ကန့်နှင့် OmniBook တွင် ၀.၂၂၇ ခုဖြင့် prompt processing ဖြင့် အဖြေများပေးစွမ်းခဲ့ပြီး အုပ်စုတွင် အမြန်ဆုံးအဖြေများ ရရှိခဲ့သည်။
LLM ဝန်ဆောင်မှု
serving test သည် llama-server ကို 4,096-token prompts များနှင့် 1,024-token output များဖြင့် လုပ်ဆောင်ပြီး request တစ်ခုမှ GPU အများဆုံးသိမ်းဆည်းထားနိုင်သည့်အထိ တစ်ပြိုင်နက်တည်းလုပ်ဆောင်ကာ output throughput၊ per-user throughput၊ first token သို့ရောက်ရှိချိန်နှင့် output token တစ်ခုလျှင်အချိန်ကို အစီရင်ခံပါသည်။
OmniBook နှင့် Pro Precision 5 16S တို့ကို စမ်းသပ်ပြီးနောက် ကျွန်ုပ်တို့၏ Dell Pro Precision 9 T2 သုံးသပ်ချက် ဖြင့် ပွဲဦးထွက်ခဲ့သော ကြောင့် ဤအုပ်စုရှိ RTX PRO 2000 စနစ်နှစ်ခုသာ ၎င်းကို လည်ပတ်ခဲ့ပြီး 8GB တွင် အသေးဆုံးမော်ဒယ်သာ အရည်အချင်းပြည့်မီခဲ့သည်- 2.13GB KV cache နှင့် slot လေးခုပါရှိသော Ministral 3 3B Reasoning at Q8_0။ 8B၊ 27B နှင့် 120B အဆင့်များသည် နှစ်ခုလုံးတွင် မလည်ပတ်ဟု ပြသထားသည်။

| လာမာ-ဆာဗာ၊ ဝန်ကြီးဌာန ၃ 3B ကျိုးကြောင်းဆင်ခြင်ခြင်း Q8_0၊ ဝင်ပေါက် ၄,၀၉၆ / ထွက်ပေါက် ၁,၀၂၄ | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) |
|---|---|---|
| တစ်ပြိုင်နက်တည်း တောင်းဆိုမှု ၁ ခု | ||
| အထွက်နှုန်း (tok/s) | 67.0 | 55.5 |
| ပထမဆုံးတိုကင်အတွက် အချိန်၊ အလယ်အလတ် (ms၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 890 | 1,089 |
| အထွက်တိုကင်တစ်ခုလျှင် အချိန်၊ အလယ်အလတ် (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 14.0 | 17.0 |
| တစ်ပြိုင်နက်တည်း တောင်းဆိုမှု ၄ ခု | ||
| အထွက်နှုန်း (tok/s) | 68.3 | 65.4 |
| အသုံးပြုသူတစ်ဦးချင်းစီ၏ စွမ်းဆောင်ရည် (tok/s) | 34.1 | 32.7 |
| ပထမဆုံးတိုကင်အတွက် အချိန်၊ အလယ်အလတ် (ms၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 1,417 | 1,738 |
| တစ်ပြိုင်နက်တည်း တောင်းဆိုမှု ၄ ခု | ||
| အထွက်နှုန်း (tok/s) | 168.3 | 141.0 |
| အသုံးပြုသူတစ်ဦးချင်းစီ၏ စွမ်းဆောင်ရည် (tok/s) | 42.1 | 35.2 |
| ပထမဆုံးတိုကင်အတွက် အချိန်၊ အလယ်အလတ် (ms၊ ပိုနိမ့်လေ ပိုကောင်းလေ) | 1,737 | 2,100 |
| ပထမဆုံးတိုကင်အတွက် အချိန်၊ p99 (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 3,773 | 4,530 |
တောင်းဆိုမှုတစ်ခုတွင် P1 သည် ပထမတိုကင်သို့ 890ms အချိန်ဖြင့် တစ်စက္ကန့်လျှင် တိုကင် ၆၇.၀ ထုတ်ပေးသည်။ တစ်ပြိုင်နက်တည်း တောင်းဆိုမှုလေးခုတွင် အထွက်တစ်စက္ကန့်လျှင် တိုကင် ၁၆၈.၃ ခု (အသုံးပြုသူတစ်ဦးလျှင် ၄၂.၁ ခု) ရောက်ရှိခဲ့ပြီး ပထမတိုကင်၏ ပျမ်းမျှအချိန်မှာ 1,737ms ဖြစ်သည်။
Dell Pro Max 14 သည် အဆင့်တိုင်းတွင် နောက်ကျကျန်နေခဲ့သည်။ တောင်းဆိုမှုလေးခုတွင် တစ်စက္ကန့်လျှင် 141.0 တိုကင်ရှိပြီး ပထမတိုကင်ထက် ၂၁ မှ ၂၃ ရာခိုင်နှုန်းအထိ ပိုရှည်ပြီး MLPerf ကိန်းဂဏန်းများကပြသသည့်အတိုင်း 47W vs 50W ကွာဟချက်ရှိသည်။ P1 တွင် တောင်းဆိုမှုတစ်ခုမှ လေးခုသို့ တိုးချဲ့ခြင်းဖြင့် output throughput ကို 2.5x မြှင့်တင်ပေးသောကြောင့် ကတ်သည် မော်ဒယ်ငယ်တွင် အသုံးပြုသူအနည်းငယ်အတွက် နေရာလွတ်ရှိသည်။ ၎င်းတွင် မပါဝင်သည်မှာ နောက်မော်ဒယ်အတွက် နေရာလွတ်ဖြစ်သည်။
CPU စွမ်းဆောင်ရည်
Core Ultra 9 386H သည် Cougar Cove P-core လေးခု၊ Darkmont E-core ရှစ်ခုနှင့် low-power E-core လေးခုပါ၀င်သော 16-core အစိတ်အပိုင်းတစ်ခုဖြစ်ပြီး hyper-threading မပါဝင်ဘဲ last-level cache 18MB ရှိသည်။ Dell Pro Max 14 ရှိ 285H သည် ၎င်း၏ 16 cores ကို P-core ခြောက်ခု၊ E-core ရှစ်ခုနှင့် low-power cores နှစ်ခုအဖြစ် 5.4GHz အထိ အသုံးပြုသော်လည်း P-core နှစ်ခုနှင့် peak clock 500MHz ကို microarchitecture အသစ်နှင့် ပိုမိုမြန်ဆန်သော memory path အတွက် လဲလှယ်ထားသည်။ Dell Pro Precision 5 16S ရှိ X9 388H နှင့် နှိုင်းယှဉ်ပါက ၎င်းတွင် core layout တူညီသော်လည်း ၎င်း၏ P-core 200MHz သည် ပိုမိုနှေးကွေးသည်။ တစ်ချိန်တည်းမှာပင် OmniBook ၏ N1X သည် all-core စမ်းသပ်မှုတိုင်းတွင် Arm core 20 ကို ယူဆောင်လာသည်။
Cinebench 2026 နှင့် စဉ်ဆက်မပြတ် ဝန်အား
Cinebench 2026 သည် CPU ပေါ်တွင် Maxon ၏ Redshift engine ဖြင့် မြင်ကွင်းတစ်ခုကို ဖန်တီးပြီး single-core နှင့် multi-core throughput ကို ရရှိသည်။ SMT single-core စမ်းသပ်မှုသည် မည်သည့်ချစ်ပ်နှင့်မျှ မသက်ဆိုင်ပါ။ ကျွန်ုပ်တို့သည် multi-core run ကို မိနစ် ၃၀ ခန့် ထပ်ခါတလဲလဲလုပ်ဆောင်သည့် sustained loop ဖြင့် ၎င်းကို လိုက်နာပြီး steady state ကို ပထမအကြိမ်နှင့် နှိုင်းယှဉ်ပါသည်။

| Cinebench ၂၀၂၆ (အမှတ်များ၊ မြင့်လေ ပိုကောင်းလေ) | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| single-core | 519.9 | 486.0 | 534.8 | 558.6 |
| SMT single core | မရှိပါ (SMT မရှိပါ) | မရှိပါ (SMT မရှိပါ) | မရှိပါ (SMT မရှိပါ) | မရှိပါ (SMT မရှိပါ) |
| Multi Core | 5,083 | 4,292 | 4,739 | 7,004 |
| စဉ်ဆက်မပြတ် ကွင်းဆက်၊ ပထမအကြိမ် | 4,894 | 4,315 | 4,765 | 6,954 |
| စဉ်ဆက်မပြတ်လည်ပတ်မှု၊ တည်ငြိမ်သောအခြေအနေ | 4,811 | 4,257 | 4,468 | 6,942 |
| တည်ငြိမ်သောအခြေအနေ / ပထမအကြိမ်အောင်မြင်ခြင်း | 0.983 | 0.987 | 0.938 | 0.998 |
| စဉ်ဆက်မပြတ် လည်ပတ်မှု၊ တည်ငြိမ်သော အခြေအနေ CPU နာရီ (MHz) | 3,505 | 3,396 | 3,294 | 3,231 |
P1 ဟာ multi-core 5,083 ရရှိခဲ့ပြီး 285H ရဲ့ 4,292 ထက် ၁၈ ရာခိုင်နှုန်း သာလွန်ကာ Dell Pro Precision 5 16S မှာ X9 388H ရဲ့ 4,739 ထက် ၇ ရာခိုင်နှုန်း သာလွန်ပါတယ်။ OmniBook ရဲ့ 20-core N1X က 7,004 နဲ့ ဦးဆောင်နေပါတယ်။ core တစ်ခုမှာတော့ clock speed ကို လိုက်ကြည့်မယ်ဆိုရင် 388H ရဲ့ 534.8 နဲ့ N1X ရဲ့ 558.6 တို့က P1 ရဲ့ 519.9 ထက် သာလွန်ပြီး 285H က 486.0 ရရှိထားပါတယ်။
မိနစ် ၃၀ ကျော်အတွင်း P1 သည် ၎င်း၏ပထမဆုံးအကြိမ် pass ၏ ၄,၈၁၁ (၀.၉၈၃) ကို 3,505MHz ပျမ်းမျှနာရီနှင့် 94.1C CPU ceiling တွင် ထိန်းသိမ်းထားနိုင်ပြီး ထို steady-state ကိန်းဂဏန်းသည် Pro Precision 5 16S ၏ multi-core ရမှတ်အသစ်ထက် ၂ ရာခိုင်နှုန်းသာ ပိုများနေဆဲဖြစ်သည်။ Dell Pro Precision 5 16S သည် အပူကြောင့် အများဆုံးဆုံးရှုံးခဲ့ပြီး ၎င်း၏ပထမဆုံးအကြိမ် pass ၏ ၀.၉၃၈ တွင် ရပ်တန့်ခဲ့ပြီး Dell Pro Max 14 သည် ၀.၉၈၇ တွင် ရပ်တည်ခဲ့သည်။ Panther Lake စက်နှစ်ခုကြား ကွာဟချက်မှာ ကိုယ်ထည်ဖြစ်သည်- P1 ၏ ၁၆ လက်မ အလူမီနီယမ်ကိုယ်ထည်ရှိ ဆီလီကွန်တူညီသည် 5 16S ထက် ၈ ရာခိုင်နှုန်း ပိုမိုခံနိုင်ရည်ရှိသည်။
7-Zip
7-Zip ရဲ့ built-in benchmark က LZMA compression နဲ့ decompression throughput ကို တစ်စက္ကန့်ကို giga-instructions နဲ့ thread တိုင်းမှာ တစ်ကြိမ်၊ single core တစ်ခုမှာ pin လုပ်ပြီးရင် report လုပ်ပါတယ်။ LZMA က integer throughput၊ branch prediction နဲ့ cache နဲ့ memory latency တွေကို အခြေခံထားတာကြောင့် vector width ထက် core count နဲ့ fast memory path ကို ပိုပြီး reward လုပ်ပါတယ်။

| 7-Zip (GIPS၊ မြင့်လေ ပိုကောင်းလေ) | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| ချည်နှောင်ချက်အားလုံး | ||||
| စုစုပေါင်း | 109.2 | 93.4 | 108.4 | 151.2 |
| သိပ် | 116.6 | 97.0 | 116.1 | 157.9 |
| ဒီဇင်ဘာ | 101.7 | 89.4 | 101.0 | 144.5 |
| ချည်တစ်ချောင်း | ||||
| စုစုပေါင်း | 9.49 | 9.13 | 9.80 | 9.09 |
| သိပ် | 8.55 | 7.28 | 8.71 | 7.31 |
| ဒီဇင်ဘာ | 10.43 | 10.98 | 10.88 | 10.87 |
thread ၁၆ ခုတွင် P1 သည် 109.2 GIPS အဆင့်သတ်မှတ်ချက်ရှိပြီး 285H တွင် 93.4 ရှိပြီး 17 ရာခိုင်နှုန်း ဦးဆောင်ကာ compression သည် 20 ရာခိုင်နှုန်း ရှေ့သို့ ရောက်ရှိကာ X9 388H ၏ 108.4 နှင့် တစ်မှတ်အတွင်း တူညီသည်။ 20-thread N1X သည် 151.2 ဖြင့် ဦးဆောင်သည်။ thread တစ်ခုတွင် စနစ်လေးခုသည် တစ်ခုနှင့်တစ်ခု 8 ရာခိုင်နှုန်းအတွင်း တည်ရှိပြီး P1 ၏ single-thread compression 8.55 GIPS သည် 285H ၏ 7.28 နှင့် နှိုင်းယှဉ်ပါက Panther Lake တွင် suite တွင် ပြသထားသည့် per-core gain အရှင်းလင်းဆုံးဖြစ်သည်။
Blender၊ HandBrake နှင့် LLVM
Blender 4.5 သည် Monster၊ Junkshop နှင့် Classroom မြင်ကွင်းများကို CPU တွင် Cycles ဖြင့် ဖန်တီးပေးသည်။ HandBrake သည် x265 (HEVC၊ medium preset၊ quality 22) နှင့် SVT-AV1 (preset 8၊ quality 30) ဖြင့် 4K60 clip in software ၏ စက္ကန့် ၆၀ ကို encode လုပ်သည်။ LLVM စမ်းသပ်မှုသည် suite ၏ အရှည်ကြာဆုံး all-core workload ဖြစ်သော Clang နှင့် Ninja ဖြင့် LLVM 21.1.4 tree အပြည့်အစုံကို compile လုပ်သည်။


| စမ်းသပ် | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| Blender 4.5 Monster (နမူနာ/မိနစ်၊ များလေ ပိုကောင်းလေ) | 135.4 | 112.7 | 129.6 | 210.5 |
| Blender 4.5 Junkshop (နမူနာ/မိနစ်) | 92.8 | 75.4 | 89.8 | 128.0 |
| Blender ၄.၅ စာသင်ခန်း (နမူနာ/မိနစ်) | 66.8 | 56.6 | 63.2 | 92.8 |
| HandBrake x265၊ အလတ်စား၊ q22 (fps၊ မြင့်လေ ပိုကောင်းလေ) | 30.3 | 28.9 | 29.5 | 41.2 |
| HandBrake SVT-AV1၊ ကြိုတင်သတ်မှတ်မှု ၈၊ q30 (fps) | 84.5 | 79.8 | 80.8 | 15.4 |
| LLVM 21.1.4 တည်ဆောက်မှု (များသည်၊ နိမ့်လေ ပိုကောင်းလေ) | 309.1 | 393.9 | 340.1 | 206.6 |
P1 သည် Monster ကို တစ်မိနစ်လျှင် နမူနာ ၁၃၅.၄ ခုဖြင့် render လုပ်ခဲ့ပြီး 285H တွင် ၁၁၂.၇ ခုနှင့် 388H တွင် ၁၂၉.၆ ခု၊ Junkshop နှင့် Classroom တွင် ၂၀ ရာခိုင်နှုန်းနှင့် ၄ ရာခိုင်နှုန်းရှိသော leads များ ရရှိခဲ့သည်။ ၎င်းသည် LLVM ကို ၃၀၉.၁ စက္ကန့်အတွင်း တည်ဆောက်ခဲ့ပြီး ယခင်မျိုးဆက်ထက် ၂၂ ရာခိုင်နှုန်း လျော့နည်းခဲ့သည်။ N1X သည် cores လေးခုဖြင့် တစ်မိနစ်လျှင် နမူနာ ၂၁၀.၅ ခုနှင့် ၂၀၆.၆ စက္ကန့်ဖြင့် render လုပ်ပြီး compile လုပ်ရာတွင် ပိုမိုမြန်ဆန်သည်။
HandBrake မှာ x86 စက်တွေ ပေါင်းစပ်ပြီး Arm စက် ကွဲသွားပါတယ်။ x265 က P1 မှာ 30.3 fps၊ Dell Pro Max 14 မှာ 28.9 fps နဲ့ Pro Precision 5 16S မှာ 29.5 fps တွေနဲ့ လည်ပတ်နေပြီး SVT-AV1 က 84.5, 79.8 နဲ့ 80.8 ဒီဂရီတွေ ရရှိခဲ့တာကြောင့် P1 ဟာ encoder တစ်ခုစီမှာ 285H ထက် ၅ ရာခိုင်နှုန်းကနေ ၆ ရာခိုင်နှုန်းအထိ သာလွန်နေပါတယ်။ OmniBook ရဲ့ x265 ရလဒ်က 41.2 fps ဖြစ်ပြီး အုပ်စုထဲမှာ အကောင်းဆုံးဖြစ်ပြီး SVT-AV1 ရဲ့ 15.4 fps ကတော့ အဆိုးဆုံးဖြစ်ပြီး အဲဒီသုံးသပ်ချက်က silicon မဟုတ်ဘဲ SVT-AV1 ရဲ့ Arm64 code path ကို ခြေရာခံခဲ့တာပါ။
Stockfish၊ primesieve၊ Python နှင့် Browser
Stockfish 19 သည် ၎င်း၏ built-in bench ကို thread တစ်ခုနှင့် thread တိုင်းတွင် လုပ်ဆောင်ပြီး၊ primesieve သည် primes များကို thread အားလုံးတွင် 10^12 အထိနှင့် thread တစ်ခုတွင် 10^11 အထိ ရေတွက်ပြီး၊ PyPerformance သည် အမြန်ဆုံး core တွင် go, nbody နှင့် regex_compile benchmarks များကို လုပ်ဆောင်ပြီး၊ Speedometer 3.1 သည် browser ကို discrete GPU တွင် pin လုပ်ထားခြင်းဖြင့် Microsoft Edge တွင် လုပ်ဆောင်ပါသည်။
| စမ်းသပ် | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| Stockfish၊ ချည်တစ်ခု (Mnps၊ မြင့်လေ ပိုကောင်းလေ) | 1.76 | 1.68 | 1.86 | 1.73 |
| Stockfish၊ ချည်မျှင်အားလုံး (Mnps) | 15.30 | 12.53 | 14.81 | 16.28 |
| primesieve ကို 10^12 အထိ၊ thread အားလုံး (s၊ နိမ့်လေ ပိုကောင်းလေ) | 11.10 | 14.20 | 11.31 | 9.57 |
| primesieve ကို 10^11 အထိ၊ thread တစ်ခု (s၊ နိမ့်လေ ပိုကောင်းလေ) | 10.15 | 9.88 | 9.56 | 12.03 |
| PyPerformance go (ms၊ နိမ့်လေ ပိုကောင်းလေ) | 75.5 | 74.2 | 69.2 | 111.2 |
| PyPerformance nbody (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 58.7 | 61.6 | 53.1 | 80.4 |
| PyPerformance regex_compile (ms၊ ပိုနည်းလေ ပိုကောင်းလေ) | 71.0 | 69.8 | 65.1 | 84.6 |
| မြန်နှုန်းပြကိရိယာ ၃.၁ (ရမှတ်၊ မြင့်လေ ပိုကောင်းလေ) | 40.6 | 41.5 | 42.7 | 36.7 |
P1 မှာ thread အားလုံးမှာ Stockfish ဟာ တစ်စက္ကန့်ကို node ၁၅.၃၀ သန်းအထိ ရောက်ရှိခဲ့ပြီး 285H မှာ ၁၂.၅၃ နဲ့ 388H မှာ ၁၄.၈၁ ရှိပြီး primesieve ဟာ ၎င်းရဲ့ thread အားလုံးမှာ ရေတွက်မှုကို ၁၁.၁၀ စက္ကန့်အတွင်း ပြီးမြောက်ခဲ့ပြီး Dell Pro Max 14 မှာ ၁၄.၂၀ ရှိရာကနေ ၂၂ ရာခိုင်နှုန်း လျော့ကျသွားခဲ့ပါတယ်။
single-thread row များသည် ယခင်မျိုးဆက်နှင့် တူညီသည်- P1 ၏ Python အချိန် 75.5၊ 58.7 နှင့် 71.0ms များသည် မည်သည့်ဦးတည်ချက်တွင်မဆို 285H ၏ 2 မှ 5 ရာခိုင်နှုန်းအတွင်းရှိပြီး 388H ၏ အပို 200MHz သည် တူညီသောစမ်းသပ်မှုသုံးခုတွင် 8 မှ 10 ရာခိုင်နှုန်းအထိ လျော့နည်းသွားကြောင်း ပြသသည်။ Speedometer ရမှတ်များသည် P1 တွင် 40.6၊ Dell Pro Max 14 တွင် 41.5 နှင့် Pro Precision 5 16S တွင် 42.7 ရရှိပြီး Edge ၏ Arm64 build တွင် N1X သည် 36.7 ဖြင့် နောက်ကျကျန်နေသည်။
GROMACS၊ OpenBLAS နှင့် မှတ်ဉာဏ်
GROMACS 2025.3 သည် benchMEM မော်လီကျူး ဒိုင်းနမစ်စနစ်ကို cores ၁၆ ခုတွင် လုပ်ဆောင်ပြီး တစ်နေ့လျှင် nanoseconds simulation ဖြင့် rank နှင့် thread layout လေးခုအနက် အကောင်းဆုံးကို အစီရင်ခံပါသည်။ OpenBLAS 0.3.34 သည် N=20,000 နှင့် N=40,000 တွင် dense LU စနစ်ကို ဖြေရှင်းပြီး physical core တိုင်းတွင် 8,000-square DGEMM ကို လုပ်ဆောင်ပြီး top core class တွင်သာ လုပ်ဆောင်ပါသည်။ STREAM သည် physical core တစ်ခုလျှင် thread တစ်ခုပါသော memory bandwidth ကို တိုင်းတာပြီး memory latency စမ်းသပ်မှုသည် 4KiB pages ပါသော 1GiB buffer ကို ဖတ်ရှုပြီး core-to-core စမ်းသပ်မှုသည် core အတွဲတိုင်းတွင် cache-line handoff latency ကို တိုင်းတာသည်။
ကျွန်ုပ်တို့သည် OpenBLAS ၏ N=10,000 အရွယ်အစားကို ဇယားမှ ဖယ်ရှားလိုက်ပါသည်။ ၎င်း၏ spread သည် ပြန်လည်လည်ပတ်ပြီးနောက် စနစ်လေးခုအနက် နှစ်ခုတွင် suite ၏ ကန့်သတ်ချက်ထက် ကျော်လွန်နေခဲ့သည်။


| စမ်းသပ် | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| GROMACS benchMEM၊ အကောင်းဆုံး အပြင်အဆင် (ns/day၊ မြင့်လေ ပိုကောင်းလေ) | 24.07 | 22.93 | 24.87 | 17.47 |
| OpenBLAS LU solve၊ N=20000၊ cores အားလုံး (GFLOPS၊ မြင့်လေ ပိုကောင်းလေ) | 474 | 321 | 504 | 330 |
| OpenBLAS LU ဖြေရှင်းချက်၊ N=40000၊ cores အားလုံး (GFLOPS) | 492 | 397 | 460 | 349 |
| OpenBLAS DGEMM၊ M=8000၊ core အားလုံး (GFLOPS) | 519 | 391 | 527 | 398 |
| OpenBLAS DGEMM၊ M=8000၊ ထိပ်တန်း core အတန်းအစား (GFLOPS) | 250 | 266 | 262 | 489 |
| တိုက်ရိုက်ကူးယူခြင်း (MB/s၊ မြင့်လေ ပိုကောင်းလေ) | 72,548 | 59,090 | 73,595 | 130,790 |
| STREAM Triad (MB/s) | 81,712 | 62,255 | 82,706 | 122,260 |
| မှတ်ဉာဏ် နှောင့်နှေးမှု၊ 1GiB၊ 4KiB စာမျက်နှာများ (ns၊ နိမ့်လေ ပိုကောင်းလေ) | 116.1 | 173.1 | 115.5 | 143.1 |
| Core-to-core latency၊ ပျမ်းမျှ (ns၊ နည်းလေ ပိုကောင်းလေ) | 92.0 | 59.2 | 88.2 | 156.8 |
| Core မှ Core အထိ နှောင့်နှေးမှု၊ အနည်းဆုံး / အများဆုံး (ns) | 27.6 / 135.5 | 19.0 / 163.9 | 24.2 / 129.4 | 54.1 / 273.6 |
P1 သည် GROMACS ကို တစ်ရက်လျှင် 24.07 ns ဖြင့် လည်ပတ်ခဲ့ပြီး 285H တွင် 22.93 ns/day ရှိခဲ့ကာ ၎င်း၏ OpenBLAS DGEMM သည် 519 GFLOPS ဖြင့် လည်ပတ်ခဲ့ပြီး 391 ထက် 33 ရာခိုင်နှုန်း တိုးလာကာ LU solution မှာ 24 မှ 48 ရာခိုင်နှုန်းအထိ မြင့်တက်လာခဲ့သည်။ Panther Lake ချစ်ပ်နှစ်ခုသည် OpenBLAS အတန်းတိုင်းတွင် တစ်ခုနှင့်တစ်ခု ရာခိုင်နှုန်းအနည်းငယ်အတွင်း ကျရောက်ပြီး N1X သည် 285H နှင့် တန်းတူ all-core DGEMM တွင် Panther Lake စနစ်နှစ်ခုလုံး၏ 398 GFLOPS ဖြင့် နောက်ကျကျန်နေပြီး ၎င်း၏ ထိပ်တန်း core အတန်းအစားတွင်သာ ဦးဆောင်နေပြီး ၎င်းသည် core တစ်ခုလျှင် vector units များ ကျဉ်းမြောင်းသော်လည်း အရေအတွက် ပိုများသော ချစ်ပ်တစ်ခု၏ ပုံစံဖြစ်သည်။
မှတ်ဉာဏ်ရလဒ်များက multi-core အပိုင်း၏အများစုကို ရှင်းပြသည်။ STREAM Triad သည် P1 တွင် 81,712MB/s နှင့် Pro Precision 5 16S တွင် 82,706 (နှစ်ခုစလုံး LPDDR5X-8533 တွင်) ဖတ်ရှုနိုင်ပြီး 285H ၏ LPDDR5X-8400 တွင် 62,255 ရှိပြီး မှတ်ဉာဏ်ထိန်းချုပ်ကိရိယာအသစ်မှ 31 ရာခိုင်နှုန်း ပိုမိုကောင်းမွန်လာပြီး transfer rate တူညီသည်။ LPDDR5X-9400 မှ N1X ၏ 122,260MB/s သည် မှတ်ဉာဏ်စနစ်၏ အတန်းအစားကွဲပြားသည်။ မှတ်ဉာဏ် latency သည် 285H တွင် 173.1 ns မှ P1 တွင် 116.1 သို့ ကျဆင်းသွားပြီး core-to-core latency သည် ပျမ်းမျှအားဖြင့် 59.2 ns မှ 92.0 ns သို့ မြင့်တက်လာပြီး ၎င်းသည် Panther Lake ၏ tile layout ၏ ဈေးနှုန်းဖြစ်ပြီး ကျွန်ုပ်တို့ run ထားသော မည်သည့်အရာတွင်မျှ မပေါ်ပါ။
ဂိမ်းကစားခြင်းနှင့် GPU ကုဒ်သွင်းခြင်း
SuperTuxKart 1.5 သည် suite ၏ cross-platform OpenGL ဂိမ်းစမ်းသပ်မှုဖြစ်ပြီး vsync ကိုပိတ်ထားပြီး အမြင့်ဆုံး preset တွင် 1080p တွင်လည်ပတ်ပြီး average၊ typical နှင့် steady frame rates အဖြစ်အစီရင်ခံသည်။
FFmpeg NVENC စမ်းသပ်မှုသည် GPU ၏ fixed-function encoder တွင် 4K60 clip ကို HEVC သို့ 8Mbps ဖြင့် encode လုပ်ပြီး၊ Arc Pro B390 တွင် Quick Sync ပါဝင်ပြီး RTX PRO 2000 စနစ်နှစ်ခုလုံးတွင် NVENC လမ်းကြောင်းသည် NVIDIA မှ ပေးပို့သော workstation driver branch အောက်တွင် စတင်ရန် ငြင်းဆိုခဲ့ပြီး၊ ၎င်းသည် အခြား notebook များ ဆွဲယူသည့် GeForce branch ကို ခြေရာခံသည်။ ထို cell များကို driver မီအောင် မလုပ်ဆောင်မချင်း မလုပ်ဆောင်ရန် အမှတ်အသားပြုထားသည်။ Media Foundation လမ်းကြောင်းသည် adapter ကိုယ်တိုင်ကို ရွေးချယ်ပြီး hybrid-graphics စက်များတွင် ဒီဇိုင်းအရ ဖယ်ထုတ်ထားသည်။

| စမ်းသပ် | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| SuperTuxKart 1080p Ultra၊ ပျမ်းမျှ FPS (မြင့်လေ ပိုကောင်းလေ) | 179.2 | 150.9 | 166.8 | 225.9 |
| SuperTuxKart 1080p Ultra၊ ပုံမှန် FPS | 178 | 150 | 165 | 227 |
| SuperTuxKart 1080p Ultra၊ တည်ငြိမ်သော FPS | 67 | 46 | 98 | 143 |
| FFmpeg NVENC HEVC၊ 8Mbps တွင် 4K60 (fps၊ မြင့်လေ ပိုကောင်းလေ) | မပြေးပါ (ယာဉ်မောင်း) | မပြေးပါ (ယာဉ်မောင်း) | ၁၂၈ (QSV) | ၁၃၂ (NVENC) |
P1 ဟာ Dell Pro Max 14 မှာ 150.9 fps နဲ့ ယှဉ်ရင် ပျမ်းမျှ 179.2 fps ရရှိခဲ့ပြီး AI ရလဒ်တွေနဲ့ ကိုက်ညီတဲ့ GPU မှာ 19 ရာခိုင်နှုန်း ဦးဆောင်နေပြီး Arc Pro B390 မှာတော့ 166.8 fps ရရှိထားပါတယ်။ AI ကိန်းဂဏန်းတွေက အကြံပြုထားတာထက် discrete card နဲ့ ပိုနီးစပ်ပါတယ်။ N1X ကတော့ 225.9 fps နဲ့ ဦးဆောင်နေပါတယ်။
RTX PRO 2000 က ဂိမ်းကတ်တစ်ခု မဟုတ်သလို SuperTuxKart ကလည်း တောင်းဆိုမှုများတဲ့ ဂိမ်းတစ်ခု မဟုတ်တဲ့အတွက် ဒီစာကြောင်းက GPU ရဲ့ စွမ်းဆောင်ရည်ကို စစ်ဆေးတာဖြစ်ပြီး ဆုံးဖြတ်ချက် မဟုတ်ပါဘူး။ NVENC ရလဒ် ပျောက်ဆုံးနေတာက P1 ရဲ့ GPU ဇာတ်လမ်းထဲက ကျွန်တော်တို့ ဓာတ်ခွဲခန်းမှာ မဖြေရှင်းနိုင်တဲ့ ကွာဟချက်တစ်ခုဖြစ်ပြီး hardware ပြဿနာ မဟုတ်ဘဲ driver ပြဿနာပါ။ Dell Pro Precision 5 16S က Quick Sync မှာ HEVC ကို 128 fps နဲ့ encode လုပ်ထားပြီး OmniBook ကတော့ NVENC မှာ 138 fps နဲ့ encode လုပ်ထားပါတယ်။
အပူချိန်ထိန်းကိရိယာများနှင့် ဝန်အားအောက်ရှိနာရီများ
suite သည် စမ်းသပ်မှုတိုင်းတွင် CPU အပူချိန်နှင့် clock ကို နမူနာယူသည်။ P1 သည် နှစ်ခုလုံးကို အစီရင်ခံခဲ့သည်။ Dells နှစ်ခုသည် suite ၏ sensor path သို့ clock များကို ဖော်ထုတ်ခဲ့သော်လည်း အပူချိန်များကို မဖော်ထုတ်ခဲ့ဘဲ၊ အုပ်စုရှိ system တွင် GPU အပူချိန် သို့မဟုတ် power ကို မည်သည့် system မှ မဖော်ထုတ်ခဲ့ပါ။ ထို့ကြောင့် အောက်ပါဇယားတွင် P1 နှင့် OmniBook ၏ အမြင့်ဆုံး CPU အပူချိန်နှင့် system လေးခုလုံး၏ စမ်းသပ်မှုတစ်ခုလျှင် ပျမ်းမျှ clock ကို ဖော်ပြထားသည်။ P1 သည် လည်ပတ်မှုမပြုမီ 44C တွင် အလုပ်မလုပ်ခဲ့ပါ။

| စမ်းသပ်နေစဉ်အတွင်း အမြင့်ဆုံး CPU အပူချိန် / ပျမ်းမျှ CPU နာရီ (MHz) | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| Cinebench ၂ | 94C / 3,853 | 3,818 | 3,792 | 98C / 2,962 |
| စဉ်ဆက်မပြတ် ကွင်းဆက် | 94C / 3,503 | 3,409 | 3,397 | 98C / 3,239 |
| 7-Zip | 94C / 3,854 | 3,768 | 3,936 | 98C / 2,838 |
| ငါး | 95C / 3,712 | 3,142 | 3,345 | 98C / 3,269 |
| Blender | 94C / 3,779 | 3,506 | 3,665 | 98C / 3,123 |
| HandBrake | 94C / 3,764 | 3,469 | 3,718 | 98C / 2,756 |
| LLVM တည်ဆောက်မှု | 94C / 3,754 | 3,477 | 3,631 | 98C / 3,151 |
| ဂရိုမက်စ် | 94C / 3,601 | 3,483 | 3,525 | 98C / 3,308 |
| OpenBLAS | 95C / 3,696 | 3,471 | 3,701 | 98C / 3,024 |
| ရေနွေးငွေ့ | 76C / 3,844 | 4,347 | 4,014 | 98C / 3,258 |
| primesive sieve | 95C / 3,792 | 3,716 | 3,894 | 98C / 2,930 |
| MLPerf ကလိုင်းယင့် | 89C / 3,544 | 3,980 | 2,632 | 93C / 2,114 |
| အဝတ်စုတ် | 91C / 3,661 | 3,684 | 3,838 | 94C / 2,749 |
| LLM ဝန်ဆောင်မှု | 82C / 3,810 | 4,156 | မပြေးပါ | မပြေးပါ |
| Super Tux Kart | 86C / 3,612 | 3,912 | 3,653 | 95C / 1,957 |
| fio သိုလှောင်မှု | 84C / 3,680 | 3,437 | 3,366 | 94C / 2,359 |
all-core CPU စမ်းသပ်မှုတိုင်းတွင် P1 ၏ processor သည် 94 သို့မဟုတ် 95C အထိ ရောက်ရှိခဲ့ပြီး Intel သည် Panther Lake ကို လည်ပတ်ခွင့်ပြုသည့်နေရာဖြစ်ပြီး chip ၏ clock သည် ထိုအမြင့်ဆုံးအဆင့်တွင် တည်ရှိသော နံပါတ်သည် အရေးကြီးသည်- Cinebench မှတစ်ဆင့် 3,853MHz၊ Blender မှတစ်ဆင့် 3,779၊ LLVM build မှတစ်ဆင့် 3,754 နှင့် မိနစ် ၃၀ loop တွင် 3,503 ရရှိခဲ့ပြီး Dell Pro Max 14 ရှိ 285H တွင် 3,818၊ 3,506၊ 3,477 နှင့် 3,409 နှင့် Pro Precision 5 16S ရှိ 3,792၊ 3,665၊ 3,631 နှင့် 3,397 တို့ကို နှိုင်းယှဉ်ခဲ့သည်။
P1 သည် renders၊ build နှင့် 30-minute loop တို့တွင် x86 system သုံးခုအနက် အမြင့်ဆုံး clocks များကို ကိုင်ဆောင်ထားပြီး 7-Zip၊ primesieve နှင့် OpenBLAS တို့တွင် 388H ၏ 3 ရာခိုင်နှုန်းအတွင်းတွင် ရှိနေပြီး chassis သည် ၎င်း၏အလုပ်ကို လုပ်ဆောင်နေသည်။ memory၊ serving နှင့် storage စမ်းသပ်မှုများသည် 76 မှ 84C အထိ ရှိပြီး all-core CPU စမ်းသပ်မှုများအတွက် 94 မှ 95C အထိ ရှိသည်။
သိုလှောင်ရေးစွမ်းဆောင်မှု
P1 မှာ Surface Laptop Ultra မှာလည်း Gen5 slot မှာ ပါရှိတဲ့ OEM Gen5 x4 drive ဖြစ်တဲ့ 2TB SK hynix PCB01 ပါဝင်ပါတယ်။ Dell Pro Precision 5 16S မှာတော့ Dell Pro Max 14 နဲ့ 2TB SK hynix PC811 တို့ရဲ့ 1TB ဗားရှင်းနဲ့ OmniBook နဲ့ 2TB Sandisk SN8050S တို့ရဲ့ ဗားရှင်းတွေ ပါဝင်ပါတယ်။
ဒီ suite ဟာ file system မှတစ်ဆင့် boot drive ကို ထောင့်လေးထောင့်မှာ run ပြီး read တွေအတွက် raw device ကို 5GiB နဲ့ 25GiB footprints တွေမှာ run ပါတယ်။ 25GiB ရလဒ်တွေကို အောက်မှာ ဖော်ပြထားပါတယ်။ Sequential tests တွေက one job မှာ queue depth 32 မှာ 128K transfers တွေကို အသုံးပြုပြီး random tests တွေက 4, 8 နဲ့ 16 job မှာ queue depth 32 မှာ 4K transfers တွေကို အသုံးပြုပြီး peak ကို ဖော်ပြပါတယ်။


| fio၊ 25GiB footprint | Lenovo ThinkPad P1 Gen 9 (386H, RTX PRO 2000) | Dell Pro Max 14 Premium (285H၊ RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H၊ Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| အစီအစဉ်အတိုင်း 128K၊ QD32၊ အလုပ် ၁ ခု | ||||
| ဖတ်ရန်၊ ဖိုင်စနစ် (MB/s၊ မြင့်လေ ပိုကောင်းလေ) | 10,012 | 7,014 | 9,216 | 13,833 |
| ဖတ်ပြီးသော၊ ကုန်ကြမ်းစက်ပစ္စည်း (MB/s) | 9,830 | 7,127 | 9,009 | 12,480 |
| ရေးသားရန်၊ ဖိုင်စနစ် (MB/s) | 9,203 | 6,709 | 9,009 | 11,720 |
| latency ကိုဖတ်ပါ၊ ပျမ်းမျှ (us၊ ပိုနည်းလေ ပိုကောင်းလေ) | 403.9 | 590.7 | 448.6 | 297.1 |
| ရေးသားချိန်၊ ပျမ်းမျှ (us၊ ပိုနည်းလေ ပိုကောင်းလေ) | 255.5 | 605.9 | 278.6 | 327.0 |
| ကျပန်း 4K၊ QD32၊ အမြင့်ဆုံးအလုပ်များ | ||||
| ဖတ်ရန်၊ ဖိုင်စနစ် (IOPS၊ မြင့်လေ ပိုကောင်းလေ) | 756,484 | 762,412 | 780,147 | 437,833 |
| ဖတ်ရန်၊ ကုန်ကြမ်းစက်ပစ္စည်း (IOPS) | 1,413,311 | 1,472,760 | 1,224,270 | 1,888,501 |
| ရေးသားရန်၊ ဖိုင်စနစ် (IOPS) | 682,019 | 668,194 | 679,108 | 228,354 |
| ကျပန်း 4K ဖတ်ရှုမှု၊ ဖိုင်စနစ်၊ အလုပ်အရေအတွက်အလိုက် | ||||
| အလုပ် ၁၆ ခု (IOPS) | 501,165 | 395,583 | 525,514 | 437,833 |
| အလုပ် ၁၆ ခု၊ p99 နှောင့်နှေးမှု (အမေရိကန်) | 281 | 379 | 253 | 643 |
| အလုပ် ၁၆ ခု (IOPS) | 672,837 | 665,195 | 736,789 | 426,433 |
| အလုပ် ၁၆ ခု၊ p99 နှောင့်နှေးမှု (အမေရိကန်) | 578 | 733 | 436 | 815 |
| အလုပ် ၁၆ ခု (IOPS) | 756,484 | 762,412 | 780,147 | 377,545 |
| အလုပ် ၁၆ ခု၊ p99 နှောင့်နှေးမှု (အမေရိကန်) | 963 | 864 | 995 | 1,122 |
| ကျပန်း 4K ရေးသားမှု၊ ဖိုင်စနစ်၊ အလုပ်အရေအတွက်အလိုက် | ||||
| အလုပ် ၁၆ ခု (IOPS) | 444,243 | 466,372 | 442,234 | 228,354 |
| အလုပ် ၁၆ ခု၊ p99 နှောင့်နှေးမှု (အမေရိကန်) | 362 | 342 | 358 | 586 |
| အလုပ် ၁၆ ခု (IOPS) | 682,019 | 668,194 | 679,108 | 221,647 |
| အလုပ် ၁၆ ခု၊ p99 နှောင့်နှေးမှု (အမေရိကန်) | 963 | 1,876 | 1,012 | 2,638 |
PCB01 သည် file system မှတစ်ဆင့် 10,012MB/s နှင့် raw device မှ 9,830 ကို ဖတ်ရှုပြီး 9,203MB/s ရေးသားကာ file system မှတစ်ဆင့် 4K random reads တွင် 756.5K IOPS နှင့် raw တွင် 1.41M IOPS ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး random writes တွင် 682.0K IOPS ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။
ထိုကိန်းဂဏန်းများသည် Pro Precision 5 16S တွင် တူညီသော drive ၏ ရာခိုင်နှုန်းအနည်းငယ်အတွင်းတွင် ရှိနေပြီး sequential work၊ 7,014MB/s read နှင့် 6,709 write တို့တွင် Dell Pro Max 14 ရှိ PC811 ထက် များစွာသာလွန်နေပြီး Dell ရှိ 1TB drive သည် ထိပ်တန်း job count တွင် random read များတွင် အနည်းငယ်ရာခိုင်နှုန်းသာလွန်နေပါသည်။ OmniBook ၏ SN8050S သည် sequential read 13,833MB/s နှင့် raw random read များတွင် ဦးဆောင်နေပြီး random write တွင် 228.4K IOPS တွင် ညံ့ဖျင်းစွာ နောက်ကျကျန်နေပြီး 16 jobs တွင် read နှင့် write နှစ်ခုလုံးတွင် 3 စက္ကန့်ကျော် 99.99th percentile latency ရှိပြီး ထိုသုံးသပ်ချက်သည် Windows on Arm storage path ကို ခြေရာခံမိခဲ့သည်။
P1 ရဲ့ drive က Gen5 badge ရရှိတဲ့ latency ပါ။ jobs လေးခုမှာ random read အတွက် 99th percentile က 281 microseconds ဖြစ်ပြီး PC811 မှာတော့ 379 ပါ။ jobs ၁၆ ခုမှာ PC811 က 99th percentile မှာ ဦးဆောင်နေပြီး P1 ရဲ့ 963 microseconds ထက် 864 microseconds ပိုများပေမယ့် P1 ရဲ့ 99.99th percentile က 12,648 microseconds ဖြစ်ပြီး Dell Pro Max 14 ရဲ့ 83,362 ထက် အနည်းငယ်သာပါတယ်။
ကျပန်းရေးသားမှုများသည် အလုပ် ၁၆ ခုတွင် တူညီသောဇာတ်လမ်းကို ပြောပြသည်- P1 တွင် p99 တွင် 963 မိုက်ခရိုစက္ကန့်များနှင့် နှိုင်းယှဉ်ပါက 1,876 မိုက်ခရိုစက္ကန့်များနှင့် နှိုင်းယှဉ်ပါက 99.99th percentile နှင့် 4,882 မိုက်ခရိုစက္ကန့်များနှင့် နှိုင်းယှဉ်ပါက 102,236 ဖြစ်သည်။ မော်ဒယ်ကက်ရှ်၊ ရယ်ဒီကယ်များအတွက် scratch volume သို့မဟုတ် ကြီးမားသော ပရောဂျက်သစ်ပင်ကို လက်ခံထားရှိမည့် workstation သည် peaks ထက် tails တွင် ကွာခြားချက်ကို ပိုမိုခံစားရလိမ့်မည်။
ကောက်ချက်
ThinkPad P1 Gen 9 သည် Panther Lake ပါဝင်သော P1 Gen 8 ဖြစ်သည်။ Panther Lake သည် Dell Pro Max 14 ရှိ 285H ထက် all-core စမ်းသပ်မှုတိုင်းတွင် သာလွန်ကောင်းမွန်ပြီး HandBrake encodes နှင့် GROMACS တွင် ၅ ရာခိုင်နှုန်းခန့်နှင့် အခြားအရာအားလုံးတွင် ၁၃ မှ ၄၈ ရာခိုင်နှုန်းအထိ သာလွန်ကောင်းမွန်ပြီး မှတ်ဉာဏ်စနစ်သည် ၃၁ ရာခိုင်နှုန်း ပိုမိုကျယ်ပြန့်ပြီး latency တွင် ၃၃ ရာခိုင်နှုန်း လျော့နည်းကာ ကိုယ်ထည်သည် Dell Pro Precision 5 16S ရှိ Panther Lake silicon ထက် ပိုမိုမြင့်မားသော clocks များတွင် ချစ်ပ်ကို ထိန်းထားနိုင်သောကြောင့် P1 သည် အခြား ၁၆ လက်မ Panther Lake workstation ထက် မိနစ် ၃၀ အတွင်း ၈ ရာခိုင်နှုန်း ပိုမိုခံနိုင်ရည်ရှိသည်။
Single-thread စွမ်းဆောင်ရည်က မပြောင်းလဲဘဲ၊ rendering နဲ့ build တွေထက် browser နဲ့ office responsiveness ကို ဦးစားပေးတဲ့ ဝယ်သူတွေဟာ ယခင်မျိုးဆက် ဒါမှမဟုတ် integrated-only configuration ပါဝင်တဲ့ X9 388H ကိုလည်း အလားတူမြန်ဆန်ပြီး အနည်းငယ်စျေးသက်သာတာကို တွေ့ရှိကြပါလိမ့်မယ်။

50W ရှိတဲ့ RTX PRO 2000 ဟာ ကျွန်တော်တို့ သုံးသပ်ဖူးသမျှထဲမှာ အမြန်ဆုံး RTX PRO 2000 ဖြစ်ပြီး MLPerf token rates မှာ ၁၉ ရာခိုင်နှုန်းကနေ ၂၇ ရာခိုင်နှုန်းအထိနဲ့ serving throughput မှာ ၁၉ ရာခိုင်နှုန်းအထိ 47W ရှိတဲ့ ကတ်ထက် သာလွန်ပါတယ်။ ပြီးတော့ P လိုင်းက ဒီဇိုင်းထုတ်ထားတဲ့ ISV အသိအမှတ်ပြုလက်မှတ်တွေကိုလည်း ရရှိထားပါတယ်။ ၎င်းရဲ့ 8GB GDDR7 ဟာ parameters ဘီလီယံအနည်းငယ်ရှိတဲ့ မော်ဒယ်တွေမှာ local AI ကို ကန့်သတ်ထားပြီး ကျွန်တော်တို့ရဲ့ model-load၊ coding-agent နဲ့ ပိုကြီးတဲ့ serving tiers တွေကို Not run အဖြစ် ပြသထားပြီး 128GB RTX Spark notebook နဲ့ 64GB Arc Pro B390 တို့ဟာ model-load နဲ့ coding-agent tier တိုင်းကို run ပါတယ်။
Lenovo ရဲ့ dGPU ကို 386H နဲ့ တွဲသုံးဖို့ ဆုံးဖြတ်ချက်ကြောင့် P1 ဝယ်ယူသူဟာ Arc Pro B390 နဲ့ 5.1GHz X9 388H တို့ကိုလည်း စွန့်လွှတ်လိုက်ရပြီး ဒါဟာ အသိအမှတ်ပြု ဂရပ်ဖစ်တွေအတွက် ကျိုးကြောင်းဆီလျော်တဲ့ အရောင်းအဝယ်တစ်ခုဖြစ်ပြီး ဒေသတွင်း ကောက်ချက်ချတဲ့ developer တွေအတွက် ပိုဆိုးတဲ့ အရောင်းအဝယ်တစ်ခုလည်း ဖြစ်ပါတယ်။
ကျွန်ုပ်တို့ရဲ့ configuration ရဲ့ OLED ဗားရှင်းအတွက် $7,719 စာရင်းနဲ့ Lenovo က အောက်တိုဘာ ၂၂ ရက်နေ့မှာ ရောင်းချခဲ့တဲ့ $5,399 ရောင်းချမှုဈေးနှုန်းနဲ့ P1 Gen 9 ရဲ့ ဈေးနှုန်းကို flagship အဖြစ် သတ်မှတ်ထားပါတယ်။ Lenovo က P လိုင်းကို မကြာခဏ လျှော့စျေးပေးထားတာကြောင့် ရောင်းချမှုဈေးနှုန်းကို လက်တွေ့ကိန်းဂဏန်းအဖြစ် သဘောထားပြီး တူညီတဲ့ processor နဲ့ GPU ပါဝင်တဲ့ P16s Gen 5 ထက် premium မှာ 90Wh ဘက်ထရီ၊ Thunderbolt 5၊ ဒုတိယ M.2 slot၊ အလူမီနီယမ်ကိုယ်ထည်နဲ့ 800-nit 4K နဲ့ Tandem OLED panel option တွေ ပါဝင်ပါတယ်။
RTX Spark N1X ပလက်ဖောင်းများသည် ယခုလတွင် စတင်တင်ပို့ခဲ့သောကြောင့် P1 Gen 8 တင်ပို့ချိန်တွင် မရှိခဲ့သော ဈေးနှုန်းတစ်ခုတွင် မည်သည့်ဈေးနှုန်းမဆို ပါဝင်ပါသည်။ ထိုအုပ်စုတွင် P1 နှင့် အနီးစပ်ဆုံး နှိုင်းယှဉ်နိုင်သော HP OmniBook Ultra 16 သည် 64GB ဖြင့် $4,999.99 နှင့် 128GB ဖြင့် $6,229.99 ဖြင့် စာရင်းတင်ထားပြီး Surface Laptop Ultra လိုင်းသည် အမြင့်ဆုံး $5,899.99 ဖြင့် ရှိနေပြီး HP ၏ ZBook Ultra G3a 16 သည် 192GB Ryzen AI Max unified memory အထိ ပါဝင်ပြီး အမေရိကန်တွင် မှာယူမှုများကို $3,149 မှစတင်၍ ဖွင့်လှစ်ထားသည်။
Lenovo ဟာ သူ့ရဲ့ အမျိုးအစားရဲ့ စားသုံးသူဘက်ခြမ်းမှာ RTX Spark ကိုလည်း တင်ပို့ပါတယ်။ ကျွန်တော်တို့ သုံးသပ်ထားတဲ့ Yoga 9n 2-in-1 16 ကို 20-core N1X နဲ့ 64GB တို့နဲ့ တွဲဖက်ရောင်းချတာဖြစ်ပြီး Lenovo Pro 9n 15 မှာတော့ 18-core နဲ့ 32GB တို့ ပါဝင်ပါတယ်။ နှစ်ခုစလုံးက အသိအမှတ်ပြု workstation မဟုတ်တဲ့အတွက် OmniBook က ဒီနေရာမှာ နှိုင်းယှဉ်လို့ ရပါတယ်။ ဒါပေမယ့် P1 မှာ မရှိတဲ့ GPU-addressable memory က Lenovo ရဲ့ ကိုယ်ပိုင် catalog မှာ ရှိနှင့်ပြီးသားပါ။ 128GB OmniBook နဲ့ Surface မှာ P1 မစတင်နိုင်တဲ့ model-load နဲ့ coding-agent tiers တွေကို အသုံးပြုထားပြီး ဝယ်ယူသူတွေအနေနဲ့ သူတို့ရဲ့ ရွေးချယ်စရာတွေကို ရှာဖွေနေလောက်တဲ့ ဈေးနှုန်းနဲ့ ရှိနေပါတယ်။
ဒီလိုပြောင်းလဲလိုက်တဲ့ ဝယ်ယူသူကတော့ ဒေါ်လာ ၅၀၀၀ ဝန်းကျင် notebook တွေမှာ GPU-addressable memory 128GB ပါဝင်ရတဲ့ အကြောင်းရင်းက သူ့ရဲ့ workload ပါ။ အဲဒီလူအတွက် ဒီဈေးနဲ့ 8GB discrete card ဝယ်ယူမှုဟာ မှားယွင်းတဲ့ ဝယ်ယူမှုတစ်ခုဖြစ်ပြီး P1 ရဲ့ အခန်းကဏ္ဍက ပိုကြီးတဲ့ စက်ရှေ့မှာ မြန်ဆန်ပြီး သယ်ဆောင်ရလွယ်ကူတဲ့ client ပါ။ Lenovo ရဲ့ အဖြေကတော့ Arc Pro B390 ပါဝင်တဲ့ X9 388H build ပါ။ ဒီသုံးသပ်ချက်မှာ Dell Pro Precision 5 16S ရဲ့ configuration က ကိုယ်စားပြုပြီး model-load နဲ့ coding-agent tier တိုင်းကို run ပေးပါတယ်။
၁.၈ ကီလိုဂရမ်အောက် အသိအမှတ်ပြု မိုဘိုင်း workstation လိုအပ်ပြီး ဒေသတွင်း AI ကို 8 ဘီလီယက်အောက် အဆင်ပြေမှုအဖြစ် သဘောထားတဲ့ အင်ဂျင်နီယာ ဒါမှမဟုတ် အရောင်ပညာရှင်အတွက် P1 ဟာ ဝယ်သင့်တဲ့ ThinkPad ပါပဲ။ unified-memory အုပ်စုမှာ သူ့ရဲ့ Thunderbolt 5 ports၊ LPCAMM2 နဲ့ dual M.2 serviceability ဒါမှမဟုတ် ISV စာရင်းနဲ့ ယှဉ်နိုင်တဲ့ ဘာမှ မရှိပါဘူး။
ဦးဆောင်သူစာရင်း- Lenovo ThinkPad P1 Gen 9 သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး မိုဘိုင်း Workstations ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး ပရီမီယံ ပါးလွှာပြီး ပေါ့ပါးသော ဆုကို ရရှိထားပြီး ၎င်း၏ ဒေသတွင်း AI ရလဒ်များကို ကျွန်ုပ်တို့၏ ဒေသတွင်း AI ဘုတ် အတွက် အကောင်းဆုံး လက်ပ်တော့ များတွင် စမ်းသပ်ထားသည် အောက်တွင် ဖော်ပြထားသည် ။



 အမေဇုံ