

Przyjrzeliśmy się już kilku stacjom GB300 DGX i ostatnio mieliśmy fizycznie dwie z nich w naszym laboratorium jednocześnie: ASUS ExpertCenter Pro ET900N G3 i HP ZGX Fury AI Station . Ponieważ obie wieże stały obok siebie, chcieliśmy je połączyć i sprawdzić, jak drugi GB300 może zwiększyć wydajność pojedynczej maszyny, umożliwiając bardziej skoordynowane zadania z zakresu AI przy biurku.
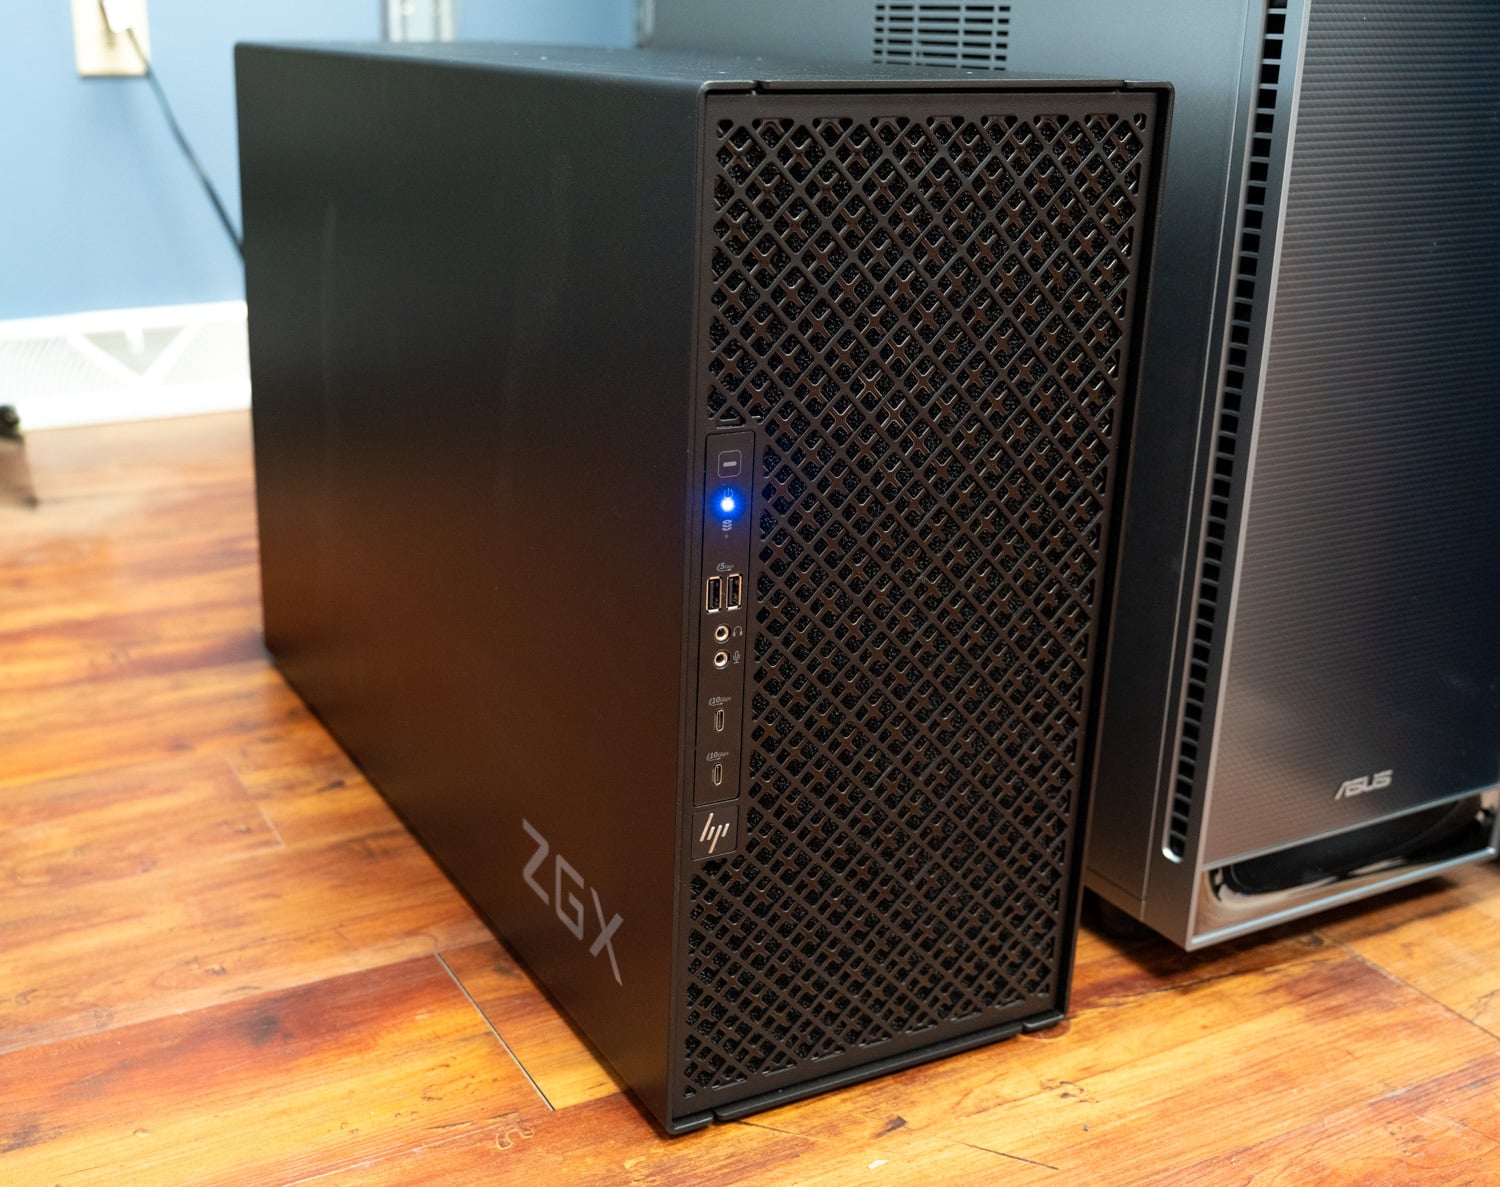
Rozbudowa komputera stacjonarnego o jeden komputer na raz nie jest nowym pomysłem; NVIDIA wyraźnie to zasugerowała w platformie GB10. Jednym z elementów, które sprawiły, że DGX Spark był tak wyjątkowy, była możliwość rozpoczęcia pracy z jednym systemem i podłączania kolejnych w miarę wzrostu obciążeń. GB300 oferuje na początku znacznie wyższą wydajność, ale obsługa większych modeli lub większej liczby użytkowników może stanowić obciążenie nawet dla jednego z najszybszych komputerów stacjonarnych, jakie testowaliśmy. Właśnie o to nam chodziło w naszej pierwotnej recenzji MSI : jeśli obciążenia uzasadniają użycie jednej z tych stacji, łatwo zrozumieć, jak ostatecznie uzasadniają użycie kilku.
Dla wielu kupujących koszty będą decydować o tym, kiedy rozbudowa stanie się realna. Zrozumienie, jak dobrze dwie stacje współpracują ze sobą, daje osobie, która zaczyna od jednej, jaśniejszy obraz korzyści, jakie może ona przynieść w przyszłości.
Na wynos
- Dwa kable, 98% przepustowości łącza: Dwa przetworniki cyfrowo-analogowe 400G umieszczone między portami ConnectX-8 w płytach ASUS ET900N G3 i HP ZGX Fury zapewniły przepustowość NCCL 98 GB/s podczas transmisji, redukcji oraz wysyłania/odbioru w porównaniu do 100 GB/s, które para może przenieść. Przepustowość GPUDirect RDMA osiągnęła 392 Gb/s na każdej szynie, a średni czas zapisu 8 bajtów w RDMA wyniósł 1.46 µs. Za konfigurację odpowiadał podręcznik firmy NVIDIA.
- GLM-5.2 zyskuje 11x przy dopasowanej współbieżności: Punkt kontrolny NVFP4 o pojemności 433 GB przekazuje około 215 GB danych eksperckich do pamięci Grace na jednej stacji, która obsługiwała 139 tokenów wyjściowych na sekundę przy 32 strumieniach; podzielone na dwa B300 w układzie tensorowym równoległym, osiągnęło 1,525 przy 32 strumieniach i 3,141 przy 256.
- GLM-5.3 zwiększa prędkość z 188 do 5,018 tokenów na sekundę: Największy wzrost w zestawie, 27x, odnotowano w drugim modelu, który przepełnia 252 GB pamięci HBM3e, przy czym para nadal osiąga 256 strumieni przy takim samym obciążeniu i utrzymuje blisko 600 tokenów wyjściowych na sekundę przy monitach 8,192 tokenów, czyli około pięciokrotnie więcej niż pojedyncza wieża.
- Długie komunikaty MiniMax-M3 zatrzymują się na ośmiu strumieniach na jednej stacji: Pojedyncza wieża obsłużyła 103 tokeny wyjściowe na sekundę przy ośmiu strumieniach, ponieważ wyczerpała się pamięć podręczna KV; w tym samym momencie para obsłużyła 736 tokenów wyjściowych (7.1x), a następnie osiągnęła 1,801 przy 256 strumieniach.
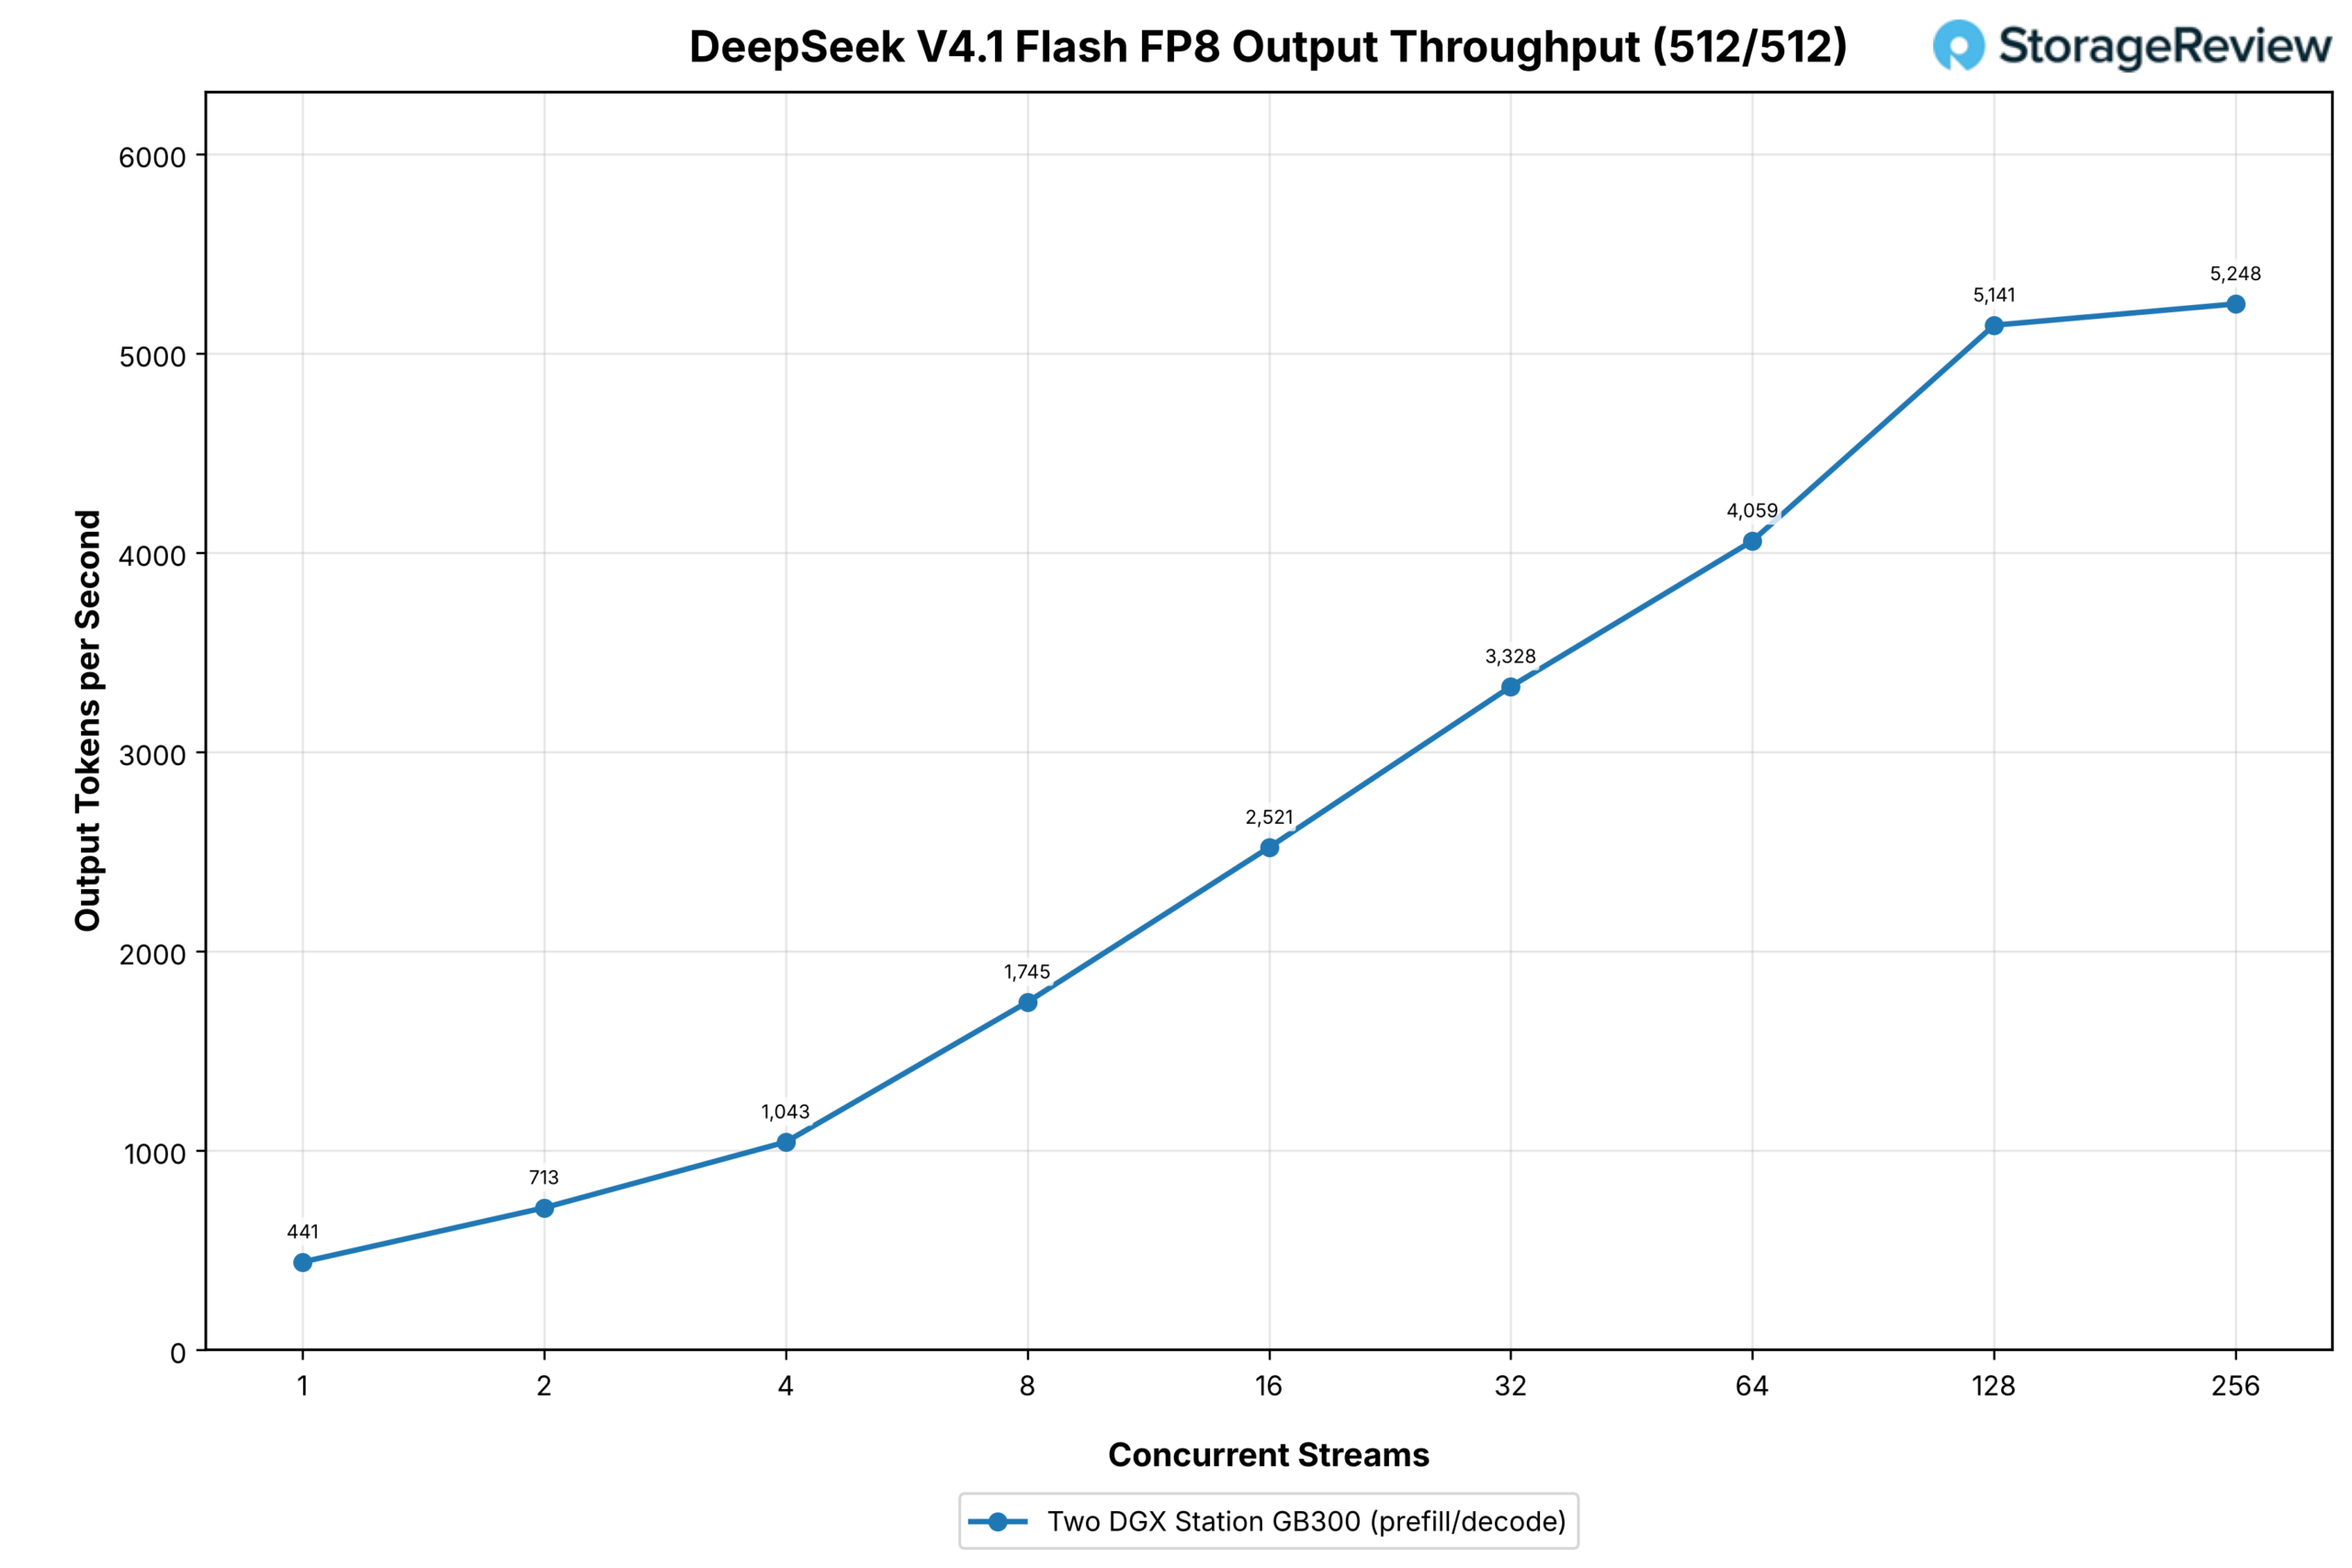
- Modele, które pasują, otrzymują drugą kopię i podział na części: wstępne wypełnienie/dekodowanie: Przy jednej stacji na wstępnym wypełnianiu i drugiej na dekodowaniu, GLM-5.3 Flash potroił przepustowość krótkich monitów przy 32 strumieniach (z 828 do 2,721) i podwoił przepustowość długich monitów (z 1,219 do 2,448), a DeepSeek V4.1 Flash osiągnął najwyższą przepustowość wyjściową ze wszystkich testowanych modeli: 5,248 tokenów na sekundę przy 256 strumieniach.
Sieć na stacji DGX
Zanim przejdziemy do omówienia klastra, podsumujmy możliwości sieciowe omówione w naszej recenzji MSI. Karta sieciowa ConnectX-8 SuperNIC oferuje więcej niż tylko połączenie sieciowe. Zintegrowany przełącznik PCIe obsługuje również część wewnętrznych operacji wejścia/wyjścia stacji, łącząc się z kontrolerem Grace oraz dwoma gniazdami pamięci masowej PCIe Gen 6 x4.
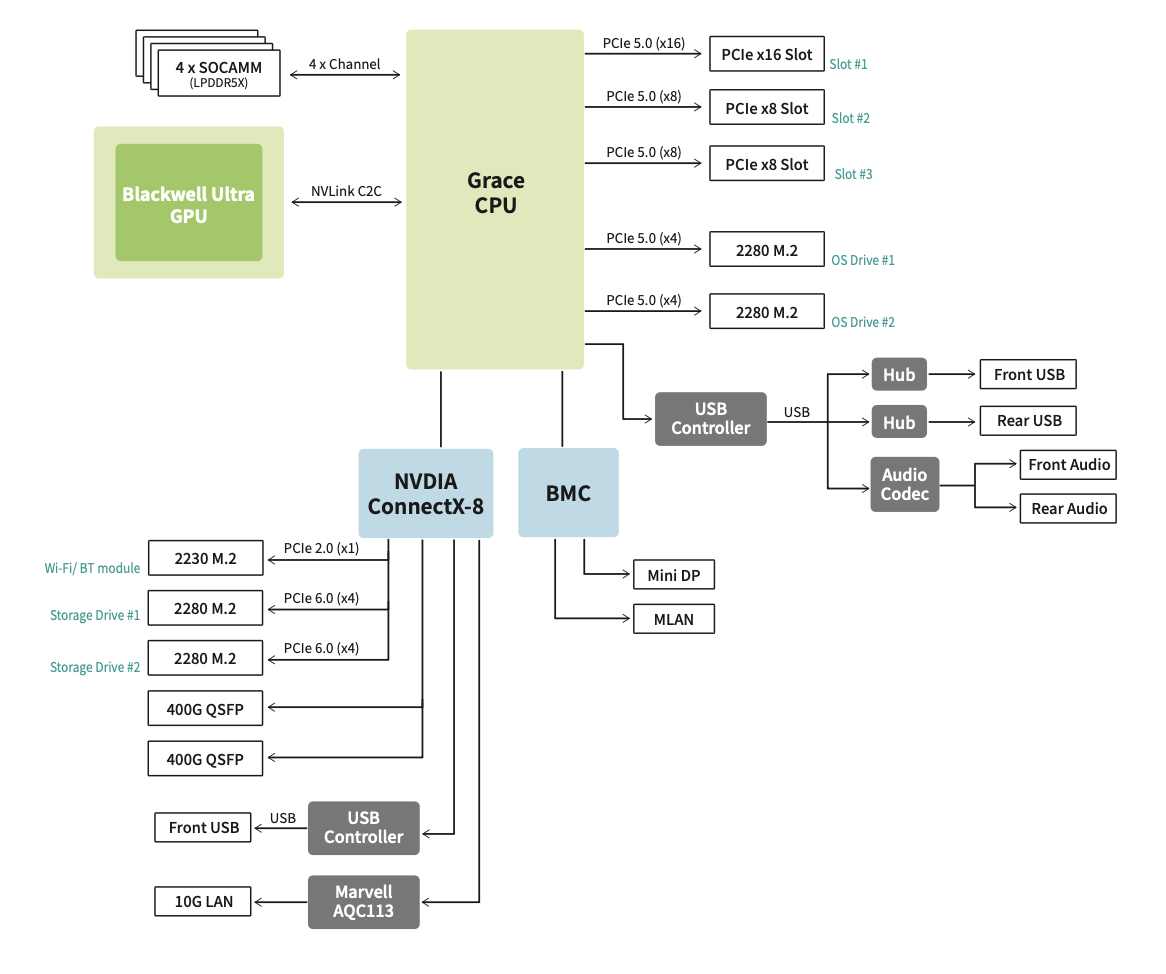
Do obsługi faktycznej sieci system udostępnia dwa porty QSFP112 o przepustowości 400 Gb/s każdy, co zapewnia łączną przepustowość 800 Gb/s, umożliwiając łączenie stacji ze sobą lub podłączanie ich do większej sieci.
W porównaniu z implementacją DGX Spark, którą omówiliśmy w naszej oryginalnej recenzji DGX Spark , ConnectX-7 Sparka o przepustowości 400 Gb/s był bardziej wydajny niż łączność PCIe GB10. Kontroler znajdował się za dwoma oddzielnymi łączami PCIe 5.0 x4, ograniczając użyteczną łączną przepustowość sieci do około 200 Gb/s. Jego dwa porty fizyczne były również widoczne jako cztery logiczne interfejsy Ethernet w systemie Linux. Uzyskanie pełnej przepustowości wymagało zmapowania tych interfejsów z powrotem do podłączonej klatki, skonfigurowania obu logicznych interfejsów za nią oraz upewnienia się, że ruch RDMA może korzystać z obu ścieżek PCIe.
Stacja oferuje nam prostsze rozwiązanie, z dwoma portami 400 Gb/s, z których każdy może służyć jako niezależna szyna sieciowa.
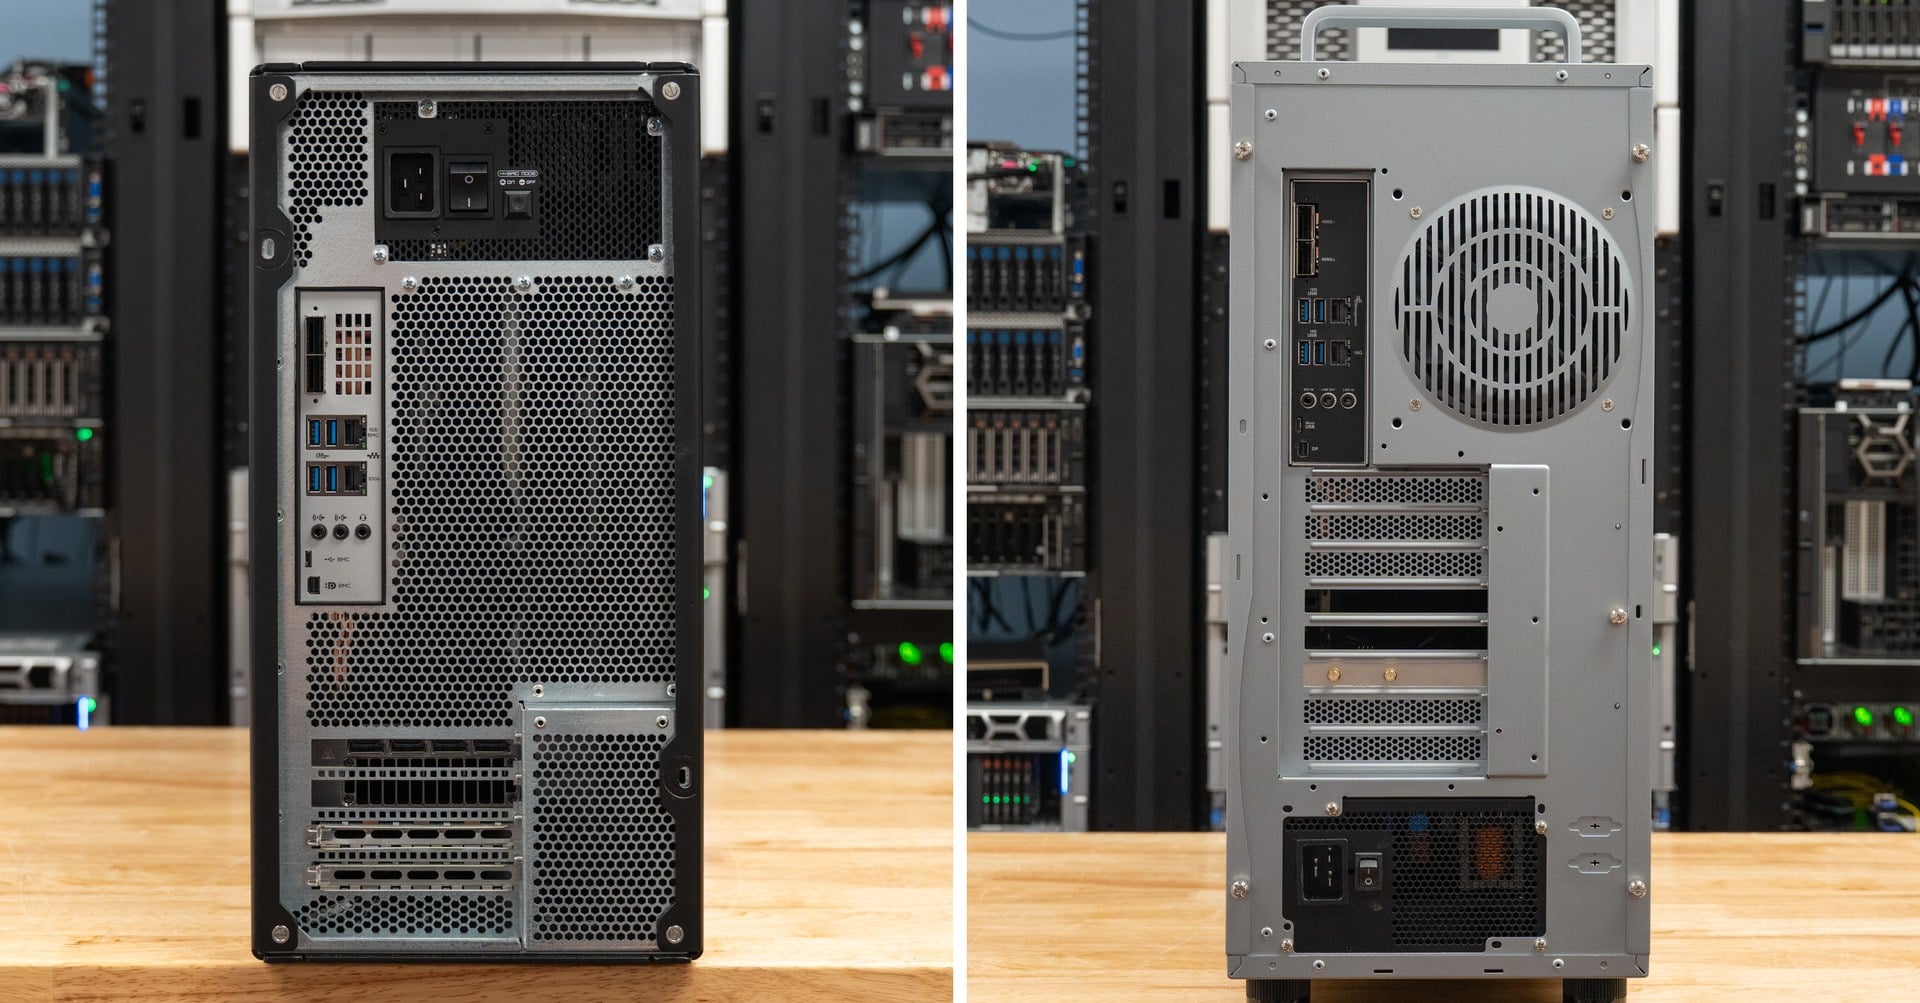
Przepuszczenie czterokrotnie większej przepustowości użytkowej Sparka przez parę klatek QSFP również zwiększa obciążenie układu chłodzenia, a podczas naszych testów każde urządzenie sobie z tym poradziło. Sam ConnectX-8 jest chłodzony cieczą, a niektórzy producenci, jak MSI, rozszerzają to chłodzenie na klatki QSFP, podczas gdy inni używają radiatorów i dedykowanych wentylatorów nad klatkami, co widzieliśmy w naszej recenzji ASUS-a. To chłodzenie jest szczególnie przydatne w przypadku modułów optycznych, które generują więcej ciepła niż pasywne przetworniki cyfrowo-analogowe (DAC). Oba podejścia sprawdziły się w naszych testach i nie napotkaliśmy problemów z chłodzeniem sieci.
Łączenie dwóch stacji
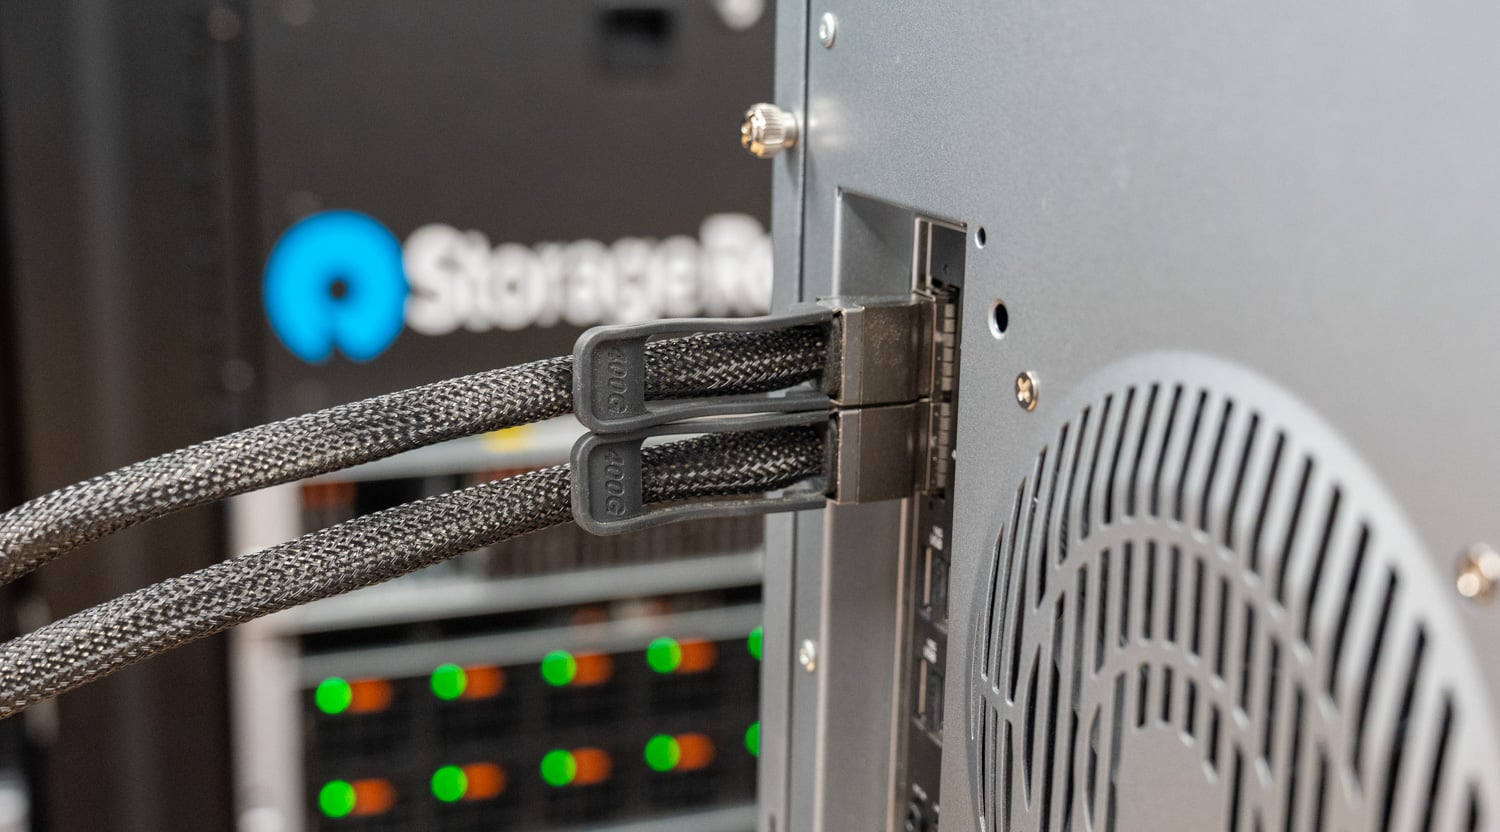
Połączenie dwóch stacji DGX było proste: połączyliśmy je bezpośrednio za pomocą dwóch miedzianych kabli 400G z bezpośrednim podłączeniem (DAC) pomiędzy pasującymi do nich portami QSFP112, uzyskując w ten sposób dwa niezależne połączenia 400 Gb/s.
Od strony oprogramowania NVIDIA udostępnia przewodnik krok po kroku dotyczący klastrowania systemów, a instrukcje były na tyle jasne, że po prostu podaliśmy link do Claude Code i pozwoliliśmy mu zająć się konfiguracją. Skonfigurował sieć między dwiema stacjami, przeprowadził testy przepustowości NCCL i przesłał nam raport z wynikami.
Przewodnik to numerowany podręcznik uruchamiany z trzeciej maszyny, która łączy się z obiema stacjami przez SSH. Porty są połączone kablami jako pasujące szyny: QSFP0 do QSFP0 i QSFP1 do QSFP1, a każda szyna staje się osobnym łączem punkt-punkt RoCEv2: skrypty uruchamiają dwa interfejsy ConnectX-8 z MTU 9,000 bajtów, przydzielają każdej szynie prywatny adres /24 i stosują ustawienia środowiska uruchomieniowego RoCE i GPUDirect.
Następnie przebieg walidacyjny potwierdza, że oba łącza trenowane są z prędkością 400 Gb/s, że pakiety jumbo ping przekraczają każdą szynę oraz że dwa urządzenia RDMA, mlx5_0 i mlx5_1, zgłaszają aktywność. Uruchomienie ib_write_bw na każdej szynie dowodzi, że sieć przesyła ruch RDMA, a nie tylko pakiety ping. Następnie NCCL jest kierowany na obie szyny z poleceniem NCCL_IB_HCA=mlx5_0,mlx5_1, a zadanie uruchamia się jak każde inne uruchomienie dwuwęzłowe. Poniższe wyniki pochodzą z tej sekwencji.
Pierwsza tabela pochodzi z nccl-tests, kolektywy rozproszonego wnioskowania lub zadań szkoleniowych, uruchamiane na dwóch procesorach B300 z obiema szynami w użyciu. Przy jednym procesorze graficznym na stację, każdy kolektyw sprowadza się do dwóch procesorów graficznych wymieniających dane przez parę łączy 400G, więc kolumna przepustowości magistrali jest bezpośrednio odczytywana z przepustowości 100 GB/s (800 Gb/s) zapewnianej przez oba kable. Wartość szczytowa to najlepszy wynik dla wszystkich rozmiarów wiadomości; kolumna 16 GiB to największa testowana wiadomość, dla której przepustowość się ustabilizowała.
| Działanie | Rozmiar szczytu | Maksymalna przepustowość magistrali | Przepustowość magistrali 16 GiB |
|---|---|---|---|
| Obniżka całości | 1 GiB | 92.242 Gb / s | 91.346 Gb / s |
| Zbiórka wszystkich | 16 GiB | 87.893 Gb / s | 87.893 Gb / s |
| Zmniejsz-rozproszenie | 2 GiB | 93.930 Gb / s | 92.905 Gb / s |
| Nadawanie | 16 GiB | 97.975 Gb / s | 97.975 Gb / s |
| Zredukować | 16 GiB | 97.978 Gb / s | 97.978 Gb / s |
| Wszyscy dla wszystkich | 8 GiB | 80.522 Gb / s | 80.512 Gb / s |
| Wysyłanie/odbieranie, jednokierunkowe | 16 GiB | 97.953 Gb / s | 97.953 Gb / s |
| Wysyłanie/odbieranie, dwukierunkowe | 16 GiB | 83.748 GB/s w każdym kierunku | 167.496 GB/s łącznie |
Transmisja, redukcja i jednokierunkowe wysyłanie/odbieranie osiągnęły 98 GB/s, czyli 98% tego, co mogą przenieść dwa kable. Wzorce z danymi przesyłanymi jednocześnie w obu kierunkach wyniosły mniej: 92 GB/s dla redukowania całościowego i 80 GB/s dla transmisji całościowej. Punktem odniesienia dla tych wyników jest wynik dwukierunkowego wysyłania/odbierania: przy jednoczesnej transmisji obu GPU, w każdym kierunku ustabilizowała się prędkość na poziomie 84 GB/s, co daje łącznie 167 GB/s w całym łączu.
Druga tabela schodzi poniżej NCCL do surowej ścieżki RDMA, używając ib_write_bw po jednej szynie na raz. Wiersze GPUDirect zapisują transfery 1 MiB z pamięci HBM jednej z płyt B300 do drugiej, a karta sieciowa odczytuje i zapisuje pamięć GPU bezpośrednio; obie szyny osiągają 392 Gb/s, czyli 98% przepustowości linii. Wiersze host-pamięć to podstawowy test porównawczy, pojedyncza para kolejek pobierająca dane z pamięci Grace, którą podręcznik NVIDII szacuje na 220–230 Gb/s na szynie 400 Gb/s; my zanotowaliśmy 228 Gb/s. Wiersz opóźnienia to zapis 8 bajtów: średnio 1.46 µs.
| Testowanie | Przepustowość | Wykorzystanie łącza |
|---|---|---|
| GPUDirect RDMA, pamięć GPU, ib_write_bw, transfery 1 MiB | ||
| Szyna 0 | 392.15 Gb / s | 98.04% |
| Szyna 1 | 392.15 Gb / s | 98.04% |
| RDMA pamięci hosta, obie szyny | ||
| Zapis RDMA, jednokierunkowy | 228.15 Gb / s | |
| Odczyt RDMA, jednokierunkowy | 228.23 Gb / s | |
| Wysyłanie RDMA, jednokierunkowe | 228.16 Gb / s | |
| Zapis RDMA, dwukierunkowy | Łącznie 447.10 Gb/s | |
| Opóźnienie zapisu RDMA, 8 bajtów | 1.46 µs średnio; 1.63 i 1.66 µs 99. percentyl dla kolei | |
Jak testowaliśmy klaster
Czas poświęcony na tę parę był ograniczony, dlatego skupiliśmy się na wnioskowaniu, najpopularniejszym obecnie zadaniu AI. Planujemy rozszerzyć te prace na większe klastry. W tym artykule skupiliśmy się na większych modelach i porównaliśmy pojedynczą stację z dwiema stacjami, wykorzystując paralelizm tensorowy (TP) oraz dezagregację metodą wstępnego wypełniania i dekodowania (PD).
Paralelizm tensorowy dzieli tensory wag i obliczenia w modelu na wiele procesorów GPU. W naszej konfiguracji dwustanowiskowej, czyli TP2, każdy B300 przechowuje część modelu i oba pracują nad każdym żądaniem. Daje nam to więcej pamięci o wysokiej przepustowości (HBM), w której możemy umieścić wagi, a także więcej mocy obliczeniowej do ich uruchomienia. Wymaga to również od procesorów GPU wymiany wyników pośrednich i synchronizacji za pośrednictwem NCCL w trakcie wnioskowania, więc narzut komunikacyjny staje się częścią kosztu uruchomienia modelu.
Wnioskowanie rozproszone przypisuje etapy prefill i decode żądania do oddzielnych procesów roboczych. Prefill przetwarza monit wejściowy i buduje pamięć podręczną klucz/wartość (KV), stan uwagi, który model wykorzystuje ponownie podczas generowania. Decode następnie wykorzystuje ten stan do generowania tokenów wyjściowych, po jednym na raz. Te dwa etapy mają różne wymagania dotyczące przetwarzania: prefill jest obciążający obliczeniowo, podczas gdy decode wymaga dużej przepustowości pamięci. W większych konfiguracjach, takie dezagregowane wnioskowanie pozwala operatorowi na niezależne skalowanie tych procesów roboczych w zależności od zapotrzebowania, co pokazał nasz artykuł na temat odciążania pamięci podręcznej KV.
W konfiguracji jednowęzłowej, gdy obie fazy współdzielą jednego pracownika, vLLM może przeplatać wstępne wypełnianie przychodzących monitów z dekodowaniem żądań, które są już w toku. To przetwarzanie monitów może wydłużyć czas między tokenami wyjściowymi. W naszej konfiguracji PD jedna stacja obsługuje wstępne wypełnianie i przesyła pamięć podręczną KV żądania do drugiej stacji, która obsługuje dekodowanie. Każdy pracownik ma dostęp do własnej kopii modelu, w tym do wszelkich danych umieszczonych w pamięci Grace. Pracownik dekodujący nie musi już planować nowego przetwarzania monitów wraz z generowaniem tokenów, co przyspiesza przepustowość wnioskowania.
W naszych testach wymagania pamięciowe modelu zadecydowały o wyborze metody. W przypadku największych punktów kontrolnych, gdzie pojedyncza stacja musiała przenieść znaczną część wag modelu do pamięci Grace, TP zapewniło nam najlepszą wydajność. Rozłożenie wag na dwa procesory graficzne pozwoliło na pozostawienie większej części modelu w pamięci HBM i zmniejszyło karę za odciążenie. W przypadku modeli, które w miarę dobrze mieściły się na jednej stacji, całkowicie w pamięci HBM lub z ograniczonym odciążeniem do pamięci Grace, zastosowaliśmy dezagregację PD. Dotyczyło to pamięci Flash DeepSeek V4.1 z tablicami wyszukiwania Engram umieszczonymi w pamięci DRAM Grace.
Aby zachować porównywalność z naszym starszym systemem, zachowaliśmy naszą starą metodologię ze stałymi długościami sekwencji wejściowych (ISL) i wyjściowych (OSL). Obciążenie o jednakowym obciążeniu wykorzystuje 512 tokenów wejściowych i 512 tokenów wyjściowych, podczas gdy obciążenie z dużym obciążeniem wstępnym wykorzystuje 8,192 tokeny wejściowe i 1,024 tokeny wyjściowe. Zmieniamy liczbę równoczesnych żądań, utrzymując jednocześnie stałe długości sekwencji.
Punktem odniesienia dla pojedynczej stacji na każdym wykresie jest ASUS ET900N G3 z naszej recenzji, przepuszczony do 32 strumieni; przebiegi dwustacyjne mają wartość 256. Każdy punkt to pojedynczy przebieg, więc spadek na jednym poziomie współbieżności jest zgłaszany jako zebrany.
Konfiguracja wnioskowania
| Model | Tryb klastra | Oprogramowanie | Dekodowanie spekulatywne | Pamięć łaski |
|---|---|---|---|---|
| DeepSeek V4.1 Flash (FP8) | Wstępne wypełnianie/dekodowanie rozbicia, pełna kopia na stację | vllm/vllm-openai:deepseekv41-flash-0909 | Własny projektant modelu, stałe 5 tokenów | Dwie tabele FP8 Engram (188.84 GB) zamocowane w pamięci Grace oraz 131.97 GB przeniesionych wag eksperckich na każdej stacji |
| GLM-5.3 NVFP4 | Tensor równoległy (TP2) | Kontener NGC NVIDIA vLLM 26.08 (vLLM 0.27.1) | MTP, stały draft 5-tokenowy | Brak w klastrze; 215 GB danych eksperckich przeniesionych na jedną stację |
| Karta pamięci GLM-5.3 Flash NVFP4 | Rozdzielenie wstępnego wypełniania/dekodowania, wstępne wypełnianie ASUS, dekodowanie HP | vLLM 0.28.1 RC1 | MTP, stały draft 5-tokenowy | żaden |
| GLM-5.2 NVFP4 | Tensor równoległy (TP2) | Kontener NGC NVIDIA vLLM 26.08 (vLLM 0.27.1) | MTP, stały draft 3-tokenowy | Brak w klastrze; około 215 GB danych eksperckich przeniesionych na jedną stację |
| MiniMax-M3 NVFP4 | Tensor równoległy (TP2) | Kontener NGC NVIDIA vLLM 26.08 (vLLM 0.27.1) | EAGLE3, stały draft 3-tokenowy | Brak w klastrze; część ekspertów przeniesiona na jedną stację |
Wydajność wnioskowania
Flash DeepSeek V4.1
Pamięć Flash DeepSeek V4.1 działała w trybie rozproszonym, jedna stacja obsługiwała wstępne wypełnianie, a druga dekodowanie. Każda stacja zawierała pełną kopię modelu: dwie tabele Engram FP8 o łącznej pojemności 188.84 GB, przypięte do pamięci Grace oraz kolejne 131.97 GB danych eksperckich przeniesionych do pamięci Grace. To czyni ją jedyną konfiguracją w zestawie z pamięcią Grace włączoną na obu komputerach. Jest to również jedyny model w tej serii bez linii pojedynczej stacji, ponieważ test ASUS-a uruchomił wcześniejszy punkt kontrolny pamięci Flash V4, a te dwa modele nie są bezpośrednio porównywalne.
W klastrze dwustanowiskowym, natywny model FP8 osiągnął przepustowość od 441 tokenów wyjściowych na sekundę przy jednym strumieniu do 3,328 przy 32, 5,141 przy 128 i 5,248 przy 256, co stanowi najwyższą przepustowość wyjściową spośród wszystkich modeli w tym zestawie, a krzywa spłaszczała się dopiero w górnej części wykresu. Dla porównania, pojedyncza stacja ASUS obsługiwała pamięć Flash V4 z prędkością 1,766 tokenów wyjściowych na sekundę przy 32 strumieniach w naszej recenzji.
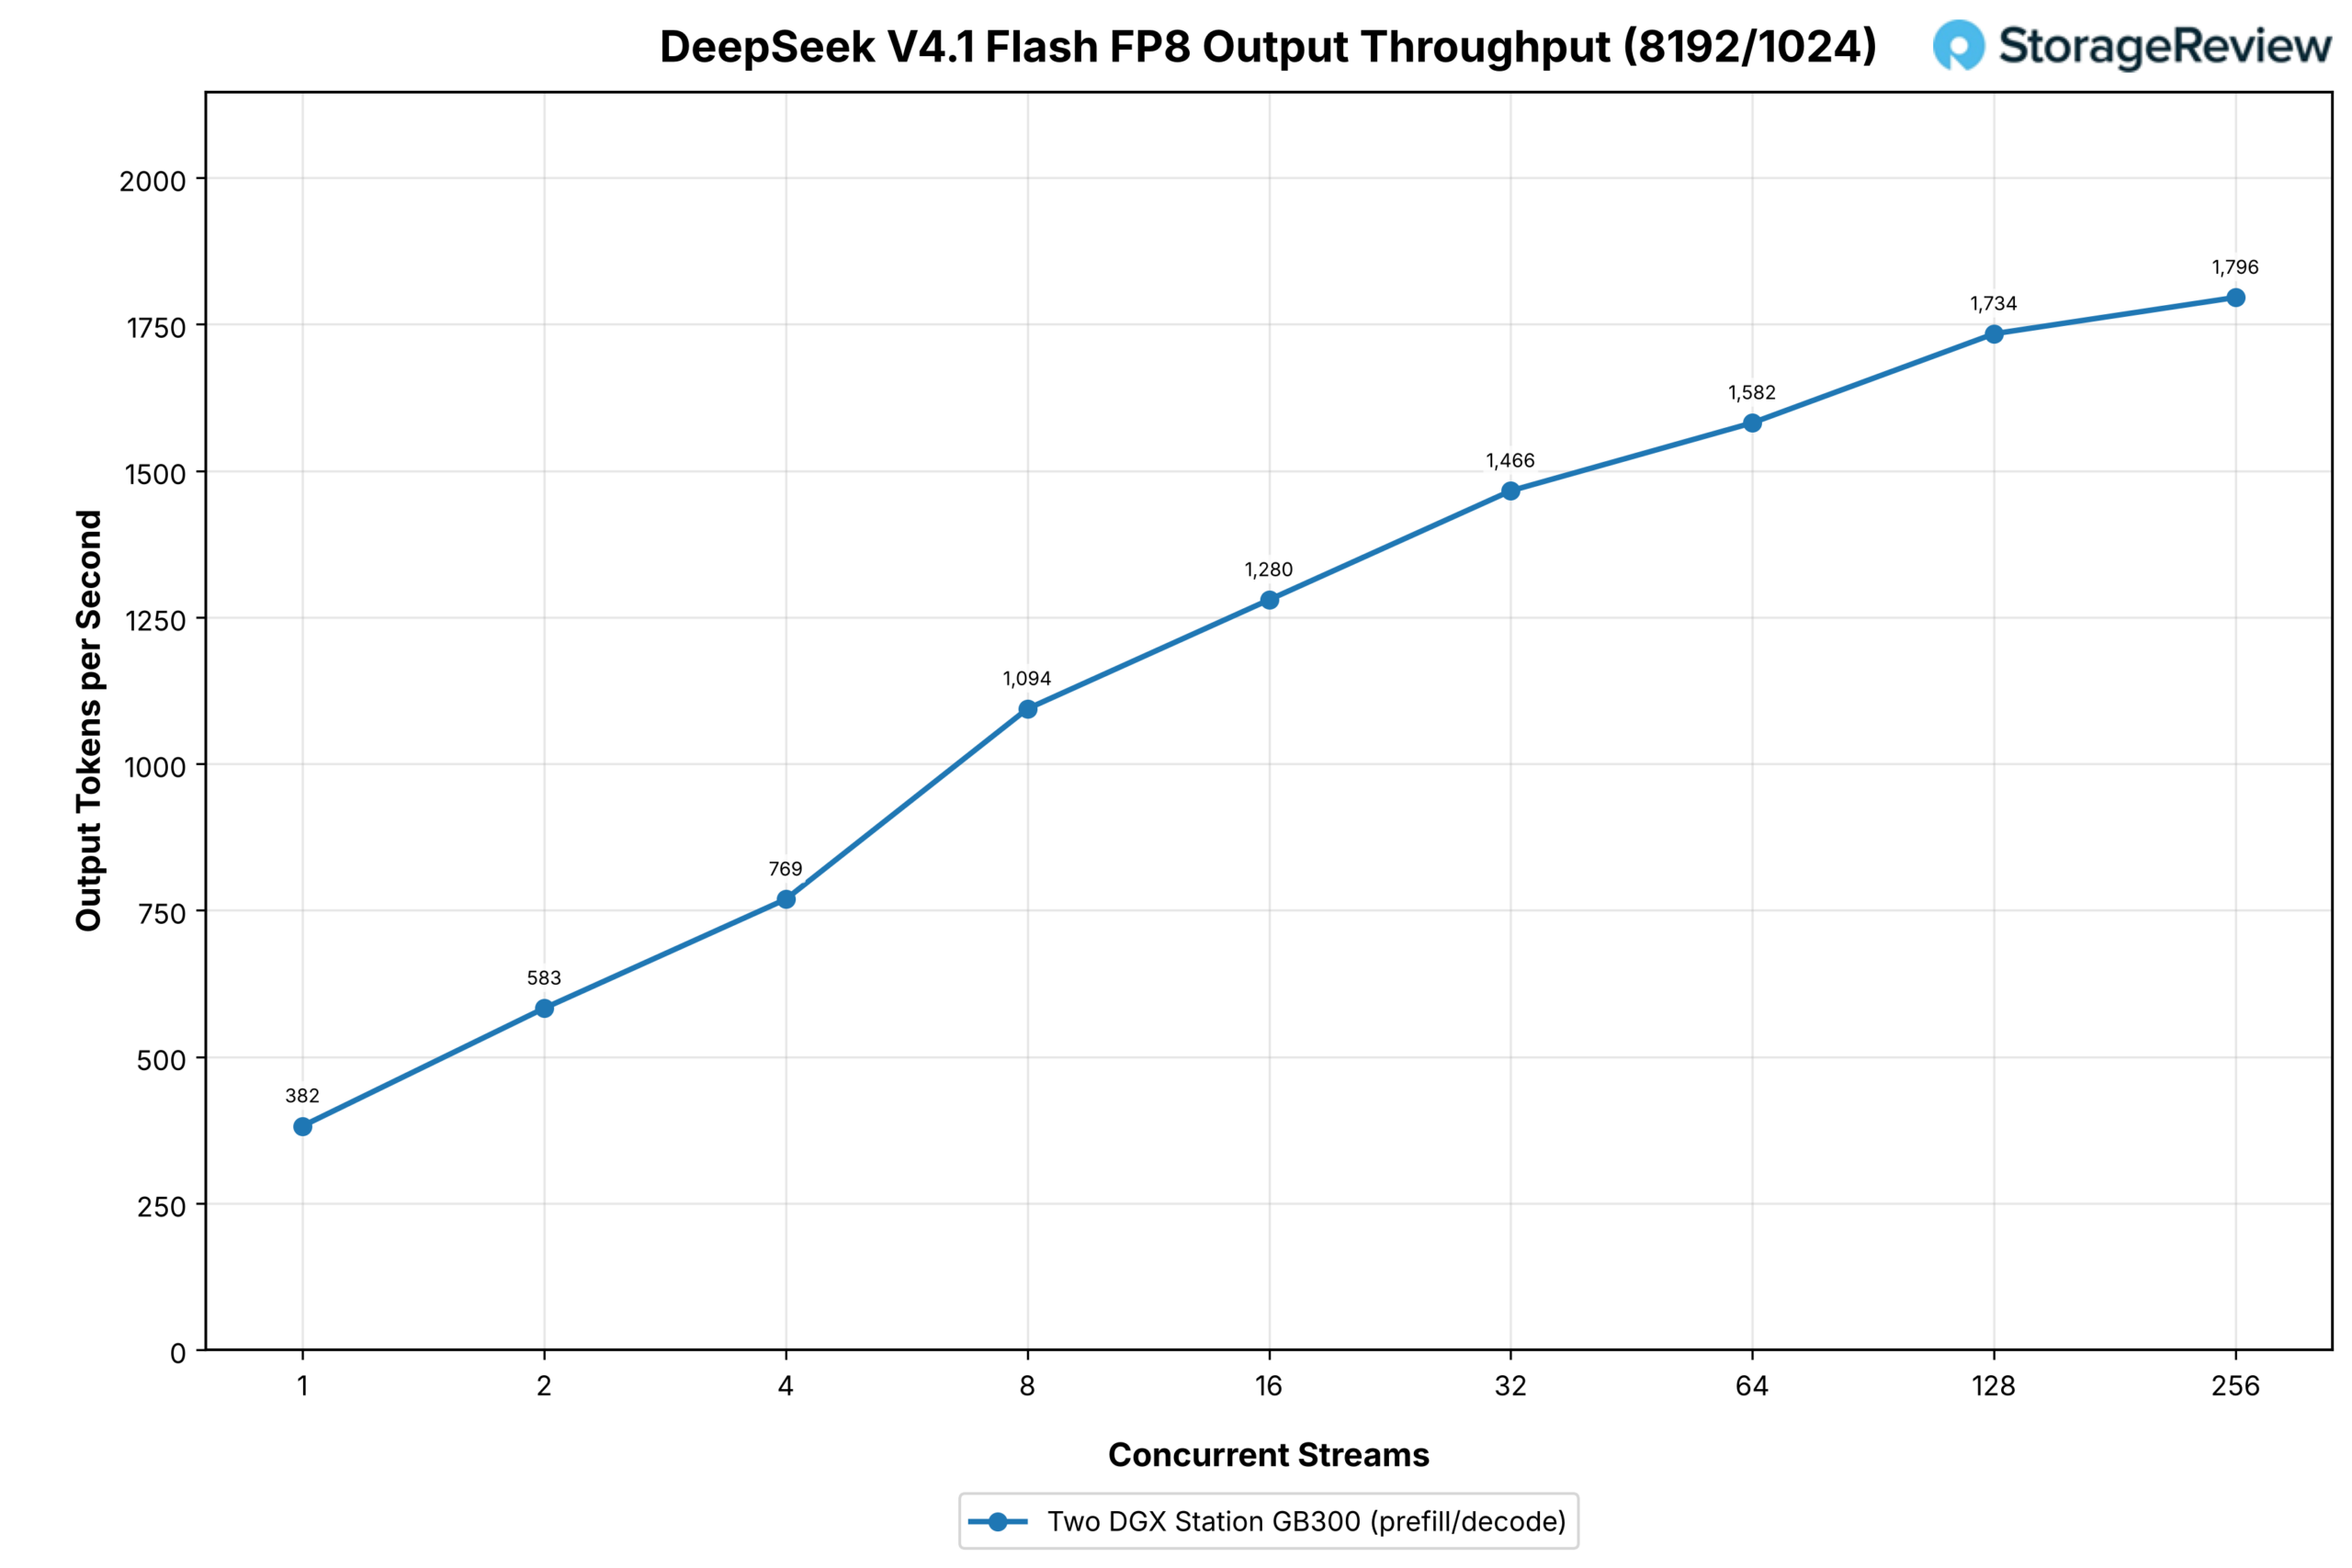
W profilu z dużym obciążeniem wstępnym, klaster działał z 382 tokenów wyjściowych na sekundę dla jednego strumienia do 1,466 dla 32 i 1,796 dla 256, a ponieważ każde żądanie niesie 8,192 tokeny wejściowe, całkowita przepustowość osiągnęła 16 163 tokeny na sekundę na szczycie cyklu. Dzięki tabelom Engram i 131.97 GB wag eksperckich umieszczonych w pamięci Grace na każdej stacji, krzywe pozostają płynne w całym cyklu.
GLM-5.3
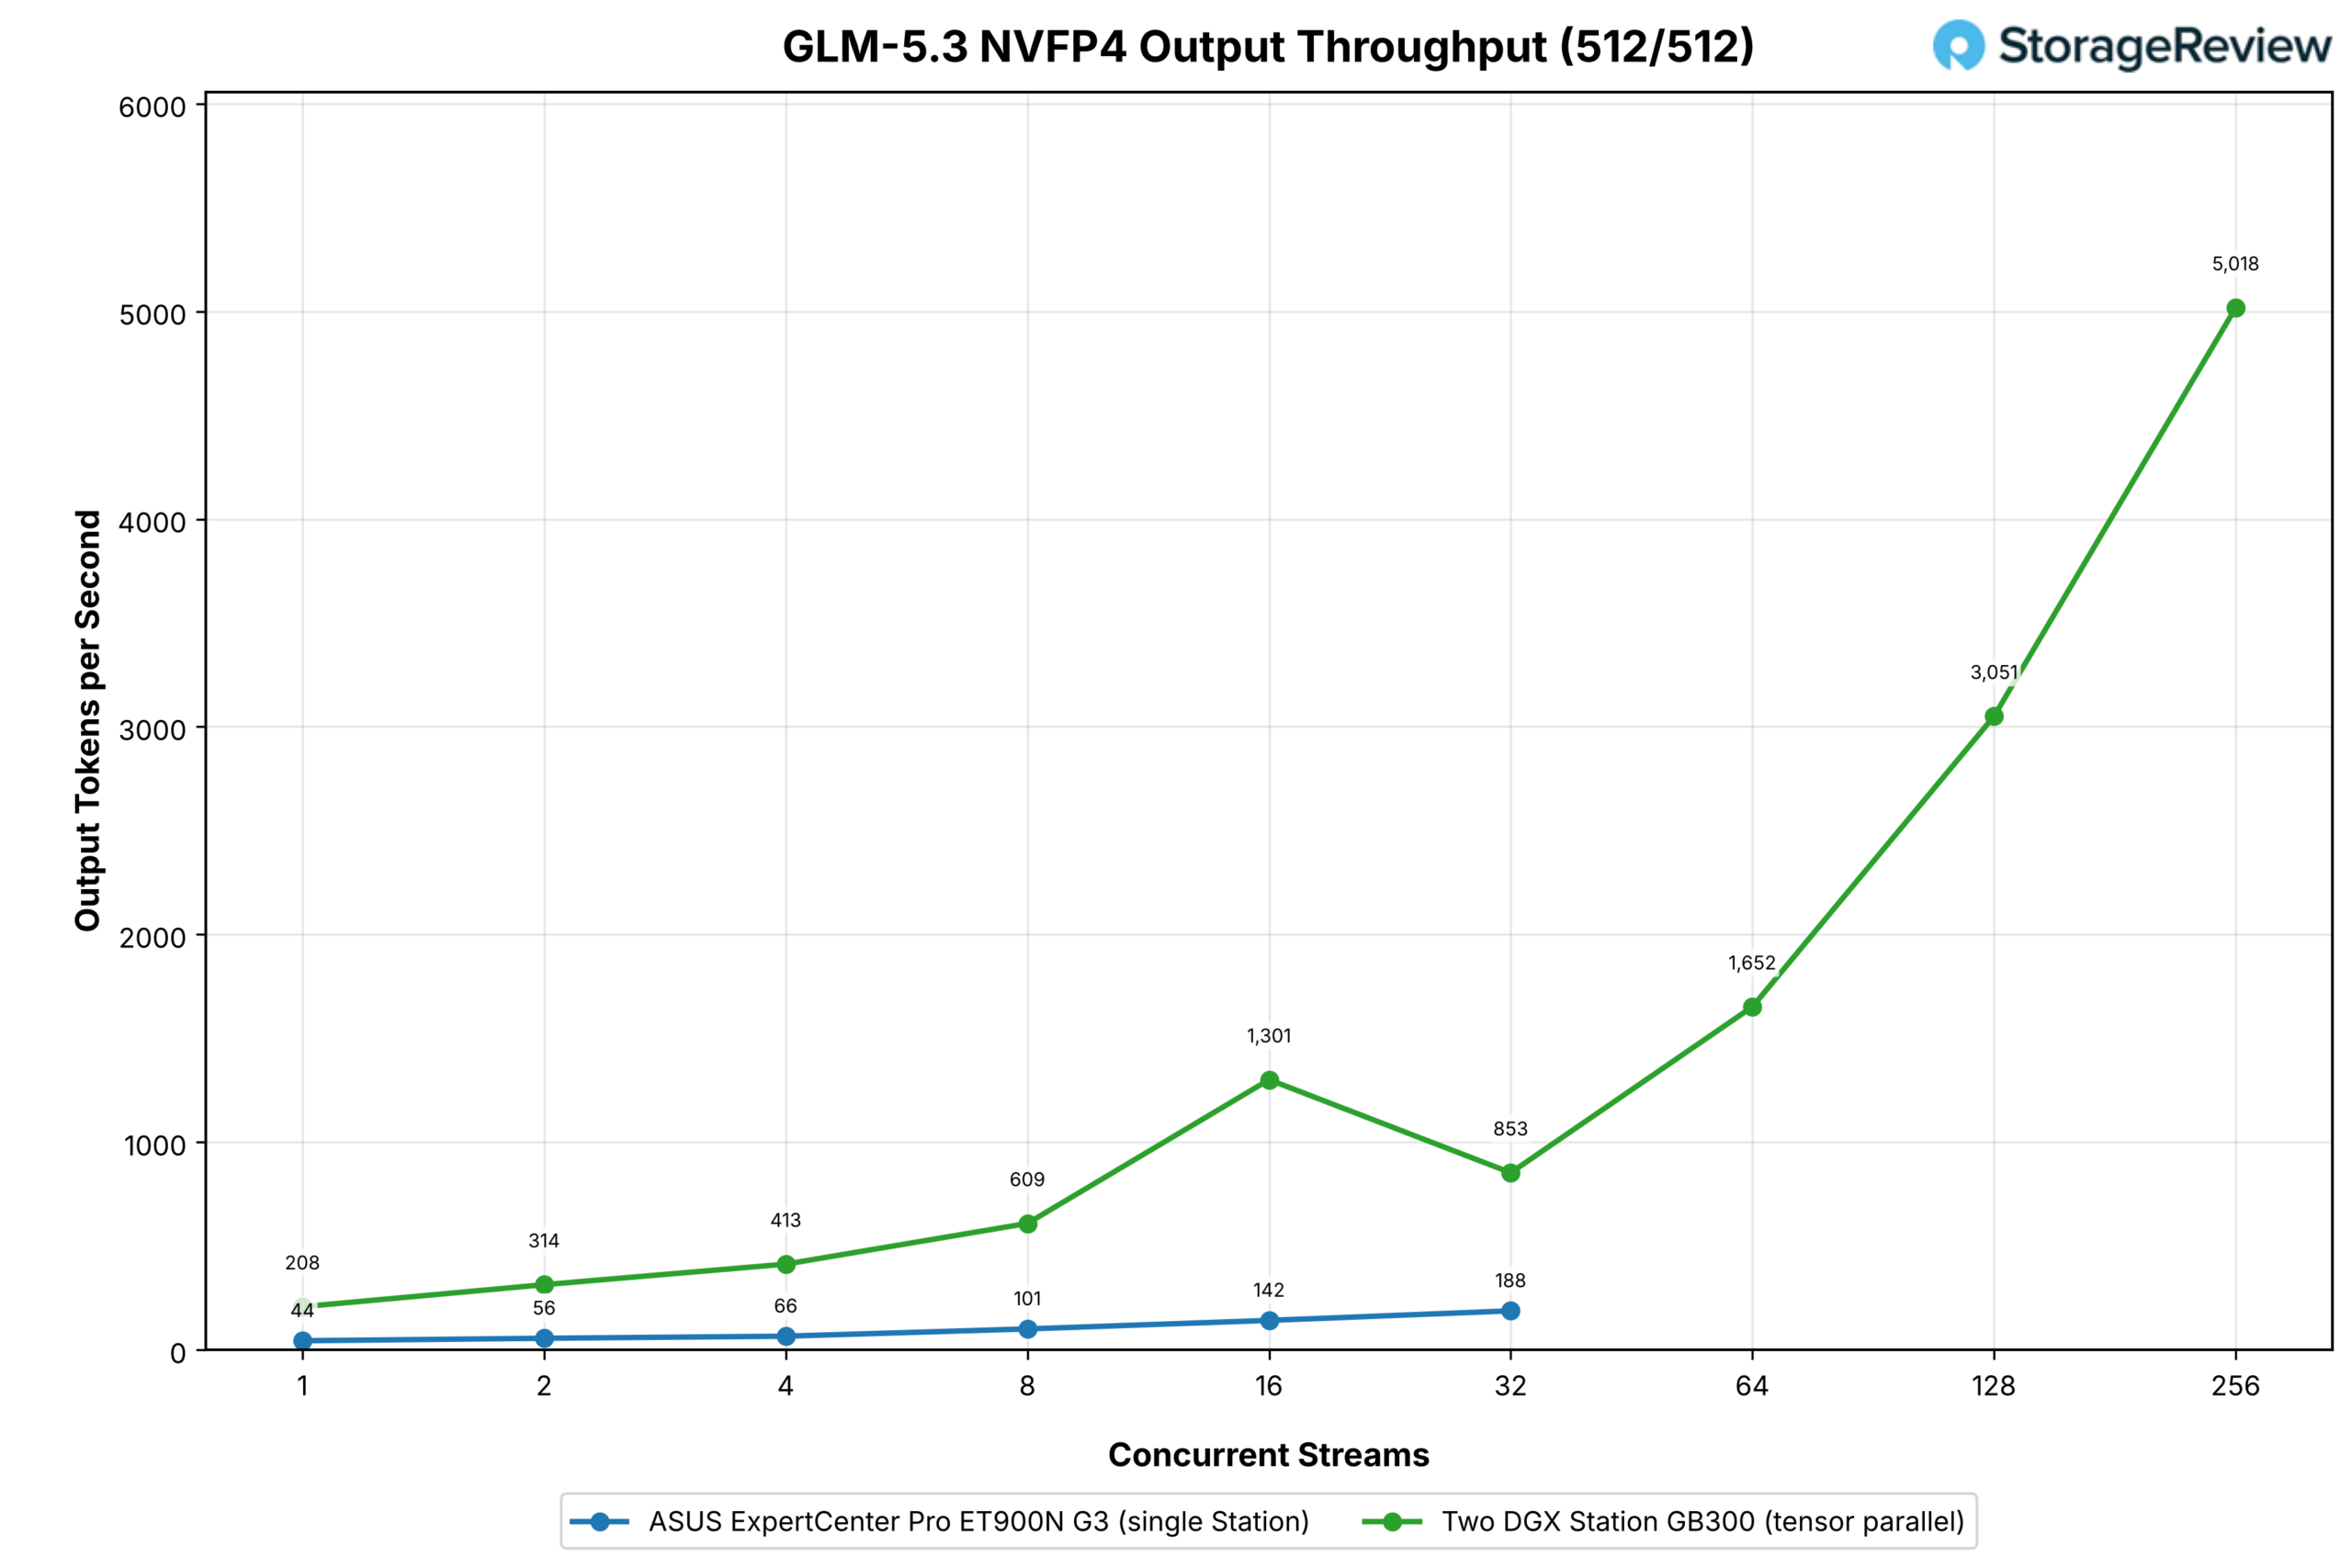
GLM-5.3 działał w TP2 bez odciążania Grace. Na pojedynczej stacji odciąża 215 GB wag eksperckich do pamięci Grace, a wynik klastra jest zgodny z GLM-5.2 przez większość cyklu, zanim stanie się nierównomierny. Jedna stacja działała z prędkością od 44 tokenów wyjściowych na sekundę przy jednym strumieniu do 188 przy 32 przy tym samym obciążeniu.
Klaster dwustacyjny działał od 208 przy jednym strumieniu do 1,301 przy 16, pomiędzy 4.7x a 9.2x w porównaniu z pojedynczą wieżą, spadł do 853 przy 32, a następnie wznowił wzrost do 1,652 przy 64, 3,051 przy 128 i 5,018 przy 256. Punkt 32 strumieni znajduje się w zebranych danych; decyzje dotyczące przetwarzania wsadowego i wyboru jądra zmieniają się wraz ze wzrostem współbieżności, a wdrożenie tensorowo-równoległe dodaje zbiorowość na każdej warstwie, która musi zostać ukończona przed następnym krokiem, więc krzywa nie jest linią prostą, ale pułap przy 256 strumieniach jest 27x większy niż ten, który osiągnęła jedna stacja przy 32.
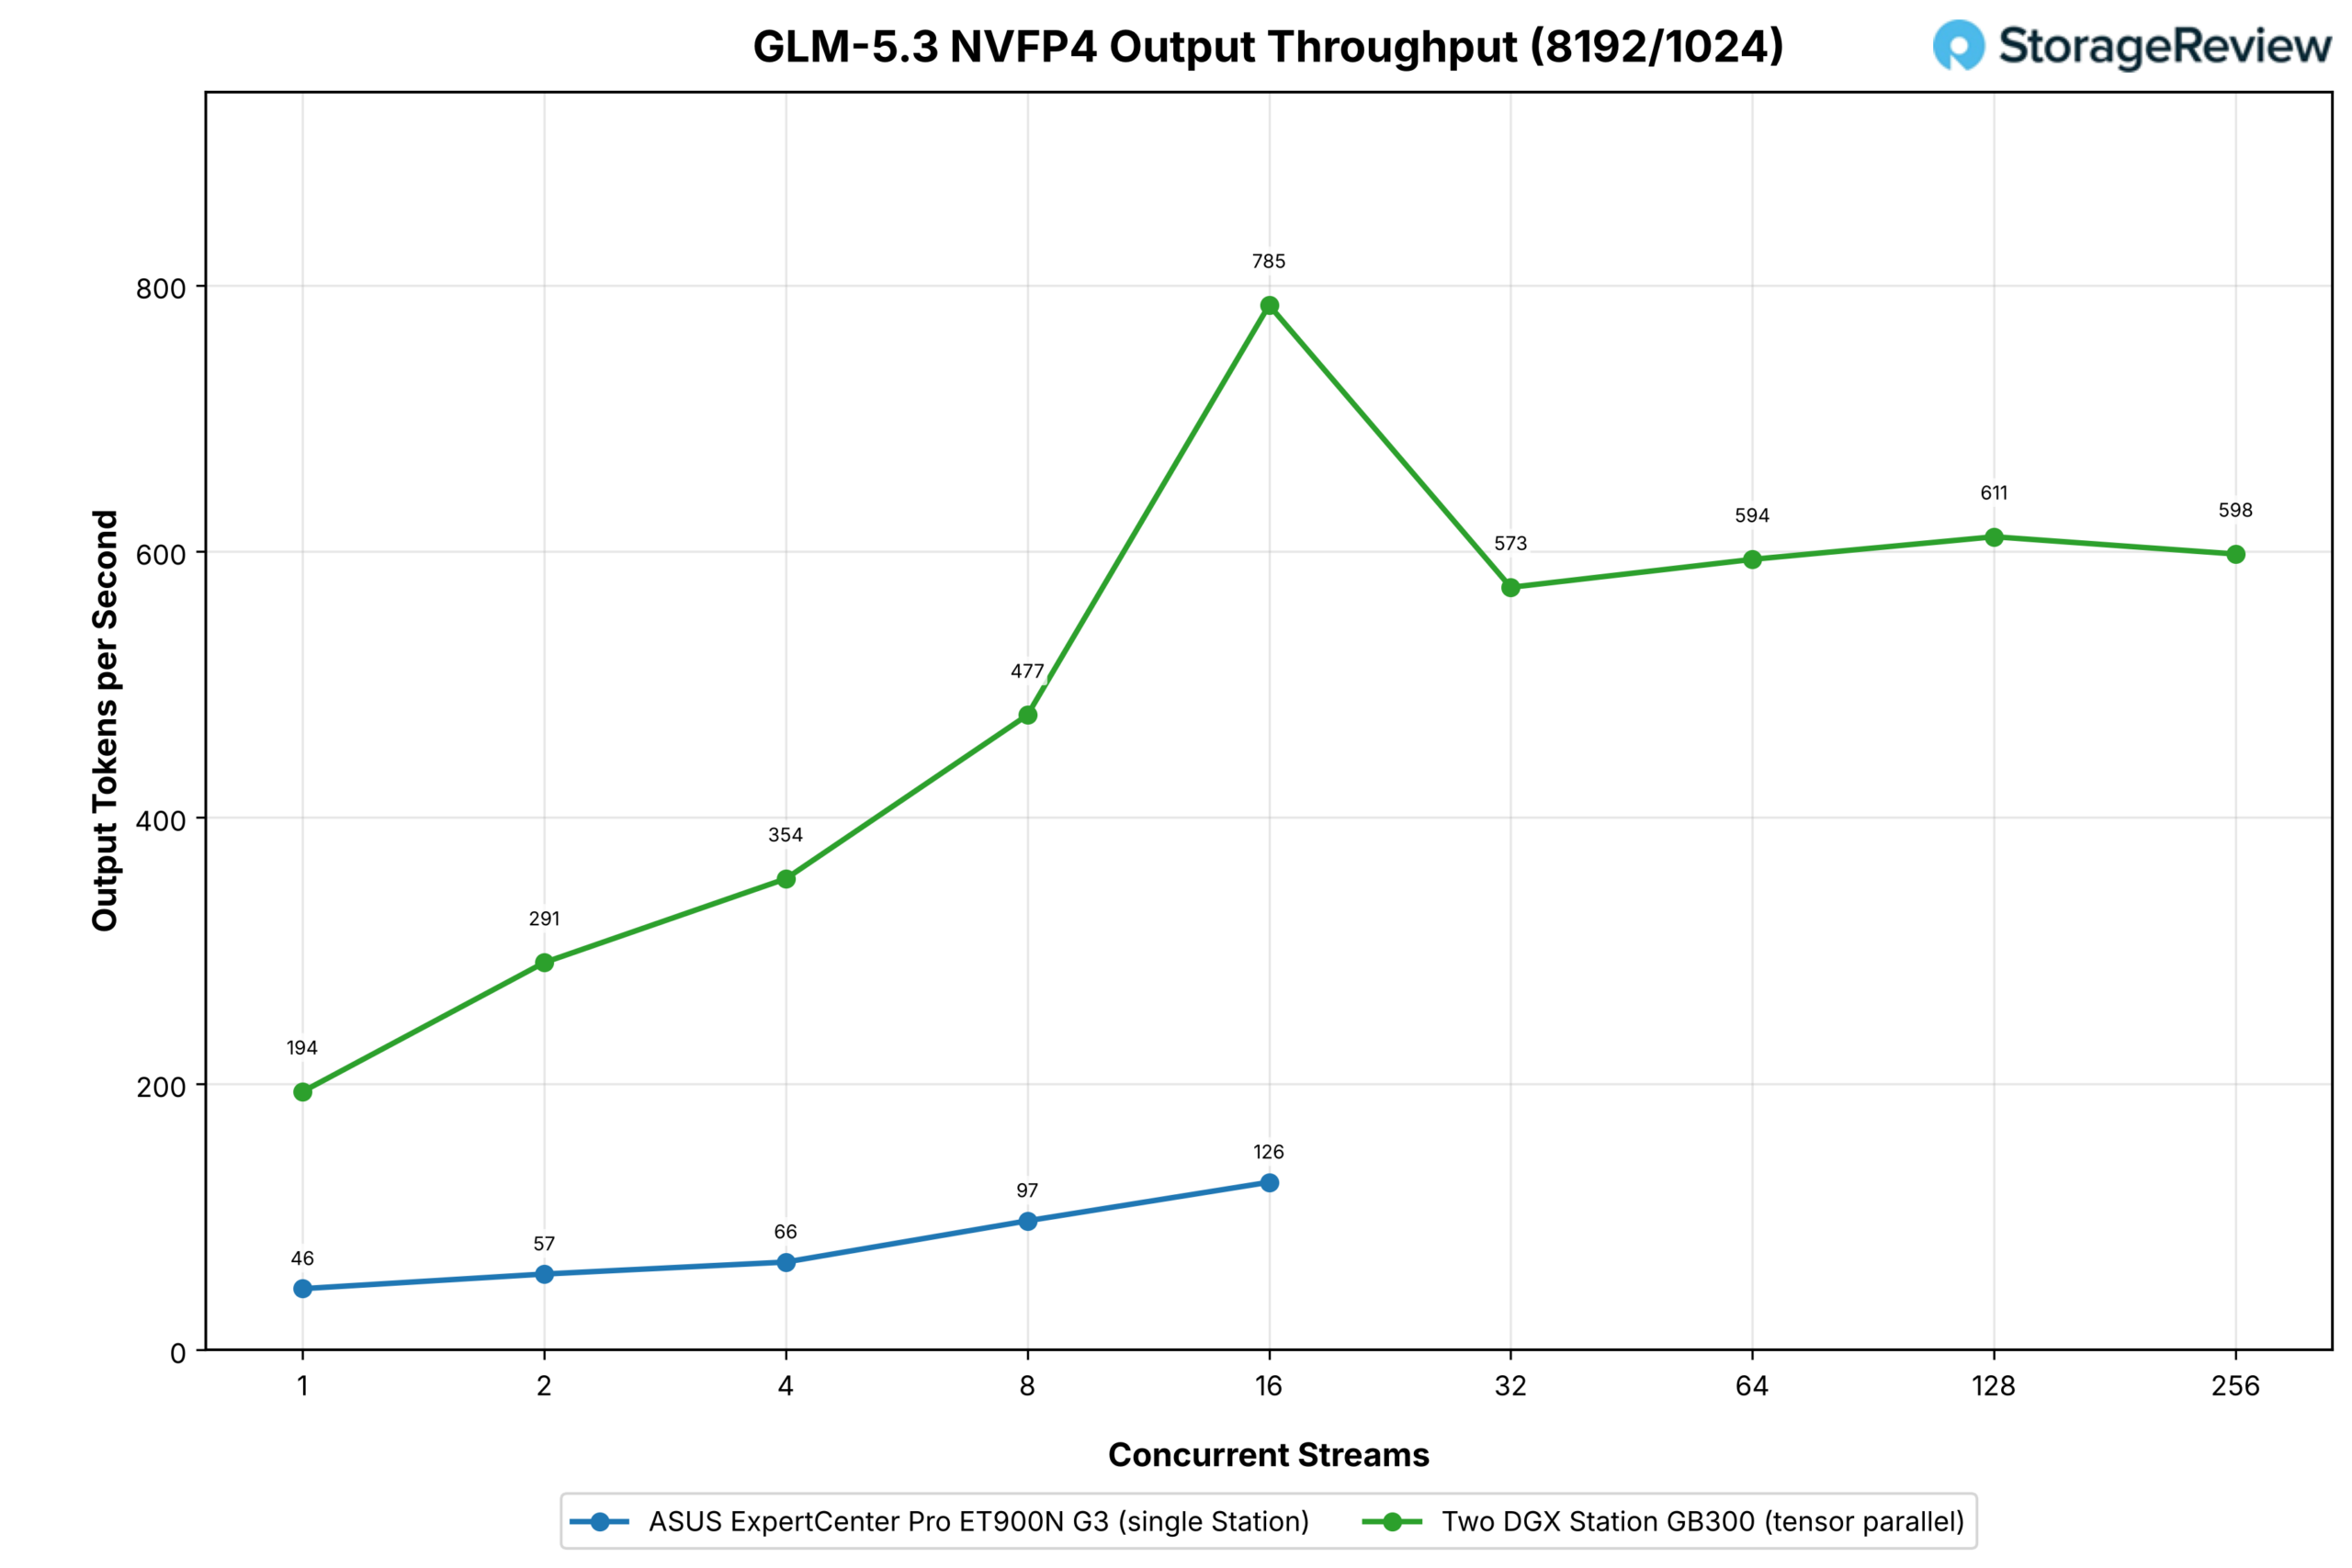
W profilu z dużym udziałem prefillu, pojedyncza stacja zatrzymała się na 16 strumieniach, co było celowe: model odciążony szybko się spłaszcza, a dalsze zwiększanie współbieżności niewiele daje. Wzrosła z 46 tokenów wyjściowych na sekundę dla jednego strumienia do 126 dla 16. Klaster wzrósł ze 194 do 785 w tym samym zakresie, 6.2x na szczycie, a następnie ustabilizował się między 573 a 611 od 32 strumieni do 256, co stanowi pułap dla długich komunikatów w pobliżu 600 tokenów wyjściowych na sekundę, co nadal jest około pięciokrotnie więcej niż najlepszy wynik pojedynczej stacji.
Lampa błyskowa GLM-5.3
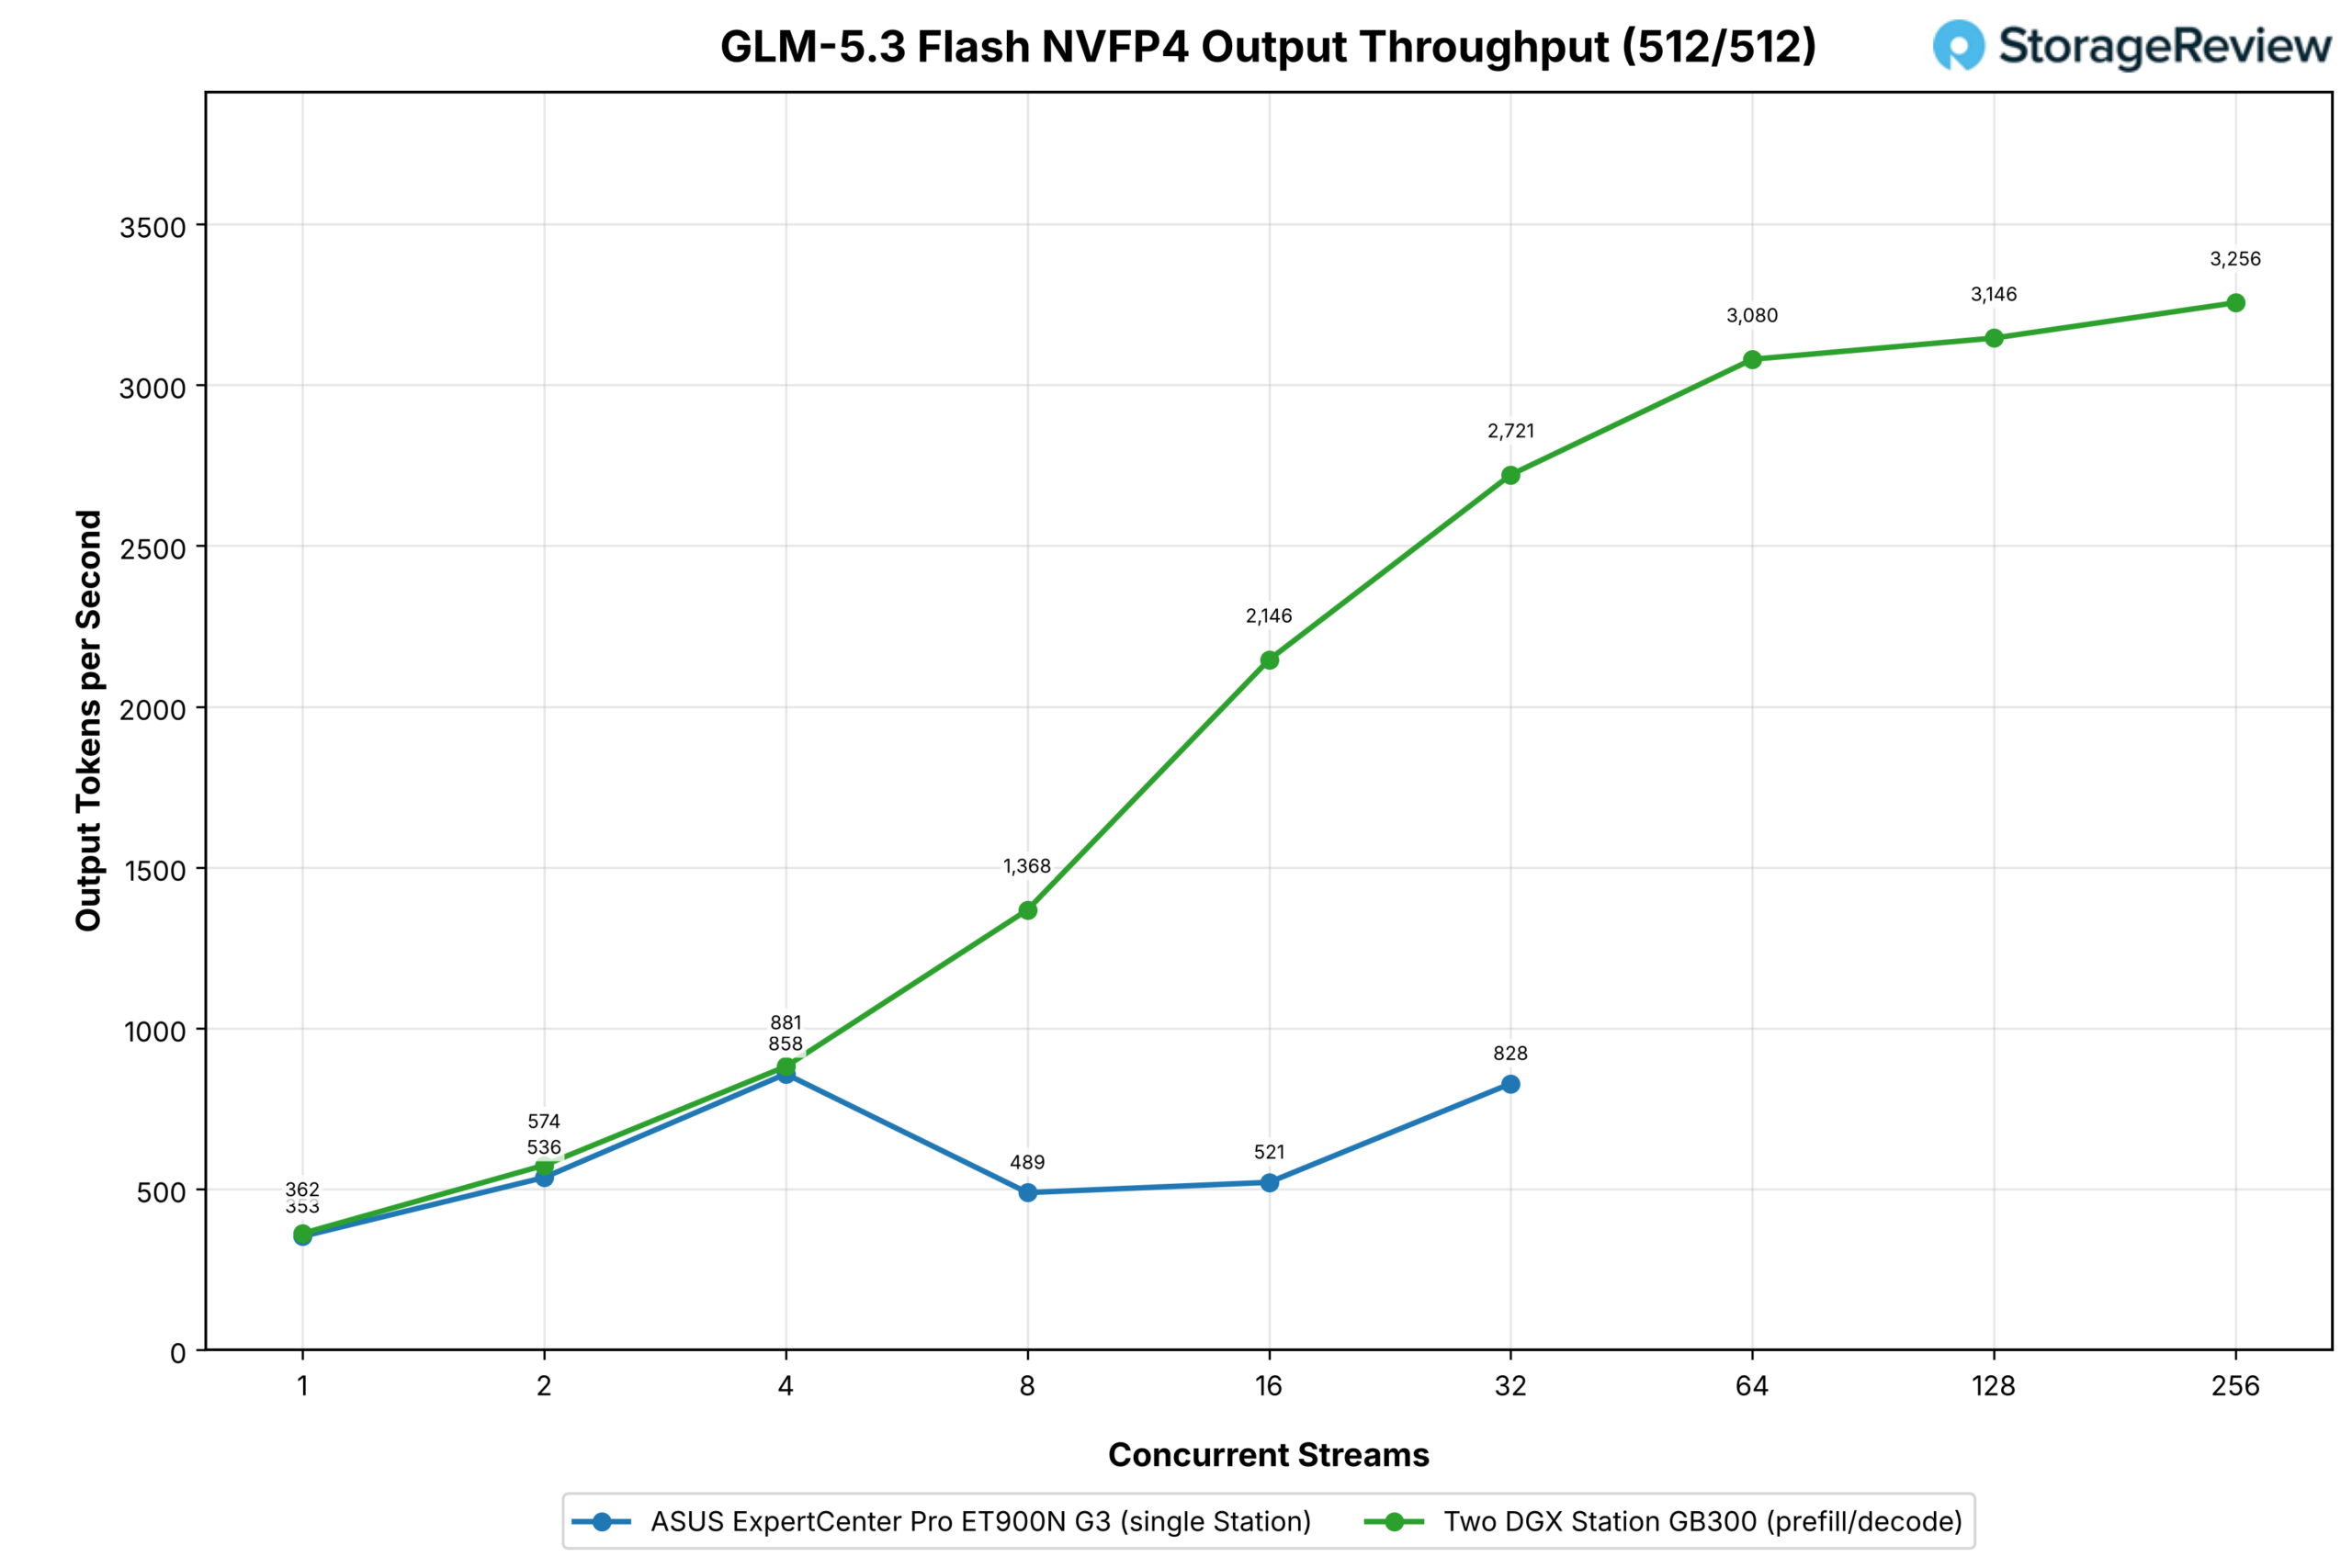
Pamięć flash GLM-5.3 jest na tyle mała, że każda stacja może pomieścić pełną kopię, dlatego działała w trybie rozproszonym, z obsługą wstępnego wypełniania przez ASUS i obsługą dekodowania przez HP. Pamięć flash ma niewielką liczbę aktywnych parametrów, więc na jednej stacji działa już szybko: 353 tokeny wyjściowe na sekundę przy jednym strumieniu i 828 przy 32 przy takim samym obciążeniu, z nierówną wartością pośrodku (858 przy czterech strumieniach, 489 przy ośmiu), którą raportujemy jako zebraną.
W przypadku rozdzielonej pary równe obciążenie wynosiło od 362 tokenów wyjściowych na sekundę przy jednym strumieniu do 2,721 przy 32, czyli 3.3-krotnie więcej niż przy pojedynczej wieży, a następnie 3,256 przy 256 strumieniach.
W przypadku jednego i dwóch strumieni para dopasowuje się niemal dokładnie do pojedynczej stacji, czego można się spodziewać, gdy stacja dekodująca wykonuje tę samą pracę samodzielnie; zysk pojawia się, gdy w locie jest wystarczająco dużo żądań, aby stacja wstępnego wypełniania mogła pozostać zajęta, a stacja dekodująca nie musiała nigdy przerywać wstępnego wypełniania.
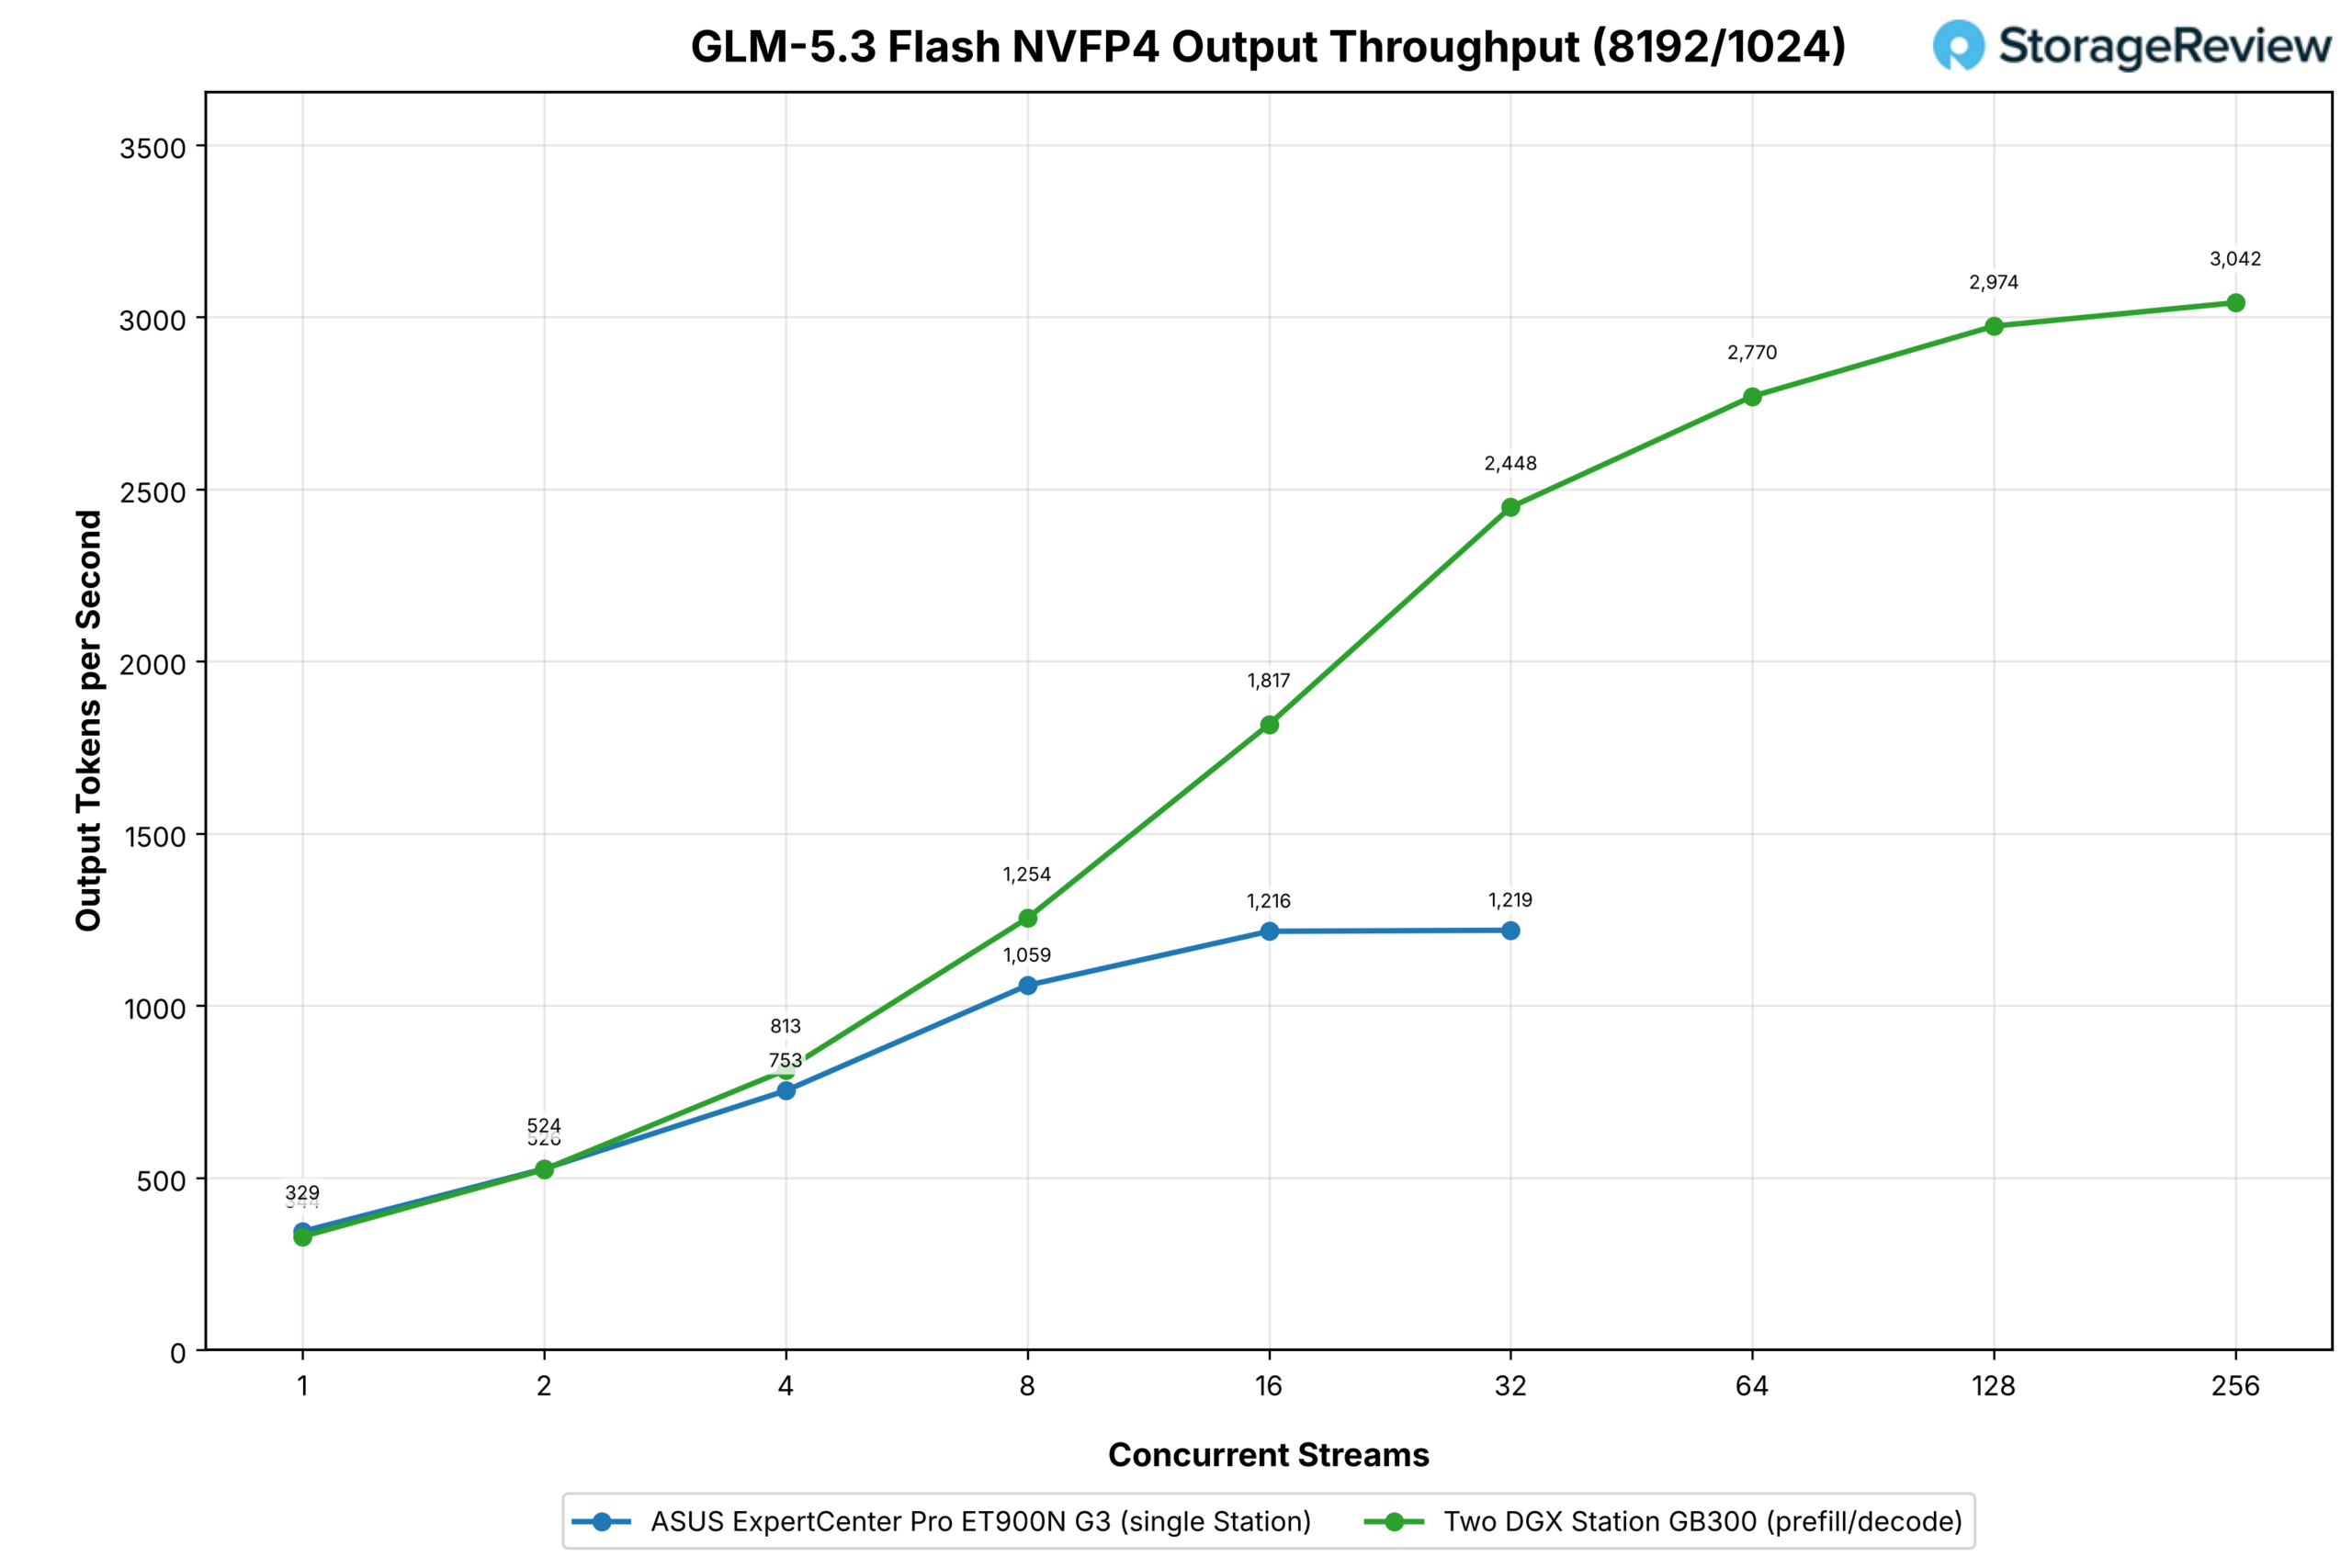
W profilu z dużym udziałem prefillu, pojedyncza stacja wzrosła z 344 tokenów wyjściowych na sekundę dla jednego strumienia do 1,216 dla 16 i utrzymała się na poziomie 1,219 dla 32, pozostając na tym samym poziomie od 16 strumieni. Para prefill/decode nadal rosła, z 329 dla jednego strumienia do 2,448 dla 32, dwukrotnie więcej niż pojedyncza stacja, na której się ustabilizowała, i do 3,042 dla 256. Długie monity to przypadek, dla którego ten podział został stworzony, ponieważ stacja prefillu absorbuje monity o długości 8,192 tokenów, podczas gdy pamięć podręczna KV i obliczenia stacji decode pozostają w trakcie generowania.
GLM-5.2
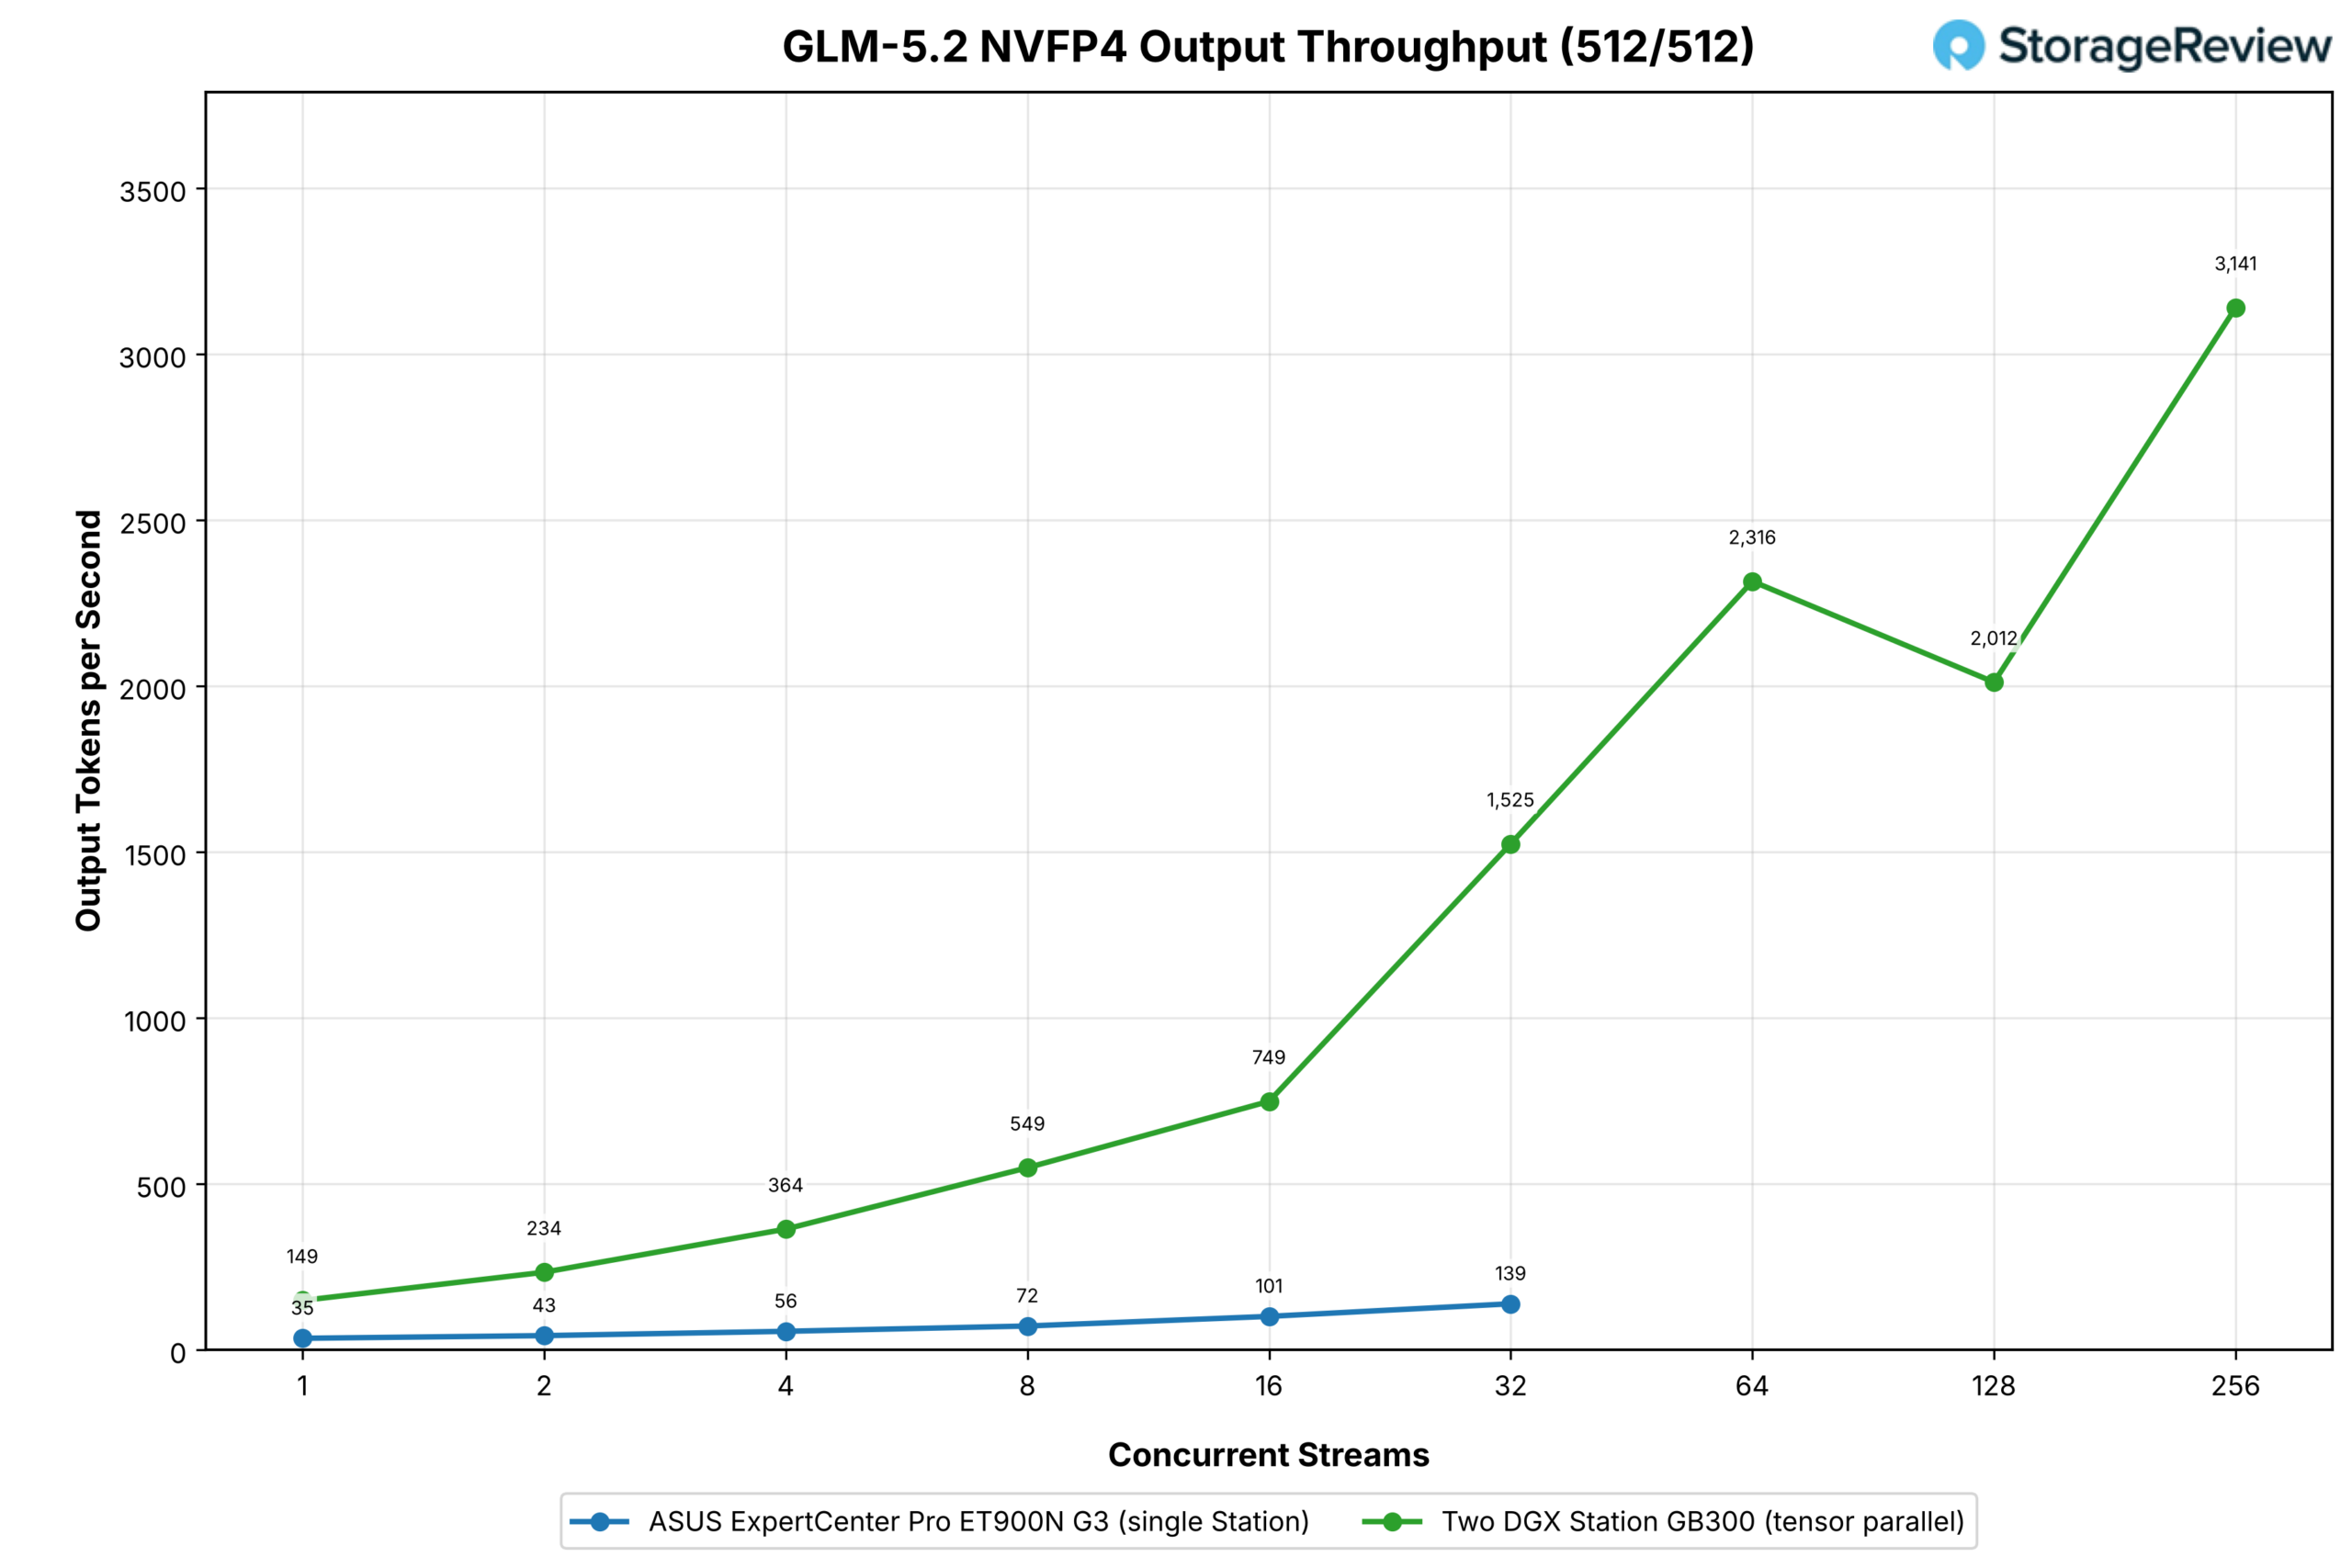
GLM-5.2 działał w TP2 bez odciążenia Grace w klastrze i to właśnie ten model najmocniej uzasadnia użycie drugiej stacji. Punkt kontrolny NVFP4 zajmuje około 433 GB, więc na jednym GB300 około 215 GB wag eksperckich znajduje się w pamięci Grace, a każdy krok dekodowania, który ich dotyczy, przechodzi z NVLink-C2C do LPDDR5X z prędkością 396 GB/s. Podzielony na dwie stacje, każdy B300 mieści około połowę modelu w HBM3e.
Przy takim samym obciążeniu pojedyncza wieża ET900N G3 dostarczyła 35 tokenów wyjściowych na sekundę w jednym strumieniu i 139 przy 32. Klaster dwustanowiskowy rozpoczął od 149 tokenów na sekundę w jednym strumieniu, czyli 4.3 razy więcej niż pojedyncza wieża, osiągnął 1,525 przy 32 strumieniach, czyli 11 razy więcej, i stale rósł, przewyższając zakres pojedynczej stacji do 2,316 przy 64 i 3,141 przy 256, ze spadkiem do 2,012 przy 128. Model, w którym jedna stacja obsługuje prędkość konwersacyjną dla garstki użytkowników, staje się modelem, w którym dwie stacje mogą obsługiwać dział.
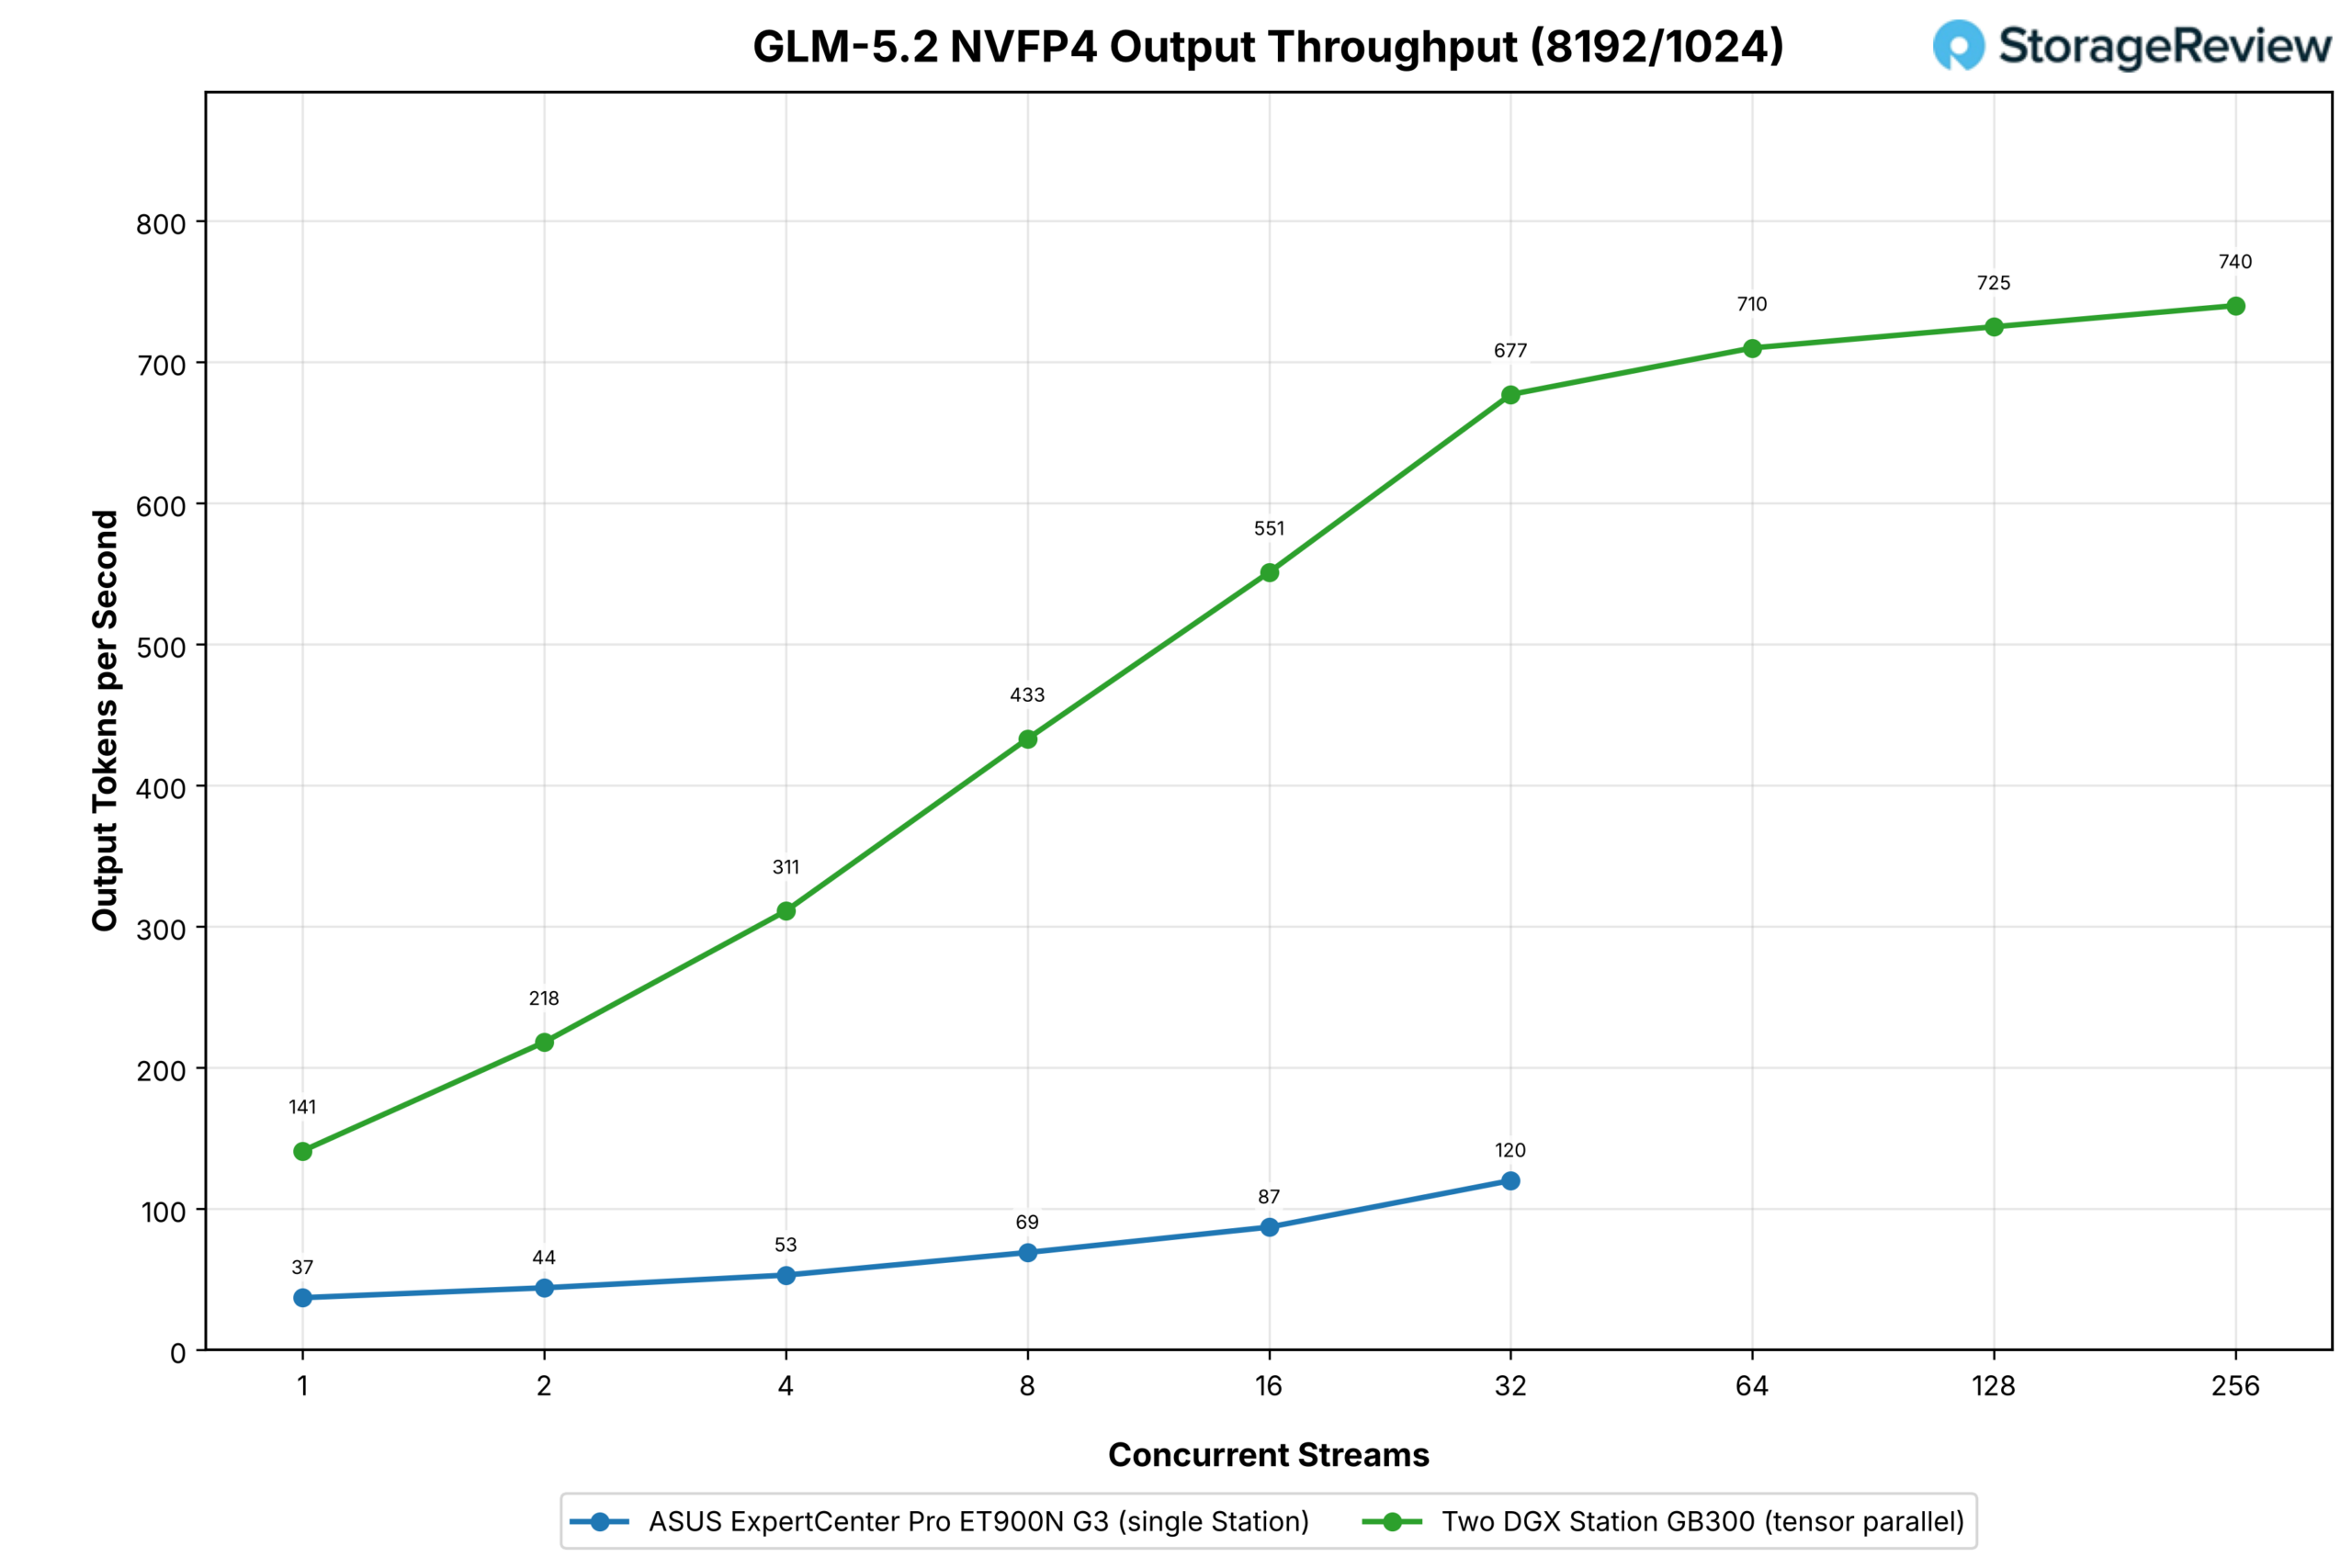
Profil z dużą liczbą wstępnie wypełnionych tokenów przedstawia tę samą historię na niższej wysokości, przy czym jedna stacja przesuwa się z 37 tokenów wyjściowych na sekundę w jednym strumieniu do 120 przy 32, a klaster przesuwa się od 141 do 677 w tym samym zakresie, 3.8x na dole wykresu i 5.6x na górze, a następnie spłaszcza się przy 710, 725 i 740 poprzez 256 strumieni.
Długie monity wymagają więcej pracy w procesie wstępnego wypełniania, gdzie obie konfiguracje są ograniczone obliczeniowo, więc obciążenie, które usuwa druga stacja, stanowi mniejszą część całości niż w przypadku krótkich monitów. Zysk jest znacznie większy niż dwukrotny w obu profilach, ponieważ druga stacja pobiera model 433 GB z pamięci LPDDR5X i umieszcza go w całości w pamięci HBM, a to ma tutaj większe znaczenie niż moc obliczeniowa drugiej B300.
MiniMax-M3
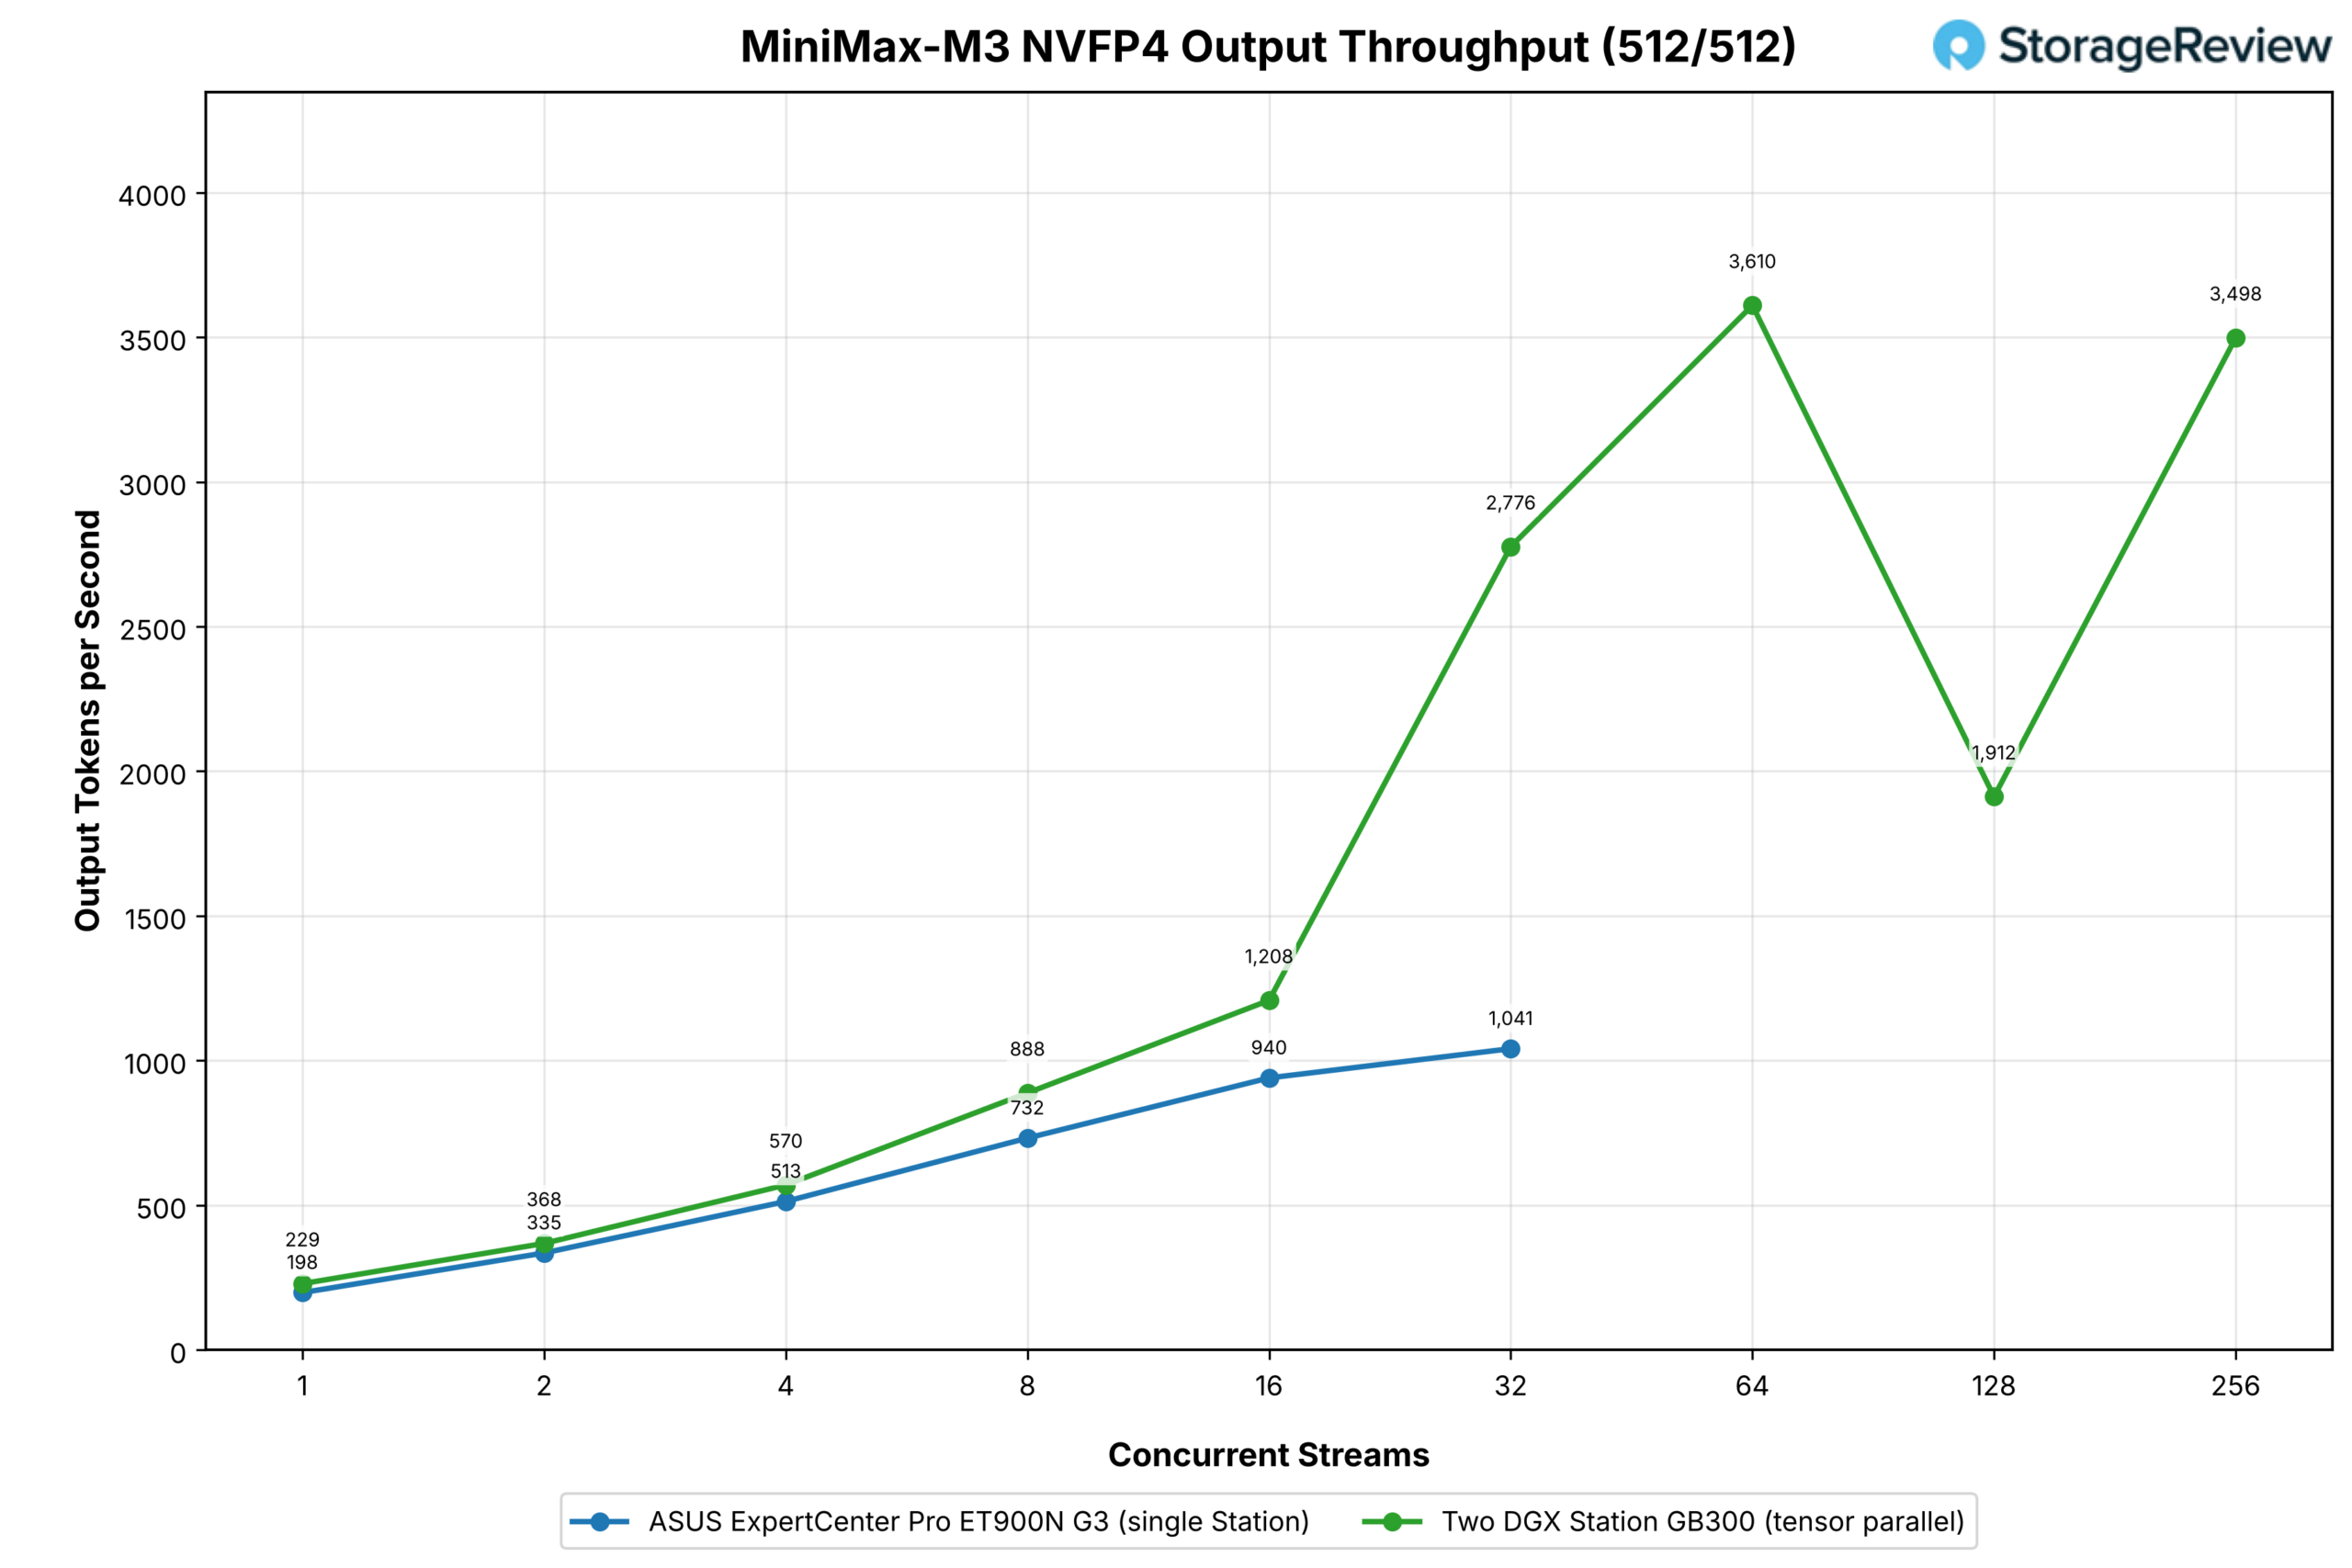
MiniMax-M3 działał w trybie TP2 bez odciążania Grace. Na jednej stacji znajdował się na granicy HBM, z częścią pamięci Grace, a w teście ASUS osiągnął 1,041 tokenów wyjściowych na sekundę przy 32 strumieniach i tym samym obciążeniu co EAGLE3.
Klaster śledzi pojedynczą stację dokładnie przez 16 strumieni (1,208 w porównaniu do 940), a następnie się oddala: 2,776 przy 32, 2.7x więcej niż pojedyncza wieża, 3,610 przy 64, spadek do 1,912 przy 128 i 3,498 przy 256. Dwie stacje dodają tutaj mniej niż w przypadku GLM-5.2, ponieważ jedna stacja już przechowuje większość tego modelu w HBM, więc wkład drugiego procesora graficznego jest bliższy zwykłemu skalowaniu obliczeniowemu, z dodatkową przestrzenią na pamięć podręczną KV.
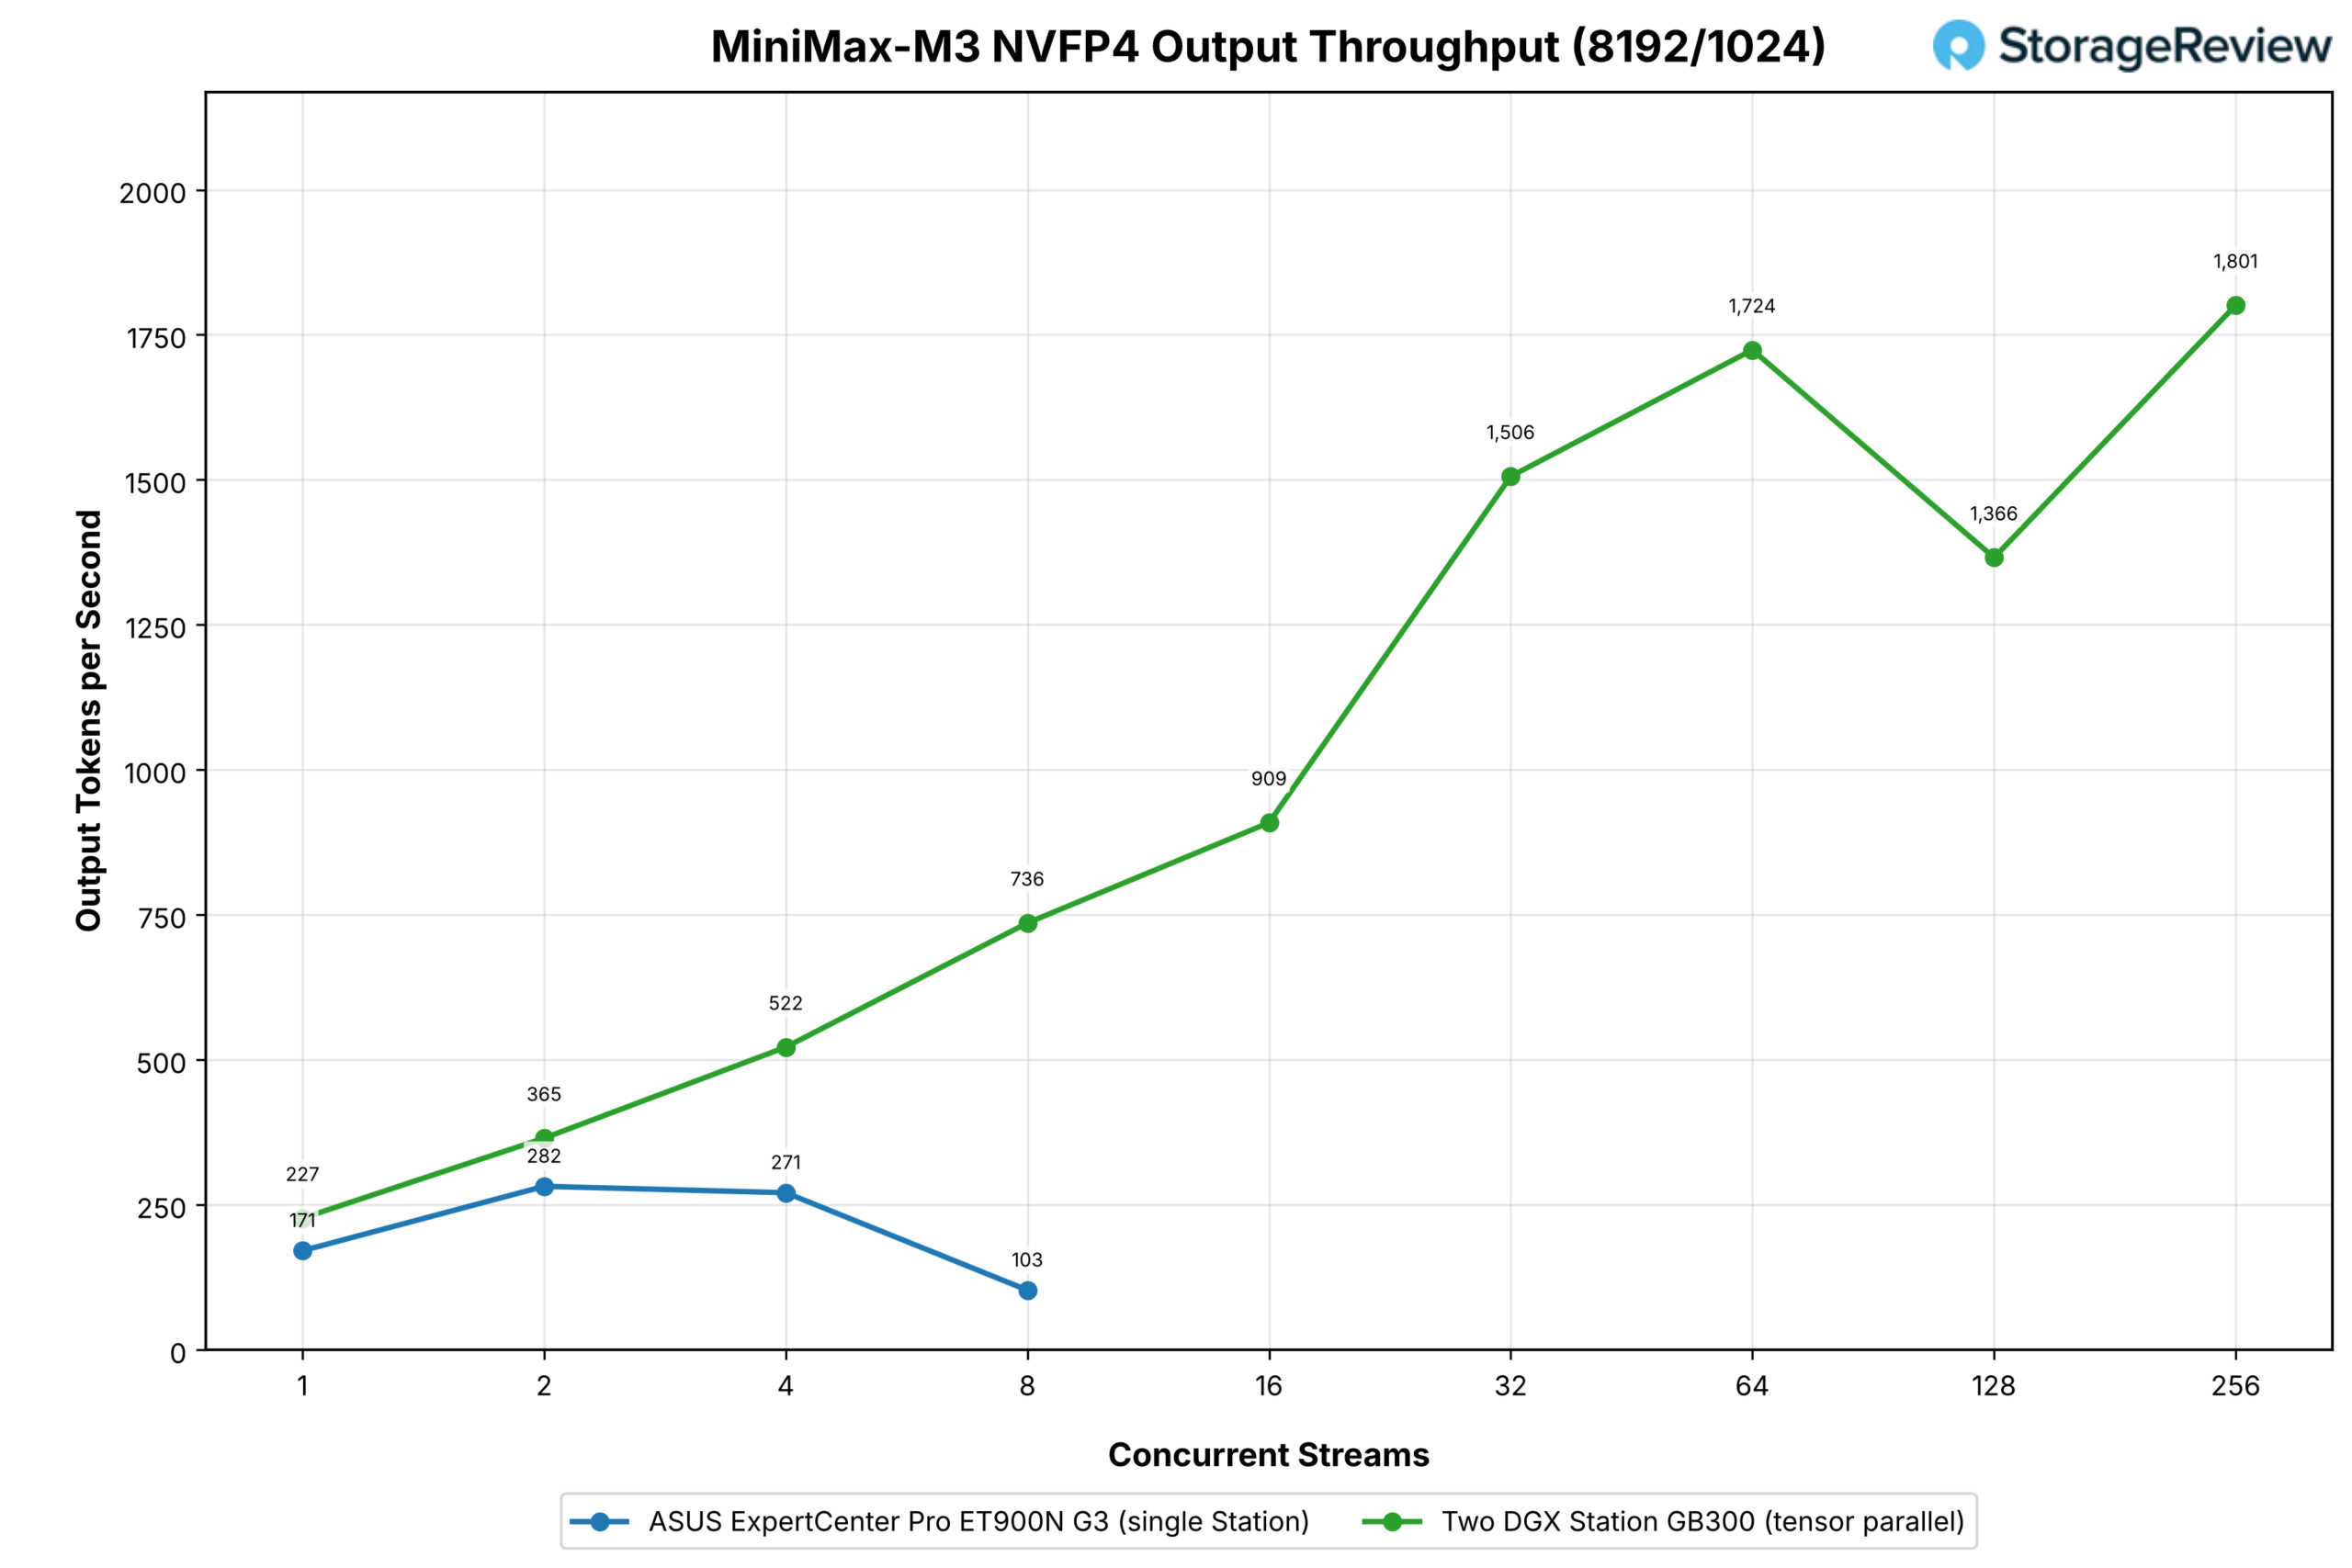
Profil z dużą ilością wstępnie wypełnianych torów to miejsce, w którym MiniMax-M3 zabrakło miejsca na jednej stacji: 8,192 monity o tokeny szybko zużywają pozostałą pamięć podręczną KV, więc pojedyncza wieża osiągnęła szczyt na poziomie 282 tokenów wyjściowych na sekundę przy dwóch strumieniach, utrzymała się na poziomie 271 przy czterech i spadła do 103 przy ośmiu, na tym przeszukiwanie się zakończyło, ponieważ nie było już niczego do zmierzenia.
Po podziale modelu na dwie stacje, te same punkty wskazywały 365, 522 i 736, co oznacza wzrost o 30% przy dwóch strumieniach, gdzie obie konfiguracje mają zapas pamięci podręcznej, oraz 7.1x przy ośmiu, gdzie jeden z nich się wyczerpał. Klaster kontynuował następnie do 909 przy 16, 1,506 przy 32, 1,724 przy 64, 1,366 przy 128 i 1,801 przy 256 – zakresu, którego pojedyncza stacja w ogóle nie jest w stanie osiągnąć w tym profilu.
Wniosek
Dwie stacje GB300 DGX połączone ze sobą za pomocą własnych portów ConnectX-8 spełniają wymagania opisane w dokumentacji firmy NVIDIA. Konfiguracja przebiegła bezproblemowo, a są to pierwsze dane dotyczące przepustowości, jakie widzieliśmy dla konfiguracji z dwoma systemami.
Druga stacja utrzymuje się dzięki modelom, które przekraczają 252 GB pamięci HBM3e: GLM-5.2 przechodzi z 139 tokenów wyjściowych na sekundę przy 32 strumieniach na jednej stacji do 1,525 na dwóch i dalej do 3,141 przy 256 strumieniach, ponieważ podział usuwa model 433 GB z pamięci LPDDR5X; GLM-5.3 osiąga 5,018 przy 256 strumieniach z limitu 188 dla pojedynczej stacji; MiniMax-M3 na długich monitach przechodzi z wieży, która zwalnia przy ośmiu strumieniach, do pary, która wciąż rośnie przy 256.
W przypadku dwóch modeli mieszczących się w jednej stacji, GLM-5.3 Flash i DeepSeek V4.1 Flash, lepszym sposobem wykorzystania drugiego urządzenia jest przydzielenie każdej stacji całej kopii, oddzielenie wstępnego wypełniania od dekodowania i umożliwienie pracownikowi dekodowania generowania bez zatrzymywania; w przypadku GLM-5.3 Flash nastąpiło podwojenie przepustowości długich monitów przy 32 strumieniach i potrojenie przepustowości krótkich monitów, a DeepSeek V4.1 Flash osiągnął najwyższą przepustowość wyjściową w zestawie: 5,248 tokenów na sekundę.
Nasze zdanie na temat tego produktu nie zmieniło się od czasu recenzji MSI XpertStation WS300 : to interesująca maszyna dla określonego rynku i jeśli znajdziesz zapotrzebowanie na nią, możesz mieć zapotrzebowanie na kolejną.
Najlepszym sposobem na ich uruchomienie jest infrastruktura wymienna: pula, na której zespół planuje pracę i którą modyfikuje w miarę zmian w projektach, a NVIDIA jest właścicielem elementów, które to umożliwiają. Firma kupiła Run:ai do planowania, Brev do środowisk programistycznych i Lepton do rynku obliczeniowego, a każda z tych trzech platform w połączeniu z szafą stacji sprawiłaby, że produkt byłby bardziej atrakcyjny, gdybyś miał do nich dostęp.
Konfiguracja dwumodułowa dobrze się skalowała; najlepszy zysk, jaki zmierzyliśmy, to GLM-5.3, ze 188 tokenów wyjściowych na sekundę na pojedynczej stacji do 5,018 na parze (wzrost 27-krotny), a przy dopasowanej współbieżności GLM-5.2 osiągnął 11-krotny wzrost przy 32 strumieniach, oba w modelach, które pojedyncza stacja może obsłużyć tylko poprzez rozproszenie wag do pamięci Grace. To wynik GB300 w porównaniu z 2x 400G i jesteśmy ciekawi, jak będzie wyglądać stacja Vera Rubin, gdy NVIDIA ją wprowadzi, z następną generacją HBM i NVLink-C2C.
Miejsce, w którym to się mieści, pozostało niezmienne: dwie stacje na biurku, bez szafy ani centrum danych za nimi, obsługują teraz modele, które kiedyś uzasadniały serwer GPU i związane z nim udogodnienia. Dzięki temu zespół, który nie może znaleźć miejsca w centrum danych lub nie chce na nie czekać, ma dostęp do wnioskowania klasy pionierskiej, które znajduje się tuż obok. NVIDIA podniosła poprzeczkę w tej kategorii, pomijając cenę. Klasa GB300 znajduje się w naszym rankingu najlepszych komputerów stacjonarnych do lokalnej sztucznej inteligencji , gdzie dane z tego klastra teraz potwierdzają wybór.



 Amazon