

Zespół StorageReview Lab, wykazując się zdumiewającą sprawnością obliczeniową, ustanowił kolejny rekord świata, obliczając liczbę pi do niewiarygodnych 202 112 290 000 000 cyfr. To niezwykłe osiągnięcie przyćmiewa poprzedni rekord 105 bilionów cyfr, również należący do tego zespołu. Pokazuje ono niezrównane możliwości nowoczesnych komputerów o wysokiej wydajności i odpowiednio zaprojektowanych platform sprzętowych.
Bezprecedensowy wyczyn obliczeniowy
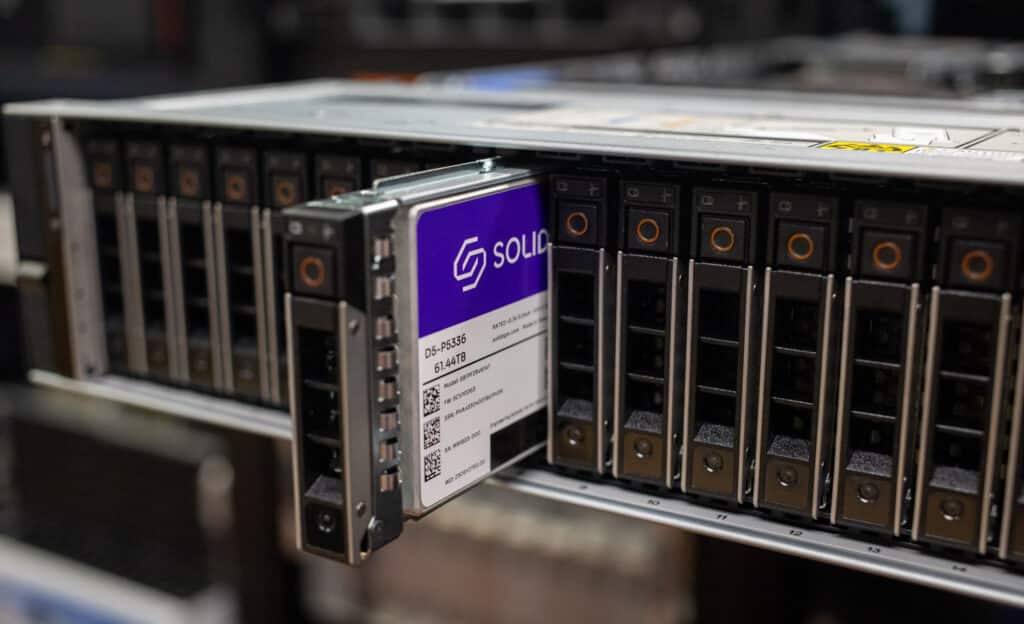
Zespół StorageReview Lab wykorzystał wysoce zaawansowaną konfigurację, aby osiągnąć ten cel. Wykorzystując procesory Intel Xeon 8592+ i dyski SSD Solidigm P5336 NVMe o pojemności 61.44 TB, zespół przeprowadzał niemal ciągłe obliczenia przez 85 dni, zużywając prawie 1.5 petabajta miejsca na 28 dyskach SSD Solidigm. Ten przełomowy projekt demonstruje znaczący postęp zarówno pod względem mocy obliczeniowej, jak i wydajności.
„Ten nowy rekord podkreśla niezwykły potencjał dzisiejszej infrastruktury obliczeniowej o wysokiej wydajności” – powiedział Jordan Ranous, architekt systemów z zespołu StorageReview Lab. „Osiągając ten kamień milowy, nie tylko wyznaczamy nowe standardy w matematyce obliczeniowej, ale także torujemy drogę przyszłym innowacjom w różnych dyscyplinach naukowych i inżynieryjnych”.
W marcu 2024 roku zespół StorageReview Lab osiągnął rekord świata, obliczając liczbę pi do 105 bilionów cyfr . Wykorzystując dwuprocesorowy system AMD EPYC z 256 rdzeniami i prawie petabajt dysków SSD Solidigm QLC, zespół zmierzył się z poważnymi wyzwaniami technicznymi, w tym ograniczeniami pamięci i pamięci masowej. Ten kamień milowy zademonstrował możliwości nowoczesnego sprzętu i dostarczył cennych informacji na temat optymalizacji systemów obliczeniowych o wysokiej wydajności.
„Napędy Solidigm i Dell PowerEdge R760 nie tylko działały bez zarzutu, ale niemal bezobsługowy charakter tego nowego rekordu był mile widzianą zmianą po niebezpieczeństwach, jakie napotkaliśmy podczas naszej ostatniej próby bicia rekordu” – powiedział Kevin O'Brien, dyrektor StorageReview Lab. „Po tym, co przeszliśmy podczas ostatniego testu 105, cieszę się, że wybraliśmy właśnie tę platformę do tego wielkiego rekordu” – kontynuował. Aby uzyskać więcej informacji na temat poprzedniej próby bicia rekordu 105 bilionów cyfr i związanych z nią wyzwań, można przeczytać cały artykuł tutaj.
Lekcja informatyki i matematyki
Kiedy po raz pierwszy zaczęliśmy szukać ciekawych sposobów testowania dysków SSD o dużej pojemności, oczywistą odpowiedzią, o której wspomnieliśmy w naszych recenzjach procesorów i systemów, był y-cruncher. Podczas wykorzystywania przestrzeni wymiany do rozległych obliczeń, zapotrzebowanie na miejsce wynosi około 4.7:1 na cyfry, więc 100 bilionów cyfr wymaga około 470 TiB przestrzeni. Bez zagłębiania się w matematykę i informatykę, y-cruncher, algorytm Chudnovsky'ego, opiera się na szybko zbieżnym szeregu wyprowadzonym z teorii funkcji modularnych i krzywych eliptycznych. Rdzeń algorytmu opiera się na następującym szeregu nieskończonym:
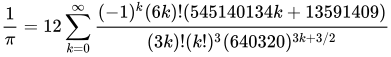
Najczęściej zadawane nam pytanie dotyczące obliczeń 100T i 105T brzmiało: „No dobrze, nic wielkiego. Dlaczego to tak długo trwa i wymaga tak dużo pamięci?”. To pytanie znalazło się wśród innych irytujących obaw dotyczących oprogramowania open source i możliwości programistycznych Alexa Yee. Cofnijmy się o krok i spójrzmy na to z poziomu systemu.
Obliczanie dużej liczby cyfr liczby Pi, takiej jak 100 bilionów, wymaga znacznej ilości miejsca ze względu na konieczność wykonywania dużych operacji arytmetycznych. Wyzwanie polega przede wszystkim na mnożeniu dużych liczb, co z natury wymaga znacznej ilości pamięci. Na przykład, najlepsze algorytmy mnożenia liczb N-cyfrowych wymagają około 4N bajtów pamięci, z których większość służy jako pamięć robocza. Do tej pamięci należy uzyskiwać dostęp wielokrotnie podczas obliczeń, co sprawia, że proces ten wymaga intensywnego przetwarzania danych wejścia/wyjścia na dysku, a nie obciąża procesora.
Wzór Chudnowskiego, powszechnie stosowany do obliczania wielu cyfr liczby Pi, wymaga rozległych operacji arytmetycznych. Te mnożenie, dzielenie i podnoszenie do kwadratu często sprowadzają się do dużych mnożeń. Historycznie superkomputery korzystały z algorytmów AGM, które, mimo że były wolniejsze, były łatwiejsze w implementacji i korzystały z brutalnej siły wielu maszyn. Jednak współczesne postępy przesunęły wąskie gardło z mocy obliczeniowej na szybkość dostępu do pamięci.
Jednostki arytmetyczne (ALU) i jednostki zmiennoprzecinkowe (FPU) procesora obsługują te duże liczby mnożenia podobnie jak mnożenie ręczne na papierze, dzieląc je na mniejsze, łatwiejsze w obsłudze operacje. Wcześniej obliczenia na Pi były ograniczone mocą obliczeniową, ale dzisiejsza moc obliczeniowa przewyższa szybkość dostępu do pamięci, co sprawia, że przechowywanie i niezawodność są kluczowymi czynnikami w ustanawianiu rekordów Pi. Na przykład, zaobserwowano niewielką różnicę w wydajności między naszym 128-rdzeniowym komputerem Intel a 256-rdzeniowym komputerem AMD Bergamo; nacisk położono na wydajność wejścia/wyjścia dysku.
Dyski SSD Solidigm odgrywają kluczową rolę w tych obliczeniach, nie ze względu na swoją naturalną szybkość, ale ze względu na wyjątkową gęstość zapisu. Dyski NVMe klasy konsumenckiej mogą pomieścić do 4 TB danych na niewielkiej przestrzeni, podczas gdy dyski SSD klasy korporacyjnej łączą te układy, aby uzyskać jeszcze większą pojemność. Chociaż pamięć NAND QLC może być wolniejsza niż inne rodzaje pamięci flash, paralelizm w tych gęstych dyskach SSD zapewnia większą łączną przepustowość, co czyni je idealnymi do obliczeń na dużej liczbie pi.
Dyski SSD Solidigm QLC NVMe umożliwiają szaleństwo
Dobrze, jeśli jeszcze nie śpisz i jesteś tu ze mną, wystarczy, że wiesz, że gdy liczby obliczeniowe są zbyt duże, aby zmieścić się w pamięci, komputery muszą korzystać z algorytmów programowych do arytmetyki wieloprecyzyjnej. Algorytmy te dzielą duże liczby na łatwe do zarządzania fragmenty i wykonują dzielenie za pomocą specjalnych technik. Właśnie tutaj pojawiają się dyski SSD Solidigm P5336 NVMe o pojemności 61.44 TB. y-cruncher pobiera te łatwe do zarządzania fragmenty, najpierw gromadzi je w pamięci systemowej, a następnie umieszcza na dysku roboczym.
Pamiętajmy, że do zamiany potrzebujemy stosunku około 4.7:1, ponieważ każda część tego przerażającego wzoru powyżej musi być reprezentowana przez bardzo wiele bitów.
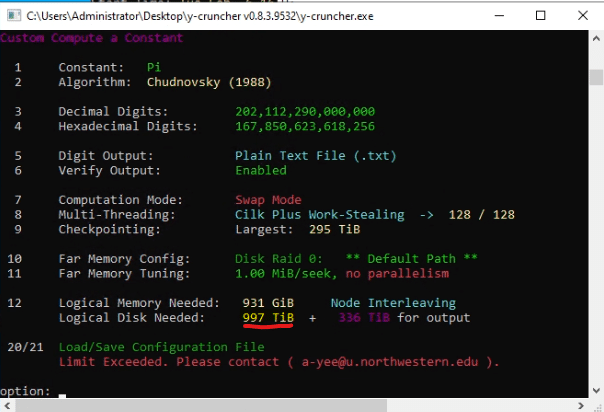
y-cruncher ma wbudowany kalkulator ilości potrzebnego miejsca na dysku (nadal oznaczony jako disk*cough*), który okazał się niezwykle dokładny w tym i poprzednich przebiegach.
Choć można by dorzucić kilka dysków twardych lub trochę pamięci obiektowej, rozmiar dysku to tylko jeden z elementów bardzo złożonego równania, co odkryliśmy w pierwszej rundzie. Możliwość umieszczenia wystarczająco dużej i szybkiej pamięci masowej blisko urządzenia obliczeniowego to powracający temat w naszym życiu w StorageReview w dobie rosnącej sztucznej inteligencji. Wydajność przestrzeni wymiany to największe wąskie gardło w tym obliczeniu. Bezpośrednio podłączone dyski NVMe oferują najwyższą dostępną wydajność i chociaż niektóre opcje mogą oferować najwyższą przepustowość na urządzenie, nasza duża, bardzo gęsta macierz QLC, łącznie, w zupełności sprostała zadaniu.
Consumer Drive i wydajność procesora. NIE system rekordów
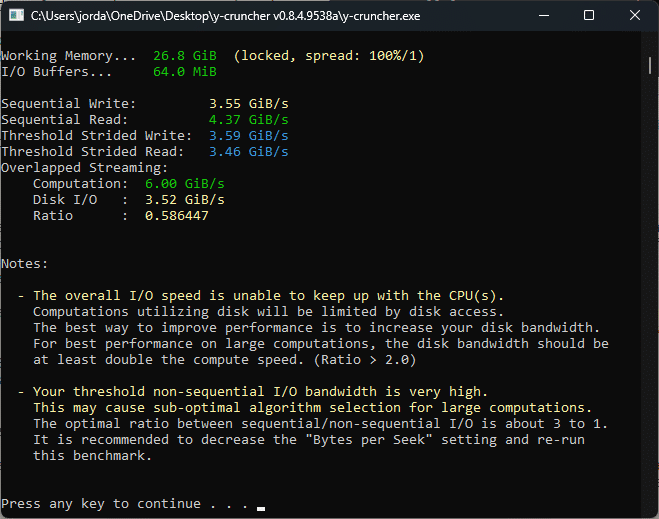
Y-cruncher posiada wbudowany test porównawczy, który pozwala na sterowanie wszystkimi parametrami i dostosowywanie ich do własnych potrzeb, aby znaleźć optymalne ustawienia wydajności dla macierzy dysków. Jest to niezwykle ważne. Powyższy zrzut ekranu pokazuje, że test porównawczy dostarcza informacji zwrotnych dla tego systemu konsumenckiego, wraz z metrykami dotyczącymi szybkości przetwarzania danych przez procesor oraz wydajności dysku SSD.
Alex dysponuje obszerną dokumentacją , ale w skrócie, po tygodniach testów odkryliśmy, że najlepszym rozwiązaniem jest bezpośrednia interakcja y-crunchera z dyskami. Testowaliśmy cele sieciowe, dyski podłączone do karty SAS RAID, karty NVMe RAID oraz cele iSCSI. Po przekazaniu kontroli nad sprzętem y-cruncherowi, wydajność jest ogromna. iSCSI również wydaje się akceptowalne, ale testowaliśmy to tylko dla pliku wyjściowego, który może wykorzystać „Direct IO” do tej interakcji. Kod RAID w trybie wymiany musi być stosunkowo dobrze przemyślany i z naszych testów oraz rozmów z deweloperem możemy wywnioskować, że działa on z dyskami na niskim poziomie.
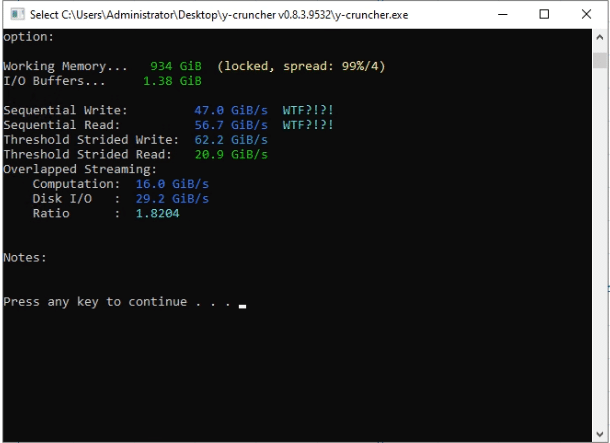
Dyski Solidigm o pojemności 61.44 TB zaczynają wyłaniać się jako najlepsze rozwiązanie wielu problemów w tym obszarze. Przeprowadzając test porównawczy w naszym systemie, widzimy, że dyski działają zgodnie ze specyfikacją zarówno w przypadku odczytu, jak i zapisu. Specjalnie wybraliśmy procesory Intel, aby uzyskać stosunek mocy obliczeniowej do mocy obliczeniowej (D/C) zbliżony do optymalnego, wynoszącego 2:1. Jest to optymalny stosunek, dzięki któremu nie tracisz czasu na procesorze, czekając na wydajność dysków. Wraz z rozwojem technologii dysków, możemy wykonywać bardziej rozbudowane i szybkie obliczenia, wybierając procesory o większej liczbie rdzeni.
Serwer Dell PowerEdge R760 „na zamówienie”
Jak głosi przysłowie, do trzech razy sztuka. To nie jest nasz pierwszy rodeo z biciem rekordów z Pi; wyciągnęliśmy wnioski z naszych dwóch pierwszych iteracji, aby zbudować najlepszą platformę Pi. Nasza pierwsza wersja wykorzystywała serwer 2U z 16 zatokami NVMe i trzema wewnętrznymi saneczkami SSD. Dzięki dyskom SSD Solidigm P5316 o pojemności 30.72 TB, zmieściliśmy przestrzeń wymiany dla y-crunchera, ale musieliśmy wykorzystać serwer pamięci masowej oparty na dyskach twardych dla pliku wyjściowego. Było to dalekie od optymalnego rozwiązania, zwłaszcza pod koniec fazy zapisu. Nasza druga platforma korzystała z tego samego serwera z podłączonym zewnętrznym modułem JBOF NVMe, co dało nam dodatkową zatokę NVMe — ale kosztem wrażliwego okablowania i niezbalansowanej wydajności. Wadą obu platform była konieczność polegania na zewnętrznym sprzęcie przez cały czas działania y-crunchera, co kosztowało nas dodatkowe zasilanie i punkty awarii.
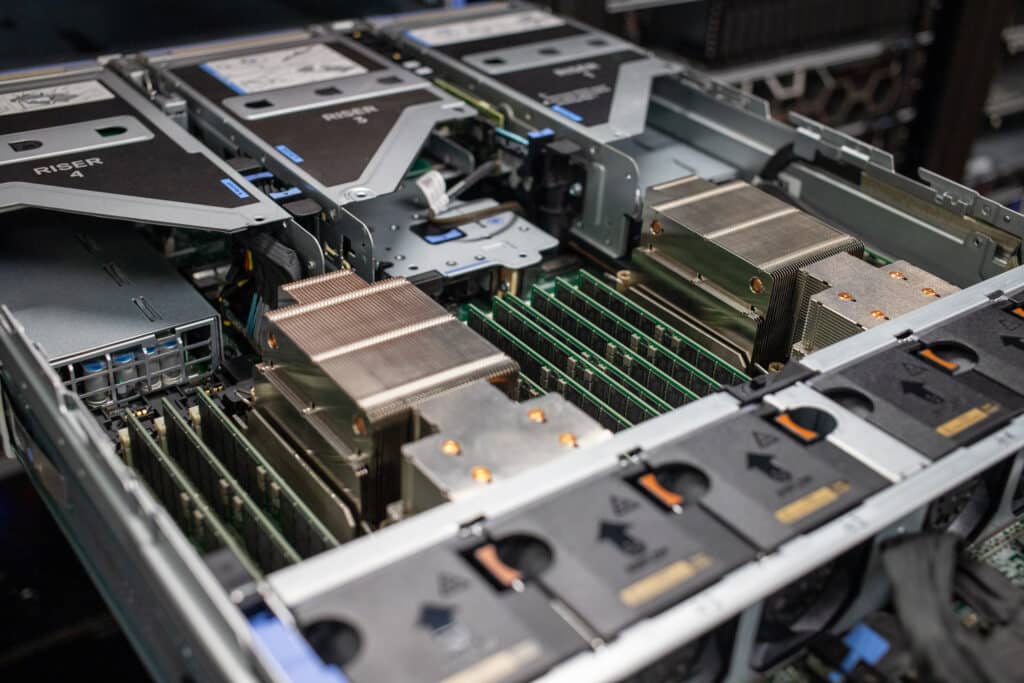
W tym teście chcieliśmy wykorzystać jeden serwer w pełni oparty na technologii Direct-NVMe i zapewnić wystarczająco dużo miejsca na pamięć masową typu „swap” i wyjściową pod jednym, blaszanym dachem. W tym celu wykorzystaliśmy serwer Dell PowerEdge R760 z 24-zatokową płytą główną NVMe Direct Drives. Platforma ta wykorzystuje wewnętrzny przełącznik PCIe, aby umożliwić jednoczesną komunikację wszystkich dysków NVMe z serwerem, eliminując potrzebę stosowania dodatkowego sprzętu lub urządzeń RAID. Następnie złożyliśmy konfigurację z wykorzystaniem risera PCIe z kilku serwerów R760 w naszym środowisku laboratoryjnym, co dało nam cztery gniazda PCIe z tyłu na dodatkowe dyski SSD NVMe montowane w U.2. Dodatkowym atutem było usunięcie większych radiatorów z innego serwera R760, co dało nam maksymalny możliwy zapas mocy w trybie turbo. System chłodzenia cieczą Direct Liquid Cooling trafił do naszego laboratorium miesiąc za późno, aby wdrożyć go w tym teście.
„Obliczenia liczby pi przez zespół StorageReview Lab, przeprowadzone z wykorzystaniem procesora Intel Xeon piątej generacji, do ponad 202 bilionów cyfr, podkreślają moc i wydajność tych procesorów. Wykorzystując zwiększoną liczbę rdzeni i zaawansowane funkcje wydajnościowe procesora Xeon piątej generacji , ten kamień milowy wyznacza nowy standard w matematyce obliczeniowej i nadal toruje drogę innowacjom w różnych zastosowaniach naukowych i inżynieryjnych” – powiedziała Suzi Jewett, dyrektor generalna Intel ds. produktów procesorów Intel Xeon piątej generacji.
Choć teoretycznie można było zamówić konfigurację Della dokładnie taką, jak ta użyta w tym przypadku, nie była ona czymś, co firma miała pod ręką i trzeba było ją złożyć. (Być może Michael wypuści limitowaną edycję „Pi” R760 z dokładnie taką konfiguracją, niestandardowym malowaniem i logo SR).
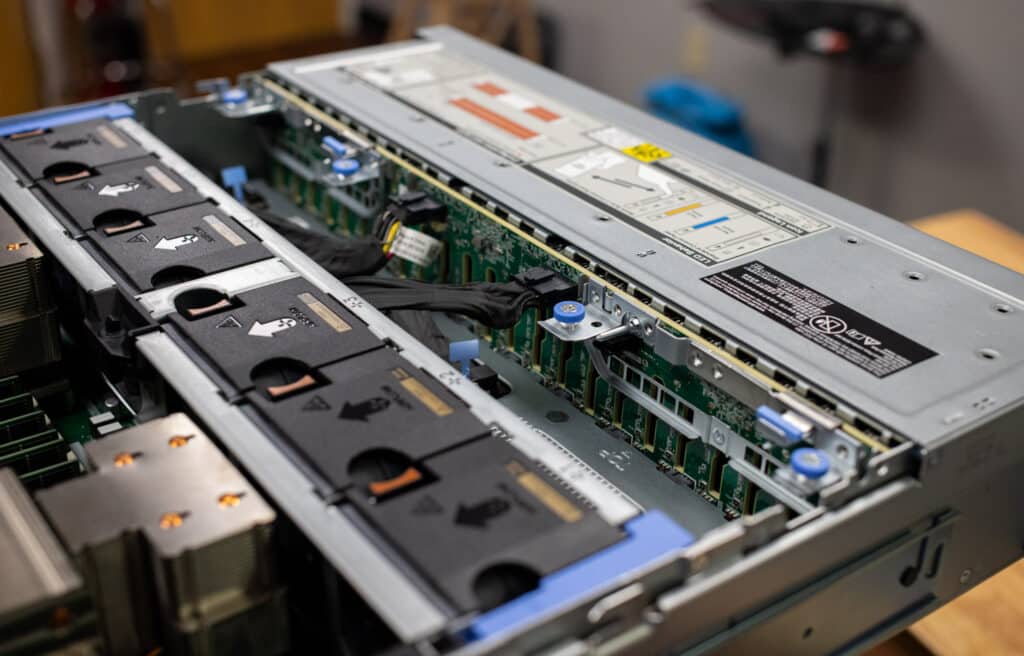
Rozmiar zasilacza był również kluczowy dla tego testu. Choć większość osób mogłaby od razu pomyśleć, że procesory pobierają najwięcej energii, umieszczenie 28 dysków SSD NVMe pod jednym dachem to znaczący spadek mocy. Nasz system wykorzystywał zasilacze o mocy 2400 W, które, jak się okazało, działały ledwo. Mieliśmy kilka momentów, w których pobór mocy był bliski krytycznemu, a gdyby system stracił jedno z połączeń z zasilaczem, zabrakłoby nam mocy. To nastąpiło już na samym początku; pobór mocy gwałtownie wzrósł, gdy obciążenie procesora osiągnęło szczyt, a system zwiększył aktywność wejścia/wyjścia na wszystkich dyskach SSD. Gdybyśmy mieli to powtórzyć, preferowane byłyby modele o mocy 2800 W.
Specyfikacje wydajności
Najważniejsze informacje techniczne
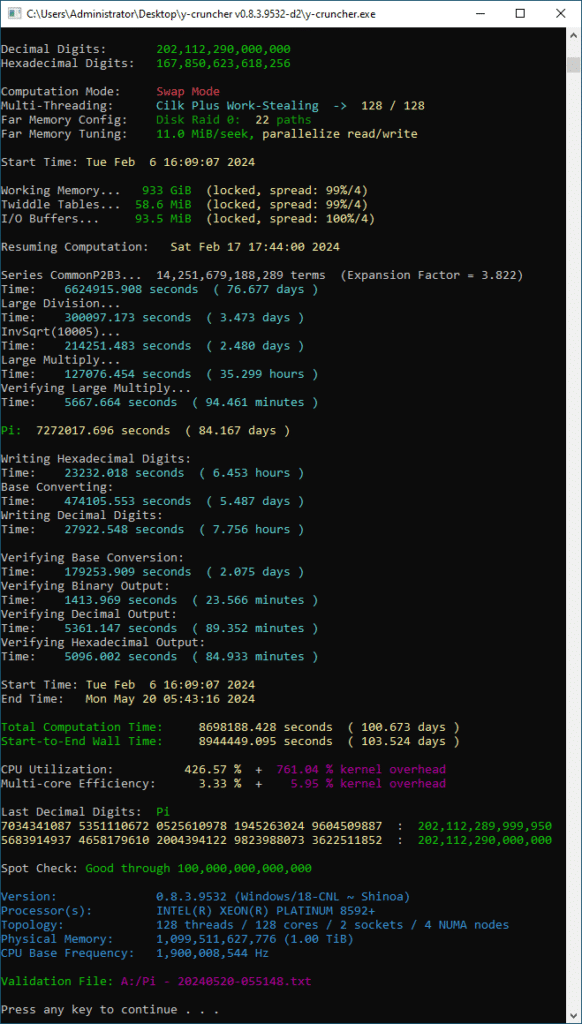
- Obliczono całkowitą liczbę cyfr: 202,112,290,000,000
- Sprzęt używany:Dell PowerEdge R760 z 2 procesorami Intel Xeon 8592+, 1 TB pamięci DRAM DDR5, 28 dyskami Solidigm 61.44 TB P5336
- Oprogramowanie i algorytmy: y-cruncher v0.8.3.9532-d2, Chudnovsky
- Przechowywanie danych: 3.76 PB zapisane na dysk, 82.7 PB na 22 dyskach w macierzy wymiany
- Czas trwania obliczeń: 100.673 dni
y-cruncher Telemetria
- Największy logiczny punkt kontrolny: 150 215 548 774 568 (278 TiB)
- Logiczne szczytowe wykorzystanie dysku: 514 540 112 731 728 (958 TiB)
- Odczytane bajty dysku logicznego: 102 614 191 450 271 272 (91.1 PiB)
- Zapisane bajty dysku logicznego: 88 784 496 475 376 328 (78.9 PiB)
- Data rozpoczęcia: wtorek, 6 lutego 2024, 16:09:07
- Data zakończenia: poniedziałek, 20 maja 2024, 05:43:16
- Pi: 7 272 017,696 sekund, 84.167 dni
- Całkowity czas obliczeń: 8 698 188,428 sekund, 100.673 dni
- Czas od początku do końca ściany: 8 944 449,095 sekund, 103.524 dni
Największą znaną cyfrą liczby Pi jest 2, znajdująca się na pozycji 202 112 290 000 000 (dwieście dwa biliony, sto dwanaście miliardów, dwieście dziewięćdziesiąt milionów).
Szersze implikacje
Chociaż obliczenie liczby pi do tak dużej liczby cyfr może wydawać się abstrakcyjnym wyzwaniem, praktyczne zastosowania i techniki opracowane w ramach tego projektu mają dalekosiężne implikacje. Te postępy mogą usprawnić różne zadania obliczeniowe, od kryptografii po złożone symulacje w fizyce i inżynierii.
Niedawne obliczenia liczby pi, wynoszącej 202 biliony cyfr, podkreślają znaczący postęp w zakresie gęstości pamięci masowej i całkowitego kosztu posiadania (TCO). Nasza konfiguracja pozwoliła na osiągnięcie zdumiewającej pojemności 1.720 petabajtów na dysku SSD NVMe w jednej obudowie 2U. Taka gęstość stanowi ogromny postęp w zakresie możliwości przechowywania danych, zwłaszcza biorąc pod uwagę, że całkowite zużycie energii osiągnęło szczytowy poziom zaledwie 2.4 kW przy pełnym obciążeniu procesora i dysku.
Ta efektywność energetyczna kontrastuje z tradycyjnymi systemami HPC, które zużywają znacznie więcej energii i generują nadmierne ciepło. Zużycie energii rośnie wykładniczo po uwzględnieniu dodatkowych węzłów w systemach pamięci masowej skalowalnych poziomo, co jest szczególnie istotne w przypadku rozbudowy współdzielonej pamięci masowej o niskiej pojemności w porównaniu z pamięcią lokalną o wysokiej gęstości. Zarządzanie ciepłem ma kluczowe znaczenie, szczególnie w mniejszych centrach danych i szafach serwerowych. Chłodzenie tradycyjnych systemów HPC nie jest łatwym zadaniem i wymaga zastosowania agregatów chłodniczych, które mogą pobierać więcej energii niż urządzenia pracujące samodzielnie. Minimalizując zużycie energii i emisję ciepła, nasza konfiguracja oferuje bardziej zrównoważone i łatwe w zarządzaniu rozwiązanie dla małych firm. Dodatkowo, większość naszych testów została przeprowadzona z wykorzystaniem chłodzenia świeżym powietrzem.
Aby to zobrazować, wyobraźmy sobie wyzwania, z jakimi borykają się osoby korzystające z sieciowych, współdzielonych pamięci masowych i niezoptymalizowanych platform. Takie konfiguracje wymagałyby co najmniej jednego agregatu chłodniczego w centrach danych, aby utrzymać temperaturę pod kontrolą. W takich środowiskach każdy zaoszczędzony wat przekłada się na mniejsze zapotrzebowanie na chłodzenie i niższe koszty operacyjne, co sprawia, że nasze podejście oparte na wysokiej gęstości i niskim zużyciu energii jest idealnym wyborem. Kolejną istotną korzyścią płynącą z utrzymania sprawnej i wydajnej platformy przez rekordowy czas jest ochrona całej konfiguracji za pomocą sprzętu do zasilania awaryjnego. Jak wspomniano wcześniej, potrzebne byłyby akumulatory zapasowe dla serwerów obliczeniowych, przełączników, serwerów pamięci masowej, agregatów chłodniczych i pomp wodnych, aby utrzymać je przy życiu przez znaczną część roku.
Ogólnie rzecz biorąc, to rekordowe osiągnięcie pokazuje potencjał obecnych technologii HPC i podkreśla znaczenie efektywności energetycznej i zarządzania temperaturą w nowoczesnych środowiskach komputerowych.
Zapewnienie dokładności: wzór Baileya–Borweina–Plouffe’a
Obliczenie liczby pi do 202 bilionów cyfr to monumentalne zadanie, ale zapewnienie dokładności tych cyfr jest równie kluczowe. W tym miejscu z pomocą przychodzi wzór Baileya-Borweina-Plouffe'a (BBP).
Wzór BBP pozwala nam weryfikować cyfry binarne liczby pi w formacie szesnastkowym (o podstawie 16) bez konieczności obliczania wszystkich poprzedzających je cyfr. Jest to szczególnie przydatne do krzyżowego sprawdzania fragmentów naszych obszernych obliczeń.
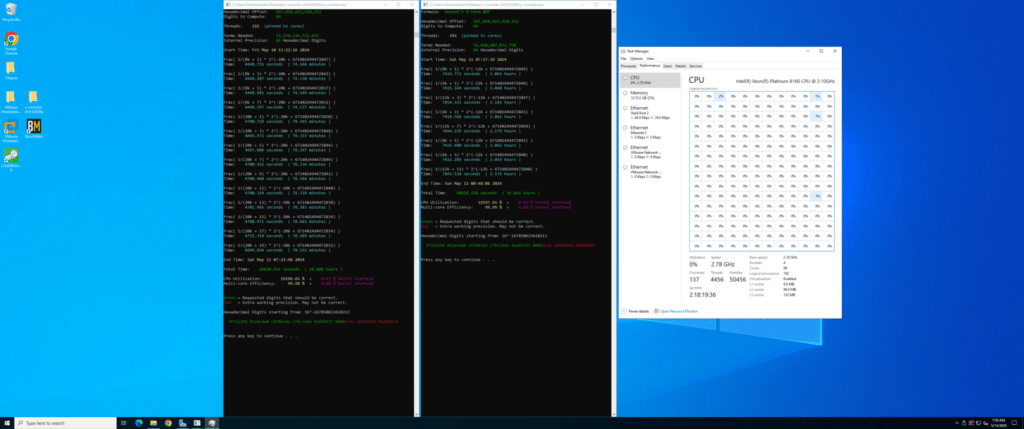
Dwa obliczenia weryfikacyjne.
Oto uproszczone wyjaśnienie:
- Wyjście szesnastkowe:Podczas głównego obliczenia najpierw generujemy cyfry pi w systemie szesnastkowym. Wzór BBP pozwala bezpośrednio obliczyć dowolną cyfrę liczby pi w systemie szesnastkowym. Można to zrobić za pomocą innych programów, takich jak GPUPI, ale y-cruncher również posiada wbudowaną funkcję. Jeśli wolisz podejście open source, Formuły są dobrze znane.
- Weryfikacja krzyżowaMożemy porównać te wyniki z naszym głównym obliczeniem, obliczając niezależnie konkretne pozycje cyfr szesnastkowych liczby pi za pomocą wzoru BBP. Jeśli są one zgodne, to wyraźnie wskazuje to na poprawność całego ciągu. Przeprowadziliśmy tę weryfikację krzyżową sześć razy; oto dwa z nich.
Na przykład, jeśli nasze podstawowe obliczenia dają te same cyfry szesnastkowe, co te uzyskane ze wzoru BBP w różnych punktach, możemy z pewnością stwierdzić ich dokładność. Ta metoda nie jest jedynie teoretyczna; została praktycznie zastosowana we wszystkich istotnych obliczeniach liczby pi, zapewniając solidność i wiarygodność wyników.
R = Oficjalny wynik biegu, V = Wynik weryfikacyjny
- R: f3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 37088*
- V: *3f7e2296 822ac6a8c9 7843dacfbc 1eeb4a5893 370888
Spostrzegawczy czytelnicy zauważą, że weryfikacje ze zrzutów ekranu i powyższego porównania są nieco przesunięte (*). Choć nie było to konieczne, ponieważ na końcu szesnastkowy zapis uległby zmianie, sprawdziliśmy również wyrywkowo kilka innych lokalizacji (np. 100 bilionów i 105 bilionów cyfr), aby upewnić się, że obliczenia są spójne. Chociaż teoretycznie możliwe jest obliczenie dowolnej cyfry dziesiętnej liczby pi przy użyciu podobnej metody, nie jest jasne, czy miałoby to precyzję przekraczającą zaledwie 100 milionów cyfr, a nawet byłoby wydajne obliczeniowo, zamiast wykonywania obliczeń Chudnovsky'ego i uwzględnienia ich wszystkich. (Jeśli Eric Weisstein to zobaczy, proszę o kontakt; chętnie spróbuję).
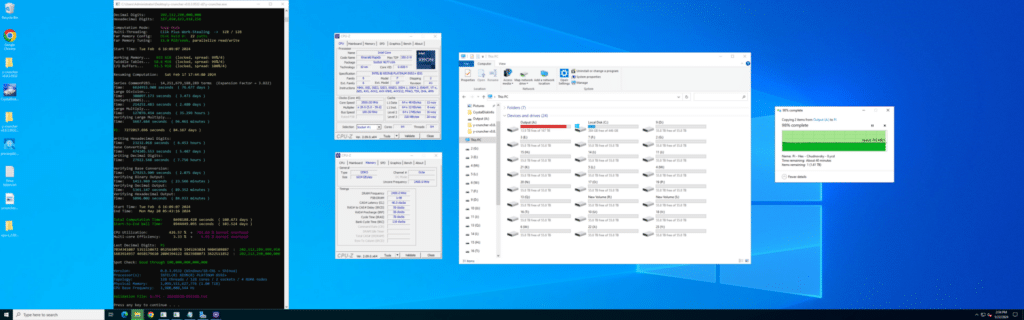
Dzięki integracji tego procesu matematycznej kontroli krzyżowej możemy zagwarantować integralność naszych rekordowych obliczeń liczby pi obejmujących 202 biliony cyfr, co stanowi dowód naszej precyzji obliczeniowej i zaangażowania w naukową dokładność.
Droga przed nami
Osiągnięcie przez zespół StorageReview Lab, polegające na obliczeniu liczby pi do ponad 202 bilionów cyfr, jest świadectwem niezwykłego postępu w dziedzinie obliczeń o wysokiej wydajności i technologii pamięci masowej. To rekordowe osiągnięcie, z wykorzystaniem procesorów Intel Xeon 8592+ w naszych dyskach SSD Dell PowerEdge R760 i Solidigm QLC NVMe o pojemności 61.44 TB, podkreśla możliwości nowoczesnego sprzętu w zakresie obsługi złożonych i wymagających dużej ilości zasobów zadań z niespotykaną dotąd wydajnością. Sukces projektu nie tylko dowodzi kompetencji zespołu StorageReview, ale także podkreśla potencjał dzisiejszej infrastruktury HPC do poszerzania granic matematyki obliczeniowej i innych dyscyplin naukowych.
„Ten nowy rekord świata dla liczby Pi to ekscytujące osiągnięcie, ponieważ to obciążenie obliczeniowe jest tak intensywne, jak wiele obciążeń AI, z którymi mamy do czynienia obecnie. Dyski SSD Solidigm D5-P5336 o pojemności 61.44 TB po raz kolejny udowodniły, że potężne połączenie ultrawysokiej pojemności, wydajności odczytu saturacyjnego PCIe 4 i wysokiej liczby zapisanych petabajtów danych jest w stanie sprostać i uwolnić potencjał niektórych z najbardziej wymagających aplikacji” – powiedział Greg Matson, wiceprezes ds. pamięci masowej w Data Center Storage Group w Solidigm. „Cieszymy się, że mieliśmy okazję umożliwić pobicie kolejnego rekordu w próbie obliczenia liczby Pi z naszymi partnerami z Dell Technologies i ekspertami z StorageReview”.
To przedsięwzięcie oferuje również cenne informacje na temat optymalizacji gęstości pamięci masowej i efektywności energetycznej, torując drogę dla bardziej zrównoważonych i zarządzalnych rozwiązań obliczeniowych. W miarę jak kontynuujemy badanie możliwości HPC, wnioski wyciągnięte z tego projektu niewątpliwie będą motorem przyszłych innowacji, przynosząc korzyści różnym dziedzinom, od kryptografii po inżynierię. Osiągnięcie zespołu StorageReview Lab stanowi kamień milowy w historii obliczeń, dowodząc, że dzięki odpowiedniemu połączeniu sprzętu i wiedzy specjalistycznej możemy osiągnąć nowe szczyty odkryć naukowych i postępu technologicznego.
Podziękowanie
Zespół StorageReview Lab pragnie wyrazić wdzięczność firmom Solidigm, Dell Technologies, Intel oraz użytkownikowi y-crunch Alexowi Yee za ich nieustające wsparcie i wkład w ten projekt.


 Amazon