

Firma Supermicro zaprezentowała nowy projekt rozwiązań Data Center Building Block Solutions (DCBBS) dla systemów HPC oparty na platformie NVIDIA Vera Rubin NVL4. To ogłoszenie rozszerza strategię firmy w zakresie architektury DCBBS poza wdrożenia sztucznej inteligencji w przedsiębiorstwach, obejmując środowiska obliczeń naukowych, zapewniając ramy referencyjne do wdrażania infrastruktury HPC i AI na dużą skalę.
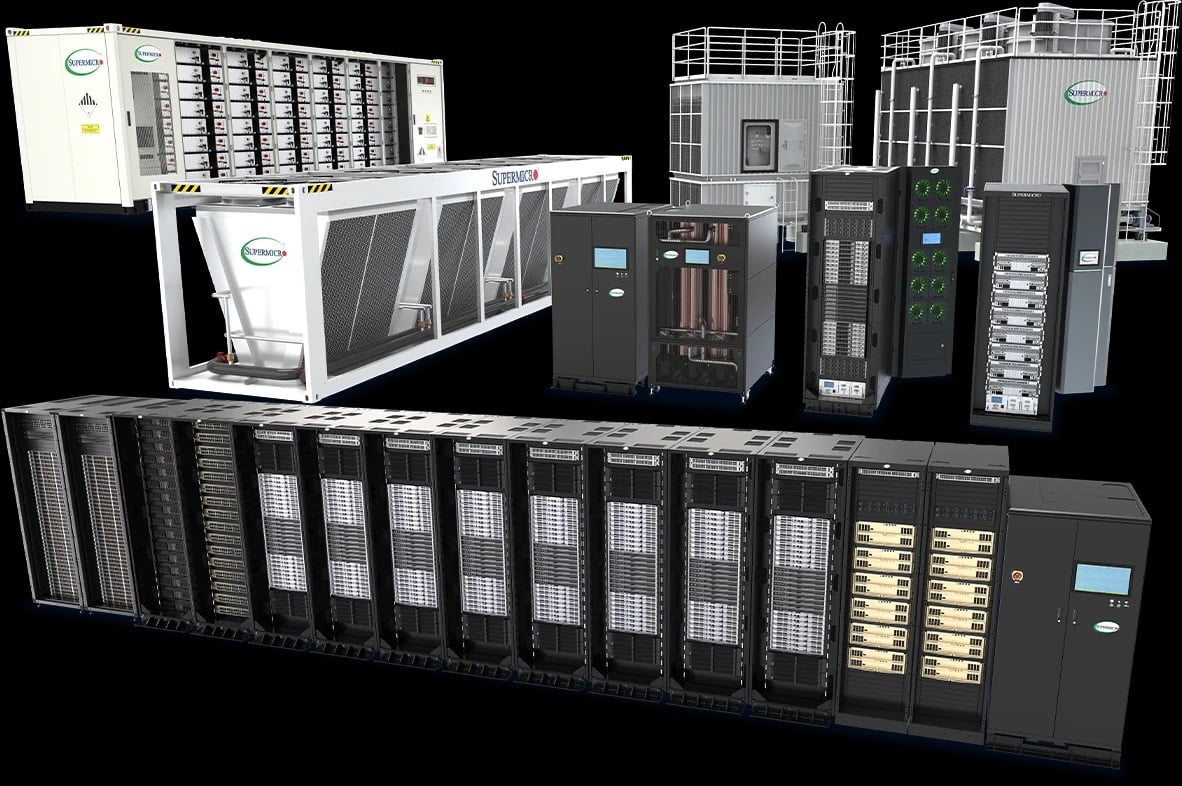
Nowy projekt bazuje na projektach NVIDIA Vera Rubin NVL72 i NVIDIA HGX Rubin NVL8 DCBBS zaprezentowanych na początku tego roku i wykorzystuje to samo zintegrowane podejście w instytucjach badawczych, laboratoriach krajowych i centrach superkomputerowych. Platforma DCBBS firmy Supermicro łączy w sobie infrastrukturę obliczeniową, sieciową, chłodzenia cieczą, dystrybucję zasilania i infrastrukturę obiektu w ramach gotowego modelu wdrożenia, który zmniejsza złożoność implementacji i przyspiesza wdrażanie klastrów.
Prezes i dyrektor generalny Supermicro, Charles Liang, powiedział, że sztuczna inteligencja staje się fundamentalnym elementem współczesnych badań naukowych. Zauważył, że organizacje zdolne do szybkiego wdrażania zaawansowanej infrastruktury będą w stanie stymulować przyszłe odkrycia. Podkreślił doświadczenie firmy w budowaniu klastrów GPU chłodzonych cieczą na dużą skalę jako kluczowy czynnik stojący za nowym projektem.
Zaprojektowany dla konwergentnych obciążeń HPC i AI
Projekt opiera się na rosnącej konwergencji tradycyjnej symulacji HPC i obliczeń wspomaganych przez sztuczną inteligencję. Organizacje badawcze coraz częściej łączą obciążenia symulacyjne o podwójnej precyzji z modelami uczenia maszynowego i sztucznej inteligencji, aby skrócić cykle rozwoju i przyspieszyć odkrycia naukowe w takich dziedzinach jak modelowanie klimatu, odkrywanie leków, materiałoznawstwo i badania energetyczne.
Supermicro pozycjonuje platformę NVIDIA Vera Rubin NVL4 jako fundament dla tych hybrydowych obciążeń, łącząc akcelerację GPU na dużą skalę z zasobami CPU i wysokowydajną siecią. Firma zaznacza, że jej metodologia wdrażania opiera się na doświadczeniu zdobytym podczas budowy klastrów superkomputerowych chłodzonych cieczą, zawierających ponad 100 000 procesorów GPU.
Kompleksowa metodologia wdrażania
Plan DCBBS przedstawia proces wdrażania, z którego Supermicro korzysta w przypadku dużych projektów infrastruktury chłodzonej cieczą.
Projekty rozpoczynają się od oceny obiektu na miejscu, która obejmuje ocenę dostępu do doków załadunkowych, wymiarów hali danych, nośności podłogi oraz istniejącej infrastruktury zasilania i chłodzenia. Uzyskane dane służą do opracowania planu wdrożenia dla konkretnego obiektu.
Integracja systemów odbywa się w zakładach produkcyjnych Supermicro przed wysyłką i obejmuje montaż szaf, okablowanie oraz testy walidacyjne na poziomie systemu (L10) i klastra (L11). Po dostarczeniu, usługi wdrożeniowe obejmują instalację szaf, integrację sieci, podłączenie zasilania i chłodzenia, uruchomienie oraz walidację operacyjną.
Supermicro oferuje również stałe usługi wsparcia, obejmujące opcje reakcji na miejscu, przeznaczone dla środowisk badawczych i produkcyjnych o znaczeniu krytycznym.
Vera Rubin NVL4 Skalowalna architektura jednostek
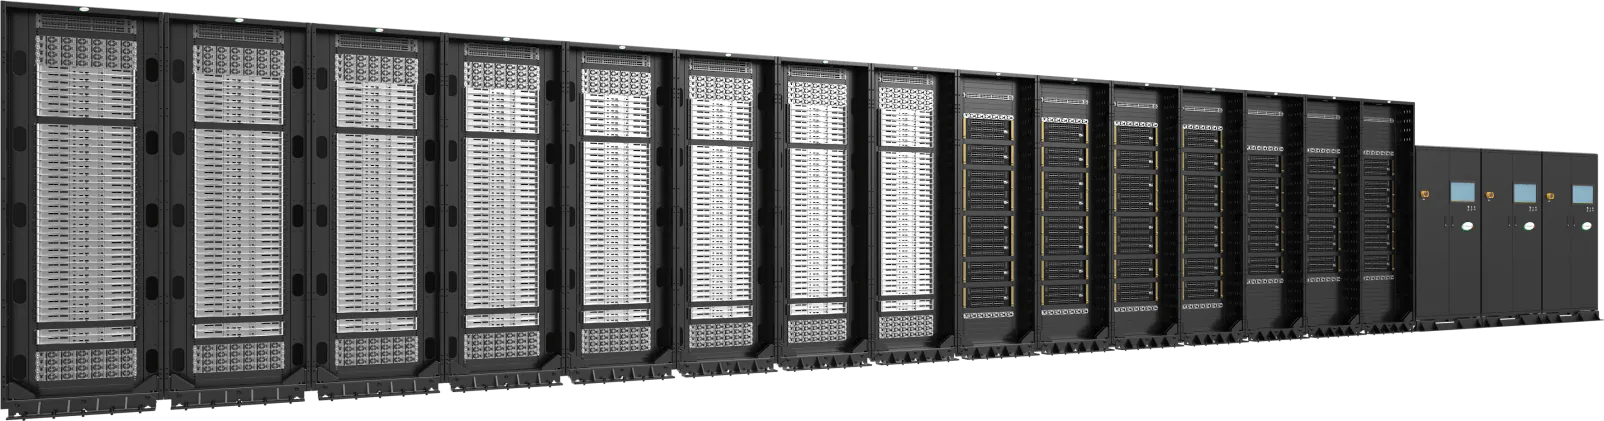
Projekt opiera się na powtarzalnej jednostce skalowalnej NVIDIA Vera Rubin NVL4, którą można replikować w celu tworzenia klastrów o mocy od około 3.2 MW do obiektów zbliżających się do skali gigawatowej.
Każda skalowalna jednostka składa się z ośmiu chłodzonych cieczą szaf obliczeniowych w niestandardowych obudowach 52U. Konfiguracja obsługuje 288 węzłów NVIDIA Vera Rubin NVL4, w tym do 1,152 procesorów graficznych NVIDIA Rubin i 576 procesorów NVIDIA Vera. Poszczególne szafy działają w zakresie mocy 362 kW.
Chłodzenie zapewnia architektura bezpośredniego chłodzenia cieczą DLC-2 firmy Supermicro. Każda skalowalna jednostka zawiera trzy rzędowe jednostki dystrybucji chłodzenia, każda o mocy do 1.8 MW, w konfiguracji redundantnej 2+1. Konstrukcja chłodzenia obejmuje płyty chłodzące doprowadzające chłodziwo bezpośrednio do układu scalonego, pionowe kolektory dystrybucji chłodziwa oraz chłodziwo o składzie PG25-A firmy Supermicro.
Sieć oparta jest na infrastrukturze NVIDIA Quantum-X800 InfiniBand, zapewniającej niskie opóźnienia i wysoką przepustowość połączeń wymaganą do rozproszonych obciążeń HPC i AI. Dostępne są również konfiguracje sieciowe chłodzone cieczą.
Dostarczanie energii odbywa się za pośrednictwem ośmiu półek zasilających o mocy 72 kW na każdą szafę obliczeniową, podczas gdy dwa przełączniki zarządzające typu top-of-rack umożliwiają monitorowanie i sterowanie poza pasmem.
Natychmiastowa dostępność dla wdrożeń GB200 NVL4
Firma Supermicro poinformowała, że oprócz architektury bazującej na architekturze Vera Rubin, konfiguracje bazujące na architekturze NVIDIA GB200 NVL4 są dostępne już teraz dla organizacji poszukujących opcji wdrożenia w najbliższej przyszłości.
Ogłoszenie odzwierciedla ciągły zwrot branży w kierunku zintegrowanych projektów infrastruktury o skali rack, które łączą moc obliczeniową, sieć, zasilanie, chłodzenie i zarządzanie w ramach wstępnie zweryfikowanych modeli wdrożeniowych. Wraz z postępującą konwergencją obciążeń AI i HPC, dostawcy coraz bardziej koncentrują się na redukcji złożoności wdrożeń, jednocześnie obsługując wyższe gęstości szaf rack i środowiska chłodzone cieczą.


 Amazon