

VAST Data rozszerzyło współpracę z AMD w zakresie infrastruktury AI dla dostawców chmury i przedsiębiorstw wdrażających usługi uczenia, wnioskowania, generacji rozszerzonej o wyszukiwanie oraz agentowe usługi AI. W ramach współpracy system operacyjny VAST AI łączy się z procesorami AMD EPYC 6. generacji , kartami graficznymi AMD Instinct, sprzętem sieciowym AMD oraz oprogramowaniem ROCm.
Współpraca odzwierciedla szerszą transformację infrastruktury z klastrów AI skoncentrowanych na szkoleniu w kierunku środowisk, które muszą również obsługiwać trwały kontekst, wnioskowanie o wysokiej współbieżności i wieloetapowe przepływy pracy agentów. Wdrożenia te kładą większy nacisk na przenoszenie danych, zarządzanie pamięcią podręczną KV, wykorzystanie GPU oraz możliwość zapewnienia dostępu z niskim opóźnieniem do dużych zestawów danych modelowych i kontekstowych.
VAST pozycjonuje swoją architekturę Disaggregated Shared Everything (DASE ) jako współdzieloną warstwę danych dla tych środowisk. Platforma łączy przechowywanie plików i obiektów, bazy danych, strumieniowanie zdarzeń i usługi danych w ramach ujednoliconej, globalnej przestrzeni nazw. Zapewnia również obsługę wielu dzierżawców i izolację obciążeń dla chmur AI obsługujących jednoczesne obciążenia klientów i aplikacji.
Platformy EPYC 9006 dla systemów VAST CBox i EBox
Firma VAST wybrała procesory AMD EPYC 6. generacji, wcześniej znane pod nazwą kodową Venice, do swoich platform CBox i EBox nowej generacji. Firma planuje wykorzystać te procesory w systemach CBox szóstej generacji i EBox trzeciej generacji, które stanowią podstawę systemu operacyjnego VAST AI.
Obsługa procesora AMD EPYC 9006 wprowadza łączność PCIe Gen6 do platformy sprzętowej VAST. VAST twierdzi, że nowy interfejs podwaja przepustowość wejścia/wyjścia w porównaniu z poprzednią generacją, zwiększając przepustowość pamięci masowej plików i obiektów, a jednocześnie zmniejszając opóźnienia w przypadku usług danych, takich jak bazy danych, magazyny danych i obciążenia strumieniowe zdarzeń dostarczane przez VAST DataBase i DataEngine.
W przypadku infrastruktury AI wyższa przepustowość wejścia/wyjścia może pomóc zredukować wąskie gardła między zasobami obliczeniowymi, sieciowymi i pamięcią masową NVMe. Jest to szczególnie istotne w przypadku ładowania modeli, potoków pobierania, dostępu do punktów kontrolnych i zewnętrznych przepływów pracy z pamięcią podręczną KV, gdzie sama pojemność pamięci GPU jest niewystarczająca do utrzymania aktywnego kontekstu.
Architektura referencyjna łączy Helios, VAST i DriveNets
VAST, AMD i DriveNets opracowują również referencyjną architekturę infrastruktury AI opartą na infrastrukturze AI AMD Helios w formacie rack, systemie operacyjnym VAST AI i sieci DriveNets AI Fabric.

Architektura referencyjna ma na celu zapewnienie wskazówek dotyczących wdrażania obciążeń związanych z trenowaniem modeli, wnioskowaniem, uczeniem maszynowym i pamięcią podręczną KV. Obejmuje ona zagadnienia dotyczące wielkości i dostępności dla organizacji budujących fabryki sztucznej inteligencji, które wymagają współdzielonej infrastruktury danych i wydajnej sieci, a także obliczeń GPU.
VAST wskazał również na rozszerzoną współpracę z dostawcami oprogramowania do wnioskowania, TensorMesh i EmbeddedLLM. Działania ekosystemu koncentrują się na produkcyjnych architekturach wnioskowania dla aplikacji AI opartych na agentach, chociaż nie ujawniono szczegółowych informacji na temat integracji produktów ani dostępności.
Odciążanie pamięci podręcznej KV ma na celu wnioskowanie o wysokiej współbieżności
Centralnym elementem ogłoszenia jest rozszerzona obsługa pamięci podręcznej KV przy użyciu procesorów graficznych AMD Instinct , AMD Infinity Context, oprogramowania ROCm i systemu operacyjnego VAST AI.
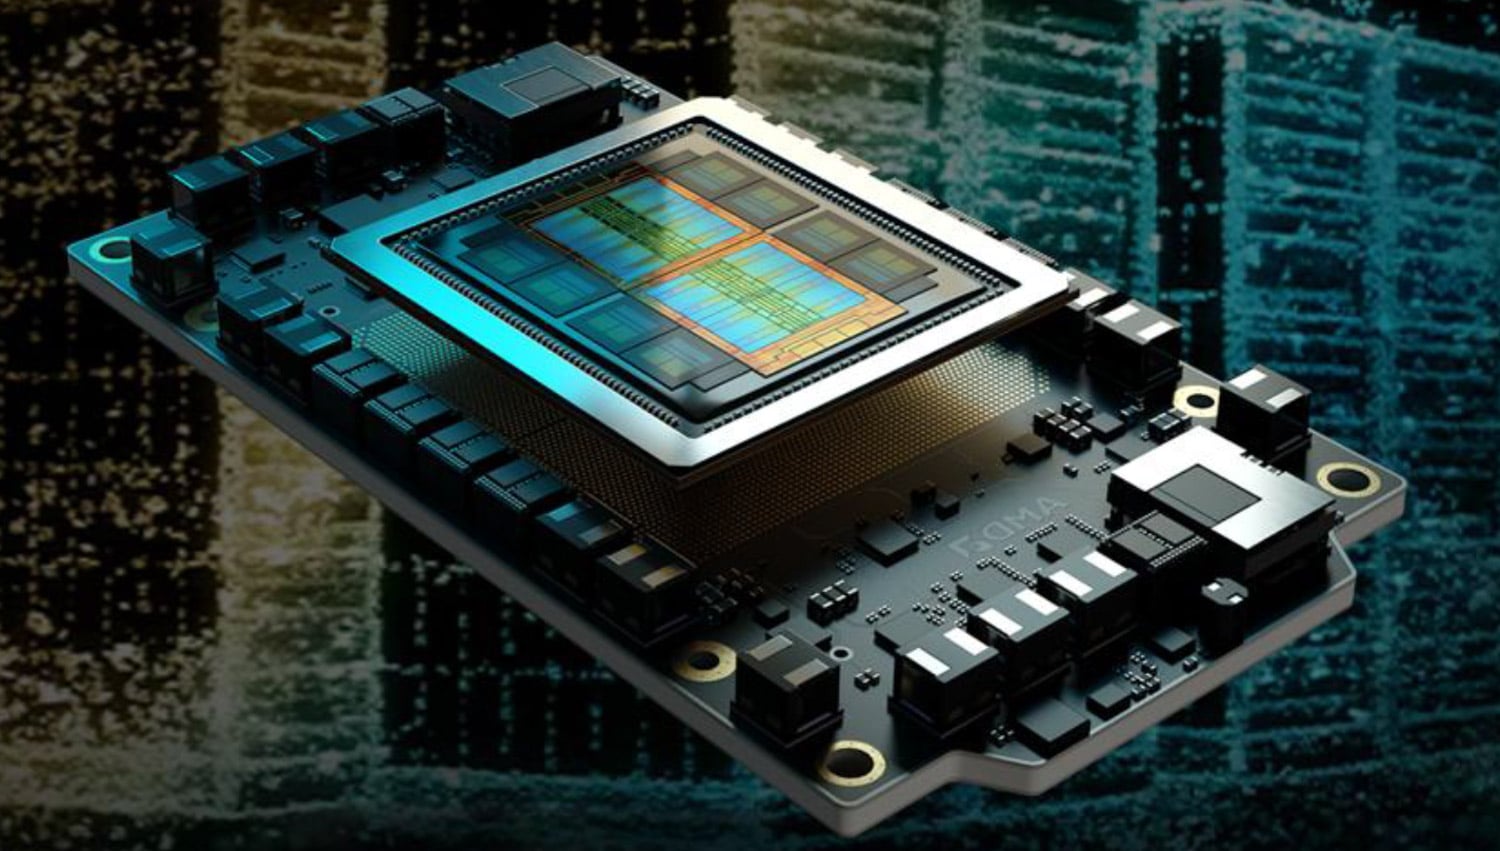
Dane pamięci podręcznej KV przechowują pośrednie informacje o stanie uwagi generowane podczas wnioskowania. Przechowywanie tych danych poprawia wydajność interakcji wieloobrotowych i obciążeń o długim kontekście, ale duże rozmiary pamięci podręcznej mogą znacząco zużywać pamięć GPU. Eksternalizacja lub warstwowanie pamięci podręcznej KV na wysokowydajną platformę pamięci masowej pozwala zwolnić pamięć GPU dla aktywnych obciążeń, zachowując jednocześnie kontekst dla kolejnych żądań wnioskowania.
VAST poinformował o wstępnych testach z kartą graficzną AMD Instinct MI355X , które wykazały 9-krotną poprawę czasu do pierwszego tokena i 9.7-krotną wyższą przepustowość tokena podczas korzystania z VAST do odciążania pamięci podręcznej KV w agentowych obciążeniach AI o wysokiej współbieżności. Firma zauważyła, że wyniki te zależą od bazowego sprzętu, charakterystyki obciążenia i konfiguracji pamięci masowej.
Integracja stosuje również zasady cyklu życia VAST do danych z pamięci podręcznej KV. Funkcja ta ma na celu automatyczne wygasanie i usuwanie informacji z pamięci podręcznej, co jest istotne, gdy kontekst wnioskowania zawiera dane wrażliwe, osobiste lub regulowane.
Pensando Pollara 400 łączy procesory graficzne z pamięcią masową współdzieloną
Architektura wykorzystuje kartę sieciową AMD Pensando Pollara 400 AI do łączenia procesorów graficznych AMD Instinct z klastrem pamięci masowej VAST. Według VAST, karta sieciowa obsługuje przesyłanie danych z procesora graficznego do pamięci masowej za pośrednictwem protokołu NFS przez TCP i RDMA, umożliwiając dostęp do klastrów VAST opartych na dyskach SSD NVMe w celu obsługi pamięci podręcznej KV i szerszych wymagań dotyczących danych inferencyjnych.
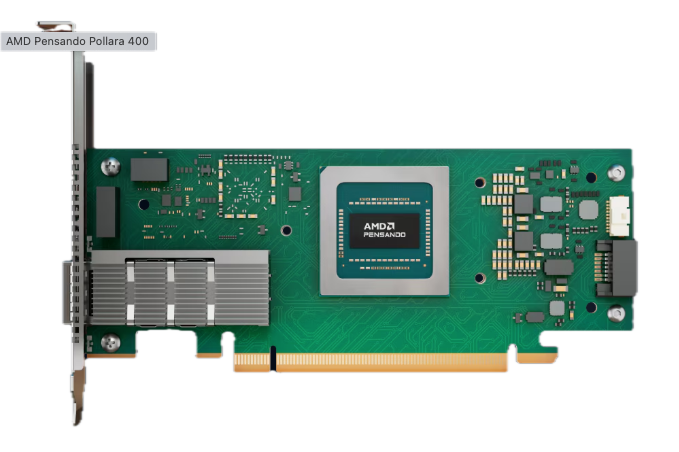
Powstały projekt ma obsługiwać środowiska AI, które wymagają skalowania zarządzania kontekstem niezależnie od pamięci GPU. Zamiast traktować pamięć masową jako oddzielną warstwę trwałości, VAST pozycjonuje platformę jako warstwę danych i wykonania, która może zarządzać modelami, bazami danych, danymi strumieniowymi, danymi plików i kontekstem AI w całej rozproszonej infrastrukturze.
W przypadku dostawców rozwiązań chmurowych AI podejście to ma na celu zwiększenie wykorzystania procesorów GPU i poprawę efektywności operacyjnej, ponieważ wdrożenia wykraczają poza wynajem procesorów GPU i szkolenie wsadowe, obejmując trwałe wnioskowanie i usługi agentowe AI.


 Amazon