

Kiedy recenzowaliśmy NVIDIA DGX Spark , pamięć masowa była najwyraźniejszą wadą konstrukcyjną platformy i jest to problem przede wszystkim formatu. Wewnętrzne gniazda Sparka mieszczą krótkie dyski M.2, klasy 2230 i 2242, gdzie wygrywa obudowa, a traci pojemność. Pojemny koniec rynku dysków SSD dla klientów to pełnowymiarowe dyski 2280, podczas gdy obecnie są dostępne modele 8 TB, a Spark po prostu nie ma gdzie umieścić takiego dysku. To pozostawia maszynę zbudowaną do poważnej pracy ze sztuczną inteligencją z limitem pamięci masowej lepiej dopasowanym do cienkiego i lekkiego laptopa, bez wewnętrznej ścieżki wokół niego. Luisuantech GP Spark jest rozwiązaniem dokładnie tego problemu: 0.58-litrowa, czterozatokowa obudowa dla pełnowymiarowych dysków M.2, która łączy się z portem 100GbE Sparka, wyświetla się jako natywne urządzenie NVMe bez sterowników ani formatowania i obsługuje ruch GPU Direct Storage z szybkością zbliżoną do szybkości łącza.
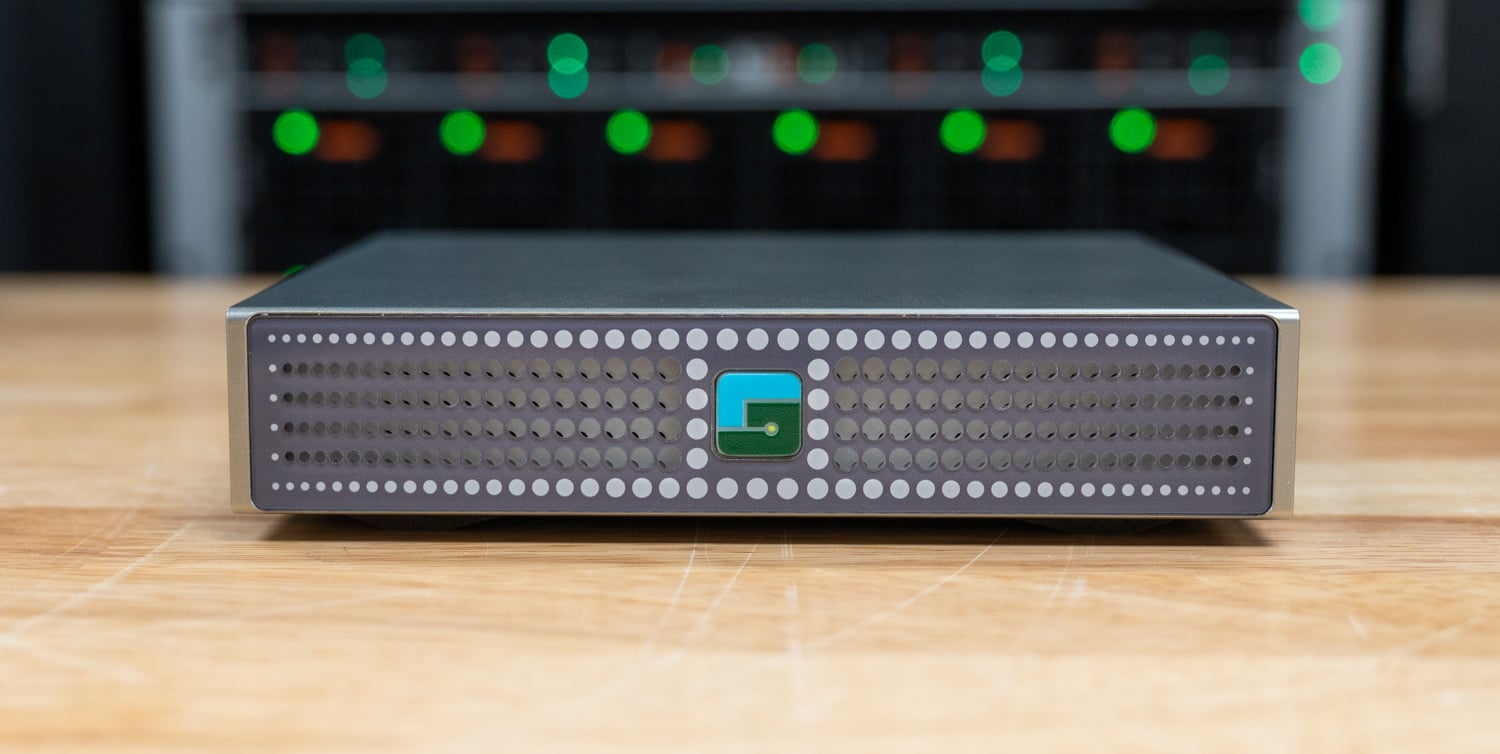
Celem jest prostota i ekonomia dysków klienckich. Cztery zatoki GP Spark mieszczą standardowe dyski SSD M.2 2280 lub 22110 NVMe, formaty blokowane przez Spark, i obsługują je za pośrednictwem protokołu NVMe-oF RDMA poprzez sprzętowy mechanizm odciążania na dedykowanym układzie. Specyfikacja Luisuantech weryfikuje obecnie dyski o pojemności do 4 TB, czyli 16 TB na obudowę, choć są to te same sloty, w których znajdują się już dyski klienckie o pojemności 8 TB, więc praktyczny limit to kwestia walidacji, a nie mechaniczna. Nie ma tu macierzy korporacyjnej, licencji ani systemu operacyjnego do opanowania. Wystarczy podłączyć kabel DAC lub AOC między GP Spark a DGX Spark, uruchomić polecenie modprobe nvme-rdma na systemie Ubuntu w Spark, a dyski pojawią się jako urządzenia /dev/nvme gotowe do dostępu do GDS.
Zaprojektuj i zbuduj
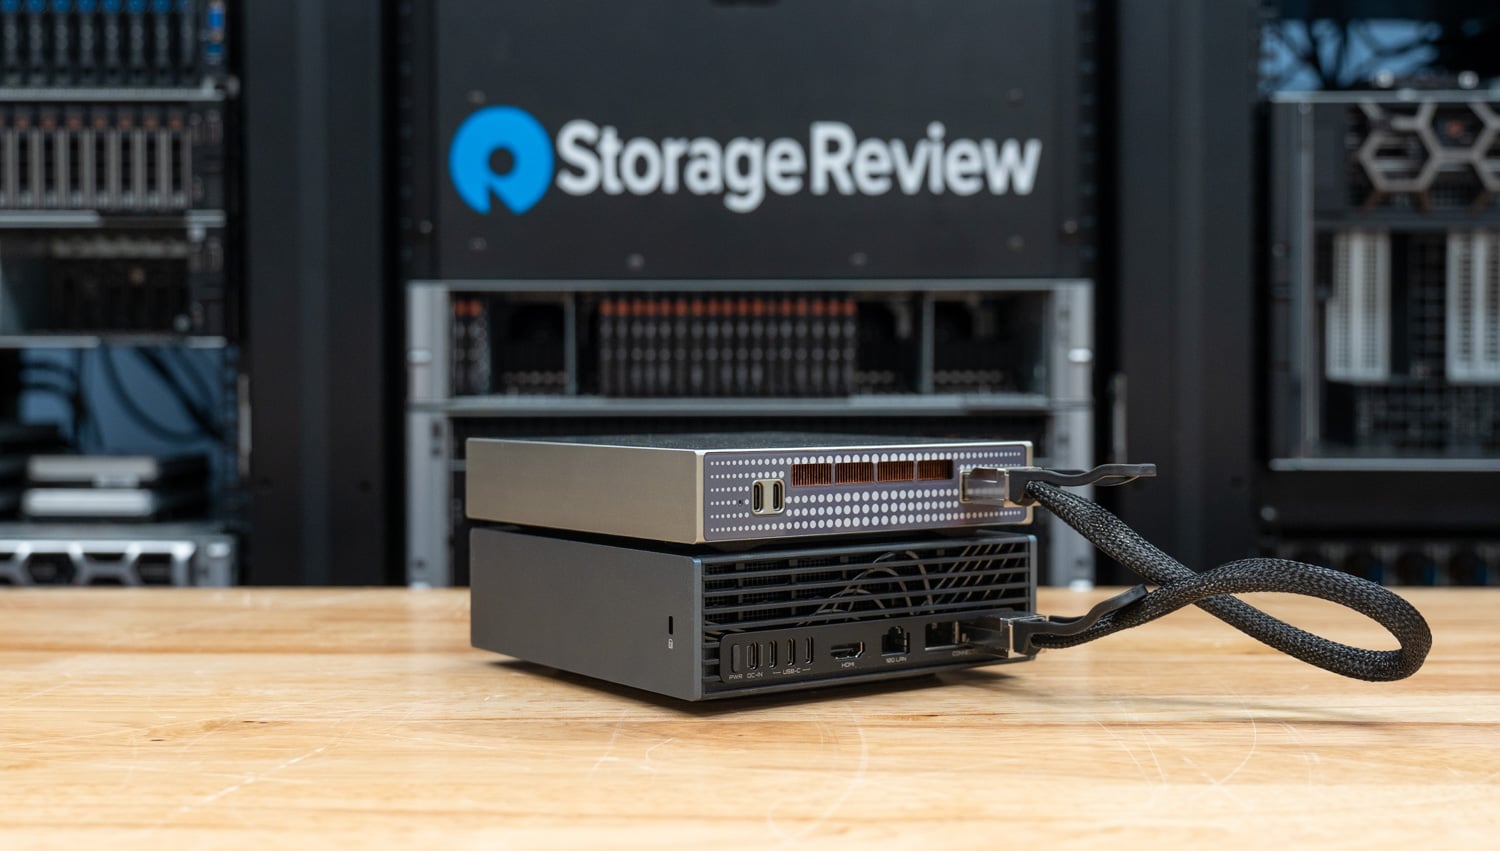
GP Spark to obudowa o wymiarach 150 mm x 150 mm x 26 mm, mniejsza od samego Sparka, zamknięta w perforowanej metalowej obudowie z pojedynczym przyciskiem zasilania, który służy również jako lampka stanu: zielona oznacza normalny stan, a czerwona sygnalizuje awarię. Zasilanie odbywa się przez USB-C PD z zewnętrznego zasilacza 20 V/5.4 A, a całe urządzenie, łącznie z napędami, ma moc poniżej 100 W. Na tylnym panelu znajdują się dokładnie trzy złącza: wejście zasilania USB-C, port debugowania fabrycznego USB-C oraz port danych QSFP28 100 GbE, który obsługuje miedziane przetworniki cyfrowo-analogowe (DAC) lub moduły optyczne. Wewnątrz, dedykowany procesor danych i koprocesor obsługują odciążenie NVMe-oF, a cztery zatoki M.2 znajdują się pod górną pokrywą.
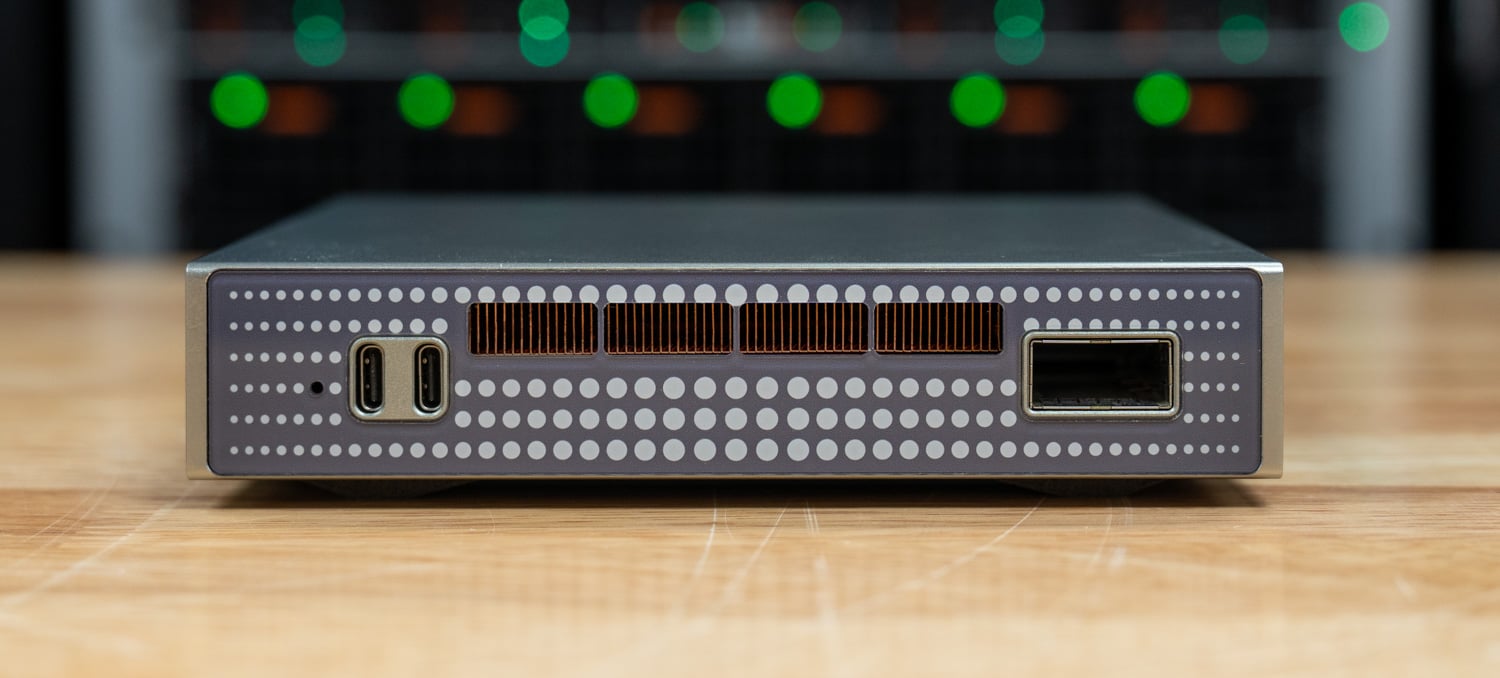
Tylny panel jest w pełni funkcjonalny: porty zasilania i debugowania USB-C po lewej stronie, klatka QSFP28 po prawej oraz rząd miedzianych żeberek widocznych przez otwory wentylacyjne między nimi. Chłodzenie jest całkowicie pasywne.
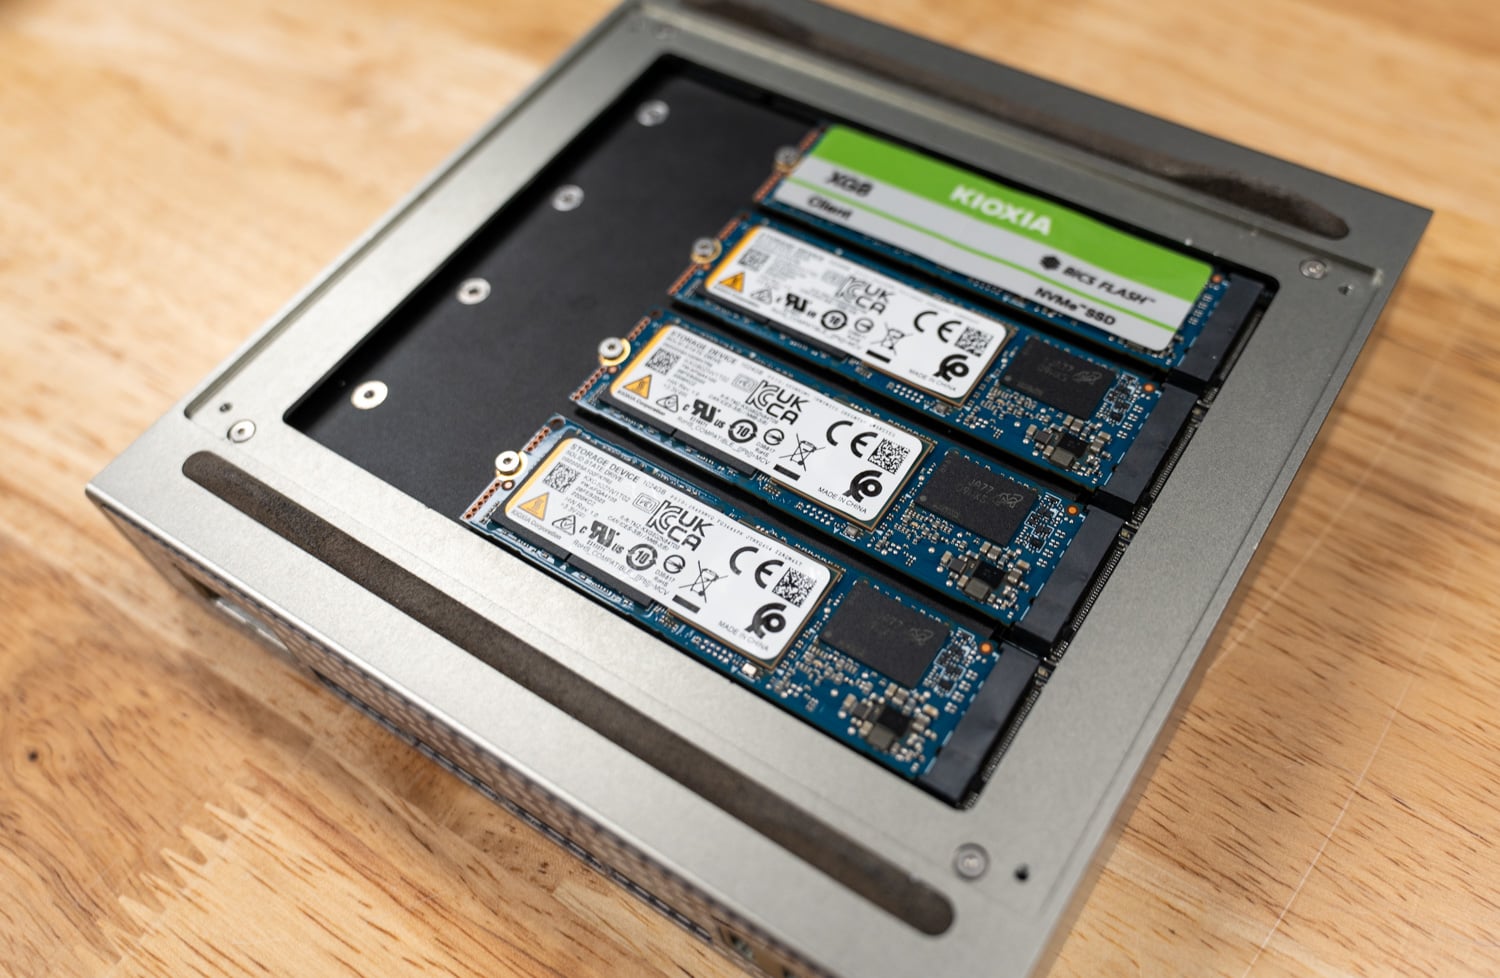
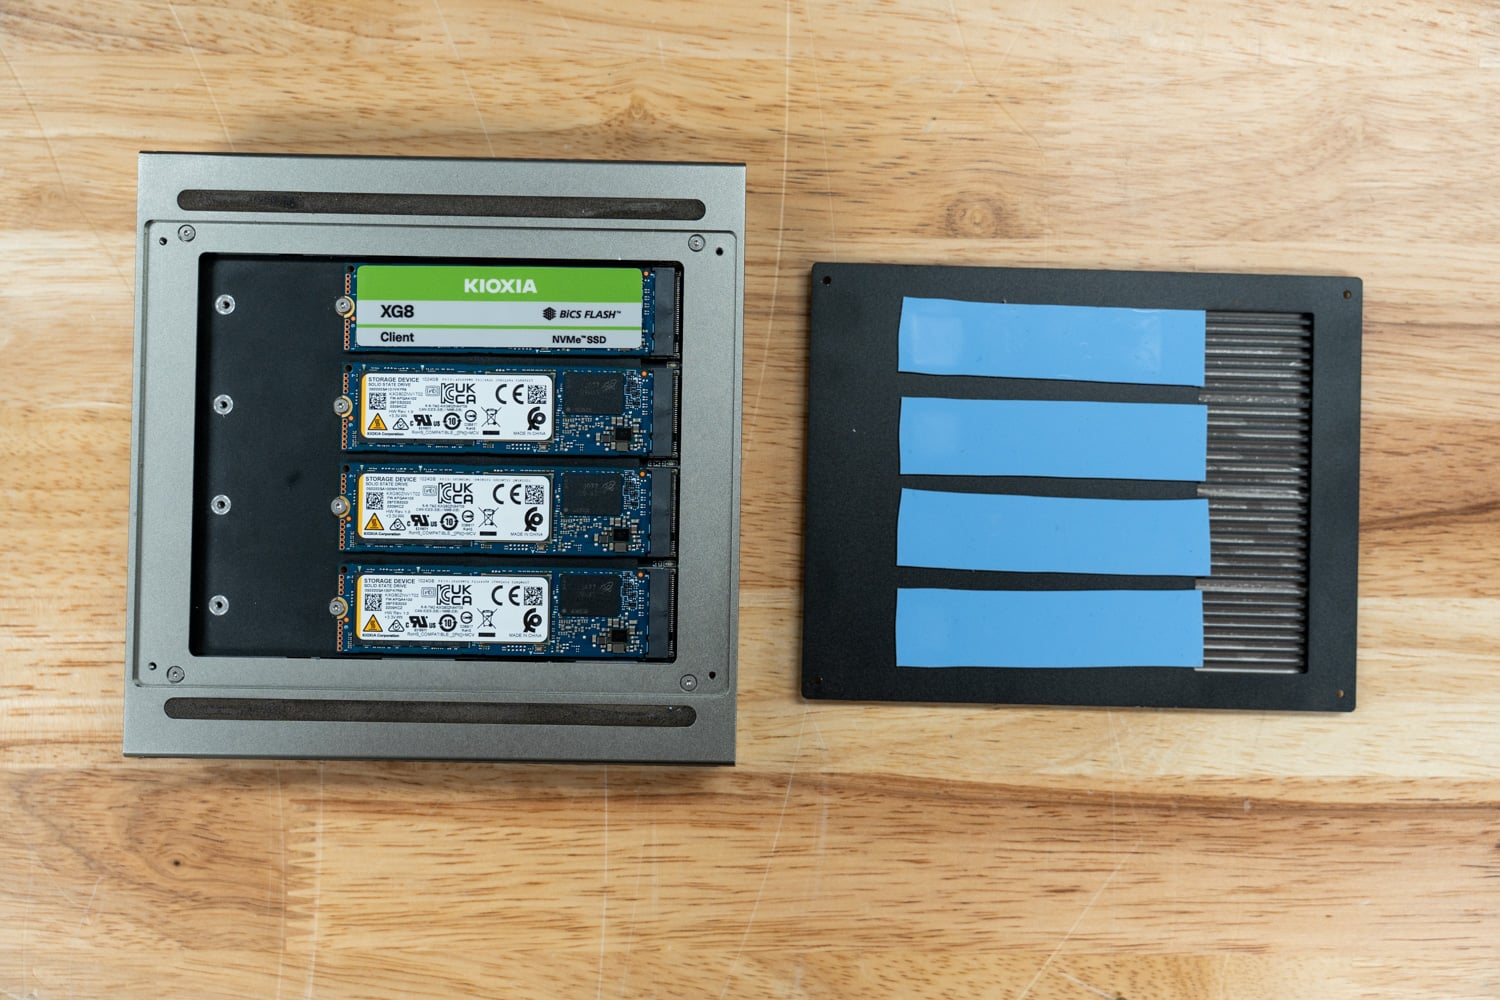
Otwórz górną pokrywę, a zobaczysz cztery zatoki M.2 ustawione w rzędzie, tutaj zapełnione naszymi dyskami testowymi KIOXIA XG8. Sama pokrywa chłodzi dysk: niebieskie podkładki termiczne na jej spodzie łączą każdy dysk SSD z żebrowanym radiatorem, który tworzy górną część obudowy. To czyste, pasywne rozwiązanie dla dysków klienckich, które nigdy nie są wykorzystywane w cyklach intensywnej pracy w przedsiębiorstwach.
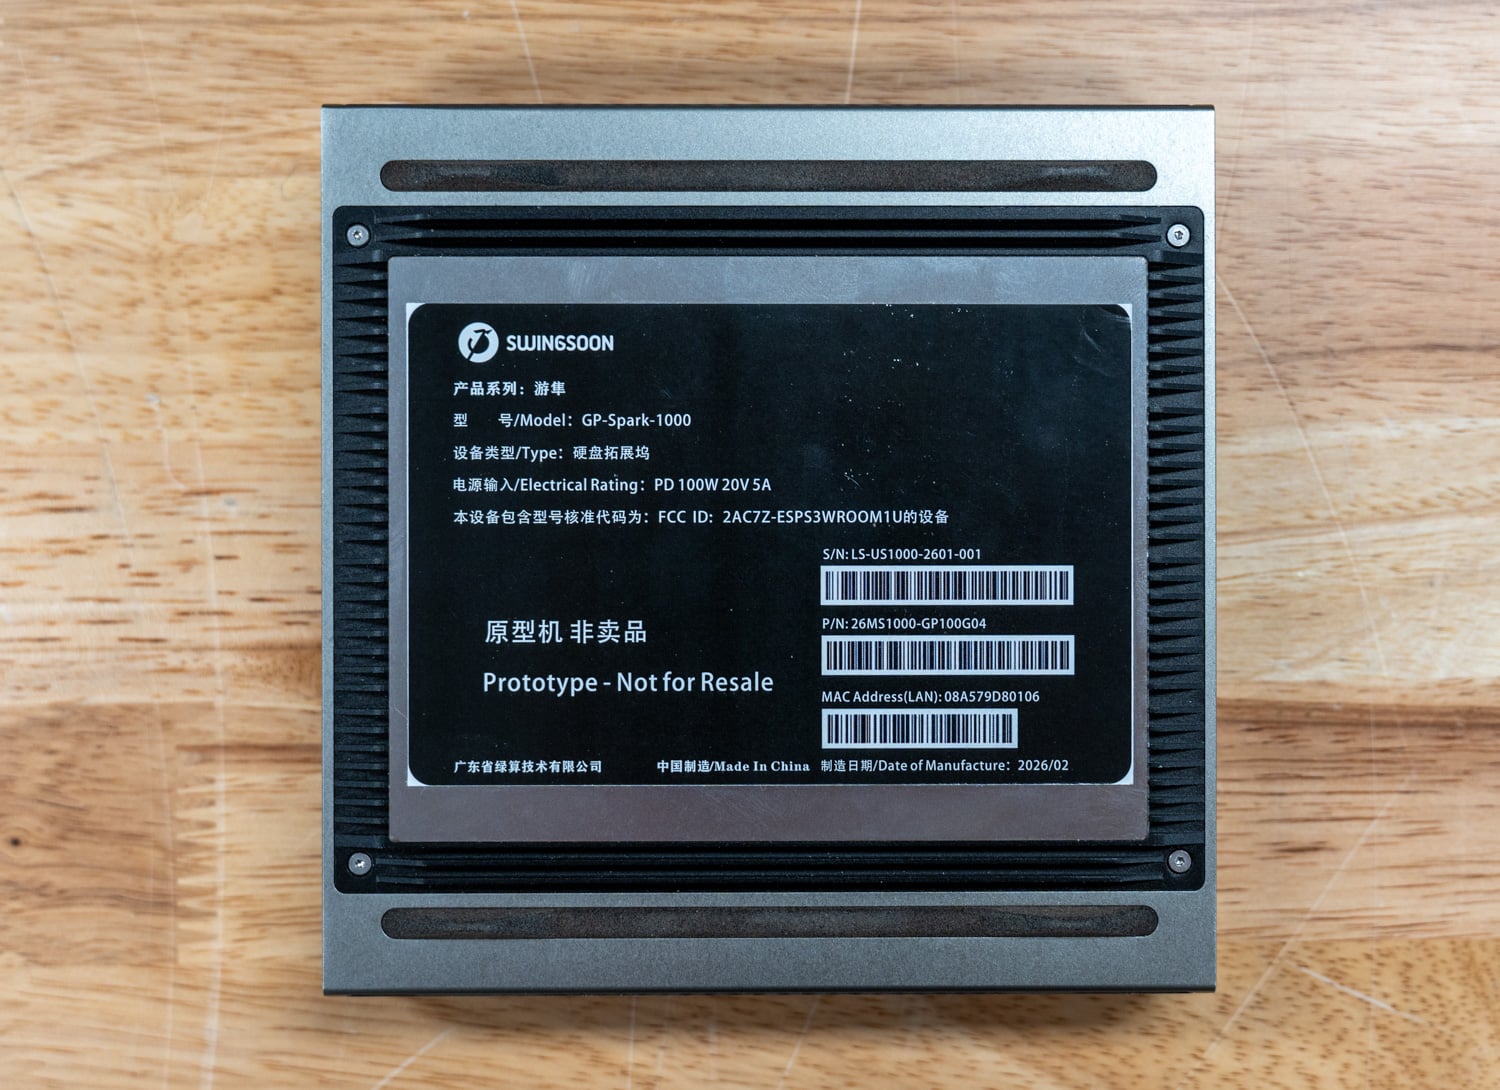
Zanim przejdziemy do liczb, mała informacja: nasze urządzenie jest prototypem. Na dolnej etykiecie widnieje napis GP-Spark-1000, co oznacza, że urządzenie jest prototypem, a nie przeznaczone do odsprzedaży, oraz data produkcji: luty 2026 r. pod marką Swingsoon, którą Luisuantech stosuje w sprzęcie. Egzemplarze produkcyjne mogą różnić się wyposażeniem i wykończeniem, jednak testowane przez nas zachowanie platformy to to, co Luisuantech wysyła dziś do recenzentów. Dwie dodatkowe uwagi dotyczące wrażeń z użytkowania po wyjęciu z pudełka. Nasze urządzenie zostało dostarczone z dwiema drukowanymi instrukcjami w całości w języku chińskim, a początkowa konfiguracja wydaje się być kierowana przez Wi-Fi. Żaden z nich nie stanowi przeszkody dla odbiorców, do których skierowane jest to urządzenie, ale premiera na Zachodzie będzie wymagała dokumentacji w języku angielskim.
Konfiguracja i architektura
Na pokładzie nie ma kontrolera RAID ani abstrakcji pamięci masowej: GP Spark to JBOF w dosłownym sensie, udostępniając każdy zainstalowany dysk SSD jako własną przestrzeń nazw NVMe-oF. W naszej konfiguracji cztery dyski były widoczne jako cztery urządzenia /dev/nvme na hoście. Nadmiarowość, czyli striping, jest zadaniem hosta. Specyfikacja producenta wymienia pojedynczy port 100 GbE o przepustowości 10 GB/s i 2.7 mln IOPS; raport produktu osobno wspomina o konfiguracjach 2x100 GbE i do 24 GB/s, co według Luisuantech jest łączną wartością odczytu i zapisu. W naszym urządzeniu i testach wykorzystaliśmy konfigurację z jednym portem.
Specyfikacja Luisuantech GP Spark
| Specyfikacja | Luisuantech GP Spark |
|---|---|
| Omówienie platformy | |
| wnęki na napędy | 4 x M.2 NVMe (2280 / 22110) Obsługiwane są pojemności mieszane, do 4 TB na dysk |
| Sieć | QSFP28 100GbE (DAC lub optyczny) Wymagane RDMA |
| protokoły | NVMe-oF RDMA Bezpośrednie przechowywanie danych GPU (GDS) |
| Wydajność (określona przez dostawcę) | |
| Wydajność | 10 GB/s na port 100 GbE Łączna prędkość odczytu i zapisu do 24 GB/s |
| IOPS | 2.7M |
| Opóźnienie dostępu | Mniej niż 20 mikrosekund |
| Moc i Fizyczność | |
| Zasilanie | Łącznie poniżej 100 W Zewnętrzny adapter USB-C PD 20 V/5.4 A |
| Wymiary | 150 mm x 150 mm x 26 mm (0.58 dł.) |
| temperatura robocza | 0 do 40C |
| zgodność | NVIDIA® DGX Spark® Stacja DGX Stacje robocze i serwery z kartami sieciowymi obsługującymi RDMA |
Wydajność
W naszej konfiguracji testowej połączyliśmy GP Spark z GIGABYTE DGX Spark przez bezpośrednie połączenie 100 GbE, a cztery dyski SSD KIOXIA XG8 NVMe o pojemności 1 TB zainstalowaliśmy w zatokach. Należy pamiętać, że wybrane dyski będą miały znaczący wpływ na mierzoną wydajność. Wykorzystaliśmy dyski SSD Gen5 dla klientów; niektóre modele, zwłaszcza dyski SSD klasy korporacyjnej, mogą oferować wyższą, stałą wydajność zapisu. Przeprowadziliśmy skanowanie FIO dla losowych obciążeń 4K i 64K oraz sekwencyjnych obciążeń 1M, odczytu i zapisu, steppingu iodepth i numjobs, aby odwzorować pełną obwiednię. Wyniki odzwierciedlają ostateczny test po zastosowaniu wskazówek Luisuantech dotyczących MTU, które poprawiły zachowanie transferu w porównaniu z naszymi początkowymi testami.
Losowa wydajność 4K
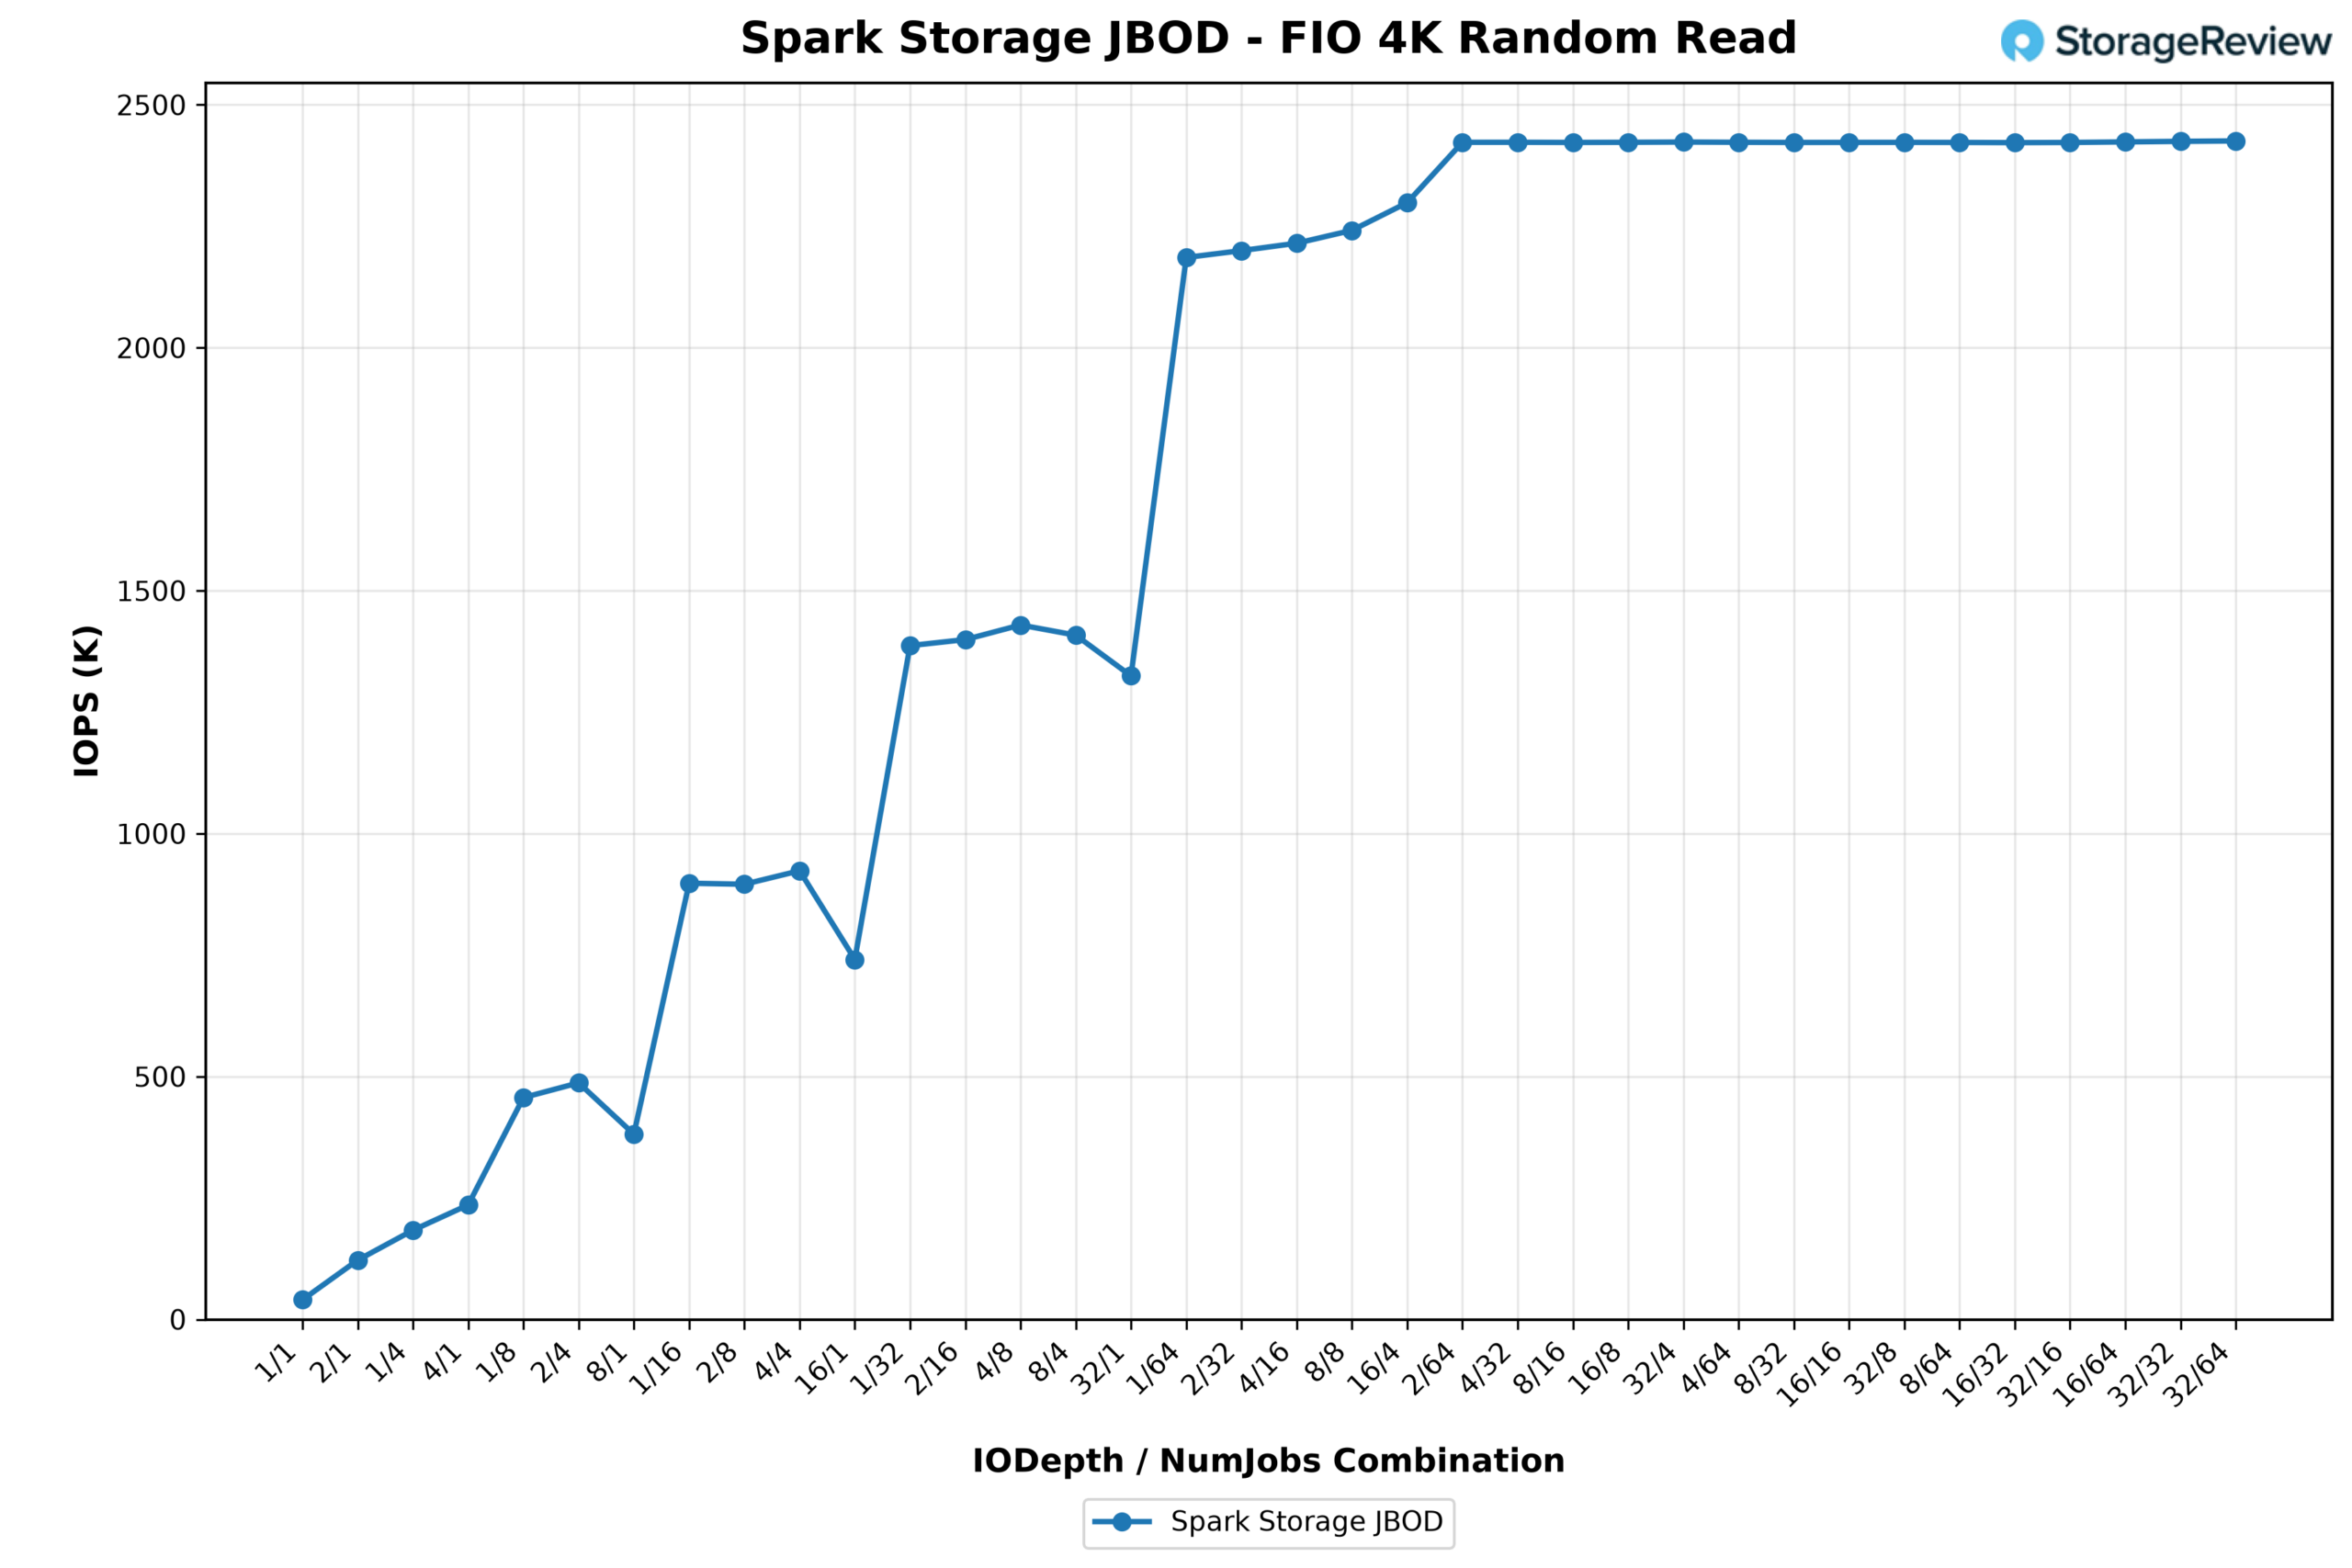
Odczyty małych bloków to właśnie tam, gdzie silnik odciążający pokazuje swoją wartość. Losowe odczyty 4K skalowane wraz z głębokością kolejki do szczytu 2.43 mln IOPS przy 9,475 MiB/s, w zasięgu deklarowanych przez dostawcę 2.7 mln, skutecznie nasycając łącze 100GbE transferami 4K. Jak na pasywnie zasilaną, czterozatokową skrzynkę obsługującą system AI przy biurku, jest to imponujący wynik.
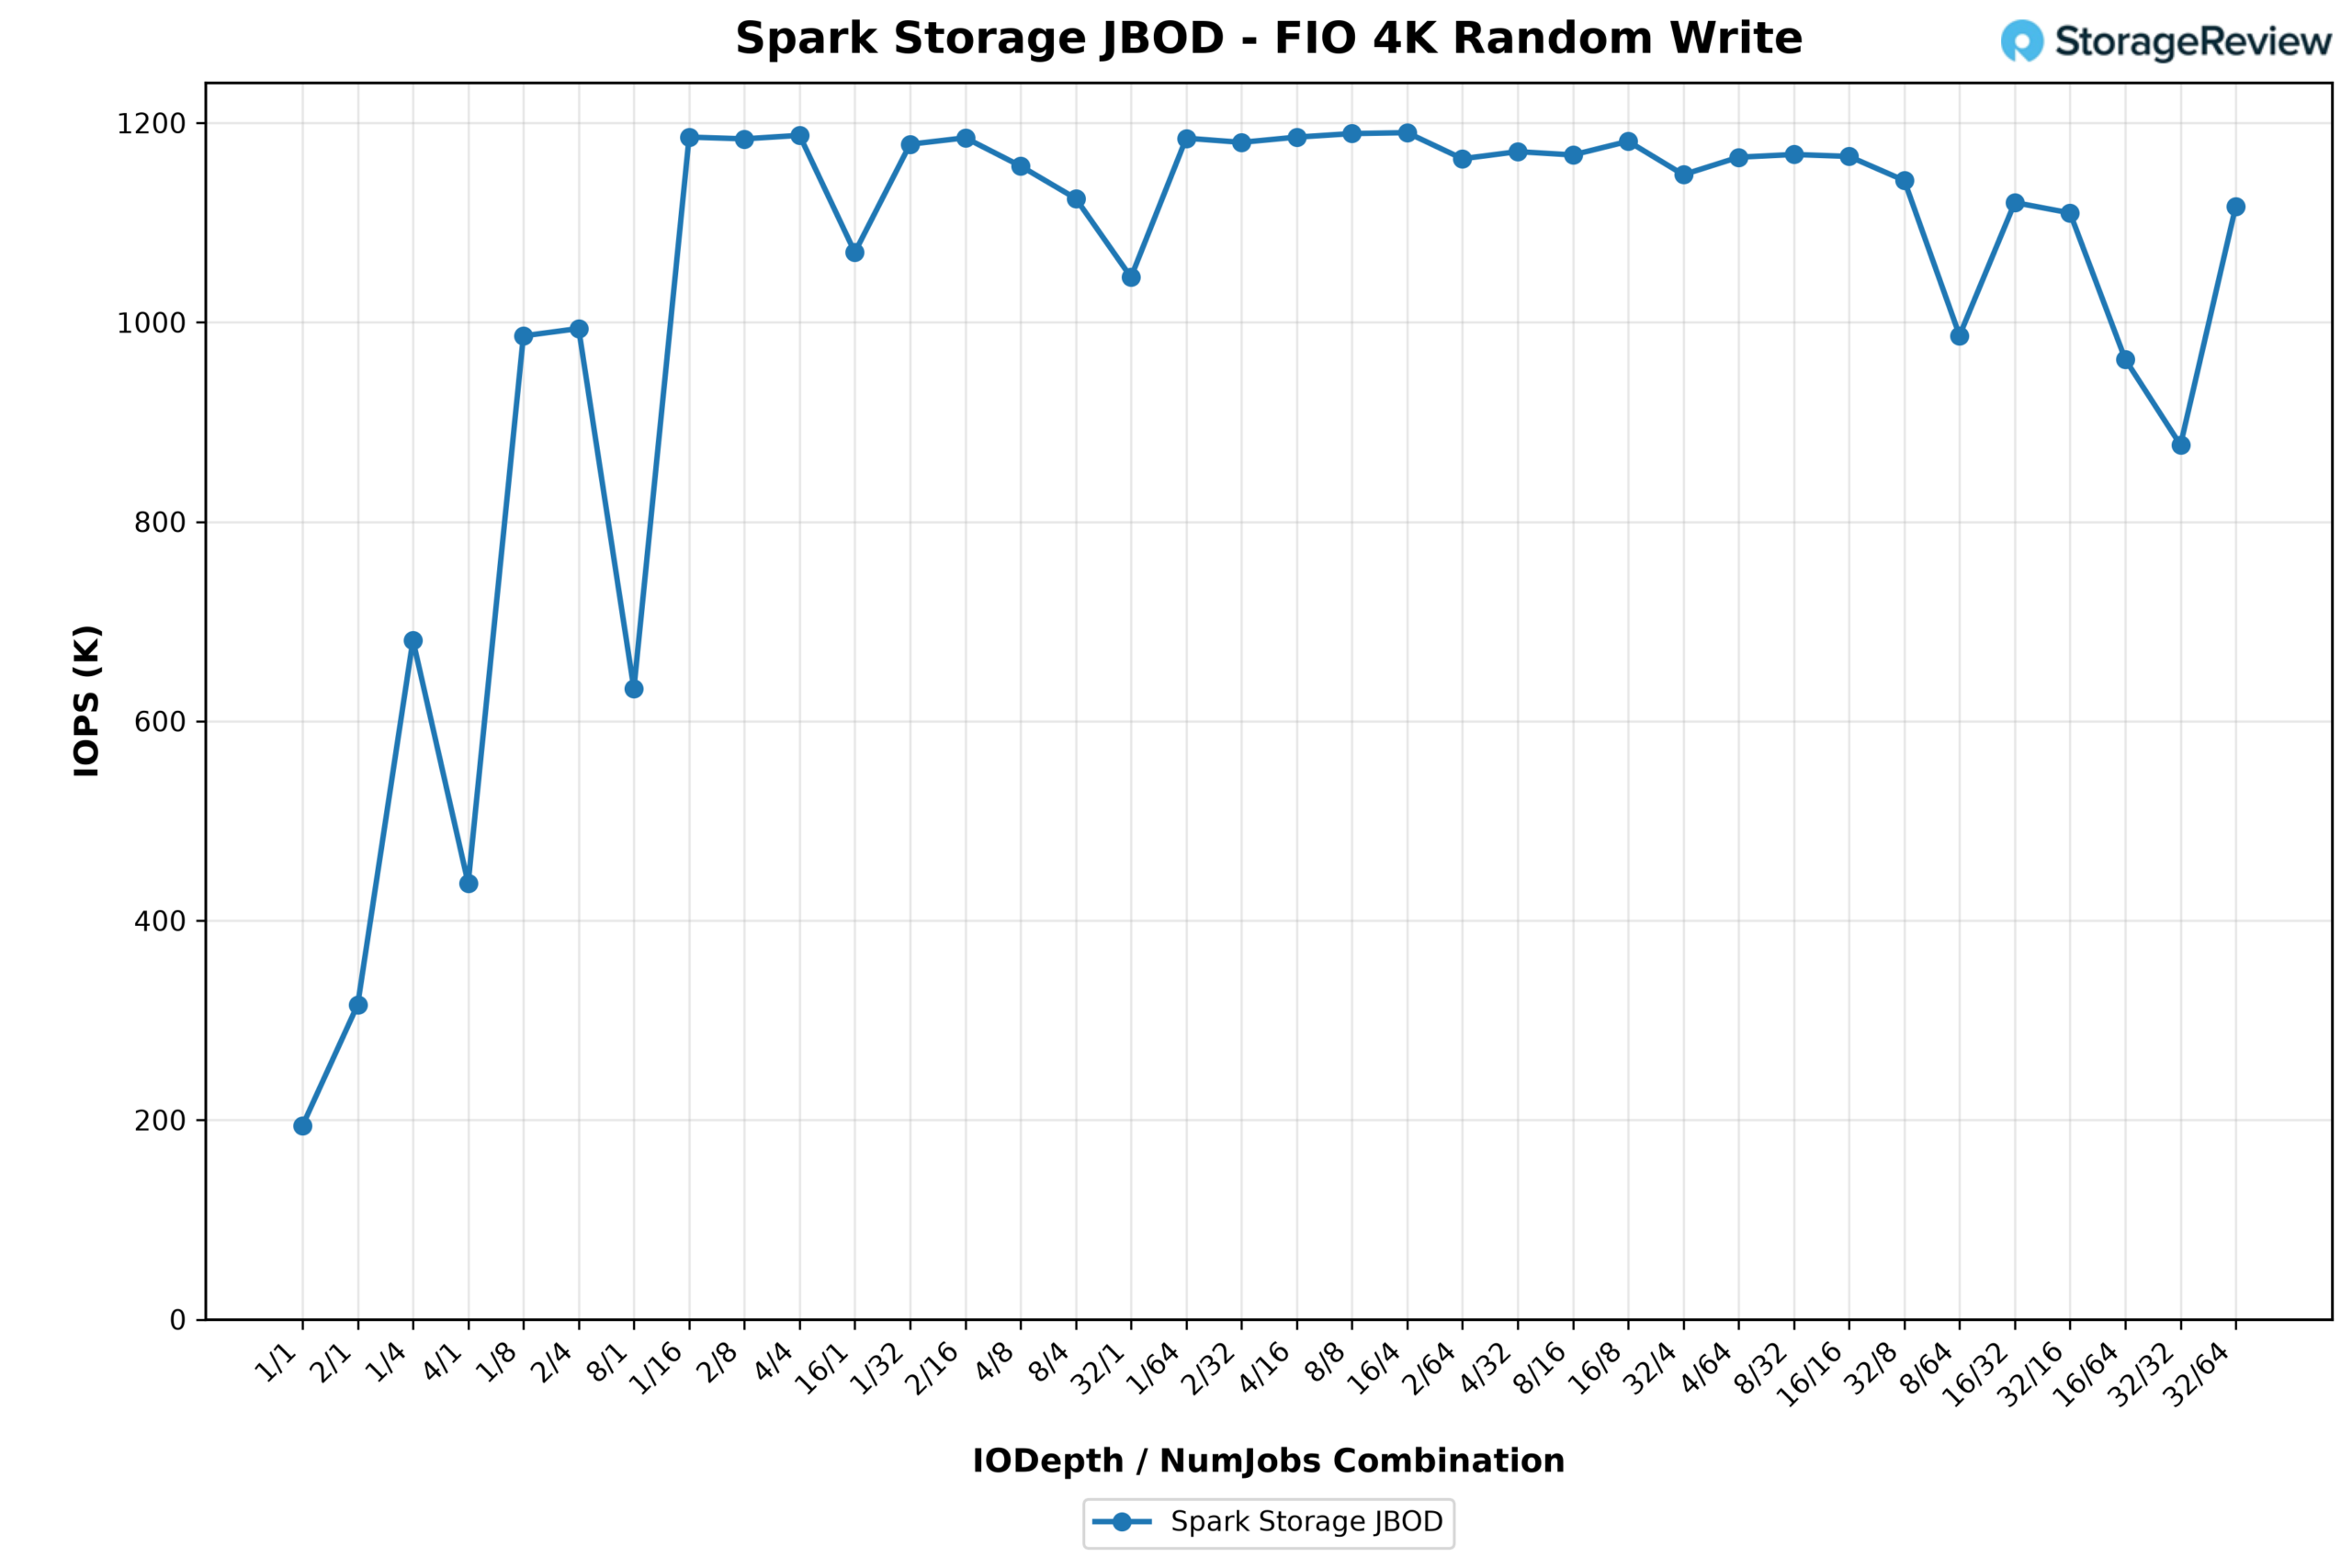
Zapisy przebiegają w ten sam sposób mniej więcej w połowie wysokości, osiągając szczyt na poziomie 1.19 miliona IOPS. Różnica między limitami odczytu i zapisu jest stała dla każdego uruchomionego przez nas obciążenia. Wydajność jest bezpośrednio związana z dyskami bazowymi, więc uzyskane wyniki będą się różnić w zależności od konfiguracji.
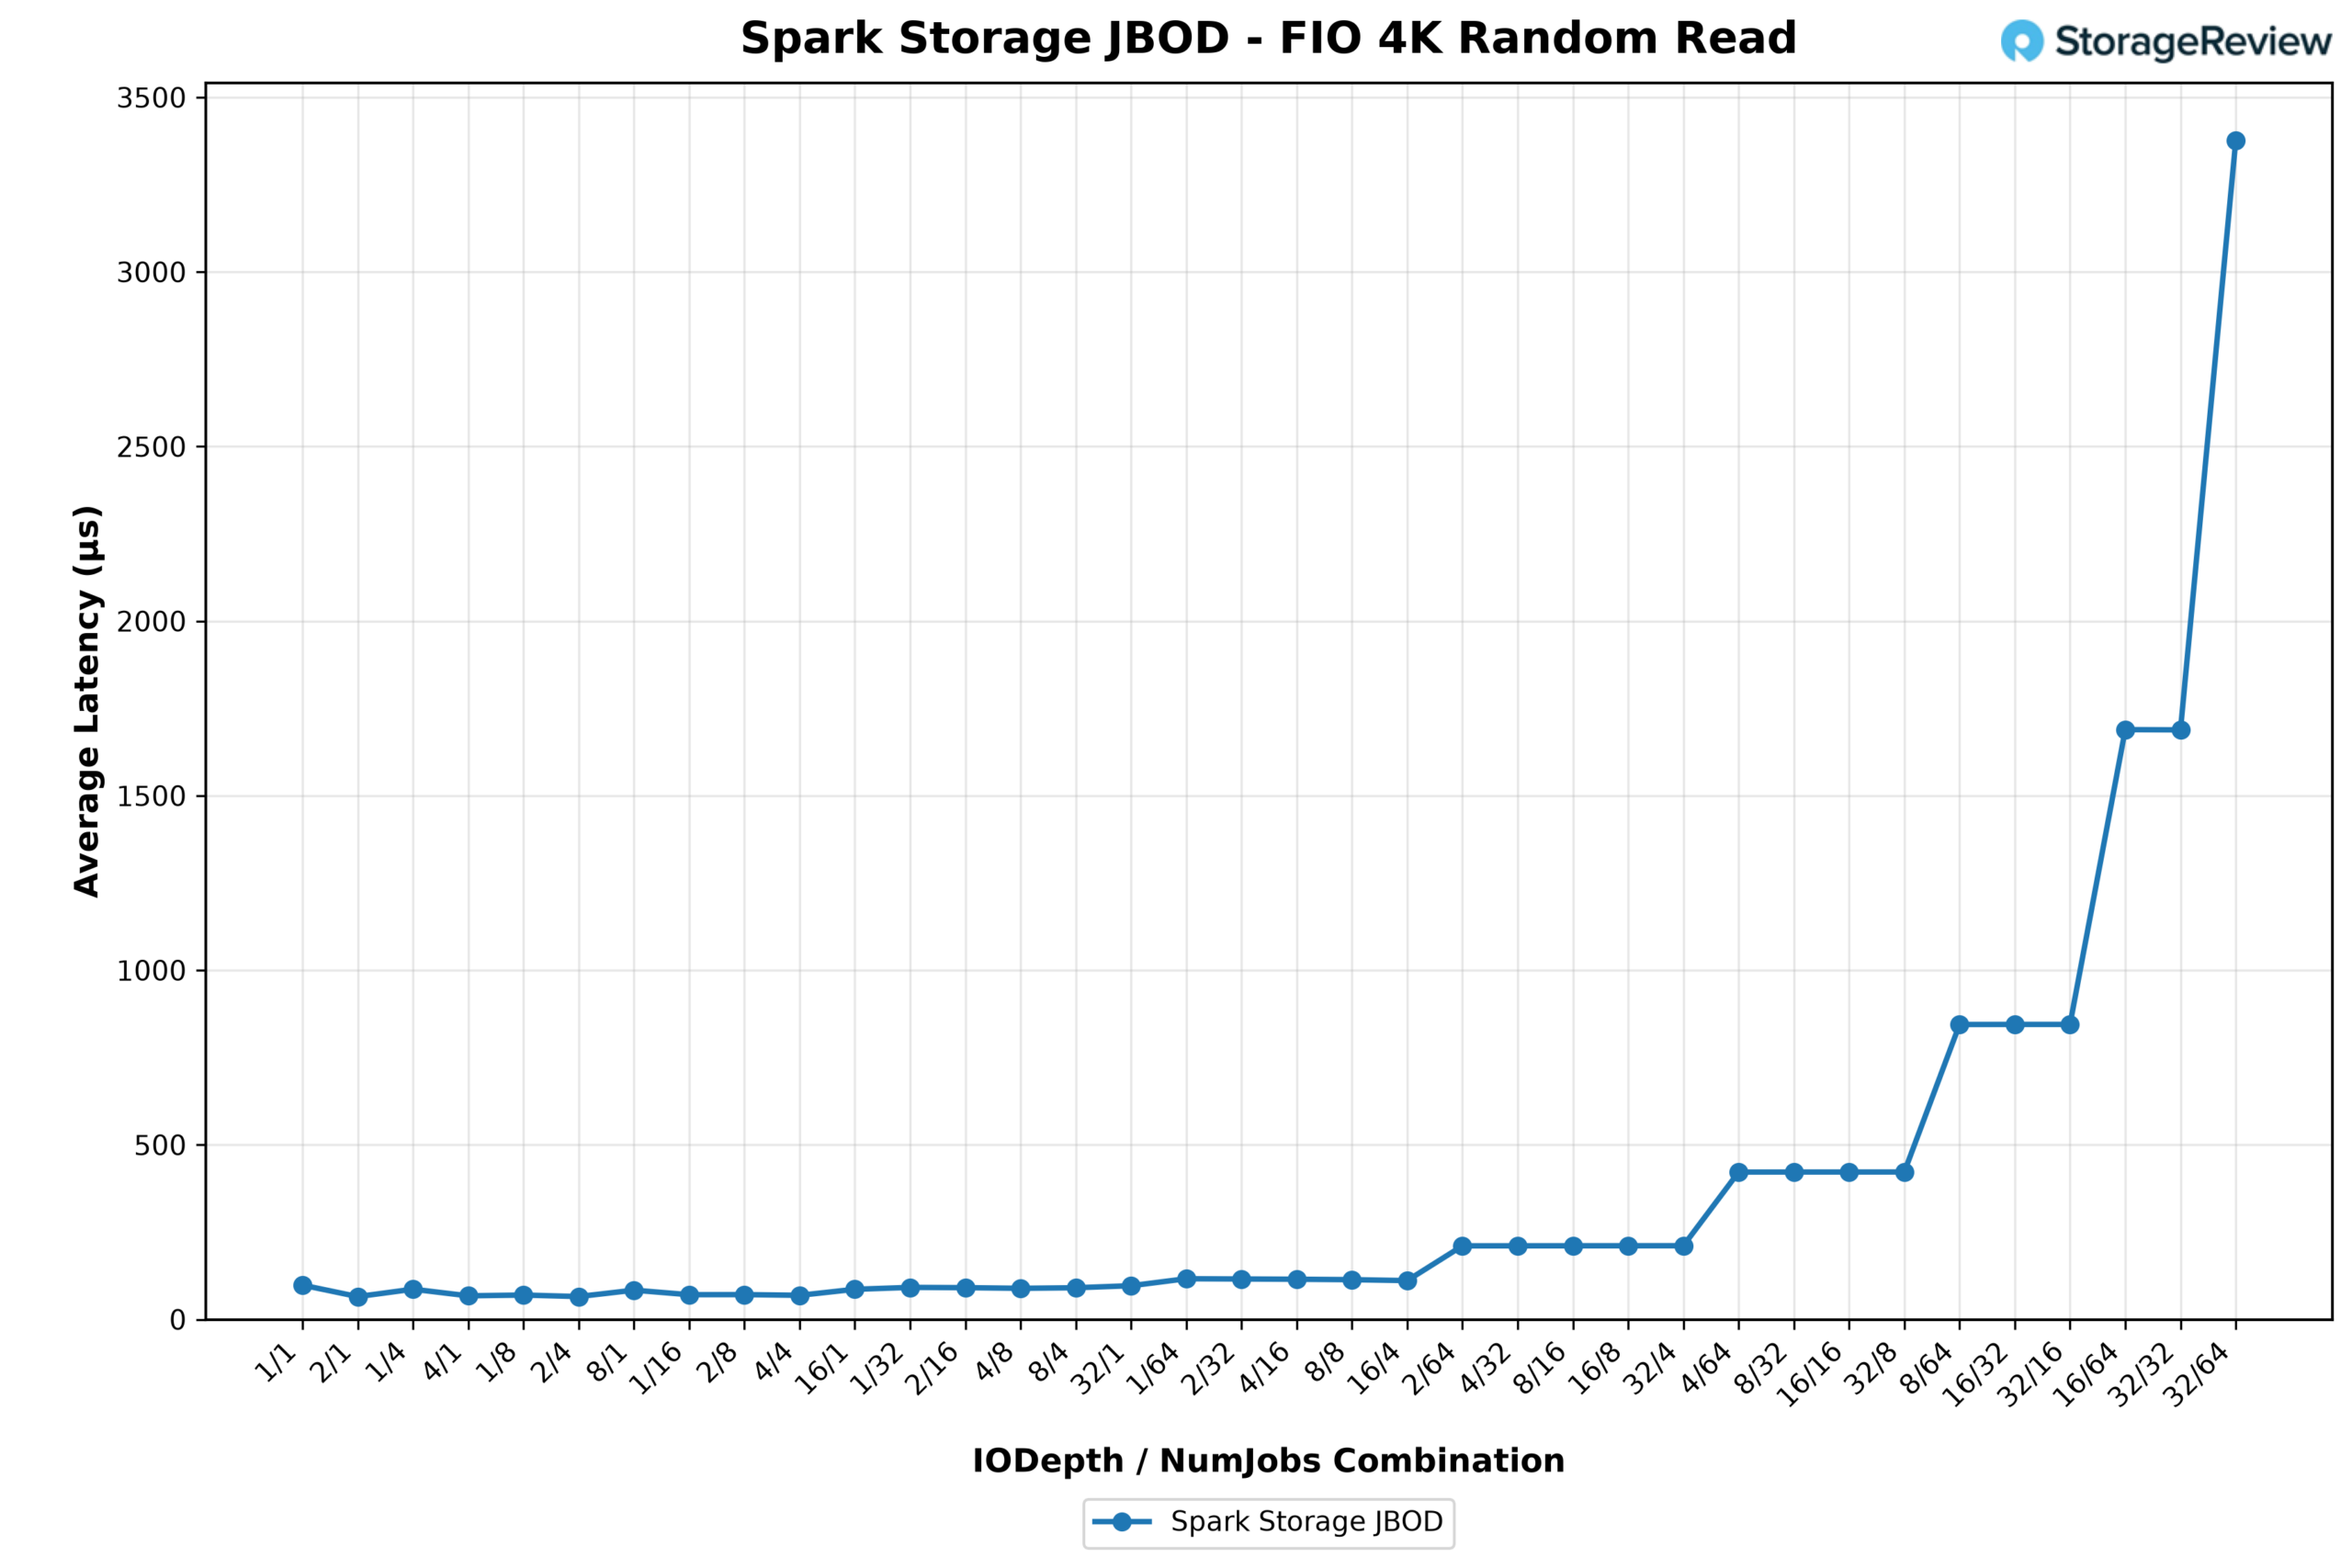
Opóźnienie odczytu osiąga średnio 65.3 mikrosekundy przy niskiej głębokości kolejki. Jest to wartość wyższa niż deklarowana przez dostawcę wartość poniżej 20 mikrosekund, ale wyniki będą się różnić w zależności od wybranego dysku i konfiguracji sieci. W przypadku transmisji w obie strony w sieci, opóźnienie pozostaje na stałym i przewidywalnym poziomie aż do momentu nasycenia łącza.
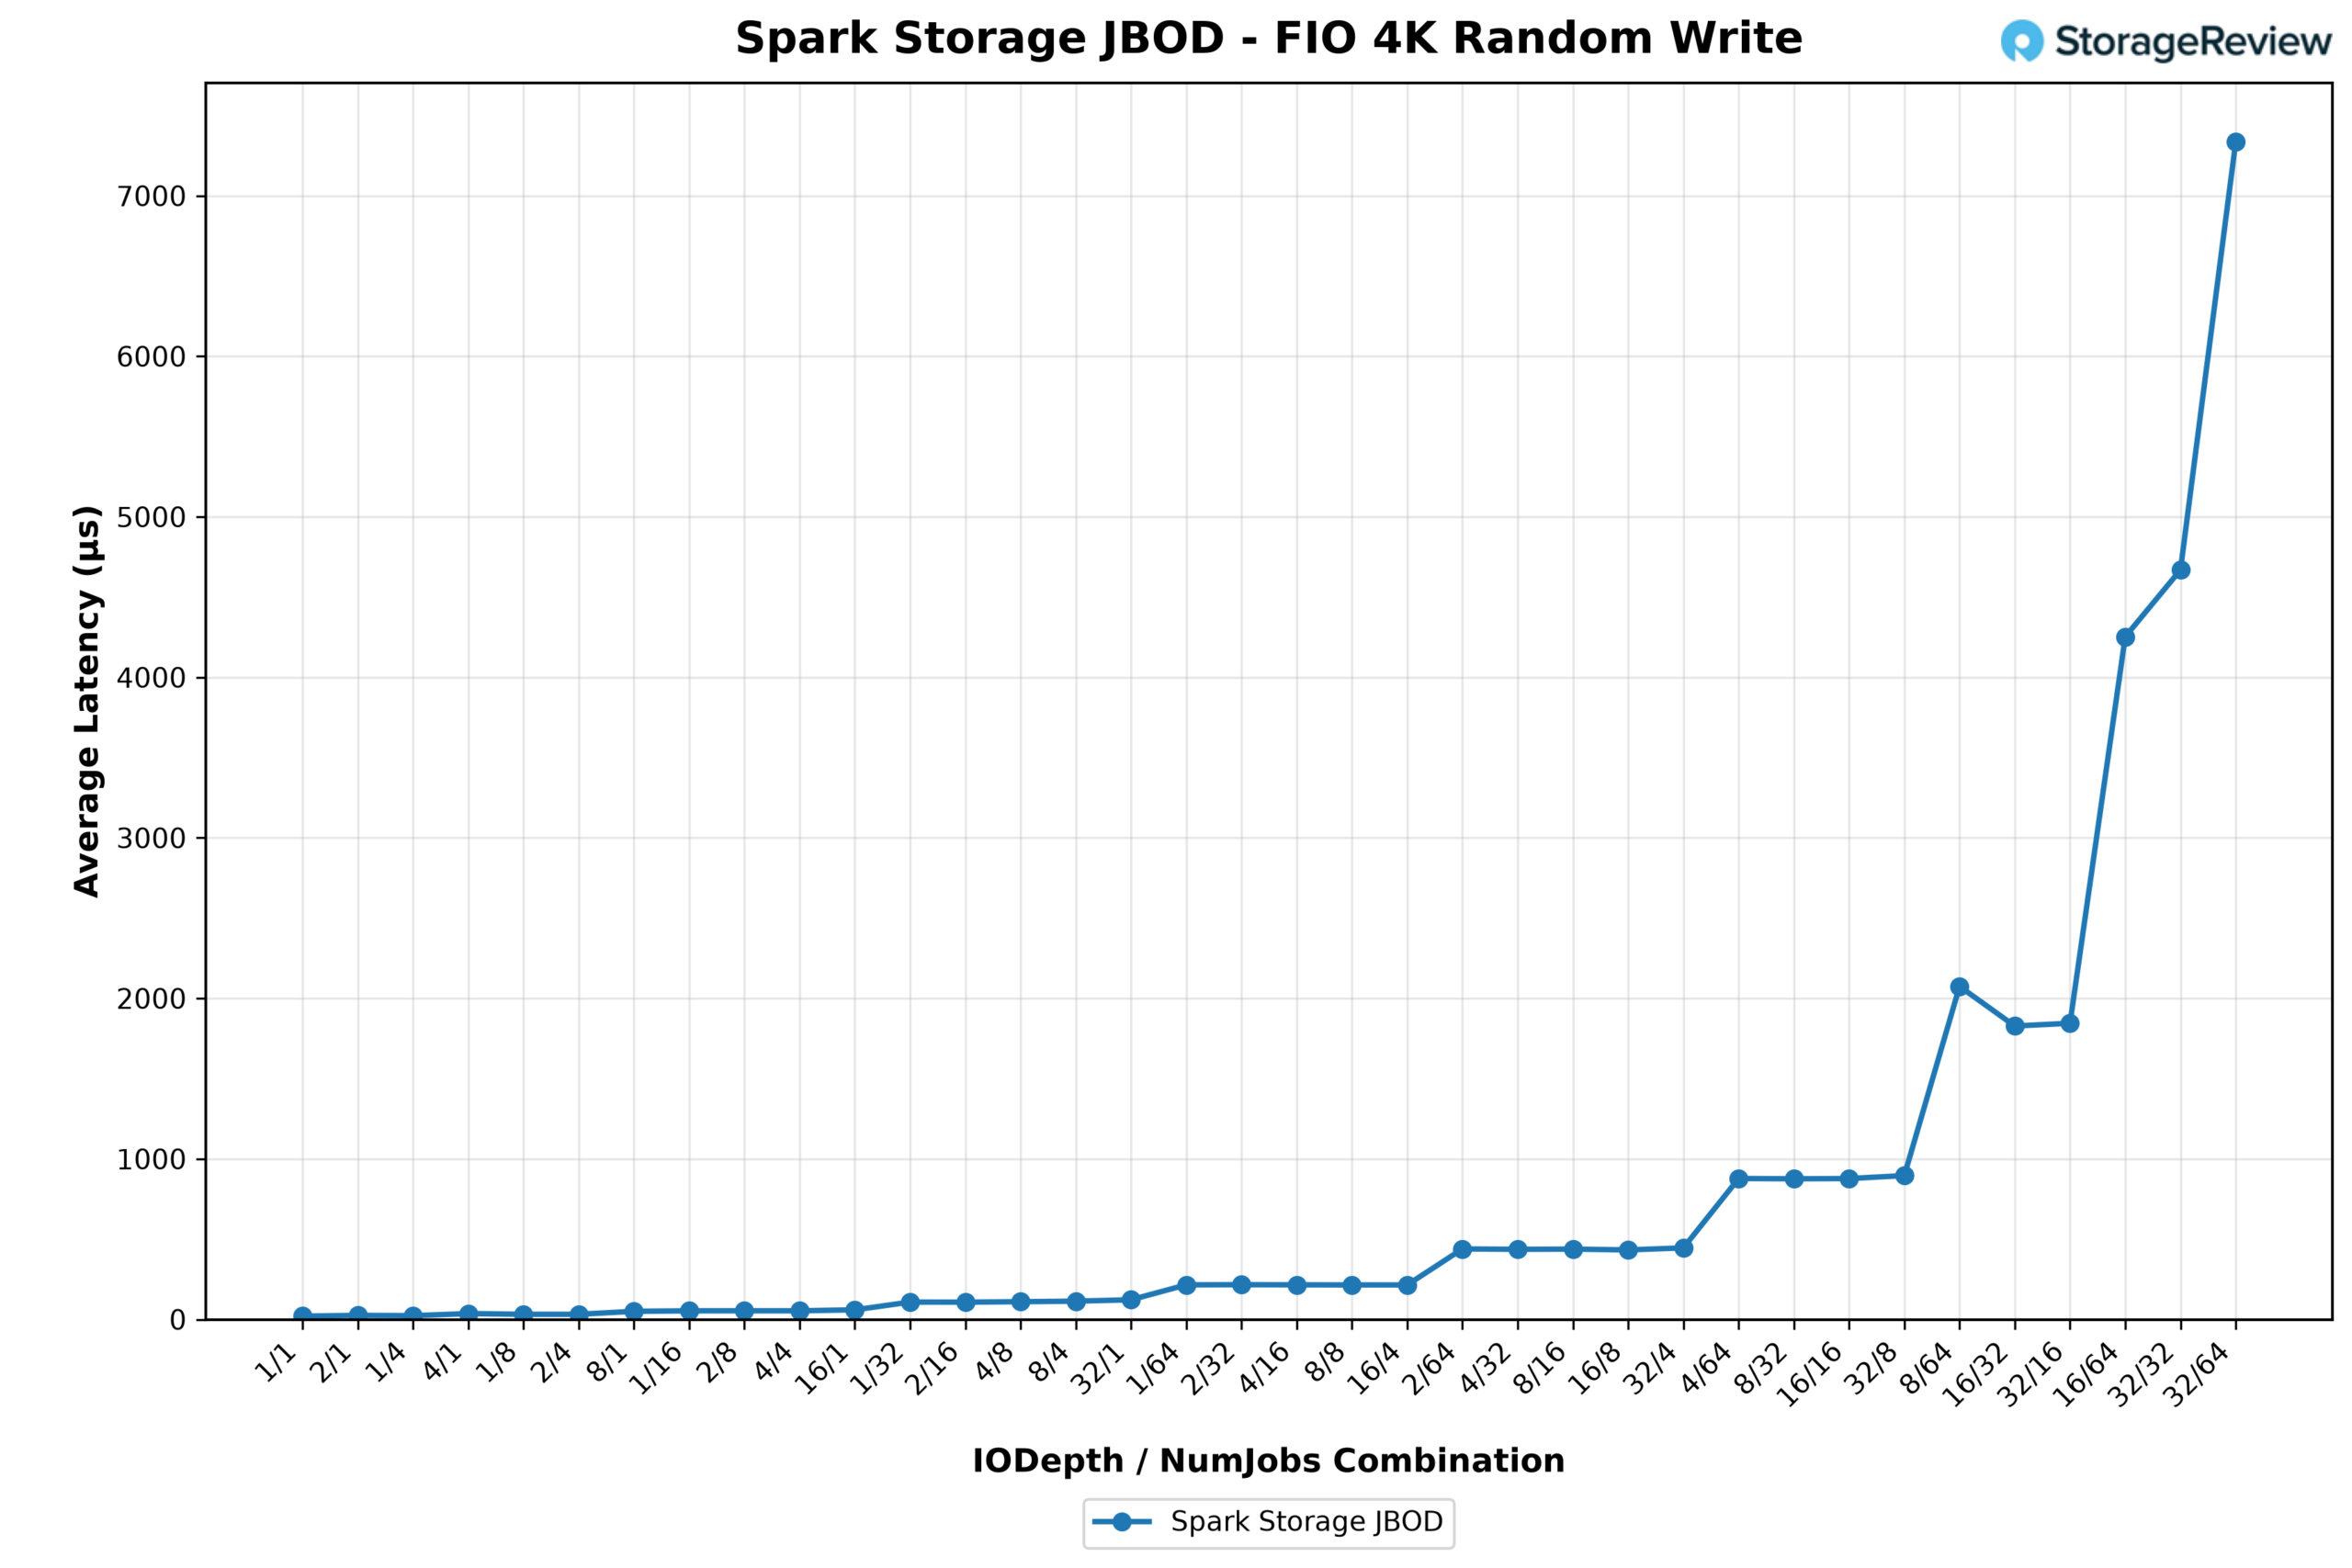
Jedynym parametrem podanym w specyfikacji jest opóźnienie zapisu: średnio 20.4 mikrosekundy przy minimalnej głębokości, czyli dokładnie tyle, co podawane przez dostawcę poniżej 20 mikrosekund, i jest to wartość na tyle niska, że struktura jest praktycznie niewidoczna dla aplikacji.
Losowa wydajność 64K
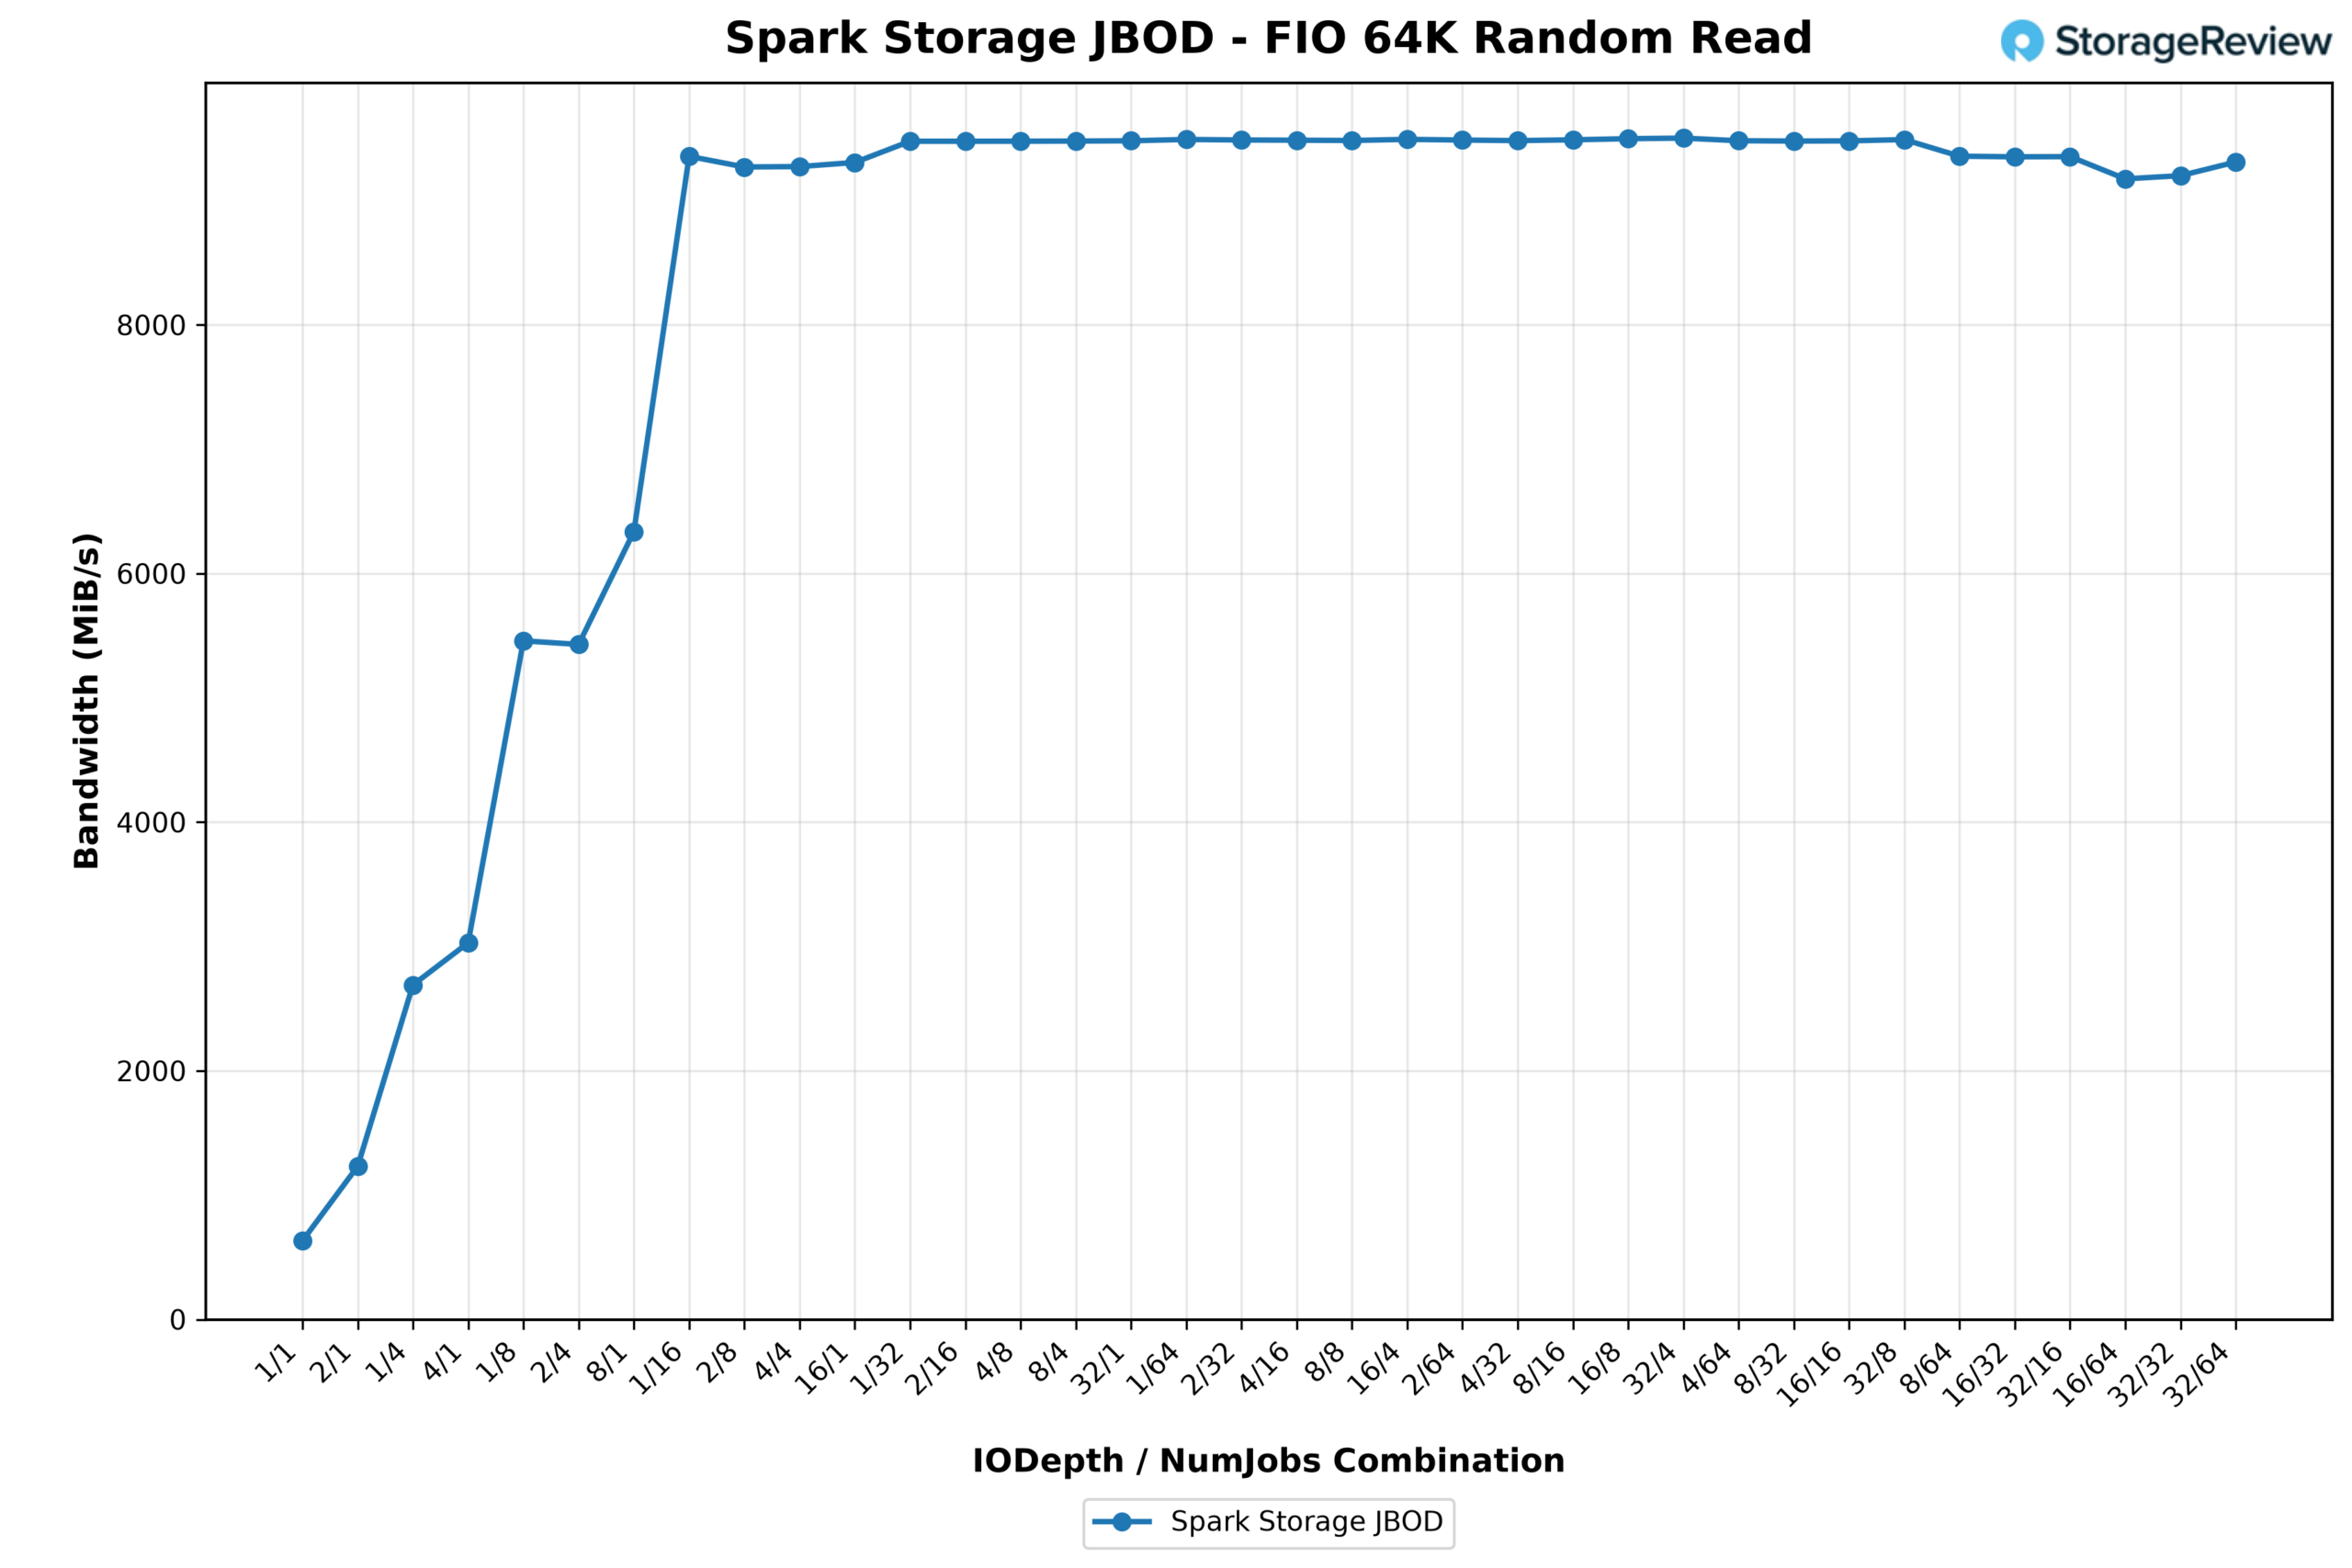
Przy 64 KB sprawa sprowadza się wyłącznie do przepustowości. Odczyty losowe osiągają 9,503 MiB/s w szczytowym momencie, statystycznie identycznie jak limity 4 KB i 1 MB. Niezależnie od rozmiaru bloku, jaki niesie ze sobą obciążenie, GP Spark zapewnia tę samą odpowiedź: pełną przepustowość łącza portu 100 GbE.
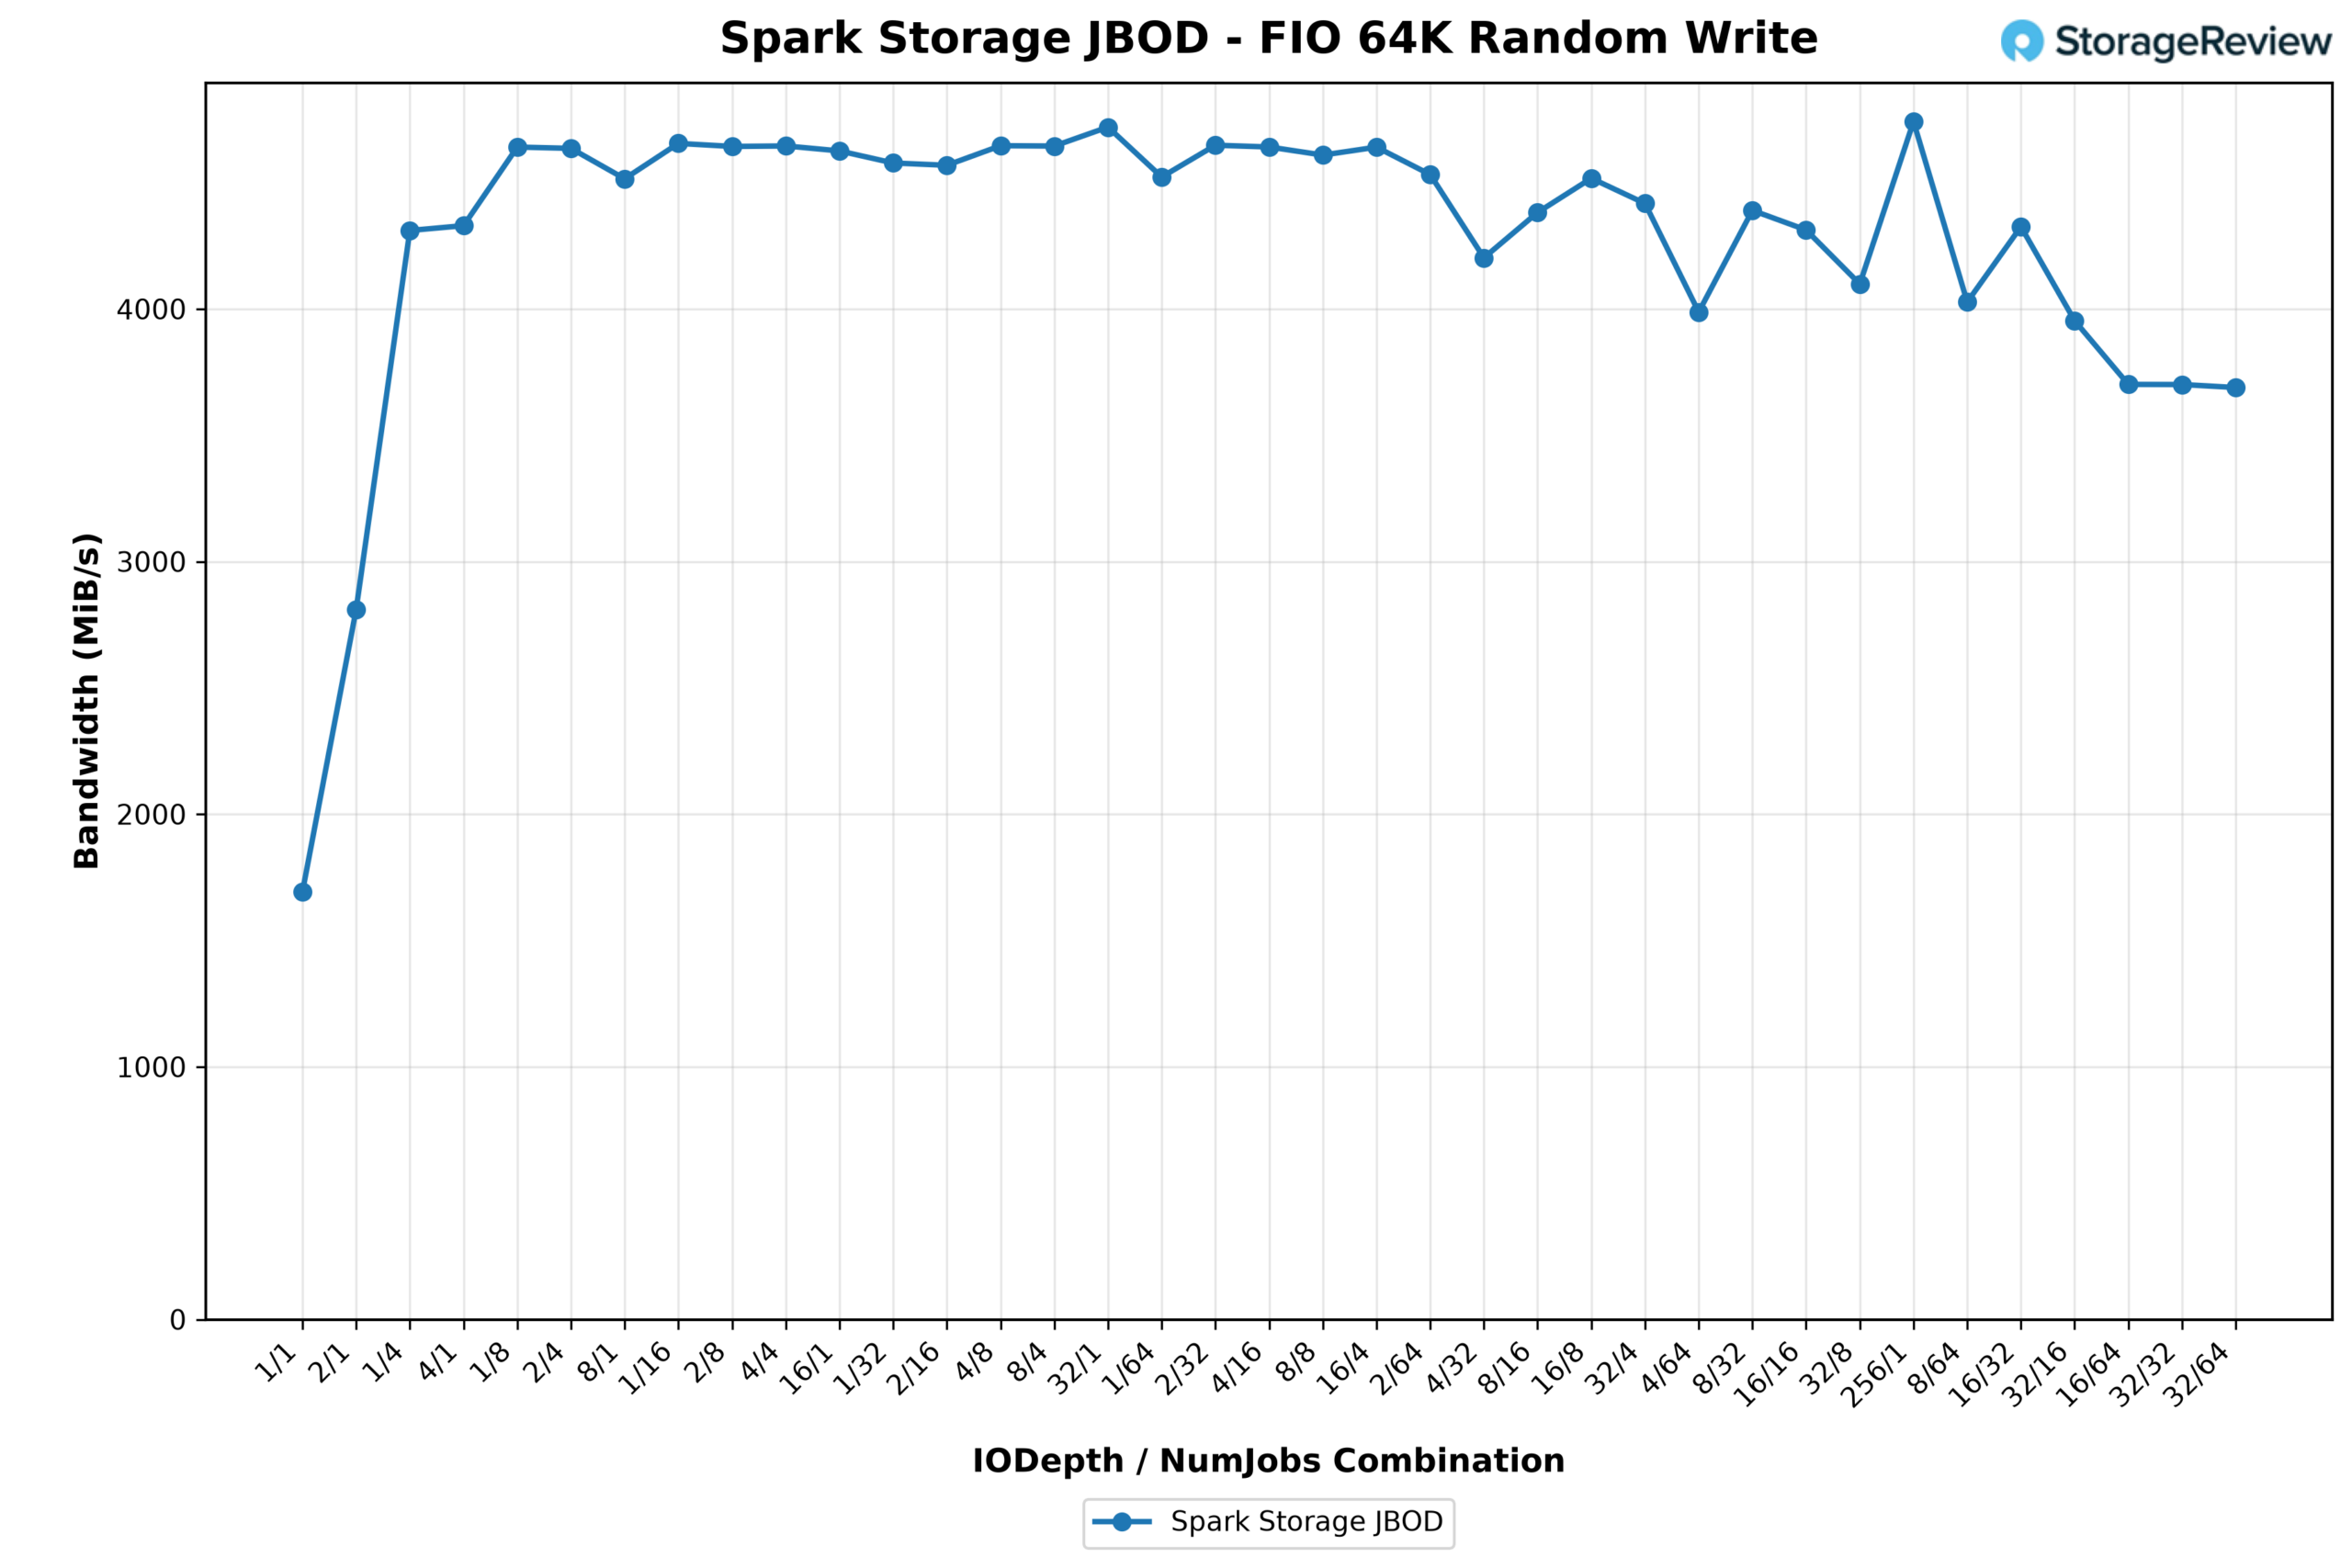
Prędkość losowego zapisu 64 tys. bloków osiągnęła poziom 4,742 MiB/s, czyli taki sam pułap, jaki zmierzyliśmy przy każdym innym rozmiarze bloku.
1M Sekwencyjna wydajność
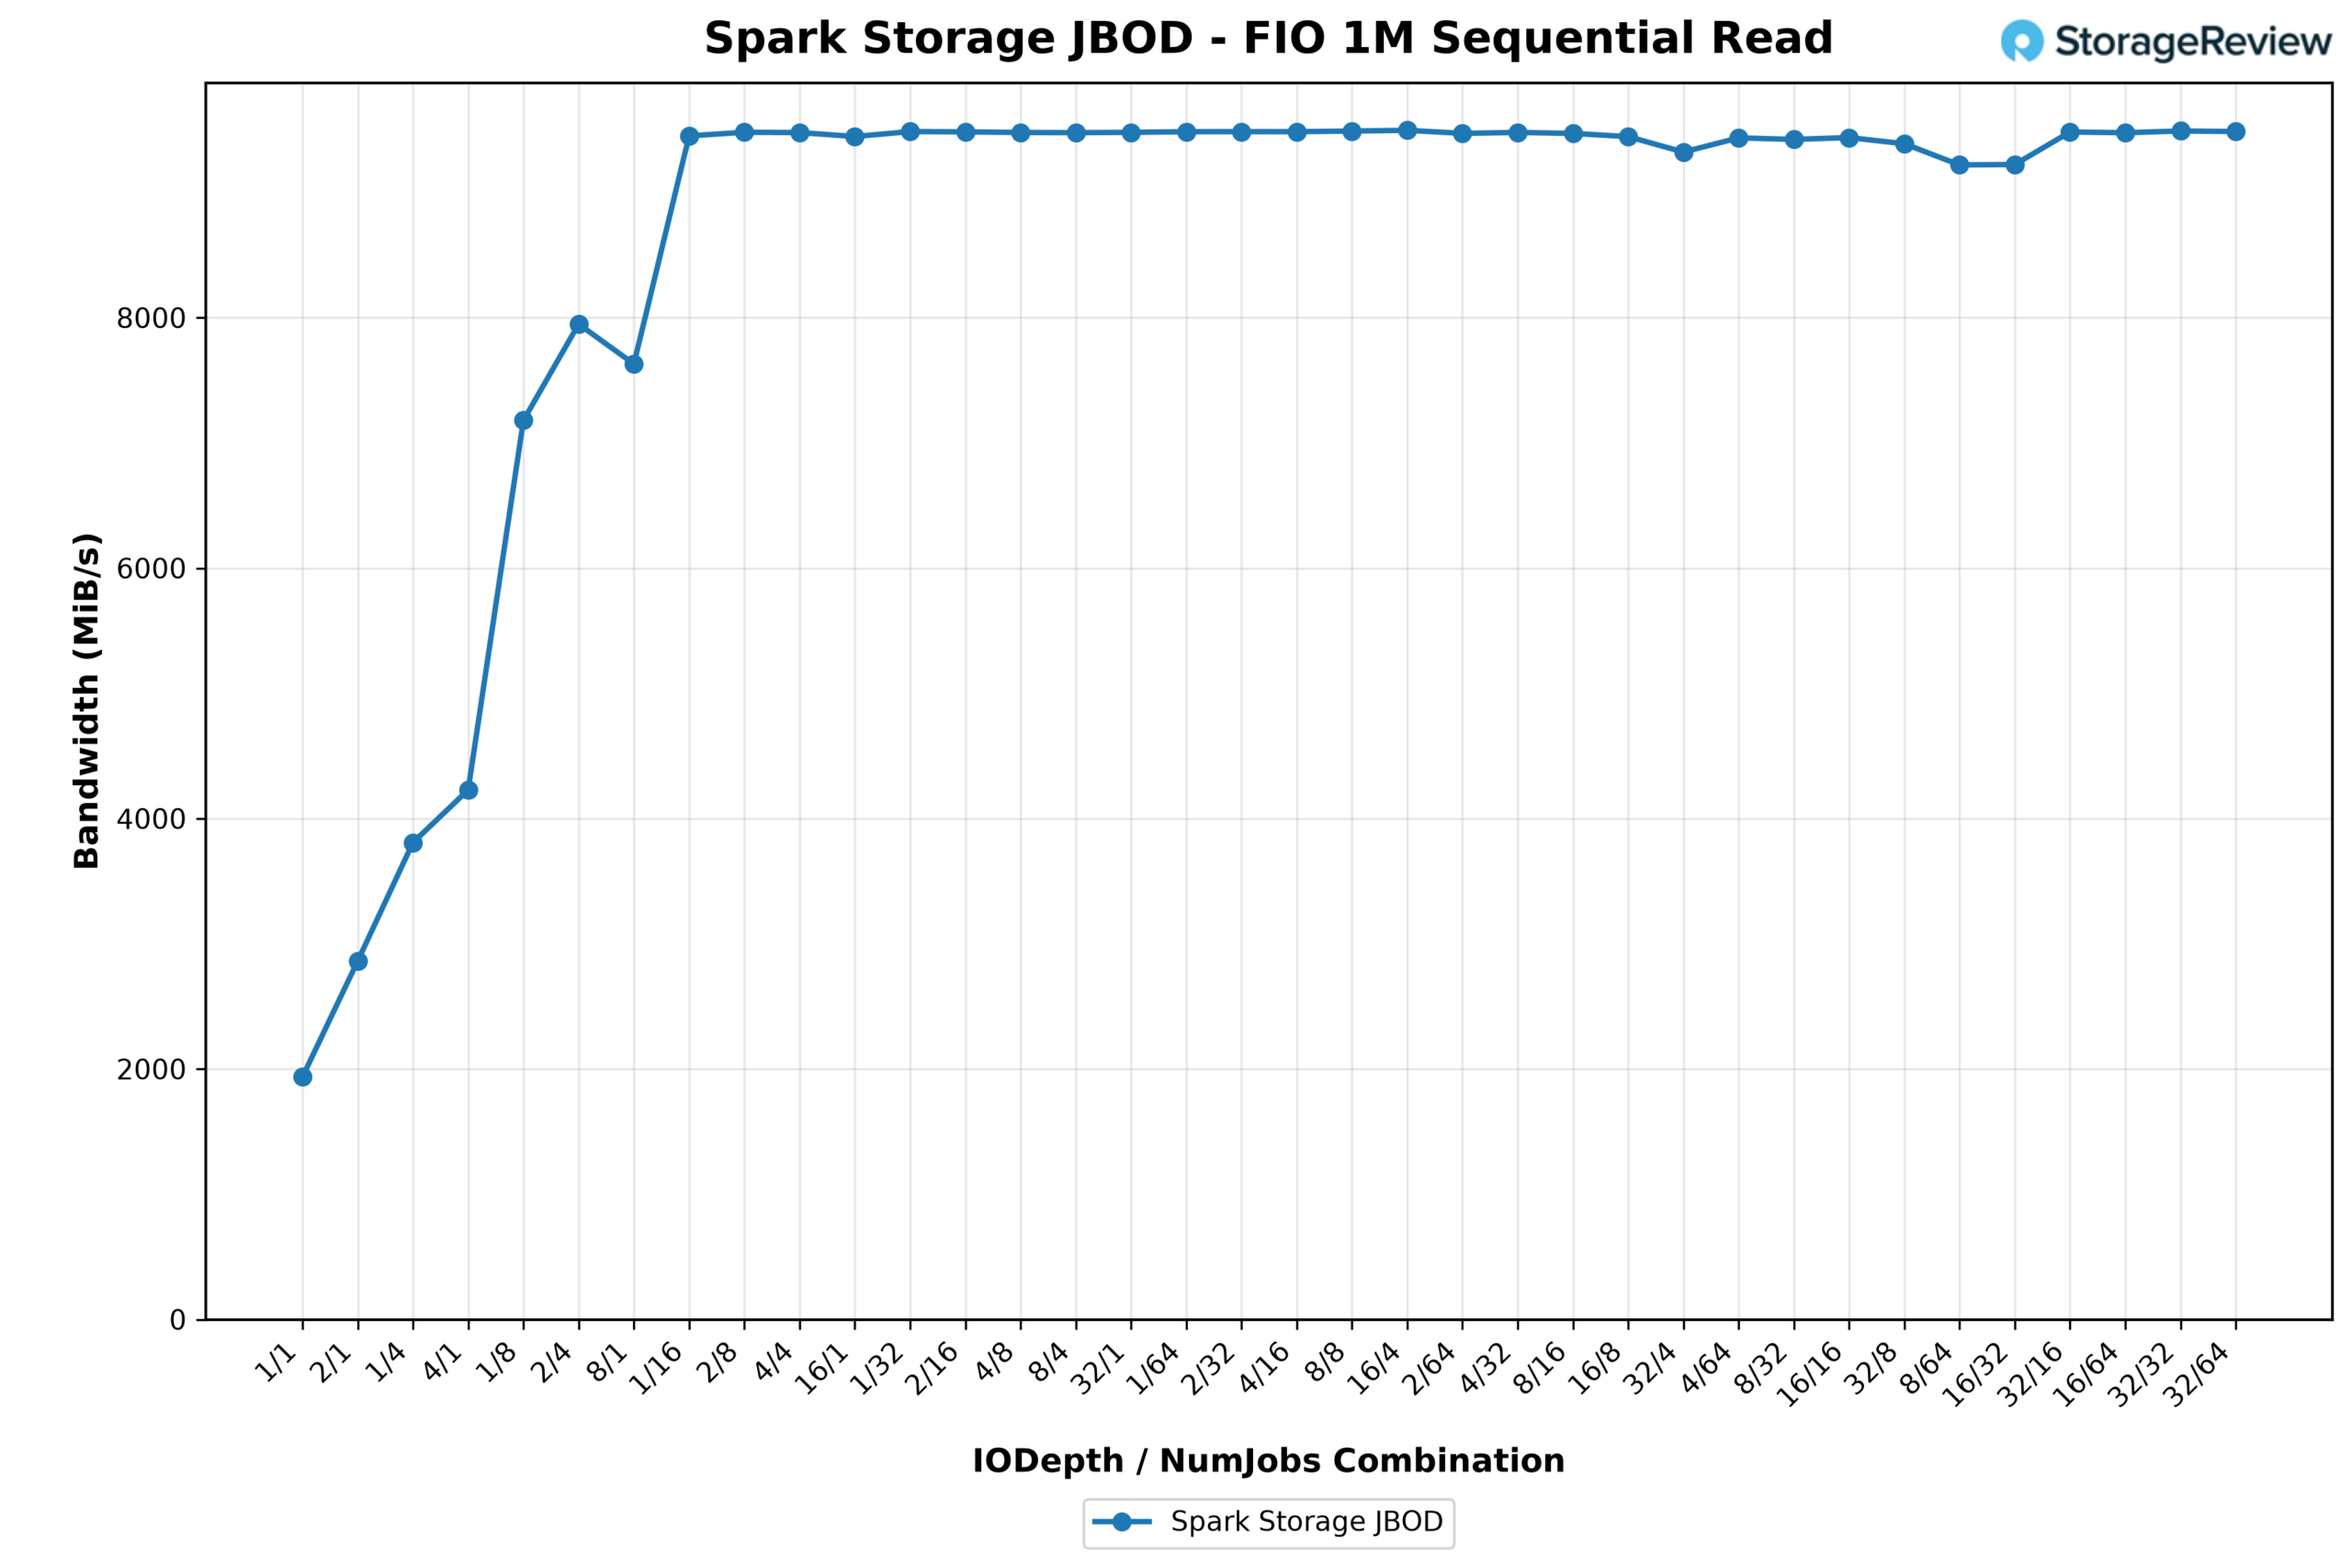
Sekwencyjne odczyty dużych bloków, profil ładowania modelu i strumieniowania zbiorów danych, osiągają 9,496 MiB/s i utrzymują się na tym poziomie od niewielkich głębokości kolejek. To właśnie dla takiego obciążenia istnieje GP Spark i działa on w trybie ciągłym.
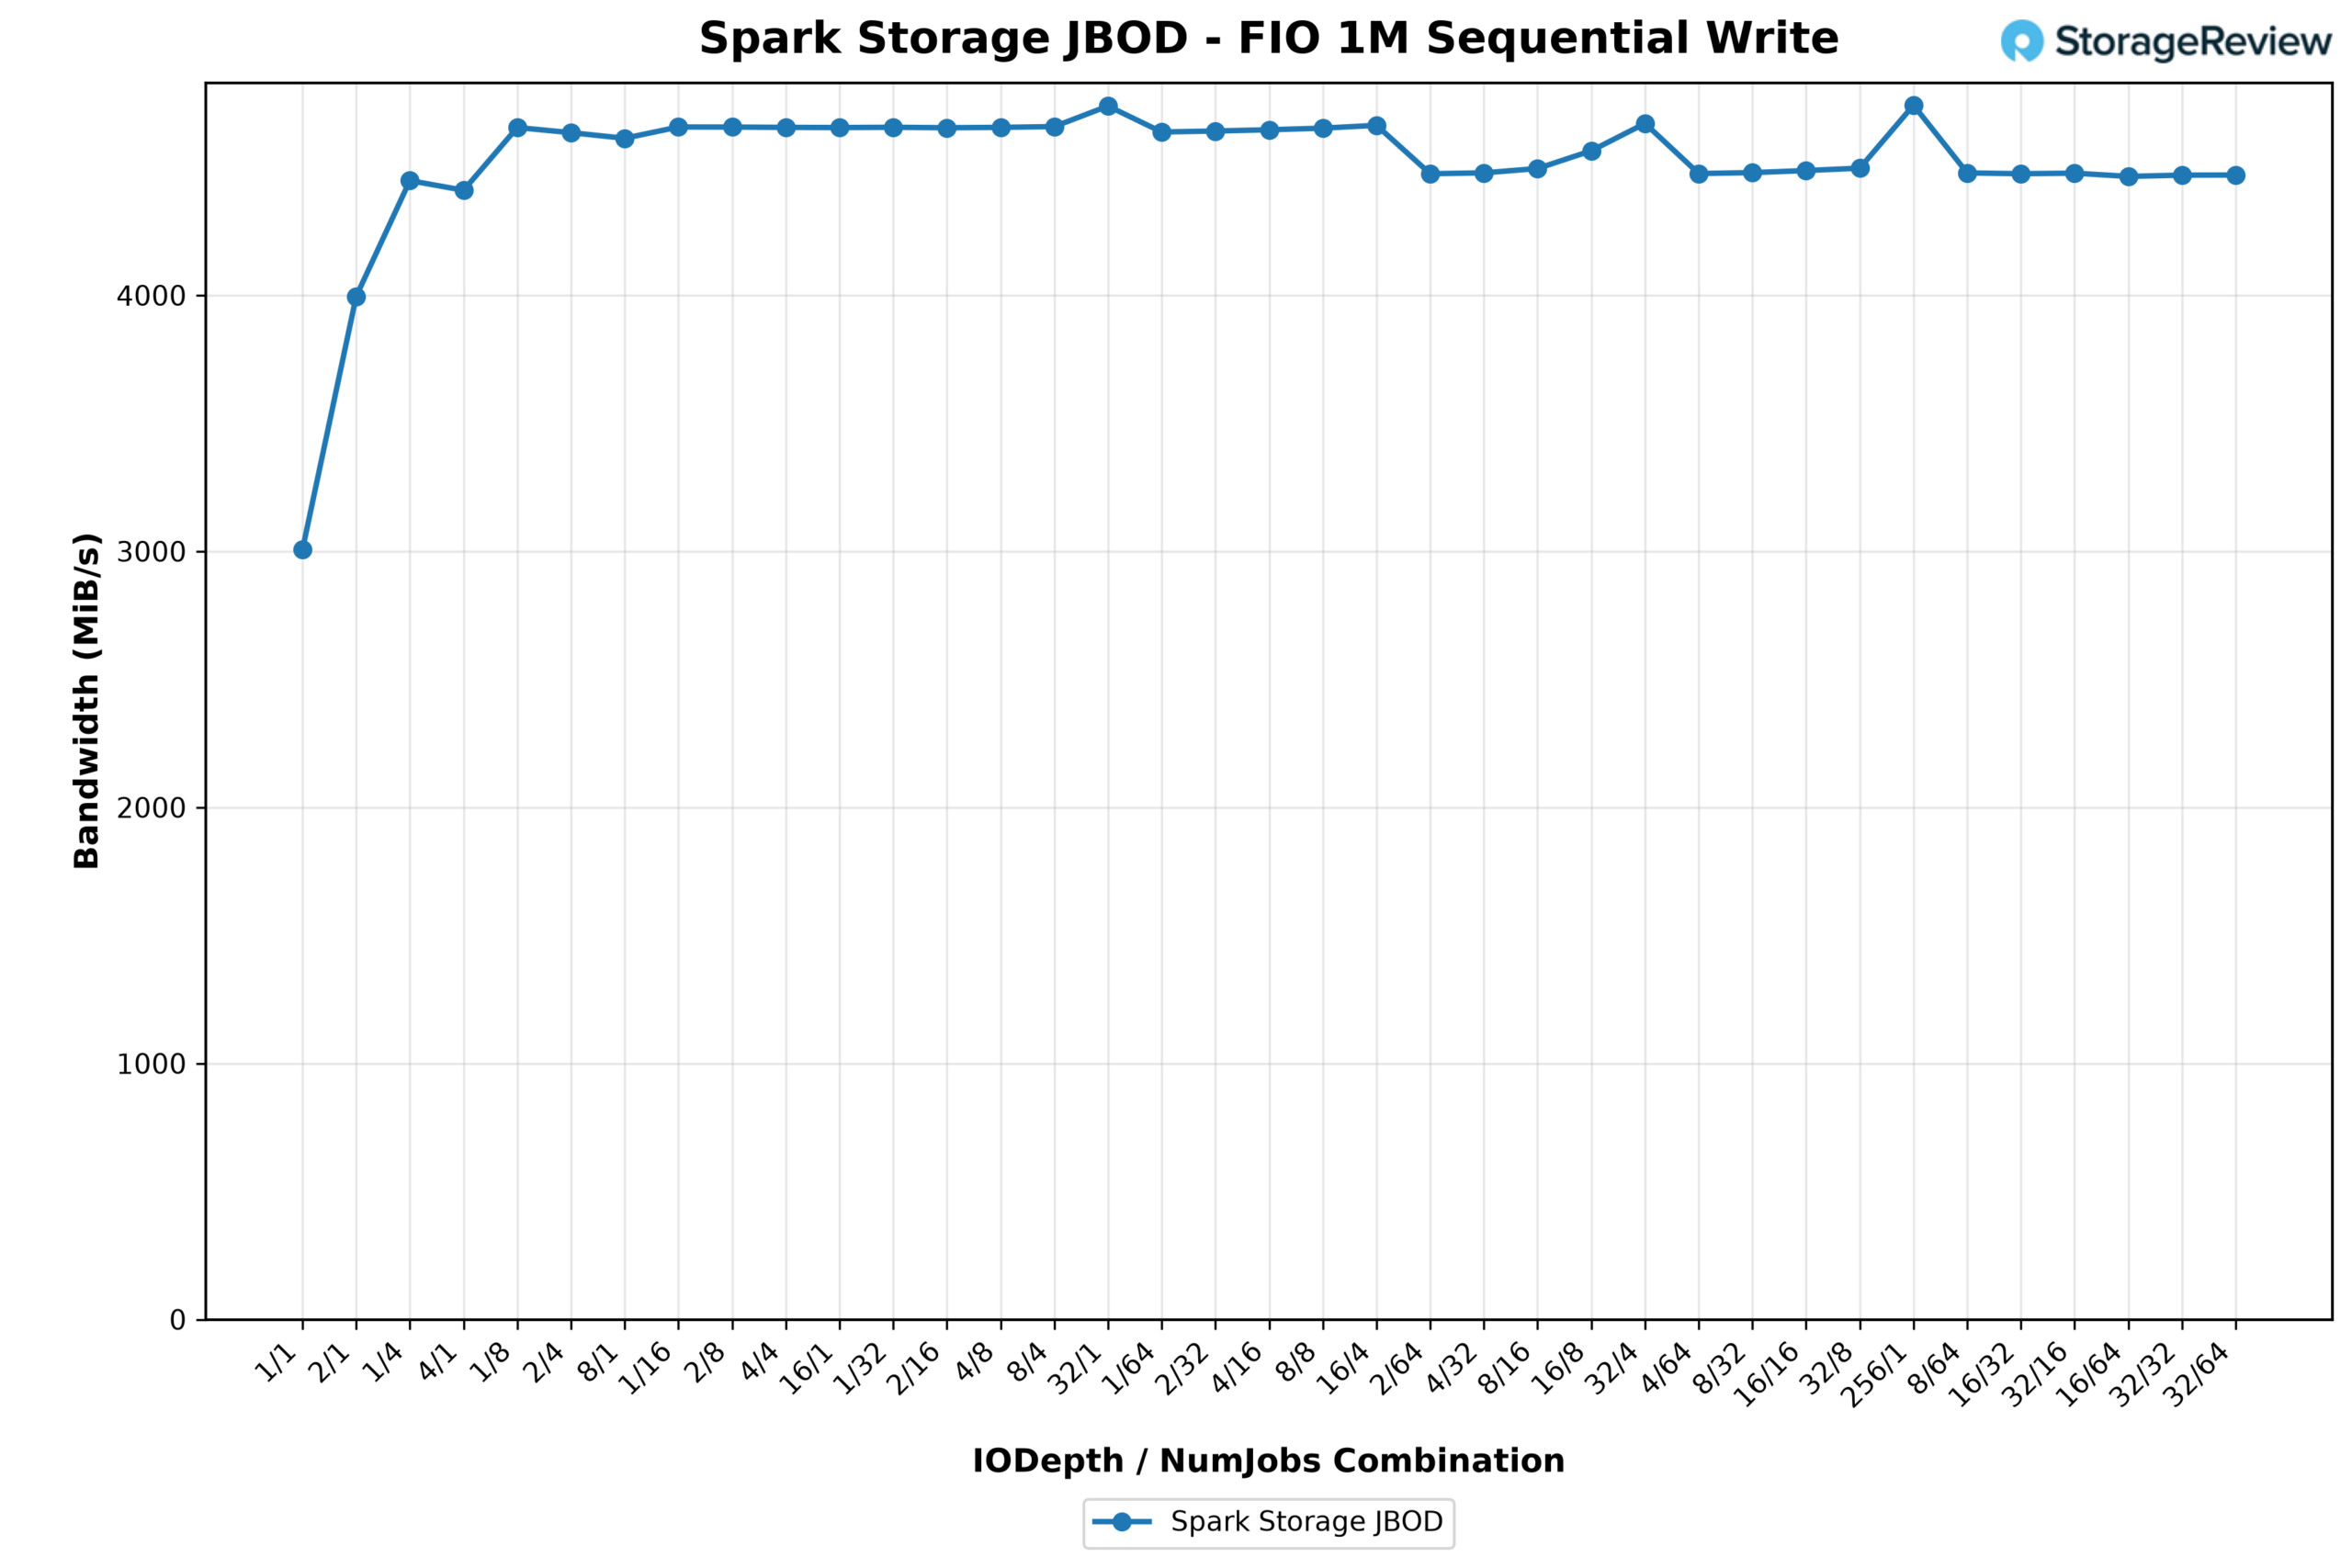
Zapis sekwencyjny utrzymuje przepustowość 4,742 MiB/s, czyli mniej więcej połowę przepustowości odczytu, a ten limit jest identyczny dla każdego testowanego rozmiaru bloku. Zgłosiliśmy asymetrię firmie Luisuantech podczas testów i przeprowadziliśmy rundę dostrajania z firmą, w tym zmiany MTU; podane wartości reprezentują najlepsze wyniki platformy w obecnej konfiguracji jednoportowej, a firma Luisuantech potwierdziła, że są one zgodne ze specyfikacjami ścieżki zapisu. W przypadku obciążeń zdominowanych przez odczyt, takich jak ładowanie modeli, strumieniowanie zbiorów danych i pobieranie RAG, jest to przypis; w przypadku intensywnego pobierania danych, oczekiwania dotyczące rozmiaru są odpowiednie.
Wniosek
GP Spark robi jedno i robi to czysto: zapewnia jednemu lub kilku systemom DGX Spark pamięć masową, której platforma naprawdę potrzebuje do ciężkich zadań. Wystarczy podłączyć go, załadować moduł jądra, a niemal 10 GB/s pamięci flash dostępnej przez GDS pojawi się bez instalacji sterowników, systemu operacyjnego ani faktury korporacyjnej. Kluczem jest wypełnienie go klienckimi dyskami M.2; pojemność staje się stosunkowo tania, gdy urządzenie obsługuje dowolne dyski SSD 2280 lub 22110, a silnik odciążający obsługuje protokół, którego dyski nigdy nie widzą.
Naszym zdaniem to schludny, dobrze wykonany dodatek, a nie przełom. Odczyt zatrzymuje się z prędkością pojedynczego łącza; zapis zatrzymuje się mniej więcej po połowie tej prędkości. Cena pozostaje kwestią otwartą: GP Spark nie jest jeszcze dostępny w sprzedaży detalicznej w USA ani Chinach, nasz egzemplarz testowy to prototyp, a Luisuantech nie opublikował cen. Argument o wartości opiera się na tym, że urządzenie jest znacznie poniżej korporacyjnych alternatyw NVMe-oF, na co powinna pozwalać jego konstrukcja z dyskiem klienckim. Dla posiadaczy pamięci Spark, którzy napotkają barierę wewnętrznej pamięci masowej – a nasza pierwotna recenzja sugeruje, że wielu z nich ją napotka – jest to łatwy sposób na rozwiązanie tego problemu bez konieczności wydzielenia pamięci masowej z dużej infrastruktury korporacyjnej.



 Amazon