

NVIDIA 为DGX Spark新增了 64GB 统一内存配置,起售价为 4,999 美元,并将于 10 月 23 日起由 Acer、ASUS、Dell、Gigabyte、HP 和 MSI 独家销售。这款新 SKU 与 128GB 版本一样,搭载了相同的 GB10 Grace Blackwell 超级芯片、ConnectX-7 网络、DGX 操作系统和 NVIDIA AI 软件栈。NVIDIA 表示,这款 64GB 版本无需将数据发送到云端,即可独立运行参数高达 1000 亿的模型,用于本地推理、微调和代理工作流程。
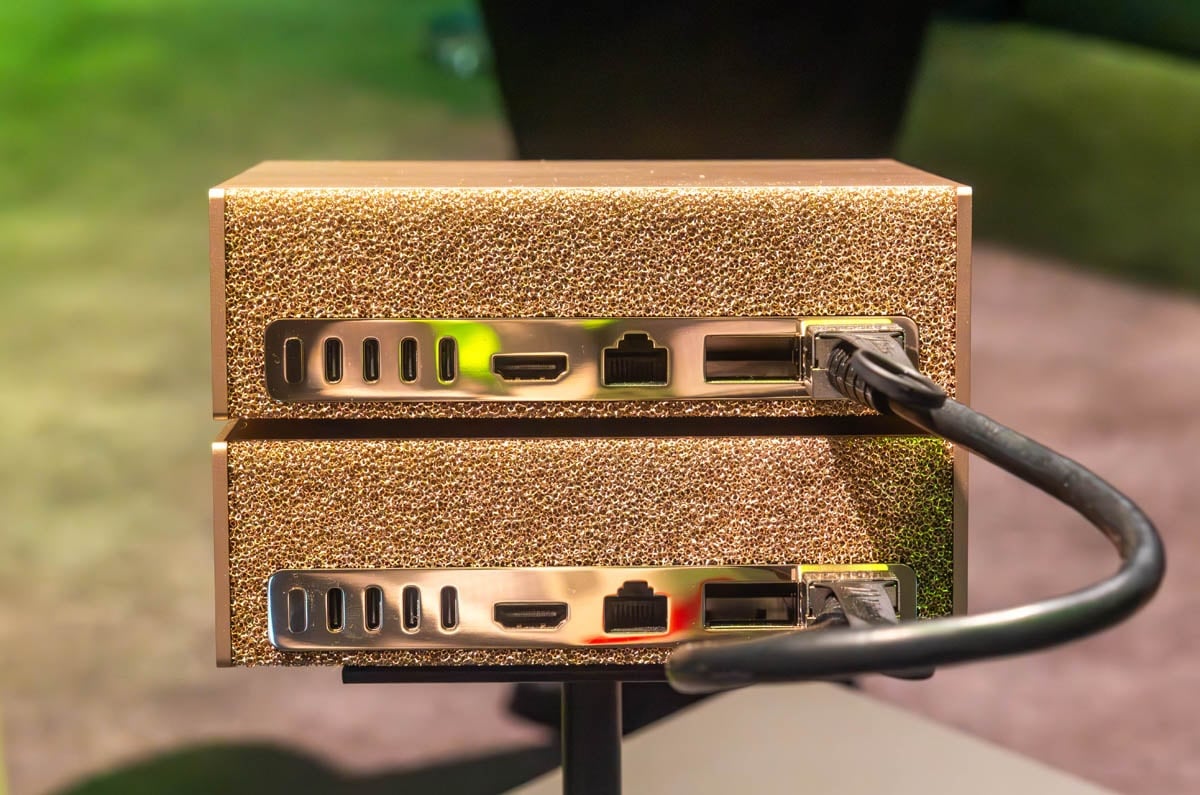
两个 64GB Spark 硬盘组成一个 128GB 集群
这款价格更低的机型(相比价格更高的同型号机型)的优势在于,两台设备组成集群即可获得不错的性能。每台 DGX Spark 都板载 ConnectX-7 网卡,因此两台设备可以通过 QSFP 线缆直接连接,接入 200GbE 链路,无需中间交换机。NVIDIA Sync Cluster Assistant 负责设备发现、验证设备配置并设置 ConnectX-7 网络。两块 64GB 的内存可合并为 128GB 的统一内存,NVIDIA 表示这足以运行参数量高达 200 亿的模型。
NVIDIA 内部数据显示,两台 64GB 集群式 Spark 系统采用 Qwen3.8 27B 架构,性能最高可达单台 128GB 系统的 1.7 倍。由于每个节点运行相同的 CUDA 库、推理引擎和 DGX 操作系统镜像,因此无需重建软件环境即可跨两台设备运行工作负载。支持的推理框架包括 llama.cpp、Ollama、vLLM 和 LM Studio。NVIDIA 还提供了一段关于如何使用 NVIDIA Sync 连接两台 Spark 的简短视频。
我们曾在戴尔、技嘉和惠普的DGX Spark单元上运行分布式推理集群,最近又在100GbE网络上为Spark集群部署了共享存储。64GB的SKU降低了此类配置的入门价格,但代价是单个单元的内存容量只有原来的一半。
NVIDIA Sync Model Launcher 将于十月底发布
公告的第二部分是软件。NVIDIA Sync Model Launcher 将于 10 月底发布,它可以在单个 Spark 或集群对上下载并启动模型(以 Qwen3.8 27B 为例),并将生成的端点暴露给网络上的开发人员机器。它还可以针对该模型设置 OpenCode,以便开发人员可以通过浏览器编写代码,而 Spark 集群则负责推理。
64GB 版本搭载与 128GB 版本相同的软件:DGX 操作系统、CUDA-X AI 库、NVIDIA Agent Toolkit、Nemotron 开源模型以及包括 Ollama、vLLM 和 PyTorch(含 CUDA)在内的运行时环境。NVIDIA 将这款设备定位为用于代理、推理、微调、数据科学和边缘开发的本地平台,其 ConnectX-7 接口意味着用户以后可以添加第二个设备。对于代理构建者,NVIDIA 建议他们访问 build.nvidia.com,查看其提供的 NemoClaw、OpenClaw、Hermes Agent 和OpenShell的 playbook作为起点。


 Amazon