

CoreWeave 已在 CoreWeave Cloud 上部署了一个多机架NVIDIA Vera Rubin NVL72集群,将数百个 Rubin GPU 连接到一个面向智能体 AI 工作负载的横向扩展环境中。每个由戴尔制造的机架包含 72 个 Rubin GPU、36 个 Vera CPU、NVLink 6 作为纵向扩展架构、BlueField-4 DPU以及每个 GPU 两个 ConnectX-9 SuperNIC。机架之间通过 NVIDIA Spectrum-X 以太网连接,形成一个两层无阻塞架构。CoreWeave 表示,该架构可扩展至约 128,000 个 GPU。CoreWeave 是首家验证并成功部署单个 Vera Rubin NVL72 集群的云服务提供商,也是首家发布该集群实测性能的云服务提供商。该平台的首批经同行评审的数据已于上周在MLPerf Inference v6.1中发布,CoreWeave 提交的测试用例运行于 GB300 NVL72 上。除了计算能力之外,CoreWeave AI 对象存储还增加了跨区域写入加速和新的归档层。
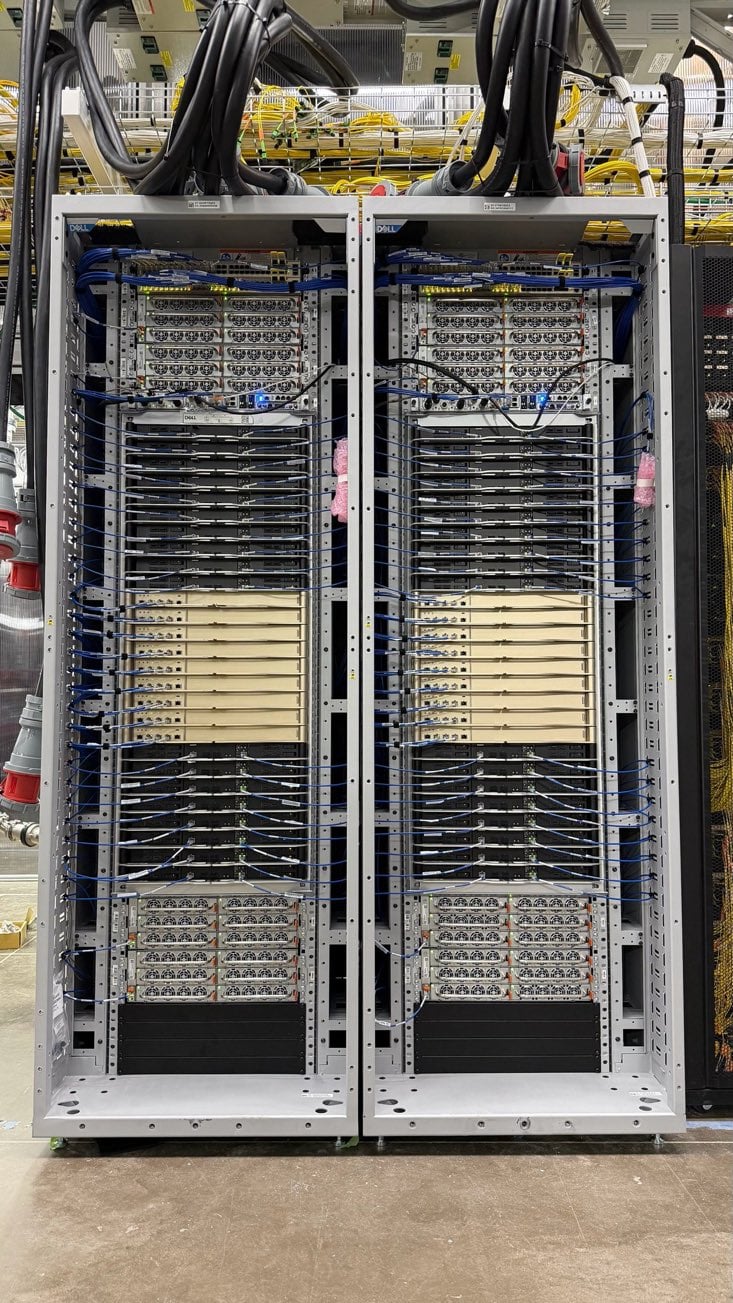
多机架式 NVIDIA Vera Rubin NVL72 架构
这种多机架架构针对代理执行路径,其中串行推理循环和外部工具调用会加剧分布式基础设施的数据访问延迟。每个 Rubin GPU 上的两个 ConnectX-9 SuperNIC 可提供高达 1.6 Tb/s 的后端网络连接,支持多轨、多平面路径。CoreWeave 将此架构描述为模块化架构,因此随着容量的增长,额外的 NVL72 机架可以加入到相同的无阻塞拓扑结构中。这些机架采用 45°C 液冷散热。
CoreWeave 通过其任务控制软件将各个机架连接起来。机架生命周期控制器负责每个机架的配置和生命周期管理,包括通过固件刷新进行硬件检测、验证、电源和散热回路管理;名为 Racky 的机架管理层控制电源和基础设施;而名为 Valvey 的可编程冷却控制器则提供对液冷回路和环境传感器的软件定义可见性和控制。
机架只有在经过分阶段验证后才能投入生产。在节点层面,这意味着要进行数小时的重复GPU诊断、CPU到GPU的数据传输检查、负载下的互连和散热验证,以及模拟真实场景的训练运行。在机架层面,所有72个GPU上的同步作业会验证NVLink GPU间的性能,任何低于预期范围的系统都会被送去进行故障排除。在机架层面,CoreWeave运行分布式工作负载,刻意禁用NVLink路径以强制流量通过后端网络,并监控物理网络是否存在链路不稳定、错误率上升、硬件过热和流量不均等问题,负载模式模拟代理应用程序:突发的需求高峰、并发性的变化以及通信的突发性。CoreWeave关于多机架启动的文档详细介绍了每个阶段,值得一读。
AI对象存储更新:跨区域写入和归档层
存储方面基于CoreWeave AI 对象存储及其本地对象传输加速器 (LOTA)。LOTA 是一种缓存代理,运行在 CoreWeave Kubernetes 服务中的每个 GPU 和 CPU 节点上,并将对象存储在节点本地的 NVMe 存储设备上。CoreWeave 报告称,每个 GPU 的缓存读取速度高达 7 GB/s,p99 读取延迟比从存储桶读取低 8 倍以上。CoreWeave 还提到,一家领先的模型提供商在超过 15,000 个 GPU 和 20PB 的缓存上运行 LOTA,命中率高达 99.7%。LOTA 不收取额外费用。
跨区域写入加速允许应用程序以本地延迟写入远程区域的存储桶,而无需更改 API 或 SDK。应用程序向 LOTA 端点发出标准的 S3 写入请求;对象数据持久化地保存在本地区域,而元数据则提交到远程区域;对象可立即读取,包括写入该对象的作业;数据在后台迁移到远程区域。应用程序在所有区域都看到一个统一的存储桶命名空间,并具有统一的 IAM 策略、生命周期规则和访问控制,从而消除了通常跨站点分发检查点所需的每个区域的分支和复制管道。
Cohere公司内部基础设施总监Cécile Robert-Michon表示:“我们的数据集跨越多个地区,我们不能让跨区域的数据检索延迟影响我们的训练计划。CoreWeave AI对象存储为我们提供了一个跨区域的统一数据集,读取操作缓存在本地,因此无需在网络上等待。”
归档层是继热存储、温存储和冷存储之后的第四种存储类别,专为写入一次、读取频率较低的数据而设计,例如较早的训练检查点和原始数据集。它的基础容量定价更低,并且免除检索费、缓存费、单次请求费、提前删除费、分层存储费和出口流量费。CoreWeave 建议的模式是将最近的检查点保留在速度更快的存储层中以便立即重启,并在 60 天未读取后自动将其分层到归档层。跨区域写入和归档层现已可用;CoreWeave 的存储文章中提供了配置详情。


 Amazon