

MLCommons 发布了 MLPerf Inference v6.1,此次测试参与机构数量创下新高,共有 30 家提交机构,并提供了 486 个数据中心和边缘计算结果。测试套件新增了两项测试:数据中心端到端 RAG 流水线测试和单用户设备边缘智能推理基准测试。此外,测试结果首次包含了 NVIDIA Vera Rubin NVL72、AMD Instinct MI350P、Intel Arc Pro B70 和 AMD Ryzen AI Max+ 395 的同行评审数据。关于性能提升速度,MLCommons 表示,服务器场景下单加速器 DeepSeek-R1 测试的最佳结果比一年前的 v5.1 版本提升了 5.7 倍,而 VLM 测试的最佳结果在 v6.0 版本发布后的六个月内提升了 2.99 倍。
两项新测试:端到端 RAG 测试和边缘智能体推理
端到端 RAG 基准测试衡量完整的问答流程,该流程涉及多个模型和一个向量数据库的协同工作。参考实现同时运行四个模型:gpt-oss-120B 负责查询分解、充分性检查和答案生成;gpt-oss-20B 对检索到的文档进行评分;e5-base-v2 生成词嵌入;ColBERTv2 对段落进行重排序。语料库包含 107,484 个段落,这些段落取自 2,515 个 HTML 文件;问题来自 Google 的 FRAMES 数据集,包含 824 个多跳任务;每个任务最多可以循环进行 5 轮检索,直到流程认为已获得足够的证据。该测试得出两个指标:构建 FAISS HNSW 向量数据库的每秒文档数,以及针对该向量数据库回答问题的每秒任务数。Llama 3.1-8B 评判器根据 97% 的准确率目标对最终答案进行评分,评判过程不计时。
Edge Agentic Inference 基准测试针对的是已迁移到工作站和桌面 AI 设备上的编码辅助模式。该模型基于 Qwen3.6-27B,并启用了“思考关闭”功能,在参考文档的 llama.cpp 中以 Q4_K_M GGUF 格式运行,每个回合处理 32K 上下文窗口。性能工作负载是 20 条从 SWE-bench Verified 数据集中提取的智能体编码轨迹的录制回放,共计 1,007 个回合,以单流方式运行,每个请求同时进行,模拟开发人员在笔记本电脑上运行智能体的方式。报告的指标是每个回合的平均延迟,同时还提供了首次令牌到达时间和每个输出令牌的到达时间分布,准确率则通过 BFCL v4 单独设定为参考分数的 97%。MLCommons 基于其即将推出的 MLPerf Agentic 数据中心基准测试框架对该测试进行了调整。
“我们新增了端到端 RAG 测试,因为很明显,问答系统已经不再局限于基于语料库训练的 LLM;利益相关者需要了解当今正在构建的多步骤、多组件管道在实际应用中的性能,”MLPerf 推理工作组联合主席 Miro Hodak 表示。“同样,我们新增了边缘智能推理测试,因为具有智能属性的复杂推理系统越来越多地部署在边缘计算设备上,这给我们的客户带来了一系列新的性能挑战。”
该轮更新还将之前仅限于 DeepSeek-R1 的推测性解码支持扩展到交互式场景中的 GPT-OSS 基准测试,并为 VLM 测试定义了一个新的交互式场景,目标是在 1.5 秒左右做出响应。
从桌面到机架,全新硅芯片
NVIDIA 的 Vera Rubin NVL72 首次亮相 MLPerf 预览版评测,NVIDIA 和 Nebius 都提交了基于 VR200 NVL72 的测试结果。NVIDIA 报告称,在离线、服务器和交互式场景下,使用 TensorRT-LLM 算法的 NVL72 在 DeepSeek-R1 测试中,其令牌吞吐量比 GB300 NVL72 高出 2.5 倍;在使用 NVIDIA Dynamo 和 vLLM 算法的 Qwen3 视觉语言模型上,其令牌吞吐量更是高达 3.7 倍。以上数据是 NVIDIA 与其上一代产品的对比结果。由于被评为预览版,该平台预计将在下一轮评测中正式上市。
AMD 将其 MLPerf Inference 6.1 参赛作品扩展至涵盖语言、推理、文本转视频和推荐任务的六个模型系列,并部署了 Instinct MI355X、MI350X 和新款 MI350P PCIe 卡。下文将介绍基于 MI355X 构建的 512 GPU Crusoe 集群,以及 AMD 对本轮比赛的详细分析。
英特尔 Arc Pro B70 采用四 GPU 架构,总显存容量达 128GB,并用于 Llama 3.1-8B、Llama 2-70B、gpt-oss-120B、Whisper 以及全新的 E2E-RAG 测试。英特尔报告称,在相同的硬件配置下,gpt-oss-120B 的服务器性能较 v6.0 提升了 36%,离线性能提升了 27%。CPU 方面,英特尔表示,在相同的芯片上,Xeon 6980P 的 Llama 3.1-8B 服务器吞吐量较 v6.0 提升了 2.4 倍,这完全是软件层面的提升。
Ryzen AI Max+ 395 的成绩由 Atlas Inference 测得。Atlas Inference 是首次提交测试结果的厂商,它使用相同的引擎和量化方案,分别在 NVIDIA DGX Spark 和 AMD Strix Halo 台式机上运行了新的 Edge Agentic 工作负载。Atlas 报告称,在 DGX Spark 上,Ryzen AI Max+ 的测试结果为每秒 20.1 个令牌,在 64 分钟内完成了全部 1,007 个回合;在 Strix Halo 上,测试结果为每秒 19.63 个令牌。这比我们在Ryzen AI Halo和DGX Spark 评测中使用现成运行时在这两个平台上测得的差距要小,而这正是新基准测试旨在呈现的结果。
更大、更多样化、更分散
本轮多节点提交数量创下新纪录,较 v4.0 版本零节点大幅增长,其中三个提交尤为突出。Crusoe 是另一位首次提交者,他使用 AMD 显卡运行了 MLPerf 推理历史上规模最大的系统:在标准的 RoCE 以太网架构上,64 个节点上分布着 512 个 Instinct MI355X GPU,提交的模型为 gpt-oss-120b 和 DeepSeek-R1。AMD 报告称,该集群在 gpt-oss-120b 的离线场景下每秒处理 5.75 万个 token,在服务器场景下每秒处理 5.39 万个 token;在 DeepSeek-R1 的离线场景下每秒处理 2.90 万个 token,在服务器场景下每秒处理 2.41 万个 token。AMD 称这是 MLPerf 历史上最高的聚合 token 吞吐量,吞吐量几乎呈线性增长,节点数量从 1 个增加到 64 个。gpt-oss-120b 的运行以 512 个独立的单 GPU 副本形式运行,采用原生 MXFP4 编码。 DeepSeek-R1 使用 SGLang,每个节点配备一个由 8 个 GPU 组成的副本。AMD 还单独引用了一项基于 72 个 GPU 的 GPT-OSS-120B 提交,其扩展效率达到 95%,每秒可处理 100 万个代币,这与v6.0 版本中 MI355X 的表现相同。
思科提交了该基准测试的首个跨厂商异构系统,该系统将八块 NVIDIA H200 和八块 AMD Instinct MI350X GPU 汇集到一个推理池中,并通过 Cisco Silicon One G200 架构运行,这与思科在其Secure AI Factory中销售的混合加速器方案相同。MangoBoost 与戴尔合作提交了该基准测试的参赛作品:分布在两大洲的四个站点,分别由 MangoBoost、戴尔、TensorWave 和 Microsoft Azure 托管,横跨太平洋,作为一个统一的终端运行,MangoBoost 报告称其扩展效率高达 97%。MangoBoost 还声称首次在 AMD Instinct GPU 上获得了预填充/解码分解后的测试结果。
其他结果显示,CoreWeave 在 GB300 NVL72 上实现了每秒 1.16 万个令牌的聚合吞吐量,自 v6.0 版本以来,每个 GPU 的离线吞吐量提升了 17%;HPE 指出,在两台搭载 Blackwell Ultra 处理器的 Compute XD690 服务器上,DeepSeek-R1 的 GPU 每秒可处理 8,500 个令牌;谷歌则将提交的测试结果重点放在了 DeepSeek-R1 上,并指出业界正在转向大规模混合专家模型。gpt-oss-120b 吸引了 112 个提交,是所有 MLPerf 工作负载中提交数量最多的。
AMD 的两种 CDNA 4 外形尺寸:OAM 和双槽 PCIe
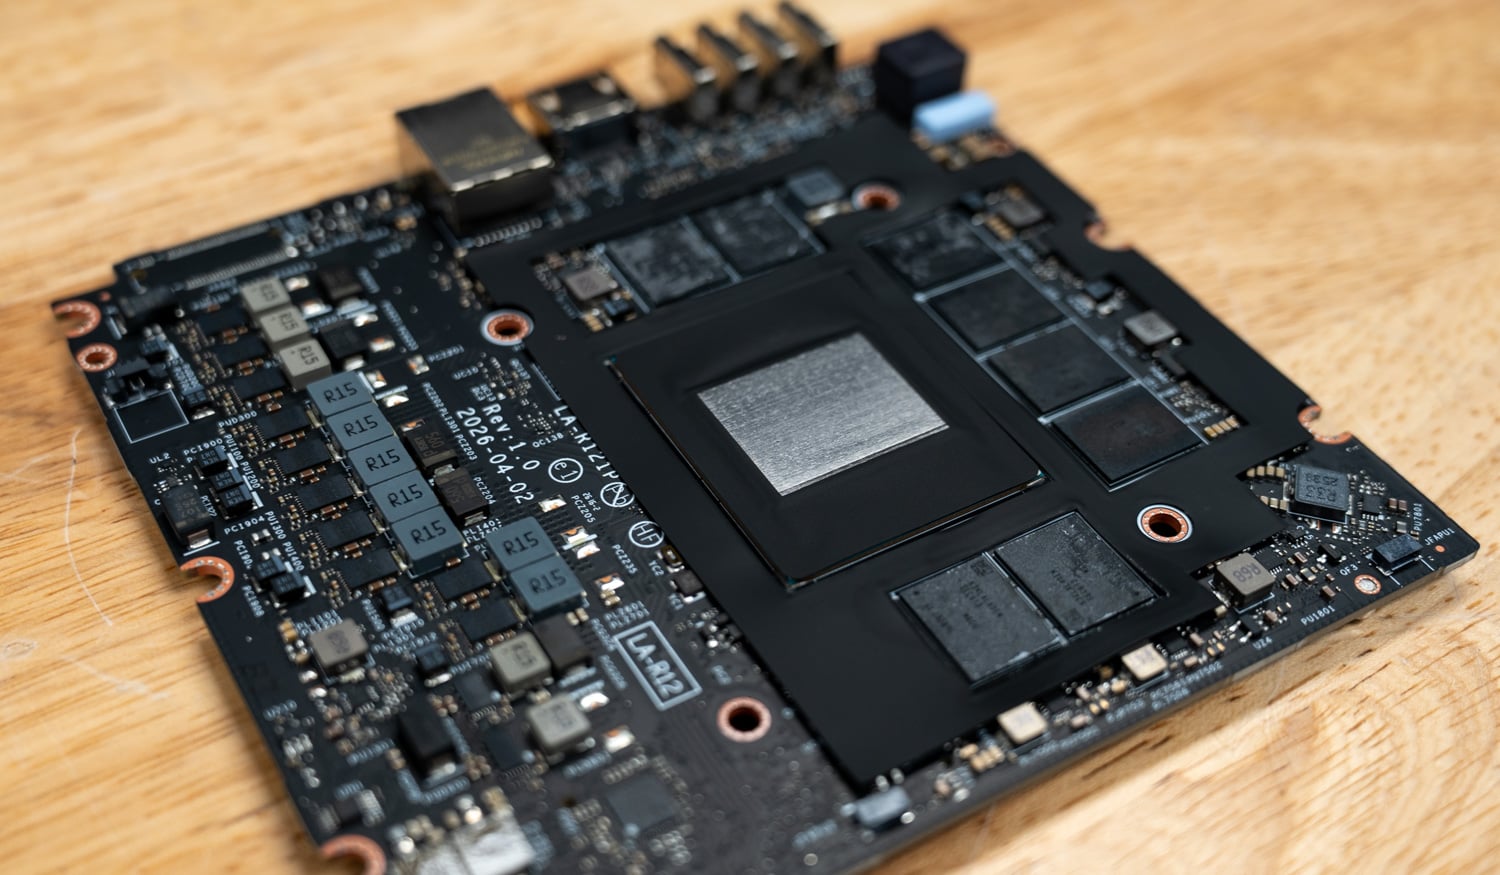
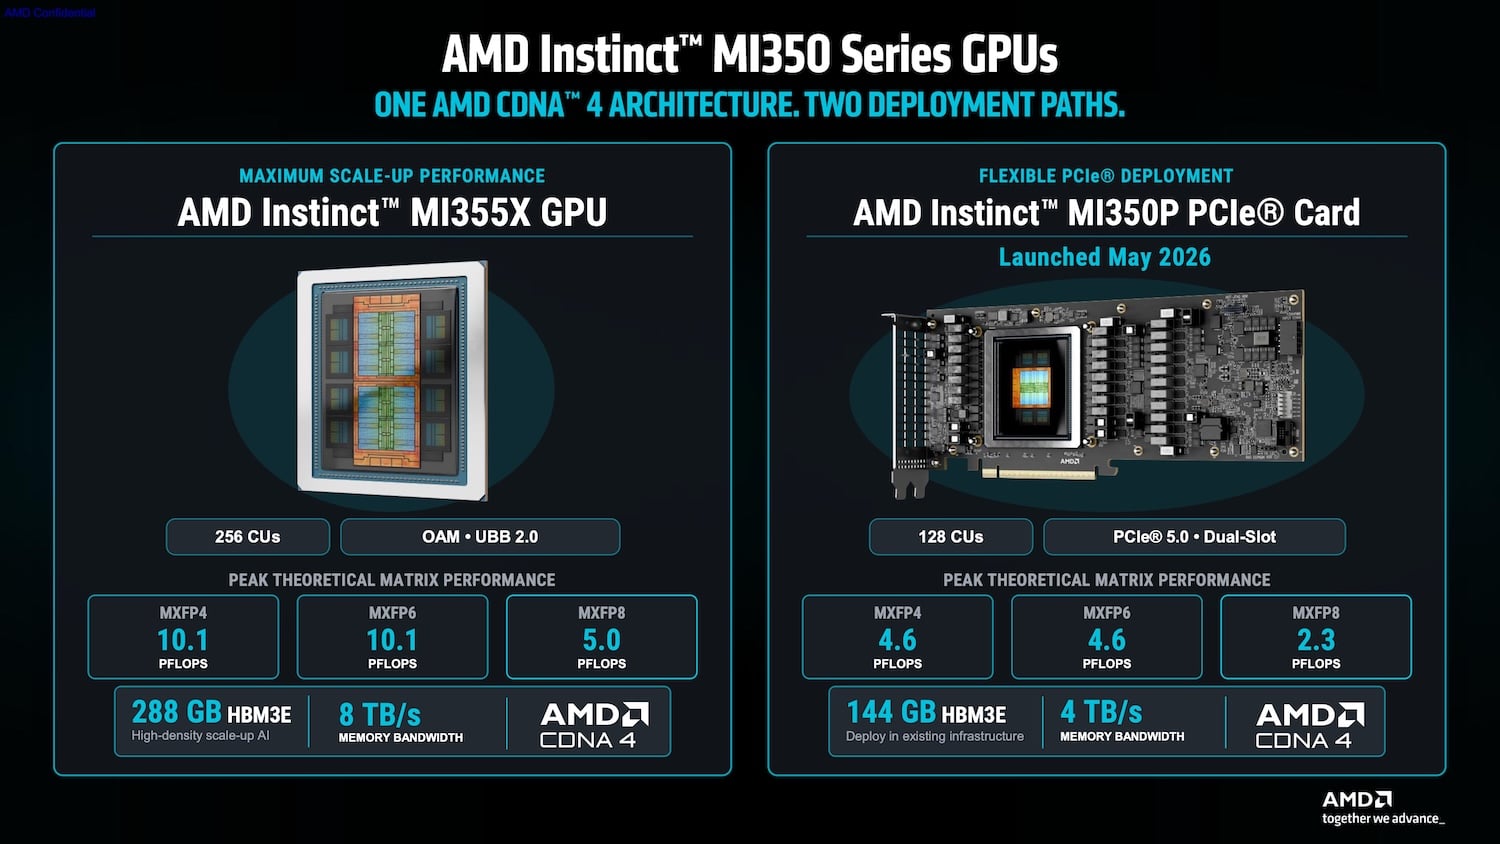
AMD 的 CDNA 4 架构提供两种物理尺寸规格,以满足不同的数据中心电源和散热需求。旗舰级产品 Instinct MI355X 采用 OAM 外形尺寸,基于 OCP 通用基板 (UBB 2.0) 平台,面向高密度计算节点,提供 256 个计算单元、288 GB HBM3E 内存和 8 TB/s 的总内存带宽。其理论峰值 MXFP4 和 MXFP6 矩阵计算性能最高可达 10.1 PFLOPS。新推出的 Instinct MI350P 将相同的 CDNA 4 芯片集成到双槽 PCIe 5.0 扩展卡中,适用于标准企业级机箱,配备 128 个计算单元、144 GB HBM3E 内存和 4 TB/s 的带宽,理论峰值 MXFP4 和 MXFP6 矩阵计算性能最高可达 4.6 PFLOPS。
软件驱动的代际性能提升,基于相同的芯片
AMD ROCm v7 中的软件优化在相同的 MI355X 硬件上,于单个 MLPerf 测试周期内实现了可测量的吞吐量提升。在配备 8 个 GPU 的 MI355X 节点上进行的测试表明,GPT-OSS-120B 吞吐量在离线场景下提升了 28%,在服务器场景下提升了 38%,而 Wan-2.2 SingleStream 性能提升了 70%。在集群规模下,MLPerf 6.1 中 72 个 MI355X 加速器的总 GPT-OSS-120B 吞吐量高于 6.0 版本中报告的 94 个 GPU 配置。在 AMD 发布的对比测试中,配备 8 个 GPU 的 MI355X 在 GPT-OSS-120B 测试结果中领先于 NVIDIA B200 和 B300,而 72 个 GPU 的集群则领先于 NVIDIA GB200。
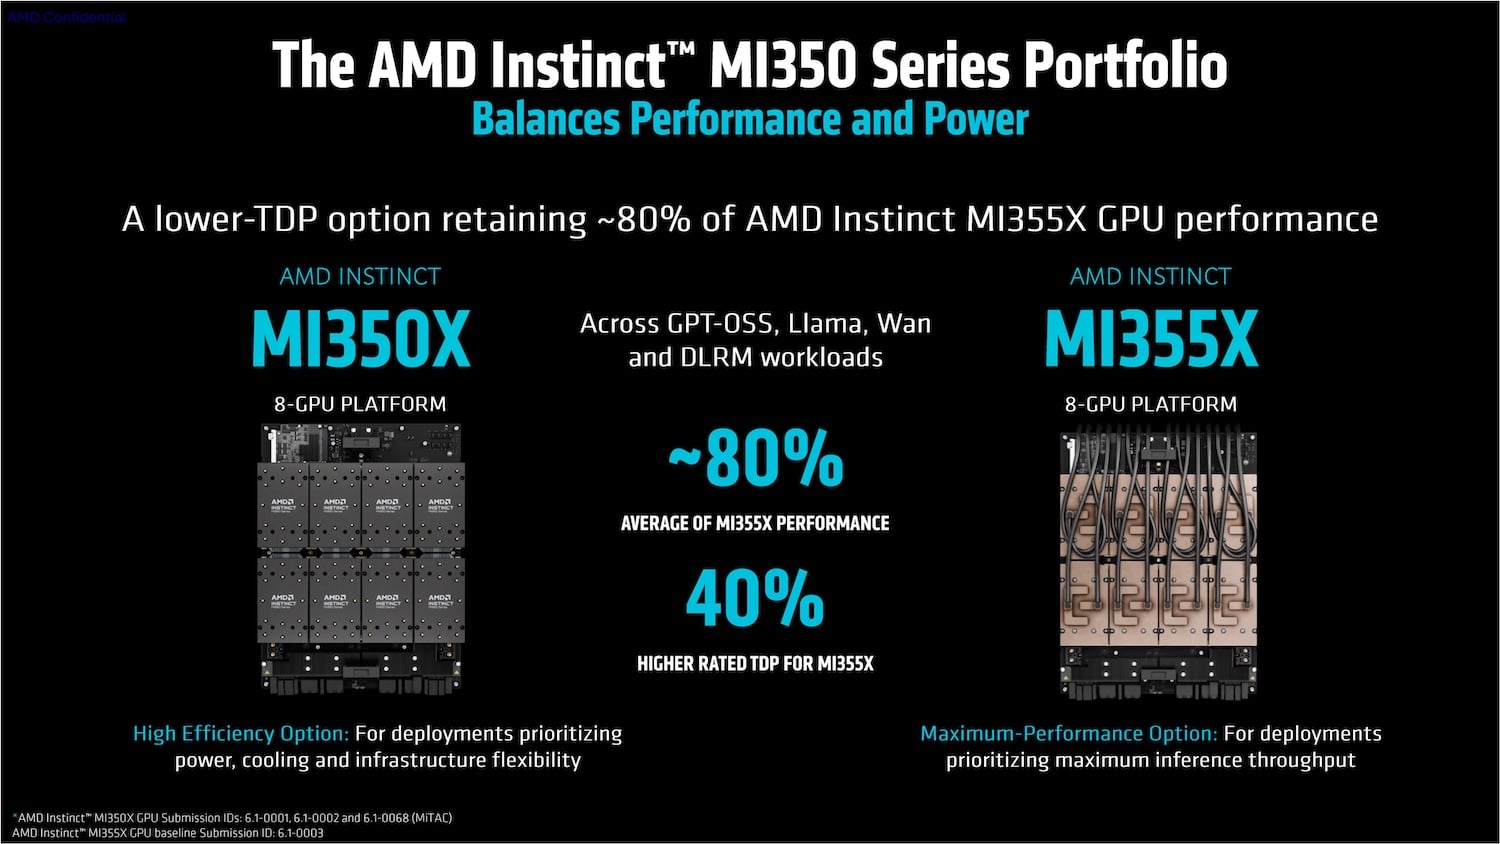
在首轮 MLPerf 测试中,双槽 MI350P 在五项封闭式工作负载测试中均取得了领先成绩,超越了 NVIDIA RTX PRO 6000 Server Edition 和 H200 NVL 的部分测试结果。对于对功耗和散热预算较为敏感的部署,配备八 GPU 的 MI350X 系统在 GPT-OSS、Llama、WAN 和 DLRM 工作负载测试中,性能达到了 MI355X 平台基准测试性能的约 80%,而 MI355X 的额定 TDP 却高出 40%。Signal65 委托进行的一项研究表明,这些吞吐量数据转化为更低的单文档运营成本和更高的每美元代币产出,且延迟限制在一定范围内。
AMD合作伙伴业绩及韩美集群
AMD 表示,来自戴尔科技、甲骨文、惠普企业、超微、MangoBoost、Crusoe 和 MiTAC 等七家合作伙伴提交的类似 MI355X 测试结果,平均与参考系统结果相差在 4% 以内,有些测试结果甚至与参考系统结果持平或略有提高。
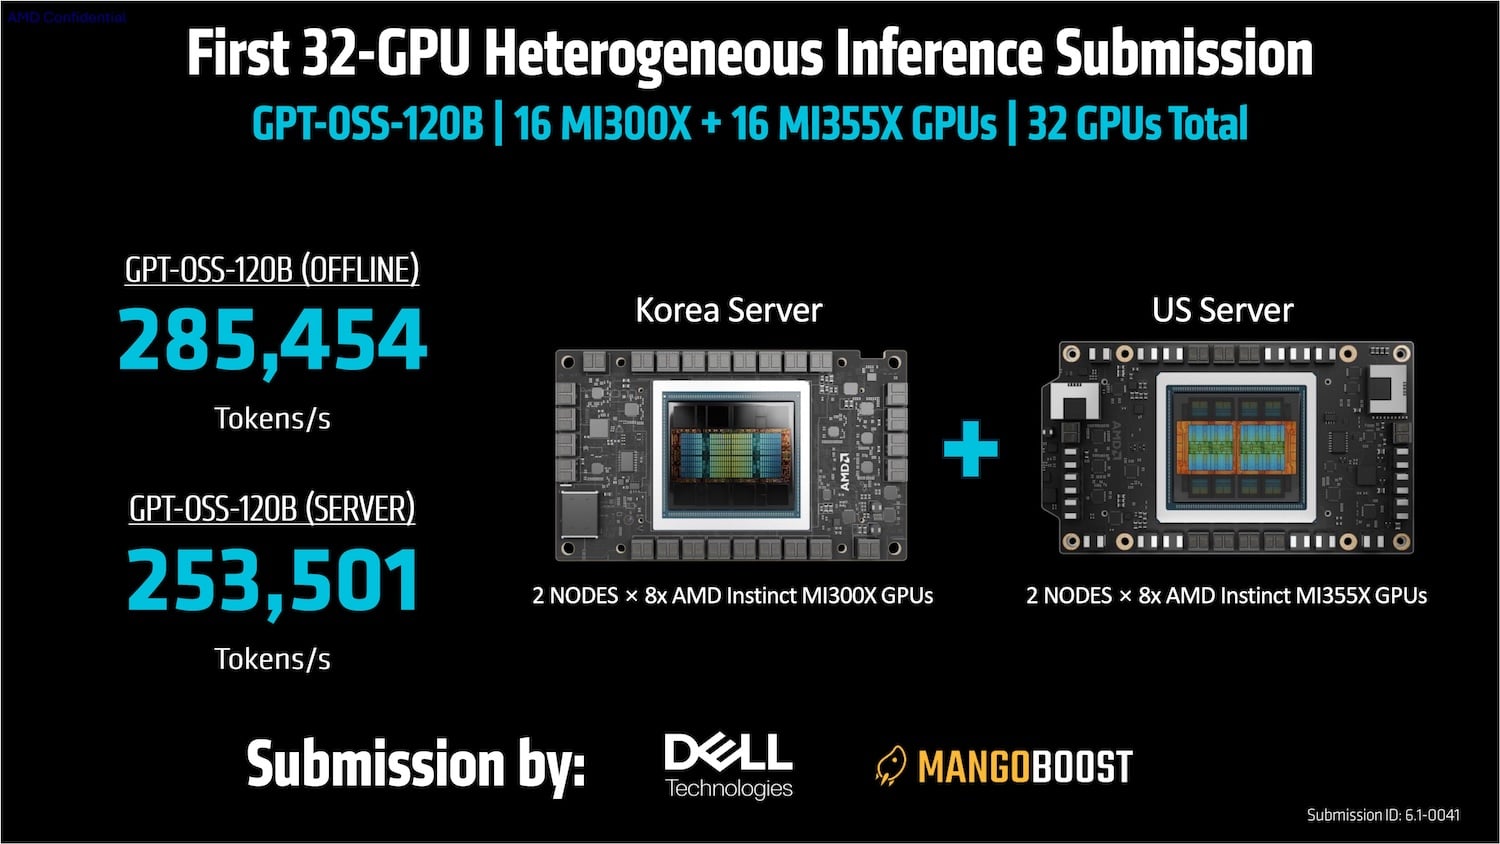
上文提到的 MangoBoost 和戴尔的参赛作品是该基准测试中首个异构 32 GPU 服务配置,它将韩国的 16 颗上一代 Instinct MI300X GPU 与美国的 16 颗 Instinct MI355X GPU 连接成一个统一的 GPT-OSS-120B 端点。这种分离集群配置每秒可处理 285,454 个离线令牌和 253,501 个服务器令牌。测试运行在 ROCm 7 上;AMD 指出,基于 HBM4 的 MI400 系列以及后续的 MI500 系列将采用ROCm 10 版本,该版本包含 vLLM、SGLang 和 ROCm.AI 分析工具。
数据中心中取代 MLPerf 推理的工具
本轮30位提交者中有16位使用了MLPerf以API为中心的测试框架,而v6.0版本中仅有一位开放组提交者使用。该框架通过标准API对托管端点运行真正的客户端/服务器架构,这正是数据中心推理的部署方式。它已包含新的Edge Agentic测试、VLM-Interactive、gpt-oss、DeepSeek-R1、Llama 3.1-8B以及文本转视频等测试。它是MLPerf Endpoints的基础,后者将于2026年1.0月开放按需滚动提交,并于2027年取代MLPerf Inference成为数据中心基准测试。Endpoints v1.0计划提供标准化结果并扩展代理工作负载。
MLPerf负责人David Kanter表示:“展望未来,MLPerf Endpoints将取代Inference,成为我们数据中心基准测试系列的一部分。我们以API为中心的测试框架的快速普及将有助于实现这一无缝过渡。” 本轮首次提交测试结果的六家公司分别是Atlas Inference、Crusoe、Orrick Industries、ScitiX、VibeHPC,以及哈佛大学肯普纳研究所的个人贡献者Naeem Khoshnevis,他提交了单个H200 Llama 3.1-8B测试结果。
本次推理轮次是在两周前发布的MLPerf Storage v3.0 结果之后进行的,完整的数据中心和边缘表以及提交者的补充信息可在 MLCommons 结果页面上找到。


 Amazon