

NVIDIA et Microsoft ont ouvert aujourd'hui les précommandes pour les ordinateurs portables RTX Spark sous Windows, disponibles dès le 16 octobre. Les ordinateurs de bureau compacts suivront en novembre, et un aperçu de DGX Station pour Windows, que NVIDIA lancera au quatrième trimestre, est également disponible. Ces annonces ont été faites lors de l'événement Microsoft consacré à l'IA et aux Surface à San Francisco, où Jensen Huang a rejoint Satya Nadella sur scène. Microsoft a également annoncé la disponibilité générale de sa couche de confinement d'agents, Microsoft Execution Containers, sur Windows 11.
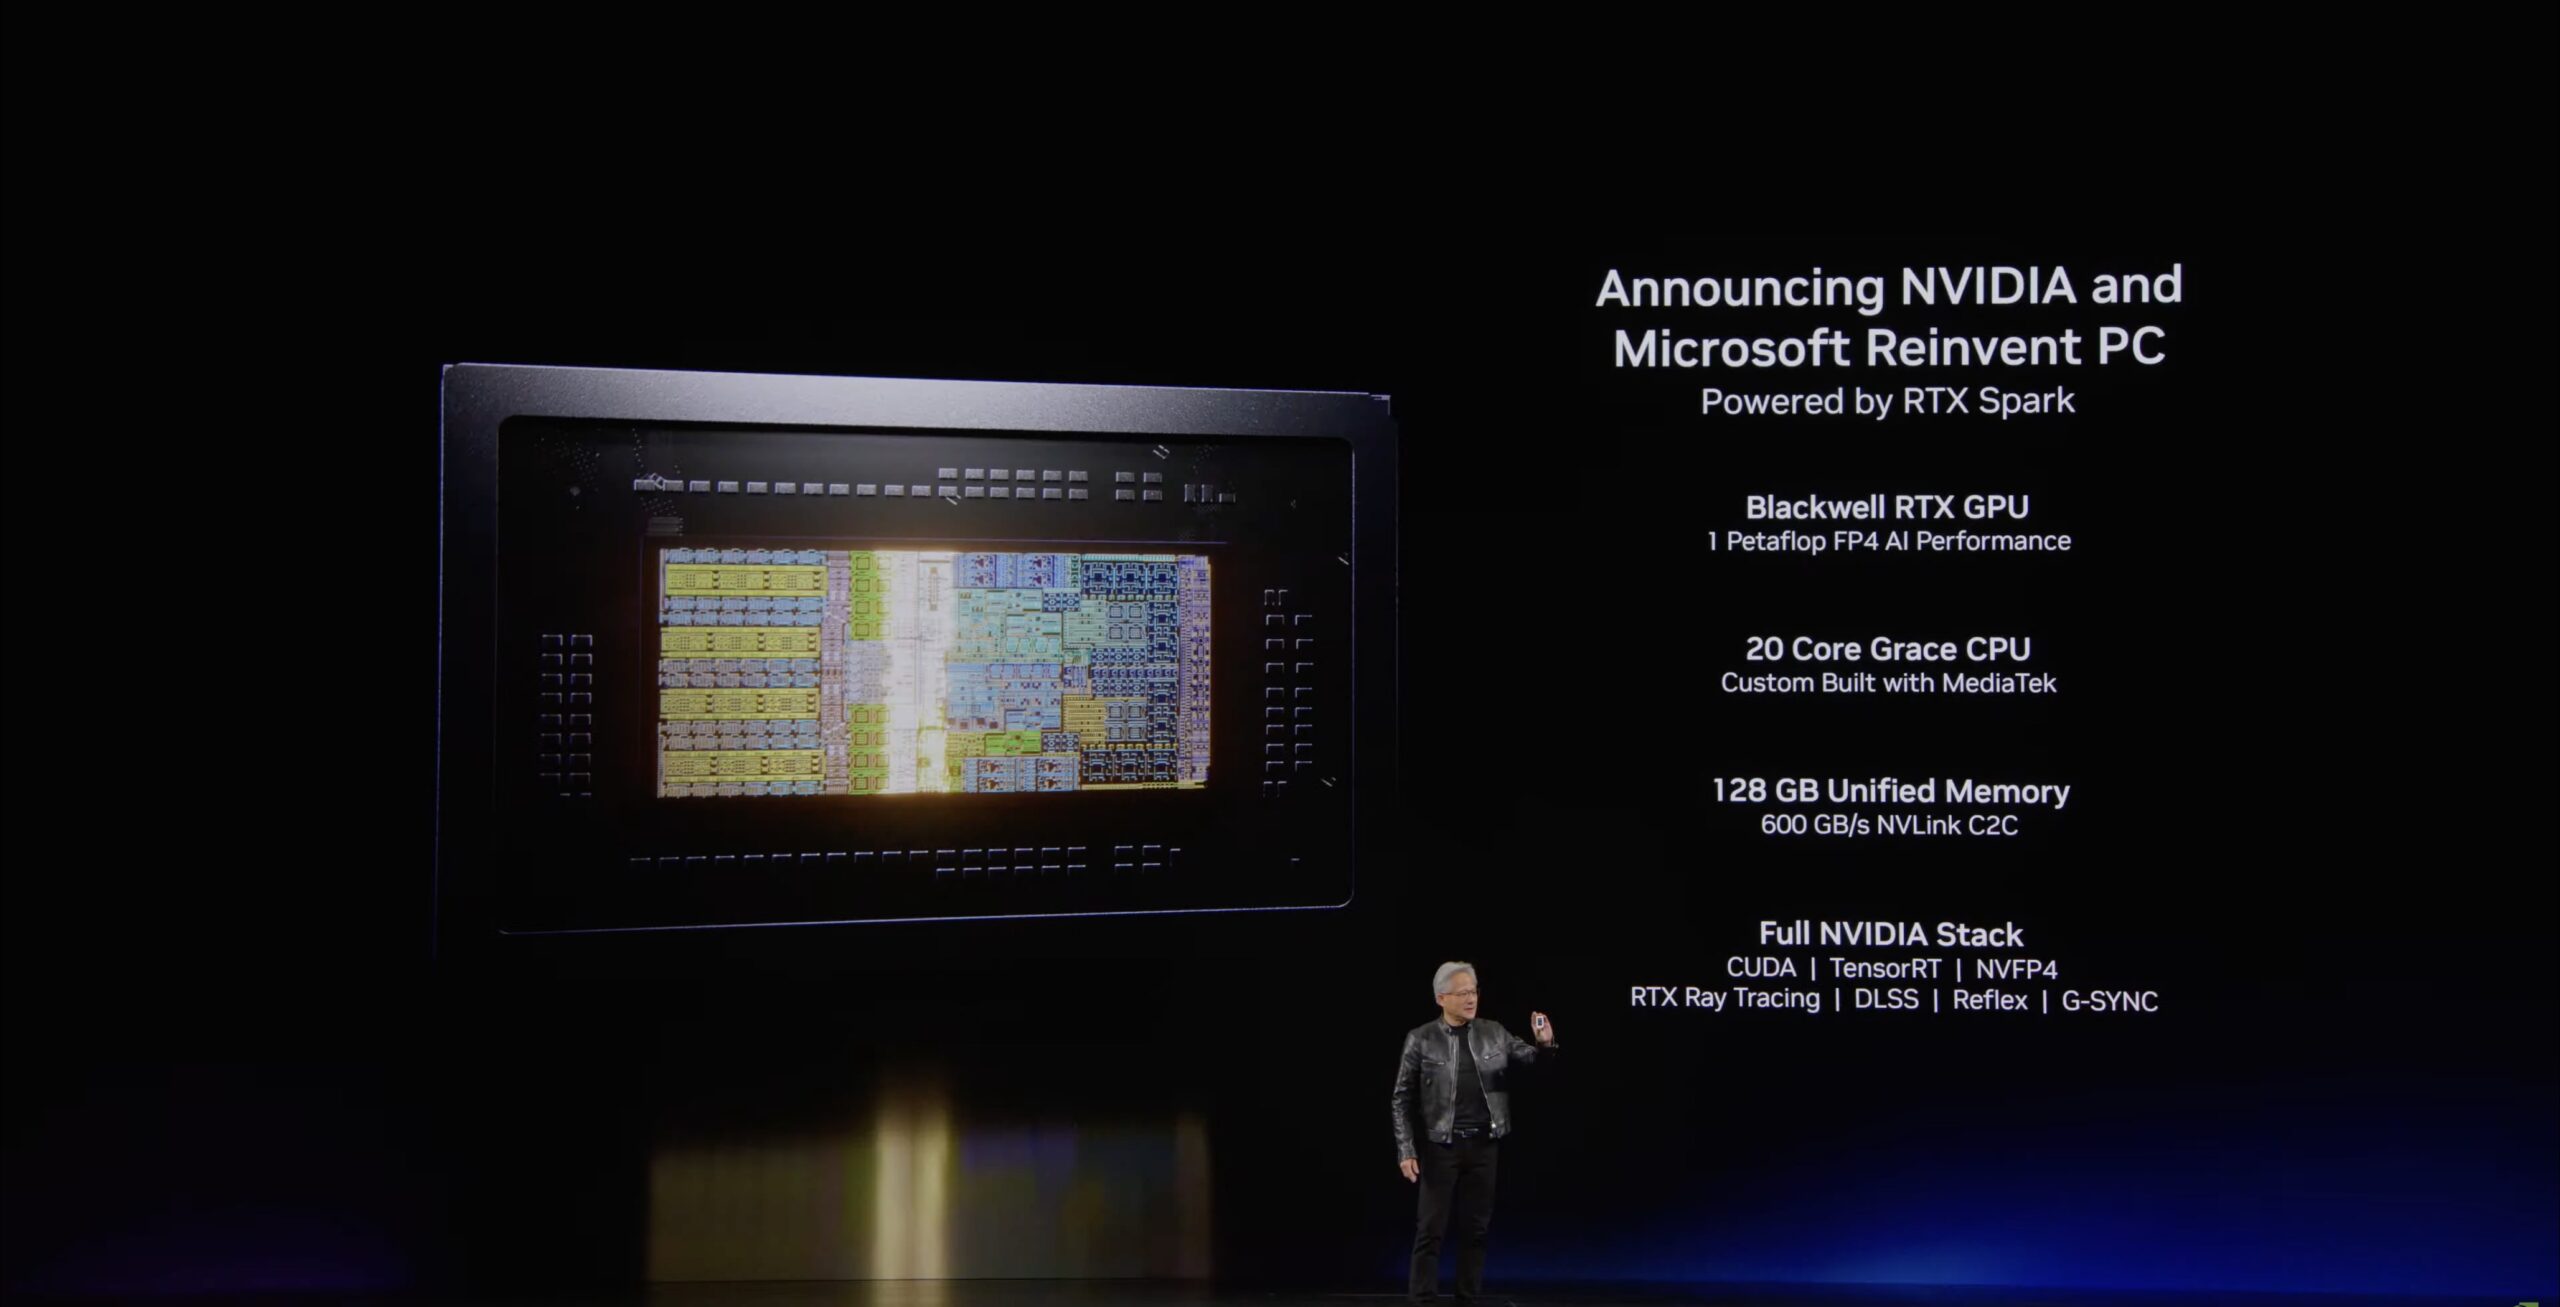
Nous avons présenté le premier de ces systèmes plus tôt dans la journée dans notre article sur le Dell XPS 16 Creator Edition , ainsi que la plateforme elle-même lors du Computex en juin. Cet article porte sur les informations inédites publiées par les deux entreprises à l'occasion de cet événement : la consommation énergétique du superprocesseur N1X, la répartition de la mémoire unifiée sous Windows, le débit mesuré pour un modèle de codage à 137 milliards de paramètres sur un ordinateur portable, le fonctionnement des agents sandbox et un tableau complet des spécifications de la station Windows DGX.
RTX Spark N1X : Deux puces, trois enveloppes de consommation
Le tableau des spécifications RTX Spark de NVIDIA distingue désormais les ordinateurs portables des ordinateurs de bureau, et cette distinction est plus instructive que les chiffres principaux. Les ordinateurs portables sont disponibles en deux versions N1X : un GPU Blackwell RTX à 6 144 cœurs avec un processeur Grace à 20 cœurs et jusqu’à 128 Go de mémoire LPDDR5X unifiée, et un GPU à 5 120 cœurs avec un processeur à 18 cœurs et jusqu’à 64 Go de mémoire ; les deux affichent un TDP de 45 à 80 W. Les ordinateurs de bureau, quant à eux, sont uniquement disponibles avec la version à 6 144 cœurs et 20 cœurs, jusqu’à 128 Go de mémoire, et NVIDIA annonce un TDP de 140 W.
Cette valeur de 140 W correspond au TDP publié par NVIDIA pour le GB10 dans DGX Spark, incluant le CPU et le GPU. Cela confirme les déclarations de NVIDIA en juin, selon lesquelles les deux puces constituent le même système optimisé pour différentes plateformes. Cela signifie également qu'un ordinateur portable N1X consomme entre 32 % et 57 % de la puissance nominale de la version de bureau, tandis que chaque système de la gamme affiche la même puissance de calcul FP4 « jusqu'à 1 pétaflops ». Dans les notes de bas de page relatives à la Surface de Microsoft, ce chiffre correspond aux performances FP4 théoriques obtenues en utilisant la méthode de la sparsité.
| Spécifications | RTX Spark N1X (ordinateur portable) | RTX Spark N1X (ordinateur portable) | RTX Spark N1X (Ordinateur de bureau) | GB10 (DGX Spark) |
|---|---|---|---|---|
| GPU | RTX Blackwell à 6 144 cœurs | RTX Blackwell à 6 144 cœurs | RTX Blackwell à 6 144 cœurs | Blackwell, cœurs Tensor de 5e génération, cœurs RT de 4e génération |
| Processeur | Grâce à 20 noyaux | Grâce à 18 noyaux | Grâce à 20 noyaux | 20 cœurs Arm (10 Cortex-X925, 10 Cortex-A725) |
| TDP | 45 à 80W | 45 à 80W | 140W | 140 W (alimentation 240 W) |
| Mémoire unifiée | Jusqu'à 128 Go LPDDR5X | Jusqu'à 64 Go LPDDR5X | Jusqu'à 128 Go LPDDR5X | 64 Go ou 128 Go LPDDR5X, 273 Go/s |
| moteurs de médias | 1 processeur NVENC de 9e génération, 1 processeur NVDEC de 6e génération | 1 processeur NVENC de 9e génération, 1 processeur NVDEC de 6e génération | 1 processeur NVENC de 9e génération, 1 processeur NVDEC de 6e génération | 1x NVENC, 1x NVDEC |
| Affichage et E/S | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | PCIe Gen5, HDMI 2.1b, DisplayPort 2.1b | HDMI 2.1a, ConnectX-7 200 Gbit/s, 10 Gbit/s |
| Système exploitation | Windows 11 | Windows 11 | Windows 11 | Système d'exploitation NVIDIA DGX |
NVIDIA ne communique pas de chiffre concernant la densité FP4 pour la N1X ; sur la GB300, où les deux valeurs sont publiées, le chiffre pour la densité représente 75 % du chiffre pour la faible densité. Nous pensons que la conception thermique des constructeurs différenciera ces ordinateurs portables d'une manière inédite par rapport aux unités DGX Spark, et un écart de 35 W au sein de la plage de TDP des ordinateurs portables, avant tout réglage par le constructeur, en est la première preuve concrète.
Microsoft introduit une nouveauté du côté des ordinateurs de bureau. La page de son Surface RTX Spark Dev Box indique une enveloppe thermique de 100 W dans un châssis en aluminium doté de 1 000 aérations, soit 40 W de moins que le TDP annoncé par NVIDIA pour la N1X de bureau. Les deux entreprises mesurent peut-être des éléments différents (la puissance du processeur dans un cas, la conception du châssis dans l'autre), mais un acheteur comparant des ordinateurs de bureau compacts en novembre devrait interroger chaque fabricant sur la consommation électrique de son produit.
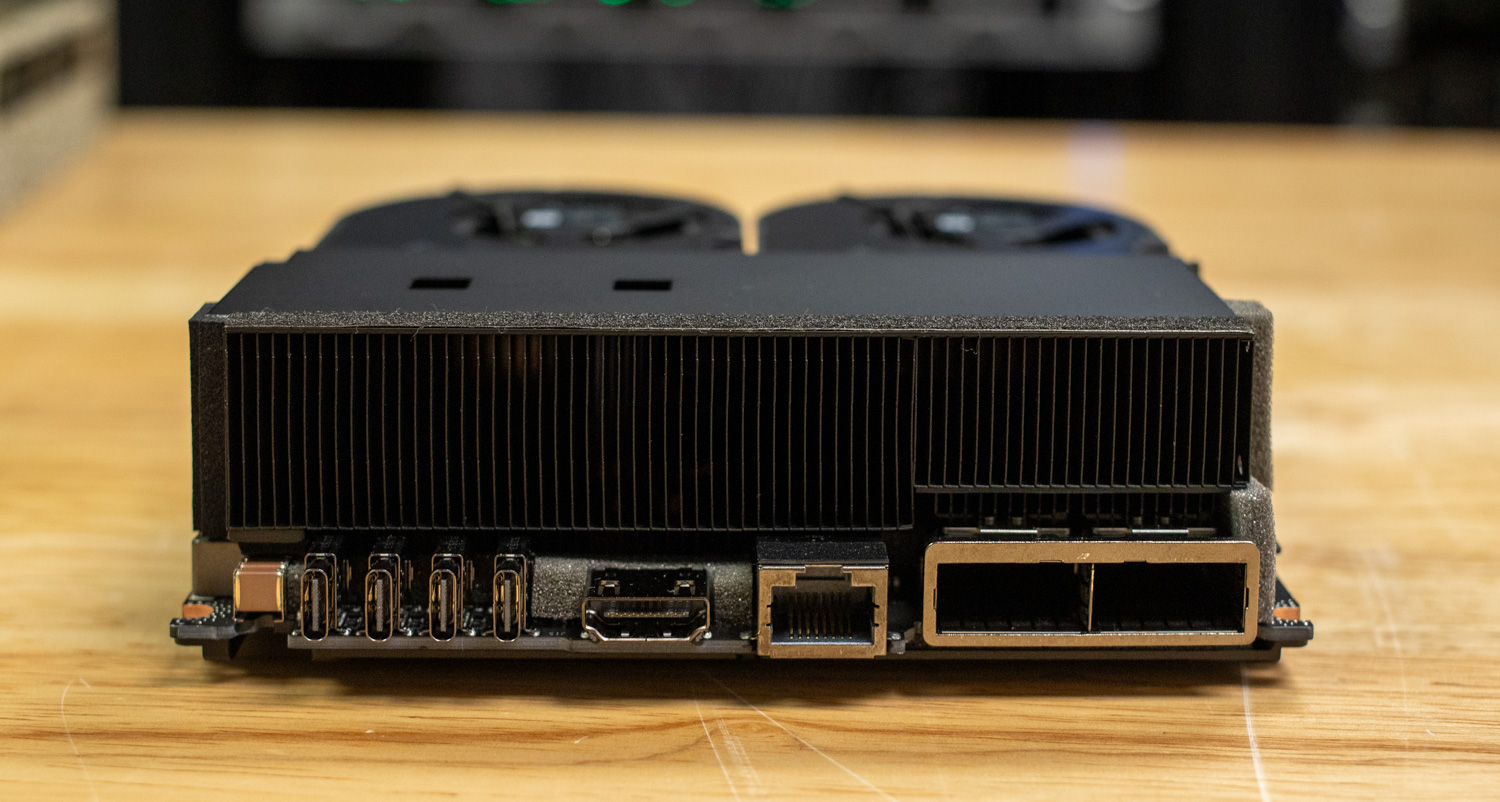
La vitesse de la mémoire est l'autre différence majeure avec la GB10. La fiche technique du XPS de Dell indique une LPDDR5X à 9 400 MT/s, ce qui, sur une interface 256 bits comme celle de la GB10, correspond à 300.8 Go/s, soit les 300 Go/s annoncés par NVIDIA en juin et environ 10 % de plus que les 273 Go/s de la DGX Spark. Le processeur et la carte graphique communiquent via NVLink-C2C à 600 Go/s. Le reste des caractéristiques est commun aux trois composants : cœurs Tensor de cinquième génération, cœurs RT de quatrième génération, DLSS 5, Reflex 2 avec Frame Warp et HDMI 2.1b jusqu'à 4K à 480 Hz ou 8K à 120 Hz avec DSC.
La plateforme NVIDIA propose 17 configurations d'ordinateurs portables en précommande, et indique la part des modèles disponibles en dessous de la configuration principale. Parmi les 15 configurations que nous avons examinées, sept utilisent le processeur à 5 120 cœurs, et la mémoire vive est disponible avec 24 Go, 32 Go, 48 Go et 128 Go, le stockage étant réparti entre les disques PCIe Gen4 et Gen5.
Comment Windows répartit 128 Go de mémoire unifiée
La mémoire est partagée dynamiquement entre le processeur et la carte graphique, et la capacité maximale de cette dernière dépend de sa configuration. Une capture d'écran du Gestionnaire des tâches, publiée par Microsoft et dans un article technique sur GitHub, illustre ce fonctionnement sur un Surface Laptop Ultra équipé du processeur N1X à 6 144 cœurs. Windows indique 74.9 Go de mémoire GPU dédiée, 35.5 Go de mémoire GPU partagée, soit un total de 110 Go de mémoire GPU et 51.5 Go de mémoire système.
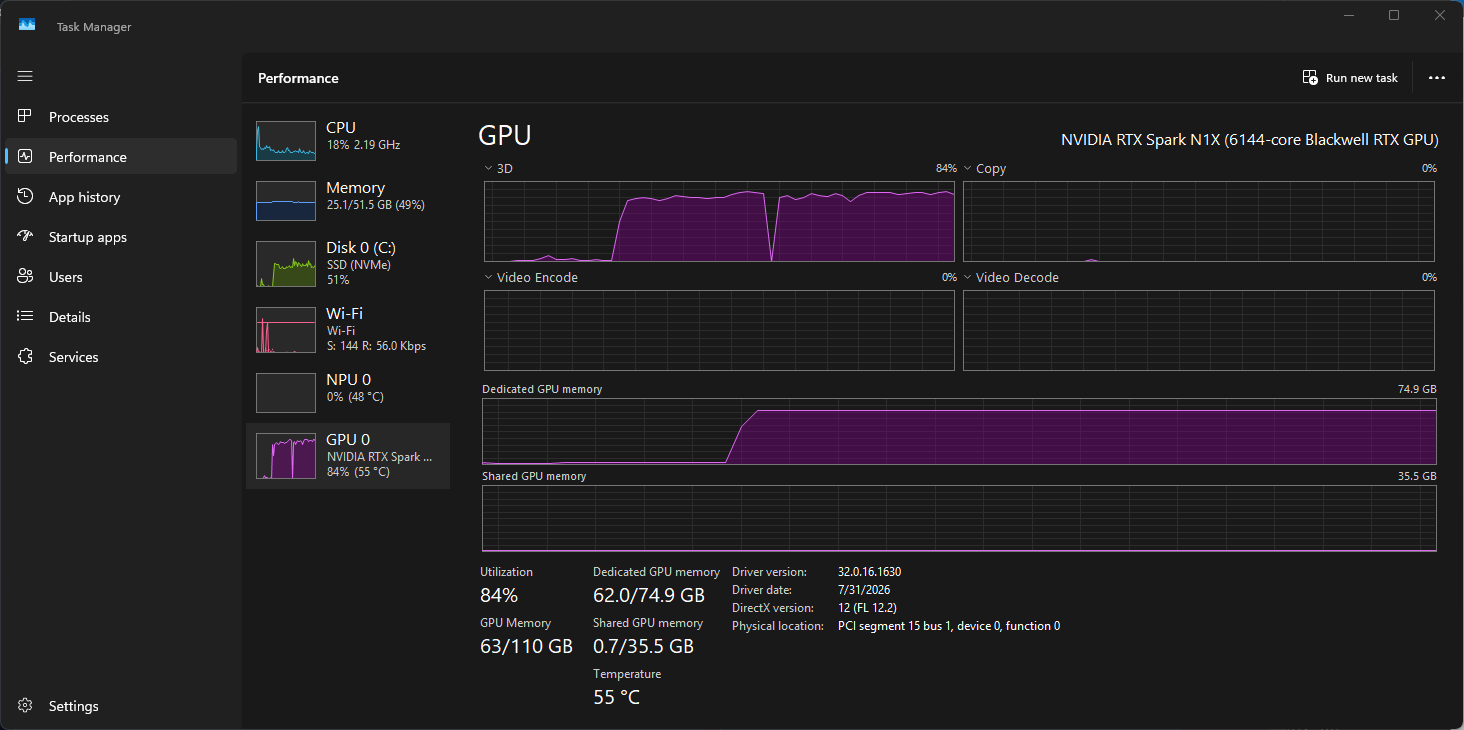
La somme de la mémoire dédiée et de la mémoire système atteint 126.4 Go. Windows présente donc le pool unifié comme il présente une carte graphique dédiée : une allocation dédiée fixe, le GPU pouvant emprunter de la mémoire système jusqu'à une certaine limite. Sur cet appareil, la limite du GPU est de 110 Go, soit 86 % des 128 Go installés, et les poids, le cache clé-valeur et la surcharge d'exécution doivent tous tenir dans cette limite. La même capture d'écran montre le pilote 32.0.16.1630, daté du 31 juillet, et un NPU listé comme un périphérique distinct du GPU.
L'article précise que les poids des modèles ne représentent qu'une partie de la mémoire allouée ; le système d'exploitation, les applications, l'environnement d'exécution de l'inférence et le cache clé-valeur qui stocke l'état d'attention pour le contexte évolutif d'un agent puisent tous dans le même pool de mémoire. Pour les configurations 24 Go et 32 Go, qui constituent la majeure partie des précommandes, cela laisse de la place pour des modèles de classe 27B en 4 bits, et guère plus. Les affirmations concernant les modèles volumineux dans les documents de lancement supposent toutes la version 128 Go.
Ce qui convient : Nombre de paramètres et bits par poids
Les limites de paramètres annoncées pour une même puce semblent quelque peu incohérentes. La page produit de NVIDIA indique des modèles prenant en charge jusqu'à 120 milliards de paramètres avec un contexte d'un million de jetons, et son blog cite Qwen 3.8 Flash Next comme exemple à 125 milliards. Microsoft annonce des modèles dépassant les 120 milliards, puis mentionne MAI Code 1.1 Flash à 137 milliards et DeepSeek V4 Flash à 284 milliards comme modèles à venir sur RTX Spark, tandis que Dell annonce 200 milliards. Cet écart s'explique par le nombre de bits alloués à chaque paramètre.
| Modèle | Paramètres | La précision | numérique | Matériau |
|---|---|---|---|---|
| MAI Code 1.1 Flash | 137 milliards au total, 6.8 milliards actifs (ensemble d'experts) | Précision mixte, environ 3.3 bits par poids | Poids de 53 Go ; pic de 75.5 Go à 256 Ko de contexte | Microsoft, GitHub |
| NVIDIA Nemotron (à venir) | Plus de 70 milliards | 2-bits | Un peu plus de 20 Go | Microsoft |
| Flash DeepSeek V4 | 284B | Non indiqué | Non indiqué | Microsoft |
| Qwen 3.8 Flash Next | 125B | Non indiqué | Non indiqué | NVIDIA |
| Qwen3.5 27B | 27B | Q4_K_M | Non indiqué | Note de bas de page sur les benchmarks de Microsoft |
Les chiffres de Microsoft concernant la mémoire Flash de MAI Code 1.1 sont les plus complets. Le modèle cloud de BF16 occuperait 274 Go ; la version installée sur l'appareil pèse 53 Go, soit une réduction de 80 % selon Microsoft, avec environ 3.3 bits par poids et une quantification à précision mixte. Le chiffre de Nemotron est similaire : 2 bits pour 70 milliards de poids représentent 17.5 Go avant surcharge. La mémoire Flash de DeepSeek V4, avec 284 milliards de paramètres, nécessite environ 3.1 à 3.3 bits par poids, voire moins, pour tenir sous la limite de 110 Go du GPU, avant même le chargement du contexte.
Ce sont les données de qualité qui rendent l'affirmation concernant les performances sur 3 bits digne d'intérêt. Microsoft indique que le modèle quantifié sur appareil obtient 70.8 % sur SWE-Bench, contre 72.6 % pour la version cloud BF16, et 66.29 % sur Terminal-Bench 2.1 contre 62.9 %. Le second résultat place le modèle quantifié en tête, ce qui, sur un ensemble de 89 tâches, représente une différence de trois tâches et nous semble anecdotique. Le modèle GPT-OSS-120B GGUF d'Unsloth, utilisé comme point de comparaison, a obtenu des scores de 32.0 % et 23.6 % sur ces mêmes deux tests.
Les données de débit proviennent d'un Surface Laptop Ultra sous Windows Arm64, utilisant llama.cpp avec le backend CUDA et le décodage spéculatif à fenêtre glissante DFlash2 (selon Microsoft), testé avec une charge de travail de génération de code synthétique. Le graphique de Microsoft ne comportant pas d'étiquettes de données, voici nos estimations : environ 63 jetons par seconde avec un contexte de 2 Ko, 61 à 8 Ko, 57 à 32 Ko, 52 à 64 Ko, 55 à 120 Ko et 39 à 256 Ko. La mémoire maximale utilisée avec un contexte de 256 Ko est de 75.5 Go, ce qui correspond exactement à la consommation du GPU dédié observée dans le Gestionnaire des tâches.

Le temps de traitement des invites est le paramètre clé à surveiller pour le travail des agents. Microsoft annonce 923.5 jetons par seconde avec un contexte de 64 Ko et 769.8 avec un contexte de 128 Ko. Le traitement d'une invite froide de 64 Ko prend environ 71 secondes, et celui d'une invite froide de 128 Ko environ 170 secondes avant l'affichage du premier jeton. L'article de blog souligne également que le maintien d'un modèle chargé ne garantit pas un temps de réponse constant et que Copilot pondère l'état du cache lors du routage des tâches. C'est pourquoi le préremplissage est le paramètre que nous mesurerons en premier sur le matériel de test.
Comparatif MacBook et ses notes de bas de page
La comparaison de Microsoft oppose les PC RTX Spark à un MacBook Pro 16 pouces équipé d'une carte graphique M5 Pro et de 64 Go de RAM : temps d'affichage du premier jeton jusqu'à 2.1 fois plus rapide, génération d'images 4.3 fois plus rapide et génération vidéo 6.2 fois plus rapide. Le premier résultat provient de tests commandés par Microsoft, réalisés avec llama.cpp, une carte graphique Qwen 3.5 de 27 octets (Q4_K_M) et une invite de 8 192 jetons. Les deux autres résultats sont des tests NVIDIA réalisés avec ComfyUI, utilisant une carte graphique FLUX 2 Klein de 4 octets (quatre étapes, résolution 1024 x 1024) et une carte graphique LTX 2.3 de 22 octets (121 images, huit étapes, résolution 1280 x 720).
Les notes de bas de page comportent plusieurs précisions, à commencer par le matériel : tous les tests ont été effectués en septembre sur des systèmes RTX Spark de préproduction dotés de 64 Go de RAM, et le système Apple utilisé est le M5 Pro ; aucun M5 Max n’a été inclus dans la comparaison. Les deux tests ComfyUI ont utilisé les modèles à une précision NVFP4, et les notes de bas de page ne décrivent pas la configuration logicielle du Mac. Le résultat du modèle de langage correspond à une mesure de préremplissage pour une longueur d’invite donnée ; aucune des deux entreprises n’a publié de comparaison du nombre de jetons décodés par seconde, chiffre pourtant couramment cité par les utilisateurs locaux de modèles de langage.
Côté jeux, NVIDIA affirme que la RTX Spark fait tourner les titres AAA en 1440p à plus de 100 images par seconde avec DLSS 5, Reflex et G-SYNC, sans préciser les titres ni les paramètres. Microsoft propose quant à elle Gears of War: E-Day avec le ray tracing DirectX, le VRS (Variable Rate Shading), DirectStorage et l'ADL (Advanced Shader Delivery), qui, selon Microsoft, réduit la compilation des shaders au lancement de plusieurs minutes à quelques secondes. L'entreprise s'est également engagée à ce que Call of Duty arrive sur RTX Spark en 2027. Retrouvez plus d'informations sur Prism et le système anti-triche dans notre article consacré à Dell.
Conteneurs d'exécution Microsoft : fonctionnement du bac à sable de l'agent
MXC est l'élément de l'annonce ayant la plus grande portée, car il s'applique à tout PC Windows 11 et est distribué sous forme de bibliothèque open source et de SDK multilingue avec des backends pour macOS et Linux. Un développeur déclare les besoins d'une charge de travail dans une stratégie JSON : les fichiers qu'elle peut modifier, les fichiers qu'elle peut uniquement lire, l'accès réseau entrant et sortant, et son autorisation d'accéder au bureau. MXC applique cette stratégie à un backend d'isolation lors de l'exécution. La stratégie étant externe à la charge de travail, le code généré ne peut pas s'octroyer d'accès supplémentaires.
| Backend MXC | Plateformes | Mécanisme | Utilisation prévue |
|---|---|---|---|
| Conteneur de traitement | Windows 11, macOS, Linux | AppContainer sous Windows, Seatbelt sous macOS, Bubblewrap sous Linux | Confinement à faible latence pour l'exécution du code généré par le modèle et des outils |
| conteneur de session | Windows 11 uniquement | Compte et session Windows distincts, chacun avec son propre bureau, presse-papiers, interface utilisateur et entrées. | Agents et automatisation de longue durée nécessitant un ordinateur de bureau |
| Conteneur WSL (WSLc) | Windows 11 uniquement | Environnement d'exécution Linux via WSL | chaînes d'outils d'agents prioritaires pour Linux |
| MicroVM | Windows 11 et Linux (expérimental) | Limite virtualisée imposée par le matériel | Charges de travail à risque élevé et code non fiable |
Le cycle de création de stratégies comprend trois modes de fonctionnement : le mode « Application » bloque toute action non conforme à la stratégie ; le mode « Apprentissage » bloque également l’opération et l’enregistre dans un rapport d’activité JSON ; et le mode « Permissif » autorise l’opération et enregistre ce qui aurait été refusé. Ainsi, une équipe peut tester un agent en situation réelle et élaborer une stratégie de moindre privilège à partir des données recueillies. Le rapport d’activité est disponible uniquement pour les conteneurs de processus sous Windows. Les organisations peuvent ajouter leurs propres contraintes à la stratégie d’un développeur via des outils de gestion. Microsoft annonce que la gestion des conteneurs de processus MXC par Intune sera bientôt disponible.
Il est important de préciser ce qui est généralement disponible : le confinement est la fonctionnalité déployée depuis le 7 octobre. L’identité de l’agent, qui permet à Microsoft Entra de distinguer les actions d’un agent de celles de l’utilisateur connecté, sera bientôt disponible, tout comme l’extension des contrôles d’Agent 365 aux agents locaux. En attendant, un conteneur MXC limite l’accès d’un agent, mais les outils de sécurité continuent de percevoir son activité sous l’identité de l’utilisateur, et la gouvernance à l’échelle du parc décrite par Microsoft n’est pas encore en place ; une note de bas de page indique d’ailleurs que la gouvernance à grande échelle peut nécessiter des services supplémentaires.
La description de l'intégration fournie par GitHub indique clairement où se situe la limite. Copilot utilise la couche de base du conteneur de processus sous Windows, et les commandes shell, ainsi que les serveurs MCP locaux et les serveurs de langage (par défaut), s'y exécutent. Les outils de fichiers intégrés à Copilot s'exécutent dans l'environnement de l'agent, où les requêtes sont vérifiées par rapport à une politique, mais ne sont pas isolées par le système d'exploitation. Les serveurs MCP distants, quant à eux, sont totalement situés en dehors de l'environnement isolé local. L'inférence locale ne change rien à cela, car une commande shell hérite des mêmes droits d'accès, quel que soit le modèle qui l'a demandée.
Les agents compatibles avec MXC incluent aujourd'hui GitHub Copilot, OpenAI Codex, OpenClaw, Replit, LM Studio et Unsloth AI. Claude Code, Perplexity, Manus et Hermes Agent devraient prochainement être pris en charge. NVIDIA a intégré OpenShell à MXC, ce qui, selon Microsoft, renforce le contrôle des accès des agents aux fichiers et aux services d'inférence, offre des contrôles réseau avancés, la gestion des identifiants et l'audit OCSF pour les entreprises.
Huang a insisté sur l'importance de cette annonce pour la couche conteneur : « De même que Windows et DirectX ont révolutionné la conception des applications, MXC va révolutionner la conception et le déploiement des agents. » Notre point de vue est plus restreint : le modèle de stratégie est solide et le SDK multiplateforme réduit les coûts d'adoption, mais la seule intégration décrite en détail à ce jour utilise le backend le plus léger, et l'isolation d'un agent dépend entièrement du backend choisi par son développeur.
Routage hybride : HydraFusion, Windows ML et llama.cpp
Les modèles locaux sont mis à la disposition des développeurs via GitHub Copilot. HydraFusion, lancé par GitHub en début d'année pour acheminer chaque tâche vers le modèle cloud approprié, est étendu aux modèles présents sur l'appareil. Une version préliminaire sera disponible dans l'application Copilot, l'interface de ligne de commande Copilot et Visual Studio Code fin octobre. Les développeurs peuvent laisser le placement sur « Auto » ou sélectionner explicitement un modèle local : MAI Code 1.1 Flash via le fournisseur Windows ML ou tout modèle accessible via un point de terminaison local compatible OpenAI.
Microsoft a également ajouté la prise en charge de llama.cpp à Windows ML, l'environnement d'exécution utilisé pour générer les numéros de code MAI mentionnés ci-dessus. Cette intégration offre à l'écosystème des modèles ouverts une voie d'accès prise en charge à la plateforme. Notre page « Meilleurs outils LLM locaux » recense les environnements d'exécution et les interfaces utilisateur développés sur cette plateforme. Cependant, Microsoft minimise cette affirmation. Sa page Dev Box indique que le routage intelligent peut décharger jusqu'à 20 % des charges de travail de Copilot vers des modèles locaux, ce qui présente l'inférence locale comme un moyen d'optimiser le budget des jetons, le cloud conservant la majeure partie du travail.
Systèmes, prix et dates
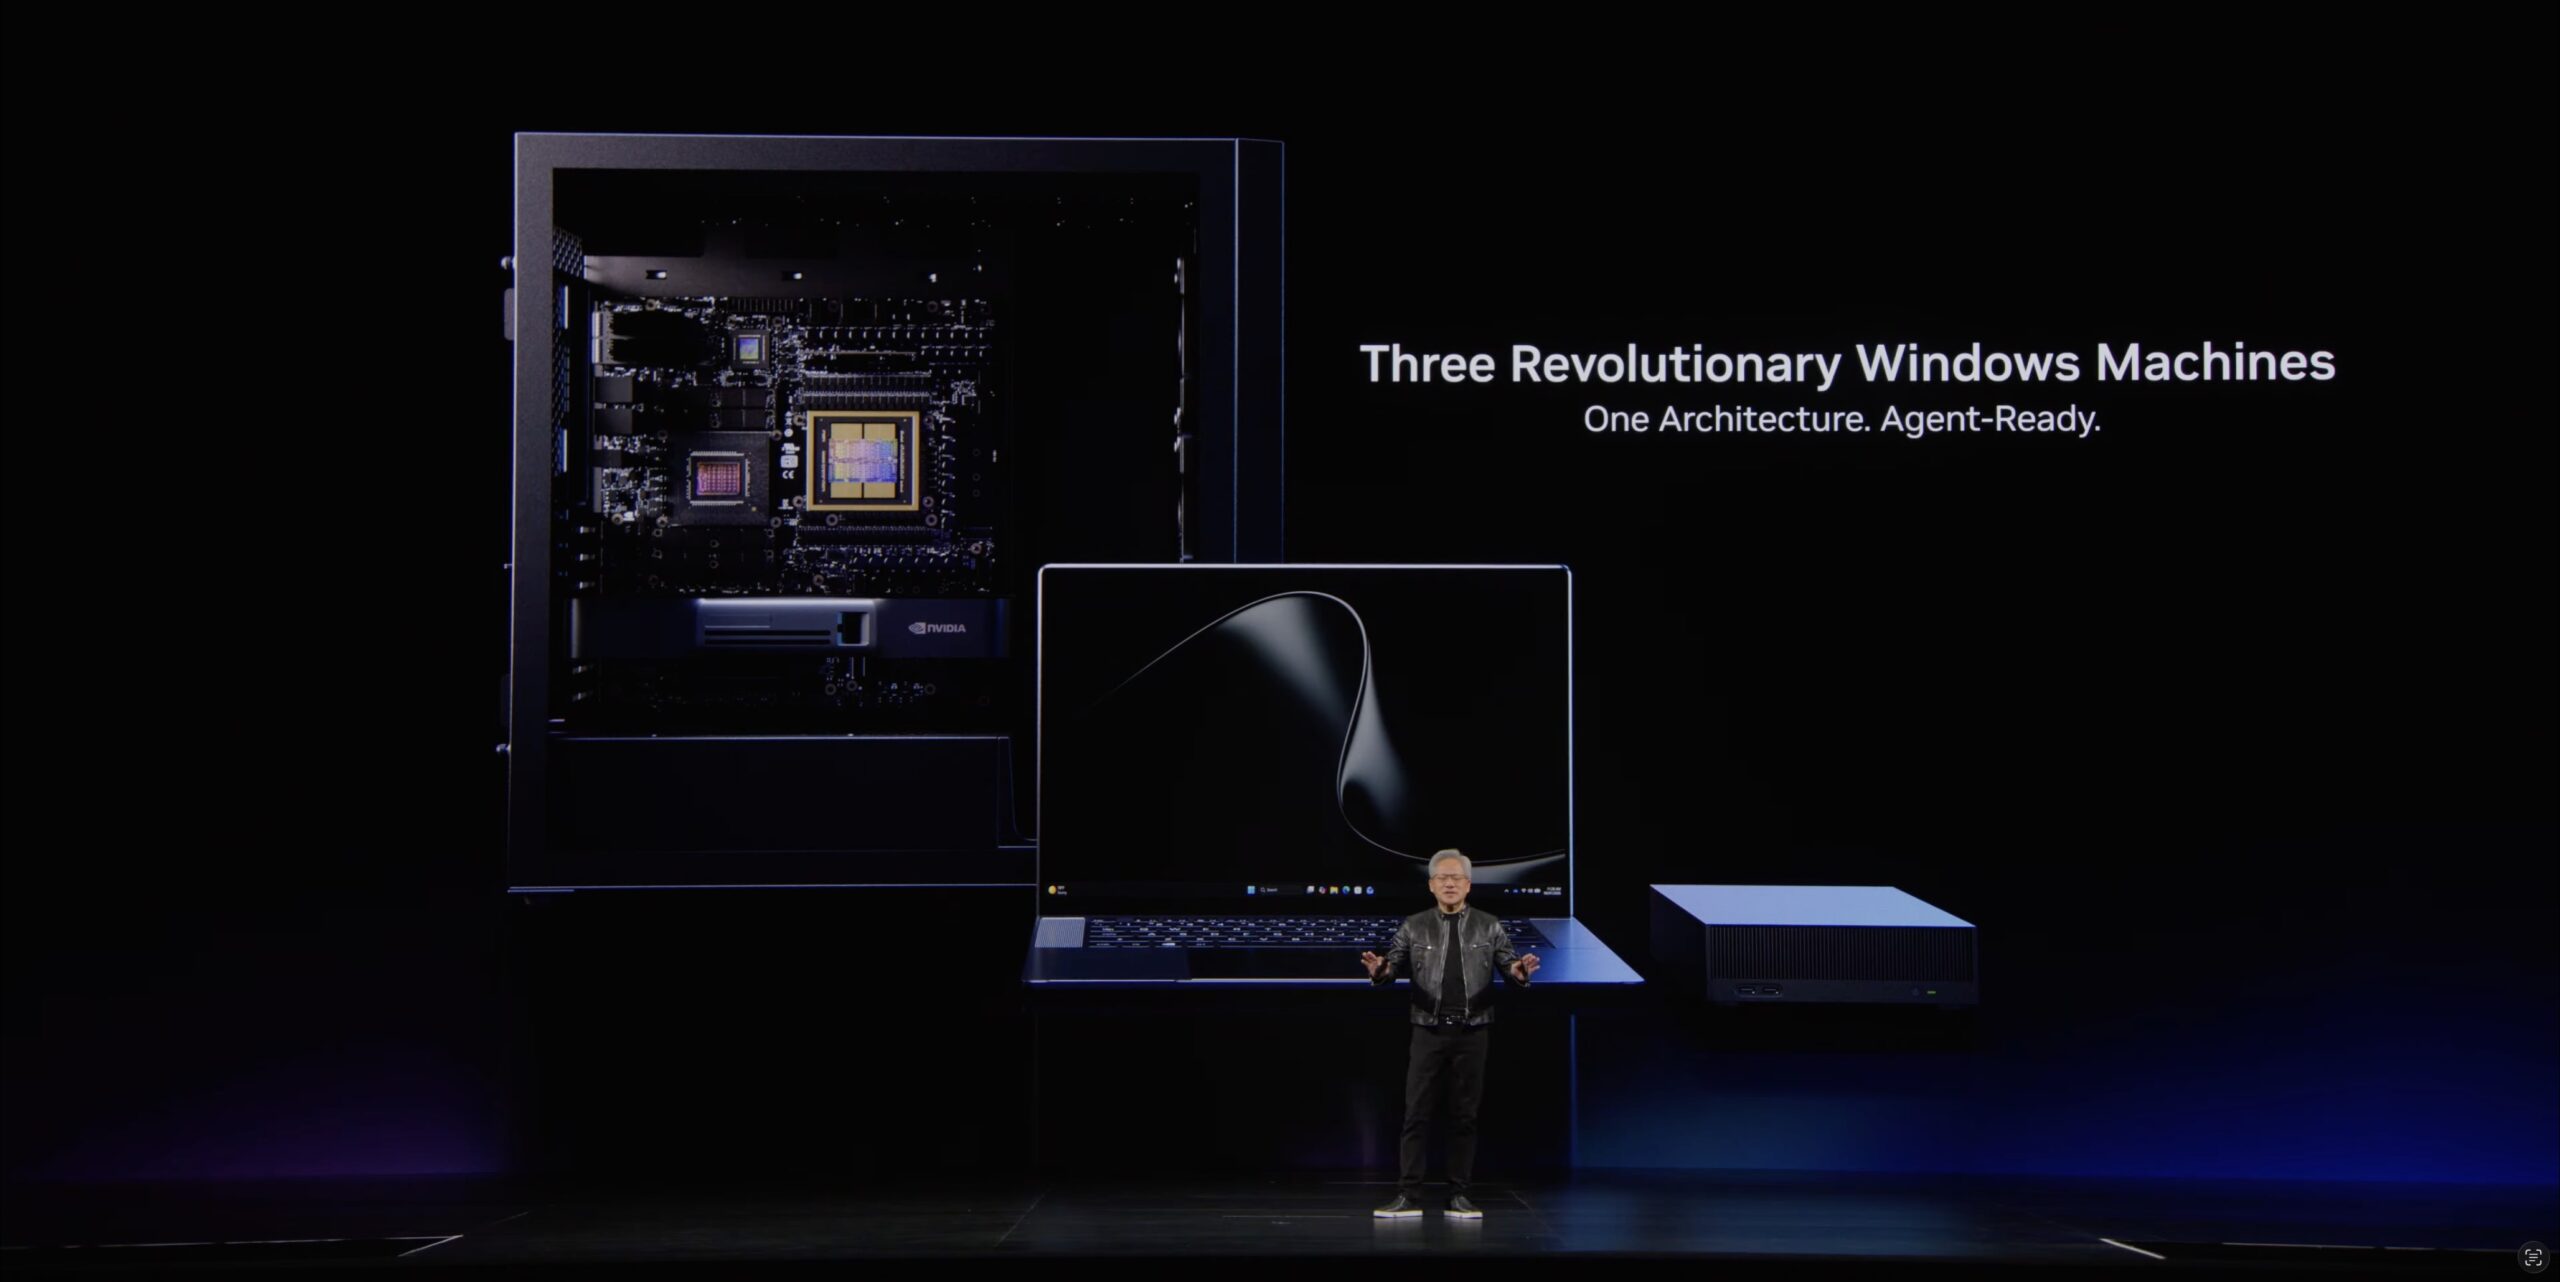
Six constructeurs proposent des ordinateurs portables en précommande pour le 16 octobre : les ASUS ProArt P16 et P14, le Dell XPS 16 Creator Edition , le HP OmniBook Ultra 16, le Lenovo Yoga 9n 2-en-1, le MSI Prestige N16 Flip AI+ et le Microsoft Surface Laptop Ultra. La plateforme NVIDIA mentionne également le HP OmniBook X 14. Le modèle de MSI est équipé d'un écran OLED tandem UHD+ de 16 pouces et d'une batterie de 99.9 Wh. NVIDIA cite par ailleurs Acer et Gigabyte parmi les fabricants qui commercialiseront des systèmes RTX Spark.
Le Surface Laptop Ultra est proposé à partir de 2 599 $, le prix le plus bas jamais constaté pour une carte graphique RTX Spark. Son châssis, conçu par Microsoft, ne dépasse pas 18 mm d'épaisseur et pèse moins de 2 kg. Microsoft annonce une capacité thermique 2.5 fois supérieure à celle de ses Surface Laptop actuels, un écran tactile 15 pouces à 120 Hz (3 270 x 2 180 pixels) avec une luminosité HDR maximale de 2 000 nits (mesurée sur une fenêtre de 10 %), un stockage amovible et un port USB-C magnétique permettant la charge et la transmission de données et de vidéos. Une alimentation de 140 W est fournie avec certaines configurations. La configuration d'entrée de gamme sur la plateforme NVIDIA associe la puce à 5 120 cœurs à 24 Go de RAM et un SSD Gen4 de 512 Go.
Le Surface RTX Spark Dev Box est le premier ordinateur de bureau compact vendu exclusivement sur Microsoft.com aux États-Unis. Proposé à 5 999 $ avec 128 Go de mémoire, il sera disponible en novembre avec Visual Studio Code, Git, GitHub Copilot, WSL, Python et Node préinstallés. Son prix est supérieur de 1 000 $ à celui du DGX Spark 64 Go (4 999 $) , qui offre pourtant deux fois plus de mémoire. Microsoft mentionne deux ports USB-C, un port USB-A, un port HDMI, un port Ethernet et une prise casque, mais ne fait aucune mention des ports ConnectX-7 permettant le clustering des DGX Spark, une solution que nous avions évoquée en juin concernant la connectivité réseau.
Station DGX pour Windows : Quatrième trimestre, avec le tableau des spécifications complet
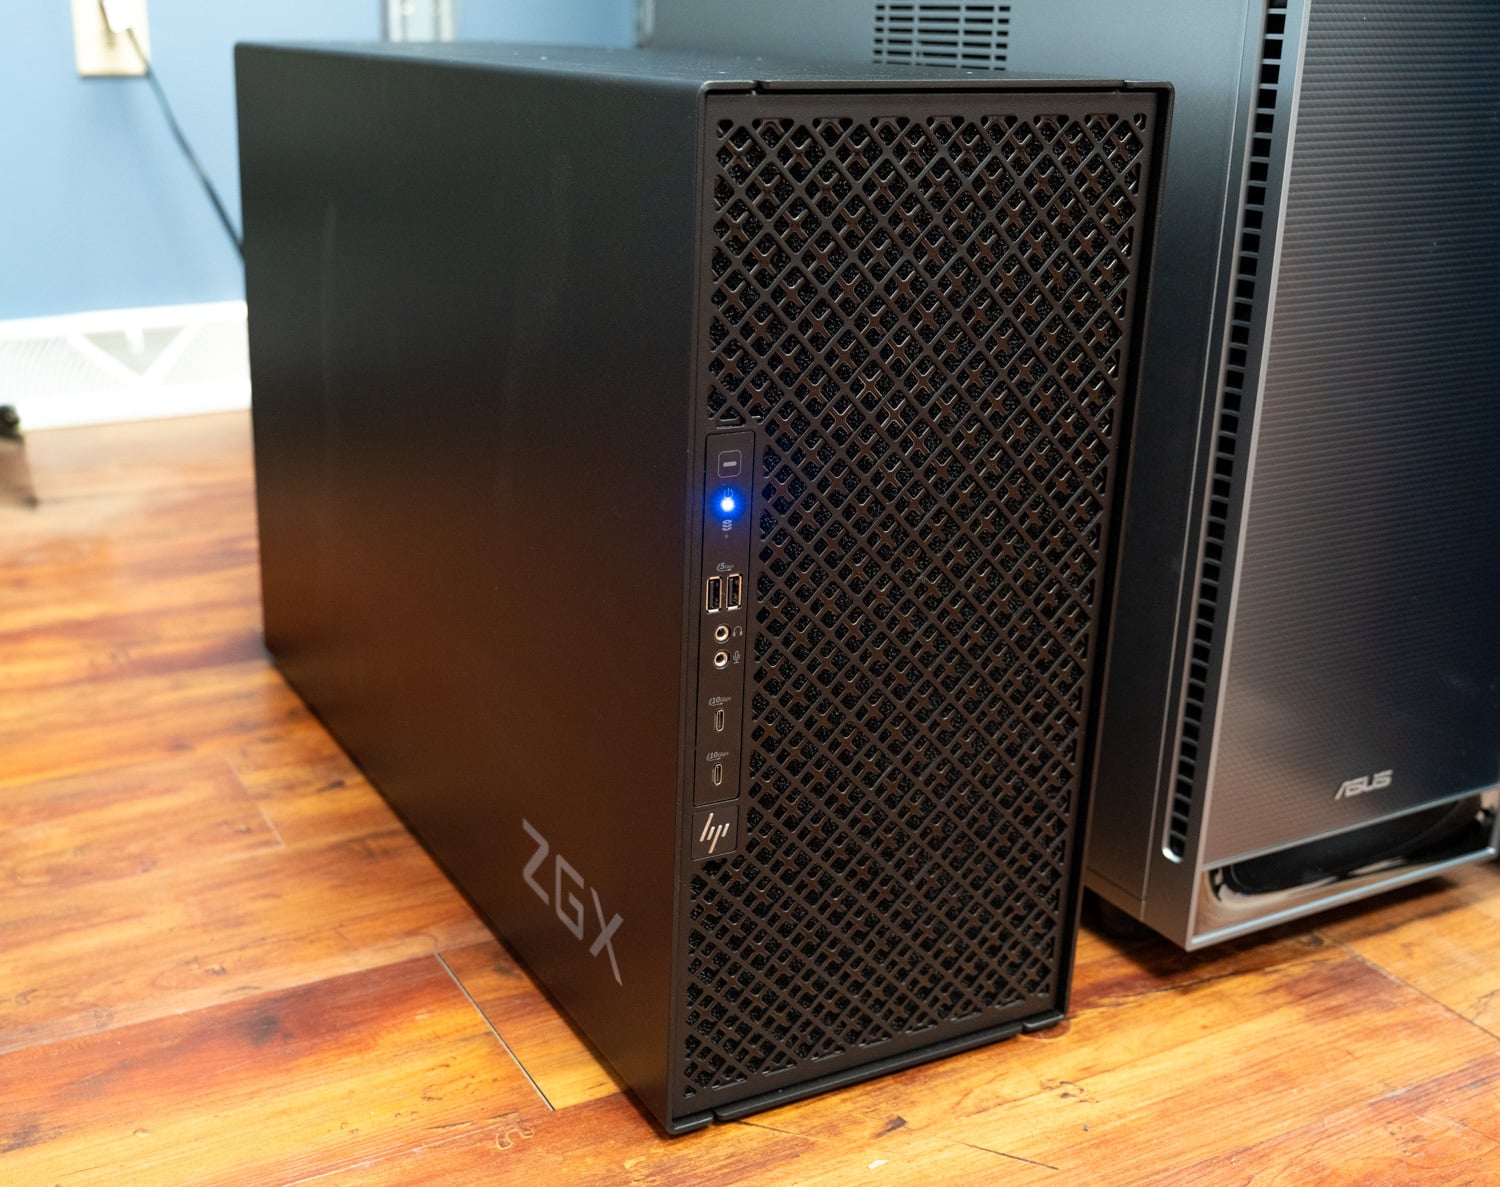
La page NVIDIA dédiée à DGX Station pour Windows indique désormais « Disponible au quatrième trimestre », tandis que Microsoft annonce une arrivée des systèmes plus tard dans l'année, citant en premier lieu le Dell Pro Precision avec GB300 et la station d'IA HP ZGX Fury. La liste des partenaires NVIDIA s'enrichit d'ASUS, Gigabyte, MSI et Supermicro. Le matériel est le processeur graphique GB300 Grace Blackwell Ultra Desktop Superchip, que nous avons testé sous Ubuntu sur la MSI XpertStation WS300 , l' ASUS ExpertCenter Pro ET900N G3 et dans une configuration à deux tours.
| Spécifications | Station NVIDIA DGX pour Windows |
|---|---|
| GPU | 1x NVIDIA Blackwell Ultra, 252 Go HBM3e à 7.1 To/s |
| Processeur | 1 processeur Grace, 72 cœurs Neoverse V2, 496 Go de mémoire LPDDR5X à 396 Go/s |
| Mémoire cohérente | Jusqu'à 748 Go ; NVLink-C2C à 900 Go/s |
| Noyau tenseur FP4 | 20 PFLOPS avec parcimonie ; 15 PFLOPS sans |
| Noyau Tensor FP8 et FP6 | 10hXNUMX FPLOPS |
| Noyau Tensor FP16 et BF16 | 5hXNUMX FPLOPS |
| Noyau tenseur TF32 | 2.5hXNUMX FPLOPS |
| FP32 / FP64 | 80 TFLOPS / 1.3 TFLOPS |
| Networking | SuperNIC ConnectX-8, jusqu'à 800 Gbit/s : 2 ports QSFP112 à 400 Gbit/s chacun 1 port RJ-45 10GbE, 1 port RJ-45 1GbE (BMC) |
| Stockage | 4 emplacements M.2 PCIe Gen5 |
| Emplacements PCIe | 1 port PCIe Gen5 x16 ; 2 ports PCIe Gen5 x16 (x8 électrique) |
| Cartes graphiques RTX PRO prises en charge | RTX PRO 6000 Workstation Edition, RTX PRO 6000 Blackwell Max-Q Workstation Edition, RTX PRO 4000 Blackwell SFF Edition, RTX PRO 2000 Blackwell (la compatibilité peut varier selon le système) |
| Décodeurs | 7 NVDEC, 7 nvJPEG |
| Puissance du système | 1 600 W ; circuit de 20 A requis |
| Système exploitation | Chaînes d'outils Microsoft Windows et Linux via WSL |
Microsoft décrit deux usages pour la station Windows DGX. Le premier est un supercalculateur d'IA personnel destiné aux travaux d'ingénierie et de recherche, exécutant des modèles tels que Llama 4 Maverick, Kimi K2.6 et DeepSeek V4 Pro, sur un matériel prenant en charge, selon une note de bas de page, des modèles jusqu'à 1 000 milliards de paramètres. Le second est ce qu'elle appelle une « usine à jetons Windows », un système partagé prenant en charge 32 agents simultanés ou plus pour une équipe, afin de réduire la consommation de jetons cloud. Microsoft précise que les équipes informatiques peuvent gérer ces systèmes avec les mêmes outils que ceux utilisés pour l'ensemble de son parc Windows.
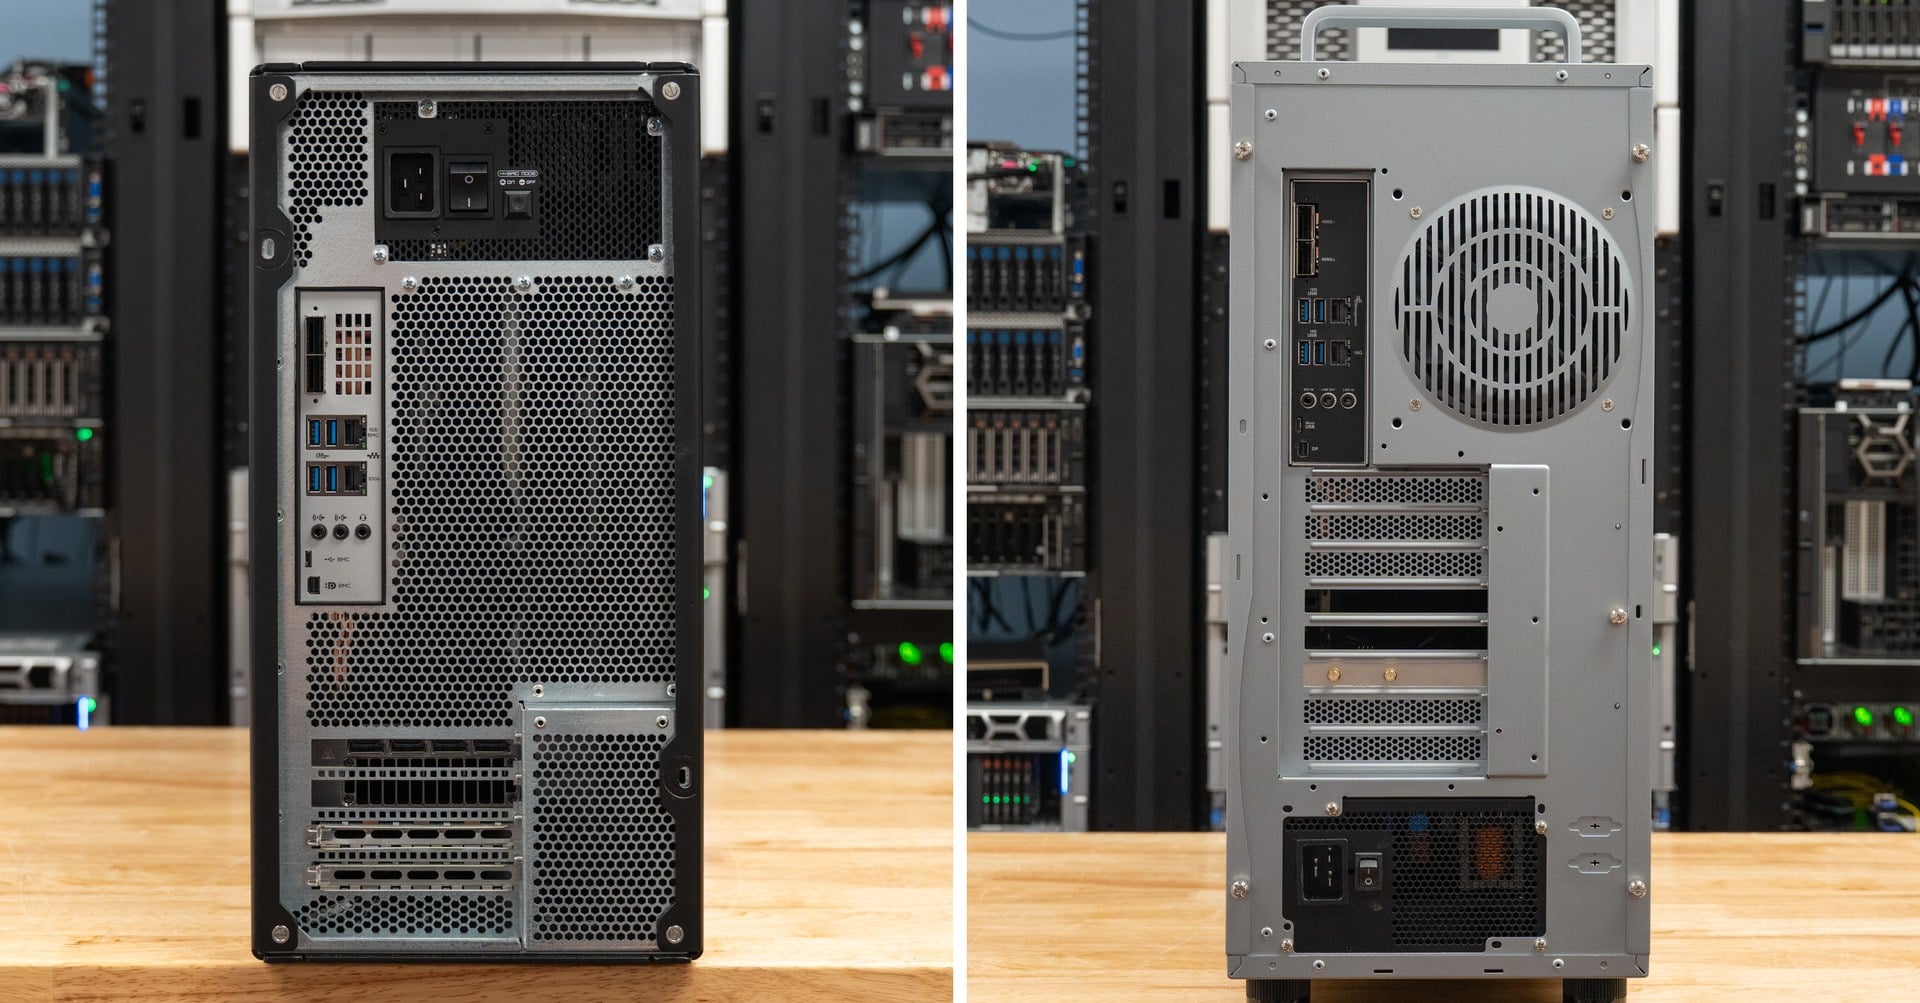
La carte RTX PRO optionnelle est plus importante sous Windows que sous Linux. Comme nous l'avons constaté au Computex, le GPU Blackwell Ultra du GB300 ne possède pas de cœurs RT ; par conséquent, la visualisation par lancer de rayons dans les applications de conception et d'ingénierie Windows est exécutée par la carte additionnelle, le superprocesseur gérant l'IA. NVIDIA répertorie quatre cartes RTX PRO Blackwell compatibles, de la RTX PRO 2000 à la 6000, et précise que la compatibilité peut varier selon le système.
La question restée en suspens depuis juin demeure. Nos travaux sur le GB300 ont été entièrement réalisés sous Ubuntu avec vLLM et la pile de conteneurs NVIDIA. Or, aucune des deux sociétés n'a précisé quelles piles de serveurs fonctionnent nativement sous Windows sur ce matériel et lesquelles fonctionnent sous WSL, ni le coût de WSL en termes de débit sur un hôte Grace à 72 cœurs équipé de deux ports 400 Gb/s. Ce sont les premiers points que nous testerons dès réception d'un serveur Windows au laboratoire.
En résumé
Les documents de lancement répondent à plusieurs questions restées en suspens lors du Computex. Les ordinateurs portables consomment entre 45 et 80 W avec la puce, tandis que les ordinateurs de bureau consomment 140 W. L'option 128 Go est liée à la puce la plus performante des deux. Windows limite la mémoire adressable par le GPU en deçà de la capacité totale installée. Enfin, le premier ordinateur de bureau compact de Microsoft ne propose aucune connectivité réseau haut débit. L'affirmation de Pavan Davuluri, vice-président exécutif de Microsoft en charge de Windows et des périphériques, selon laquelle « cet ordinateur portable permet d'exécuter des modèles qui ne tiennent tout simplement pas sur une machine traditionnelle », se vérifie pour les configurations 128 Go. Le modèle de codage 137B de Microsoft, fonctionnant à environ 60 jetons par seconde, en est une illustration.
Il manque encore des informations sur tout ce qui dépend du châssis : l’autonomie lors d’une longue session d’agent, le débit de décodage par rapport aux systèmes Apple M5 Max et AMD Strix Halo, l’autonomie de la batterie en inférence et le prix de la plupart des ordinateurs portables de 128 Go. Nous ignorons également quand Windows sera disponible sur le DGX Spark basé sur GB10, qui a reçu un certificat de démarrage Windows dans son firmware le mois dernier. Les unités de test seront soumises aux mêmes tests que ceux utilisés pour nos classements des meilleurs ordinateurs portables et de bureau pour l’IA locale .



 Amazon