

MLCommons သည် MLPerf Inference v6.1 ကိုထုတ်ဝေခဲ့ပြီး၊ အဆိုပါပြိုင်ပွဲတွင် အဖွဲ့အစည်း ၃၀ မှ တင်သွင်းပြီး datacenter နှင့် edge ရလဒ် ၄၈၆ ခုဖြင့် ပါဝင်မှုမှတ်တမ်းသစ်တစ်ခုကို တင်ခဲ့သည်။ စမ်းသပ်မှုအသစ်နှစ်ခုပါဝင်သည်- datacenter အတွက် End-to-End RAG pipeline နှင့် single-user devices များအတွက် Edge Agentic Inference benchmark ဖြစ်ပြီး၊ ရလဒ်များတွင် NVIDIA ၏ Vera Rubin NVL72၊ AMD ၏ Instinct MI350P၊ Intel ၏ Arc Pro B70 နှင့် AMD ၏ Ryzen AI Max+ 395 တို့အတွက် ပထမဆုံး peer-reviewed နံပါတ်များကို သယ်ဆောင်ထားသည်။ တိုးတက်မှုနှုန်းနှင့်ပတ်သက်၍ MLCommons က server scenario တွင် အကောင်းဆုံး per-accelerator DeepSeek-R1 ရလဒ်သည် လွန်ခဲ့သောတစ်နှစ်က v5.1 ထက် ၅.၇ ဆ ပိုကောင်းပြီး အကောင်းဆုံး VLM ရလဒ်သည် v6.0 မှစ၍ ခြောက်လအတွင်း ၂.၉၉ ဆ တိုးတက်ကောင်းမွန်လာကြောင်း ပြောကြားခဲ့သည်။
စမ်းသပ်မှုအသစ်နှစ်ခု- အဆုံးမှအဆုံး RAG နှင့် Edge Agentic Inference
End-to-End RAG benchmark သည် မေးခွန်း-ဖြေဆိုခြင်း pipeline တစ်ခုလုံး၊ မော်ဒယ်များစွာနှင့် vector database တစ်ခု အတူတကွ လုပ်ဆောင်ခြင်းကို တိုင်းတာသည်။ reference implementation သည် မော်ဒယ်လေးခုကို အတူတကွ လုပ်ဆောင်သည်- gpt-oss-120B သည် query decomposition၊ sufficiency checking နှင့် answer generation တို့ကို ကိုင်တွယ်သည်။ gpt-oss-20B သည် ရယူထားသော စာရွက်စာတမ်းများကို အဆင့်သတ်မှတ်သည်။ e5-base-v2 သည် embedding များကို ထုတ်လုပ်သည်။ ColBERTv2 သည် passages များကို ပြန်လည်အဆင့်သတ်မှတ်သည်။ corpus တွင် HTML ဖိုင် ၂,၅၁၅ ခုမှ အပိုင်းလိုက် passages ၁၀၇,၄၈၄ ခု ပါဝင်သည်။ မေးခွန်းများသည် Google ၏ FRAMES dataset မှ multi-hop task ၈၂၄ ခုဖြစ်သည်။ pipeline သည် လုံလောက်သော အထောက်အထားရှိသည်ဟု မဆုံးဖြတ်မီ task တစ်ခုစီသည် retrieval ၅ ကြိမ်အထိ loop လုပ်နိုင်သည်။ metrics နှစ်ခု ထွက်လာသည်- FAISS HNSW vector database တည်ဆောက်ရန်အတွက် တစ်စက္ကန့်လျှင် documents နှင့် ၎င်းနှင့် ဆန့်ကျင်သော မေးခွန်းများကို ဖြေဆိုရန်အတွက် တစ်စက္ကန့်လျှင် task များ။ Llama 3.1-8B judge သည် နောက်ဆုံးအဖြေများကို ၉၇% accuracy target နှင့် အမှတ်ပေးပြီး အကဲဖြတ်ခြင်းကို အချိန်မသတ်မှတ်ထားပါ။
Edge Agentic Inference benchmark သည် workstation များနှင့် desktop AI box များပေါ်သို့ ရွေ့လျားသွားသော coding-assistant pattern ကို ပစ်မှတ်ထားသည်။ မော်ဒယ်မှာ Qwen3.6-27B ဖြစ်ပြီး thinking off ဖြင့် reference တွင် llama.cpp အောက်ရှိ Q4_K_M GGUF အဖြစ် run ထားပြီး turn တစ်ခုလျှင် context window 32K ဖြင့် serve လုပ်ထားသည်။ performance workload သည် SWE-bench Verified မှ ဆွဲထုတ်ထားသော agentic coding trajectories ၂၀ ကို record လုပ်ထားပြီး စုစုပေါင်း turn ၁၀၀၇ ခုကို request တစ်ခုဖြင့် single stream တွင် မောင်းနှင်ထားပြီး laptop ပေါ်ရှိ developer တစ်ဦးက agent တစ်ခုကို run သကဲ့သို့ဖြစ်သည်။ အစီရင်ခံထားသော metric မှာ turn တစ်ခုလျှင် mean latency ဖြစ်ပြီး time-to-first-token နှင့် time-per-output-token distributions များနှင့်အတူ ရှိပြီး accuracy ကို reference score ၏ 97% တွင် BFCL v4 မှ သီးခြားစီ ကန့်သတ်ထားသည်။ MLCommons သည် ၎င်း၏ လာမည့် MLPerf Agentic datacenter benchmark မှ framework ကို လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်ထားသည်။
"မေးခွန်းဖြေကြားခြင်းသည် corpus ပေါ်တွင် လေ့ကျင့်ထားသော LLM ထက်ကျော်လွန်၍ တိုးတက်ပြောင်းလဲလာကြောင်း ထင်ရှားသောကြောင့် End-to-end RAG စမ်းသပ်မှုကို ကျွန်ုပ်တို့ ထည့်သွင်းခဲ့ပါသည်။ ယနေ့တည်ဆောက်နေသော multi-step၊ multi-component pipeline အမျိုးအစားများ၏ လက်တွေ့ကမ္ဘာစွမ်းဆောင်ရည်ကို အကျိုးတူပါဝင်သူများ နားလည်ရန် လိုအပ်ပါသည်" ဟု MLPerf Inference လုပ်ငန်းအဖွဲ့၏ တွဲဖက်ဥက္ကဋ္ဌ Miro Hodak က ပြောကြားခဲ့သည်။ "အလားတူပင်၊ agentic properties များပါရှိသော ရှုပ်ထွေးသော inference စနစ်များကို edge computing devices များတွင် ပိုမိုများပြားစွာ host လုပ်ထားသောကြောင့် ကျွန်ုပ်တို့၏ဖောက်သည်များ ယနေ့ရင်ဆိုင်နေရသော စွမ်းဆောင်ရည်ဆိုင်ရာစိန်ခေါ်မှုအသစ်များကို ဖန်တီးပေးသောကြောင့် Edge Agentic Inference စမ်းသပ်မှုကို ကျွန်ုပ်တို့ ထည့်သွင်းခဲ့ပါသည်။"
ယခင်က DeepSeek-R1 တွင်သာ ကန့်သတ်ထားသော speculative decoding support ကို interactive scenario ရှိ GPT-OSS benchmark အထိ ဤ round သည် တိုးချဲ့ပေးပြီး ၁.၅ စက္ကန့်ခန့် ပစ်မှတ်ထားသော တုံ့ပြန်မှုများဖြင့် VLM စမ်းသပ်မှုအတွက် interactive scenario အသစ်တစ်ခုကို သတ်မှတ်ပေးပါသည်။
Desktop မှ Rack အထိ ဆီလီကွန်အသစ်
NVIDIA ရဲ့ Vera Rubin NVL72 ဟာ NVIDIA နဲ့ Nebius တို့က VR200 NVL72 မှာ တင်သွင်းတဲ့ preview အမျိုးအစားမှာ MLPerf ပွဲဦးထွက်ခဲ့ပါတယ်။ NVIDIA က TensorRT-LLM ကိုအသုံးပြုတဲ့ offline, server နဲ့ interactive scenarios တွေမှာ DeepSeek-R1 မှာ GB300 NVL72 ထက် token throughput ၂.၅ ဆအထိ ပိုများပြီး NVIDIA Dynamo နဲ့ vLLM ကိုအသုံးပြုတဲ့ Qwen3 vision-language model မှာ ၃.၇ ဆအထိ ပိုများတယ်လို့ အစီရင်ခံပါတယ်။ ဒါတွေက NVIDIA ရဲ့ ယခင်မျိုးဆက်နဲ့ နှိုင်းယှဉ်ချက်တွေဖြစ်ပြီး preview သတ်မှတ်ချက်က ဒီ platform ကို နောက်အဆင့်မှာ စီးပွားဖြစ်ရရှိနိုင်မယ်လို့ မျှော်လင့်ရပါတယ်။
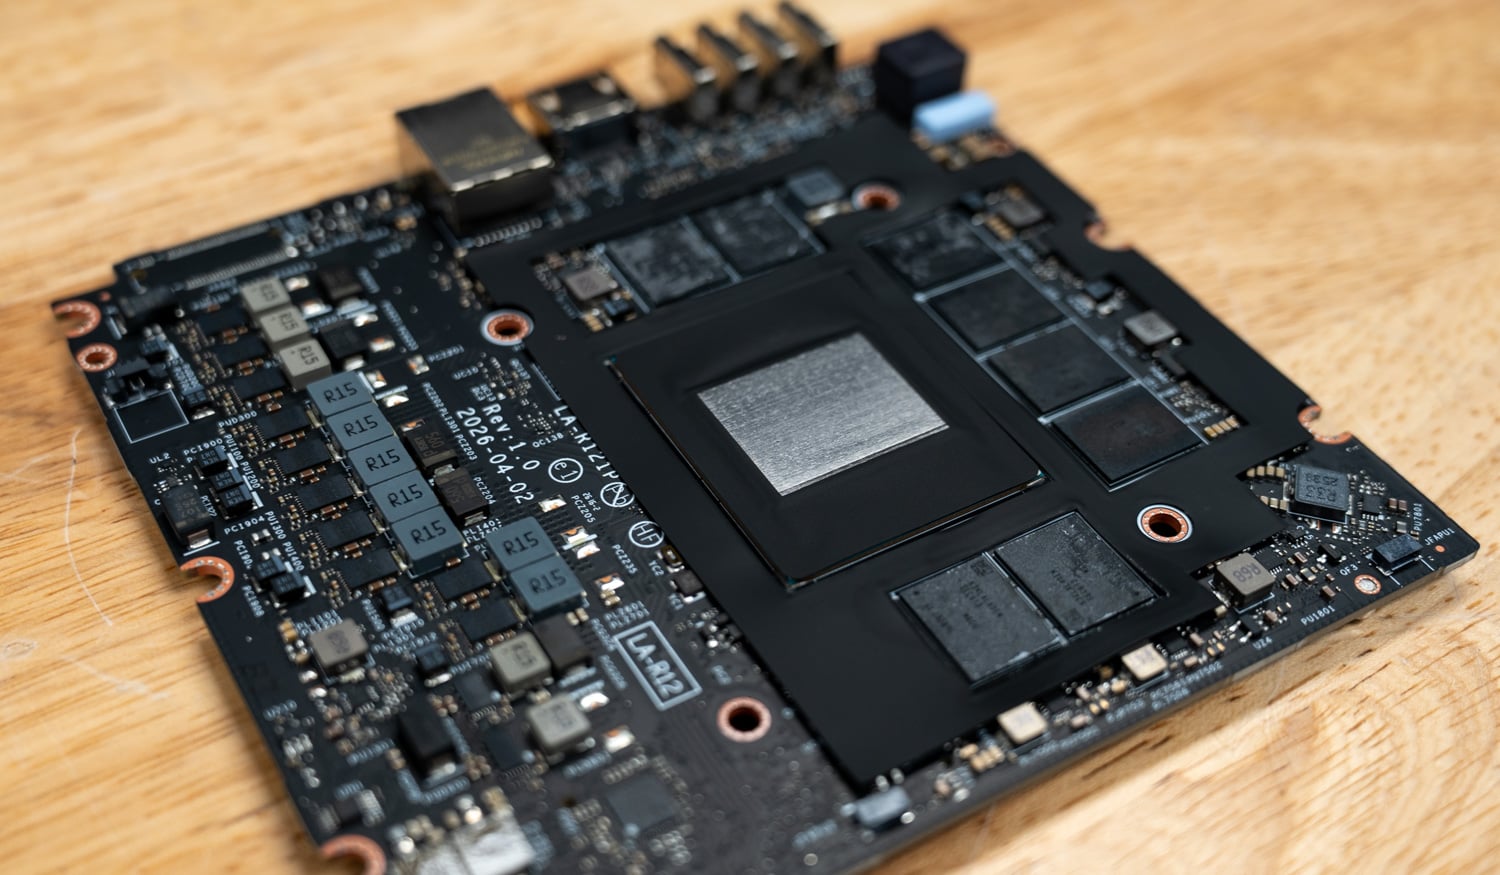
AMD သည် ၎င်း၏ MLPerf Inference 6.1 တင်သွင်းမှုကို ဘာသာစကား၊ ကျိုးကြောင်းဆင်ခြင်ခြင်း၊ စာသားမှဗီဒီယိုနှင့် အကြံပြုချက်လုပ်ငန်းများတွင် မော်ဒယ်မိသားစုခြောက်ခုသို့ တိုးချဲ့ခဲ့ပြီး Instinct MI355X၊ MI350X နှင့် MI350P PCIe ကတ်အသစ်ကို ဖြန့်ကျက်ခဲ့သည်။ MI355X တွင်တည်ဆောက်ထားသော 512-GPU Crusoe cluster ကို AMD ၏ကိုယ်ပိုင်ခွဲခြမ်းစိတ်ဖြာမှုနှင့်အတူ အောက်တွင်ဖော်ပြထားသည်။
Intel ရဲ့ Arc Pro B70 ဟာ Intel က Llama 3.1-8B၊ Llama 2-70B၊ gpt-oss-120B၊ Whisper နဲ့ E2E-RAG စမ်းသပ်မှုအသစ်အတွက် အသုံးပြုခဲ့တဲ့ 128GB ပေါင်းစပ် VRAM ပါဝင်တဲ့ four-GPU node တစ်ခုမှာ ပေါ်လာပါတယ်။ Intel က gpt-oss-120B ဟာ v6.0 မှာ တူညီတဲ့ hardware ထက် server မှာ ၃၆% နဲ့ offline မှာ ၂၇% တိုးတက်ကောင်းမွန်လာတယ်လို့ အစီရင်ခံပါတယ်။ CPU ဘက်မှာ Intel က Xeon 6980P Llama 3.1-8B server throughput ဟာ v6.0 မှာ တူညီတဲ့ silicon ထက် ၂.၄ ဆ မြင့်တက်လာပြီး software-only gain ဖြစ်တယ်လို့ ပြောပါတယ်။
Ryzen AI Max+ 395 ဟာ Atlas Inference မှတစ်ဆင့် ပေါ်လာပါတယ်။ Atlas Inference ဟာ NVIDIA DGX Spark နဲ့ AMD Strix Halo desktop နှစ်ခုလုံးမှာ Edge Agentic workload အသစ်ကို engine နဲ့ quantization recipe တူညီစွာ run ခဲ့တဲ့ ပထမဆုံးအကြိမ် submitter တစ်ခုဖြစ်ပါတယ်။ Atlas က DGX Spark မှာ တစ်စက္ကန့်ကို token ၂၀.၁ ခု ရရှိပြီး turn ၁၀၀၇ ခုလုံးကို မိနစ် ၆၄ အောက်နဲ့ ပြီးမြောက်အောင် လုပ်ဆောင်နိုင်တယ်လို့ ဖော်ပြထားပြီး Strix Halo မှာ တစ်စက္ကန့်ကို token ၁၉.၆၃ ခု ရရှိပါတယ်။ အဲဒါက ကျွန်တော်တို့ရဲ့ Ryzen AI Halo နဲ့ DGX Spark reviews တွေမှာ off-the-shelf runtimes ရှိတဲ့ platform နှစ်ခုကြားက တိုင်းတာခဲ့တာထက် ပိုကျဉ်းမြောင်းတဲ့ ကွာဟချက်တစ်ခုဖြစ်ပြီး benchmark အသစ်က ပေါ်လာဖို့ ဒီဇိုင်းထုတ်ထားတဲ့ ရလဒ်မျိုးပါပဲ။
ပိုကြီး၊ ပိုကွဲပြားပြီး ပိုဖြန့်ဝေမှု
multi-node တင်သွင်းမှုများသည် ယခုအချီတွင် စံချိန်တင်ခဲ့ပြီး v4.0 တွင် သုညမှ မြင့်တက်လာခဲ့ပြီး သုံးခုမှာ ထင်ရှားပါသည်။ နောက်ထပ် ပထမဆုံးအကြိမ် တင်သွင်းသူ Crusoe သည် AMD ဖြင့် MLPerf Inference သမိုင်းတွင် အကြီးမားဆုံးစနစ်ကို လုပ်ဆောင်ခဲ့သည်- gpt-oss-120b နှင့် DeepSeek-R1 အတွက် တင်သွင်းထားသော standard RoCE Ethernet fabric ပေါ်ရှိ node ၆၄ ခုတွင် Instinct MI355X GPU ၅၁၂ ခု။ AMD သည် offline scenario တွင် တစ်စက္ကန့်လျှင် token ၅.၇၅ သန်းနှင့် ထို cluster မှ gpt-oss-120b ရှိ server တွင် ၅.၃၉ သန်း၊ DeepSeek-R1 ရှိ offline ၂.၉၀ သန်းနှင့် server ၂.၄၁ သန်းကို အစီရင်ခံခဲ့ပြီး AMD သည် MLPerf သမိုင်းတွင် အမြင့်ဆုံး token throughput ဟု ခေါ်ဆိုပြီး throughput သည် ၁ မှ ၆၄ node အထိ မျဉ်းဖြောင့်အတိုင်း ချိန်ညှိထားသည်။ gpt-oss-120b လည်ပတ်မှုသည် native MXFP4 တွင် independent single-GPU replicas ၅၁၂ ခုအဖြစ် မော်ဒယ်ကို ပံ့ပိုးပေးခဲ့သည်။ DeepSeek-R1 သည် node တစ်ခုလျှင် ရှစ်ခုပါ GPU ပုံတူတစ်ခုဖြင့် SGLang ကိုအသုံးပြုခဲ့သည်။ AMD သည် 95% scaling efficiency နှင့် တစ်စက္ကန့်လျှင် တိုကင် ၁ သန်းဖြင့် 72-GPU GPT-OSS-120B တင်သွင်းမှုကို သီးခြားကိုးကားခဲ့ပြီး၊ v6.0 ရှိ MI355X တွင် ဖော်ပြခဲ့သော ခေါင်းစဉ်နှင့် အတူတူပင်ဖြစ်သည် ။
Cisco ဟာ benchmark ရဲ့ ပထမဆုံး cross-vendor heterogeneous system ကို တင်သွင်းခဲ့ပြီး NVIDIA H200 ရှစ်ခုနဲ့ AMD Instinct MI350X GPU ရှစ်ခုကို Cisco Silicon One G200 fabric ပေါ်မှာ single inference pool တစ်ခုအဖြစ် ပေါင်းစပ်ထည့်သွင်းခဲ့ပါတယ်။ ဒါဟာ Secure AI Factory မှတစ်ဆင့် ရောင်းချနေတဲ့ mixed-accelerator approach နဲ့ အတူတူပါပဲ ။ ပထဝီဝင်အနေအထားအရ ဖြန့်ဝေထားတဲ့ entry ဟာ MangoBoost နဲ့အတူ Dell ကနေ လာတာပါ။ တိုက်ကြီးနှစ်ခုပေါ်က site လေးခုကို MangoBoost၊ Dell၊ TensorWave နဲ့ Microsoft Azure တို့က host လုပ်ထားပြီး ပစိဖိတ်သမုဒ္ဒရာကို ဖြတ်ကျော်ပြီး MangoBoost က 97% scaling efficiency လို့ ဖော်ပြထားတဲ့ endpoint တစ်ခုတည်းအနေနဲ့ လည်ပတ်နေပါတယ်။ MangoBoost ဟာ AMD Instinct GPU တွေမှာ ပထမဆုံး prefill/decode-disaggregated results ကိုလည်း ရရှိခဲ့ပါတယ်။
ရလဒ်များ၏ အခြားနေရာများတွင် CoreWeave မှ GB300 NVL72 တွင် တစ်စက္ကန့်လျှင် တိုကင် ၁.၁၆ သန်း ရရှိခဲ့ပြီး v6.0 မှစ၍ GPU တစ်ခုလျှင် အော့ဖ်လိုင်း throughput ၁၇% တိုးလာကြောင်း အစီရင်ခံခဲ့ပြီး၊ HPE သည် Blackwell Ultra ပါရှိသော Compute XD690 ဆာဗာနှစ်ခုတွင် DeepSeek-R1 တွင် GPU တစ်ခုလျှင် တစ်စက္ကန့်လျှင် တိုကင် ၈,၅၀၀ ရရှိကြောင်း ကိုးကားဖော်ပြခဲ့ပြီး Google သည် ၎င်း၏တင်သွင်းမှုကို DeepSeek-R1 တွင် အာရုံစိုက်ခဲ့ပြီး လုပ်ငန်းနယ်ပယ်သည် ကျွမ်းကျင်သူများ ရောနှောထားသော မော်ဒယ်များသို့ ပြောင်းလဲလာခြင်းကို ကိုးကားဖော်ပြခဲ့သည်။ gpt-oss-120b သည် တင်သွင်းမှု ၁၁၂ ခုကို ရရှိခဲ့ပြီး၊ မည်သည့် MLPerf workload ထက်မဆို အများဆုံးဖြစ်သည်။
AMD ရဲ့ CDNA 4 Form Factor နှစ်ခုဖြစ်တဲ့ OAM နဲ့ Dual-Slot PCIe
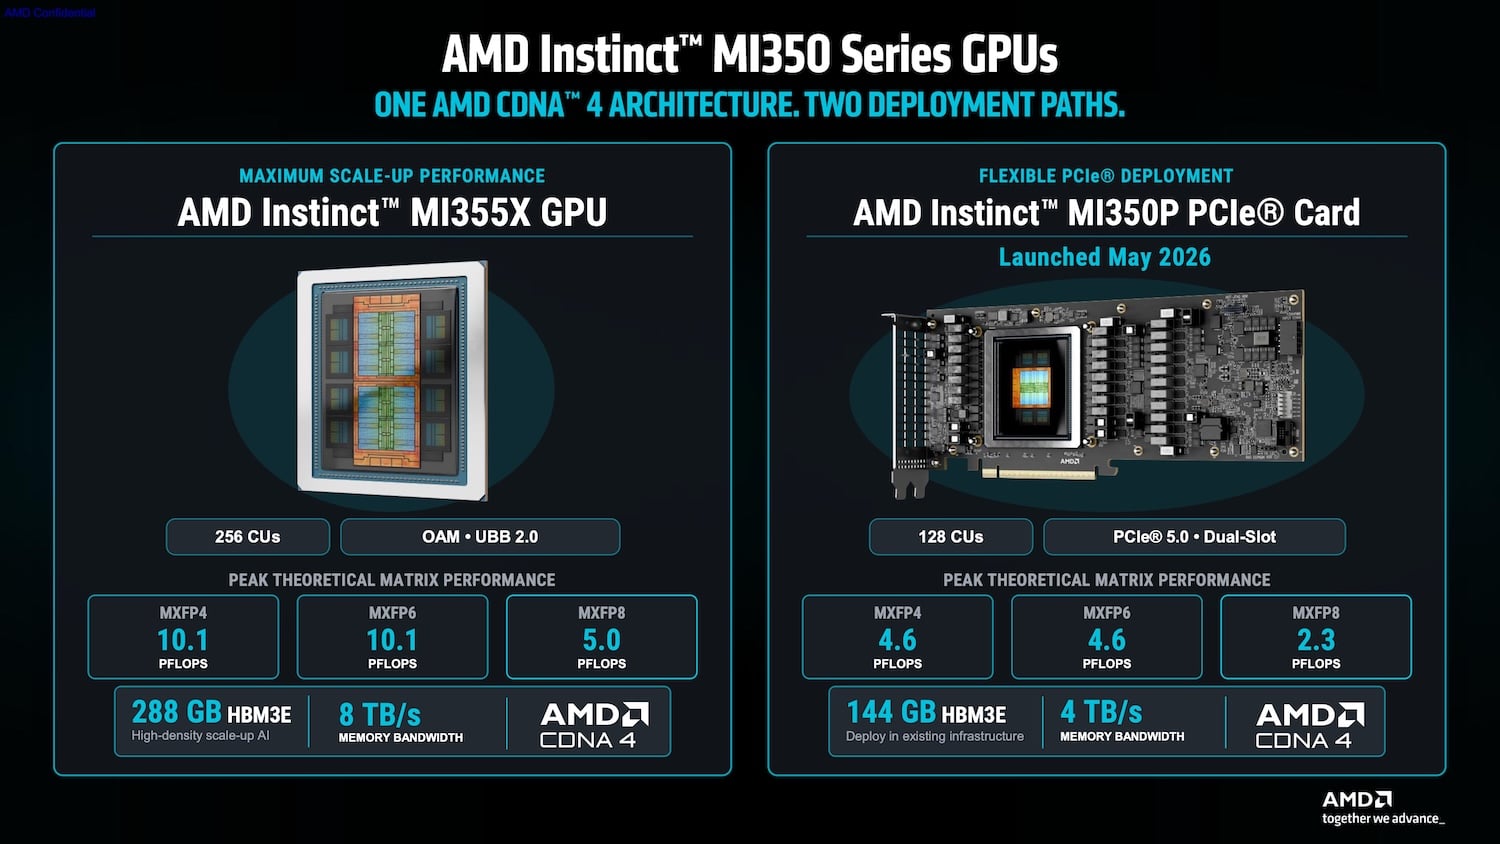
AMD ရဲ့ CDNA 4 ဗိသုကာကို သတ်မှတ်ထားတဲ့ ဒေတာစင်တာ ပါဝါနဲ့ အအေးပေးစနစ် ကန့်သတ်ချက်တွေနဲ့ ကိုက်ညီအောင် ရုပ်ပိုင်းဆိုင်ရာ ပုံစံနှစ်မျိုးနဲ့ ရရှိနိုင်ပါတယ်။ ထိပ်တန်း Instinct MI355X ဟာ OCP Universal Baseboard (UBB 2.0) ပလက်ဖောင်းပေါ်က OAM form factor ကို အသုံးပြုပြီး မြင့်မားတဲ့ သိပ်သည်းဆ compute node တွေကို ပစ်မှတ်ထားပြီး compute unit ၂၅၆ ခု၊ HBM3E memory ၂၈၈ GB နဲ့ aggregate memory bandwidth ၈ TB/s တို့ကို ပံ့ပိုးပေးပါတယ်။ အမြင့်ဆုံး theoretical MXFP4 နဲ့ MXFP6 matrix compute ရဲ့ 10.1 PFLOPS အထိ ပေးစွမ်းနိုင်ပါတယ်။ မကြာသေးမီက မိတ်ဆက်ခဲ့တဲ့ Instinct MI350P ဟာ အဲဒီ CDNA 4 silicon ကို standard enterprise chassis အတွက် dual-slot PCIe 5.0 add-in card အဖြစ် ပြောင်းလဲပေးပြီး compute unit ၁၂၈ ခု၊ HBM3E memory ၁၄၄ GB၊ bandwidth ၄ TB/s ပါဝင်ပြီး အမြင့်ဆုံး theoretical MXFP4 နဲ့ MXFP6 matrix performance ရဲ့ 4.6 PFLOPS အထိ ပေးစွမ်းပါတယ်။
တူညီသော ဆီလီကွန်ပေါ်တွင် ဆော့ဖ်ဝဲလ်အခြေပြု မျိုးဆက်မြှင့်တင်မှု
AMD ROCm v7 ရှိ software optimization များသည် MLPerf cycle တစ်ခုတည်းအတွင်း တူညီသော MI355X hardware ပေါ်တွင် တိုင်းတာနိုင်သော throughput တိုးတက်မှုများကို ရရှိခဲ့သည်။ eight-GPU MI355X node တွင် စမ်းသပ်ချက်များအရ Offline scenario တွင် GPT-OSS-120B throughput သည် 28% နှင့် Server scenario တွင် 38% မြင့်တက်လာခဲ့ပြီး Wan-2.2 SingleStream စွမ်းဆောင်ရည်မှာ 70% တိုးတက်လာကြောင်း ပြသခဲ့သည်။ cluster scale တွင် MLPerf 6.1 ရှိ MI355X accelerators 72 ခုသည် 6.0 round တွင် ဖော်ပြထားသော 94-GPU configuration ထက် စုစုပေါင်း GPT-OSS-120B throughput ပိုမိုမြင့်မားခဲ့သည်။ AMD မှထုတ်ဝေသော ယှဉ်ပြိုင်မှုနှိုင်းယှဉ်မှုများတွင် eight-GPU MI355X သည် GPT-OSS-120B ရှိ NVIDIA B200 နှင့် B300 တို့ကို နှိုင်းယှဉ်ရာတွင် တင်သွင်းထားသော ရလဒ်များကို ဦးဆောင်ခဲ့ပြီး 72-GPU cluster သည် NVIDIA ၏ GB200 တင်သွင်းမှုကို ဦးဆောင်ခဲ့သည်။
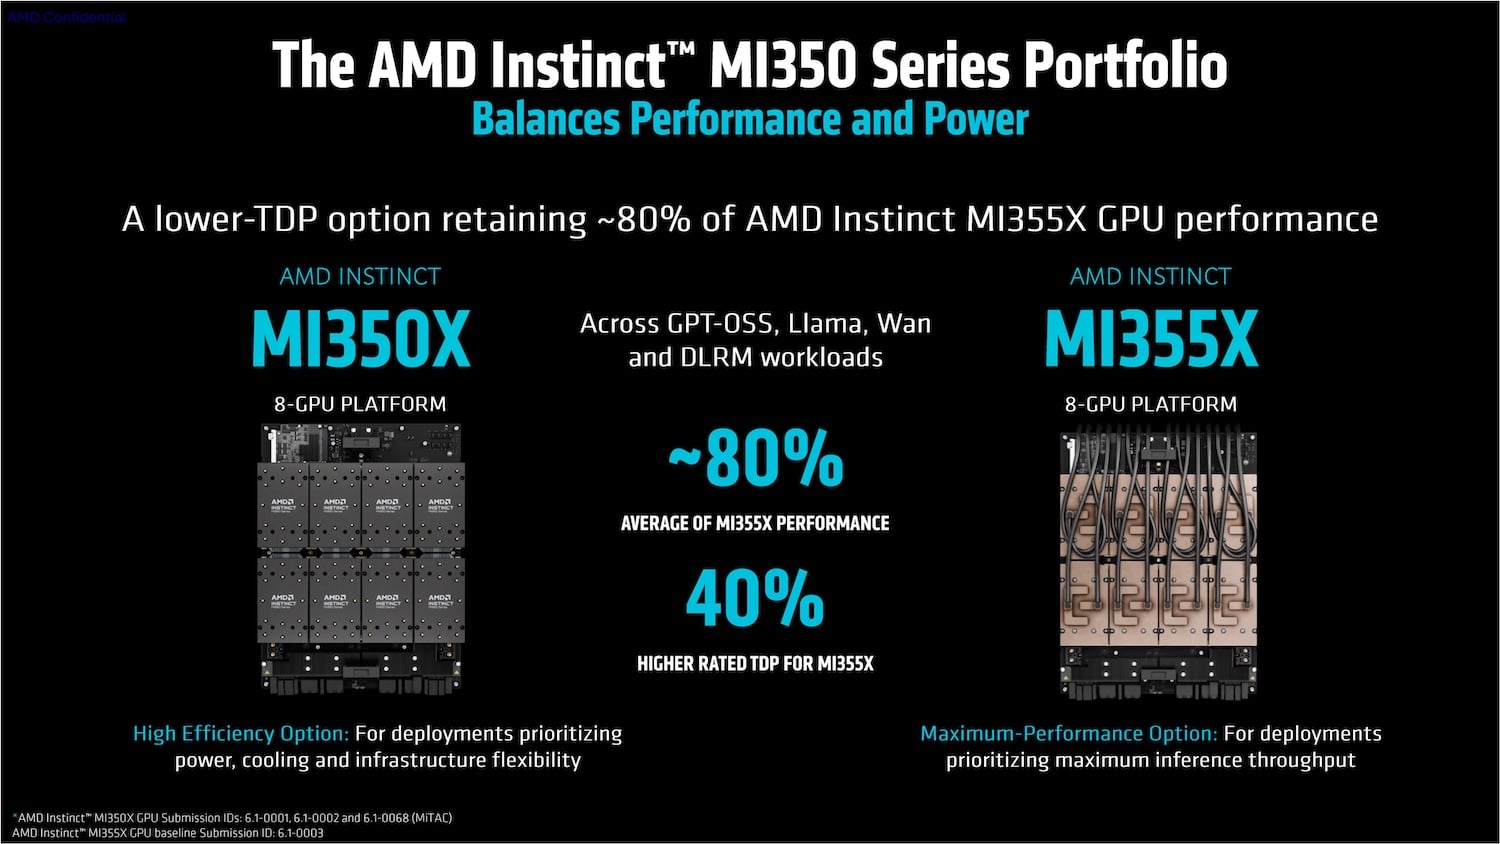
၎င်း၏ ပထမဆုံး MLPerf အချီတွင် dual-slot MI350P သည် Closed workloads ငါးခုတွင် တင်သွင်းခဲ့ပြီး NVIDIA RTX PRO 6000 Server Edition နှင့် H200 NVL တို့၏ ရွေးချယ်ထားသော တင်သွင်းမှုများနှင့် နှိုင်းယှဉ်ပါက ဦးဆောင်ရလဒ်များကို တင်ခဲ့သည်။ ပါဝါနှင့် အအေးပေးဘတ်ဂျက်များအပေါ် အာရုံခံနိုင်သော ဖြန့်ကျက်မှုများအတွက်၊ ရှစ် GPU MI350X စနစ်သည် GPT-OSS၊ Llama၊ Wan နှင့် DLRM workloads များတွင် MI355X platform ၏ benchmark စွမ်းဆောင်ရည်၏ 80% ခန့်ကို ထိန်းသိမ်းထားနိုင်ပြီး MI355X တွင် အဆင့်သတ်မှတ်ချက် TDP ၄၀% မြင့်မားသည်။ Signal65 မှ တာဝန်ပေးအပ်ထားသော လေ့လာမှုတစ်ခုအရ ဤ throughput နံပါတ်များသည် fixed latency ကန့်သတ်ချက်များအတွင်း စာရွက်စာတမ်းတစ်ခုလျှင် လည်ပတ်မှုကုန်ကျစရိတ် နည်းပါးစေပြီး တစ်ဒေါ်လာလျှင် token output မြင့်မားစေကြောင်း ဖော်ပြခဲ့သည်။
AMD မိတ်ဖက်ရလဒ်များနှင့် ကိုရီးယားမှ အမေရိကန်သို့ ကွန်ရက်ချိတ်ဆက်မှု
AMD က Dell Technologies၊ Oracle၊ Hewlett Packard Enterprise၊ Supermicro၊ MangoBoost၊ Crusoe နှင့် MiTAC တို့မှ နှိုင်းယှဉ်နိုင်သော MI355X တင်သွင်းမှုများသည် ၎င်း၏ရည်ညွှန်းစနစ်ရလဒ်များ၏ ပျမ်းမျှ ၄% အတွင်းတွင်ရှိပြီး အချို့သောလုပ်ဆောင်မှုများသည် ၎င်းတို့နှင့် ကိုက်ညီသည် သို့မဟုတ် အနည်းငယ်ကျော်လွန်သည်ဟု ပြောကြားခဲ့သည်။
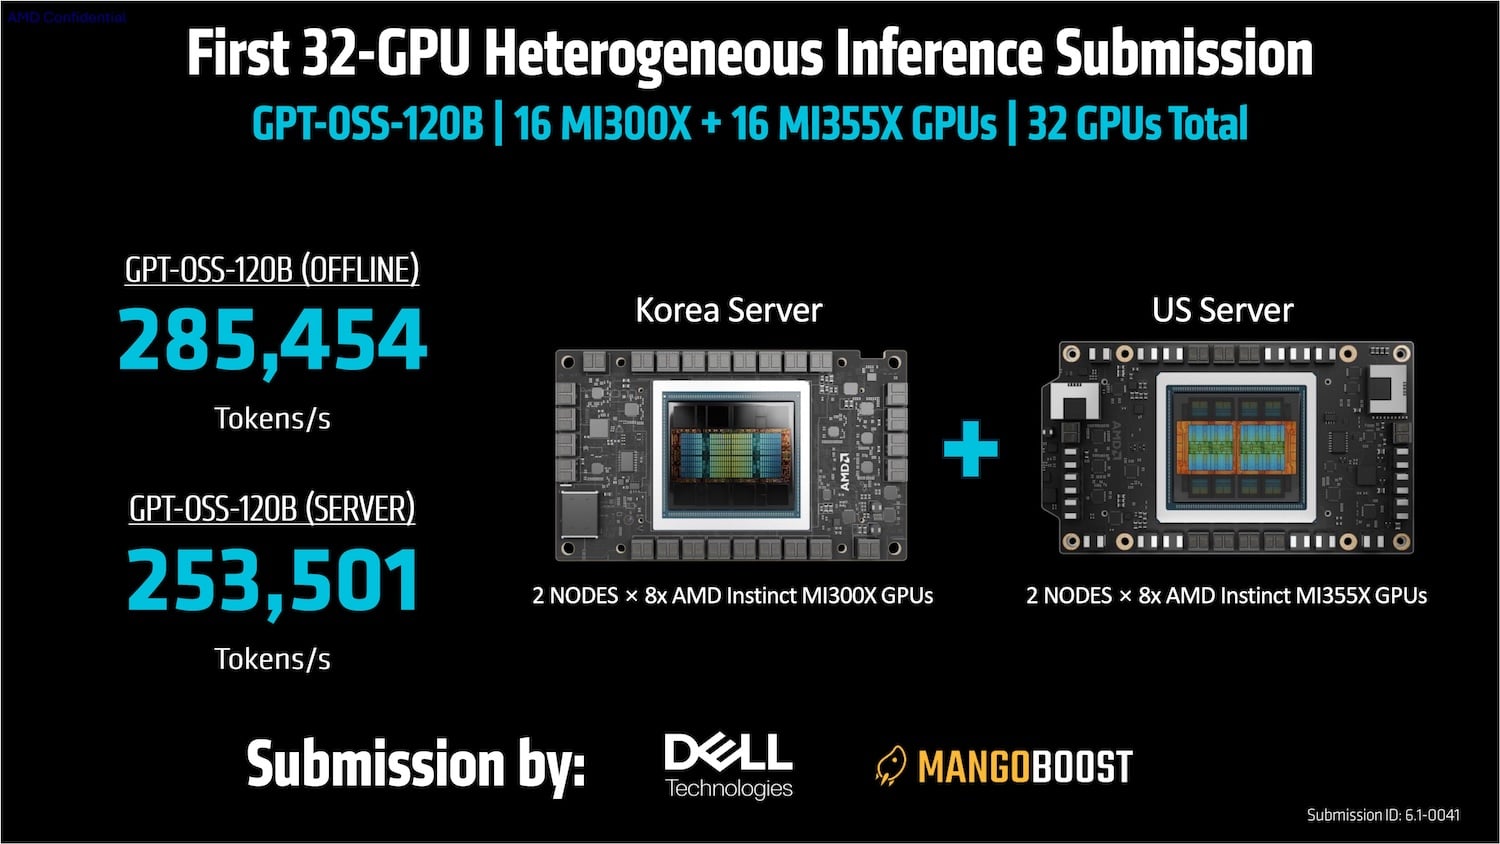
အထက်တွင်ဖော်ပြထားသော MangoBoost နှင့် Dell entry သည် benchmark ၏ ပထမဆုံးသော ကွဲပြားသော 32-GPU serving configuration ဖြစ်ပြီး ကိုရီးယားရှိ ယခင်မျိုးဆက် Instinct MI300X GPU ၁၆ ခုနှင့် အမေရိကန်ပြည်ထောင်စုရှိ Instinct MI355X GPU ၁၆ ခုကို ပေါင်းစည်းထားသော GPT-OSS-120B endpoint အဖြစ် ပေါင်းကူးပေးသည်။ split-cluster configuration သည် တစ်စက္ကန့်လျှင် Offline tokens ၂၈၅,၄၅၄ ခုနှင့် တစ်စက္ကန့်လျှင် Server tokens ၂၅၃,၅၀၁ ခုကို ပေးပို့သည်။ တင်သွင်းမှုများကို ROCm 7 တွင် လုပ်ဆောင်ခဲ့ပြီး AMD သည် vLLM၊ SGLang နှင့် ROCm.AI profiling tools များပါရှိသော ROCm 10 ထုတ်ဝေမှုကို HBM4-based MI400 Series နှင့် နောက်ဆက်တွဲ MI500 မျိုးဆက် ထက် ရှေ့သို့တက်လှမ်းရန် လမ်းကြောင်းအဖြစ် ထောက်ပြသည်။
Datacenter မှာ MLPerf Inference ကို အစားထိုးတဲ့ Harness
တင်သွင်းသူ ၃၀ တွင် ၁၆ ဦးသည် ယခုအချီတွင် MLPerf ၏ API-centric harness ကို အသုံးပြုခဲ့ပြီး v6.0 ရှိ open-division submitter တစ်ခုတည်းမှ မြင့်တက်လာခဲ့သည်။ harness သည် datacenter inference ကို ဖြန့်ကျက်သည့်နည်းလမ်းဖြစ်သည့် hosted endpoint နှင့် standard API များပေါ်တွင် client/server setup ကို စံ API များပေါ်တွင် လုပ်ဆောင်ပြီး Edge Agentic စမ်းသပ်မှုအသစ်၊ VLM-Interactive၊ gpt-oss၊ DeepSeek-R1၊ Llama 3.1-8B နှင့် text-to-video တို့ကို သယ်ဆောင်ထားပြီးဖြစ်သည်။ ၎င်းသည် MLPerf Endpoints ၏ အခြေခံအုတ်မြစ်ဖြစ်ပြီး ၂၀၂၆ ခုနှစ် အောက်တိုဘာလတွင် on-demand rolling submissions များကို ဖွင့်လှစ်ပြီး ၂၀၂၇ ခုနှစ်တွင် datacenter benchmark အဖြစ် MLPerf Inference ကို အစားထိုးမည်ဖြစ်ပြီး Endpoints v1.0 အတွက် normalized ရလဒ်များနှင့် တိုးချဲ့ထားသော agentic workloads များဖြင့် စီစဉ်ထားသည်။
“ရှေ့ဆက်သွားမယ်ဆိုရင် MLPerf Endpoints ဟာ datacenter အတွက် benchmark မိသားစုမှာ Inference ကို အစားထိုးသွားမှာဖြစ်ပြီး၊ ကျွန်ုပ်တို့ရဲ့ API-centric harness ကို မြန်မြန်ဆန်ဆန် အသုံးချနိုင်ခြင်းအားဖြင့် အဲဒီအသွင်ကူးပြောင်းမှုကို ချောမွေ့စွာလုပ်ဆောင်နိုင်မှာ ဖြစ်ပါတယ်” လို့ MLPerf ရဲ့ အကြီးအကဲ David Kanter က ပြောပါတယ်။ ဒီအချီမှာ ပထမဆုံးအကြိမ် တင်သွင်းသူ ခြောက်ဦးကတော့ Atlas Inference၊ Crusoe၊ Orrick Industries၊ ScitiX၊ VibeHPC နဲ့ Harvard ရဲ့ Kempner Institute မှ တစ်ဦးချင်းပံ့ပိုးကူညီသူ Naeem Khoshnevis တို့ဖြစ်ပြီး single-H200 Llama 3.1-8B ရလဒ်ကို တင်သွင်းခဲ့ပါတယ်။
ကောက်ချက်ချမှုအဆင့်သည် လွန်ခဲ့သော နှစ်ပတ်က ထုတ်ပြန်ခဲ့သော MLPerf Storage v3.0 ရလဒ်များကို လိုက်နာပြီး datacenter နှင့် edge ဇယားအပြည့်အစုံနှင့်အတူ submitter ဖြည့်စွက်ချက်များကို MLCommons ရလဒ်စာမျက်နှာများတွင် ရရှိနိုင်ပါသည်။


 အမေဇုံ