

Dell Pro Max 16 Plus မှာ အထပ်နှစ်ထပ်ရှိပြီး ဆန့်ကျင်ဘက် ဦးတည်ချက်တွေကို ဆွဲငင်နိုင်ပါတယ်။ တစ်ခုက ထိပ်တန်းမိုဘိုင်း workstation တစ်ခုပါ- Intel ရဲ့ 24-core Core Ultra 9 285HX၊ 256GB အထိ CAMM2 မှတ်ဉာဏ်၊ M.2 slot သုံးခု၊ NVIDIA RTX PRO Blackwell ဂရပ်ဖစ်၊ 24GB GDDR7 ပါဝင်တဲ့ 5000-series အထိ၊ MIL-STD-810H တည်ဆောက်မှုနဲ့ Dell က အင်ဂျင်နီယာပိုင်းဆိုင်ရာတွေကို ထဲထဲဝင်ဝင် ထည့်သွင်းထားတဲ့ ကိုယ်ထည်တစ်ခုတို့ ပါဝင်ပါတယ်။
နောက်တစ်ခုကတော့ ပြန်လည်သုံးသပ်နေတဲ့ SKU ဖြစ်ပြီး GPU ကို Qualcomm AIC100 PC Inference Card၊ ၂၀၁၉ ခုနှစ်ခေတ် Cloud AI 100 silicon ပေါ်မှာတည်ဆောက်ထားတဲ့ dual-SoC module နဲ့ ခေတ်သစ် inference workloads အများစုကို နာကျင်စရာ စူးစမ်းလေ့လာမှုတစ်ခုအဖြစ် ပြောင်းလဲပေးတဲ့ software stack တို့နဲ့ လဲလှယ်ထားပါတယ်။ ဒါက flagship chassis တစ်ခုကို accelerator မှားနဲ့ တွဲလိုက်တဲ့အခါ ဘာတွေဖြစ်လာမလဲဆိုတာနဲ့ ဝယ်ယူမှုအော်ဒါမှာ လက်မှတ်မထိုးခင်မှာ AI solution ရဲ့နောက်ကွယ်က software stack ကို နားလည်ဖို့ လိုအပ်တဲ့အကြောင်း သတိပေးဇာတ်လမ်းတစ်ပုဒ်ပါ။ ဘာကြောင့်လဲဆိုတာ မပြောခင်မှာ laptop တစ်ခုလုံးကို ကြည့်ကြရအောင်။
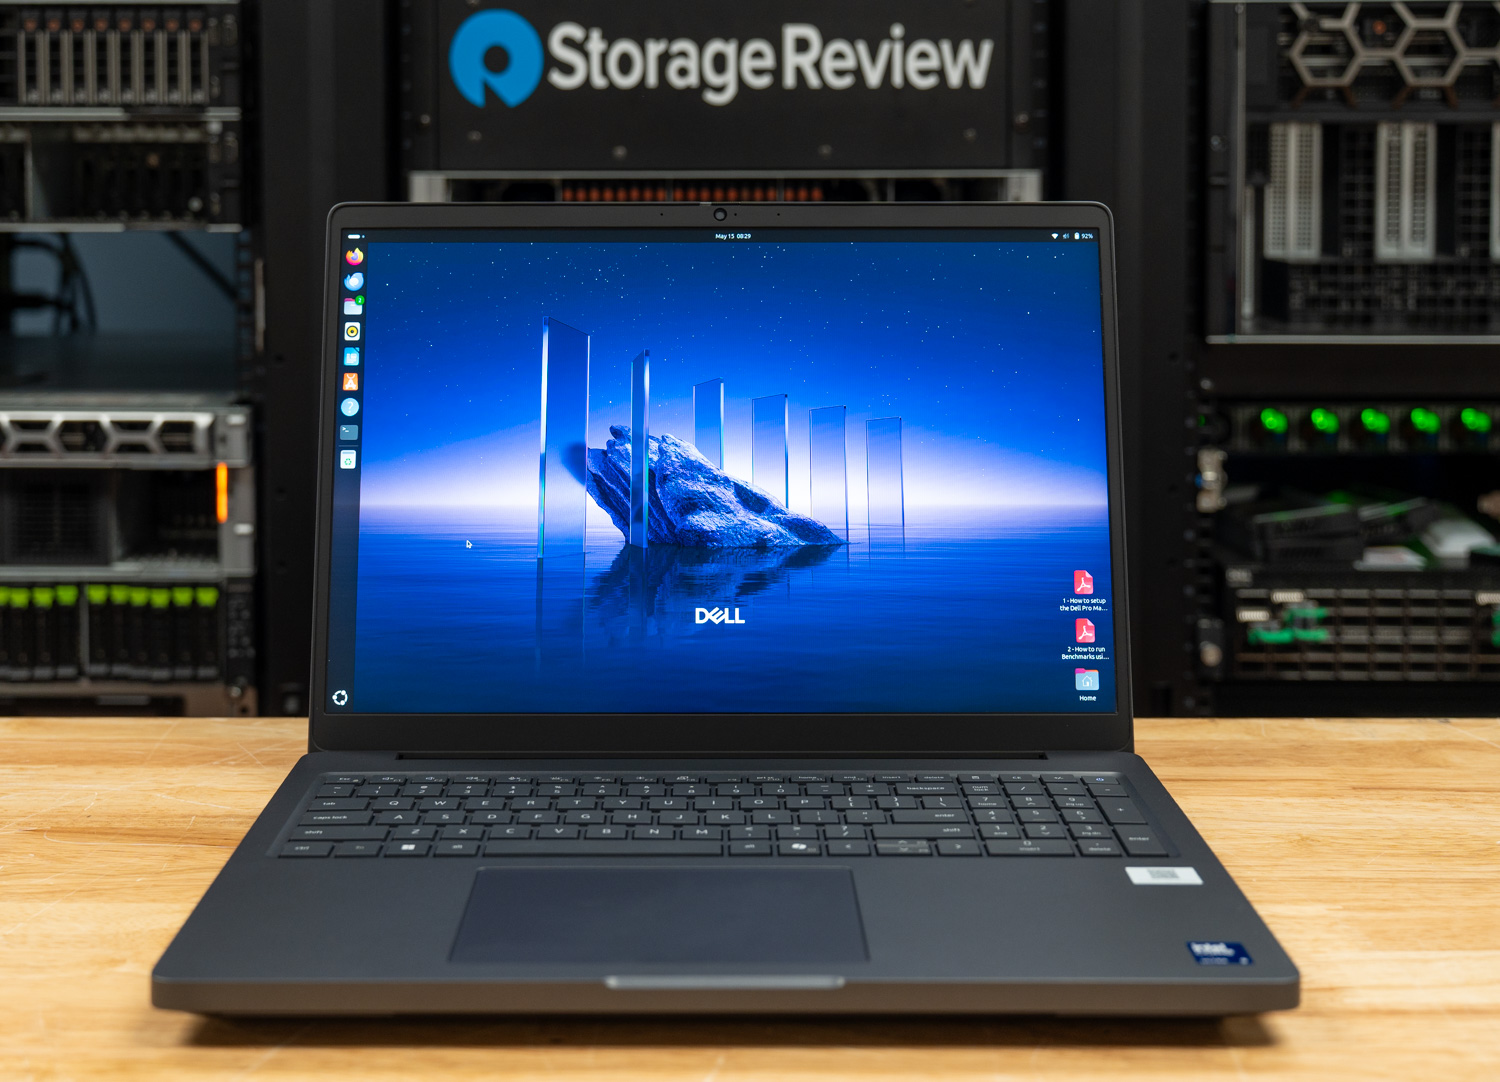
Pro Max 16 Plus ဟာ Dell ရဲ့ Pro Max workstation စီးရီးရဲ့ ထိပ်ဆုံးမှာ ရှိနေပြီး entry-level Pro Max 16 နဲ့ ပိုပါးတဲ့ Pro Max 16 Premium နှစ်ခုလုံးထက် ပိုမိုကောင်းမွန်တဲ့ ပါဝါကို ပေးစွမ်းနိုင်ပါတယ်။ အဓိကအားဖြင့် Intel ရဲ့ scalable Core Ultra 9 285HX ဖြစ်ပြီး 55GHz turbo boost ပါတဲ့ 5.5-watt, 24-core chip တစ်ခုဖြစ်ပါတယ်။ CPU configuration အားလုံးက Intel vPro Enterprise ကို ထောက်ပံ့ပေးပြီး laptop ရဲ့ enterprise-grade credentials ကို အားဖြည့်ပေးပါတယ်။ ဈေးနှုန်းက $2,779 ကနေ စတင်ပါတယ်။
ဂရပ်ဖစ်ရွေးချယ်မှုများတွင် NVIDIA ၏ Blackwell-based RTX PRO 1000 မှတစ်ဆင့် integrated Intel ဂရပ်ဖစ်များ ပါဝင်ပြီး ယခင်က ကျွန်ုပ်တို့သုံးသပ်ခဲ့သော RTX PRO 5000 အထိ တိုးချဲ့ထားပြီး အထင်ကြီးလောက်စရာ 24GB GDDR7 မှတ်ဉာဏ်ပါရှိသည်။ သိုလှောင်မှုနှင့် မှတ်ဉာဏ်ဖွဲ့စည်းပုံများသည်လည်း အတူတူပင်များပြားသည်- M.2 Gen5 slot သုံးခုတွင် 12TB အထိနှင့် Dell ၏ CAMM2 မော်ဂျူးမှတစ်ဆင့် ပေးပို့သော DDR5-6400 မှတ်ဉာဏ် 128GB အထိ။
မျက်နှာပြင်ရွေးချယ်မှုများတွင် အခြေခံ 1920 x 1200 IPS panel မှ ကြည်လင်ပြတ်သားသော 3840 x 2400 OLED touchscreen အထိ အမျိုးမျိုးရှိသည်။ အလယ်အလတ်အဆင့် 1920 x 1200 ရွေးချယ်မှုသည် နှစ်ခုကြားတွင် 500 nits brightness၊ 120Hz variable refresh rate နှင့် DCI-P3 coverage အပြည့်အဝပါဝင်သည်။ ISV အသိအမှတ်ပြုလက်မှတ် ၁၀၀ ကျော်ဖြင့် ဖန်တီးမှုပညာရှင်များသည် ၎င်းတို့၏အပလီကေးရှင်းများကို ချောမွေ့စွာလည်ပတ်နိုင်မည်ဟု မျှော်လင့်နိုင်သည်။
လုံခြုံရေးအင်္ဂါရပ်များသည် လုပ်ငန်းသုံးအတွက် အသင့်ဖြစ်ပြီး လက်ဗွေဖတ်စက်၊ Smart Card ပံ့ပိုးမှု၊ NFC၊ မျက်နှာမှတ်မိခြင်းအတွက် 8MP IR ကင်မရာနှင့် Dell ၏ Control Vault 3 အပါအဝင်ဖြစ်သည်။ စံသုံးနှစ်အာမခံသည် ပက်ကေ့ချ်ကို ပြီးပြည့်စုံစေပြီး အလုပ်အတွက် အရေးပါသောကိရိယာတစ်ခုအဖြစ် လက်ပ်တော့၏ အခန်းကဏ္ဍကို အလေးပေးဖော်ပြသည်။
Dell Pro Max 16 Plus ၏ အသေးစိတ်အချက်အလက်များ
| specification | Dell Pro Max 16 Plus |
|---|---|
| ပလက်ဖောင်း | |
| processor ကို | Intel Core Ultra 5 245HX Intel Core Ultra 7 265HX Intel Core Ultra 9 285HX |
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | Windows ကို 11 Pro ကို Ubuntu Linux 24.04 LTS |
| မှတ်ဉာဏ် | 16GB-128GB CSoDIMM သို့မဟုတ် CAMM2၊ အပေါက် ၁ ခု |
| ဂရပ်ဖစ်နှင့် AI အရှိန်မြှင့်တင်မှု | |
| ဂရပ်ဖစ်ကဒ် | Intel ပေါင်းစပ်ဂရပ်ဖစ် NVIDIA RTX PRO 1000 8GB NVIDIA RTX PRO 2000 8GB NVIDIA RTX PRO 3000 12GB NVIDIA RTX PRO 4000 16GB NVIDIA RTX PRO 5000 24GB Qualcomm AI Cloud 100 64GB (2x 32GB) |
| သိုလှောင်မှုနှင့် ပြသမှု | |
| သိုလှောင်ခြင်း | M.2 SSD ၃ ခုအထိ၊ တစ်ခုလျှင် 4TB ရရှိနိုင်သော RAID 0/1/5 |
| မျက်နှာပြင် | ၁၆ လက်မ ၁၆:၁၀ ၁၉၂၀×၁၂၀၀၊ ၃၀၀-nit၊ ၄၅% NTSC၊ ၆၀Hz၊ ထိတွေ့မှုမရှိ 1920×1200၊ 500-nit၊ 100% DCI-P3၊ 120Hz VRR၊ ထိတွေ့မှုမရှိသော ၃၈၄၀ × ၂၄၀၀၊ ၅၀၀-nit၊ OLED၊ ထိတွေ့မှု |
| ချိတ်ဆက်မှုနှင့် ပါဝါ | |
| ကင်မရာ | 8MP အနီအောက်ရောင်ခြည် |
| ကြိုးမဲ့ကွန်ယက်အဖွဲ့ | Intel Wi-Fi 7 BE200၊ Bluetooth 5.4 ပါရှိ/မပါရှိ ရရှိနိုင်သော မိုဘိုင်းဘရော့ဘန်း |
| ဘက်ထရီ | ၆-ဆဲလ် ၉၆Whr |
| ပါဝါစ Adapter ကို | 165W သို့မဟုတ် 280W |
| လုံခြုံရေးနှင့် ရုပ်ပိုင်းဆိုင်ရာ | |
| လုံခြုံရေးအင်္ဂါရပ်များ | အနီအောက်ရောင်ခြည် ဝက်ဘ်ကင်မရာ လက်ဗွေစာဖတ်သူကို စမတ်ကတ်ဖတ်စက် NFC ကို ထိန်းချုပ်ရေးသေတ္တာ ၃ |
| ရှုထောင့်နှင့်အလေးချိန် | 1.22 x 10.18 x 14.17 လက်မ စတင်အလေးချိန်: ၅.၆၃ ပေါင် |
| အာမခံချက် | ပုံမှန်သုံးနှစ်၊ နောက်တစ်နေ့တွင် ဆိုက်တွင်းပြုပြင်ခြင်း |
တည်ဆောက်ခြင်းနှင့်ဒီဇိုင်းဆွဲခြင်း
ကျွန်ုပ်တို့ သုံးသပ်ခဲ့တဲ့ ယခင်ယူနစ်လိုပဲ Pro Max 16 Plus ဟာ ခိုင်ခံ့မှုမရှိဘဲ MIL-STD-810H အသိအမှတ်ပြုလက်မှတ်ရရှိထားပြီး လိုအပ်ချက်များတဲ့ ပတ်ဝန်းကျင်မှာ တာရှည်ခံပါတယ်။ Dell ရဲ့ ပစ္စည်းပေါင်းစပ်မှုဟာ ရေရှည်တည်တံ့ခိုင်မြဲမှုကို အခြေခံထားပြီး အသုံးပြုပြီးသား ပြန်လည်အသုံးပြုထားတဲ့ ပလတ်စတစ်၊ ပြန်လည်အသုံးပြုထားတဲ့ မဂ္ဂနီဆီယမ်နဲ့ ကိုဘော့တ်နဲ့ ဇီဝအခြေခံ ပလတ်စတစ်တွေကို ပေါင်းစပ်ထားပါတယ်။ လက်ထဲမှာကိုင်ထားရင် ကိုယ်ထည်က အလွန်တောင့်တင်းပြီး ကွေးညွှတ်မှုမရှိတာကို ခံစားရပါတယ်။ အတိုချုပ်ပြောရရင် တိုင်ကီတစ်ခုလို တည်ဆောက်ထားပါတယ်။
ဒါက ကြီးမားတဲ့ စက်တစ်ခုပါ။ ၁.၂၂ လက်မ အထူ (ခြေထောက်တွေအပါအဝင်) နဲ့ ၅.၆၃ ပေါင်ကနေ စတင်တဲ့ ဒီစက်ကို မကြာခဏ ခရီးသွားလာဖို့ တည်ဆောက်ထားတာ မဟုတ်ပေမယ့် ၁၀.၁၈ x ၁၄.၁၇ လက်မ အရွယ်အစားက ၁၆ လက်မ၊ ၁၆:၁၀ မျက်နှာပြင်အတွက် အတော်လေး သေးငယ်ပါတယ်။ ဝက်ဘ်ကင်မရာကို အဖုံးရဲ့ အပေါ်ဘက်မှာ တပ်ဆင်ထားပြီး လျှောကျတဲ့ privacy shutter ပါရှိပါတယ်။ ကျွန်ုပ်တို့ရဲ့ သုံးသပ်ချက်ယူနစ်မှာ မျက်နှာမှတ်မိဖို့အတွက် IR ဗားရှင်း ပါဝင်ပါတယ်။
Dell ရဲ့ ဒီဇိုင်းဘာသာစကားဟာ အလှအပပိုင်းဆိုင်ရာမှာ ချို့ယွင်းချက်တစ်ခုအထိ လျော့တွက်ထားပါတယ်။ မီးခိုးရောင်-အနက်ရောင် အပြင်ပိုင်းနဲ့ သိမ်မွေ့တဲ့ အမှတ်တံဆိပ်က ဒါဟာ ပုံသဏ္ဍာန်ထက် လုပ်ဆောင်ချက်ရဲ့ ထုတ်ကုန်တစ်ခုဖြစ်တယ်ဆိုတာကို ပေါ်လွင်စေပါတယ်။ Pro Max Premium လိုင်းဟာ စွမ်းဆောင်ရည်နဲ့ ချဲ့ထွင်မှုတွေရဲ့ ကုန်ကျစရိတ်နဲ့ ပိုပြီး အမြင်အာရုံကို ပေးစွမ်းနိုင်ပါတယ်။
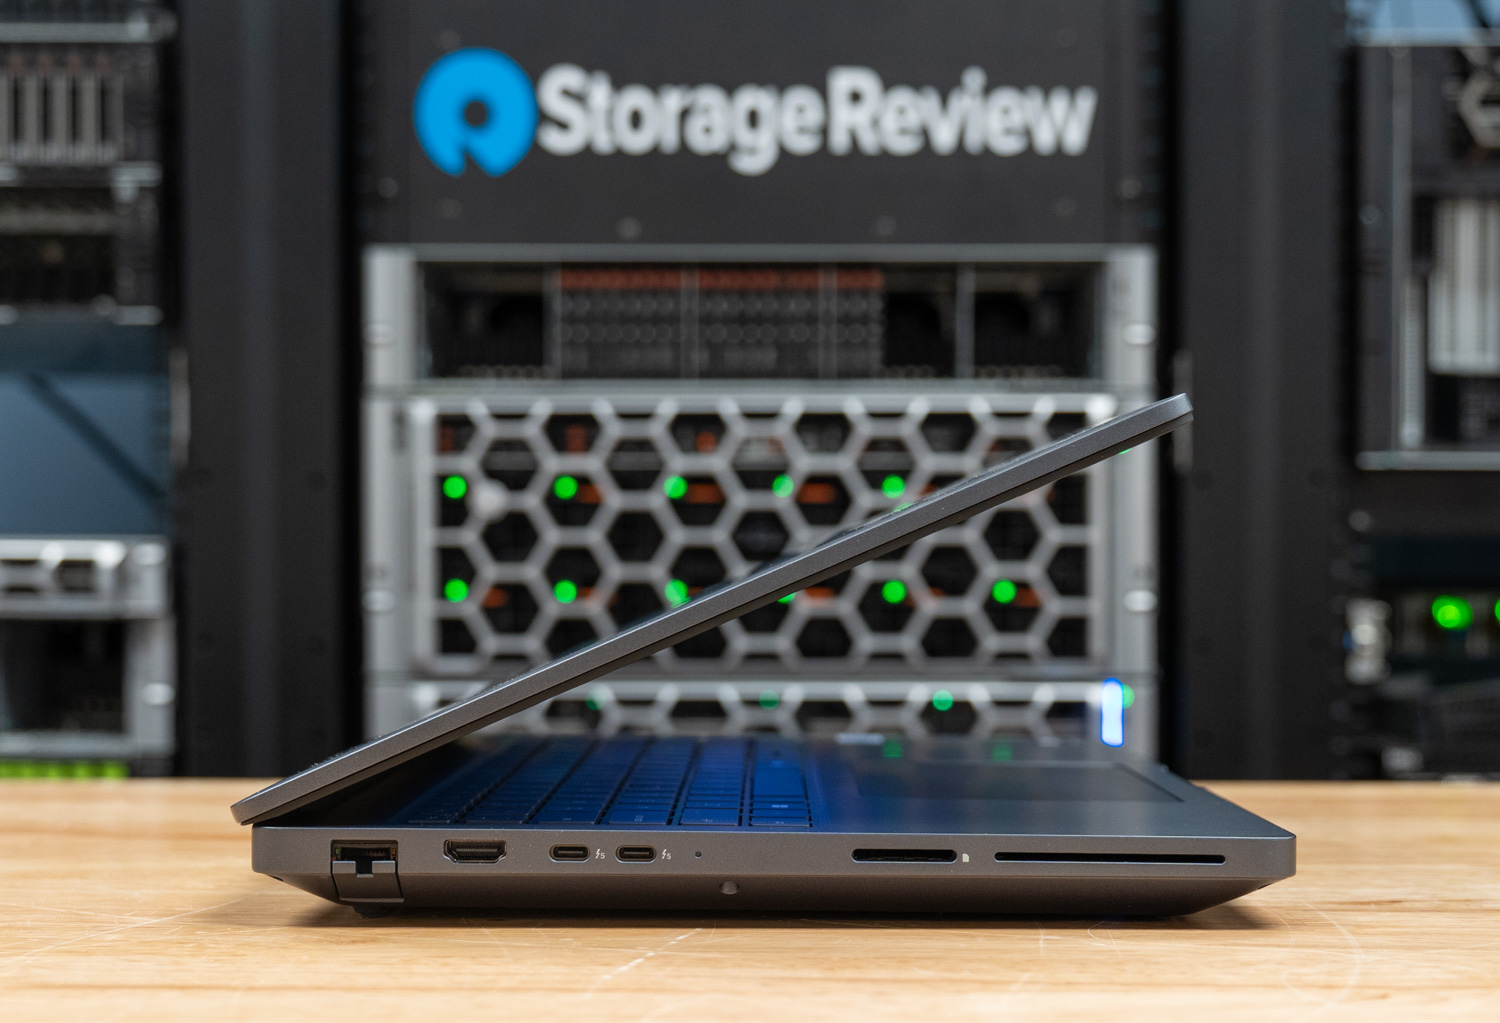
ပြည့်စုံသော port ရွေးချယ်မှုသည် ဘယ်ဘက်အစွန်းမှ စတင်သည်-
- 2.5Gbps RJ45 အီသာနက်
- HDMI 2.1 အထွက်
- Thunderbolt 5 (USB-C) port နှစ်ခု
- SD ကဒ်စာဖတ်သူကို
- ရွေးချယ်နိုင်သော SmartCard slot
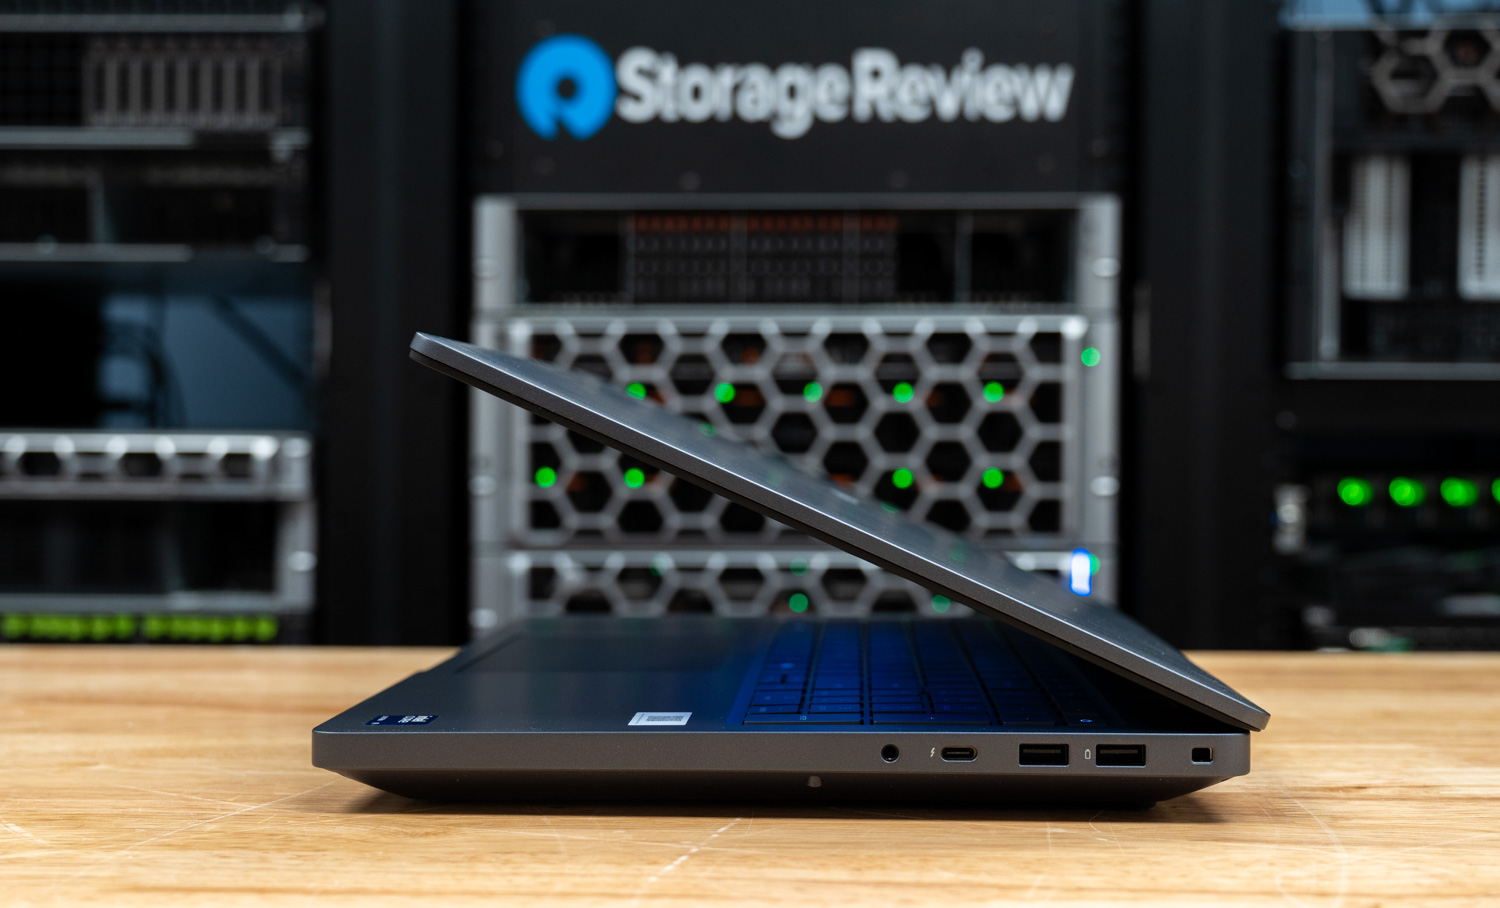
ညာဘက်တွင်:
- 3.5mm audio jack
- Thunderbolt 4 (က USB ကို C)
- USB 3.2 Gen1 Type-A port နှစ်ခု
- သော့ခတ်ပေါက်
နောက်ဘက်အစွန်းမှာ port တွေ မပါပါဘူး။ ကြိုးမဲ့ချိတ်ဆက်မှုကို Intel ရဲ့ BE200 မော်ဂျူးကနေ ကိုင်တွယ်ပြီး Wi-Fi 7 နဲ့ Bluetooth 5.4 တို့ကို ပံ့ပိုးပေးပါတယ်။ စိတ်ကြိုက် configuration တွေမှာ Bluetooth ကို ထည့်သွင်းထားစရာမလိုဘဲ 5G မိုဘိုင်း broadband ကိုလည်း ရရှိနိုင်ပါတယ်။
မျက်နှာပြင်နှင့် ထည့်သွင်းကိရိယာများ
ကျွန်ုပ်တို့ရဲ့ သုံးသပ်ချက်ယူနစ်မှာ Dell ရဲ့ ၁၆ လက်မ 1920×1200 မျက်နှာပြင်ပါဝင်ပြီး နေ့စဉ်အသုံးပြုမှုမှာ အလွန်ကောင်းမွန်စွာ ပေါ်လွင်စေတဲ့ 120Hz VRR panel ပါဝင်ပါတယ်။ အရောင်တွေက တောက်ပပြီး 100% DCI-P3 coverage ရှိတာကြောင့် ချိန်ညှိပြီးတာနဲ့ အရောင်ကို အာရုံခံနိုင်တဲ့ workflow တွေအတွက် သင့်တော်ပါတယ်။ 500-nit brightness က ပိုမိုလင်းလက်တဲ့ ရုံးခန်း ဒါမှမဟုတ် စတူဒီယိုပတ်ဝန်းကျင်မှာ မျက်နှာပြင်ကို အသုံးပြုရာမှာ သက်တောင့်သက်သာရှိနေစေဖို့လည်း ကူညီပေးပါတယ်။
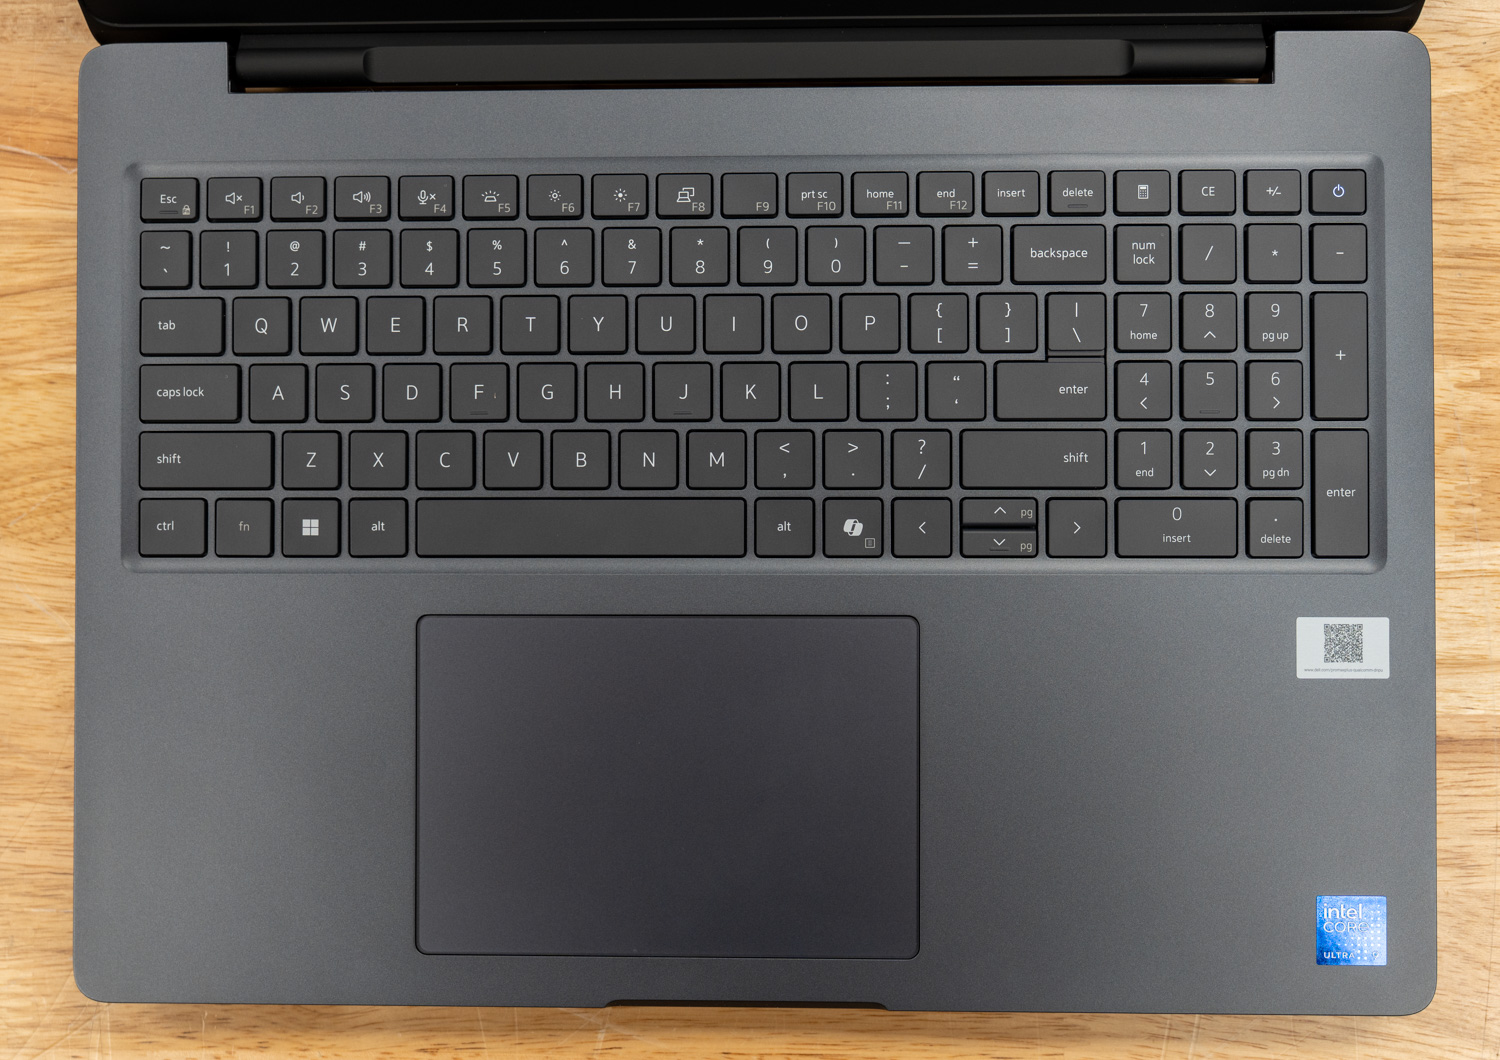
Dell ရဲ့ ကီးဘုတ်ဟာ စာရိုက်ချိန်ကြာမြင့်စွာ အသုံးပြုဖို့အတွက် သင့်တော်ပြီး ပေါ့ပါးပြီး တုံ့ပြန်မှုကောင်းမွန်ကာ ကြည်လင်ပြတ်သားတဲ့ ထိတွေ့မှုရရှိစေမယ့် full-size ကီးတွေ ပါဝင်ပါတယ်။ အဖြူရောင်နောက်ခံမီးကြောင့် မှောင်နေတဲ့ပတ်ဝန်းကျင်မှာ မြင်သာစေပါတယ်။ အပြင်အဆင်က အများအားဖြင့် သမားရိုးကျဖြစ်ပေမယ့် မြှားခလုတ်တွေရဲ့ အရွယ်အစား မညီမျှမှုက ရံဖန်ရံခါ မှားယွင်းနှိပ်မိစေတတ်ပြီး Home နဲ့ End ခလုတ်တွေရဲ့ နေရာချထားမှုက အထူးအားနည်းချက်တစ်ခုပါ။ F11 နဲ့ F12 တွေနဲ့ နေရာခွဲဝေအသုံးပြုရတာကြောင့် Fn-Lock (Fn + Esc) ကို function row ကို ဦးစားပေးအသုံးပြုခွင့်ပေးတာက Fn + F11 ဒါမှမဟုတ် F12 ကို နှိပ်ပြီး ဝင်ရောက်ကြည့်ရှုနိုင်ပါတယ်။ Page Up နဲ့ Page Down ခလုတ်တွေကို သီးသန့်နှိပ်ရင် ကြိုဆိုရမှာပါ။ အဲဒီအစား၊ သူတို့က အပေါ်နဲ့အောက် မြှားတွေရဲ့ ဒုတိယလုပ်ဆောင်ချက်တွေဖြစ်ပြီး၊ cluster ထဲမှာ အခက်ခဲဆုံး ခလုတ်တွေဖြစ်ပါတယ်။ ညာဘက်အပေါ်ထောင့်မှာ ရှိတဲ့ power ခလုတ်က fingerprint sensor အဖြစ်လည်း အသုံးပြုနိုင်ပါတယ်။
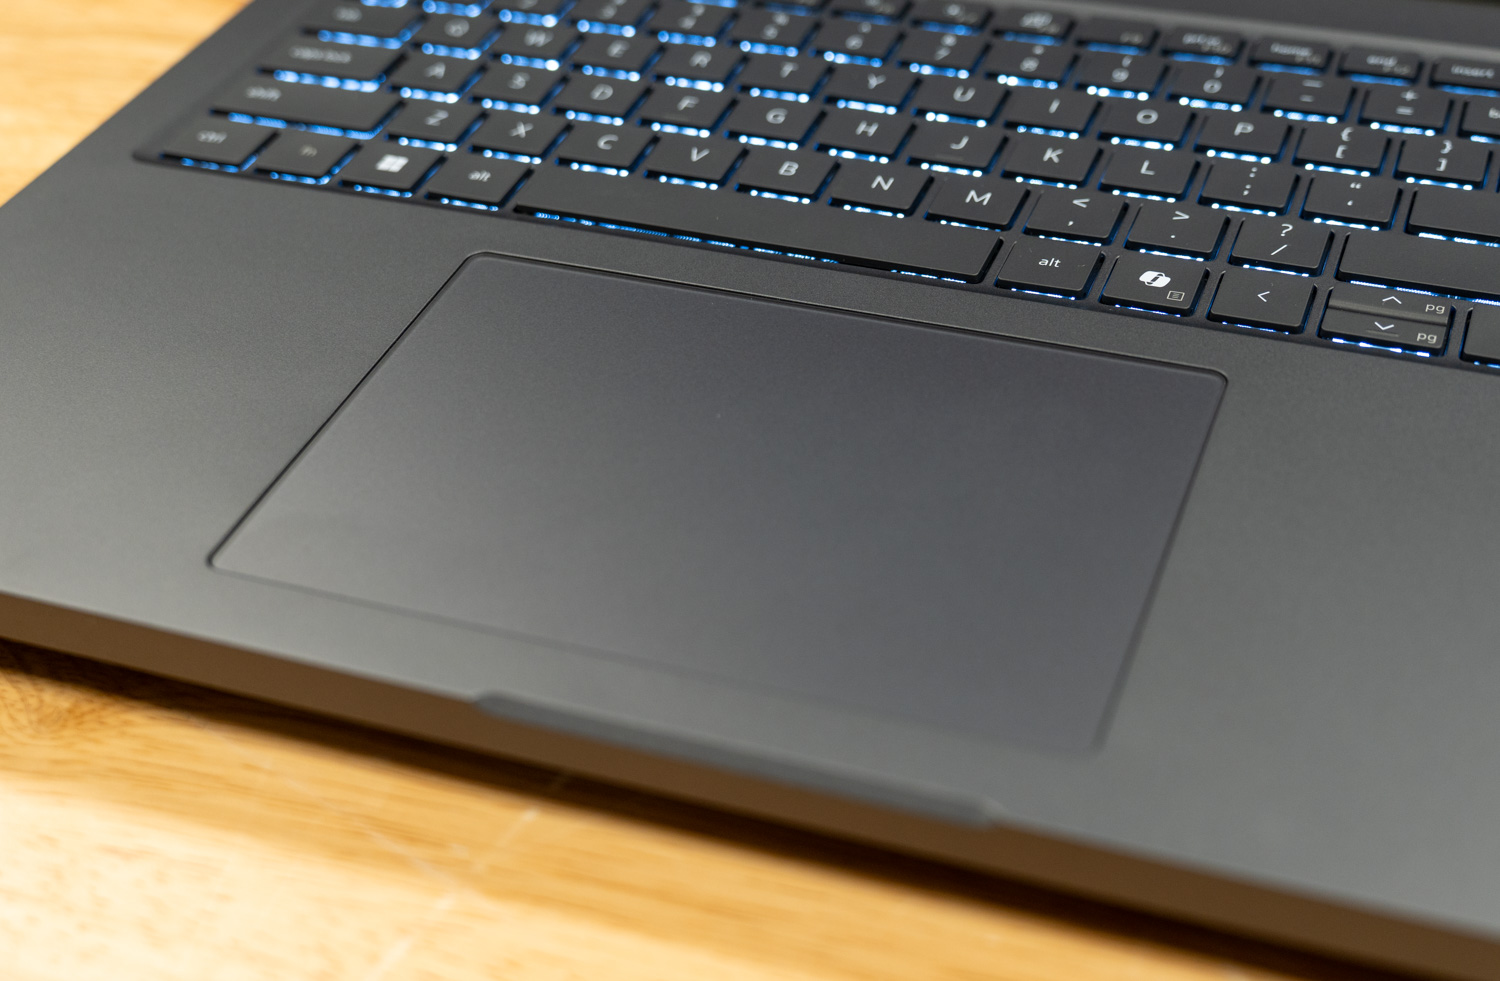
အရွယ်အစားကြီးမားသော touchpad သည် ၁၆ လက်မပုံစံကို ဖြည့်စွက်ပေးပါသည်။ ၎င်း၏ ချောမွေ့သော anti-glare မျက်နှာပြင်သည် တိကျစွာ ခြေရာခံနိုင်ပြီး စမ်းသပ်မှုတစ်လျှောက်လုံးတွင် လက်ဖဝါးငြင်းပယ်မှုမှာ အပြစ်အနာအဆာကင်းစွာ လုပ်ဆောင်ပေးပါသည်။
အဆင့်မြှင့်တင်နိုင်မှု
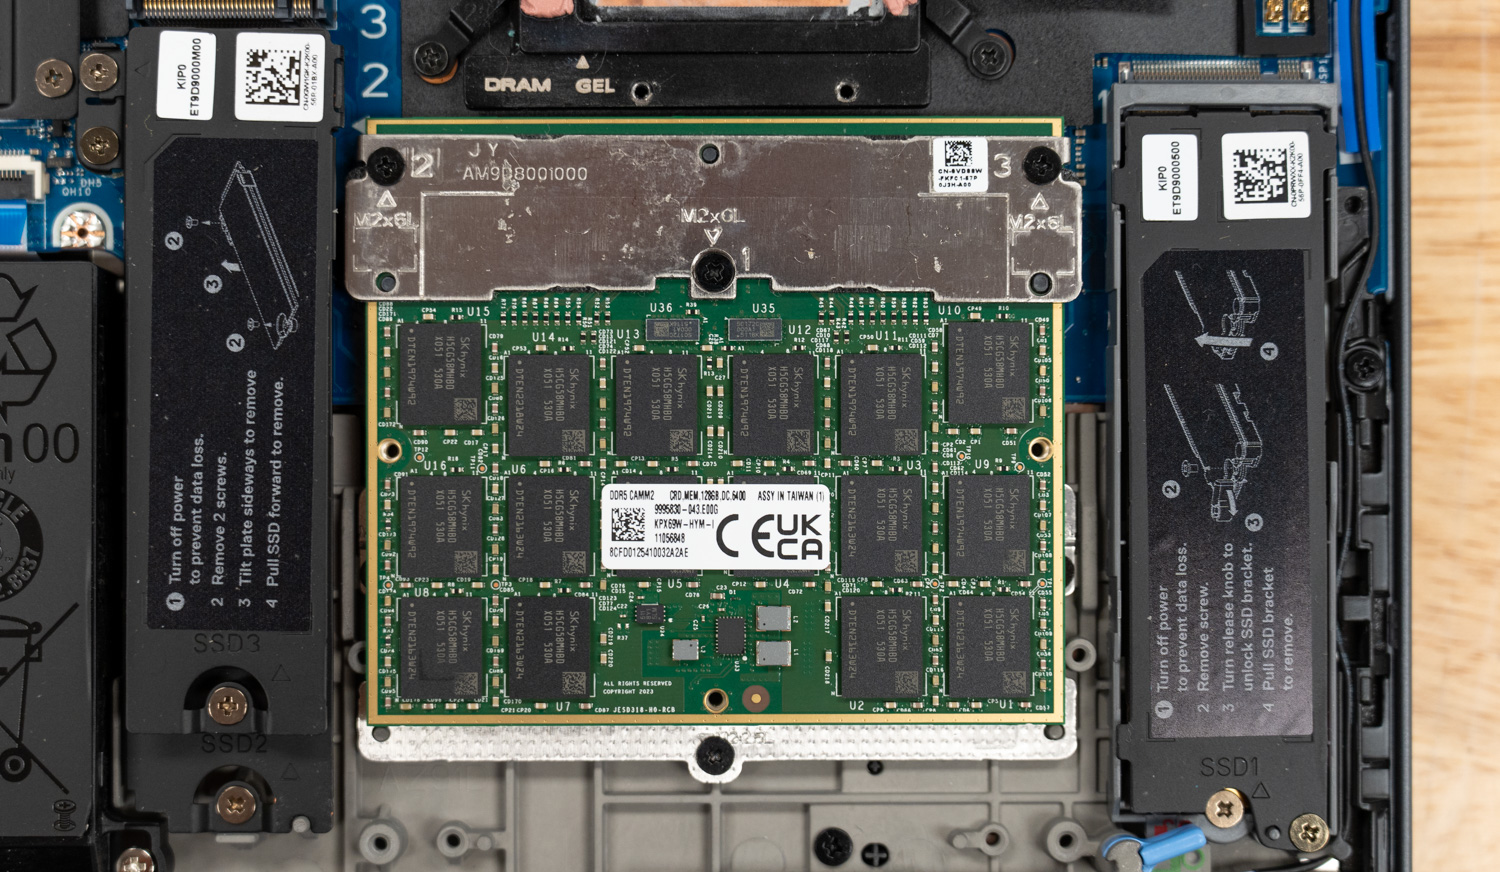
Pro Max 16 Plus ကို တိုးချဲ့အသုံးပြုနိုင်ရန် ရည်ရွယ်၍ တည်ဆောက်ထားပြီး သိသာထင်ရှားသော အဆင့်မြှင့်တင်မှု အလားအလာကို ပေးစွမ်းနိုင်ပါသည်။ ၎င်းတွင် သိုလှောင်မှုအတွက် M.2 Gen5 slot သုံးခု၊ မှတ်ဉာဏ်အဆင့်မြှင့်တင်မှုအတွက် CAMM2 slot တစ်ခုနှင့် အစားထိုးနိုင်သော USB-C port များအပါအဝင် မော်ဂျူလာ အစိတ်အပိုင်းများစွာ ပါဝင်သည်။
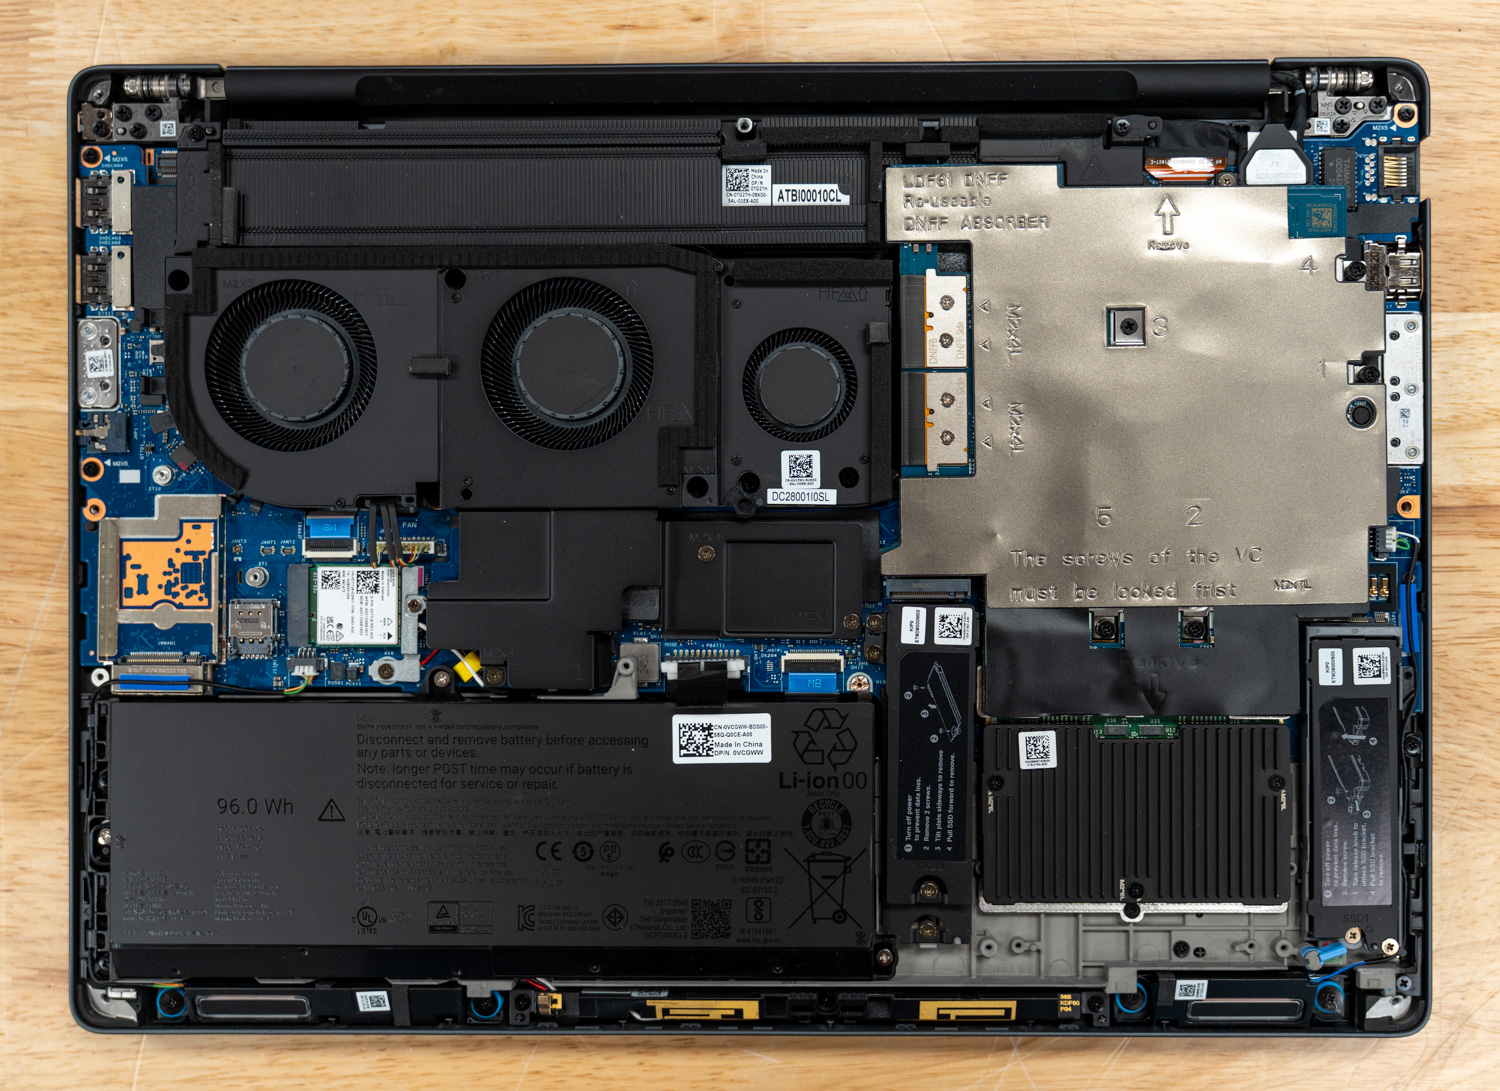
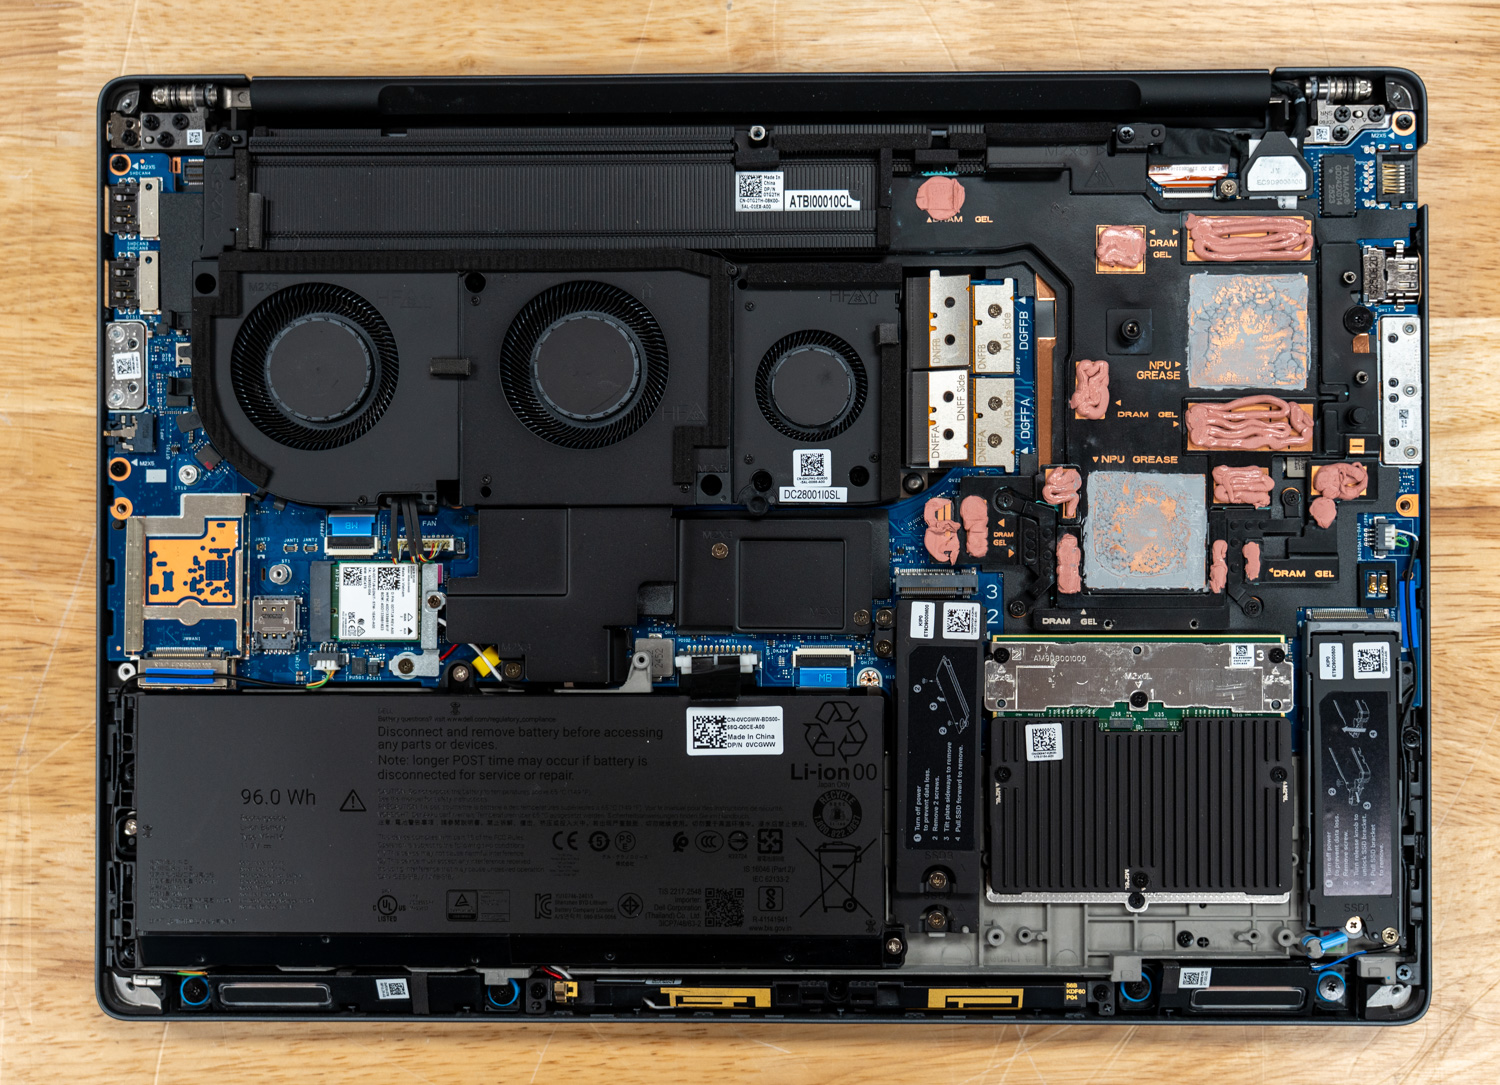
အတွင်းပိုင်းကို ဝင်ရောက်ကြည့်ရှုရန်မှာ ရိုးရှင်းပါသည်- ပတ်လည်ရှိ ဝက်အူများကို ဖယ်ရှားပြီး အောက်ခြေ panel ကို နောက်မှ ရှေ့သို့ မြှောက်ပါ။ အထဲတွင် ခိုင်ခံ့သော ပန်ကာသုံးလုံးပါ အအေးပေးစနစ်နှင့် ကြီးမားသော 96Whr ဘက်ထရီတစ်ခု ပါရှိသည်။ CAMM2 မှတ်ဉာဏ် module သည် အောက်ခြေညာဘက်တွင် တည်ရှိပြီး သီးသန့် heatsink အောက်တွင် တည်ရှိပြီး M.2 slot များဖြင့် ဘေးတွင် တည်ရှိသည်။ ဓာတ်ပုံမှ ပြောရန်ခက်ခဲသော်လည်း ဘယ်ဘက်ရှိ M.2 slot သည် အမှန်တကယ်တွင် တူညီသော footprint တွင် drive နှစ်ခုထည့်ထားသော အထပ်လိုက် slot တစ်ခုဖြစ်သည်။ အသုံးပြုသူမှ အစားထိုးနိုင်သော M.2 wireless card သည် ဘက်ထရီ၏ အထက်တွင် ရှိသည်။
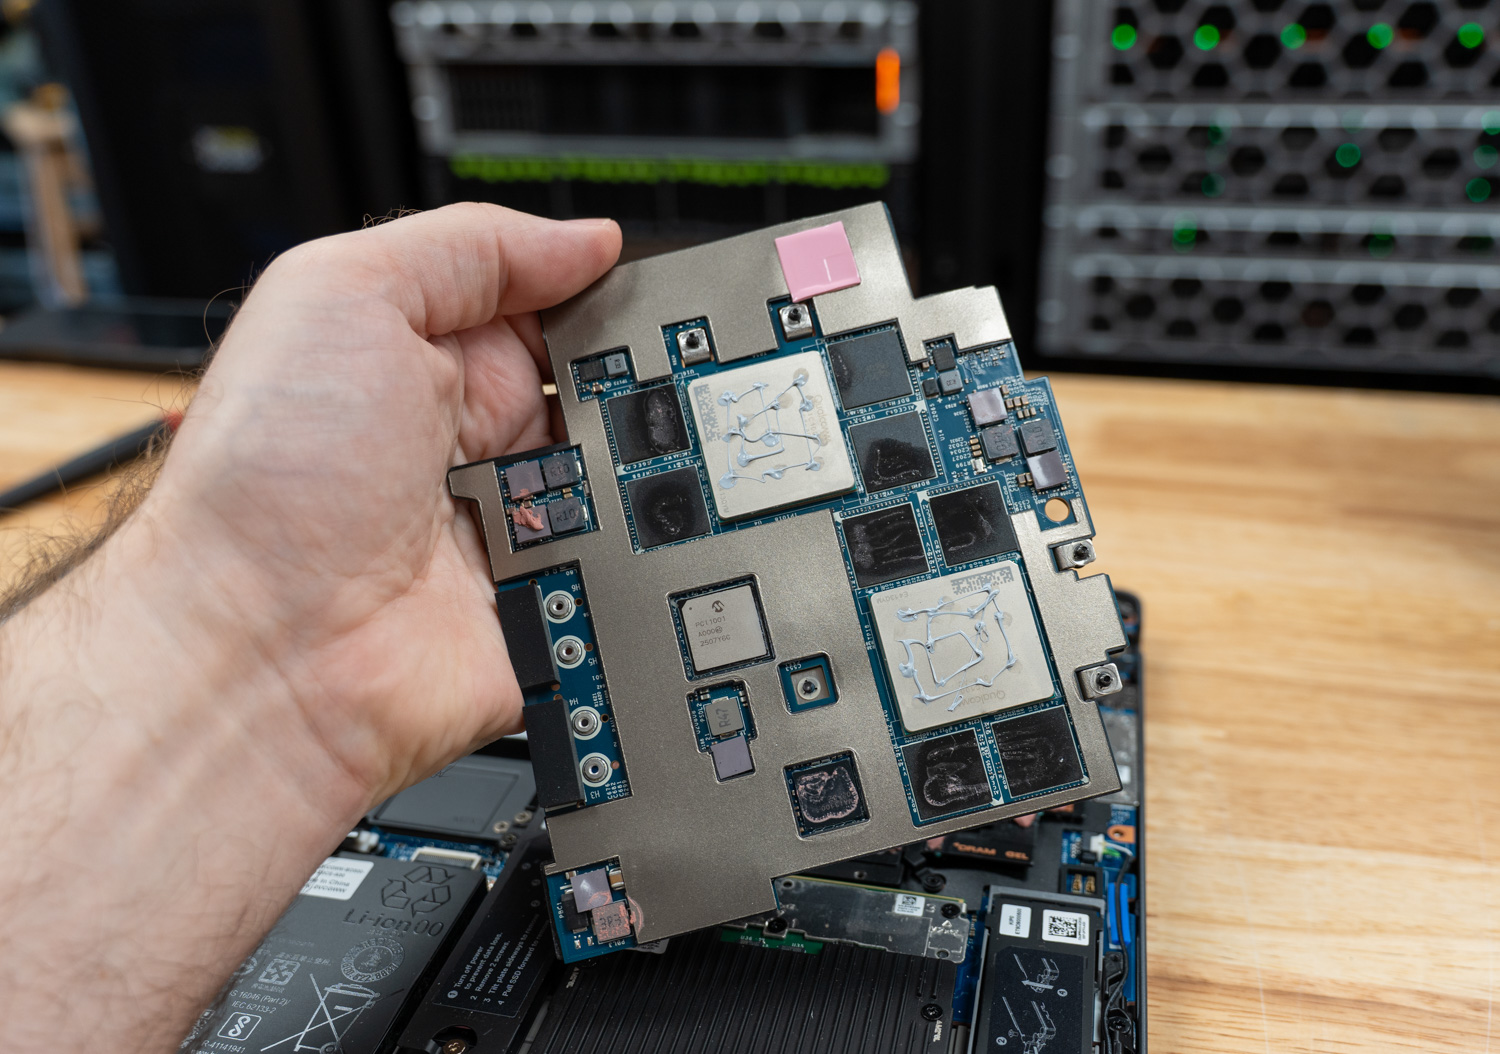
ပြပွဲ၏ ကြယ်ပွင့်- Qualcomm AIC100
ပြန်လည်သုံးသပ်နေသော Dell SKU တွင် Qualcomm AI 100 NPU နှင့်အတူ ပါလာပါသည်။ ၎င်းသည် Qualcomm Cloud AI 100 SoC နှစ်ခုကို ဘေးချင်းယှဉ်တွဲထားသော မော်ဂျူးတစ်ခုတည်းဖြစ်သည်။ SoC တစ်ခုစီတွင် မော်ဂျူးတစ်လျှောက်တွင် ပေါင်းစပ် ၃၂ ခုအတွက် AI core ၁၆ ခုပါဝင်ပြီး တစ်ခုချင်းစီတွင် ၎င်း၏ကိုယ်ပိုင် LPDDR4x 32GB ပါရှိပြီး host သို့ သီးခြား NPU နှစ်ခုအဖြစ် တင်ပြထားသည်။
Dell နှင့် Qualcomm တို့သည် INT8 throughput ၏ TOPS ၄၅၀ ခန့်နှင့် 100-billion-parameter အတိုင်းအတာရှိ မော်ဒယ်များကို လည်ပတ်နိုင်စွမ်းကို ကြော်ငြာထားပြီး Dell သည် လက်တော့ပ်တွင် ဒေသတွင်းတွင် လည်ပတ်နေသော Llama 4 Scout (109B parameters, MoE) ကို လူသိရှင်ကြား သရုပ်ပြခဲ့သည်။ SoC နှစ်ခုသည် Linux QAIC accelerator driver မှတစ်ဆင့် host နှင့် ဆက်သွယ်ပြီး firmware blobs များကို linux-firmware ထဲသို့ upstream လုပ်သည်။
အခုထိတော့ ကျိုးကြောင်းဆီလျော်ပါတယ်။ ကိန်းဂဏန်းတွေက သီးခြားကြည့်ရင် များပါတယ်။ ပြဿနာက အဲဒီကိန်းဂဏန်းတွေအောက်က ဆီလီကွန်ပါ။
Qualcomm သည် Cloud AI 100 ကို ၂၀၁၉ ခုနှစ် ဧပြီလတွင် ကြေညာခဲ့ပြီး ၂၀၂၀ ခုနှစ်နှောင်းပိုင်းတွင် နမူနာယူခဲ့ပြီး ၂၀၂၁ ခုနှစ် ပထမနှစ်ဝက်တွင် စီးပွားဖြစ် တင်ပို့ခဲ့သည်။ ထိုချစ်ပ်ကို 7nm node ပေါ်တွင် တည်ဆောက်ထားပြီး 2100 MHz (LPDDR4X-4200) တွင် လည်ပတ်နေသော 64-bit LPDDR4X controller လေးခုကို အသုံးပြုထားပြီး Qualcomm ၏ ကိုယ်ပိုင် Cloud AI ဗိသုကာစာရွက်စာတမ်းအရ SoC တစ်ခုလျှင် 136 GB/s မန်မိုရီ bandwidth ကို ပေးစွမ်းနိုင်သည်။
မူလက PCIe form factor ကို ထည့်သွင်းစဉ်းစားပြီး ဒီဇိုင်းထုတ်ခဲ့တာပါ။ ဒီချစ်ပ်နှစ်ခုကို custom module တစ်ခုထဲကိုထည့်ပြီး ၂၀၂၅ ခုနှစ်ထုတ် laptop ထဲကို ထည့်လိုက်ရုံနဲ့ အခြေခံအပေးအယူတွေကို မပြောင်းလဲပါဘူး။ ဒါက ၂၀၁၉ ခုနှစ်ထုတ် silicon ဖြစ်ပြီး ၂၀၁၉ ခုနှစ်ထုတ် memory နည်းပညာကို ပြန်လည်ဆန်းသစ်ပြီး အမည်ပြောင်းလဲထားပေမယ့် ဗိသုကာပိုင်းဆိုင်ရာအရ အတူတူပါပဲ။ Dell Pro Max 16 Plus မှာ ပါဝင်လာတဲ့အချိန်မှာ ကျန်တဲ့ industry တွေက HBM2e, HBM3, HBM3e နဲ့ LPDDR5X တွေကို အသုံးပြုနေကြပြီး အခုဆိုရင် AI accelerator တွေမှာ GDDR7 နဲ့ HBM4 တွေကို အသုံးပြုလာကြပါပြီ။
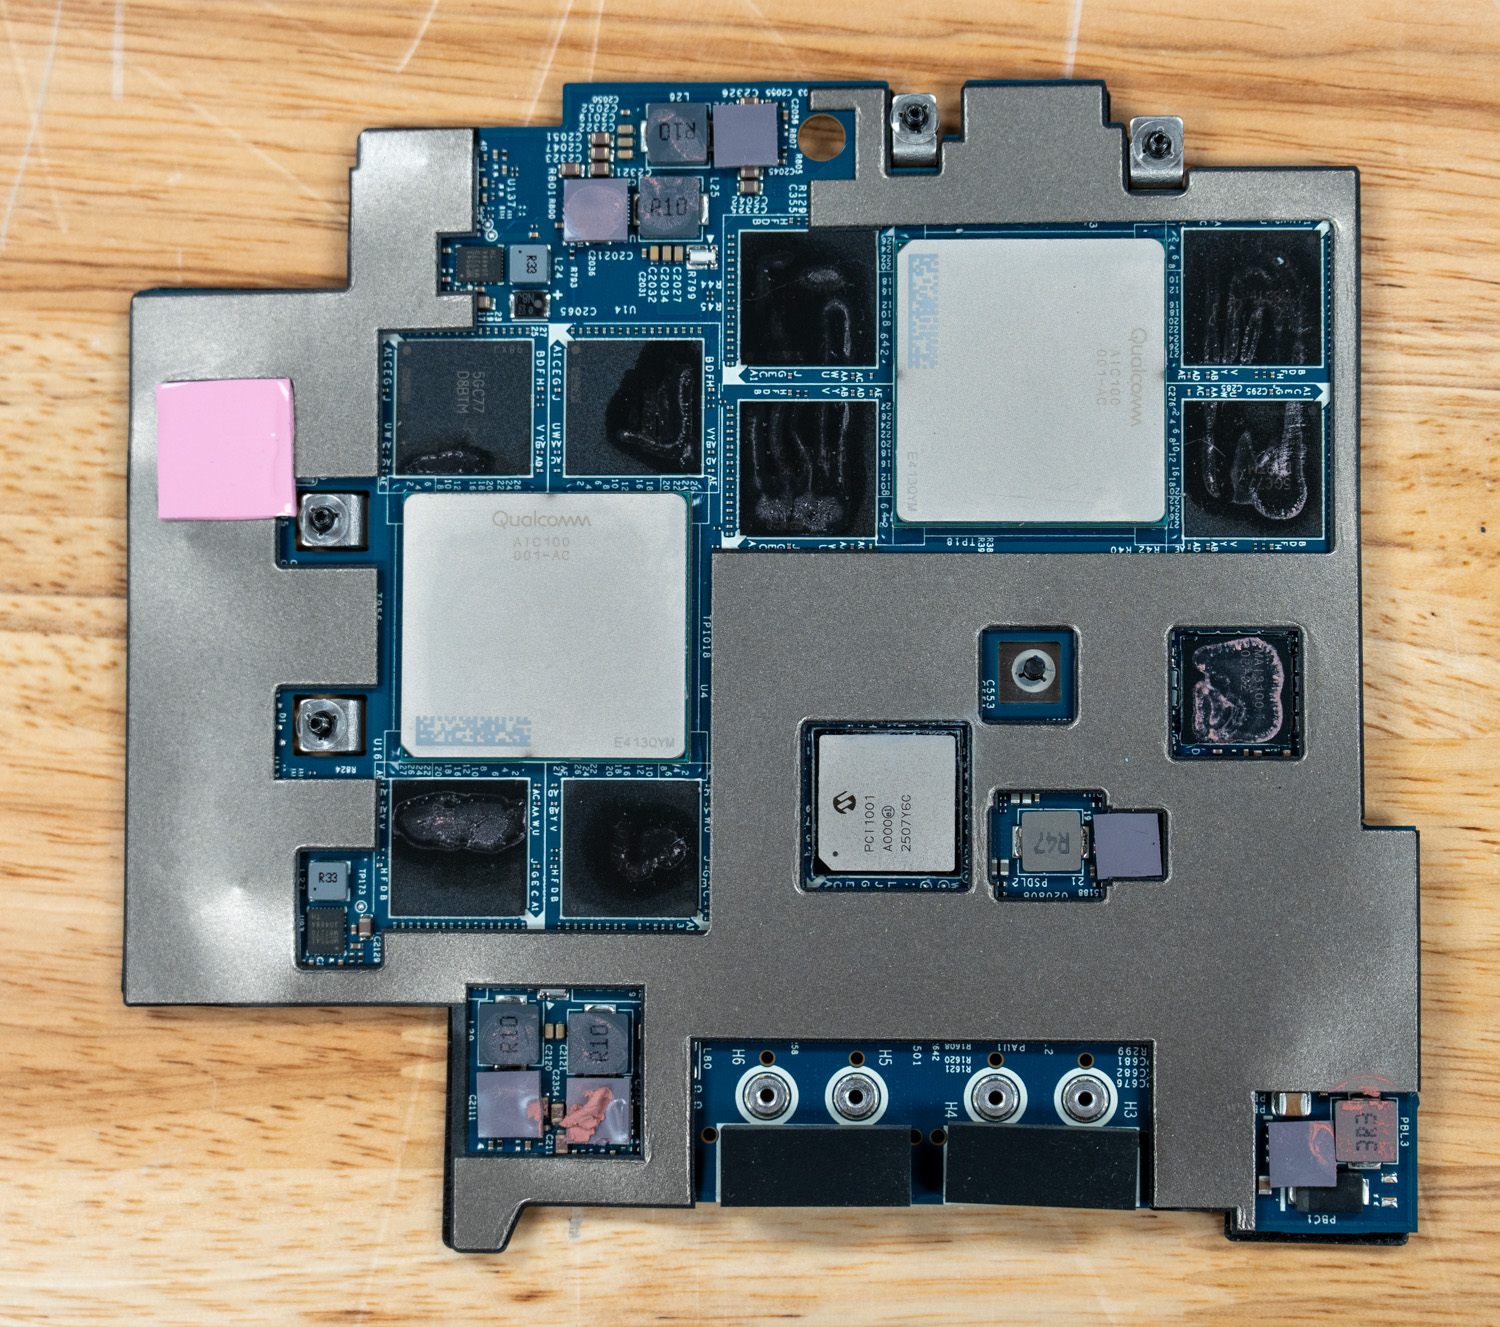
ဒါပေမယ့် ပိုနက်ရှိုင်းတဲ့ပြဿနာက မန်မိုရီ bandwidth ထက် ပိုအရေးကြီးပါတယ်။ AI inference ပြဿနာကို အလွန်နက်ရှိုင်းတဲ့အဆင့်မှာ နားလည်တဲ့ ထူးချွန်ထက်မြက်တဲ့ ချစ်ပ်ဒီဇိုင်းတွေနဲ့ အင်ဂျင်နီယာအဖွဲ့တွေ အများကြီးရှိပြီး Cloud AI 100 ဗိသုကာကိုယ်တိုင်က အရည်အချင်းပြည့်ဝနိုင်ပါတယ်။ ပြဿနာက ထုတ်ကုန်တစ်ခုကို အသက်ဝင်အောင် ဒါမှမဟုတ် သေဆုံးသွားအောင် တကယ်လုပ်ဆောင်တဲ့ ဆော့ဖ်ဝဲအင်ဂျင်နီယာတွေဟာ တခြားဂေဟစနစ်တစ်ခုမှာ အကြီးအကျယ် ရင်းနှီးမြှုပ်နှံထားပြီးသားပါ။ အဲဒါကတော့ CUDA ပါ။ ပြောင်းလဲဖို့ စိတ်အားထက်သန်မှုမရှိရင် developer တွေဟာ ကောင်းမွန်တဲ့ ပံ့ပိုးမှု၊ စာရွက်စာတမ်းနဲ့ အသိုင်းအဝိုင်းအကူအညီတွေ ရှိပြီးသား toolchain ကိုပဲ ဆက်လက်အသုံးပြုကြပါတယ်။ NVIDIA ဟာ developer အခြေခံကို အစောပိုင်းမှာ သိမ်းပိုက်ပြီး ကြီးမားတဲ့ အသိုင်းအဝိုင်းတစ်ခုကို တည်ဆောက်ခဲ့ပါတယ်။ AMD ဟာ ဒီကိစ္စမှာ နှစ်ပေါင်းများစွာ နောက်ကျကျန်နေခဲ့ပေမယ့် မကြာသေးမီက ROCm revs တွေက အမှန်တကယ်ကောင်းမွန်ပြီး ကွာဟချက်က နီးကပ်လာပါပြီ။ Modular ရဲ့ Mojo နဲ့ MAX လိုမျိုး solution တွေက NVIDIA ဒါမှမဟုတ် AMD ကို တူညီတဲ့ code နဲ့ ပစ်မှတ်ထားနိုင်ပြီး တစ်ခါတစ်ရံမှာ native runtimes တွေကို ကျော်လွန်နိုင်ပါတယ်။ ဒါပေမယ့် တခြား accelerator တိုင်းဟာ software backing မရှိတာကြောင့် public adoption နဲ့ ရုန်းကန်နေရပါတယ်။
အများပြည်သူအသုံးပြုခြင်းသည် လုပ်ဆောင်ချက်ဆိုင်ရာ စကားစုဖြစ်သည်။ Google ကဲ့သို့သော အဖွဲ့အစည်းကြီးများသည် TPU များ သီဆိုနိုင်ရန် XLA နှင့် JAX တွင် ဘီလီယံနှင့်ချီ၍ ရင်းနှီးမြှုပ်နှံနိုင်သည် ။ ရန်ပုံငွေကောင်းစွာရရှိထားသော ပုဂ္ဂလိက startup များနှင့် AI ဓာတ်ခွဲခန်းများသည် ၎င်းတို့၏ကိုယ်ပိုင် ကျဉ်းမြောင်းသော မော်ဒယ်များအတွက် custom kernel များကို ရေးသားနိုင်ပြီး အခြားမည်သူမျှ အဆုံးမရှိ အများပြည်သူအသုံးပြုမှုကိစ္စများအတွက် မတည်ဆောက်ထားသော stack ကို ပုံတူကူးယူ၍မရသည်ကို ဂရုမစိုက်ပါ။ ၎င်းတို့သည် ၎င်းတို့ရင်ဆိုင်နေရသော ပြဿနာများအတွက် တည်ဆောက်နေကြသည်။ အများပြည်သူစားသုံးသူ သို့မဟုတ် လုပ်ငန်းအများစုအတွက်ပင် ကြီးထွားဖွံ့ဖြိုးသော အများပြည်သူ developer ecosystem မပါရှိသော accelerator သည် လုပ်ဆောင်နိုင်စွမ်းအရ အသုံးမဝင်ပါ။ သင့်မော်ဒယ်ကို ၎င်းတွင်ထည့်သွင်းရန် ရက်သတ္တပတ်များစွာ အချိန်ကုန်ခံရမည်ဖြစ်ပြီး Hugging Face သည် architecture အသစ်တစ်ခုကို ပေးပို့လိုက်သည်နှင့် CUDA နှင့် ROCm ရှိလူတိုင်းတွင် day-zero support ရှိပြီး recompile job (သို့မဟုတ် unsupported-model error) ကို ကြည့်နေလိမ့်မည်။
ဒါကြောင့် ကျွန်တော်ရှင်းရှင်းလင်းလင်းပြောရရင် ဒီလက်တော့ပ်ထဲက AIC100 ဟာ ရေထဲမှာကုန်ဆုံးသွားပါပြီ။ ဘယ်သူမှ မဝယ်သင့်ပါဘူး။ အင်ဂျင်နီယာအရင်းအမြစ်တွေနဲ့ သူ့ရဲ့ သီးခြားအလုပ်ပမာဏအတွက် ကောက်ချက်ချဖို့ ရှင်းလင်းတဲ့ရည်ရွယ်ချက်မရှိရင်၊ ပြီးတော့ အဲဒီ stack ကို ထိန်းသိမ်းဖို့ စာရင်းသွင်းနေတယ်ဆိုတာကို လက်ခံထားမှသာ ဘယ်အဖွဲ့အစည်းမှ ဝယ်သင့်ပါတယ်။
ဆော့ဖ်ဝဲနှင့် ကိရိယာတန်ဆာပလာများ လက်တွေ့ဘဝ
အဲဒီအကြံပြုချက်က ဘာကြောင့် ဒီလောက်ပြင်းထန်ရတာလဲဆိုတာကို နားလည်ဖို့အတွက် ဒီကတ်ပေါ်က ပို့ဆောင်ရေးဆိုင်ရာ ကောက်ချက်မှာ တကယ်ပါဝင်တဲ့အရာတွေကို ကြည့်ရပါမယ်။
အသုံးပြုသူဘက်မှ ထိတွေ့ဆက်ဆံရသော အပိုင်းအစများကို SDK နှစ်ခုနှင့် wrapper library တစ်ခုအဖြစ် ပိုင်းခြားထားသည်။ Qualcomm Cloud AI Platform SDK သည် kernel driver (mainline Linux ရှိ upstream accel/qaic driver)၊ device firmware၊ on-card runtime နှင့် low-level API များကို ပို့ဆောင်ပေးသည်။ Apps SDK သည် အပေါ်ဆုံးတွင်ရှိပြီး qaic-exec compiler၊ qaic-runner inference CLI၊ QAIC execution provider မှတစ်ဆင့် ONNX Runtime integration၊ Python bindings နှင့် vLLM fork တို့ကို ပံ့ပိုးပေးသည်။ QEfficient ဟုလည်းခေါ်သော Qualcomm efficient-transformers library သည် Hugging Face Transformers wrapper တစ်ခုဖြစ်ပြီး AIC100 မှ လိုအပ်သော static shapes၊ KV cache layouts နှင့် graph transformations များဖြင့် ရေပန်းစားသော LLM architectures များကို ပြန်လည်အကောင်အထည်ဖော်သည်။ Qualcomm AI Hub သည် သီးခြား model catalog နှင့် compile-as-a-service ထုတ်ကုန်တစ်ခုဖြစ်သော်လည်း branding ကို မျှဝေထားသည်။
compile path က တင်းကျပ်ပါတယ်။ PyTorch model ကိုယူပြီး torch.export ဒါမှမဟုတ် ONNX ကိုသုံးပြီး export လုပ်ပါ၊ ပြီးတော့ -convert-to-fp16၊ -mxfp6-matmul၊ batch size၊ context length နဲ့ target SoC count စတဲ့ flag တွေနဲ့ qaic-exec ကို feed လုပ်ပါတယ်။ compiler က ahead-of-time scheduling နဲ့ memory placement ကိုလုပ်ဆောင်ပြီးရင် QPC၊ Qualcomm Program Container၊ memory layout၊ KV cache shape၊ batch size၊ prefill sequence length နဲ့ context length တွေကို pin လုပ်တဲ့ sealed binary ကိုထုတ်လွှတ်ပါတယ်။ JIT မရှိပါဘူး။ Qualcomm ရဲ့ LLM documentation အရ ahead-of-time AI 100 compiler က prompt length၊ generation length၊ KV cache နဲ့ batch size ပေါ်မူတည်ပြီး device resource တွေကို preallocate လုပ်ပေးပြီး Cloud AI 100 က static input shapes တွေကိုပဲ support လုပ်ပါတယ်။ compile-time parameter တွေကို ပြောင်းလဲရင် full compile တစ်ခုကို ထပ်လုပ်ပါတယ်၊ အဲဒါက model သေးသေးလေးတွေအတွက် မိနစ်ပေါင်းများစွာကြာပြီး model ကြီးကြီးတွေအတွက် နာရီပေါင်းများစွာကြာနိုင်ပါတယ်။
ပံ့ပိုးပေးထားတဲ့ ဗိသုကာလက်ရာစာရင်းက အရမ်းတိုပါတယ်။ Dell က သုံးစွဲသူတွေကို မော်ဒယ်ဟောင်းတွေကို အများအားဖြင့် လွှမ်းခြုံထားတယ်လို့ ညွှန်ပြတဲ့ QEfficient library နဲ့ Zentree-hosted prebuilt QPC catalog တို့ဟာ ၂၀၂၆ ခုနှစ်မှာ အသုံးပြုသင့်တဲ့ ပမာဏ အနည်းငယ်သာ ရှိပါတယ်။
FP8-native checkpoints အသစ်များသည် requantization လိုအပ်သည်။ လူကြိုက်များသော GPT-OSS မော်ဒယ်များကဲ့သို့ မော်ဒယ်တစ်ခုသည် MXFP4 တွင် natively ပို့ဆောင်ပါက၊ သင်သည် weight များကို လျှော့ချမည့်အစား conversion-and-recompile pipeline ကို ကြည့်ရှုနေခြင်းဖြစ်သည်။ သင်အလုပ်လုပ်ရန် ဆန္ဒရှိပါက ၎င်းတို့ထဲမှ တစ်ခုမျှ မဖြစ်နိုင်သော်လည်း ၎င်းသည် အမြဲတမ်း အခွန်တစ်ခုဖြစ်သည်။
ပြီးတော့ concurrency ပြဿနာရှိပါသေးတယ်၊ အဲဒါက laptop တွေ ပျက်သွားတဲ့နေရာပါ၊ box ထဲက စွမ်းဆောင်ရည်ကို အာရုံစိုက်တဲ့ developer တွေအတွက်တောင်မှပါ။ Dell က user တွေကို vLLM နဲ့ pull လုပ်ပြီး run ဖို့ ညွှန်ကြားထားတဲ့ Dell ပေးထားတဲ့ container image တွေက Zentree က သတ်မှတ်ထားတဲ့ shape တွေနဲ့ pre-compiled လုပ်ထားတဲ့ QPC တွေပေါ်မှာ အခြေခံထားပြီး shipped container တွေက concurrency 1 မှာပဲ run ပါတယ်။ input ဒါမှမဟုတ် output sequence shape မည်သို့ပင်ရှိစေကာမူ၊ ပေးထားတဲ့ model အတွက် fixed throughput တစ်ခုတည်းကို ရရှိပါတယ်။ multiple parallel request တွေကို တစ်ပြိုင်နက်တည်း run မှာ မဟုတ်ပါဘူး။ vLLM က queue လုပ်ပြီး sequence အတိုင်း process လုပ်ပါတယ်။ dynamically batch လုပ်လို့မရပါဘူး။ Team Red ဒါမှမဟုတ် Green GPU တွေမှာ vLLM ဒါမှမဟုတ် SGLang က အခမဲ့ပေးထားတဲ့ continuous batching ကို အသုံးပြုလို့မရပါဘူး။ 1 အထက် concurrency ရဖို့ QPC ကို batch size ပိုကြီးတဲ့နည်းနဲ့ recompile လုပ်ရပါမယ်။
Dell ရဲ့ ဥပမာတွေက ဒီလက်တော့ပ်ကို developer တွေဆီ မိတ်ဆက်ပေးခဲ့ပြီး ဒီနေ့ခေတ် developer တွေအတွက် အသုံးအများဆုံး AI အသုံးပြုမှုကတော့ Claude Code၊ OpenCode စတဲ့ tool တွေနဲ့ vibe coding ပါ။ ဒီ tool တွေဆီကို request တစ်ခုတည်းနဲ့ parallel LLM call တွေ အများကြီးဖြစ်သွားနိုင်ပါတယ်။ ဒီ NPU တွေက အဲဒီ request တွေကို parallel မဟုတ်ဘဲ အစဉ်လိုက် queue လုပ်ပြီး process လုပ်မှာဖြစ်လို့ NVIDIA Spark မှာ စက္ကန့်ပိုင်းလောက်ကြာရင် ဒီ setup မှာ မိနစ်ပိုင်းလောက်ကြာပါလိမ့်မယ်။
performance
Dell မှ စမ်းသပ်ရန်အတွက် ပံ့ပိုးပေးထားသော စနစ်တွင် အောက်ပါဖွဲ့စည်းပုံရှိသည်။
- Intel Core Ultra 9 285HX စီပီယူ
- Qualcomm AIC100 PC Inference Card
- 128GB 6400MTS CAMM2 DDR5
- 4TB SSD ကို
ဂဏန်းတွေမပေါ်ခင်မှာ methodology note တစ်ခုပြောပါရစေ။ အထက်မှာဖော်ပြထားတဲ့အတိုင်း AIC100 ဟာ frozen batch size, sequence length နဲ့ KV-cache layout တွေနဲ့ pre-of-time-compiled QPC တွေကို လုပ်ဆောင်ပါတယ်။ Dell က Zentree မှာ host လုပ်ထားတဲ့ pre-compiled QPC အစုံနဲ့ ပထမဆုံး launch လုပ်တဲ့အခါ pull လုပ်တဲ့ vLLM container image နဲ့အတူ ဒီ laptop ကို ပို့ပေးပါတယ်။ concurrency 1 မှာ Dell ရဲ့ reference container မှတစ်ဆင့် ပေးပို့တဲ့ pre-cooked QPC အစုံဟာ end user တစ်ယောက်က စက်ကို unbox လုပ်ပြီး Dell ရဲ့ documentation ကို လိုက်နာတဲ့အခါ တကယ်ရရှိတဲ့အရာဖြစ်ပြီး အဲဒါက ကျွန်တော်တို့ benchmark လုပ်ထားတဲ့ configuration ပါ။
တခြားနည်းလမ်းတွေနဲ့ လုပ်ဖို့အတွက် ကျွန်တော်တို့မှာ ကိရိယာတွေ ရှိပါတယ်။ ကျွန်တော်တို့ qaic-exec ကို ဆွဲထုတ်ပြီး checkpoint တစ်ခုကို ယူကာ torch.export ကနေ run ပြီး requantize လုပ်နိုင်သလို၊ batch size ပိုကြီးတဲ့ QPC ကို recompile လုပ်ပြီး vLLM ကနေ ပြန် feed လုပ်နိုင်ပါတယ်။ ကျွန်တော်တို့ ရေးချင်ရင် QAIC accelerator driver နဲ့ custom kernels တွေ ရေးလို့ရပါတယ်။ ဒီ laptop ရဲ့ target market မှာရှိတဲ့ buyer အများစုဖြစ်တဲ့ developer တွေ၊ AI ကို စိတ်ဝင်စားတဲ့ engineer တွေနဲ့ enterprise pilot team တွေက အဲဒီအလုပ်ကို မလုပ်ကြတဲ့အတွက် ကျွန်တော်တို့ မရေးဖို့ ရွေးချယ်ခဲ့ပါတယ်။ သူတို့က container ကို ဆွဲထုတ်ပြီး run ပြီး product ကို ဘာထွက်လာလဲဆိုတဲ့အပေါ်မှာ အကဲဖြတ်ကြပါလိမ့်မယ်။ ဒါကြောင့် ကျွန်တော်တို့ တိုင်းတာခဲ့တာက အဲဒါပါပဲ။
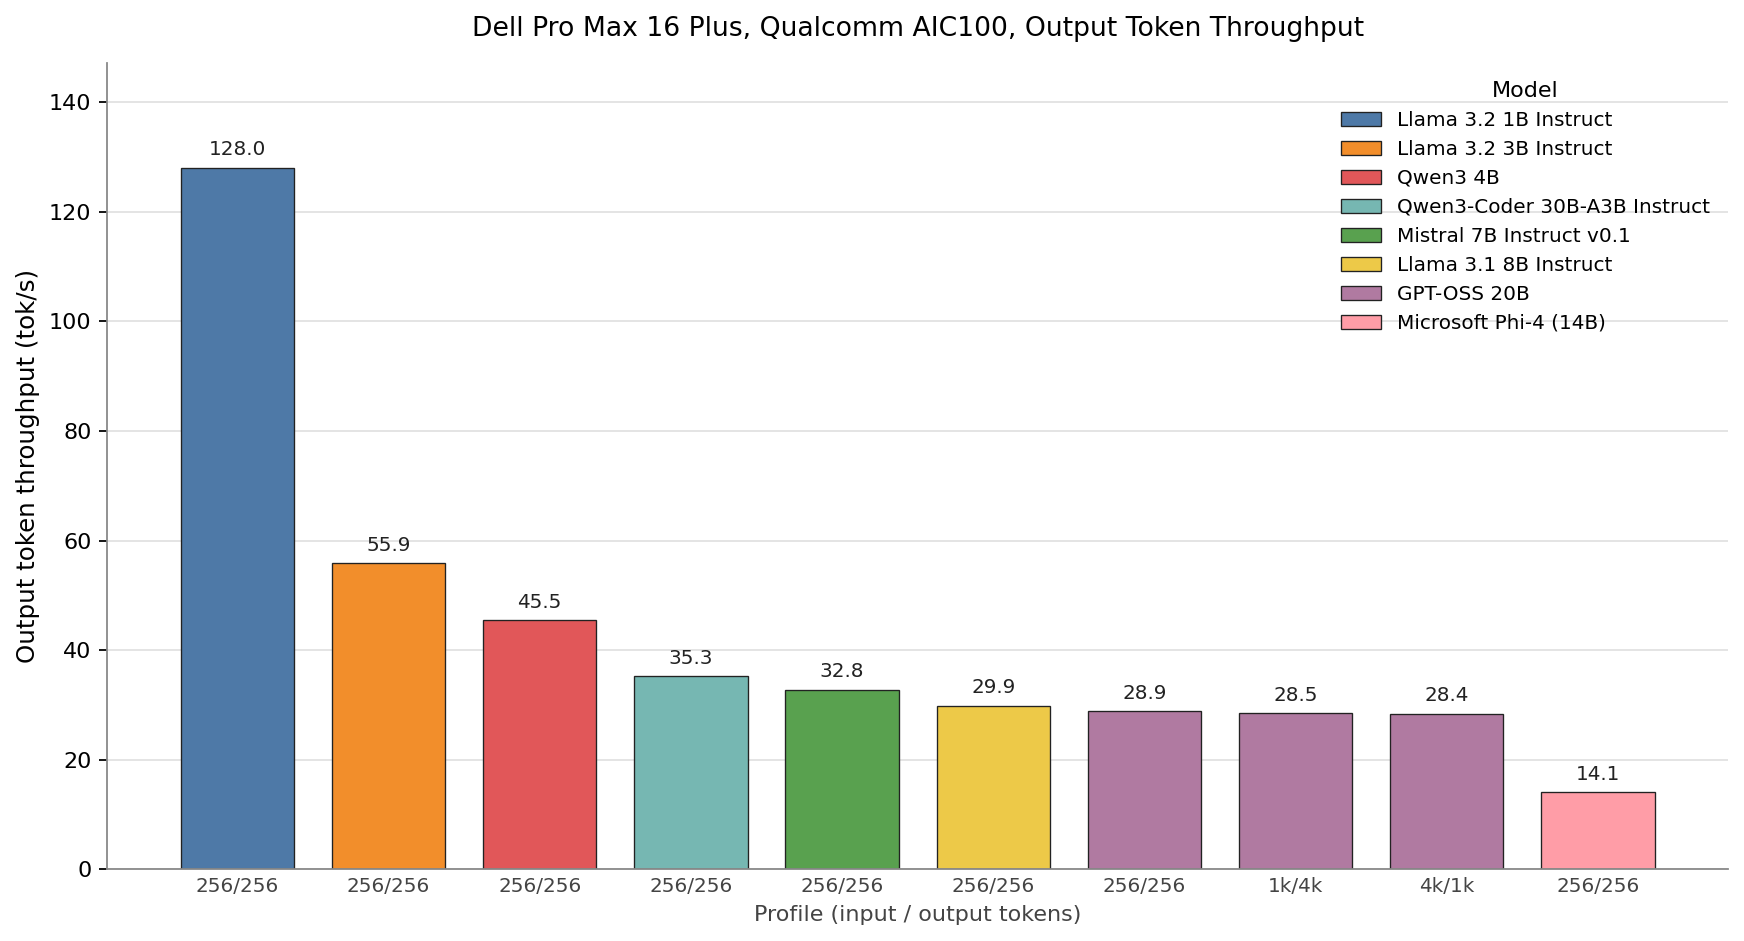
ဘားတိုင်းသည် MXFP6 အလေးချိန်များနှင့် MXINT8 KV cache ဖြင့် လည်ပတ်နေသော Qualcomm-compiled QPC ကို ကိုယ်စားပြုပြီး Dell ၏ တင်ပို့ထားသော artifacts များက ဘုတ်အဖွဲ့တစ်ခုလုံးတွင် အသုံးပြုသည့် တိကျမှုဖြစ်သည်။ Llama 3.2 1B သည် ဇယားတွင် 100 TPS ထက်ကျော်လွန်သော တစ်ခုတည်းသော မော်ဒယ်ဖြစ်ပြီး 128 TPS အထိ ရောက်ရှိခဲ့သည်။ Llama 3.2 3B သည် 56 TPS၊ Qwen3 4B သည် 45 TPS၊ Qwen3-Coder 30B-A3B သည် 35 TPS၊ Mistral 7B သည် 33 TPS နှင့် Llama 3.1 8B သည် 30 TPS ဖြင့် အသီးသီး ရပ်တည်လျက်ရှိသည်။ GPT-OSS 20B သည် 256/256၊ 1k/4k နှင့် 4k/1k ပရိုဖိုင်များတွင် 28.9၊ 28.5 နှင့် 28.4 TPS တွင် ရှိနေပြီး Qualcomm ၏ စာရွက်စာတမ်းများက AOT compiler အကြောင်း ကတိပြုထားသည်ကို အတည်ပြုပေးသည်- QPC တစ်ခုကို ပုံသဏ္ဍာန်တစ်ခုအတွက် တည်ဆောက်ပြီးသည်နှင့် decode rate သည် ပုံသေဖြစ်ပြီး prompt length သည် per-token cost ကို မပြောင်းလဲပါ။ Phi-4 သည် ဇယားကို 14 TPS တွင် အဆုံးသတ်ထားသည်။
အထက်ဖော်ပြပါ မော်ဒယ်များထက် ပိုကြီးသော မော်ဒယ်များသည် ဤကတ်တွင် တပ်ဆင်နိုင်သော်လည်း၊ ကျွန်ုပ်တို့သည် ၎င်းတို့ကို benchmark မလုပ်ခဲ့ပါ။ ဥပမာအားဖြင့်၊ Dell မှ လူသိရှင်ကြား သရုပ်ပြခဲ့သော Llama 4 Scout မော်ဒယ်ဖြင့် ထိုသို့ပြုလုပ်ခြင်းသည် INT4 အထိ တိကျမှုကို ထပ်မံလျှော့ချရန် လိုအပ်ပြီး လက်တွေ့တွင်၊ ပမာဏနည်းသော၊ ပိုသေးငယ်သော မော်ဒယ်သည် ပမာဏများသော၊ ပိုကြီးသော မော်ဒယ်ထက် workload များစွာတွင် စွမ်းဆောင်ရည် ပိုမိုကောင်းမွန်မည်ဖြစ်သည်။
ပို့ဆောင်ထားသော vLLM container သည် batch_size=1 တွင် QPC တိုင်းကို လုပ်ဆောင်ပေးပြီး၊ တစ်ပြိုင်နက်တည်း request နှစ်ခုထုတ်ပေးခြင်းသည် throughput ကို နှစ်ဆမတိုးစေကြောင်း လက်တွေ့တွင် အတည်ပြုခဲ့ပါသည်။ ဒုတိယ request သည် ပထမ request ပြီးဆုံးသည်အထိ software queue တွင် စောင့်ဆိုင်းရုံသာဖြစ်သည်။ ပို့ဆောင်ထားသော stack တွင် ရရှိနိုင်သော continuous batching၊ in-flight batching သို့မဟုတ် speculative decoding မရှိပါ။ Claude Code သို့မဟုတ် OpenCode ကဲ့သို့သော user turn တစ်ခုတည်းမှ multiple parallel LLM calls များကို ထုတ်ပေးသည့် coding agent များအတွက်၊ ဤ single-stream cap သည် response time ၏ စက္ကန့်အနည်းငယ်ကို multi-minute wall-clock wait အဖြစ်သို့ ပြောင်းလဲပေးသည်။ batch dimension ကို မြှင့်တင်ရန်အတွက် host တွင် QPC ကို ပြန်လည် compile လုပ်ရန် လိုအပ်ပြီး ၎င်းသည် ကျွန်ုပ်တို့ ဖြတ်သန်းရန် ငြင်းဆိုထားပြီးသား trapdoor သို့ ပြန်ရောက်စေပါသည်။
ဒါကို NVIDIA Spark နဲ့ နှိုင်းယှဉ်ကြည့်ရအောင်။ 256/256 Input နဲ့ Output Sequence Length ရှိတဲ့ Spark ဟာ Dell ရဲ့ Qualcomm AIC 100 က 20B မော်ဒယ်ကို run တာထက် 120B မော်ဒယ်ကို ပိုမြန်အောင် run နိုင်ပါတယ်။ ဒီရလဒ်တွေကို software revision တွေမှာ Marlin Kernel ကို အသုံးပြုပြီး စုဆောင်းထားတဲ့အတွက် ဒါက Spark ပေးနိုင်တဲ့ အကောင်းဆုံး ဂဏန်းတွေတောင် မဟုတ်ပါဘူး။
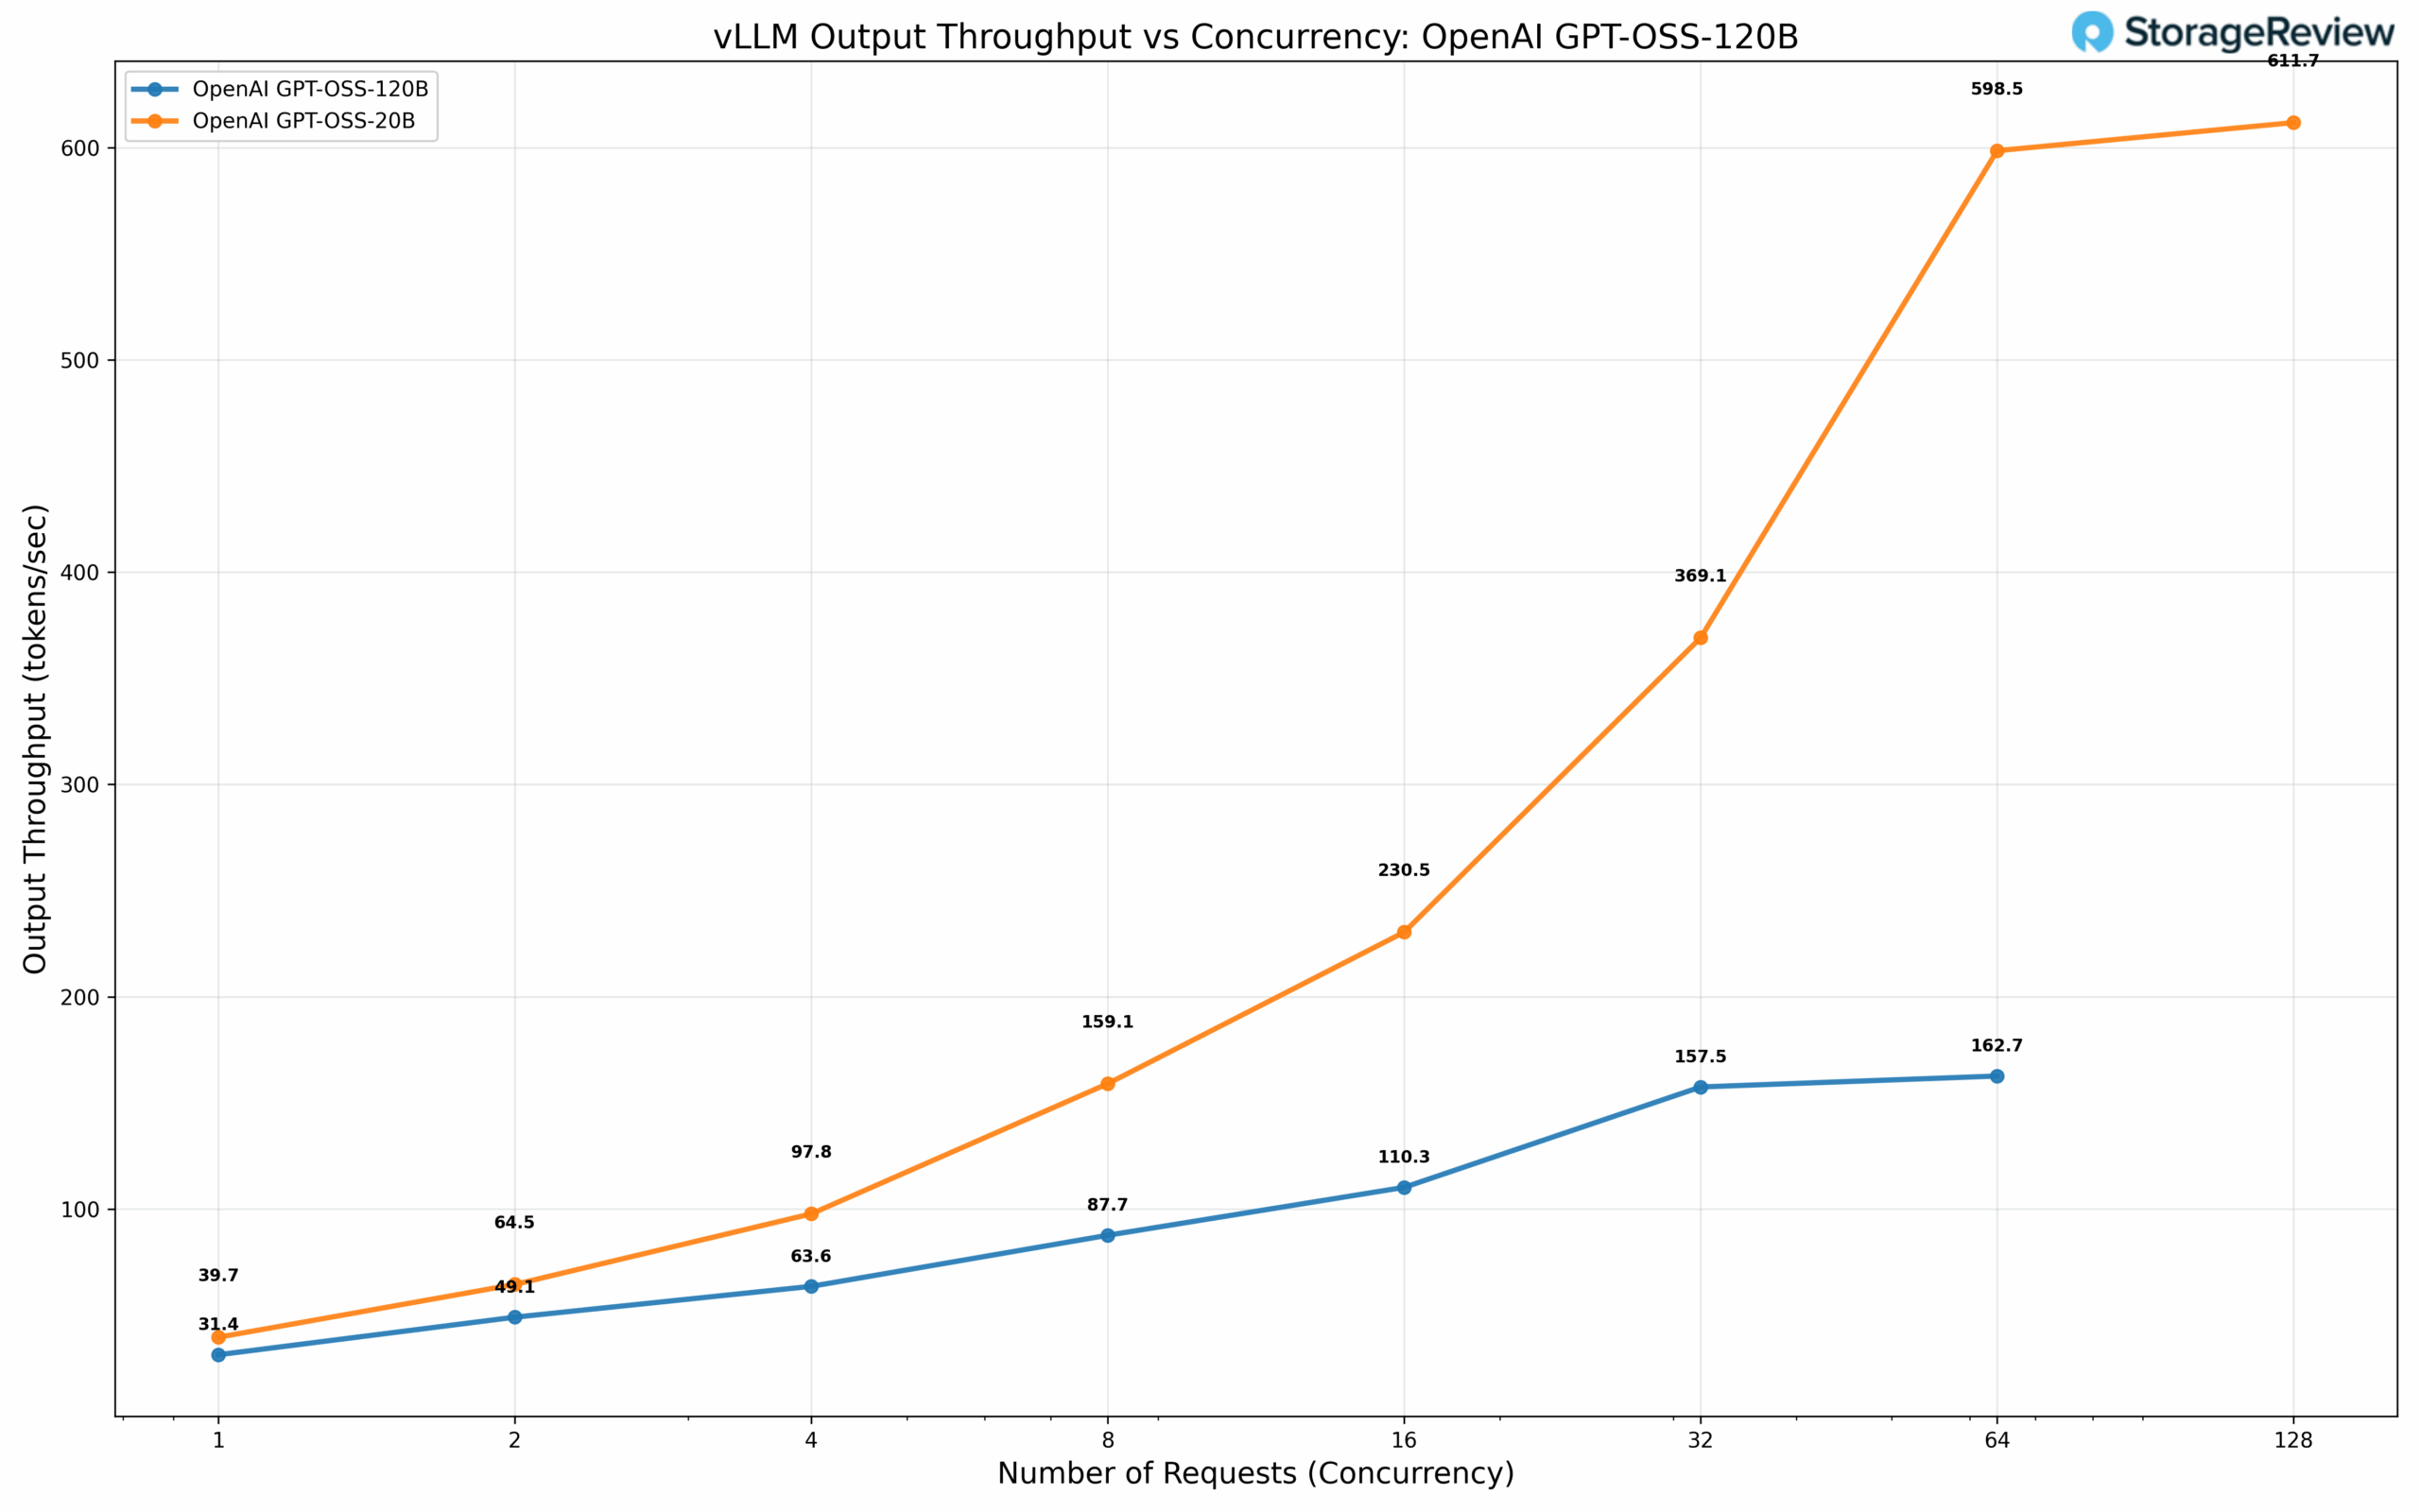
အဓိကအချက်ကတော့ ကျဉ်းမြောင်းပါတယ်။ အသုံးပြုသူတစ်ဦးတည်းအတွက်၊ စကားပြောဆိုမှုတစ်ခုတည်းအတွက်၊ SoC တစ်ခုလျှင် LPDDR4X 136 GB/s အထိ သေးငယ်သော မော်ဒယ်သည် ချည်နှောင်မှုကန့်သတ်ချက်မဟုတ်ပါ (Llama 3.2 1B နှင့် အငြင်းပွားဖွယ်ရာ Llama 3.2 3B)၊ ဤလက်တော့ပ်ရှိ AIC100 ကို အသုံးပြုနိုင်ပါသည်။ ပိုမိုကြီးမားသော မည်သည့်အရာအတွက်မဆို၊ ဖောက်သည်အမှန်တကယ်ရရှိသော ဖွဲ့စည်းပုံတွင်၊ single-stream decode နှင့် Qualcomm ကြိုတင်မဖုတ်ထားသော မည်သည့်ပုံသဏ္ဍာန်ကိုမဆို အပြစ်ပေးသည့် static-shape compile pipeline ပေါင်းစပ်မှုကြောင့် ဤ accelerator သည် ၎င်းဘေးတွင်ရှိသော Intel Core Ultra HX တွင် integrated NPU နှင့် integrated GPU ၏နောက်တွင် ကျန်ရှိနေခဲ့ပြီး၊ တူညီသော chassis ကို မှာယူနိုင်သော discrete NVIDIA SKUs များကို မပြောနှင့်။
ကျွန်တော်တို့ဟာ raw specs တွေကို စက္ကန့်ပိုင်းလောက် နှိုင်းယှဉ်ကြည့်မယ်ဆိုရင် NVIDIA Spark က 273GB/s ပေးစွမ်းနိုင်ပြီး single chip တစ်ခုမှာ FP8 (E4M3) မှာ 200TFLOPS မှာ maximum achievable floating-point flops (MAMF) တွေကို စမ်းသပ်ခဲ့ပါတယ် ။ QAIC က chip နှစ်ခုမှာ 272GB/s နဲ့ INT8 ရဲ့ 435 TFLOPS မှာ ပေးစွမ်းနိုင်တယ်လို့ ကြော်ငြာထားပါတယ်။ ဒါကြောင့် သီအိုရီအရ ဒီ chip တွေက အလားတူစွမ်းဆောင်ရည်ရှိသင့်ပေမယ့် Qualcomm ကတော့ software ကြောင့် နောက်ကျနေပါတယ်။
ဒါက ဘယ်သူတွေအတွက်လဲ၊ ဝယ်သင့်လား
ယနေ့ခေတ်မှာ AI အလုပ်ကို အလေးအနက်ထားလုပ်ဆောင်ဖို့ ကြိုးစားနေသူတိုင်းအတွက် အဖြေက မရှိပါဘူး။ ဒီ configuration ကို မဝယ်ပါနဲ့။
Dell ရဲ့ အမေရိကန်စတိုးမှာ Pro Max 16 Plus ရဲ့ AIC100 SKU တွေကို အမြင့်ဆုံး configuration (Core Ultra 9 285HX, 128GB RAM, 4TB SSD) အတွက် $14,871.56၊ အလယ်အလတ် configuration (Core Ultra 7 265HX, 64GB, 1TB) အတွက် $9,661.56 နဲ့ entry AIC100 SKU အတွက် $8,831.56 နဲ့ ရောင်းချပေးသွားမှာပါ။ အားလုံးက Ubuntu Linux နဲ့ပဲ ဖြန့်ချိမှာဖြစ်ပြီး Windows ကိုလည်း မကြာခင် ထောက်ပံ့ပေးသွားမှာပါ။ စမ်းသပ်ထားတဲ့အတိုင်း ဒီစက်ရဲ့ ဈေးနှုန်းက $14,000 မှ $15,000 အတွင်းမှာပဲ ရှိပါတယ်။
ရည်ညွှန်းချက်အနေနဲ့ NVIDIA ရဲ့ DGX Spark ကို လက်ရှိမှာ ဒေါ်လာ ၄၆၉၉ နဲ့ ရောင်းချနေပါတယ်။ အဲဒီဈေးနဲ့ဆိုရင် GB10 Grace Blackwell Superchip ၊ 128GB unified LPDDR5X memory၊ 4TB NVMe၊ Blackwell GPU နဲ့ FP4 AI compute ရဲ့ 1 petaflop လောက် ရရှိမှာဖြစ်ပြီး အားလုံးကို CUDA software stack၊ TensorRT-LLM၊ NIM နဲ့ NVIDIA ecosystem တစ်ခုလုံးက ကျောထောက်နောက်ခံပေးထားပါတယ်။ DGX Spark တစ်ခုတည်းနဲ့ ဒီ laptop ရဲ့ AI workload တိုင်းလိုလိုမှာ AIC100 ထက် ပိုကောင်းပြီး ဒီနှစ်မှာ ငှားရမ်းထားတဲ့ AI engineer တိုင်းက ဘယ်လိုသုံးရမလဲဆိုတာ သိပြီးသား software နဲ့ဆိုရင် ပိုကောင်းပါတယ်။ ကျွန်တော်တို့ရဲ့ review unit ရဲ့ ဈေးနှုန်းနဲ့ဆိုရင် DGX Sparks သုံးခုဝယ်ပြီး တစ်ခုချင်းစီမှာ monitor၊ peripherals နဲ့ desk တစ်လုံးစီ တပ်ဆင်ပေးရုံနဲ့ ပိုက်ဆံပိုကျန်ပါသေးတယ်။ သေးငယ်တဲ့ AI ကို မကြိုက်ဘူးဆိုရင် Intel 285K၊ 128GB DDR5 RAM နဲ့ NVIDIA RTX Pro 6000 GPU ပါဝင်တဲ့ Dell Pro Max Tower T2 workstation ကလည်း SSD အရွယ်အစားပေါ်မူတည်ပြီး ဒေါ်လာ ၁၅၀၀၀ ဝန်းကျင်နဲ့ ရောင်းချနေပါတယ်။
Dell က e-waste တွေလို အရာတွေကို အလွန်ကောင်းမွန်တဲ့ ကိုယ်ထည်ထဲမှာ ထည့်သွင်းထားတယ်ဆိုတဲ့ ခံစားချက်ကနေ လွတ်မြောက်ဖို့ ခက်ပါတယ်။ RTX PRO 5000 ပါတဲ့ Pro Max 16 Plus က အလွန်ကောင်းမွန်တဲ့ မိုဘိုင်း workstation တစ်ခုပါ။ AIC100 ပါတဲ့ အဲဒီစက်က Dell ရဲ့ အာမခံအောက်မှာ ရှုပ်ထွေးတဲ့ သိပ္ပံစမ်းသပ်မှုတစ်ခုပါပဲ။
ကောက်ချက်
ဒီလက်တော့ပ်တွေထဲက တစ်လုံးကို နှစ်အနည်းငယ်ကြာမှ ဖတ်ဖူးပြီး ဒေါ်လာ နှစ်ရာ သုံးရာလောက်နဲ့ ဈေးသက်သာတဲ့ စင်ပေါ်မှာ တွေ့ခဲ့ရင် ဝယ်လိုက်ပါ။ စနစ်က ပြုပြင်လို့ရပြီး အဆင့်မြှင့်တင်လို့ရတယ်၊ ကီးဘုတ်ကလည်း ကောင်းပြီး AIC100 မော်ဂျူးတွေကို စနေ၊တနင်္ဂနွေ ပရောဂျက်တစ်ခုအနေနဲ့ စိတ်ဝင်စားစရာကောင်းတဲ့ တစ်ခုခုကို လုပ်ဆောင်ခိုင်းတာက ဒီဟာ့ဒ်ဝဲအတွက် ထိုက်တန်တဲ့ ပျော်စရာမျိုးပါပဲ။
ဒီနေ့ AI အလုပ်ကို အလေးအနက်ထား လုပ်ဆောင်ဖို့ ကြိုးစားနေသူတစ်ယောက်ဆိုရင် သင့်ရဲ့ Pro Max 16 Plus ကို တခြား accelerator တစ်ခုခုနဲ့ configure လုပ်ပါ။ NVIDIA RTX PRO mobile GPU၊ entry-level RTX PRO 1000 တောင်မှ AIC100 modules တွေထက် ပိုကောင်းအောင် လုပ်ဆောင်ပေးပါလိမ့်မယ်။ Intel Core Ultra HX ရဲ့ integrated NPU က Windows ML၊ OpenVINO နဲ့ လက်ရှိ PC AI stack တွေနဲ့ ချိတ်ဆက်အသုံးပြုနိုင်တာကြောင့် လက်တွေ့ကျတဲ့ အခြေအနေတော်တော်များများမှာ ပိုကောင်းအောင် လုပ်ဆောင်ပေးပါလိမ့်မယ်။
Dell ကို ပေးသင့်တဲ့ အကြံပြုချက်တစ်ခုကတော့ Pro Max 16 Plus ဟာ အလွန်ကောင်းမွန်တဲ့ ကိုယ်ထည်တစ်ခုဖြစ်ပြီး Pro Max လိုင်းဟာ ဈေးကွက်ထဲမှာ အခိုင်မာဆုံး မိုဘိုင်း workstation platform တွေထဲက တစ်ခုဖြစ်ပါတယ်။ AIC100 SKU ဟာ တင်ပို့ရောင်းချတဲ့ စံနှုန်းနဲ့ လုံးဝကိုက်ညီမှု မရှိပါဘူး။ ဒီလို ရှင်းရှင်းလင်းလင်း တံဆိပ်ကပ်ထားတဲ့ experimental ဒါမှမဟုတ် developer-preview product လိုင်းဟာ Dell အနေနဲ့ အဆင်သင့်မဖြစ်သေးတဲ့ stack နောက်ကွယ်မှာ Pro Max နာမည်ကို မထည့်ဘဲ စမ်းသုံးကြည့်ချင်တဲ့ ဖောက်သည်တွေဆီ ထူးခြားတဲ့ accelerator တွေကို တင်ပို့ရောင်းချနိုင်အောင် ကူညီပေးပါလိမ့်မယ်။ Pro Max brand ဟာ ကာကွယ်ထိုက်ပြီး experimental hardware တွေအတွက် နေရာတစ်ခု ရှာဖွေနေချိန်မှာပဲ အဲဒီလို လုပ်ဆောင်နိုင်တဲ့ သန့်ရှင်းတဲ့ နည်းလမ်းတစ်ခု ရှိပါတယ်။


 အမေဇုံ