

NVIDIA ရဲ့ GB10 မှာတည်ဆောက်ထားတဲ့ Deskside AI စနစ်တွေမှာ အလုပ်တစ်ခုပဲရှိပြီး ကောင်းကောင်းလုပ်နိုင်ပါတယ်။ unified memory 128GB နဲ့ compute petaflop ကို အသုံးပြုသူနဲ့ နီးတဲ့စားပွဲပေါ်မှာ ထားရင် iteration ချက်ချင်းပြီးပါတယ်။ သူတို့မှာ အဖွဲ့အစည်းတစ်ခုက လည်ပတ်နေတဲ့ storage နဲ့ ချိတ်ဆက်မှုမရှိပါဘူး။ DGX Spark နဲ့ OEM ဗားရှင်းတိုင်းမှာ M.2 slot တိုလေးတစ်ခုပါရှိပြီး local capacity ကို 4TB ဝန်းကျင်မှာ ကန့်သတ်ထားပြီး အဲဒီစက်ပေါ်က dataset၊ model နဲ့ checkpoint တိုင်းကို data center မှာရှိနေတဲ့ government, access controls, backup နဲ့ audit trail တွေရဲ့ အပြင်ဘက်မှာထားပေးပါတယ်။ အဲဒါကို ဓာတ်ခွဲခန်း၊ ဌာန ဒါမှမဟုတ် campus နဲ့ မြှောက်လိုက်ရင် ရလဒ်အနေနဲ့ သီးခြား 4TB islands တွေ အများကြီးရှိပြီး တစ်ခုချင်းစီမှာ တူညီတဲ့ model နဲ့ dataset တွေရဲ့ ကိုယ်ပိုင်မိတ္တူကို ကိုင်ဆောင်ထားပြီး တစ်ခုချင်းစီဟာ သူထိုင်နေတဲ့ desk လောက်သာ လုံခြုံပါတယ်။
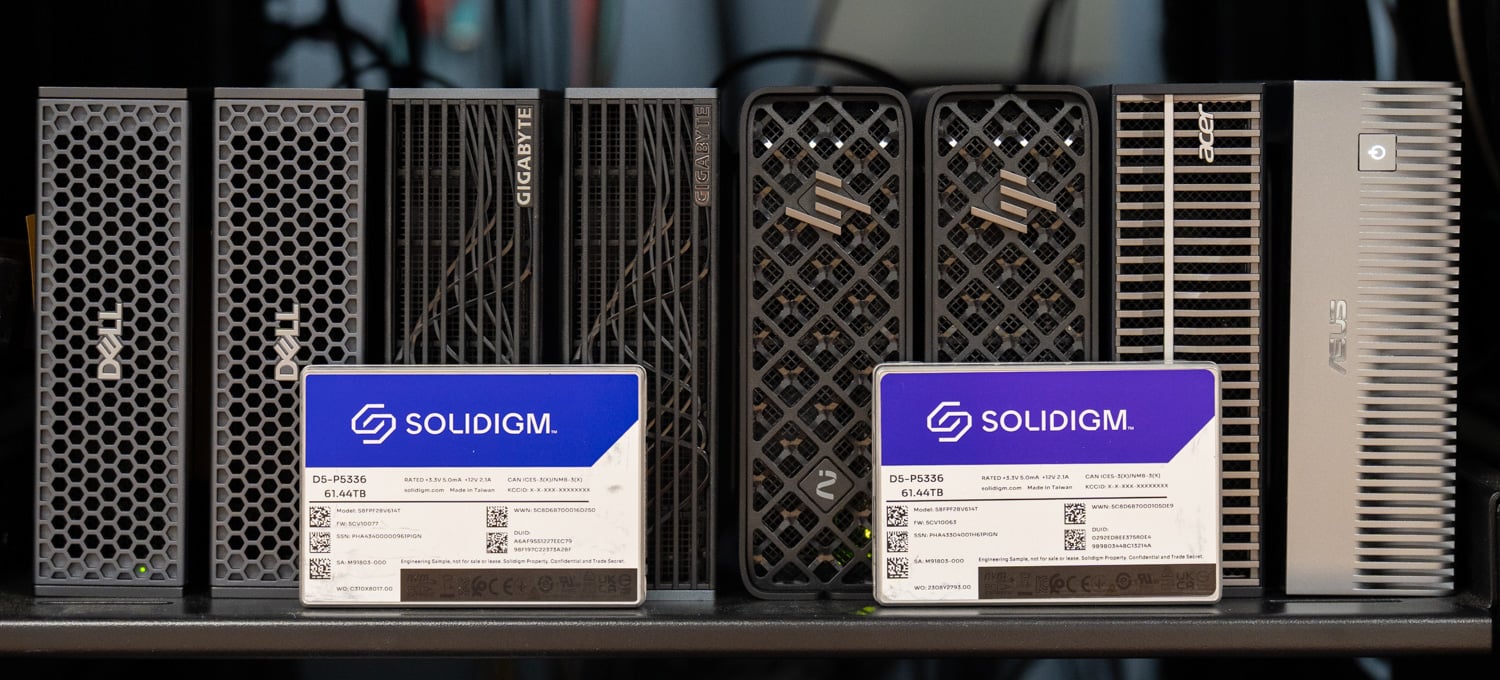
ဒီပရောဂျက်က storage ပြဿနာကို data center ကို ပြန်ယူဆောင်သွားပါတယ်။ Dell PowerEdge R770AP၊ Graid SupremeRAID RAID 5 မှာ Solidigm D5-P5336 QLC SSD ရှစ်ခု၊ Broadcom 400GbE networking နဲ့ Tuxera Fusion တွေကနေ DGX Spark shared storage host တစ်ခုကို တည်ဆောက်ခဲ့ပြီး RDMA မှာ NFS ကို serve လုပ်ကာ Spark ရှစ်ခုကို 100GbE ports တွေမှာ ချိတ်ဆက်ထားပါတယ်။ fabric ပေါ်က Spark တိုင်းဟာ တူညီတဲ့ governed, parity-protected storage pool ကို line တစ်ခုနဲ့ mount လုပ်ပါတယ်။ model နဲ့ dataset တစ်ခုစီရဲ့ copy တစ်ခုစီက အားလုံးကို serve လုပ်ပါတယ်။ ဘယ် workstation မှ storage ပိုများများ မလိုအပ်ပါဘူး။ Spark တွေကိုယ်တိုင်က array ဘေးက rack မှာ secure လုပ်ရတာ၊ cool လုပ်ရတာနဲ့ share လုပ်ရတာ ပိုလွယ်ကူပါတယ်။ ဒီ build ရဲ့ အဓိကအချက်ကတော့ data တွေ ဘယ်မှာရှိနေလဲဆိုတာပါပဲ။ မြန်ဆန်တဲ့ NIC တွေပါတဲ့ NVMe server တိုင်းက ဒီအခန်းကဏ္ဍကနေ ပါဝင်နိုင်ပါတယ်။ AI သင်ယူမှုအတွက် ကြီးမားသော Spark ဓာတ်ခွဲခန်းတစ်ခုကို လေ့လာနေပြီး ကျောင်းသားများအား terabytes ဆယ်ဂဏန်းဖြင့် တိုင်းတာထားသော သုတေသနဒေတာစုများကို ဝင်ရောက်ကြည့်ရှုခွင့်ပေးလိုသော Oregon State University သည် ကျွန်ုပ်တို့ တည်ဆောက်မှုကို ဒီဇိုင်းဆွဲစဉ်တွင် ၎င်း၏အတွေးအခေါ်ကို ကျွန်ုပ်တို့နှင့် မျှဝေခဲ့ပြီး ထိုအတိုင်းအတာရှိသော ဒေတာအတွက် shared storage သည် ဤအကဲဖြတ်ချက်နှင့် ကိုက်ညီသော ချဉ်းကပ်မှုဖြစ်သည်။
Key ကို Takeaways
- array တစ်ခု၊ Sparks ရှစ်ခု၊ client software မပါဝင်ပါ- OEM ငါးခုမှ DGX Sparks ရှစ်ခုသည် Graid SupremeRAID နှင့် Tuxera Fusion နောက်ကွယ်ရှိ Solidigm D5-P5336 QLC array တစ်ခုတည်းမှ NFS/RDMA shares များကို mount လုပ်ကာ ၎င်းတို့တွင်ရှိပြီးသား 100GbE ports များမှတစ်ဆင့် stock Ubuntu တွင် one-line mount ဖြင့် mount လုပ်သည်။
- Hosted model များသည် local model များကဲ့သို့ load လုပ်သည်- 78GB Qwen3.5-122B-A10B-NVFP4 မော်ဒယ်ကို shared array မှ Spark တစ်ခုတည်းတွင် ၂၆၉.၆ စက္ကန့်အတွင်း load လုပ်ခဲ့ပြီး၊ တူညီသော Spark သည် ၎င်း၏ internal NVMe မှ လိုအပ်သော ၂၃၉.၆ စက္ကန့်၏ ၁၃% အတွင်းတွင် load လုပ်ခဲ့ပြီး၊ Spark ရှစ်ခုသည် တူညီသောမိတ္တူတစ်ခုတည်းကို တစ်ပြိုင်နက် load လုပ်ခြင်းသည် ၂၃၂.၈ မှ ၃၂၆.၅ စက္ကန့်အကြားတွင် ပြီးဆုံးခဲ့သည်။
- မိတ္တူတစ်စောင်သည် စားပွဲတိုင်းရှိ silo တစ်ခုကို အစားထိုးသည်- အုပ်ချုပ်ထားသော၊ parity-protected data center storage ရှိ မော်ဒယ်များနှင့် dataset များသည် 4TB M.2 drives များရှိ per-workstation copy များကို အစားထိုးသောကြောင့် အသုံးပြုမှု မြင့်တက်လာပြီး copy data ကျဆင်းသွားကာ Spark သည် storage အဆင့်မြှင့်တင်မှု သို့မဟုတ် စားပွဲပေါ်တွင် နေရာတစ်ခု မလိုအပ်ပါ။ Oregon State မှ စူးစမ်းလေ့လာနေသော ကြီးမားသော AI learning lab တစ်ခုအတွက်၊ သုတေသန dataset များသည် terabytes ဆယ်ဂဏန်းအထိ လည်ပတ်နေသောကြောင့်၊ ဤသည်မှာ ကျွန်ုပ်တို့၏ အကဲဖြတ်ချက်တွင် အသုံးပြုမှုကိစ္စနှင့် ကိုက်ညီသော ချဉ်းကပ်မှုဖြစ်သည်။
- drive တွေက အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပြီး network မှာ headroom ရှိပါတယ်- Sparks ရှစ်ခုစလုံးကို တစ်ပြိုင်နက်ဖတ်ရှုခြင်းဖြင့်၊ ရှစ်ခုပါ RAID 5 array သည် 25GiB/s နီးပါး၊ 214Gb/s ခန့်ရှိပြီး၊ host ရှိ Broadcom BCM57608 NIC နှစ်ခုသယ်ဆောင်နိုင်သော 800Gb/s ၏ 27% ကိုအသုံးပြုခဲ့သည်။ array မှ Spark ဖတ်ရှုမှုတစ်ခုသည် 10.8GiB/s ဖြင့် GB10 စနစ်တွင် ကျွန်ုပ်တို့တိုင်းတာခဲ့သော အမြန်ဆုံး internal M.2 နှင့် ကိုက်ညီပါသည်။
- အုပ်ချုပ်မှုသည် လုပ်ထုံးလုပ်နည်းနှင့်အတူ ပါလာသည်- RDMA ပါသည့် NFS သည် အသုံးပြုသူတစ်ဦးချင်းစီအတွက် ဖိုင်တွဲများ၊ မျှဝေထားသော dataset များနှင့် hosted မော်ဒယ်များကို Active Directory၊ Kerberos နှင့် LDAP hooks များဖြင့် namespace တစ်ခုတည်းတွင် ထားရှိပြီး Sparks များသည် rack ထဲသို့ ရွှေ့နေစဉ်တွင် ဒေတာကို data center ထိန်းချုပ်မှုအောက်တွင် ရှိနေစေပါသည်။
စားပွဲတိုင်းမှာ AI ကျွန်းတစ်ခုရှိနေခြင်းရဲ့ ပြဿနာ
DGX Spark နှင့် Dell၊ GIGABYTE၊ HP၊ Acer နှင့် ASUS မှ ၎င်း၏ OEM ဗားရှင်းများအားလုံးသည် GB10 platform နှင့် တူညီသော storage ceiling ကို မျှဝေအသုံးပြုကြသည်။ ကျွန်ုပ်တို့၏ မူရင်း DGX Spark သုံးသပ်ချက် တွင် storage သည် platform ၏ အရှင်းလင်းဆုံး ကန့်သတ်ချက်ဖြစ်သည်။ internal slot သည် M.2 drives တိုတိုများကို လက်ခံသောကြောင့် 2280 form factor ဖြင့် တင်ပို့သော 8TB client SSD များသည် ရုပ်ပိုင်းဆိုင်ရာ အံဝင်ခွင်ကျ မဖြစ်ပါ။ သြဂုတ်လတွင် ကျွန်ုပ်တို့ သုံးသပ်ခဲ့သော Luisuantech GP Spark သည် 100GbE port တစ်ခုမှ ချိတ်ဆွဲထားသော လေး-bay M.2 enclosure ဖြင့် တုံ့ပြန်ထားပြီး ၎င်းသည် စားပွဲတစ်ခုတွင် Spark တစ်ခုနှင့် ဓာတ်ခွဲခန်းအတိုင်းအတာအရ စားပွဲတိုင်းတွင် silo ပိုကြီးသော နေရာတွင် ထားရှိရန် သင့်လျော်ပါသည်။
စွမ်းရည်က ပြဿနာရဲ့ တစ်ဝက်ဖြစ်ပြီး ကျန်တစ်ဝက်ကတော့ စားပွဲဘေးက စက်ပေါ်ကို ဒေတာရောက်သွားတာနဲ့ ဖြစ်ပျက်တဲ့အရာပါ။ Spark ကို ဆွဲချထားတဲ့ 78GB မော်ဒယ်က IT မှာ ဘယ်သူမှ မမြင်နိုင်တဲ့ မိတ္တူတစ်ခုပါ။ ဒေသတွင်း flash မှာ အဆင့်လိုက် တည်ဆောက်ထားတဲ့ သုတေသန dataset က backup schedule ပြင်ပ၊ access policy နဲ့ institutional audits ပြင်ပက မိတ္တူတစ်ခုပါ။ ဓာတ်ခွဲခန်းတစ်ခုမှာ Spark ဆယ်ခုရှိတယ်ဆိုတာ flash 780GB ကို အသုံးပြုတဲ့ အလေးချိန်တူ မိတ္တူဆယ်ခုကို ဆိုလိုပြီး တခြားတစ်ခုခုအတွက် အသုံးပြုနိုင်ပြီး dataset တစ်ခုဟာ စက်နဲ့အတူ နေရာဆယ်ခုကို ထွက်သွားနိုင်ပါတယ်။ GB10 စနစ်တွေ ဒါမှမဟုတ် desktop AI infrastructure တစ်ခုခုပဲဖြစ်ဖြစ် ပြဿနာက အရေအတွက်တွေ တိုးလာတာနဲ့အမျှ ပိုဆိုးလာပါတယ်။ လက်တော့ပ်အများအပြားကို စီမံခန့်ခွဲခဲ့တဲ့ အဖွဲ့အစည်းတိုင်းက ဒီပုံစံကို သိကြပြီး အဖြေကတော့ အတူတူပါပဲ။ data ကို data center မှာ shared storage မှာ သိမ်းဆည်းထားပြီး endpoint ကို endpoint အဖြစ် ထားရှိပါ။
ကံကောင်းထောက်မစွာပဲ NVIDIA က Spark ကို အလုပ်လုပ်အောင် port တွေ ပါအောင် ဒီဇိုင်းထုတ်ထားပါတယ်။ unit တိုင်းမှာ integrated ConnectX-7 ပေါ်မှာ QSFP56 cages နှစ်ခု ပါရှိပြီး PCIe Gen5 x4 links တစ်စုံနောက်မှာ 200Gb platform ceiling ရှိတဲ့ အသုံးပြုနိုင်တဲ့ bandwidth ရှိပါတယ်။ ကျွန်တော်တို့ရဲ့ DGX Spark cluster review မှာ cage တစ်ခုဟာ peer Spark ကိုသွားပြီး နောက်တစ်ခုကို storage ကိုသွားတဲ့ split-role configuration ကို ဖော်ပြခဲ့ပါတယ်။ ဒီ project က Spark တစ်ခုစီကို 100GbE မှာ storage အတွက် cage တစ်ခုကို အသုံးပြုပြီး ဒုတိယတစ်ခုကို clustering ဒါမှမဟုတ် bandwidth အပိုအတွက် အလွတ်ထားခဲ့ပါတယ်။ 100GbE မှာ Spark တစ်ခုစီမှာ storage host ကို theoretical bandwidth 12.5GB/s လောက် ရှိပြီး ဒီ system အများစုမှာ internal M.2 slot က ပေးထားတဲ့ bandwidth ထက် ကျော်လွန်ပါတယ်။
ဒေတာသည် ထိုလင့်ခ်၏ အခြားတစ်ဖက်တွင် ရှိနေသည်နှင့် Spark ၏ အခန်းကဏ္ဍ ပြောင်းလဲသွားပါသည်။ ၎င်းသည် boot drive နှင့် local cache drive ပါရှိသော compute endpoint တစ်ခု ဖြစ်လာပြီး စွမ်းရည်သည် workstation တစ်ခုစီအတွက် ဝယ်ယူရမည့်အရာ မဟုတ်တော့ပါ။ မော်ဒယ် သို့မဟုတ် dataset တစ်ခုကို တစ်ကြိမ်ရေးသားပြီး client တိုင်းမှ ဖတ်ရှုသောကြောင့် သိုလှောင်မှုအသုံးပြုမှု တိုးလာပြီး မိတ္တူအရေအတွက် လျော့ကျသွားသည်။ ဒေတာကာကွယ်မှုသည် server chassis ရှိ parity-protected array သို့ ရွေ့လျားသွားပြီး access control၊ encryption at rest၊ backup နှင့် auditing အားလုံးသည် အခြားအရာအားလုံးအတွက် လုပ်ဆောင်နေပြီးသားနေရာတွင် ဖြစ်ပေါ်သည်။ ထို့အပြင် Spark သည် ယခုအခါ ပါဝါနှင့် 100GbE link မှလွဲ၍ ဘာမှမလိုအပ်သောကြောင့် စားပွဲပေါ်တွင် တင်ထားရန် မလိုအပ်ပါ။ storage host ဘေးတွင် တပ်ဆင်ထားသောကြောင့် ၎င်းသည် ပိုမိုအေးမြပြီး ပိုမိုတိတ်ဆိတ်ကာ ရုပ်ပိုင်းဆိုင်ရာ လုံခြုံပြီး နောက်တစ်ကြိမ် လိုအပ်သူတိုင်းအတွက် ရရှိနိုင်ပါသည်။
သိုလှောင်မှု Host
storage host က Dell PowerEdge R770AP ပါ ၊ ဒီနှစ်အစောပိုင်းက ကျွန်တော်တို့ review လုပ်ခဲ့တဲ့ 2U Xeon 6 platform ပါပဲ၊ project စတင်တုန်းက lab မှာ အခမဲ့ဖြစ်လို့ ကျွန်တော်တို့ သုံးခဲ့တာပါ။ မြန်ဆန်တဲ့ NIC တွေနဲ့ GPU သေးသေးလေးအတွက် နေရာရှိတဲ့ မည်သည့် NVMe server မဆို ဒီအခန်းကဏ္ဍကို ဖြည့်ဆည်းနိုင်ပါတယ်၊ R770AP က နည်းနည်း overbuilt ဖြစ်နေရင်တောင် တည်ဆောက်ဖို့ နည်းလမ်းတစ်ခုပါ။ ကျွန်တော်တို့ server က 24 DIMM တွေမှာ 1.5TB DDR5 ပါတဲ့ Xeon 6 6978P processors နှစ်ခုကို run ပြီး Gen5 NVMe bay ရှစ်ခုပါတဲ့ bank နှစ်ခုထဲက တစ်ခုကို အသုံးပြုပြီး CPU 1 မှာ 400GbE adapter နှစ်ခုနဲ့ drive တွေနဲ့ Graid GPU ကို CPU 0 ကနေ hang လုပ်ထားပါတယ်။ server က Ubuntu 24.04 ကို run ပါတယ်။
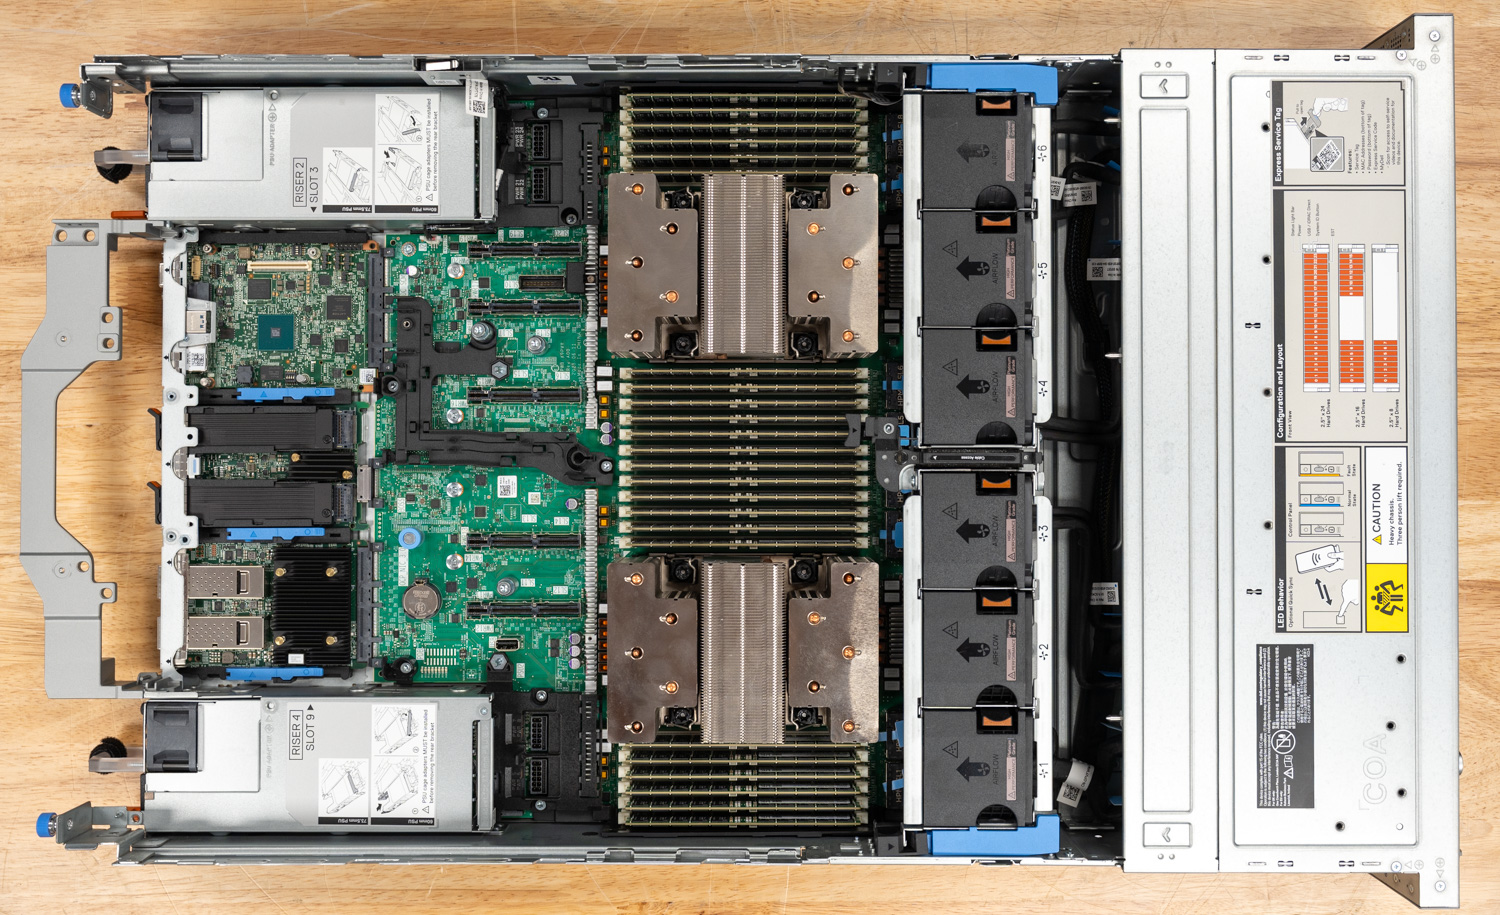
| component | သိုလှောင်မှု Host ပုံစံပြင်ဆင်မှု |
|---|---|
| ဆာဗာ | Dell PowerEdge R770AP, 2U, 16x 2.5-လက်မ Gen5 NVMe bays |
| စီပီယူ | Intel Xeon 6 6978P ၂ ခု |
| မှတ်ဉာဏ် | 1.5TB DDR5 (24x 64GB) |
| သိုလှောင်ခြင်း | 8x Solidigm D5-P5336 61.44TB U.2 PCIe 4.0 QLC (491.52TB အကြမ်း) |
| RAID | Graid SupremeRAID၊ drive ရှစ်ခုလုံးတွင် RAID 5၊ CPU တွင် NVIDIA RTX A2000 GPU 0 |
| ဖိုင်ထားသိုစနစ် | SupremeRAID virtual drive ပေါ်ရှိ XFS |
| ဖိုင်ဆာဗာ | Tuxera Fusion (Fusion NFS၊ သီးသန့် preview build)၊ RDMA မှတစ်ဆင့် NFS 4.1 (port 20049 တွင် RPC-RDMA)၊ အသုံးပြုသူမုဒ် |
| Network | ၂x Broadcom BCM57608 (Thor 2) single-port 400GbE၊ CPU ၁ တွင် PCIe Gen5 x16၊ RoCEv2 |
| ပွောငျးလဲ | Dell PowerSwitch Z9864F-ON၊ 64x 800GbE OSFP112၊ Enterprise SONiC |
| ကလိုင်းယင့်လင့်ခ်များ | 800G optic ကို 8x100GbE အထိ ပိုင်းခြားထားပြီး၊ Spark တစ်ခုလျှင် link တစ်ခု၊ storage NIC တစ်ခုလျှင် Spark လေးခု သီးခြား VLAN များတွင် ထားရှိသည် |
| clients | GB10 ပါဝင်သော Dell Pro Max ၂ ခု၊ GIGABYTE AI TOP ATOM ၂ ခု၊ HP ZGX Nano G1n ၂ ခု၊ Acer Veriton GN100၊ ASUS Ascent GX10 |
| OS | Ubuntu ကို 24.04 LTS |
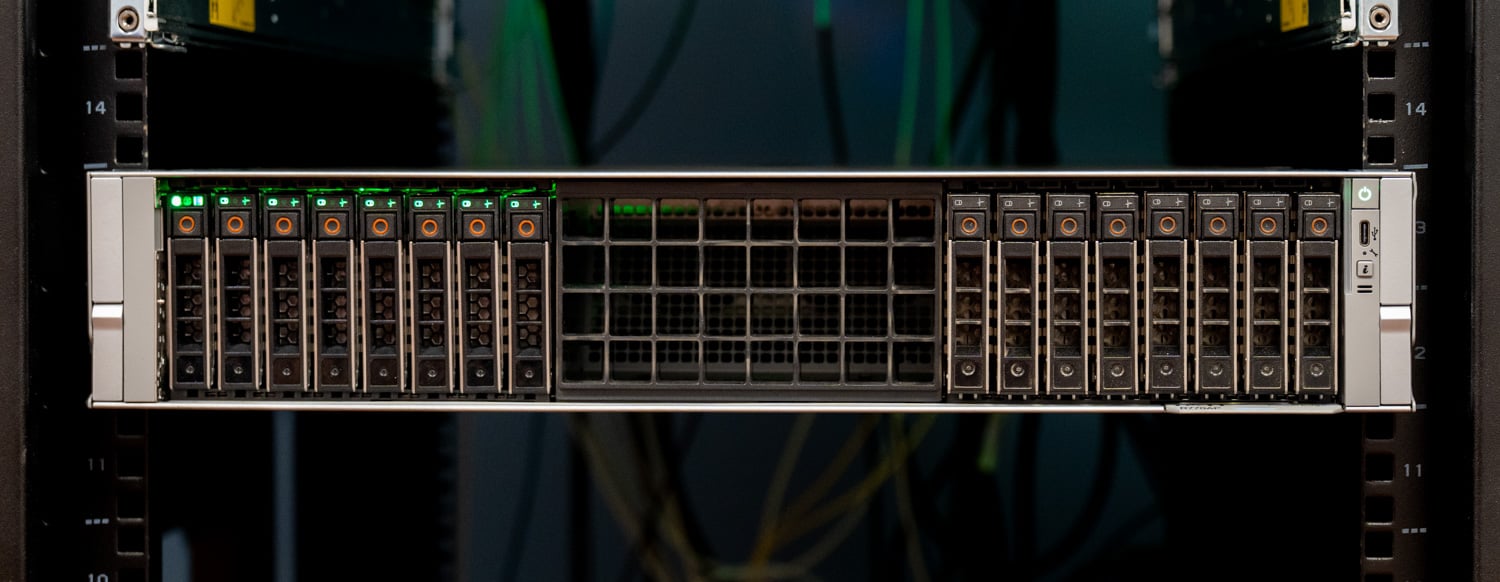
QLC ကို ဘာကြောင့်သုံးသင့်တာလဲ၊ D5-P5336 ကို ဘာကြောင့်သုံးသင့်တာလဲ
Spark ဓာတ်ခွဲခန်း အယူအဆနှင့် ပတ်သက်၍ Oregon State နှင့် ကျွန်ုပ်တို့၏ ဆွေးနွေးမှုများတွင်၊ ပါဝင်သည့် သုတေသနဒေတာစုများသည် ကြီးမားသောကြောင့် စွမ်းရည်သည် ပထမဆုံးလိုအပ်ချက်ဖြစ်သည်။ ဤဆာဗာ၏ အလုပ်မှာ Sparks ပြည့်နေသော အခန်းတစ်ခန်းတွင် လိုချင်နိုင်သည့် အရာအားလုံးကို သိမ်းဆည်းရန်နှင့် client များစွာ တစ်ပြိုင်နက် ဖတ်ရှုနိုင်သည့် ပုံစံဖြင့် ဝန်ဆောင်မှုပေးရန်ဖြစ်သည်။ ၎င်းသည် ဖတ်ရှုမှုများပြားသော၊ ကြီးမားသော block၊ စွမ်းရည်မြင့်မားသော ပရိုဖိုင်တစ်ခုဖြစ်ပြီး QLC တည်ဆောက်ထားသည့် ပရိုဖိုင်လည်း ဖြစ်သည်။ D5-P5336 မိသားစုသည် 7.68TB မှ 122.88TB အထိ လည်ပတ်သည်။ ဤနေရာတွင် အသုံးပြုထားသော 61.44TB U.2 drives များကို Solidigm မှ 7,000MB/s sequential read၊ 3,000MB/s sequential write၊ 1.005M random 4K read IOPS နှင့် 65.2PBW ခံနိုင်ရည် သို့မဟုတ် ငါးနှစ်တာကာလအတွင်း တစ်နေ့လျှင် 0.58 drive writes 16KB indirection unit ပါရှိသော 192-layer QLC NAND ပေါ်တွင် အဆင့်သတ်မှတ်ထားသည်။
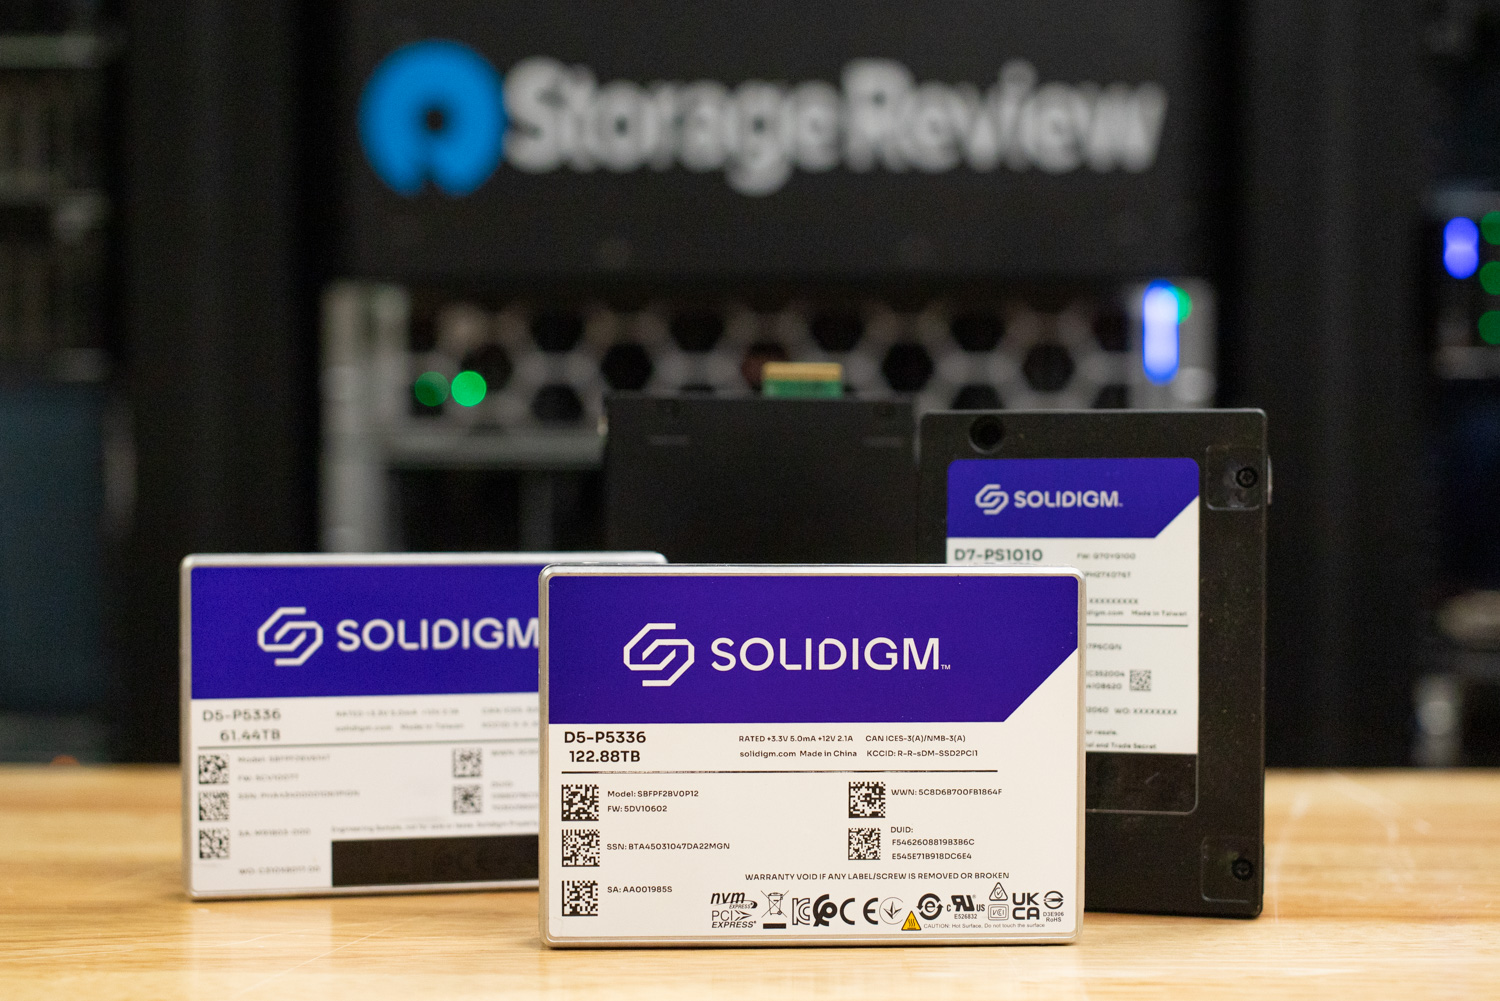
61.44TB drive ရှစ်ခုသည် R770AP ၏ ရှေ့ bay များ၏ ထက်ဝက်ကို ဖြည့်ပေးပြီး production build တစ်ခုသည် မိသားစုတွင် မည်သည့် capacity point နှင့် မည်သည့် bay အရေအတွက်ကိုမဆို ရွေးချယ်နိုင်သည်။ သို့သော် RAID 5 ရှိ drive ရှစ်ခုသည် single-drive fault tolerance ဖြင့် အသုံးပြုနိုင်သော space 430TB ခန့်ကို ပေးစွမ်းသည်။ ၎င်းသည် Spark ၏ M.2 slot တွင် သိမ်းဆည်းထားသည်ထက် အဆ ၁၀၀ ကျော်ပိုများပြီး ဌာနတစ်ခု၏ model library၊ ကျောင်းသားများအလုပ်လုပ်သော shared datasets နှင့် per-user home directory များအတွက် လုံလောက်သည်။ ကျန် bay ရှစ်ခုကို ဖြည့်ခြင်းသည် network design ကို မထိခိုက်စေဘဲ ၎င်းကို နှစ်ဆတိုးစေပြီး ဤသုံးသပ်ချက်၏ နောက်ပိုင်းတွင်ရှိသော sizing number များက drive များသည် အဘယ်ကြောင့် ကြီးထွားလာရမည့် အစိတ်အပိုင်းဖြစ်ကြောင်း ပြသသည်။
16KB indirection unit သည် ဤ workload အတွက် အရေးကြီးပါသည်၊ အဘယ်ကြောင့်ဆိုသော် Solidigm ၏ ပိုကြီးသော IU သည် သေးငယ်သော random-write efficiency ကို density နှင့် cost အတွက် လဲလှယ်ပေးသောကြောင့်ဖြစ်ပြီး၊ မော်ဒယ်များနှင့် dataset များကို ဝန်ဆောင်မှုပေးသော share တစ်ခုအတွက် သေးငယ်သော random write များသည် အနည်းစုကိစ္စဖြစ်သည်။ Model loading သည် ကြီးမားသော sequential read များဖြစ်သည်။ Dataset streaming သည် ကြီးမားသော sequential read များဖြစ်သည်။ Checkpoint များနှင့် student file များကို တစ်ကြိမ်ရေးသားပြီး မကြာခဏဖတ်ရှုသည်။ ဤအရာမှ ပေါ်ပေါက်လာသော အလုပ်ခွဲဝေမှုသည် Spark lab အတွက် မှန်ကန်သောအလုပ်ဖြစ်သည်- shared QLC array သည် လူအများဖတ်ရှုသော အရာအားလုံးကို သိမ်းဆည်းထားပြီး Spark ၏ကိုယ်ပိုင် M.2 သည် တစ်ဦးရေးသားသော scratch နှင့် swap traffic ကို ကိုင်တွယ်သည်။
GPU ပေါ်တွင် RAID- Graid SupremeRAID
Gen4 drive ရှစ်ခုတွင် NVMe RAID သည် 7,000MB/s ဖြင့် ဖတ်ရှုနိုင်ပြီး၊ ၎င်းသည် သမားရိုးကျ hardware RAID ကတ်တစ်ခုသည် byte တိုင်းသည် ကတ်၏ PCIe slot ကို ဖြတ်သန်းရမည်ဖြစ်သောကြောင့် bottleneck ဖြစ်လာသည့်အချက်ဖြစ်သည်။ Software RAID သည် resource စိန်ခေါ်မှုအမျိုးမျိုးနှင့် ရင်ဆိုင်နေရသည်။ Graid SupremeRAID သည် parity တွက်ချက်မှုများကို GPU သို့ offload လုပ်ကာ host ၏ PCIe lanes များတွင် data path ကို သိမ်းဆည်းထားသည်၊ ထို့ကြောင့် drive ၁၆ ခုဖြင့် ကျွန်ုပ်တို့၏ SupremeRAID AE စမ်းသပ်မှု တွင် 180GB/s ထက်ပို၍ တိုးချဲ့လာသည်ကို ကျွန်ုပ်တို့တွေ့မြင်ခဲ့ရသည် ။ ဤ host အတွက်၊ ကျွန်ုပ်တို့သည် NVIDIA RTX A2000၊ workstation GPU ငယ်တစ်ခုတွင် SupremeRAID ကို run ခဲ့သည်။
D5-P5336 drive ရှစ်ခုကို Graid ထံ လွှဲပြောင်းပေးခြင်းမပြုမီ secure-erase လုပ်ပြီး အစဉ်လိုက် ဖြည့်သွင်းပြီးနောက် single RAID 5 array အဖြစ် configure လုပ်ခဲ့သည်။ ရလဒ် virtual drive ကို XFS ဖြင့် format ချပြီး Tuxera မှ ဝန်ဆောင်မှုပေးခဲ့သည်။ RAID 5 သည် ဤကဲ့သို့သော share အတွက် မှန်ကန်သော level ဖြစ်သည်- drive ချို့ယွင်းချက်သည် array ကို online ဖြစ်အောင်ထားရှိပြီး user data ကို offline မလုပ်ဘဲ rebuild များပြုလုပ်ပြီး capacity penalty မှာ drive ရှစ်ခုတွင် တစ်ခုဖြစ်သည်။ capacity ထက် rebuild-window protection ကို အလေးထားသော production deployment အတွက် RAID 6 သို့မဟုတ် RAID 10 သည် ကျိုးကြောင်းဆီလျော်သော ရွေးချယ်မှုတစ်ခုဖြစ်ပြီး၊ SupremeRAID သည် နှစ်မျိုးလုံးကို support လုပ်ပါသည်။
ကွန်ရက်- Broadcom 400GbE နှင့် 800G Core
သိုလှောင်မှုအပိုင်းမှာ R770AP မှာ Broadcom BCM57608 Thor 2 adapter နှစ်ခုပါဝင်ပြီး တစ်ခုချင်းစီမှာ PCIe Gen5 x16 interface ပေါ်မှာ single-port 400GbE NIC ပါရှိပါတယ်။ Broadcom က BCM57608 ကို industry ရဲ့ အနိမ့်ဆုံးပါဝါ 400G NIC အဖြစ် ထားရှိထားပြီး ၎င်းရဲ့ feature set က သင့်တော်ပါတယ်- မြှင့်တင်ထားတဲ့ DCQCN congestion control၊ adaptive routing၊ secure boot with a silicon root of trust နဲ့ inline kTLS encryption offload တို့ပါဝင်တဲ့ RoCEv2။ RoCEv2 က ဒီဒီဇိုင်းမှာ RDMA ပေါ်မှာ NFS ကို သယ်ဆောင်ပေးပြီး congestion control က client အများအပြား တစ်ပြိုင်နက်တည်း ဆွဲတဲ့အခါ အချင်းချင်း နင်းမိခြင်းကို ကာကွယ်ပေးပါတယ်။ တည်ဆောက်မှုအတွင်းမှာ bnxt_en driver က 400G port တွေမှာရှိတဲ့ optic module တွေဟာ ကြာရှည်ခံ load အောက်မှာ 70C warning threshold ကို ရောက်ရှိနေတယ်လို့ သတင်းပို့ခဲ့ပါတယ်။ R770AP မှာ fan-profile offset အသေးစားတစ်ခုနဲ့ ဒီပြဿနာကို ဖြေရှင်းခဲ့ပြီး နောက်ပိုင်းမှာ NIC တွေဟာ ဘာပြဿနာမှ မရှိဘဲ လည်ပတ်နိုင်ခဲ့ပါတယ်။
NIC နှစ်ခုစလုံးသည် ကျွန်ုပ်တို့၏ဓာတ်ခွဲခန်း၏ 800G core switch ဖြစ်သော Dell PowerSwitch Z9864F-ON တွင် ဆင်းသက်ပြီး Enterprise SONiC ကို အသုံးပြုသည်။ Z9864F-ON တွင် 800GbE တွင် OSFP112 port ၆၄ ခု ပါဝင်ပြီး ၎င်းတို့ထဲမှ တစ်ခုကို 2x400G၊ 4x200G သို့မဟုတ် 8x100G အထိ ပိုင်းခြားထားသည်။ 8x100G အထိ ပိုင်းခြားထားသော 800G optic တစ်ခုသည် 400G storage link နှစ်ခုကို အဆုံးသတ်ပေးသည့် switch တစ်ခုတည်းနှင့် link တစ်ခုစီဖြစ်သည့် Sparks ရှစ်ခုကို ချိတ်ဆက်ပေးသည်။ 400G NIC တစ်ခုစီသည် ၎င်း၏ကိုယ်ပိုင် VLAN တွင်တည်ရှိပြီး Sparks လေးခုကို ဝန်ဆောင်မှုပေးသောကြောင့် storage host သည် RDMA target နှစ်ခုကို တင်ပြပြီး load ကို ဒီဇိုင်းအရ ညီတူညီမျှ ခွဲဝေထားသည်။ လက်တွေ့တွင် ၎င်းသည် full-rate topology ဖြစ်သည်- တစ်ဖက်တွင် client bandwidth 8x100G၊ တစ်ဖက်တွင် storage bandwidth 2x400G နှင့် အလယ်တွင် capacity 102.4Tbps ရှိသော switch တစ်ခုဖြစ်သည်။
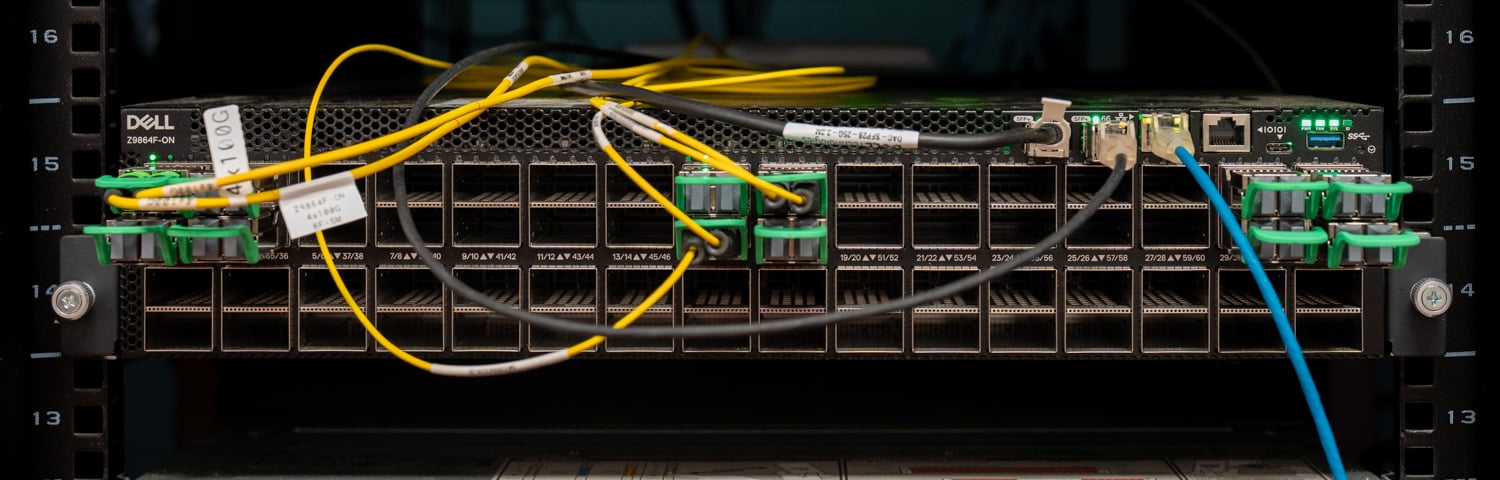
မည်သည့် storage software မှ မထိတွေ့မီတွင် fabric ကို ကျွန်ုပ်တို့ အတည်ပြုခဲ့ပါသည်။ R770AP နှင့် 400G link များပေါ်ရှိ ဒုတိယ host အကြား Server-to-server စမ်းသပ်မှုများသည် နှစ်ဖက်စလုံးတွင် line rate ဖြင့် လည်ပတ်ခဲ့ပြီး Sparks မှ RDMA traffic က 100G breakout port များသည် အပြည့်အဝ မြန်နှုန်းဖြင့် လည်ပတ်ကြောင်း အတည်ပြုခဲ့သည်။ Tuxera ၏ အင်ဂျင်နီယာများသည် NFS shares များကို up လုပ်ပြီးနောက် Sparks မှ ၎င်းတို့၏ သက်ဆိုင်ရာ NIC များသို့ iperf3 သည် parallel stream လေးခုနှင့် retransmit လုံးဝမပြုလုပ်ဘဲ သန့်ရှင်းသော 99Gbps ကို ပြသခဲ့သည်။
ဘာကြောင့် NFS လဲ၊ ဘာကြောင့် Tuxera လဲ
Graid က မြန်ဆန်တဲ့ block device တစ်ခုကို တင်ပြထားတာကြောင့် storage host ဟာ Sparks တွေကို NVMe-oF block targets ဒါမှမဟုတ် file shares အနေနဲ့ ဝန်ဆောင်မှုပေးနိုင်ပါတယ်။ GP Spark review မှာ block path ကို စမ်းသပ်ခဲ့ပြီး client တစ်ခုတည်းအတွက် ကောင်းကောင်းအလုပ်လုပ်ပါတယ်။ Sparks အများကြီးပါဝင်တဲ့ lab အတွက် ကျွန်တော်တို့က တခြားတစ်ခုခုကို လိုချင်ခဲ့ပါတယ်။ Block volumes တွေက one-to-one ပါ။ user တစ်ယောက်စီက LUN တစ်ခု လိုအပ်မှာဖြစ်ပြီး user နှစ်ယောက်က dataset တစ်ခုတည်းကို လိုချင်တဲ့အခါ သင်က copy ကူးနေမှာဖြစ်ပြီး ဒါက ဒီ design တစ်ခုလုံးကို ဖယ်ရှားဖို့ ရှိနေတဲ့ ပြဿနာပါ။ NFS က Venn diagram ရဲ့ အလယ်ဗဟိုမှာ ရှိပါတယ်- single namespace က shared datasets၊ hosted models နဲ့ per-user folders တွေကို သိမ်းဆည်းထားပါတယ်။ Spark mount တိုင်းက Ubuntu မှာ ရှိပြီးသား NFS client ကို အသုံးပြုပြီး Kubernetes နဲ့ Slurm tooling တွေက တက္ကသိုလ်တစ်ခုက Spark lab ပေါ်မှာ တင်ထားမယ့် tooling အားလုံးက NFS ကို ပြောတာပါ။
Fusion NFS သည် Tuxera Fusion ၏ NFS တစ်ဝက်ဖြစ်ပြီး၊ ၎င်းသည် user-mode, multithreaded core တစ်ခုတည်းတွင် SMB နှင့် NFS ကို လွှမ်းခြုံထားသော multiprotocol file server ဖြစ်သည်။ ကျွန်ုပ်တို့သည် ၂၀၂၄ ခုနှစ်တွင် Solidigm နှင့် Tuxera media workflow project တွင် Fusion SMB ကို ပထမဆုံးကြည့်ရှုခဲ့သည် ။ Tuxera သည် RDMA နှင့် single 200GbE connection တွင် 22.7GB/s အထိ ရရှိနိုင်ပြီး ကုမ္ပဏီ၏ကိုယ်ပိုင်စမ်းသပ်မှုတွင် kernel NFSD နှင့် Ganesha ထက် သာလွန်ကြောင်း အခိုင်အမာပြောဆိုထားပြီး ထုတ်ကုန်သည် NFS 4.1၊ active-active scale-out clustering၊ transparent failover နှင့် Active Directory၊ Kerberos နှင့် LDAP integration တို့ကို ပံ့ပိုးပေးသည်။ နောက်ဆုံးအစုံမှာ governance hook ဖြစ်သည်- Spark သို့ မည်သူဝင်ရောက်နိုင်သည်ကို ထိန်းချုပ်သော directory သည် share တွင် ၎င်းတို့မြင်နိုင်သည်ကိုလည်း ထိန်းချုပ်သည်။ ဤဆောင်းပါးရှိ Tuxera နံပါတ်တိုင်းအတွက် သတိပေးချက်တစ်ခု သက်ရောက်သည်- ကျွန်ုပ်တို့လုပ်ဆောင်ခဲ့သော build သည် Fusion NFS ၏ private preview တစ်ခုဖြစ်ပြီး Tuxera က စွမ်းဆောင်ရည်အတွက် အပြည့်အဝ optimize မလုပ်ရသေးကြောင်းနှင့် software ကို စီးပွားဖြစ်ရောင်းချရန် မရရှိနိုင်သေးကြောင်း ပြောကြားခဲ့သည်။ SC'26 ပြီးနောက် နိုဝင်ဘာလတွင် ယေဘုယျရရှိနိုင်မှုကို စီစဉ်ထားသည်။
Tuxera က R770AP မှာ Fusion ကို ထည့်သွင်းပြီး XFS နဲ့ Graid volume ကို format ချကာ server ကို standard port မှာ NFS နဲ့ port 20049 မှာ RPC-RDMA နဲ့ configure လုပ်ခဲ့ပါတယ်။ ဒီ project က NFS-only ဖြစ်တဲ့အတွက် SMB listeners တွေကို ချန်ထားခဲ့ပါတယ်။ အစပိုင်း thread configuration မှာ protocol thread လေးခုပါဝင်ပြီး တစ်ခုစီမှာ transport transmit နဲ့ receive အတွက် thread ရှစ်ခုစီပါဝင်ပြီး Tuxera က tuning အတွက် အစပြုရာနေရာအဖြစ် ဖော်ပြထားပါတယ်။ Directory service တွေကို lab build မှာ ရည်ရွယ်ချက်ရှိရှိ ချန်ထားခဲ့ပါတယ်။ တက္ကသိုလ် deployment က သူ့ရဲ့ကိုယ်ပိုင် identity service တွေကို အပေါ်ဆုံးမှာ layer လုပ်မှာပါ။ Spark ဘက်မှာ share ကို mount လုပ်တာက command တစ်ခုတည်းပါ။
sudo mount -t nfs -o proto=rdma,port=20049 ဖြင့် ရိုက်ထည့်ပါ။ :/mnt/ရှယ်ယာများ/smbnfs1/ /localnfs
အဲဒီတစ်ကြောင်းတည်းက Spark မှာ driver၊ initiator configuration နဲ့ vendor software မပါဘဲ client integration တစ်ခုလုံးပါ။ မနက်ဖြန်မှာ တခြား Spark တစ်ခုမှာ login ဝင်တဲ့ user က အဲဒီတစ်ကြောင်းတည်းကို run ပြီး အဲဒီဖိုင်တွေကို မြင်ရမှာပါ။
ဖွဲ့စည်းမှုအထောက်အထား- ဒေတာအစုံတစ်ခုတွင် မီးပွားရှစ်ခု
မော်ဒယ်အလုပ်တွေမစခင်မှာ Spark တစ်ခုချင်းစီကို sanity check တစ်ခုစီလုပ်ခဲ့ပါတယ်- array ပေါ်က သူ့ရဲ့ကိုယ်ပိုင် folder နဲ့ jobs ၁၆ ခုပါတဲ့ 1M sequential fio read နဲ့ queue depth ၁၆ ခုရှိပါတယ်။ unit ရှစ်ခုက 10.0 နဲ့ 11.2GiB/s ကြားမှာ return ပြန်ခဲ့ပြီး တစ်ခုချင်းစီရဲ့ 100GbE link ကို saturate လုပ်ခဲ့ပါတယ်။ ပြီးတော့ ရှစ်ခုစလုံးက သူတို့ရဲ့ load ကို ထိန်းထားနိုင်တယ်ဆိုတာ သက်သေပြဖို့ sweep လုပ်ခဲ့ပါတယ်။ run တစ်ခုချင်းစီမှာ queue depth ၁၆ ခုမှာ fixed thread ၁၆ ခုကို သိမ်းဆည်းထားပြီး 1M sequential၊ 64K random၊ 16K sequential နဲ့ 4K random workloads တွေပေါ်မှာ one, two ... ရှစ်ခုလုံးကို တစ်ပြိုင်နက် load လုပ်လိုက်တဲ့အခါ၊ တစ်ယူနစ်ကို 1M sequential reads တွေက 3.09 မှ 3.13GiB/s အထိ၊ 64K random reads တွေက 6,648 မှ 6,779 IOPS အထိ၊ 4K random writes တွေက 2,136 မှ 2,155 IOPS အထိ ရှိပြီး၊ fairness enforcement မရှိဘဲ VLAN နှစ်ခုပေါ်က OEM ငါးခုမှာ ရှိပါတယ်။ Spark တိုင်းဟာ array ကို ရောက်ရှိပြီး Spark တိုင်းဟာ ညီညာတဲ့ share ကို ရရှိခဲ့ပြီး အရေးကြီးတဲ့ workload အတွက် configuration အဆင်သင့်ဖြစ်နေပါပြီ။
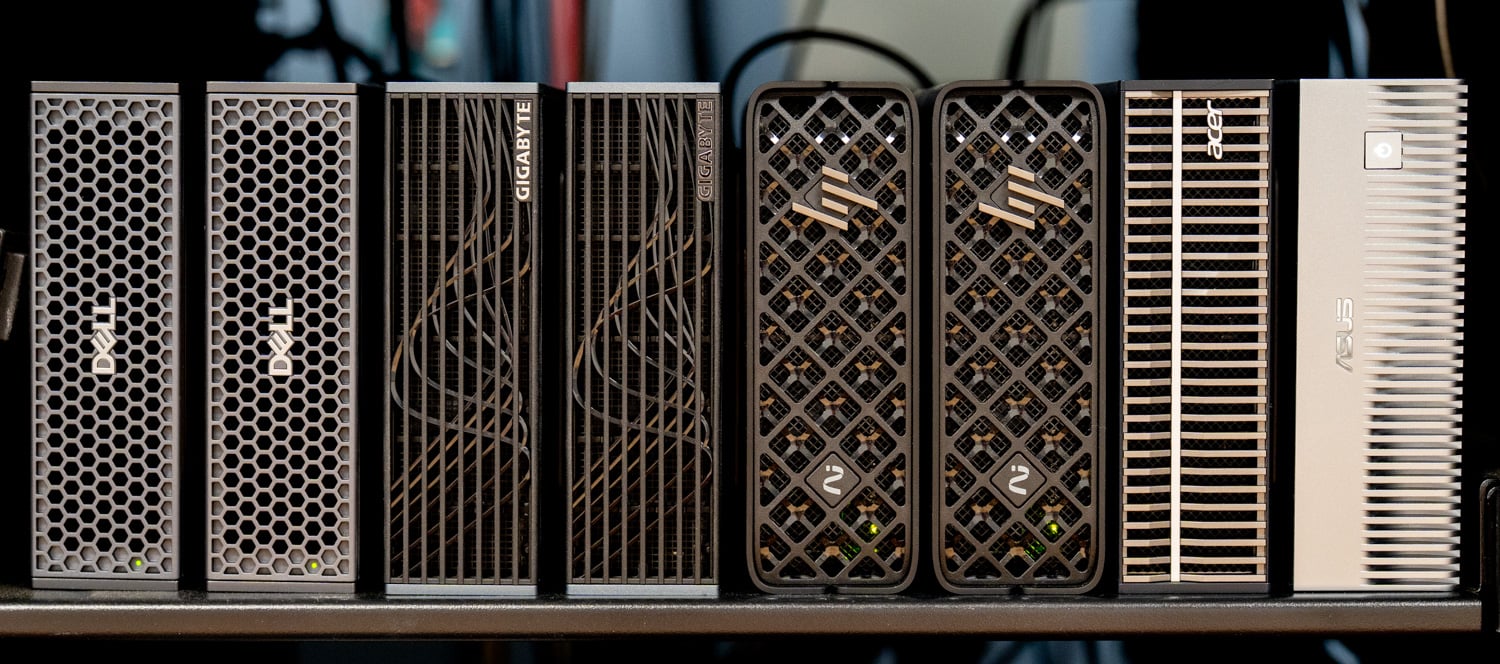
| Spark (client ရှစ်ခု၊ thread ၂ ခု x တစ်ခုစီတွင် QD16) | သိုလှောင်မှု NIC | ၁ သန်း အစဉ်လိုက်ဖတ်ရှုခြင်း | 64K ကျပန်းဖတ်ရှုမှု IOPS | 4K ကျပန်းဖတ်ရှုမှု IOPS | 4K ကျပန်းရေးသားခြင်း IOPS |
|---|---|---|---|---|---|
| GB10 (1) ပါရှိသော Dell Pro Max | 1 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI ထိပ်တန်း ATOM (1) | 1 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,670 | 10,100 | 2,149 |
| GB10 (2) ပါရှိသော Dell Pro Max | 2 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI ထိပ်တန်း ATOM (2) | 2 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | 6,734 | 10,300 | 2,145 |
Host ကို အရွယ်အစားသတ်မှတ်ခြင်း- NIC နှစ်ခုနှင့် Headroom များစွာ
ဓာတ်ခွဲခန်း သို့မဟုတ် လုပ်ငန်းတစ်ခုသည် ဝယ်ယူခြင်းမပြုမီ ပေးချေရမည့် မေးခွန်းကို ထိုနည်း၎င်းပင် ဖြေဆိုပေးပါသည်။ အမြင့်ဆုံးပမာဏက ဘယ်မှာလဲ၊ host ရဲ့ ဘယ်အပိုင်းက သတ်မှတ်ပေးသလဲ။ အောက်ဖော်ပြပါ panel လေးခုသည် fixed load သည် Spark တစ်ခုမှ ရှစ်အထိ တိုးလာသည်နှင့်အမျှ workload လေးခုလုံး၏ read throughput ကို ပြသထားသည်။ write ဘက်ခြမ်းကို အောက်ဘက်ရှိ စာသားနှင့် ဇယားတွင် ဖော်ပြထားသည်။
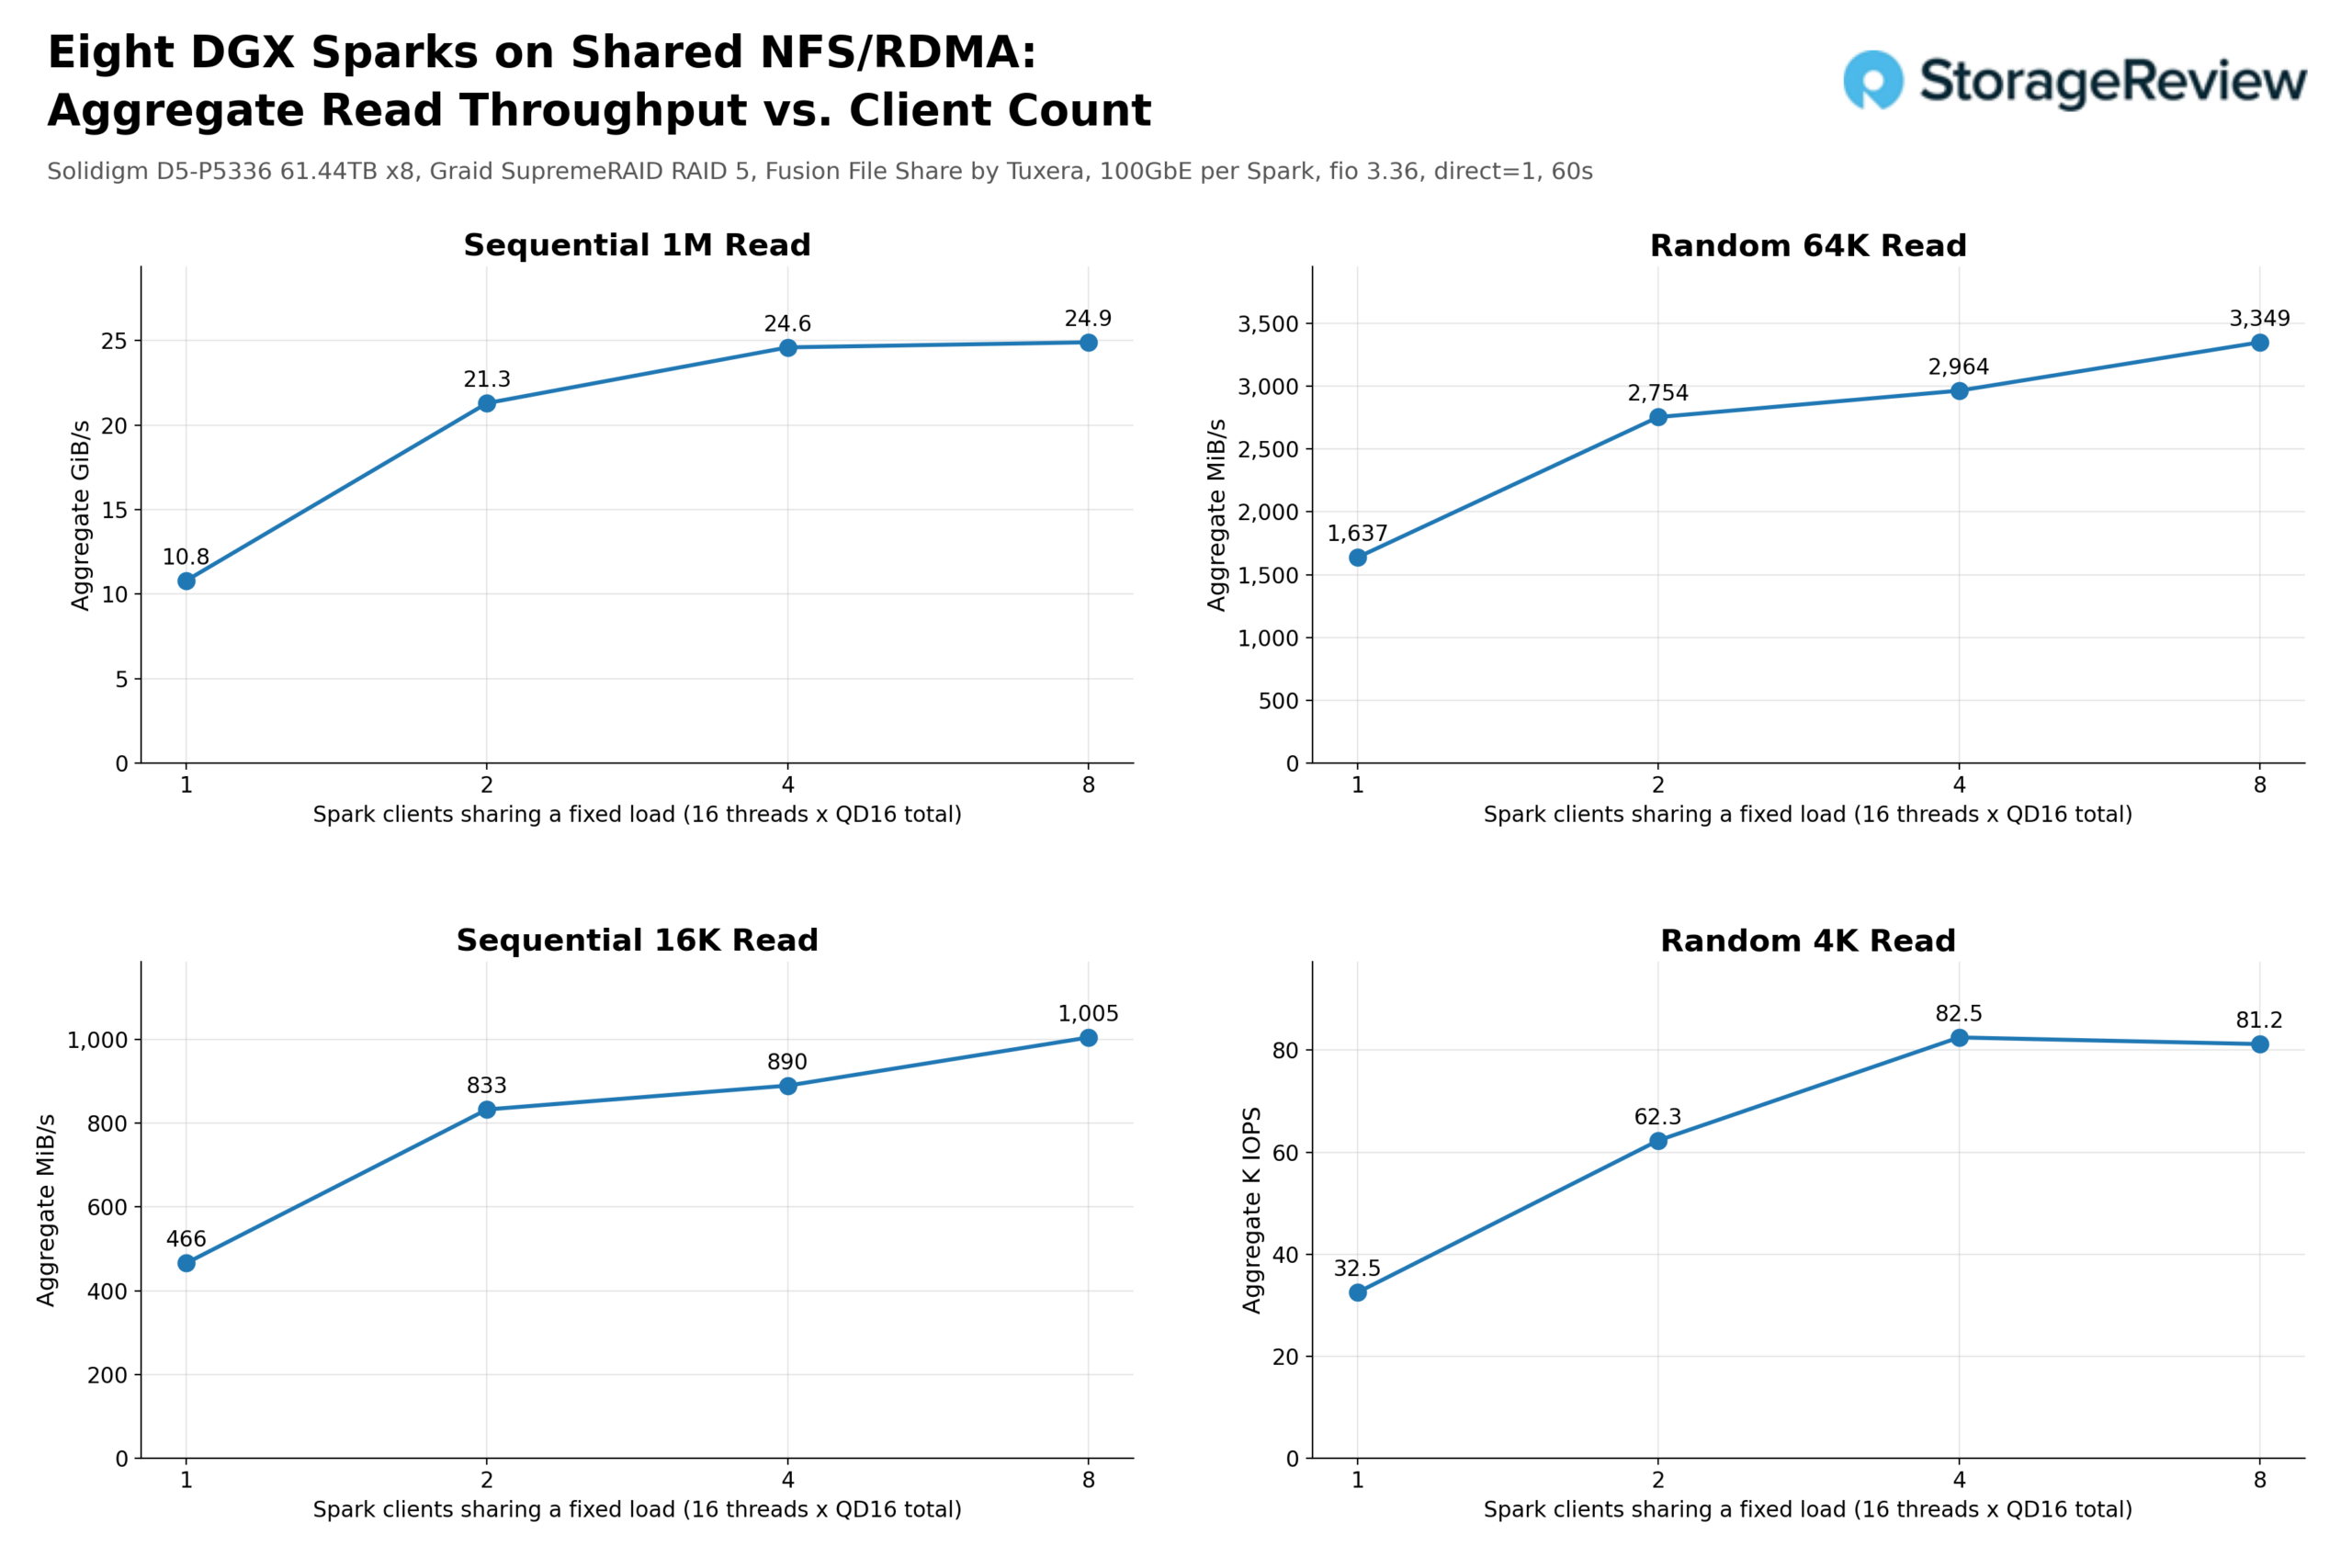
စုစုပေါင်း 1M sequential read သည် Spark တစ်လုံးတွင် 10.8GiB/s မှ နှစ်လုံးတွင် 21.3GiB/s၊ လေးလုံးတွင် 24.6GiB/s နှင့် ရှစ်လုံးတွင် 24.9GiB/s အထိ မြင့်တက်လာခဲ့သည်။ ကွန်ရက်အရ Broadcom 400GbE NIC နှစ်လုံး သယ်ဆောင်နိုင်သော 800Gb/s နှင့် နှိုင်းယှဉ်ပါက 93Gb/s၊ 183Gb/s၊ 212Gb/s နှင့် 214Gb/s ရှိပြီး၊ ထို့ကြောင့် ရှစ်လုံး-client load တွင် array သည် host ၏ network capacity ၏ 27% ကို အသုံးပြုခဲ့သည်။ 25GiB/s အနီးရှိ ကုန်းမြင့်သည် ရှစ်လုံး-drive RAID 5 QLC array နှင့် သက်ဆိုင်သည်။ NIC များ၊ switch နှင့် Sparks ၏ကိုယ်ပိုင် 100GbE link များသည် ကန့်သတ်ချက် မဖြစ်ခဲ့ပေ။
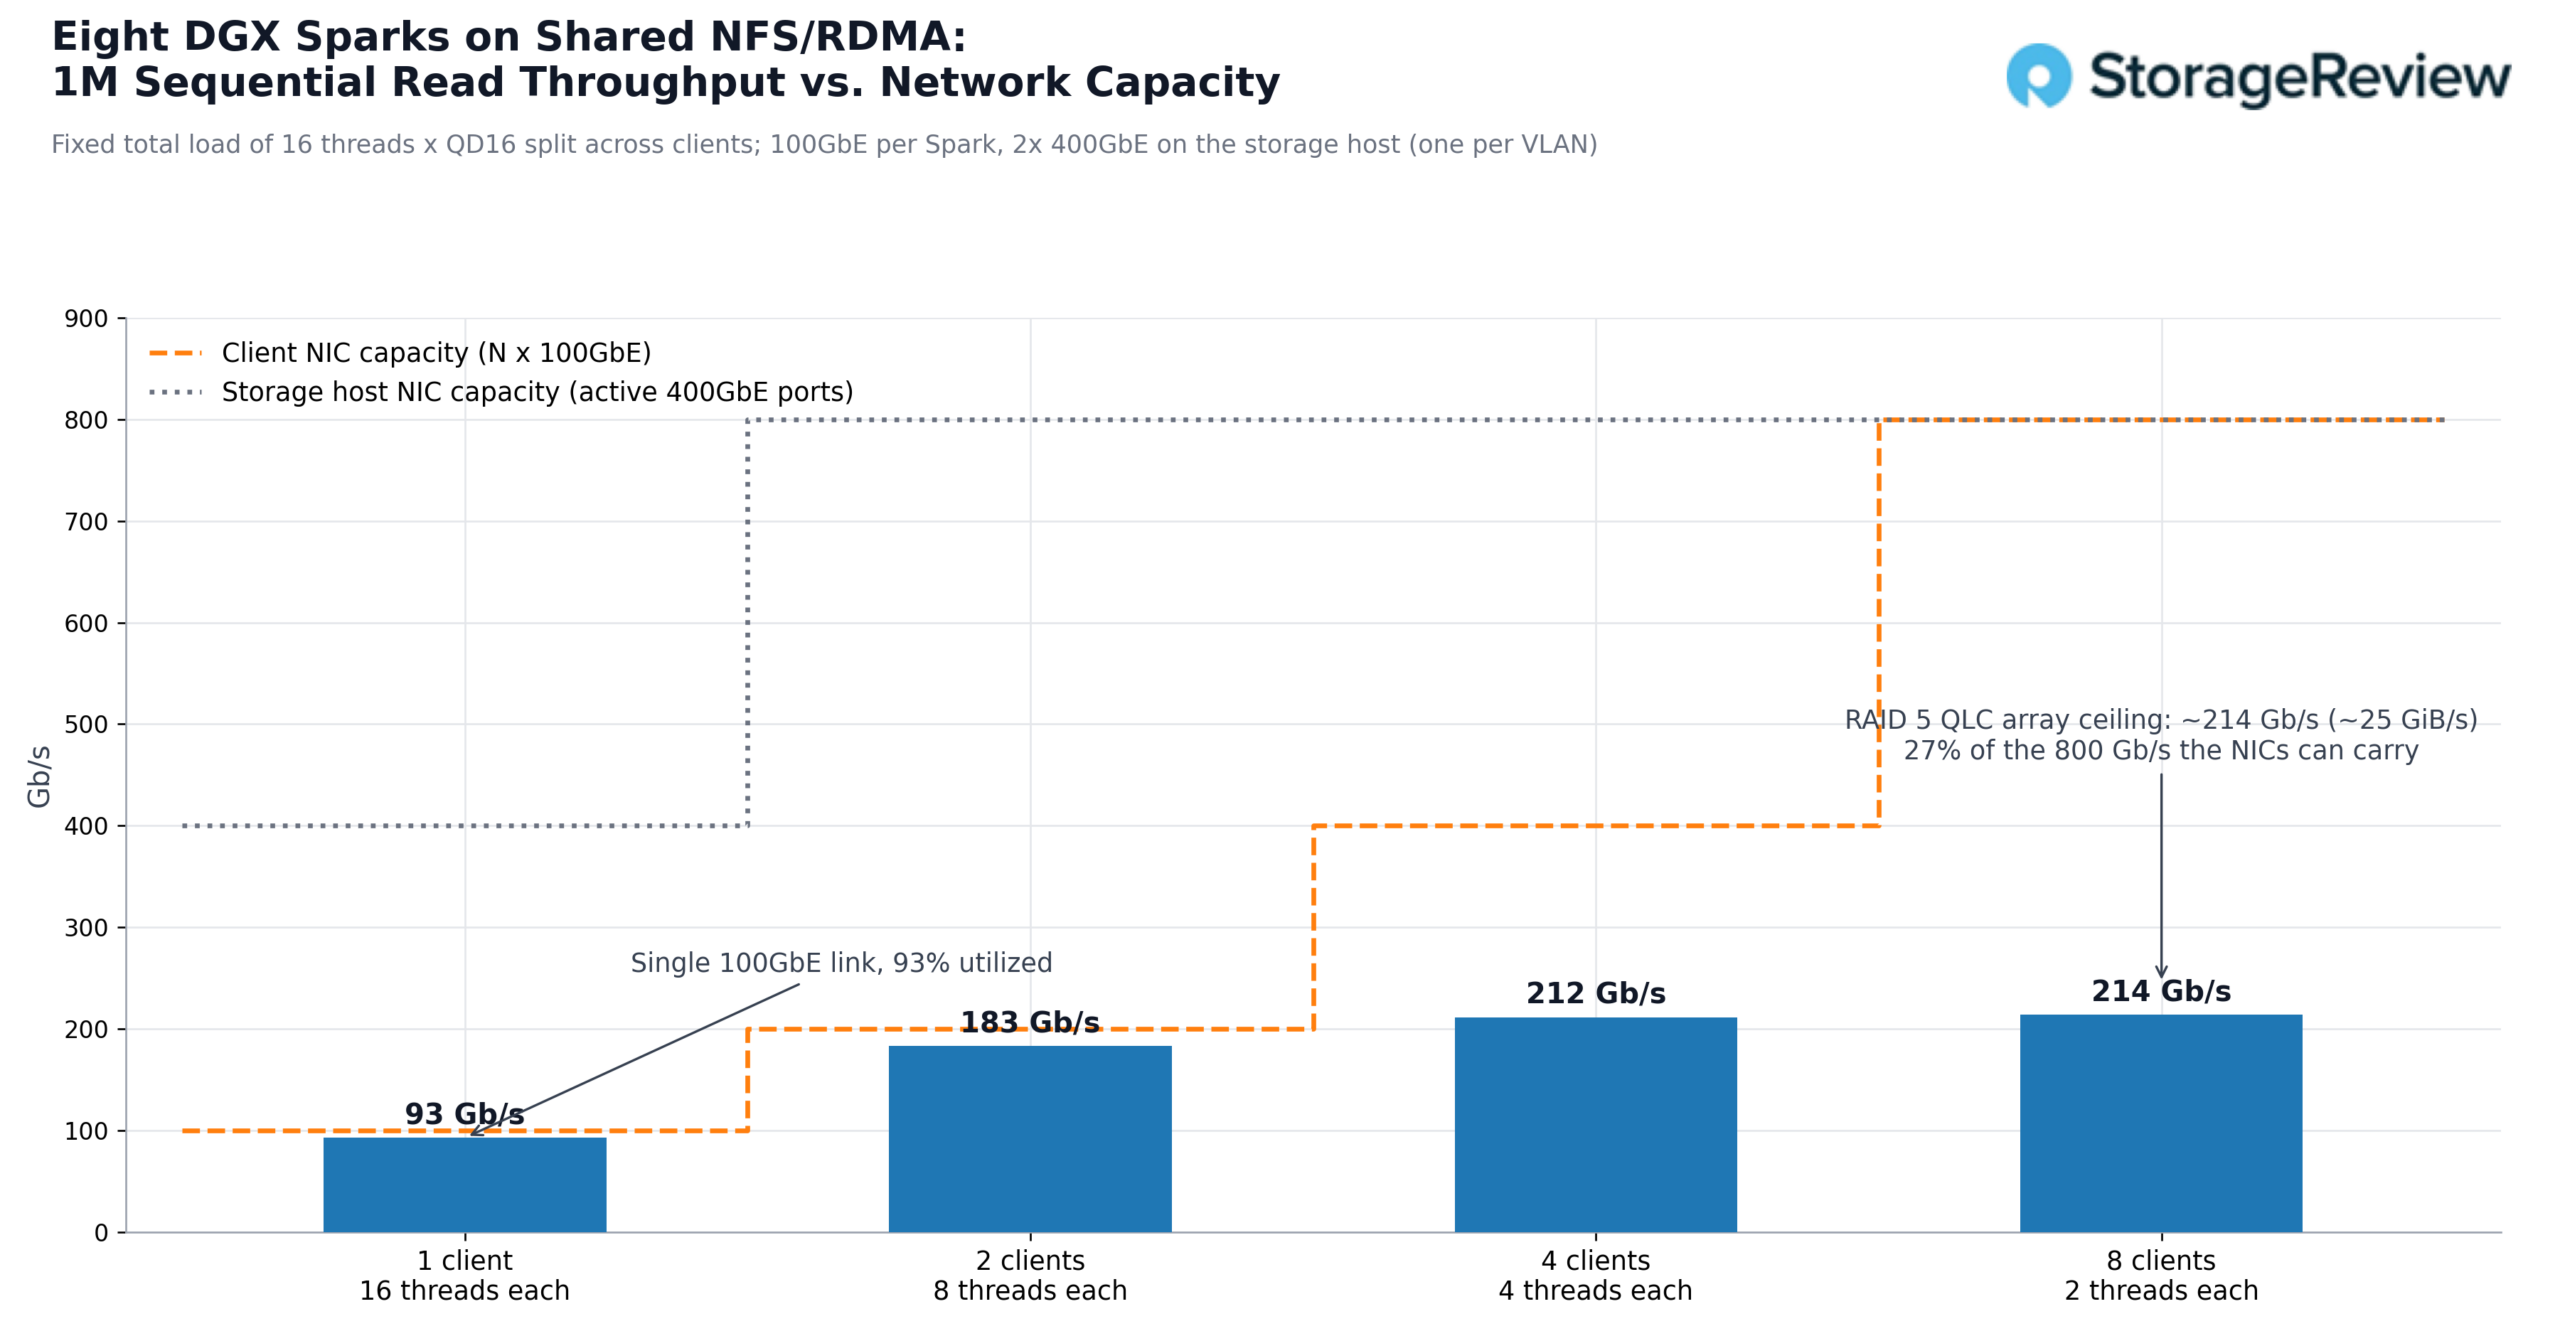
server-side NIC နှစ်ခုသည် line rate တွင် Sparks ရှစ်ခုကို လွှမ်းခြုံထားပြီးဖြစ်ပြီး R770AP ရှိ အခြား bay ရှစ်ခုကိုလည်း လွှမ်းခြုံထားမည်ဖြစ်သည်။ ဒုတိယ array သို့မဟုတ် ပိုမိုကျယ်ပြန့်သော RAID set တစ်ခုအနေဖြင့် drive အရေအတွက်ကို နှစ်ဆတိုးလိုက်ခြင်းဖြင့် တူညီသော port နှစ်ခုနောက်တွင် read bandwidth ပိုမိုများပြားလာပြီး နေရာလွတ်များ ပိုများလာပါသည်။ I/O အတွက်လည်း အလားတူပင်ဖြစ်သည်။ 4K random read များသည် client တစ်ခုတွင် 32.5K IOPS မှ client လေးခုနှင့်အထက်တွင် 81K IOPS ခန့်အထိ တိုးမြှင့်ခဲ့ပြီး client တစ်ခုစီ၏ queue များ ပိုမိုနက်ရှိုင်းလာသည်နှင့်အမျှ per-I/O latency သည် 7.9ms မှ 3.1ms သို့ ကျဆင်းသွားခဲ့ပြီး 64K random read များသည် 1,637 မှ 3,349MiB/s သို့ ကျဆင်းသွားခဲ့ပြီး နှစ်ခုစလုံးတွင် network သည် ၎င်း၏ကန့်သတ်ချက်ထက် များစွာနိမ့်ကျနေခဲ့သည်။
နောက်ထပ်အရေးကြီးတဲ့ နှိုင်းယှဉ်ချက်တစ်ခုကတော့ Spark မှာရှိပြီးသား storage နဲ့ နှိုင်းယှဉ်ကြည့်တာပါ။ ကျွန်တော်တို့ရဲ့ GB10 review တစ်ခုချင်းစီမှာ internal M.2 ကနေ GDSIO 1M reads ဟာ Acer Veriton GN100 နဲ့ GIGABYTE AI TOP ATOM မှာ 11.2GiB/s နီးပါးအထိ ရောက်ရှိခဲ့ပါတယ်။ GB10 နဲ့ HP ZGX Nano G1n ပါတဲ့ Dell Pro Max မှာ 5.5GiB/s ဝန်းကျင်အထိ ရောက်ရှိခဲ့ပြီး ASUS Ascent GX10 မှာတော့ 5GiB/s နီးပါးအထိ ရောက်ရှိခဲ့ပါတယ်။ နှိုင်းယှဉ်ကြည့်မယ်ဆိုရင် Luisuantech GP Spark ရဲ့ external NVMe-oF box ဟာ တူညီတဲ့ 100GbE port မှာ 9.5GB/s ပေးပို့ခဲ့ပါတယ်။ shared QLC array ကနေ 10.8GiB/s ရှိတဲ့ Spark reading တစ်ခုတည်းဟာ အဲဒီအုပ်စုထဲက အမြန်ဆုံး internal drives တွေနဲ့ ကိုက်ညီပြီး တခြား Spark တိုင်း ဖတ်နိုင်တဲ့ data ကနေ cable တစ်ခုပေါ်မှာ အနှေးဆုံးကို နှစ်ဆလောက် မြှင့်တင်ပေးပါတယ်။ tools တွေ ကွဲပြားပါတယ်- internal drives တွေမှာ GDSIO နဲ့ NFS ပေါ်မှာ fio ရှိပါတယ်၊ ဒါကြောင့် ဒါက range နှိုင်းယှဉ်ချက်တစ်ခုပါ။
client အရေအတွက်တစ်ခုစီတွင် workload လေးခုလုံးအတွက် စုစုပေါင်းကိန်းဂဏန်းများဖြင့် အပြည့်အစုံကို အောက်တွင်ဖော်ပြထားပါသည်။ array တွင် headroom မပြည့်မချင်း read row တိုင်းသည် client အရေအတွက်နှင့်အတူ တက်လာပြီး write row တိုင်းသည် Spark တစ်ခုမှ ရှစ်ခုအထိ တပြေးညီရှိနေပါသည်၊ အဘယ်ကြောင့်ဆိုသော် RAID 5 parity path သည် client မည်မျှမျှဝေပါစေ array ကို ပုံသေ write ceiling တွင် ထိန်းထားပေးသောကြောင့်ဖြစ်သည်။ လူအများဖတ်ရှုပြီး ingest လုပ်ချိန်တွင် တစ်ကြိမ်ရေးသားရန် တည်ဆောက်ထားသော share တစ်ခုအတွက်၊ ၎င်းသည် ဒီဇိုင်းတည်ဆောက်ထားသော profile ဖြစ်သည်။
| စုစုပေါင်း (စုစုပေါင်း thread ၁၆ ခု) | ၁ စပါ့ခ် | ၈ စပါ့ခ်များ | ၈ စပါ့ခ်များ | ၈ စပါ့ခ်များ |
|---|---|---|---|---|
| ၁ သန်း အစဉ်လိုက်ဖတ်ရှုခြင်း | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် |
| ၁ သန်း အစဉ်လိုက်ရေးသားခြင်း | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် | ၅.၉ ဂစ်ဂါဘိုက်/စက္ကန့် |
| 64K ကျပန်းဖတ်ပါ။ | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် |
| 64K ကျပန်းရေးပါ။ | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် |
| ၁၆K အစဉ်လိုက်ဖတ်ရှုခြင်း | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် |
| 16K အစဉ်လိုက်ရေးသားခြင်း | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် | ၃၀၀၀ မိုက်ခရိုဘိုက်/စက္ကန့် |
| 4K ကျပန်းဖတ်ပါ။ | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K ကျပန်းရေးပါ။ | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Shared Storage တွင် Hosting မော်ဒယ်များ
fio sweep က array နဲ့ network ဟာ စွမ်းဆောင်ရည်ထက် သာလွန်တယ်ဆိုတာ သက်သေပြပါတယ်။ use case အတွက် အရေးကြီးတဲ့ နောက်ထပ်စမ်းသပ်မှုတစ်ခုကတော့ shared array မှာနေထိုင်တဲ့ model က Spark ရဲ့ NVMe မှာနေထိုင်တဲ့ model နဲ့ အတူတူပဲ load လုပ်သလားဆိုတာပါပဲ။ ဘာလို့လဲဆိုတော့ ဒီဇိုင်းတစ်ခုလုံးရဲ့ workflow က အဲဒါပေါ်မှာ မူတည်နေလို့ပါ။ ဗဟိုမှာ host လုပ်ထားတဲ့ copy တစ်ခု၊ ဘယ်သူမဆို load လုပ်တယ်။ NVFP4 မှာ Qwen3.5-122B-A10B ကို ရွေးချယ်ခဲ့ပါတယ်။ ဒါက 122-billion-parameter mixture-of-experts model တစ်ခုဖြစ်ပြီး disk မှာ 78GB ယူထားပြီး Spark ရဲ့ unified memory တစ်ခုတည်းမှာ ဆန့်ပါတယ်။ inference server ကို launch လုပ်တဲ့အချိန်ကနေ server က ကျန်းမာတဲ့အခြေအနေကို report လုပ်တဲ့အထိ အချိန်ကို scenarios သုံးခုနဲ့ တိုင်းတာခဲ့ပါတယ်။ တစ်ခုက internal NVMe ကနေ load လုပ်တာ၊ shared array ကနေ NFS/RDMA ပေါ်မှာ Spark တစ်ခုတည်း load လုပ်တာနဲ့ Spark ရှစ်ခုစလုံးက array ကနေ copy တစ်ခုတည်းကို တစ်ပြိုင်နက် load လုပ်တာပါ။
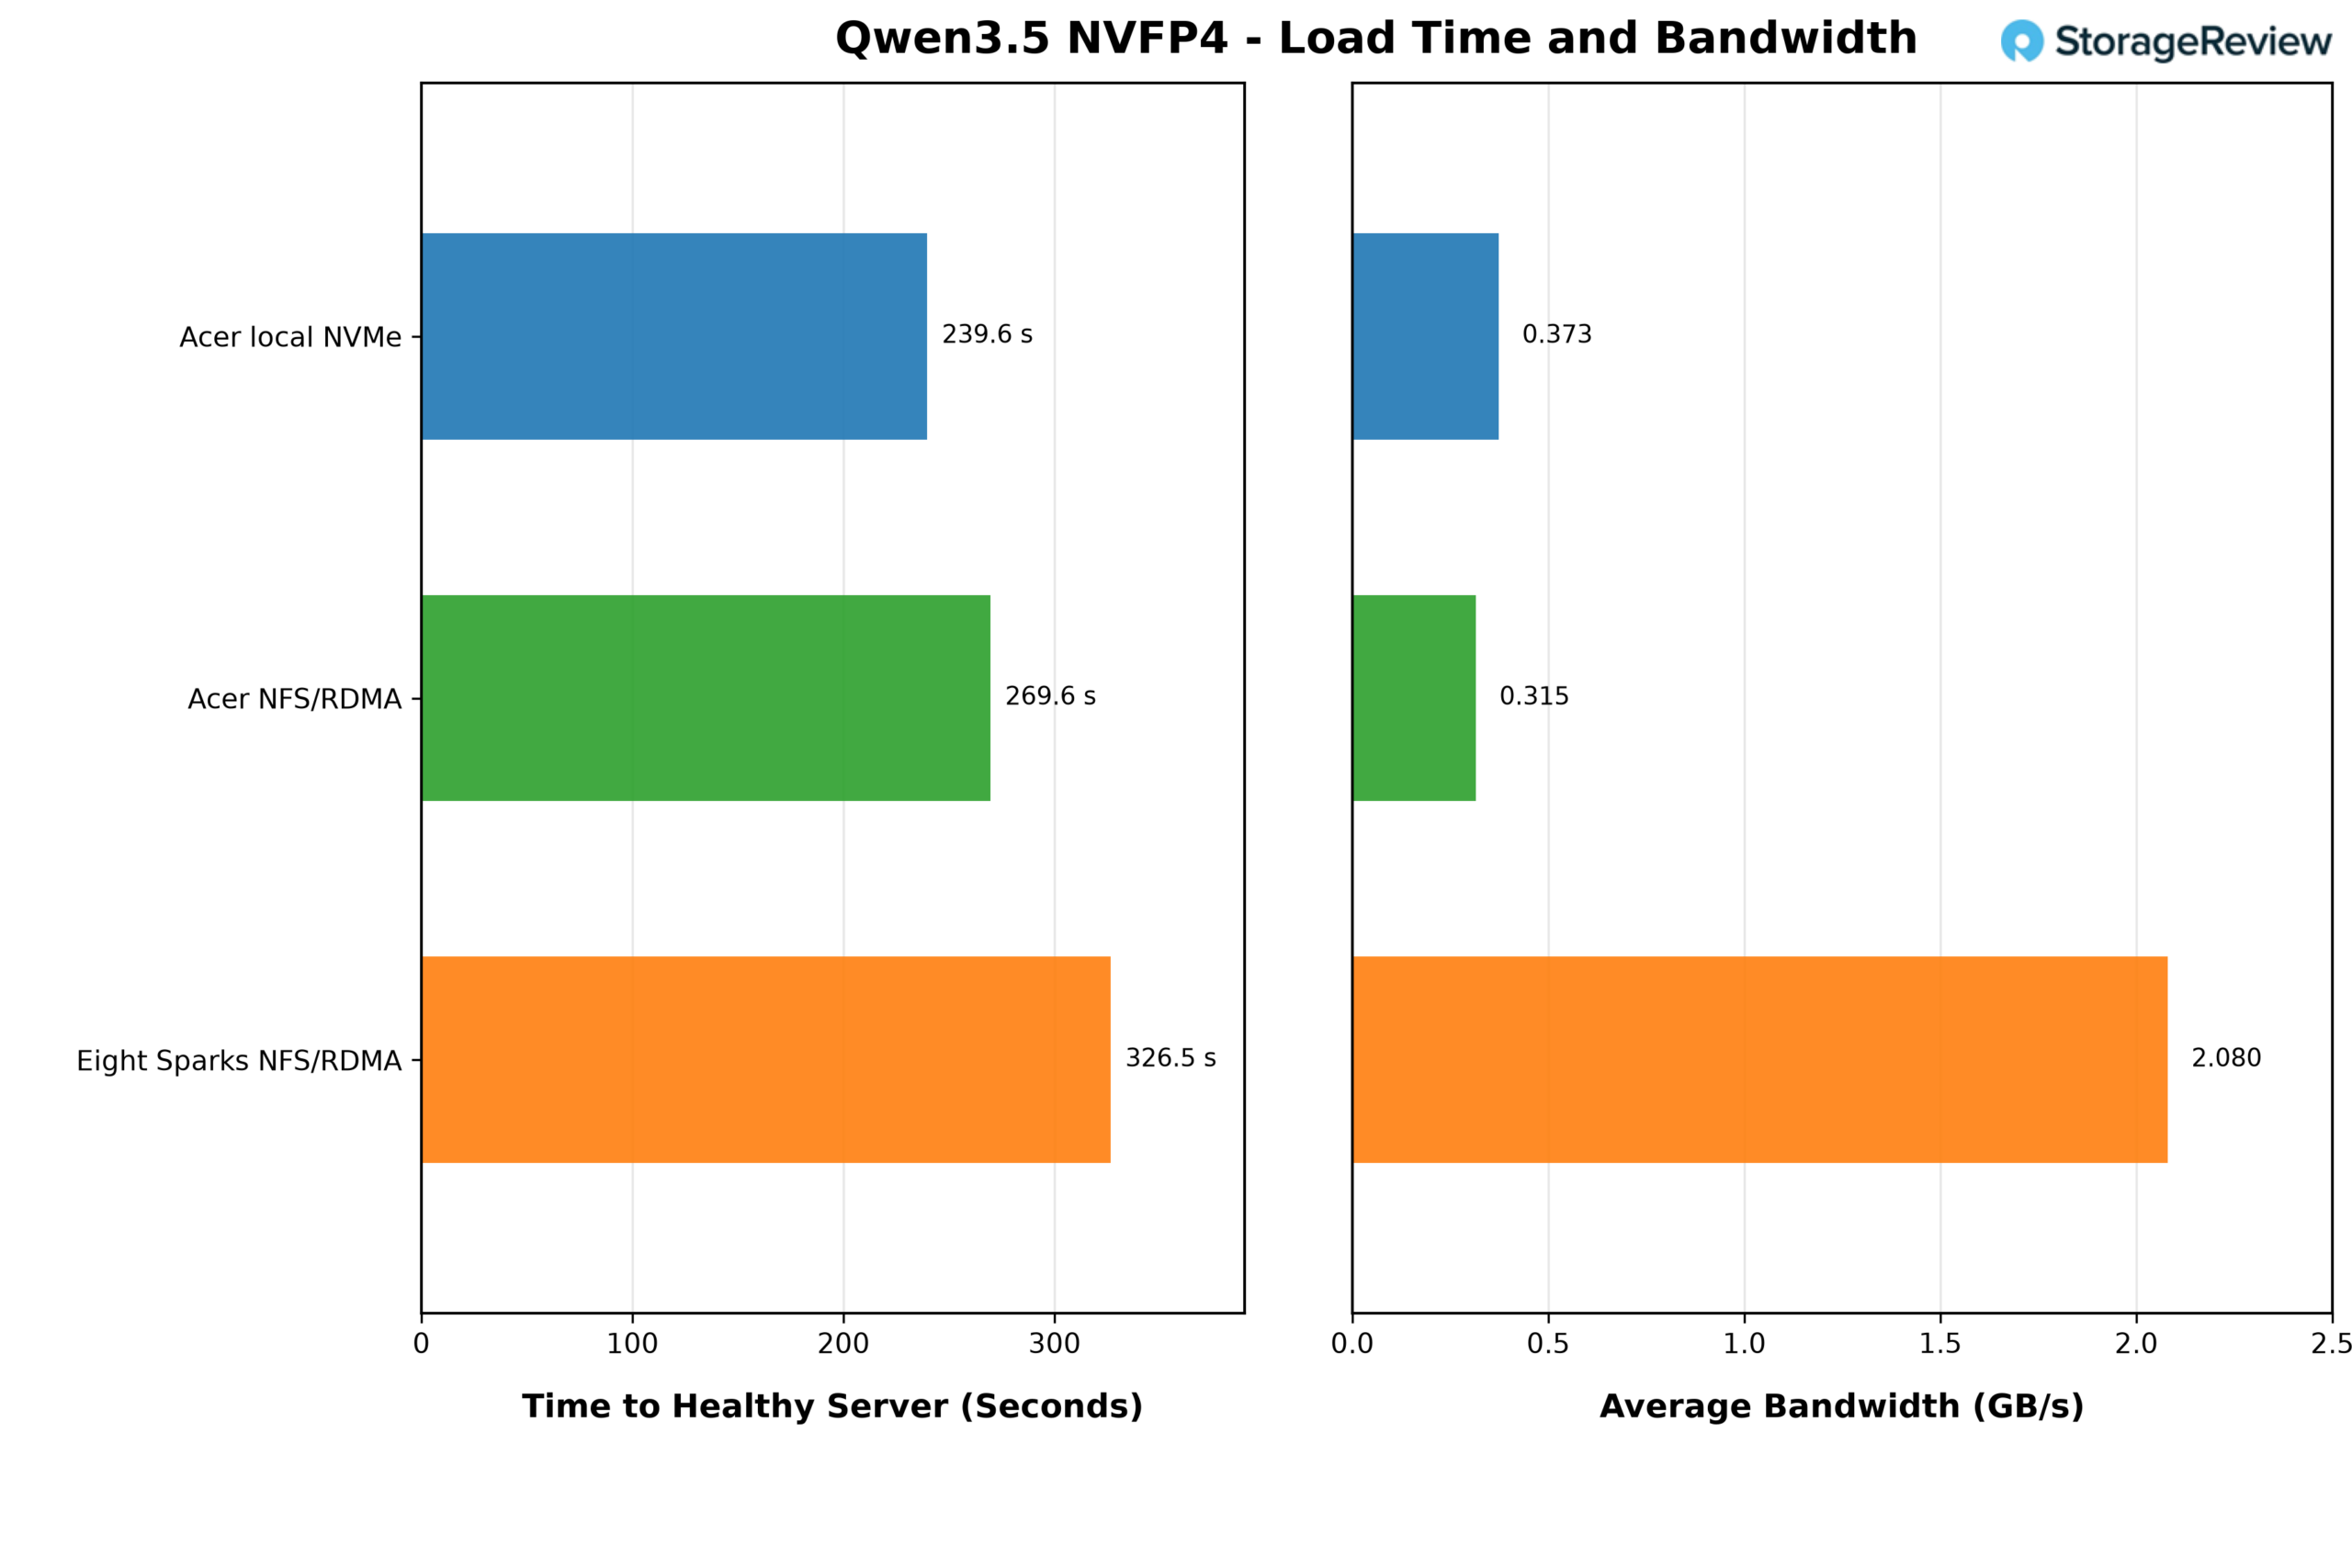
internal NVMe ကနေ Acer Veriton GN100 ဟာ ၂၃၉.၆ စက္ကန့်အတွင်း ကျန်းမာတဲ့ server ကို ရောက်ရှိခဲ့ပြီး ပျမ်းမျှအားဖြင့် 0.373GB/s ရှိခဲ့ပါတယ်။ NFS/RDMA မှတစ်ဆင့် shared array ကနေ တူညီတဲ့ Spark ဟာ 0.315GB/s မှာ ၂၆၉.၆ စက္ကန့် ကြာမြင့်ခဲ့ပြီး စက္ကန့် ၃၀ ခန့် သို့မဟုတ် ၁၃% ပိုကြာခဲ့ပါတယ်။ ပျမ်းမျှအားဖြင့် လေးမိနစ်ကျော် 78GB မှာ Spark မှာ model loading ဟာ ဘယ်လိုအခြေအနေမျိုးမှာမဆို storage-bound မရှိဘူးလို့ ပြသနေပါတယ်။ GB10 ရဲ့ weight တွေကို processing လုပ်ခြင်းက အရှိန်အဟုန်ကို သတ်မှတ်ပေးပြီး storage က window ရဲ့ အများစုကို စောင့်ဆိုင်းစေပါတယ်။
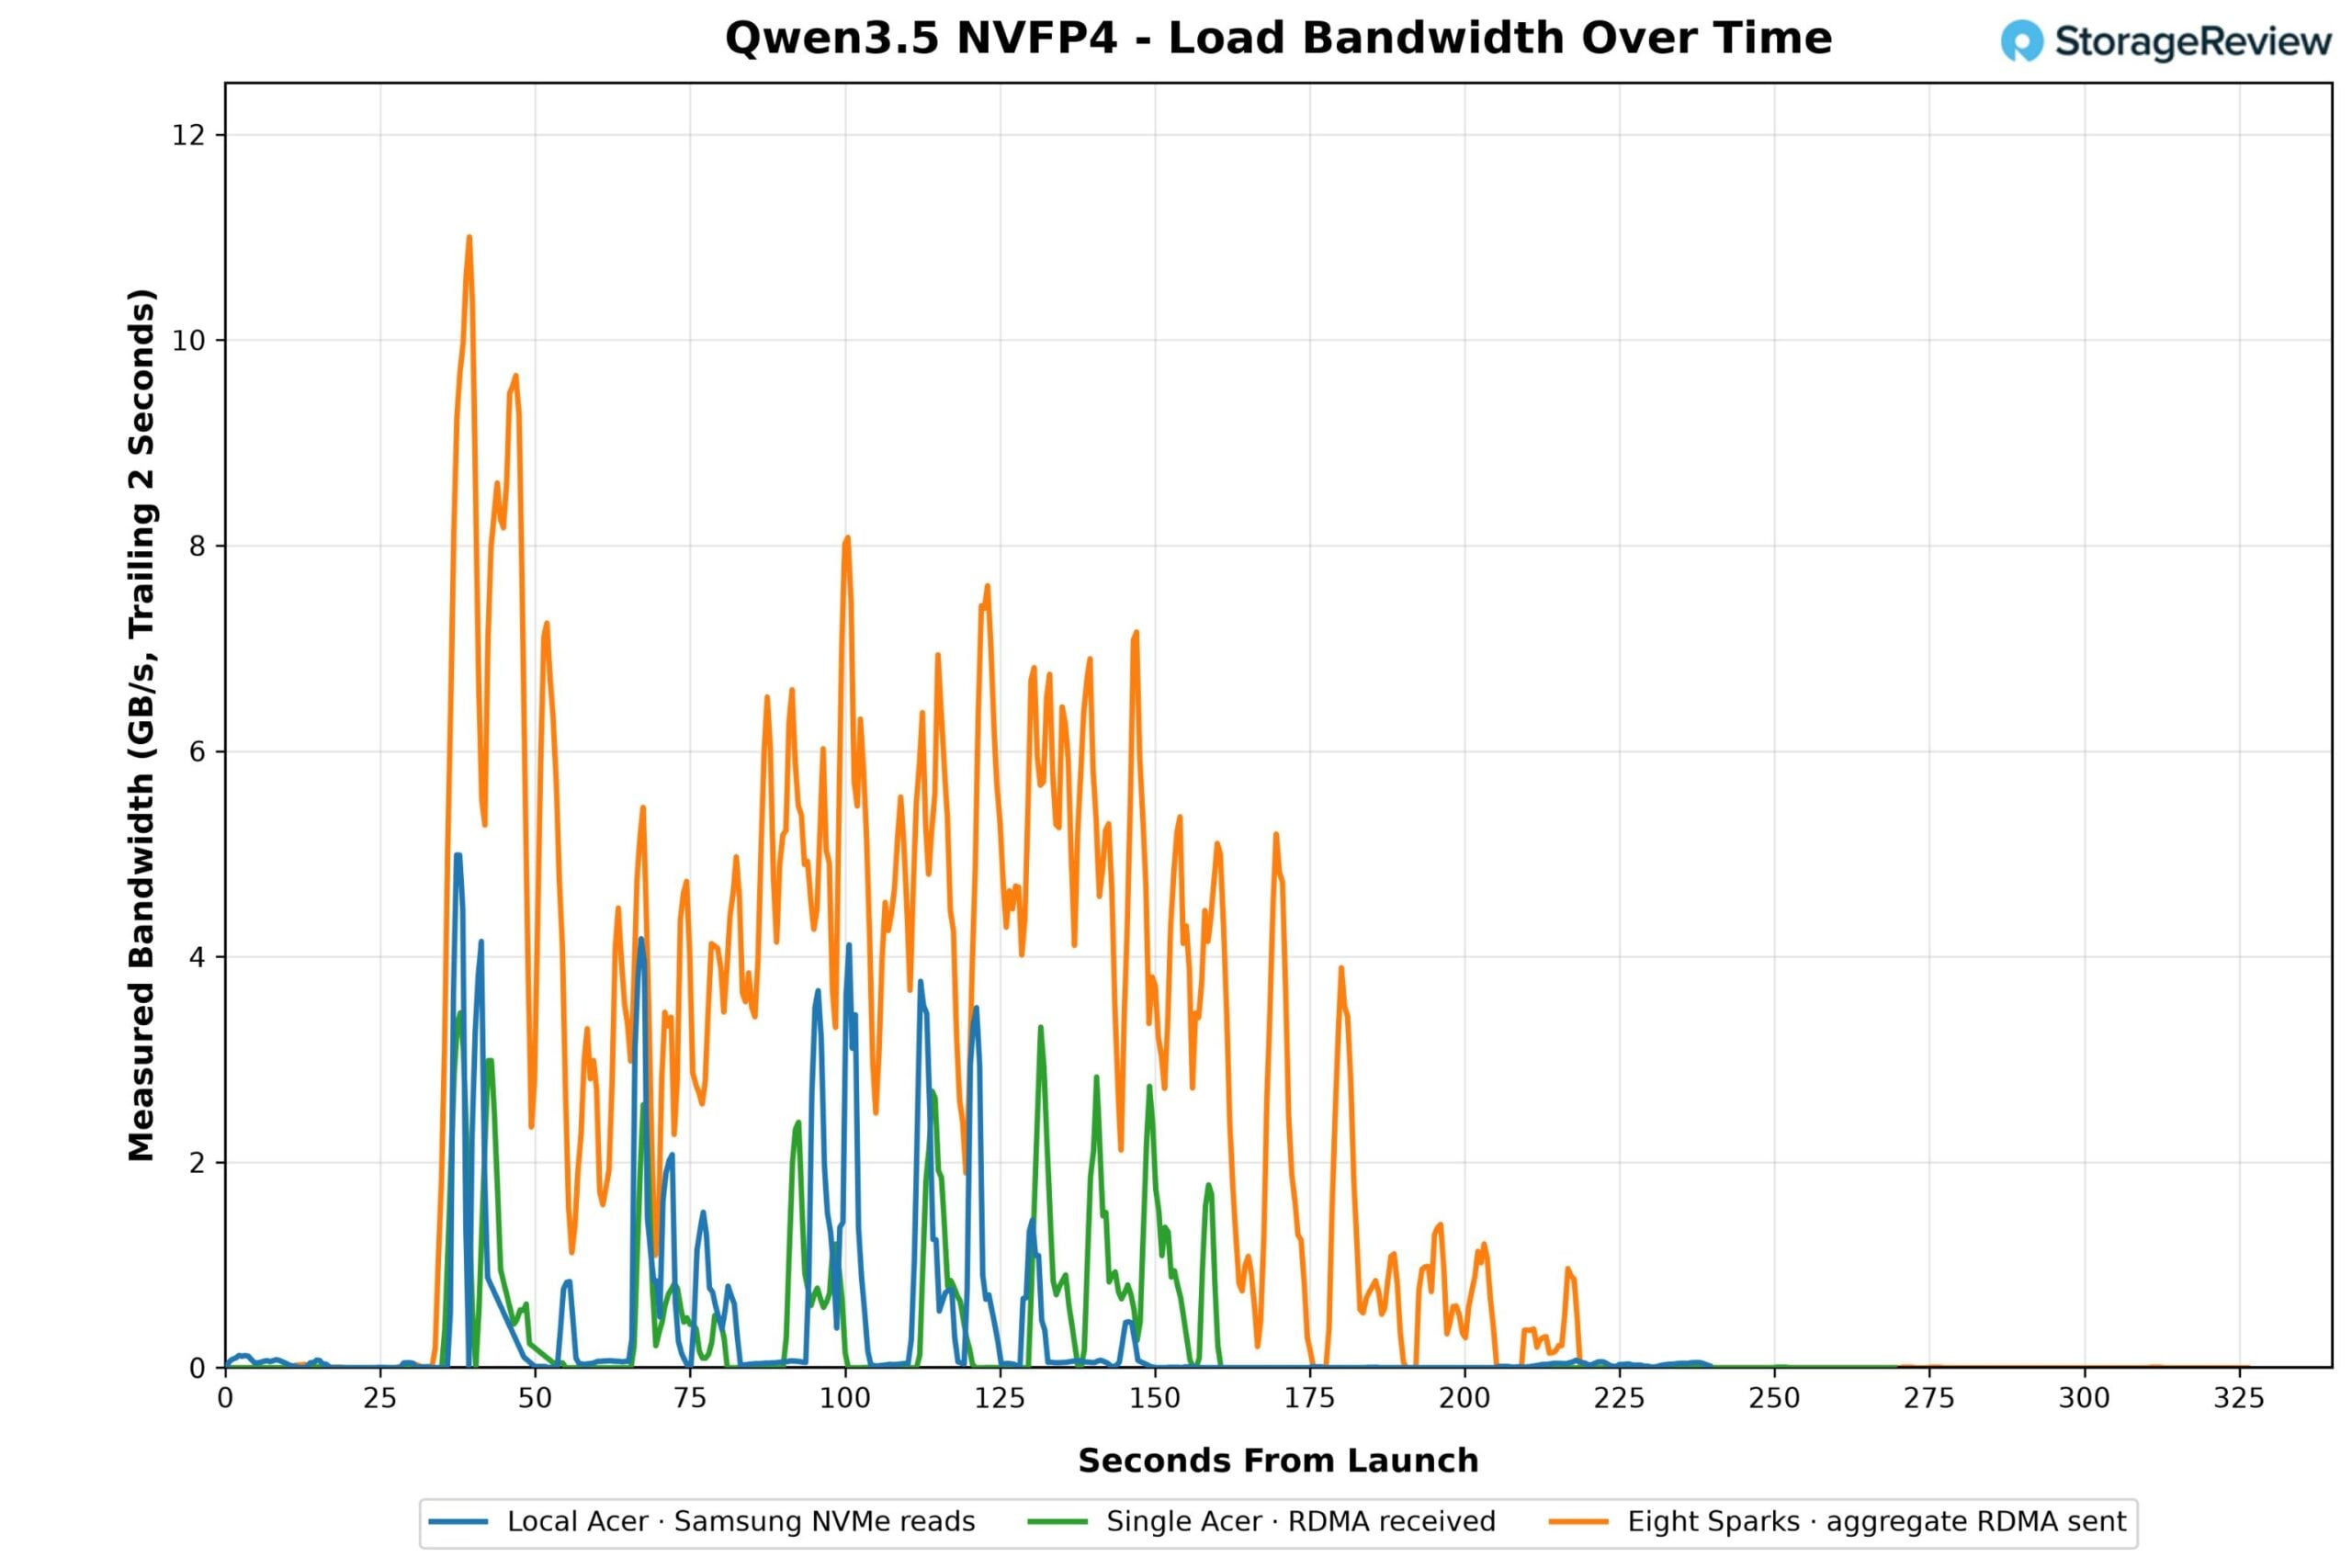
bandwidth trace က ပုံစံကို ပြသပါတယ်- local NVMe reads တွေဟာ 5GB/s နီးပါး အမြင့်ဆုံးရောက်ရှိတဲ့ burst တွေအဖြစ် ရောက်ရှိလာပြီး အကြားအကွာအဝေးရှည်ကြီးတွေ ရှိနေပါတယ်။ single NFS client ကတော့ အနည်းငယ်နိမ့်တဲ့ အမြင့်ဆုံးတွေမှာ burst ပုံသဏ္ဍာန်တူညီတာကို ပြသပါတယ်။ ရှစ်ခုပါ Spark aggregate line က concurrent demand အောက်မှာရှိတဲ့ array ကို ပြသပါတယ်။ ရှစ်ခုစလုံးဟာ တစ်ပြိုင်နက်တည်း 78GB တူညီတဲ့ array ကို ဆွဲယူနေချိန်မှာ array ဟာ ပထမမိနစ်မှာ 11GB/s အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး နောက်နှစ်မိနစ်မှာတော့ 4 နဲ့ 8GB/s အကြား တည်ငြိမ်နေခဲ့ပြီး Sparks တွေက သူတို့ရဲ့ အလေးချိန်တွေကို ဖြတ်သန်းပြီး full window တစ်လျှောက်မှာ ပျမ်းမျှ 2.08GB/s ရရှိခဲ့ပါတယ်။ 25GiB/s နဲ့ ယှဉ်ရင် fio sweep က array ဟာ ပေးပို့နိုင်တယ်ဆိုတာကို ပြသခဲ့ပြီး Sparks ရှစ်ခုက မော်ဒယ်တစ်ခုကို တစ်ပြိုင်နက် load လုပ်တဲ့အခါ ရရှိနိုင်တဲ့ ပမာဏရဲ့ အစိတ်အပိုင်းတစ်ခုကို အသုံးပြုခဲ့ပါတယ်။
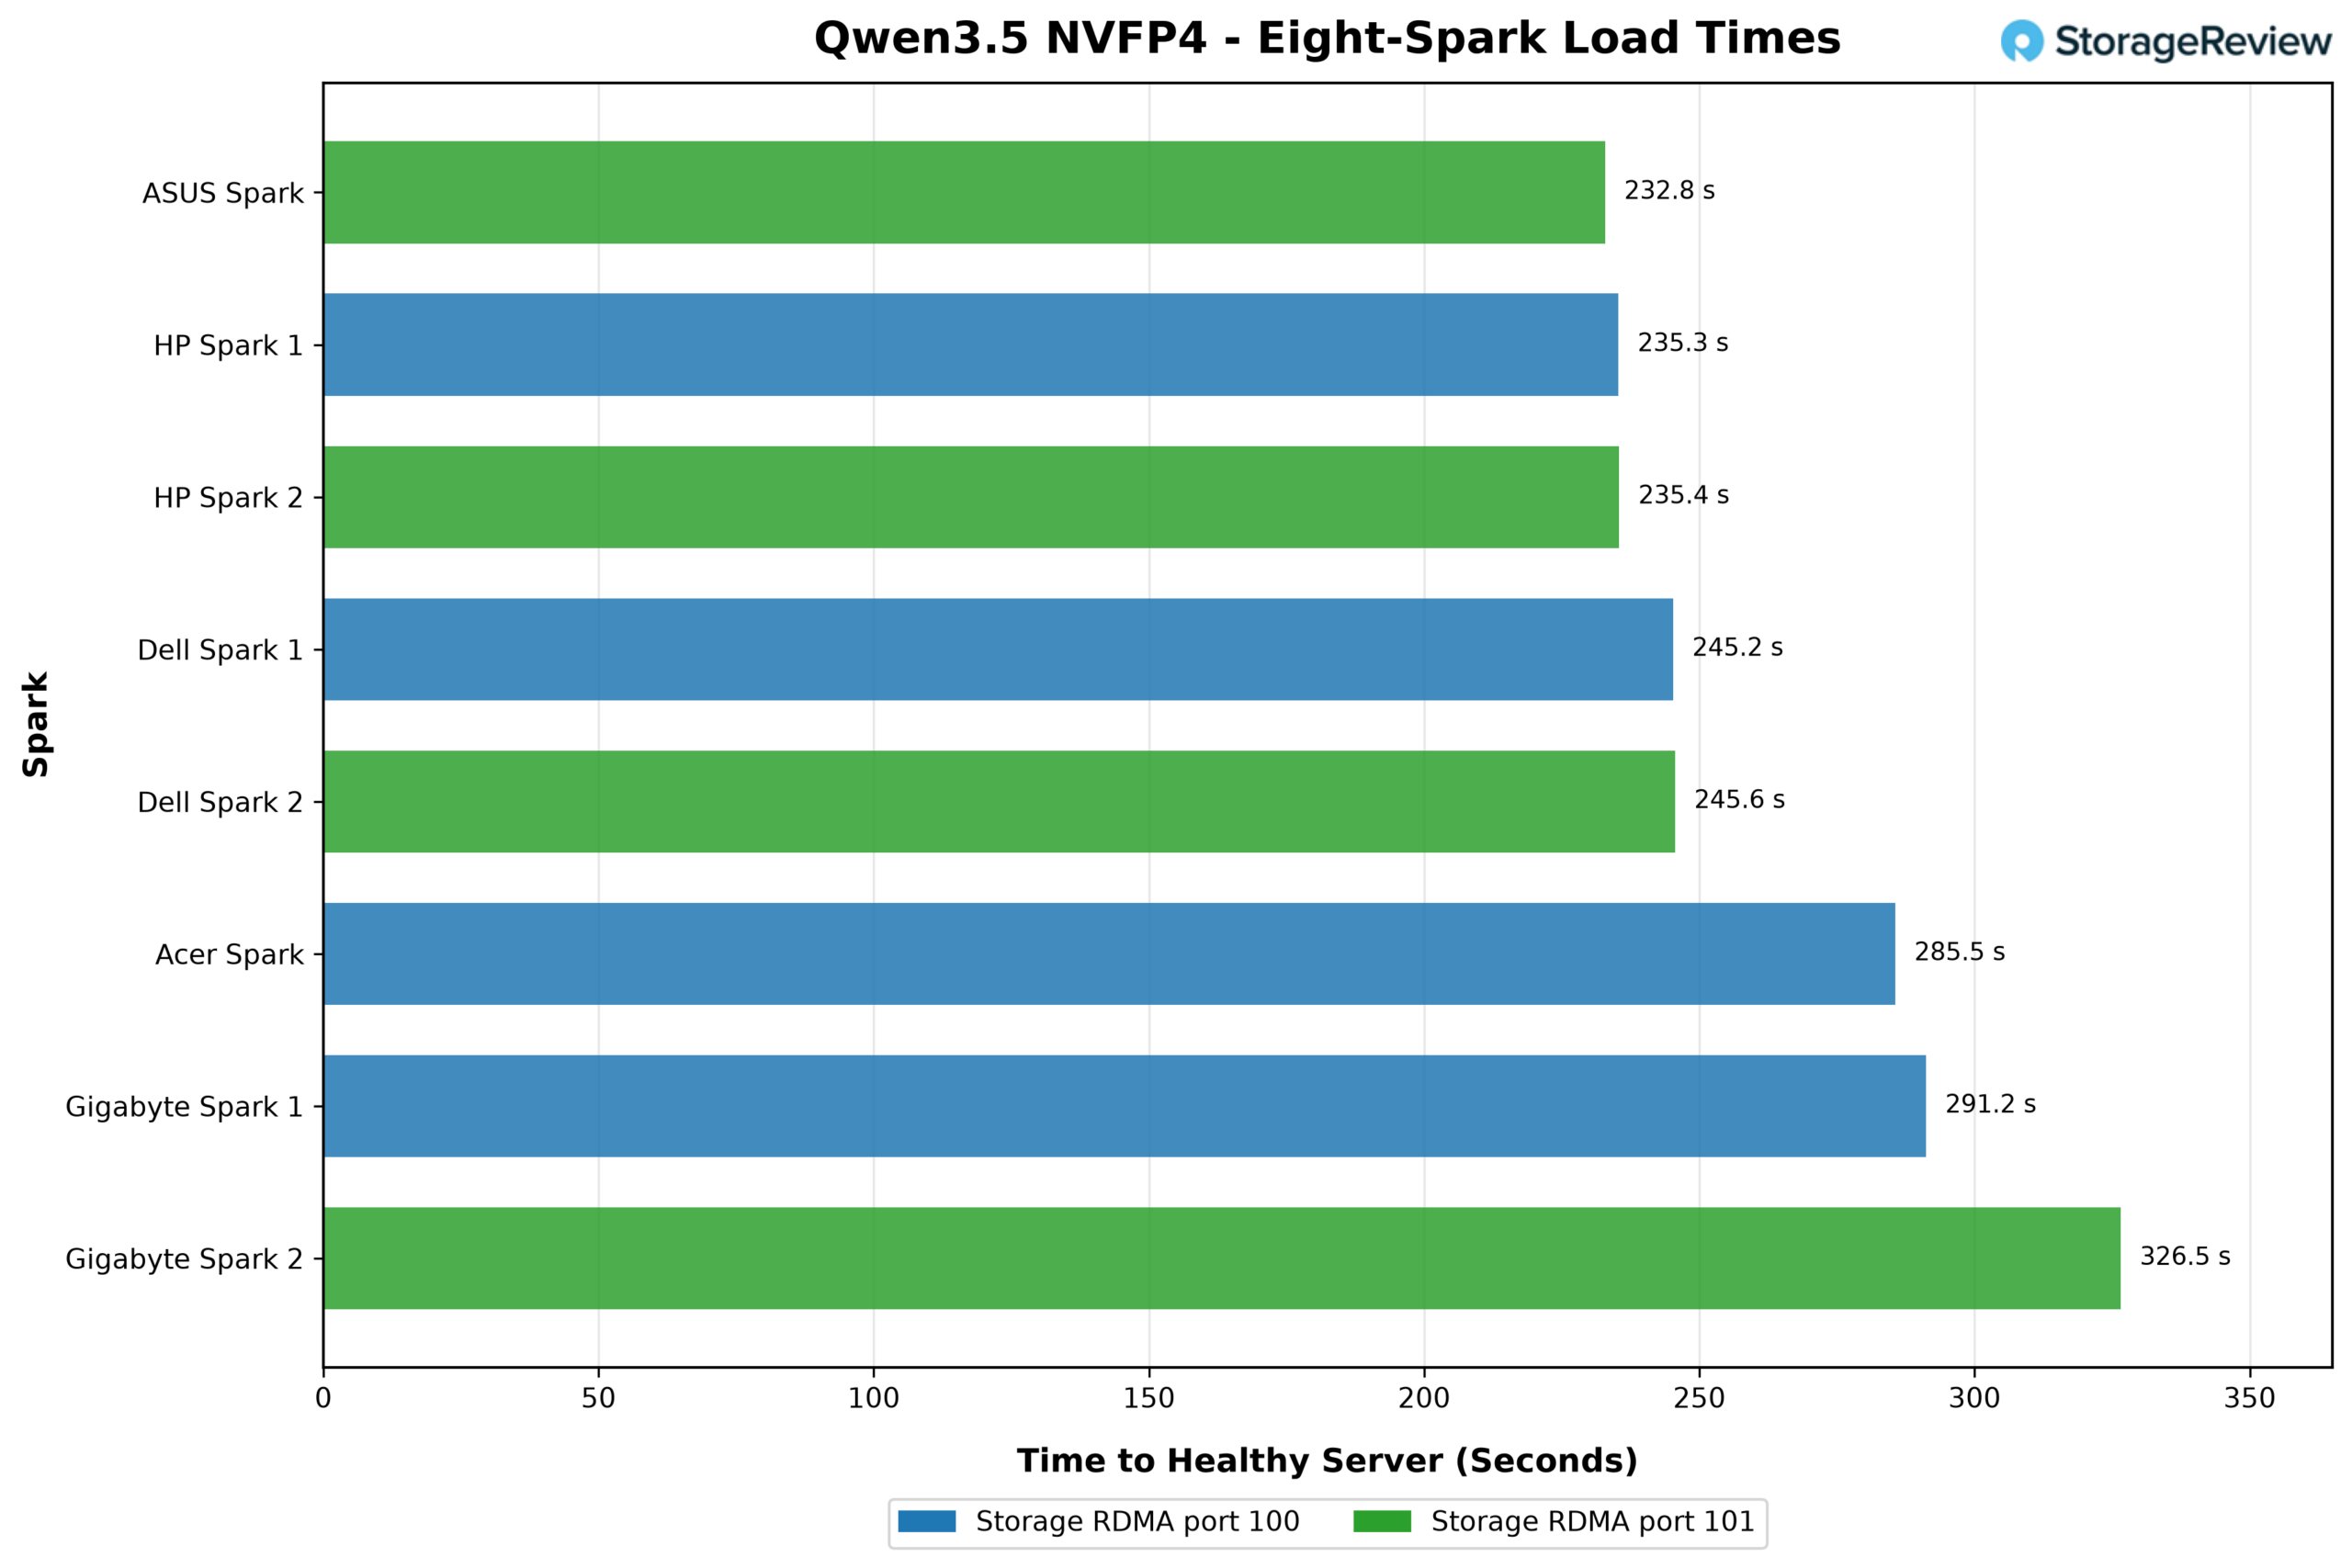
ရှစ်လမ်းစမ်းသပ်မှုတွင် ယူနစ်တစ်ခုလျှင် load time များသည် ASUS Ascent GX10 တွင် ၂၃၂.၈ စက္ကန့်မှ GIGABYTE AI TOP ATOM unit တစ်ခုတွင် ၃၂၆.၅ စက္ကန့်အထိ ရှိပြီး HP ZGX Nano G1n system နှစ်ခုသည် ၂၃၅.၃ စက္ကန့်နှင့် ၂၃၅.၄ စက္ကန့်နှင့် GB10 unit ပါ Dell Pro Max နှစ်ခုသည် ၂၄၅.၂ စက္ကန့်နှင့် ၂၄၅.၆ စက္ကန့် အသီးသီး ရှိသည်။ shared array မှ တစ်ပြိုင်နက် load လုပ်သော Sparks ရှစ်ခုအနက် ငါးခုသည် NFS/RDMA မှတစ်ဆင့် Spark loading တစ်ခုတည်းကို ကျော်လွန်ပြီး ၎င်းတို့အနက် သုံးခုသည် local NVMe run ကို ကျော်လွန်သည်။ spread သည် vendor ဇာတ်လမ်းမဟုတ်ပါ။ stack တွင် QoS မရှိသောကြောင့် မည်သည့် unit သည် array တွင် စောင့်ဆိုင်းနေရပြီး run တစ်ခုမှ တစ်ခုသို့ ပြောင်းလဲသွားပြီး storage NIC တစ်ခုစီရှိ unit နှစ်ခုသည် ဇယား၏ မြန်ဆန်သောနှင့် နှေးကွေးသောအဆုံးများတွင် ညီတူညီမျှ ခွဲဝေထားသည်။
lab တစ်ခုအတွက် ရလဒ်အနေနဲ့ array မှာ model တိုင်းရဲ့ copy တစ်ခုကို သိမ်းထားနိုင်ပြီး Spark တိုင်း ဒါမှမဟုတ် Spark တိုင်းက download step၊ local capacity သုံးစွဲမှုမရှိဘဲ local copy တစ်ခုကို load လုပ်ဖို့ ကြာမယ့်အချိန်လောက်မှာပဲ load လုပ်ပါတယ်။ desk ပေါ်မှာ weight တွေရဲ့ copy လည်း မရှိပါဘူး။
အော်ရီဂွန်ပြည်နယ်အသုံးပြုမှုကိစ္စ
Oregon State's College of Earth, Ocean and Atmospheric Sciences သည် သုတေသနသင်္ဘောပေါ်တွင် အချိန်နှင့်တပြေးညီ သမုဒ္ဒရာသုတေသန မှသည် Metrum AI ဖြင့် AI အကူအညီဖြင့် ပညာရေးဆိုင်ရာ အကဲဖြတ်ခြင်း အထိ ကျွန်ုပ်တို့၏ AI အခြေခံအဆောက်အအုံလုပ်ငန်းတွင် အထပ်ထပ်ပူးပေါင်းဆောင်ရွက်သူတစ်ဦးဖြစ်သည် ။ OSU ၏ သုတေသနနှင့် ပညာရေးဆိုင်ရာ ကွန်ပျူတာဒါရိုက်တာ Chris Sullivan နှင့် ၎င်း၏ဗိသုကာပညာရှင် Thomas Olson တို့သည် ယူနစ် ၁၀၀ အထိ တိုးချဲ့နိုင်သော AI သင်ယူမှုအတွက် ကြီးမားသော Spark ဓာတ်ခွဲခန်းတစ်ခုကို စူးစမ်းလေ့လာနေပြီး သိုလှောင်မှုအကြောင်း ၎င်းတို့၏ တွေးခေါ်မှုသည် ကျွန်ုပ်တို့၏ ဒီဇိုင်းကို နည်းလမ်းနှစ်ခုဖြင့် အထောက်အကူပြုခဲ့သည်။
ပထမဦးစွာ၊ သိုလှောင်မှုသည် Sparks နှင့် လွတ်လပ်ရမည်။ OSU သည် Sparks များတစ်လျှောက် ဖြန့်ကျက်ထားသော ဖိုင်စနစ်တစ်ခုကို ထည့်သွင်းစဉ်းစားခဲ့ပြီး node တစ်ခုတည်းကို ထည့်သွင်းခြင်း သို့မဟုတ် ဖယ်ရှားခြင်းသည် အားလုံးအတွက် သိုလှောင်မှုဝန်ဆောင်မှုကို အနှောင့်အယှက်ဖြစ်စေမည်ဖြစ်သောကြောင့် အတန်းတစ်တန်းအတွက် ငြင်းပယ်ခဲ့သည်။ မည်သည့် Spark mount မဆို Spark တစ်ခုကို ထည့်သွင်းခြင်း၊ ဖယ်ရှားခြင်း၊ ပြန်လည်ပုံဖော်ခြင်း သို့မဟုတ် အခြားကျောင်းသားတစ်ဦးထံ လွှဲပြောင်းပေးခြင်းတို့ကို ဆိုလိုသည်။ ဒုတိယအချက်အနေဖြင့်၊ သိုလှောင်မှုသည် အသုံးပြုသူကို လိုက်နာရမည်။ OSU လိုအပ်ချက်ကို AI ရည်ရွယ်ချက်များအတွက် ဖိုင်မျှဝေမှုများ၏ မြှင့်တင်ထားသော ဗားရှင်းတစ်ခုအဖြစ် ကျွန်ုပ်တို့ ဖော်ပြထားပြီး ကျောင်းသားများသည် စနစ်များအကြား ရွေ့လျားနေစဉ်တွင် persistent အချက်အလက်များကို သိမ်းဆည်းသည်။ NFS ဖြင့် ၎င်းသည် ကျောင်းသားတစ်ဦးစီအတွက် folder တစ်ခုဖြစ်သည်။ မည်သည့် Spark ထဲသို့မဆို login ဝင်ပြီး share ကို mount လုပ်ပါ၊ ထို့နောက် သင်၏အလုပ်သည် ထိုနေရာတွင် ရှိနေသည်။
Home-directory server ထက် OSU အတွက် ဒါက ပိုအရေးကြီးတဲ့ အကြောင်းရင်းက dataset တွေပါ။ College of Earth, Ocean, and Atmospheric Sciences က ကျောင်းသားတွေ ကိုယ်ပိုင်သုတေသနအတွက် terabyte ဆယ်ဂဏန်းနဲ့ တိုင်းတာထားတဲ့ သုတေသနဒေတာ၊ သမုဒ္ဒရာဗေဒနဲ့ လေထုဆိုင်ရာ စုဆောင်းမှုတွေကို ရရှိနိုင်စေချင်ပါတယ်။ စားပွဲဘေးသိုလှောင်မှုမှာ ဒီလိုဗားရှင်းမျိုး မရှိပါဘူး- 4TB M.2 slot က အဲဒီစုဆောင်းမှုတွေထဲက တစ်ခုကိုမှ မသိမ်းဆည်းနိုင်ပါဘူး၊ ပြီးတော့ ပြင်ပအကာအရံတွေနဲ့ ပြည့်နေတဲ့ ဓာတ်ခွဲခန်းတောင်မှ စားပွဲတိုင်းအတွက် မိတ္တူတစ်ခုဝယ်ပြီး မိတ္တူတိုင်းကို လက်ရှိအတိုင်း ထိန်းသိမ်းထားရမယ်လို့ ဆိုလိုပါတယ်၊ ဘယ်ဌာနမှ မတတ်နိုင်ပါဘူး။ array မှာ ဒေတာကို တစ်ကြိမ် hosting လုပ်ပြီး 100GbE မှာ mount လုပ်တာက ကျွန်တော်တို့ရဲ့ အကဲဖြတ်ချက်မှာ အဲဒီလိုအပ်ချက်နဲ့ ကိုက်ညီတဲ့ ချဉ်းကပ်မှုပါ။ တူညီတဲ့ array က model library ကို host လုပ်တာကြောင့် ကျောင်းသားတွေက သူတို့ရဲ့ session ကို download လုပ်စရာမလိုဘဲ Qwen, Llama ဒါမှမဟုတ် တခြား model တွေကို run ပါတယ်။ developer workstation တွေအဖြစ် desktop AI system တွေကို ဖြန့်ကျက်တဲ့ enterprise အတွက်လည်း အလားတူ နိယာမ သက်ရောက်ပါတယ်- production dataset ကို မြန်နှုန်းမြင့် network ပေါ်မှာ mount လုပ်ပြီး system ကို နေရာမှာ အလုပ်လုပ်ခိုင်းပါ၊ ဒါကြောင့် desktop စက်တွေမှာ ဖတ်စရာတစ်ခုခုရှိအောင် ဒုတိယ data lake တစ်ခု ထားရှိဖို့ မလိုအပ်တော့ပါဘူး။ ဒေတာသည် ဒေတာစင်တာတွင် ရှိနှင့်ပြီးသား ဝင်ရောက်ခွင့်ထိန်းချုပ်မှုများ၊ ကုဒ်ဝှက်ခြင်းနှင့် အရန်ကူးယူခြင်းစနစ်များအောက်တွင် ရှိနေမည်ဖြစ်ပြီး Spark သည် တံခါးမှထွက်သွားသောအခါတွင် အရေးမကြီးသောအရာများကို မသိမ်းဆည်းထားပါ။
ကောက်ချက်
Deskside AI ဟာ့ဒ်ဝဲဟာ အရာအားလုံးမှာ ကောင်းမွန်ပေမယ့် အဖွဲ့အစည်းတစ်ခုရဲ့ ဒေတာပိုင်ဆိုင်မှုရဲ့ အစိတ်အပိုင်းတစ်ခုဖြစ်ဖို့အတွက်တော့ သိပ်မကောင်းပါဘူး။ GB10 စနစ်တိုင်းမှာရှိတဲ့ M.2 slot တစ်ခုတည်းက အဲဒါကို သေချာစေပါတယ်။ အသုံးပြုသူ လိုအပ်တဲ့အရာမှန်သမျှကို local flash ပေါ် ကူးယူပြီး IT မမြင်ရအောင်၊ ကာကွယ်မထားဘဲ တခြား desk တိုင်းမှာ မိတ္တူကူးထားသလို ဖြစ်နေပါတယ်။ Spark တစ်ခုတည်းအတွက် external local storage box တစ်ခုဟာ ကျိုးကြောင်းဆီလျော်တဲ့ အဖြေတစ်ခုပါ။ ဓာတ်ခွဲခန်းတစ်ခု၊ ဌာနတစ်ခု ဒါမှမဟုတ် ဒါဇင်ပေါင်းများစွာနဲ့ ဒါတွေကို ဖြန့်ကျက်နေတဲ့ လုပ်ငန်းတစ်ခုအတွက် ကိုယ်ပိုင်ဒေတာရှိတဲ့ desk တိုင်းမှာ silo တစ်ခုဖြစ်ပြီး အဖြေကတော့ data center က လွန်ခဲ့တဲ့နှစ်တွေကတည်းက ရောက်ရှိလာခဲ့တဲ့ silo ပါပဲ။ မြန်နှုန်းမြင့်ကွန်ရက်တစ်ခုရဲ့နောက်ကွယ်မှာ စွမ်းရည်ကို ထားရှိပြီး တစ်ကြိမ်တည်း အုပ်ချုပ်ပြီး မျှဝေပါ။ Sparks မှာ မြန်နှုန်းမြင့်ကွန်ရက်ရှိပြီးသားပါ။ ဒီပရောဂျက်မှာ တစ်နေရာရာကို သွားဖို့ပေးလိုက်တဲ့အခါ ဘာတွေဖြစ်လာလဲဆိုတာကို ပြသထားပြီး Sparks ကိုယ်တိုင်က ဘေးနားက rack မှာ ပါဝင်သင့်တယ်ဆိုတာကိုလည်း ဖော်ပြထားပါတယ်။
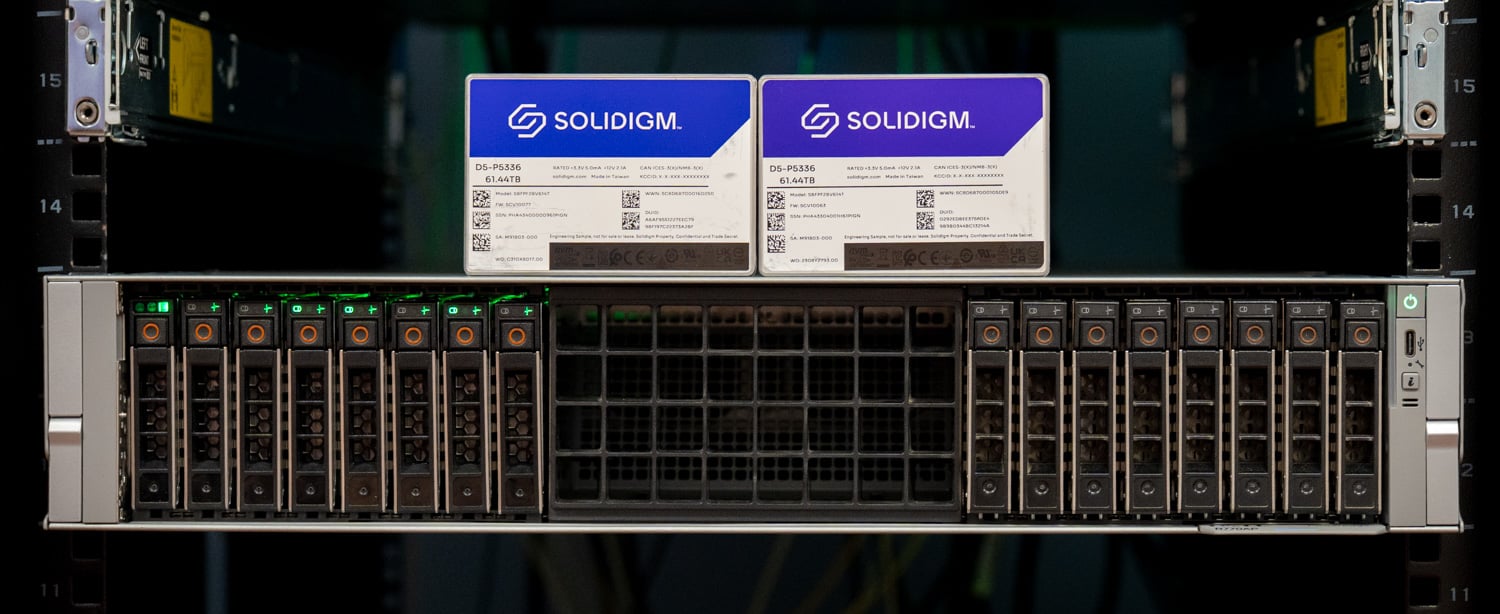
Dell server တစ်ခုရဲ့ Graid RAID 5 မှာရှိတဲ့ Solidigm D5-P5336 QLC drive ရှစ်ခုက Sparks ရှစ်ခုကို single parity-protected dataset တစ်ခုပေးခဲ့ပါတယ်။ Broadcom 400GbE NIC နှစ်ခုနဲ့ 800G breakout ပါတဲ့ Dell Z9864F-ON တစ်ခုက Sparks ရှစ်ခုကို 100GbE တစ်ခုစီပေးခဲ့ပါတယ်။ Tuxera ရဲ့ Fusion NFS over RDMA က အဲဒီစွမ်းရည်ကို stock Ubuntu မှာ access control အတွက် directory-service hooks တွေနဲ့ one-line mount တစ်ခုဖြစ်အောင် ပြုလုပ်ပေးခဲ့ပါတယ်။ ရှစ်ခုလုံးမှာ ပျံ့နှံ့နေတဲ့ fixed load အောက်မှာ array ဟာ aggregate sequential read 24.9GiB/s ကို ပေးပို့ခဲ့ပြီး QoS မရှိဘဲ ညီတူညီမျှ ခွဲဝေပေးခဲ့ပြီး Spark တစ်ခုတည်းကပဲ သူ့ရဲ့ link ကို 10.8GiB/s နဲ့ saturate လုပ်ခဲ့ပြီး ကျွန်တော်တို့စမ်းသပ်ဖူးသမျှ GB10 system မှာ အကောင်းဆုံး internal drive လောက်မြန်ပါတယ်။ အဲဒီ ceiling ဟာ server-side NIC နှစ်ခုသယ်ဆောင်နိုင်တဲ့ပမာဏရဲ့ 27% ကို အသုံးပြုခဲ့တာကြောင့် network ကို ဒီတစ်ခုထက် ပိုပြည့်စုံတဲ့ server အတွက် အရွယ်အစားသတ်မှတ်ထားပါတယ်။ မော်ဒယ်စမ်းသပ်မှုက workflow ကို အတည်ပြုခဲ့သည်- shared array တွင် တစ်ကြိမ် host လုပ်ထားသော 78GB မော်ဒယ်သည် local NVMe ၏ 13% အတွင်း Spark တစ်ခုတွင် load လုပ်ကာ Spark ရှစ်ခုတွင် တစ်ပြိုင်နက် load လုပ်ကာ ရှစ်ခုအနက် ငါးခုသည် solo NFS run ထက် ပိုမိုမြန်ဆန်စွာ ပြီးဆုံးသည်။
QLC flash က ဒီစီးပွားရေးတွေကို အလုပ်ဖြစ်စေပါတယ်၊ ဘာလို့လဲဆိုတော့ workload က capacity-weight များပြီး read-weight များတာကြောင့်၊ D5-P5336 ရဲ့ အားသာချက်က စွမ်းဆောင်ရည်မြင့်မားပြီး server တစ်ခုတည်းက Sparks ရာပေါင်းများစွာ ဒေသတွင်းမှာ မသယ်ဆောင်နိုင်တဲ့ အရာတွေကို သိမ်းဆည်းထားနိုင်ပြီး၊ အရာအားလုံးရဲ့ မိတ္တူတစ်ခုစီနဲ့ မိတ္တူတိုင်းကို data center ရဲ့ ထိန်းချုပ်မှုအောက်မှာ သိမ်းဆည်းထားနိုင်ပါတယ်။ Oregon State မှာ မစောင့်နိုင်တဲ့ အလုပ်တွေအတွက် production research storage ရှိပါတယ်။ Chris Sullivan နဲ့ Thomas Olson တို့ စူးစမ်းလေ့လာနေတဲ့ concept က ဒီနေ့ခေတ်မှာ မရှိတဲ့ ပညာရေးအဆင့်တစ်ခုပါ- server တစ်ခုနဲ့ high-capacity drive အနည်းငယ်နဲ့ တည်ဆောက်ထားတဲ့ Sparks rack တစ်ခု ဒါမှမဟုတ် တစ်ခုထက်ပိုတဲ့ အရွယ်အစားရှိတဲ့ အုပ်ချုပ်မှုရှိတဲ့ shared pool တစ်ခုဖြစ်ပြီး Sparks အသုံးပြုတဲ့ fabric တစ်ခုတည်းပေါ်မှာ ကြီးမားတဲ့ AI learning lab တစ်ခုရှေ့မှာ တကယ့် oceanographic နဲ့ atmospheric data တွေကို terabyte ဆယ်ဂဏန်းလောက် ထားရှိနိုင်ပါတယ်။
ဤအစီရင်ခံစာကို Solidigm မှ ကမကထပြုပါသည်။ ဤအစီရင်ခံစာတွင် ဖော်ပြထားသော အမြင်များနှင့် ထင်မြင်ယူဆချက်အားလုံးသည် ထည့်သွင်းစဉ်းစားနေသော ထုတ်ကုန်(များ)အပေါ် ကျွန်ုပ်တို့၏ ဘက်မလိုက်သော အမြင်ပေါ်တွင် အခြေခံထားပါသည်။
ဤဆောင်းပါးရှိ စီးပွားဖြစ်ထုတ်ကုန်များအကြောင်း ရည်ညွှန်းချက်များသည် သတင်းအချက်အလက် ရည်ရွယ်ချက်အတွက်သာဖြစ်ပြီး Oregon State University မှ ထောက်ခံချက်မဟုတ်ပါ။



 အမေဇုံ