

Firma NVIDIA dodała konfigurację zunifikowanej pamięci DGX Spark z 64 GB , w cenie od 4,999 USD, dostępną wyłącznie u producentów Acer, ASUS, Dell, Gigabyte, HP i MSI od 23 października. Nowy model SKU zawiera ten sam układ GB10 Grace Blackwell Superchip, sieć ConnectX-7, system operacyjny DGX OS i pakiet oprogramowania NVIDIA AI, co model 128 GB. NVIDIA twierdzi, że sam model 64 GB obsługuje modele do 100 miliardów parametrów do lokalnego wnioskowania, precyzyjnego dostrajania i przepływów pracy agentów bez konieczności przesyłania danych do chmury.
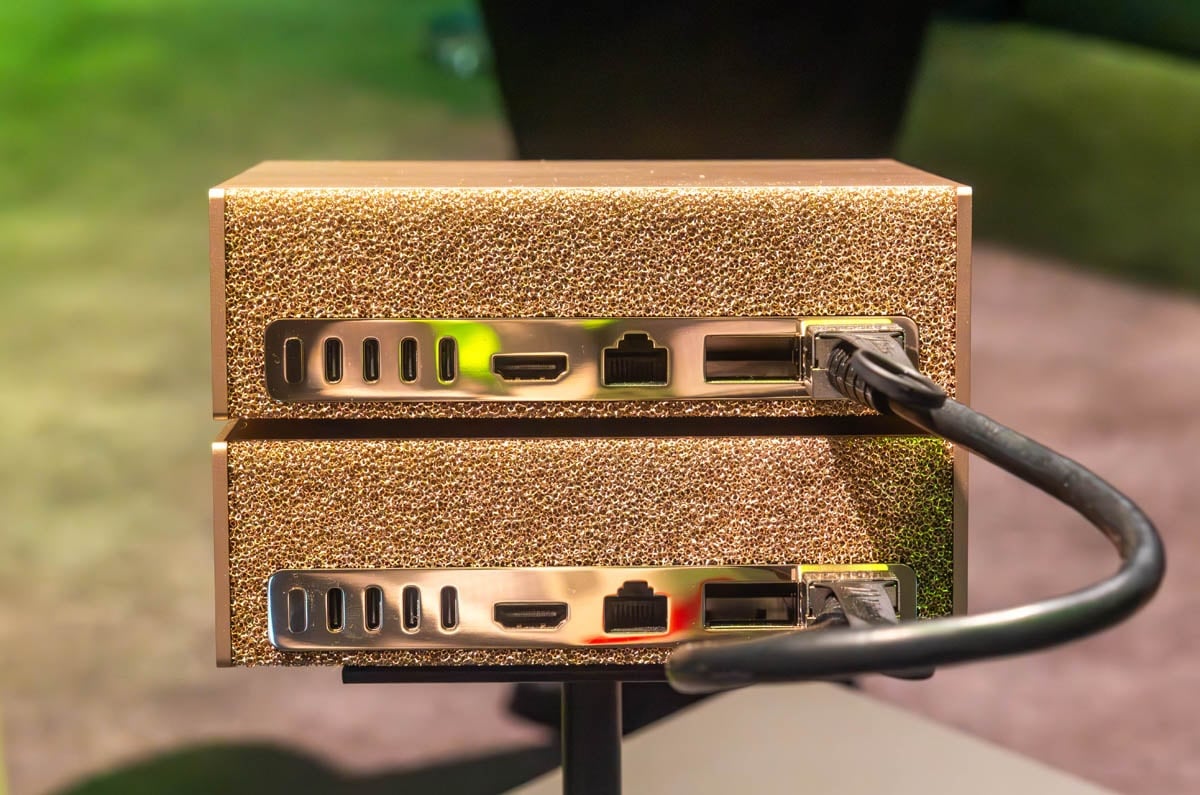
Dwa dyski Spark 64 GB dla jednego klastra 128 GB
Argumentem przemawiającym za tańszą jednostką (w porównaniu z cenami rynkowymi większego modelu) jest to, że dwa z nich w klastrze radzą sobie całkiem dobrze. Każdy DGX Spark ma wbudowaną kartę sieciową ConnectX-7, więc para łączy się bezpośrednio przez kabel QSFP na łączu 200 GbE, bez przełączania między nimi. Asystent klastra NVIDIA Sync obsługuje wykrywanie urządzeń, weryfikuje konfigurację urządzeń i konfiguruje sieć ConnectX-7. Dwie jednostki 64 GB łączą się w 128 GB zunifikowanej pamięci, co według NVIDIA wystarcza do obsługi modeli obsługujących do 200 miliardów parametrów.
Wewnętrzne obliczenia firmy NVIDIA dotyczące parowania wykorzystują Qwen3.8 27B: dwa klastrowane systemy 64 GB zapewniły do 1.7 razy większą wydajność niż pojedynczy system 128 GB. Ponieważ każdy węzeł korzysta z tych samych bibliotek CUDA, silników inferencyjnych i obrazu systemu operacyjnego DGX, obciążenie obejmuje obie jednostki bez konieczności przebudowywania środowiska programowego. Obsługiwane frameworki inferencyjne obejmują llama.cpp, Ollama, vLLM i LM Studio. Firma NVIDIA przygotowała krótki film na temat łączenia dwóch urządzeń Spark za pomocą NVIDIA Sync.
Uruchomiliśmy rozproszony klaster wnioskowania na jednostkach Dell, Gigabyte i HP DGX Spark , a ostatnio umieściliśmy współdzieloną pamięć masową za klastrem Spark o przepustowości 100 GbE . Wersja 64 GB obniża cenę początkową takiej konfiguracji, a kompromisem jest to, że pojedyncza jednostka ma teraz połowę pamięci oryginału.
NVIDIA Sync Model Launcher pojawi się pod koniec października
Druga część ogłoszenia dotyczy oprogramowania. NVIDIA Sync Model Launcher, którego premiera planowana jest na koniec października, pobiera i uruchamia model na pojedynczym serwerze Spark lub parze klastrów, na przykładzie Qwen3.8 27B, i udostępnia wynikowy punkt końcowy komputerom programistów w sieci. Może również skonfigurować OpenCode dla tego modelu, dzięki czemu programiści mogą kodować z poziomu przeglądarki, a klaster Spark przeprowadza wnioskowanie.
Systemy 64 GB są dostarczane z tym samym oprogramowaniem, co model 128 GB: systemem operacyjnym DGX OS, bibliotekami sztucznej inteligencji CUDA-X, zestawem narzędzi NVIDIA Agent Toolkit, otwartymi modelami Nemotron oraz środowiskami uruchomieniowymi, takimi jak Ollama, vLLM i PyTorch z CUDA. NVIDIA pozycjonuje urządzenie jako lokalną platformę dla agentów, wnioskowania, dostrajania, analizy danych i rozwoju brzegowego, a port ConnectX-7 umożliwia późniejsze dodanie drugiego urządzenia. Twórcy agentów, NVIDIA wskazuje na swoje podręczniki dla NemoClaw, OpenClaw, Hermes Agent i OpenShell na stronie build.nvidia.com jako punkt wyjścia.


 Amazon