

Systemy sztucznej inteligencji typu Deskside oparte na procesorze GB10 firmy NVIDIA mają jedno zadanie i wykonują je dobrze: umieścić 128 GB zunifikowanej pamięci i petaflop mocy obliczeniowej na biurku wystarczająco blisko osoby, która z nich korzysta, aby iteracja była natychmiastowa. Brakuje im jednak połączenia z pamięcią masową, którą organizacja już posiada. Każdy wariant DGX Spark i OEM jest dostarczany z jednym, krótkim gniazdem M.2, które ogranicza lokalną pojemność do około 4 TB i umieszcza każdy zestaw danych, model i punkt kontrolny na tej maszynie poza systemem zarządzania, kontroli dostępu, kopii zapasowej i ścieżki audytu, które znajdują się w centrum danych. Pomnóż to przez laboratorium, wydział lub kampus, a otrzymasz dziesiątki odizolowanych wysp o pojemności 4 TB, z których każda zawiera własną kopię tych samych modeli i zestawów danych, a każda jest tak bezpieczna, jak biurko, na którym stoi.
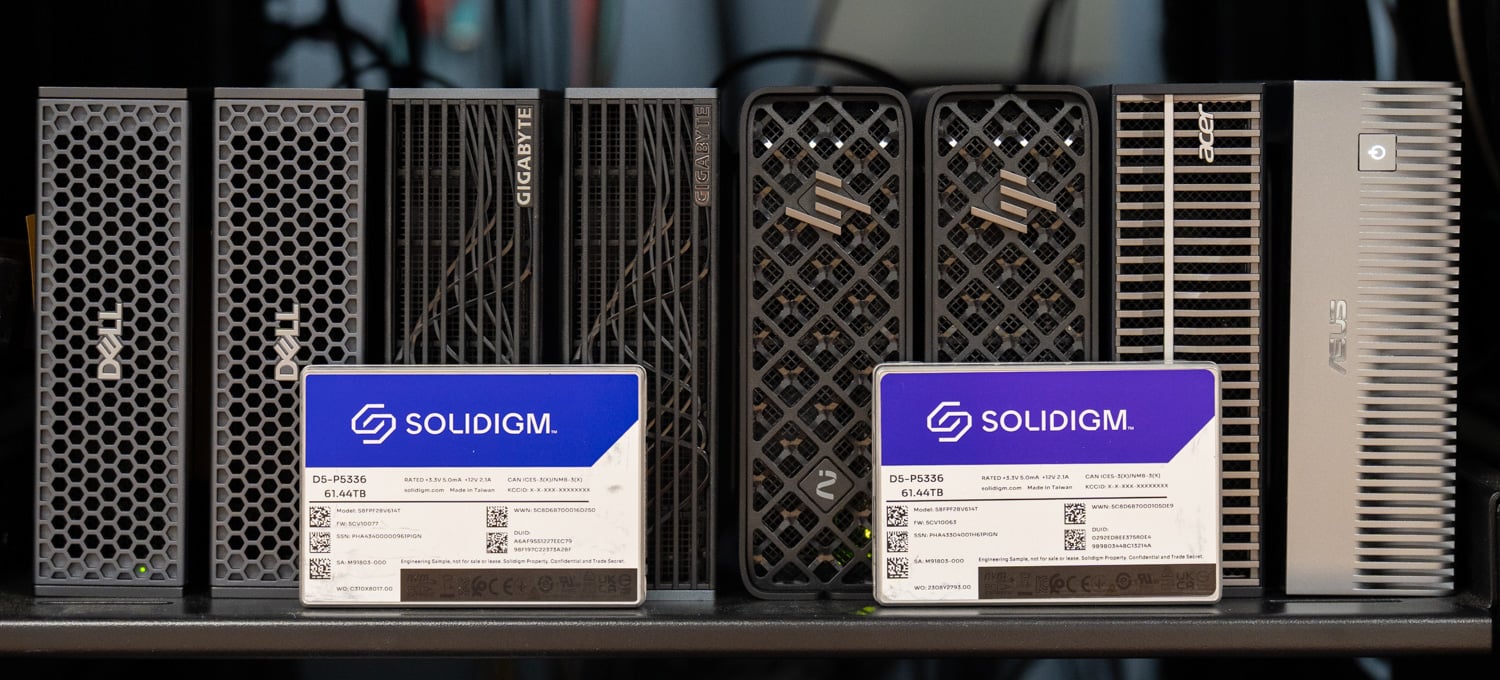
Ten projekt przenosi problem pamięci masowej z powrotem do centrum danych. Zbudowaliśmy host współdzielonej pamięci masowej DGX Spark, wykorzystując punkt dostępowy Dell PowerEdge R770AP, osiem dysków SSD Solidigm D5-P5336 QLC w konfiguracji Graid SupremeRAID RAID 5, sieć Broadcom 400GbE oraz Tuxera Fusion obsługujący NFS przez RDMA, a następnie podłączyliśmy osiem urządzeń Spark do portów 100GbE. Każdy serwer Spark w strukturze wykorzystuje tę samą zarządzaną pulę pamięci masowej z ochroną parzystości, z jednym połączeniem; pojedyncza kopia każdego modelu i zestawu danych obsługuje je wszystkie, żadna stacja robocza nie potrzebuje więcej pamięci masowej niż jest fabrycznie zainstalowana, a same urządzenia Spark mogą być umieszczone w szafie rack obok macierzy, gdzie łatwiej je zabezpieczyć, schłodzić i udostępnić. Celem tej konfiguracji jest miejsce przechowywania danych, a rolę tę może pełnić dowolny serwer NVMe z szybkimi kartami sieciowymi. Oregon State University, który rozważa stworzenie laboratorium Spark na dużą skalę do nauki sztucznej inteligencji i chce zapewnić studentom dostęp do zbiorów danych badawczych mierzonych w dziesiątkach terabajtów, podzielił się z nami swoimi przemyśleniami podczas projektowania, a w przypadku danych o takiej skali współdzielona pamięć masowa okazała się podejściem, które pasowało do tej oceny.
Na wynos
- Jedna tablica, osiem Sparków, brak oprogramowania klienckiego: Osiem komputerów DGX Spark od pięciu producentów OEM montuje udziały NFS/RDMA z pojedynczej macierzy Solidigm D5-P5336 QLC za systemem Graid SupremeRAID i Tuxera Fusion, za pośrednictwem portów 100GbE, które już posiadają, z montażem jednoliniowym w standardowym systemie Ubuntu.
- Modele hostowane ładują się podobnie jak lokalne: Model Qwen3.5-122B-A10B-NVFP4 o pojemności 78 GB załadował się z współdzielonej macierzy w 269.6 sekundy na jednym dysku Spark, co stanowiło 13% z 239.6 sekund, jakich ten sam dysk Spark potrzebował na swoim wewnętrznym dysku NVMe. Natomiast osiem dysków Spark ładujących tę samą pojedynczą kopię jednocześnie osiągnęło czas od 232.8 do 326.5 sekundy.
- Jedna kopia zastępuje silos na każdym biurku: Modele i zestawy danych w kontrolowanej, zabezpieczonej parzystością pamięci masowej w centrum danych zastępują kopie danych dla każdej stacji roboczej na dyskach M.2 o pojemności 4 TB. Dzięki temu wykorzystanie rośnie, kopiowane dane maleją, a Spark nie potrzebuje rozbudowy pamięci masowej ani miejsca na biurku. W przypadku laboratorium uczenia się sztucznej inteligencji na dużą skalę, takiego jak to, które bada Oregon State, gdzie zbiory danych badawczych osiągają rozmiary dziesiątek terabajtów, jest to podejście, które pasuje do przypadku użycia w naszej ocenie.
- Napędy wyznaczają pułap, a sieć ma zapas mocy: Przy jednoczesnym odczycie wszystkich ośmiu dysków Spark, ośmiodyskowa macierz RAID 5 osiągnęła prędkość zbliżoną do 25 Gb/s, czyli około 214 Gb/s, co stanowiło 27% z 800 Gb/s, jakie mogą obsłużyć dwie karty sieciowe Broadcom BCM57608 w hoście. Jeden odczyt Spark z macierzy z prędkością 10.8 Gb/s odpowiada najszybszemu wewnętrznemu dyskowi M.2, jaki zmierzyliśmy w systemie GB10.
- Zarządzanie jest częścią protokołu: NFS z RDMA umieszcza foldery dla poszczególnych użytkowników, współdzielone zestawy danych i hostowane modele w jednej przestrzeni nazw z obsługą Active Directory, Kerberos i haków LDAP, co pozwala na zachowanie danych pod kontrolą centrum danych, gdy urządzenia Spark są umieszczane w szafie.
Problem z wyspą AI na każdym biurku
DGX Spark i jego wersje OEM od Dell, GIGABYTE, HP, Acer i ASUS korzystają z platformy GB10 i mają ten sam limit pamięci masowej. W naszej pierwotnej recenzji DGX Spark , pamięć masowa była największym ograniczeniem platformy. Wewnętrzny slot obsługuje krótkie dyski M.2, przez co dyski SSD klienckie o pojemności 8 TB, oferowane w formacie 2280, fizycznie się do niego nie mieszczą. Testowany w sierpniu model Luisuantech GP Spark rozwiązuje ten problem dzięki obudowie M.2 z czterema zatokami, zwisającej z jednego portu 100 GbE, co jest prostym rozwiązaniem dla jednego dysku Spark na jednym biurku, a w skali laboratoryjnej, większego silosu na każdym biurku.
Pojemność to połowa problemu; drugą połowę stanowi to, co dzieje się z danymi po ich umieszczeniu na komputerze stacjonarnym. Model 78 GB ściągnięty do Spark to kopia, której nikt w IT nie widzi. Zestaw danych badawczych umieszczony na lokalnej pamięci flash to kopia poza harmonogramem tworzenia kopii zapasowych, poza polityką dostępu i poza audytami instytucjonalnymi. Dziesięć Sparków w laboratorium oznacza dziesięć kopii tych samych wag zużywających 780 GB pamięci flash, które można by wykorzystać do czegoś innego, i dziesięć miejsc, w których zbiór danych może wyjść z maszyny. Problem pogłębia się wraz ze wzrostem liczby, niezależnie od tego, czy chodzi o systemy GB10, czy o dowolną infrastrukturę AI dla komputerów stacjonarnych. Każda organizacja zarządzająca flotą laptopów zna ten schemat, a odpowiedź była wtedy taka sama: przechowuj dane we współdzielonej pamięci masowej w centrum danych i pozwól, aby punkt końcowy był punktem końcowym.
Na szczęście NVIDIA zaprojektowała Spark z portami, które to umożliwiają. Każda jednostka zawiera dwie klatki QSFP56 na zintegrowanym ConnectX-7, z platformą o maksymalnej przepustowości 200 GB za parą łączy PCIe Gen5 x4. W naszej recenzji klastra DGX Spark opisaliśmy konfigurację z podziałem ról, w której jedna klatka jest połączona z równorzędnym serwerem Spark, a druga z pamięcią masową. W tym projekcie jedna klatka na Spark jest używana do przechowywania danych z prędkością 100 GbE, pozostawiając drugą wolną do klastrowania lub dodatkowej przepustowości. Przy prędkości 100 GbE każda Spark ma teoretyczną przepustowość około 12.5 GB/s do hosta pamięci masowej, co przekracza przepustowość zapewnianą przez wewnętrzne gniazdo M.2 w większości tych systemów.
Gdy dane znajdą się po drugiej stronie łącza, rola Sparka ulega zmianie. Staje się on punktem końcowym obliczeń z dyskiem rozruchowym i lokalnym dyskiem pamięci podręcznej, a pojemność nie jest już zakupem na stację roboczą. Model lub zestaw danych jest zapisywany raz i odczytywany przez każdego klienta, więc wykorzystanie pamięci masowej wzrasta, a liczba kopii maleje. Ochrona danych przenosi się do macierzy z ochroną parzystości w obudowie serwera, a kontrola dostępu, szyfrowanie danych w spoczynku, tworzenie kopii zapasowych i audyt odbywają się tam, gdzie dotychczas działały dla wszystkich innych funkcji. A ponieważ Spark potrzebuje teraz tylko zasilania i łącza 100 GbE, nie ma powodu, aby stał na biurku. Umieszczony obok hosta pamięci masowej, jest chłodniejszy, cichszy, fizycznie zabezpieczony i dostępny dla każdego, kto będzie go potrzebował.
Host pamięci masowej
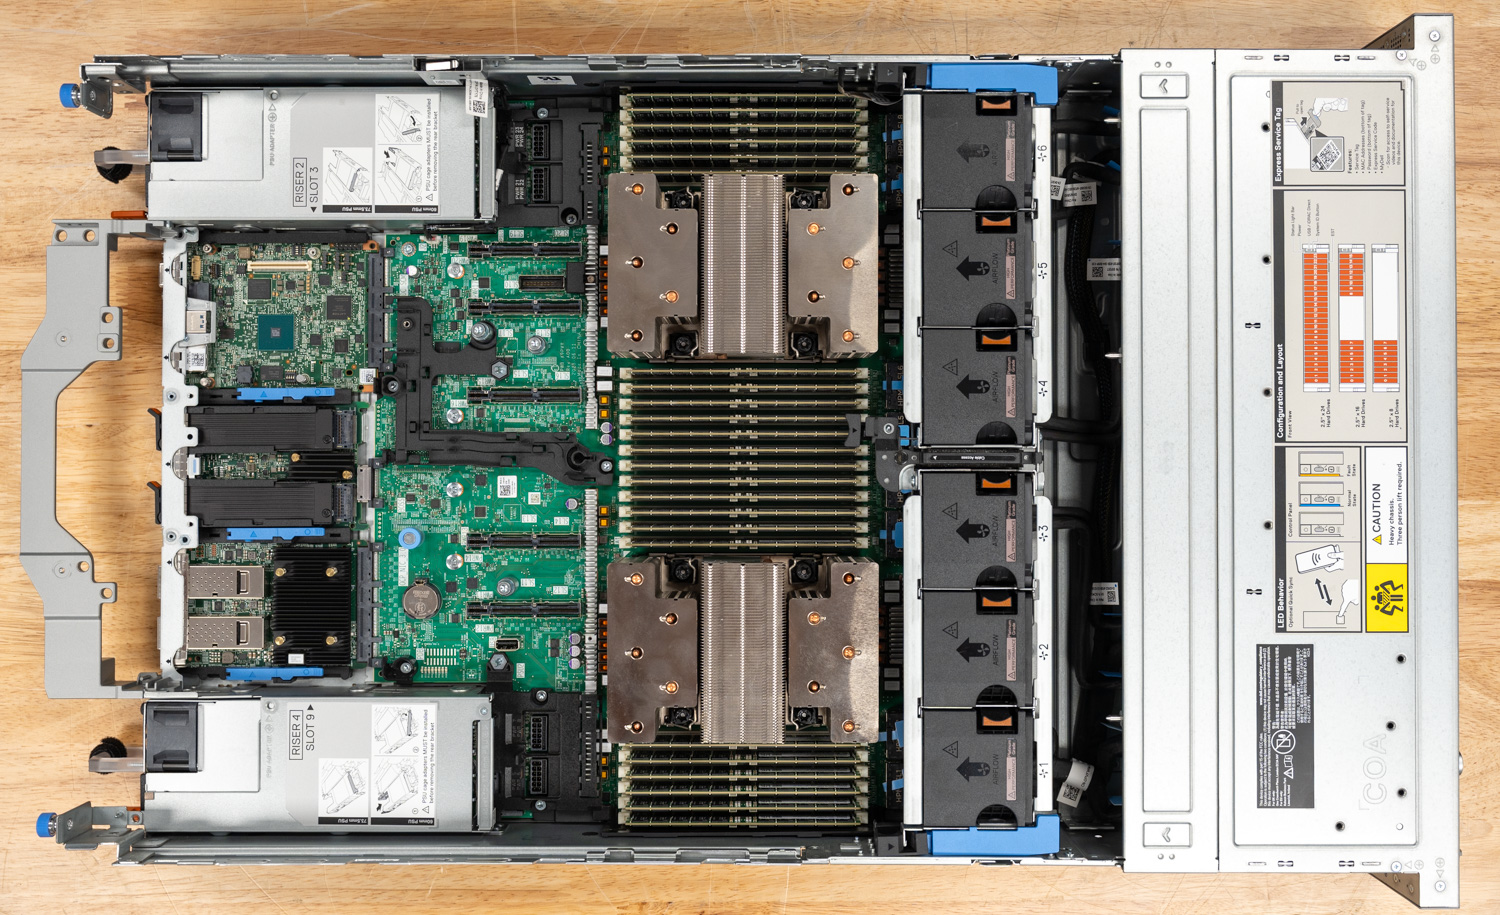
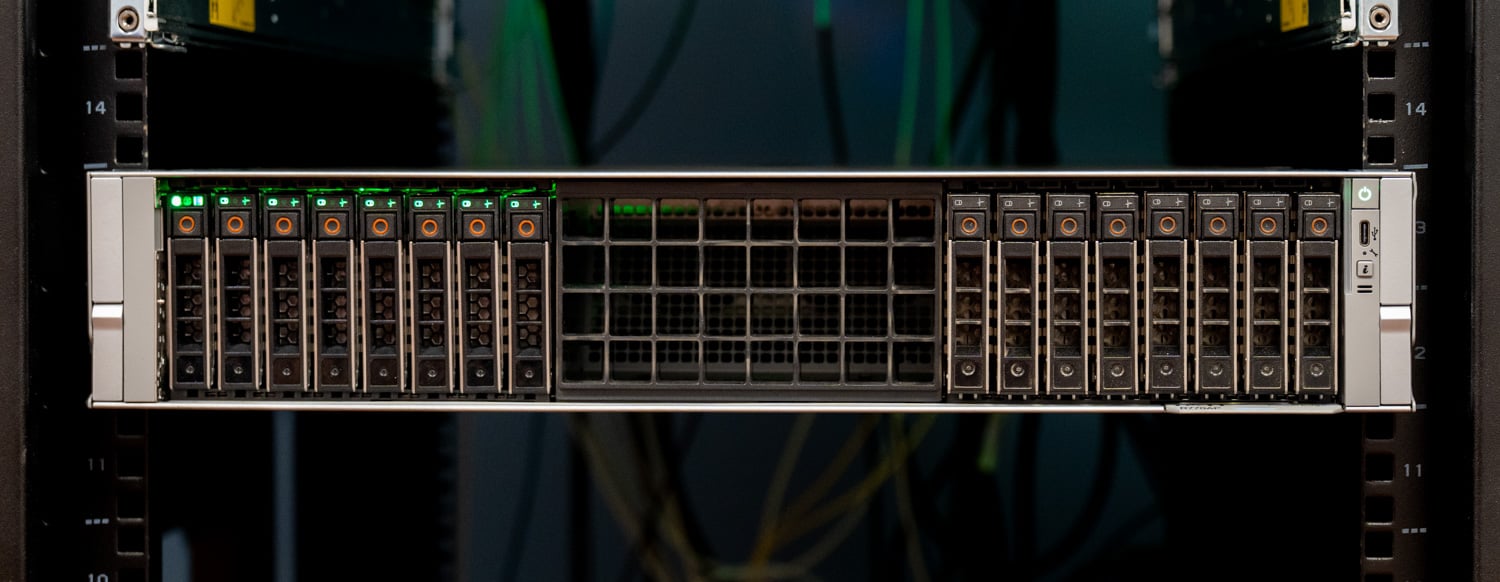
Hostem pamięci masowej jest Dell PowerEdge R770AP , ta sama platforma Xeon 6 2U, którą testowaliśmy na początku tego roku. Wykorzystaliśmy ją, ponieważ była wolna w laboratorium na początku projektu. Dowolny serwer NVMe z miejscem na szybkie karty sieciowe i małą kartą graficzną mógłby spełnić tę rolę, a R770AP to jeden ze sposobów na jej zbudowanie, nawet jeśli jest nieco przebudowany. Nasz serwer obsługuje dwa procesory Xeon 6 6978P z 1.5 TB pamięci DDR5 w 24 modułach DIMM, wykorzystuje jeden z dwóch banków ośmiu zatok NVMe Gen5 i zawiesza dyski oraz kartę graficzną Graid na procesorze 0, a dwa adaptery 400GbE na procesorze 1. Serwer działa pod kontrolą Ubuntu 24.04.
| Składnik | Konfiguracja hosta magazynu |
|---|---|
| Dell PowerEdge R770AP, 2U, 16 zatok 2.5-calowych Gen5 NVMe | |
| CPU | 2x Intel Xeon 6 6978P |
| Pamięć | 1.5 TB DDR5 (24 x 64 GB) |
| Dyski | 8x Solidigm D5-P5336 61.44 TB U.2 PCIe 4.0 QLC (491.52 TB surowy) |
| RAID | Graid SupremeRAID, RAID 5 na wszystkich ośmiu dyskach, karta graficzna NVIDIA RTX A2000 na procesorze 0 |
| System plików | XFS na wirtualnym dysku SupremeRAID |
| Serwer plików | Tuxera Fusion (Fusion NFS, prywatna kompilacja zapoznawcza), NFS 4.1 przez RDMA (RPC-RDMA na porcie 20049), tryb użytkownika |
| Sieci | 2x Broadcom BCM57608 (Thor 2) jednoportowy 400GbE, PCIe Gen5 x16 na CPU 1, RoCEv2 |
| Przełącznik | Dell PowerSwitch Z9864F-ON, 64x 800GbE OSFP112, Enterprise SONiC |
| Linki klienta | Światłowód 800G podzielony na 8x100GbE, jedno łącze na Spark, cztery Sparki na kartę sieciową pamięci masowej w oddzielnych sieciach VLAN |
| Klienci | 2x Dell Pro Max z GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Dlaczego QLC i dlaczego D5-P5336
W naszych rozmowach z Oregon State na temat koncepcji laboratorium Spark, pojemność była najważniejszym wymogiem, ponieważ zbiory danych badawczych są duże. Zadaniem tego serwera jest przechowywanie wszystkiego, czego może potrzebować pomieszczenie pełne serwerów Spark, i udostępnianie tego w formie, która może być odczytywana przez wielu klientów jednocześnie. To profil o dużej pojemności i dużej liczbie odczytów, z dużymi blokami danych, do którego QLC został stworzony. Rodzina serwerów D5-P5336 oferuje pojemność od 7.68 TB do 122.88 TB; Dyski U.2 o pojemności 61.44 TB używane w tym przypadku uzyskały ocenę Solidigm na maksymalnie 7,000 MB/s przy odczycie sekwencyjnym, 3,000 MB/s przy zapisie sekwencyjnym, 1.005 M losowych operacji wejścia/wyjścia na sekundę (IOPS) przy odczycie 4 KB i 65.2 PBW wytrzymałości, czyli 0.58 zapisów na dysk dziennie przez pięć lat, na 192-warstwowej pamięci QLC NAND z jednostką pośrednią 16 KB.
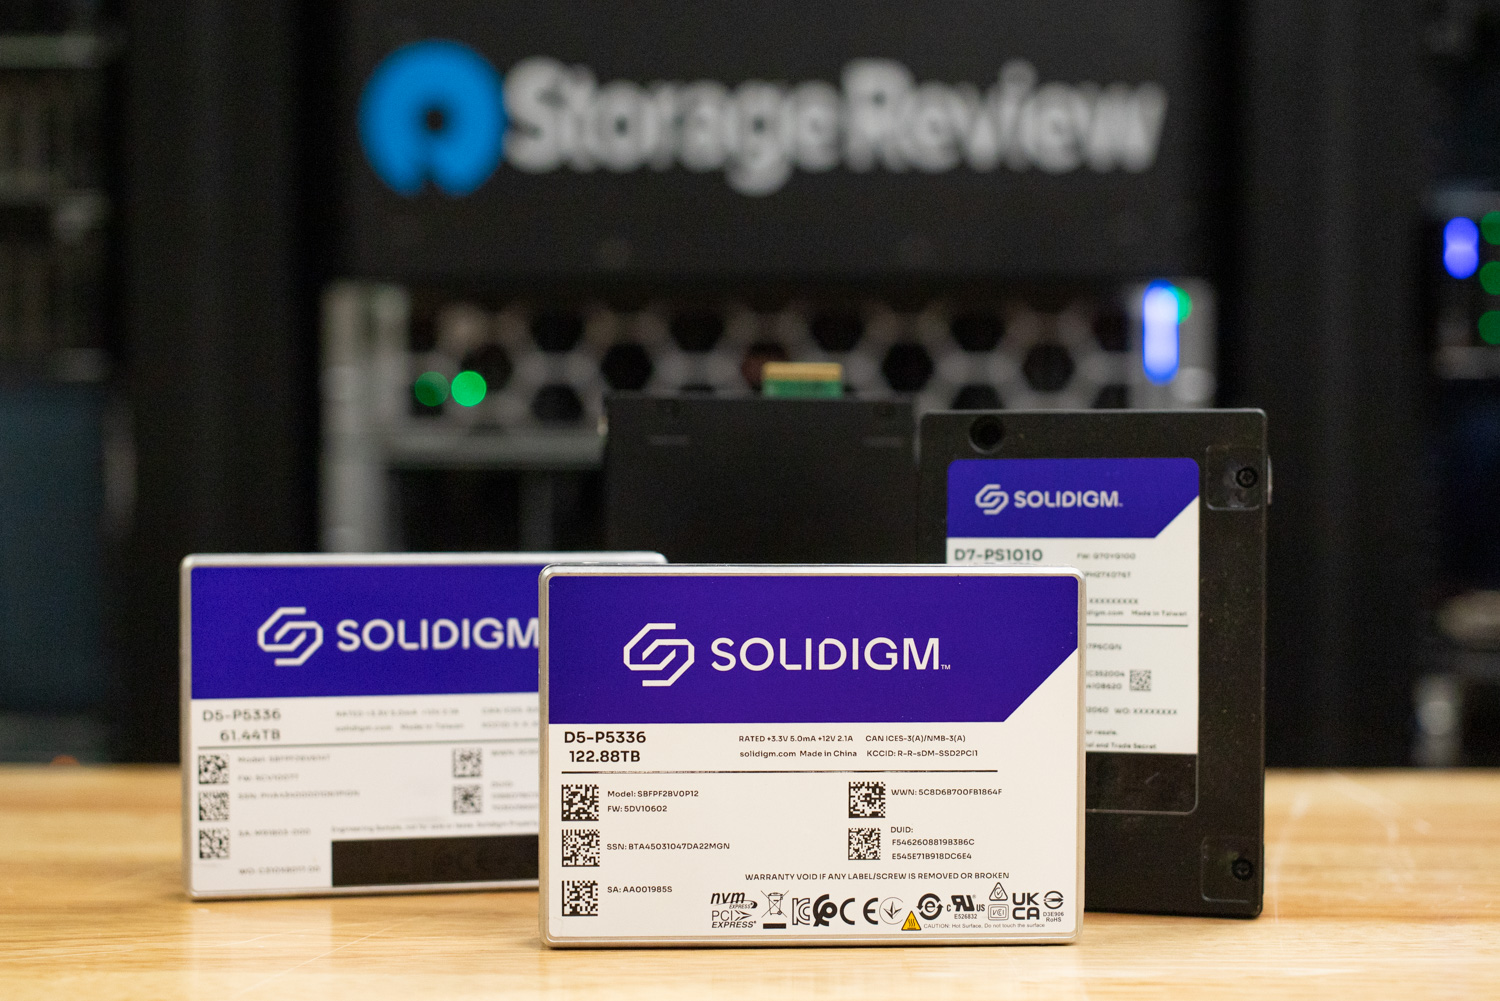
Osiem dysków o pojemności 61.44 TB wypełnia połowę przednich zatok serwera R770AP, a wersja produkcyjna może obsłużyć dowolny punkt pojemności w rodzinie i dowolną liczbę zatok. Mimo to osiem dysków w RAID 5 zapewnia około 430 TB użytecznej przestrzeni z tolerancją na awarie pojedynczego dysku. To ponad 100 razy więcej niż pojemność gniazda M.2 w serwerze Spark i wystarczająco dużo dla biblioteki modeli wydziałowych, współdzielonych zestawów danych, z których korzystają studenci, oraz katalogów domowych poszczególnych użytkowników. Zapełnienie pozostałych ośmiu zatok podwaja tę liczbę, nie wpływając na projekt sieci, a dane dotyczące rozmiarów podane w dalszej części recenzji pokazują, dlaczego dyski są elementem, który warto rozbudować.
Jednostka pośrednia 16 KB ma znaczenie dla tego obciążenia, ponieważ większa jednostka IU firmy Solidigm pozwala zaoszczędzić na gęstości i kosztach, co przekłada się na niską wydajność zapisu losowego. W przypadku współdzielenia obsługującego modele i zestawy danych, małe zapisy losowe stanowią mniejszość. Ładowanie modelu to duże sekwencyjne odczyty. Strumieniowanie zestawów danych to duże sekwencyjne odczyty. Punkty kontrolne i pliki studentów są zapisywane raz, a odczytywane często. Wynikający z tego podział pracy jest odpowiedni dla laboratorium Spark: współdzielona macierz QLC przechowuje wszystko, co jest odczytywane przez wielu, a własny interfejs M.2 platformy Spark obsługuje ruch scratch i swap zapisywany przez jedną osobę.
RAID na GPU: Graid SupremeRAID
RAID NVMe na ośmiu dyskach Gen4, z których każdy może odczytywać dane z prędkością 7,000 MB/s, to punkt, w którym konwencjonalna sprzętowa karta RAID staje się wąskim gardłem, ponieważ każdy bajt musi przejść przez gniazdo PCIe karty. RAID programowy mierzy się z innymi wyzwaniami w zakresie zasobów. Graid SupremeRAID przekazuje obliczenia parzystości do procesora graficznego i utrzymuje ścieżkę danych na liniach PCIe hosta, dlatego w naszych testach SupremeRAID AE z 16 dyskami zaobserwowaliśmy skalowalność do ponad 180 GB/s. W przypadku tego hosta uruchomiliśmy SupremeRAID na karcie graficznej NVIDIA RTX A2000, małej stacji roboczej.
Osiem dysków D5-P5336 zostało bezpiecznie wymazanych i sekwencyjnie zapełnionych przed przekazaniem do Graid, a następnie skonfigurowanych jako pojedyncza macierz RAID 5. Powstały wirtualny dysk został sformatowany w systemie XFS i obsługiwany przez Tuxera. RAID 5 to odpowiedni poziom dla takiego udziału: awaria dysku utrzymuje macierz w trybie online, odbudowa odbywa się bez wyłączania danych użytkownika, a utrata pojemności wynosi jeden dysk na osiem. RAID 6 lub RAID 10 byłyby rozsądnym wyborem dla wdrożenia produkcyjnego, w którym ochrona okna odbudowy jest ważniejsza niż pojemność, a SupremeRAID obsługuje oba.
Sieć: Broadcom 400GbE i rdzeń 800G
Część pamięci masowej w serwerze R770AP stanowią dwa adaptery Broadcom BCM57608 Thor 2, każdy z jednoportową kartą sieciową 400GbE na interfejsie PCIe Gen5 x16. Broadcom pozycjonuje kartę BCM57608 jako najsłabszą w branży kartę sieciową 400GbE, a jej zestaw funkcji sprawia, że dobrze się wpisuje w ten trend: RoCEv2 z ulepszoną kontrolą przeciążenia DCQCN, adaptacyjnym routingiem, bezpiecznym rozruchem z krzemowym rdzeniem zaufania oraz odciążeniem szyfrowania kTLS. W tym projekcie RoCEv2 obsługuje NFS przez RDMA, a kontrola przeciążenia zapobiega nachodzeniu się na siebie wielu klientów, gdy wszyscy jednocześnie zaczynają pobierać dane. Podczas kompilacji sterownik bnxt_en zgłosił, że moduły optyczne na portach 400G osiągają próg ostrzegawczy 70°C pod stałym obciążeniem. Rozwiązaliśmy ten problem, wprowadzając niewielkie przesunięcie profilu wentylatora w R770AP, a karty sieciowe działały bez zarzutu.
Obie karty sieciowe są podłączone do Dell PowerSwitch Z9864F-ON , naszego laboratoryjnego przełącznika rdzeniowego 800G, z systemem Enterprise SONiC. Z9864F-ON obsługuje 64 porty OSFP112 w standardzie 800GbE i może rozdzielić dowolny z nich na 2x400G, 4x200G lub 8x100G. Jeden port optyczny 800G rozgałęziony do 8x100G łączy osiem przełączników Spark (po jednym łączu) z tym samym przełącznikiem, który kończy dwa łącza pamięci masowej 400G. Każda karta sieciowa 400G działa we własnej sieci VLAN i obsługuje cztery przełączniki Spark, więc host pamięci masowej prezentuje dwa cele RDMA, a obciążenie jest równomiernie rozdzielone między nie, zgodnie z projektem. W praktyce jest to topologia o pełnej przepustowości: 8x100G przepustowości klienckiej po jednej stronie, 2x400G przepustowości pamięci masowej po drugiej i przełącznik o przepustowości 102.4 Tbps pośrodku.
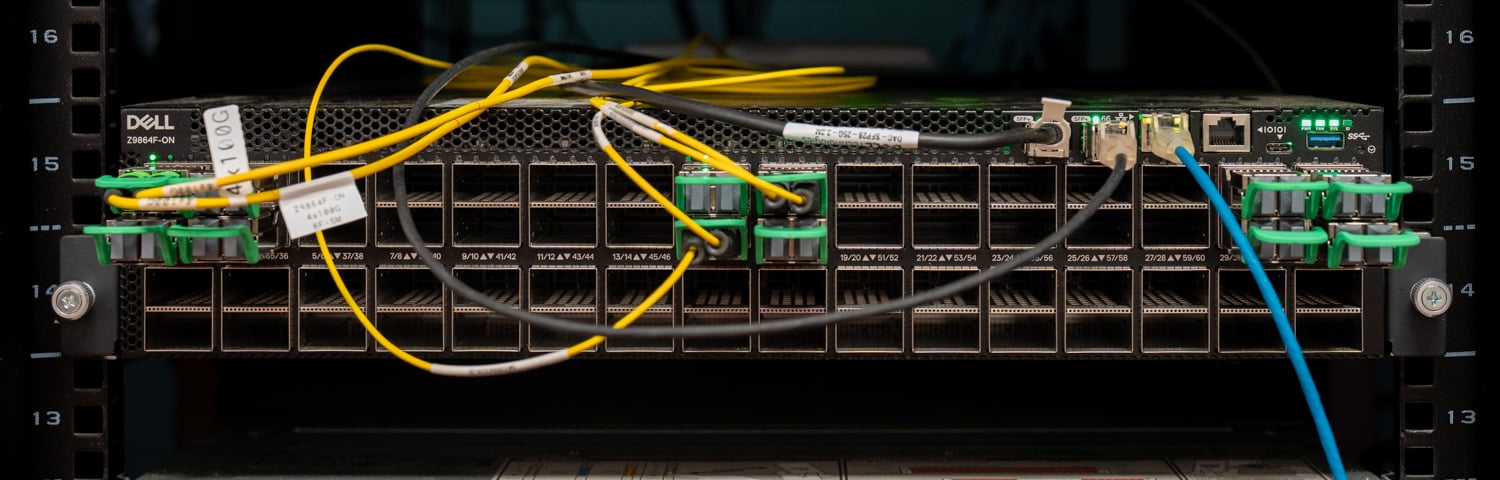
Sprawdziliśmy strukturę, zanim jakiekolwiek oprogramowanie pamięci masowej jej dotknęło. Testy serwer-serwer między R770AP a drugim hostem przez łącza 400G przebiegały z prędkością liniową w obu kierunkach, a ruch RDMA z Sparks potwierdził, że porty wyjściowe 100G działały z pełną prędkością. Gdy inżynierowie Tuxery uruchomili udziały NFS, iperf3 z Sparks do ich kart sieciowych wykazał czyste 99 Gb/s, utrzymywane przy czterech równoległych strumieniach i zerowej retransmisji.
Dlaczego NFS i dlaczego Tuxera
Dzięki Graidowi, oferującemu szybkie urządzenie blokowe, host pamięci masowej mógłby obsługiwać urządzenia Spark jako cele blokowe NVMe-oF lub udziały plików. Przetestowaliśmy ścieżkę blokową w recenzji GP Spark i działa ona dobrze dla jednego klienta. W laboratorium z wieloma urządzeniami Spark potrzebowaliśmy czegoś innego. Woluminy blokowe są typu jeden do jednego; każdy użytkownik potrzebowałby jednostki LUN, a w momencie, gdy dwóch użytkowników chce mieć ten sam zestaw danych, następuje jego kopiowanie, co jest problemem, którego rozwiązanie ma na celu cały ten projekt. NFS znajduje się w centrum diagramu Venna: pojedyncza przestrzeń nazw przechowuje współdzielone zestawy danych, hostowane modele i foldery dla każdego użytkownika. Każde urządzenie Spark korzysta z klienta NFS już w Ubuntu, a narzędzia Kubernetes i Slurm, które uniwersytet umieściłby na platformie Spark, obsługują NFS.
Fusion NFS to połówka NFS Tuxera Fusion, wieloprotokołowego serwera plików, który obejmuje SMB i NFS na jednym, wielowątkowym rdzeniu w trybie użytkownika; po raz pierwszy przyjrzeliśmy się Fusion SMB w projekcie przepływu pracy multimediów Solidigm i Tuxera w 2024 roku. Tuxera deklaruje do 22.7 GB/s na pojedynczym połączeniu 200 GbE z RDMA, powyżej kernel NFSD i Ganesha w testach firmy, a produkt obsługuje NFS 4.1, klastrowanie skalowalne w trybie aktywny-aktywny, transparentne przełączanie awaryjne oraz integrację z Active Directory, Kerberos i LDAP. Ten ostatni zestaw to hak zarządzania: ten sam katalog, który kontroluje, kto może zalogować się do Spark, kontroluje również to, co widzi w udziale. Jedno zastrzeżenie dotyczy każdego numeru Tuxera w tym artykule: kompilacja, którą uruchomiliśmy, to prywatna wersja zapoznawcza Fusion NFS, która według Tuxera nie została w pełni zoptymalizowana pod kątem wydajności, a oprogramowanie nie jest jeszcze dostępne w sprzedaży komercyjnej. Powszechne udostępnienie planowane jest na listopad, po SC'26.
Firma Tuxera zainstalowała Fusion na serwerze R770AP, sformatowała wolumin Graid za pomocą XFS i skonfigurowała serwer z NFS na porcie standardowym oraz RPC-RDMA na porcie 20049, pomijając nasłuchiwacze SMB, ponieważ projekt jest oparty wyłącznie na NFS. Początkowa konfiguracja wątków obejmowała cztery wątki protokołu, z których każdy miał osiem wątków do transportu, nadawania i odbioru, danych VFS i metadanych VFS, co Tuxera opisuje jako punkt wyjścia do dostrajania. Usługi katalogowe zostały celowo pominięte w wersji laboratoryjnej; wdrożenie uniwersyteckie nakładałoby na nie własne usługi tożsamości. Po stronie Spark, zamontowanie udziału to jedno polecenie:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Ta jedna linijka to cała integracja klienta, bez sterownika, konfiguracji inicjatora i oprogramowania dostawcy na platformie Spark. Użytkownik, który jutro zaloguje się do innej platformy Spark, uruchomi tę samą linijkę i zobaczy te same pliki.
Dowód konfiguracji: osiem iskier w jednym zestawie danych
Przed rozpoczęciem jakichkolwiek prac nad modelem przeprowadziliśmy kontrolę poprawności na każdym urządzeniu Spark z osobna: sekwencyjny odczyt fio 1M z 16 zadaniami i głębokością kolejki równą 16 dla własnego folderu w macierzy. Osiem jednostek zwróciło od 10.0 do 11.2 GiB/s, nasycając łącze 100 GbE na każdej z nich. Następnie przeprowadziliśmy skanowanie, aby udowodnić, że wszystkie osiem mogło utrzymać swoją część obciążenia. Każde uruchomienie utrzymuje stałe 16 wątków przy głębokości kolejki równej 16 w sumie i rozkłada je na jeden, dwa, cztery i osiem urządzeń Spark, na 1M sekwencyjnych, 64K losowych, 16K sekwencyjnych i 4K losowych obciążeń roboczych, z odczytem i zapisem, bezpośrednim wejściem/wyjściem, 60 sekund na test. Każdy Spark zapisuje do własnego folderu w macierzy, cztery na kartę sieciową pamięci masowej, a nigdzie w stosie nie ma QoS. Przy jednoczesnym obciążeniu wszystkich ośmiu dysków, sekwencyjne odczyty 1M na jednostkę wahały się od 3.09 do 3.13 Gb/s, losowe odczyty 64K od 6,648 do 6,779 IOPS, a losowe zapisy 4K od 2,136 do 2,155 IOPS, w pięciu urządzeniach OEM w dwóch sieciach VLAN bez egzekwowania zasady równości. Każdy dysk Spark dotarł do macierzy, każdy dysk Spark otrzymał równy udział, a konfiguracja była gotowa na obciążenie, które miało znaczenie.
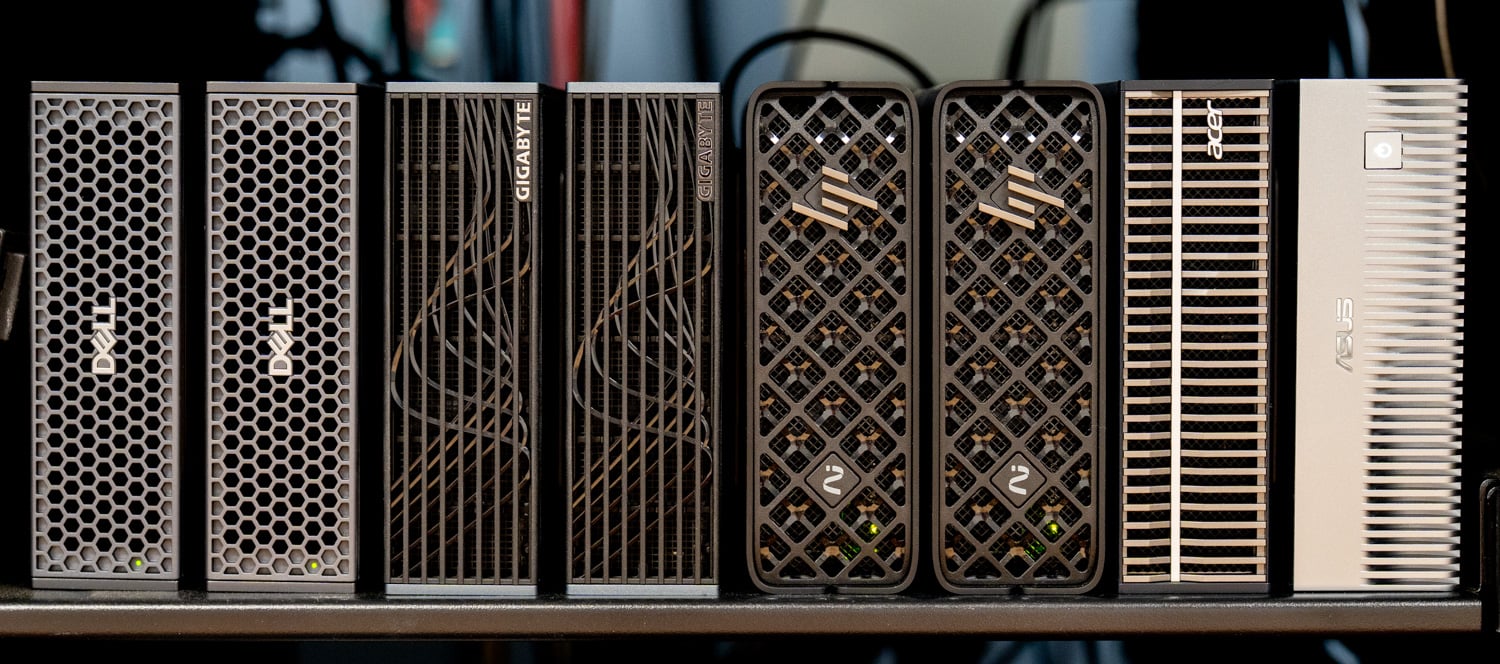
| Spark (ośmiu klientów, 2 wątki x QD16 każdy) | Karta sieciowa pamięci masowej | 1M Sekwencyjny odczyt | 64K losowy odczyt IOPS | 4K losowy odczyt IOPS | 4K losowy zapis IOPS |
|---|---|---|---|---|---|
| Dell Pro Max z GB10 (1) | 1 | 3,176 MiB/s | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 MiB/s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 MiB/s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 MiB/s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max z GB10 (2) | 2 | 3,184 MiB/s | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 MiB/s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 MiB/s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 MiB/s | 6,734 | 10,300 | 2,145 |
Określanie wielkości hosta: dwie karty sieciowe i duży zapas mocy obliczeniowej
Ten sam schemat odpowiada na pytanie, które laboratorium lub przedsiębiorstwo musi rozstrzygnąć przed zakupem: gdzie jest pułap i która część hosta go wyznacza? Cztery poniższe panele pokazują przepustowość odczytu dla wszystkich czterech obciążeń, gdy obciążenie stałe skaluje się od jednego Sparka do ośmiu; strona zapisu jest omówiona w tekście i tabeli poniżej.
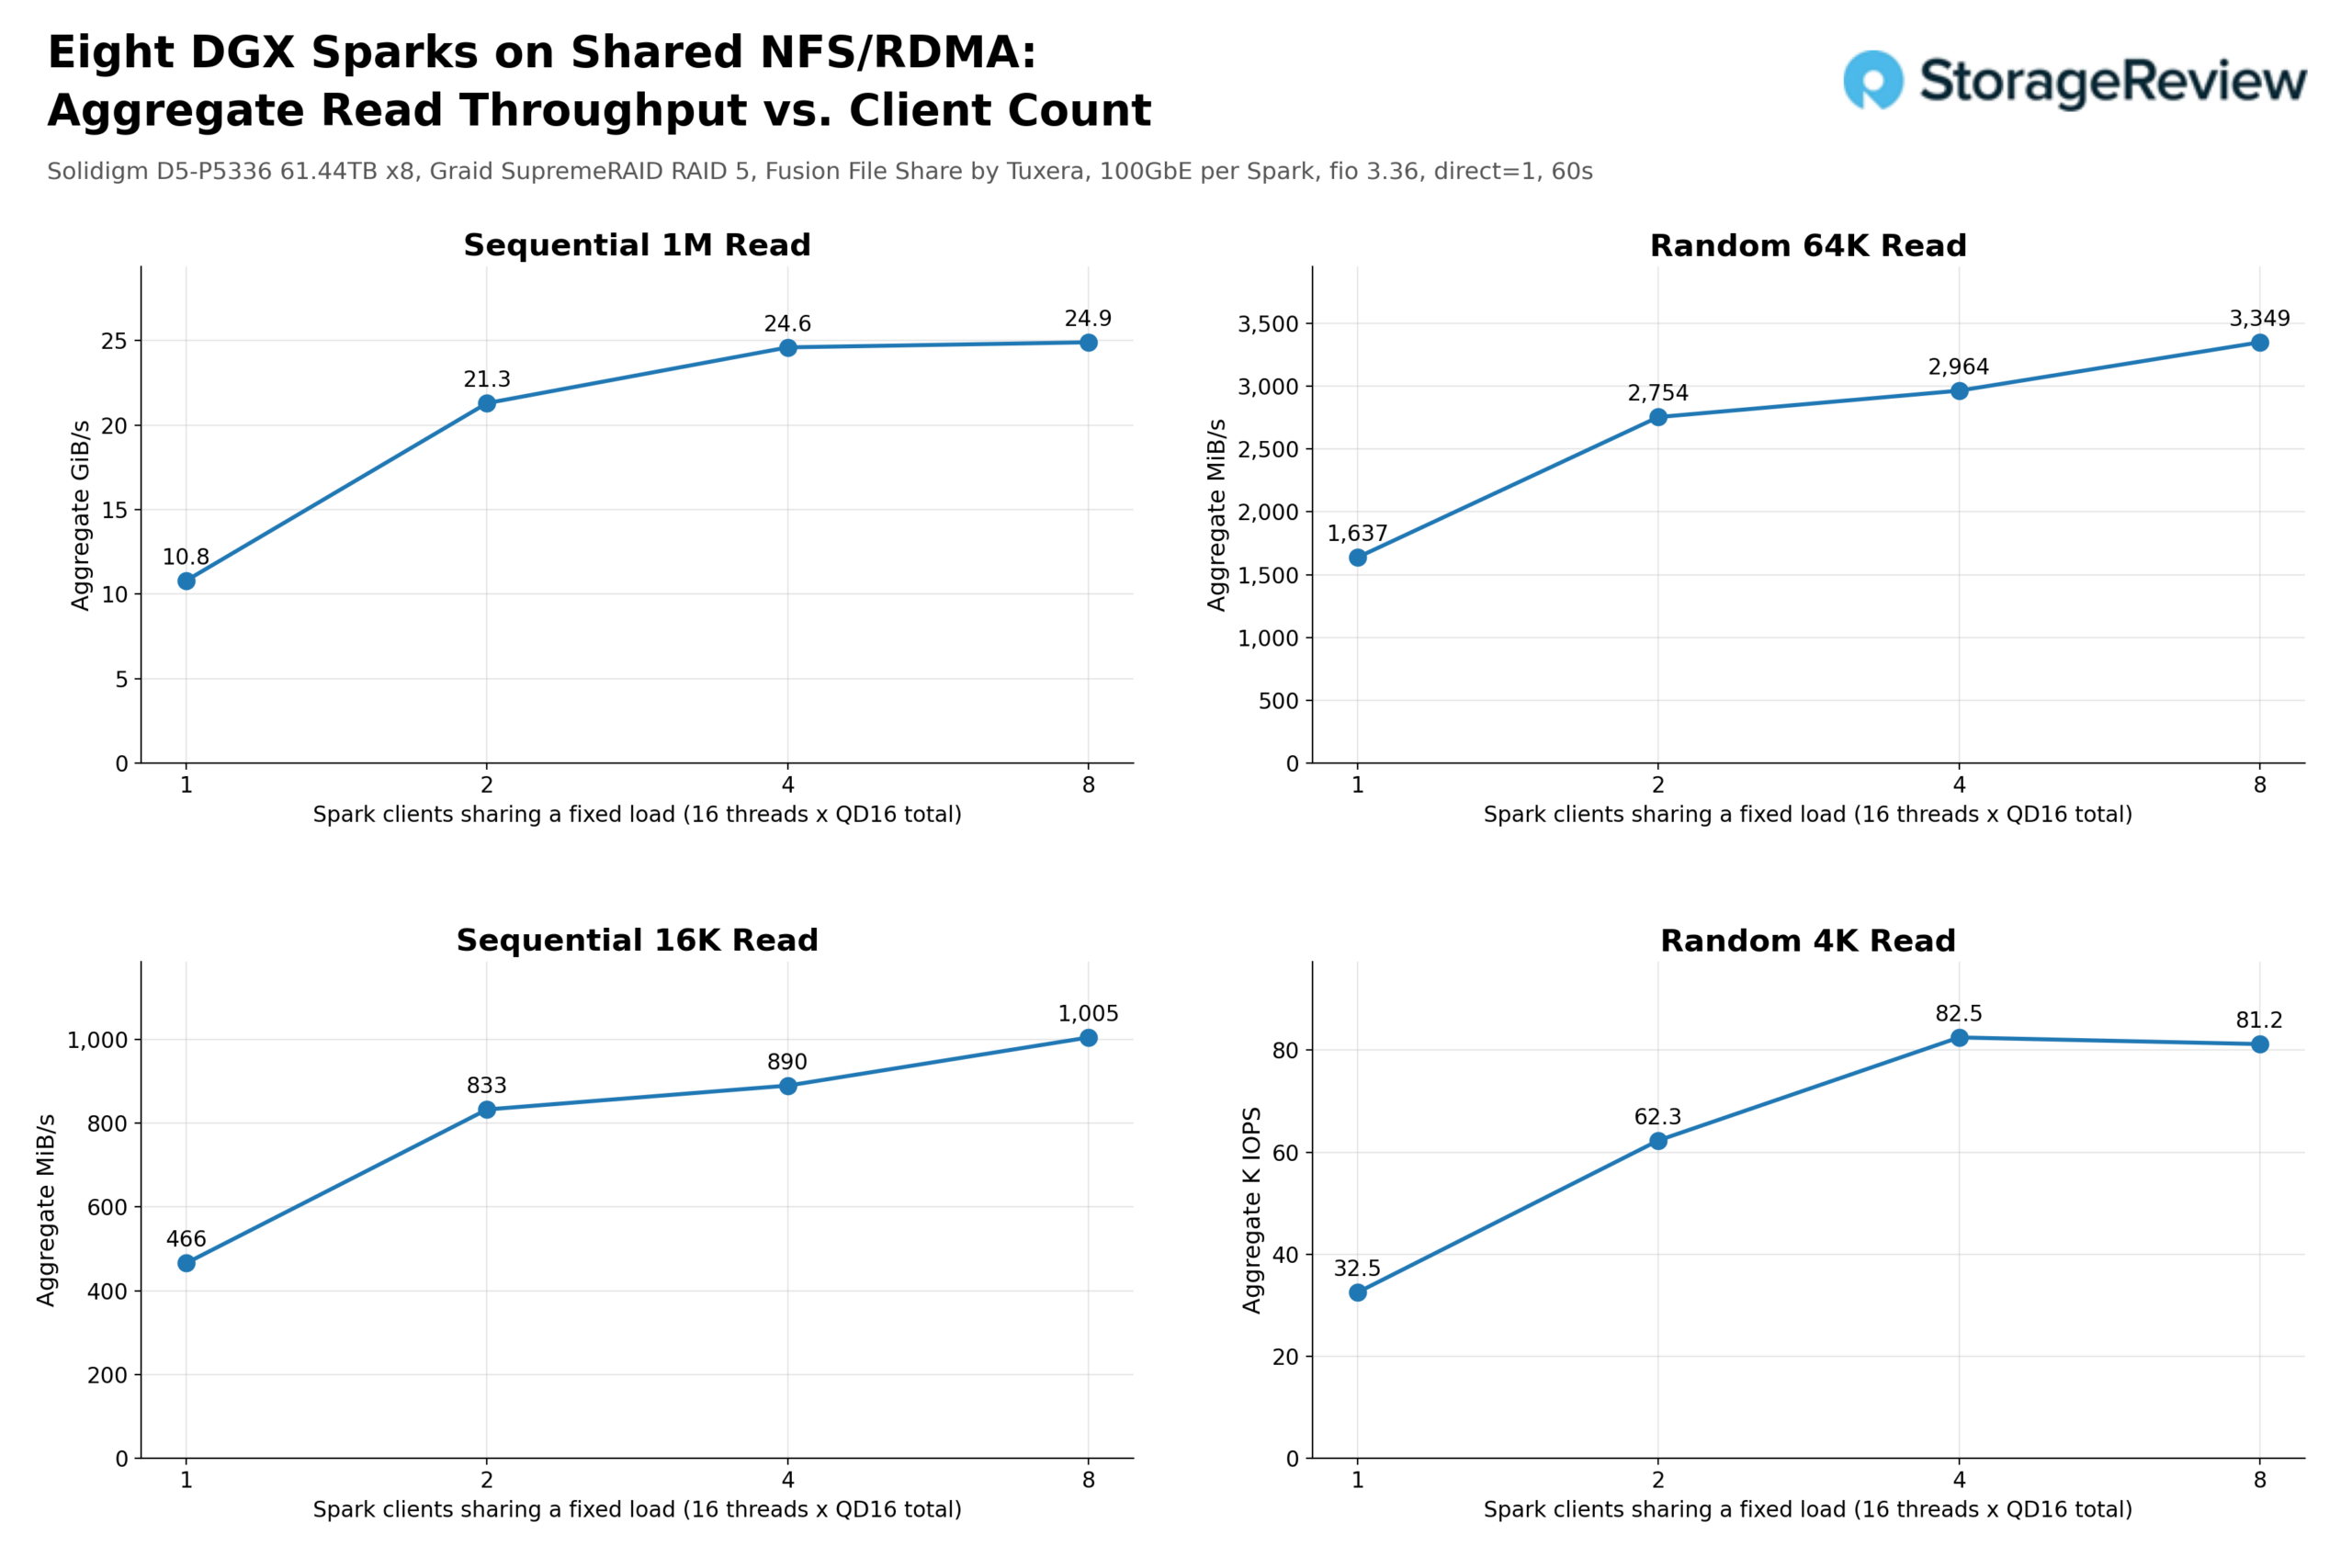
Łączna prędkość odczytu sekwencyjnego 1 MB wzrosła z 10.8 GiB/s na jednym serwerze Spark do 21.3 GiB/s na dwóch, 24.6 GiB/s na czterech i 24.9 GiB/s na ośmiu. W ujęciu sieciowym oznacza to 93 Gb/s, 183 Gb/s, 212 Gb/s i 214 Gb/s w porównaniu z 800 Gb/s, które mogą obsłużyć dwie karty sieciowe Broadcom 400 GbE. Zatem przy pełnym obciążeniu ośmiu klientów macierz wykorzystywała 27% przepustowości sieci hosta. Płaskowyż w okolicach 25 Gb/s przypada na macierz RAID 5 QLC z ośmioma dyskami; karty sieciowe, przełącznik i łącza 100 GbE w serwerach Spark nigdy nie stanowiły ograniczenia.
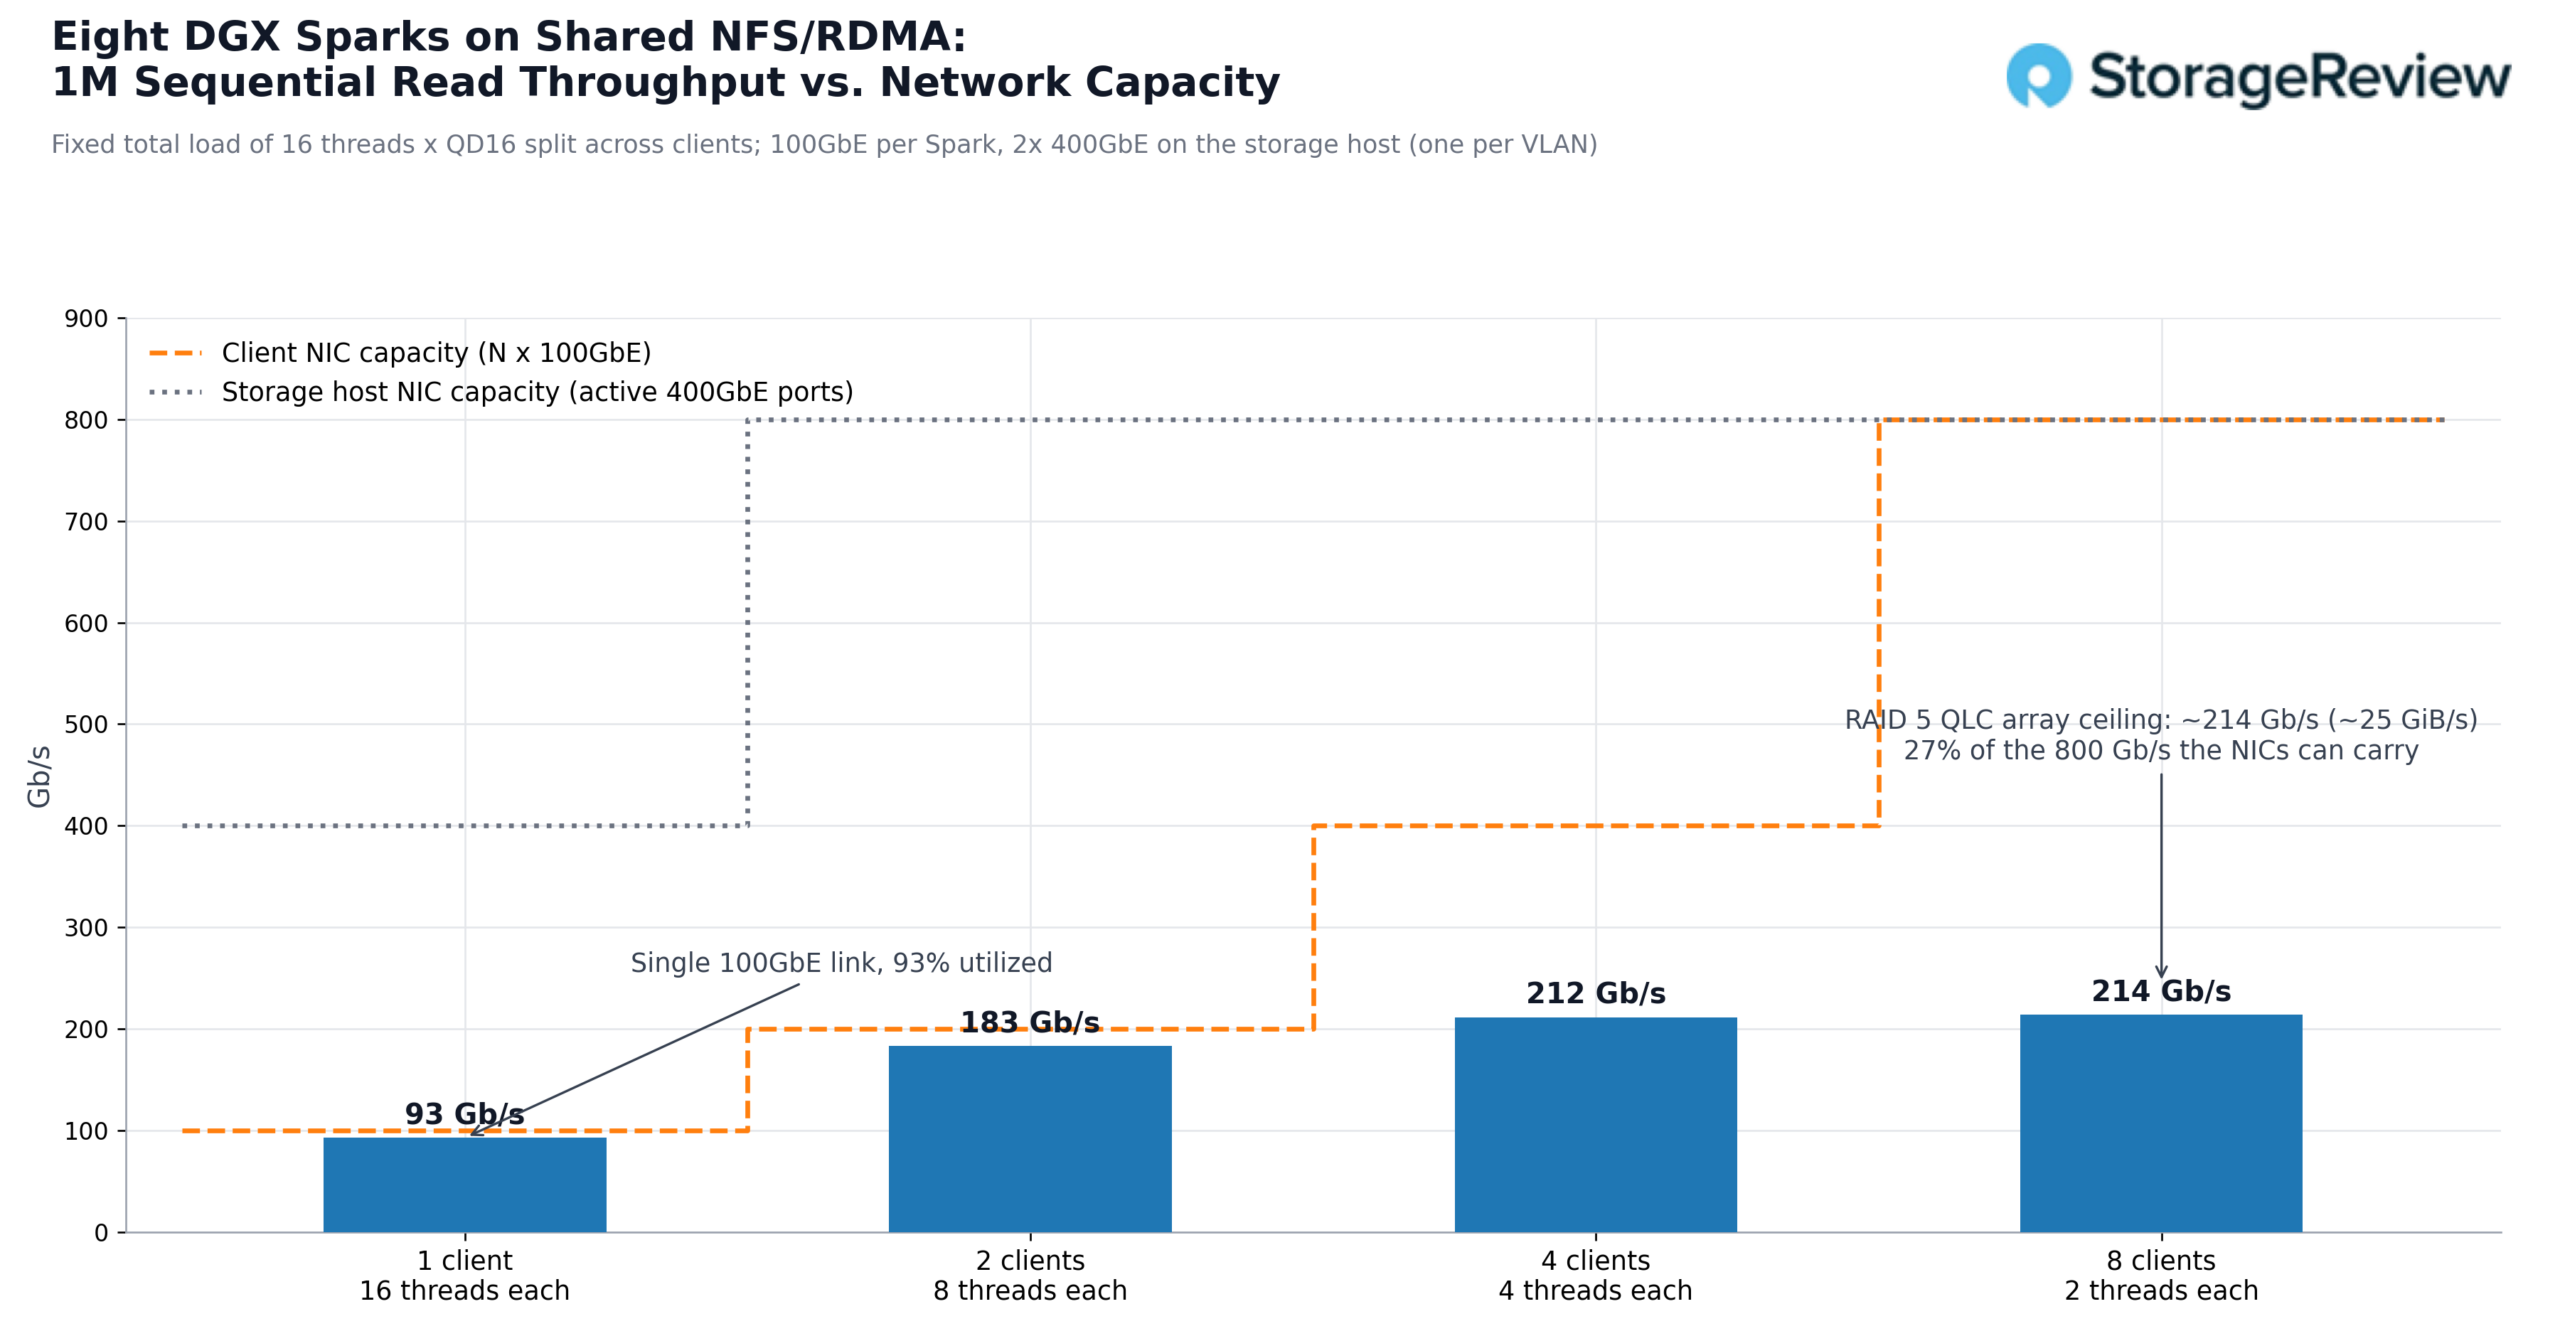
Dwie karty sieciowe po stronie serwera obsługują już osiem urządzeń Spark z prędkością łącza i będą obsługiwać również pozostałe osiem zatok w urządzeniu R770AP: podwojenie liczby dysków, czy to w postaci drugiej macierzy, czy szerszego zestawu RAID, zapewnia większą przepustowość odczytu za tymi samymi dwoma portami, z zapasem. To samo dotyczy operacji wejścia/wyjścia. Losowe odczyty 4K wzrosły z 32.5 tys. IOPS na jednym kliencie do plateau około 81 tys. IOPS na czterech klientach i więcej, przy czym opóźnienie na operację wejścia/wyjścia spadło z 7.9 ms do 3.1 ms wraz ze zmniejszaniem się kolejki każdego klienta, a losowe odczyty 64K wzrosły z 1,637 do 3,349 MiB/s, przy czym sieć w obu przypadkach znacznie przekroczyła swój limit.
Innym istotnym porównaniem jest porównanie z pamięcią masową, którą już ma Spark. W naszych indywidualnych recenzjach GB10, odczyty GDSIO 1M z wewnętrznego M.2 osiągnęły szczyt blisko 11.2 GiB/s na Acer Veriton GN100 i GIGABYTE AI TOP ATOM. Dell Pro Max z GB10 i HP ZGX Nano G1n osiągnęły około 5.5 GiB/s, podczas gdy ASUS Ascent GX10 zbliżył się do 5 GiB/s. Dla porównania, zewnętrzna obudowa NVMe-oF Luisuantech GP Spark dostarczyła 9.5 GB/s na tym samym porcie 100 GbE. Pojedynczy odczyt Spark ze współdzielonej macierzy QLC z prędkością 10.8 GiB/s dorównuje najszybszym dyskom wewnętrznym w tej grupie i mniej więcej podwaja najwolniejszy, przez jeden kabel, z danych, które może odczytać również każdy inny Spark. Narzędzia różnią się: GDSIO na dyskach wewnętrznych i fio przez NFS tutaj, więc jest to porównanie zakresów.
Poniżej znajduje się pełny wykres, wraz z danymi zbiorczymi dla wszystkich czterech obciążeń przy każdej liczbie klientów. Każdy wiersz odczytu rośnie wraz z liczbą klientów, aż do wyczerpania zapasu w macierzy, a każdy wiersz zapisu pozostaje płaski, od jednego Sparka do ośmiu, ponieważ ścieżka parzystości RAID 5 utrzymuje macierz na stałym limicie zapisu, niezależnie od liczby klientów, którzy ją współdzielą. W przypadku udziału zbudowanego tak, aby mógł być odczytywany przez wielu użytkowników i zapisywany jednorazowo podczas pobierania, jest to profil, dla którego projekt został stworzony.
| Łącznie (16 wątków) | 1 Spark | 2 Iskry | 4 Iskry | 8 Iskry |
|---|---|---|---|---|
| 1M Sekwencyjny odczyt | 10.8 Gb/s | 21.3 Gb/s | 24.6 Gb/s | 24.9 Gb/s |
| 1M Zapis sekwencyjny | 2.4 Gb/s | 2.4 Gb/s | 2.4 Gb/s | 2.4 Gb/s |
| Odczyt losowy 64K | 1,637 MiB/s | 2,754 MiB/s | 2,964 MiB/s | 3,349 MiB/s |
| Losowy zapis 64K | 722 MiB/s | 719 MiB/s | 723 MiB/s | 703 MiB/s |
| 16K Sekwencyjny odczyt | 466 MiB/s | 833 MiB/s | 890 MiB/s | 1,005 MiB/s |
| 16K Sekwencyjny zapis | 57 MiB/s | 60 MiB/s | 62 MiB/s | 28 MiB/s |
| Odczyt losowy 4K | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| Losowy zapis 4K | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Modele hostingu na współdzielonej pamięci masowej
Przeszukanie Fio dowodzi, że macierz i sieć są więcej niż wydajne. Kolejnym testem, który ma znaczenie dla przypadku użycia, jest to, czy model działający na współdzielonej macierzy ładuje się tak samo, jak model działający na własnym NVMe Spark, ponieważ jest to przepływ pracy, od którego zależy cały projekt: jedna kopia, hostowana centralnie, ładowana przez dowolnego. Wybraliśmy Qwen3.5-122B-A10B w NVFP4, 122-miliardowym modelu mieszanym przez ekspertów, który zajmuje 78 GB na dysku i mieści się w 128 GB zunifikowanej pamięci pojedynczego Sparka. Zmierzyliśmy czas od uruchomienia serwera wnioskowania do momentu, gdy serwer zgłosi prawidłowy stan, wraz ze średnią przepustowością pamięci masowej w tym oknie, w trzech scenariuszach: jeden Spark ładujący się z wewnętrznego NVMe, ten sam Spark ładujący się przez NFS/RDMA z współdzielonej macierzy i wszystkie osiem Sparków ładujących tę samą pojedynczą kopię z macierzy w tym samym czasie.
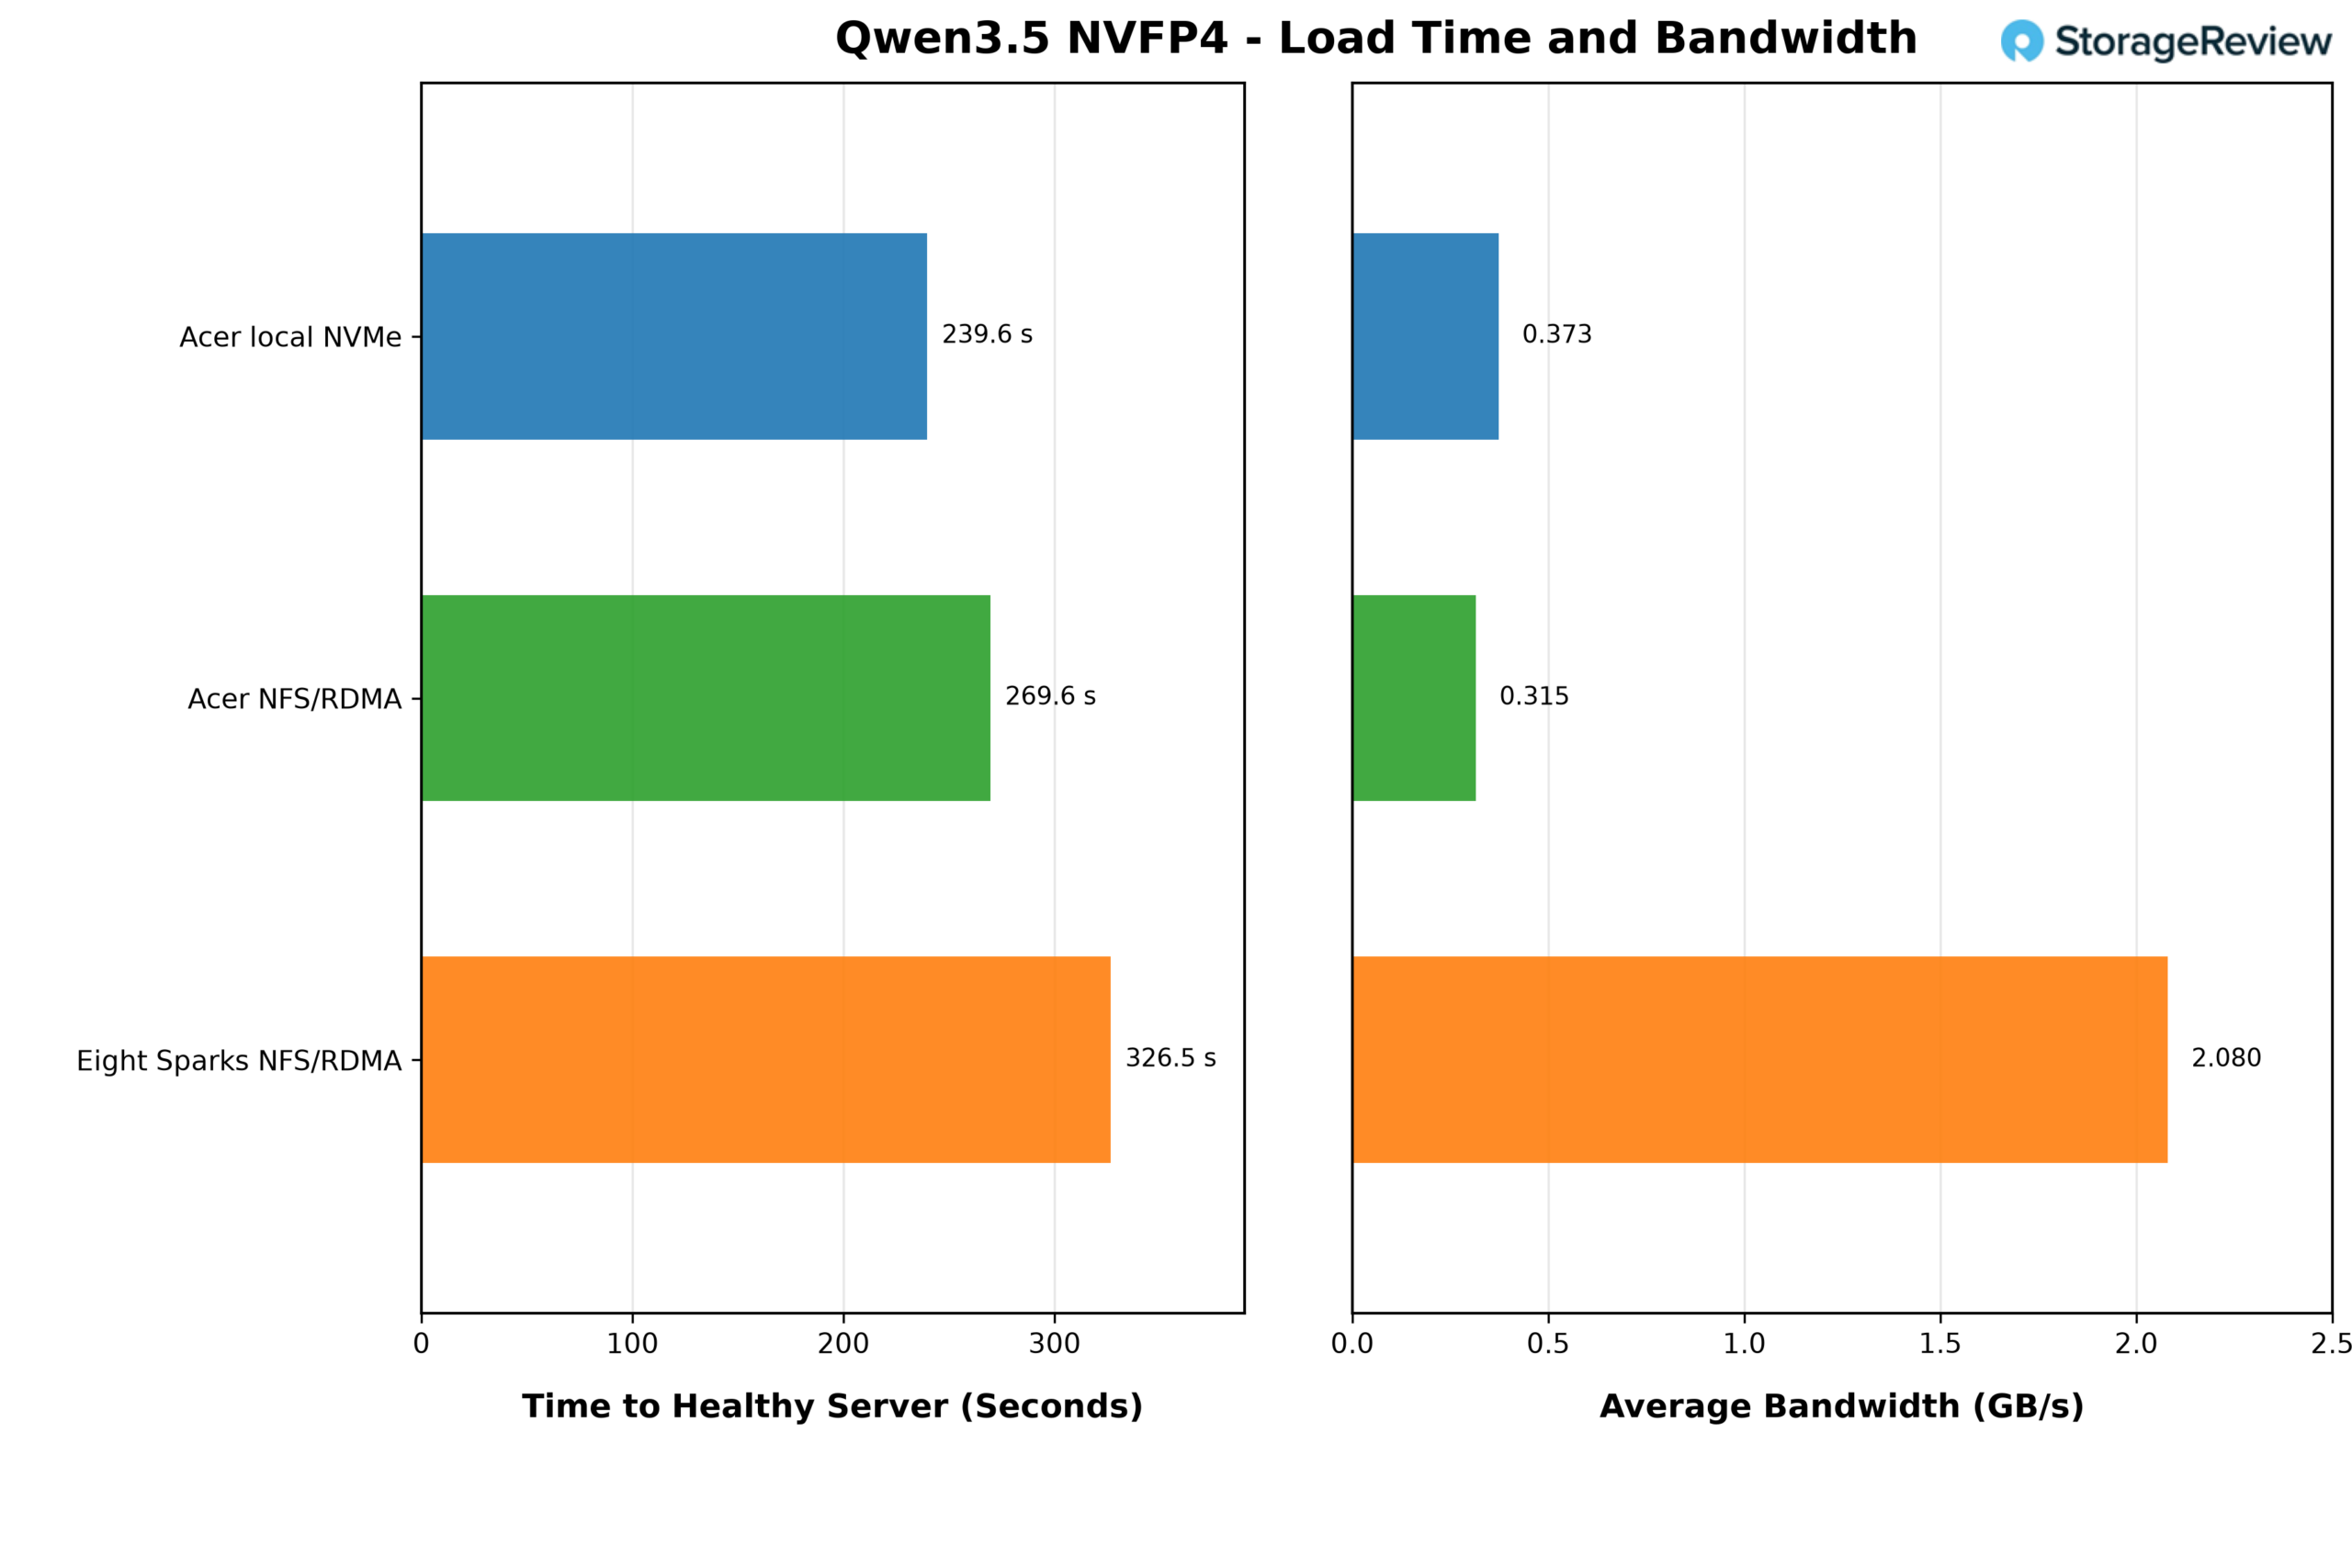
Korzystając z wewnętrznego interfejsu NVMe, Acer Veriton GN100 osiągnął stan prawidłowego działania serwera w 239.6 sekundy, ze średnią przepustowością 0.373 GB/s. Korzystając ze współdzielonej macierzy przez NFS/RDMA, ten sam Spark potrzebował 269.6 sekundy, z przepustowością 0.315 GB/s, czyli około 30 sekund, czyli o 13% dłużej. Średnie pokazują, że przy 78 GB w ciągu czterech minut, ładowanie modelu na Spark w żadnym z przypadków nie jest ograniczone pojemnością pamięci masowej. Procesor GB10 sam wyznacza tempo, a pamięć masowa spędza większość okna oczekując.
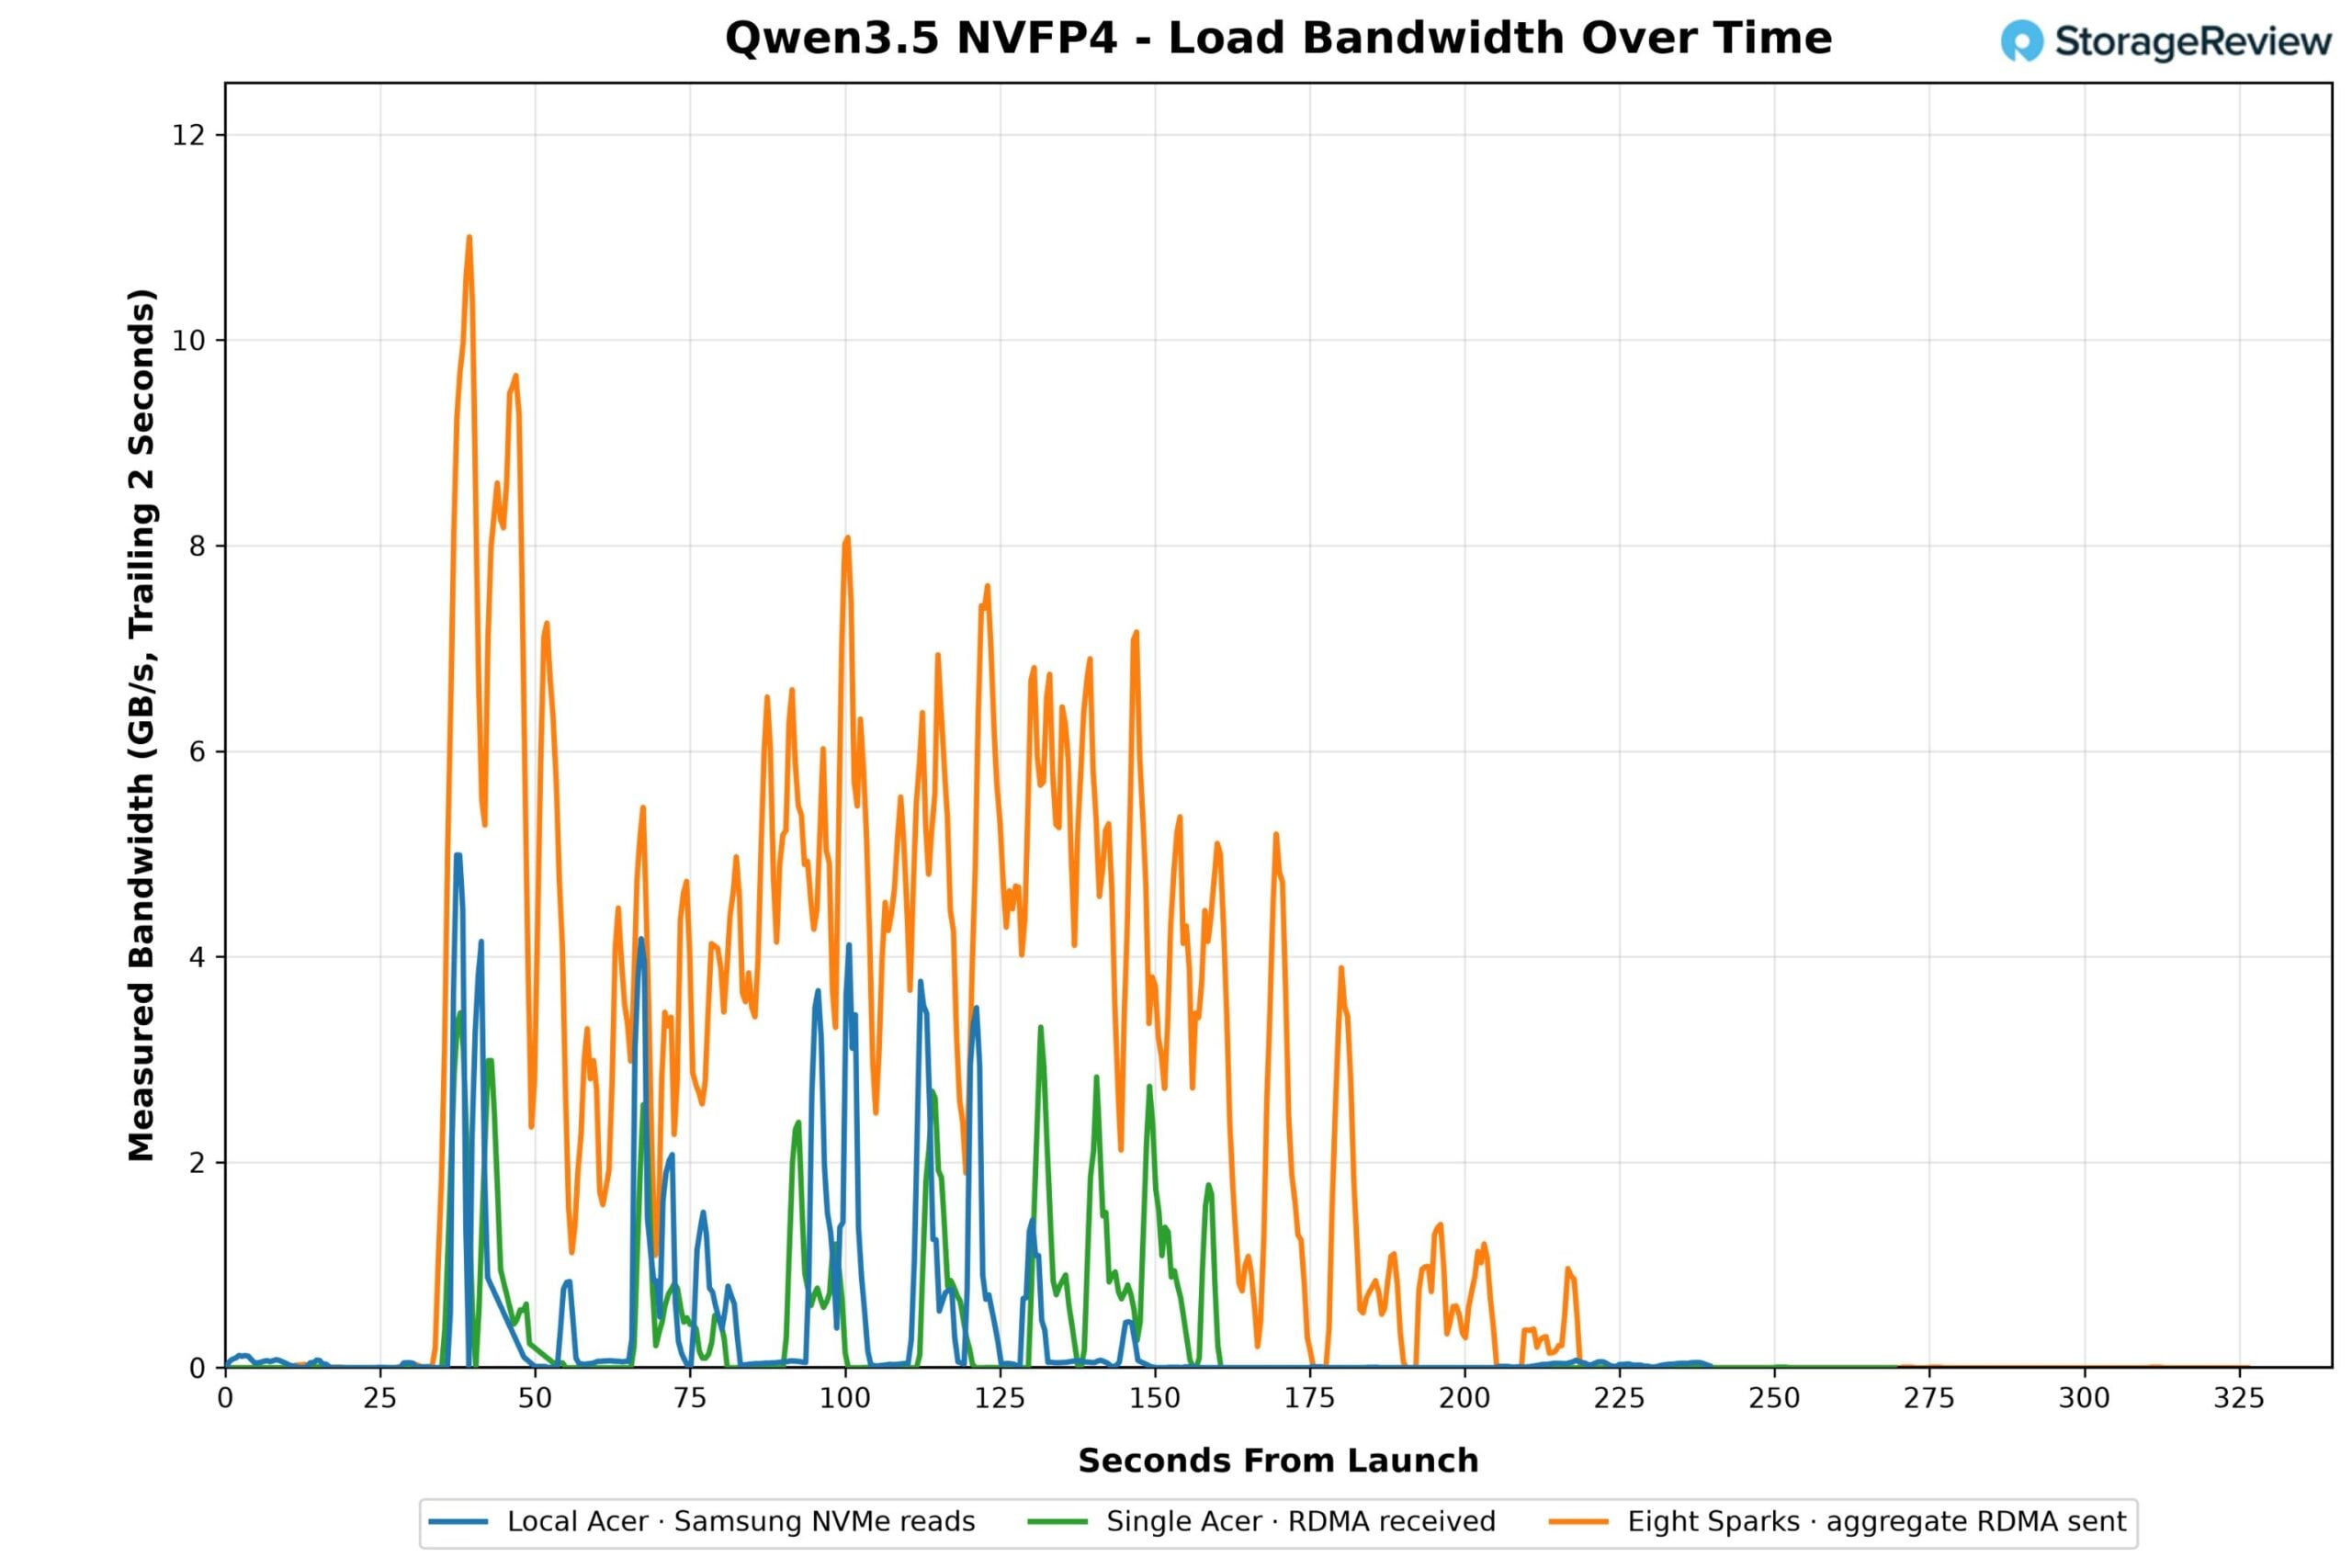
Ślad przepustowości pokazuje ten schemat: lokalne odczyty NVMe docierają w seriach, których szczyty sięgają około 5 GB/s, z długimi przerwami między nimi; pojedynczy klient NFS pokazuje ten sam kształt serii z nieco niższymi szczytami. Linia agregacji ośmiu Sparków przedstawia macierz przy jednoczesnym zapotrzebowaniu. Gdy wszystkie osiem urządzeń pobierało jednocześnie te same 78 GB, macierz osiągnęła szczytowy poziom 11 GB/s w pierwszej minucie, a następnie ustabilizowała się na poziomie około 4–8 GB/s przez kolejne dwie minuty, podczas gdy urządzenia Spark pracowały nad swoimi wagami, osiągając średnio 2.08 GB/s w całym oknie. W porównaniu z 25 GiB/s, które pokazało przeszukiwanie fio, osiem urządzeń Spark ładujących model jednocześnie zużywało ułamek dostępnej mocy.
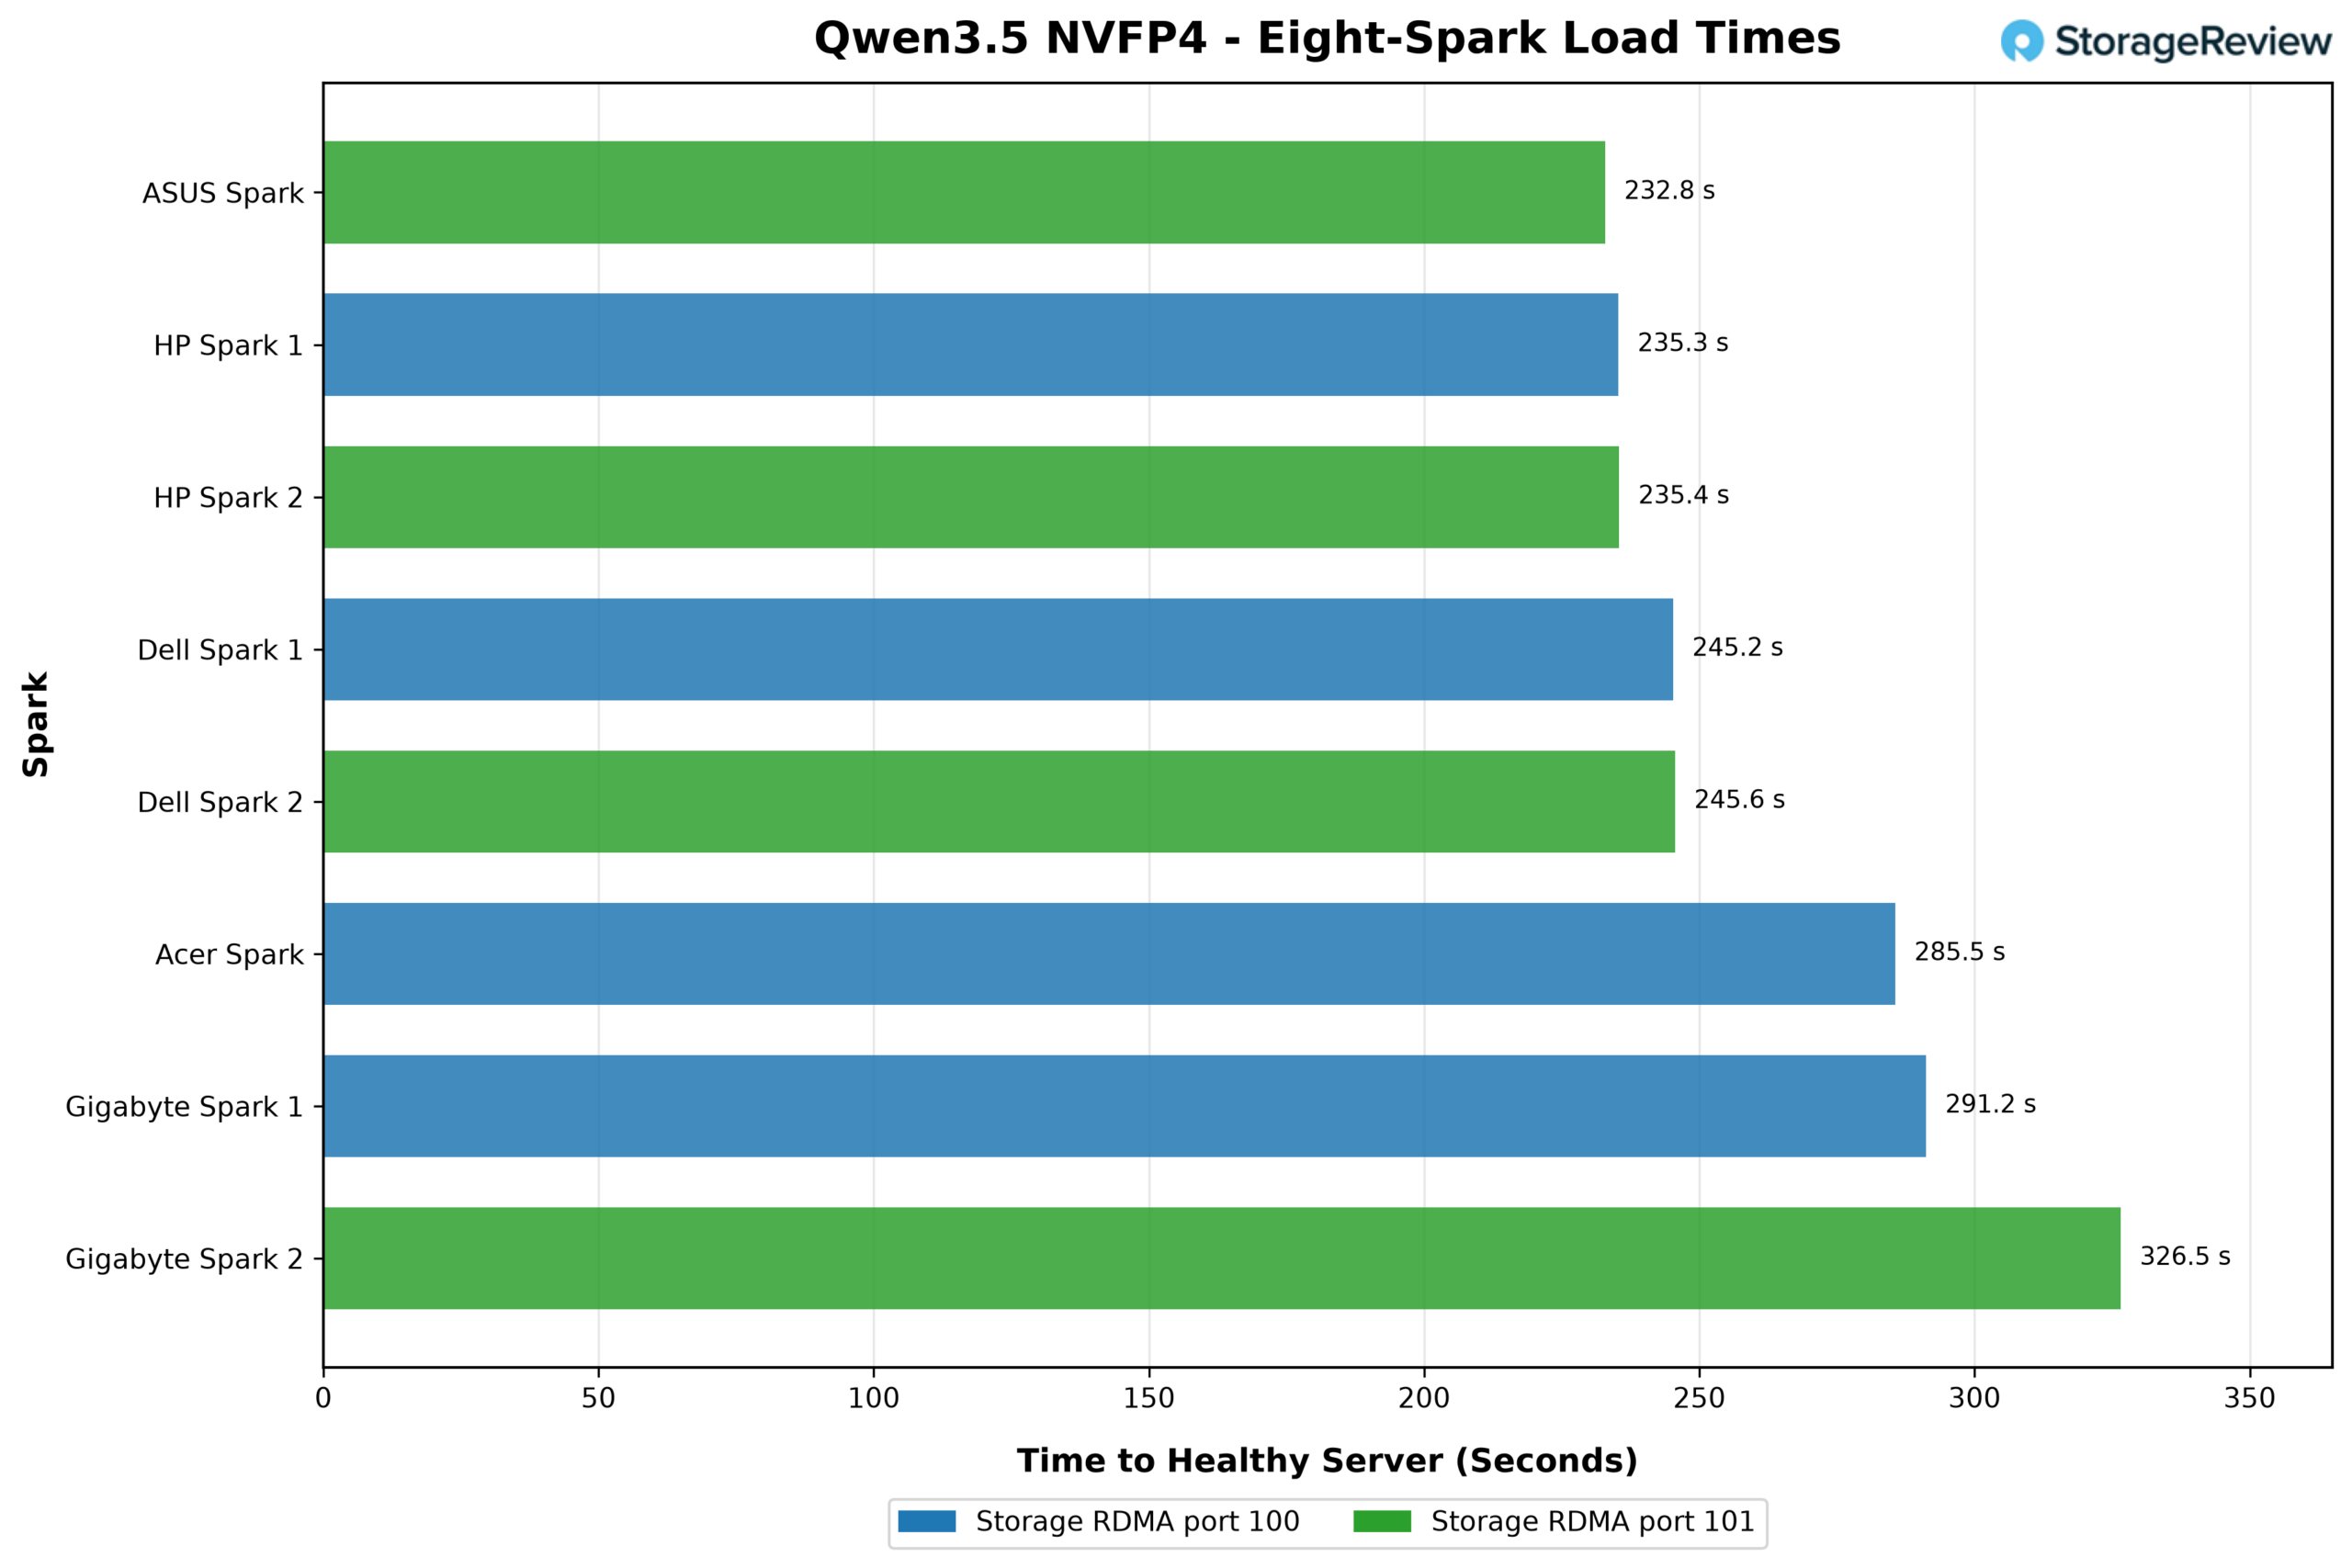
Czasy ładowania na jednostkę w teście ośmiokierunkowym wahały się od 232.8 sekundy na ASUS Ascent GX10 do 326.5 sekundy na jednej z jednostek GIGABYTE AI TOP ATOM, przy czym dwa systemy HP ZGX Nano G1n miały 235.3 i 235.4 sekundy, a dwa Dell Pro Max z jednostkami GB10 245.2 i 245.6 sekundy. Pięć z ośmiu urządzeń Spark ładowanych jednocześnie z współdzielonej macierzy pokonało pojedyncze ładowanie urządzenia Spark przez NFS/RDMA, a trzy z nich pokonały lokalne uruchomienie NVMe. Rozkład nie jest kwestią dostawcy; bez QoS w stosie, która jednostka czeka na macierz w dowolnym momencie, zmienia się z uruchomienia na uruchomienie, a dwie jednostki na każdej karcie sieciowej pamięci masowej są rozdzielone równo na szybkie i wolne końce wykresu.
W przypadku laboratorium wynik jest taki, że można przechowywać jedną kopię każdego modelu na tablicy, a każdy Spark ładuje go w czasie odpowiadającym załadowaniu kopii lokalnej, bez konieczności pobierania, zajmowania lokalnej pojemności i bez konieczności przechowywania kopii wag na biurku.
Przypadek użycia Oregon State
Wydział Nauk o Ziemi, Oceanie i Atmosferze Uniwersytetu Stanowego Oregonu wielokrotnie współpracował z nami w zakresie infrastruktury AI, od badań oceanicznych w czasie rzeczywistym na pokładzie statku badawczego po wspomaganą sztuczną inteligencją ocenę akademicką z wykorzystaniem Metrum AI . Chris Sullivan, dyrektor ds. badań i informatyki akademickiej Uniwersytetu Stanowego Oregonu, i jego architekt Thomas Olson analizują możliwości stworzenia laboratorium Spark do nauki sztucznej inteligencji, które mogłoby skalować się do 100 jednostek. Ich przemyślenia na temat pamięci masowej wpłynęły na nasz projekt na dwa konkretne sposoby.
Po pierwsze, pamięć masowa musi być niezależna od systemu Sparks. Uniwersytet Stanowy Ohio rozważał system plików rozciągnięty na same systemy Sparks i odrzucił go w klasie, ponieważ dodanie lub usunięcie pojedynczego węzła zakłóciłoby działanie usługi pamięci masowej dla wszystkich. Centralna tablica, którą montuje każdy system Spark, oznacza, że można dodać, usunąć, odtworzyć obraz lub przekazać dane innemu uczniowi bez wpływu na dane innych osób. Po drugie, pamięć masowa musi podążać za użytkownikiem. Wymagania OSU opisujemy jako ulepszoną wersję współdzielonych plików dla celów sztucznej inteligencji, w której studenci przechowują trwałe informacje podczas przemieszczania się między systemami. W przypadku NFS jest to folder dla każdego studenta; zaloguj się do dowolnego systemu Spark, zamontuj współdzielony plik, a Twoja praca będzie dostępna.
Zestawy danych są powodem, dla którego jest to ważniejsze dla OSU niż dla serwera katalogu domowego. Wydział Nauk o Ziemi, Oceanie i Atmosferze chce udostępnić studentom swoje dane badawcze, zbiory oceanograficzne i atmosferyczne mierzone w dziesiątkach terabajtów, do ich własnych badań. Nie ma takiej możliwości w przypadku pamięci masowej przy biurku: gniazdo M.2 o pojemności 4 TB nie pomieści ani jednej z tych kolekcji, a nawet laboratorium pełne zewnętrznych obudów wymagałoby zakupu i wypełnienia kopii dla każdego biurka, a następnie utrzymywania każdej kopii w aktualnej wersji, na co żaden wydział nie mógłby sobie pozwolić. Jednorazowe hostowanie danych na macierzy i zainstalowanie ich na 100 GbE to podejście, które spełnia to wymaganie w naszej ocenie. Ta sama macierz hostuje bibliotekę modeli, więc studenci spędzają sesję, uruchamiając Qwen, Llama lub dowolny inny model, bez konieczności pobierania. Ta sama zasada ma zastosowanie w przedsiębiorstwie wdrażającym systemy sztucznej inteligencji (AI) jako stacje robocze dla programistów: zamontuj produkcyjny zbiór danych w szybkiej sieci i pozwól systemowi na jego działanie, eliminując potrzebę tworzenia drugiego jeziora danych, aby komputery stacjonarne miały coś do odczytu. Dane pozostają w centrum danych, z zachowaniem kontroli dostępu, szyfrowania i systemu kopii zapasowych, które już tam istnieją, a Spark nie przechowuje niczego, co ma znaczenie, gdy opuszcza serwer.
Wniosek
Sprzęt ze sztuczną inteligencją typu Deskside jest dobry w wielu rzeczach, ale nie sprawdza się w byciu częścią zasobów danych organizacji, a pojedynczy slot M.2 w każdym systemie GB10 to gwarantuje: wszystko, czego potrzebuje użytkownik, zostaje skopiowane do lokalnej pamięci flash, niewidoczne dla działu IT, niezabezpieczone i zduplikowane na każdym innym biurku, które potrzebuje tego samego. Dla pojedynczego Sparka, zewnętrzny lokalny dysk jest rozsądnym rozwiązaniem. Dla laboratorium, działu lub przedsiębiorstwa wdrażającego ich dziesiątki, każde biurko z własnymi danymi jest silosem, a rozwiązaniem jest to, do czego centrum danych dotarło lata temu: umieść pojemność za szybką siecią, zarządzaj nią raz i udostępniaj. Sparki już mają szybką sieć; ten projekt pokazuje, co się dzieje, gdy dajesz jej jakieś miejsce, i dowodzi, że same Sparki powinny być w szafie obok.
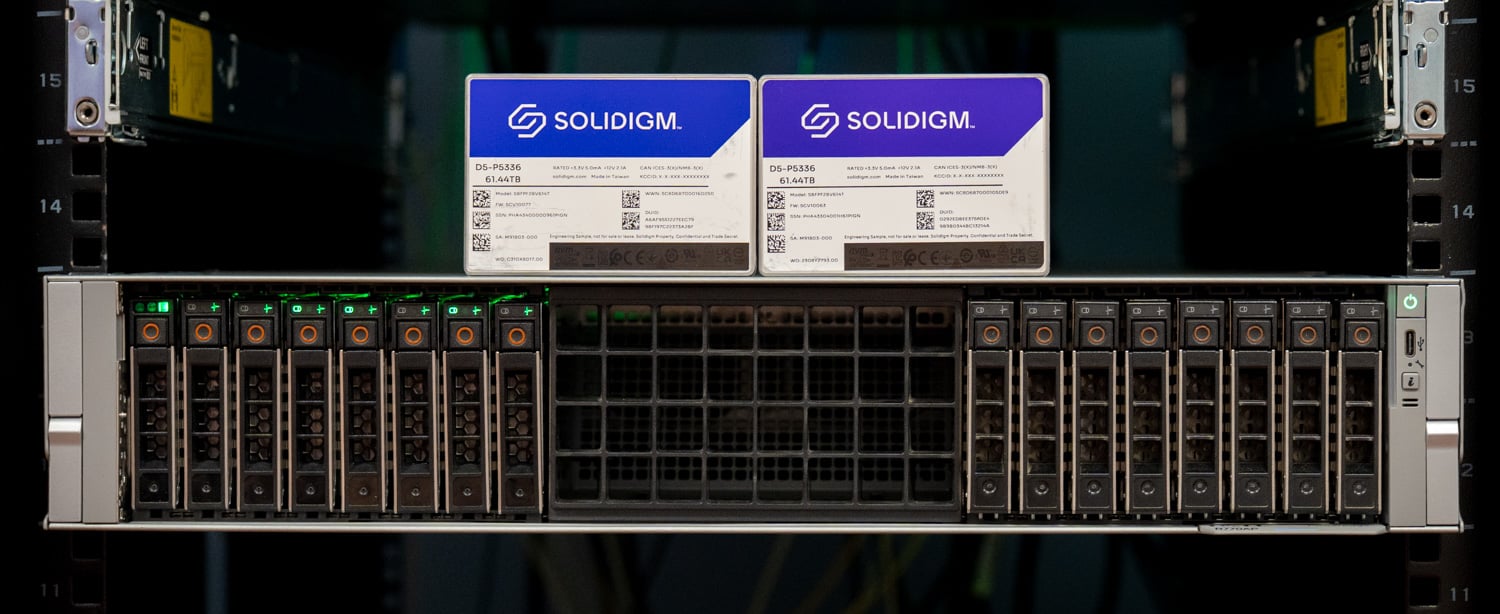
Osiem dysków Solidigm D5-P5336 QLC w konfiguracji Graid RAID 5 w serwerze Dell zapewniło ośmiu serwerom Spark pojedynczy zestaw danych z ochroną parzystości. Dwie karty sieciowe Broadcom 400GbE i karta Dell Z9864F-ON z modułem 800G zapewniły ośmiu serwerom Spark po 100GbE. Technologia Fusion NFS over RDMA firmy Tuxera umożliwiła montaż jednej linii w standardowym systemie Ubuntu z hakami usług katalogowych do kontroli dostępu. Przy stałym obciążeniu rozłożonym na wszystkie osiem serwerów, macierz zapewniła łączną prędkość odczytu sekwencyjnego 24.9 GiB/s, podzieloną równomiernie bez QoS, a jeden sam serwer Spark przeciążył łącze z prędkością 10.8 GiB/s, co jest szybkością porównywalną z najlepszym dyskiem wewnętrznym w dowolnym testowanym przez nas systemie GB10; ten limit wykorzystywał 27% możliwości dwóch kart sieciowych po stronie serwera, więc sieć jest dostosowana do serwera o większej pojemności niż ten. Test modelu potwierdził przepływ pracy: model 78 GB hostowany raz na współdzielonej macierzy ładuje się na jednym urządzeniu Spark w tempie 13% szybkości lokalnego NVMe i na ośmiu urządzeniach Spark jednocześnie, przy czym pięć z ośmiu kończy działanie szybciej niż samodzielne uruchomienie NFS.
Pamięć flash QLC sprawia, że te oszczędności się opłacają, ponieważ obciążenie jest duże i wymaga dużej pojemności, co jest mocną stroną D5-P5336, a pojedynczy serwer może pomieścić to, czego sto dysków Spark nigdy nie przeniosłoby lokalnie, z jedną kopią wszystkiego i każdą kopią pod kontrolą centrum danych. Oregon State dysponuje magazynem danych do badań produkcyjnych dla prac, które nie mogą czekać. Koncepcja, którą badają Chris Sullivan i Thomas Olson, to poziom edukacyjny, którego uczelnia nie ma dzisiaj: zarządzana, współdzielona pula danych o rozmiarze szafy lub większej liczby dysków Spark, zbudowana z serwera i kilku dysków o dużej pojemności, która mogłaby umieścić dziesiątki terabajtów rzeczywistych danych oceanograficznych i atmosferycznych przed wielkoskalowym laboratorium uczenia się sztucznej inteligencji na tej samej platformie, z której korzystają dyski Spark.
Niniejszy raport jest sponsorowany przez firmę Solidigm. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie rozpatrywanego produktu/produktów.
Odniesienia do produktów komercyjnych zawarte w tym artykule służą celom informacyjnym i nie są równoznaczne z poparciem ze strony Oregon State University.



 Amazon