

英特尔今天在OCP全球峰会上正式公布了Crescent Island的产品名称。这款英特尔D系列GPU基于Xe3P架构,最高可配备480GB LPDDR5X内存,拥有1.5TB/s的内存带宽和1.3 petaflops的FP8计算能力,所有这些都集成在一张350W风冷PCIe卡中。480GB的容量指的是合作伙伴代工的显卡;英特尔自家品牌的显卡容量为160GB。英特尔表示,目前正在向服务器OEM厂商、ODM厂商、云服务商和独立软件供应商提供样品。英特尔发布的渲染图被标记为GPU D270,这是我们目前看到的该系列显卡的首个产品编号。
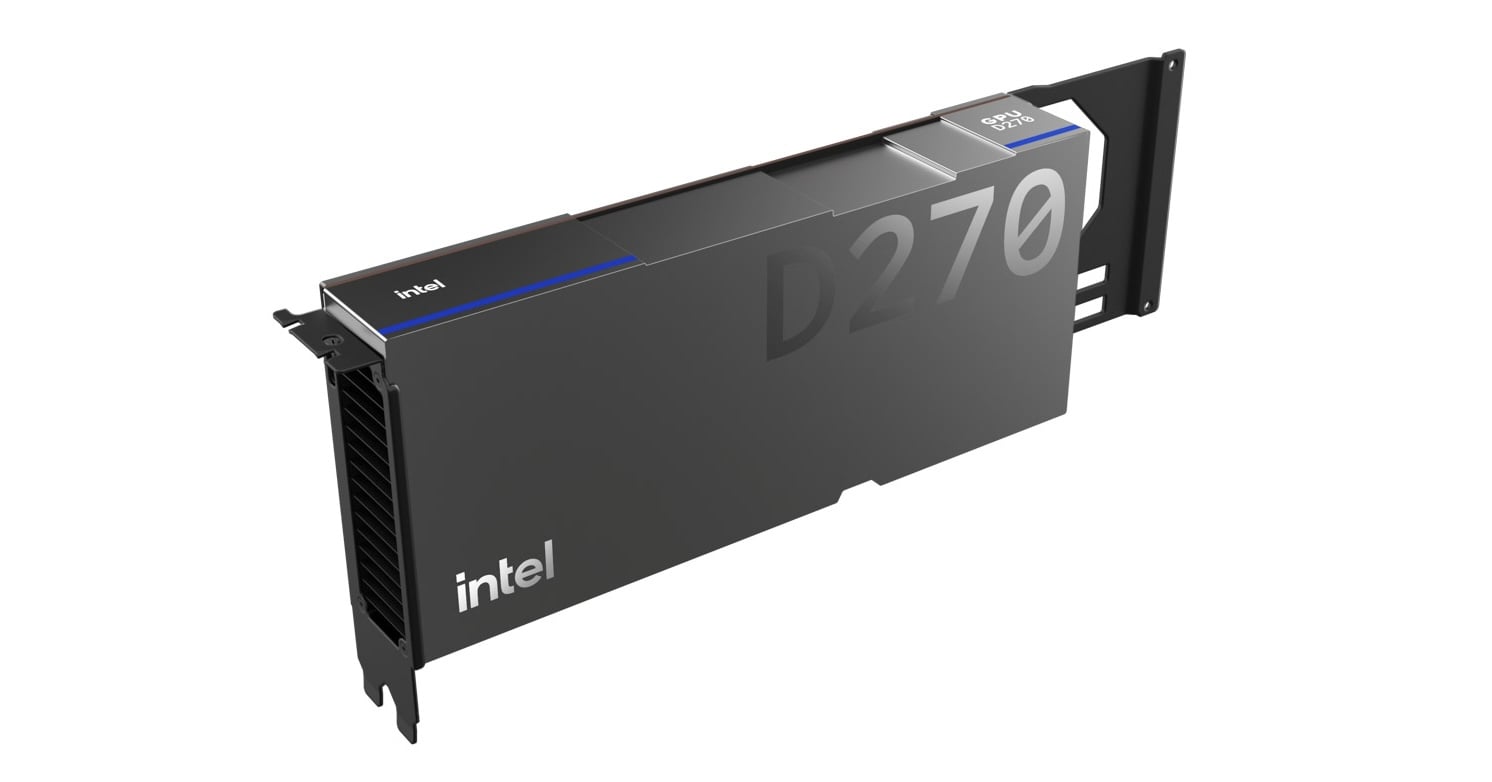
Xe3P架构面向内存密集型推理
英特尔在OCP 2025 大会上首次展示了 Crescent Island 架构,并在 8 月份的 Hot Chips 大会上详细介绍了其芯片:采用 Xe3P 架构,配备 32 个 Xe 核心和 256 个 XMX 引擎,并使用 LPDDR5X 内存取代 HBM 内存,因此该显卡可以直接安装到现有的风冷机架中。今天新增的信息包括产品名称、带宽和计算参数,以及确认客户已收到样机。
作为参考,英特尔目前发布的 PCIe 推理加速器是 Gaudi 3,配备 128GB HBM2e 显存,读写速度为 3.7TB/s。我们曾在二月份对戴尔 PowerEdge XE7740服务器中的这款显卡进行过详细评测。英特尔在 OCP 2025 大会上首次展示这款 GPU 时,将 Crescent Island 架构与 Gaudi 3 机架式设计相结合。而 D 系列显卡则反其道而行之,单卡显存容量接近 Gaudi 3 的四倍,带宽却远低于 Gaudi 3 的一半。
英特尔表示,单张D系列显卡可承载高达约3000亿个参数的模型,而配备8个GPU的主机可扩展至超过1万亿个参数。该公司将该显卡定位为持续的多租户推理和长上下文代理工作负载,在这些工作负载中,键值缓存的增长速度远超计算能力的增长速度。该显卡的带宽为1.5TB/s,远低于HBM级加速器,英特尔认为,对于解码密集型服务而言,每瓦和每美元的容量比峰值带宽更为重要。
英特尔数据中心事业部人工智能产品及市场推广副总裁 Anil Nanduri 表示:“推理正成为人工智能的核心工作负载,企业需要能够以合适的成本提供合适性能的基础设施。英特尔 GPU D 系列致力于让高容量推理的部署切实可行,并实现经济高效的扩展。” 软件方面基于通用的 Xe 平台,英特尔表示,该平台可确保其 GPU 产品线之间的二进制可移植性,因此在 Arc Pro 显卡上开发的代码无需重写内核即可移植到 D 系列显卡上。
英特尔的堆栈集成了上游运行时和服务框架,涵盖至强主机和D系列加速器,并从一开始就支持Meta的Muse Glimmer——Meta为本地代理工作构建的拥有300亿参数的开放权重模型。目前运行在至强处理器上的英特尔企业级人工智能代理工具包采用基于提供商的架构,并将随着D系列硬件的上市而逐步扩展到D系列,从而在加速器大规模应用之前就已部署好编排层。
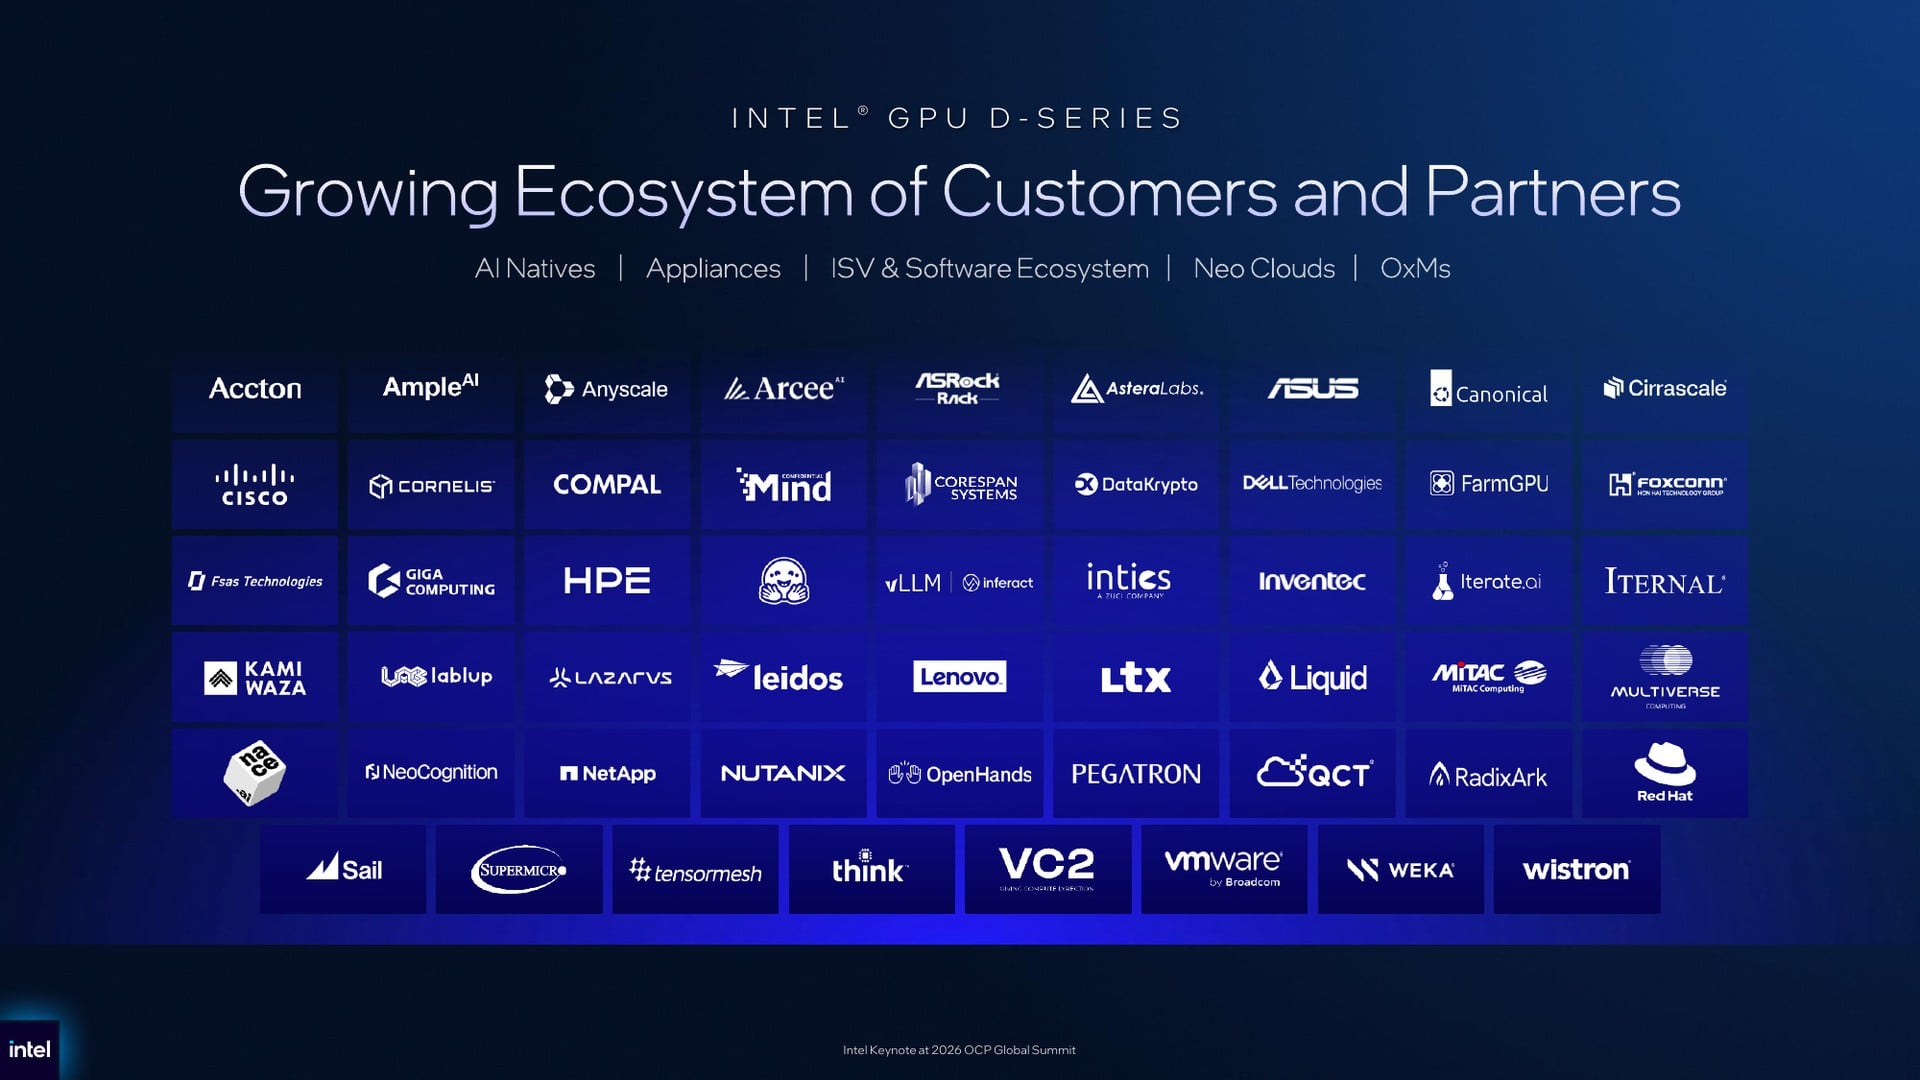
英特尔在主题演讲中展示的合作伙伴幻灯片上列出了多达 53 家公司的标志,涵盖人工智能原生企业、设备供应商、软件、新型云平台以及 OEM 和 ODM 厂商。服务器厂商的名称都在意料之中:戴尔、HPE、联想、超微、思科、华硕、华擎机架、技嘉科技、美泰科技、和硕、高通科技、纬创资通、英业达、仁宝科技和富士康。对于一款主打便携性的显卡而言,软件厂商的名单更为重要,因为该显卡上集成了 Red Hat、Canonical、博通旗下 VMware、Nutanix、NetApp、WEKA、vLLM、Hugging Face、Anyscale 和 OpenHands 等厂商的产品,互连方面则有 Astera Labs 和 Cornelis 的产品。
ORv3 Xeon 机架可扩展至超过 46,000 个核心
除了这款显卡,英特尔还展示了基于Xeon 6+ 处理器,并按照 OCP Open Rack v3 规范构建的机架级系统。英特尔表示,最高密度的配置每个机架可容纳超过 46,000 个核心,总功耗为 133.45kW。288 核的 Xeon 6+ 处理器需要 160 个插槽才能达到如此高的性能,即在一个机架中部署 80 个双路节点,每个插槽的功耗约为 834W,这还不包括机架的其他部分。英特尔将这些机架定位在代理流水线的 CPU 端,用于处理令牌路由、检索、数据库查找、代码执行以及为加速器提供 I/O 数据。
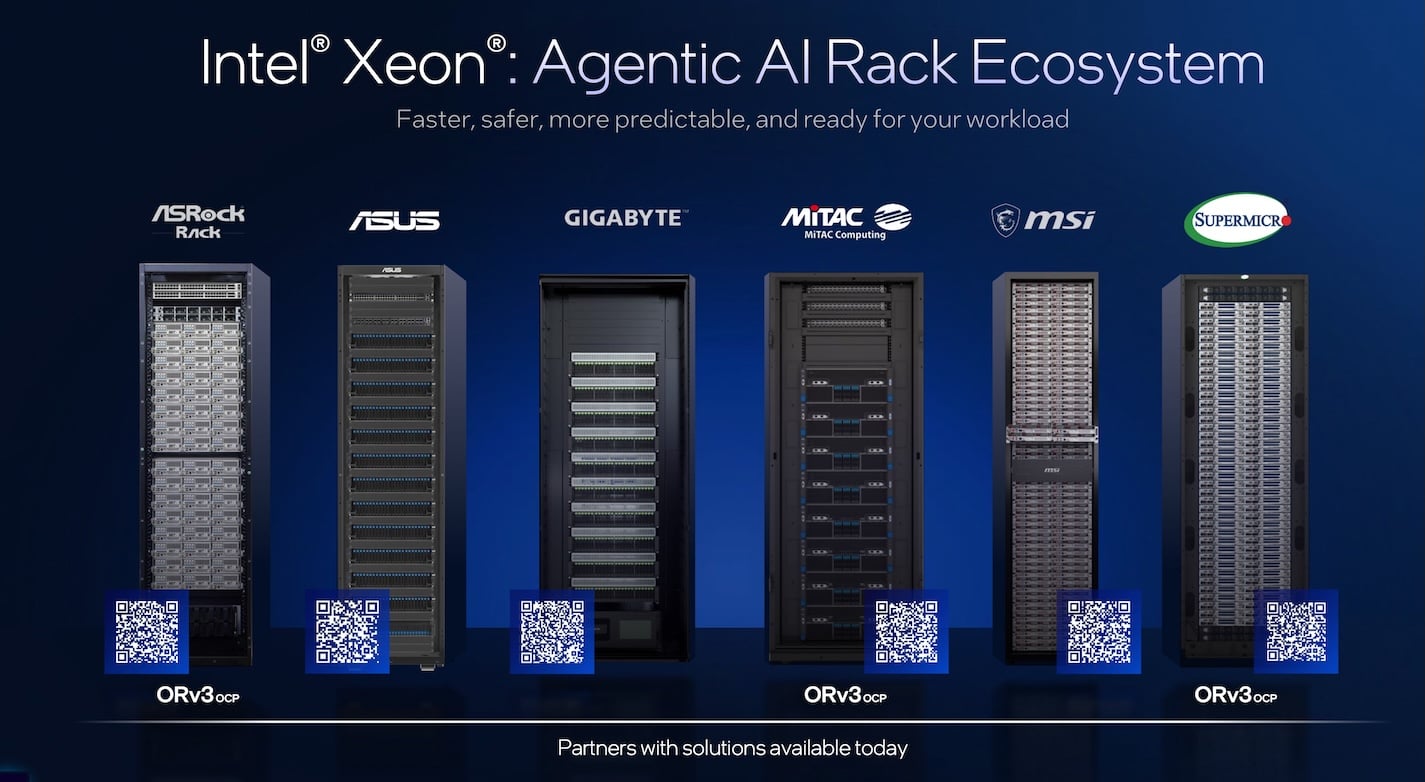
合作伙伴幻灯片列出了华擎机架 (ASRock Rack)、华硕 (ASUS)、技嘉 (GIGABYTE)、MiTAC Computing、微星 (MSI) 和超微 (Supermicro) 等厂商,他们目前均提供相关系统。展示的六款机架中,三款采用 ORv3 架构,其余三款则采用 19 英寸机箱。英特尔表示,衡量 AI 机架的标准正在转向其在目标延迟下能够支持的并发代理数量。“智能代理 AI 正在改变客户对数据中心的需求。仅仅更快地生成令牌已经不够了。基础设施必须能够协调复杂的工作流程、执行任务,并高效地大规模交付有用的工作成果。”英特尔数据中心事业部执行副总裁兼总经理 Kevork Kechichian 表示。
OCP的开放式适配器卡工作仍在继续
英特尔还提到了其在OCP开放适配器卡工作组的工作,该工作组由英特尔与AMD、戴尔、英伟达和高通于今年早些时候共同组建。该工作组正在定义一种介于标准PCIe卡和完整机架级系统之间的子机架加速器外形尺寸,并采用标准化的机械、电源和带外管理接口,以便不同厂商的加速器可以安装到同一个开放式机箱中。
该工作组的目标是为 19 英寸和 21 英寸机架式推理和中端训练平台开发高功率适配器,英特尔和 AMD 将在本周的峰会上展示该规范的最新进展。自 2011 年以来,英特尔已为 OCP 贡献了 116 项内容,Nic Dubé 的主题演讲“Put Every Prompt in Its Place”(每个提示都各就各位)定于太平洋时间 10 月 13 日上午 10:30 举行。


 Amazon