

Intel Arc Pro B70 to najbardziej wydajna i obiecująca karta AI typu desk-side, jaką Intel wypuścił, ale czasami bywa też najbardziej frustrująca. Intel ustalił cenę katalogową na 949 USD za 32 GB GDDR6, gdy karta pojawiła się na rynku w marcu tego roku. Jednak kryzys pamięci ściskający cały rynek podniósł ceny detaliczne do ponad 1,100 USD w momencie publikacji tej recenzji. Nawet wtedy B70 podbija cenę NVIDIA RTX Pro 4000, która jest wyżej wymieniona i przekroczyła 2,000 USD, pomimo oferowania 24 GB, o jedną trzecią mniej pamięci VRAM niż B70. Cztery B70 mieszczą się w jednej stacji roboczej lub serwerze, co daje 128 GB puli VRAM, wystarczającej do obsługi modeli o 120 miliardach parametrów dla ekspertów przy współbieżności, która wcześniej wymagała znacznie większych nakładów. Sprzęt jest imponujący; cena jest jeszcze bardziej imponująca. Powstrzymuje go ten sam problem, który powstrzymał B60, którego zaprezentowaliśmy w grudniu ubiegłego roku: oprogramowanie nie jest jeszcze dostępne i musimy zadać sobie pytanie: czy Intel kiedykolwiek to osiągnie?
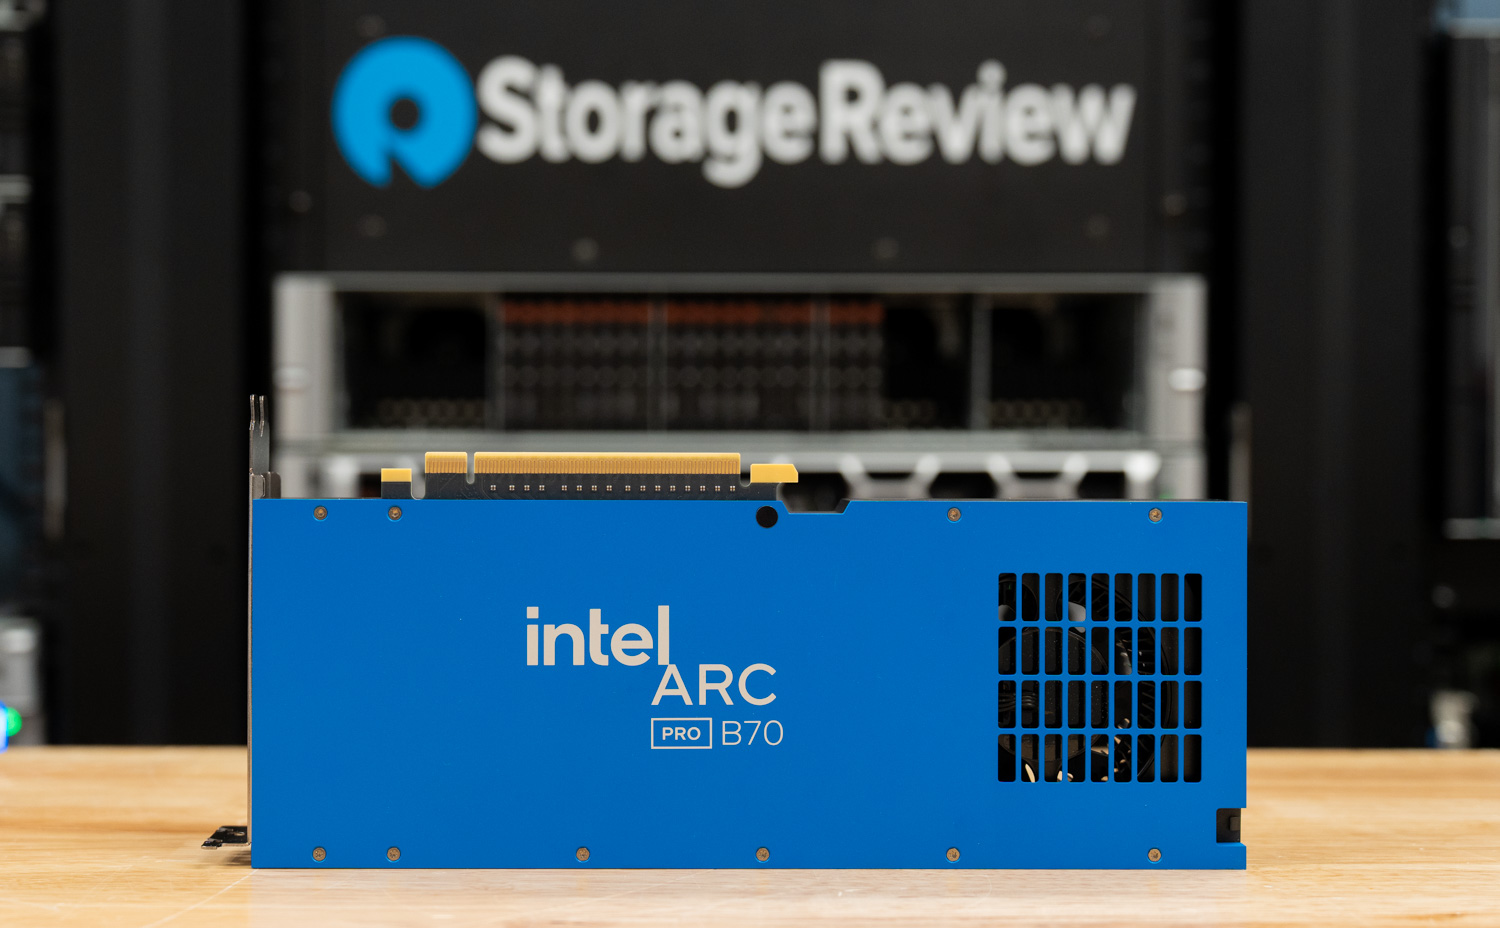
Byliśmy tu już wcześniej z Intelem więcej niż raz. Kiedy przyjrzeliśmy się Arc Pro B60 Battlematrix , historia była świetna krzem czekający na stos przedpremierowy, a B70 dziedziczy obie połowy. Karta jest zbudowana na większej matrycy BMG-G31 z 32 rdzeniami Xe2, 256 silnikami XMX i 367 INT8 TOPS. Jest zasilana przez 256-bitową magistralę o przepustowości 608 GB/s i konfigurowalną od 160 W do 290 W. W porównaniu z B60, Intel podaje zysk generacyjny na poziomie średnio 44% w obciążeniach stacji roboczych i do 69% w aplikacjach profesjonalnych. Warto wiedzieć z góry o jednym problemie wdrożenia: podczas gdy B60 jest dostarczana jako karta z dwoma procesorami graficznymi, które dzielą gniazdo x8/x8, B70 ma jeden procesor graficzny na kartę i wymaga pełnej linii PCIe 5.0 x16, co zmienia sposób zapełniania obudowy czterech kart.
Marketing Intela opiera się wyłącznie na lokalnym wnioskowaniu, a porównaniem jest karta NVIDIA RTX Pro 4000 24 GB. Według danych Intela dotyczących Linuksa, 32 GB pamięci podręcznej B70 mieści około 93 tys. tokenów KV-cache, podczas gdy RTX Pro 4000 ma 42 tys., zanim się zapełni, zapewnia do 85% wyższą przepustowość tokenów wraz ze wzrostem liczby użytkowników, odpowiada do 6.2 razy szybciej w czasie oczekiwania na pierwszy token pod obciążeniem i oferuje do 2 razy więcej tokenów za dolara. Są to dane Intela, dla pojedynczej karty, na małej karcie Llama 3.1 8B z targów BF16; przyjrzyjmy się bliżej kartom B70. Deklarowana liczba tokenów za dolara została uwzględniona w cenach katalogowych; przy obecnych cenach różnica utrzymuje się lub powiększa na korzyść Intela.
Zanim przejdziemy do testów porównawczych, ten kompromis ma znaczenie, ponieważ decyduje o tym, kto powinien kupić tę kartę już dziś. Intel LLM Scaler, gałąź rozwojowa vLLM obsługująca Battlemage, naszym zdaniem jest w najlepszym razie wciąż wersją beta. Pokrycie modelu jest ograniczone; kilka ścieżek kwantyzacji, które powinny działać, jeszcze nie działa, a stos ogranicza możliwości sprzętu. Ten sam problem zaobserwowaliśmy na Intel Gaudi 3 w Dell PowerEdge XE7740 , gdzie miękkie wyniki FP8 nie były powiązane z krzemem, ale z niedojrzałymi ścieżkami kodu w forku vLLM Intela. B70 znajduje się w tym samym miejscu. To tutaj Intel musi podjąć decyzję i trzymać się jej bardziej agresywnie niż do tej pory.
Fosa NVIDII to nie tylko CUDA. To nudne rzeczy, które liczą się przy wdrażaniu modelu: dokumentacja, przykłady, działające kontenery, odpowiedzi na forum i wystarczająco dużo historii społeczności, aby większość problemów została rozwiązana. AMD wyraźnie popycha ROCm w tym samym kierunku. Intel potrzebuje takiego samego poziomu zaangażowania w Arc Pro, w przeciwnym razie B70 ryzykuje, że stanie się kartą, którą entuzjaści kart będą chcieli polubić, ale zespoły będą miały problem z jej wdrożeniem.
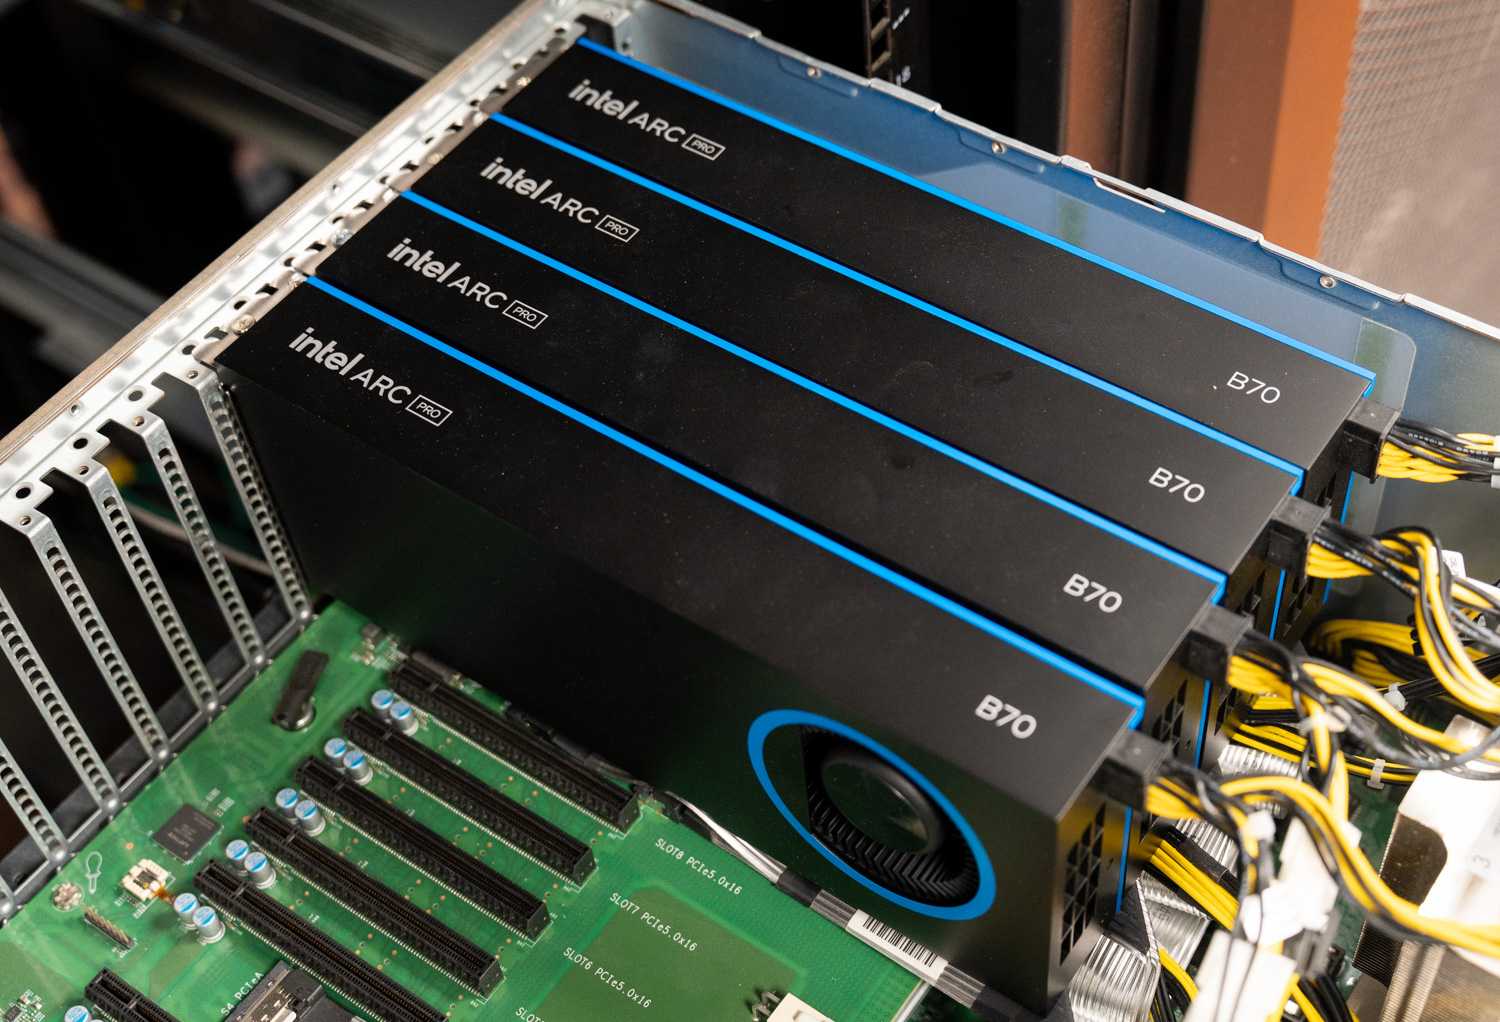
W tej recenzji, aby zapewnić czyste porównanie, zastosowaliśmy platformę identyczną z platformą B60: Supermicro AS-4125GS-TNRT z procesorami AMD EPYC 9374F i 512 GB pamięci DDR5, na której działały cztery karty B70 (128 GB) i cztery karty B60 (96 GB) w trybie vLLM. Podobnie jak w przypadku B60, nie jest to referencyjny model Intel Battlematrix, który łączy karty z hostem Xeon 6. Systemy produkcyjne oparte na procesorach Intel mogą zachowywać się inaczej. Poniższe wyniki należy traktować jako test porównawczy dla tej samej generacji i wartości, ponieważ dojrzałość oprogramowania wpływa na każdy wynik.
Specyfikacja Intel Arc Pro B70
| Specyfikacja | Intel Arc Pro B70 |
|---|---|
| Ogólne | |
| Produkt rodzinny | Karta graficzna Intel Arc Pro serii B |
| Model | Intel Arc Pro B70 |
| Nazwa kodowa | Mag bitewny |
| Mikroarchitektura | Xe2 |
| Proces technologii | TSMC N5 |
| Data wprowadzenia | Q1 2026 |
| Gwarancja | 3 Lata |
| Specyfikacje GPU | |
| Rdzenie Xe | 32 |
| Renderuj plasterki | 8 |
| Jednostki śledzenia promieni | 32 |
| Silniki Intel XMX | 256 |
| Silniki wektorowe Xe | 256 |
| Zegar graficzny | 2280 MHz |
| Maksymalny zegar dynamiczny | 2800 MHz |
| Wydajność FP32 | X TFTPS |
| Wydajność INT8 AI | 367 TOPS |
| Całkowita moc płyty (TBP) | 230 W (konfigurowalne: 160–290 W) |
| Interfejs PCI Express | PCIe 5.0 x16 |
| Pamięć | |
| Pojemność pamięci | 32GB GDDR6 |
| Magistrala pamięci | 256-bit |
| Przepustowość pamięci | 608 Gb / s |
| Pamięć ECC | Utrzymany |
| Wyświetlacz i wejście/wyjście | |
| Wyświetl wyjścia | DisplayPort 2.1 |
| Maksymalna liczba wyświetlaczy | 4 |
| Maksymalna rozdzielczość | 7680 × 4320 @ 120 Hz (HDMI / DisplayPort) |
| Zmienna częstotliwość odświeżania | HDMI VRR, adaptacyjna synchronizacja VESA |
| Funkcje i oprogramowanie | |
| Kodowanie/dekodowanie wideo | H.264, H.265 (HEVC), AV1 |
| Ray Tracing | Utrzymany |
| Struktury sztucznej inteligencji | oneAPI, OpenVINO, rozszerzenie Intel dla PyTorch (IPEX) |
| Interfejsy API graficzne | DirectX 12 Ultimate, Vulkan 1.3, OpenGL 4.6, OpenCL 3.0 |
| Intel XeSS | Utrzymany |
| Obsługa HDR | HDR10, HDR10+ Gaming, Dolby Vision |
| Silniki kodeków wieloformatowych | 2 |
| Parametry fizyczne | |
| Wymiary | 10.5 × 3.9 cale |
| Szerokość gniazda | Podwójne gniazdo |
| Waga | 1020g |
| Złącze zasilania | 1 × 8-pinowe (ATX 2 × 4) |
Budowa i projekt procesora Intel Arc Pro B70
Karta Intel Arc Pro B70 o wymiarach 10.5 × 3.9 cala (267 × 99 mm) i wadze 2.25 funta (1 kg) charakteryzuje się kompaktową, dwugniazdową konstrukcją o czystym, stonowanym wyglądzie. Karta jest wykończona w matowym, czarnym kolorze z charakterystycznymi dla Intela niebieskimi akcentami. Posiada pełnowymiarową, anodowaną aluminiową płytę tylną, która zwiększa sztywność i pasuje do brandingu Intela.
Karta wyposażona jest w pojedynczy wentylator, który zasysa powietrze przez radiator i wydmuchuje je bezpośrednio przez tylny wspornik I/O. Ta zamknięta konstrukcja chłodzenia pozwala na kompaktowe wymiary karty i zapewnia czysty przepływ powietrza w systemie.
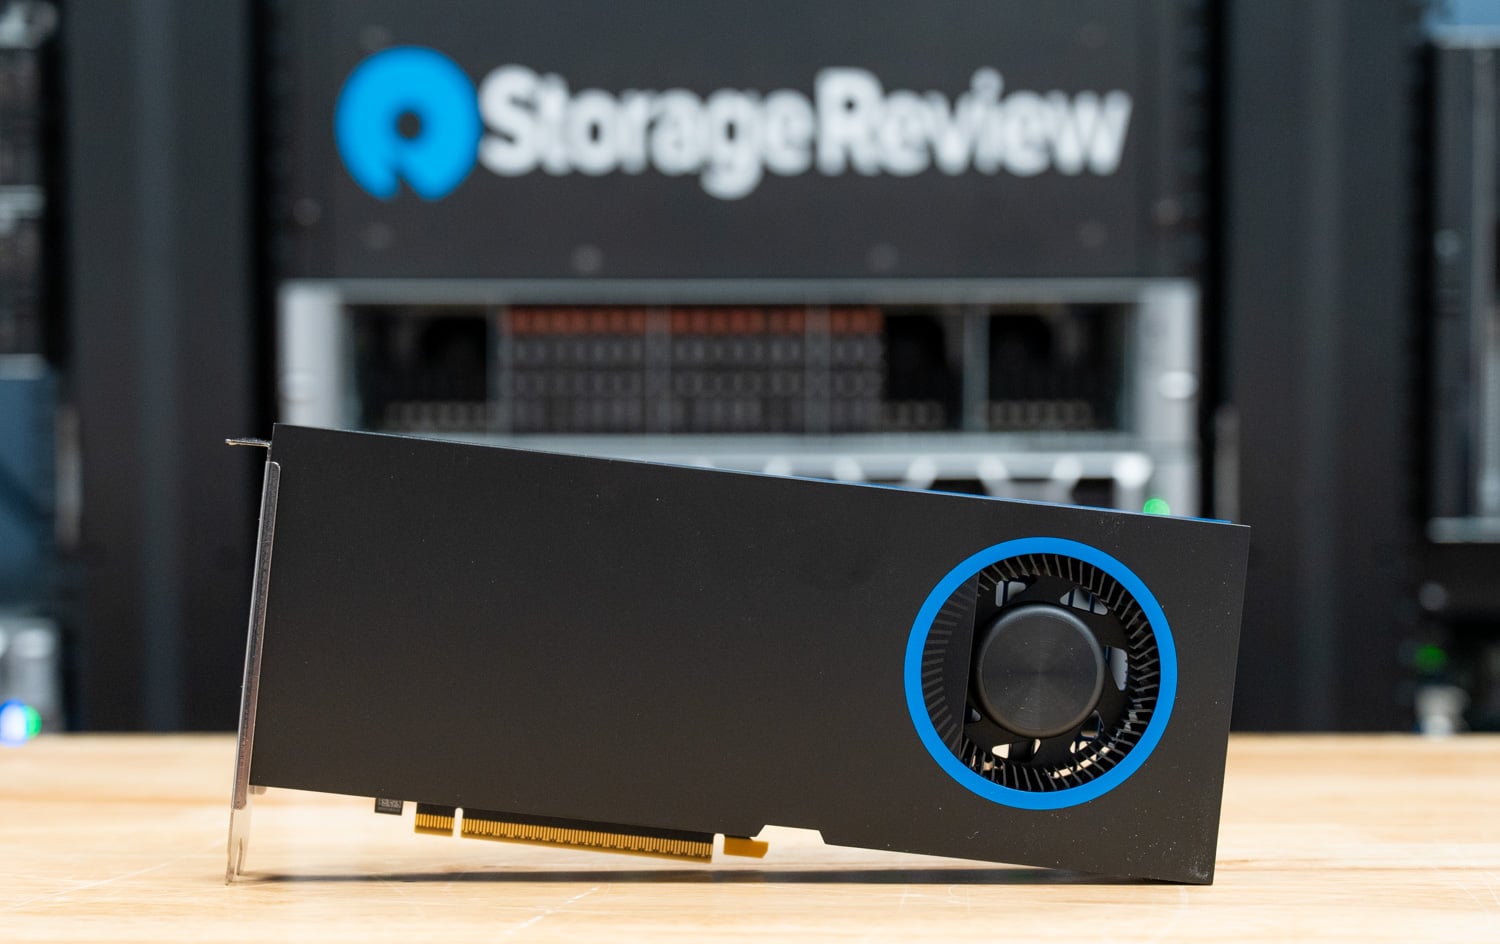
Z tyłu karty, naprzeciwko wspornika PCIe, Intel umieścił pojedyncze, 8-pinowe (2×4) złącze zasilania PCIe do zasilania zewnętrznego. Ta strona osłony ma również dodatkowe otwory wlotowe, które dostarczają świeże powietrze do wentylatora, a także gwintowane punkty montażowe do mocowania opcjonalnego wspornika GPU, co poprawia stabilność wdrożeń stacji roboczych.
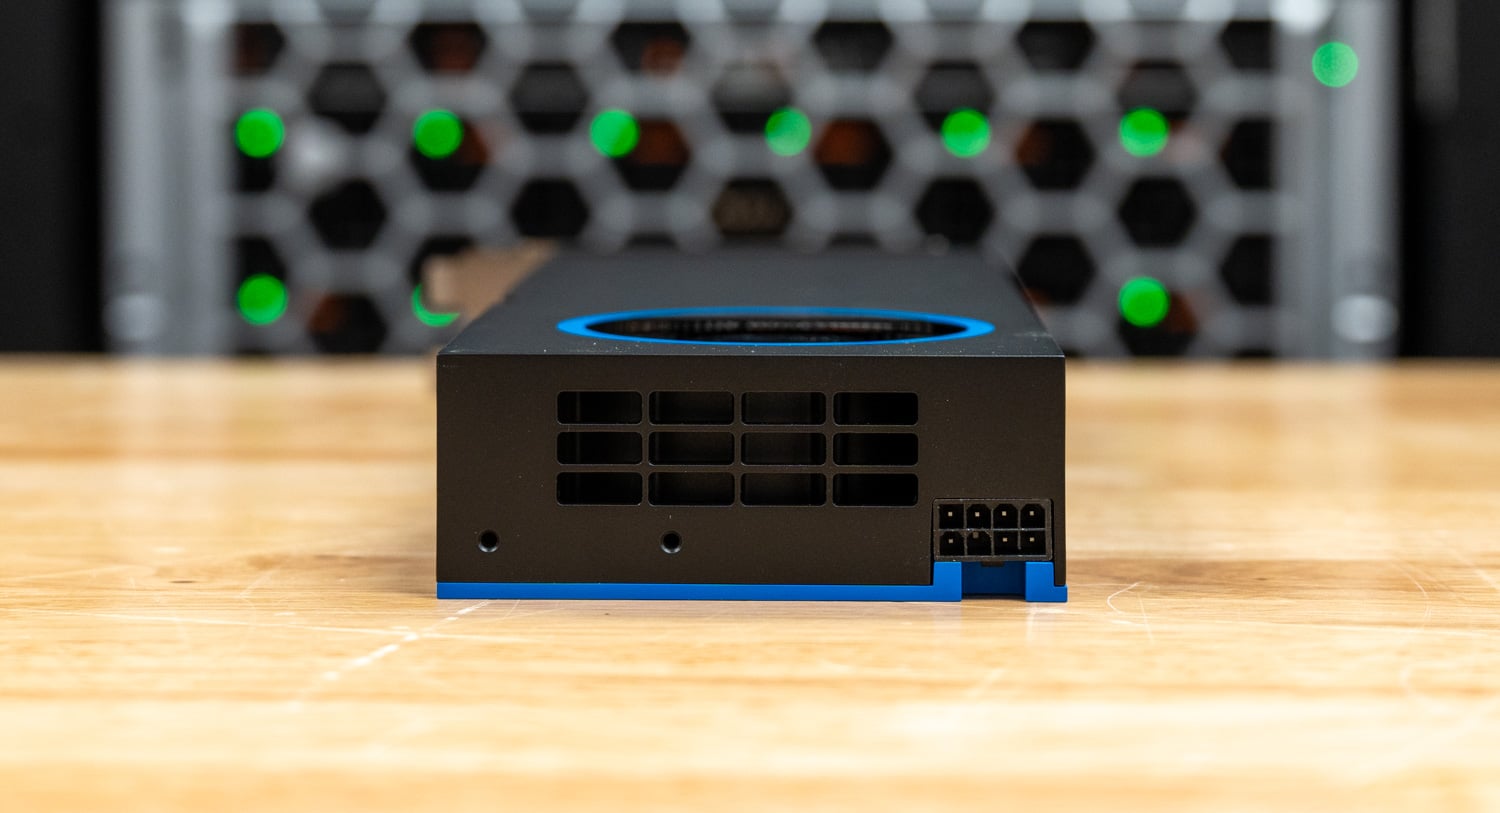
Wzdłuż dolnej krawędzi, Arc Pro B70 wykorzystuje standardowy interfejs PCIe 5.0 x16 do łączności z hostem. Ten kąt uwydatnia również dwuslotowy format karty. Zapewnia ona wystarczająco dużo miejsca na zamknięty system chłodzenia, a jednocześnie jest na tyle kompaktowa, że nadaje się do instalacji w stacjach roboczych i serwerach o dużej gęstości.
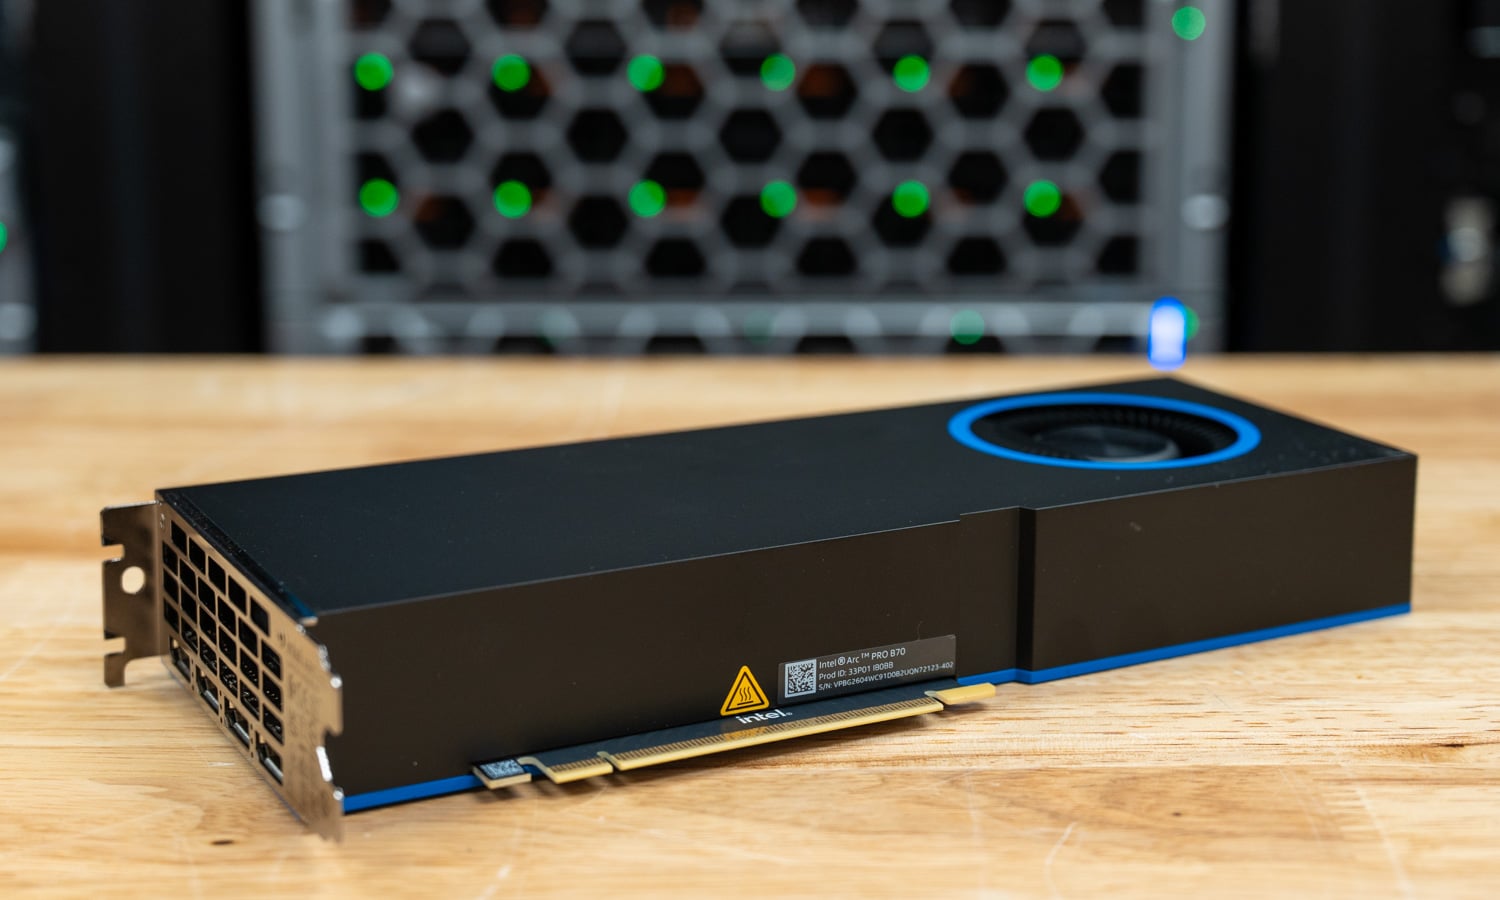
Wspornik wejścia/wyjścia posiada duży otwór wentylacyjny, który pozwala wentylatorowi na odprowadzanie gorącego powietrza bezpośrednio z obudowy. Pod otworem wentylacyjnym znajdują się cztery wyjścia DisplayPort 2.1, z których każde obsługuje wyświetlacze o rozdzielczości do 7680 × 4320 (8K) przy częstotliwości 120 Hz, zapewniając wystarczającą przepustowość dla środowisk wielomonitorowych o wysokiej rozdzielczości.
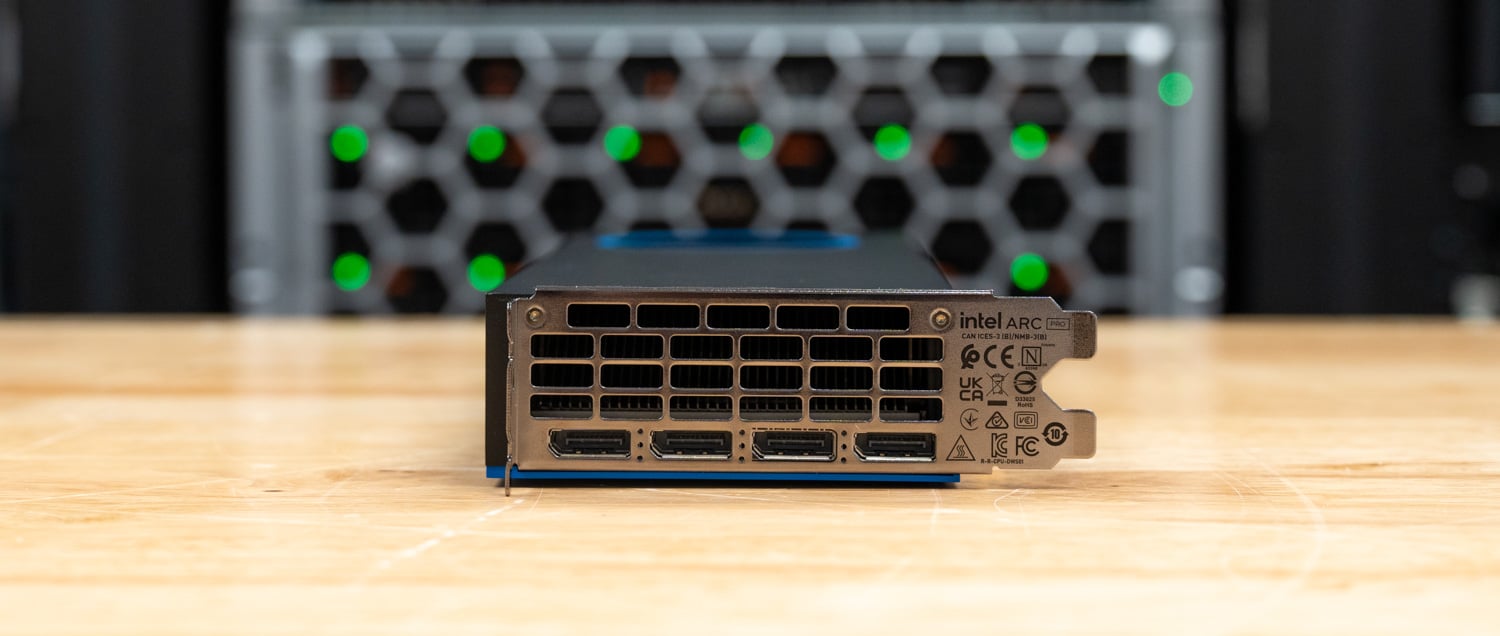
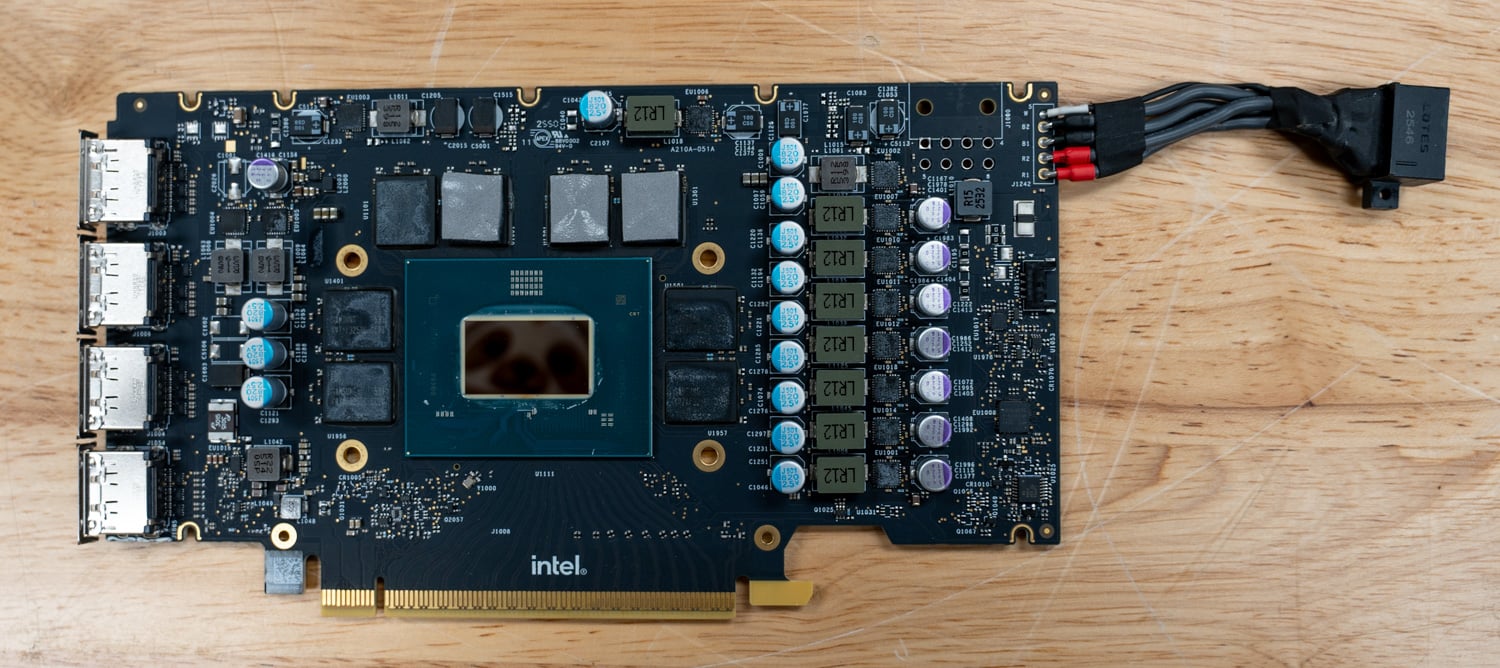
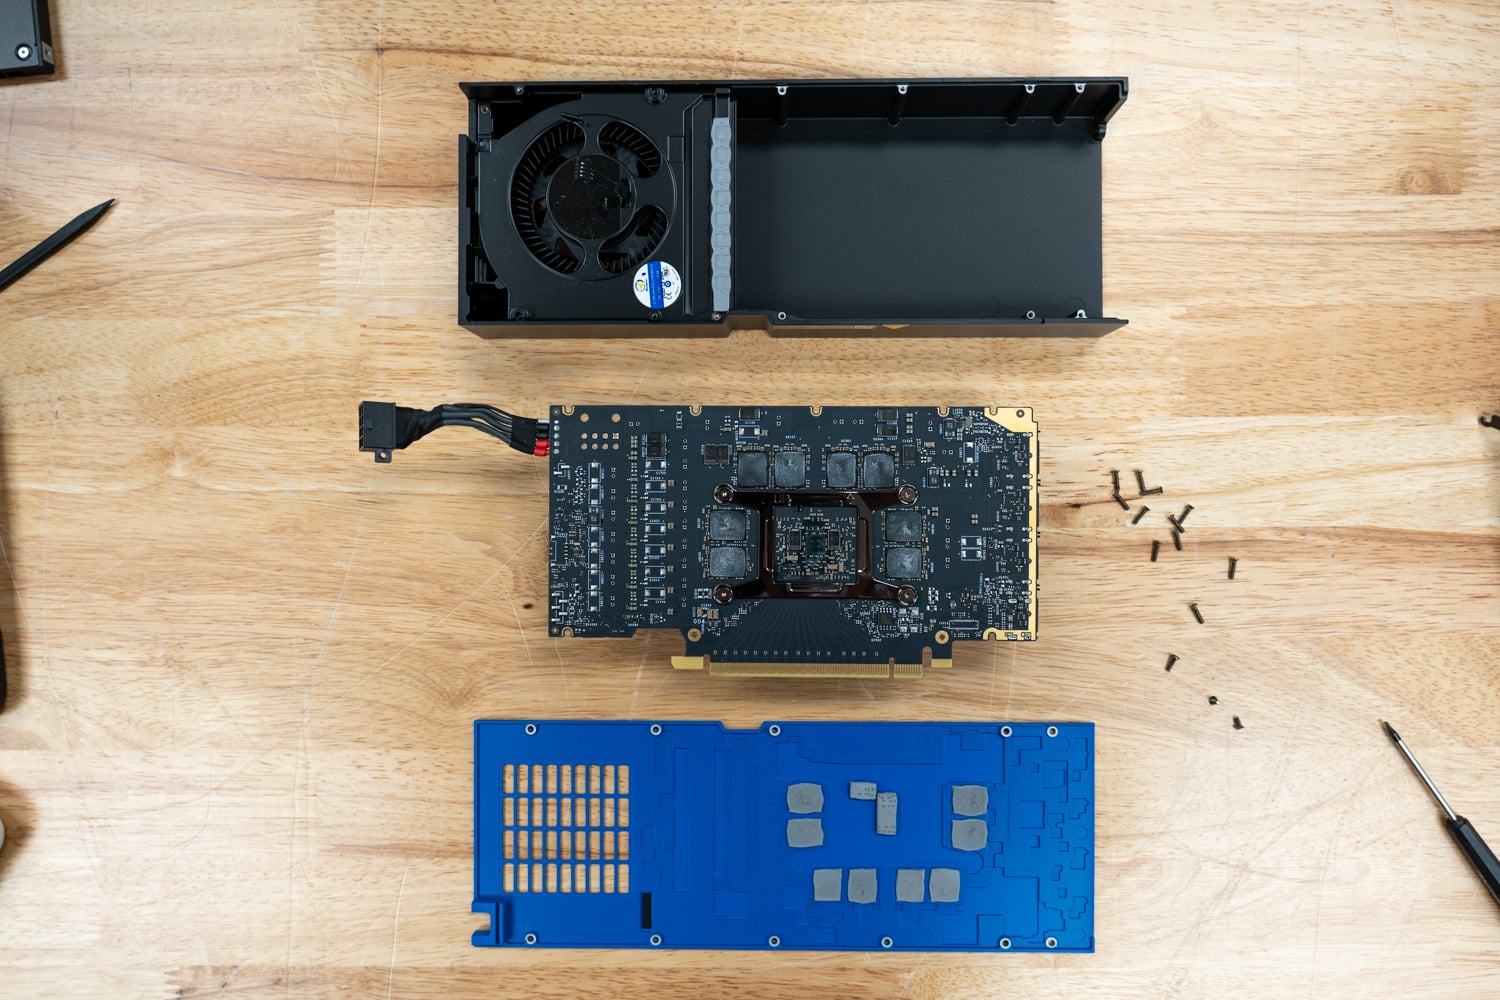
Po usunięciu chłodnicy, płytka PCB Arc Pro B70 odsłania główne komponenty zasilające kartę. W jej centrum znajduje się 32-rdzeniowy procesor graficzny Intel Xe2-HPG, otoczony 32 GB dedykowanej pamięci GDDR6 połączonej 256-bitowym interfejsem pamięci, zapewniającym przepustowość do 608 GB/s. Procesor graficzny integruje również 256 silników sztucznej inteligencji XMX, generujących do 367 INT8 TOPS wydajności obliczeniowej AI, a także 32 dedykowane jednostki Ray Tracing do sprzętowej akceleracji zadań śledzenia promieni. Wokół procesora graficznego znajdują się stopnie zasilania, obwody pamięci oraz komponenty wyjściowe wyświetlacza, które wspierają konstrukcję karty.
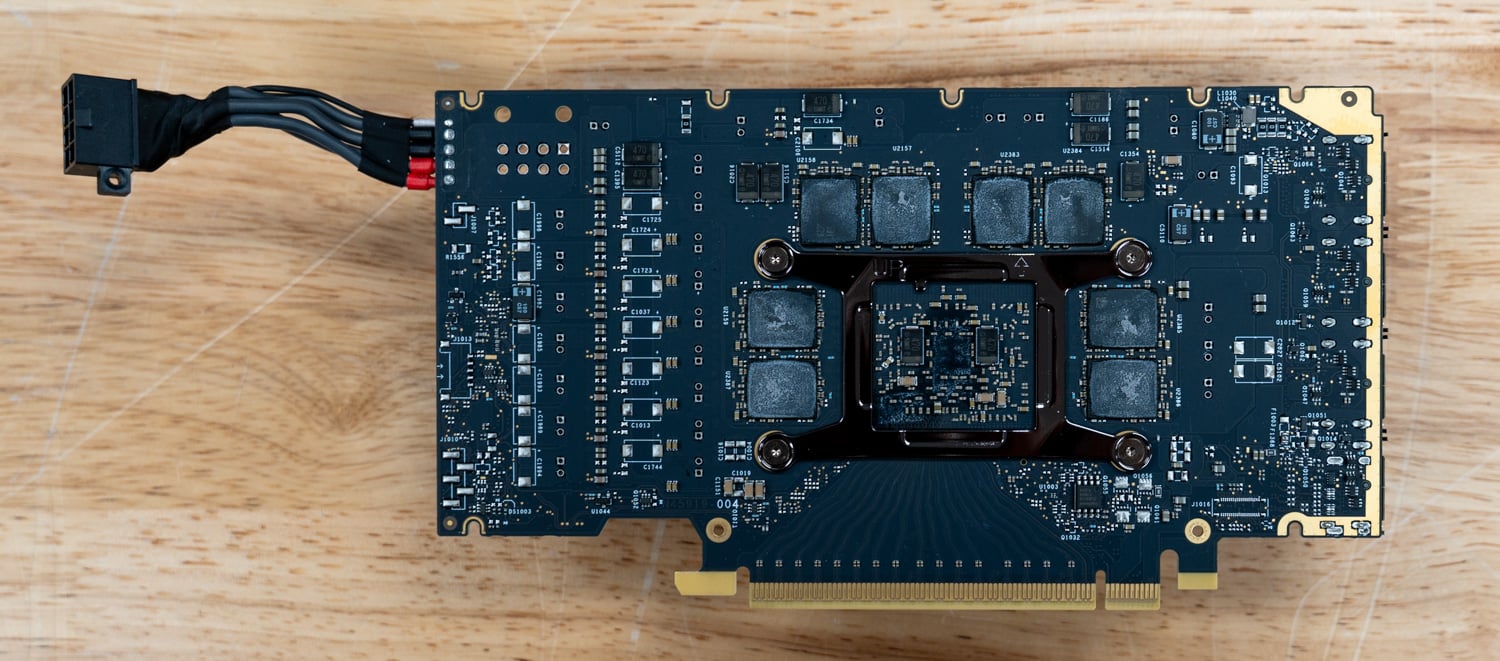
Tylna część płytki PCB odsłania kolejne moduły pamięci GDDR6 oraz elementy układu zasilania karty. Duży uchwyt mocujący otaczający moduł GPU pomaga równomiernie rozprowadzić nacisk z radiatora. 8-pinowe złącze zasilania PCIe zapewnia zewnętrzne zasilanie karty. Dzięki zasilaniu przez gniazdo PCIe, Arc Pro B70 może pobierać do 230 W całkowitej mocy płyty.
Testy wydajności Intel Arc Pro B70
Testowanie systemu Windows – platforma testowa StorageReview AMD Threadripper
Oto platforma testowa, której będziemy używać do testów pojedynczego procesora Intel Arc Pro B70:
- płyta główna: ASUS Pro WS TRX50-SAGE WIFI
- PROCESOR: AMD Ryzen Threadripper 7980X 64-rdzeniowy
- RAM: 128 GB DDR5 4800MT/s
- Przechowywanie: 2 TB Samsunga 980 Pro
- OS: Windows 11 Pro dla stacji roboczych
Porównywalne przetestowane procesory graficzne
- Intel Arc Pro B50
- Intel Arc Pro B70
- AMD Radeon RX 9060 XT
- AMD Radeon RX 9070
- AMD Radeon RX 9070 XT
- NVIDIA GeForce RTX 5060 Ti
- NVIDIA GeForce RTX 5070FE
UL Procyon: generowanie tekstu AI
Test Procyon AI Text Generation Benchmark usprawnia testowanie wydajności AI LLM dzięki zwięzłej i spójnej metodzie oceny. Umożliwia on wielokrotne testowanie wielu modeli LLM, minimalizując jednocześnie złożoność dużych modeli i wpływ zmiennych czynników. Opracowany we współpracy z liderami w dziedzinie sprzętu AI, optymalizuje wykorzystanie lokalnych akceleratorów AI, zapewniając bardziej niezawodne i wydajne oceny wydajności. Poniższe wyniki uzyskano przy użyciu TensorRT na modelach NVIDIA oraz ONNX na modelach AMD.
Karta Arc Pro B70 oferuje jedną z największych ulepszeń generacyjnych w tym porównaniu, zwiększając ogólne wyniki o 60% w porównaniu z kartą B50 w modelach Phi, Mistral i Llama 3, jednocześnie skracając czas do pierwszego tokena o 40-45%. W porównaniu z AMD, karta B70 uzyskała o 224% wyższy wynik niż Radeon RX 9060 XT w Phi (4,152 w porównaniu z 1,281), o 220% wyższy wynik w Mistral (4,082 w porównaniu z 1,274) i o 250% wyższy w Llama 3 (4,029 w porównaniu z 1,150). W porównaniu z Radeonem RX 9070 XT, Intel nadal utrzymuje przewagę odpowiednio 100%, 83% i 95%. NVIDIA zmniejsza różnicę, a RTX 5060 Ti ustępuje B70 o 45% w Phi i 45% w Mistral, podczas gdy RTX 5070 pozostaje o 15-20% w tyle w tych samych modelach. Najbardziej wyróżniającym się wynikiem jest Llama 2, gdzie B70 uzyskał najwyższy wynik w całym porównaniu – 5,769, przewyższając RTX 5070 o 85% i RX 9070 XT o 151%.
| UL Procyon: generowanie tekstu AI | Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| Wynik ogólny Phi | 2,593 | 4,152 | 1,281 | 1,933 | 2,080 | 2,870 | 3,453 |
| Czas wyjścia Phi do pierwszego tokena | 0.275 s | 0.155 s | 1.473 s | 0.954 s | 0.855 s | 0.375 s | 0.323 s |
| Tokeny wyjściowe Phi na sekundę | 72.128 tokenów/sek. | 104.121 tokenów/sek. | 94.453 tokenów/sek. | 139.187 tokenów/sek. | 144.471 tokenów/sek. | 120.773 tokenów/sek. | 150.435 tokenów/sek. |
| Całkowity czas trwania Phi | 39.179 s | 37.924 s | 39.365 s | 26.989 s | 25.587 s | 25.216 s | 20.302 s |
| Wynik ogólny Mistral | 2,483 | 4,082 | 1,274 | 2,040 | 2,231 | 2,807 | 3,562 |
| Czas wyjścia Mistral do pierwszego tokena | 0.346 s | 0.180 s | 1.827 s | 1.109 s | 0.946 s | 0.526 s | 0.433 s |
| Żetony wyjściowe Mistral na sekundę | 46.799 tokenów/sek. | 65.834 tokenów/sek. | 65.115 tokenów/sek. | 101.300 tokenów/sek. | 103.348 tokenów/sek. | 91.057 tokenów/sek. | 120.507 tokenów/sek. |
| Całkowity czas trwania Mistrala | 59.907 s | 58.976 s | 54.516 s | 34.960 s | 33.350 s | 33.377 s | 25.496 s |
| Ocena ogólna Llama3 | 2,427 | 4,029 | 1,150 | 1,904 | 2,070 | 2,599 | 3,125 |
| Czas wyjścia Llama3 do pierwszego tokena | 0.311 s | 0.166 s | 1.632 s | 0.981 s | 0.845 s | 0.449 s | 0.379 s |
| Tokeny wyjściowe Llama3 na sekundę | 45.031 tokenów/sek. | 66.340 tokenów/sek. | 53.167 tokenów/sek. | 87.594 tokenów/sek. | 89.102 tokenów/sek. | 74.709 tokenów/sek. | 100.388 tokenów/sek. |
| Całkowity czas trwania Llama3 | 61.926 s | 53.687 s | 62.563 s | 38.273 s | 36.742 s | 39.489 s | 29.720 s |
| Ocena ogólna Llama2 | - | 5,769 | 1,252 | 2,047 | 2,298 | 2,576 | 3,125 |
| Czas wyjścia Llama2 do pierwszego tokena | - | 0.259 s | 2.992 s | 1.926 s | 1.565 s | 0.844 s | 0.785 s |
| Tokeny wyjściowe Llama2 na sekundę | - | 63.666 tokenów/sek. | 34.654 tokenów/sek. | 59.673 tokenów/sek. | 61.127 tokenów/sek. | 41.386 tokenów/sek. | 56.647 tokenów/sek. |
| Całkowity czas trwania Llama2 | - | 44.131 s | 99.027 s | 59.100 s | 55.520 s | 71.302 s | 53.234 s |
UL Procyon: Generowanie obrazu AI
Test Procyon AI Image Generation Benchmark spójnie i dokładnie mierzy wydajność wnioskowania AI w szerokim zakresie sprzętu, od energooszczędnych procesorów NPU po zaawansowane procesory graficzne (GPU). Obejmuje on trzy testy: Stable Diffusion XL (FP16) dla zaawansowanych procesorów graficznych, Stable Diffusion 1.5 (FP16) dla procesorów graficznych o umiarkowanej mocy oraz Stable Diffusion 1.5 (INT8) dla urządzeń o niskim poborze mocy. Test wykorzystuje optymalny silnik wnioskowania dla każdego systemu, zapewniając uczciwe i porównywalne wyniki.
Generowanie obrazu to kolejny obszar, w którym Arc Pro B70 wykazuje znaczącą poprawę w porównaniu ze swoim mniejszym odpowiednikiem, osiągając o 179% wyższy wynik w teście Stable Diffusion 1.5 FP16 (2,101 vs. 754), a jednocześnie skracając czas generowania obrazu ze 132.6 sekundy do 47.6 sekundy, co stanowi redukcję o 64%. B70 zasadniczo dorównuje RTX 5060 Ti (2,101 vs. 2,110, różnica poniżej 1%), tracąc jednocześnie 19% do RX 9070 XT i 29% do RTX 5070. W teście Stable Diffusion XL FP16, Intel ponownie niemal trzykrotnie przewyższa wydajność B50 (o 181% wyższą) i plasuje się zaledwie o 8% wyżej od RTX 5060 Ti, tracąc jednocześnie około 18% do RTX 5070 FE. Obciążenie INT8 faworyzuje implementację TensorRT firmy NVIDIA, choć procesor B70 i tak jest o 265% lepszy od procesora B50 i skraca czas generowania obrazu o ponad 72%.
| UL Procyon: generowanie obrazu AI (ogólny wynik: im wyższy tym lepiej) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| Stabilna dyfuzja 1.5 (FP16) — wynik ogólny | 754 | 2,101 | 1,436 | 2,110 | 2,280 | 2,598 | 2,937 |
| Stabilna dyfuzja 1.5 (FP16) — czas całkowity | 132.585 s | 47.585 s | 69.633 s | 47.590 s | 43.858 s | 38.481 s | 34.038 s |
| Stabilna dyfuzja 1.5 (FP16) — prędkość generowania obrazu | 8.287 s/obraz | 2.974 s/obraz | 4.352 s/obraz | 2.974 s/obraz | 2.741 s/obraz | 2.405 s/obraz | 2.127 s/obraz |
| Stabilna dyfuzja 1.5 (INT8) — wynik ogólny | 5,020 | 18,344 | N / A | 27,705 | N / A | N / A | 36,320 |
| Stabilna dyfuzja 1.5 (INT8) — czas całkowity | 49.795 s | 13.628 s | N / A | 9.024 s | N / A | N / A | 6.883 s |
| Stabilna dyfuzja 1.5 (INT8) — prędkość generowania obrazu | 6.224 s/obraz | 1.703 s/obraz | N / A | 1.128 s/obraz | N / A | N / A | 0.860 s/obraz |
| Stabilna dyfuzja XL (FP16) — ocena ogólna | 748 | 2,102 | 1,124 | 1,940 | 1,805 | 2,010 | 2,473 |
| Stabilna dyfuzja XL (FP16) — czas całkowity | 790.774 s | 285.344 s | 533.736 s | 326.550 s | 332.400 s | 298.499 s | 242.606 s |
| Stabilna dyfuzja XL (FP16) — prędkość generowania obrazu | 49.423 s/obraz | 17.834 s/obraz | 33.359 s/obraz | 20.409 s/obraz | 20.775 s/obraz | 18.656 s/obraz | 15.163 s/obraz |
Luxmark
Luxmark to test wydajności GPU, który wykorzystuje LuxRender, open-source'owy moduł renderujący z wykorzystaniem ray tracingu, do oceny wydajności systemu w przypadku bardzo szczegółowych scen 3D. Test ten jest szczególnie przydatny do oceny możliwości renderowania graficznego serwerów i stacji roboczych, zwłaszcza w aplikacjach do efektów wizualnych i wizualizacji architektonicznej, gdzie precyzyjna symulacja oświetlenia ma kluczowe znaczenie.
LuxMark wykazuje doskonałą skalowalność w Battlemage. Arc Pro B70 przewyższa B50 o 128% w kategorii „Jedzenie” i o 137% w kategorii „Hall”. Przewyższa również Radeona RX 9060 XT o 33% w kategorii „Jedzenie” i o 53% w kategorii „Hall”. Skoncentrowany na grach RX 9070 XT utrzymuje przewagę około 54% w kategorii „Jedzenie” i 37% w kategorii „Hall”, podczas gdy NVIDIA RTX 5070 FE prowadzi odpowiednio o 62% i 81%. Ogólnie rzecz biorąc, B70 ugruntowuje swoją pozycję jako solidny akcelerator renderowania OpenCL dla stacji roboczych.
| Luxmark (wyżej jest lepiej) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| Ocena żywności | 2,456 | 5,609 | 4,220 | 6,590 | 8,233 | 8,610 | 9,061 |
| Wynik Halla | 5,158 | 12,220 | 8,007 | 15,348 | 16,566 | 16,758 | 22,062 |
Geekbench 6
Geekbench 6 to wieloplatformowy benchmark mierzący ogólną wydajność systemu. Przeglądarka Geekbench pozwala porównać z nim dowolny system.
Arc Pro B70 uzyskał wynik 140 165, co stanowi dokładnie 100% poprawę w porównaniu z Arc Pro B50. Wyprzedza Radeona RX 9070 o około 1%, RX 9060 XT o 36% i ustępuje RTX 5060 Ti o zaledwie 7%. NVIDIA RTX 5070 FE powiększa przewagę do około 24%, podczas gdy AMD RX 9070 XT wyprzedza go o około 35%, co plasuje B70 dokładnie w środku stawki w segmencie najpopularniejszych procesorów.
| Geekbench 6 OpenCL (wyżej jest lepiej) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | AMD Radeon RX 9070 | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| Wynik OpenCL GPU | 70,038 | 140,165 | 102,750 | 138,463 | 150,743 | 173,255 | 188,892 |
3DMark
3DMark Port Royal, Speed Way i Steel Nomad to testy wydajności GPU, które testują wydajność w różnych scenariuszach. Port Royal koncentruje się na ray tracingu, Speed Way ocenia wydajność w symulacjach wyścigowych, a Steel Nomad testuje wydajność GPU za pomocą intensywnej, realistycznej grafiki. Oceniają one możliwości GPU w zakresie renderowania, oświetlenia i dynamicznych scen.
Wydajność grafiki syntetycznej dobrze skaluje się z nową architekturą. Arc Pro B70 osiąga o 154% lepsze wyniki niż B50 w teście Port Royal, o 136% lepsze w teście Speed Way i o 149% lepsze w teście Steel Nomad. W porównaniu z RX 9060 XT, B70 wyprzedza o 9% w teście Port Royal, o 7% w teście Speed Way i o 9% w teście Steel Nomad. W porównaniu z RTX 5060 Ti, B70 wypada w teście Port Royal z przewagą 2%, traci 23% w teście Speed Way i prowadzi o 13% w teście Steel Nomad. Wyższej klasy karty RTX 5070 FE i RX 9070 XT nadal mają przewagę 31–83% w zależności od obciążenia, co odzwierciedla ich pozycję jako wydajnych procesorów graficznych do gier.
| 3DMark (wyżej jest lepiej) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| Port Royal | 4,197 | 10,668 | 9,751 | 10,432 | 14,026 | 15,760 | 17,989 |
| Żużel | 1,355 | 3,202 | 3,004 | 4,184 | 5,869 | 5,791 | 6,237 |
| Stalowy Nomad (DX12) | 1,644 | 4,089 | 3,767 | 3,611 | 5,019 | 5,992 | 6,977 |
Sztuczna inteligencja wideo Topaz
Topaz Video AI to profesjonalna aplikacja do ulepszania i przywracania wideo z wykorzystaniem zaawansowanych modeli AI. Obsługuje ona różnorodne zadania, takie jak skalowanie nagrań do rozdzielczości 4K lub 8K, wyostrzanie rozmazanych fragmentów, redukcja szumów, uwydatnianie detali twarzy, kolorowanie czarno-białych ujęć oraz interpolacja klatek w celu uzyskania płynniejszego ruchu. Pakiet zawiera wbudowany test porównawczy, który mierzy wydajność systemu w oparciu o różne algorytmy ulepszania wideo, zapewniając przejrzysty obraz tego, jak dobrze platformy sprzętowe radzą sobie z wymagającymi obciążeniami przetwarzania wideo z wykorzystaniem AI.
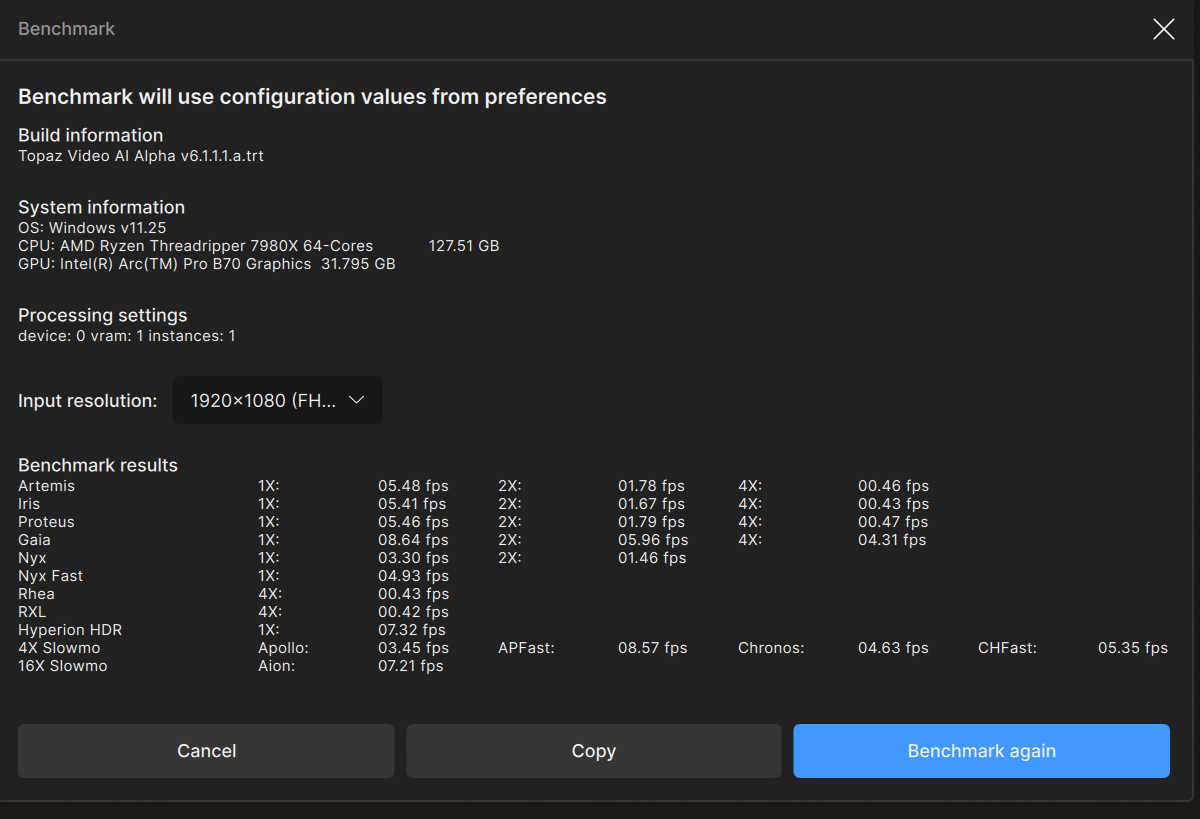
Karta Arc Pro B70 oferuje znaczną poprawę w porównaniu z poprzednią generacją profesjonalnych kart Intela, a największe korzyści widoczne są w obciążeniach związanych ze skalowaniem AI. Karta osiąga 5.48 kl./s w trybie Artemis, 5.41 kl./s w trybie Iris i 5.46 kl./s w trybie Proteus przy 1-krotnym wzmocnieniu, podczas gdy Gaia osiąga 8.64 kl./s, co jest najszybszym wynikiem spośród standardowych modeli wzmocnienia. Bardziej wymagające obliczeniowo modele odzyskiwania danych działają naturalnie wolniej – Nyx osiąga 3.30 kl./s, Nyx Fast 4.93 kl./s, a Hyperion HDR przetwarza materiał z prędkością 7.32 kl./s. Generowanie zwolnionego tempa również działa dobrze, generując 3.45 kl./s w trybie Apollo, 8.57 kl./s w trybie APFast, 4.63 kl./s w trybie Chronos, 5.35 kl./s w trybie CHFast i 7.21 kl./s w trybie Aion. Łącznie wyniki te pokazują, że Arc Pro B70 może obsłużyć pełen zakres przepływów pracy Topaz AI, od ulepszania wideo i usuwania szumów po konwersję HDR i interpolację klatek, co czyni go solidną opcją dla twórców chcących wykorzystać przyspieszenie Intel XMX AI.
Blender 4.5
Blender to aplikacja do modelowania 3D o otwartym kodzie źródłowym. Ten test porównawczy został przeprowadzony za pomocą narzędzia Blender Benchmark na wszystkich procesorach GPU. Wynik jest mierzony w próbkach na minutę, a wyższe wartości oznaczają lepszą wydajność.
Arc Pro B70 generuje 1,524.6 próbek/minutę w trybie Monster, 846.9 próbek/minutę w trybie Junkshop i 912.2 próbek/minutę w trybie Classroom. Choć te wartości nie dorównują zaawansowanym procesorom graficznym dla entuzjastów, takim jak RX 9070 XT czy RTX 5070, to jednak dowodzą, że Battlemage oferuje wystarczającą wydajność renderowania do profesjonalnych zadań wizualizacyjnych i tworzenia treści. W połączeniu z 32 GB buforem ramki i certyfikowanymi sterownikami stacji roboczych, B70 zapewnia praktyczną równowagę między możliwościami renderowania, akceleracją AI i profesjonalną niezawodnością.
| Blender 4.5.0 (liczba próbek na minutę, im wyższa tym lepiej) | Intel Arc Pro B70 |
|---|---|
| Potwór | 1,524.60 |
| Sklep ze złomem | 846.87 |
| Sala szkoleniowa | 912.24 |
Pobór mocy: Intel B70
Pobór mocy jest istotnym elementem każdej platformy obliczeniowej. Każda nowa generacja GPU zużywa więcej energii pod obciążeniem, co wymaga mocniejszych zasilaczy i odpowiedniego przepływu powietrza do chłodzenia. Jednak szybsze GPU mogą osiągać wyższe wartości szczytowe, ale czas trwania każdego obciążenia ulega skróceniu. Używając analizatora Quarch Mains Analyzer w naszym laboratorium testowym, zmierzyliśmy całkowite zużycie energii systemu podczas testu generatora obrazu Procyon AI Stable Diffusion XL FP16. To obciążenie wykorzystało limity mocy każdego GPU, a zdefiniowane punkty początkowe i końcowe dla każdego wygenerowanego obrazu były wyraźnie widoczne.
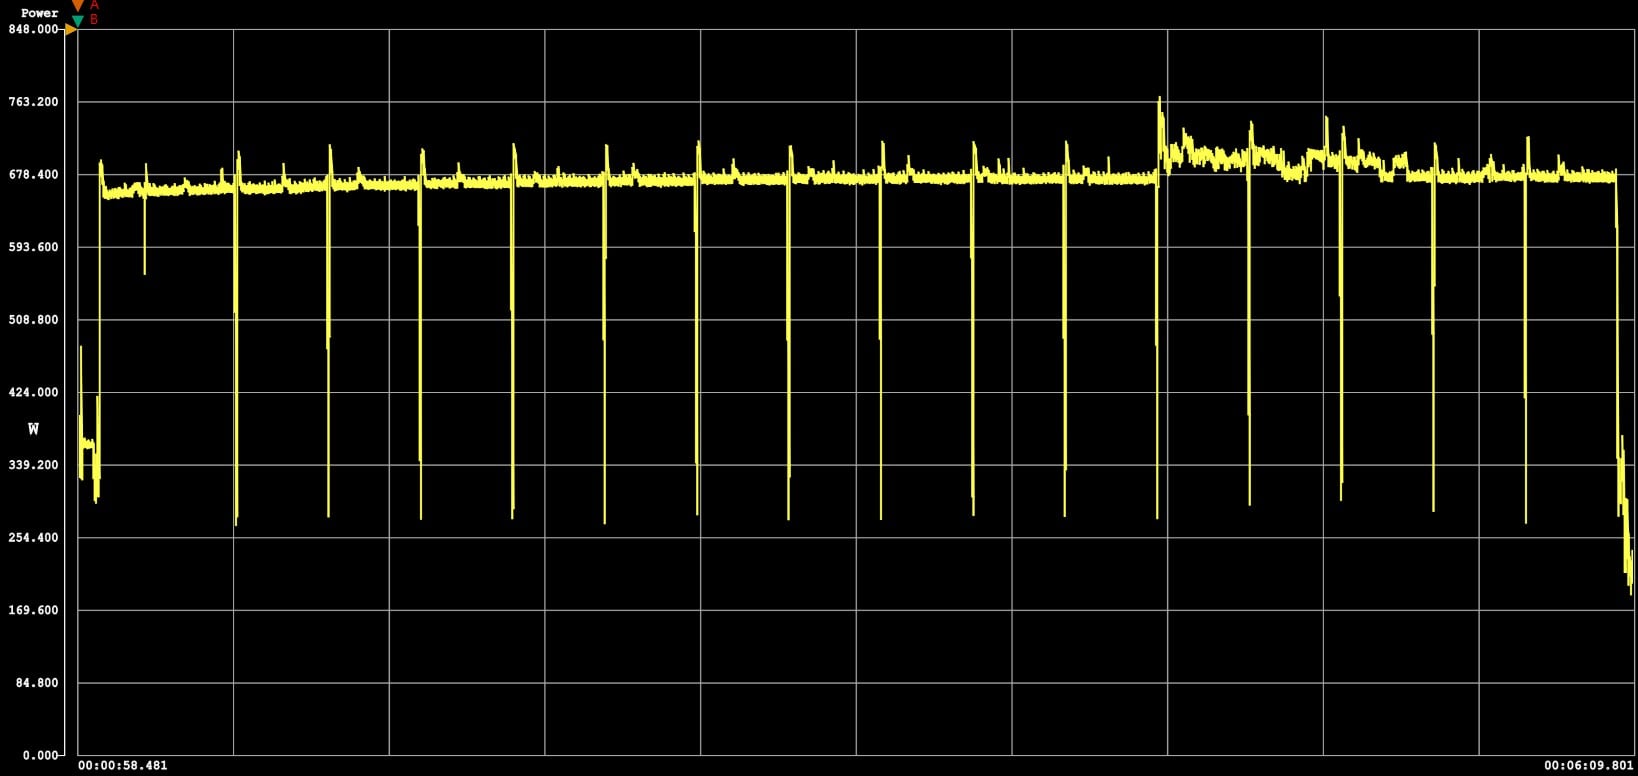
Podczas testów procesora Intel Arc Pro B70 zmierzyliśmy, że pobór mocy w stanie spoczynku wyniósł 207 W, szczytowy pobór mocy podczas obciążenia wyniósł 705.6 W, a średni pobór mocy podczas obciążenia wyniósł 638.6 W.
| Stabilna dyfuzja XL FP16 – wydajność energetyczna (niższe jest lepsze) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | PNY NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|
| Zużycie energii | 5.32 Wh | 3.45 Wh | 4.00 Wh | 3.41 Wh | 2.13 Wh | 2.46 Wh |
| Czas trwania testu | 49.9 s | 18.46 s | 33.0 s | 17.4 s | 20.2 s | 19.2 s |
Wydajność testu porównawczego obsługi online vLLM
vLLM to najpopularniejszy silnik wnioskowania i obsługi o wysokiej przepustowości dla systemów LLM. Test porównawczy obsługi online vLLM to narzędzie do oceny wydajności, które mierzy rzeczywistą wydajność obsługi przy współbieżnych żądaniach. Symuluje obciążenia produkcyjne, wysyłając żądania do działającego serwera vLLM z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia/wyjścia i liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość (liczba tokenów na sekundę), czas do pierwszego tokena (TTFT) i czas na token wyjściowy (TPOT), pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Platforma testowa:
- serwer: Supermicro AS-4125GS-TNRT
- Procesory: AMD EPYC 9374F
- Pamięć: 512 GB Samsung 4800 MT/s DDR5
- ISL 2k/ OSL 256
Test porównywalnych procesorów graficznych
- Intel Arc Pro B60
- Intel Arc Pro B70
- NVIDIA RTX Pro 6000
- NVIDIA® DGX Spark®
Przetestowaliśmy cztery karty B70 (128 GB) i cztery karty B60 (96 GB) w hoście Supermicro, porównując je z jedną kartą RTX Pro 6000 i jedną kartą DGX Spark. Nierówna liczba kart GPU jest celowa: przy cenie katalogowej 949 dolarów, zestaw czterech kart B70 kosztuje mniej więcej tyle samo, co jedna karta Spark, a znacznie mniej niż jedna karta RTX Pro 6000. Dlatego porównanie platform opiera się na szacunkowej inwestycji, a nie na liczbie kart.
Mistral Small 24B
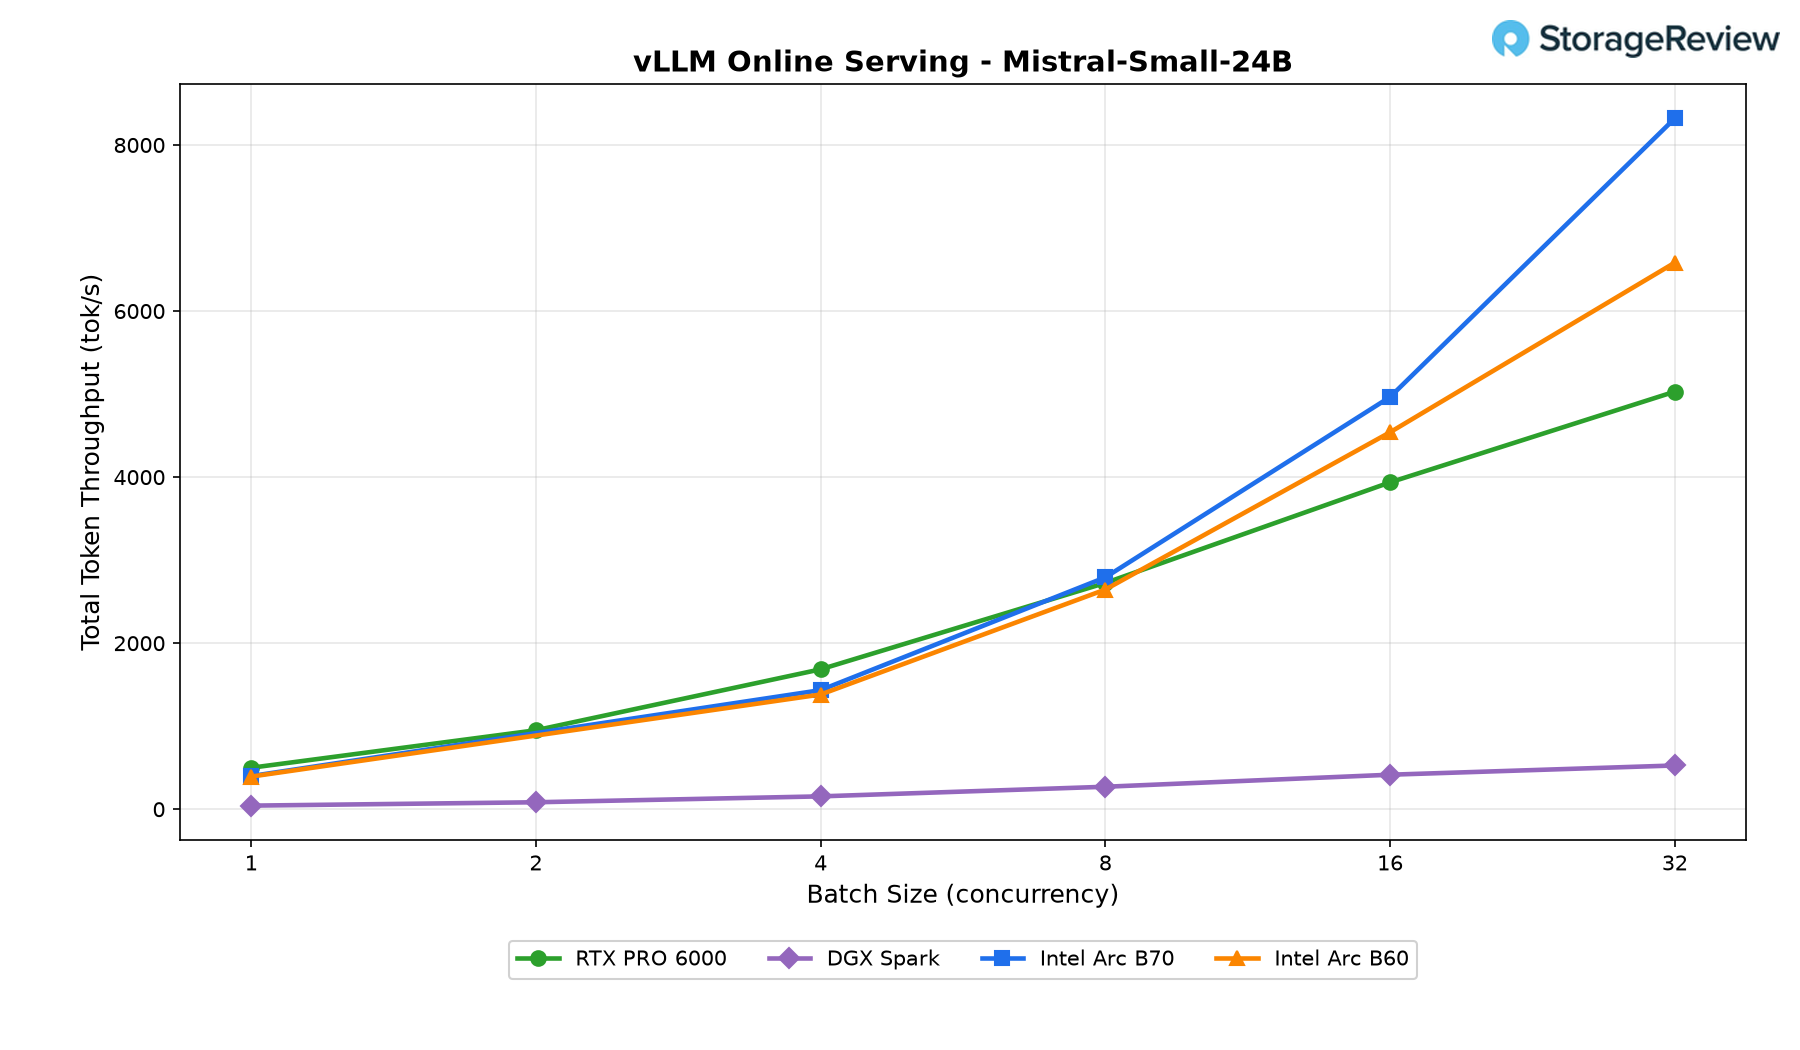
Procesor Intel Arc Pro B70 osiągnął najlepszy wynik w obciążeniu Mistral-Small-24B, skalując się z 450 tok/s przy rozmiarze partii 1 do 8,321 tok/s przy rozmiarze partii 32. Podczas gdy RTX PRO 6000 utrzymywał niewielką przewagę do rozmiaru partii 4, B70 wyprzedził go przy rozmiarze partii 8 i stale powiększał przewagę, kończąc z przewagą około 65% przy najwyższej współbieżności. W porównaniu ze swoim mniejszym odpowiednikiem, Arc Pro B60, B70 utrzymał niewielką przewagę na początku i powiększył ją do około 26% przy rozmiarze partii 32. DGX Spark pozostawał daleko w tyle przez cały test, osiągając szczyt na poziomie zaledwie 527 tok/s, co oznacza, że B70 był prawie 16 razy szybszy przy maksymalnym obciążeniu.
Koder Qwen3 30B
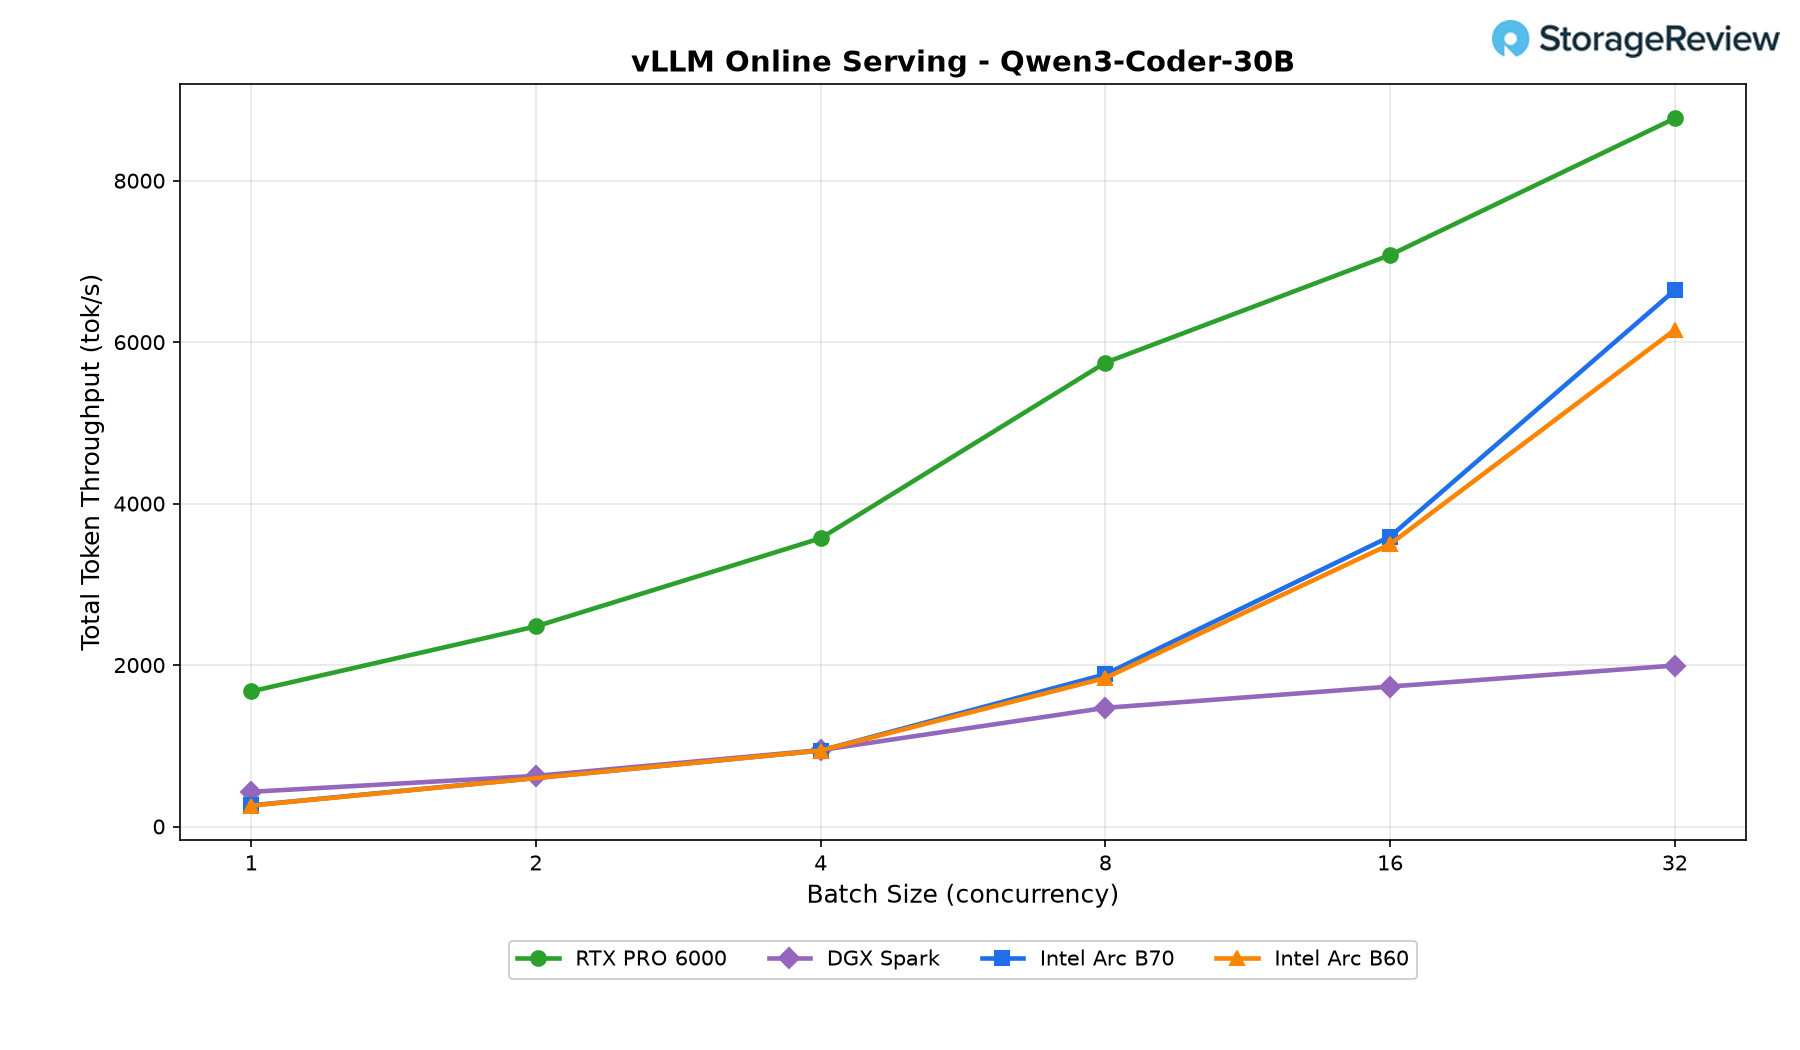
Qwen3-Coder-30B faworyzował kartę RTX PRO 6000, która utrzymała najwyższą przepustowość na wszystkich poziomach współbieżności, osiągając 8,772 tok/s. Mimo to karta Intel Arc Pro B70 skalowała się dobrze, osiągając 6,643 tok/s przy rozmiarze partii 32, zachowując jednocześnie niewielką, ale stałą przewagę nad kartą Arc Pro B60, osiągając wynik o około 8% szybszy. Chociaż nie mogła dorównać karcie RTX PRO 6000 w tym obciążeniu zorientowanym na deweloperów, B70 i tak zapewniała ponad trzykrotnie większą przepustowość niż DGX Spark przy maksymalnej współbieżności, co podkreśla jej zdolność do efektywnego obsługiwania większej liczby jednoczesnych żądań wnioskowania.
Lama 3.1 8B
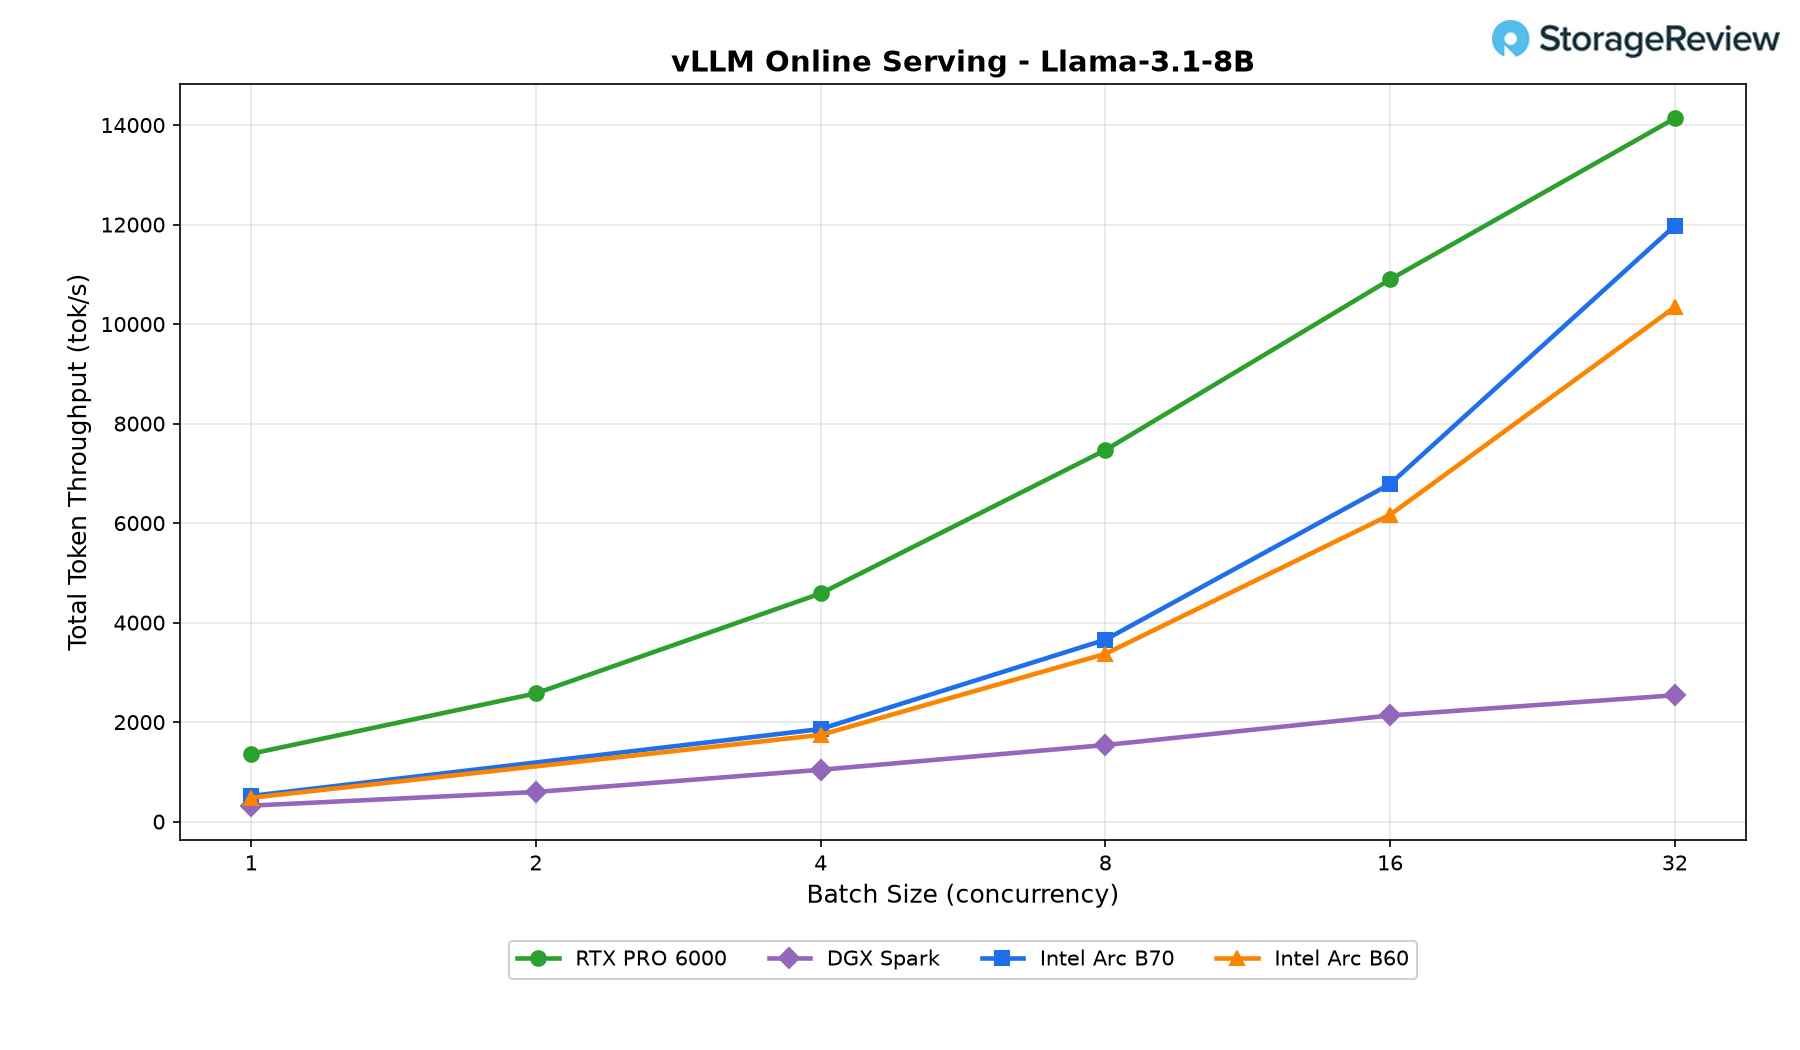
W mniejszym modelu Llama-3.1-8B wszystkie oddzielne układy GPU dynamicznie skalowały się wraz ze wzrostem współbieżności, choć RTX PRO 6000 pozostał zdecydowanym liderem wydajności. Intel Arc Pro B70 osiągnął prawie 12 000 tok/s przy rozmiarze partii 32, co dało mu około 16% przewagi nad Arc Pro B60 i jednocześnie około 85% przepustowości RTX PRO 6000. Różnica w porównaniu z DGX Spark stale się powiększała wraz ze wzrostem współbieżności, a B70 osiągał około 4.7-krotnie wyższą przepustowość przy największym rozmiarze partii. Wyniki pokazują również, że B70 znacząco korzysta z większych kolejek żądań, co pozwala mu wykorzystać dostępne zasoby GPU.
GPT OSS 20B
Test GPT-OSS-20B ponownie umieścił kartę RTX PRO 6000 na szczycie zestawienia, osiągając wynik prawie 16 900 tok/s. Intel Arc Pro B70 osiągnął nieco ponad 10 000 tok/s, utrzymując niewielką, ale mierzalną przewagę nad Arc Pro B60 na całej krzywej skalowania, kończąc o około 7% szybciej przy rozmiarze partii 32. Chociaż procesor ten był gorszy o około 40% od flagowego procesora graficznego NVIDIA do stacji roboczych, nadal zapewniał prawie trzykrotnie większą przepustowość niż DGX Spark. Prawie liniowe skalowanie powyżej rozmiaru partii 8 sugeruje również, że B70 pozostaje dobrze wykorzystany pomimo wzrostu liczby równoczesnych żądań.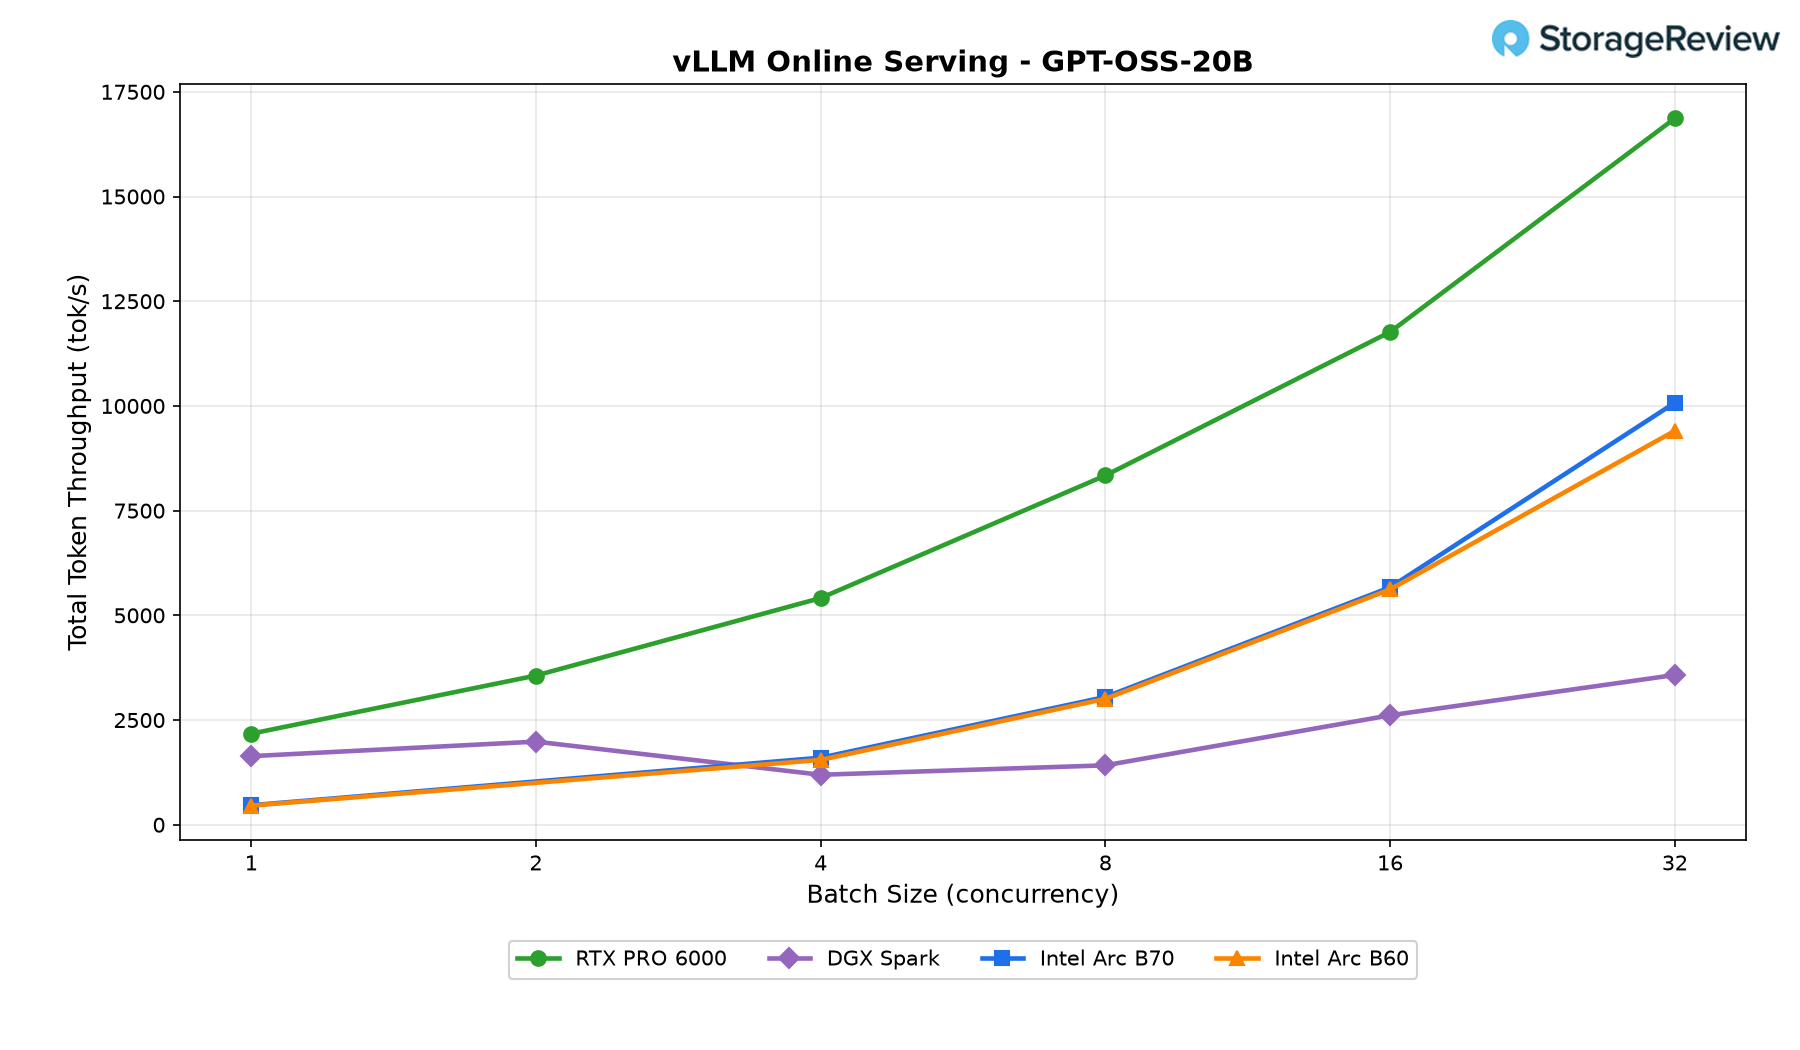
GPT OSS 120B
Największy model w grupie okazał się bardziej wymagający na wszystkich platformach, jednak Intel Arc Pro B70 nadal skalował się efektywnie. Osiągnął 6,870 tok/s, o około 7% więcej niż Arc Pro B60, osiągając jednocześnie około trzech czwartych przepustowości RTX PRO 6000. DGX Spark osiągnął 2,175 tok/s przy tym samym poziomie współbieżności, dając B70 około 3.2-krotną przewagę. Podczas gdy RTX PRO 6000 utrzymał swoją ogólną przewagę, B70 pokazał, że pozostaje wysoce konkurencyjny w obsłudze większych modeli językowych, szczególnie gdy wyższa współbieżność zapewnia pełne wykorzystanie zasobów sprzętowych.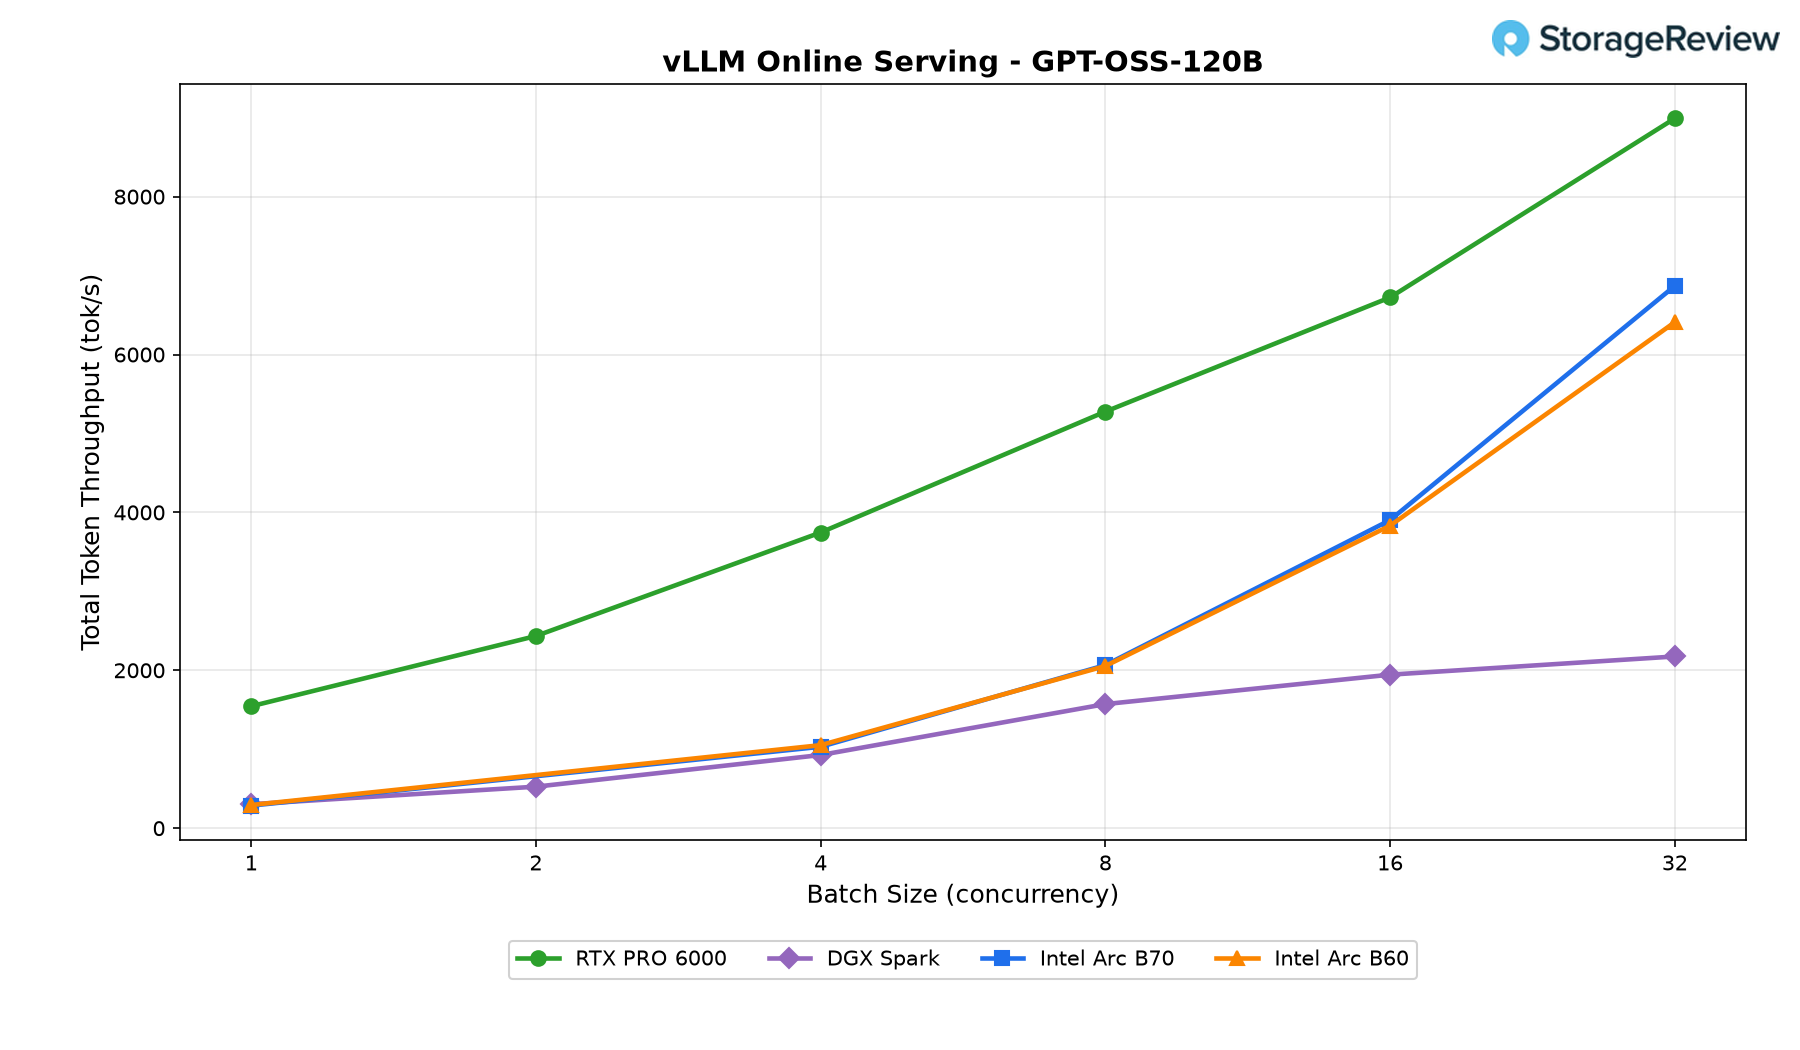
Wniosek
Karta Intel Arc Pro B70 to jeden z najciekawszych procesorów graficznych AI do stacji roboczych, jakie Intel wprowadził do tej pory na rynek. W sugerowanej cenie detalicznej 949 dolarów, wyrobiła sobie unikalną pozycję, łącząc 32 GB pamięci ECC GDDR6 z wydajnością, która w wielu zastosowaniach AI i profesjonalnych przewyższała podobne cenowo procesory graficzne dla użytkowników indywidualnych, a jednocześnie znacznie ustępowała konkurencyjnym rozwiązaniom NVIDIA dla stacji roboczych. Nawet przy obecnej cenie rynkowej, która wynosi ponad 1,100 dolarów, oferta wartości pozostaje atrakcyjna w porównaniu z produktami takimi jak RTX Pro 4000, szczególnie dla użytkowników potrzebujących dużych modeli lokalnych lub wdrożeń z wieloma procesorami graficznymi, gdzie czynnikiem ograniczającym jest pojemność pamięci, a nie moc obliczeniowa.
Z punktu widzenia sprzętu, Intel Arc Pro B70 spełnił oczekiwania: skutecznie dorównał RTX 5060 Ti w generowaniu obrazu Stable Diffusion 1.5, osiągnął przyzwoite wyniki renderowania i obsługiwał nowoczesne modele językowe z szybkością, która czyni go godnym kandydatem do lokalnej infrastruktury AI, osiągając prawie 12 000 tok/s w Llama 3.1 8B i, z czterema kartami, pokonując nasz pojedynczy referencyjny RTX Pro 6000 o 65% w Mistral Small 24B przy pełnej współbieżności. Cztery karty B70 w jednej stacji roboczej zapewniają 128 GB pamięci VRAM za około 3,800 dolarów w cenie katalogowej, znacznie poniżej ceny pojedynczego procesora graficznego do stacji roboczej klasy high-end.
Największym wyzwaniem stojącym przed Arc Pro B70 nie jest układ scalony, lecz otaczający go ekosystem oprogramowania. Jakość sterowników i obsługa frameworków nadal pozostają w tyle zarówno za ekosystemem CUDA firmy NVIDIA, jak i za coraz bardziej dojrzałym stosem ROCm firmy AMD. Chociaż Intel poczynił znaczące postępy w zakresie oneAPI, OpenVINO i prac rozwojowych nad vLLM z obsługą Battlemage, użytkownicy nadal powinni spodziewać się sporadycznych problemów ze zgodnością, ograniczonej obsługi modeli i większej gotowości do rozwiązywania problemów niż w przypadku konkurencyjnych platform. Osoby poszukujące gotowego procesora graficznego, który „po prostu działa” w praktycznie każdym frameworku i aplikacji AI, nadal uznają NVIDIA i AMD za bezpieczniejszy wybór.
Ostatecznie, Arc Pro B70 można z łatwością polecić klientom ceniącym pojemność pamięci VRAM, funkcje stacji roboczej i wydajność AI w stosunku do ceny, pod warunkiem, że rozumieją, na co się decydują. To wyjątkowy sprzęt, którego cena jest agresywna, ale jego długoterminowy sukces zależy niemal wyłącznie od zaangażowania Intela w ciągły rozwój oprogramowania i rozszerzanie wsparcia ekosystemu. Jeśli Intel utrzyma tę inwestycję, B70 ma solidne podstawy sprzętowe, by stać się jednym z atutów w akceleracji AI dla użytkowników indywidualnych i profesjonalistów. W przeciwnym razie istnieje ryzyko, że pozostanie kartą o ogromnym potencjale, która nigdy nie osiągnie bezproblemowej użyteczności, jaką oferują jej konkurenci z firmami NVIDIA i AMD.


 Amazon