

Aktualizacja z 2 października 2026 r.: karta NetApp zawiera Novus — metadane pNFS oddzielone od węzłów danych AFF A90, można już zamawiać — narzędzie Claims Tracker rejestruje roszczenie dotyczące „najszybszej pamięci masowej na świecie” na podstawie projekcji Omdia, a wprowadzenie do narzędzia śledzącego teraz odróżnia pochodzenie zweryfikowane przez analityków od wewnętrznych testów dostawcy.
Każdy duży dostawca pamięci masowej twierdzi, że sprzedaje najlepszą macierz pamięci masowej, a przez lata wyznacznikiem najlepszej była najszybsza. Prawie żaden z nich nie oferuje niezależnych testów. Dell, Everpure (dawniej Pure Storage), VAST, Weka, IBM, NetApp i Huawei – wszystkie te firmy reklamują się jako liderzy w zakresie wydajności, a niemal każda liczba stojąca za tymi deklaracjami pochodzi z wewnętrznych testów dostawcy, z przypisem „rzeczywista wydajność może się różnić”.
Ta strona powstała, aby to uporządkować. Dzielimy dane dotyczące wydajności pamięci masowej na trzy klasy i odpowiednio oznaczamy każdą liczbę na tej stronie: zweryfikowane wyniki testów porównawczych (MLPerf Storage, IO500, SPC-1, gdzie dostawcy przesyłają wyniki zgodnie z opublikowanymi zasadami), oświadczenia dostawców (arkusze specyfikacji i numery premier bez niezależnej weryfikacji) oraz wyniki laboratoryjne StorageReview (systemy, które sami zmierzyliśmy). Gdy dostawca nie pozwala nam przetestować swojej macierzy, mówimy o tym; brak weryfikowalnych danych jest częścią problemu.
Liderzy w dziedzinie pamięci masowej AI
To dostawcy, którzy pojawiają się po zbudowaniu klastra szkoleniowego AI lub neocloud. Nie tworzymy ich rankingu, ponieważ nie uzgodniono żadnego pojedynczego pomiaru. Możemy jednak podać każdemu z nich ten sam zestaw faktów: czym właściwie jest platforma, gdzie jest wdrożona pod nazwą klienta, czy została zweryfikowana przez firmę NVIDIA, czy ma wyniki audytu benchmarkowego i które z jej deklaracji dotyczących wydajności pozostają niezweryfikowane. Jeśli dostawca upubliczni którykolwiek z tych elementów, aktualizujemy profil.
Pierwsze cztery to specjaliści od pamięci masowych opartych na sztucznej inteligencji. Pozostali to uznani dostawcy pamięci masowych dla przedsiębiorstw z liniami produktów AI. Obie grupy odnoszą sukcesy w rzeczywistych wdrożeniach; każda z nich dysponuje bardzo różną ilością dowodów.
Dane VAST
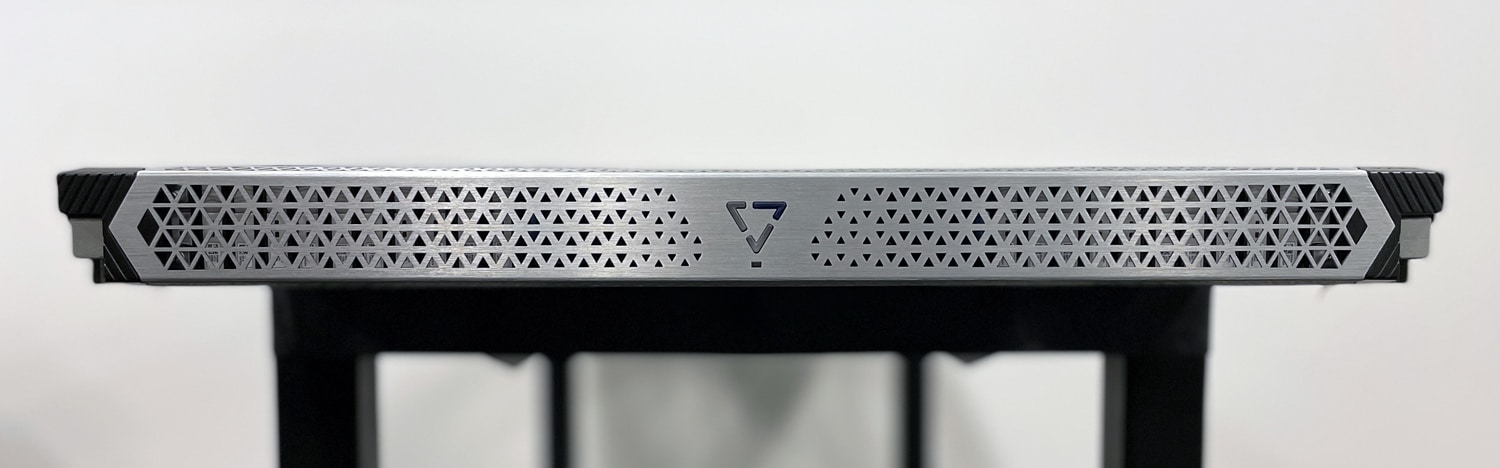
Platforma: System operacyjny VAST AI, oparty na architekturze DASE (Disaggregated, Shared-Everything). Kontenery obliczeniowe bezstanowe obsługują pulę obudów NVMe za pośrednictwem protokołu NVMe-oF i zapewniają pojedynczą przestrzeń nazw dla dostępu do plików, obiektów i baz danych. Nośniki all-QLC z buforem zapisu pamięci klasy storage.
Wymienione wdrożenia: CoreWeave, w ramach wieloletniej umowy o wartości 1.17 miliarda dolarów, ogłoszonej w listopadzie 2025 roku, którą VAST określa jako swojego największego klienta. VAST został również włączony do rozszerzenia xAI Colossus Frontier AI Factory i obsługuje fabryki AI Mistral Compute działające na platformie NVIDIA GB300 NVL72.
Walidacja NVIDIA: Certyfikowany partner NVIDIA w zakresie wprowadzania na rynek rozwiązań pamięci masowej, zatwierdzony do użytku z DGX SuperPOD.
Wynik audytu: Brak. VAST nigdy nie przesyłał danych do MLPerf Storage.
Otwarte roszczenia: Wspólne roszczenie VAST i AMD o 9-krotnie szybszym czasie do pierwszego tokenu dzięki odciążeniu pamięci podręcznej KV w systemie Instinct, na podstawie testów dostawcy. Kwietniowa seria F z 2026 roku, z wyceną 30 miliardów dolarów, wyznacza oczekiwania, ale nie jest to wartość liczbowa dotycząca wydajności.
Nasze relacje z ubiegłego roku:
- VAST i AMD twierdzą, że dzięki odciążeniu pamięci podręcznej KV czas do pierwszego tokenu jest 9-krotnie szybszy (lipiec 2026)
- Cloudera i VAST walczą z niedoborem mocy obliczeniowej GPU (lipiec 2026)
- VAST napędza fabryki Mistral Compute AI na GB300 NVL72 (Maj 2026)
- VAST prezentuje swój agentowy system operacyjny AI (Feb 2026)
- VAST Amplify ma na celu sprawić, że istniejące dyski SSD będą wydawały się 6 razy większe (Jan 2026)
- VAST wprowadza architekturę wnioskowania natywną dla DPU (Jan 2026)
WEKA
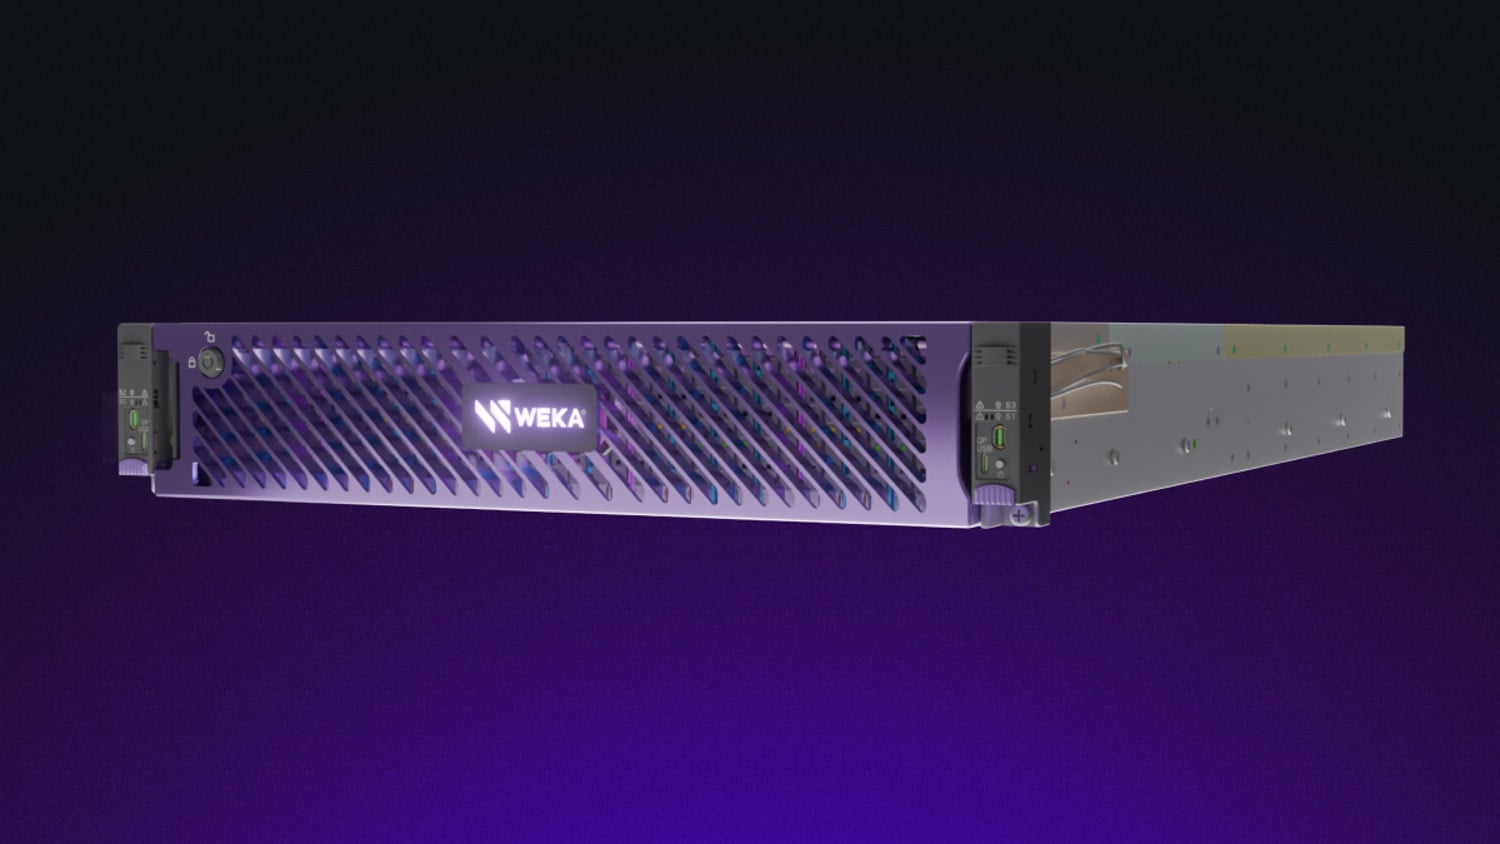
Platforma: NeuralMesh, programowalny równoległy system plików, wcześniej znany jako WekaFS, sprzedawany jako oprogramowanie i urządzenia WEKApod. NeuralMesh Axon osadza tę samą płaszczyznę danych w serwerach GPU, dzięki czemu lokalny NVMe dołącza się do klastra zamiast pozostawać bezczynny.
Wdrożenia nazwane: Nebius korzysta z NeuralMesh jako warstwy premium swojej chmury AI. Andromeda ujednoliciła NeuralMesh u około 50 dostawców GPU w lipcu 2026 r. WEKA jest również częścią wielodostawczego stosu w CoreWeave.
Walidacja NVIDIA: Certyfikowany partner NVIDIA w zakresie wprowadzania na rynek rozwiązań pamięci masowej, posiadający walidację DGX SuperPOD i BasePOD.
Wynik audytu: WEKA przesłała dane do MLPerf Storage w wersji 1.0 we wrześniu 2024 r., ale nie przesłała danych do wersji 2.0 w sierpniu 2025 r. Najnowsze audytowane dane pochodzą sprzed generacji.
Otwarte deklaracje: WEKApod 3 z NeuralMesh 6 ma deklarowane 1.1 EB i 10.2 TB/s w pojedynczej szafie. Dane pochodzą od dostawcy, nie są poparte żadnymi audytowanymi danymi.
Warto wiedzieć: HPE zakończyło partnerstwo z WEKA, Qumulo i Scality w listopadzie 2025 r., w związku z czym WEKA nie dociera już do klientów za pośrednictwem kanału HPE.
Nasze relacje z ubiegłego roku:
- Andromeda standaryzuje technologię NeuralMesh u ponad 50 dostawców GPU (lipiec 2026)
- WEKApod 3 przełamuje barierę pojedynczego eksabajta (lipiec 2026)
- NeuralMesh AIDP osiąga powszechną dostępność (Mar 2026)
- NeuralMesh integruje się z NVIDIA STX w celu zapewnienia pamięci wnioskowania (Mar 2026)
- Platformy nowej generacji WEKApod Prime i Nitro (Nov 2025)
DDN
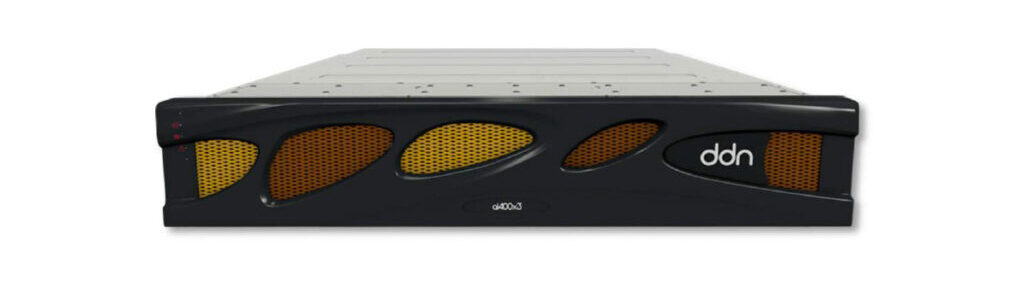
Platforma: Dwie linie. EXAScaler, równoległy system plików oparty na Lustre, obsługujący urządzenia AI400X3 i AI400X3M, obsługuje szkolenie. Infinia, platforma obiektów klucz-wartość, która dodała obsługę wielu najemców i POSIX w wersji 2.4, jest ukierunkowana na obciążenia związane z inferencją i fabryką AI.
Wymienione wdrożenia: xAI Colossus, ogłoszony w listopadzie 2024 r., z 200 000 procesorów graficznych, na platformach EXAScaler i Infinia. DDN posiada również długą listę instalacji w laboratoriach krajowych i systemach HPC, które powstały przed cyklem sztucznej inteligencji.
Walidacja NVIDIA: Certyfikowany partner NVIDIA w zakresie wprowadzania na rynek rozwiązań pamięci masowej, posiadający walidację DGX SuperPOD.
Wynik audytu: Tak i jest aktualny. W MLPerf Storage v2.0 AI400X3 utrzymywał 120.68 GB/s w sieci 3D U-Net na wielu węzłach i obsługiwał punkty kontrolne Llama3-8b z prędkością 30.6 GB/s odczytu i 15.3 GB/s zapisu z urządzenia 2RU. Na podstawie dowodów można stwierdzić, że DDN jest najsilniejszą pozycją na tej liście.
Otwarte roszczenia: przyspieszenie pamięci podręcznej KV poprzez NVIDIA Dynamo, zweryfikowane wspólnie z Nebul, a nie przez niezależną instytucję.
Nasze relacje z ubiegłego roku:
- DDN wprowadza na rynek AI400X3M na targach ISC 2026 (czerwiec 2026)
- Infinia 2.4 dodaje obsługę wielu najemców i POSIX (lipiec 2026)
- DDN i Nebul sprawdzają przyspieszenie pamięci podręcznej KV (lipiec 2026)
DDN przewodził MLPerf Storage v2.0 pod względem gęstości wydajności, ale nie poddał się rundzie v3.0.
Hammerspace
Platforma: Hammerspace Global Data Platform i Tier 0, która przekształca lokalną pamięć NVMe, już znajdującą się w serwerach GPU, we współdzieloną pamięć z obsługą punktów kontrolnych. Jest ona oparta na standardach, równoległym NFS (NFS 4.2 z FlexFiles) i działa na zwykłych serwerach, a nie na zastrzeżonym urządzeniu. Nie ma potrzeby fotografowania urządzenia Hammerspace, co jest celem tej architektury.
Wdrożenia nazwane: Meta udokumentowała Hammerspace w dwóch klastrach H100 z 24 576 GPU na swoim blogu inżynierskim. Jest to najbardziej szczegółowy opis wdrożenia pamięci masowej AI na dużą skalę od dowolnego dostawcy na tej stronie, ponieważ napisał go operator, a nie dostawca.
Walidacja NVIDIA: Brak. Hammerspace nie posiada certyfikatu DGX SuperPOD, DGX BasePOD, architektury referencyjnej NCP ani oznaczenia NVIDIA-Certified Storage.
Wynik audytu: Tak, zarówno w MLPerf Storage v1.0, jak i v2.0. W wersji 2.0, Tier 0 zapewnił 420.8 GB/s w sieci 3D U-Net na pięciu węzłach przy 96.4-procentowym wykorzystaniu akceleratora, zasilając 140 symulowanych H100. Hammerspace ma najlepszy wynik audytu udziału w tym zestawieniu i najsłabszą historię walidacji NVIDIA, co jest odwrotnością niemal wszystkich innych firm na tej liście.
Nasze relacje: Hammerspace nie był jeszcze w laboratorium StorageReview, a nasze ostatnie relacje są skąpe. To luka po naszej stronie, a nie wada platformy.
Hammerspace, który przesłał zgłoszenie w wersji 2.0, nie wziął również udziału w rundzie wersji 3.0.
Dell Technologies
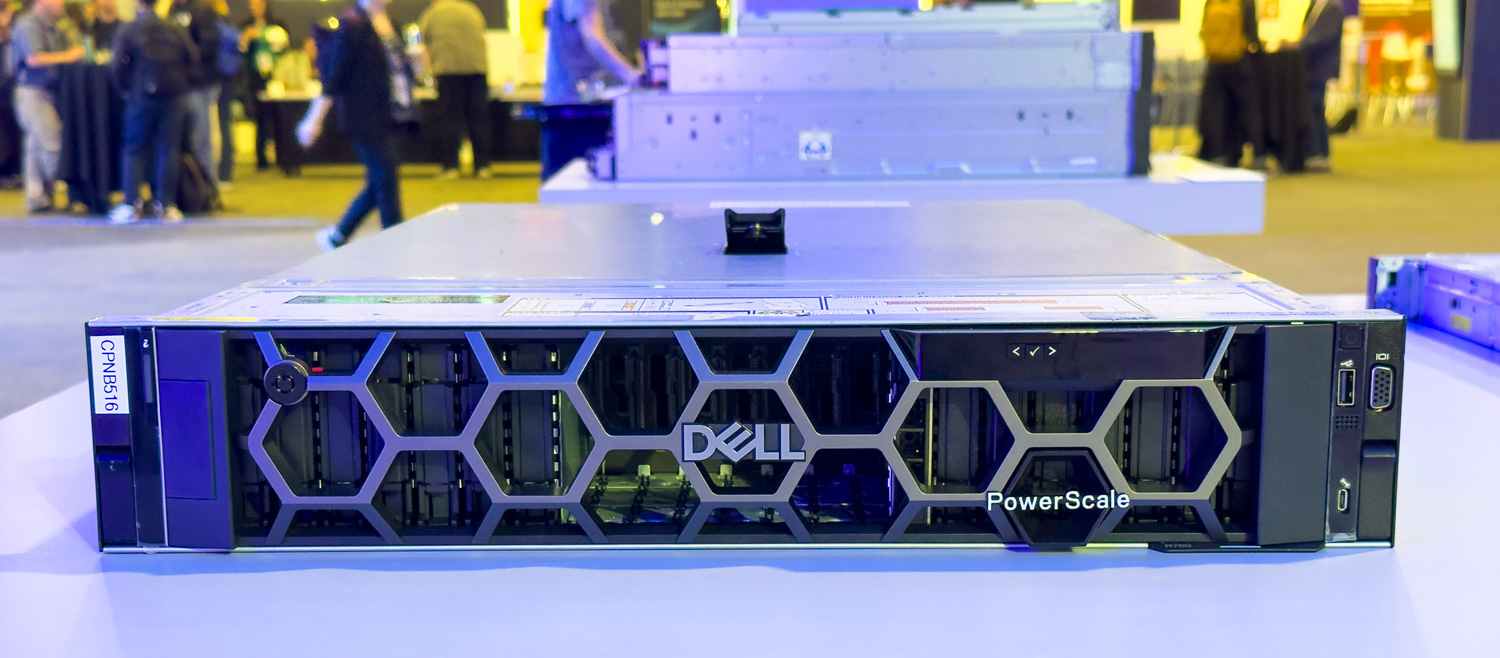
Platforma: Trzy elementy, skierowane do różnych części procesu. PowerScale to skalowalna linia serwerów NAS z węzłami all-flash serii F. ObjectScale to warstwa S3, która w 2026 roku przejęła S3 przez RDMA i odciążenie pamięci podręcznej KV. Lightning File System to nowy, równoległy system plików, który stał się ogólnodostępny w kwietniu 2026 roku i jest elementem, który Dell pozycjonuje na tle DDN, VAST i WEKA.
Wdrożenia nazwane: Nie udało nam się potwierdzić wdrożenia szkolenia AI na dużą skalę w oparciu o pamięć masową Dell. Najbardziej konkretnym przykładem jest Subaru, które prowadzi laboratorium AI w zakresie bezpieczeństwa kierowców w PowerScale. Dla dostawcy tej wielkości jest to uderzająca luka w porównaniu z neocloud, którą nagłaśniają dostawcy rozwiązań opartych na sztucznej inteligencji.
Walidacja firmy NVIDIA: Partnerem wprowadzającym na rynek rozwiązania NVIDIA-Certified Storage oraz platformą PowerScale jest firma NVIDIA Cloud Partner, która w lipcu 2025 r. uzyskała certyfikat.
Wynik audytu: Brak. Firma Dell nigdy nie zgłaszała się do MLPerf Storage.
Otwarte roszczenia: Dell określa Lightning jako najszybszy na świecie równoległy system plików, opierając się na analizie wewnętrznej, i podaje dane o wydajności pamięci masowej Exascale na poziomie wielu TB/s na szafę. Oba te dane znajdują się w poniższym zestawieniu roszczeń. Praktyczna uwaga dla kupujących: Lightning jest ogólnodostępny, ale jego zakres obejmuje fabryczne wersje AI i większość czytelników nie znajdzie go w standardowej ofercie.
Nasze relacje z ubiegłego roku:
- Dell utrzymuje pozycję lidera w raporcie Gartner MQ 2026 dla pamięci masowej dla przedsiębiorstw (Aug 2026)
- ObjectScale osiąga 9.83 PB w obudowie 2U z dyskami SSD Kioxia o pojemności 245 TB i technologią S3 przez RDMA (Aug 2026)
- Dell wyprzedził w sprzedaży pozostałe pięć największych firm IDC w pierwszym kwartale, jeśli chodzi o zewnętrzne pamięci masowe (lipiec 2026)
- Wewnątrz resetu PowerStore Gen 3 (Maj 2026)
- Głębokie zanurzenie w PowerStoreOS 5.0, oprogramowanie stanowiące część resetu Gen 3 (wrzesień 2026)
- System plików Lightning i pamięć masowa Exascale na GTC 2026 (Mar 2026)
- Nasza recenzja PowerEdge R5715, 2U z pamięcią masową, który przetestowaliśmy osobiście (Mar 2026)
HPE
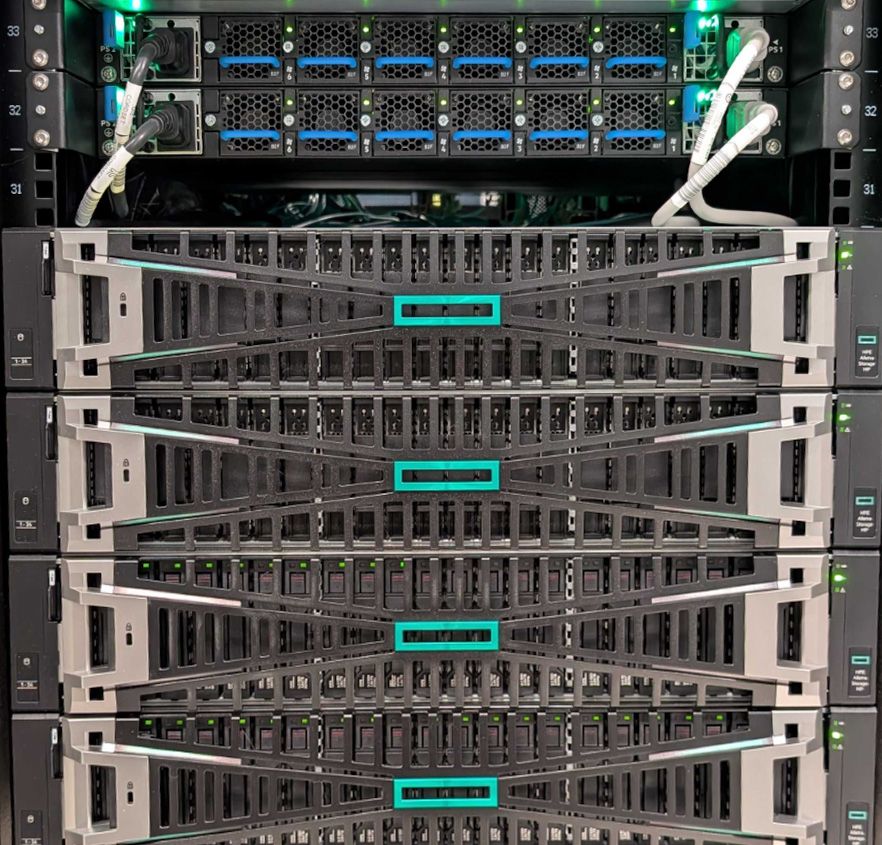
Platforma: Alletra Storage MP, podzielona na B10000 dla pamięci blokowej i X10000 dla pamięci obiektowej oraz GreenLake dla pamięci plikowej. HPE sprzedaje również zasoby obliczeniowe i sieciowe, w ten sposób dostarczając większość swoich pamięci masowych AI.
Wdrożenia nazwane: Sovereign AI i kompilacje fabryczne AI, w których HPE dostarcza pełny stos. Brak nazwanych wdrożeń neocloud porównywalnych z przykładami VAST, WEKA czy DDN powyżej.
Walidacja NVIDIA: Certyfikowany partner NVIDIA w zakresie wprowadzania na rynek rozwiązań pamięci masowej, z walidacją DGX BasePOD i SuperPOD.
Wynik audytu: HPE pojawiło się w każdej rundzie MLPerf Storage, od wersji 1.0 do 3.0, co stawia je przed Dell i NetApp pod względem udziału. Należy jednak uważnie przeczytać zgłoszenia dotyczące plików: najlepsze wyniki HPE w kategorii plików AI uzyskano dzięki współzgłoszeniom z WEKA, a HPE zakończyło tę współpracę, wraz z Qumulo i Scality, w listopadzie 2025 r. Te wyniki nie odzwierciedlają już produktu, który HPE może Ci dziś sprzedać.
Nasze sprawozdanie z ubiegłego roku: Przetestowaliśmy platformę Alletra w praktyce.
- HPE utrzymuje pozycję lidera w raporcie Gartner MQ 2026 dla pamięci masowej dla przedsiębiorstw (Aug 2026)
- Alletra Storage MP B10000 z NIST CSF 2.0 – nasze testy praktyczne (czerwiec 2026)
- Alletra Storage MP X10000 z węzłem Data Protection Accelerator (Feb 2026)
- CloudCasa dodaje Kubernetes DR dla B10000 (czerwiec 2026)
- MLPerf Storage v3.0: 345.8 GiB/s w sieci 3D U-Net z procesorem K3000, jeden z dwóch dostawców na tej stronie, którzy zgłosili swoją ofertę w tej rundzie.
IBM
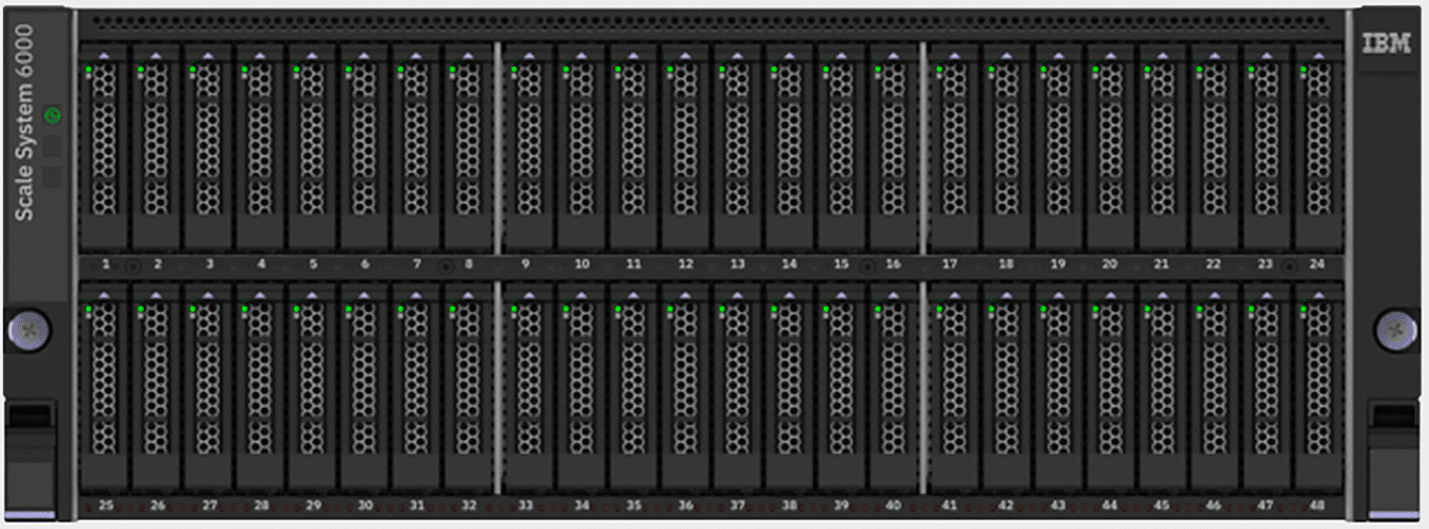
Platforma: IBM Storage Scale, równoległy system plików oparty na systemie GPFS, sprzedawany jako oprogramowanie i jako urządzenia Storage Scale System, z pakietem Fusion dla platformy Kubernetes i potoków AI.
Wdrożenia nazwane: Część wielodostawczego stosu w CoreWeave. IBM Cloud buduje również dedykowany klaster inferencyjny HGX B300 z Together AI o wartości 240 milionów dolarów, którego premiera planowana jest na sierpień 2026 r., choć warstwa pamięci masowej nie została jeszcze ujawniona.
Walidacja NVIDIA: Partner wprowadzający na rynek produkty pamięci masowej z certyfikatem NVIDIA.
Wynik audytu: Tak, w MLPerf Storage v2.0, wliczając obciążenie punktów kontrolnych, gdzie Storage Scale odnotował 656.7 GiB/s odczytu w modelu Llama 3.1 1T. Przywracanie punktów kontrolnych to metryka, która decyduje o tym, ile czasu z przebiegu treningowego Frontier traci się w wyniku awarii, a niewielu dostawców opublikowało zweryfikowaną wartość dla tego parametru.
Otwarte twierdzenia: Nic szczególnego w kategorii najszybszych macierzy. IBM reklamuje Storage Scale na podstawie skali i integracji, a nie rekordowej przepustowości.
Nasze relacje z ubiegłego roku:
- IBM utrzymuje pozycję lidera w raporcie Gartner MQ 2026 dla pamięci masowej przedsiębiorstw (Aug 2026)
- IBM i Together AI zainwestowały 240 mln dolarów w dedykowany klaster wnioskowania HGX B300 (Aug 2026)
- IBM wprowadza rozwiązanie Content-Aware Storage dla obciążeń RAG (Apr 2026)
- FlashSystem nowej generacji z agentową sztuczną inteligencją (Feb 2026)
- System Storage Scale System 6000, ujednolicona pamięć masowa dla sztucznej inteligencji i HPC (Nov 2025)
- Nasza recenzja IBM FlashSystem 5300, praktyczna analiza kompaktowej macierzy IBM i przydatne informacje o zachowaniu większych systemów (wrzesień 2024)
Everpure (dawniej Pure Storage)
Platforma: FlashBlade//EXA to wejście w świat sztucznej inteligencji (AI), rozdzielające metadane i ścieżki danych, dzięki czemu płaszczyzna danych skaluje się niezależnie. FlashBlade//S i FlashArray pokrywają resztę. Everpure buduje własne moduły DirectFlash zamiast kupować gotowe dyski SSD, dlatego jego dane dotyczące gęstości i wytrzymałości nie odzwierciedlają reszty rynku. Firma oficjalnie przyjęła nazwę Everpure 23 lutego 2026 roku.
Wdrożenia nazwane: Część stosu wielodostawców w CoreWeave. Nie udało nam się potwierdzić wdrożenia szkolenia AI nazwanego konkretnie na FlashBlade//EXA.
Walidacja NVIDIA: Partner wprowadzający na rynek produkty pamięci masowej z certyfikatem NVIDIA.
Zweryfikowany wynik: MLPerf Storage v3.0 (wrzesień 2026 r.), pierwsze zgłoszenie Everpure: 877.5 GiB/s zapisu punktu kontrolnego i 833.0 GiB/s odczytu w 30 węzłach danych FlashBlade//EXA, największa liczba punktów kontrolnych w rundzie, a także najwyższy wynik w rundzie dla pamięci podręcznej KV – 1,623.4 GiB/s. Jest to również rekord SPECstorage Solution 2020_ai_image z liczbą 6,300 zadań AI, opublikowany 17 lutego 2026 r. Inny benchmark, inny model obciążenia, ale jest to rzeczywiste zgłoszenie w ramach opublikowanego zestawu reguł z procesem weryfikacji i się liczy.
Otwarte oświadczenia: FlashBlade//EXA jest reklamowany jako najwydajniejsza platforma pamięci masowej w branży, z przewidywaną przepustowością powyżej 10 TB/s w pojedynczej przestrzeni nazw. Przewidywana, a nie mierzona.
Nasze relacje z ubiegłego roku:
- Everpure po raz drugi z rzędu plasuje się na szczycie obu osi rankingu Gartner MQ 2026 (Aug 2026)
- Everpure wprowadza Data Stream dla korporacyjnych systemów sztucznej inteligencji (czerwiec 2026)
- Udoskonalenia Data Intelligence i Enterprise Data Cloud (czerwiec 2026)
- Emulex SecureHBA z Everpure XL130 R5 – nie test porównawczy sztucznej inteligencji, ale praktyczny test ze sprzętem Everpure (Mar 2026)
- MLPerf Storage v3.0 (wrzesień 2026): pierwsze przesłanie, 877.5 GiB/s zapisu do punktu kontrolnego i 833 GiB/s odczytu na FlashBlade//EXA, plus 1,623 GiB/s odczytu z pamięci podręcznej KV, największa liczba punktów kontrolnych i wnioskowań w tej rundzie. Pełne pokrycie wersji 3.0.
NetApp
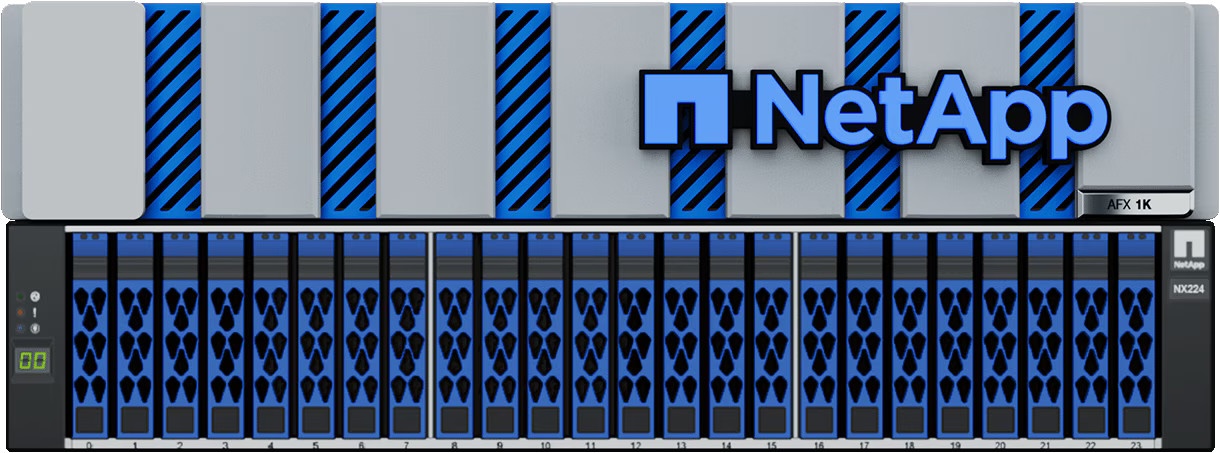
Platforma: AFX, zapowiedziana w październiku 2025 r., to rozproszona, all-flashowa platforma ONTAP stworzona z myślą o potokach danych AI, z nałożoną warstwą AI Data Engine. AIPod to referencyjny projekt zatwierdzony przez firmę NVIDIA. Novus, zapowiedziany na targach INSIGHT 2026 i dostępny już do zamówienia, znajduje się nad AFX w fabrykach AI: metadane pNFS są przesyłane do węzłów Data Director działających na kwalifikowanych serwerach Supermicro, podczas gdy pary AFF A90 HA przenoszą dane, a klienci korzystają z gotowych systemów Linux pNFS, bez zastrzeżonego agenta na serwerach GPU.
Wdrożenia nazwane: Brak, którego możemy potwierdzić w skali szkolenia AI. Najsilniejsze publiczne artefakty to sprawdzone architektury, a nie nazwy klientów, w tym projekty FlexPod AI z Cisco od czerwca 2026 r.
Walidacja NVIDIA: Partner wprowadzający na rynek rozwiązania w zakresie pamięci masowej z certyfikatem NVIDIA, posiadający certyfikat DGX SuperPOD.
Zweryfikowany wynik: Brak w systemie MLPerf Storage, do którego NetApp nigdy nie wchodził. Za firmą Novus, NetApp powołuje się na test audytowany przez Omdia, który wykazał niemal liniowe skalowanie w miarę dołączania klastrów ONTAP do jednej przestrzeni nazw; nagłówek 100 TB/s to wynik modelowania Omdia z tego testu, a nie wynik pomiarów.
Nasze relacje z ubiegłego roku:
- Novus oddziela metadane pNFS z węzłów danych AFF A90, dążąc do 100 TB/s (Październik 2026)
- NetApp utrzymuje pozycję lidera w raporcie Gartner MQ 2026 dla pamięci masowej dla przedsiębiorstw (Aug 2026)
- HCLTech łączy Keystone z U4X w celu zapewnienia opartego na konsumpcji magazynu danych AI (Aug 2026)
- NetApp kupuje DataPelago do przetwarzania danych GPU (lipiec 2026)
- StorageGRID 12.1 dodaje federacyjną przestrzeń nazw i do 12 TB/s (czerwiec 2026)
- FlexPod zweryfikował architektury AI przy użyciu Cisco (czerwiec 2026)
- Premiera AFX (Październik 2025)
Uwaga na temat Huawei
Huawei odnotował najwyższą przepustowość bezwzględną w MLPerf Storage v2.0, 698 GiB/s w sieci 3D U-Net z dwuwęzłowego systemu 8U OceanStor A800, obsługującego 255 symulowanych H100, co zostało wymienione w poniższej tabeli. Nie uwzględniliśmy go w profilach liderów, ponieważ nie jest to praktyczny zakup dla nabywców w Stanach Zjednoczonych, Europie ani na większości rynków obsługiwanych przez tę stronę. Liczba jest prawdziwa, ale dostępność nie. Raport Gartner Magic Quadrant z 2026 roku osiąga ten sam wynik z drugiej strony, utrzymując Huawei w kwadrancie liderów dzięki sile OceanStor poza Ameryką Północną.
Co mówią analitycy
Pozycja analityka to osobna klasa dowodów: nie audytowany punkt odniesienia, ale niezależna ocena realizacji i wizji, która jest bliższa temu, jak te systemy są faktycznie kupowane. W raporcie Gartner Magic Quadrant for Enterprise Storage Platforms z 2026 r. tych samych sześciu dostawców znajduje się w kwadrancie liderów co w zeszłym roku: Everpure, Huawei, HPE, NetApp, Dell i IBM, przy czym Everpure zajmuje najwyższą pozycję pod względem zdolności do realizacji i najdalej pod względem kompletności wizji drugi rok z rzędu. Dwie notatki dotyczące zakresu są istotne dla tej strony. Gartner ocenia rynek podstawowej pamięci masowej i śledzi grupę wysokowydajnych plików i obiektów w oddzielnych badaniach, gdzie mieszkają specjaliści od sztucznej inteligencji wymienieni powyżej, więc ich nieobecność w kwadrancie jest granicą kategorii, a nie werdyktem. A kiedy sześciu z ośmiu ocenianych dostawców otrzymuje etykietę Lidera, sama etykieta niewiele mówi kupującym; względne pozycje niosą sygnał.
Co zmieniłoby tę listę
Cztery rzeczy, w kolejności, w jakiej nadalibyśmy im wagę. Dostawca daje nam dostęp do testowania swojej platformy zgodnie z naszą metodologią, niezależnie od tego, czy jest to sprzęt, który możemy sami hostować, czy dostęp do większego wdrożenia. Dostawca zgłasza się do aktualnej rundy audytu, MLPerf Storage lub SPECstorage. Operator, a nie dostawca, dokumentuje wdrożenie, tak jak Meta zrobiła to z Hammerspace. Albo dostawca traci oznaczenie lub partnerstwo, od którego zależy jego obecne pozycjonowanie – sposób, w jaki podział WEKA i HPE zmienił sposób, w jaki obie firmy docierają do nabywców rozwiązań AI. Aktualizujemy profile w miarę ich występowania.
Co tak naprawdę pokazują audytowane wskaźniki porównawcze
Szkolenia AI i dostawcy neocloud, którzy je obsługują, to obszary, w których w 2026 roku toczy się wyścig o wydajność pamięci masowej. Jest to jedyny segment z solidnym, audytowanym benchmarkiem: MLCommons MLPerf Storage. Aktualnie opublikowana runda to v3.0 (wrzesień 2026), z 19 zgłoszonymi organizacjami i 143 wynikami. Po raz pierwszy benchmark obejmuje cały proces AI: przepustowość szkolenia, punkty kontrolne i dwa nowe testy wnioskowania (Vector Database i KV Cache), a także obsługę pamięci obiektowej S3, z której korzystała około jedna szósta zgłoszeń. Ponieważ v3.0 przeniosła symulowane akceleratory z H100 do B200, wyniki nie są porównywalne z wynikami z poprzednich rund. MLPerf Storage nie wyłonił jednego zwycięzcy; różne systemy generują różne obciążenia i metryki.
| Konfiguracja | Wynik audytu (pamięć masowa MLPerf w wersji 3.0) | Klasa |
|---|---|---|
| Everpure FlashBlade//EXA | Zapis do punktu kontrolnego 877.5 GiB/s i odczyt 833 GiB/s przy 30 węzłach danych; odczyt pamięci podręcznej KV 1,623 GiB/s | Lider w zakresie punktów kontrolnych i wnioskowania |
| YanRongTech F9000X | 543.9 GiB/s w sieci U-Net 3D zasilającej 99 symulowanych akceleratorów B200 | Najwyższa przesłana przepustowość szkoleniowa |
| TuringData F9200 | 541.5 GiB/s w sieci 3D U-Net z trzech węzłów pamięci masowej; punkt kontrolny 70B przy odczycie 539.9 GiB/s i zapisie 307.1 GiB/s | Nowość w zakresie gęstości wydajności |
| Zarządzany połysk platformy Azure | Zapis punktu kontrolnego 642.2 GiB/s z 4,096 TiB zarządzanego wdrożenia w chmurze | Pierwsza przesłana usługa w chmurze o dużej skali |
| NVIDIA AIStore | 20 zgłoszeń dotyczących pamięci masowej obiektów S3 w OCI, AWS i GCP | Przechowywanie obiektów w środowisku równoległego systemu plików |
W kategorii HPC, na liście IO500 (edycja ISC 2026) liderem jest Sugon ParaStor z SCNet z mierzoną przepustowością 26 888 GiB/s na 500 węzłach klienckich, przy czym systemy Intel DAOS (Argonne Aurora, LRZ) zajmują wiele czołowych miejsc, a Weka pojawia się na liście Samsung SSC-24. Obroty w wersji 3.0 są równie ważne, co liczby: liderzy przepustowości w wersji 2.0, DDN, Huawei, Hammerspace i Lightbits, opuścili tę rundę, a 11 firm zgłosiło się po raz pierwszy, w tym Azure i NVIDIA. Pełna analiza w naszym omówieniu MLPerf Storage v3.0.
Kto tak naprawdę zasila Neocloudy
Sukcesy we wdrożeniach nie są punktami odniesienia, ale realnym dowodem na to, co kupują operatorzy, gdy wydajność jest ich priorytetem. Warto zauważyć, że największe fabryki sztucznej inteligencji pochodzą od wielu dostawców; żadna firma zajmująca się pamięcią masową nie jest wyłącznym właścicielem żadnej z tych lokalizacji.
| AI Chmura | Dyski | Szczegóły |
|---|---|---|
| RdzeńWeave | VAST Data (oraz WEKA, DDN, IBM Storage Scale, Everpure w stosie) | Wieloletnia umowa o wartości 1.17 miliarda dolarów, listopad 2025 r., największy klient VAST |
| Kolos xAI | DDN EXAScaler i Infinia z VAST Data dodanymi w rozszerzeniu Frontier AI Factory | DDN ogłoszono w listopadzie 2024 r. przy 100 tys. procesorów GPU; od końca 2025 r. będzie oferować rozwiązania wielu dostawców |
| Nebiusz | Siatka neuronowa WEKA | Poziom premium Nebius AI Cloud, zapowiedziany w czerwcu 2025 r. |
| Razem AI | IBM Cloud (systemy HGX B300) | Umowa o wartości 240 milionów dolarów ogłoszona w sierpniu 2026 r.; warstwa pamięci masowej nie została jeszcze ujawniona |
Śledzenie roszczeń
Oto aktualne „najszybsze” twierdzenia w segmencie pamięci masowej AI. Żadne z nich nie zostało niezależnie zweryfikowane w deklarowanej skali; większość z nich jest podawana przez dostawców jako wynik testów wewnętrznych, a najsilniejsze pochodzenie w tabeli to test audytowany przez analityków, oparty na prognozowanym nagłówku.
| Roszczenie sprzedawcy | Numer | Status |
|---|---|---|
| Everpure FlashBlade//EXA, „najwydajniejsza w branży platforma do przechowywania danych” (marzec 2025 r.) | Przewidywana prędkość odczytu 10+ TB/s w pojedynczej przestrzeni nazw | Prognoza dostawcy; brak zweryfikowanego zgłoszenia |
| Dell Lightning File System, „najszybszy na świecie równoległy system plików” (GA, kwiecień 2026 r.) | Do 150 GB/s na jednostkę rackową, w oparciu o wewnętrzną analizę firmy Dell | Roszczenie dostawcy; brak zweryfikowanego zgłoszenia |
| Pamięć masowa Dell Exascale (GTC 2026) | Do 6 TB/s na szafę | Roszczenie dostawcy; brak zweryfikowanego zgłoszenia |
| Huawei New-Gen OceanStor Dorado (wrzesień 2024) | Maksymalny limit 100 milionów IOPS według specyfikacji przy opóźnieniu 0.03 ms | Specyfikacja dostawcy; test Omdia zlecony przez Huawei wykazał 2.58 mln stałych operacji wejścia/wyjścia na sekundę (IOPS) przy 70 mikrosekundach na rzeczywistym obciążeniu Oracle RAC, co stanowi przydatną weryfikację rzeczywistych wartości maksymalnych podanych w specyfikacji |
| WEKA, WEKApod 3 z NeuralMesh 6, deklaracja pojedynczego eksabajta (lipiec 2026 r.) | 1.1 EB i 10.2 TB/s w jednej szafie | Roszczenie dostawcy; WEKA ostatnio przesłała do MLPerf Storage w wersji 1.0 i pominęła wersję 2.0 |
| VAST Data i AMD, odciążenie pamięci podręcznej KV w systemie Instinct (lipiec 2026 r.) | 9x szybszy czas do pierwszego tokena | Wspólne testowanie dostawców; VAST nigdy nie poddał się testowi MLPerf Storage |
| DDN i Nebul, przyspieszenie pamięci podręcznej KV z NVIDIA Dynamo (lipiec 2026 r.) | Przyspieszenie obciążeń wnioskowania określone przez dostawcę | Walidacja partnera, a nie niezależny audyt; DDN posiada aktualne wyniki MLPerf Storage v2.0 |
| NetApp Novus, „najszybsza pamięć masowa na świecie” (październik 2026 r.) | Przewidywana przepustowość 100 TB/s sekwencyjnych odczytów w obrębie pojedynczej przestrzeni nazw pNFS | Skalowanie niemal liniowe w mniejszym klastrze, sprawdzone przez Omdia; wartość 100 TB/s to prognoza Omdia z tego testu, a nie pomiar |
Co się stało z SPC-1?
SPC-1 był branżowym benchmarkiem pamięci blokowej, a obecnie jest w stanie półuśpienia: amerykańscy dostawcy praktycznie z niego zrezygnowali około 2018 roku, pozostawiając w rankingu zdominowanych przez dostawców chińskich. Obecny akceptowany rekord nie jest powszechnie cytowanym wynikiem Huawei. ExponTech WDS V3 utrzymuje najwyższy akceptowany wynik z wynikiem 27.2 mln IOPS SPC-1 (zaakceptowany w listopadzie 2023 r.), wyprzedzając Inspur z wynikiem 23.0 mln, a słynne 21.0 mln IOPS Huawei z 2020 r. zajmuje obecnie czwarte miejsce. Wyższy wynik FlashNexus, wynoszący 30.0 mln IOPS, pozostaje niezaakceptowany w procesie weryfikacji od lutego 2025 r. i nie traktujemy go jako rekordu, dopóki nie zrobi tego Storage Performance Council.
Jak działa ta strona
Trzy zasady. Po pierwsze, każda liczba jest oznaczona klasą dowodów: zweryfikowane zgłoszenie, oświadczenie dostawcy lub pomiar StorageReview. Po drugie, nie powtarzamy superlatywów, których nie możemy znaleźć w aktualnych danych; kilka znanych twierdzeń o „najszybszych” na tej stronie pochodzi sprzed lat i jest odpowiednio oznaczonych. Po trzecie, ścieżka do zweryfikowanej strony tej strony jest otwarta dla każdego dostawcy: prześlij do MLPerf Storage lub IO500 albo daj nam dostęp do testów zgodnie z naszą standardową metodologią. Ta strona dotyczy wyłącznie sztucznej inteligencji i pamięci masowej neocloud. Typowe korporacyjne pamięci masowe blokowo-plikowe i pamięci masowe dla małych i średnich firm (SMB) otrzymują osobne strony, a nie są tutaj umieszczane, ponieważ dowody dostępne w każdym segmencie są inne. Aktualizujemy profile liderów w miarę pojawiania się nowych informacji i przeprowadzamy pełne przejście po opublikowaniu nowej, zweryfikowanej rundy.
Najczęściej zadawane pytania dotyczące najszybszego przechowywania danych
Jaka jest najszybsza macierz pamięci masowej na świecie?
Nie ma jednej, zweryfikowanej odpowiedzi, a każdy, kto ją podaje, powołuje się na dostawcę. Według zweryfikowanych danych z września 2026 r.: FlashBlade//EXA firmy Everpure odnotował najwyższą wartość punktu kontrolnego MLPerf Storage v3.0 na poziomie zapisu 877.5 GiB/s, F9000X firmy YanRongTech osiągnął najwyższą przepustowość szkoleniową na poziomie 543.9 GiB/s, Sugon ParaStor jest na szczycie listy przepustowości IO500, a ExponTech utrzymuje akceptowany rekord SPC-1 IOPS. Największe deklarowane wartości, w tym prognozy Dell dotyczące pamięci masowej Exascale na szafę, pozostają niezweryfikowane przez niezależne podmioty.
Jaki jest najszybszy sposób przechowywania danych do trenowania sztucznej inteligencji?
W ocenie MLPerf Storage v3.0, jedynego audytowanego benchmarku pamięci masowej AI, liderami w zakresie przepustowości szkoleń są YanRongTech, TuringData i UBIX, podczas gdy Everpure prowadzi w zakresie punktów kontrolnych i wnioskowania o pamięci podręcznej KV, a Azure przoduje wśród usług chmurowych. Biorąc pod uwagę to, co wdrażają najwięksi operatorzy AI, VAST, DDN i WEKA dominują w neocloudzie, choć żadna z tych trzech firm nie zgłosiła się do v3.0. Oba rodzaje dowodów są opisane powyżej.
Dlaczego istnieje tak mało niezależnych testów porównawczych macierzy korporacyjnych?
Ponieważ większość dostawców pamięci masowej dla przedsiębiorstw ma w umowach zakaz publikowania wyników testów porównawczych, a producenci macierzy głównych zrezygnowali z publicznych testów porównawczych, z których kiedyś korzystali, zwłaszcza z SPC-1, około 2018 roku. Dostawcy oferujący rozwiązania AI częściowo odwrócili ten trend, ponieważ udział w programie MLPerf Storage stał się wymogiem sprzedaży. Aktualizujemy tę stronę w miarę publikowania nowych, zweryfikowanych wyników.
Czy szyfrowanie odporne na ataki kwantowe powinno być czynnikiem branym pod uwagę przy zakupie macierzy?
W przypadku branż regulowanych – tak, a terminy są bliższe, niż się wydaje. Wytyczne NSA dotyczące CNSA 2.0 wymagają, aby nowe instalacje Systemu Bezpieczeństwa Narodowego były zgodne z normami do stycznia 2027 r., a systemy niezgodne z nimi zostały wycofane z eksploatacji do końca 2030 r., a unijne ramy NIS2 i DORA mają własne wymagania dotyczące szyfrowania. Ukończony standard FC-SP-3 sprawia, że jest to raczej szczegół zamówienia niż projekt: karty HBA obsługujące FC-SP-3 szyfrują ruch SAN w locie z prędkością łącza za pomocą algorytmów postkwantowych, a ponieważ szyfrowanie odbywa się na poziomie warstwy transportowej, macierz nadal otrzymuje dane, które może kompresować, deduplikować i skanować w poszukiwaniu anomalii związanych z oprogramowaniem ransomware, co jest pomijane przez szyfrowanie na poziomie aplikacji usług. Określenie łączności FC-SP-3 w standardowych zakupach odświeżonych co trzy do pięciu lat zapewnia w pełni zaszyfrowaną sieć SAN do 2030 r. jako produkt uboczny. Sprzęt jest już dostępny w segmencie średnim: każdy Dell PowerStore Gen 3 jest obecnie wyposażony w karty Fibre Channel obsługujące EDIF w gniazdach OCP, a Dell planuje samo szyfrowanie połączeń w ramach niezakłócającej pracy aktualizacji oprogramowania PowerStoreOS 5.1, omówionej w naszym dogłębnym opracowaniu PowerStoreOS 5.0 . Nasze dogłębne omówienie standardu, terminów realizacji i modeli wdrożenia.


 Amazon