

၂၀၂၆ ခုနှစ်၊ အောက်တိုဘာလ ၂၉ ရက်နေ့တွင် အပ်ဒိတ်လုပ်ခဲ့သည်- IBM ၏ပရိုဖိုင်တွင် FlashSystem block storage နှင့် ကျွန်ုပ်တို့၏ Oracle AI Database 26ai လွှမ်းခြုံမှုကို ထည့်သွင်းထားပြီး၊ quantum-resistant encryption FAQ တွင် Broadcom ၏ Fibre Channel hardware ကို ထည့်သွင်းထားသည်။ အောက်တိုဘာလ ၁၃ ရက်နေ့တွင်၊ house style အတွက် copy pass တစ်ခုသည် vendor profile များ၊ claims tracker နှင့် data များကို မပြောင်းလဲစေခဲ့ပါ။
အဓိကသိုလှောင်မှုရောင်းချသူတိုင်းက အကောင်းဆုံးသိုလှောင်မှုအစုအဝေးကို ရောင်းချသည်ဟု ဆိုကြပြီး နှစ်ပေါင်းများစွာ အကောင်းဆုံးအတွက် proxy သည် အမြန်ဆုံးဖြစ်သော်လည်း မည်သူမျှ လွတ်လပ်သောစမ်းသပ်မှုကို ခွင့်မပြုပါ။ Dell၊ Everpure (ယခင် Pure Storage)၊ VAST၊ Weka၊ IBM၊ NetApp နှင့် Huawei အားလုံးသည် ဈေးကွက်စွမ်းဆောင်ရည် ဦးဆောင်သူများဖြစ်ပြီး ထိုအခိုင်အမာပြောဆိုချက်များ၏နောက်ကွယ်ရှိ ကိန်းဂဏန်းအားလုံးနီးပါးသည် ရောင်းချသူ၏ကိုယ်ပိုင်အတွင်းပိုင်းစမ်းသပ်မှုမှ လာခြင်းဖြစ်ပြီး “တကယ့်စွမ်းဆောင်ရည် ကွဲပြားနိုင်သည်” ဟု အောက်ခြေတွင် ဖော်ပြထားသည်။
ဒီစာမျက်နှာက အဲဒါကို ဖြေရှင်းဖို့ ရှိနေတာကြောင့် သိုလှောင်မှုစွမ်းဆောင်ရည် အထောက်အထားတွေကို အမျိုးအစားသုံးမျိုး ခွဲခြားပြီး ဒီစာမျက်နှာက နံပါတ်တိုင်းကို သက်ဆိုင်ရာ အမည်တပ်ထားပါတယ်- စစ်ဆေးပြီးသား benchmark တင်သွင်းမှုတွေ (MLPerf Storage၊ IO500၊ SPC-1၊ ရောင်းချသူတွေက ထုတ်ဝေထားတဲ့ စည်းမျဉ်းတွေအောက်မှာ ရလဒ်တွေကို တင်သွင်းတဲ့)၊ ရောင်းချသူတွေရဲ့ တောင်းဆိုချက်တွေ (သီးခြားအတည်ပြုချက်မရှိဘဲ spec sheet တွေနဲ့ launch နံပါတ်တွေ) နဲ့ StorageReview ဓာတ်ခွဲခန်းရလဒ်တွေ (ကျွန်တော်တို့ကိုယ်တိုင် တိုင်းတာထားတဲ့ စနစ်တွေ)။ ရောင်းချသူက သူ့ရဲ့ array ကို စမ်းသပ်ခွင့်မပြုတဲ့အခါ၊ ကျွန်တော်တို့ အဲဒီလိုပြောပါတယ်။ အတည်ပြုနိုင်တဲ့ data မရှိတာက ဇာတ်လမ်းရဲ့ တစ်စိတ်တစ်ပိုင်းပါ။
AI သိုလှောင်မှုတွင် ဦးဆောင်သူများ
AI လေ့ကျင့်ရေး cluster သို့မဟုတ် neocloud တစ်ခုတည်ဆောက်သည့်အခါ ပေါ်လာသော ရောင်းချသူများမှာ ဤရောင်းချသူများဖြစ်သည်။ တစ်ခုတည်းသော တိုင်းတာမှုတစ်ခုကို သဘောတူညီထားခြင်း မရှိသောကြောင့် ကျွန်ုပ်တို့သည် ၎င်းတို့ကို အဆင့်သတ်မှတ်ခြင်း မပြုလုပ်ပါ။ ကျွန်ုပ်တို့ လုပ်ဆောင်နိုင်သည်မှာ တစ်ခုချင်းစီကို တူညီသော အချက်အလက်အစုံ ပေးရုံသာဖြစ်သည်- ပလက်ဖောင်းကား အဘယ်နည်း၊ ဖောက်သည်အမည်ဖြင့် မည်သည့်နေရာတွင် ဖြန့်ကျက်ထားသည်၊ NVIDIA က ၎င်းကို အတည်ပြုထားခြင်း ရှိ၊ မရှိ၊ ၎င်းတွင် စာရင်းစစ်ထားသော benchmark ရလဒ် ရှိမရှိနှင့် ၎င်း၏ စွမ်းဆောင်ရည် တောင်းဆိုချက်များထဲမှ မည်သည့်အရာများကို အတည်မပြုရသေးပါ။ ရောင်းချသူတစ်ဦးက ဤအရာများထဲမှ တစ်ခုခုအကြောင်း သတင်းများ ထုတ်ပြန်သည့်အခါ ကျွန်ုပ်တို့သည် ပရိုဖိုင်ကို အပ်ဒိတ်လုပ်ပါသည်။
ပထမလေးဦးက AI-native storage specialists တွေဖြစ်ပြီး ကျန်တဲ့သူတွေကတော့ AI ထုတ်ကုန်လိုင်းတွေရှိတဲ့ တည်ထောင်ပြီးသား enterprise storage vendors တွေပါ။ အဖွဲ့နှစ်ဖွဲ့စလုံးက တကယ့်ဖြန့်ကျက်မှုတွေမှာ အနိုင်ရကြပြီး သက်သေအထောက်အထားတွေ အရမ်းကွာခြားပါတယ်။
VAST Data
ပလက်ဖောင်း- DASE (Disaggregated, Shared-Everything) ဗိသုကာပေါ်တွင်တည်ဆောက်ထားသော VAST AI Operating System။ Stateless compute containers များသည် NVMe-oF ပေါ်ရှိ NVMe enclosures အစုအဝေးကို ရှေ့တွင်ထားပြီး storage-class-memory write buffer ပါရှိသော all-QLC media ပေါ်တွင် file၊ object နှင့် database access တစ်လျှောက် single namespace ကိုတင်ပြသည်။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- VAST သည် ၎င်း၏ အကြီးဆုံးဖောက်သည်အဖြစ် ဖော်ပြသည့် ၂၀၂၅ ခုနှစ် နိုဝင်ဘာလတွင် ကြေညာခဲ့သော ဒေါ်လာ ၁.၁၇ ဘီလီယံတန် နှစ်ရှည်သဘောတူညီချက်အောက်တွင် CoreWeave။ VAST ကို xAI Colossus Frontier AI Factory တိုးချဲ့မှုတွင် ထည့်သွင်းထားပြီး NVIDIA GB300 NVL72 တွင် အသုံးပြုနေသော Mistral Compute AI စက်ရုံများကို စွမ်းအားပေးပါသည်။
NVIDIA အတည်ပြုချက်- NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်နှင့် DGX SuperPOD အတွက် အတည်ပြုချက်။
စစ်ဆေးပြီးသော ရလဒ်- မရှိပါ။ VAST သည် MLPerf Storage သို့ ဘယ်သောအခါမှ တင်သွင်းခြင်း မရှိပါ။
ပွင့်လင်းသောတောင်းဆိုချက်များ- Instinct တွင် KV cache offload မှတစ်ဆင့် time-to-first-token ကို ၉ ဆ ပိုမြန်စေကြောင်း VAST နှင့် AMD ပူးတွဲပြောဆိုချက်၊ vendor စမ်းသပ်မှု။ ဒေါ်လာ ၃၀ ဘီလီယံတန်ဖိုးရှိ ၂၀၂၆ ခုနှစ် ဧပြီလ Series F သည် မျှော်လင့်ချက်များကို သတ်မှတ်ပေးသော်လည်း စွမ်းဆောင်ရည်နံပါတ်မဟုတ်ပါ။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု-
- KV cache offload ဖြင့် ပထမဆုံး token ကို ၉ ဆ ပိုမြန်စေကြောင်း VAST နှင့် AMD တို့က အခိုင်အမာဆို (ဇူလိုင် 2026)
- GPU ရှားပါးမှုကို ဖြေရှင်းရန် Cloudera နှင့် VAST တို့က အာရုံစိုက် (ဇူလိုင် 2026)
- VAST သည် GB300 NVL72 တွင် Mistral Compute AI စက်ရုံများကို စွမ်းအားပေးသည် (မေ 2026)
- VAST သည် ၎င်း၏ အေးဂျင့် AI OS ကို မိတ်ဆက်ခဲ့သည် (ဖေဖော်ဝါရီ ၁၅)
- VAST Amplify သည် ရှိပြီးသား SSD များကို ၆ ဆ ပိုကြီးသည်ဟု ခံစားရစေရန် ရည်ရွယ်သည် (ဇန်နဝါရီလ 2026)
- VAST သည် DPU-native inference architecture ကို မိတ်ဆက်သည် (ဇန်နဝါရီလ 2026)
WEKA
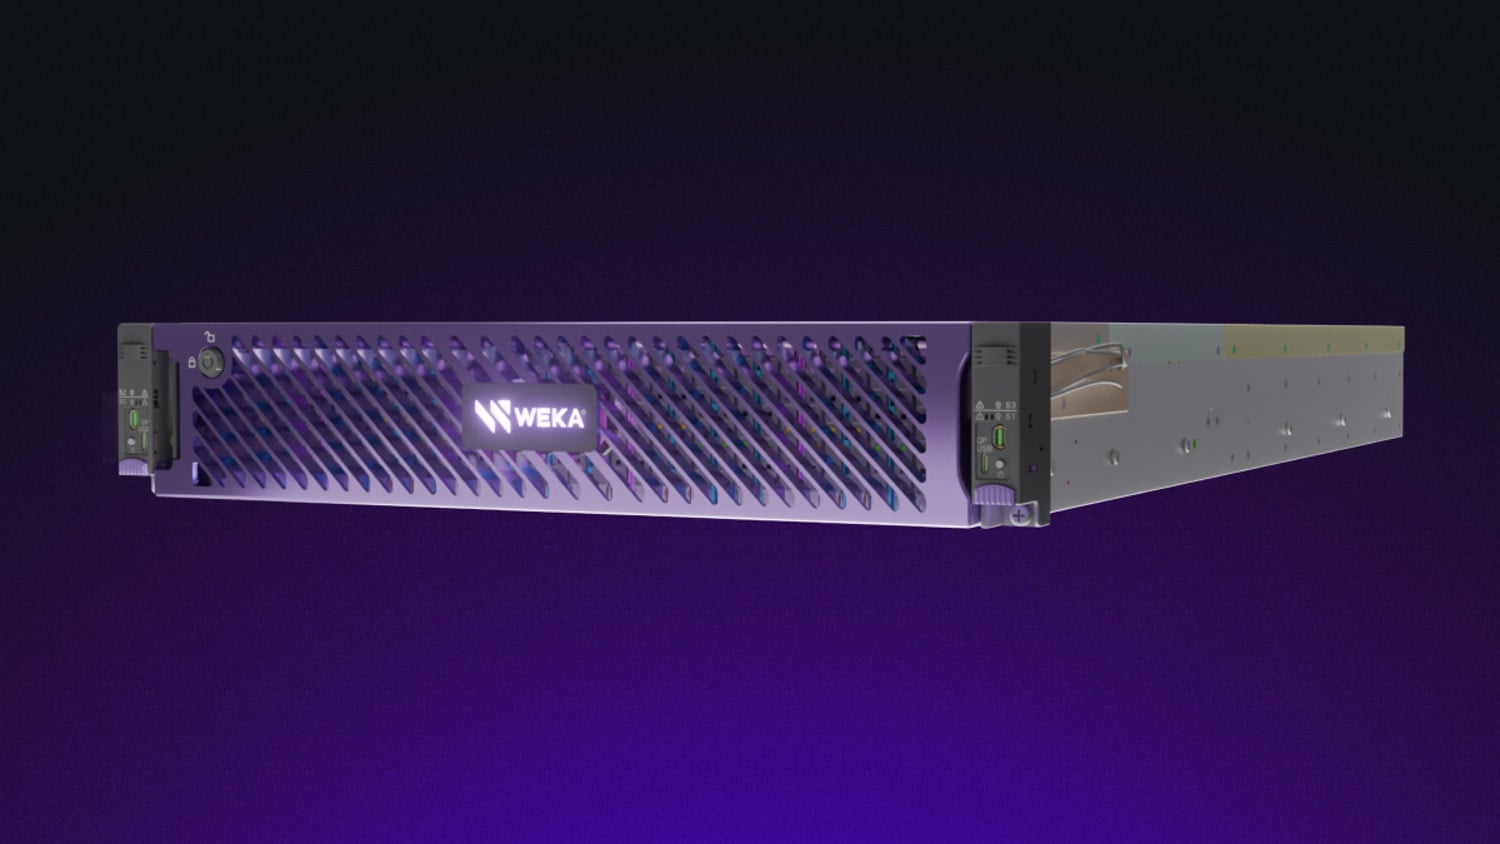
ပလက်ဖောင်း: ယခင်က WekaFS အဖြစ်လူသိများသော software-defined parallel file system ဖြစ်သည့် NeuralMesh ကို software အဖြစ်နှင့် WEKApod appliances အဖြစ်ရောင်းချသည်။ NeuralMesh Axon သည် GPU server များအတွင်း တူညီသော data plane ကိုထည့်သွင်းထားသောကြောင့် local NVMe သည် cluster နှင့်ပူးပေါင်းပြီး အလုပ်မလုပ်တော့ပါ။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- Nebius သည် ၎င်း၏ AI cloud ၏ ပရီမီယံအဆင့်အဖြစ် NeuralMesh ကို လုပ်ဆောင်သည်။ Andromeda သည် ၂၀၂၆ ခုနှစ် ဇူလိုင်လတွင် GPU provider ၅၀ ခန့်တွင် NeuralMesh တွင် စံသတ်မှတ်ခဲ့သည်။ WEKA သည် CoreWeave ရှိ multi-vendor stack ၏ အစိတ်အပိုင်းတစ်ခုလည်းဖြစ်သည်။
NVIDIA အတည်ပြုချက်- NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်၊ DGX SuperPOD နှင့် BasePOD အတည်ပြုချက်များ။
စစ်ဆေးပြီးရလဒ်- WEKA သည် ၂၀၂၄ ခုနှစ် စက်တင်ဘာလတွင် MLPerf Storage v1.0 သို့ တင်သွင်းခဲ့သော်လည်း ၂၀၂၅ ခုနှစ် ဩဂုတ်လတွင် v2.0 သို့ တင်သွင်းခြင်းမပြုခဲ့ပါ။ ၎င်း၏ မကြာသေးမီက စစ်ဆေးပြီးသော နံပါတ်များသည် မျိုးဆက်တစ်ခုသာ ရှိသေးပါသည်။
ပွင့်လင်းသောတောင်းဆိုမှုများ- NeuralMesh 6 ပါသည့် WEKApod 3 ကို single rack တွင် 1.1 EB နှင့် 10.2 TB/s ဖြင့် အခိုင်အမာပြောဆိုထားသည်။ ရောင်းချသူကိန်းဂဏန်းများ၊ ၎င်းတို့နောက်ကွယ်တွင် စာရင်းစစ်ထားသော တင်ပြချက်မရှိပါ။
သိထားသင့်သည်များ- HPE သည် ၎င်း၏ WEKA၊ Qumulo နှင့် Scality မိတ်ဖက်များကို ၂၀၂၅ ခုနှစ် နိုဝင်ဘာလတွင် ရပ်ဆိုင်းလိုက်သောကြောင့် WEKA သည် HPE channel မှတစ်ဆင့် ဝယ်ယူသူများထံ မရောက်နိုင်တော့ပါ။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု-
- Andromeda သည် GPU ပံ့ပိုးပေးသူ ၅၀ ကျော်တွင် NeuralMesh တွင် စံသတ်မှတ်သည် (ဇူလိုင် 2026)
- WEKApod 3 သည် single-rack exabyte အတားအဆီးကို ချိုးဖျက်သည် (ဇူလိုင် 2026)
- NeuralMesh AIDP သည် ယေဘုယျအားဖြင့် ရရှိနိုင်မှုသို့ ရောက်ရှိပါပြီ (မတ် ၁၅)
- NeuralMesh သည် inference memory အတွက် NVIDIA STX နှင့် ပေါင်းစပ်ထားသည် (မတ် ၁၅)
- WEKApod Prime နှင့် Nitro နောက်မျိုးဆက် ပလက်ဖောင်းများ (နိုဝင်ဘာ ၁၅)
DDN
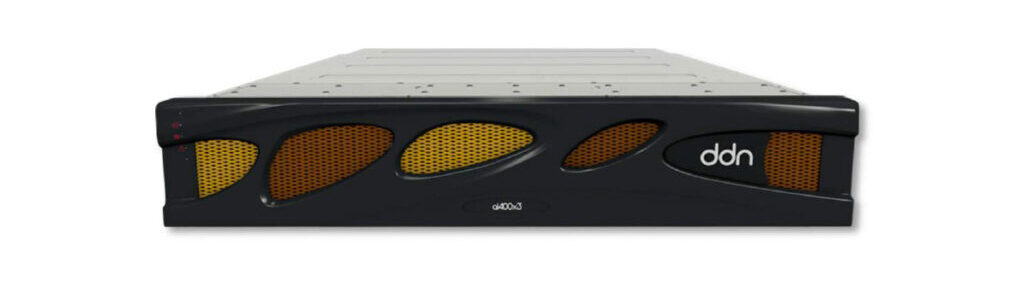
ပလက်ဖောင်း- AI400X3 နှင့် AI400X3M appliances များ၏နောက်ကွယ်ရှိ Lustre မှဆင်းသက်လာသော parallel file system EXAScaler ပါဝင်သော လိုင်းနှစ်ခုသည် လေ့ကျင့်မှုကို ကိုင်တွယ်သည်။ 2.4 တွင် multi-tenancy နှင့် POSIX ပံ့ပိုးမှုကို ထည့်သွင်းထားသော key-value object platform တစ်ခုဖြစ်သည့် Infinia သည် inference နှင့် AI factory workloads များကို ပစ်မှတ်ထားသည်။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- ၂၀၂၄ ခုနှစ် နိုဝင်ဘာလတွင် GPU ၂၀၀,၀၀၀ ဖြင့် EXAScaler နှင့် Infinia တွင် ကြေညာခဲ့သော xAI Colossus။ DDN တွင် AI လည်ပတ်မှုမတိုင်မီက အမျိုးသားဓာတ်ခွဲခန်းနှင့် HPC တပ်ဆင်မှုများ၏ စာရင်းရှည်ကိုလည်း သိမ်းဆည်းထားသည်။
NVIDIA အတည်ပြုချက်- NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်၊ DGX SuperPOD အတည်ပြုချက်။
စစ်ဆေးပြီးရလဒ်- ဟုတ်ကဲ့၊ ၎င်းသည် လက်ရှိအခြေအနေဖြစ်သည်။ MLPerf Storage v2.0 တွင် AI400X3 သည် node များစွာတွင် 3D U-Net တွင် 120.68 GB/s ကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး 2RU appliance မှ Llama3-8b checkpoints များကို 30.6 GB/s read နှင့် 15.3 GB/s write ဖြင့် ကိုင်တွယ်ခဲ့သည်။ အထောက်အထားများအရ DDN သည် ဤစာရင်းတွင် အားအကောင်းဆုံး entry ဖြစ်သည်။
ပွင့်လင်းသောပြောဆိုချက်များ- NVIDIA Dynamo မှတစ်ဆင့် KV cache အရှိန်မြှင့်ခြင်းကို လွတ်လပ်သောအဖွဲ့အစည်းတစ်ခုမှမဟုတ်ဘဲ Nebul နှင့်ပူးတွဲအတည်ပြုထားသည်။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု-
- DDN သည် ISC 2026 တွင် AI400X3M ကို မိတ်ဆက်ခဲ့သည် ဇွန်လ (၁၉၃၂)၊
- Infinia 2.4 မှာ multi-tenancy နဲ့ POSIX support တွေ ပါဝင်လာပါတယ် (ဇူလိုင် 2026)
- DDN နှင့် Nebul တို့သည် KV cache acceleration ကို အတည်ပြုပေးသည် (ဇူလိုင် 2026)
DDN သည် MLPerf Storage v2.0 ကို စွမ်းဆောင်ရည်သိပ်သည်းဆတွင် ဦးဆောင်ခဲ့သော်လည်း v3.0 အဆင့်သို့ မရောက်ရှိခဲ့ပါ။
ဟမ်းမားစပေ့စ်
ပလက်ဖောင်း- GPU ဆာဗာများအတွင်းတွင်ရှိနှင့်ပြီးဖြစ်သော local NVMe ကို shared, checkpoint-capable capacity အဖြစ်သို့ပြောင်းလဲပေးသည့် Hammerspace Global Data Platform နှင့် Tier 0။ ၎င်းကို standards များ၊ parallel NFS (NFS 4.2 with FlexFiles) ပေါ်တွင်တည်ဆောက်ထားပြီး proprietary appliance မပါသော normal server များတွင်လည်ပတ်သောကြောင့် ဓာတ်ပုံရိုက်ရန် Hammerspace box မရှိပါ။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- Meta သည် ၎င်း၏ကိုယ်ပိုင် အင်ဂျင်နီယာဘလော့ဂ်တွင် 24,576-GPU H100 cluster နှစ်ခုတွင် Hammerspace ကို မှတ်တမ်းတင်ထားသည်။ ၎င်းသည် ဤစာမျက်နှာရှိ မည်သည့်ရောင်းချသူထံမှမဆို ကြီးမားသော AI storage ဖြန့်ကျက်မှု၏ အတိကျဆုံး first-party အကောင့်ဖြစ်သည်၊ အဘယ်ကြောင့်ဆိုသော် ရောင်းချသူမဟုတ်ဘဲ operator က ၎င်းကို ရေးသားထားသောကြောင့်ဖြစ်သည်။
NVIDIA အတည်ပြုချက်- မရှိပါ။ Hammerspace တွင် DGX SuperPOD၊ DGX BasePOD၊ NCP ရည်ညွှန်းဗိသုကာ သို့မဟုတ် NVIDIA-Certified Storage သတ်မှတ်ချက် မရှိပါ။
စစ်ဆေးပြီးရလဒ်- ဟုတ်ကဲ့၊ MLPerf Storage v1.0 နှင့် v2.0 နှစ်ခုလုံးတွင်။ v2.0 တွင် Tier 0 သည် accelerator utilization ၉၆.၄ ရာခိုင်နှုန်းဖြင့် node ငါးခုတွင် 3D U-Net တွင် 420.8 GB/s ပေးပို့ခဲ့ပြီး simulated H100s ၁၄၀ ကို ထောက်ပံ့ပေးခဲ့သည်။ Hammerspace သည် ဤစာရင်းတွင် အကောင်းဆုံးစစ်ဆေးပြီးပါဝင်မှုမှတ်တမ်းရှိပြီး NVIDIA အတည်ပြုချက်ဇာတ်လမ်းတွင် အားအနည်းဆုံးဖြစ်ပြီး ဤနေရာရှိ အခြားသူများနီးပါးနှင့် ပြောင်းပြန်ဖြစ်သည်။
ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု- Hammerspace ဟာ StorageReview lab ကနေတစ်ဆင့် မဝင်ရောက်ရသေးဘဲ၊ ကျွန်တော်တို့ရဲ့ မကြာသေးမီက လွှမ်းခြုံမှုက နည်းပါးပါတယ်။ အဲဒါက ကျွန်တော်တို့ဘက်မှာ ကွာဟချက်တစ်ခုပါ၊ platform ကို ထိခိုက်စေတာ မဟုတ်ပါဘူး။
v2.0 တင်သွင်းသူ Hammerspace သည်လည်း v3.0 အချီတွင် မပါဝင်ခဲ့ပါ။
Dell က Technologies က
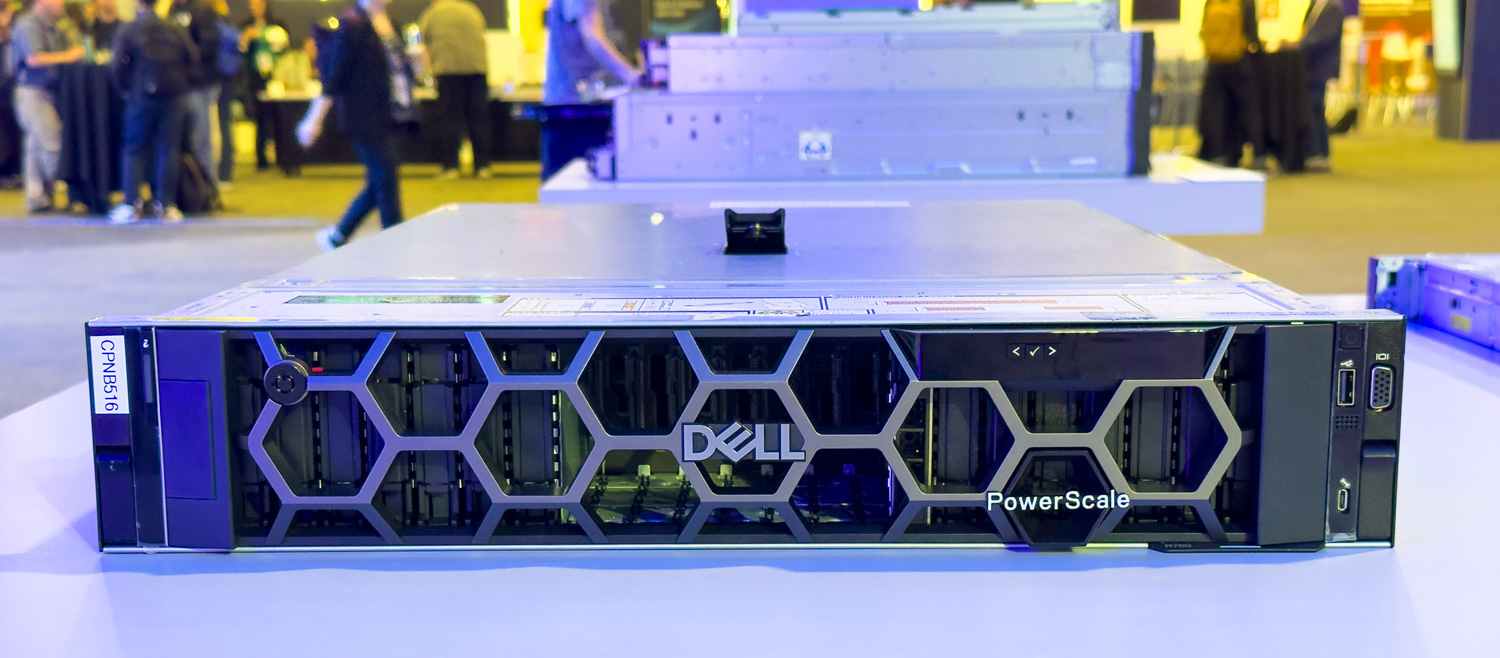
Platform: pipeline ရဲ့ အစိတ်အပိုင်းအမျိုးမျိုးကို ရည်ရွယ်တဲ့ အချက်သုံးချက်ပါ။ PowerScale က all-flash F-series node တွေပါတဲ့ scale-out NAS line ပါ။ ObjectScale က ၂၀၂၆ ခုနှစ်မှာ RDMA နဲ့ KV cache offload ကနေ S3 ကို ကောက်ယူခဲ့တဲ့ S3 layer ပါ။ Lightning File System က ၂၀၂၆ ခုနှစ် ဧပြီလမှာ GA ဖြစ်လာတဲ့ parallel file system အသစ်တစ်ခုဖြစ်ပြီး Dell က DDN၊ VAST နဲ့ WEKA တို့ကို ယှဉ်ပြီး ရပ်တည်နေတဲ့ အပိုင်းပါ။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- Dell သိုလှောင်မှုတွင် အမည်ပေးထားသော ကြီးမားသော AI လေ့ကျင့်ရေး ဖြန့်ကျက်မှုကို ကျွန်ုပ်တို့ အတည်မပြုနိုင်ပါ။ အခိုင်မာဆုံး အများပြည်သူဆိုင်ရာ ကိုးကားချက်မှာ PowerScale တွင် ယာဉ်မောင်းဘေးကင်းရေး AI ဓာတ်ခွဲခန်းကို လည်ပတ်နေသော Subaru ဖြစ်သည်။ ဤအရွယ်အစားရှိသော ရောင်းချသူအတွက်၊ ၎င်းသည် AI-native ရောင်းချသူများ လူသိရှင်ကြားထုတ်ပြန်သည့် neocloud အနိုင်ရမှုနှင့်ဘေးတွင် ထင်ရှားသောကွာဟချက်တစ်ခုဖြစ်သည်။
NVIDIA အတည်ပြုချက်- NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်နှင့် PowerScale တို့သည် ၂၀၂၅ ခုနှစ် ဇူလိုင်လတွင် NVIDIA Cloud Partner program အသိအမှတ်ပြုလက်မှတ်ကို ရရှိခဲ့သည်။
စာရင်းစစ်ဆေးပြီးသောရလဒ်- မရှိပါ။ Dell သည် MLPerf Storage သို့ ဘယ်သောအခါမှ တင်သွင်းခဲ့ခြင်းမရှိပါ။
ပွင့်လင်းသောပြောဆိုချက်များ- Dell သည် Lightning ကို ကမ္ဘာ့အမြန်ဆုံး parallel file system ဟု အတွင်းပိုင်းခွဲခြမ်းစိတ်ဖြာမှု၏အစွမ်းသတ္တိဖြင့် ခေါ်ဆိုပြီး rack တစ်ခုလျှင် TB/s များစွာဖြင့် Exascale Storage ကို ကိုးကားသည်။ နှစ်ခုစလုံးသည် အောက်ဖော်ပြပါ claims tracker တွင်ရှိသည်။ ဝယ်ယူသူများအတွက် လက်တွေ့ကျသောသတိပေးချက်- Lightning သည် GA ဖြစ်သော်လည်း AI factory builds များတွင် scope လုပ်ထားပြီး စာဖတ်သူအများစုသည် standard quote တွင် မတွေ့ရပါ။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု-
- Dell သည် ၂၀၂၆ ခုနှစ် Gartner MQ အတွက် Enterprise Storage တွင် ၎င်း၏ ဦးဆောင်သူနေရာကို ရယူထားသည် (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- ObjectScale သည် 2U တွင် 245TB Kioxia SSD များနှင့် RDMA မှတစ်ဆင့် S3 ဖြင့် 9.83PB အထိ ရောက်ရှိခဲ့သည် (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- Dell သည် IDC ၏ ထိပ်တန်းကုမ္ပဏီငါးခုပေါင်းထက် ပထမသုံးလပတ် external storage တွင် အရောင်းရဆုံးဖြစ်ခဲ့သည်။ (ဇူလိုင် 2026)
- PowerStore Gen 3 reset အတွင်းပိုင်း (မေ 2026)
- PowerStoreOS 5.0 ကို နက်နက်ရှိုင်းရှိုင်း လေ့လာခြင်း၊ Gen 3 ၏ ဆော့ဖ်ဝဲလ်တစ်ဝက်ကို ပြန်လည်သတ်မှတ်ခြင်း (စက်တင်ဘာ 2026)
- GTC 2026 မှာ Lightning File System နဲ့ Exascale Storage (မတ် ၁၅)
- ကျွန်ုပ်တို့လက်တွေ့စမ်းသပ်ထားတဲ့ storage-forward 2U တစ်ခုဖြစ်တဲ့ PowerEdge R5715 သုံးသပ်ချက် (မတ် ၁၅)
HPE
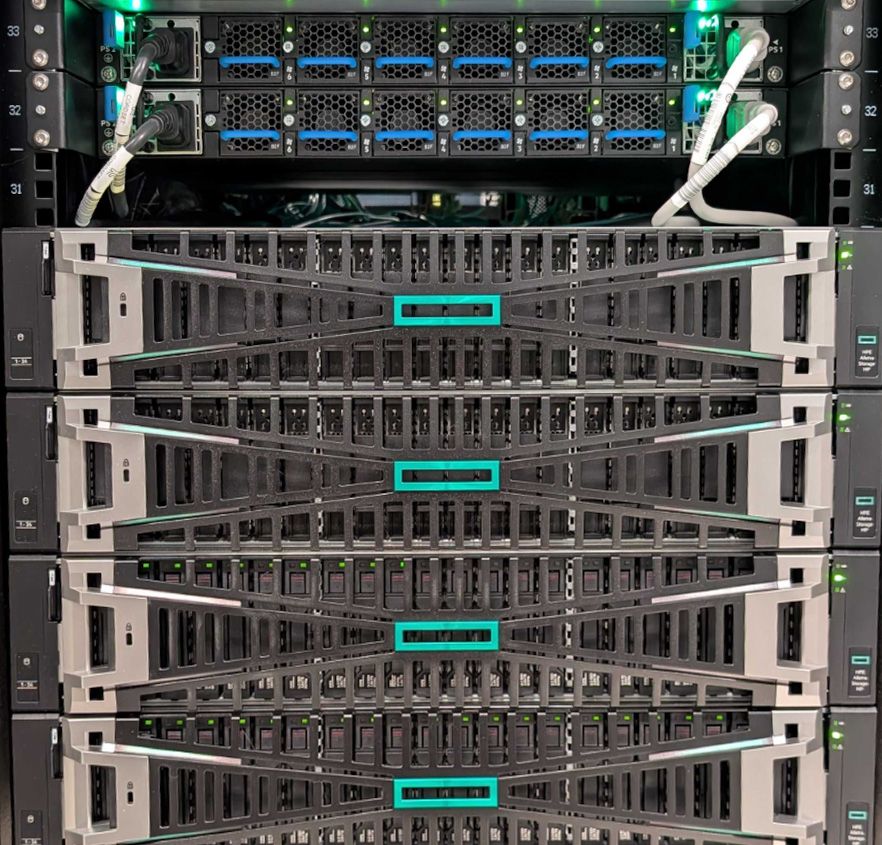
ပလက်ဖောင်း: Alletra Storage MP ကို block အတွက် B10000 နှင့် object အတွက် X10000 အဖြစ် ပိုင်းခြားထားပြီး File အတွက် GreenLake အဖြစ်လည်း ပိုင်းခြားထားသည်။ HPE သည် ၎င်း၏ AI သိုလှောင်မှုအများစုကို ဤနည်းအတိုင်း ပံ့ပိုးပေးသည့် compute နှင့် networking ကိုလည်း ရောင်းချသည်။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- HPE သည် full stack ကို ထောက်ပံ့ပေးသည့် Sovereign AI နှင့် AI factory build များ။ အထက်ဖော်ပြပါ VAST၊ WEKA သို့မဟုတ် DDN ဥပမာများနှင့် နှိုင်းယှဉ်နိုင်သော အမည်ပေးထားသော neocloud win မရှိပါ။
NVIDIA အတည်ပြုချက်- DGX BasePOD နှင့် SuperPOD အတည်ပြုချက်များပါရှိသော NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်။
စစ်ဆေးပြီးရလဒ်- HPE သည် MLPerf Storage round တိုင်းတွင် v1.0 မှ v3.0 အထိ ပါဝင်ခဲ့ပြီး Dell နှင့် NetApp တို့ထက် သာလွန်နေပါသည်။ ဖိုင်ဘက်ခြမ်းမှတ်တမ်းများကို ဂရုတစိုက်ဖတ်ရှုပါ- HPE ၏ အားအကောင်းဆုံး AI ဖိုင်ရလဒ်များသည် WEKA နှင့် ပူးတွဲတင်သွင်းမှုများမှတစ်ဆင့် ထွက်ပေါ်လာခဲ့ပြီး HPE သည် ၂၀၂၅ ခုနှစ် နိုဝင်ဘာလတွင် Qumulo နှင့် Scality တို့နှင့်အတူ ထိုမိတ်ဖက်မှုကို အဆုံးသတ်ခဲ့သည်။ ထိုရလဒ်များသည် HPE သည် ယနေ့ရောင်းချနိုင်သည့် ထုတ်ကုန်တစ်ခုကို မဖော်ပြတော့ပါ။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏လွှမ်းခြုံမှု- Alletra ပလက်ဖောင်းကို လက်တွေ့စမ်းသပ်ပြီးပါပြီ။
- HPE သည် 2026 Gartner MQ for Enterprise Storage တွင် ၎င်း၏ ဦးဆောင်သူနေရာကို ရယူထားသည် (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- Alletra Storage MP B10000 ကို NIST CSF 2.0 ဖြင့် ကျွန်ုပ်တို့၏ လက်တွေ့စမ်းသပ်မှု ဇွန်လ (၁၉၃၂)၊
- Data Protection Accelerator node ပါရှိသော Alletra Storage MP X10000 (ဖေဖော်ဝါရီ ၁၅)
- CloudCasa သည် B10000 အတွက် Kubernetes DR ကို ထည့်သွင်းထားသည် ဇွန်လ (၁၉၃၂)၊
- MLPerf Storage v3.0: K3000 ဖြင့် 3D U-Net တွင် 345.8 GiB/s၊ ဤစာမျက်နှာတွင် ဤအသုတ်ကို တင်သွင်းသည့် ရောင်းချသူနှစ်ဦးအနက် တစ်ခုဖြစ်သည်။
IBM က
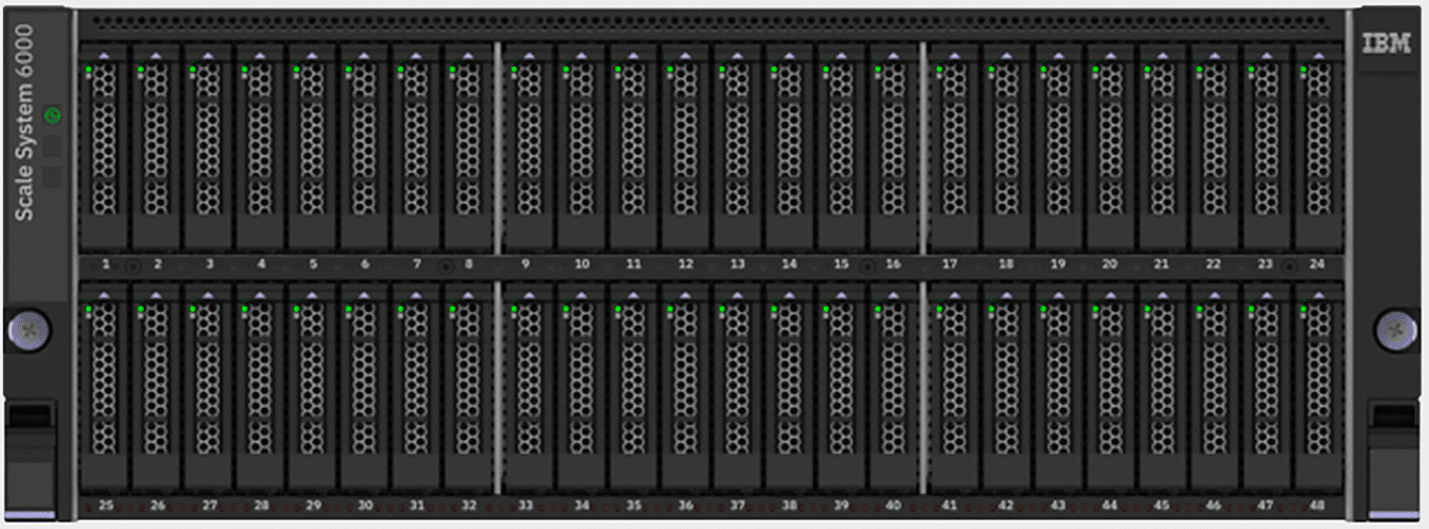
ပလက်ဖောင်း- GPFS မျိုးရိုးပါရှိသော parallel file system ဖြစ်သည့် IBM Storage Scale ကို software အဖြစ်နှင့် Storage Scale System appliances အဖြစ် ရောင်းချပြီး Kubernetes နှင့် AI pipelines များအတွက် Fusion packaging ဖြင့် ရောင်းချသည်။ FlashSystem သည် block ကို လွှမ်းခြုံထားပြီး ၂၀၂၆ ခုနှစ် အောက်တိုဘာလတွင် ကျွန်ုပ်တို့ ဖော်ပြခဲ့သော Oracle AI Database 26ai ၏ IBM နှင့် Broadcom validation တွင် 64G Fibre Channel ပေါ်ရှိ FlashSystem 9000-series array တစ်ခုတွင် OLTP ၏ဘေးတွင် vector search ကို လုပ်ဆောင်ခဲ့သည်။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- CoreWeave ရှိ multi-vendor stack ၏ အစိတ်အပိုင်း။ IBM Cloud သည် Together AI ဖြင့် ဒေါ်လာ ၂၄၀ သန်းတန် HGX B300 inference cluster တစ်ခုကိုလည်း တည်ဆောက်နေပြီး ၂၀၂၆ ခုနှစ် ဩဂုတ်လတွင် ကြေညာခဲ့သော်လည်း storage layer ကို ထုတ်ဖော်ပြောကြားခြင်း မရှိပါ။
NVIDIA အတည်ပြုချက်- NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်။
စစ်ဆေးပြီးရလဒ်- ဟုတ်ကဲ့၊ MLPerf Storage v2.0 မှာ checkpointing workload အပါအဝင် Storage Scale က Llama 3.1 1T မော်ဒယ်မှာ 656.7 GiB/s read ကို တင်ခဲ့ပါတယ်။ Checkpoint restore ဆိုတာ frontier training run ဘယ်လောက်ကျရှုံးလဲဆိုတာကို ဆုံးဖြတ်ပေးတဲ့ metric ဖြစ်ပြီး vendor အနည်းငယ်သာ ဒီအတွက် audited number ကို ထုတ်ပြန်ထားပါတယ်။
ပွင့်လင်းသောတောင်းဆိုမှုများ- အမြန်ဆုံး array အမျိုးအစားတွင် ထူးချွန်သောအရာမရှိပါ။ IBM သည် ခေါင်းစဉ် throughput မှတ်တမ်းထက် Storage Scale ကို စကေးနှင့် ပေါင်းစပ်မှုဖြင့် ဈေးကွက်တင်သည်။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု-
- IBM FlashSystem နှင့် Brocade Gen 8 Fibre Channel တွင် Oracle AI Database 26aivector search နှင့် OLTP ပါဝင်သော array တစ်ခုနှင့် ကျွန်ုပ်တို့၏ လုပ်ဆောင်မှုများတွင် 32G ပေါ်တွင် တစ်စက္ကန့်လျှင် 43.7 မှ 85.0 အထိ query များကို 64G မြှင့်တင်ပေးသည် (အောက်တိုဘာ ၂၀၂၆)
- IBM သည် ၂၀၂၆ ခုနှစ် Gartner MQ အတွက် Enterprise Storage တွင် ၎င်း၏ ဦးဆောင်သူနေရာကို ရယူထားသည် (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- IBM နှင့် Together AI တို့သည် သီးသန့် HGX B300 inference cluster တစ်ခုတွင် ဒေါ်လာ ၂၄၀ သန်း ရင်းနှီးမြှုပ်နှံခဲ့ကြသည်။ (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- RAG workloads များအတွက် Content-Aware Storage ကို IBM မှ မိတ်ဆက် (၂၀၁၆ Aprပြီလ)
- အေးဂျင့် AI ပါရှိသော နောက်မျိုးဆက် FlashSystem (ဖေဖော်ဝါရီ ၁၅)
- Storage Scale System 6000၊ AI နှင့် HPC အတွက် စုစည်းထားသော သိုလှောင်မှု (နိုဝင်ဘာ ၁၅)
- IBM ရဲ့ compact array နဲ့ ပိုကြီးတဲ့ စနစ်တွေရဲ့ လုပ်ဆောင်ချက်တွေအတွက် အသုံးဝင်တဲ့ အရသာတွေကို လက်တွေ့ကျကျ လေ့လာထားတဲ့ ကျွန်ုပ်တို့ရဲ့ IBM FlashSystem 5300 သုံးသပ်ချက် (စက်တင်ဘာ 2024)
Everpure (ယခင် Pure Storage)
ပလက်ဖောင်း: FlashBlade//EXA သည် AI entry ဖြစ်ပြီး metadata နှင့် data path များကို ပိုင်းခြားပေးသောကြောင့် data plane သည် သီးခြားစီ ချိန်ညှိနိုင်သည်။ FlashBlade//S နှင့် FlashArray တို့သည် ကျန်အပိုင်းများကို လွှမ်းခြုံထားသည်။ Everpure သည် အပြီးသတ် SSD များကို ဝယ်ယူမည့်အစား ၎င်း၏ကိုယ်ပိုင် DirectFlash Modules များကို တည်ဆောက်သောကြောင့် ၎င်း၏သိပ်သည်းဆနှင့် ခံနိုင်ရည်ရှိမှုကိန်းဂဏန်းများသည် ဈေးကွက်၏ ကျန်အပိုင်းများကို ခြေရာခံမထားပါ။ ကုမ္ပဏီသည် ၂၀၂၆ ခုနှစ် ဖေဖော်ဝါရီလ ၂၃ ရက်နေ့တွင် Everpure အဖြစ် တရားဝင်ဖြစ်လာခဲ့သည်။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- CoreWeave ရှိ multi-vendor stack ၏ အစိတ်အပိုင်းတစ်ခု။ FlashBlade//EXA တွင် အမည်ပေးထားသော AI လေ့ကျင့်ရေး ဖြန့်ကျက်မှုကို ကျွန်ုပ်တို့ အတိအကျ အတည်မပြုနိုင်ပါ။
NVIDIA အတည်ပြုချက်- NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်။
စစ်ဆေးပြီးရလဒ်- MLPerf Storage v3.0 (စက်တင်ဘာ ၂၀၂၆)၊ Everpure ၏ ပထမဆုံးတင်သွင်းမှု- FlashBlade//EXA data node ၃၀ တွင် 877.5 GiB/s checkpoint write နှင့် 833.0 GiB/s read ရရှိခဲ့ပြီး ၎င်းသည် round ၏ အကြီးဆုံး checkpoint နံပါတ်များအပြင် round ၏ အကြီးဆုံး KV cache ရလဒ်မှာ 1,623.4 GiB/s ဖြစ်သည်။ ၎င်းသည် ၂၀၂၆ ခုနှစ် ဖေဖော်ဝါရီလ ၁၇ ရက်နေ့တွင် ထုတ်ဝေခဲ့သော 6,300 AI Jobs ဖြင့် SPECstorage Solution 2020_ai_image မှတ်တမ်းကိုလည်း ပိုင်ဆိုင်ထားသည်။ benchmark ကွဲပြားသည်၊ workload model ကွဲပြားသည်၊ သို့သော် ၎င်းသည် ပြန်လည်သုံးသပ်ခြင်းလုပ်ငန်းစဉ်ပါရှိသော ထုတ်ဝေထားသော စည်းမျဉ်းတစ်ခုအောက်တွင် စစ်မှန်သောတင်သွင်းမှုတစ်ခုဖြစ်ပြီး အရေးပါပါသည်။
ပွင့်လင်းစွာပြောဆိုချက်များ- FlashBlade//EXA ကို လုပ်ငန်းနယ်ပယ်တွင် အမြင့်ဆုံးစွမ်းဆောင်ရည်ရှိသော ဒေတာသိုလှောင်မှုပလက်ဖောင်းအဖြစ် ဈေးကွက်တင်ထားပြီး single namespace တွင် 10 TB/s အထက် ခန့်မှန်းထားသော throughput ရှိသည်။ ခန့်မှန်းထားသည်၊ တိုင်းတာခြင်းမဟုတ်ပါ။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု-
- Everpure သည် ၂၀၂၆ Gartner MQ ၏ ကဏ္ဍနှစ်ခုလုံးတွင် နှစ်နှစ်ဆက်တိုက် ထိပ်ဆုံးမှ ရပ်တည်ခဲ့သည်။ (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- Everpure သည် Enterprise AI ပိုက်လိုင်းများအတွက် Data Stream ကို စတင်လိုက်ပါပြီ ဇွန်လ (၁၉၃၂)၊
- Data Intelligence နှင့် Enterprise Data Cloud မြှင့်တင်မှုများ ဇွန်လ (၁၉၃၂)၊
- Everpure XL130 R5 ပါရှိသော Emulex SecureHBA သည် AI benchmark မဟုတ်ဘဲ Everpure hardware ဖြင့် လက်တွေ့လုပ်ဆောင်ချိန်ဖြစ်သည်။ (မတ် ၁၅)
- MLPerf Storage v3.0 (စက်တင်ဘာ ၂၀၂၆): ပထမဆုံးတင်သွင်းမှု၊ 877.5 GiB/s checkpoint write နှင့် 833 GiB/s read၊ ပေါင်း 1,623 GiB/s KV Cache read ဖြစ်ပြီး၊ ၎င်းမှာ အချီတွင် အကြီးဆုံး checkpoint နှင့် inference နံပါတ်များ ဖြစ်သည်။ v3.0 အပြည့်အဝ အကျုံးဝင်မှု.
NetApp
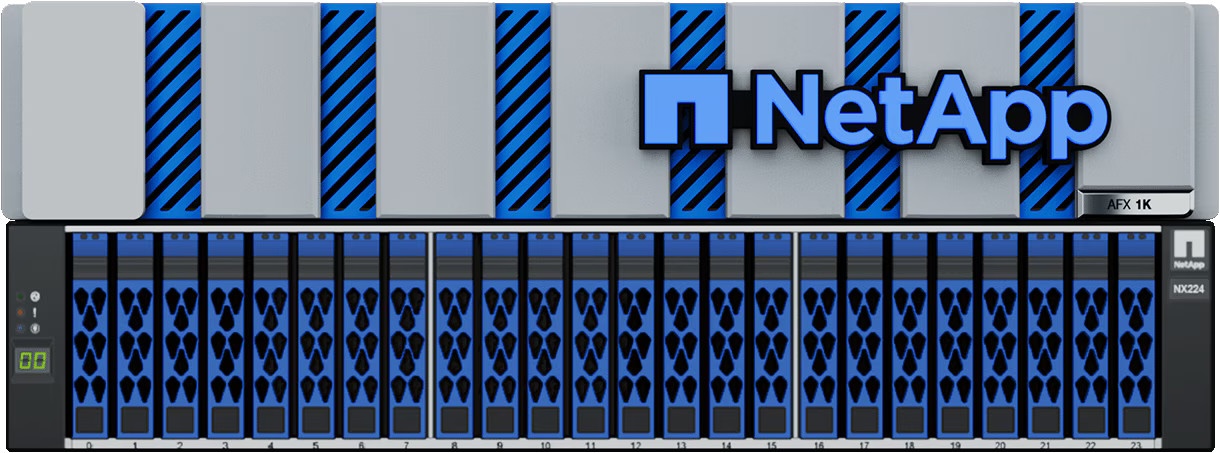
ပလက်ဖောင်း- ၂၀၂၅ ခုနှစ် အောက်တိုဘာလတွင် ကြေညာခဲ့သော AFX သည် AI data pipeline များအတွက် တည်ဆောက်ထားသော all-flash ONTAP ခွဲထားပြီး AI Data Engine ကို အပေါ်ဆုံးတွင် အလွှာဖြင့် ဖုံးအုပ်ထားသည်။ AIPod သည် NVIDIA မှ အတည်ပြုထားသော reference design ဖြစ်သည်။ INSIGHT 2026 တွင် ကြေညာခဲ့ပြီး ယခု မှာယူနိုင်ပြီဖြစ်သော Novus သည် AI factories များအတွက် AFX အထက်တွင် ရှိသည်- pNFS metadata သည် အရည်အချင်းပြည့်မီသော Supermicro server များပေါ်တွင် လည်ပတ်နေသော Data Director node များပေါ်သို့ ရွေ့လျားပြီး AFF A90 HA အတွဲများသည် data များကို သယ်ဆောင်ပြီး client များသည် GPU server များတွင် proprietary agent မရှိဘဲ stock Linux pNFS ဖြစ်သည်။
အမည်ပေးထားသော ဖြန့်ကျက်မှုများ- AI လေ့ကျင့်ရေးစကေးတွင် အတည်ပြုနိုင်သော မရှိပါ။ အခိုင်မာဆုံး အများပြည်သူဆိုင်ရာ လက်ရာများမှာ ၂၀၂၆ ခုနှစ် ဇွန်လမှ Cisco နှင့်အတူ FlexPod AI ဒီဇိုင်းများ အပါအဝင် ဖောက်သည်အမည်များထက် အတည်ပြုထားသော ဗိသုကာများဖြစ်သည်။
NVIDIA အတည်ပြုချက်- DGX SuperPOD အသိအမှတ်ပြုလက်မှတ်ဖြင့် NVIDIA-Certified Storage မိတ်ဆက်မိတ်ဖက်။
စစ်ဆေးပြီးရလဒ်- NetApp ဘယ်တုန်းကမှ ဝင်ရောက်ခဲ့ခြင်းမရှိပါ။ Novus နောက်ကွယ်တွင် NetApp သည် ONTAP cluster များသည် namespace တစ်ခုနှင့် ပူးပေါင်းသွားသောအခါ near-linear scaling ကိုပြသသည့် Omdia-audited စမ်းသပ်မှုကို ကိုးကားထားသည်။ 100 TB/s ခေါင်းစဉ်မှာ ထိုစမ်းသပ်မှုမှ Omdia ၏ မော်ဒယ်လ်ဖြစ်ပြီး တိုင်းတာထားသောရလဒ်မဟုတ်ပါ။
ပြီးခဲ့သည့်နှစ်က ကျွန်ုပ်တို့၏ လွှမ်းခြုံမှု-
- Novus သည် pNFS metadata ကို AFF A90 data node များမှ ခွဲထုတ်ပြီး 100 TB/s ကို ပစ်မှတ်ထားသည် (အောက်တိုဘာ ၁၅)
- NetApp သည် ၂၀၂၆ ခုနှစ် Gartner MQ for Enterprise Storage တွင် ၎င်း၏ ဦးဆောင်သူနေရာကို ရရှိထားသည်။ (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- HCLTech သည် သုံးစွဲမှုအခြေခံ AI သိုလှောင်မှုအတွက် Keystone ကို U4X နှင့် တွဲဖက်ပေးသည် (၂၀၂၁ ခုနှစ်၊ ဩဂုတ်လ)
- NetApp သည် GPU ဒေတာလုပ်ဆောင်ခြင်းအတွက် DataPelago ကိုဝယ်ယူသည် (ဇူလိုင် 2026)
- StorageGRID 12.1 မှာ federated namespace တစ်ခုနဲ့ 12 TB/s အထိ data တွေကို သိမ်းဆည်းနိုင်စေမှာ ဖြစ်ပါတယ်။ ဇွန်လ (၁၉၃၂)၊
- FlexPod သည် Cisco ဖြင့် AI ဗိသုကာများကို အတည်ပြုခဲ့သည် ဇွန်လ (၁၉၃၂)၊
- AFX စတင်ရောင်းချခြင်း (အောက်တိုဘာ ၁၅)
Huawei အကြောင်း မှတ်ချက်
Huawei သည် MLPerf Storage v2.0 တွင် အမြင့်ဆုံး absolute throughput 698 GiB/s ကို 8U dual-node OceanStor A800 မှ 3D U-Net တွင် 255 simulated H100s များကို ကျွေးမွေးပြီး အောက်ပါစာရင်းစစ်ထားသောဇယားတွင် ဖော်ပြထားသည်။ အမေရိကန်၊ ဥရောပ သို့မဟုတ် ဤစာမျက်နှာမှ ဝန်ဆောင်မှုပေးသော ဈေးကွက်အများစုရှိ ဝယ်သူများအတွက် လက်တွေ့ကျသော ဝယ်ယူမှုမဟုတ်သောကြောင့် ၎င်းကို ဦးဆောင်သူပရိုဖိုင်များမှ ကျွန်ုပ်တို့ မဖော်ပြပါ။ ကိန်းဂဏန်းမှာ အမှန်တကယ်ဖြစ်ပြီး ရရှိနိုင်မှုမှာ မဟုတ်ပါ။ 2026 Gartner Magic Quadrant သည် အခြားဘက်မှ တူညီသောဟန်ချက်ညီမှုကို ရောက်ရှိခဲ့ပြီး မြောက်အမေရိကပြင်ပရှိ OceanStor ၏ အားသာချက်ဖြင့် Huawei ကို ဦးဆောင်သူ quadrant တွင် ထိန်းသိမ်းထားနိုင်ခဲ့သည်။
လေ့လာသူတွေက ဘာပြောလဲ။
ခွဲခြမ်းစိတ်ဖြာသူနေရာချထားမှုသည် ၎င်း၏ကိုယ်ပိုင်အထောက်အထားအတန်းအစားဖြစ်သည်- စာရင်းစစ်ထားသော စံနှုန်းမဟုတ်ဘဲ အကောင်အထည်ဖော်မှုနှင့် ရူပါရုံကို လွတ်လပ်သော အကဲဖြတ်ချက်တစ်ခုဖြစ်ပြီး ဤစနစ်များကို မည်သို့ဝယ်ယူသည်နှင့် ပိုမိုနီးစပ်သည်။ ၂၀၂၆ ခုနှစ် Gartner Magic Quadrant for Enterprise Storage Platforms တွင် ၊ ရောင်းချသူခြောက်ဦးသည် ယမန်နှစ်ကကဲ့သို့ ခေါင်းဆောင်များ quadrant ကို ပိုင်ဆိုင်ထားသည်- Everpure၊ Huawei၊ HPE၊ NetApp၊ Dell နှင့် IBM တို့ဖြစ်ပြီး Everpure သည် အကောင်အထည်ဖော်နိုင်စွမ်းတွင် အမြင့်ဆုံးဖြစ်ပြီး ရူပါရုံ၏ ပြီးပြည့်စုံမှုတွင် နှစ်နှစ်ဆက်တိုက် အမြင့်မားဆုံးဖြစ်သည်။
ဤစာမျက်နှာအတွက် နယ်ပယ်အလိုက် မှတ်စုနှစ်ခုသည် အရေးကြီးပါသည်- Gartner သည် မူလသိုလှောင်မှုဈေးကွက်ကို အကဲဖြတ်ပြီး အထက်ဖော်ပြပါ AI-native ကျွမ်းကျင်သူများ နေထိုင်သည့် သီးခြားသုတေသနတွင် high-performance file နှင့် object crowd ကို ခြေရာခံသည်၊ ထို့ကြောင့် Quadrant မှ ၎င်းတို့မရှိခြင်းသည် အမျိုးအစားနယ်နိမိတ်တစ်ခုဖြစ်ပြီး ဆုံးဖြတ်ချက်မဟုတ်ပါ။ အကဲဖြတ်ထားသော ရောင်းချသူ ရှစ်ဦးတွင် ခြောက်ဦးသည် Leader label ရရှိသောအခါ label ကိုယ်တိုင်က ဝယ်ယူသူများကို အနည်းငယ်သာ ပြောပြပြီး relative positions များသည် အချက်ပြမှုကို သယ်ဆောင်သည်။
ဒီစာရင်းကို ဘာက ပြောင်းလဲစေမှာလဲ။
အချက်လေးချက်ကတော့ ကျွန်တော်တို့ ဘယ်လောက်အလေးချိန်ပေးမလဲဆိုတာ အစီအစဉ်အတိုင်းပါ။ ရောင်းချသူတစ်ဦးက ကျွန်ုပ်တို့ကိုယ်တိုင် host လုပ်နိုင်တဲ့ hardware ဖြစ်စေ၊ ပိုကြီးတဲ့ deployment ကို ဝင်ရောက်ခွင့်ပေးတာဖြစ်စေ ကျွန်ုပ်တို့ရဲ့ methodology အောက်မှာ သူ့ရဲ့ platform ကို စမ်းသပ်ဖို့ access ပေးပါတယ်။ ရောင်းချသူတစ်ဦးက လက်ရှိ audit လုပ်ထားတဲ့ round ဖြစ်တဲ့ MLPerf Storage ဒါမှမဟုတ် SPECstorage ကို submit လုပ်ပါတယ်။ ရောင်းချသူတစ်ဦးအစား operator တစ်ဦးဟာ Meta Hammerspace နဲ့ လုပ်ခဲ့သလို deployment ကို မှတ်တမ်းတင်ပါတယ်။ ဒါမှမဟုတ် ရောင်းချသူတစ်ဦးက သူ့ရဲ့ လက်ရှိ positioning ပေါ်မူတည်ပြီး WEKA နဲ့ HPE ခွဲဝေမှုက ကုမ္ပဏီနှစ်ခုလုံး AI ဝယ်သူတွေဆီ ဘယ်လိုရောက်ရှိသလဲဆိုတာကို ပြောင်းလဲစေခဲ့တဲ့ သတ်မှတ်ချက် ဒါမှမဟုတ် partnership ကို ဆုံးရှုံးသွားပါတယ်။ အဲဒါတွေဖြစ်လာတာနဲ့အမျှ profile တွေကို အပ်ဒိတ်လုပ်ပါတယ်။
စာရင်းစစ်ဆေးပြီးသော စံနှုန်းများက ပြသသည့်အရာ
AI လေ့ကျင့်ရေးနှင့် ၎င်းကို ဝန်ဆောင်မှုပေးသော neocloud ဝန်ဆောင်မှုပေးသူများသည် ၂၀၂၆ ခုနှစ်တွင် သိုလှောင်မှုစွမ်းဆောင်ရည်ပြိုင်ပွဲကို ကျင်းပနေပြီး ၎င်းသည် ကျန်းမာသောစာရင်းစစ်ထားသော benchmark ရှိသည့် တစ်ခုတည်းသော segment ဖြစ်သည်- MLCommons MLPerf Storage။ လက်ရှိထုတ်ဝေထားသော round သည် v3.0 (စက်တင်ဘာ ၂၀၂၆) ဖြစ်ပြီး တင်သွင်းသည့်အဖွဲ့အစည်း ၁၉ ခုနှင့် ရလဒ် ၁၄၃ ခုရှိသည်။ ပထမဆုံးအကြိမ်အဖြစ် benchmark သည် AI pipeline တစ်ခုလုံးကို လွှမ်းခြုံထားသည်- လေ့ကျင့်မှု throughput၊ checkpointing နှင့် inference စမ်းသပ်မှုအသစ်နှစ်ခု (Vector Database နှင့် KV Cache)၊ ထို့အပြင် တင်သွင်းမှု၏ ခြောက်ပုံတစ်ပုံခန့်ကို အသုံးပြုသည့် S3 object storage support။
v3.0 သည် ၎င်း၏ သရုပ်ဖော်ထားသော accelerator များကို H100 မှ B200 သို့ ရွှေ့ပြောင်းခဲ့သောကြောင့် ရလဒ်များသည် အစောပိုင်းအဆင့်များနှင့် နှိုင်းယှဉ်၍မရပါ။ MLPerf Storage သည် အနိုင်ရသူတစ်ဦးတည်းကို မရွေးချယ်ပါ။ စနစ်အမျိုးမျိုးသည် မတူညီသော workloads နှင့် metrics များကို ဦးဆောင်ကြသည်။
| စံနစ် | စစ်ဆေးပြီးသော ရလဒ် (MLPerf Storage v3.0) | class |
|---|---|---|
| Everpure FlashBlade//EXA | ဒေတာနုတ် ၃၀ တွင် ၈၇၇.၅ GiB/s စစ်ဆေးရေးဂိတ် ရေးသားမှုနှင့် ၈၃၃ GiB/s ဖတ်ရှုမှု၊ ၁,၆၂၃ GiB/s KV Cache ဖတ်ရှုမှု | စစ်ဆေးရေးဂိတ်နှင့် ကောက်ချက်ချသူ |
| YanRongTech F9000X | 3D U-Net တွင် 543.9 GiB/s ဖြင့် 99 simulated B200 accelerators များ ကျွေးမွေးခြင်း | အမြင့်ဆုံး လေ့ကျင့်မှု throughput ကို တင်သွင်းခဲ့သည် |
| TuringData F9200 | သိုလှောင်မှု node သုံးခုမှ 3D U-Net တွင် 541.5 GiB/s; Checkpoint-70B သည် 539.9 GiB/s ဖတ်ရှုမှုနှင့် 307.1 GiB/s ရေးသားမှုဖြင့် | စွမ်းဆောင်ရည်သိပ်သည်းဆအသစ် |
| Azure စီမံခန့်ခွဲထားသော Lustre | 4,096TiB စီမံခန့်ခွဲထားသော cloud ဖြန့်ကျက်မှုမှ 642.2 GiB/s checkpoint write | ပထမဆုံး hyperscale cloud ဝန်ဆောင်မှုကို တင်သွင်းခဲ့သည် |
| NVIDIA AI စတိုး | OCI၊ AWS နှင့် GCP တစ်လျှောက် S3 object storage မှတစ်ဆင့် တင်သွင်းမှု ၂၀ ခု | parallel-file-system နယ်မြေရှိ object storage |
HPC ဘက်တွင်၊ IO500 စာရင်း (ISC 2026 edition) ကို SCNet ရှိ Sugon ParaStor မှ ဦးဆောင်ပြီး client node ၅၀၀ တွင် တိုင်းတာထားသော bandwidth 26,888 GiB/s ဖြင့် Intel DAOS စနစ်များ (Argonne Aurora, LRZ) သည် ထိပ်တန်း slot များစွာကို ပိုင်ဆိုင်ထားပြီး Weka သည် Samsung SSC-24 မှတစ်ဆင့် ပေါ်လာသည်။ v3.0 လည်ပတ်မှုသည် ကိန်းဂဏန်းများကဲ့သို့ပင် သတင်းဖြစ်နိုင်သည်။ v2.0 throughput ဦးဆောင်သူများဖြစ်သော DDN၊ Huawei၊ Hammerspace နှင့် Lightbits အားလုံးသည် ဤအဆင့်တွင် ရှိနေခဲ့ပြီး ပထမဆုံးအကြိမ် တင်သွင်းသူ ၁၁ ဦး ပေါ်လာခဲ့ပြီး Azure နှင့် NVIDIA တို့လည်း ပါဝင်သည်။ ကျွန်ုပ်တို့၏ MLPerf Storage v3.0 လွှမ်းခြုံ မှုတွင် အပြည့်အစုံ ခွဲခြမ်းစိတ်ဖြာထားသည် ။
Neocloud တွေကို ဘယ်သူက စွမ်းအားပေးသလဲ
ဖြန့်ကျက်မှုအောင်မြင်မှုများသည် စံနှုန်းများမဟုတ်သော်လည်း စွမ်းဆောင်ရည်သည် ၎င်းတို့၏လုပ်ငန်းဖြစ်သည့်အခါ အော်ပရေတာများ ဝယ်ယူသည့်အရာ၏ တကယ့်သက်သေအထောက်အထားများဖြစ်သည်။ အကြီးဆုံး AI စက်ရုံများသည် multi-vendor များဖြစ်ကြောင်း သတိပြုပါ။ မည်သည့်သိုလှောင်မှုကုမ္ပဏီမျှ ဤနေရာများကို လုံးဝပိုင်ဆိုင်ခြင်းမရှိပါ။
| AI တိမ်တိုက် | သိုလှောင်ခြင်း | အသေးစိတ် |
|---|---|---|
| CoreWeave | VAST Data (ထပ်ထည့်ရင် stack ထဲမှာ WEKA၊ DDN၊ IBM Storage Scale၊ Everpure တွေပါပါတယ်) | ဒေါ်လာ ၁.၁၇ ဘီလီယံတန် နှစ်ရှည်သဘောတူညီချက်၊ ၂၀၂၅ ခုနှစ်၊ နိုဝင်ဘာလ၊ VAST ၏ အကြီးဆုံးဖောက်သည် |
| xAI ကော်လိုဆပ်စ် | Frontier AI Factory တိုးချဲ့မှုတွင် VAST Data ထည့်သွင်းထားသော DDN EXAScaler နှင့် Infinia | DDN သည် ၂၀၂၄ ခုနှစ် နိုဝင်ဘာလတွင် GPU ၁၀၀K ဖြင့် ကြေညာခဲ့ပြီး ၂၀၂၅ ခုနှစ်နှောင်းပိုင်းတွင် multi-vendor အဖြစ် ကြေငြာခဲ့သည်။ |
| Nebius | WEKA NeuralMesh | Nebius AI Cloud ၏ ပရီမီယံအဆင့်၊ ၂၀၂၅ ခုနှစ် ဇွန်လတွင် ကြေညာခဲ့သည် |
| AI နဲ့ အတူတူ | IBM Cloud (HGX B300 စနစ်များ) | ဒေါ်လာ သန်း ၂၄၀ တန် သဘောတူညီချက်ကို ၂၀၂၆ ခုနှစ် ဩဂုတ်လတွင် ကြေညာခဲ့သော်လည်း သိုလှောင်မှုအလွှာကို မဖော်ပြရသေးပါ။ |
တောင်းဆိုချက်များ ခြေရာခံကိရိယာ
၎င်းတို့သည် AI သိုလှောင်မှုကဏ္ဍတွင် လက်ရှိ "အမြန်ဆုံး" တောင်းဆိုချက်များဖြစ်သည်။ တောင်းဆိုထားသော စကေးတွင် မည်သည့်အရာကိုမျှ လွတ်လပ်စွာ အတည်ပြုထားခြင်း မရှိပါ။ အများစုကို ၎င်းတို့၏ ရောင်းချသူများက အတွင်းပိုင်းစမ်းသပ်မှုအဖြစ် အောက်ခြေတွင် ဖော်ပြထားပြီး ဇယားတွင် အခိုင်မာဆုံးရင်းမြစ်မှာ ခန့်မှန်းခေါင်းစဉ်တစ်ခုနောက်ကွယ်မှ ခွဲခြမ်းစိတ်ဖြာသူ-စစ်ဆေးထားသော စမ်းသပ်မှုတစ်ခုဖြစ်သည်။
| ရောင်းချသူ တောင်းဆိုချက် | ဂဏန်း | status |
|---|---|---|
| Everpure FlashBlade//EXA၊ “စက်မှုလုပ်ငန်း၏ အမြင့်ဆုံးစွမ်းဆောင်ရည်ရှိသော ဒေတာသိုလှောင်မှုပလက်ဖောင်း” (မတ်လ ၂၀၂၅) | တစ်ခုတည်းသော namespace တွင် ခန့်မှန်းထားသော 10+ TB/s ဖတ်ရှုမှုများ | ရောင်းချသူ ခန့်မှန်းချက်၊ စာရင်းစစ်ထားသော တင်သွင်းမှု မရှိပါ |
| Dell Lightning File System၊ “ကမ္ဘာ့အမြန်ဆုံး parallel file system” (GA ဧပြီလ ၂၀၂၆) | Dell အတွင်းပိုင်း ခွဲခြမ်းစိတ်ဖြာမှုအပေါ် အခြေခံ၍ ရက်ခ်ယူနစ်တစ်ခုလျှင် 150 GB/s အထိ | ရောင်းချသူတောင်းဆိုချက်၊ စာရင်းစစ်ထားသော တင်ပြချက်မရှိပါ |
| Dell Exascale သိုလှောင်မှု (GTC 2026) | Rack တစ်ခုလျှင် 6 TB/s အထိ | ရောင်းချသူတောင်းဆိုချက်၊ စာရင်းစစ်ထားသော တင်ပြချက်မရှိပါ |
| Huawei မျိုးဆက်သစ် OceanStor Dorado (၂၀၂၄ ခုနှစ်၊ စက်တင်ဘာလ) | 0.03 ms latency တွင် 100 million IOPS spec-sheet အမြင့်ဆုံးပမာဏ | ရောင်းချသူသတ်မှတ်ချက်၊ Huawei မှ တာဝန်ပေးအပ်ထားသော Omdia စမ်းသပ်မှုသည် Oracle RAC workload တွင် 70 microseconds တွင် 2.58M IOPS ကို တိုင်းတာခဲ့ပြီး၊ spec-sheet အမြင့်ဆုံးပမာဏများအပေါ် အသုံးဝင်သော လက်တွေ့စစ်ဆေးမှုတစ်ခုဖြစ်သည်။ |
| WEKA၊ NeuralMesh 6 ပါသည့် WEKApod 3၊ single-rack exabyte claim (ဇူလိုင် ၂၀၂၆) | 1.1 EB နှင့် 10.2 TB/s တို့ကို rack တစ်ခုတည်းတွင် သိမ်းဆည်းထားသည် | ရောင်းချသူတောင်းဆိုချက်- WEKA သည် v1.0 တွင် MLPerf Storage သို့ နောက်ဆုံးတင်သွင်းခဲ့ပြီး v2.0 ကိုကျော်သွားသည် |
| Instinct မှာ VAST Data နဲ့ AMD၊ KV cache offload လုပ်ခြင်း (ဇူလိုင် ၂၀၂၆) | ပထမဆုံးတိုကင်သို့ ၉ ဆ ပိုမြန်သောအချိန် | ပူးတွဲရောင်းချသူစမ်းသပ်မှု၊ VAST သည် MLPerf Storage သို့ ဘယ်သောအခါမှ တင်သွင်းခဲ့ခြင်းမရှိပါ။ |
| NVIDIA Dynamo ဖြင့် DDN နှင့် Nebul၊ KV cache အရှိန်မြှင့်ခြင်း (ဇူလိုင် ၂၀၂၆) | ရောင်းချသူမှဖော်ပြထားသော ကောက်ချက်ချမှု အလုပ်ပမာဏများကို အရှိန်မြှင့်ခြင်း | ပါတနာ အတည်ပြုချက်၊ လွတ်လပ်သော စာရင်းစစ် မဟုတ်ပါ။ DDN တွင် လက်ရှိ MLPerf Storage v2.0 ရလဒ်များ ရှိသည် |
| NetApp Novus၊ “ကမ္ဘာပေါ်တွင် အမြန်ဆုံး သိုလှောင်မှု” (၂၀၂၆ ခုနှစ် အောက်တိုဘာလ) | pNFS namespace တစ်ခုတည်းတွင် အစဉ်လိုက်ဖတ်ရှုမှု 100 TB/s ခန့်မှန်းထားသည် | Omdia-audited near-linear scaling ကို cluster ငယ်တစ်ခုပေါ်တွင် ပြုလုပ်ခဲ့သည်။ 100 TB/s ကိန်းဂဏန်းသည် Omdia ၏ ထိုစမ်းသပ်မှုမှ ခန့်မှန်းချက်ဖြစ်ပြီး တိုင်းတာမှုမဟုတ်ပါ။ |
SPC-1 ဘာဖြစ်သွားတာလဲ။
SPC-1 သည် လုပ်ငန်းနယ်ပယ်၏ block-storage စံချိန်စံညွှန်းဖြစ်ပြီး ယခုအခါ တစ်ဝက်တစ်ပျက် ငြိမ်သက်နေသည်- အမေရိကန်ရောင်းချသူများသည် ၂၀၁၈ ခုနှစ်ဝန်းကျင်တွင် ၎င်းကို ထိရောက်စွာစွန့်လွှတ်ခဲ့ပြီး တရုတ်ရောင်းချသူများ လွှမ်းမိုးထားသော ဦးဆောင်သူစာရင်းကို ချန်ထားခဲ့သည်။ လက်ရှိလက်ခံထားသော စံချိန်သည် ကျယ်ကျယ်ပြန့်ပြန့်ကိုးကားထားသော Huawei ရလဒ်မဟုတ်ပါ။ ExponTech WDS V3 သည် SPC-1 IOPS ၂၇.၂ သန်း (၂၀၂၃ ခုနှစ် နိုဝင်ဘာလတွင် လက်ခံခဲ့သည်) ဖြင့် အမြင့်ဆုံးလက်ခံထားသော ရမှတ်ကို ရရှိထားပြီး Inspur ၂၃.၀ သန်းထက် သာလွန်ပြီး Huawei ၏ ၂၀၂၀ ခုနှစ်မှ ၂၁.၀ သန်းသည် ယခုအခါ စတုတ္ထနေရာတွင် ရှိနေသည်။ FlashNexus ၏ IOPS ၃၀.၀ သန်း မြင့်မားသော တင်သွင်းမှုကို ၂၀၂၅ ခုနှစ် ဖေဖော်ဝါရီလမှစ၍ ပြန်လည်သုံးသပ်ရာတွင် လက်မခံဘဲ ထားခဲ့ပြီး Storage Performance Council မှ မလက်ခံမချင်း မှတ်တမ်းအဖြစ် ကျွန်ုပ်တို့ မသတ်မှတ်ပါ။
ဤစာမျက်နှာ မည်သို့အလုပ်လုပ်သည်
ဤစာမျက်နှာကို စည်းမျဉ်းသုံးခုဖြင့် အုပ်ချုပ်ပြီး ပထမတစ်ခုမှာ နံပါတ်တိုင်းကို ၎င်း၏အထောက်အထားအတန်းအစားဖြင့် အညွှန်းတပ်ထားခြင်းဖြစ်သည်။ စစ်ဆေးပြီးသော တင်ပြချက်၊ ရောင်းချသူတောင်းဆိုချက် သို့မဟုတ် StorageReview တိုင်းတာခြင်း။ ဒုတိယအချက်မှာ လက်ရှိဒေတာကို ရယူ၍မရသော အကောင်းဆုံးအချက်များကို ကျွန်ုပ်တို့ ထပ်ခါတလဲလဲ မပြုလုပ်ပါ။ ဤစာမျက်နှာရှိ နာမည်ကြီး “အမြန်ဆုံး” တောင်းဆိုချက်များစွာသည် နှစ်ပေါင်းများစွာကြာပြီဖြစ်ပြီး ထိုအတိုင်း မှတ်သားထားသည်။ တတိယအချက်မှာ ဤစာမျက်နှာ၏ အတည်ပြုထားသောဘက်သို့ လမ်းကြောင်းသည် ရောင်းချသူမည်သူမဆိုအတွက် ဖွင့်လှစ်ထားသည်- MLPerf Storage သို့မဟုတ် IO500 သို့ တင်ပြပါ သို့မဟုတ် ကျွန်ုပ်တို့၏ စံနည်းလမ်းအောက်တွင် စမ်းသပ်ခွင့်ကို ကျွန်ုပ်တို့အား ပေးပါ။
ဤစာမျက်နှာတွင် AI နှင့် neocloud storage ကိုသာ ဖော်ပြထားသည်။ Mainstream enterprise block and file နှင့် SMB storage တို့သည် ၎င်းတို့၏ကိုယ်ပိုင်စာမျက်နှာများ ရရှိနေပြီး ဤနေရာတွင် ထည့်သွင်းထားခြင်း မရှိပါ။ သတင်းများ ရောက်ရှိလာသည်နှင့်အမျှ leader profile များကို အပ်ဒိတ်လုပ်ပြီး အသစ် audit လုပ်ထားသော round ထုတ်ဝေသည့်အခါ အပြည့်အဝ ပေးပို့ပါသည်။
အမြန်ဆုံးသိုလှောင်မှုဆိုင်ရာ FAQ
ကမ္ဘာပေါ်မှာ အမြန်ဆုံး storage array က ဘာလဲ။
အတည်ပြုထားသော အဖြေတစ်ခုတည်း မရှိဘဲ၊ ပေးသူတိုင်းသည် ရောင်းချသူတစ်ဦး၏ ကိုးကားချက်ဖြစ်သည်။ ၂၀၂၆ ခုနှစ် စက်တင်ဘာလအထိ စာရင်းစစ်ထားသော အချက်အလက်များအရ- Everpure ၏ FlashBlade//EXA သည် MLPerf Storage v3.0 ၏ အကြီးမားဆုံး စစ်ဆေးရေးဂိတ်နံပါတ်ကို 877.5 GiB/s ရေးသားမှုဖြင့် တင်ခဲ့ပြီး၊ YanRongTech ၏ F9000X သည် 543.9 GiB/s လေ့ကျင့်ရေး throughput ကို ဦးဆောင်ခဲ့ပြီး၊ Sugon ParaStor သည် IO500 bandwidth စာရင်းတွင် ထိပ်ဆုံးမှ ရပ်တည်ခဲ့ပြီး ExponTech သည် လက်ခံထားသော SPC-1 IOPS မှတ်တမ်းကို ပိုင်ဆိုင်ထားသည်။ Dell ၏ per-rack Exascale Storage ခန့်မှန်းချက်များ အပါအဝင် အကြီးမားဆုံး ပြောဆိုထားသော နံပါတ်များကို လွတ်လပ်စွာ အတည်မပြုရသေးပါ။
AI လေ့ကျင့်ရေးအတွက် အမြန်ဆုံးသိုလှောင်မှုက ဘယ်လောက်လဲ။
တစ်ခုတည်းသော audited AI storage benchmark ဖြစ်သည့် MLPerf Storage v3.0 ဖြင့် ဆုံးဖြတ်ရာတွင် training-throughput ဦးဆောင်သူများမှာ YanRongTech၊ TuringData နှင့် UBIX တို့ဖြစ်ပြီး cloud service များတွင် Everpure သည် checkpointing နှင့် KV cache inference တို့တွင် ဦးဆောင်ကာ Azure သည် ဦးဆောင်နေသည်။ အကြီးဆုံး AI operator များ deploy လုပ်သည့်အရာများအပေါ် မူတည်၍ ဆုံးဖြတ်ရာတွင် VAST၊ DDN နှင့် WEKA တို့သည် neocloud အနိုင်ရရှိမှုကို လွှမ်းမိုးထားသော်လည်း v3.0 သို့ တင်သွင်းခဲ့သော အထောက်အထားသုံးခုနှင့် အထောက်အထားနှစ်မျိုးလုံးသည် အထက်တွင် label လုပ်ထားသည်။
Enterprise array တွေရဲ့ လွတ်လပ်တဲ့ benchmark တွေက ဘာကြောင့် ဒီလောက်နည်းနေရတာလဲ။
အဘယ်ကြောင့်ဆိုသော် enterprise storage ရောင်းချသူအများစုသည် စာချုပ်အရ benchmark ရလဒ်များထုတ်ဝေခြင်းကို တားမြစ်ထားပြီး mainstream array ထုတ်လုပ်သူများသည် ၎င်းတို့တစ်ချိန်ကအသုံးပြုခဲ့သော အများပြည်သူဆိုင်ရာ benchmark များ၊ အထူးသဖြင့် SPC-1 ကို ၂၀၁၈ ခုနှစ်ဝန်းကျင်တွင် စွန့်လွှတ်ခဲ့ကြသောကြောင့်ဖြစ်သည်။ MLPerf Storage ပါဝင်မှုသည် ရောင်းချမှုလိုအပ်ချက်တစ်ခုဖြစ်လာသောကြောင့် AI ကို ဝန်ဆောင်မှုပေးသော ရောင်းချသူများသည် လမ်းကြောင်းကို တစ်စိတ်တစ်ပိုင်းပြောင်းပြန်လှန်လိုက်ကြသည်။ စာရင်းစစ်ထားသော ရလဒ်အသစ်များထုတ်ဝေသည်နှင့်အမျှ ဤစာမျက်နှာကို ကျွန်ုပ်တို့ အပ်ဒိတ်လုပ်ပါသည်။
array ဝယ်ယူမှုတွင် ကွမ်တမ်ခံနိုင်ရည်ရှိသော ကုဒ်ဝှက်ခြင်း ထည့်သွင်းစဉ်းစားသင့်ပါသလား။
စည်းမျဉ်းစည်းကမ်းသတ်မှတ်ထားသော စက်မှုလုပ်ငန်းများအတွက်၊ ဟုတ်ပါတယ်၊ နောက်ဆုံးရက်တွေက ထင်ထားတာထက် ပိုနီးကပ်လာပါပြီ။ NSA ရဲ့ CNSA 2.0 လမ်းညွှန်ချက်မှာ အမျိုးသားလုံခြုံရေးစနစ်အသစ်တပ်ဆင်မှုတွေဟာ ၂၀၂၇ ခုနှစ် ဇန်နဝါရီလမှာ လိုက်နာရမှာဖြစ်ပြီး၊ လိုက်နာမှုမရှိတဲ့ စနစ်တွေကို ၂၀၃၀ ခုနှစ်ကုန်မှာ ဖျက်သိမ်းရမှာဖြစ်သလို EU ရဲ့ NIS2 နဲ့ DORA မူဘောင်တွေမှာလည်း သူတို့ရဲ့ကိုယ်ပိုင် encryption လိုအပ်ချက်တွေ ရှိပါတယ်။
ပြီးစီးသွားသော FC-SP-3 စံနှုန်းသည် ၎င်းကို ပရောဂျက်တစ်ခုထက် ဝယ်ယူမှုအသေးစိတ်အချက်အလက်တစ်ခု ဖြစ်စေသည်- FC-SP-3-capable HBA များသည် post-quantum algorithms များဖြင့် line rate ဖြင့် flight ရှိ SAN traffic ကို encrypt လုပ်ပြီး၊ encryption သည် transport layer တွင် ဖြစ်ပေါ်သောကြောင့်၊ array သည် ransomware anomalies များအတွက် compress၊ deduplicate နှင့် scan လုပ်နိုင်သော data များကို လက်ခံရရှိနေဆဲဖြစ်ပြီး၊ services application-level encryption သည် ရှုံးနိမ့်စေသည်။ ပုံမှန် သုံးနှစ်မှ ငါးနှစ်အထိ refresh ဝယ်ယူမှုများတွင် FC-SP-3 ချိတ်ဆက်မှုကို သတ်မှတ်ခြင်းသည် ၂၀၃၀ ခုနှစ်တွင် အပြည့်အဝ encrypted SAN ကို ဘေးထွက်ထုတ်ကုန်အဖြစ် ပေးစွမ်းသည်။
ဟာ့ဒ်ဝဲဘက်ခြမ်းကတော့ အလယ်အလတ်တန်းစားအဆင့်မှာပဲ တင်ပို့နေပါပြီ- Dell PowerStore Gen 3 တိုင်းဟာ ဒီနေ့မှာ OCP slot တွေမှာ EDIF-capable Fibre Channel card တွေကို တပ်ဆင်ထားပြီး Dell က PowerStoreOS 5.1 software update ကို အနှောင့်အယှက်မဖြစ်စေဖို့အတွက် wire encryption ကို ထည့်သွင်းထားပါတယ်။ ဒါကို PowerStoreOS 5.0 deep dive မှာ ဖော်ပြထားပါတယ် ။ Broadcom က ဒီနေ့ Fibre Channel မှာ နှစ်ဖက်စလုံးကို တင်ပို့နေပါပြီ- Emulex 64G SecureHBAs တွေကို flight မှာ encrypt လုပ်ထားပြီး Brocade Gen 8 switch တွေကိုတော့ IBM FlashSystem နဲ့ Oracle AI Database 26ai မှာ ဖော်ပြထားတဲ့ post-quantum cryptography နဲ့ တည်ဆောက်ထားပါတယ် ။ ကျွန်ုပ်တို့ရဲ့ FC-SP-3 deep dive မှာ standard၊ deadline နဲ့ deployment model တွေကို လွှမ်းခြုံထားပါတယ်။


 အမေဇုံ