

Intel Arc Pro B70 ဟာ Intel ထုတ်လုပ်ခဲ့တဲ့ deskside AI card တွေထဲမှာ စွမ်းဆောင်ရည်အမြင့်ဆုံးနဲ့ အလားအလာအရှိဆုံး ကတ်ဖြစ်ပေမယ့် တစ်ခါတစ်ရံမှာ စိတ်ပျက်စရာအကောင်းဆုံးလည်း ဖြစ်ပါတယ်။ Intel က ဒီနှစ် မတ်လမှာ စတင်ရောင်းချချိန်မှာ 32GB GDDR6 အတွက် စာရင်းဈေးနှုန်းကို ဒေါ်လာ ၉၄၉ သတ်မှတ်ထားပါတယ်။ ဒါပေမယ့် ဈေးကွက်တစ်ခုလုံးကို ဖိနှိပ်ထားတဲ့ မှတ်ဉာဏ်အကျပ်အတည်းကြောင့် ဒီသုံးသပ်ချက်အရ လမ်းဘေးဈေးတွေကို ဒေါ်လာ ၁၁၀၀ ကျော်အထိ မြင့်တက်စေခဲ့ပါတယ်။ အဲဒီတုန်းကတောင် B70 ဟာ NVIDIA ရဲ့ RTX Pro 4000 ထက် ဈေးပိုမြင့်ပြီး 24GB ပေးဆောင်ထားပေမယ့် ဒေါ်လာ ၂၀၀၀ ကျော်အထိ မြင့်တက်ခဲ့ပါတယ်။ B70 လေးခုဟာ workstation ဒါမှမဟုတ် server တစ်ခုတည်းမှာ 128GB pooled VRAM အတွက် လုံလောက်ပြီး အရင်က ကုန်ကျစရိတ်ပိုများတဲ့ ကျွမ်းကျင်သူ ၁၂၀ ဘီလီယံ မော်ဒယ်တွေကို တစ်ပြိုင်နက်တည်း လက်ခံအသုံးပြုနိုင်ပါတယ်။ ဟာ့ဒ်ဝဲက အထင်ကြီးစရာကောင်းပြီး ဈေးနှုန်းကလည်း ပိုမြင့်ပါတယ်။ ပြီးခဲ့တဲ့ ဒီဇင်ဘာလက ကျွန်တော်တို့ ကြိုတင်ကြည့်ရှုခဲ့တဲ့ B60 ကို တားဆီးထားတဲ့ ပြဿနာပါပဲ။ ဆော့ဖ်ဝဲလ်က မရှိသေးဘဲ Intel က အဲဒီကို ရောက်နိုင်ပါ့မလားဆိုတာ ကျွန်တော်တို့ တွေးနေရပါတယ်။
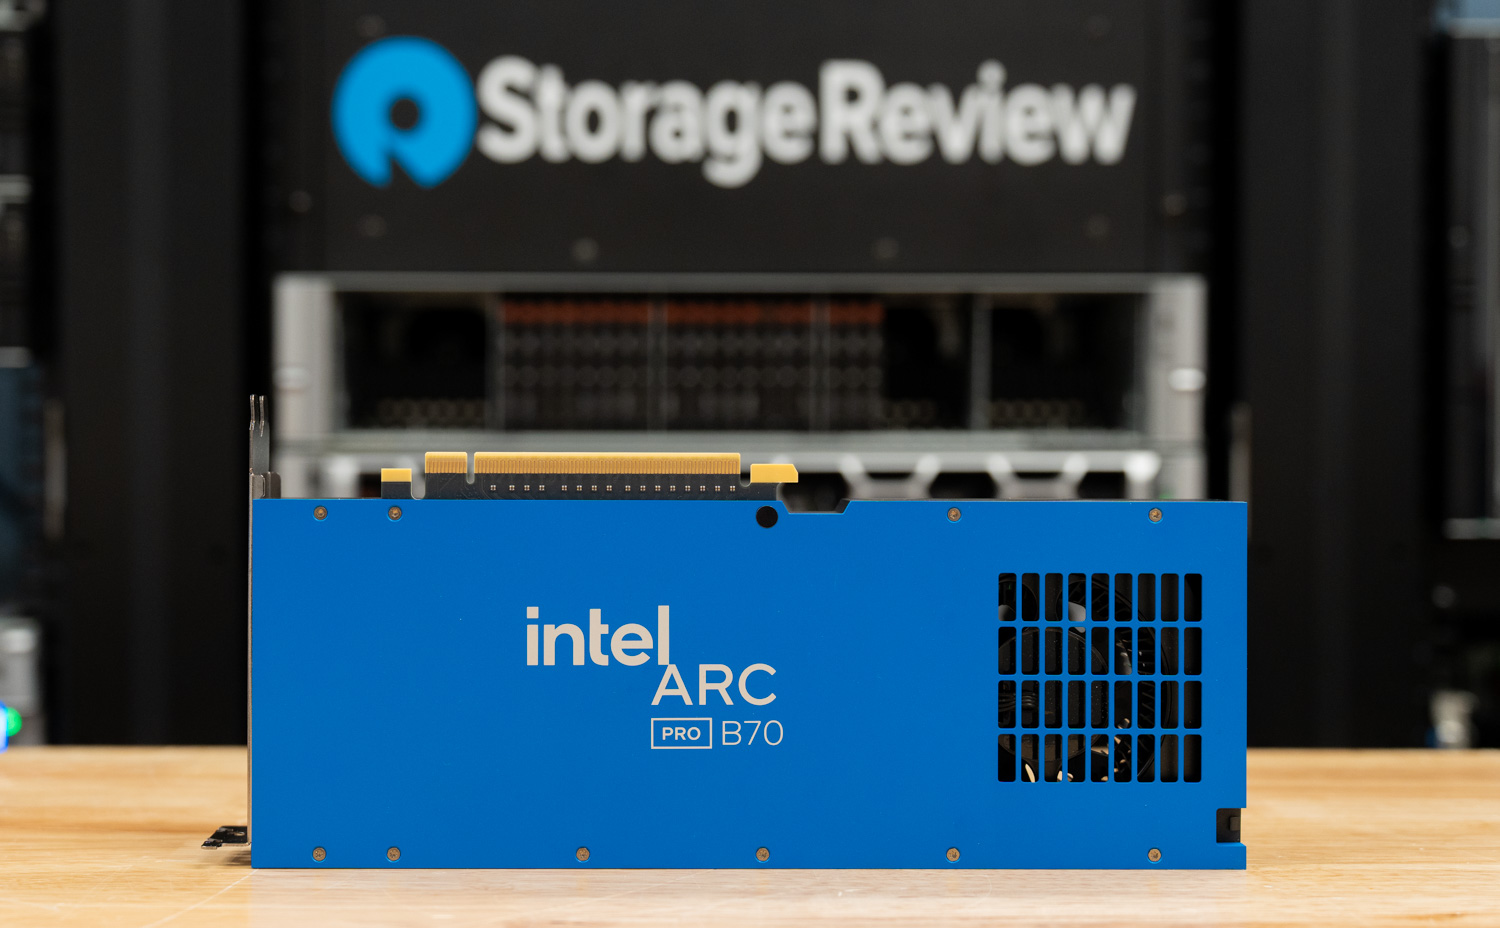
Intel နဲ့ ကျွန်တော်တို့ တစ်ခါထက်ပိုပြီး ကြုံဖူးပါတယ်။ Arc Pro B60 Battlematrix ကို ကြည့်တဲ့အခါ pre-release stack မှာ စောင့်မျှော်နေတဲ့ ဇာတ်လမ်းက အရမ်းကောင်းပြီး B70 က တစ်ဝက်စီကို အမွေဆက်ခံထားပါတယ်။ ဒီကတ်ကို 32 Xe2 cores၊ 256 XMX engines နဲ့ 367 INT8 TOPS ပါတဲ့ ပိုကြီးတဲ့ BMG-G31 die ပေါ်မှာ တည်ဆောက်ထားပါတယ်။ 608 GB/s မှာ 256-bit bus ကနေ ထောက်ပံ့ပေးထားပြီး 160W မှ 290W အထိ configure လုပ်နိုင်ပါတယ်။ B60 နဲ့ ယှဉ်ရင် Intel က workstation workloads တွေမှာ ပျမ်းမျှအားဖြင့် 44% နဲ့ professional applications တွေမှာ 69% အထိ generational gain ကို ပေးထားပါတယ်။ ကြိုတင်သိထားသင့်တဲ့ deployment wrinkle တစ်ခုကတော့ B60 ကို slot x8/x8 ခွဲထားတဲ့ dual-GPU ကတ်တွေအနေနဲ့ တင်ပို့ရောင်းချပေမယ့် B70 ကတော့ ကတ်တစ်ခုလျှင် GPU တစ်ခုဖြစ်ပြီး PCIe 5.0 x16 lane အပြည့်လိုအပ်ပြီး ကတ်လေးခုပါ chassis မှာ ဘယ်လိုထည့်သွင်းရမလဲဆိုတာ ပြောင်းလဲစေပါတယ်။
Intel ရဲ့ ဈေးကွက်ရှာဖွေရေးဟာ ဒေသတွင်း ကောက်ချက်ချမှုကို အပြည့်အဝ မှီခိုနေပြီး NVIDIA ရဲ့ RTX Pro 4000 24GB နဲ့ နှိုင်းယှဉ်ကြည့်နိုင်ပါတယ်။ Intel ရဲ့ Linux ကိန်းဂဏန်းတွေအရ B70 ရဲ့ 32GB ဟာ မန်မိုရီမကုန်ခင် RTX Pro 4000 ရဲ့ 42K နဲ့ ယှဉ်ရင် KV-cache tokens 93K ခန့်ကို သိမ်းဆည်းထားပြီး၊ တစ်ချိန်တည်းမှာ အသုံးပြုသူတွေ တိုးလာတာနဲ့အမျှ token throughput 85% အထိ ပိုများလာပါတယ်၊ load အောက်မှာ ပထမဆုံး token ကို ရရှိချိန်မှာ 6.2 ဆ အထိ ပိုမြန်တဲ့ အဖြေတွေ ပေးစွမ်းနိုင်ပြီး တစ်ဒေါ်လာကို token ၂ ဆ အထိ ပေးစွမ်းနိုင်ပါတယ်။ ဒါတွေက Intel ရဲ့ single-card ကိန်းဂဏန်းတွေဖြစ်ပြီး BF16 မှာရှိတဲ့ Llama 3.1 8B အသေးလေးပေါ်မှာ တွက်ချက်ထားတာပါ။ B70 တွေကို နည်းနည်းပိုကြိုးစားပြီး လုပ်ဆောင်သွားပါမယ်။ tokens-per-dollar တောင်းဆိုချက်မှာ launch list ဈေးနှုန်းတွေကို အသုံးပြုထားပါတယ်။ လက်ရှိဈေးနှုန်းအရ Intel ဘက်က ကွာဟချက်က ထိန်းထားနိုင်သလို ကျယ်လာပါတယ်။
benchmark တွေဆီ မရောက်ခင်မှာ အဲဒီ trade-off က အရေးကြီးပါတယ်။ ဘာလို့လဲဆိုတော့ ဒီနေ့ ဒီကတ်ကို ဘယ်သူဝယ်သင့်လဲဆိုတာကို ဆုံးဖြတ်ပေးလို့ပါ။ Battlemage-enabled vLLM ရဲ့ development branch ဖြစ်တဲ့ Intel ရဲ့ LLM Scaler ဟာ အကောင်းဆုံးအနေနဲ့ beta release ပဲ ရှိပါသေးတယ်။ Model coverage က အကန့်အသတ်ရှိပါတယ်။ အလုပ်လုပ်သင့်တဲ့ quantization path အတော်များများက အလုပ်လုပ်မှာ မဟုတ်သေးပါဘူး။ stack က hardware လုပ်နိုင်တာကို ကန့်သတ်ထားပါတယ်။ Dell PowerEdge XE7740 မှာရှိတဲ့ Intel Gaudi 3 မှာလည်း အလားတူပြဿနာကို ကျွန်တော်တို့ တွေ့ခဲ့ရပါတယ် ။ soft FP8 ရလဒ်တွေက silicon ကို မဟုတ်ဘဲ Intel ရဲ့ vLLM fork မှာရှိတဲ့ immature code path တွေကို ခြေရာခံမိခဲ့ပါတယ်။ B70 ကလည်း အဲဒီနေရာမှာပဲ ရှိပါတယ်။ ဒီနေရာမှာ Intel အနေနဲ့ ဆုံးဖြတ်ချက်ချပြီး အခုချိန်ထိထက် ပိုပြီး ပြင်းပြင်းထန်ထန် လုပ်ဆောင်ရမယ့်နေရာပါ။
NVIDIA ရဲ့ အဓိကအချက်က CUDA တစ်ခုတည်း မဟုတ်ပါဘူး။ မော်ဒယ်တစ်ခုကို ဖြန့်ကျက်တဲ့အခါ အရေးကြီးတဲ့ ပျင်းစရာကောင်းတဲ့အရာတွေပါ- docs၊ ဥပမာများ၊ အလုပ်လုပ်တဲ့ containers၊ forum အဖြေများနဲ့ လုံလောက်တဲ့ community history တွေက ပြဿနာအများစုကို ဖြေရှင်းပြီးသွားပါပြီ။ AMD က ROCm ကို အဲဒီလမ်းကြောင်းအတိုင်း တွန်းအားပေးနေတာ ထင်ရှားပါတယ်။ Intel ကလည်း Arc Pro နဲ့ပတ်သက်ပြီး အလားတူ ကတိကဝတ်အဆင့် လိုအပ်ပါတယ်။ မဟုတ်ရင် B70 ဟာ ကတ်ဝါသနာရှင်တွေ နှစ်သက်ချင်ပေမယ့် အဖွဲ့တွေက လက်ခံကျင့်သုံးဖို့ ရုန်းကန်ရနိုင်ပါတယ်။
ဤသုံးသပ်ချက်အတွက်၊ ကျွန်ုပ်တို့သည် B60 လုပ်ဆောင်ချက်နှင့် တူညီသော platform ကို သန့်ရှင်းသော နှိုင်းယှဉ်မှုအတွက် ထားရှိခဲ့သည်- AMD EPYC 9374F ပရိုဆက်ဆာများနှင့် DDR5 512GB ပါရှိသော Supermicro AS-4125GS-TNRT၊ B70 လေးလုံး (128GB) ကို vLLM အောက်တွင် B60 လေးလုံး (96GB) နှင့် လည်ပတ်သည်။ B60 ကဲ့သို့ပင်၊ ၎င်းသည် Intel ၏ all-Intel Battlematrix ရည်ညွှန်းချက်မဟုတ်ပါ။ Intel silicon ပေါ်ရှိ ထုတ်လုပ်မှုစနစ်များသည် ကွဲပြားစွာ လုပ်ဆောင်နိုင်သည်။ နောက်ဆက်တွဲများကို software ရင့်ကျက်မှုနှင့်အတူ မျိုးဆက်တူနှင့် တန်ဖိုးစစ်ဆေးမှုအဖြစ် သဘောထားပြီး ရလဒ်တိုင်းကို သက်ရောက်မှုရှိသည်။
Intel Arc Pro B70 သတ်မှတ်ချက်များ
| specification | Intel Arc Pro B70 |
|---|---|
| ယေဘုယျ | |
| ကုန်ပစ္စည်းမိသားစု | Intel Arc Pro B-Series ဂရပ်ဖစ်များ |
| ပုံစံ | Intel Arc Pro B70 |
| ကုဒ်နာမည် | Battlemage |
| Microarchitecture ပါ | Xe2 |
| ဖြစ်စဉ်ကိုနည်းပညာ | TSMC N5 |
| launch နေ့စွဲ | Q1 2026 |
| အာမခံချက် | 3 နှစ်များ |
| GPU သတ်မှတ်ချက်များ | |
| Xe-Core များ | 32 |
| ပုံဖော်ခြင်း အပိုင်းများ | 8 |
| ဓာတ်မှန်ရိုက်ခြင်း ယူနစ်များ | 32 |
| Intel XMX အင်ဂျင်များ | 256 |
| Xe Vector အင်ဂျင်များ | 256 |
| ဂရပ်ဖစ်နာရီ | 2280 MHz |
| အမြင့်ဆုံး ဒိုင်းနမစ်နာရီ | 2800 MHz |
| FP32 စွမ်းဆောင်ရည် | 22.94 TFLOPS |
| INT8 AI စွမ်းဆောင်ရည် | 367 ထိပ် |
| စုစုပေါင်းဘုတ်အဖွဲ့ပါဝါ (TBP) | ၂၃၀ ဝပ် (ပြင်ဆင်သတ်မှတ်နိုင်သည်- ၁၆၀–၂၉၀ ဝပ်) |
| PCI Express Interface | PCIe 5.0 x16 |
| မှတ်ဉာဏ် | |
| မှတ်ဉာဏ်စွမ်းဆောင်ရည် | 32GB GDDR6 |
| မှတ်ဉာဏ်ဘတ်စ်ကား | 256-bit မှာ |
| မှတ်ဉာဏ် Bandwidth | 608 GB ကို / s နဲ့ |
| ECC မှတ်ဉာဏ် | ထောက်ပံ့ထား |
| မျက်နှာပြင်နှင့် အဝင်/အထွက် | |
| display ရလဒ်မျာ | DisplayPort 2.1 |
| အများဆုံးပြသမှုများ | 4 |
| အများဆုံး resolution ကို | 7680 × 4320 @ 120Hz (HDMI / DisplayPort) |
| variable Refresh Rate | HDMI VRR၊ VESA အလိုက်သင့် ချိန်ညှိမှု |
| အင်္ဂါရပ်များနှင့် ဆော့ဖ်ဝဲ | |
| ဗီဒီယို ကုဒ်ပြောင်းခြင်း/ကုဒ်ဖြည်ခြင်း | H.264၊ H.265 (HEVC)၊ AV1 |
| Ray tracing | ထောက်ပံ့ထား |
| AI မူဘောင်များ | oneAPI၊ OpenVINO၊ PyTorch အတွက် Intel Extension (IPEX) |
| ဂရပ်ဖစ် API များ | DirectX 12 Ultimate၊ Vulkan 1.3၊ OpenGL 4.6၊ OpenCL 3.0 |
| Intel XeSS | ထောက်ပံ့ထား |
| HDR အထောက်အပံ့ | HDR10၊ HDR10+ ဂိမ်းကစားခြင်း၊ Dolby Vision |
| ဖော်မတ်များစွာပါဝင်သော ကုဒ်ဒိတ်အင်ဂျင်များ | 2 |
| ရုပ်ပိုင်းဆိုင်ရာအသေးစိတ်ဖော်ပြချက် | |
| ရှုထောင့် | ၂ × ၂ လက်မ |
| slot အကျယ် | Dual Slot |
| အလေးချိန် | 1020g |
| Power က Connector | ၁ × ၈-ပင် (ATX ၂×၄) |
Intel Arc Pro B70 တည်ဆောက်ပုံနှင့် ဒီဇိုင်း
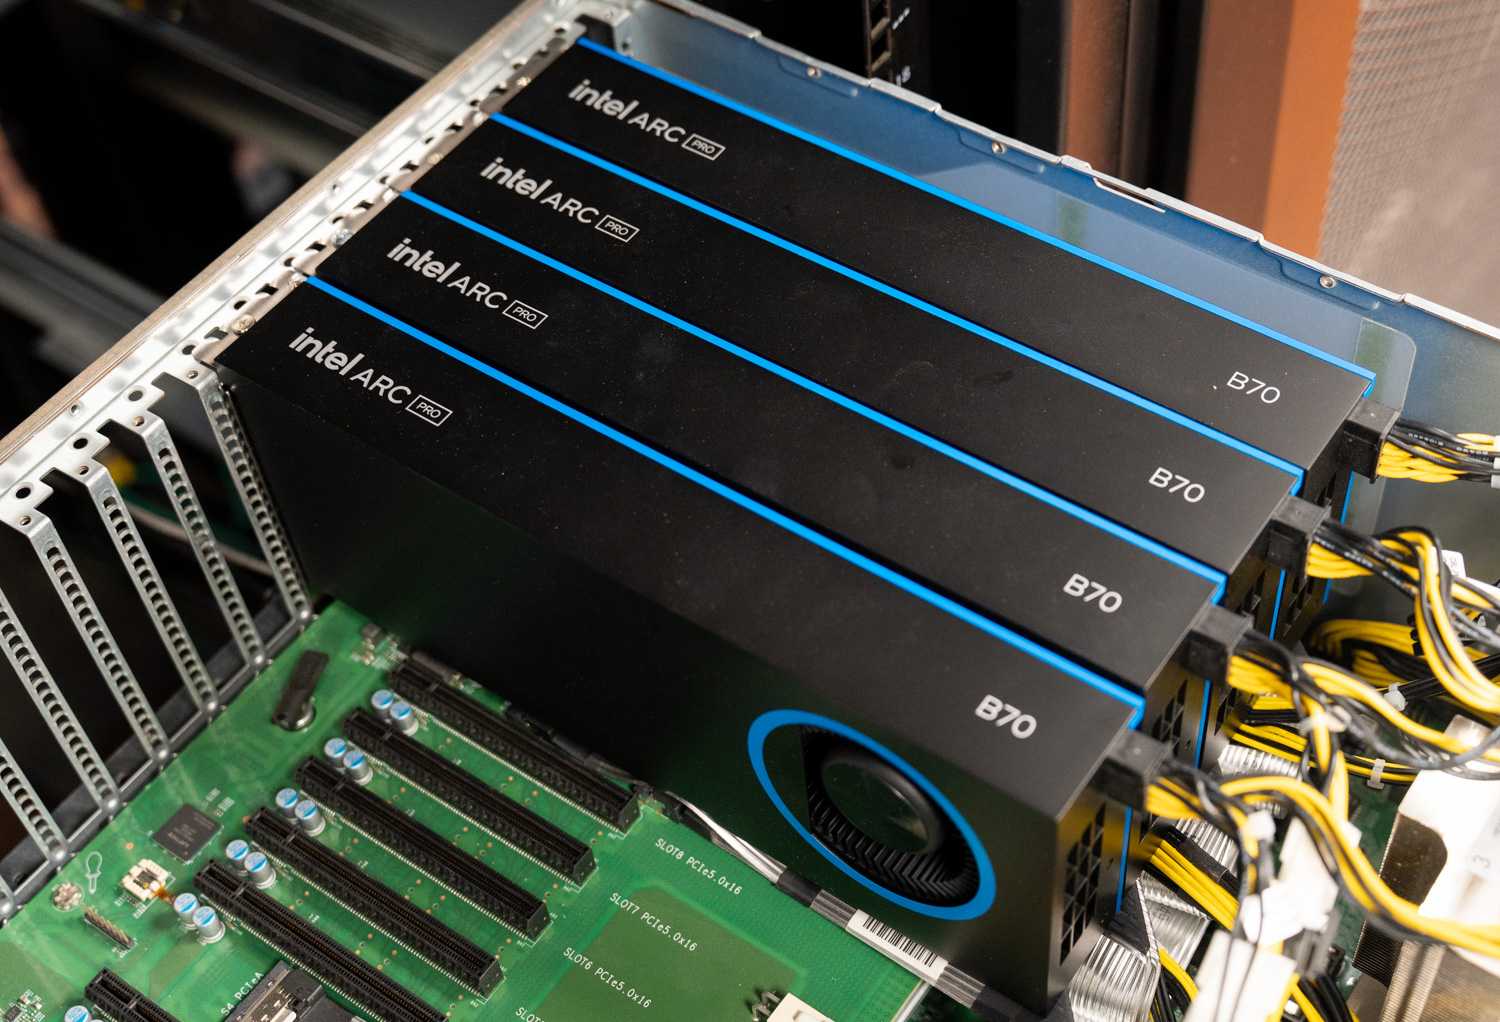
အရွယ်အစား ၁၀.၅ × ၃.၉ လက်မ (၂၆၇ × ၉၉ မီလီမီတာ) နှင့် အလေးချိန် ၂.၂၅ ပေါင်ရှိသော Intel Arc Pro B70 သည် သပ်ရပ်လှပသော အသွင်အပြင်ရှိသည့် ကျစ်လျစ်သော dual-slot ဒီဇိုင်းဖြင့် ပါရှိသည်။ ကတ်ကို Intel ၏ ထူးခြားသော အပြာရောင် အနားကွပ်များဖြင့် အဆုံးသတ်ထားပြီး မာကျောမှုကို ပေါင်းထည့်ပေးပြီး Intel ၏ အမှတ်တံဆိပ်နှင့် ကိုက်ညီသော full-length anodized aluminum backplate ပါဝင်သည်။
၎င်းတွင် လေမှုတ်စက်မှတစ်ဆင့် လေကိုဆွဲထုတ်ပြီး နောက်ဘက် I/O ကွင်းမှ တိုက်ရိုက်ထုတ်လွှတ်သည့် တစ်ခုတည်းသော လေမှုတ်ပန်ကာပါရှိသည်။ ဤပိတ်လှောင်ထားသော အအေးပေးဒီဇိုင်းသည် ကတ်၏ အရွယ်အစားကို ကျစ်လျစ်စေပြီး စနစ်တစ်လျှောက် သန့်ရှင်းသော လေစီးဆင်းမှုလမ်းကြောင်းကို ထိန်းသိမ်းပေးသည်။
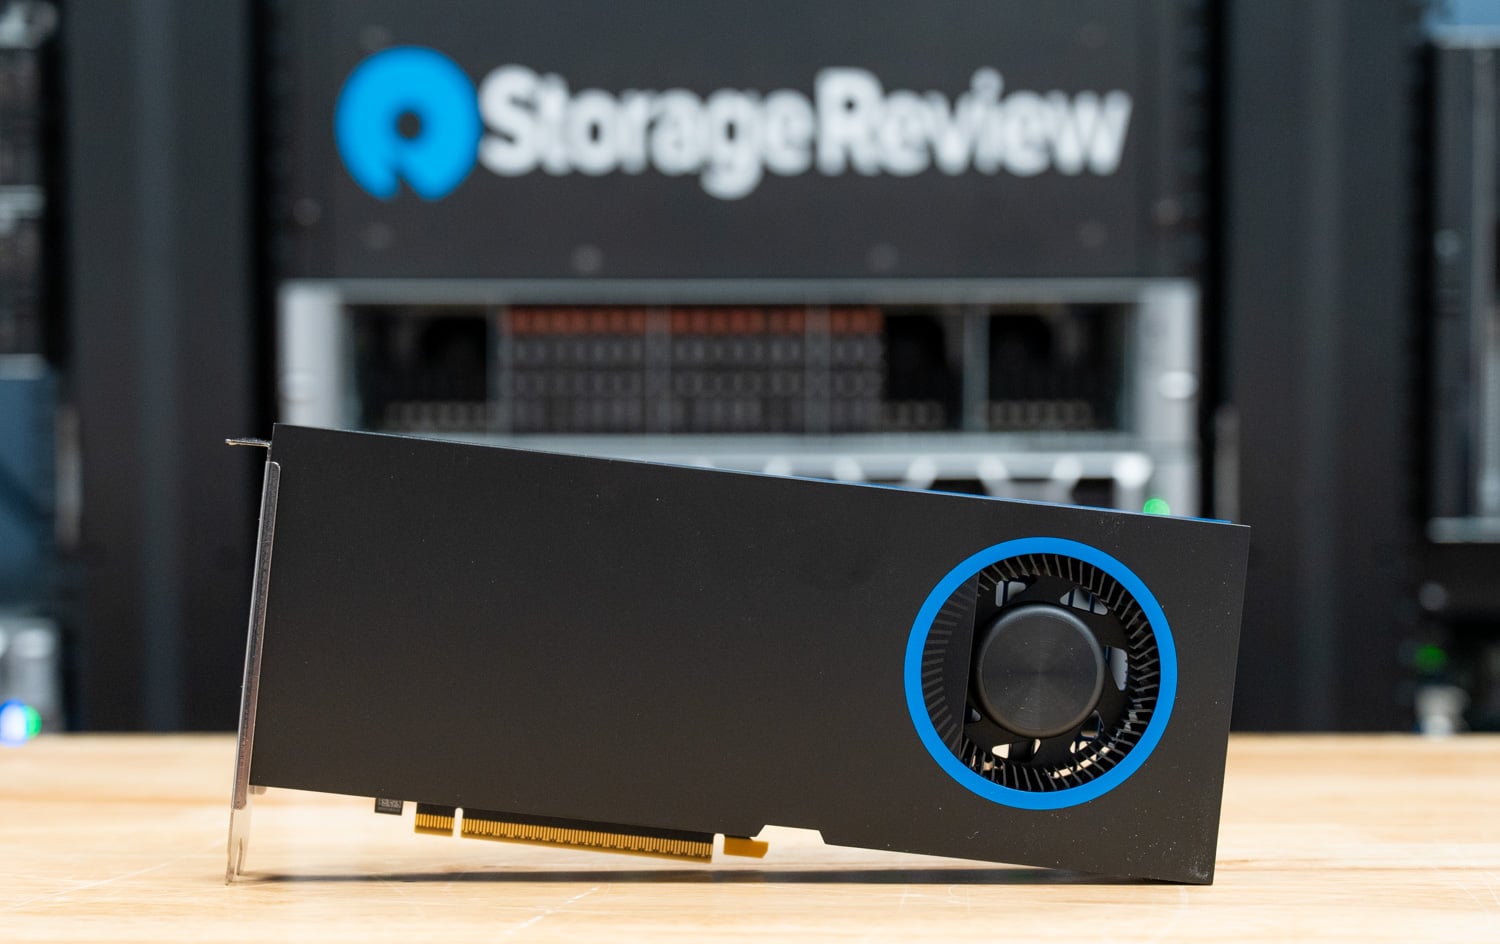
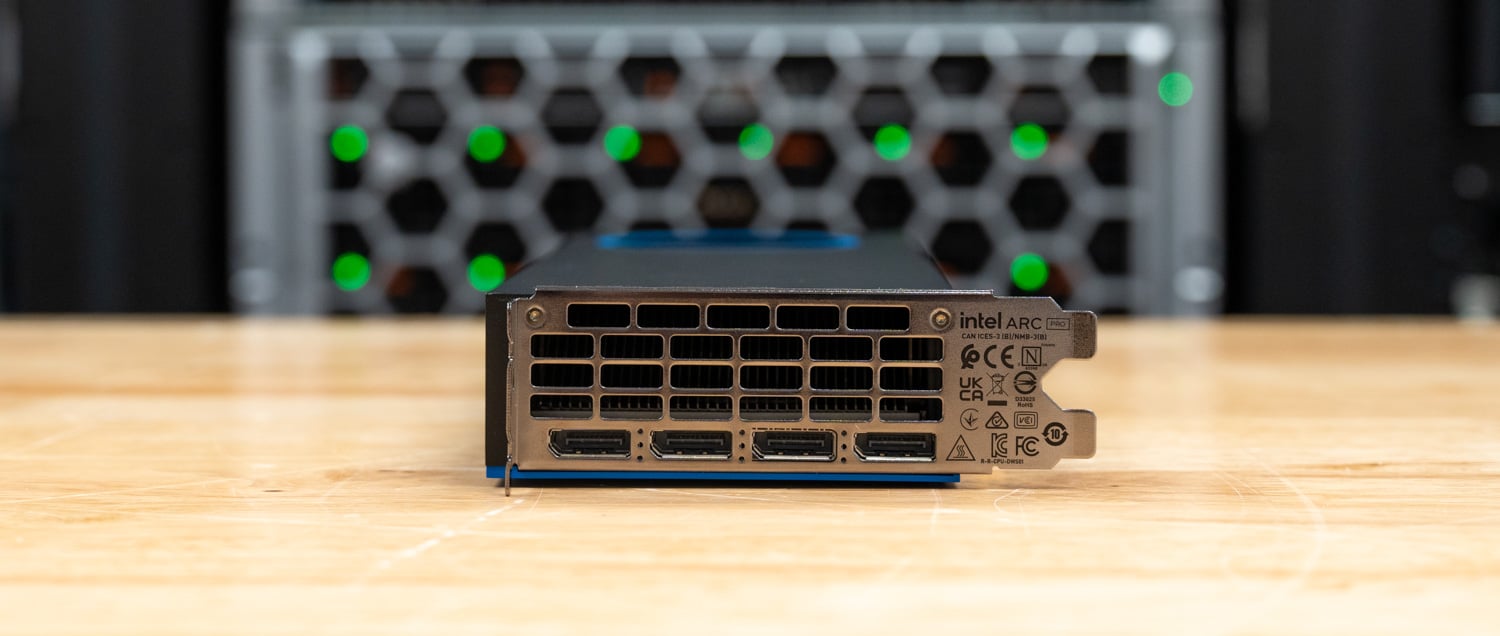
ကတ်ရဲ့နောက်ဘက်မှာ PCIe bracket ရဲ့တစ်ဖက်တစ်ချက်မှာ Intel က ပြင်ပပါဝါကိုထောက်ပံ့ပေးဖို့အတွက် single 8-pin (2×4) PCIe power connector ပါရှိပါတယ်။ ဒီ shroud ရဲ့အဆုံးမှာ blower fan ထဲကို လတ်ဆတ်တဲ့လေတွေထည့်ပေးတဲ့ intake opening တွေအပြင် workstation တွေမှာ တည်ငြိမ်မှုတိုးတက်စေဖို့ optional GPU support bracket တစ်ခုတပ်ဆင်ဖို့အတွက် threaded mounting point တွေလည်းပါရှိပါတယ်။
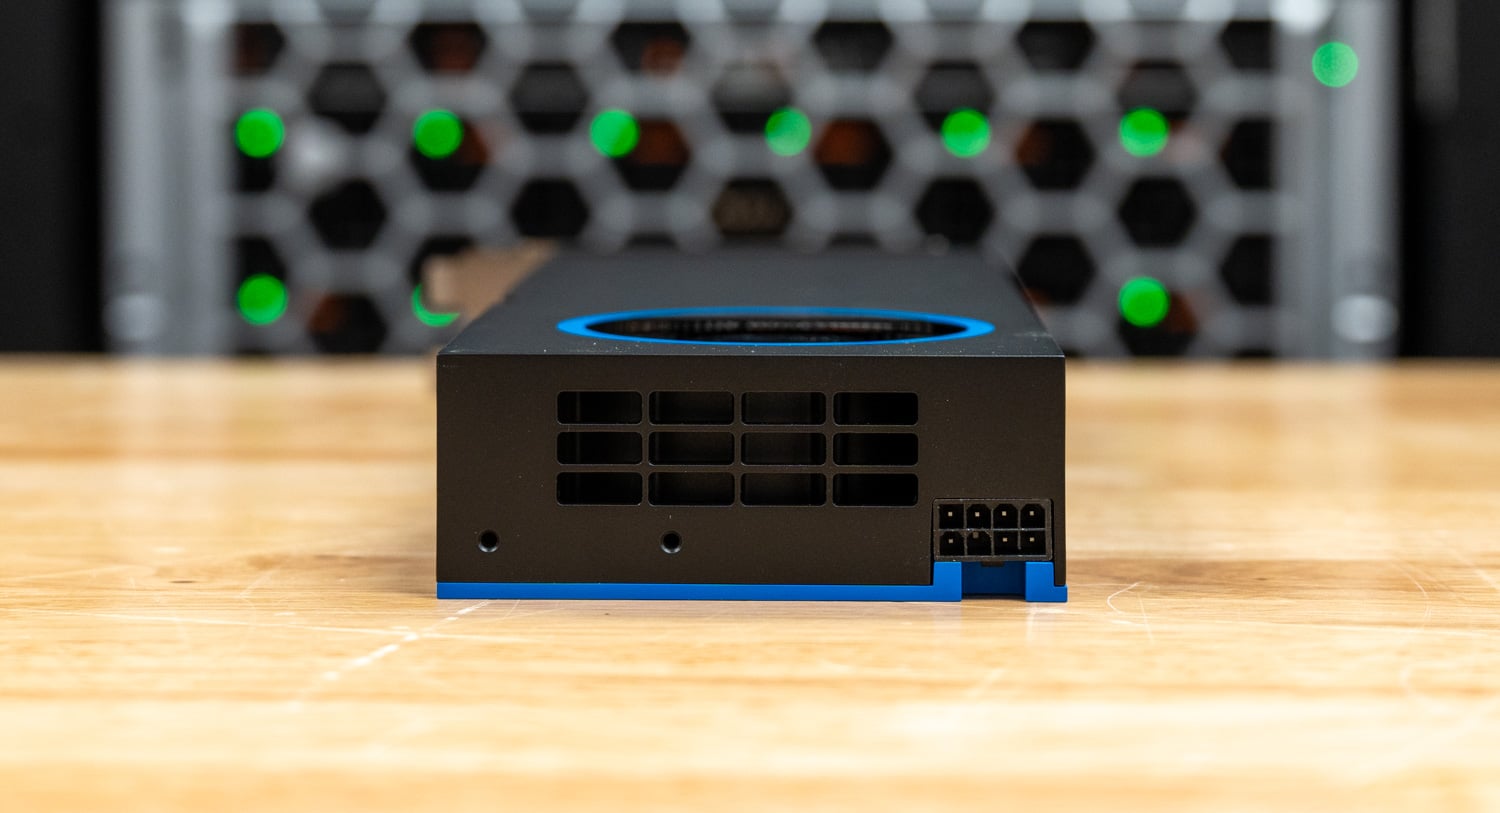
အောက်ခြေအနားတစ်လျှောက်တွင် Arc Pro B70 သည် host ချိတ်ဆက်မှုအတွက် စံ PCIe 5.0 x16 interface ကို အသုံးပြုသည်။ ဤထောင့်သည် ကတ်၏ dual-slot form factor ကိုလည်း မီးမောင်းထိုးပြသည်။ ၎င်းသည် blower cooling solution အတွက် လုံလောက်သောနေရာပေးစွမ်းပြီး ထူထပ်သော workstation နှင့် server တပ်ဆင်မှုများအတွက် လုံလောက်သော ကျစ်လစ်မှုရှိသည်။
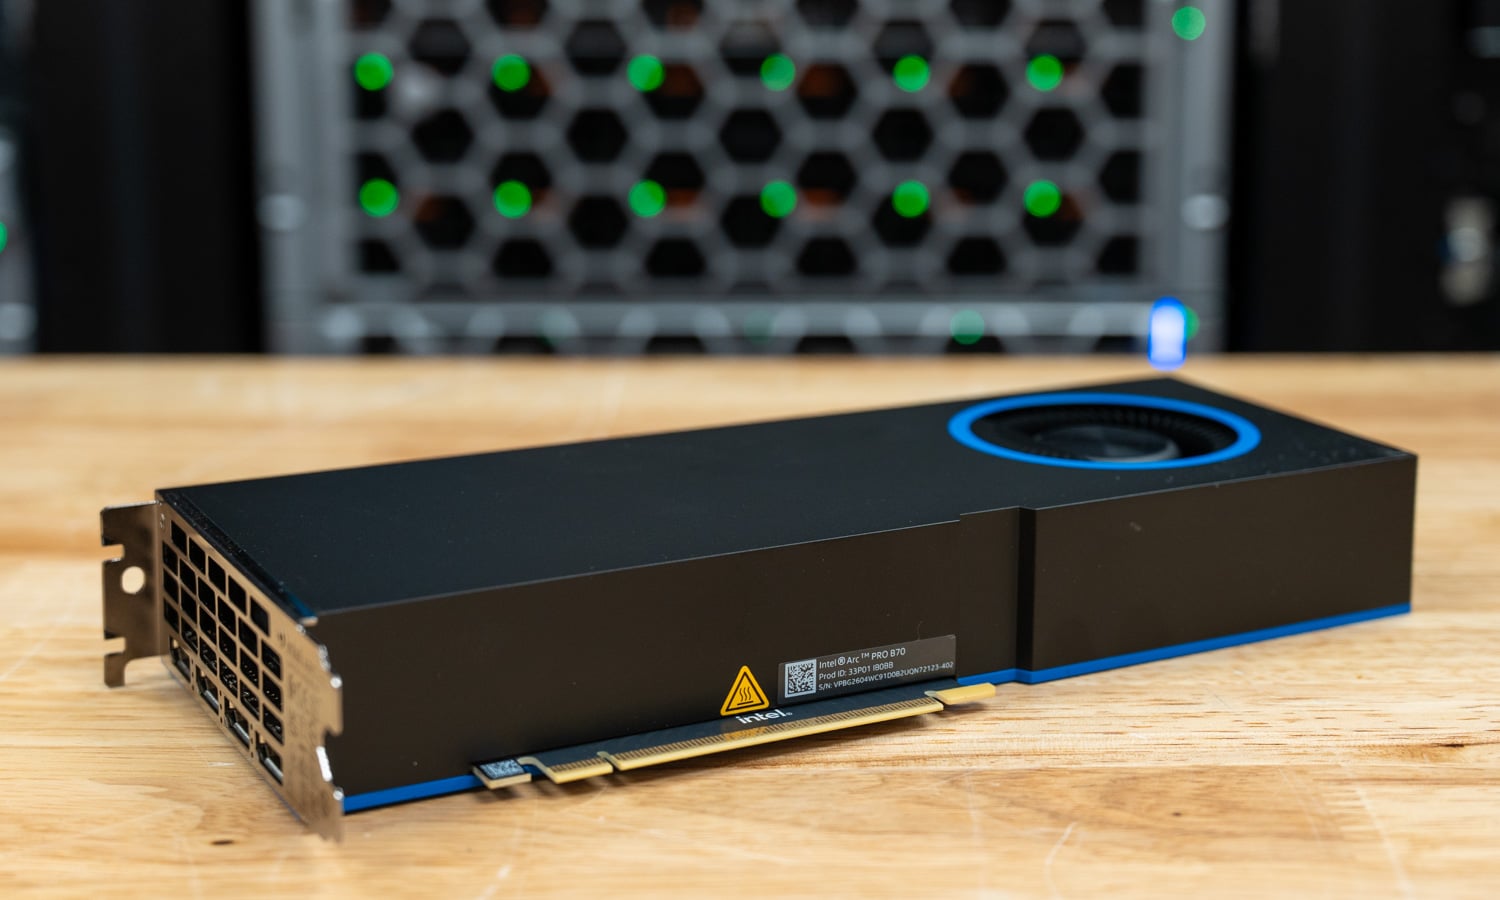
I/O bracket တွင် blower fan မှ chassis မှ ပူသောလေကို တိုက်ရိုက်ထုတ်လွှတ်နိုင်စေမည့် ကြီးမားသော exhaust ပါရှိသည်။ exhaust အောက်တွင် DisplayPort 2.1 output လေးခုရှိပြီး တစ်ခုချင်းစီသည် 120Hz တွင် 7680 × 4320 (8K) အထိ display များကို မောင်းနှင်နိုင်ပြီး resolution မြင့်မားသော multi-monitor workstation ပတ်ဝန်းကျင်များအတွက် bandwidth လုံလောက်စွာ ပေးစွမ်းနိုင်သည်။
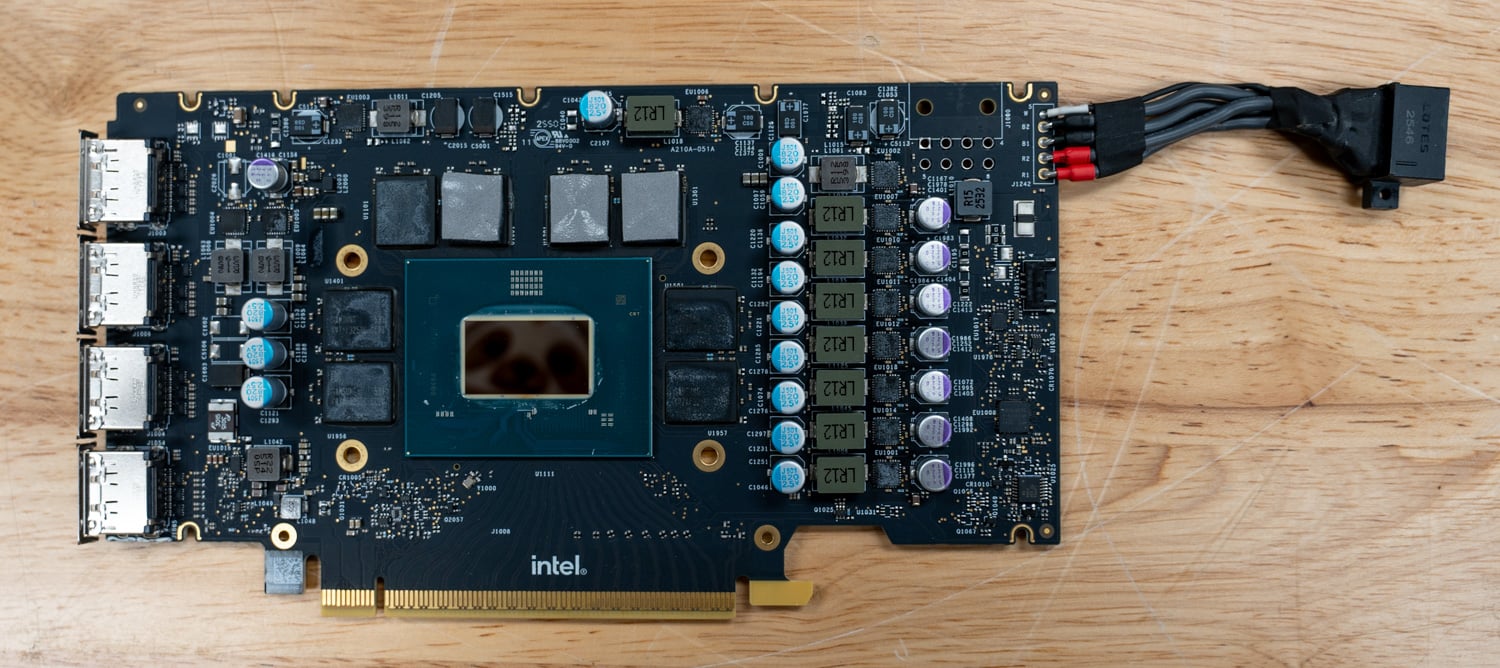
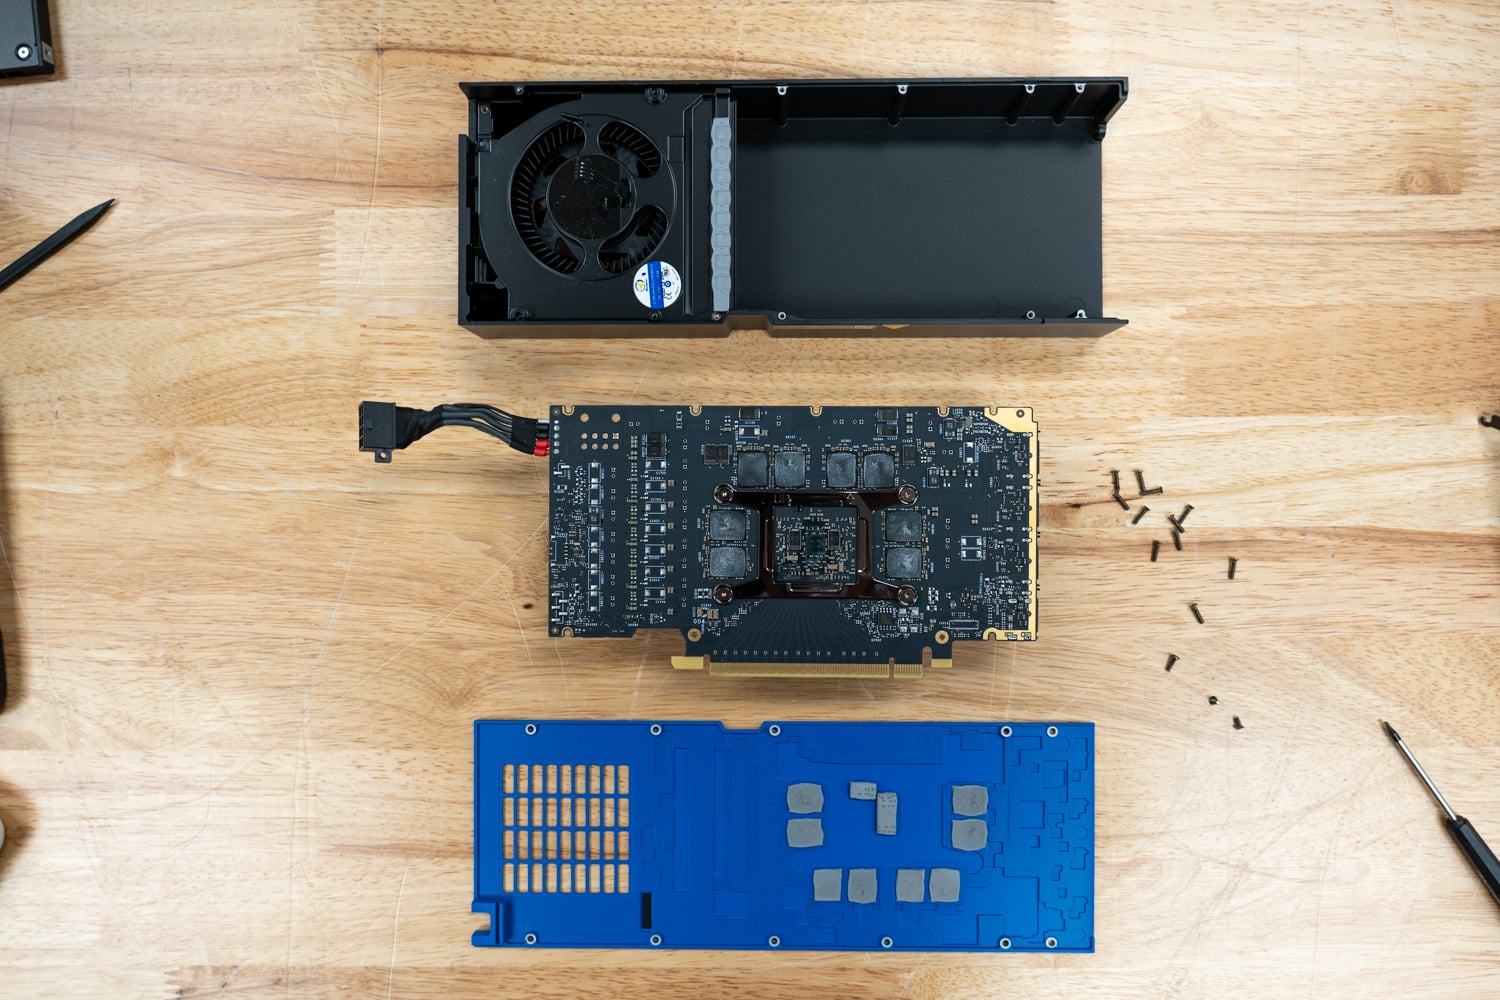
အအေးခံကိရိယာကို ဖယ်ရှားလိုက်တဲ့အခါ Arc Pro B70 ရဲ့ PCB က ကတ်ကို စွမ်းအားပေးနေတဲ့ အဓိက အစိတ်အပိုင်းတွေကို ပြသပေးပါတယ်။ အလယ်ဗဟိုမှာ Intel ရဲ့ 32-core Xe2-HPG GPU ရှိပြီး 256-bit memory interface ကနေတစ်ဆင့် ချိတ်ဆက်ထားတဲ့ 32GB dedicated GDDR6 memory က ဝန်းရံထားပြီး memory bandwidth 608 GB/s အထိ ပေးစွမ်းနိုင်ပါတယ်။ GPU မှာ AI compute performance ရဲ့ INT8 TOPS ၃၆၇ ခုအထိ ပေးစွမ်းနိုင်တဲ့ XMX AI engines ၂၅၆ ခုနဲ့ hardware-accelerated ray-tracing workloads တွေအတွက် dedicated Ray Tracing units ၃၂ ခု ပါဝင်ပါတယ်။ GPU ကို ဝန်းရံထားတာက power delivery stages၊ memory circuitry နဲ့ display output components တွေ ဖြစ်ပါတယ်။
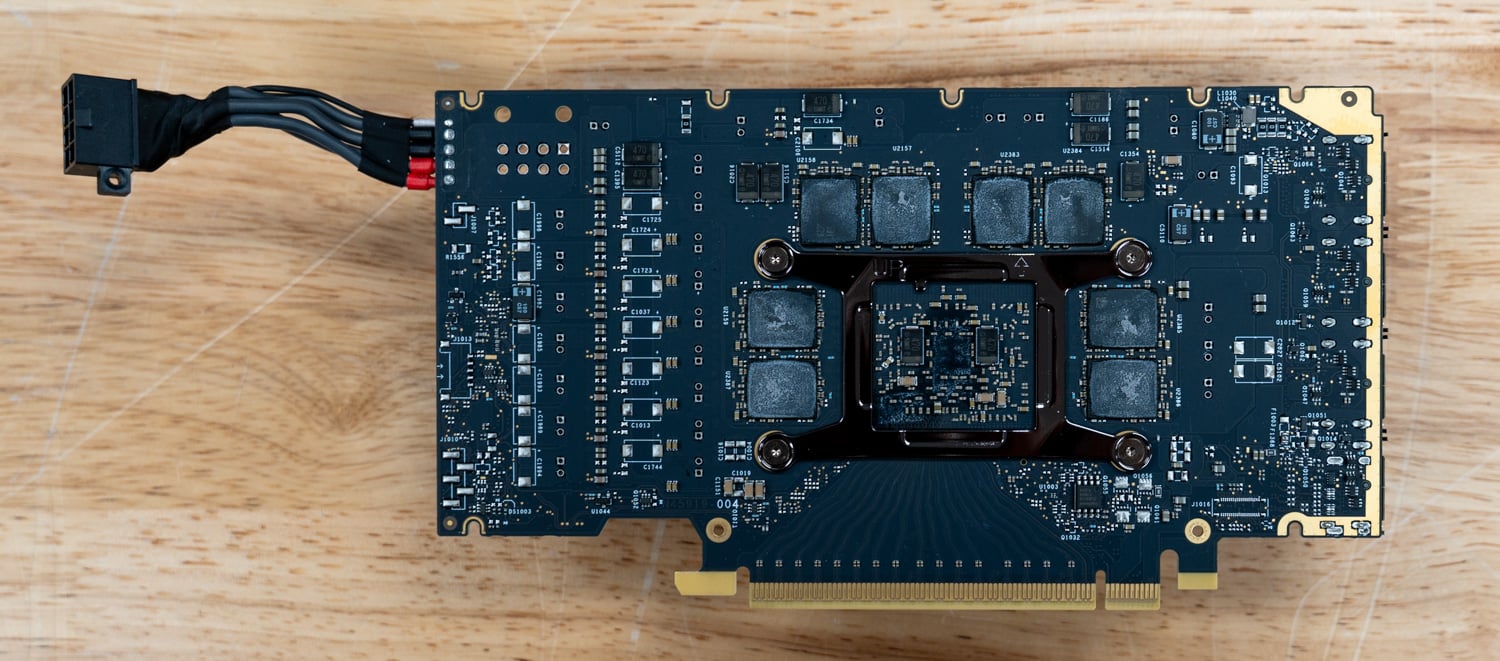
PCB ရဲ့နောက်ဘက်မှာ GDDR6 မန်မိုရီပက်ကေ့ချ်တွေနဲ့ ကတ်ရဲ့ ပါဝါပေးပို့မှုပတ်လမ်းရဲ့ အစိတ်အပိုင်းတွေကို ပိုမိုပေါ်လွင်စေပါတယ်။ GPU ပက်ကေ့ချ်ကို ဝန်းရံထားတဲ့ ကြီးမားတဲ့ ထိန်းသိမ်းမှုကွင်းက heatsink ကနေ mounting pressure ကို ညီညာစွာဖြန့်ဝေပေးပါတယ်။ 8-pin PCIe ပါဝါချိတ်ဆက်ကိရိယာက ကတ်ရဲ့ ပြင်ပပါဝါကို ထောက်ပံ့ပေးပါတယ်။ PCIe slot ကနေတစ်ဆင့် ပါဝါပေးပို့တာကြောင့် Arc Pro B70 ဟာ ဘုတ်ရဲ့ စုစုပေါင်းပါဝါရဲ့ 230W အထိ ထောက်ပံ့ပေးနိုင်ပါတယ်။
Intel Arc Pro B70 စွမ်းဆောင်ရည်စမ်းသပ်ခြင်း
Windows စမ်းသပ်ခြင်း – StorageReview AMD Threadripper စမ်းသပ်ပလက်ဖောင်း
ကျွန်ုပ်တို့၏ Intel Arc Pro B70 စမ်းသပ်မှုအတွက် အသုံးပြုမည့် စမ်းသပ်မှုပလက်ဖောင်းမှာ အောက်ပါအတိုင်းဖြစ်သည်။
- motherboard: ASUS Pro WS TRX50-SAGE WIFI
- CPU ကို: AMD Ryzen Threadripper 7980X 64-Core
- ရမ်: 128GB DDR5 4800MT/s
- သိုလှောင်မှု: 2TB Samsung 980 Pro
- OS ကို: Workstations အတွက် Windows 11 Pro
စမ်းသပ်ထားသော နှိုင်းယှဉ်နိုင်သော GPU များ
- Intel Arc Pro B50
- Intel Arc Pro B70
- AMD Radeon RX 9060 XT
- AMD Radeon RX 9070
- AMD Radeon RX 9070 XT
- Nvidia GeForce RTX 5060 တီ
- NVIDIA GeForce RTX 5070 FE
UL Procyon: AI စာသားထုတ်လုပ်ခြင်း
Procyon AI Text Generation Benchmark သည် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို တိကျပြီး တသမတ်တည်းရှိသော အကဲဖြတ်နည်းလမ်းဖြင့် ပိုမိုကောင်းမွန်စေသည်။ ၎င်းသည် ကြီးမားသော မော်ဒယ်များ၏ ရှုပ်ထွေးမှုနှင့် variable factor များ၏ သက်ရောက်မှုကို လျှော့ချပေးနေစဉ် LLM မော်ဒယ်များစွာတွင် ထပ်ခါတလဲလဲ စမ်းသပ်နိုင်စေပါသည်။ AI hardware ဦးဆောင်သူများနှင့်အတူ တီထွင်ထားသောကြောင့် ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်သော စွမ်းဆောင်ရည် အကဲဖြတ်မှုများကို ပေးအပ်နိုင်ရန် ဒေသတွင်း AI accelerator များအသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးပါသည်။ အောက်ပါရလဒ်များကို NVIDIA မော်ဒယ်များတွင် TensorRT နှင့် AMD မော်ဒယ်များတွင် ONNX ကို အသုံးပြု၍ တိုင်းတာခဲ့သည်။
Arc Pro B70 သည် နှိုင်းယှဉ်မှုတွင် အကြီးမားဆုံး မျိုးဆက်တိုးတက်မှုများထဲမှ တစ်ခုကို ပေးစွမ်းနိုင်ပြီး Phi၊ Mistral နှင့် Llama 3 မော်ဒယ်များတွင် B50 ထက် စုစုပေါင်းရမှတ် ၆၀% တိုးလာပြီး ပထမဆုံးတိုကင်ရရှိရန် အချိန်ကို ၄၀-၄၅% လျှော့ချပေးပါသည်။ AMD နှင့် နှိုင်းယှဉ်ပါက B70 သည် Phi (၄,၁၅၂ vs. ၁,၂၈၁) တွင် Radeon RX 9060 XT ထက် ၂၂၄% ပိုများပြီး Mistral (၄,၀၈၂ vs. ၁,၂၇၄) တွင် ၂၂၀% ပိုများကာ Llama 3 (၄,၀၂၉ vs. ၁,၁၅၀) တွင် ၂၅၀% ပိုများသည်။ Radeon RX 9070 XT နှင့် နှိုင်းယှဉ်ပါက Intel သည် အသီးသီး ၁၀၀%၊ ၈၃% နှင့် ၉၅% အားသာချက်ကို ထိန်းသိမ်းထားဆဲဖြစ်သည်။ NVIDIA က RTX 5060 Ti ဟာ Phi မှာ B70 ထက် ၄၅% နဲ့ Mistral မှာ ၄၅% နောက်ကျနေပြီး RTX 5070 ကတော့ အဲဒီမော်ဒယ်တွေမှာ ၁၅-၂၀% နောက်ကျနေပါတယ်။ အထင်ရှားဆုံးရလဒ်ကတော့ Llama 2 ဖြစ်ပြီး B70 ဟာ 5,769 မှတ်နဲ့ အမြင့်ဆုံးရမှတ်ရရှိကာ RTX 5070 ထက် ၈၅% နဲ့ RX 9070 XT ထက် ၁၅၁% သာလွန်ပါတယ်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | Nvidia GeForce RTX 5060 တီ | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| Phi ၏ စုစုပေါင်းရမှတ် | 2,593 | 4,152 | 1,281 | 1,933 | 2,080 | 2,870 | 3,453 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.275 ့ | 0.155 ့ | 1.473 ့ | 0.954 ့ | 0.855 ့ | 0.375 ့ | 0.323 ့ |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | 72.128 တိုကင်/s | 104.121 တိုကင်/s | 94.453 တိုကင်/s | 139.187 တိုကင်/s | 144.471 တိုကင်/s | 120.773 တိုကင်/s | 150.435 တိုကင်/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 39.179 ့ | 37.924 ့ | 39.365 ့ | 26.989 ့ | 25.587 ့ | 25.216 ့ | 20.302 ့ |
| Mistral ၏ စုစုပေါင်းရမှတ် | 2,483 | 4,082 | 1,274 | 2,040 | 2,231 | 2,807 | 3,562 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.346 ့ | 0.180 ့ | 1.827 ့ | 1.109 ့ | 0.946 ့ | 0.526 ့ | 0.433 ့ |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | 46.799 တိုကင်/s | 65.834 တိုကင်/s | 65.115 တိုကင်/s | 101.300 တိုကင်/s | 103.348 တိုကင်/s | 91.057 တိုကင်/s | 120.507 တိုကင်/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 59.907 ့ | 58.976 ့ | 54.516 ့ | 34.960 ့ | 33.350 ့ | 33.377 ့ | 25.496 ့ |
| Llama3 အလုံးစုံရမှတ် | 2,427 | 4,029 | 1,150 | 1,904 | 2,070 | 2,599 | 3,125 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.311 ့ | 0.166 ့ | 1.632 ့ | 0.981 ့ | 0.845 ့ | 0.449 ့ | 0.379 ့ |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | 45.031 တိုကင်/s | 66.340 တိုကင်/s | 53.167 တိုကင်/s | 87.594 တိုကင်/s | 89.102 တိုကင်/s | 74.709 တိုကင်/s | 100.388 တိုကင်/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 61.926 ့ | 53.687 ့ | 62.563 ့ | 38.273 ့ | 36.742 ့ | 39.489 ့ | 29.720 ့ |
| Llama2 အလုံးစုံရမှတ် | - | 5,769 | 1,252 | 2,047 | 2,298 | 2,576 | 3,125 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | - | 0.259 ့ | 2.992 ့ | 1.926 ့ | 1.565 ့ | 0.844 ့ | 0.785 ့ |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | - | 63.666 တိုကင်/s | 34.654 တိုကင်/s | 59.673 တိုကင်/s | 61.127 တိုကင်/s | 41.386 တိုကင်/s | 56.647 တိုကင်/s |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | - | 44.131 ့ | 99.027 ့ | 59.100 ့ | 55.520 ့ | 71.302 ့ | 53.234 ့ |
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ ဟာ့ဒ်ဝဲအမျိုးမျိုးတွင် AI inference စွမ်းဆောင်ရည်ကို စဉ်ဆက်မပြတ်နှင့် တိကျစွာ တိုင်းတာပေးသည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခုပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ်ပါဝါရှိသော GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်းစက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သောရလဒ်များကို သေချာစေသည်။
ရုပ်ပုံထုတ်လုပ်မှုသည် Arc Pro B70 သည် ၎င်း၏ သေးငယ်သောညီအစ်ကိုထက် သိသိသာသာတိုးတက်မှုကို ပြသသည့် နောက်ထပ်နယ်ပယ်တစ်ခုဖြစ်ပြီး Stable Diffusion 1.5 FP16 ရမှတ် (2,101 vs. 754) ကို ၁၇၉% မြင့်မားစေပြီး ထုတ်လုပ်မှုအချိန်ကို ၁၃၂.၆ စက္ကန့်မှ ၄၇.၆ စက္ကန့်အထိ လျှော့ချပေးခဲ့ပြီး ၆၄% လျော့ကျစေခဲ့သည်။ B70 သည် RTX 5060 Ti (2,101 vs. 2,110၊ ၁% ကွာခြားချက်ထက်နည်းသည်) နှင့် အခြေခံအားဖြင့် တူညီပြီး RX 9070 XT ထက် ၁၉% နှင့် RTX 5070 ထက် ၂၉% နောက်ကျနေသည်။ Stable Diffusion XL FP16 တွင် Intel သည် B50 စွမ်းဆောင်ရည်ကို သုံးဆနီးပါး (၁၈၁% ပိုများသည်) မြှင့်တင်ပေးပြီး RTX 5060 Ti ထက် ၈% သာလွန်ပြီး RTX 5070 FE ထက် ၁၈% ခန့်နောက်ကျနေသည်။ INT8 workload သည် NVIDIA ၏ TensorRT အကောင်အထည်ဖော်မှုကို အထောက်အကူပြုသော်လည်း B70 သည် B50 ထက် 265% ပိုမိုကောင်းမွန်လာပြီး image generation အချိန်ကို 72% ကျော် လျှော့ချပေးပါသည်။
| UL Procyon: AI ပုံရိပ်ထုတ်လုပ်ခြင်း (စုစုပေါင်းရမှတ်- မြင့်လေ ပိုကောင်းလေ) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | Nvidia GeForce RTX 5060 တီ | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — အလုံးစုံရမှတ် | 754 | 2,101 | 1,436 | 2,110 | 2,280 | 2,598 | 2,937 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ಒಟ್ಟಾರೆအချိန် | 132.585 ့ | 47.585 ့ | 69.633 ့ | 47.590 ့ | 43.858 ့ | 38.481 ့ | 34.038 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — အလုံးစုံရမှတ် | 5,020 | 18,344 | N / A | 27,705 | N / A | N / A | 36,320 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — ಒಟ್ಟಾರೆအချိန် | 49.795 ့ | 13.628 ့ | N / A | 9.024 ့ | N / A | N / A | 6.883 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | N / A | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | N / A | N / A | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — အလုံးစုံရမှတ် | 748 | 2,102 | 1,124 | 1,940 | 1,805 | 2,010 | 2,473 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ಒಟ್ಟಾರೆအချိန် | 790.774 ့ | 285.344 ့ | 533.736 ့ | 326.550 ့ | 332.400 ့ | 298.499 ့ | 242.606 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray-tracing renderer ဖြစ်သော LuxRender ကိုအသုံးပြု၍ အလွန်အသေးစိတ်ကျသော 3D မြင်ကွင်းများဖြင့် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် ဆာဗာများနှင့် workstation များ၏ graphical rendering စွမ်းရည်များကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များတွင် တိကျသောအလင်း simulation သည် အရေးကြီးပါသည်။
LuxMark သည် Battlemage အတွက် အလွန်ကောင်းမွန်သော scaling ကို ပြသခဲ့သည်။ Arc Pro B70 သည် B50 ထက် Food မြင်ကွင်းတွင် 128% နှင့် Hall တွင် 137% တိုးတက်ကောင်းမွန်လာသည်။ ၎င်းသည် Radeon RX 9060 XT ထက် Food တွင် 33% နှင့် Hall တွင် 53% စွမ်းဆောင်ရည် ပိုမိုကောင်းမွန်သည်။ ဂိမ်းကစားခြင်းကို အဓိကထားသော RX 9070 XT သည် Food တွင် 54% ခန့်နှင့် Hall တွင် 37% အားသာချက်ကို ထိန်းသိမ်းထားပြီး NVIDIA ၏ RTX 5070 FE သည် 62% နှင့် 81% အသီးသီး ဦးဆောင်နေသည်။ အလုံးစုံပြောရလျှင် B70 သည် workstation workloads များအတွက် ခိုင်မာသော OpenCL rendering accelerator တစ်ခုအဖြစ် ခိုင်မာစွာ ရပ်တည်နေသည်။
| လပ်စ်မာ့ခ် (မြင့်ရင် ပိုကောင်းတယ်) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | Nvidia GeForce RTX 5060 တီ | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|---|
| အစားအသောက်ရမှတ် | 2,456 | 5,609 | 4,220 | 6,590 | 8,233 | 8,610 | 9,061 |
| ခန်းမရမှတ် | 5,158 | 12,220 | 8,007 | 15,348 | 16,566 | 16,758 | 22,062 |
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
Arc Pro B70 ဟာ ရမှတ် ၁၄၀,၁၆၅ ရရှိထားပြီး Arc Pro B50 ထက် ၁၀၀% တိုးတက်မှုကို ကိုယ်စားပြုပါတယ်။ Radeon RX 9070 ထက် ၁% ခန့် သာလွန်ပြီး RX 9060 XT ထက် ၃၆% သာလွန်ကာ RTX 5060 Ti ထက် ၇% သာလွန်ပါတယ်။ NVIDIA ရဲ့ RTX 5070 FE က ၂၄% ခန့် ဦးဆောင်နေပြီး AMD ရဲ့ RX 9070 XT က ၃၅% ခန့် သာလွန်ပြီး B70 က အမြင့်ဆုံး mainstream compute stack ရဲ့ အလယ်မှာ ရှိနေပါတယ်။
| Geekbench 6 OpenCL (မြင့်ရင် ပိုကောင်းတယ်) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | AMD Radeon RX 9070 | Nvidia GeForce RTX 5060 တီ | NVIDIA GeForce RTX 5070 FE | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| GPU OpenCL ရမှတ် | 70,038 | 140,165 | 102,750 | 138,463 | 150,743 | 173,255 | 188,892 |
3DMark
3DMark Port Royal၊ Speed Way နှင့် Steel Nomad တို့သည် မတူညီသော အခြေအနေများတွင် စွမ်းဆောင်ရည်ကို စမ်းသပ်သည့် GPU benchmark များဖြစ်သည်။ Port Royal သည် ray tracing ကို အာရုံစိုက်ပြီး Speed Way သည် racing simulation များတွင် စွမ်းဆောင်ရည်ကို အကဲဖြတ်ပြီး Steel Nomad သည် မြင့်မားသော intensity၊ လက်တွေ့ကျသော ဂရပ်ဖစ်များဖြင့် GPU များကို စိန်ခေါ်သည်။ ၎င်းတို့သည် rendering၊ lighting နှင့် dynamic scenes များတွင် GPU စွမ်းရည်များကို အကဲဖြတ်သည်။
ပေါင်းစပ်ဂရပ်ဖစ်စွမ်းဆောင်ရည်သည် ဗိသုကာပုံစံအသစ်နှင့်အတူ ကောင်းမွန်စွာချိန်ညှိနိုင်သည်။ Arc Pro B70 သည် Port Royal တွင် B50 ထက် 154% မြင့်မားပြီး Speed Way တွင် 136% မြင့်မားကာ Steel Nomad တွင် 149% မြင့်မားသည်။ RX 9060 XT နှင့်နှိုင်းယှဉ်ပါက B70 သည် Port Royal တွင် 9%၊ Speed Way တွင် 7% နှင့် Steel Nomad တွင် 9% ဖြင့် ဦးဆောင်နေသည်။ RTX 5060 Ti နှင့်နှိုင်းယှဉ်ပါက B70 သည် Port Royal တွင် 2% အတွင်း စွမ်းဆောင်ရည်ရှိပြီး Speed Way တွင် 23% နောက်ကျပြီး Steel Nomad တွင် 13% ဖြင့် ဦးဆောင်နေသည်။ အဆင့်မြင့် RTX 5070 FE နှင့် RX 9070 XT တို့သည် workload ပေါ် မူတည်၍ 31-83% အားသာချက်ကို ဆက်လက်ထိန်းသိမ်းထားပြီး ၎င်းတို့၏ စွမ်းဆောင်ရည်မြင့် gaming GPU များအဖြစ် ရပ်တည်မှုကို ထင်ဟပ်စေသည်။
| 3DMark (မြင့်ရင် ပိုကောင်းတယ်) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9060 XT | Nvidia GeForce RTX 5060 တီ | NVIDIA GeForce RTX 5070 FE | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| ဆိပ်ကမ်းတော်ဝင် | 4,197 | 10,668 | 9,751 | 10,432 | 14,026 | 15,760 | 17,989 |
| မြန်နှုန်းမြင့်လမ်း | 1,355 | 3,202 | 3,004 | 4,184 | 5,869 | 5,791 | 6,237 |
| သံမဏိနိုမက် (DX12) | 1,644 | 4,089 | 3,767 | 3,611 | 5,019 | 5,992 | 6,977 |
ဥဿဖရား ဗီဒီယို AI
Topaz Video AI သည် အဆင့်မြင့် AI မော်ဒယ်များကို အသုံးပြု၍ ဗီဒီယိုကို မြှင့်တင်ခြင်းနှင့် ပြန်လည်ရယူခြင်းအတွက် ပရော်ဖက်ရှင်နယ် အပလီကေးရှင်းတစ်ခုဖြစ်သည်။ ၎င်းသည် ဗီဒီယိုများကို 4K သို့မဟုတ် 8K သို့ မြှင့်တင်ခြင်း၊ မှုန်ဝါးနေသော အကြောင်းအရာများကို ပိုမိုထက်မြက်စေခြင်း၊ ဆူညံသံများ လျှော့ချခြင်း၊ မျက်နှာအသေးစိတ်အချက်အလက်များကို မြှင့်တင်ခြင်း၊ အဖြူအမည်း ဗီဒီယိုများကို အရောင်ခြယ်ခြင်းနှင့် ချောမွေ့သော ရွေ့လျားမှုအတွက် frame များကို interpolate လုပ်ခြင်း အပါအဝင် အလုပ်အမျိုးမျိုးကို ပံ့ပိုးပေးသည်။ ၎င်း suite တွင် ၎င်း၏ ဗီဒီယို-enhancing algorithms အမျိုးမျိုးတွင် စနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် onboard benchmark တစ်ခု ပါဝင်ပြီး hardware platform များသည် လိုအပ်ချက်များသော AI ဗီဒီယို-processing workloads များကို မည်မျှကောင်းမွန်စွာ ကိုင်တွယ်နိုင်သည်ကို ရှင်းလင်းစွာ မြင်တွေ့နိုင်စေပါသည်။
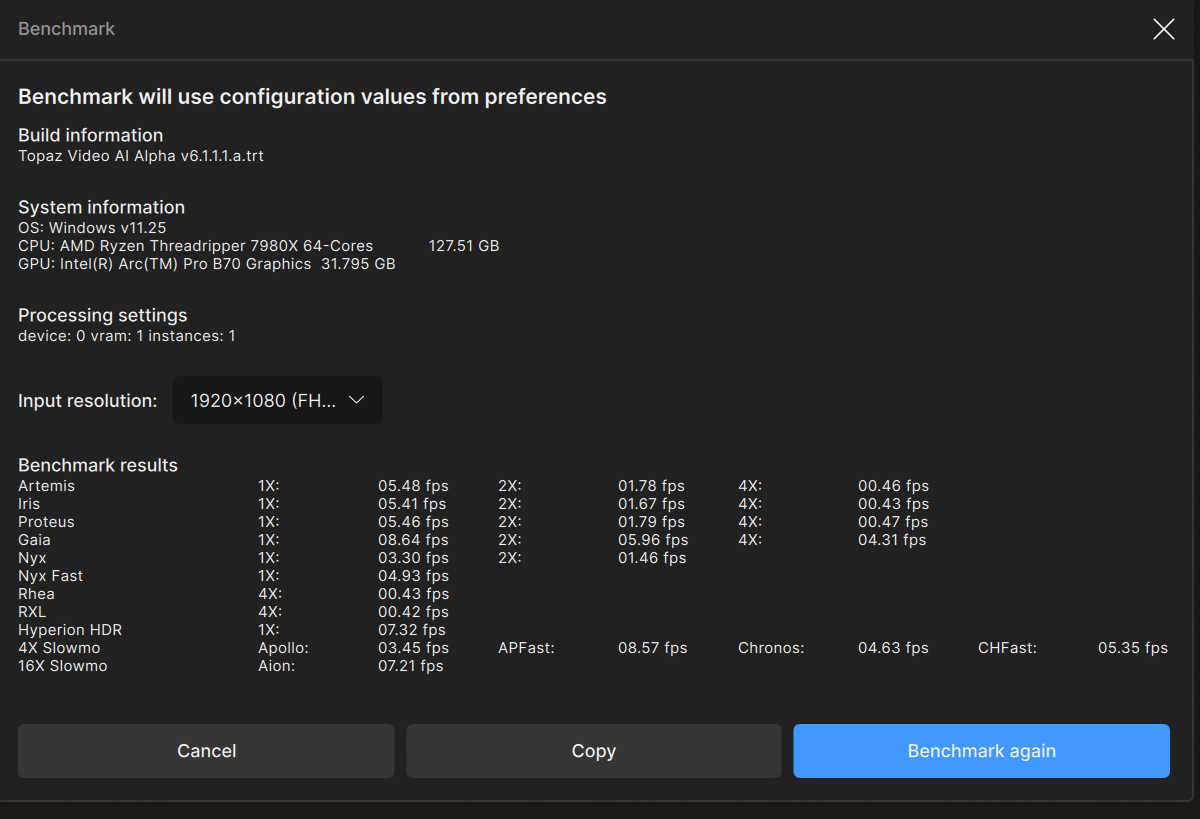
Arc Pro B70 သည် Intel ၏ ယခင်မျိုးဆက် ပရော်ဖက်ရှင်နယ် ကမ်းလှမ်းချက်ထက် သိသိသာသာ တိုးတက်မှုကို ပေးစွမ်းပြီး AI upscaling workloads များတွင် အကြီးမားဆုံး အားသာချက်များ ပေါ်လာပါသည်။ 1× enhancement တွင် Artemis တွင် 5.48 FPS၊ Iris တွင် 5.41 FPS နှင့် Proteus တွင် 5.46 FPS ရရှိပြီး Gaia သည် 8.64 FPS အထိ ရောက်ရှိပြီး ၎င်းသည် စံ enhancement မော်ဒယ်များ၏ အမြန်ဆုံးရလဒ်ဖြစ်သည်။ ပိုမိုတွက်ချက်မှု မြင့်မားသော restoration မော်ဒယ်များသည် သဘာဝအတိုင်း နှေးကွေးစွာ လည်ပတ်ပြီး Nyx သည် 3.30 FPS နှင့် Nyx Fast သည် 4.93 FPS ဖြင့် လည်ပတ်ပြီး Hyperion HDR သည် 7.32 FPS ဖြင့် ရိုက်ကူးမှုများကို လုပ်ဆောင်သည်။ Slow-motion ထုတ်လုပ်ခြင်းသည်လည်း ကောင်းမွန်စွာ စွမ်းဆောင်ရည်ရှိပြီး Apollo ဖြင့် 3.45 FPS၊ APFast ဖြင့် 8.57 FPS၊ Chronos ဖြင့် 4.63 FPS၊ CHFast ဖြင့် 5.35 FPS နှင့် Aion ဖြင့် 7.21 FPS ထုတ်လုပ်ပေးသည်။ စုပေါင်းအားဖြင့် ဤရလဒ်များက Arc Pro B70 သည် ဗီဒီယို မြှင့်တင်ခြင်းနှင့် ဆူညံသံလျှော့ချခြင်းမှသည် HDR ပြောင်းလဲခြင်းနှင့် frame interpolation အထိ Topaz AI workflows အပြည့်အစုံကို ကိုင်တွယ်နိုင်ကြောင်း ပြသနေပြီး Intel ၏ XMX AI အရှိန်မြှင့်မှုကို အသုံးချလိုသော ဖန်တီးသူများအတွက် ခိုင်မာသော ရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။
Blender ၂.၆၅
Blender သည် open-source 3D modeling application တစ်ခုဖြစ်သည်။ ဤ benchmark ကို GPU များတစ်လျှောက် Blender Benchmark utility ကို အသုံးပြု၍ လုပ်ဆောင်ခဲ့သည်။ ရမှတ်ကို တစ်မိနစ်လျှင် နမူနာများဖြင့် တိုင်းတာပြီး မြင့်မားသောတန်ဖိုးများသည် ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြသည်။
Arc Pro B70 သည် Monster တွင် တစ်မိနစ်လျှင် နမူနာ ၁,၅၂၄.၆ ခု၊ Junkshop တွင် တစ်မိနစ်လျှင် နမူနာ ၈၄၆.၉ ခု နှင့် Classroom တွင် တစ်မိနစ်လျှင် နမူနာ ၉၁၂.၂ ခု ထုတ်လုပ်ပေးသည်။ ဤကိန်းဂဏန်းများသည် RX 9070 XT သို့မဟုတ် RTX 5070 ကဲ့သို့သော အဆင့်မြင့် GPU များနှင့် မယှဉ်ပြိုင်နိုင်သော်လည်း၊ Battlemage တွင် ပရော်ဖက်ရှင်နယ် visualization နှင့် content creation workloads များအတွက် လုံလောက်သော rendering စွမ်းဆောင်ရည်ရှိကြောင်း ပြသနေသည်။ ၎င်း၏ 32GB framebuffer နှင့် အသိအမှတ်ပြု workstation drivers များနှင့် ပေါင်းစပ်ထားသော B70 သည် rendering စွမ်းရည်၊ AI အရှိန်မြှင့်ခြင်းနှင့် ပရော်ဖက်ရှင်နယ် ယုံကြည်စိတ်ချရမှုတို့အကြား လက်တွေ့ကျသော ဟန်ချက်ညီမှုကို ဖော်ဆောင်ပေးသည်။
| Blender 4.5.0 (တစ်မိနစ်လျှင် နမူနာများ၊ များလေ ပိုကောင်းလေ) | Intel Arc Pro B70 |
|---|---|
| ဧရာမသတ္တဝါကြီး | 1,524.60 |
| အမှိုက်ဆိုင် | 846.87 |
| စာသင်ခန်း | 912.24 |
ပါဝါသုံးစွဲမှု: Intel B70
ပါဝါသုံးစွဲမှုသည် မည်သည့်ကွန်ပျူတာပလက်ဖောင်း၏မဆို သိသာထင်ရှားသော အစိတ်အပိုင်းတစ်ခုဖြစ်သည်။ GPU မျိုးဆက်အသစ်တစ်ခုစီသည် ဝန်အောက်တွင် ပါဝါပိုမိုသုံးစွဲသောကြောင့် ပါဝါထောက်ပံ့မှုပိုမိုများပြားပြီး အအေးခံရန်အတွက် လုံလောက်သောလေစီးဆင်းမှုလိုအပ်သည်။ သို့သော် မြန်ဆန်သော GPU များသည် အမြင့်ဆုံးတန်ဖိုးများမြင့်မားစွာရောက်ရှိနိုင်သော်လည်း workload တစ်ခုစီ၏ကြာချိန်သည် လျော့ကျသွားသည်။ ကျွန်ုပ်တို့၏စမ်းသပ်ဓာတ်ခွဲခန်းရှိ Quarch Mains Analyzer ကို အသုံးပြု၍ Procyon AI Image Generator Stable Diffusion XL FP16 စမ်းသပ်မှု အတွင်း စနစ်ပါဝါသုံးစွဲမှုစုစုပေါင်းကို တိုင်းတာခဲ့သည် ။ ဤ workload သည် GPU တစ်ခုစီကို ၎င်း၏ပါဝါကန့်သတ်ချက်များအထိ တွန်းပို့ခဲ့ပြီး ထုတ်လုပ်ထားသောပုံရိပ်တစ်ခုစီအတွက် သတ်မှတ်ထားသော စတင်သည့်နေရာနှင့် ရပ်တန့်သည့်နေရာများကို ရှင်းရှင်းလင်းလင်းမြင်နိုင်သည်။
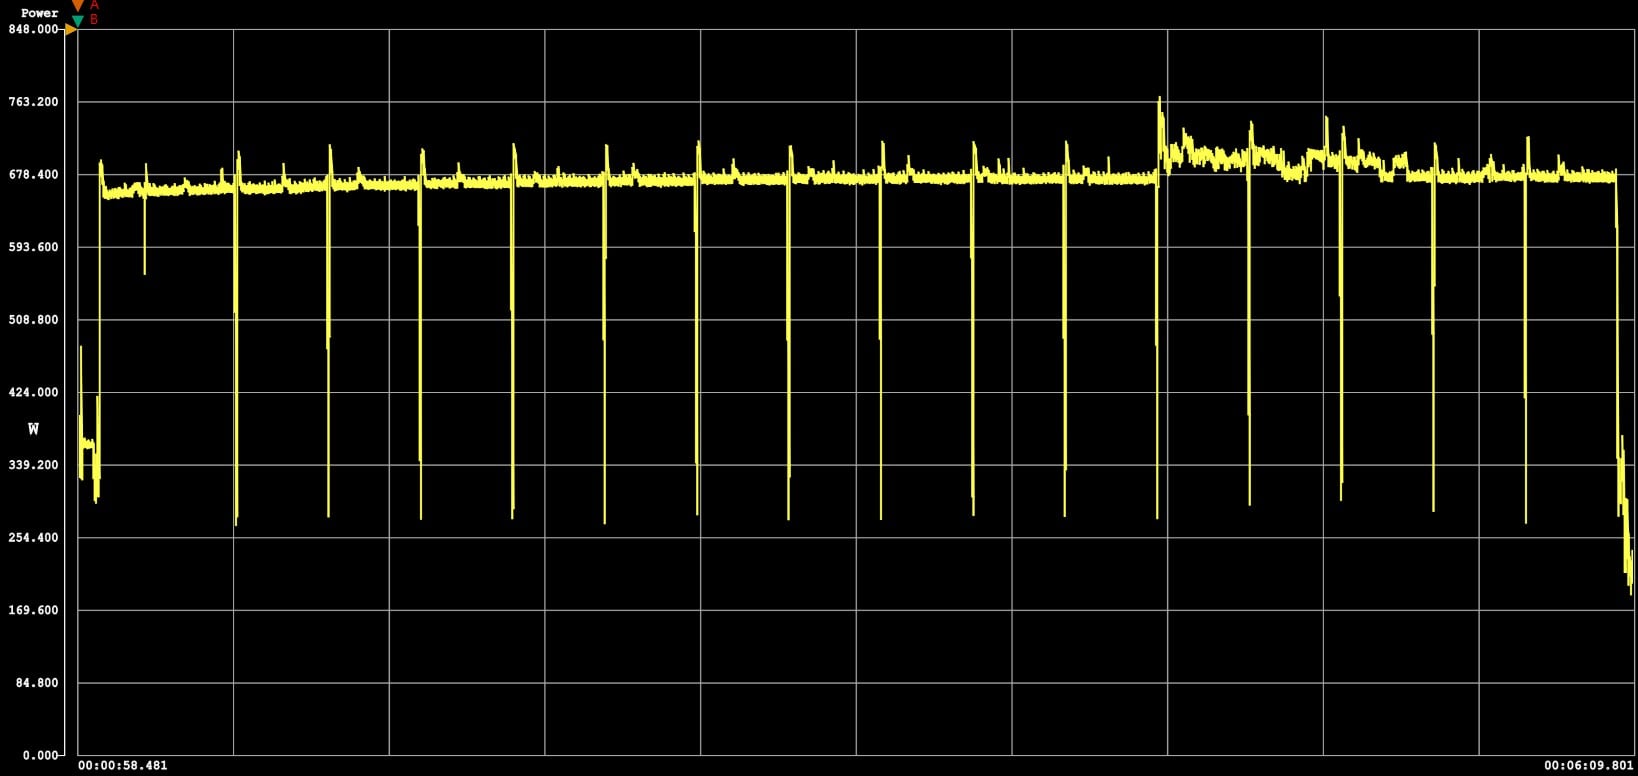
Intel Arc Pro B70 ကို စမ်းသပ်စဉ်အတွင်း စနစ်အားလပ်ချိန် ပါဝါသုံးစွဲမှု 207W၊ workload အတွင်း အမြင့်ဆုံးပါဝါသုံးစွဲမှု 705.6W နှင့် workload ပျမ်းမျှပါဝါသုံးစွဲမှု 638.6W တို့ကို တိုင်းတာခဲ့ပါသည်။
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL FP16 ပါဝါထိရောက်မှု (အောက်က ပိုကောင်းတယ်) |
Intel Arc Pro B50 | Intel Arc Pro B70 | AMD Radeon RX 9070 | AMD Radeon RX 9070 XT | PNY NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070 FE |
|---|---|---|---|---|---|---|
| ပါဝါသုံးစွဲမှု | 5.32 Wh | 3.45 Wh | 4.00 Wh | 3.41 Wh | 2.13 Wh | 2.46 Wh |
| စမ်းသပ်ကာလ | 49.9 ့ | 18.46 ့ | 33.0 ့ | 17.4 ့ | 20.2 ့ | 19.2 ့ |
vLLM အွန်လိုင်းဝန်ဆောင်မှုစံနှုန်းစွမ်းဆောင်ရည်
vLLM သည် LLM များအတွက် အလွန်ရေပန်းစားသော high-throughput inference နှင့် serving engine ဖြစ်သည်။ vLLM အွန်လိုင်း serving benchmark သည် concurrent request များအောက်တွင် လက်တွေ့ကမ္ဘာ serving စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် စွမ်းဆောင်ရည်အကဲဖြတ်ကိရိယာတစ်ခုဖြစ်သည်။ ၎င်းသည် request rate၊ input/output အရှည်များနှင့် concurrent client အရေအတွက်အပါအဝင် configure လုပ်နိုင်သော parameter များဖြင့် လည်ပတ်နေသော vLLM server သို့ request များပေးပို့ခြင်းဖြင့် production workloads များကို simulate လုပ်သည်။ benchmark သည် throughput (tokens per second)၊ time to first token (TTFT) နှင့် time per output token (TPOT) အပါအဝင် အဓိက metrics များကို တိုင်းတာပြီး အသုံးပြုသူများ vLLM သည် မတူညီသော load condition များအောက်တွင် မည်သို့လုပ်ဆောင်သည်ကို နားလည်ရန် ကူညီပေးသည်။
စမ်းသပ်ပလက်ဖောင်း-
- ဆာဗာ: စူပါမိုက်ခရို AS-၄၁၂၅GS-TNRT
- ပရိုဆက်ဆာများ AMD EPYC 9374F
- မှတ်ဉာဏ်: 512GB Samsung 4800 MT/s DDR5
- ISL ၂ ကီလိုဂရမ်/ OSL ၂၅၆
နှိုင်းယှဉ်နိုင်သော GPU များ စမ်းသပ်ခြင်း
- Intel Arc Pro B60
- Intel Arc Pro B70
- NVIDIA RTX Pro 6000
- NVIDIA DGX Spark
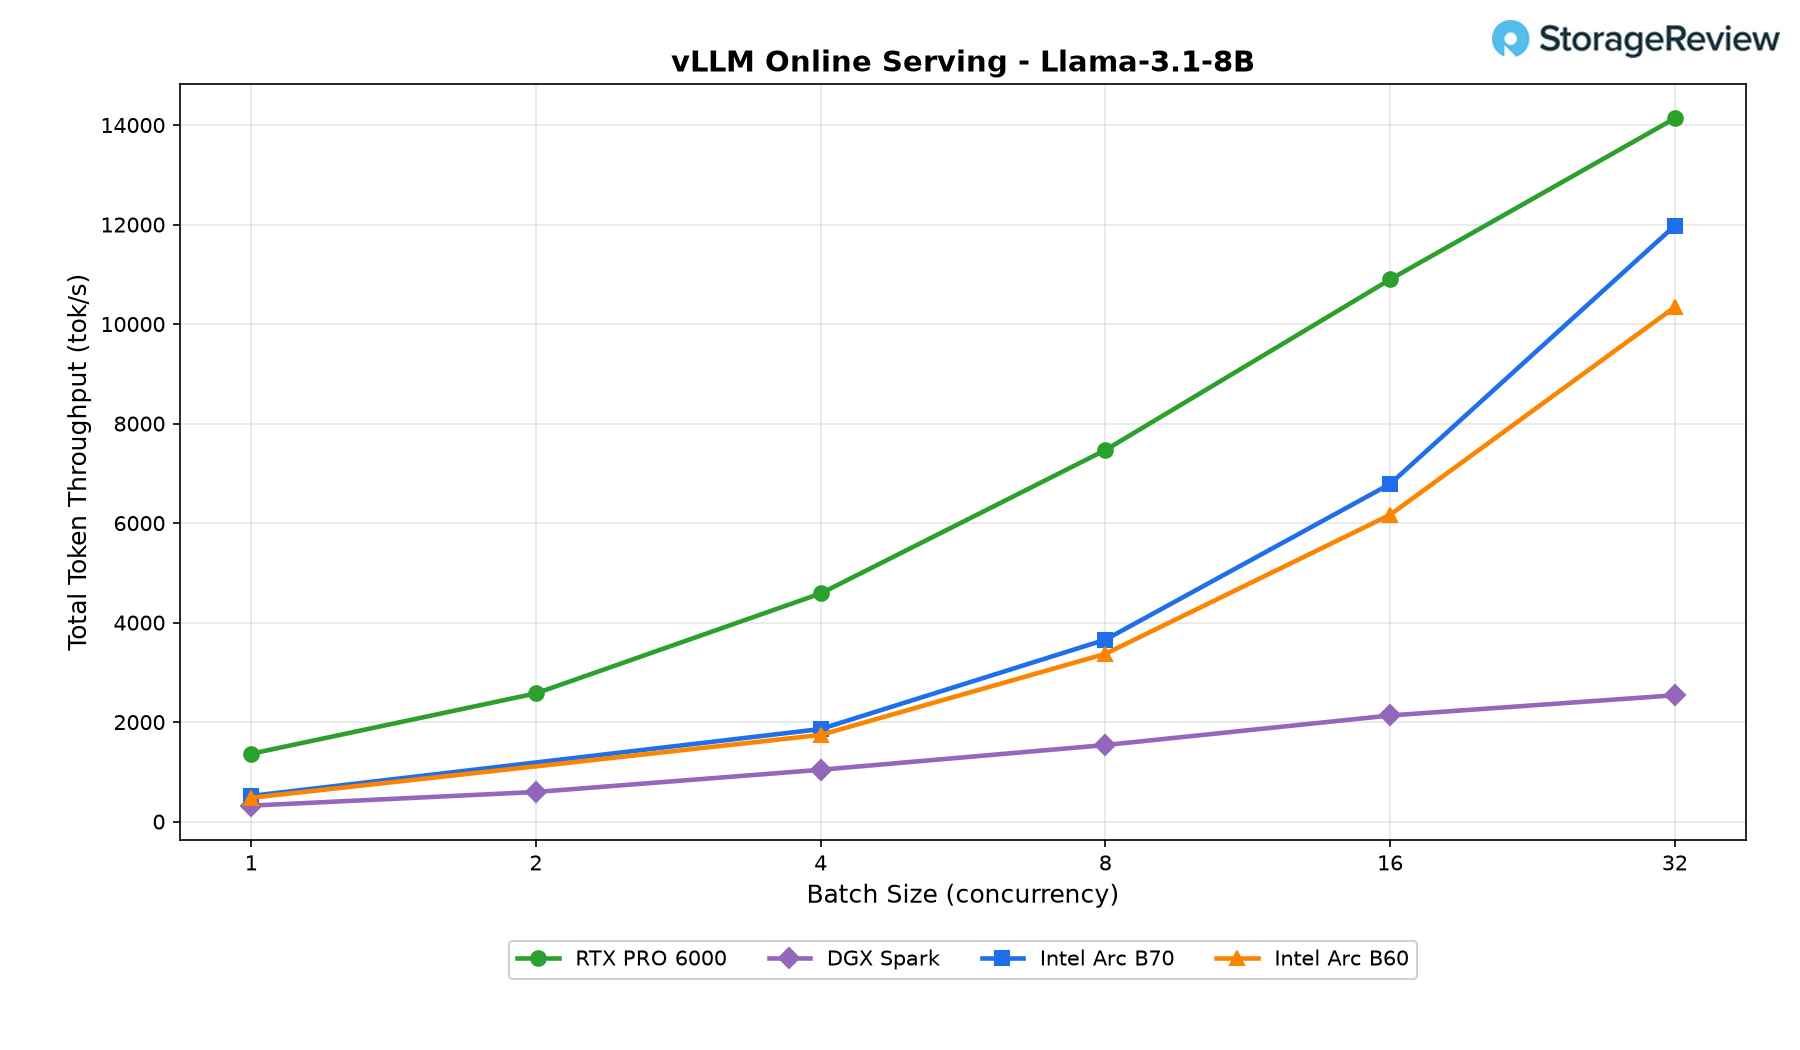
Supermicro host မှာ B70 လေးလုံး (128GB) နဲ့ B60 လေးလုံး (96GB) ကို RTX Pro 6000 တစ်လုံးနဲ့ DGX Spark တစ်လုံးနဲ့ စမ်းသပ်ခဲ့ပါတယ်။ GPU အရေအတွက် မညီမျှတာက ရည်ရွယ်ချက်ရှိရှိ လုပ်ဆောင်ထားတာပါ- စာရင်းဈေးနှုန်း $949 မှာ ကတ်လေးကတ်ပါတဲ့ B70 အစုံက Spark တစ်လုံးရဲ့ ဈေးနှုန်းနဲ့ နီးစပ်ပြီး RTX Pro 6000 တစ်လုံးထက် အများကြီး နိမ့်ကျတာကြောင့် ဒီနှိုင်းယှဉ်မှုက ကတ်အရေအတွက်ထက် ရင်းနှီးမြှုပ်နှံမှု အကြမ်းဖျင်းအားဖြင့် ပလက်ဖောင်းတွေကို ချိန်ညှိပေးပါတယ်။
မစ်စထရယ် အသေးစား ၂၄ဘီ
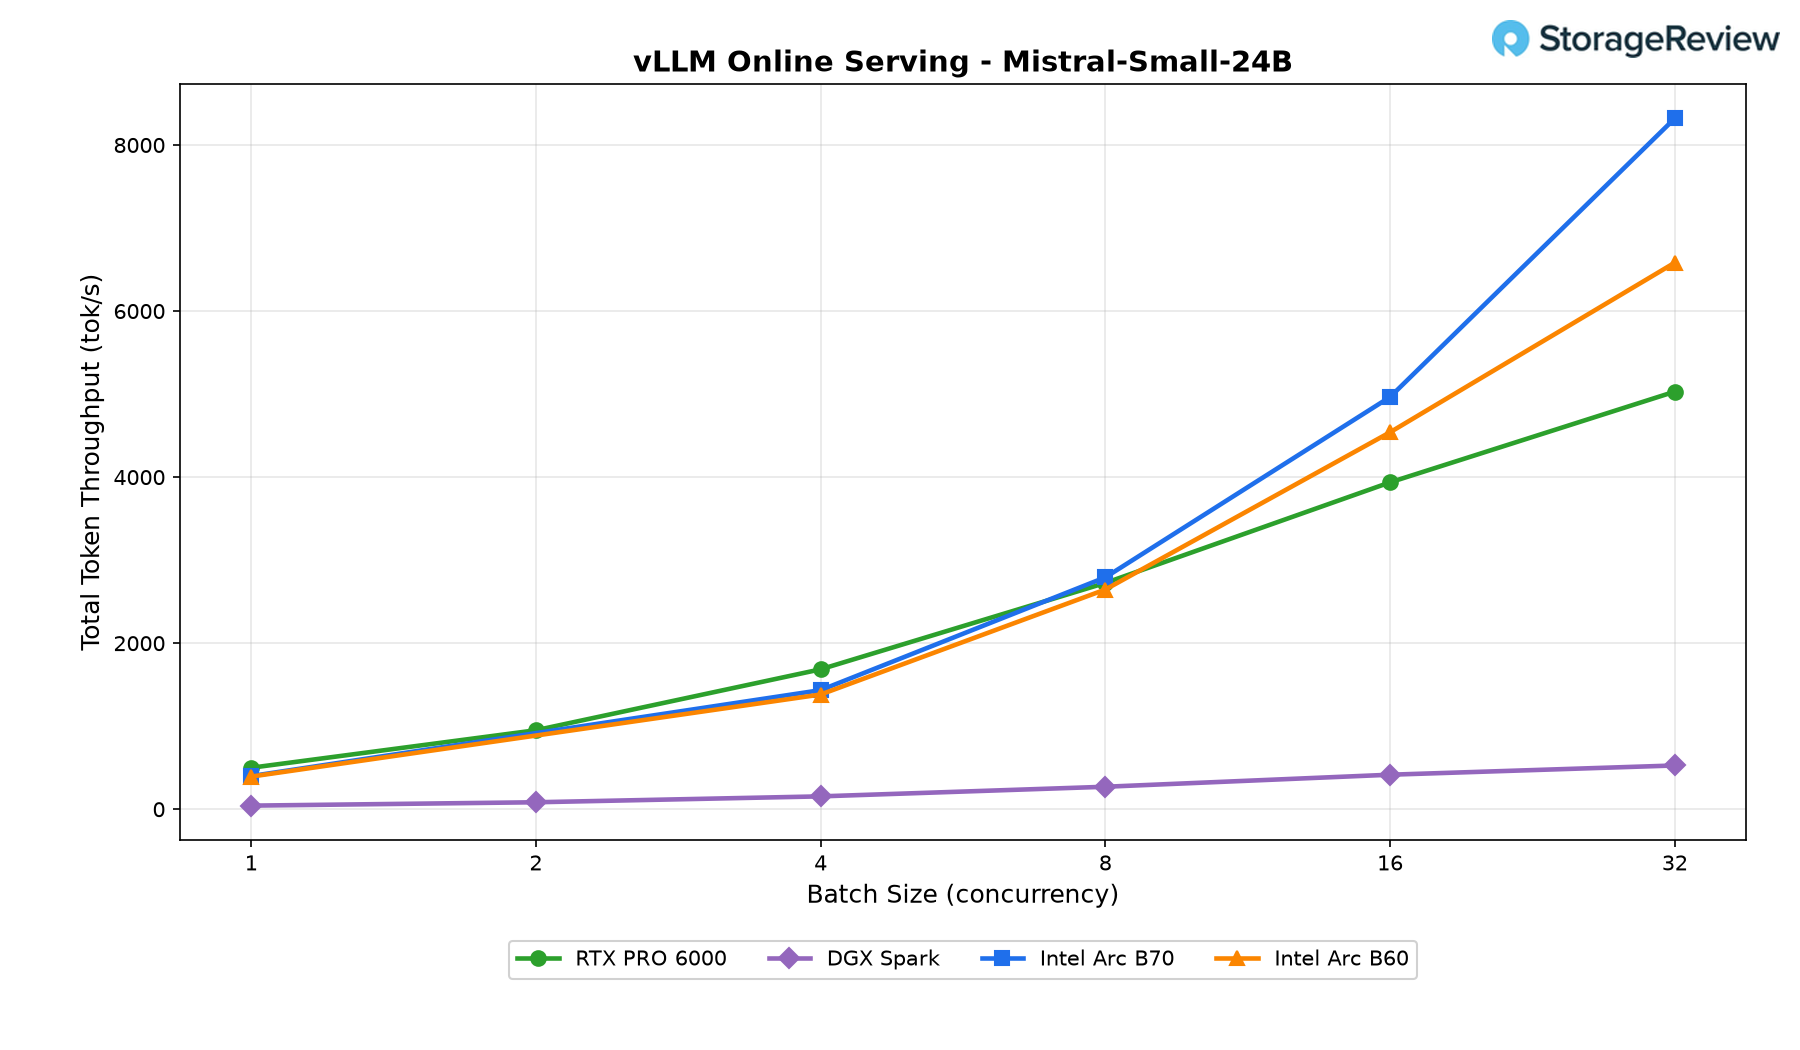
Intel Arc Pro B70 သည် Mistral-Small-24B workload တွင် ၎င်း၏ အားအကောင်းဆုံးပြသမှုကို ပေးစွမ်းခဲ့ပြီး batch size 1 တွင် 450 tok/s မှ batch size 32 တွင် 8,321 tok/s အထိ တိုးမြှင့်နိုင်ခဲ့သည်။ RTX PRO 6000 သည် batch size 4 တွင် အနည်းငယ်အားသာချက်ရှိခဲ့သော်လည်း B70 သည် batch size 8 တွင် ၎င်းကိုကျော်တက်ခဲ့ပြီး တဖြည်းဖြည်းနှင့် ကွာဟချက်ကို ကျယ်ပြန့်စေခဲ့ပြီး အမြင့်ဆုံး concurrency တွင် 65% ခန့် ဦးဆောင်ခဲ့သည်။ ၎င်း၏ သေးငယ်သောညီအစ်ကို Arc Pro B60 နှင့် နှိုင်းယှဉ်ပါက B70 သည် အစောပိုင်းတွင် အနည်းငယ်ဦးဆောင်နေခဲ့ပြီး batch size 32 တွင် ထိုအားသာချက်ကို 26% ခန့်အထိ တိုးချဲ့နိုင်ခဲ့သည်။ DGX Spark သည် စမ်းသပ်မှုတစ်လျှောက်လုံးတွင် နောက်ကျကျန်နေခဲ့ပြီး 527 tok/s ဖြင့်သာ အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး B70 သည် အမြင့်ဆုံး load အောက်တွင် 16 ဆနီးပါး ပိုမိုမြန်ဆန်ခဲ့သည်။
Qwen3 ကုဒ်ဒါ 30B
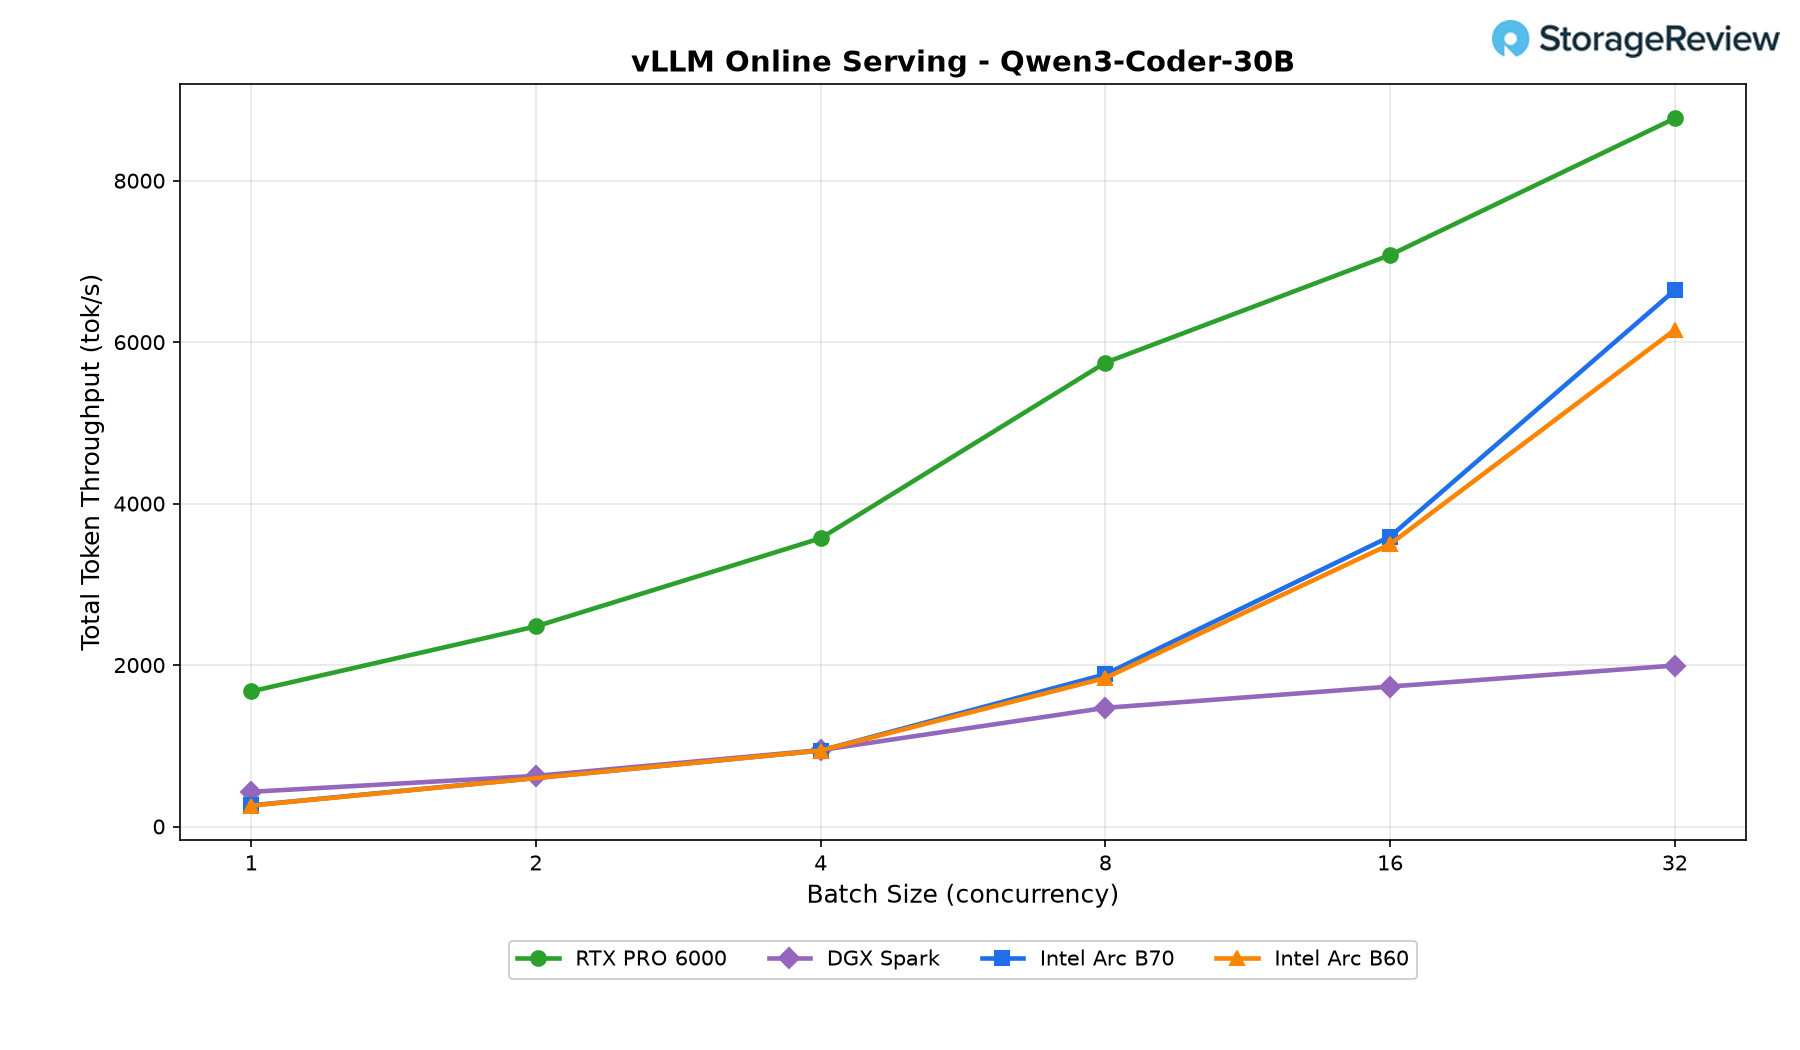
Qwen3-Coder-30B သည် RTX PRO 6000 ကို နှစ်သက်ခဲ့ပြီး၊ ၎င်းသည် concurrency အဆင့်အားလုံးတွင် အမြင့်ဆုံး throughput ကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး 8,772 tok/s ဖြင့် ပြီးဆုံးခဲ့သည်။ Intel Arc Pro B70 သည် ကောင်းစွာ scaled လုပ်ခဲ့ပြီး 32 batch size တွင် 6,643 tok/s အထိ ရောက်ရှိခဲ့ပြီး Arc Pro B60 ထက် အနည်းငယ်သာသော်လည်း တသမတ်တည်း အားသာချက်ကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး 8% ခန့် ပိုမြန်ခဲ့သည်။ developer-oriented workload တွင် RTX PRO 6000 နှင့် မယှဉ်နိုင်သော်လည်း၊ B70 သည် အမြင့်ဆုံး concurrency တွင် DGX Spark ထက် throughput သုံးဆကျော် ပေးပို့နိုင်ခဲ့ပြီး တစ်ပြိုင်နက်တည်း inference request အများအပြားကို ထိရောက်စွာ ကိုင်တွယ်နိုင်စွမ်းကို ပေါ်လွင်စေသည်။
Llama 3.1 8B
Llama-3.1-8B မော်ဒယ်ငယ်ဖြင့်၊ discrete GPU အားလုံးသည် တစ်ပြိုင်နက်တည်းလုပ်ဆောင်မှု တိုးလာသည်နှင့်အမျှ တိုးချဲ့လာသော်လည်း RTX PRO 6000 သည် စွမ်းဆောင်ရည် ဦးဆောင်သူအဖြစ် ဆက်လက်တည်ရှိနေပါသည်။ Intel Arc Pro B70 သည် batch size 32 အရ tok/s 12,000 နီးပါးအထိ မြင့်တက်ခဲ့ပြီး Arc Pro B60 ထက် ၁၆% ခန့် သာလွန်နေပြီး RTX PRO 6000 ၏ throughput ၏ ၈၅% ခန့် ရောက်ရှိခဲ့သည်။ DGX Spark နှင့် နှိုင်းယှဉ်ပါက ကွာဟချက်သည် တစ်ပြိုင်နက်တည်းလုပ်ဆောင်မှု တိုးလာသည်နှင့်အမျှ ဆက်လက်ကျယ်ပြန့်လာပြီး B70 သည် အမြင့်ဆုံး batch size တွင် throughput ၏ ၄.၇ ဆခန့် ထုတ်လုပ်ခဲ့သည်။ ရလဒ်များအရ B70 သည် ပိုမိုကြီးမားသော request queues များမှ အကျိုးကျေးဇူးများစွာ ရရှိပြီး ရရှိနိုင်သော GPU အရင်းအမြစ်များကို အခွင့်ကောင်းယူနိုင်ကြောင်းလည်း ပြသနေသည်။
GPT OSS 20B
GPT-OSS-20B benchmark မှာ RTX PRO 6000 ကို ဇယားထိပ်ဆုံးမှာ ထပ်မံထားရှိခဲ့ပြီး tok/s 16,900 နီးပါးနဲ့ အဆုံးသတ်ခဲ့ပါတယ်။ Intel Arc Pro B70 ဟာ scaling curve မှာ Arc Pro B60 ထက် အနည်းငယ်သာ ကွာခြားပေမယ့် တိုင်းတာလို့ရတဲ့ ဦးဆောင်မှုကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး batch size 32 မှာ 7% လောက် ပိုမြန်ခဲ့ပါတယ်။ NVIDIA ရဲ့ flagship workstation GPU ထက် 40% လောက် နောက်ကျနေပေမယ့် DGX Spark ထက် throughput သုံးဆနီးပါး ပို့ဆောင်ပေးနိုင်ခဲ့ပါတယ်။ batch size 8 ထက် linear scaling နီးပါးက B70 ကို concurrent request တွေ တိုးလာတာနဲ့အမျှ ကောင်းကောင်း အသုံးချနေဆဲဖြစ်ကြောင်းလည်း ညွှန်ပြနေပါတယ်။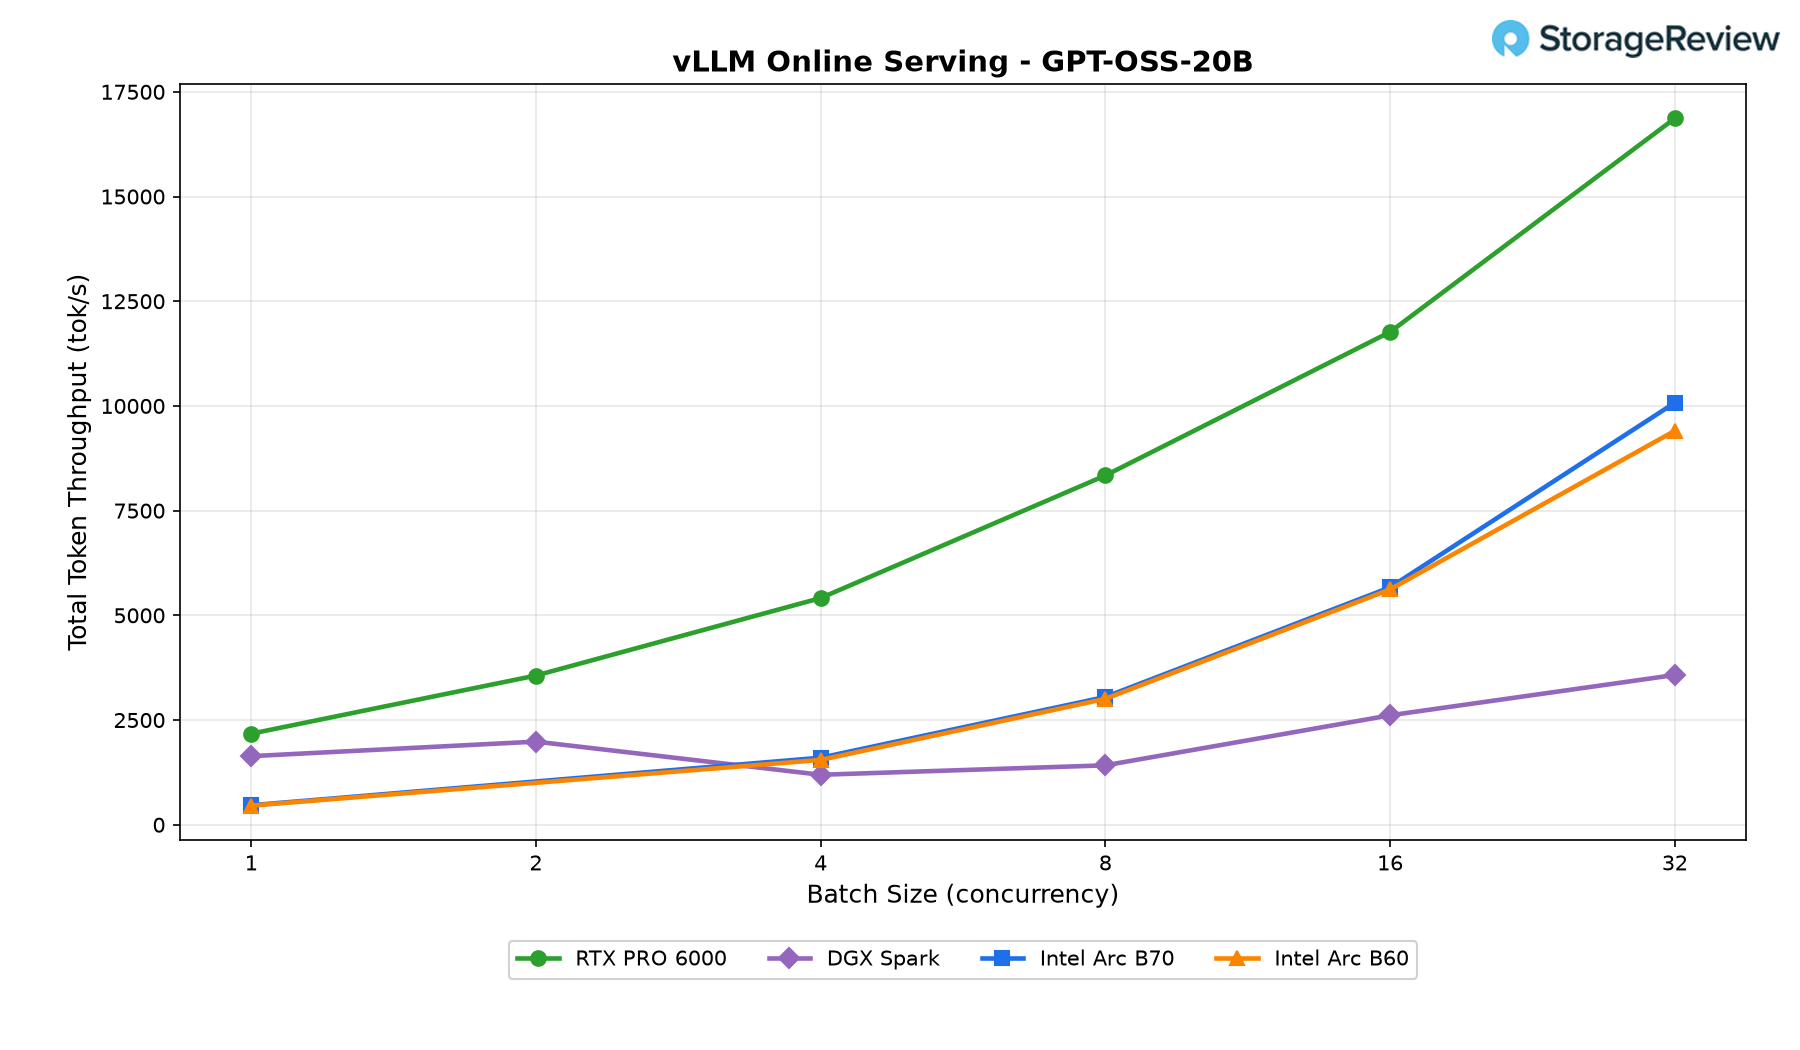
GPT OSS 120B
အဖွဲ့ထဲမှာ အကြီးဆုံးမော်ဒယ်ဟာ ပလက်ဖောင်းအားလုံးမှာ ပိုပြီးတောင်းဆိုမှုတွေ များလာပေမယ့် Intel Arc Pro B70 ကတော့ ထိရောက်စွာ ဆက်လက်တိုးချဲ့နိုင်ခဲ့ပါတယ်။ Arc Pro B60 ထက် ၇% ခန့် သာလွန်ပြီး tok/s 6,870 ဖြင့် ပြီးဆုံးခဲ့ပြီး RTX PRO 6000 ရဲ့ throughput ရဲ့ လေးပုံသုံးပုံခန့်သာ ရှိခဲ့ပါတယ်။ DGX Spark ဟာ တူညီတဲ့ concurrency level မှာ 2,175 tok/s ရောက်ရှိခဲ့ပြီး B70 ကို ၃.၂ ဆ အားသာချက် ရရှိစေခဲ့ပါတယ်။ RTX PRO 6000 ဟာ ಒಟ್ಟಾರೆ ဦးဆောင်မှုကို ထိန်းသိမ်းထားနိုင်ခဲ့ပေမယ့် B70 ကတော့ ပိုကြီးတဲ့ ဘာသာစကားမော်ဒယ်တွေကို ဝန်ဆောင်မှုပေးရာမှာ အထူးသဖြင့် concurrency မြင့်မားခြင်းက hardware ကို အပြည့်အဝ အလုပ်များစေတဲ့အခါ ယှဉ်ပြိုင်နိုင်စွမ်း မြင့်မားနေဆဲဖြစ်ကြောင်း ပြသခဲ့ပါတယ်။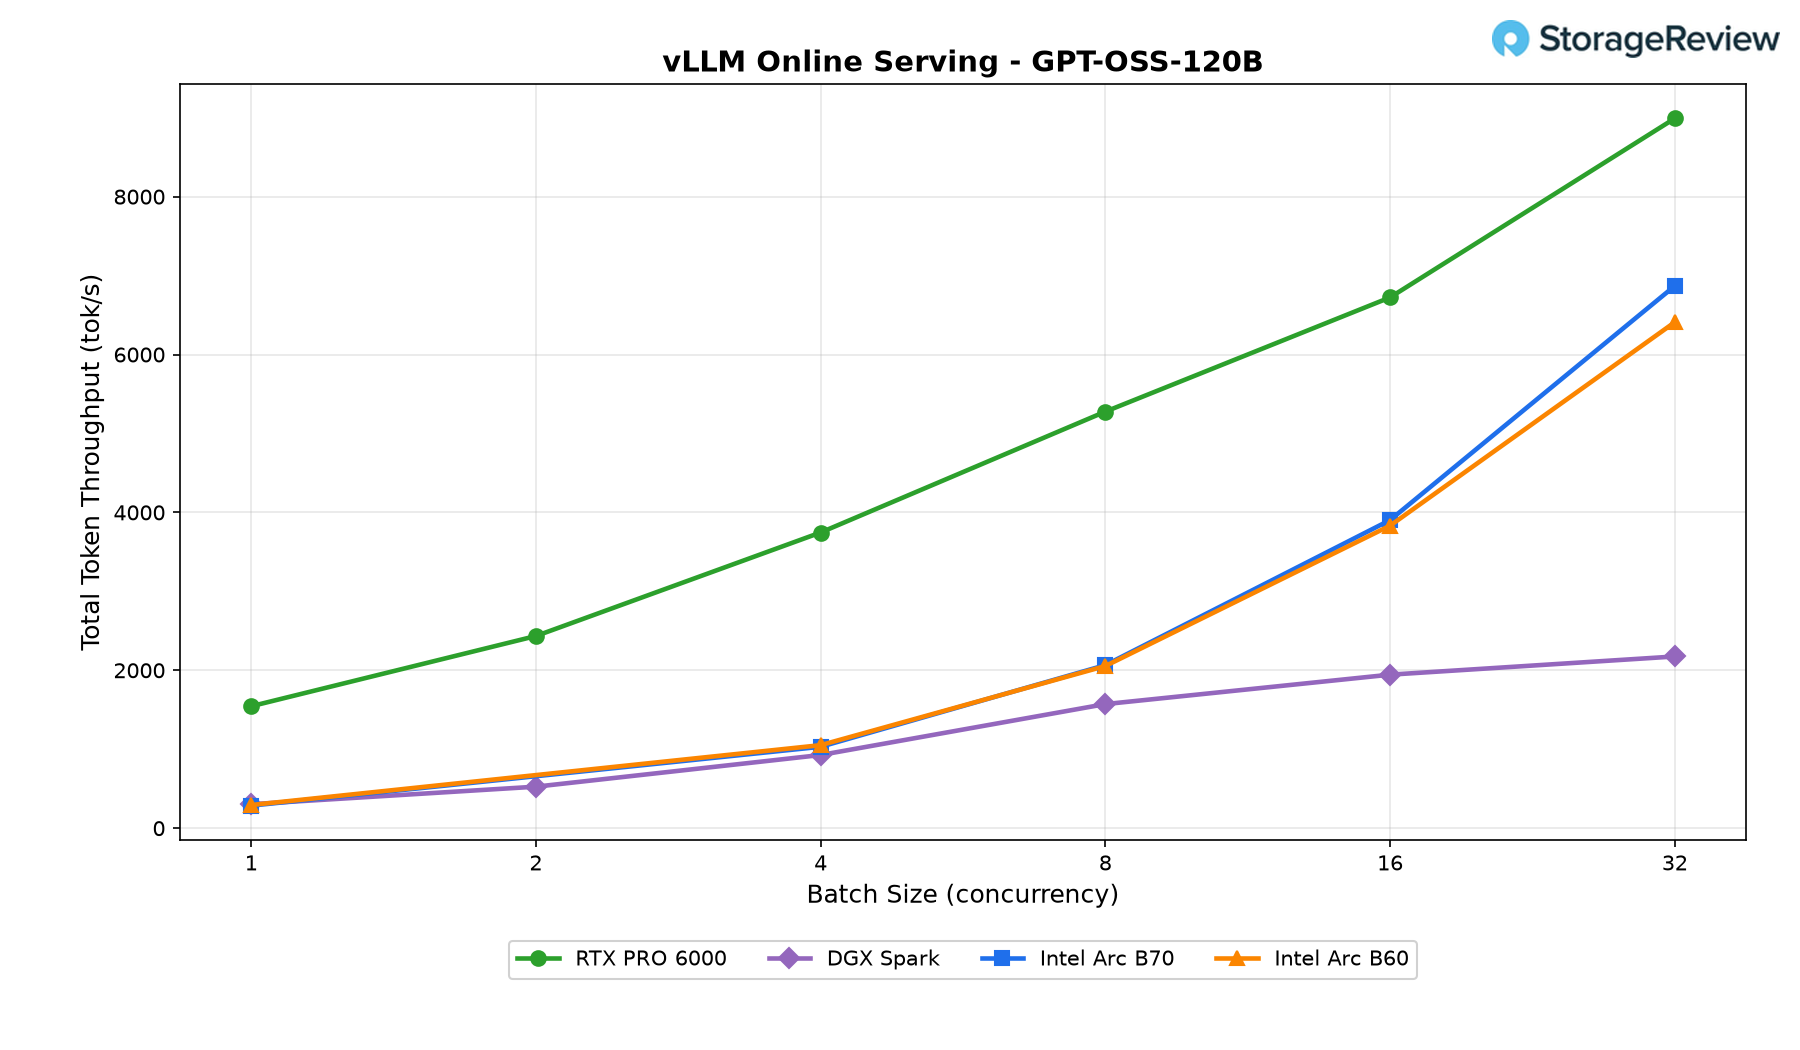
ကောက်ချက်
Intel Arc Pro B70 သည် Intel မှ ယနေ့အထိ ထုတ်လုပ်ခဲ့သော ဆွဲဆောင်မှုအရှိဆုံး workstation AI GPU များထဲမှ တစ်ခုဖြစ်သည်။ ၎င်း၏ MSRP $949 တွင် 32GB ECC GDDR6 ကို AI နှင့် ပရော်ဖက်ရှင်နယ် workloads အများစုတွင် အလားတူစျေးနှုန်းရှိသော consumer GPU များထက် သာလွန်သော စွမ်းဆောင်ရည်နှင့် တွဲဖက်အသုံးပြုခြင်းဖြင့် ထူးခြားသော ရပ်တည်ချက်ကို ဖော်ထုတ်ခဲ့ပြီး workstation-class NVIDIA ၏ အခြားရွေးချယ်စရာများကို သိသိသာသာ လျှော့ချပေးခဲ့သည်။ လက်ရှိစျေးကွက်စျေးနှုန်းသည် ကတ်ကို $1,100 အထက်သို့ တွန်းပို့နေသော်လည်း၊ RTX Pro 4000 ကဲ့သို့သော ထုတ်ကုန်များနှင့် နှိုင်းယှဉ်ပါက တန်ဖိုးအဆိုပြုချက်သည် ဆွဲဆောင်မှုရှိနေဆဲဖြစ်ပြီး အထူးသဖြင့် raw compute ထက် memory capacity သည် အကန့်အသတ်ရှိသော local model ကြီးများ သို့မဟုတ် multi-GPU deployments များ လိုအပ်သော user များအတွက် အထူးသဖြင့် መልእክትကို ကန့်သတ်ထားသော အချက်ဖြစ်သည်။
ဟာ့ဒ်ဝဲရှုထောင့်မှကြည့်လျှင် Intel Arc Pro B70 သည် ပြီးမြောက်အောင်မြင်ခဲ့သည်- Stable Diffusion 1.5 image generation တွင် RTX 5060 Ti နှင့် ထိရောက်စွာ တူညီစေပြီး၊ လေးစားဖွယ်ကောင်းသော rendering ရလဒ်များကို ပြသခဲ့ပြီး၊ ဒေသတွင်း AI အခြေခံအဆောက်အအုံအတွက် တရားဝင်ရွေးချယ်မှုတစ်ခုဖြစ်စေသည့် နှုန်းထားများဖြင့် ခေတ်မီဘာသာစကားမော်ဒယ်များကို ပံ့ပိုးပေးခဲ့ပြီး Llama 3.1 8B တွင် tok/s 12,000 နီးပါးရောက်ရှိခဲ့ပြီး၊ ကတ်လေးခုဖြင့် ကျွန်ုပ်တို့၏ RTX Pro 6000 ရည်ညွှန်းချက်တစ်ခုတည်းကို တစ်ပြိုင်နက်တည်းအပြည့်အဝလုပ်ဆောင်ရာတွင် Mistral Small 24B တွင် 65% ဖြင့် ကျော်လွန်ခဲ့သည်။ တစ်ခုတည်းသော workstation တွင် B70 လေးခုသည် 128GB VRAM ကို စာရင်းတွင် $3,800 ခန့်ဖြင့် ပေးစွမ်းနိုင်ပြီး၊ high-end workstation GPU တစ်ခုတည်း၏ ဈေးနှုန်းနှင့် များစွာနီးစပ်ပါသည်။
Arc Pro B70 ရင်ဆိုင်နေရတဲ့ အကြီးမားဆုံးစိန်ခေါ်မှုက ဆီလီကွန်မဟုတ်ဘဲ ၎င်းပတ်ဝန်းကျင်ရှိ software ecosystem ပါ။ Driver quality နှင့် framework support တို့သည် NVIDIA ၏ CUDA ecosystem နှင့် AMD ၏ ရင့်ကျက်လာသော ROCm stack နှစ်ခုလုံးတွင် ဆက်လက်နောက်ကျကျန်နေပါသည်။ Intel သည် oneAPI၊ OpenVINO နှင့် ၎င်း၏ Battlemage-enabled vLLM ဖွံ့ဖြိုးတိုးတက်ရေးလုပ်ငန်းများတွင် အဓိပ္ပာယ်ရှိသောတိုးတက်မှုများ ပြုလုပ်ခဲ့သော်လည်း အသုံးပြုသူများသည် ရံဖန်ရံခါ တွဲဖက်အသုံးပြုနိုင်မှုပြဿနာများ၊ မော်ဒယ်ပံ့ပိုးမှုအကန့်အသတ်ရှိခြင်းနှင့် ပြိုင်ဘက်ပလက်ဖောင်းများထက် ပြဿနာရှာဖွေဖြေရှင်းရန် ပိုမိုဆန္ဒရှိခြင်းကို မျှော်လင့်ထားသင့်သည်။ AI framework နှင့် application အားလုံးနီးပါးတွင် "အလုပ်လုပ်ရုံ" သော turnkey GPU ကို ရှာဖွေနေသူများသည် NVIDIA နှင့် AMD တို့ကို ပိုမိုလုံခြုံသောရွေးချယ်မှုများအဖြစ် တွေ့ရှိကြဆဲဖြစ်သည်။
အဆုံးစွန်အားဖြင့် Arc Pro B70 သည် VRAM စွမ်းရည်၊ workstation အင်္ဂါရပ်များနှင့် တစ်ဒေါ်လာလျှင် AI စွမ်းဆောင်ရည်ကို တန်ဖိုးထားသော ဝယ်ယူသူများအတွက် အကြံပြုရန်လွယ်ကူပြီး ၎င်းတို့ဝယ်ယူနေသည့်အရာကို နားလည်ပါကဖြစ်သည်။ ၎င်းသည် ဈေးနှုန်းမြင့်မားစွာဖြင့် ကျောထောက်နောက်ခံပြုထားသော ထူးချွန်သော hardware အစိတ်အပိုင်းတစ်ခုဖြစ်သော်လည်း ၎င်း၏ရေရှည်အောင်မြင်မှုသည် Intel ၏ software ဖွံ့ဖြိုးတိုးတက်မှုကို ဆက်လက်လုပ်ဆောင်ခြင်းနှင့် ecosystem ပံ့ပိုးမှုကို တိုးချဲ့ခြင်းအပေါ် ကတိကဝတ်ပေါ်တွင် အပြည့်အဝမူတည်သည်။ Intel သည် ထိုရင်းနှီးမြှုပ်နှံမှုကို ထိန်းသိမ်းထားနိုင်ပါက B70 သည် စားသုံးသူနှင့် ပရော်ဖက်ရှင်နယ် AI အရှိန်မြှင့်တင်မှုတွင် ပိုမိုခိုင်မာသောတန်ဖိုးများထဲမှ တစ်ခုဖြစ်လာရန် hardware အခြေခံရှိသည်။ မဟုတ်ပါက NVIDIA နှင့် AMD ပြိုင်ဘက်များကဲ့သို့ လွယ်ကူစွာအသုံးပြုနိုင်မှုကို မရရှိနိုင်သော အလားအလာကြီးမားသည့် ကတ်တစ်ခုအဖြစ် ဆက်လက်တည်ရှိနေနိုင်သည့် အန္တရာယ်ရှိသည်။


 အမေဇုံ